Paper verified
正式发表
ECCV 2024,LNCS 15129,正式章节页码 235–251。Springer 页面记录 First Online 为 2024-11-01,引用年份显示 2025 属于卷册出版信息。
用冻结的 Stable Diffusion v1.4 在每个 DDIM 去噪步计算内部表征能量梯度,同时动态缩放它相对 CFG 的强度,从而兼顾文本编辑和源图保存。
ECCV 2024,LNCS 15129,正式章节页码 235–251。Springer 页面记录 First Online 为 2024-11-01,引用年份显示 2025 属于卷册出版信息。
正式论文脚注与 Springer 明确确认 Vadim Titov、Madina Khalmatova、Alexandra Ivanova 共同第一。Springer 另明确列出 Aibek Alanov 为通讯作者。
正文与附录依据 arXiv v3 合订本,共 38 页:正文 17 页,附录 21 页。方法实现核查锁定官方仓库提交 4a79013c641d20f57b206ad7f0bf2e9d01cd412c。
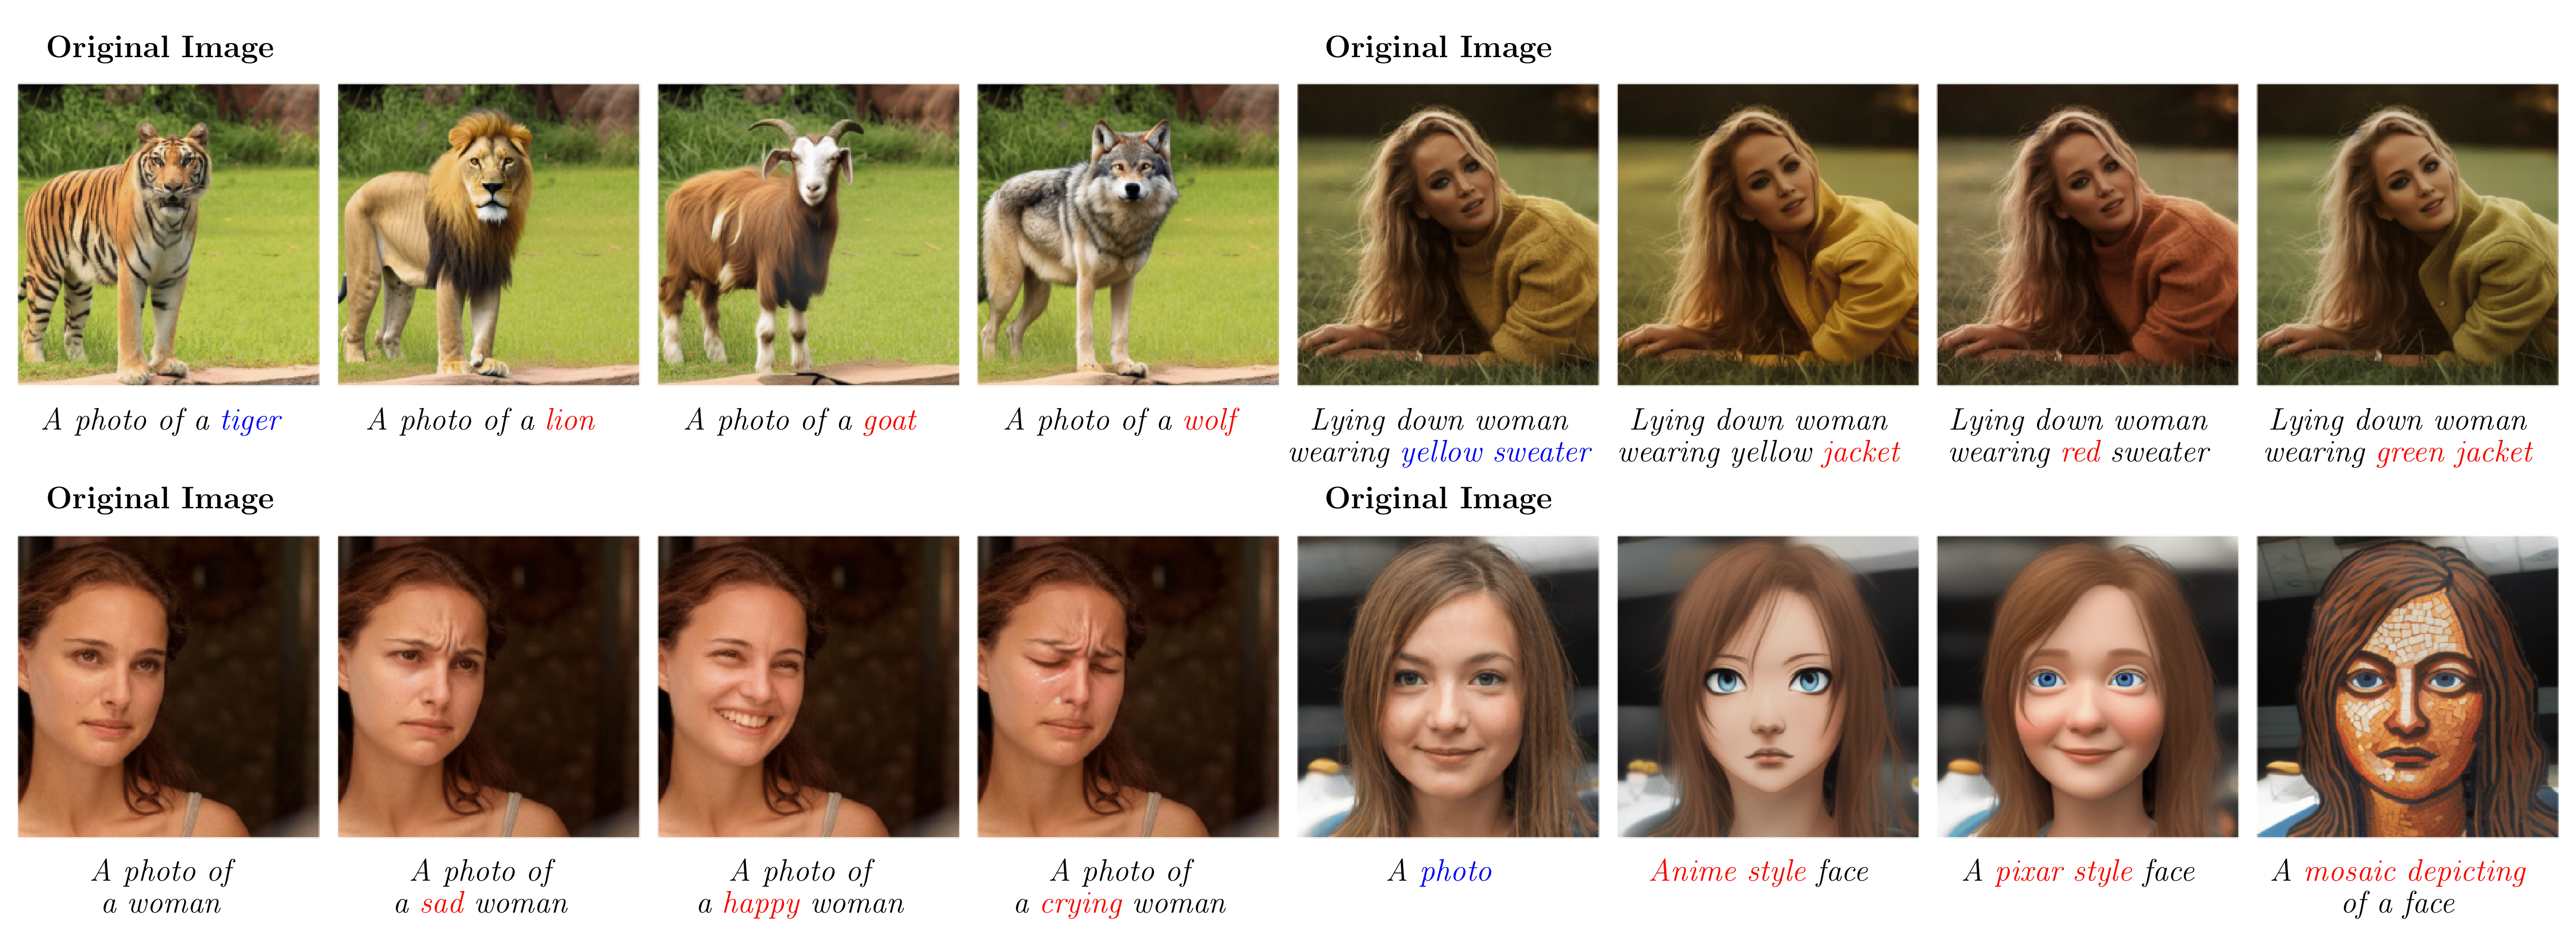
逐图微调能够保存身份和细节,却增加优化时间;表征替换速度较快,但直接注入缓存特征会产生轨迹与表征错配;精确 inversion 提升重建,也增加反演计算。
时间对齐的 inversion latent \(z_t^{\ast}\) 是源图的参考轨迹。当前编辑 latent \(z_t\) 经过同一 source prompt 后,其 self-attention 与 feature 应当接近参考轨迹中对应表征。
作者希望用一个无需训练模型权重、无需精确反演的统一机制,覆盖局部属性、对象替换、表情编辑与全局风格化,并让编辑强度和保存强度在去噪过程中保持可控。
输入为真实图像 \(x_{\mathrm{init}}\)、源描述 \(y_{\mathrm{src}}\) 与目标描述 \(y_{\mathrm{trg}}\)。输出 \(x_{\mathrm{edit}}\) 应满足目标文本,同时保存目标编辑之外的源图结构和外观。
VAE encoder 将图像映射为 \(z_0^{\ast}\),DDIM inversion 产生完整参考轨迹 \(\{z_t^{\ast}\}_{t=0}^{T}\),其中 \(T=50\)。
\(a_t,b_t,a_t^{\ast},b_t^{\ast}\) 由累计噪声系数 \(\bar\alpha_t\) 决定。论文 Appendix A 的 \(\alpha_t\) 实际承担 cumulative alpha 的角色。
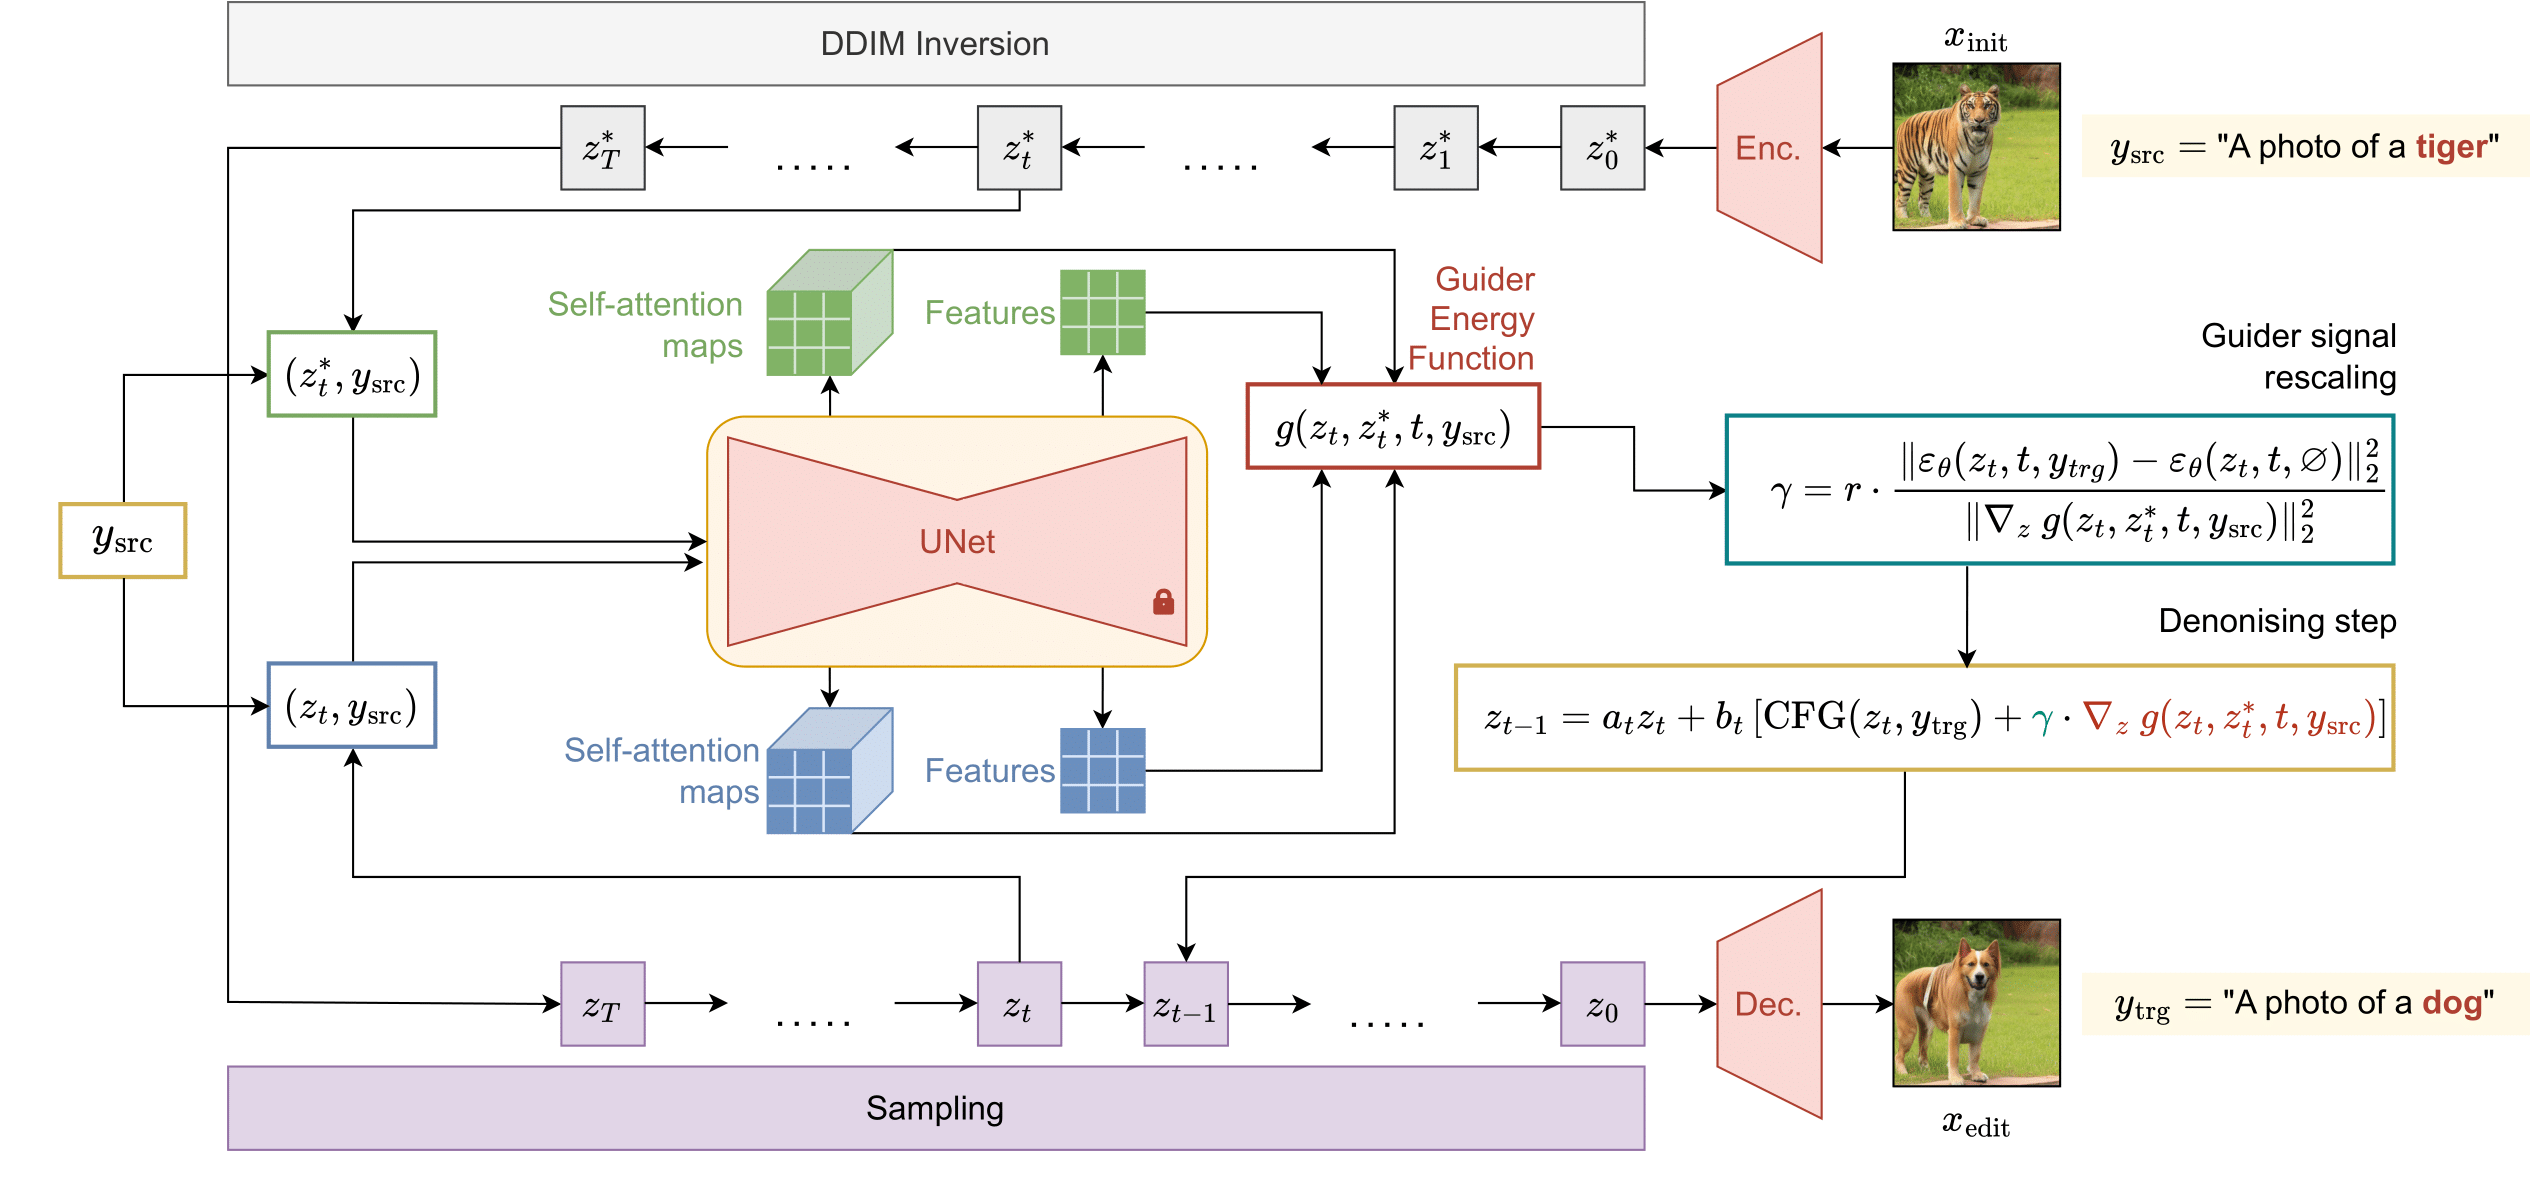
以 source prompt、CFG scale 1 反演真实图像并保存 51 个 latent。这里使用普通 conditional prediction。
unconditional:当前 latent + 空文本;inv_inv:参考 latent + source prompt;cur_inv:当前 latent + source prompt;cur_trg:当前 latent + target prompt。
参考 forward 在 no_grad 下运行;当前 latent 设置 requires_grad,内部表征差异求和后执行 backward,得到对 \(z_t\) 的梯度 \(G_t\)。UNet 参数保持冻结。
目标 prompt 负责编辑方向,source prompt 下的内部表征负责源图保存。
论文在最后若干步关闭 guiders,使末端采样回到 CFG。非风格任务论文写前 35 步启用;固定提交配置使用前 30 步。风格化均为前 25 步。
inversion 使用 \(w=1\),目标采样使用 \(w=7.5\)。直接从 \(z_T^{\ast}\) 按目标 prompt 去噪会让当前轨迹远离参考轨迹,Figure 3 中表现为源图背景、身份和未编辑属性一起漂移。
\(A_{i,t}^{\ast}\) 来自 inv_inv,\(\bar A_{i,t}\) 来自 cur_inv。每层先对逐元素平方差取 mean,再跨层求和。它主要约束对象的相对位置与全局布局。
取最后一个 UNet up-block 的输出,参考与当前都用 source prompt。公开配置:\(v_{\mathrm{self}}=300000\),\(v_{\mathrm{feat}}=500\)。
取第二个 up-block 的第二个 ResNet 输出。当前 feature 来自 cur_trg,参考 feature 来自 inv_inv。公开配置:\(v_{\mathrm{self}}=100000\),\(v_{\mathrm{feat}}=2.5\)。
实现把各 attention head 折入 batch 维,单层 self-attention map 可记为 \(A_i\in\mathbb R^{(B H_i)\times N_i\times N_i}\)。feature map 为 \(\Phi\in\mathbb R^{B\times C\times H\times W}\)。高分辨率层的 \(N_i^2\) 决定主要临时显存。
实现每个 timestep 重新计算参考表征并在读取后清空 hook 输出,没有把 50 步的全部 attention maps 长期缓存。需要保存的是 inversion latents;每步四次 UNet forward 加一次 latent backward,解释了 24.26 秒的运行时间。
该式缩放后的普通范数比为:
因此,论文所称“把 guider 与 CFG 的范数比截断到区间”与其平方范数公式并不严格相符。
提交 4a79013… 的 RangeNoiseRescaler 使用 torch.norm,直接实现普通范数比截断。非风格区间为 \([0.33,3.0]\);风格化上下界都为 \(1.5\),非零条件下最终比值固定为 1.5。
代码在 CFG norm 为零时把 ratio 设为 1;在 guider norm 为零时把 scale 设为 1。这些分支保证数值操作有限,但无法继续保证相对比例。
| 项目 | 论文 / 官方实现 | 复现含义 |
|---|---|---|
| 基础模型 | Stable Diffusion v1.4,冻结 UNet;VAE encoder / decoder | 没有训练 optimizer、learning rate、epoch 或数据训练过程 |
| 采样 | DDIM,50 steps;inversion CFG 1;目标 CFG 7.5 | 保存完整 inversion latent trajectory |
| 非风格 guider | self 300000;feature 500;论文 35 步,代码 30 步 | source/current 与 source/reference;feature 为最后 up-block 输出 |
| 风格 guider | self 100000;feature 2.5;前 25 步;fixed ratio 1.5 | attention 使用 source/current;feature 使用 target/current 与 source/reference |
| 非风格 rescale | lower 0.33;upper 3.0 | 公开代码按普通范数比截断 |
| 运行环境 | Python 3.8.5;PyTorch 2.3.0;Diffusers 0.17.1;NVIDIA A100 40GB | README 披露的官方环境 |
| Prompt | 每个样本需要 source / target caption;论文未公开完整 80 样本 prompt 清单 | 附录给出各数据集构造规则和图中部分 prompt |
| 停止条件 | 固定 50 步完成;末端 guider scale 变为 0 | 没有 beam search、reranking、retry 或 backtracking |
这里用 \(\bar\alpha_t\) 显式表示累计 alpha,避免把单步 \(\alpha_t\) 与累计量混淆。
| 方法 | LPIPS ↓ | CLIP ↑ | FID ↓ | A100 时间 / 秒 ↓ |
|---|---|---|---|---|
| ProxMasaCtrl | 0.267 | 0.215 | 94.53 | 12.94 |
| MasaCtrl | 0.306 | 0.223 | 100.62 | 13.73 |
| EDICT | 0.221 | 0.229 | 47.13 | 68.13 |
| P2P + NTI | 0.279 | 0.233 | 42.46 | 66.77 |
| P2P + NPI Prox | 0.170 | 0.233 | 43.16 | 8.59 |
| P2P + NPI | 0.251 | 0.234 | 44.05 | 8.54 |
| PnP | 0.366 | 0.256 | 39.55 | 197.0 |
| Guide-and-Rescale | 0.228 | 0.243 | 39.07 | 24.26 |
正文声称 LPIPS 仅 EDICT 更低。表中 P2P + NPI Prox 为 0.170,同样低于本文的 0.228,而且差距更大。
LPIPS 在整张原图与编辑图之间计算,编辑目标区域变化也会增加距离。更低数值可能来自编辑不足,因此要和 CLIP、局部 mask 或人评一起解释。
FID 39.07 与 PnP 39.55 没有置信区间或重复试验。论文没有提供显著性检验,不能把 0.48 的差值解释为稳定优势。
| 对比 baseline | Editing Q1 | Preservation Q2 |
|---|---|---|
| MasaCtrl | 85% | 70% |
| ProxMasaCtrl | 82% | 63% |
| P2P + NTI | 60% | 49% |
| P2P + NPI | 59% | 58% |
| P2P + NPI Prox | 50% | 55% |
| PnP | 60% | 61% |
| EDICT | 56% | 59% |
62 名参与者回答 960 个问题;每位最多完成 6 次任务。每个唯一比较由 3 名不同用户判断。主表中 NTI 的 preservation 为 49%,NPI Prox 的 editing 为 50%,因此“每个维度均胜过全部 baseline”的表述超出数据。
4 类任务,每类人工收集 20 张:animal-to-animal、face-in-the-wild、person-in-the-wild、stylisation。选择过程和来源分布没有完整披露。
随机选 500 张图,source prompt 用 caption,target prompt 随机拼接 25 种风格之一。用于 stylisation。
500 张 dog,source 为 “a dog”,target 为 “a cat”;FID 参考 5,000 张 cat。样本量和子集选择会影响 FID 方差。
source 为 “A photo of a person”,从 15 种情绪词随机选一个插入 target prompt。用于表情改变。
| 方法 | 关键参数 |
|---|---|
| PnP | self_attn_block_indices=[4..11];out_layers_output_block_indices=[4];feature_injection_threshold=40;scale=10 |
| EDICT | mix_weight=0.93;init_image_strength=0.8;guidance_scale=3 |
| MasaCtrl | STEP=4;论文表内拼写 LAYPER=10 |
| ProxMasaCtrl | npi=True;npi_interp=1;prox=l0;quantile=0.6;masa_step=4;masa_layer=10 |
| NPI + P2P | cross_replace_steps=0.8;self_replace_steps=0.6;blend_word=None |
| NPI Prox + P2P | 上项参数 + prox=l0;quantile=0.6 |
| NTI + P2P | P2P 参数 + opt_early_stop_epsilon=1e-5;opt_num_inner_steps=10 |
| 方法 | AverageRank ↓ | COCO LPIPS ↓ | COCO CLIP ↑ | FFHQ LPIPS ↓ | FFHQ CLIP ↑ |
|---|---|---|---|---|---|
| Guide-and-Rescale | 2.0 | 0.449 | 0.290 | 0.156 | 0.183 |
| NPI Prox + P2P | 3.0 | 0.208 | 0.263 | 0.134 | 0.171 |
| PnP | 3.7 | 0.378 | 0.286 | 0.251 | 0.190 |
| NPI + P2P | 4.0 | 0.394 | 0.265 | 0.249 | 0.175 |
| EDICT | 4.7 | 0.273 | 0.253 | 0.158 | 0.174 |
| NTI + P2P | 4.7 | 0.338 | 0.272 | 0.120 | 0.171 |
| ProxMasaCtrl | 6.7 | 0.227 | 0.231 | 0.281 | 0.184 |
| MasaCtrl | 7.3 | 0.300 | 0.240 | 0.346 | 0.190 |
AverageRank 对 LPIPS、CLIP、FID 三项名次做等权平均,把不同数据量与不同任务的指标压缩成单值。它容易隐藏指标幅度、相关性和统计不确定性。COCO 风格化中本文 LPIPS 最差 0.449、CLIP 最高 0.290,说明保存原图像素相似度与充分风格化存在冲突。
| Baseline | Face | Animal | Stylisation | Person | ||||
|---|---|---|---|---|---|---|---|---|
| Pres. | Edit | Pres. | Edit | Pres. | Edit | Pres. | Edit | |
| NTI + P2P | 40% | 73% | 67% | 59% | 33% | 52% | 50% | 58% |
| NPI Prox + P2P | 32% | 47% | 92% | 67% | 64% | 36% | 50% | 50% |
| NPI + P2P | 67% | 83% | 73% | 73% | 46% | 62% | 52% | 33% |
| PnP | 72% | 89% | 50% | 58% | 69% | 62% | 61% | 33% |
| EDICT | 68% | 68% | 80% | 67% | 50% | 33% | 42% | 58% |
| ProxMasaCtrl | 67% | 83% | 67% | 81% | 50% | 83% | 73% | 82% |
| MasaCtrl | 75% | 25% | 29% | 71% | 76% | 92% | 100% | 100% |
分任务结果波动很大:例如对 MasaCtrl,本文在 face editing 仅获 25% 胜率,在 person 任务两项均为 100%。附录没有报告每格题目数量、置信区间、随机化顺序或参与者人口统计,无法判断这些极端比例的稳定性。
noise_rescales.py 使用未平方的 torch.norm,在两个范数非零时严格实现最终 guider-to-CFG 范数比截断。它与论文 Equation 15 的 squared norm 不同。
论文 Appendix A 为非风格任务给出 \(\tau=35\)。ours_nonstyle_best.yaml 写 total_first_steps: 30,调度器生成长度 50 的数组,前 30 项非零。
unconditional 与 reference source forward 使用 no_grad;随后当前 latent 开启梯度,依次运行 current source 与 current target。模型参数已冻结,latent 梯度仍通过 UNet 计算。
FeaturesMapL2EnergyGuider.forward_hooks=['cur_trg','inv_inv'],当前分支采用 target prompt,参考分支采用 source prompt。非风格 guider 使用 cur_inv/inv_inv。
风格 feature hook 在 up_blocks[1].resnets[1],逐元素平方差后 mean。非风格 new_features:true 在最后 up-block 输出取 feature,逐元素绝对差后 mean。
grad_guider 的含义属性为 true 表示 guider 直接提供方向,无需对自身输出执行 backward,例如 CFG。能量 guider 为 false,随后会对总能量 backward。名称容易造成相反理解。
forward hook 只保留当前所需输出;写入 data_dict 后执行 single_output_clear。每个采样步还调用垃圾回收与 CUDA cache 清理。
官方仓库提供推理实现、配置与 notebook,没有发布 custom 80 的完整样本及 prompt 列表,也没有实验脚本生成论文全部表格。
本文在公开表格中取得 FID 39.07、CLIP 0.243,且人评多数整体比较偏好本文。
rescaling 能“保持 noise distribution”是作者解释,论文没有直接测量生成轨迹分布。
方法的实际价值来自限制保存梯度相对 CFG 的幅值,并让 source-conditioned 表征提供区域稳定性。
可以把普通范数比实现视作约束投影,再扩展为按层、按区域、按 timestep 的可学习预算。