这篇论文解决的计算错配
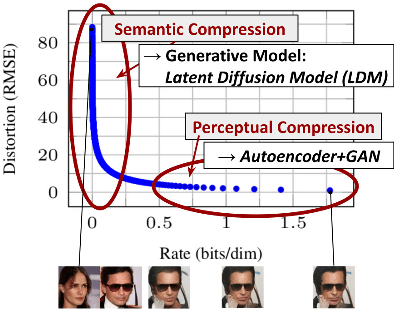
扩散网络的每次前向都处理全部 RGB 像素,高频与人眼不敏感的细节仍持续消耗训练和采样计算。
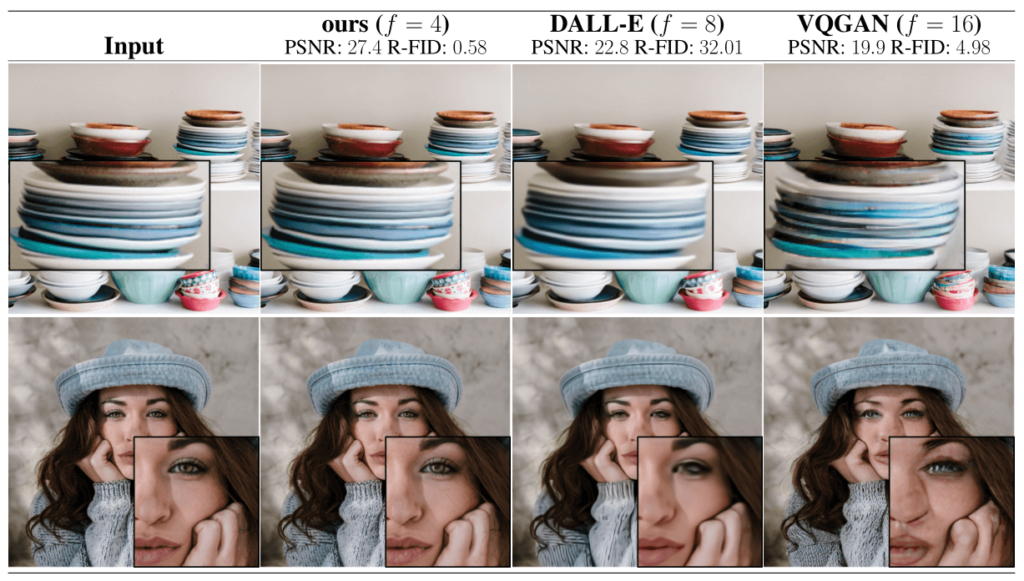
下采样因子 \(f\in\{4,8\}\) 在重建能力、生成质量和吞吐量之间达到论文观测到的最佳区域。
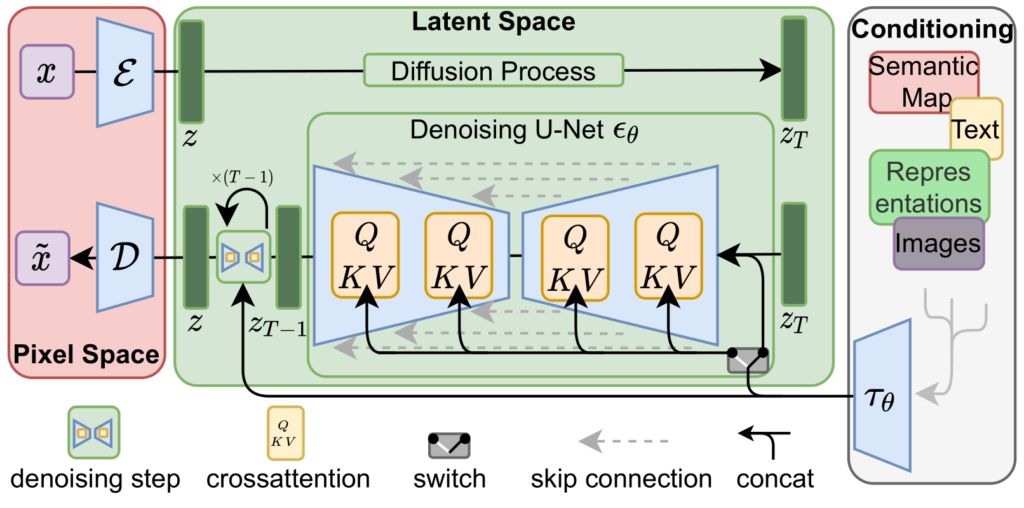
cross-attention 将文本、类别和 bounding boxes 映射到同一个 UNet 条件接口;空间图像条件直接与 noisy latent 拼接。
问题定义与表示
给定图像 \(x\in\mathbb{R}^{H\times W\times3}\),编码器 \(\mathcal{E}\) 产生 \(z=\mathcal{E}(x)\in\mathbb{R}^{h\times w\times c}\),解码器 \(\mathcal{D}\) 还原 \(\tilde{x}=\mathcal{D}(z)\)。空间压缩因子 \(f=H/h=W/w\)。第一阶段固定以后,第二阶段只在 \(z\) 上执行正向加噪与反向去噪。
两类第一阶段正则
KL-regularized
编码器输出对角高斯 \(q_{\mathcal{E}}(z\mid x)\),用约 \(10^{-6}\) 权重的 KL 项轻度约束到标准正态。训练 LDM 时从 posterior 采样连续 latent;这一轻正则保留较强重建能力。
VQ-regularized
使用高容量 codebook 训练 autoencoder。官方实现的 LDM 接口取 quantization 前的连续 tensor 作为扩散空间,解码时再量化并送入 decoder;因此第二阶段仍是连续空间扩散。
KL 分支使用轻权重 \(D_{\mathrm{KL}}(q(z\mid x)\lVert\mathcal{N}(0,\mathbf I))\);VQ 分支用最近 codebook 向量 \(z_q\) 训练 decoder。LPIPS 提供感知相似度,patch discriminator 增强局部纹理,正则项控制 latent。论文把这个阶段称为 perceptual compression;它承担难以察觉的细节压缩,同时保留可供卷积网络建模的二维结构。
Latent diffusion 的训练与采样
前向过程与噪声预测
\(t\) 从 \(\{1,\ldots,T\}\) 均匀采样。这里 \(\alpha_t=\sqrt{\bar{\alpha}_t}\),\(\sigma_t=\sqrt{1-\bar{\alpha}_t}\),\(\bar{\alpha}_t\) 是单步保留系数的累计乘积。UNet 接收 noisy latent \(z_t\) 与 timestep \(t\),预测加入的噪声。附录从 ELBO、真实后验和 \(x_0\)-prediction 推导到 \(\epsilon\)-parameterization,并采用 equal weighting 的简化目标。
反向过程
实际评测大量使用 DDIM 子序列,按 50、100、200、250 或 500 步采样。令 \(\widehat z_0=(z_t-\sqrt{1-\bar{\alpha}_t}\epsilon_{\theta}(z_t,t))/\sqrt{\bar{\alpha}_t}\),一次 DDIM 更新为
此处 \(\sigma_{\eta,t}\) 是 DDIM 子序列的采样随机量,与前向边缘分布中的 \(\sigma_t=\sqrt{1-\bar{\alpha}_t}\) 含义不同;对跳步采样可把 \(t-1\) 替换为前一个子序列时刻 \(\tau\lt t\)。\(\eta=0\) 给出确定性 DDIM 路径,\(\eta\gt0\) 注入随机性。论文训练噪声日程为 1000 步 linear schedule,采样步数与训练 diffusion steps 需要分开理解。
冻结边界
第一阶段编码器与解码器在训练 LDM 时设为 evaluation 状态并关闭梯度。UNet 与可训练的 conditioner \(\tau_{\theta}\) 共同优化。这样的训练边界使生成模型面对固定表示空间,也允许同一 autoencoder 被多个任务复用。
条件生成:一个 UNet,两类入口
Cross-attention
非空间条件 \(y\) 经领域编码器 \(\tau_{\theta}\) 得到 \(\tau_{\theta}(y)\in\mathbb{R}^{M\times d_c}\)。UNet 中间特征 \(\varphi_i(z_t)\in\mathbb{R}^{N\times d_i}\) 产生 query,conditioner 产生 key 与 value。
其中 \(W_Q^{(i)}\in\mathbb{R}^{d_i\times d}\),\(W_K^{(i)}\in\mathbb{R}^{d_c\times d}\),\(W_V^{(i)}\in\mathbb{R}^{d_c\times d_v}\),attention 输出属于 \(\mathbb{R}^{N\times d_v}\)。
文本模型使用 BERT tokenizer,序列长度 77;conditioner 是 depth 32、dim 1280 的 unmasked transformer。布局模型把 bounding box 离散为左上位置、右下位置与类别三元组,序列长度 92,transformer depth 16、dim 512。类别模型使用单个 512 维可学习 embedding。原论文模型没有使用 CLIP text encoder。
空间拼接
超分辨率把低分辨率图像上采样到 latent 尺寸后与 \(z_t\) 在 channel 维拼接;inpainting 同时提供被遮挡图像和 mask;semantic synthesis 拼接下采样的语义图。空间坐标天然对应时,拼接比 token 化更直接。
Classifier-free guidance
文本结果使用 \(s=1.5\) 进行 COCO 量化评测,Figure 5 的自定义提示样例使用 \(s=10\)。ImageNet 最佳结果使用 \(s=1.5\)。增大 \(s\) 通常提升 fidelity,同时会降低 diversity;Table 10 中 recall 从 unguided 的 0.62 降至 0.48。
主文实验:结果与边界
| 数据集 | 方法 | FID↓ | Precision↑ | Recall↑ |
|---|---|---|---|---|
| CelebA-HQ 256² | DC-VAE | 15.8 | – | – |
| VQGAN+T (k=400) | 10.2 | – | – | |
| PGGAN | 8.0 | – | – | |
| LSGM | 7.22 | – | – | |
| UDM | 7.16 | – | – | |
| LDM-4, 500 DDIM steps | 5.11 | 0.72 | 0.49 | |
| FFHQ 256² | ImageBART | 9.57 | – | – |
| U-Net GAN (+aug) | 10.9 (7.6) | – | – | |
| UDM | 5.54 | – | – | |
| StyleGAN | 4.16 | 0.71 | 0.46 | |
| ProjectedGAN | 3.08 | 0.65 | 0.46 | |
| LDM-4, 200 steps | 4.98 | 0.73 | 0.50 | |
| LSUN Churches 256² | DDPM | 7.89 | – | – |
| ImageBART | 7.32 | – | – | |
| PGGAN | 6.42 | – | – | |
| StyleGAN | 4.21 | – | – | |
| StyleGAN2 | 3.86 | – | – | |
| ProjectedGAN | 1.59 | 0.61 | 0.44 | |
| LDM-8 (KL), 200 steps | 4.02 | 0.64 | 0.52 | |
| LSUN Bedrooms 256² | ImageBART | 5.51 | – | – |
| DDPM | 4.9 | – | – | |
| UDM | 4.57 | – | – | |
| StyleGAN | 2.35 | 0.59 | 0.48 | |
| ADM | 1.90 | 0.66 | 0.51 | |
| ProjectedGAN | 1.52 | 0.61 | 0.34 | |
| LDM-4, 200 steps | 2.95 | 0.66 | 0.48 |
| 方法 | FID↓ | IS↑ | 参数量 | 采样设置 |
|---|---|---|---|---|
| CogView | 27.10 | 18.20 | 4B | self-ranking,拒绝率 0.017 |
| LAFITE | 26.94 | 26.02 | 75M | – |
| GLIDE | 12.24 | – | 6B | 277 DDIM,CFG \(s=3\) |
| Make-A-Scene | 11.84 | – | 4B | AR classifier-free guidance \(s=5\) |
| LDM-KL-8 | 23.31 | 20.03 ± 0.33 | 1.45B | 250 DDIM |
| LDM-KL-8-G | 12.63 | 30.29 ± 0.42 | 1.45B | 250 DDIM,CFG \(s=1.5\) |
| 方法 | FID↓ | IS↑ | Precision↑ | Recall↑ | 参数 |
|---|---|---|---|---|---|
| BigGAN-deep | 6.95 | 203.6 ± 2.6 | 0.87 | 0.28 | 340M |
| ADM | 10.94 | 100.98 | 0.69 | 0.63 | 554M |
| ADM-G | 4.59 | 186.7 | 0.82 | 0.52 | 608M |
| LDM-4 | 10.56 | 103.49 ± 1.24 | 0.71 | 0.62 | 400M |
| LDM-4-G, \(s=1.5\) | 3.60 | 247.67 ± 5.59 | 0.87 | 0.48 | 400M |
| 任务 | Pixel-DM | LDM-4 | LaMa | LDM-4 修复 |
|---|---|---|---|---|
| Task 1:与 GT 并列时被偏好 | 16.0% | 30.4% | 13.6% | 21.0% |
| Task 2:模型间偏好 | 29.4% | 70.6% | 31.9% | 68.1% |
每次选择展示 3 秒,位置随机,先收集所有 Task 1 再收集 Task 2。论文没有报告参与人数,因此无法从正文复核置信区间与参与者独立性。
| 方法 | FID↓(val/train) | IS↑ | PSNR↑ | SSIM↑ | 参数 | A100 样本/秒 |
|---|---|---|---|---|---|---|
| Image Regression | 15.2 | 121.1 | 27.9 | 0.801 | 625M | N/A |
| SR3 | 5.2 | 180.1 | 26.4 | 0.762 | 625M | N/A |
| LDM-4, 100 steps | 2.8 / 4.8 | 166.3 | 24.4 ± 3.8 | 0.69 ± 0.14 | 169M | 4.62 |
| LDM-4 big, 100 steps | 2.4 / 4.3 | 174.9 | 24.7 ± 4.1 | 0.71 ± 0.15 | 552M | 4.5 |
| LDM-4, 50 steps, LPIPS guiding | 4.4 / 6.4 | 153.7 | 25.8 ± 3.7 | 0.74 ± 0.12 | 184M | 0.38 |
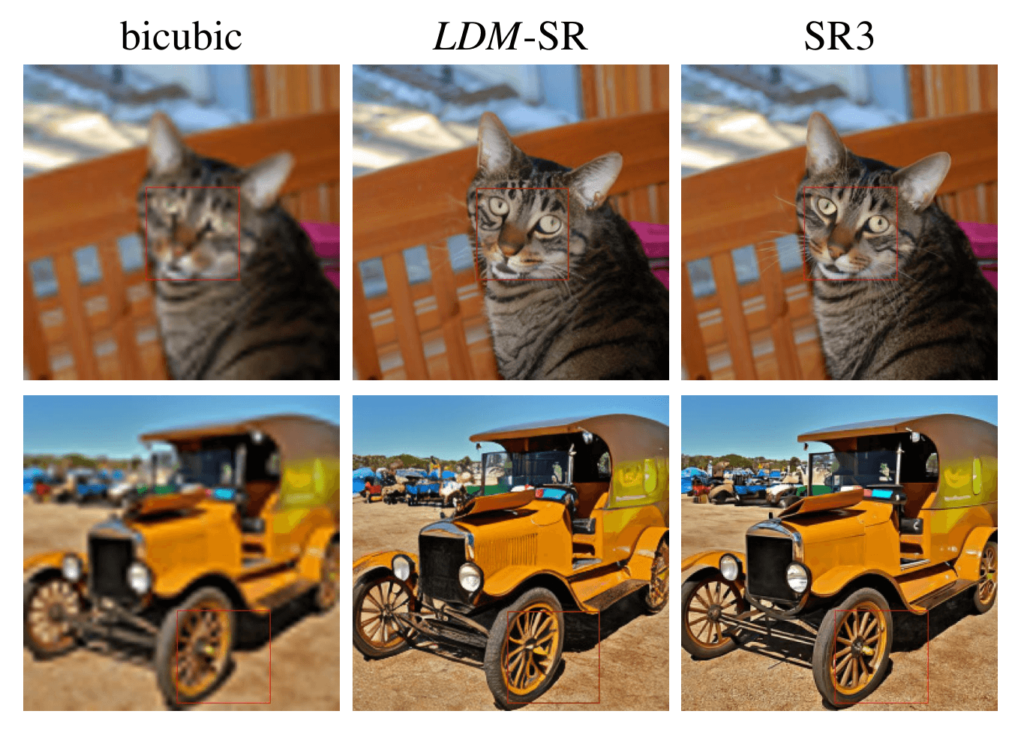
FID 支持 LDM 的感知质量,PSNR/SSIM 支持 regression baseline 的逐像素保真。LPIPS guidance 经 decoder 对 latent 求梯度,提高 distortion 指标并显著降低吞吐量。
| 模型 | 训练样本/秒 | 采样 @256 | 采样 @512 | 训练+验证 小时/epoch | epoch 6 FID@2k |
|---|---|---|---|---|---|
| LDM-1,pixel | 0.11 | 0.26 | 0.07 | 20.66 | 24.74 |
| LDM-4 KL,有 attention | 0.32 | 0.97 | 0.34 | 7.66 | 15.21 |
| LDM-4 VQ,有 attention | 0.33 | 0.97 | 0.34 | 7.04 | 14.99 |
| LDM-4 VQ,无 attention | 0.35 | 0.99 | 0.36 | 6.66 | 15.95 |
| 方法 | 40–50% mask FID↓ | 40–50% LPIPS↓ | 全部 FID↓ | 全部 LPIPS↓ |
|---|---|---|---|---|
| LDM-4 big,有 finetune | 9.39 | 0.246 ± 0.042 | 1.50 | 0.137 ± 0.080 |
| LDM-4 big,无 finetune | 12.89 | 0.257 ± 0.047 | 2.40 | 0.142 ± 0.085 |
| LDM-4,有 attention | 11.87 | 0.257 ± 0.042 | 2.15 | 0.144 ± 0.084 |
| LDM-4,无 attention | 12.60 | 0.259 ± 0.041 | 2.37 | 0.145 ± 0.084 |
| LaMa,作者重算 | 12.31 | 0.243 ± 0.038 | 2.23 | 0.134 ± 0.080 |
| LaMa,原报告 | 12.0 | 0.24 | 2.21 | 0.14 |
| CoModGAN | 10.4 | 0.26 | 1.82 | 0.15 |
| RegionWise | 21.3 | 0.27 | 4.75 | 0.15 |
| DeepFill v2 | 22.1 | 0.28 | 5.20 | 0.16 |
| EdgeConnect | 30.5 | 0.28 | 8.37 | 0.16 |
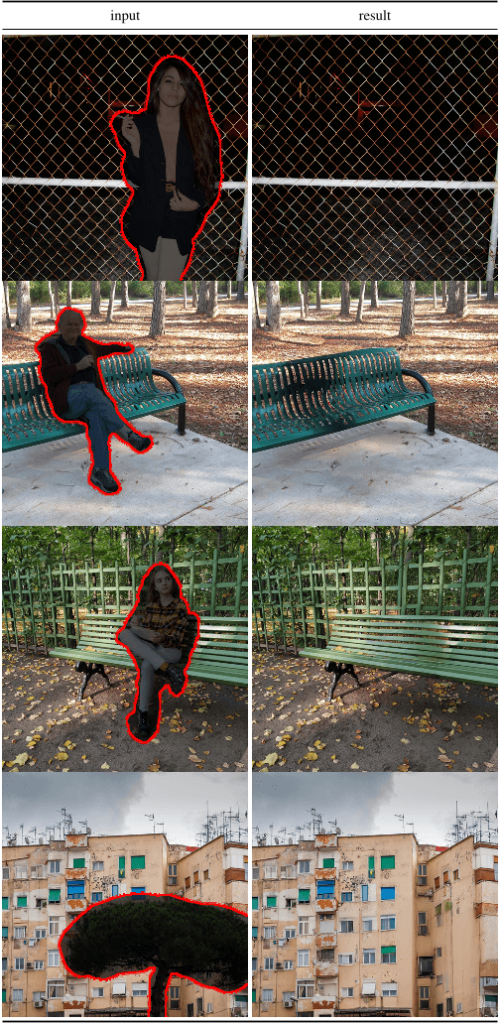
LaMa 原测试集无法获得,论文用自建固定测试集重算一行,并保留 LaMa 论文原报告。训练使用 Places 的 256² random crops;验证 2k,测试 30k,评测使用 512² crops。big 模型为 387M UNet,在 512² 上额外 finetune 约半个 epoch。
附录 Table 8–18:重建与复现配置
| \(f\) | 正则 / codebook | \(c\) | R-FID↓ | R-IS↑ | PSNR↑ | PSIM↓ | SSIM↑ |
|---|---|---|---|---|---|---|---|
| 16 VQGAN | 16384 | 256 | 4.98 | – | 19.9 ± 3.4 | 1.83 ± 0.42 | 0.51 ± 0.18 |
| 16 VQGAN | 1024 | 256 | 7.94 | – | 19.4 ± 3.3 | 1.98 ± 0.43 | 0.50 ± 0.18 |
| 8 DALL-E | 8192 | – | 32.01 | – | 22.8 ± 2.1 | 1.95 ± 0.51 | 0.73 ± 0.13 |
| 32 | VQ 16384 | 16 | 31.83 | 40.40 ± 1.07 | 17.45 ± 2.90 | 2.58 ± 0.48 | 0.41 ± 0.18 |
| 16 | VQ 16384 | 8 | 5.15 | 144.55 ± 3.74 | 20.83 ± 3.61 | 1.73 ± 0.43 | 0.54 ± 0.18 |
| 8 | VQ 16384 | 4 | 1.14 | 201.92 ± 3.97 | 23.07 ± 3.99 | 1.17 ± 0.36 | 0.65 ± 0.16 |
| 8 | VQ 256 | 4 | 1.49 | 194.20 ± 3.87 | 22.35 ± 3.81 | 1.26 ± 0.37 | 0.62 ± 0.16 |
| 4 | VQ 8192 | 3 | 0.58 | 224.78 ± 5.35 | 27.43 ± 4.26 | 0.53 ± 0.21 | 0.82 ± 0.10 |
| 4† | VQ 8192 | 3 | 1.06 | 221.94 ± 4.58 | 25.21 ± 4.17 | 0.72 ± 0.26 | 0.76 ± 0.12 |
| 4 | VQ 256 | 3 | 0.47 | 223.81 ± 4.58 | 26.43 ± 4.22 | 0.62 ± 0.24 | 0.80 ± 0.11 |
| 2 | VQ 2048 | 2 | 0.16 | 232.75 ± 5.09 | 30.85 ± 4.12 | 0.27 ± 0.12 | 0.91 ± 0.05 |
| 2 | VQ 64 | 2 | 0.40 | 226.62 ± 4.83 | 29.13 ± 3.46 | 0.38 ± 0.13 | 0.90 ± 0.05 |
| 32 | KL | 64 | 2.04 | 189.53 ± 3.68 | 22.27 ± 3.93 | 1.41 ± 0.40 | 0.61 ± 0.17 |
| 32 | KL | 16 | 7.3 | 132.75 ± 2.71 | 20.38 ± 3.56 | 1.88 ± 0.45 | 0.53 ± 0.18 |
| 16 | KL | 16 | 0.87 | 210.31 ± 3.97 | 24.08 ± 4.22 | 1.07 ± 0.36 | 0.68 ± 0.15 |
| 16 | KL | 8 | 2.63 | 178.68 ± 4.08 | 21.94 ± 3.92 | 1.49 ± 0.42 | 0.59 ± 0.17 |
| 8 | KL | 4 | 0.90 | 209.90 ± 4.92 | 24.19 ± 4.19 | 1.02 ± 0.35 | 0.69 ± 0.15 |
| 4 | KL | 3 | 0.27 | 227.57 ± 4.89 | 27.53 ± 4.54 | 0.55 ± 0.24 | 0.82 ± 0.11 |
| 2 | KL | 2 | 0.086 | 232.66 ± 5.16 | 32.47 ± 4.19 | 0.20 ± 0.09 | 0.93 ± 0.04 |
† 表示 attention-free autoencoder。R-FID 是重建 FID,衡量第一阶段上限;极低 R-FID 并不自动带来最高生成效率,因为 latent 分辨率也决定扩散计算量。
| 方法 | COCO 256² FID↓ | OpenImages 256² | OpenImages 512² |
|---|---|---|---|
| LostGAN-V2 | 42.55 | – | – |
| OC-GAN | 41.65 | – | – |
| SPADE | 41.11 | – | – |
| VQGAN+T | 56.58 | 45.33 | 48.11 |
| LDM-8,COCO scratch,100 steps | 42.06 | – | – |
| LDM-4,OpenImages→COCO finetune,200 steps | 40.91 | 32.02 | 35.80 |
| 方法 | FID | IS | P | R | 参数 | 设置 |
|---|---|---|---|---|---|---|
| SR3 | 11.30 | – | – | – | 625M | – |
| ImageBART | 21.19 | – | – | – | 3.5B | – |
| ImageBART | 7.44 | – | – | – | 3.5B | 0.05 rejection |
| VQGAN+T | 17.04 | 70.6 ± 1.8 | – | – | 1.3B | – |
| VQGAN+T | 5.88 | 304.8 ± 3.6 | – | – | 1.3B | 0.05 rejection |
| BigGAN-deep | 6.95 | 203.6 ± 2.6 | 0.87 | 0.28 | 340M | – |
| ADM | 10.94 | 100.98 | 0.69 | 0.63 | 554M | 250 DDIM |
| ADM-G | 4.59 | 186.7 | 0.82 | 0.52 | 608M | 250 DDIM |
| ADM-G + ADM-U | 3.85 | 221.72 | 0.84 | 0.53 | n/a | 2 × 250 DDIM |
| CDM | 4.88 | 158.71 ± 2.26 | – | – | n/a | 2 × 100 DDIM |
| LDM-8, 2.9M | 17.41 | 72.92 ± 2.6 | 0.65 | 0.62 | 395M | 200 DDIM |
| LDM-8-G, 2.9M | 8.11 | 190.43 ± 2.60 | 0.83 | 0.36 | 506M | classifier scale 10 |
| LDM-8, 4.8M | 15.51 | 79.03 ± 1.03 | 0.65 | 0.63 | 395M | 200 DDIM |
| LDM-8-G, 4.8M | 7.76 | 209.52 ± 4.24 | 0.84 | 0.35 | 506M | classifier scale 10 |
| LDM-4 | 10.56 | 103.49 ± 1.24 | 0.71 | 0.62 | 400M | 250 DDIM |
| LDM-4-G | 3.95 | 178.22 ± 2.43 | 0.81 | 0.55 | 400M | CFG \(s=1.25\) |
| LDM-4-G | 3.60 | 247.67 ± 5.59 | 0.87 | 0.48 | 400M | CFG \(s=1.5\) |
| 方法 | FID val/train | IS | PSNR | SSIM |
|---|---|---|---|---|
| Image Regression | 15.2 | 121.1 | 27.9 | 0.801 |
| SR3 | 5.2 | 180.1 | 26.4 | 0.762 |
| LDM-4, 100 steps | 2.8 / 4.8 | 166.3 | 24.4 ± 3.8 | 0.69 ± 0.14 |
| LDM-4, 50 steps, guiding | 4.4 / 6.4 | 153.7 | 25.8 ± 3.7 | 0.74 ± 0.12 |
| LDM-4, 100 steps, guiding | 4.4 / 6.4 | 154.1 | 25.7 ± 3.7 | 0.73 ± 0.12 |
| LDM-4, +15 epochs | 2.6 / 4.6 | 169.76 ± 5.03 | 24.4 ± 3.8 | 0.69 ± 0.14 |
| Pixel-DM, +15 epochs | 5.1 / 7.1 | 163.06 ± 4.67 | 24.1 ± 3.3 | 0.59 ± 0.12 |
Table 12 · 无条件模型训练配置
| 配置 | CelebA-HQ | FFHQ | LSUN Churches | LSUN Bedrooms |
|---|---|---|---|---|
| f / z-shape / codebook | 4 / 64×64×3 / 8192 | 4 / 64×64×3 / 8192 | 8 / 原表未报 / 原表未报 | 4 / 64×64×3 / 8192 |
| steps / schedule / params | 1000 / linear / 274M | 1000 / linear / 274M | 1000 / linear / 294M | 1000 / linear / 274M |
| channels / depth / multiplier | 224 / 2 / 1,2,3,4 | 224 / 2 / 1,2,3,4 | 192 / 2 / 1,2,2,4,4 | 224 / 2 / 1,2,3,4 |
| attention res. / head channels | 32,16,8 / 32 | 32,16,8 / 32 | 32,16,8,4 / 24 | 32,16,8 / 32 |
| batch / iterations / LR | 48 / 410k / 9.6e-5 | 42 / 635k / 8.4e-5 | 96 / 500k / 5e-5 | 48 / 1.9M / 9.6e-5 |
Table 13 · ImageNet 压缩率分析配置
| 配置 | LDM-1 | LDM-2 | LDM-4 | LDM-8 | LDM-16 | LDM-32 |
|---|---|---|---|---|---|---|
| z-shape | 256×256×3 | 128×128×2 | 64×64×3 | 32×32×4 | 16×16×8 | 8×8×32* |
| codebook | – | 2048 | 8192 | 16384 | 16384 | 16384 |
| params / channels | 396M / 192 | 391M / 192 | 391M / 192 | 395M / 256 | 395M / 256 | 395M / 256 |
| multiplier | 1,1,2,2,4,4 | 1,2,2,4,4 | 1,2,3,5 | 1,2,4 | 1,2,4 | 1,2,4 |
| batch / LR | 7 / 4.9e-5 | 9 / 6.3e-5 | 40 / 8e-5 | 64 / 6.4e-5 | 112 / 4.5e-5 | 112 / 4.5e-5 |
| CA resolutions | 32,16,8 | 32,16,8 | 32,16,8 | 32,16,8 | 16,8,4 | 8,4,2 |
全部为 1000 diffusion steps、linear schedule、depth 2、1 head、2M iterations、CA、embedding 512、transformer depth 1。* arXiv v2 TeX 源写成“88×8×32”,与 \(f=32\) 的空间尺寸关系冲突;页面按 8×8×32 显示并保留此版本勘误说明。
Table 14 · CelebA 压缩率分析配置
| 配置 | LDM-1 | LDM-2 | LDM-4 | LDM-8 | LDM-16 | LDM-32 |
|---|---|---|---|---|---|---|
| z-shape | 256×256×3 | 128×128×2 | 64×64×3 | 32×32×4 | 16×16×8 | 8×8×32* |
| params / channels | 270M / 192 | 265M / 192 | 274M / 224 | 258M / 256 | 260M / 256 | 258M / 256 |
| multiplier | 1,1,2,2,4,4 | 1,2,2,4,4 | 1,2,3,4 | 1,2,4 | 1,2,4 | 1,2,4 |
| attention res. | 32,16,8 | 32,16,8 | 32,16,8 | 32,16,8 | 16,8,4 | 8,4,2 |
| batch / LR | 9 / 9e-5 | 11 / 1.1e-4 | 48 / 9.6e-5 | 96 / 9.6e-5 | 128 / 1.3e-4 | 128 / 1.3e-4 |
全部为 1000 steps、linear、depth 2、head channels 32、500k iterations;提前收敛时使用最佳 checkpoint。* 同 Table 13 的 TeX 源勘误。
Table 15 · 全部条件模型配置
| 任务 / 数据 | f / z-shape / codebook | 参数 / channels / multiplier | batch / iterations / LR | 条件 |
|---|---|---|---|---|
| Text-to-Image / LAION | 8 / 32×32×4 / continuous | 1.45B / 320 / 1,2,4,4;8 heads | 680 / 390k / 1e-4 | CA 32,16,8;dim 1280;UNet transformer depth 1 |
| Layout / OpenImages | 4 / 64×64×3 / 8192 | 306M / 128 / 1,2,3,4 | 24 / 4.4M / 4.8e-5 | CA 32,16,8;dim 512;depth 3 |
| Layout / COCO | 8 / 32×32×4 / 16384 | 345M / 192 / 1,2,4;dropout 0.1 | 48 / 170k / 4.8e-5 | CA 32,16,8;dim 512;depth 2 |
| Class / ImageNet | 4 / 64×64×3 / 8192 | 395M / 192 / 1,2,3,5 | 1200 / 178k / 1e-4 | CA 32,16,8;dim 512;depth 1 |
| Super Resolution / ImageNet | 4 / 64×64×3 / 8192 | 169M / 160 / 1,2,2,4 | 64 / 860k / 6.4e-5 | concat |
| Inpainting / Places | 4 / 64×64×3 / 8192 | 215M / 128 / 1,4,8 | 128 / 360k / 1e-6 | concat;8×V100 |
| Semantic Map / Landscapes | 8 / 32×32×4 / 16384 | 215M / 128 / 1,4,8 | 48 / 360k / 4.8e-5 | concat |
全部使用 1000 diffusion steps、linear schedule、depth 2。其余模型按原表说明使用单张 A100。正文语义合成段落写 \(f=4\) VQ,Table 15 写 \(f=8\);这里保留原文内部差异。COCO 配置对应 scratch LDM-8;Table 9 的最佳 COCO 行是 OpenImages LDM-4 finetune,二者不可合并。
Table 16–17 · Transformer 结构与 conditioner
Table 16:输入 \(\mathbb{R}^{h\times w\times c}\) → LayerNorm → 1×1 Conv 到 \(d\cdot n_h\) → reshape 为 \(hw\times d n_h\) → 重复 \(T\) 次 Self-Attention、MLP、Cross-Attention → reshape → 1×1 Conv 回到 \(c\)。残差连接维持原 feature map。
| Conditioner | 序列长度 | depth \(N\) | dim |
|---|---|---|---|
| Text-to-Image,BERT tokenizer | 77 | 32 | 1280 |
| Layout-to-Image | 92 | 16 | 512 |
Table 18 · 计算量、吞吐量与质量
| 数据 / 方法 | Generator / classifier / overall V100-days | A100 样本/秒 | 参数 | FID / IS / P / R |
|---|---|---|---|---|
| Churches StyleGAN2 | 64 / – / 64 | – | 59M | 3.86 / – / – / – |
| Churches LDM-8, 100 steps | 18 / – / 18 | 6.80 | 256M | 4.02 / – / .64 / .52 |
| Bedrooms ADM, 1000 | 232 / – / 232 | .03 | 552M | 1.90 / – / .66 / .51 |
| Bedrooms LDM-4, 200 | 60 / – / 55* | 1.07 | 274M | 2.95 / – / .66 / .48 |
| CelebA LDM-4, 500 | 14.4 / – / 14.4 | .43 | 274M | 5.11 / – / .72 / .49 |
| FFHQ StyleGAN2 | 32.13 / – / 32.13 | – | 59M | 3.8 / – / – / – |
| FFHQ LDM-4, 200 | 26 / – / 26 | 1.07 | 274M | 4.98 / – / .73 / .50 |
| ImageNet VQGAN-f4 first stage | 29 / – / 29 | – | 55M | R-FID .58 / – / – / – |
| ImageNet VQGAN-f8 first stage | 66 / – / 66 | – | 68M | R-FID 1.14 / – / – / – |
| BigGAN-deep | 128–256 / – / 128–256 | – | 340M | 6.95 / 203.6±2.6 / .87 / .28 |
| ADM, 250 | 916 / – / 916 | .12 | 554M | 10.94 / 100.98 / .69 / .63 |
| ADM-G, 25 | 916 / 46 / 962 | .7 | 608M | 5.58 / – / .81 / .49 |
| ADM-G, 250 | 916 / 46 / 962 | .07 | 608M | 4.59 / 186.7 / .82 / .52 |
| ADM-G + ADM-U | 329 / 30 / 349* | n/a | n/a | 3.85 / 221.72 / .84 / .53 |
| LDM-8-G, 100, 2.9M | 79 / 12 / 91 | 1.93 | 506M | 8.11 / 190.4±2.6 / .83 / .36 |
| LDM-8, 200, 2.9M | 79 / – / 79 | 1.9 | 395M | 17.41 / 72.92 / .65 / .62 |
| LDM-4, 250, 178k | 271 / – / 271 | .7 | 400M | 10.56 / 103.49±1.24 / .71 / .62 |
| LDM-4-G, \(s=1.25\) | 271 / – / 271 | .4 | 400M | 3.95 / 178.22±2.43 / .81 / .55 |
| LDM-4-G, \(s=1.5\) | 271 / – / 271 | .4 | 400M | 3.60 / 247.67±5.59 / .87 / .48 |
V100-days 由作者把单 A100 天数按 2.2× 速度比换算;这是硬件近似换算。* 原 Table 18 的 Bedrooms 行 generator 60、overall 55,以及 ADM-G+ADM-U 行 329+30 与 overall 349 均存在算术不一致,页面保留原值。Churches 的 Table 12 参数量 294M 与 Table 18 的 256M 也存在报告差异,公开材料不足以确认具体口径。
任务协议与高分辨率机制
文本生成
1.45B LDM-KL-8 在 LAION-400M 上训练 390k iterations,batch 680,LR \(10^{-4}\)。COCO-val 30k captions 用 250 DDIM 评测。v2 已替换早期 Conceptual Captions 645M 模型。论文中的“1.45B”包含生成网络与条件组件的报告口径;发布配置保留 BERT conditioner。
超分辨率
训练输入为 ImageNet,短边至少 256,遵循 SR3 预处理,固定 bicubic \(4\times\) degradation。LDM-BSR 将它替换为随机 JPEG、相机噪声、插值、Gaussian blur 与 Gaussian noise 的组合,并修改了 BSRGAN 原始参数;量化主表对应 fixed bicubic 模型。
修复
使用 LaMa mask generator。训练 crop 256²,测试 crop 512²;条件为 masked image 与 mask 的 channel concatenation。基础模型 215M,big 模型 387M。LDM 产生多样候选,LPIPS 对平均化输出有不同偏好。
卷积式高分辨率采样
UNet 与 autoencoder 都是卷积结构,因此可在大于训练尺寸的 latent 网格上运行。空间条件有助于固定全局布局;文本或无条件生成在大尺寸上会出现重复与结构松散。附录使用低分辨率目标的 \(L_2\) 或 LPIPS 梯度引导大图采样。
其中 \(T\) 可以是 identity 或 downsampling,\(C\) 是与 \(z_t\) 无关的常数。这里的 \(\widetilde p\) 表示未归一化 Gaussian energy,并用 \(\widehat z_0(z_t)\) plug-in 近似构造引导梯度;它不构成精确的观测 likelihood。该梯度修正当前 score;LPIPS 版本把 \(L_2\) 换成 learned perceptual distance。
原图占位:未嵌入 Figure 的编号索引(编号依据 arXiv v2)
LAION 1.45B 文本模型的自定义提示样例;200 DDIM、\(\eta=1\)、CFG \(s=10\)。
ImageNet 与 CelebA 的压缩率训练曲线、FID–sampling throughput 曲线,支撑 \(f=4\) 与 \(f=8\) 的折中判断。
COCO layout-to-image 样例与 512×1024 语义图条件卷积采样,展示两类条件入口。
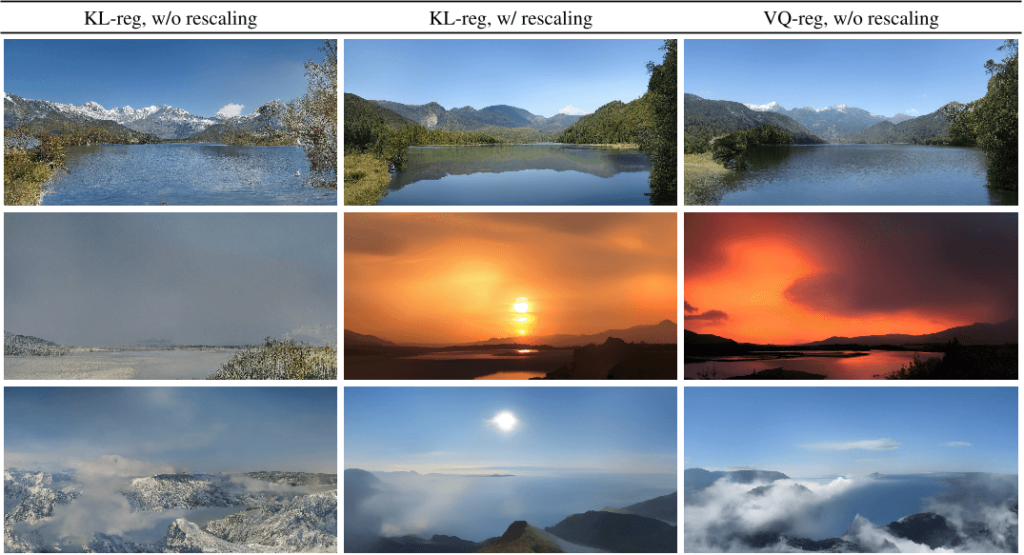
512² landscapes、文本大图、低分辨率图像引导及 latent rescaling;Figure 15 已在上文嵌入。
布局补充样例、ImageNet 固定算力曲线、LDM-BSR 泛化与等训练量 pixel-SR 对比。
修复多样性、物体移除、landscape 大图和语义条件跨分辨率泛化。
ImageNet CFG 样例与 CelebA-HQ、FFHQ、Churches、Bedrooms 无条件样例;图注中的部分 FID 沿用早期 checkpoint。
VGG-16 feature space 最近邻,检查样本是否直接复现训练图像。
Paper vs. Implementation · 固定提交代码审计
审计对象:官方仓库提交 a506df5756472e2ebaf9078affdde2c4f1502cd4。以下结论来自配置与实现文件,适用范围限定在该提交。
latent 缩放
论文附录 G 的规则是首个 batch 上估计 \(z\) 的全局标准差,再使用其倒数缩放。实现路径调用 z.flatten().std(),统计覆盖 batch、channel 和空间维度,得到单一 scalar。没有逐通道减均值表达。
发布的 txt2img-1p4B-eval.yaml 直接写 scale_factor: 0.18215。它是固定评估配置值;论文训练规则仍是首批全局标准差估计。该值确实存在于原始 LDM 官方仓库。
第一阶段接口
first_stage_model.eval() 且所有参数 requires_grad=False。KL 分支调用 posterior sample()。VQModelInterface.encode 返回 quantization 前 tensor,decode 再执行 quantize,吻合“连续 spatial latent diffusion”的论文表述。
原始文本配置
text-to-image 配置为 BERTEmbedder:depth 32、embedding 1280、序列 77;UNet channels 320、8 heads,在 32/16/8 分辨率使用 spatial transformer;KL-f8 latent 为 4 channels。它没有使用 Stable Diffusion 后续的 CLIP text encoder。
优化器与学习率
扩散实现使用 AdamW,并在 cond_stage_trainable 时把 conditioner 参数加入同一 optimizer。配置和调用没有显式给出 betas 与 weight decay,因此只能按所锁定 PyTorch 环境的 AdamW 默认值理解,论文没有报告它们。
main.py 在 scale_lr 开启时计算:actual LR = gradient accumulation × GPU 数 × batch size × base LR。配置中的 base_learning_rate 不等同于论文 Table 15 的报告 LR,也不能脱离启动参数推断实际 LR。
实现边界
- blind SR 使用官方仓库中的 BSRGAN degradation 代码;论文只说明调整原始参数,完整随机分布依赖代码版本。
- 分类发布目录同时存在 VQ-f4 与 VQ-f8 配置;模型结构随 checkpoint 改变,不能汇总成单一 ImageNet 架构。
- README 后加入 retrieval-augmented diffusion 与 CLIP retrieval 内容,属于后续项目扩展,未纳入本文方法与实验结论。
- 官方项目页仍展示早期版本部分图注与数值,例如 Churches 4.48、CelebA 5.15;v2 Table 1 数值为 4.02 与 5.11。
Reviewer Commentary
贡献成立的地方
- 把生成计算从像素域移入温和压缩 latent,同时保留卷积二维归纳偏置,设计简单并具有广泛复用价值。
- Table 6 直接比较 pixel 与 latent 修复,在相近模型规模下给出训练、采样、时间和 FID,多维证据支持效率主张。
- cross-attention 把文本、布局和类别纳入同一框架;拼接条件覆盖 SR、修复和语义图,任务跨度充足。
- 附录公开 autoencoder zoo、全任务配置、评测 splits、算力换算和早期版本变更,复现信息在当时较完整。
证据仍有缺口
- 压缩率分析固定训练 steps 与单 A100,但各模型 batch、LR、空间计算量和 wall time 不同;“same computational budget”只能近似成立。
- 文本模型量化结果仍略落后 Make-A-Scene 与 GLIDE 的 FID,比较还包含自报 baseline 与不同参数、采样策略。
- 用户研究缺少参与人数、置信区间和招募信息,统计可靠性无法复核。
- 高分辨率卷积采样没有全局结构保证;无条件与文本条件尤其容易出现重复或空间失真。
- Table 13/14 的 LDM-32 z-shape 排版错误,Table 15 与正文的 semantic \(f\) 也存在冲突。
可以继续研究的问题
- 让第一阶段压缩率随图像区域或频率自适应,并用生成误差反向选择 latent 容量。
- 为大图采样加入低频全局 latent、分块一致性约束或多尺度 denoiser,减少 convolutional tiling 的结构漂移。
- 统一 conditioner 的 token、空间图与图像条件,研究条件冲突时的动态 cross-attention 路由。
- 用执行期质量估计器选择 CFG 强度与采样步数,显式优化 fidelity–recall–latency 三者关系。
复现时需要锁定
- arXiv v2、具体 autoencoder、latent scale 规则、checkpoint 与采样器。
- FID reference split:无条件训练集、COCO-val 30k、SR 同时报 val/train features。
- CFG scale、DDIM steps 与 \(\eta\);这些参数可大幅改变 FID 与 recall。
- 学习率口径与 trainer 的 scale_lr、GPU 数、batch 和 accumulation。
一手资料与版本说明
- arXiv 2112.10752v2,论文与 45 页附录,2022-04-13。
- CVPR 2022 正式论文页,页码 10684–10695。
- Ommer Lab 官方项目页,作者、CVPR oral、论文 Figure 与项目说明。
- CompVis 官方代码固定提交,配置与实现审计基准。
- LAION-400M,v2 文本条件模型的训练数据说明。
- Classifier-Free Diffusion Guidance,论文采用的无分类器引导来源。
Figure 1–4、10、15 使用 Ommer Lab 官方项目页的直接图片。项目页沿用较早论文排版,部分 Figure 编号与 v2 PDF 有偏移;正文表格与数值以 arXiv v2 / CVPR 版本为准。