论文身份与研究缺口
10.1109/TPAMI.2022.3201904 发布;部分作者稿按 online publication 写作 2022。输入是源人物视频 (S={S_i}) 与目标人物视频 (T={T_j})。输出视频要让目标人物执行源人物动作,同时保留目标身体形状、服饰和背景。二维关键点对深度次序、自遮挡和身体表面对应描述不足;已有 3D warping 方法又偏向跨人物通用模型,特定人物的细节质量有限。
二维姿态缺少表面结构
手臂交叉、侧身和弯曲手指时,二维骨架无法提供稳定的表面位置与遮挡关系。
逐帧生成容易模糊
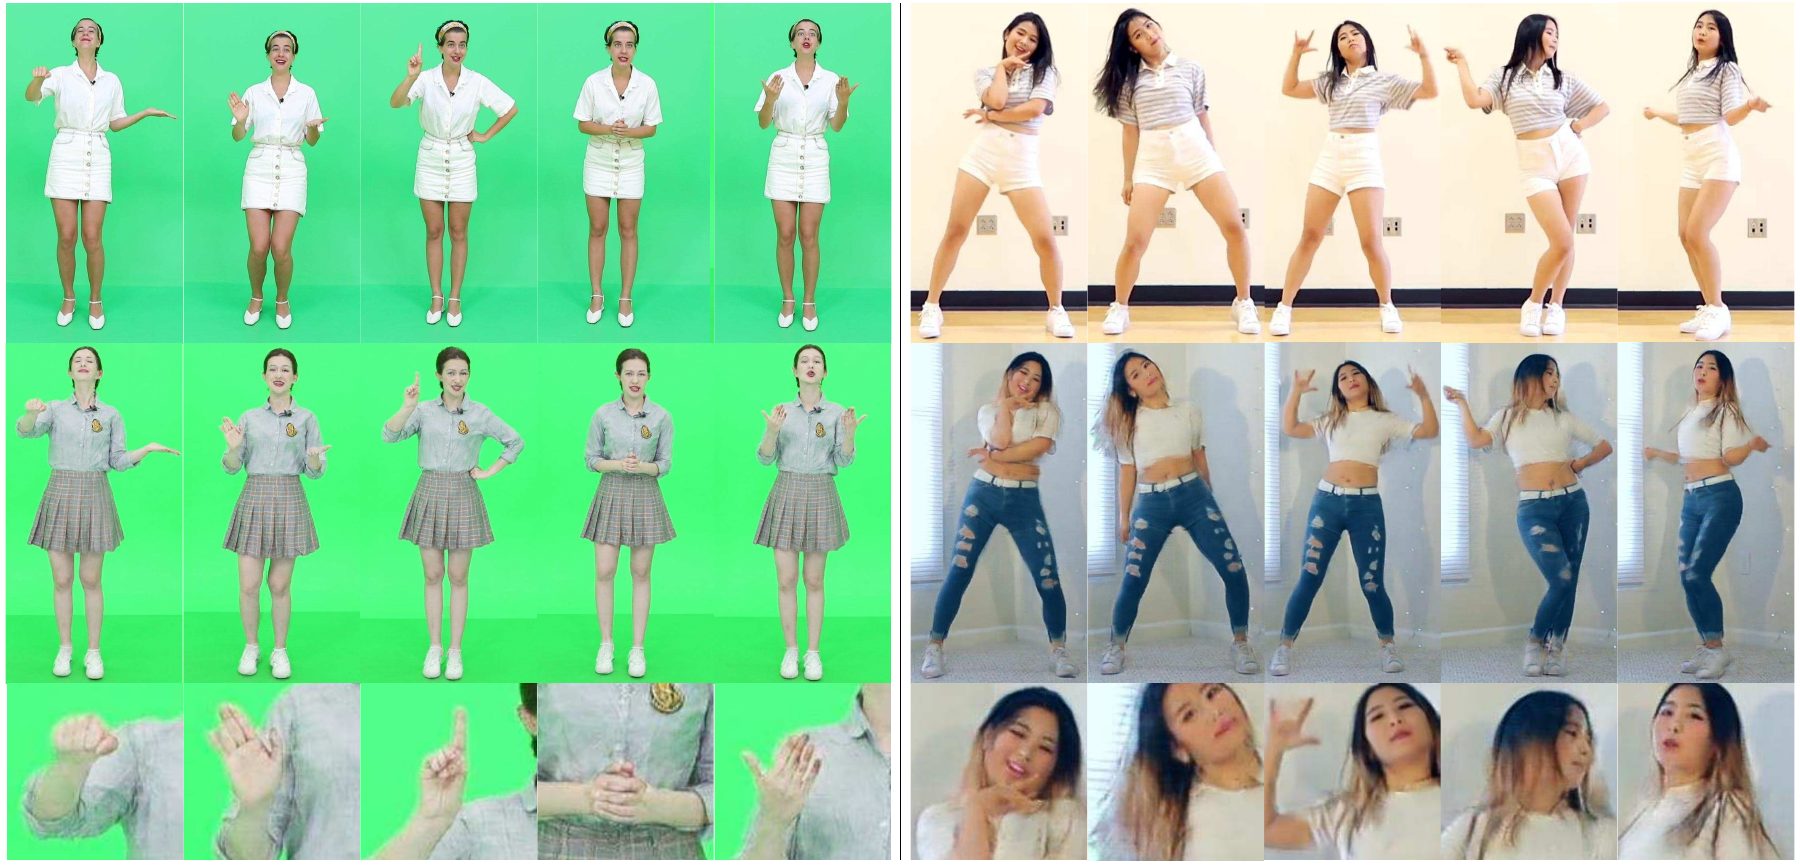
目标训练集未见过的姿态使脸部和手部产生模糊,单靠目标域纹理不足以恢复细节。
源帧细节可以复用
源与目标的脸和手具有局部结构相似性,经几何对齐和域转换后可为目标结果补充清晰信息。
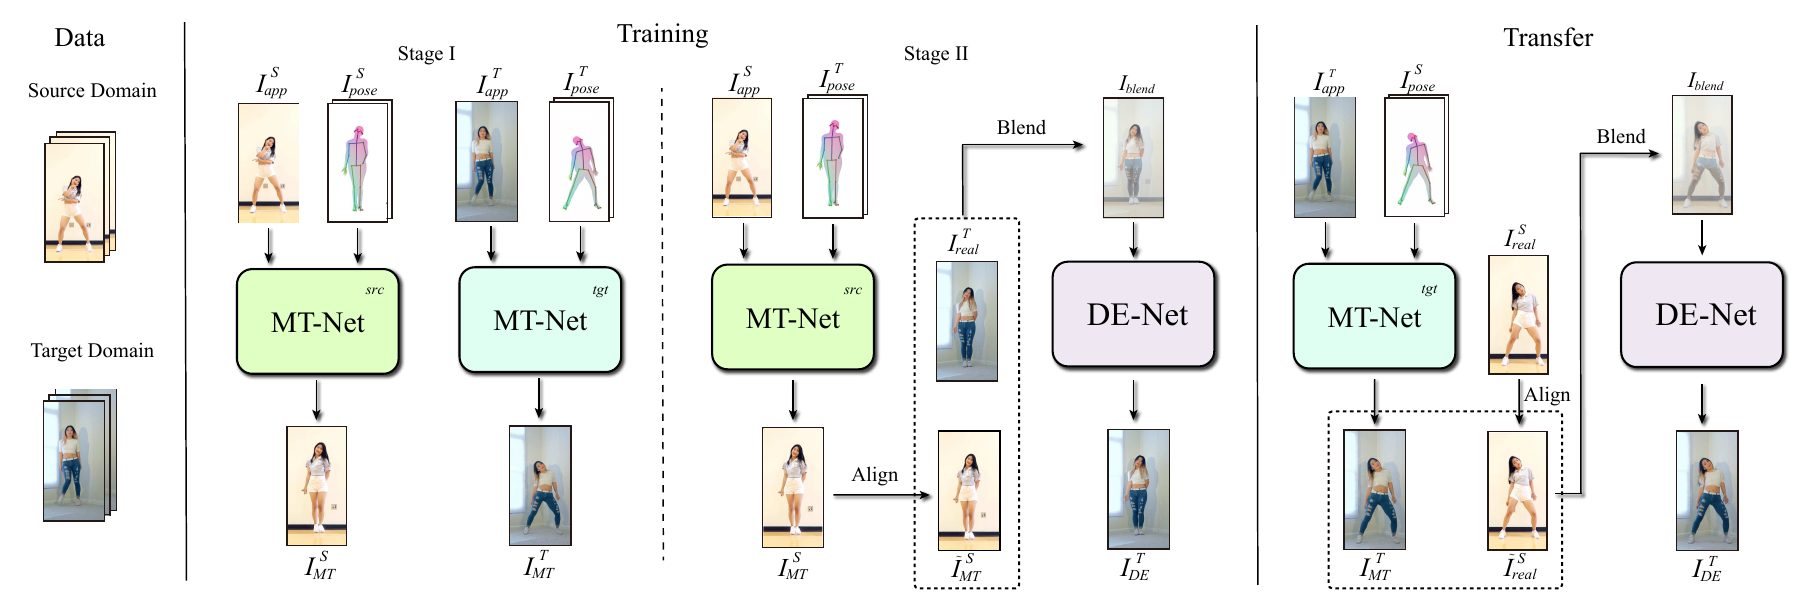
完整方法流程
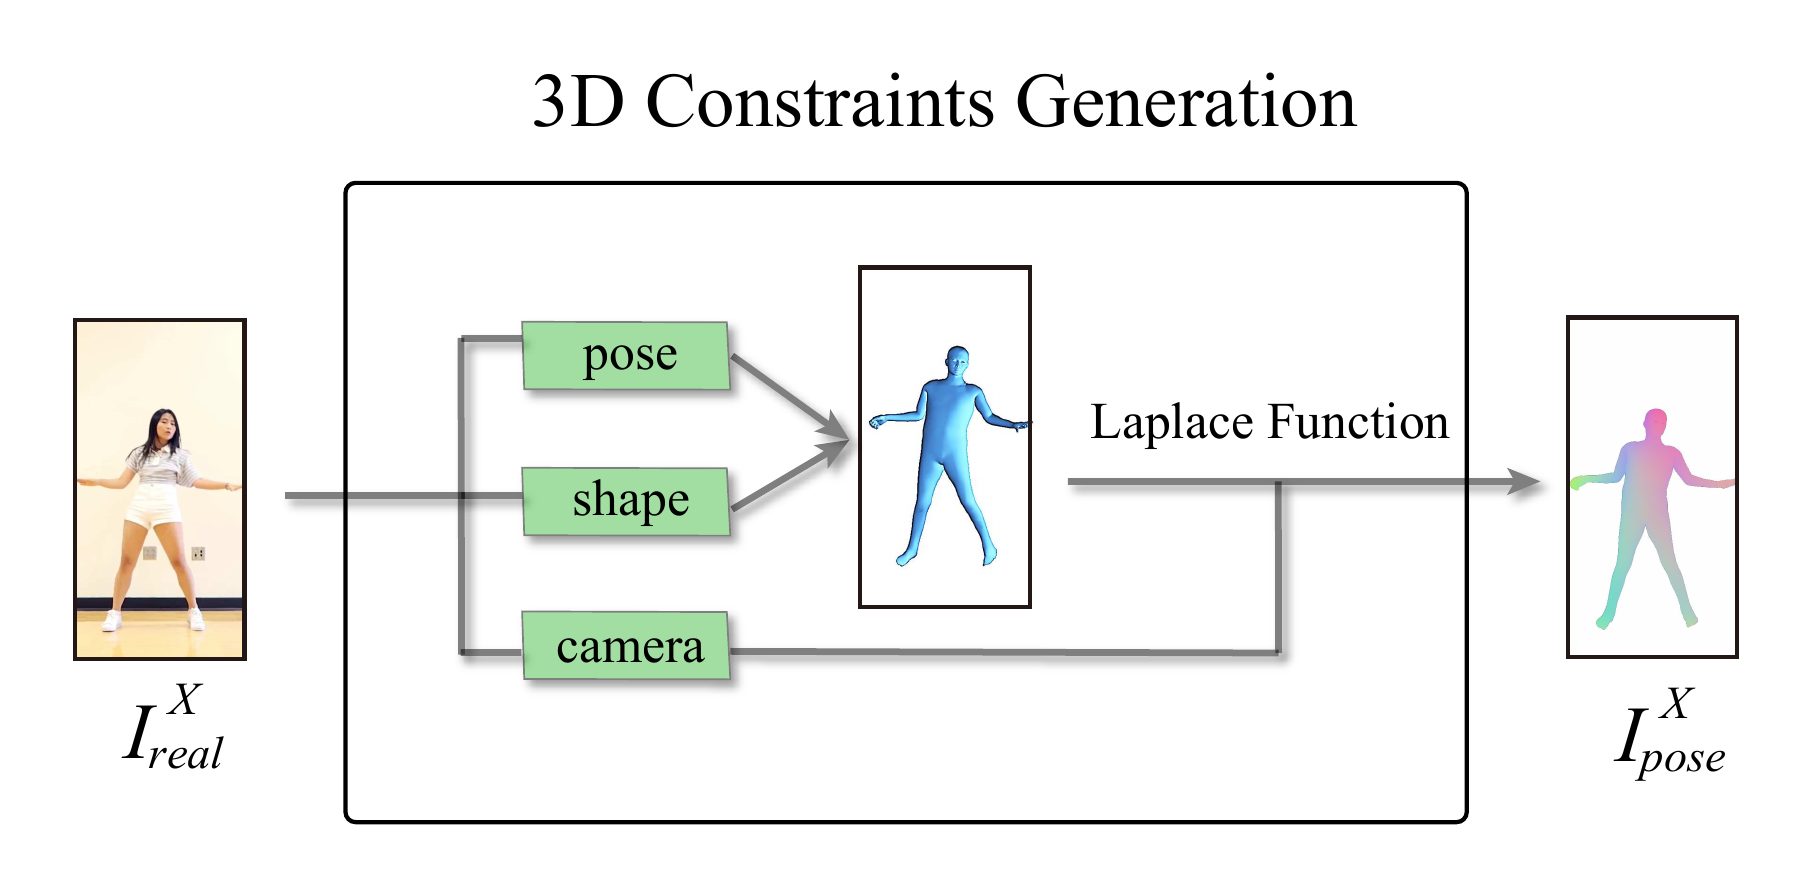
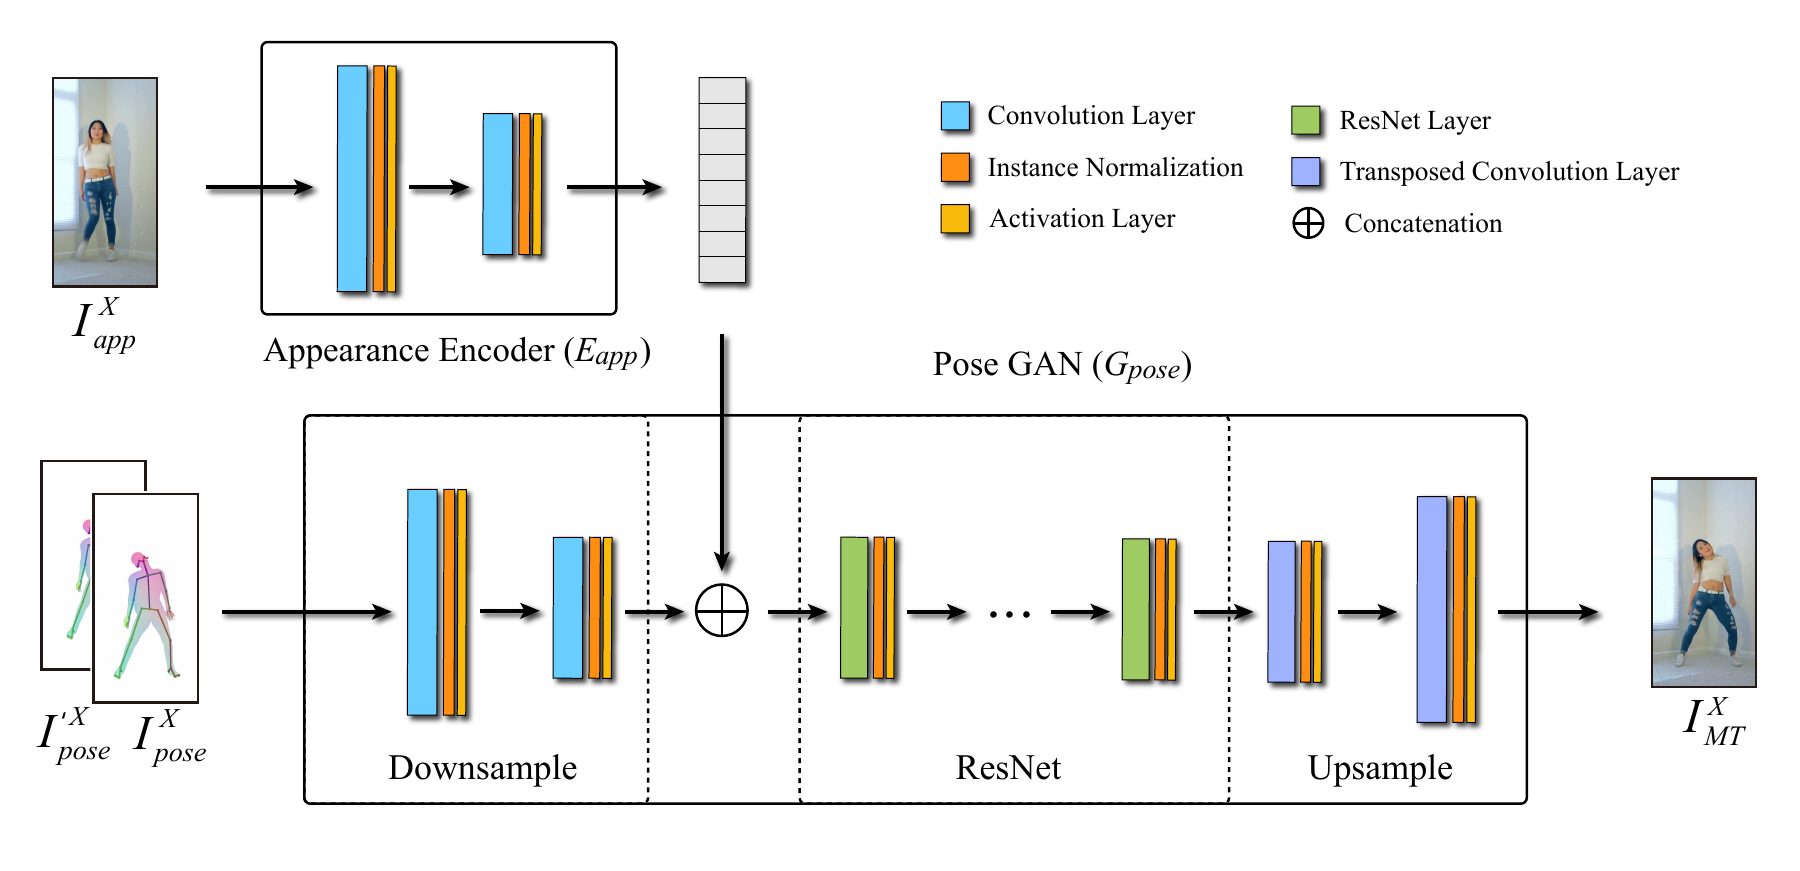
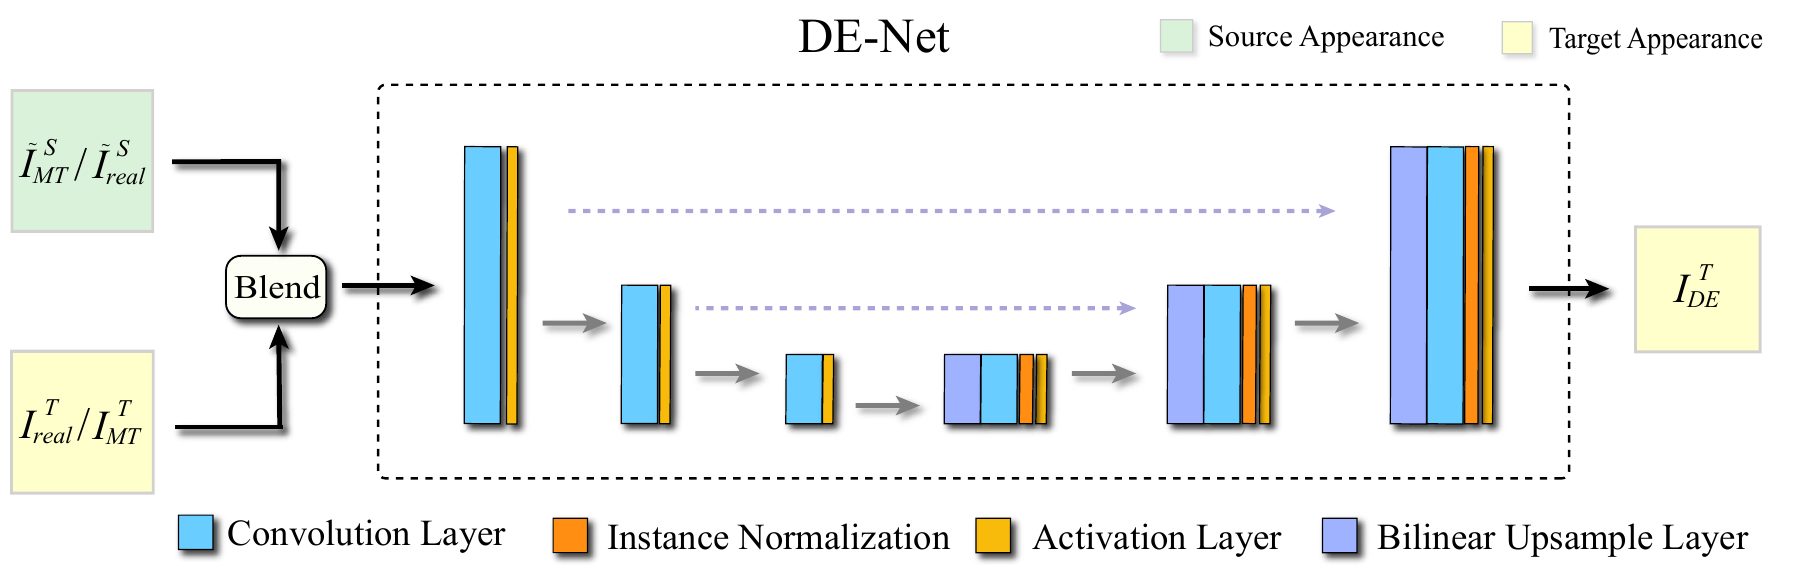
表示、条件与优化目标
符号
Laplace 特征投影
论文取重建网格 Laplace 矩阵最小的三个非平凡特征向量作为每个顶点的 RGB。以离散广义特征问题表示:
\(L\) 是离散 Laplace-Beltrami 算子,\(M\) 是质量矩阵。忽略常数特征向量后,\((\phi_1(v),\phi_2(v),\phi_3(v))\) 为顶点 \(v\) 提供连续的内在坐标,再随网格投影到图像。论文没有给出求解器、归一化方式与跨人物特征符号对齐细节。
MT-Net 对抗学习
判别器看到当前与上一帧条件以及真实或生成图像;生成器同时受 VGG-19 perceptual loss 与多尺度判别器 feature matching 约束:
对齐、混合与 DE-Net
波浪号表示利用源姿态与目标体形、相机参数计算的几何对齐。DE-Net 的总目标包含对抗、VGG perceptual、feature matching 与混合系数正则:
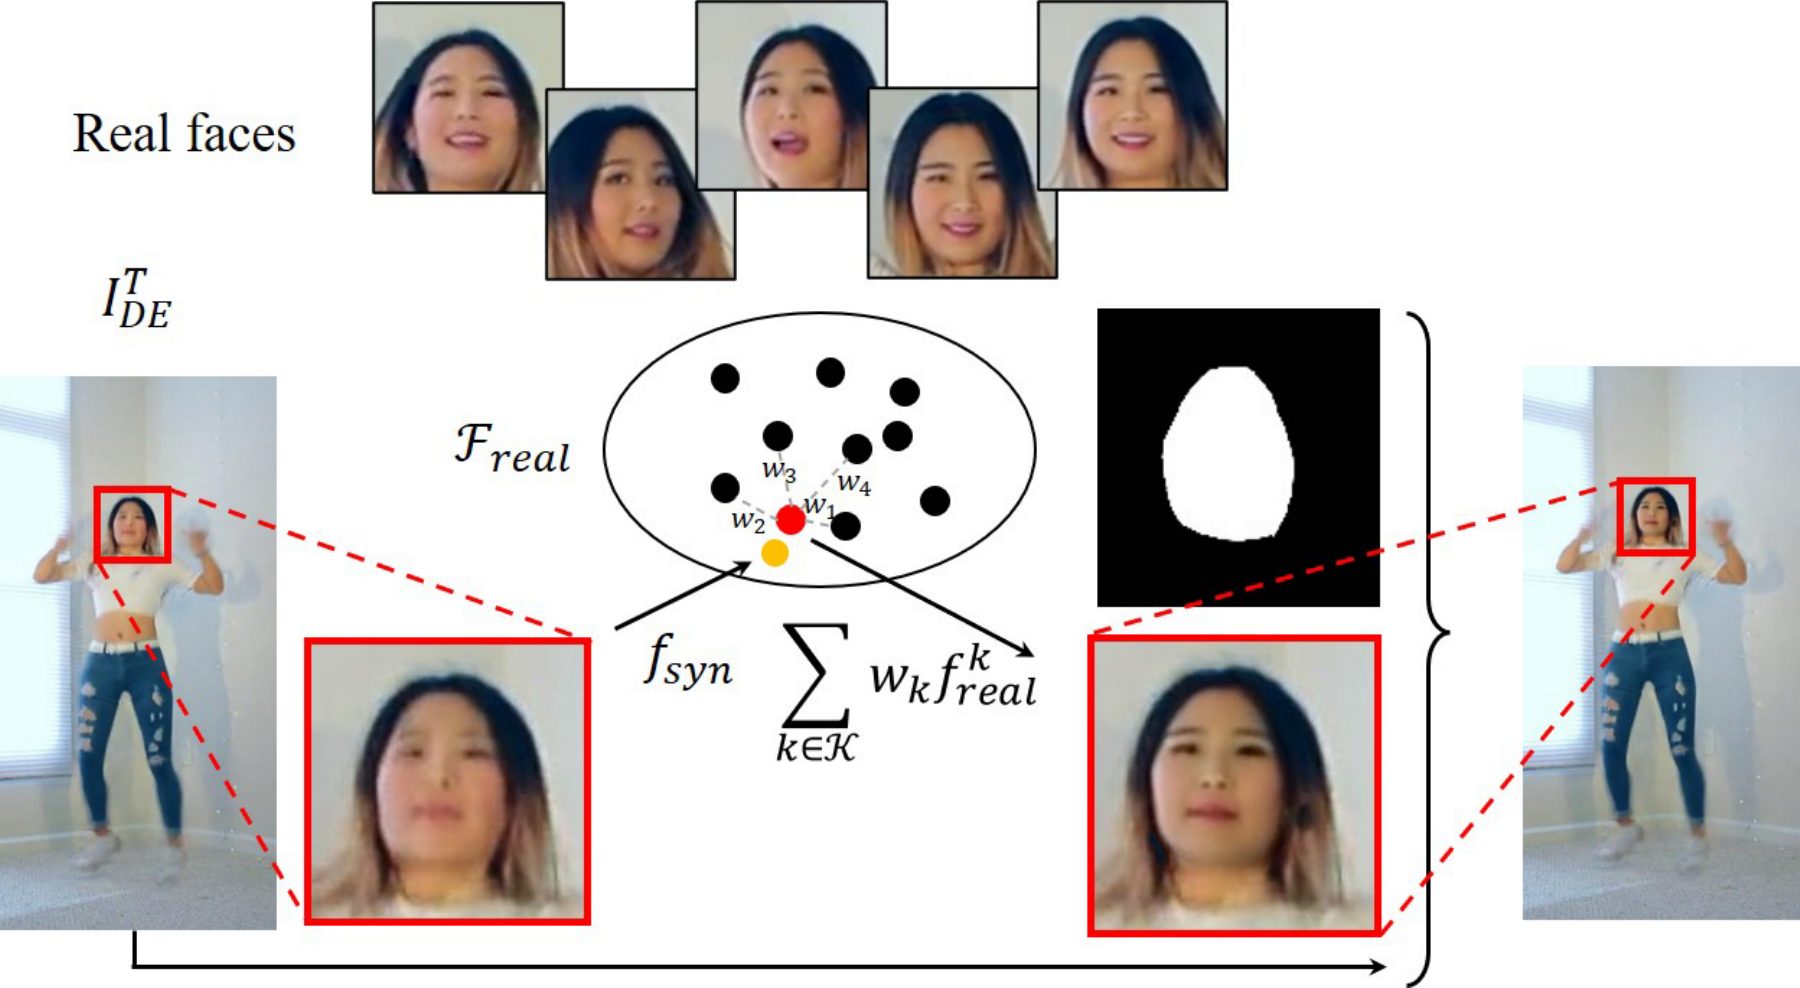
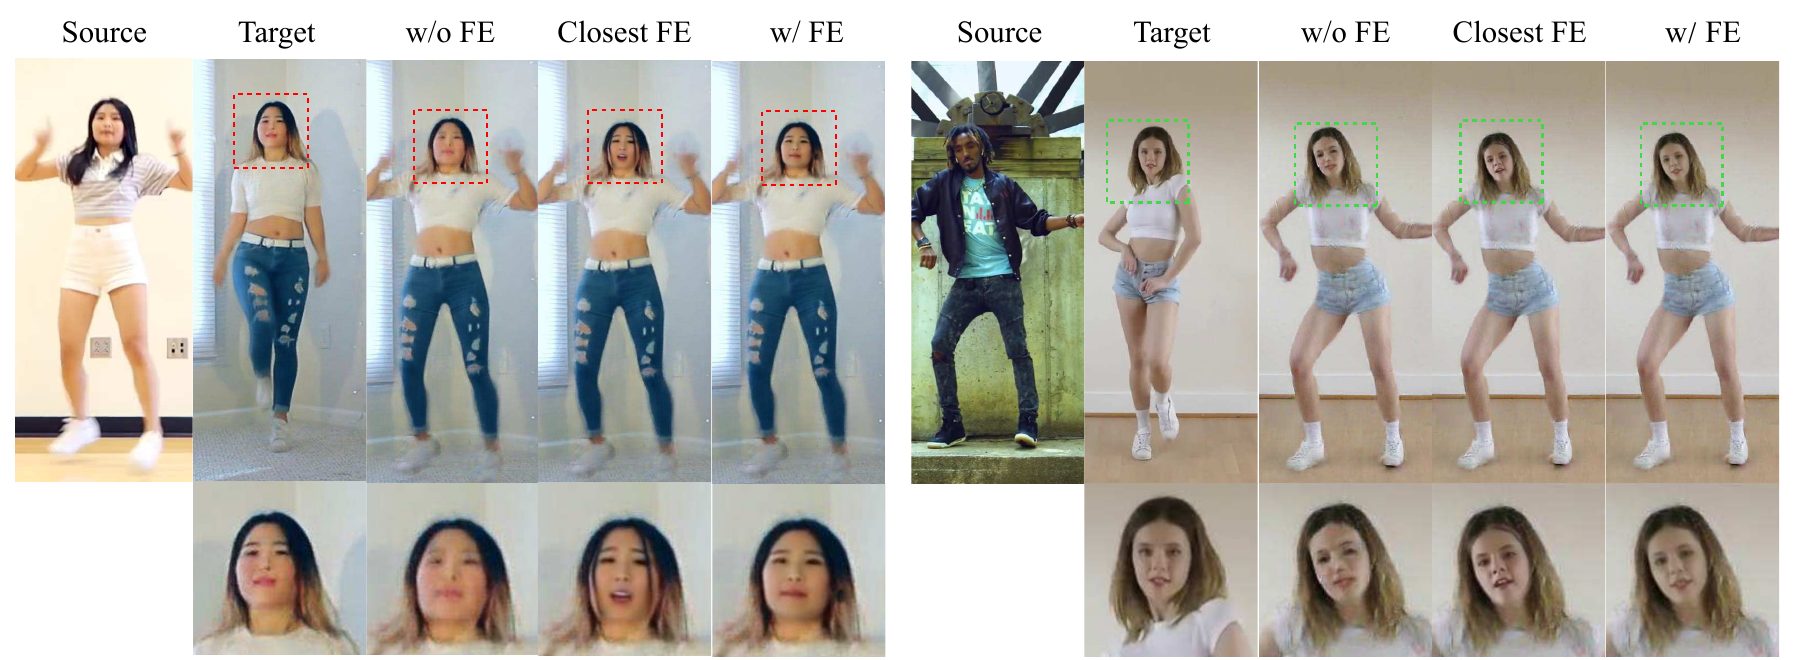
StyleGAN3 局部线性面部增强
\(f_{\mathrm{syn}}\) 是合成脸 latent,\(\mathcal{K}\) 是真实目标脸库中欧氏距离最近的 K 个 latent。论文没有公开 K、e4e/StyleGAN3 checkpoint、crop 规则或 mask 网络训练信息。
数据、训练与推理复现清单
| 项目 | 论文给出的信息 | 缺失或边界 |
|---|---|---|
| 数据来源 | Everybody Dance Now 数据、若干 YouTube/Bilibili 单人视频、5 段自摄视频 | 未给出视频清单、总帧数和下载链接 |
| 自摄视频 | 2 段普通背景、3 段绿幕;受试者同意用于实验 | 未给出人物数、帧率与时长 |
| 动作 | 自由舞蹈、拉伸等;删去首尾无动作片段 | 未给出动作类别分布 |
| 图像预处理 | 缩放和平移,裁切归一为 1024×512 | 未给出人体框检测与裁切参数 |
| 姿态条件 | Monocular Total Capture + 时间顶点平滑 + OpenPose | 平滑窗口、Laplace 求解与特征归一化缺失 |
| MT-Net | 20 epochs;Adam;learning rate 0.0001 | 论文未给 beta、batch size、GPU、训练时间 |
| DE-Net | 冻结 MT-Net,单独训练 10 epochs | 公开代码默认调度不同 |
| 损失权重 | \(\lambda_{\mathrm{FM}}=10,\lambda_P=5,\lambda_{\mathrm{reg}}=10\) | 论文未给早停与随机种子 |
| 时间条件 | 当前帧与上一帧标签 | 仅两帧条件,长期稳定性依赖间接约束 |
| 推理 | MT-Net 粗生成 → 对齐源帧混合 → DE-Net → 可选面部增强 | 没有报告速度、显存和单对人物训练成本 |
主结果与完整消融
Table 1:与三种方法比较
| 场景 | 指标 | vid2vid | Chan et al. | LW-GAN | Ours |
|---|---|---|---|---|---|
| Self-transfer | SSIM ↑ | 0.781 | 0.836 | 0.790 | 0.891 |
| Self-transfer | LPIPS ↓ | 0.096 | 0.067 | 0.106 | 0.039 |
| Cross-transfer | IS-ReID ↑ | 3.568 | 3.794 | 3.274 | 4.015 |
| Cross-transfer | FID ↓ | 59.98 | 57.02 | 81.20 | 51.26 |
Self-transfer 使用每个 subject 的 8:2 train/validation split。Cross-transfer 无成对 ground truth,FID 在原始目标图像与生成目标图像间计算;IS-ReID 使用在 Market-1501 上微调的 Inception。绿幕数据被排除在量化评估之外。
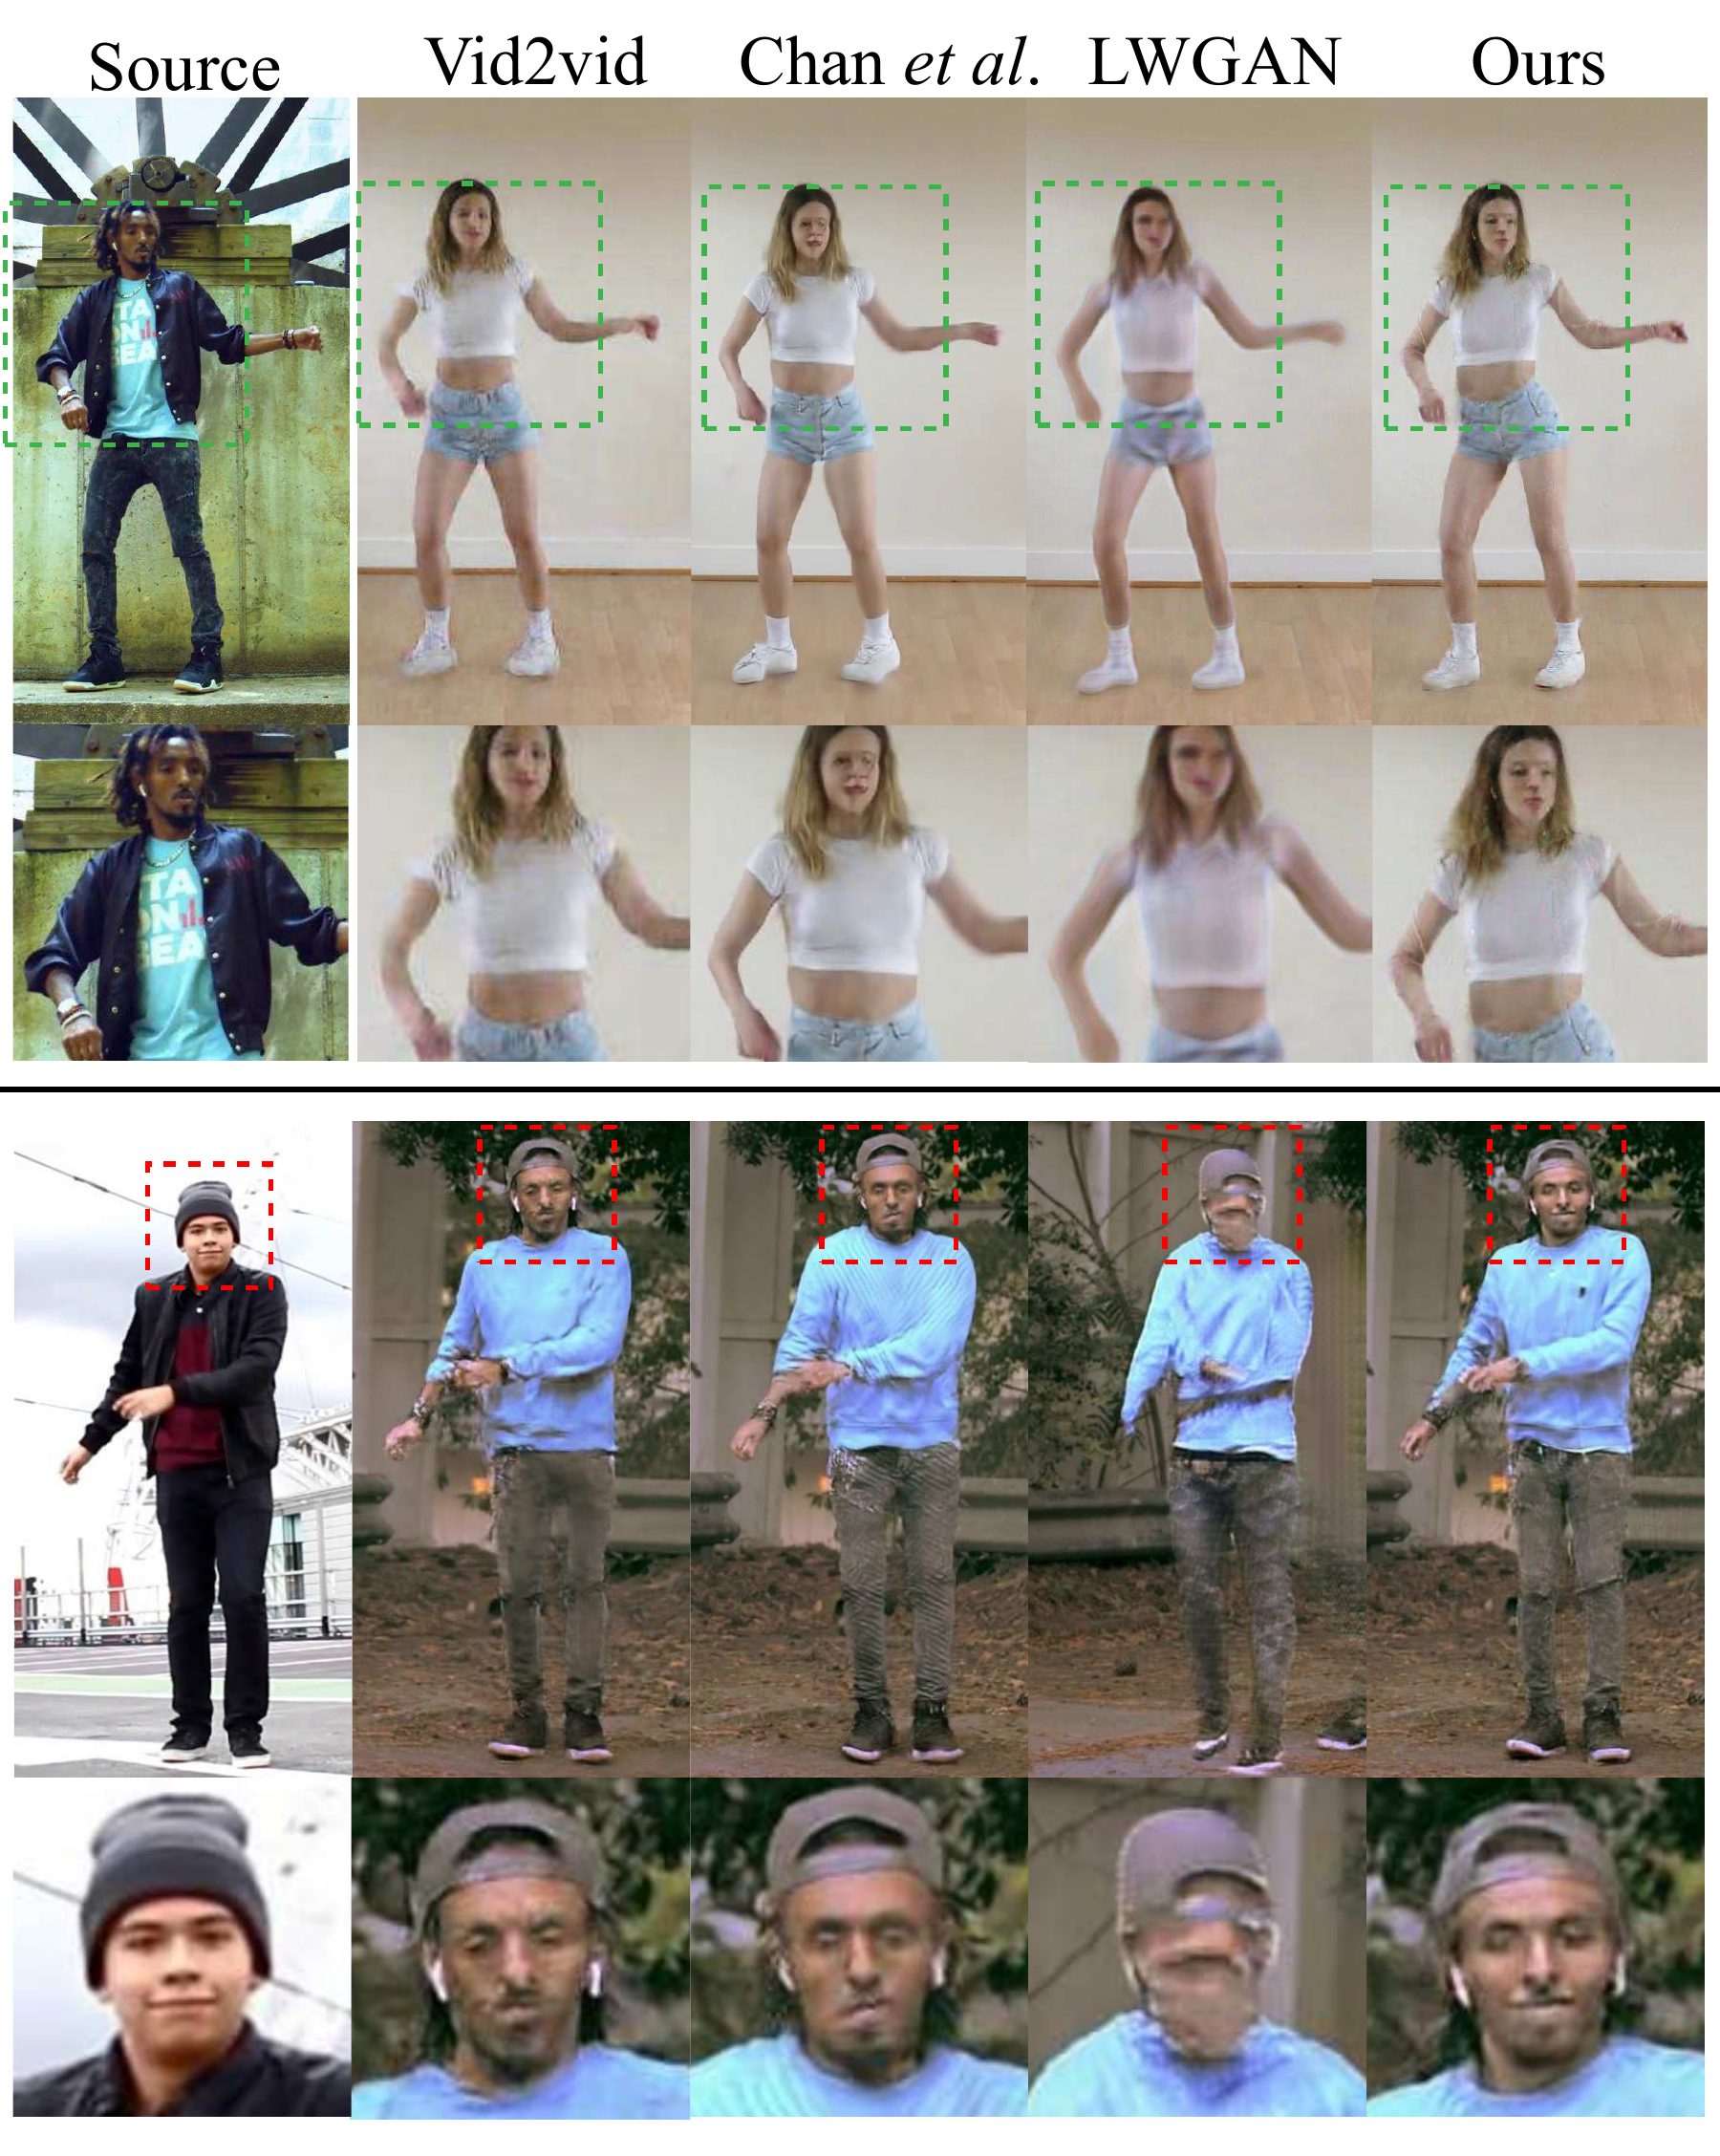
Table 2:六种组件配置
| 指标 | MT(2D) | MT(3D) | MT(2D+3D) | MT(2D)+DE | Full (ave) | Full |
|---|---|---|---|---|---|---|
| SSIM ↑ | 0.828 | 0.831 | 0.856 | 0.877 | 0.887 | 0.891 |
| LPIPS ↓ | 0.064 | 0.063 | 0.058 | 0.043 | 0.041 | 0.039 |
| IS-ReID ↑ | 3.523 | 3.632 | 3.731 | 3.587 | 3.954 | 4.015 |
| FID ↓ | 58.62 | 56.68 | 55.77 | 57.56 | 53.76 | 51.26 |
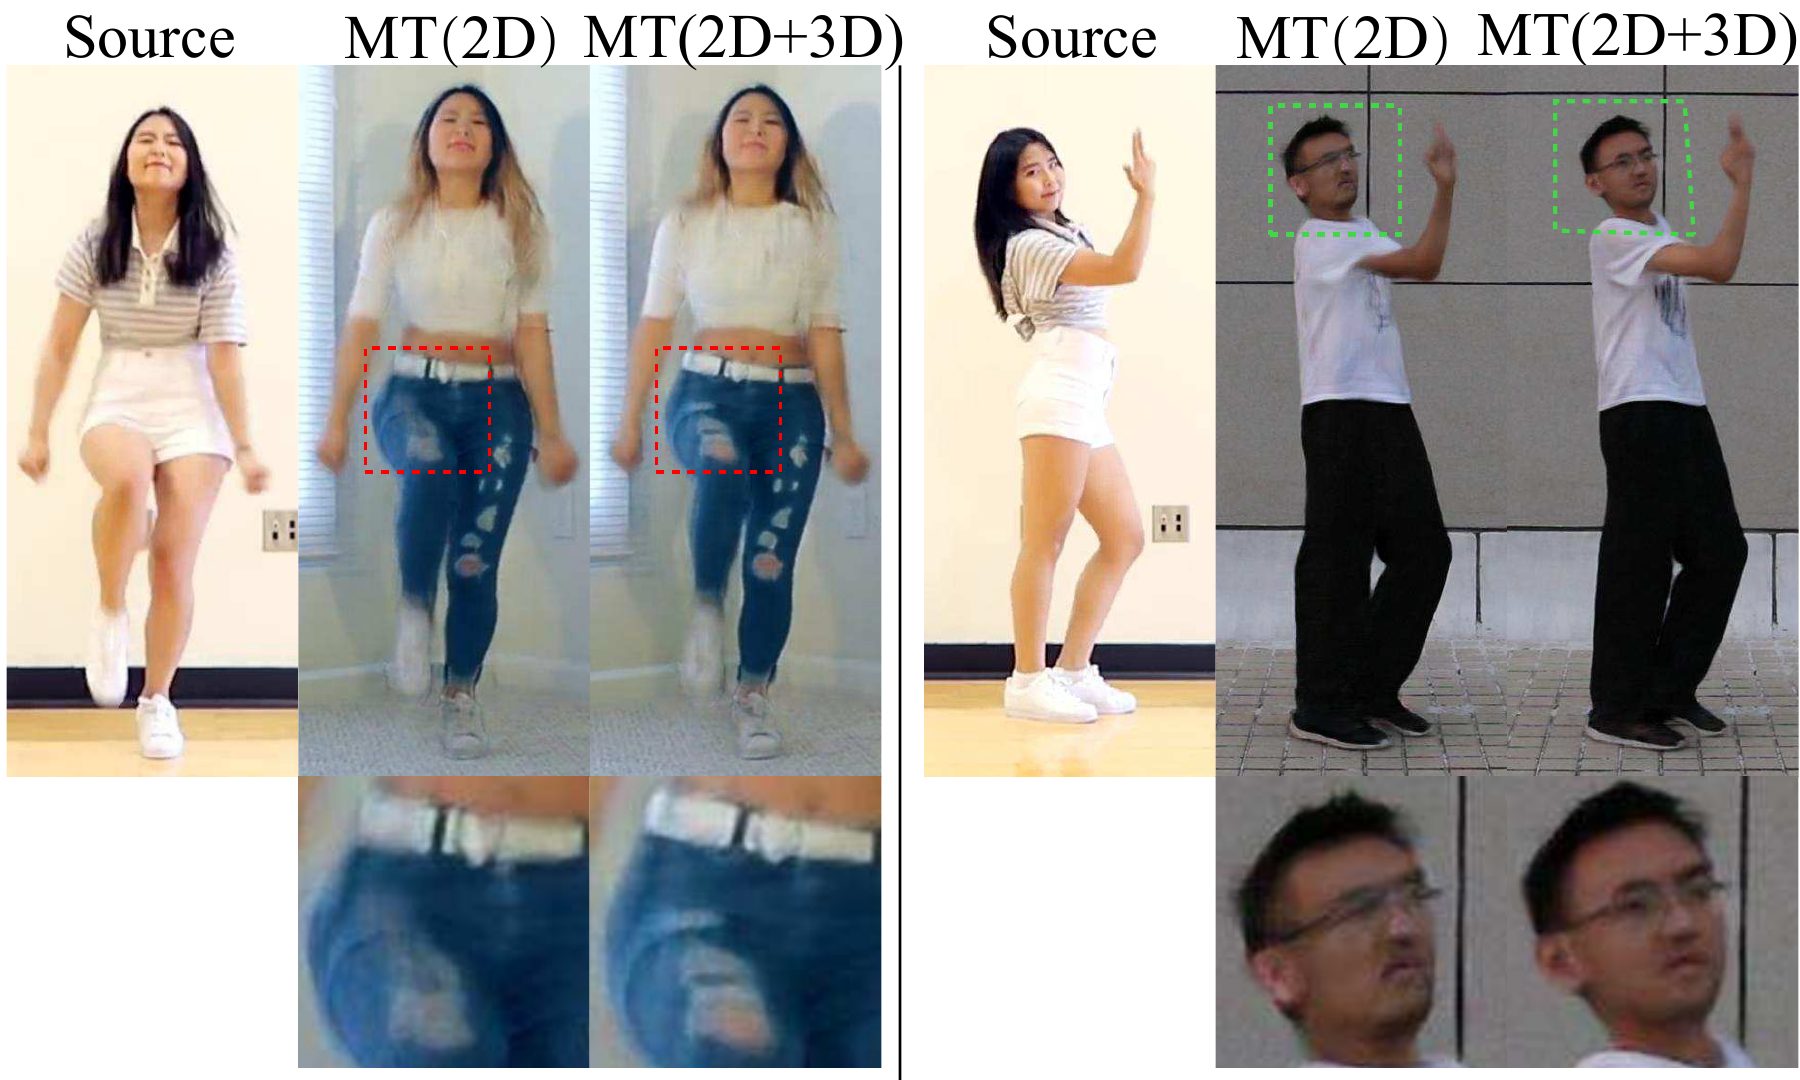
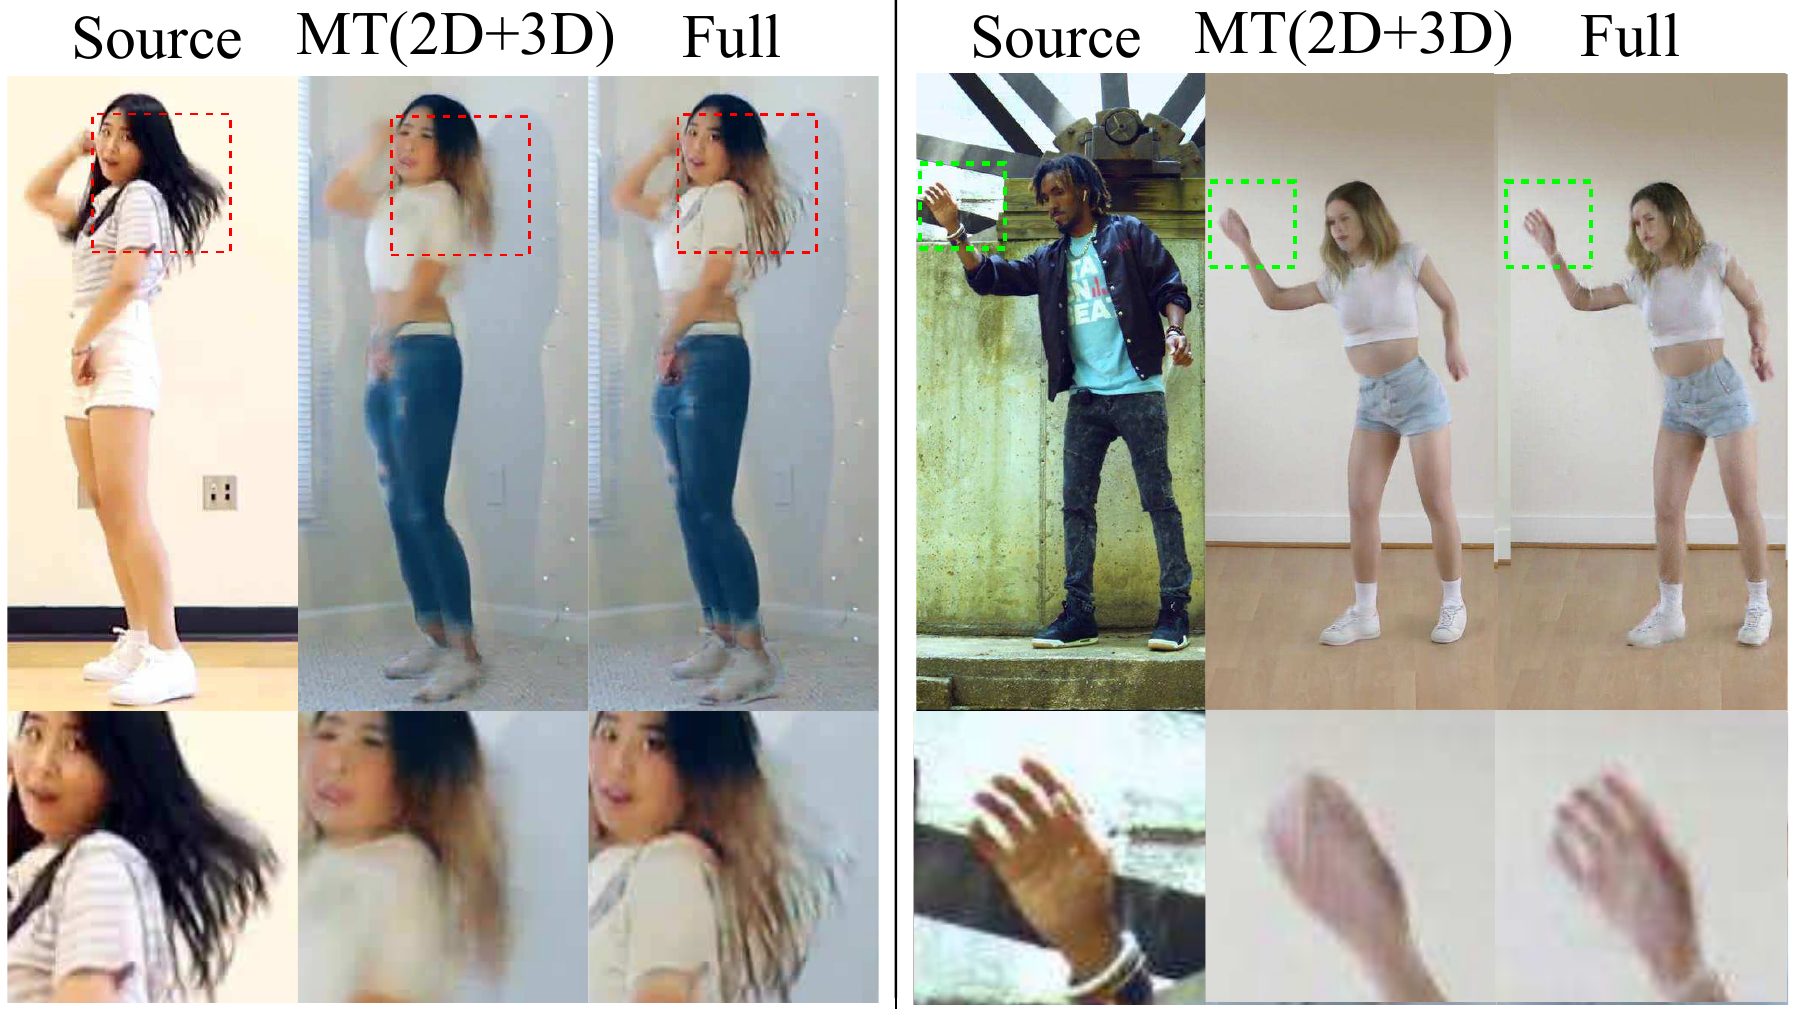
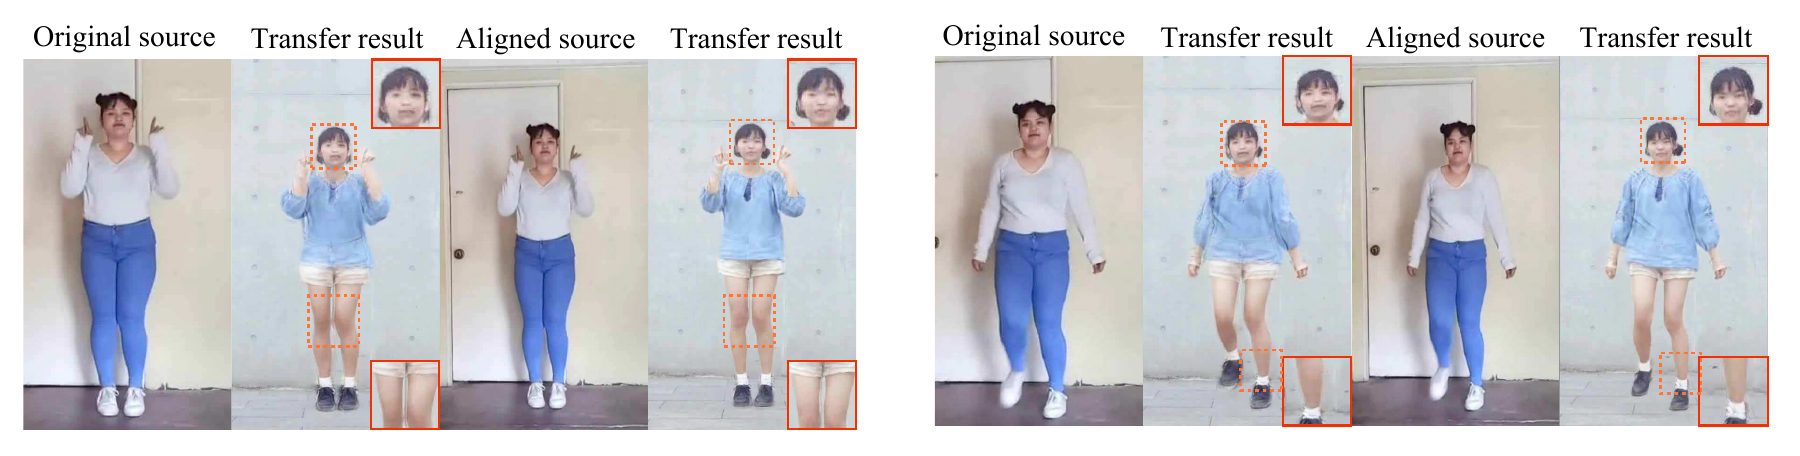
Table 3:50 人用户研究
| 问题 | vid2vid | Chan et al. | LW-GAN | Ours |
|---|---|---|---|---|
| 细节与清晰度 | 22.2% | 16.7% | 7.07% | 54.0% |
| 时间稳定性 | 24.7% | 15.1% | 9.60% | 50.5% |
| 整体观感 | 26.3% | 17.7% | 8.08% | 48.0% |
每位参与者在无限时长条件下,从四种方法中选择三个问题的最佳视频。论文没有报告参与者背景、视频对数量、呈现随机化、置信区间或统计检验。
Table 4:三维标签表示
| 指标 | LW-GAN UV 标签 | Laplacian 标签 |
|---|---|---|
| IS-ReID ↑ | 3.612 | 4.015 |
| FID ↓ | 58.42 | 51.26 |
论文还将 Laplacian 特征与 depth 条件作定性比较,指出 UV 在手腕与手部接缝处会出现不连续颜色。Table 4 只量化了 UV 对照,没有给 depth 数值。
Paper vs. Implementation
官方 GitHub 仓库 IGLICT/MT_DE-Jittor 的核查基于 commit 315886d9b78d9ada9b6ba3471745197a43dc66c4。仓库可帮助理解网络与数据接口,当前状态不能直接复现论文完整流程。
| 项目 | 论文 | 公开 Jittor 代码 | 影响 |
|---|---|---|---|
| 输入分辨率 | 1024×512 | run.sh 训练设 loadSize/fineSize=512;test.sh 设 256 | 测试与论文分辨率不一致 |
| 训练入口 | 20 epoch MT + 10 epoch DE | run.sh 固定 do_test=1,默认不会进入训练分支 | README 命令不能直接训练 |
| 阶段调度 | 先 MT,固定 MT 后单训 DE | train.py 第 1 epoch 为 stage 1,第 2 epoch 起 stage 2;默认总计 40 epochs | 公开默认调度与论文不同 |
| 冻结 MT-Net | DE 阶段固定 MT-Net | stage 2 仍执行 optimizer_G_trg 与两个判别器更新 | 优化对象与论文陈述不同 |
| Adam | 仅报告 lr=0.0001 | \(\beta_1=0.5,\beta_2=0.999\),batch size=1 | 代码补充了部分参数 |
| 损失 | log-GAN 公式 | no_lsgan 默认 false,实际用 LSGAN | 数学目标与实现不同 |
| 混合正则 | \(\lambda_{\mathrm{reg}}=10\) | 代码乘以 100 | 权重不一致 |
| 外观帧 | 随机选择并固定 | 数据类最终使用 self.src_img_paths[0] 与目标首帧 | 随机逻辑残留,但被首帧覆盖 |
| 对齐变换 | 基于重建网格形状、姿态、相机 | 仓库要求预处理目录,没有发布重建、平滑和对齐脚本 | 最关键几何步骤不可复现 |
| 面部增强 | e4e + StyleGAN3 + KNN/LLE + mask | 仓库没有 e4e、StyleGAN3、face crop、K 或 mask 实现 | v4 最终质量模块缺失 |
| 数据与 checkpoint | 多来源舞蹈视频 | 没有论文数据清单、预训练权重或可运行示例 | 无法核对论文数值 |
| 可移植性 | 未讨论 | 脚本硬编码作者本地 /home 与 /mnt/b 路径 | 需要手工修改 |
num_of_frame=2;生成器滤波器基数 32、判别器基数 32、6 个 ResNet blocks、instance normalization;公开脚本使用单 GPU、batch size 1、无翻转。Reviewer Commentary
把三维结构转成生成条件
Laplacian 特征把网格表面位置编码成连续三通道图,与二维骨架组合,形成可直接进入 pix2pixHD 风格生成器的条件。
DE-Net 有可监督训练构造
反方向迁移使目标域真实同姿态帧成为 ground truth,解决正向迁移缺少成对监督的问题。
主表和组件消融完整
同一组四项指标覆盖 self/cross transfer,六种配置拆开二维、三维、DE 与混合策略。
每个人物单独训练
模型无法泛化到新人物,训练成本和新人物适配速度没有报告,应用范围受到明显限制。
时间评估不充分
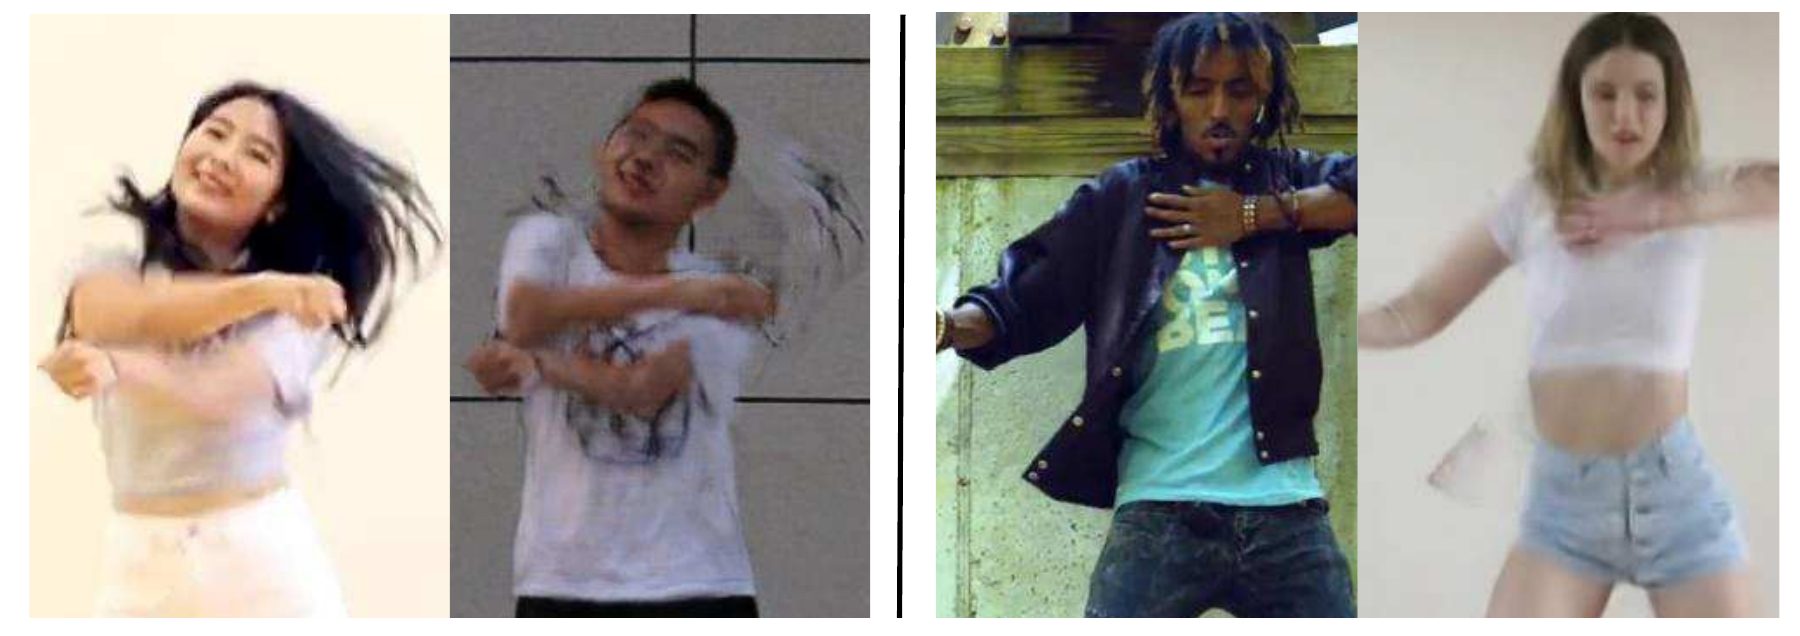
客观指标按单帧计算,时间稳定性主要依赖用户研究;长期漂移和快速遮挡缺少可重复指标。
公开实现与论文分离
关键预处理、对齐、数据、权重和面部增强缺失,训练调度与论文叙述也不同。
来源与证据边界
- arXiv:2003.13510v4:12 页完整正文、公式、Figure 1–16、Table 1–4;v4 日期 2023-05-08。
- PubMed PMID 36018870:正式出版年月 2023-04、45(4)、4682–4693、DOI。
- IEEE DOI:TPAMI 正式记录。
- 官方 Jittor 仓库:数据目录、训练脚本、模型与默认参数;核查 commit 见实现章节。
- 作者主页论文 PDF:作者团队提供的 TPAMI 作者稿。
- 本地 PDF:
Reading/Papers/2003.13510v4.pdf,12 页;没有附加的独立 supplementary PDF。正文多次引用 supplementary materials,但 arXiv v4 源包未包含所述训练细节或视频清单。
论文首页明确标记 Lin Gao 为通讯作者。第一作者 Yang-Tian Sun 的第一机构是 Chinese Academy of Sciences。