CVPR 2024 · pp. 4241–4251 · 14 页 arXiv 合订本

把二维图像
放进三维空间雕刻

Image Sculpting 先把单张图像中的对象重建成可变形三维网格,再用骨架、旋转、平移、布尔切割与场景组合执行定量编辑,最后让 SDXL 在深度与内部特征约束下恢复纹理和真实感。

Jiraphon YenphraphaiXichen PanSainan LiuDaniele PanozzoSaining XieNYU · Intel Labs

研究缺口:生成模型缺少可测量的空间控制

语言能够描述语义,却难以稳定执行“旋转 42°”“向镜头移动 4 米”或符合骨架约束的姿态编辑。二维拖拽方法也无法自然表示遮挡、离面旋转与三维透视。论文把三维网格当作交互控制面,把扩散模型当作外观修复器。

Control

三维空间承载编辑

旋转角、平移距离、骨骼关节和布尔体直接定义目标几何,编辑操作具有量纲和物理意义。

Appearance

单图个性化保留对象

one-shot DreamBooth 通过 LoRA 记住输入对象的纹理与身份,补回粗网格缺失的外观细节。

Geometry

深度与特征双重约束

从变形网格直接渲染深度;DDIM inversion 的粗图分支向增强分支注入 feature 与 self-attention。
Paper Verified。 论文演示六类编辑:姿态、旋转、平移、三维组合、雕刻与连续添加;核心实验评估的是粗到细增强模块,三维重建器和变形算法没有重新训练或系统比较。
Author Claim。 作者称结果具备 precise、quantifiable 与 physically plausible 属性。精确量来自三维控制操作;最终扩散增强是否逐像素保持目标几何,只通过 D-RMSE 和定性示例近似评估。
Image Sculpting 官方 teaser,展示六类编辑
Figure 1。 官方项目页原图;六类编辑由同一条“重建—几何操作—扩散增强”链路支持。

问题形式化与表示

输入

  • 原始 RGB 图像 \(I\) 与 SAM 得到的对象区域;
  • 用户编辑后的三维网格 \(G^{\ast}=(V^{\ast},F,U)\);
  • 粗渲染 \(I_c=R(G^{\ast},C,L)\) 与网格深度 \(D\);
  • inversion prompt \(y_{\mathrm{inv}}\) 和增强 prompt \(y\)。

输出

  • 保持目标对象纹理和编辑几何的图像 \(I_f\);
  • 原背景通过逐步 latent blend 保留;
  • 输出分辨率由 SDXL 管线决定,官方代码默认渲染与数据尺寸为 1024×1024。
\(I,I_c,I_f\)
输入图像、编辑网格的粗渲染、最终增强图像。
\(G=(V,F,U)\)
顶点、面与 UV 坐标组成的纹理网格;几何编辑改变 \(V\),UV 坐标 \(U\) 保持。
\(\boldsymbol{x}_t^c,\boldsymbol{x}_t^f\)
时间步 \(t\) 的粗渲染 inversion latent 与最终图像 latent。
\(\boldsymbol{f}_t^c,\boldsymbol{f}_t^f\)
残差块 feature maps,承载对象语义与较低层结构。
\(\boldsymbol{A}_t^c,\boldsymbol{A}_t^f\)
Transformer self-attention maps,论文用来传递布局与几何。
\(D\)
由变形三维模型直接渲染的对象深度;背景区域不提供深度。
\(\tau_f,\tau_A\)
feature 与 self-attention 注入停止阈值,分别取 0.2 与 0.5。

完整流程:几何先确定,生成模型再修复

对象分割。 SAM 从输入图像提取目标对象;官方复现说明还需要移除背景、重新居中并缩放。
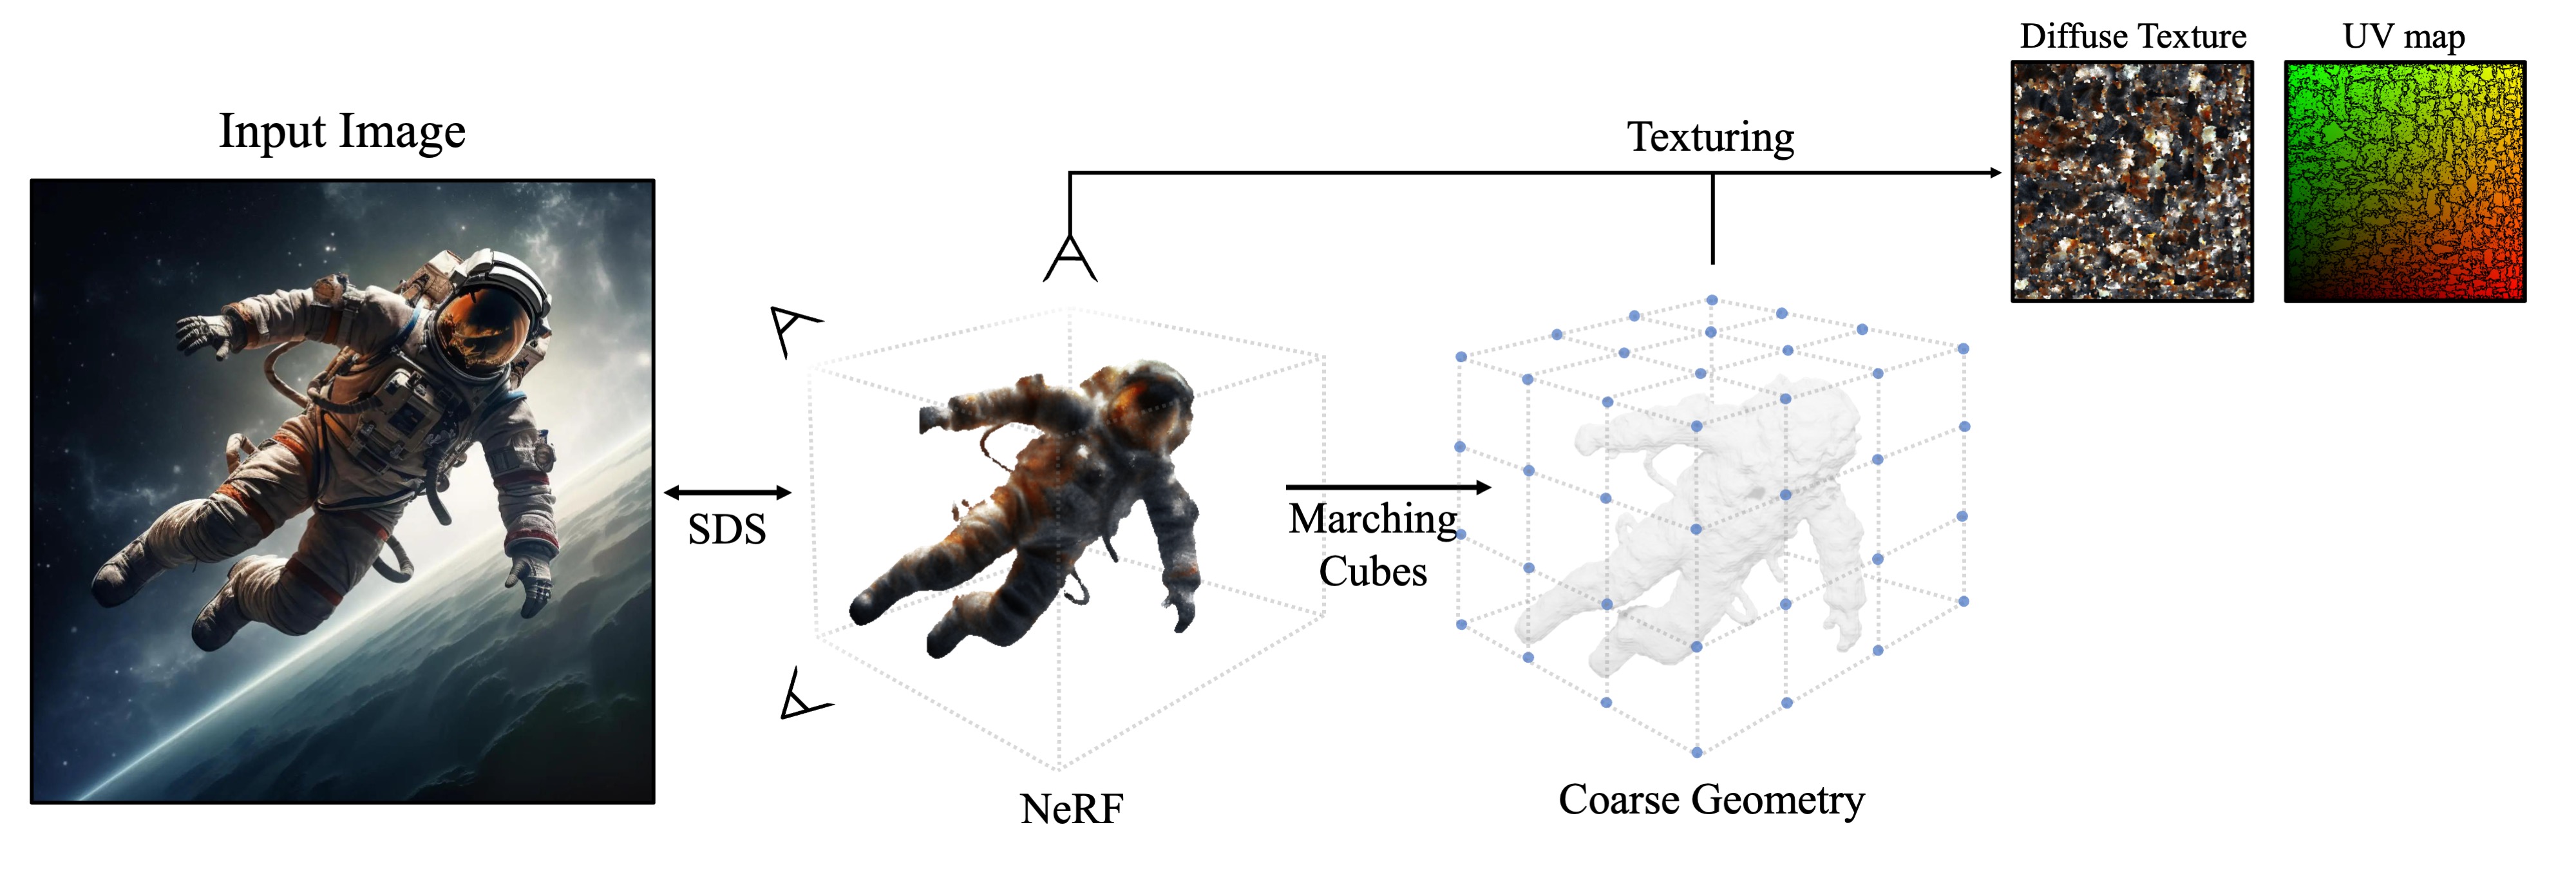
单图三维重建。 Zero-1-to-3 提供视角条件先验,以 SDS 优化 NeRF;使用 Instant-NGP 表示。
提取纹理网格。 密度转 SDF,Marching Cubes 提取等值面,xatlas 参数化 UV,差分渲染提取纹理。
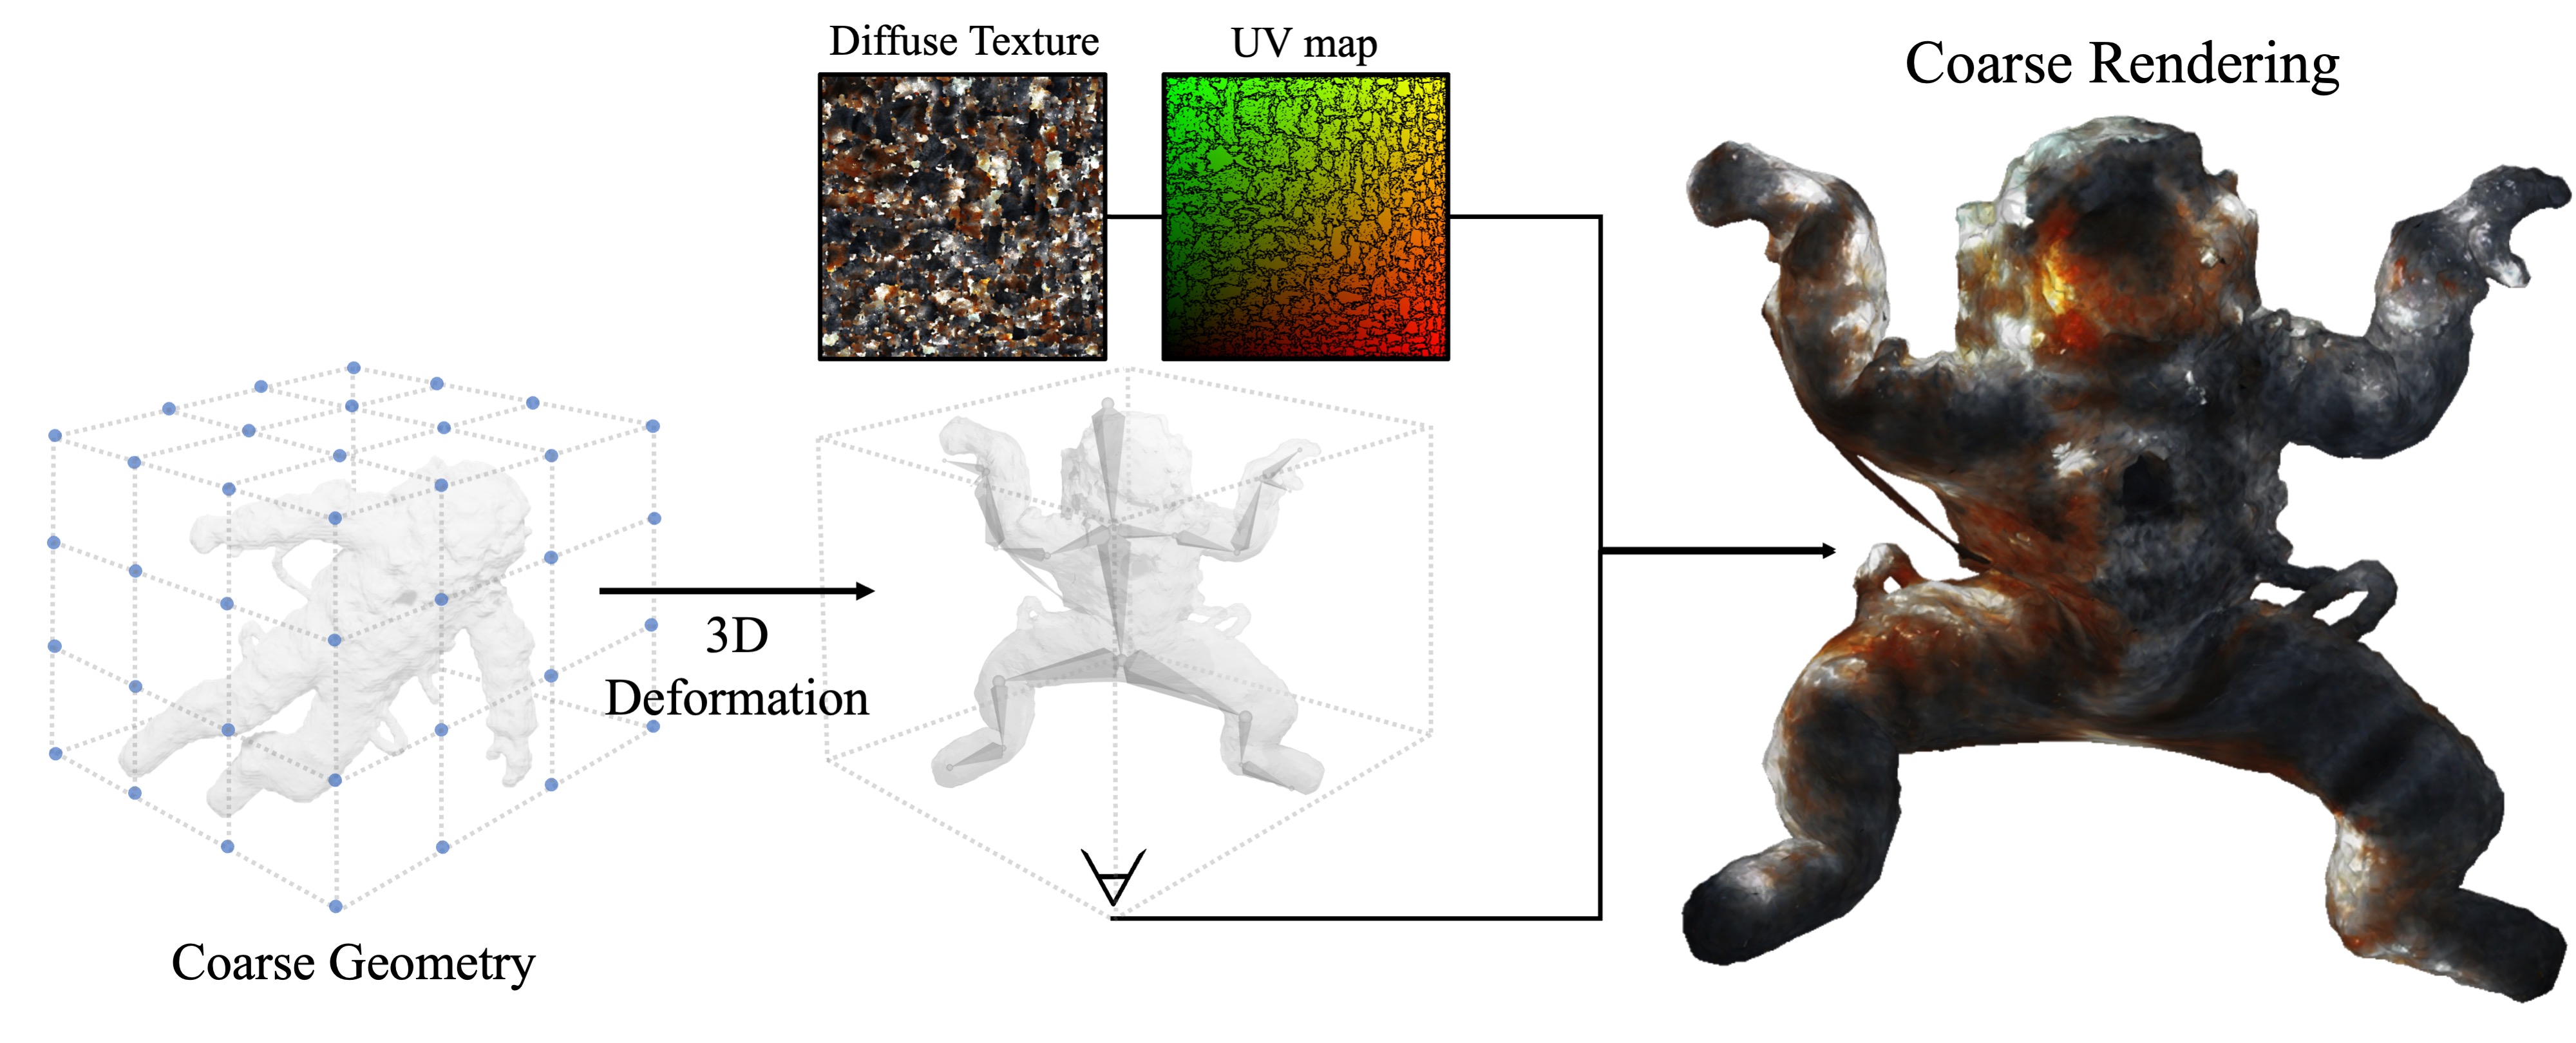
执行三维编辑。 用户建立骨架和 skinning weights,或直接旋转、平移、加入网格、连续加入多个网格、使用模具布尔切割。
生成粗渲染与深度。 变形后的网格从目标相机渲染 \(I_c\) 与 \(D\),显式确定几何和透视。
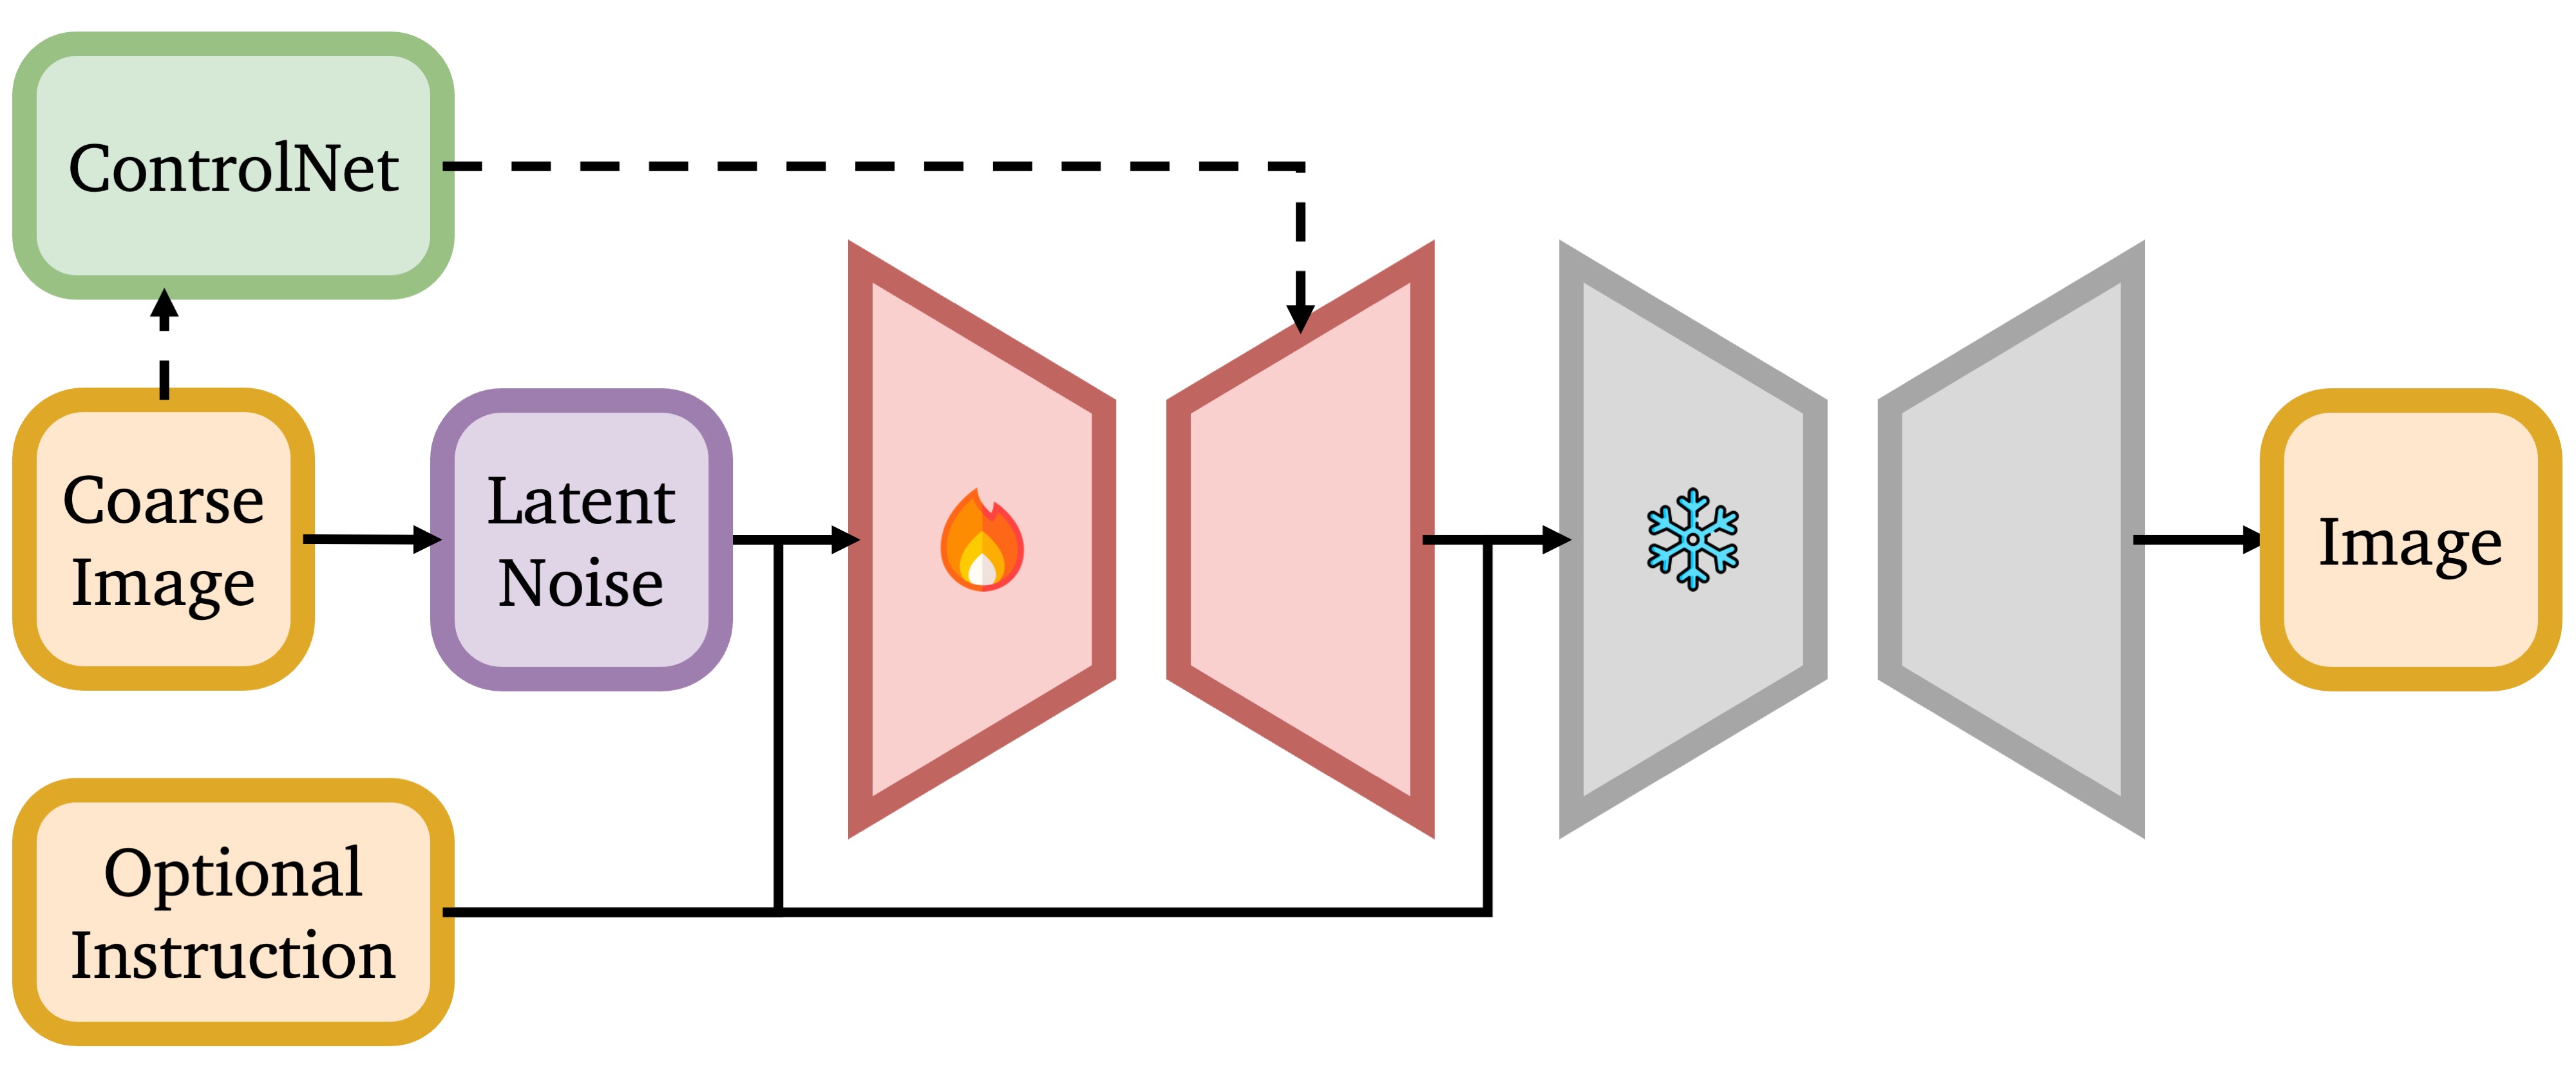
个性化 SDXL。 输入图像作为唯一实例图,LoRA 微调 SDXL-1.0 共 800 steps,学习率 \(10^{-5}\)。
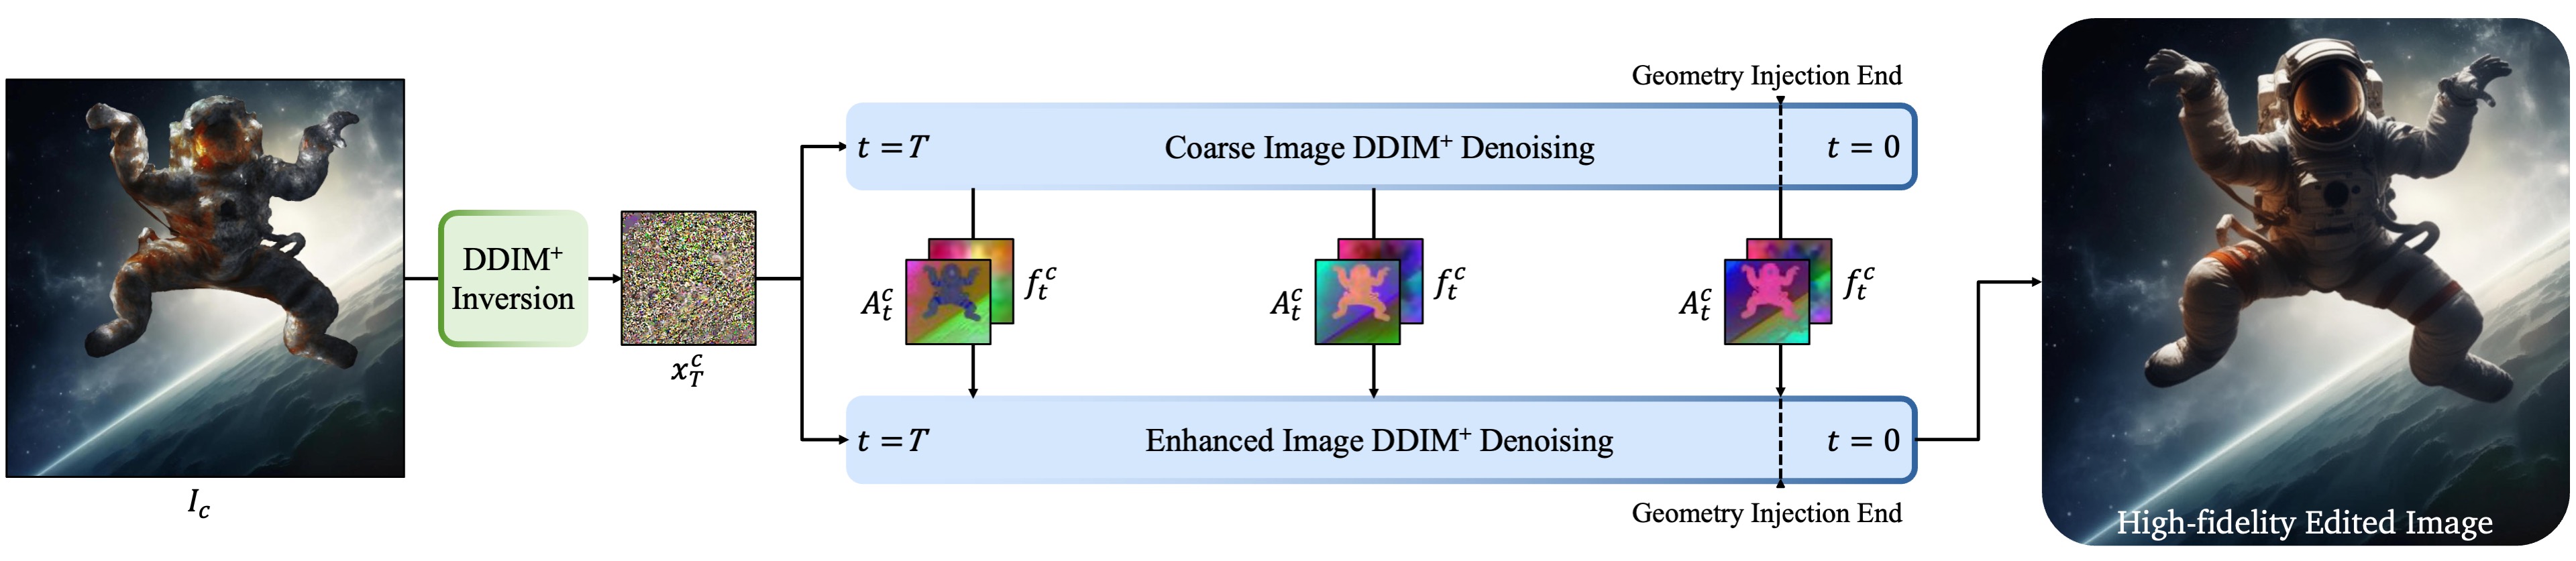
反演并双分支去噪。 depth-ControlNet 参与 DDIM inversion;增强分支从 \(\boldsymbol{x}_T^c\) 起步,按阈值注入粗图 feature 与 attention。
背景融合与 Refiner。 Adobe Generative Fill 先生成无对象背景;每步去噪用 mask 混合背景,最后在 \(t=0.1T\) 后使用冻结的 SDXL Refiner。
官方项目页的单图三维重建流程
Figure 3 对应阶段:de-rendering。 RGB 对象经 SDS 得到 NeRF,再提取纹理网格。
官方项目页的三维变形流程
Figure 3 对应阶段:3D deformation。 骨架与 skinning weights 提供可交互姿态控制。

粗到细增强:两条去噪轨迹共享结构

one-shot DreamBooth 得到个性化模型 \(\hat M\)。粗渲染经过带深度条件的 DDIM inversion:

\[ \boldsymbol{x}_{0:T}^{c}=\operatorname{DDIMInv}(I_c,y_{\mathrm{inv}},D;\hat M), \qquad \boldsymbol{x}_T^f=\boldsymbol{x}_T^c. \]

在每个时间步,两条轨迹都通过 SDXL UNet,提取 feature maps 与 self-attention maps:

\[ (\boldsymbol{f}_t^c,\boldsymbol{A}_t^c)=\epsilon_{\theta}(\boldsymbol{x}_t^c,y_{\mathrm{inv}},D,t), \qquad (\boldsymbol{f}_t^f,\boldsymbol{A}_t^f)=\epsilon_{\theta}(\boldsymbol{x}_t^f,y,D,t). \]

处于早期高噪声阶段时,增强分支直接采用粗渲染分支的内部状态:

\[ \widetilde{\boldsymbol{f}}_t^f= \begin{cases}\boldsymbol{f}_t^c,&t\gt\tau_f\\ \boldsymbol{f}_t^f,&t\le\tau_f\end{cases}, \qquad \widetilde{\boldsymbol{A}}_t^f= \begin{cases}\boldsymbol{A}_t^c,&t\gt\tau_A\\ \boldsymbol{A}_t^f,&t\le\tau_A\end{cases}. \]

注入后的 UNet 在时间步 \(t\) 预测噪声,再执行 DDIM 更新。原文 Algorithm 1 把该预测写作 \(\boldsymbol{\epsilon}_{t-1}^{f}\);这里使用 \(\widehat{\boldsymbol{\epsilon}}_{t}^{f}\) 标明它由 \(\boldsymbol{x}_t^f\) 计算,避免与更新后的 latent 下标混淆:

\[ \widehat{\boldsymbol{\epsilon}}_{t}^{f}=\epsilon_{\theta}(\boldsymbol{x}_t^f,y,D,t;\widetilde{\boldsymbol{f}}_t^f,\widetilde{\boldsymbol{A}}_t^f), \qquad \boldsymbol{x}_{t-1}^{f}=\operatorname{DDIMStep}(\boldsymbol{x}_t^f,\widehat{\boldsymbol{\epsilon}}_{t}^{f};\hat M). \]

最终从干净 latent 解码:

\[ I_f=\operatorname{Decoder}(\boldsymbol{x}_0^f). \]
Our Interpretation。 Depth ControlNet 提供外显几何条件;self-attention 注入固定全局布局;residual feature 注入补充局部形状。两个阈值让后期去噪逐渐脱离粗网格伪影,恢复对象纹理。
官方项目页粗到细模型图
Figure 5。 红色 one-shot DreamBooth 需要逐对象微调;灰色 SDXL Refiner 在实验中冻结。
官方项目页 feature injection 图
Figure 5 细节。 粗图 DDIM inversion 与最终图去噪并行运行,内部 feature 和 self-attention 按阈值替换。

六类编辑的实际操作

Pose editing

用户手动创建骨架并计算 skinning weights,再旋转骨骼。姿态本身不要求文字 prompt。

Rotation

围绕质心旋转网格。角度在 \([-45^{\circ},45^{\circ}]\) 使用 front view,\([135^{\circ},225^{\circ}]\) 使用 back view,其余使用 side view,以减轻 Janus 问题。

Translation

在三维空间按指定方向和距离移动网格;对象靠近相机时,渲染尺寸随透视自然增大。

Composition

将艺术家制作或其他图像重建的网格加入场景。新增对象未用于原对象的 DreamBooth 微调,必要时以文字补充语义。

Carving

把模具与网格求交并移除重叠区域,例如在南瓜表面切出月亮和星形孔洞。

Serial addition

逐个加入鱼、鸭或樱桃网格,并分别调节大小、姿态和朝向;每轮生成都需要场景合成与增强。

自动化边界。 论文把“精确控制”交给现成三维工具。骨架、skinning、Blender 变换、布尔雕刻、场景摆放与若干 prompt 都需要人工操作,系统没有学习一个端到端编辑器。

SculptingBench 与实验结论

SculptingBench 包含 15 张输入图像与 28 个编辑实例,覆盖六类任务。论文未公布 train/validation/test split,因为 benchmark 用于测试增强方案;逐对象 LoRA 的输入就是各自原图。

Table 1:增强模块消融

方法DINO ↑CLIP-I ↑D-RMSE ↓
Original Coarse Rendering0.7580.9020.00
SDEdit,\(t_0=0.4\)0.7880.9191.71
SDEdit,\(t_0=0.6\)0.8000.9202.12
Ours w/o Feature Injection0.8480.9252.33
Ours w/o Depth Control0.8510.9212.15
Ours0.8530.9211.99

原表全部六行。粗渲染 D-RMSE 为零是定义导致,因为它与自身深度比较;这个数值不能说明其视觉质量更高。

D-RMSE 使用 MiDaS 分别预测粗渲染与增强结果的深度:

\[ \mathrm{D\text{-}RMSE}=\sqrt{\mathbb{E}\left[(\mathrm{depth}_{\mathrm{coarse}}-\mathrm{depth}_{\mathrm{enhanced}})^2\right]}. \]

纹理质量

完整方法相对粗渲染把 DINO 从 0.758 提高到 0.853,绝对增加 0.095;CLIP-I 从 0.902 提高到 0.921。

组件贡献

移除 feature injection 后 D-RMSE 恶化到 2.33;移除 depth control 后为 2.15;完整方法为 1.99,支持两种约束共同保持几何;SDEdit \(t_0=0.4\) 的 1.71 更低,因此完整方法并非全表 D-RMSE 最优。

权衡

w/o Feature Injection 的 CLIP-I 最高 0.925;完整方法的 DINO 最高。论文展示的是纹理相似与几何保真之间的折中。
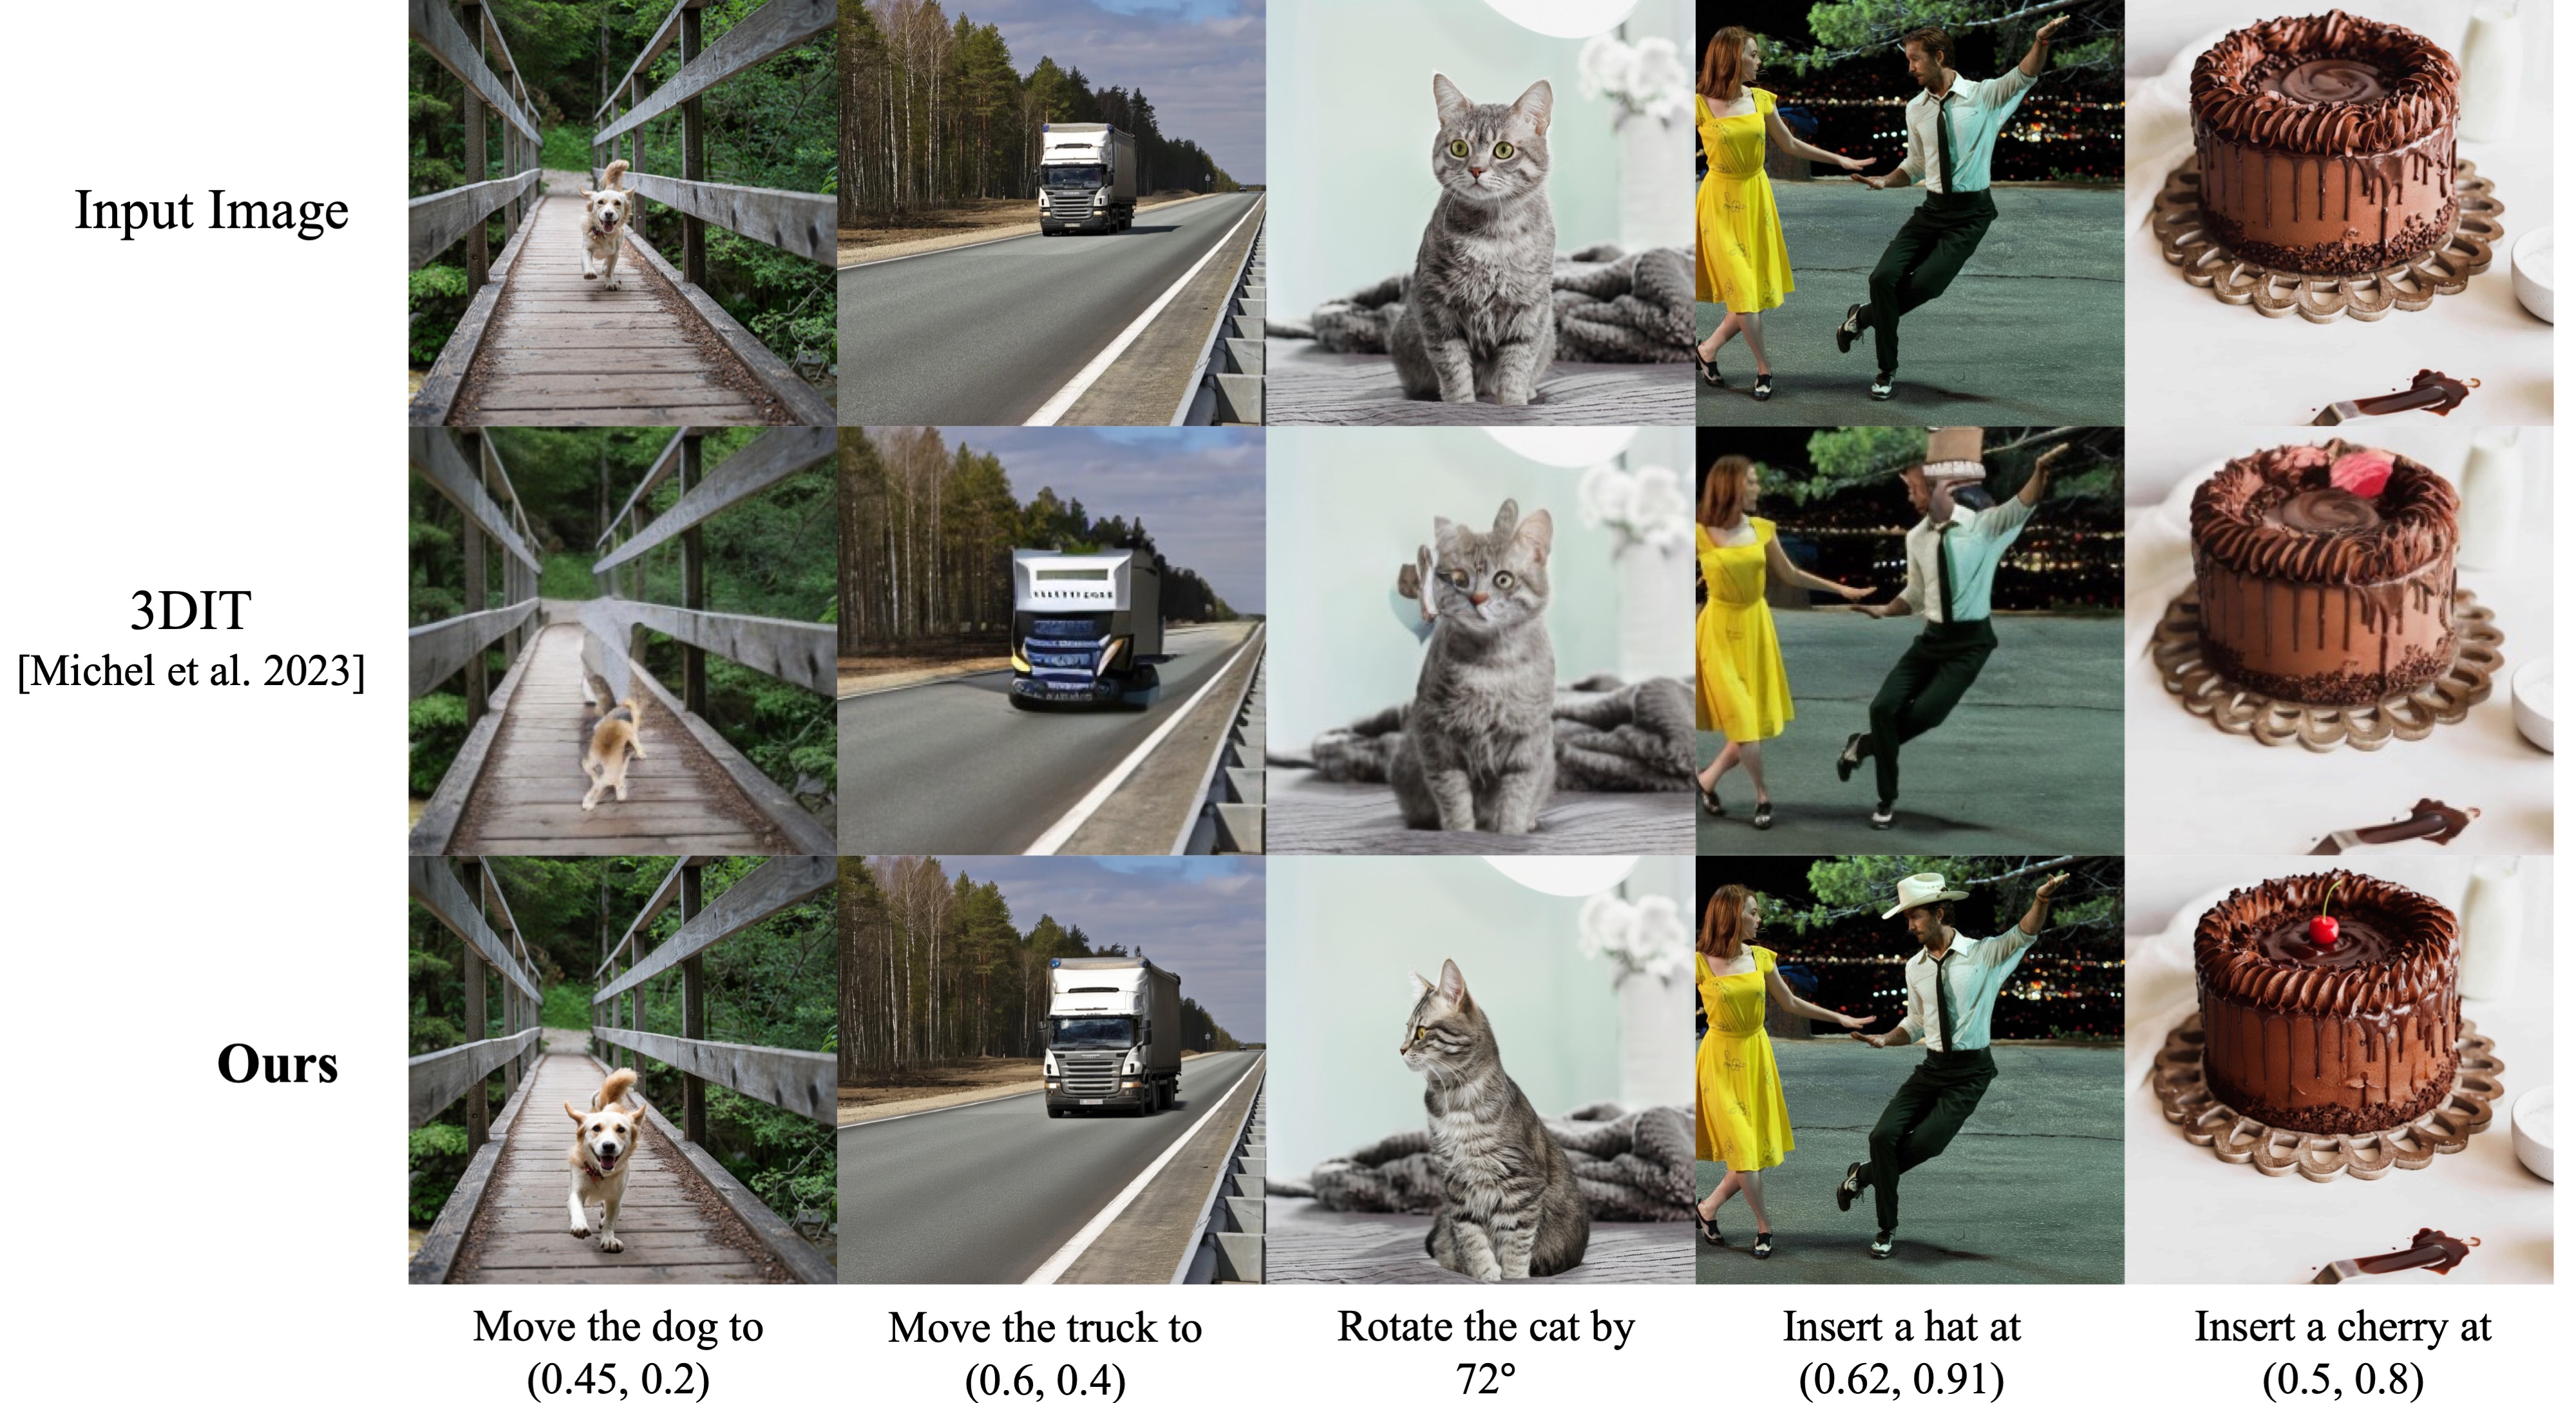
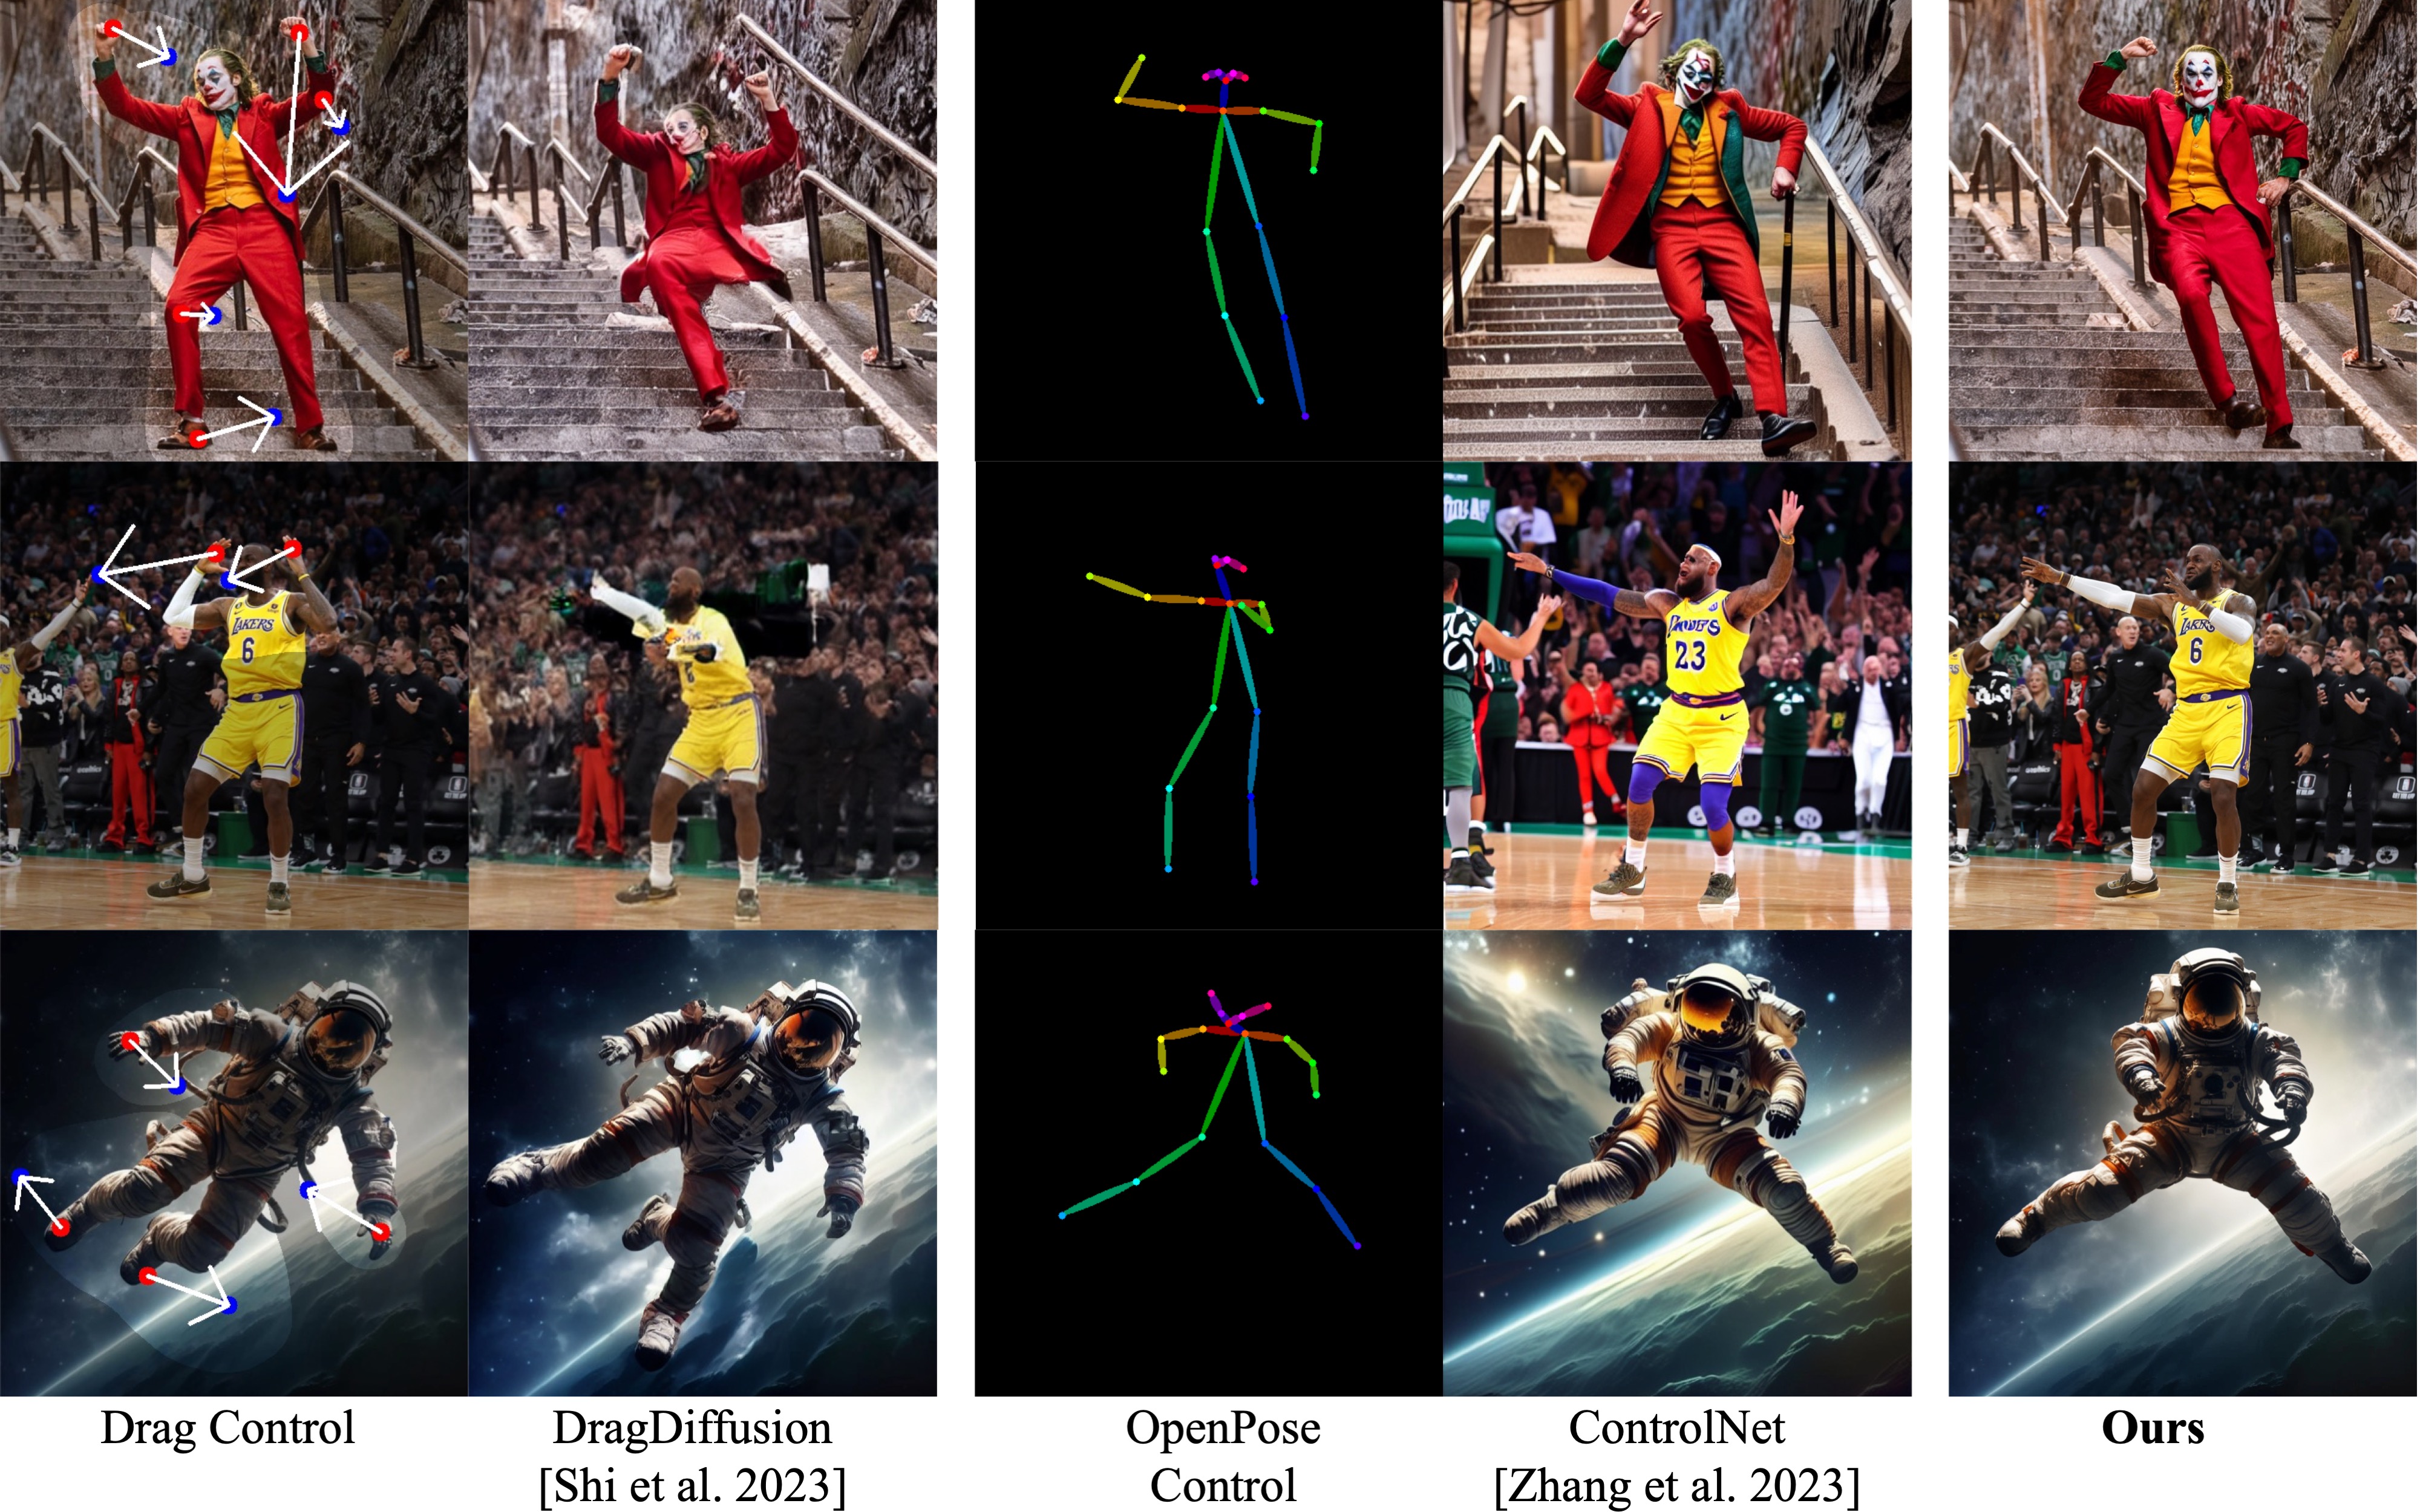
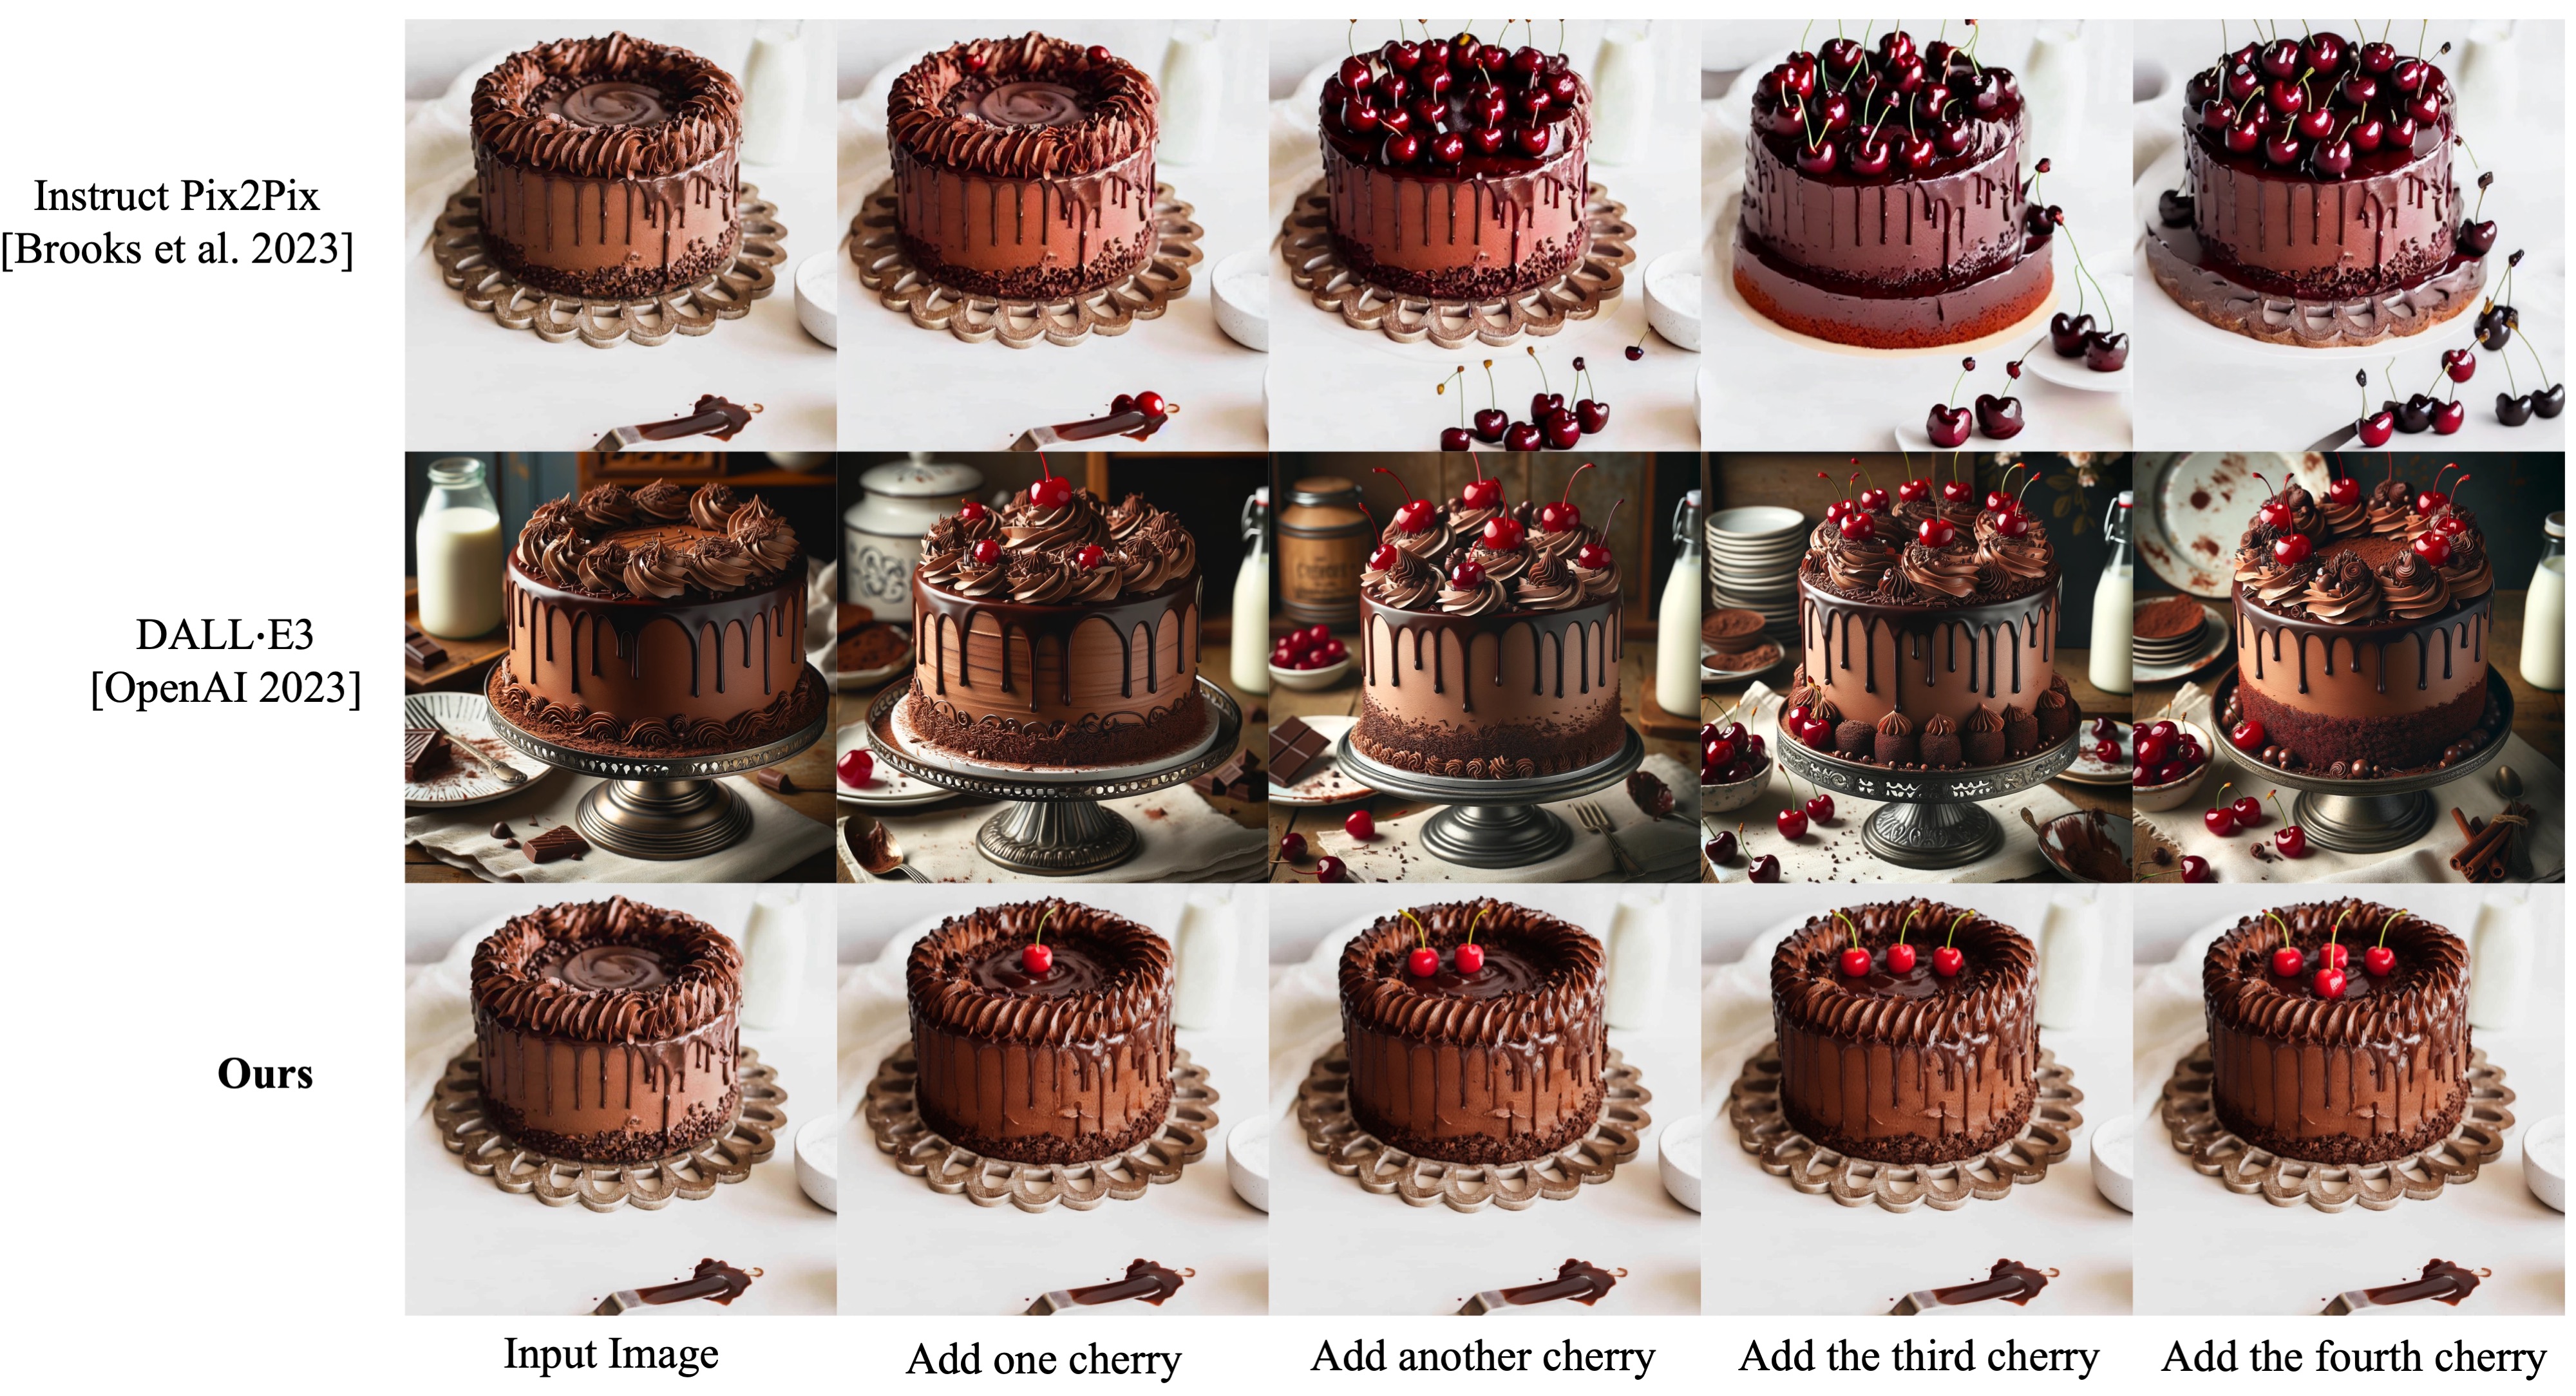
证据边界。 Table 1 是增强方法消融,没有报告 3DIT、DragDiffusion、ControlNet、InstructPix2Pix 或 DALL·E 3 的数值。跨方法结论依赖挑选的定性案例;论文也没有用户研究、显著性检验、运行时间或计算成本表。
OBJect-3DIT 与 Image Sculpting 定性比较
Figure 9。 3DIT 在平移、旋转和插入任务上的定性比较。
DragDiffusion、ControlNet 与 Image Sculpting 姿态比较
Figure 10。 DragDiffusion 与 OpenPose ControlNet 在复杂姿态编辑中的定性比较。
InstructPix2Pix 和 DALL-E 3 连续添加比较
Figure 11。 InstructPix2Pix 与 DALL·E 3 对连续定量添加指令的定性比较。

Figure 2–14 阅读索引

Figure 2cage-based space deformation、ARAP 与 linear blend skinning;三类控制在易用性、速度和精度之间取舍。
Figure 4粗渲染、SDEdit、DreamBooth、depth control 与完整方法;展示纹理保持和几何保持的冲突。
Figure 6六类任务及混合编辑的完整定性结果。
Figure 7–8逐步背景 latent blend;直接粘贴缺少反射与阴影,生成融合改善场景一致性。
Figure 12注入更多 self-attention 层时,增强图与目标编辑的结构一致性提高。
Figure 1315 张输入图像的 28 个 SculptingBench 编辑与文字说明。
Figure 14三类失败:面部纹理模糊、腋下网格伪影、重建颜色错误。

训练、推理与官方实现审计

Paper configuration

论文明确披露

  • Instant-NGP,网格提取 grid size 256;
  • SDXL-1.0 + LoRA,单图 800 steps,学习率 \(10^{-5}\);
  • 注入 SDXL decoder 全部 self-attention 层与 upsampling decoder 第一个 block;
  • \(\tau_A=0.5,\ \tau_f=0.2\),SDXL Refiner 在 \(t=0.1T\) 后启用;
  • Adobe Generative Fill 用于背景补全。
Not disclosed

复现缺失项

  • Zero-1-to-3/SDS 的每对象优化步数、学习率与时长;
  • LoRA rank、batch size、optimizer、scheduler、warmup、weight decay;
  • 论文实验的随机种子、逐案例 prompt、ControlNet scale;
  • benchmark 原始图像许可、统一评估预处理与显著性检验;
  • 完整系统运行时间、显存和人工交互时间。

Paper vs. Implementation

项目论文官方仓库 707ef77影响
增强分辨率未在正文明确data 与 renderer 默认 1024×1024可复现实例的实际尺寸得到补充
去噪步数未明确 \(T\)默认 100算法阈值换算依赖该步数
ControlNet scale未明确默认 0.5,覆盖全程几何约束强度属于代码设置
视图数量任务逐案例变化默认 12;README 示例设置 4脚本参数可以覆盖配置
背景补全Adobe Generative Fill读取已经生成的 bg_path仓库没有自动调用 Adobe 服务
三维编辑手动 skeleton、变形和组合README 指向 Blender 操作与教程代码并非端到端自动编辑系统
预训练网格描述完整重建流程示例要求另行下载 runs.zip仓库示例复用预计算资产
GPU未披露README 称在 RTX 4090、CUDA 12.0 测试属于发布后实现环境信息
Paper Verified。 旋转任务的 front/back/side prompt 是附录明确规则;姿态任务无需描述姿态的文字 prompt。composition 的外部网格没有加入 DreamBooth 训练。
Implementation Finding。 官方仓库的 GenerativeFill 类只读取预先生成的背景图,论文所述 Adobe 背景补全仍在仓库外完成。复现者还需要自行移除背景、搭建骨架、编辑网格和准备 prompt。

局限与失败模式

单图重建误差传播

不可见视角的纹理、几何和颜色一旦重建错误,会经过深度控制与特征注入进入最终图。Figure 14 展示三种具体失败。

人工操作成本

每个模型可能需要手动 rigging、skinning、骨骼编辑或布尔运算;论文没有报告用户完成一次编辑所需时间。

背景照明未联动

系统没有动态重估光照;背景生成融合可以产生阴影或反射外观,却不能保证与三维光源物理一致。

分辨率仍有限

作者承认输出距离工业渲染质量仍有差距,并把 super-resolution 作为后续方向。

指标依赖代理深度

D-RMSE 比较 MiDaS 预测深度。它同时受增强几何变化和 MiDaS 误差影响,也没有度量用户指定角度或距离的直接误差。

比较公平性不透明

多个 baseline 只提供定性图;prompt、随机种子、调参预算和输入控制并未逐项公开。

Reviewer Commentary

Strength

控制接口清晰

把姿态、角度、位移和布尔切割交给三维几何,解决文字条件天然含糊的问题。

Strength

模块职责分明

粗网格承载结构,DreamBooth 承载对象身份,Depth ControlNet 与内部注入限制增强漂移。

Strength

失败原因可定位

Appendix 将失败分为纹理、网格和颜色重建错误,便于判断改进应该发生在哪一阶段。

Weakness

实验规模较小

28 个编辑、15 张图像不足以支撑对复杂类别、极端视角与遮挡条件的广泛结论。

Weakness

缺少直接精度指标

论文没有测量最终图中的旋转角、三维位移或骨骼关节误差,precision 主要来自控制界面的定义。

Weakness

端到端成本偏高

NeRF 优化、逐对象 LoRA、人工 Blender 操作与外部背景生成共同构成较重的编辑流程。

Paper Verified。 完整方法在 DINO 指标领先,几何 D-RMSE 优于两个删减版本;CLIP-I 最高值来自 w/o Feature Injection。
Author Claim。 作者把系统视为生成模型与传统图形流程结合的起点。现有实验验证了可行性,没有证明它已达到工业级三维编辑系统的速度、分辨率或可重复性。
Our Interpretation。 这项工作的核心贡献是一种职责拆分:低保真三维资产无需直接成为最终画面,只需充当具有物理量的控制代理;扩散模型负责把代理渲染投射回自然图像分布。
Research Extension。 可以把多候选三维重建与 test-time search 结合:根据最终图的角度误差、深度一致性、身份相似度和背景光照一致性联合选择 reconstruction、camera、prompt 与 injection schedule。
Research Extension。 对 procedural material editing,可把材质图节点、UV-space mask 和几何深度共同作为显式控制;renderer-in-the-loop 同时优化材质参数与扩散增强,另外报告参数误差、渲染相似度和跨视角一致性。

来源与身份核查

  1. CVPR 2024 Open Access:正式会议信息与页码 4241–4251。
  2. arXiv HTML v1:正文、Algorithm 1、Appendix A–D 与 Table 1。
  3. 官方项目页:交互案例、原图资源与系统流程说明。
  4. 官方代码固定提交 707ef77:配置、默认推理设置与自动化边界。
  5. 本地 PDF:Reading/Papers/2401.01702v1.pdf,14 页,SHA-256 3F31107160FAC22F90AA38D4F9ACC5844AB83BD526D8B530D1A7695EBCC3E0A6。

论文与正式 CVPR 页面均未发现明确通讯作者标记。归档继续把末位作者 Saining Xie 记录为候选,状态为 unverified。