给衣服保留
自己的身份
Improving Diffusion Models for Authentic Virtual Try-on in the Wild
Yisol Choi · Sangkyung Kwak · Kyungmin Lee · Hyungwon Choi · Jinwoo Shin
虚拟试衣同时要生成自然的人像,并准确保留衣服的形状、印花、颜色与纹理。IDM-VTON 把同一件衣服的高层语义、低层空间特征和细致文本描述送入不同通道,再以单对样本定制处理真实场景。
为什么要给同一件衣服三种条件?
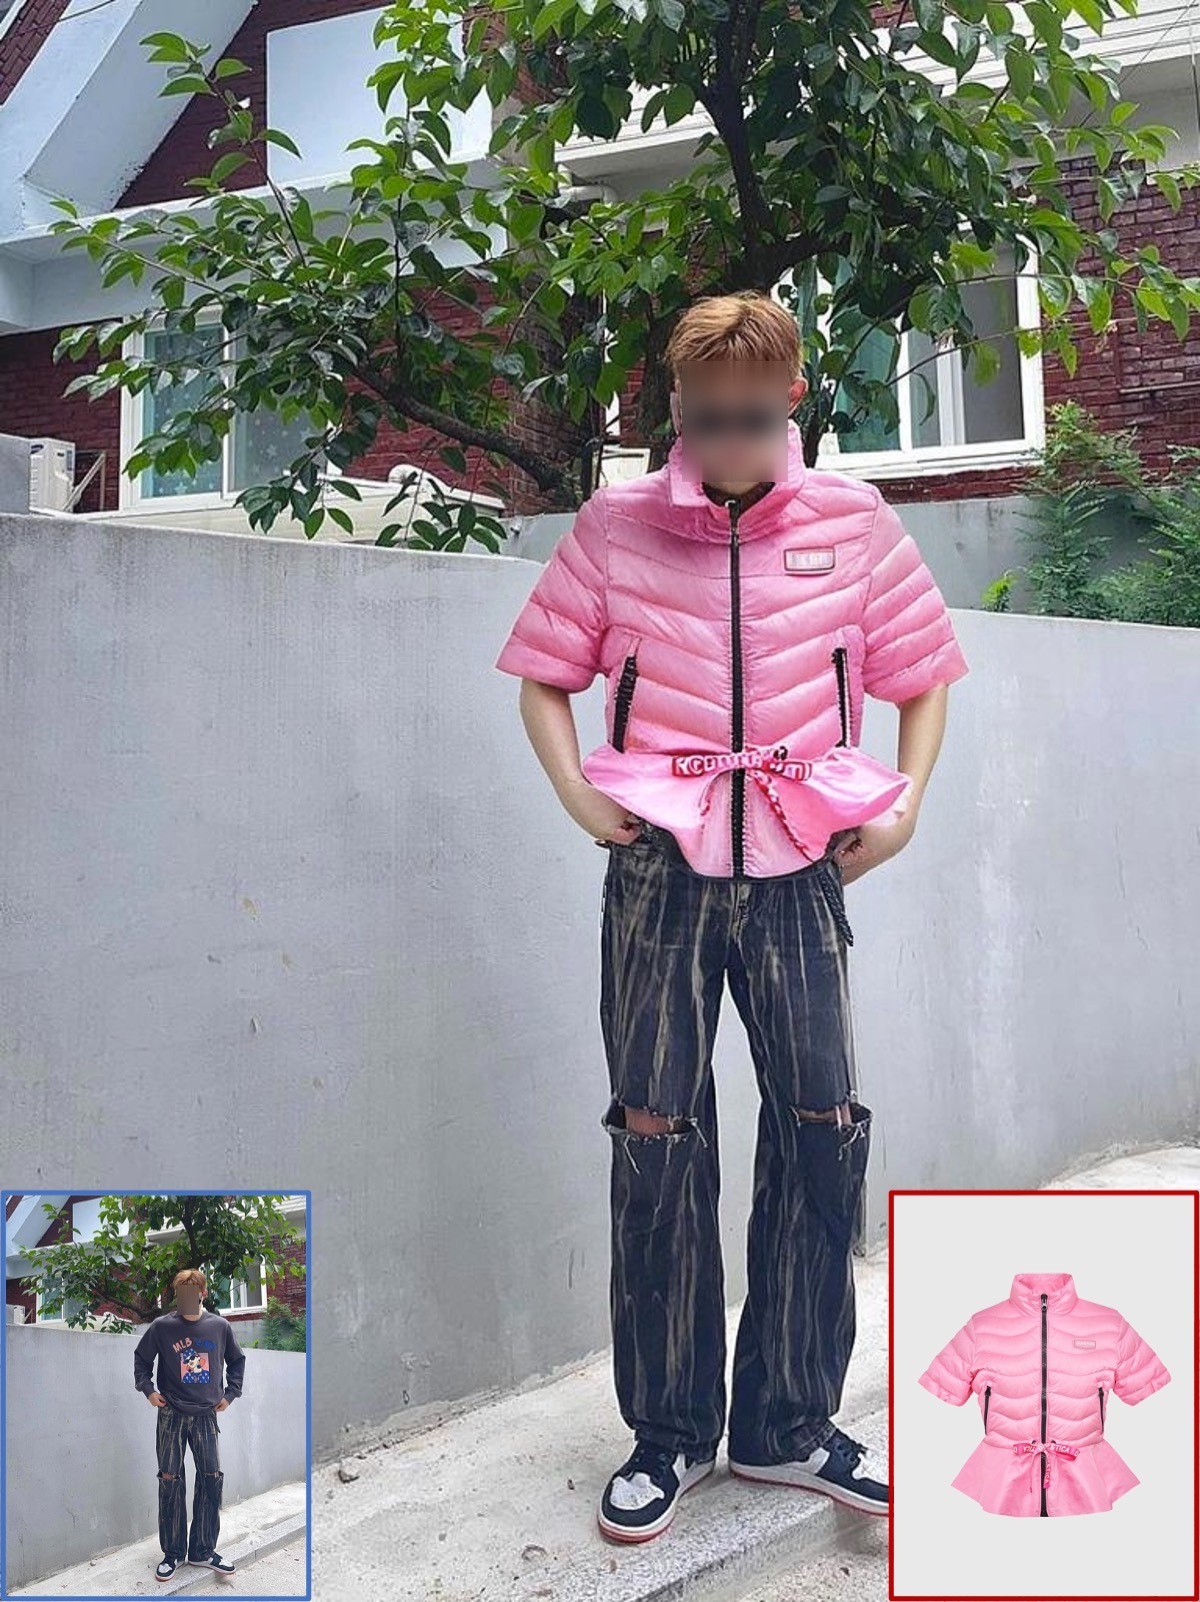
输入是目标人物照片与单独的衣物照片,输出应当保留人物姿态和背景,同时令衣物确实像输入商品。传统 GAN 方法常依赖显式形变,复杂姿态与背景会使形变和融合失效;早期扩散试衣虽然改善自然度,仍容易丢失印花、领口和文字等商品身份信息。[论文 §1–2]
高层语义
OpenCLIP ViT-H/14 与 IP-Adapter 判断衣物类型和整体外观,进入 TryonNet 的 cross-attention。
低层结构
冻结的平行 SDXL UNet 编码衣物的空间细节,特征拼入 TryonNet 的 self-attention。
语言先验
袖长、领型、类别组成较具体的衣物说明,分别进入人物分支和衣物分支。
核心假设是:单一 CLIP 图像条件偏重语义,难以独自传递需要像素级保真的图案;冻结的生成模型中间特征可以补充空间信息。论文通过 GarmentNet 消融支持这一判断,但没有把不同特征频段单独测量,因此“高层/低层”的命名仍是结构解释。[论文 §3.2、Table 3]

从输入到图像
令 \(x_p\) 为目标人物图像,\(x_g\) 为衣物商品图像,\(m\) 为人物原衣物区域掩码,\(x_m=(1-m)\odot x_p\) 为遮去该区域的人像,\(x_{\mathrm{pose}}\) 为 DensePose 图像。目标是生成 \(x_{\mathrm{tr}}\):保留人物身份、背景和姿态,并穿上 \(x_g\)。论文把任务当作有衣物样例约束的潜空间修复;VAE 编码器 \(E\)、解码器 \(D\) 负责图像与潜变量变换。[论文 §3.2]
扩散训练目标
对真实穿衣图像编码得到 \(z_0=E(x_p)\),采样时间步 \(t\) 与高斯噪声 \(\epsilon\),生成带噪潜变量。噪声预测器通过人物条件和三种衣物条件预测加入的噪声;最小化预测误差即训练 TryonNet 与可训练的 IP-Adapter 部件。论文式 (1) 写成通用扩散形式,实际代码的调度器与损失实现见下文。[论文 §3.1、Appendix A.2]
\[\mathcal{L}_{\mathrm{DM}}(\theta)=\mathbb{E}_{t,\epsilon}\!\left[\omega(t)\left\|\epsilon_{\theta}(z_t,c_p,c_g,L_g,H_g,t)-\epsilon\right\|_2^2\right]\]
这里 \(c_p,c_g\) 是人物/衣物分支的文本条件;\(L_g\) 是 GarmentNet 空间特征,\(H_g\) 是 IP-Adapter 图像语义。\(\omega(t)\) 为时间步权重;论文没有给出与训练代码完全一致的逐项展开,不能把上式当成另一个新损失。
13 通道的 TryonNet 输入
SDXL inpainting UNet 的首层被扩展到 13 通道:4 通道带噪潜变量、1 通道掩码、4 通道遮挡人像潜变量、4 通道 DensePose 潜变量。新增卷积权重从零初始化。正文有一处把第一个分量写成人物原图潜变量;Figure 2 与训练实现实际输入是带噪的目标潜变量,页面以训练实现和扩散训练机制解释该处。[论文 Figure 2、§3.2][代码 train_xl.py]
两种注意力怎样分工
IP-Adapter 为衣物图像嵌入计算额外的 key/value,与文本 cross-attention 的结果相加。\(Q\) 来自 TryonNet 中间特征,\(K_c,V_c\) 来自文本,\(K_i,V_i\) 来自衣物图像。这是语义条件进入每层生成过程的通路。[论文式 (3)]
GarmentNet 接收 \(E(x_g)\) 与衣物提示词,其冻结的 UNet 中间张量同层拼到 TryonNet 张量的空间/序列维度。self-attention 计算完后只保留属于人物分支的那一半输出,再继续人物分支。衣物分支不是把最终衣物图像直接贴到人像上;它在去噪阶段给人物分支提供可参考的局部细节。[论文 Figure 2、§3.2][代码 src/unet_hacked_tryon.py]
公式中的 \(F_p,F_g\) 分别是两条 UNet 在相应层的中间特征;方括号表示序列维拼接;\(\operatorname{slice}_{p}\) 取回人物对应的位置。此式是对论文文字和实现流程的符号化解释,并非论文原列公式。
详细衣物说明与定制
附录说明商业时尚属性标注器从超过 1000 种属性的体系中提取袖长、领口和商品类别三类,使用人工模板形成如 “short sleeve off shoulder t-shirts” 的短句。GarmentNet 使用 “A photo of [V]”;TryonNet 使用 “Model is wearing [V]”。标注器服务与模板是训练数据准备的一部分,论文没有公开模型权重或完整标注流水线。[论文 Figure 9、Appendix A.3]
遇到商品或人像偏离训练分布时,给定一张人物穿着目标衣物的照片,或从此照片分割衣物并白底化,再只微调 TryonNet 上采样块的注意力层。正文的“单对”意味着每件衣物需要一张已经穿着该衣物的示范照;真实电商只持有孤立商品图时,还需要取得此类示范数据。[论文 §3.2、Table 4]
训练与推理需要什么
基础模型
TryonNet:SDXL 1.0 inpainting 0.1;GarmentNet:SDXL base 1.0 UNet;OpenCLIP ViT-H/14 图像编码器;预训练 SDXL IP-Adapter。冻结 VAE、文本编码器、图像编码器和 GarmentNet;训练 TryonNet 与图像投影/适配器。[论文 §4.1][代码]
数据与预处理
VITON-HD 训练集 11,647 对,1024 × 768。人像、掩码、DensePose 与衣物需要配对;水平翻转概率 0.5,人物条件随机平移和缩放幅度至 0.2、概率 0.5。DressCode 只用于主文跨数据集评估;附录另报告在 DressCode 上训练。[论文 §4.1、Appendix A.2]
优化器
论文:Adam,学习率 1e-5、总 batch 24、130 epoch、约 63k 次迭代、4 张 A800 约 40 小时。定制:学习率 1e-6、100 步、单张 A800 约 2 分钟。代码脚本使用每卡 batch 6、4 卡对应总 batch 24,并提供 8-bit AdamW 选项。[Appendix A.2][README、train_xl.py]
单次推理的实际次序
- 取得人物图像、商品衣物图像,并产生人物 agnostic mask 与 DensePose;分别生成两条文本描述。
- VAE 编码遮挡人像、DensePose 和衣物;OpenCLIP 编码衣物语义。随机高斯噪声作为衣物区域的起点,strength 设为 1.0。
- 每一步 GarmentNet 提供冻结特征,TryonNet 在 self-attention 融入衣物空间信息,在 cross-attention 融入文本与 IP-Adapter 语义。
- 使用 DDPM scheduler 30 步、合并衣物高低层条件的 classifier-free guidance,权重 2.0;完成后经 VAE 解码。
论文 Appendix A.2 说两类衣物条件共同进入条件分支。仓库示例推理命令另外给出 768 × 1024、随机种子 42、batch 2、负向提示 “monochrome, lowres, bad anatomy, worst quality, low quality”。负向提示来自代码示例,论文没有把它列为主表评测的完整协议。[论文 Appendix A.2][README、inference.py]
把主表逐行读完
LPIPS 与 FID 越低越好,SSIM 与 CLIP-I 越高越好。LPIPS/SSIM/CLIP-I 关注与真实穿衣照的相似性;FID 关注生成集分布。VITON-HD 和 DressCode 的主表模型都在 VITON-HD 上训练,DressCode 数值因此同时检验跨数据集迁移。不同 baseline 使用公开检查点;低分辨率输出被插值或超分辨到 1024 × 768,并在不同上采样方式中取最好结果,仍不能消除原模型训练集、预处理的差异。[论文 §4.1、Table 1]
Table 1 · 公共数据集全表
| 方法 | VITON-HD | DressCode upper-body | ||||||
|---|---|---|---|---|---|---|---|---|
| LPIPS ↓ | SSIM ↑ | FID ↓ | CLIP-I ↑ | LPIPS ↓ | SSIM ↑ | FID ↓ | CLIP-I ↑ | |
| HR-VITON · GAN | 0.115 | 0.883 | 9.70 | 0.832 | 0.112 | 0.910 | 21.42 | 0.771 |
| GP-VTON · GAN | 0.105 | 0.898 | 6.43 | 0.874 | 0.484 | 0.780 | 55.21 | 0.628 |
| LaDI-VTON · diffusion | 0.156 | 0.872 | 8.85 | 0.834 | 0.149 | 0.905 | 16.54 | 0.803 |
| DCI-VTON · diffusion | 0.166 | 0.856 | 8.73 | 0.840 | 0.162 | 0.893 | 17.63 | 0.777 |
| StableVITON · diffusion | 0.133 | 0.885 | 6.52 | 0.871 | 0.107 | 0.910 | 14.37 | 0.866 |
| IDM-VTON | 0.102 | 0.870 | 6.29 | 0.883 | 0.062 | 0.920 | 8.64 | 0.904 |
在 VITON-HD,上述八列中 IDM-VTON 领先三列,SSIM 由 GP-VTON 领先;本方法的 SSIM 也低于 StableVITON。DressCode 四列均领先,尤以 FID 从 StableVITON 的 14.37 降至 8.64。论文未给置信区间,因此小幅差距的统计稳定性无法判断。
Table 2 · In-the-Wild 全表
| 方法 | LPIPS ↓ | SSIM ↑ | CLIP-I ↑ |
|---|---|---|---|
| HR-VITON | 0.330 | 0.741 | 0.701 |
| LaDI-VTON | 0.303 | 0.768 | 0.819 |
| DCI-VTON | 0.283 | 0.735 | 0.752 |
| StableVITON | 0.260 | 0.736 | 0.836 |
| IDM-VTON | 0.164 | 0.795 | 0.901 |
| StableVITON + customization | 0.259 | 0.733 | 0.858 |
| IDM-VTON + customization | 0.150 | 0.797 | 0.909 |
内部 In-the-Wild 数据集有 62 件上衣与 312 张穿着照片;每件衣物选一张用于定制,余下 250 张评估。未定制 IDM-VTON 相对 StableVITON 的 LPIPS 从 0.260 降至 0.164;定制后降至 0.150。这里评测的衣物已经在定制阶段出现,只是人物照片不同,因此这组结果证明的是“同衣物新人物”的适应效果,不能直接代表全新商品零样本部署。[论文 §4.1、Table 2]
哪些模块真的提供了增益?
Table 3 · GarmentNet 消融
| 设置 | LPIPS ↓ | SSIM ↑ | CLIP-I ↑ |
|---|---|---|---|
| 无 GarmentNet,仅 IP-Adapter | 0.121 | 0.849 | 0.846 |
| 加入 GarmentNet | 0.102 | 0.870 | 0.883 |
三项都改善;LPIPS 降低约 15.7%。这是支持空间衣物分支有效的主要量化证据。对 caption 的独立消融只有 Figure 7 的定性例子,没有主表式样的数值或多人评测,因此不能从该图估计其平均收益。[论文 §4.4、Tables 3、Figure 7]
Table 4 · 仅用一对示范照片定制
| 微调部分 | LPIPS ↓ | SSIM ↑ | CLIP-I ↑ |
|---|---|---|---|
| 默认模型 | 0.1642 | 0.795 | 0.901 |
| 全部 UNet | 0.1512 | 0.797 | 0.891 |
| LoRA | 0.1573 | 0.794 | 0.881 |
| 上采样块注意力层 | 0.1502 | 0.797 | 0.909 |
全 UNet 与上采样块方案的 LPIPS 差 0.001,表中没有显著性检验。全 UNet 与 LoRA 的 CLIP-I 下降;上采样块方案三项同时优于默认值。这一实验支持选取该定制位置,但未比较更多注意力层子集或长期遗忘。[论文 Table 4]
Appendix Tables 5–7 · 同期 OOTDiffusion
下表保留附录所有训练/测试方向,避免把“在 DressCode 上训练”误读为主文 Table 1 的协议。[论文 Appendix B]
| 训练 → 测试 | 方法 | LPIPS ↓ | SSIM ↑ | FID ↓ | CLIP-I ↑ |
|---|---|---|---|---|---|
| VITON-HD → VITON-HD | OOTDiffusion | 0.120 | 0.846 | 6.39 | 0.858 |
| VITON-HD → VITON-HD | IDM-VTON | 0.102 | 0.870 | 6.29 | 0.883 |
| VITON-HD → DressCode | OOTDiffusion | 0.087 | 0.901 | 10.68 | 0.852 |
| VITON-HD → DressCode | IDM-VTON | 0.062 | 0.920 | 8.64 | 0.904 |
| DressCode → DressCode | OOTDiffusion | 0.088 | 0.885 | 4.18 | 0.851 |
| DressCode → DressCode | IDM-VTON | 0.072 | 0.902 | 3.62 | 0.913 |
| DressCode → VITON-HD | OOTDiffusion | 0.205 | 0.788 | 57.87 | 0.677 |
| DressCode → VITON-HD | IDM-VTON | 0.129 | 0.859 | 12.57 | 0.839 |
| VITON-HD → In-the-Wild | OOTDiffusion | 0.203 | 0.752 | — | 0.861 |
| VITON-HD → In-the-Wild | IDM-VTON | 0.164 | 0.795 | — | 0.901 |
前八行来自 Table 5、6,最后两行来自 Table 7;附录只在公共数据集报告 FID。DressCode → VITON-HD 的大差距说明该迁移方向值得关注,也暴露分布差异:OOTDiffusion FID 达到 57.87,不能把某一个跨集方向泛化为全部分布。
证据边界与研究判断
Paper Verified
GarmentNet 在 VITON-HD 的三项消融指标上提供增益;IDM-VTON 在 DressCode 主表四项领先;单对衣物定制在 250 张内部测试照片上改善 LPIPS。
Author Claim
高层语义与低层细节分别由两分支捕获、详细 caption 调用 SDXL 先验。这些机制解释与图像结果一致,但缺少特征频段或 caption 的完整定量分解。
Our Interpretation
性能来自条件通道分工、SDXL 预训练能力、训练图像和属性标注链的共同作用。当前表格不能计算各因素的纯粹贡献,也不能证明零样本商品定制。
代码与论文的实际差异
- 论文报告 Adam;固定提交的
train_xl.py根据开关使用 AdamW8bit 或 AdamW,默认 beta 为 0.9/0.999、weight decay 1e-2。这些代码默认值不能反写为论文公开的训练设置。[代码 train_xl.py] - 论文概括“微调 TryonNet 和 IP-Adapter”;代码明确冻结衣物 UNet、VAE、两个文本编码器与图像编码器,对主 UNet 与图像投影设置可训练。要再确认每个 attention processor 是否被优化器覆盖,需要审计模型参数列表;页面只报告代码可直接确认的范围。[代码 train_xl.py]
- 论文的详细 caption 使用商业时尚属性标注器,仓库给出了 VITON-HD 已标注 JSON 与 DressCode caption 获取说明,但没有公开训练该标注器的方法。复现主实验可复用标注结果;复现整个数据生成链仍受限制。[论文 Appendix A.3][README]
- 仓库当前提交包含 Gradio 演示与额外运行说明,这些属于可用工程资料;评测结论依论文正式版的设置和数字。代码固定提交为
0d5f3ec2d737487a9bb24e4100936ad254780383,方便复核后续修改。
优点与局限
优点。模型输入、语义通道和空间特征通道各有明确作用;跨 VITON-HD、DressCode 和内部真实场景提供一致的商品保真改善;附录补充双向跨数据集和同期模型比较。局限。VITON-HD 的 SSIM 不是最佳;内部数据未开放且每件衣物的照片相互关联;商业标注器增加不可公开依赖;低分辨率 baseline 的后处理选择提高比较复杂性;没有用户研究检验消费者对尺寸、版型、真实衣物属性的感知。作者还明确指出纹身、痣等被掩码区域的人体属性可能丢失。[论文 §4–5]
Research Extension 值得继续验证的问题
可以把同衣物的局部图案区域单独构造成评价集,同时测量印花文字可读性、衣物形状和人物身份保留,并报告不同 mask、姿态、背景和衣物类别上的失败率。另一方向是把商品图像特征与人物原图中的皮肤细节分区约束,减少掩码对纹身等属性的破坏。两者是后续研究设想,论文没有实验验证。
一手资料与图表定位
- Choi 等,ECCV 2024 正式 PDF;30 页,正文 §§1–5,附录 A–B,Tables 1–7,Figures 1–18。本地核对 arXiv:2403.05139v3 PDF。ECVA 论文页。
- IDM-VTON 官方项目页:方法流程、试衣展示与代码入口;页面所用两张外链图片由此站提供。
- 作者代码固定提交:README、train_xl.py、inference.py、src 中的 UNet 与 pipeline 实现;核查日期 2026-09-30。