改变什么
姿态、视角、物体数量或动作;允许空间布局发生明显变化。
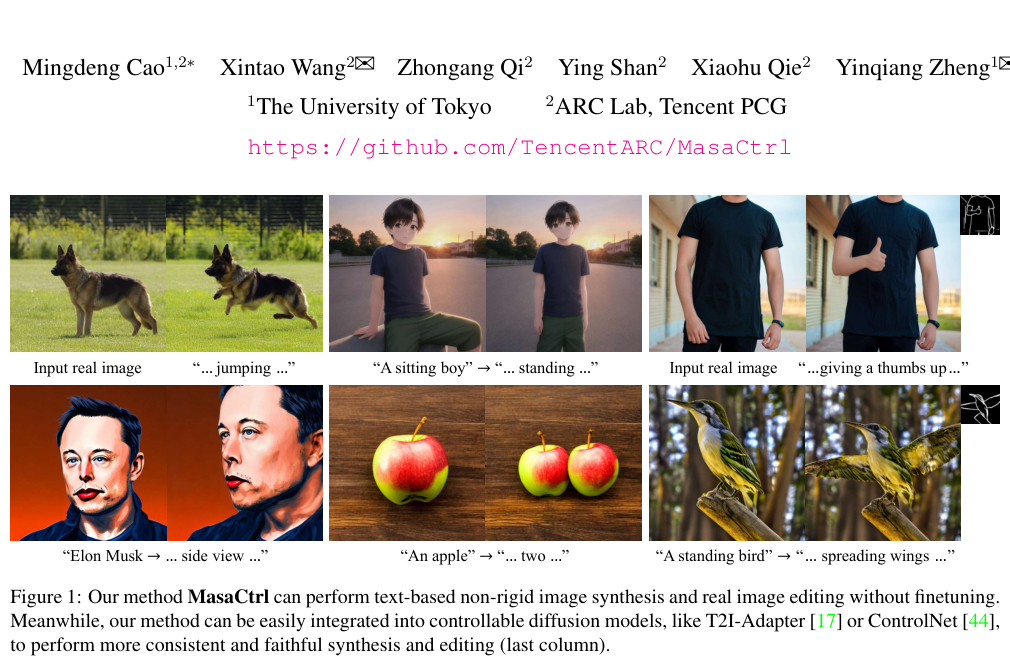
MasaCtrl: Tuning-Free Mutual Self-Attention Control for Consistent Image Synthesis and Editing|用目标 Query 检索源图内容,解耦姿态与身份
Mingdeng Cao · Xintao Wang · Zhongang Qi · Ying Shan · Xiaohu Qie · Yinqiang Zheng|ICCV 2023
MasaCtrl 把“目标应该长成什么姿态”和“目标应该用谁的外观”拆开:目标分支保留自己的 Query,去源图分支的 Key/Value 中检索纹理与身份线索。它不训练新模型,而是在已有扩散模型的特定采样阶段、特定 U-Net 层改变信息流。
Paper Verified:固定阅读对象是 arXiv:2304.08465v1,2023-04-17,13 页:正文 1–11 页,参考文献 12–13 页。共有 Figure 1–13、Algorithm 1、编号公式 1–8;该文件没有 Appendix、Supplementary 或编号数值表。官方项目与仓库确认 ICCV 2023,22560–22570。后续代码扩展独立标注,不冒充 v1 实验。
作者为 Mingdeng Cao、Xintao Wang、Zhongang Qi、Ying Shan、Xiaohu Qie、Yinqiang Zheng。第一作者隶属东京大学及腾讯 ARC Lab。固定 PDF 的星号解释为实习工作,并非通讯作者标记;当前官方项目页明确以信封标记 Xintao Wang 与 Yinqiang Zheng。原笔记元数据暂不改写,建议未来人工合并时以该一手证据更新。官方项目与作者标记
姿态、视角、物体数量或动作;允许空间布局发生明显变化。
源图对象的纹理、颜色、外观身份及背景内容;这是经验性视觉一致性,不是精确重建保证。
不微调扩散权重,不优化文本 embedding;真实图仍需 DDIM inversion,推理仍有双分支成本。
本页论文事实主要依据固定 PDF;各节页码对应 v1 原文。标为 Our Interpretation、Reviewer、Research Extension 的内容是分析或研究建议。
相同随机种子只能让两个生成过程从相同噪声起步,不能让不同 prompt 的去噪轨迹始终表示同一个角色。例如将坐着的小猫改成躺着的小猫,姿态可能改变,但毛色、脸形、地板都会漂移。另一方面,P2P 等方法通过保持源布局提升编辑稳定性,却会限制非刚性变化。MasaCtrl 的问题不是“让编辑尽量少变”,而是“结构可以变,内容仍像同一对象”。
Imagic 已探索非刚性真实图编辑,但需要图像相关的 embedding 优化及模型微调。本文希望用一次推理期信息重路由替代每张图的训练适配。其直觉是:扩散早期确定粗布局;在较晚阶段、U-Net decoder 中,语义相关位置具有可匹配的 Query,因此目标姿态中的身体区域可检索源图身体纹理,而不必复制同一像素坐标。

图解:Figure 2 上排把“固定 seed 不等于身份一致”作为动机;下排展示无 mask 与有 mask 的差异,揭示检索机制会把相似颜色的前景、背景混淆。这里是选取案例,不是成功率统计。
| 相关路线 | 控制或优化对象 | 与本文问题的关系 |
|---|---|---|
| Prompt-to-Prompt / P2P | 图文 cross-attention | 保持语义布局有利于局部替换,却可能妨碍姿态变化 |
| Plug-and-Play / PnP | 源图空间特征、attention 信息 | 适合结构保留的图像翻译;本文强调改变结构 |
| SDEdit | 输入图加噪后再去噪 | 噪声强度在编辑幅度与源保真之间折中 |
| Imagic | 文本 embedding 与模型参数 | 能力相近但需要优化;不是本文 Figure 6/7 的直接展示基线 |
| T2I-Adapter / ControlNet | 姿态、边缘等结构条件 | 提供目标布局,与本文的源外观检索互补 |
来源:PDF pp. 1–3、Sec. 2;以上表格为本页整理,不是原论文数值表。
| 符号 | 含义 | 在流程中的作用 |
|---|---|---|
| \(I_s,P_s\) | 源图与源文本 | 源图可生成,也可来自真实照片;真实图在本文设置下使用空源 prompt |
| \(P,I\) | 目标编辑文本与目标图像 | 文本确定目标动作、视角等;输出希望继承源图内容 |
| \(z^{s}_{t},z_t\) | 源与目标在时刻 t 的潜变量 | 两个同步的扩散轨迹,默认共享初始噪声 |
| \(\epsilon_{\theta}\) | 冻结的去噪 U-Net | 以潜变量、文本和时间为条件预测噪声 |
| \(Q^{l},K^{l},V^{l}\) | 目标第 l 层的查询、键、值 | Query 保持来自目标;激活控制时键和值改用源分支 |
| \(K^{l}_{s},V^{l}_{s}\) | 同一步同一层的源键和值 | 动态的内容库,不是最终 RGB 图的静态 patch 库 |
| \(S,L\) | 控制起始采样步及层 | 决定目标自由成形与源内容注入的时间/空间边界 |
| \(M_s,M\) | 源、目标对象 mask | 前者限制可查询的键,后者选择输出采用前景还是背景结果 |
模型产物是图像,不是 3D geometry、显式材质或程序图。内部 latent 是 VAE 的图像表示,自注意力 token 是空间特征,不是材质节点 token。本文没有针对身份保持写出新的优化目标、reward 或可微约束;所谓一致性由推理机制与视觉样例支撑。
Our Interpretation:在一个 head 中可把目标 \(Q\) 看作 \(n_t\times d\),源 \(K_s\) 为 \(n_s\times d\),源 \(V_s\) 为 \(n_s\times d_v\)。注意力输出形状是 \(n_t\times d_v\):目标位置数不变,但每个位置的内容由源位置加权组合。这就是可改变几何布局、又继承外观的操作基础。
PDF 的式 1 印刷为下式,均值缺少 \(x_0\),下标也不一致;式 3 的文字称 MSE,但范数没有平方。本页同时保存原式语义与标准化解释,避免静默纠错后误称逐字原式。
标准扩散解释应为 \(\bar\alpha_t=\prod_{i=1}^{t}\alpha_i\),前向分布均值为 \(\sqrt{\bar\alpha_t}x_0\),协方差为 \((1-\bar\alpha_t)I\)。可等价采样:
这个补全用于说明“向图像加噪”;MasaCtrl 实际在 latent \(z\) 中运行,且不会重新训练这个前向过程。
式 2 表达从带噪状态恢复上一步的反向分布,\(\mu_\theta\) 来自噪声预测,\(\sigma_t\) 在原文作为时间相关方差符号。原文给出的均值展开也缺少标准公式分母中的平方根,不能直接作为数值实现。标准 DDPM 写法是:
原文意图是预测加入的噪声;标准 MSE 应写 \(\mathbb E\|\epsilon-\epsilon_\theta(x_t,t)\|_2^2\)。这些是预训练扩散模型的背景知识,不是 MasaCtrl 为每幅图执行的新 loss。推理采用 DDIM 而非逐字使用式 2 进行随机 DDPM 采样。
\(d\) 是每个 head 的键/查询维度。Softmax 沿键的位置归一化,使每个目标 Query 得到对源 Value 的混合权重。普通 self-attention 的三者来自同一图像;图文 cross-attention 的键和值来自文本;本文的 mutual self-attention 则把视觉目标的 \(Q\) 与视觉源图的 \(K_s,V_s\) 配对。这里“cross”是跨图像轨迹,不能与图文 cross-attention 混称。
复现警告:原式把 t 写成大于 S,而 Algorithm 1 的 t 从 T 倒数到 1;若把它直接理解成 scheduler 的噪声时间,会反转“先让目标形成布局,再注入源内容”的意图。当前官方实现采用从零递增的 cur_step,并用 range(start_step,total_steps),层同样从 start_layer 开始包含端点。因此建议在自己的实现中用 \(k=0,\ldots,T-1\) 表示采样迭代,以 \(k\ge S\) 与选中的 decoder 层定义控制,而把 scheduler timestep 单独记作 \(\tau_k\)。这是一项明确的实现解释,不是把原式 5 改写成不存在的论文公式。
式 6 只允许检索源前景,式 7 只允许检索源背景,式 8 在目标空间依目标 mask 组合结果。原文的星号在这里是逐元素乘法,本页用 \(\odot\) 避免误读为矩阵乘法。不要把源 mask 直接贴到目标坐标上,那会重新锁死姿态。
实现可在不允许的 source key 上加极小 logit,再 Softmax;概念上相当于 \(\operatorname{Softmax}(QK_s^{\mathsf T}/\sqrt d+B_s)V_s\),其中合法位置偏置为 0,非法位置趋于负无穷。后一句是算子展开解释。需要处理空 mask 与常量 attention map,否则归一化或全屏蔽可能出问题。
公式依据:PDF pp. 3–6,Eq. 1–8;实现边界依据 官方 attention controller,2026-09-30 读取。标准化补全均已与原文排印区别标注。

| 原算法步骤 | 操作 | 应检查的实现细节 |
|---|---|---|
| 1 | 循环 t=T 至 1 | 分离扩散时间与控制器递增迭代计数 |
| 2–3 | 源 U-Net 输出噪声与源 Q/K/V,并进行源采样更新 | 缓存必须是当前步、当前层,不能错一轮 |
| 4–6 | 取得目标特征,EDIT 替换,再得到受控噪声 | 概念伪代码不意味着必须把目标 U-Net 全跑两遍;可通过 attention hook 在同一次前向中替换 |
| 7 | 依据受控噪声更新目标 latent | CFG conditional/unconditional 分支的样本排列必须一致 |
| 8 / Return | 结束循环,返回源与目标最终 latent | 比较源重建与输入,避免将反演损失归咎于编辑器 |

Figure 4:中间去噪结果支持布局早期成形的解释;第 15 个采样步骤的 Query 可视化展示 encoder 与 decoder 的差异。相似颜色只能提示特征相关,不能视为严格的一一语义对应证明。

Figure 5:上图是目标 Query 查询源 Key/Value 的数据流,下图说明 mask 来源是 token 对应的 cross-attention。整个方法不需要额外训练的分割模型,但 mask 质量受文本定位能力约束。
| 项目 | 固定 v1 明确报告 | 不能自行补齐的部分 |
|---|---|---|
| 基础模型 | Stable Diffusion v1.4;额外验证 Anything-V4 | 不是 SDXL 原论文实验;不声称覆盖任意架构 |
| 训练 | 全部使用预训练模型;本文无 fine-tuning/embedding optimization | optimizer、LR、epoch、warmup、weight decay 均不适用于本文新增训练 |
| 采样器 | DDIM,50 denoising steps | 未完整报告所有 scheduler 参数 |
| CFG | 7.5 | 未提供系统 guidance sweep |
| 默认控制 | S=4、L=10;checkpoint 不同可调 | 论文文字与公式端点存在差异,应按实现验证 |
| Adapter 组合 | 实验 S=2、L=8 | 不等于纯文本设置下也应越早越好 |
| 初始噪声 | 源与目标默认相同 | 未逐例列出随机 seed |
| 真实图反演 | 确定性 DDIM inversion;空源文本 | 未给出完整逐图重建误差或统一分辨率协议 |
| mask attention | 16×16 图文响应,跨头与层平均 | v1 正文没有完整 token 选择、阈值及插值超参数 |
| 数据 | 合成图与真实图展示 | 没有正式命名 benchmark、数据总量、划分或全样本统计 |
| 成本 | 主张免微调的便利性 | v1 未报告统一 GPU 型号、推理秒数、显存峰值或加速倍数 |
temperature、top-k、top-p、beam size、LLM system prompt 不属于本方法。图像 prompt 是输入条件,例如把坐姿词改为卧姿词;不应把本页建议写成作者提供的完整 prompt 模板。
当前官方实现核查:控制器区间包含起始步/层;CFG 两分支分开查询源特征。自动 mask 默认阈值为 0.1,token 索引列表默认 [1],对响应先做 min–max 归一化;没有已收集的 cross-attention 时退回不带 mask 的检索。恒定响应图的分母缺少显式保护,复现时值得测试。仓库还含 source+target K/V 拼接变体与 SDXL 支持,均不能等同于固定 v1 的实验配置。以上实现摘要仅描述已读源码,并未运行模型。
官方 README 给出 Python 3.8.5、PyTorch 1.11,并建议 notebook 合成至少 16 GB GPU 显存;这些是仓库使用提示,不是论文测量结果。2024 的 processor 接口与 2023 的 SDXL 扩展属于后续工程更新。官方代码与运行说明
完整原表核查:固定 v1 无 Table 1 或任何编号数值表,没有 CLIP、LPIPS、FID、用户研究百分比或速度表。因此没有“全部数值行”可重建,也无法据此计算提升幅度。本节保留所有原始实验 Figure,并用自制表格整理比较条件,绝不创造定量结果。

Figure 6:两组合成图比较分别涉及单苹果变双苹果、坐猫变躺猫。列顺序是源图、MasaCtrl、固定 seed、P2P、SDEdit 0.5、SDEdit 0.8、PnP。要同时检查“数量/姿态是否成功”与“外观是否仍来自源图”,而不是只看画面质量。

Figure 7:真实图展示奔跑的柯基与黑衣人物抬手,同样保留上述七列。真实图路径额外包含反演,因此编辑保真既受 inversion 影响,也受注意力路由影响。论文以这些案例说明复杂姿态编辑可行,没有给出整个真实图集合的失败率。
| 方法/列 | 公平比较应控制什么 | 图中支持的结论 | 不能推出 |
|---|---|---|---|
| 固定 seed | 相同初始噪声、目标文本与基础模型 | 只固定噪声不足以保证源身份 | 所有 seed 都失败 |
| P2P | 编辑词映射、attention schedule | 保留源布局与大姿态改变可能冲突 | P2P 在所有编辑任务都弱 |
| SDEdit 0.5 / 0.8 | 加噪强度与采样预算 | 编辑幅度和内容保持存在折中 | 已经穷尽 SDEdit 超参数 |
| PnP | 注入层、时间和反演质量 | 结构保持特征不总适合非刚性编辑 | 统一 benchmark 上显著落后 |
| MasaCtrl | S/L、mask、模型、同等样本挑选预算 | 选定案例可以兼顾新布局与源内容 | 精确身份保持或统计显著优势 |
作者使用公开 baseline 代码;SDEdit 使用 SD 的 img2img 脚本。论文未完整披露各 baseline 的逐例参数与选择预算,因此比较可作为机制演示,不足以判定严格的全面 SOTA。Imagic 在讨论中出现,但没有在这里作为图中同预算直接对照。
来源:PDF pp. 7、9,Sec. 5.1;表格最后两列为证据边界分析。

T2I-Adapter(Figure 8):结构条件为目标提供更可靠的几何布局,MasaCtrl 从源图提供外观。左侧是合成图一致性,右侧是真实图编辑。由于结构已经被额外指导,作者可以在更早步骤、更早层开始互注意力,使用 S=2、L=8;这与纯文本默认 S=4、L=10 的差别有明确原因。ControlNet 被提出为可兼容路线,但 Figure 8、11 的标注与具体展示是 T2I-Adapter,不能混成两者均有同样完整实验。

Anything-V4(Figure 9):动漫模型上的站立、奔跑、抬手等修改展示迁移可能性。它说明机制不只在 SD v1.4 的照片风格样例有效,但两个相近家族 checkpoint 不能证明对所有模型、分辨率或语言普适。

Figure 10:同一个男孩的坐姿、举手、点赞、侧面、背面、奔跑、笑等连续变体,展示“一张源图多种目标条件”的使用方式。这里仍是独立图像生成,不是显式三维身份模型。

视频扩展(Figure 11):先用文本与结构指导生成源帧;后续帧各自按照连贯的姿态/边缘条件生成,并向同一源帧检索内容。熊的动作与车辆场景说明可以借助连续控制信号获得内容相近的帧。本文没有训练 temporal module,没有提供 optical-flow loss、时序定量指标或长视频稳定性曲线。作者明确指出背景难以动起来,动态背景是限制,而不是已经解决的能力。
Our Interpretation:源帧共享是一种外观锚定,连续的结构条件是一种运动约束;两者相加仍不等价于对遮挡、新出现区域与时间连续性建立完整生成模型。

| 消融轴 | 原图列/配置 | 作者观察 | 证据限制 |
|---|---|---|---|
| 起始采样步 | 0、5、15、30、45 | 太早趋向复制源图;适中保留目标布局并迁移内容;太晚丢失源内容 | 一个视觉序列,不是跨数据集最优 S 估计 |
| 层范围 | 0–15、0–3、4–7、8–10、10–15 | 全层复制倾向强;低分辨率范围难兼顾;decoder 高分辨率较有效 | 图上是区间消融,不能推出所有单层独立贡献 |
| mask | Figure 2 下排:无 / 有 | 相近前景背景颜色时限制检索域可减少混淆 | 没有分割精度、阈值敏感性、开销或多对象统计 |
| 条件控制 | Figure 8:Adapter 组合及固定 seed | 结构约束有助于目标布局 | 不是同一全面网格内解耦 S、L 与条件强度的消融 |
Figure 12 的步数展示与默认 S=4 不应强行等同:图中的 step 5 是一个展示位置,代码还涉及零基索引。正文把低分辨率大致描述为 4–10、高分辨率为 0–3 与 10–15;相邻边界可能按模块描述重叠,复现应使用实际 attention index,而非仅靠概念分辨率分组。
Reviewer:这些消融支持“控制位置重要”,也为 decoder 延迟注入提供合理直觉;但不足以证明特征语义可分解具有唯一因果机制。缺少随机层对照、相同注入强度对照、跨任务统计和误差条,不能将选取可视化解释提升为一般定理。

三类原文失败:第一,基础 SD 本身不能生成目标姿态/布局时,MasaCtrl 也难补救;第二,目标需要源图未展示的内容,如张开的手掌,源特征库缺少相应视觉证据,会产生局部伪影;第三,即使总体一致,鸟嘴颜色等小细节仍可能漂移。附加结构控制能缓解第一类,不能保证消灭另外两类。
建立由源图、编辑文本、结构条件与身份标注组成的固定测试集,分开统计姿态成功、身份相似、背景漂移和局部缺陷;对真实图首先报告 inversion ceiling。采用全部 seeds 的均值与失败率,记录参数搜索预算。将纯 source K/V、source+target K/V、置信度门控进行同预算比较,再做分辨率与多对象泛化。上述为 reviewer 建议,未在 v1 完成。
Research Extension,非原论文结论:MasaCtrl 是图像编辑方法,不输出 SBS/SBSAR、shader、材质图、BRDF 或多通道贴图。它对 PMG 最有启发的部分,是把“新结构的查询”与“参考外观的内容库”解耦,而不是直接把照片注意力当成程序结构。
输入一张参考材质外观及目标程序图渲染。目标的结构特征提供 Query,参考图提供纹理 Key/Value;把前景/背景 mask 升级为材质部件、频段或表面区域 mask,例如木纹、节疤、边缘磨损。需要避免把光照高光当作 albedo,最好从多光照、多视角监督建立外观库。输出先定义为目标渲染外观,再由程序参数拟合,而非谎称 attention 已生成合法图。
这是本页提出的研究目标。\(G\) 是固定合法程序拓扑,\(\phi\) 是可优化节点参数,\(R\) 是渲染器,\(c\) 为固定相机与光照,\(D_a\) 测外观差异,\(D_s\) 测结构符合度,\(C\) 惩罚越界或无效参数。互注意力结果可以作为外观参考或候选提议,但最后必须执行真实程序,并用多条件渲染排除“单视角看起来对”的假解。
源内容缺失对应 PMG 中参考只展示部分纹理尺度、未知背面或缺少粗糙度线索。可以由检索相似度/熵估计置信度,低置信度区域保留目标自己的生成特征,高置信度区域偏向参考。该策略需与固定 source+target 拼接基线比较,以证明动态门控优于仅增加内容池。
| 实验维度 | 拟议设置 | 判断标准 |
|---|---|---|
| 任务 | 同一材质风格下改变纹理排列、频率、磨损分布 | 结构变化成功且参考材质身份保持 |
| 对照 | 无参考、固定 seed、直接像素/感知拟合、无 mask 检索、区域检索、置信度检索 | 统一渲染次数、参数搜索预算和参考信息量 |
| 程序合法性 | 拓扑约束、参数边界、节点白名单、执行检查 | 成功执行率与图复杂度,不只比较 RGB |
| 物理泛化 | 训练外的光照、相机、环境贴图 | 材质外观在新条件下稳定,排除烘焙光照 |
| 消融 | 区域 mask、步/层门控、检索置信度、renderer feedback | 分别测外观与结构收益,并报告失败样例 |
| 停止规则 | 执行预算耗尽、连续改进低于阈值、合法性失败回退 | 有明确计算上界,保留最优合法候选 |
最小可行路线应先限定合法拓扑,只优化参数;待外观迁移稳定后,再研究拓扑候选生成与执行修复。直接从 MasaCtrl 跳到“可编辑程序图自动生成”,中间缺少表示、编译、节点语义和监督信号四个关键环节。
原论文没有数值表,故本页没有虚构原表;整理表均为解释性重构。全部 13 幅原图均保留编号与解读。附录覆盖状态为“不适用:固定文件无附录”,不是声称读过不存在的 supplement。
当前交付状态:内容生成与静态检查完成;依用户最新要求,浏览器 MathJax、图片实际加载、导航及 1440/760/390 像素布局验收推迟至下载后统一处理。页面小于 20 MB,未发布;新增 Markdown 与原笔记合并候选供下载,原文前缀逐字节保留,不表示已写入任何用户仓库。