来自 Substance Share / Source 的程序化材质库;不是 88 张训练照片,也不是 88 个端到端大模型。
01 · 从照片到可编辑程序,而非一组固定贴图
MATch: Differentiable Material Graphs for Procedural Material Capture 的核心是:把已有的 Substance 材质图转成可微程序,再让照片误差沿着“渲染器 → 材质贴图 → 节点参数”反向传播。它在图库中选图并拟合连续参数,不从零生成节点拓扑,也不承诺复原照片中的每一条裂纹或每一块砖的位置。
共享纹理特征,逐图预测参数,按渲染误差选三个候选,分别优化后择优。
Albedo、Normal、Roughness、Metallicity。输出保留图与参数,可编辑和重新求值。
阅读主线:材料的随机纹理不要求像素对齐 → Gram 统计衡量外观 → 既有图限制可行材质空间 → 连续节点参数可以梯度优化 → 学习型初始化缓解局部极小值,但图与噪声结构仍决定能力上限。
主要依据:正式出版 PDF §1、§3–6、图3;本文所称“正文页”指文章自身页码 196:1–15。用户 PDF 另有一页 ACM 封面,故文件页数为16。

02 · 论文身份、证据边界与旧笔记校正
| 字段 | 核实信息 |
|---|---|
| 作者顺序 | Liang Shi、Beichen Li、Miloš Hašan、Kalyan Sunkavalli、Tamy Boubekeur、Radomir Mech、Wojciech Matusik |
| 发表 | ACM Transactions on Graphics 39(6),Article 196,2020年12月;SIGGRAPH Asia 2020 |
| DOI | 10.1145/3414685.3417781 |
| 身份与版本 | 以用户原始出版 PDF 的 SHA-256 固定版本,不把作者预印版本替换成本地原件。未发现需要填写的 arXiv ID。 |
| 补充材料 | 官方作者站点的独立7页 supplement,已阅读全文;并非在15页正文之外又附有一份完整正文。 |
| 作者机构与通讯 | 第一作者为 MIT CSAIL。原文列出所有作者联系方式,但未明确标出通讯作者;Wojciech Matusik 仅沿用为末位作者候选,状态保持 unverified。 |
| 证据标记 | Paper Verified:论文直接展示/报告;Author Claim:作者解释或推广;Our Interpretation:本精读推导;Research Extension:建议未来验证。 |
保留原笔记,同时明确补充以下限制
- 硬件与耗时:官方补充表是在 Tesla V100 与 Xeon E5-2699v4 上测试 1024² 前向执行。原笔记的“RTX 2080 Ti、4–6 GB、1000步10–20分钟”不能由该表直接支持,不作为本文复现实测值。
- 真实样本数量:正文§6.2写图6有30张照片(27张作者拍摄、3张来自 Aittala 等),并称补充中共44个例子;supplement §4写45个真实优化材质。这是原始资料的计数不一致,本文并列报告,不擅自选一个作为统一测试集规模。
- “精确参数”不是已证明的物理真值:单张照片与 Gram 损失存在歧义,本文输出的是外观相近的程序参数。法线与粗糙度之间可产生补偿,失败案例已经展示这种现象。
- “任意分辨率”是程序重求值能力:论文展示512²优化、2048²输出,不等于无限显存、恢复真实缺失细节,或任何被替换为位图的输入都自动具备无限分辨率。
03 · 为什么图先验比直接预测像素更有吸引力
逐像素 SVBRDF 捕获把输入照片反推为基础色、法线等贴图。它能保留目标纹理的精确位置,但一个像素的亮暗既可能来自底色,也可能来自法线、高光或光照;只有单次闪光观测时,这种分解高度不适定。网络先验可以缓解,却仍可能产生模糊、彩边,换光后暴露不合理的反射。
程序图提供另一类先验:艺术家已写好砖缝、皮革颗粒、颜色和粗糙度如何关联。优化不再在所有贴图像素的任意组合中游走,而是在该程序能生成的子空间中找解。因此输出不仅是图像,更是一套可再次执行、调整和铺贴的材质模型。
困难在于工业图可有上百节点、上千参数,黑盒搜索代价高;直接参数回归还受参数多解与相关性影响。MATch 把这两条路结合:先用网络提供粗解,再通过真实可微执行修正。它不是用神经网络替代所有节点,而是把很多节点的图像运算重写为 PyTorch 运算。
最关键的假设与代价
- 外观统计可代替精确布局。不同随机种子的皮革属于同类材料,不必逐像素相同;但规则图案的具体位置仍可能重要,Gram 统计会牺牲这部分信息。
- 固定图库有足够表达力。“木头图”可能拟合别的外观,因此全库检索比强行语义分组灵活;缺少结构时,多优化参数也不能凭空产生正确拓扑。
- 生成器可暂时固定。一些生成器参数只是改变噪声实例,固定它们能简化系统;另一些参数控制瓷砖数量、散布规律,固定它们就是实质性的表达限制。
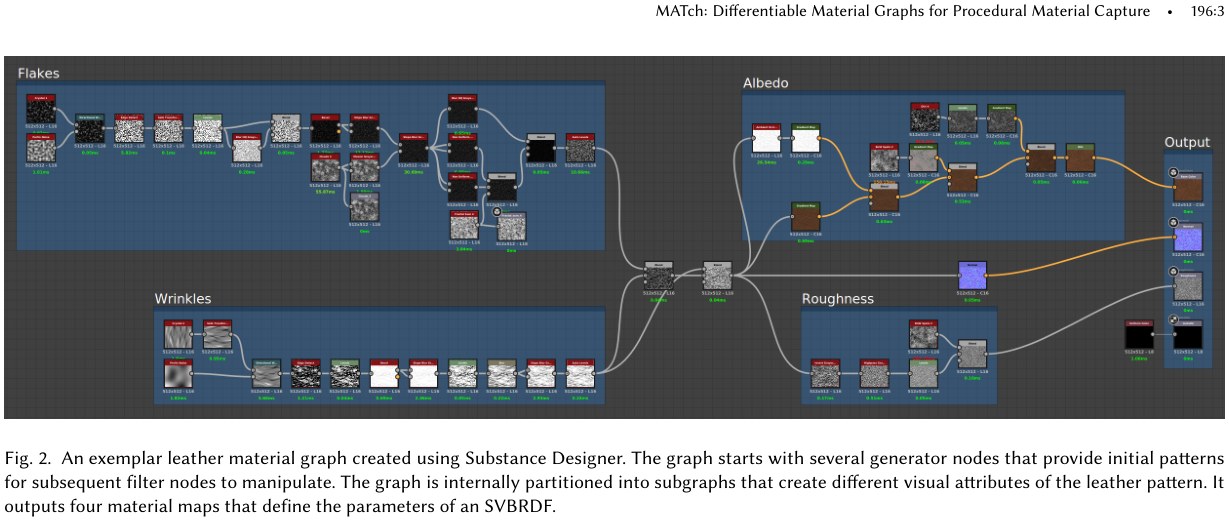
图2的皮革例子有43个 filter 节点、127个节点参数。应把“节点很多”与“需要学习很多神经网络权重”区分:推理优化的是这127个材质控制量,而不是重新训练 VGG。预测器训练则是另一件事。
Paper Verified:正文§1、§2、§3–3.1及图2。对先验与不适定性的解释为 Our Interpretation。
04 · 输入、输出、固定量与真正被优化的对象
| 符号/对象 | 含义 | 是否改变 |
|---|---|---|
| \(I^{\ast}\) | 目标 RGB 材质图像,实验为512×512;通常是平面样本的手机闪光照片 | 固定观测 |
| \(\mathcal{G}=\{G_j\}_{j=1}^{88}\) | 已有材质 DAG 集合;每图包含节点、连线与初始参数 | 从库中选择,不连续修改拓扑 |
| \(\theta_j\in\mathbb{R}^{k_j}\) | 图 \(G_j\) 的可优化连续 filter 参数串接向量 | 逐输入用 Adam 优化 |
| \(z_j\) | 生成器产生的初始噪声/图案及其随机实例 | 预计算,单次拟合保持固定 |
| \(M_{G_j}\) | 图执行器,将参数与输入纹理变成四类 SVBRDF 贴图 | 运算结构固定,参数可导 |
| \(R\) | 已知照明下的可微渲染器;主设置为相机与点光源中心共置 | 论文主问题固定拍摄模型;代码存在可选渲染参数开关,不能混同主设置 |
| \(T_G\) | Gatys 纹理描述子,G 是该描述子的记号,不是图库索引 | VGG-19 特征权重固定 |
| \(f_j\) | 图专属参数预测器,共享 VGG 输入描述子 | 离线训练权重,推理时固定 |
输出:一个选中的既有图、其优化参数和生成的四类贴图。材质保持 procedural 的意义在于可以重新执行图;论文没有输出自回归 graph tokens、SBS拓扑生成器、自然语言推理轨迹或 Agent 工具调用。
\[
(a,n,r,m)=M_G(\theta\mid z),\qquad I=R(M_G(\theta\mid z)).
\]
这是正文式(1)(2)的合并书写并恢复被作者省略的 \(z\)。\(a\) 是基础色,\(n\) 是法线,\(r\) 是粗糙度,\(m\) 是金属性。金属性混合介电与金属响应;supplement 明确使用 Cook–Torrance 微表面 BRDF 与 GGX 法线分布,正文将输出参数化描述为简化 Disney 模型。
Our Interpretation:对固定图,实际问题是 \(\theta^{\ast}=\arg\min_{\theta}\mathcal{L}_G(R(M_G(\theta\mid z)),I^{\ast})\)。对图库则先近似筛选再优化,并非穷尽所有88图的全局最优求解。优化成功也只保证对该目标函数更好,不保证分解出的 SVBRDF 是唯一真实材质。
正文§4.1,式(1)–(3);补充§1。
05 · 损失与梯度:为什么不使用像素对齐
1. Gram 描述子保留通道共现,弱化空间布局
将某层特征重排为 \(F_{\ell}\in\mathbb{R}^{C_{\ell}\times N_{\ell}}\),其中 \(C_{\ell}\) 为通道数、\(N_{\ell}=H_{\ell}W_{\ell}\) 为位置数。下面是解释 Gram 含义的标准展开,归一化需以实际实现为准,而非另造一条论文编号公式:
\[
\Gamma_{\ell}(I)=\frac{F_{\ell}(I)F_{\ell}(I)^{\top}}{N_{\ell}},\qquad
[\Gamma_{\ell}]_{uv}=\frac{1}{N_{\ell}}\sum_{p=1}^{N_{\ell}}F_{\ell,up}F_{\ell,vp}.
\]
相邻或远处位置被聚合到同一通道共现统计,因此颗粒换位置后损失仍可能较小。它不是完全不含结构的颜色直方图:VGG 感受野编码了局部形状;但它不能保证全局空间布局正确。正文描述将五个 pooling 前的特征 Gram 展平串接,输入分辨率变化不改变每层 \(C_{\ell}^2\) 的维数;所读legacy代码实际在pooling输出处取特征,见实现核查。上述除以空间位置数的归一化与该代码一致。
2. 材质参数拟合:正文式(3)
\[
\mathcal{L}_{G}=\left\|T_G(I)-T_G(I^{\ast})\right\|_1.
\]
正文采用 VGG-19、无 batch normalization,max pooling 换成 average pooling,按 ImageNet 均值/方差标准化;同时在512、256、128三个分辨率比较纹理描述子,以覆盖粗细不同的外观变化。这里 VGG 是测量器,不是待拟合的材质。原文把描述子差写为 \(\ell_1\) 范数;优化模板实际对拼接描述子作绝对值均值,二者在固定维数下仅差尺度,但训练和学习率复现时仍应区分。
\[
\frac{\partial\mathcal{L}_G}{\partial\theta}
=\frac{\partial\mathcal{L}_G}{\partial I}
\frac{\partial R}{\partial M}
\frac{\partial M_G}{\partial\theta}.
\]
上述链式关系为 Our Interpretation:必须让误差穿过渲染与整张图,才能知道“该改混合透明度、颜色曲线还是粗糙度”。固定的 VGG 仍要把梯度传回渲染图像;冻结特征网络权重不意味着切断输入梯度。
3. 预测器训练:正文式(4)(5)
\[
\mathcal{L}_{\mathrm{net}}=\lambda_{\theta}\mathcal{L}_{\theta}+
\lambda_g\mathcal{L}_{G},\qquad
\mathcal{L}_{\theta}=\|\theta-\theta^{\ast}\|_1.
\]
训练的 \(\theta^{\ast}\) 是合成时采样的参数真值,而拟合真实照片时并没有真值参数。参数损失让预测先落入合理区域;图像侧正则让预测知道参数组合究竟如何改变外观。只学参数距离可能把外观等价但参数不同的解惩罚得很重,也不能充分识别冗余颜色控制之间的补偿关系。
作者先令 \(\lambda_{\theta}=1,\lambda_g=0\) 训练1000步,再令 \(\lambda_g=0.05\)。解释是预测外观尚很差时,渲染侧正则不够有效。作者还试过图像/贴图逐像素 \(\ell_2\),观察到更模糊;没有给出独立数值消融表,因此这是一项报告的定性观察,不是量化优势幅度。
4. 参数域与“可微”的实际含义
DiffMat 用归一化参数 \(u\in[0,1]\),再按节点的最小/最大值映射到真实控制范围。wrapper 在 forward 前 clamp,避免越界。概念表达为 \(\theta=\theta_{\min}+(\theta_{\max}-\theta_{\min})\operatorname{clamp}(u,0,1)\)。clamp、阈值、离散分支不保证处处平滑;自动微分可用,也不意味着优化没有平台区和局部极小值。
正文§4.1–4.2、§5.1;实现依据 legacy tp_opt.py 的 optimize。新增展开式已标为解释,不冒充论文原公式。
06 · 从选图到收敛的完整执行路线
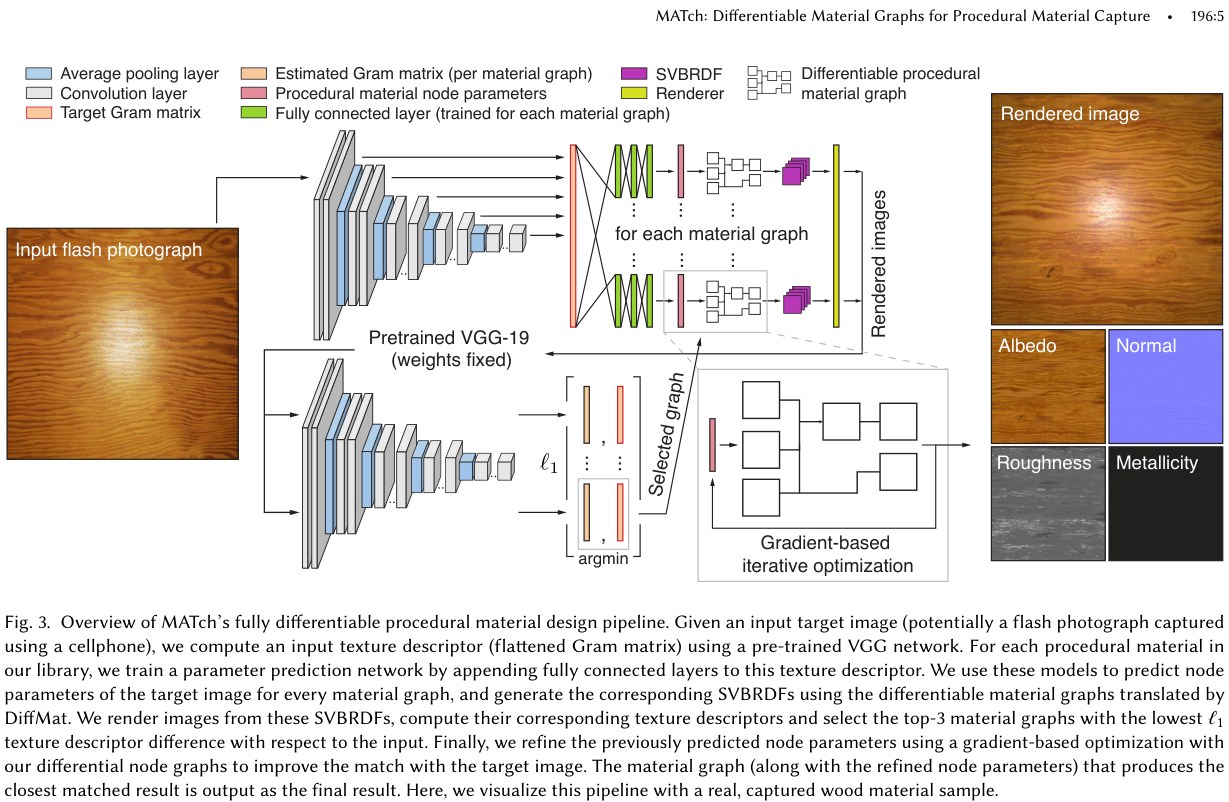
- 准备图库:读取 SBS/XML,解析连接和参数,生成可微 filter 图;生成器图案由 Substance Automation Toolkit 预计算。建立图、参数范围、随机输入与渲染配置的关联。
- 训练图专属预测头:从每张图采样连续参数,执行图并渲染,提取固定 VGG Gram 特征;三层全连接网络预测该图参数,按联合损失更新预测头。
- 目标特征只提取一次:输入照片变成目标描述子,送给各个图的预测头。预测头输出经 sigmoid 约束,再映射至节点范围。
- 真正执行所有候选:用各图预测参数生成四类贴图与图像;比较渲染描述子和目标描述子的 \(\ell_1\) 误差。不能只凭预测参数或语义类别决定胜负。
- 保留三个候选:取初始误差最低的 top-3,用其预测参数初始化;分别通过 Adam、学习率 \(5\times10^{-4}\) 优化连续参数。生成器实例和拓扑不变。
- 再次择优并保留程序:在三个优化结果中选最终误差最低者;输出图和参数,导出材质贴图以供重光照、编辑与高分辨率重求值。
如果用户能人工选合适的图,可以跳过耗时的预测器训练,直接从艺术家的默认参数优化。论文图6特意使用网络选图、默认参数起步,证明优化本身的能力;图7才比较默认初始化与预测初始化的差别。不能把所有展示结果一律写成“网络预测后优化”。
\[
s_j=\|T_G(R(M_{G_j}(f_j(T_G(I^{\ast}))\mid z_j)))-T_G(I^{\ast})\|_1,
\quad \mathcal{C}=\operatorname{Top3Smallest}_j(s_j).
\]
此式为流程的紧凑重述,不是论文新增公式。筛选是启发式近似:一个初始预测差的图可能被淘汰,即便充分优化后它会更好;原文没有 top-k 召回率曲线或对“3最优”的系统消融。
停止条件:论文没有为全部结果规定一个统一自适应停止阈值。图7展示至1000或2000步;legacy优化模板默认1000步。不要由此推断所有照片都恰好跑1000步,或每个候选固定同样耗时。
07 · DiffMat:自动翻译并不等于无损支持所有节点
节点、连接与程序顺序
材质是 DAG:generator 从无到有产生噪声/图案,filter 消费一个或多个图像。很多 filter 对应卷积、采样、逐像素函数或混合,能由 PyTorch 实现。无状态函数模拟 torch.nn.functional;wrapper 保存待优化参数,图模块聚合所有节点参数,forward 按依赖顺序执行。
| 翻译步骤(正文§5.7) | 实际动作 | 复现应检查什么 |
|---|---|---|
| 图复制 | 保存 exposed 参数默认值,复制连线与节点;无输入节点视为 generator,转为预计算位图输入 | 位图路径、种子、分辨率、许可证与缺失文件 |
| 参数转换 | 按节点类型转换参数;动态参数通过 value-processor 和默认 exposed 值求初值 | 范围、单位、动态绑定是否仍保留 |
| 数据流裁剪 | 只保留通向 albedo、normal、roughness、metallicity 的相关子图;执行后向与前向 BFS 去冗余 | 其他输出如 displacement/AO 并非默认优化对象 |
| 程序生成 | 拓扑排序,按数据依赖生成 Python 调用序列 | 输出是否与 Substance 对应,而不是仅仅能运行 |
覆盖清单及例外
论文报告21种 atomic 节点、110种常用 non-atomic 节点(Substance 当时有150余种)。附录给出全部列表。atomic 名称包括 Blend、Blur、Channel Shuffle、Curve、Directional Blur、Directional Warp、Distance、Emboss、FX-Map、Gradient (Dynamic)、Gradient Map、Grayscale Conversion、HSL、Levels、Normal、Pixel Processor、Sharpen、Transformation 2D、Uniform Color、Value Processor、Warp。
non-atomic 的110项覆盖颜色/直方图变换、不同模糊、法线混合与曲率、极坐标变换、tile修补、变形和多种blend。彩色/灰度版本常分别计数,所以110不是110种彼此独立的学习模块,也不是保证所有 Substance 节点都可转换。
- FX-map 是有限实现:支持某些 tiling 用法,不是完整 FX-map。tile generator、splatter 等若处在中间位置,不能普遍翻译;若作图输入可预计算。
- Pixel/Value Processor:执行已有数学函数,但在论文方案中相应参数不可优化,不是自动学习任意 shader 程序。
- 生成器与位图依赖:Bitmap、SVG、Text 和其他生成器输出都可成为预计算输入;这是明确系统依赖,不能描述成纯粹无需外部工具的端到端图生成。
- 未实现 filter 会变成 passthrough:正文公开说明此降级。它可能让程序仍可执行,却丢失节点效果。因此自动翻译后必须逐图核对材质输出,不能把“无报错”当成语义等价证明。
三种参数空间
- 只优化 exposed 参数:保留艺术家语义控制,但表达空间较窄。
- 保留 exposed 绑定,同时优化其余独立节点参数:兼顾编辑性与自由度。
- 移除相关 value-processor 约束,自由优化全部节点参数:空间最大,原有高层控制含义可能不再完整。
Paper Verified:正文§5.1–5.7;补充§2。原文“全部atomic”的数量必须与 FX-map 等能力限制一起阅读。
08 · 训练、推理和数据:足够具体,也不补造缺失值
| 项目 | 论文配置 | 边界 |
|---|---|---|
| 骨干 | ImageNet预训练 VGG-19,无BN,average pooling替换max pooling | 共享、冻结;不是LLM/VLM,没有prompt、temperature或token解码 |
| 预测头 | 输入长度 \(l\),三层权重尺寸 \(l\times3k,\ 3k\times3k,\ 3k\times k\),层间ReLU,末端sigmoid | 每图一个头;源码存在宽度上限和LeakyReLU差异,见后节 |
| 合成数据 | 每步采样 \(\theta^{\ast}\),执行材质图、渲染 \(I^{\ast}\),形成图像-参数对 | 无需存储完整合成图集;不等于没有图库、生成器位图或ImageNet预训练数据 |
| 训练优化器 | Adam;学习率 \(10^{-4}\);time-based衰减率0.97 | 正文没有完整scheduler方程、warmup、weight decay、精度与梯度累积说明 |
| 训练损失 | 参数 \(\ell_1\)+纹理 \(\ell_1\);1000步后将纹理权重从0改为0.05 | 参数权重始终1;原文无统一公开随机分布/采样范围表 |
| 训练量 | 一般10000步、batch size 5足够;复杂图可能不同 | 按此名义配置约50000合成样本呈现/图是算术换算,不是固定独立样本数据集 |
| 推理拟合 | 多尺度512/256/128;Adam学习率 \(5\times10^{-4}\),top-3分别优化 | 无统一训练/验证/测试划分,无全图统一迭代数和端到端延迟表 |
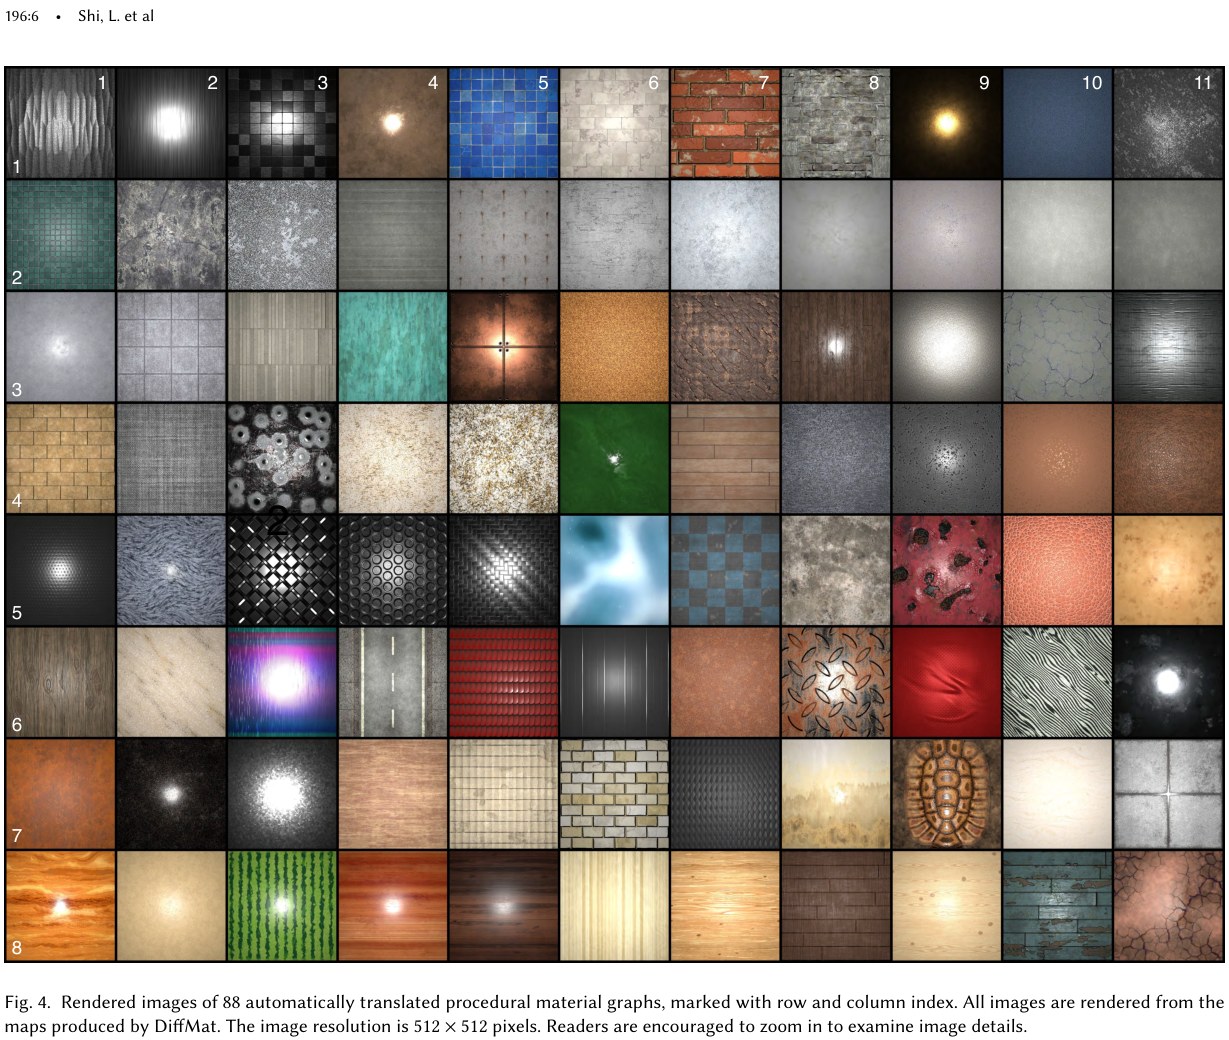
| 图库 | 88个图;平均65节点、335连续参数;最大图超过200节点、2650参数 | 88个是已选可转换集合,不能据此计算对整个Substance库的转换成功率 |
| 参数冻结 | 拓扑、离散参数、生成器实例固定;连续filter可调 | 不是完全联合离散-连续优化 |
训练图和测试图像来自同一既有图库时,测试是在已知程序族中反演参数,不等同于对从未见过的新拓扑进行零样本泛化。加入一张新图不需要重训已有图头,但需要为新图准备翻译与预测器;人工选图后直接优化仍可免去该训练成本。
09 · 结果究竟证明了什么
合成恢复:分开比较预测与优化
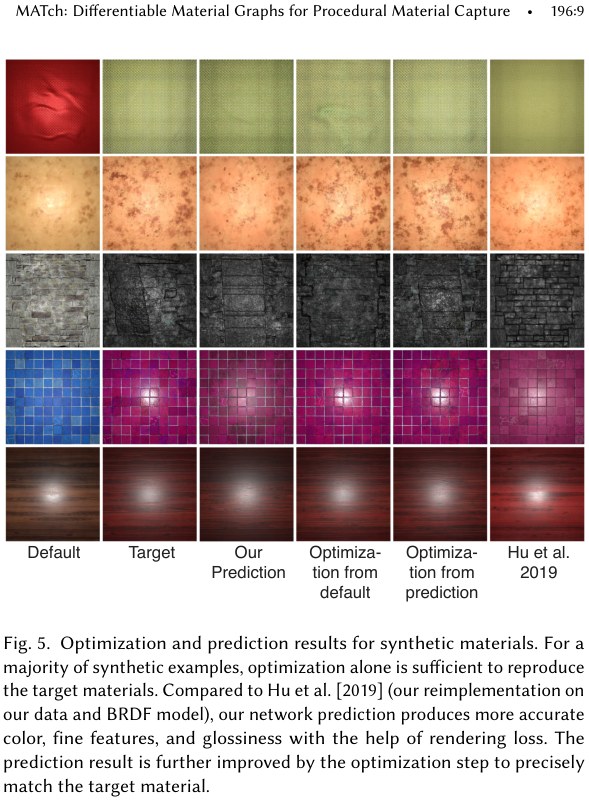
图5比较默认图、目标、本文直接预测、默认起点优化、预测起点优化、Hu等2019。五种材质例子中,默认起点往往已可拟合;直接预测主要恢复粗外观,优化补上细节与光泽。黑砖等较难例子更依赖好初始化。作者有意使目标与恢复使用不同噪声图案,以验证统计外观匹配而不是像素复制。
真实照片:同一张图可覆盖不同语义材料
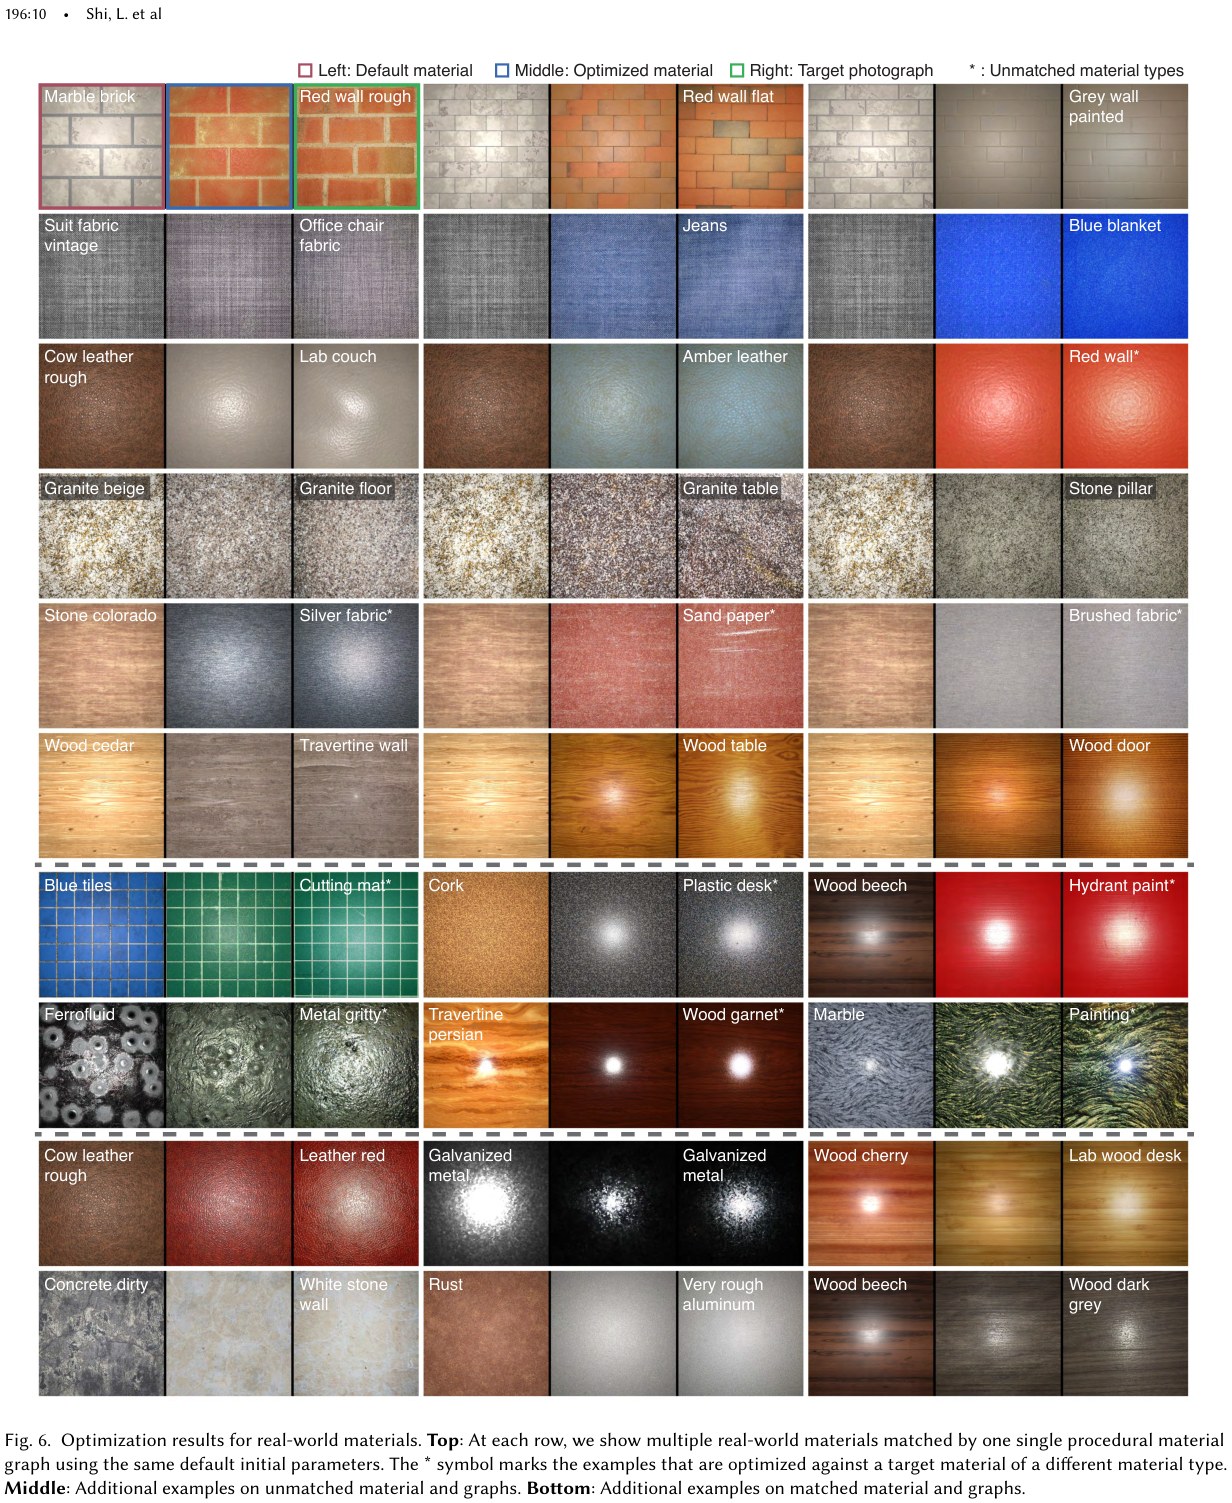
图6在相同默认初始化上拟合多种真实材料,并展示不同语义类型之间的匹配,例如某些石材图也能逼近织物或砂纸外观。它证明现有程序空间的可塑性,不证明系统理解材质语义或真的恢复了目标制造过程。
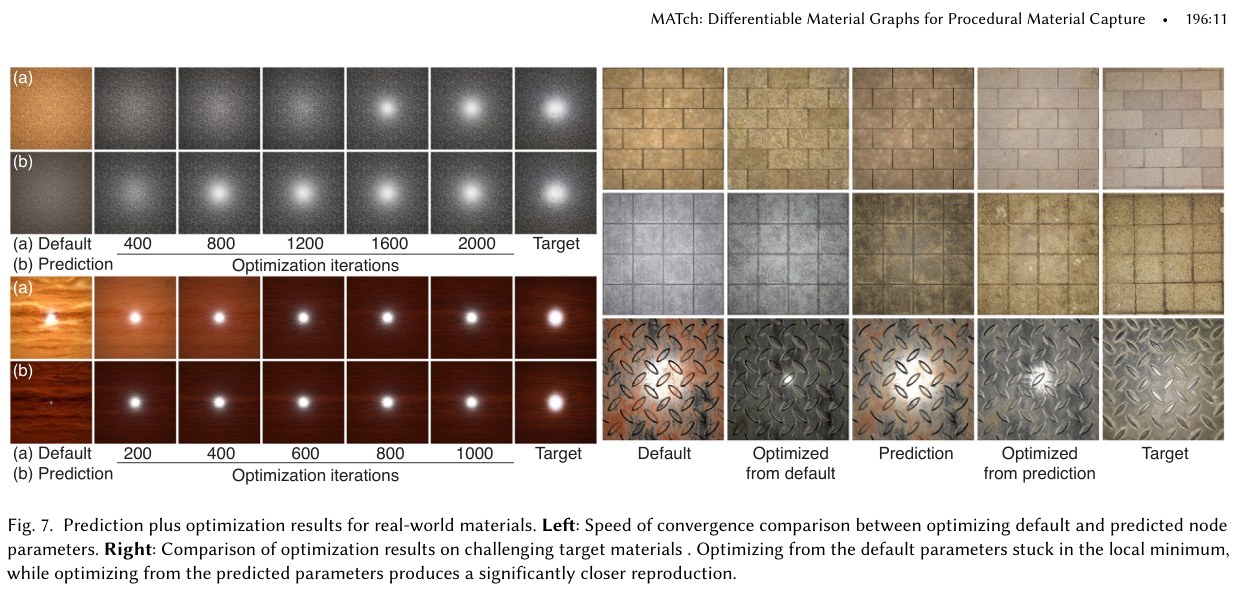
图7左侧展示预测初始化更快达到合适外观,作者报告平均所需迭代减少超过一半;右侧展示默认起点落入局部极小值而预测起点更接近目标。论文未提供汇总样本数、标准差和收敛阈值表,因此不把这句话转换成稳定的“2倍端到端加速”承诺,预测器训练成本也未包含在内。
对比范围与公平性
| 对照 | 比较设置 | 观察/权衡 |
|---|---|---|
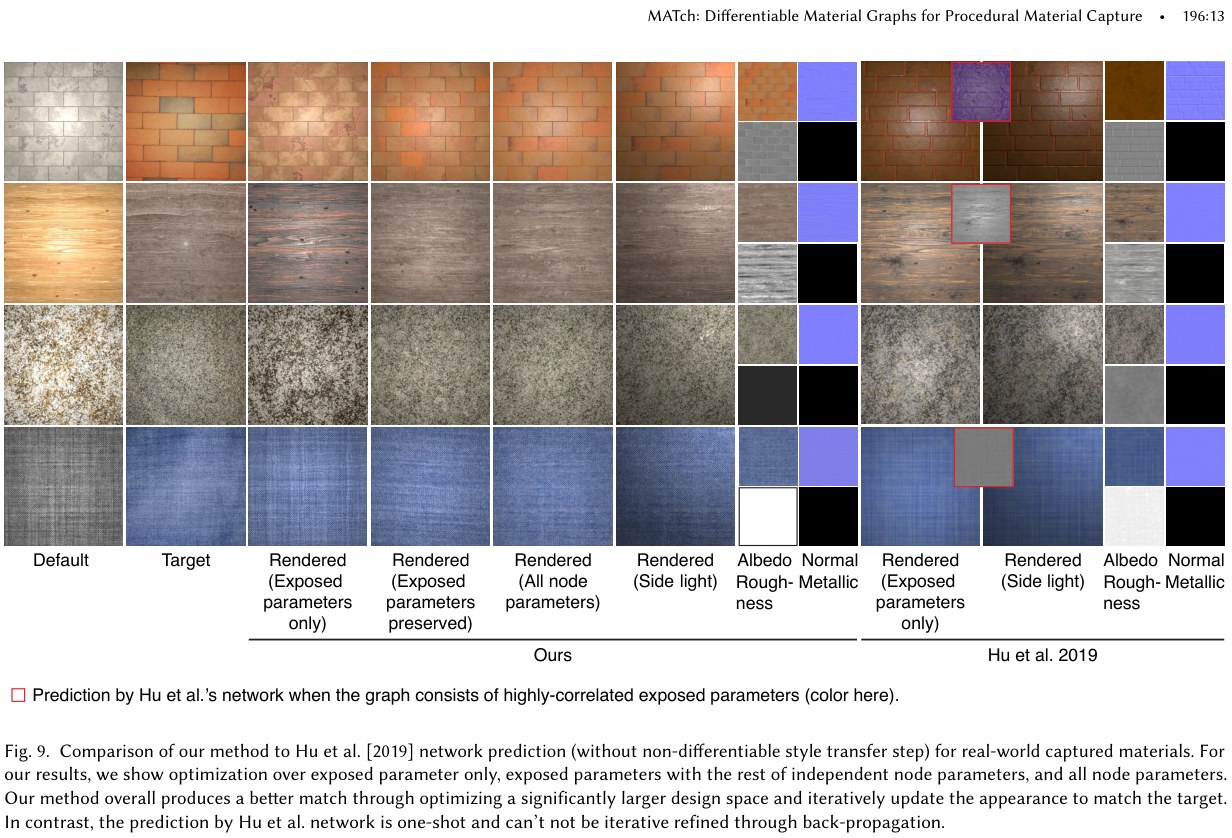
| Hu et al. 2019 | 作者在本文图库、照明及BRDF设置上重训其AlexNet参数网络;沿用只预测exposed参数,无exposed则预测全部参数 | 图5/9本文优化外观更接近;但同时改变了模型、参数空间、损失和测试时预算,不能把全部提升只归给可微库 |
| Hu的style-transfer后处理 | 图9明确不包含其不可微style-transfer步骤 | 保留程序化输出的比较有意义,但不能宣传为对其完整所有后处理链的无条件击败 |
| Deschaintre et al. 2018 | 单图SVBRDF直接预测,对比顶光、侧光和材质贴图 | 像素布局更贴近目标;论文示例出现模糊/彩边;本文图先验更清晰但布局不完全一致 |
| Gao et al. 2019 | 自编码器latent内优化的逐像素材质捕获 | 同样存在逐像素匹配与程序可编辑性/可铺贴性间的目标差异 |
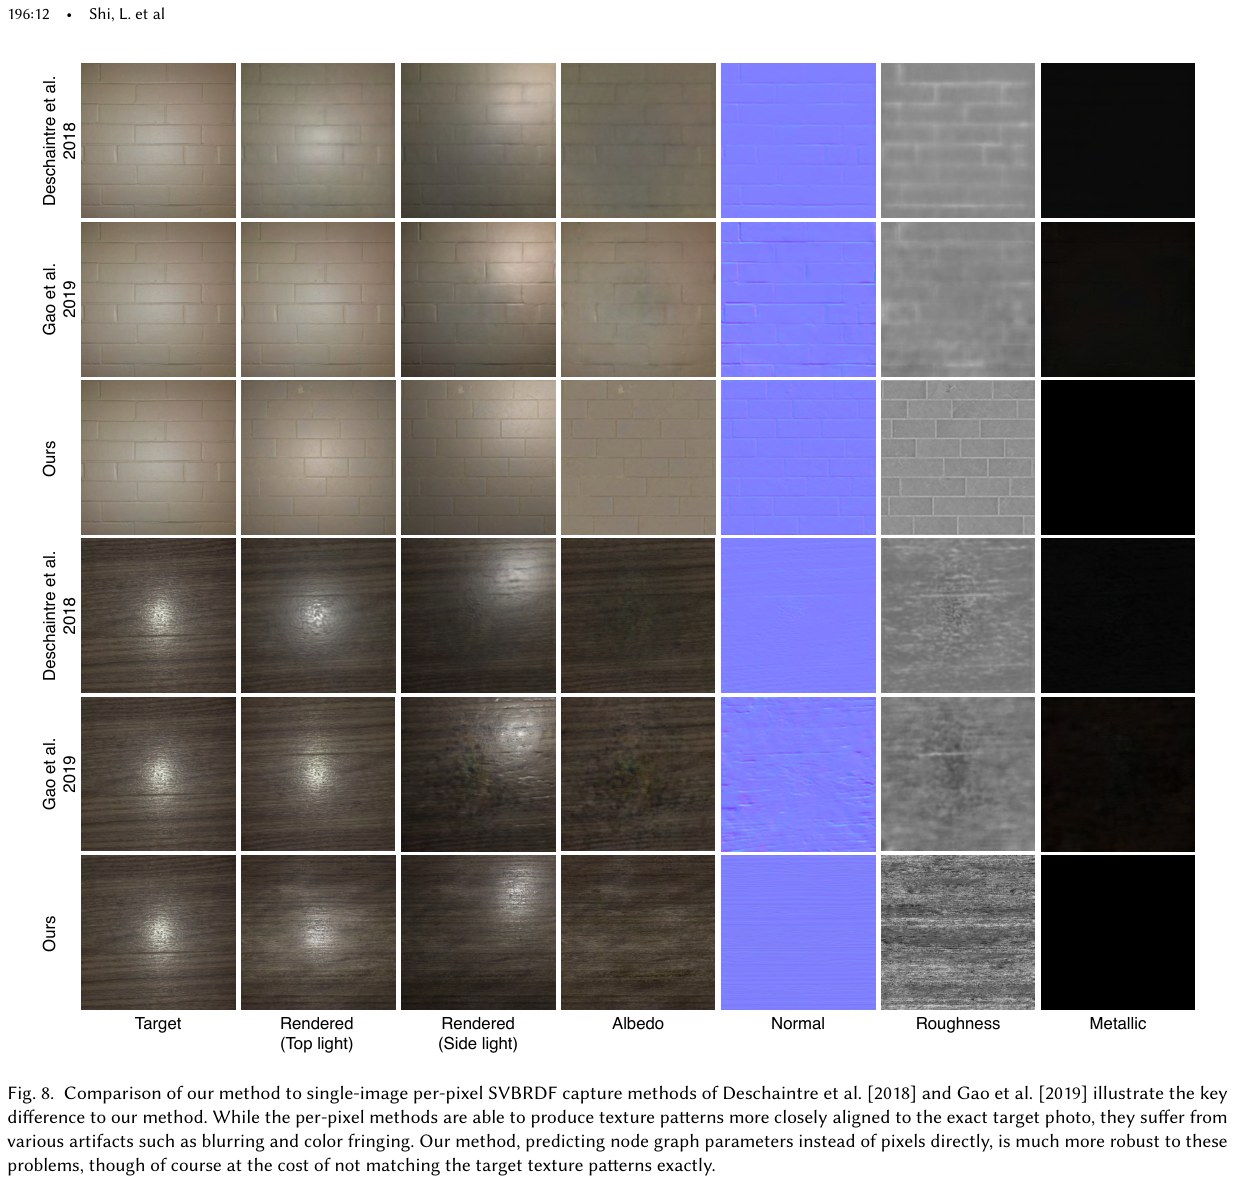
重要证据空白:正文以图像对比为主,没有一张完整的“所有方法×PSNR/LPIPS/用户偏好/耗时”主结果表,也没有大规模用户研究或置信区间。本文不会虚构这类数值。损失下降和图示质量是支持证据,不能自动变成物理参数精度的证明。
正文§6.1–6.3、图5–9;作者报告与本文评估分开阅读。
10 · 组件对照、编辑性与失败机制
| 组件/变量 | 论文证据 | 可支持的结论 | 仍未证明 |
|---|---|---|---|
| 默认 vs 预测初始化 | 图5、7 | 预测能缩短某些优化并避开部分局部极小值 | 全库所有输入的稳定收益;3个候选是否最合适 |
| 直接预测 vs 预测+优化 | 图5、7、9 | 执行反馈能修正一次回归的粗解 | 相同时间预算下与更强预测器的优势幅度 |
| exposed only / preserved / all | 图9 | 更大参数空间改善匹配;保留exposed并调独立参数可兼顾编辑性 | 语义控制质量的系统用户评测 |
| 参数损失 + 风格损失 | 正文§4.2及与Hu比较的解释 | 作者认为图像正则解释了更好外观;可微图使它可用 | 单独只变损失、其他设置相同的数值因果消融 |
| 多尺度描述子 | 正文§4.1采用3尺度 | 作者报告更好跨尺度感知匹配 | 各尺度贡献及成本曲线 |
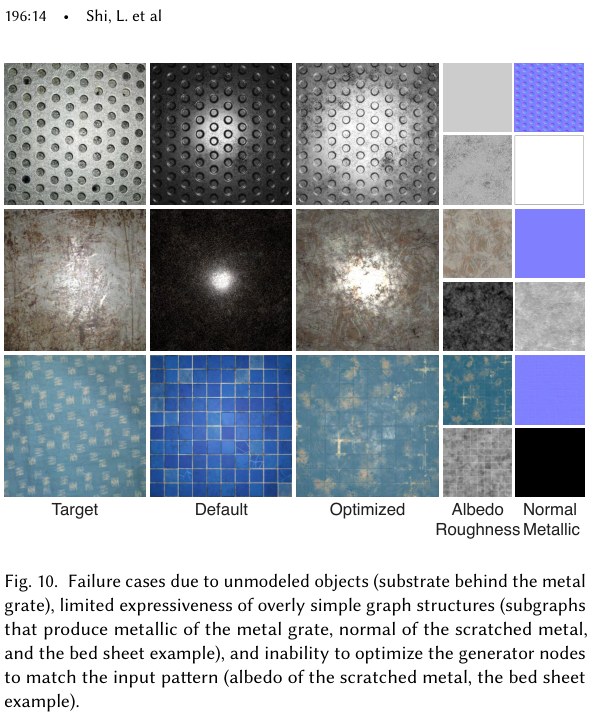
图10失败有三类,不能一概归为“没优化好”:金属格栅背后的底层未建模,属于表示缺失;划痕/沟槽细度超出法线子图能力,属于结构容量不足;床单散落方块仍保留规则tile布局,属于生成器位置不可调。图6木头沟槽被粗糙度噪声近似,也说明单张图像外观相近不代表贴图分工正确。
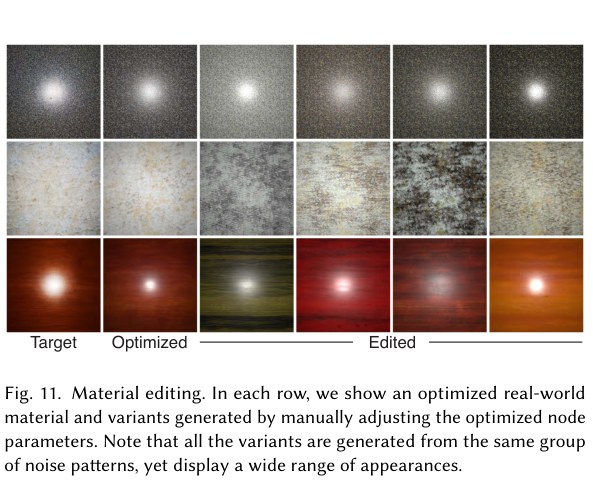
图11从同一组噪声出发改变参数得到多个外观。它展示“恢复的模型可继续创作”,不是每种编辑都保持原材料物理真实性。若自由优化全部底层参数,原来的exposed控制可能失去艺术家预设的关联,因此 preserved 模式是实用折中。

图12用512²目标拟合后以2048²重求值,表现出更锐利的程序细节。这与把低分辨率位图简单插值不同;不过新细节由程序先验生成,不是已观测物理细节的独立测量。
11 · 唯一量化性能表:完整重建,不混淆成本口径
以下为补充 Table 1全部8行。测量分辨率1024×1024,GPU NVIDIA Tesla V100,CPU Intel Xeon E5-2699v4(2.2 GHz,55 MB cache)。这是材质图前向执行,不是预测器训练、完整VGG风格优化迭代,也不是整套top-3捕获时间。
| 图名(正文图4行,列) | 节点数 | 参数数 | PyTorch保留内存 | GPU总内存 | 前向时间 |
|---|---|---|---|---|---|
| ceramic_tiles (2,1) | 42 | 128 | 450 MiB | 1449 MiB | 0.055 s |
| zombie_skin* (8,11) | 124 | 383 | 1108 MiB | 2099 MiB | 0.166 s |
| silk_red (6,9) | 51 | 250 | 506 MiB | 1505 MiB | 0.212 s |
| copper_oxydized (3,4) | 114 | 307 | 938 MiB | 1939 MiB | 0.246 s |
| bricks_gray* (1,8) | 201 | 923 | 1704 MiB | 2701 MiB | 0.318 s |
| wood_cherry* (8,4) | 124 | 925 | 1038 MiB | 2027 MiB | 0.389 s |
| wooden_planks (8,10) | 195 | 2224 | 1438 MiB | 2511 MiB | 1.291 s |
| travertine_persian (8,1) | 96 | 511 | 822 MiB | 1823 MiB | 1.295 s |
星号表示包含alpha通道计算。作者称 forward-backward 的时间和内存约为前向的2倍,这是近似报告,不能把GPU总内存中的固定开销也无条件线性加倍。解析与程序生成通常不到1秒,生成器预计算另计。
Our Interpretation:表中最慢/最快前向时间比约23.55;96节点的travertine比201节点的bricks慢约4.07倍。由此可见,仅统计节点数量或参数数量无法预测执行成本;warp、blur和复杂compound节点的算子代价不同。最大2650参数的图库陈述也不意味着此表中一定包含该最大图,表内最高为2224。
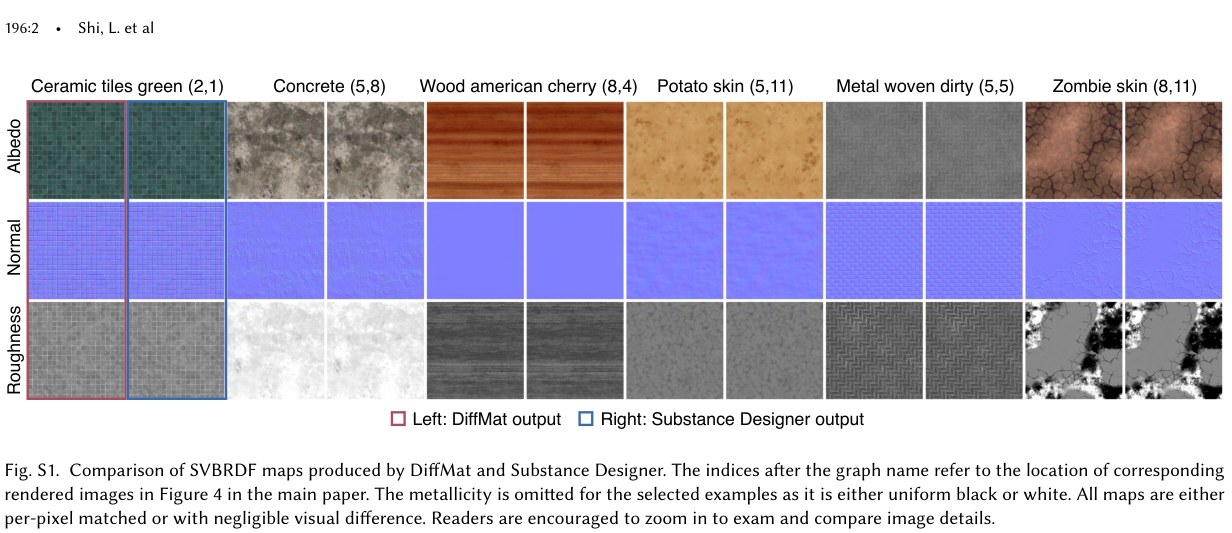
补充图S1对比 DiffMat 与 Substance 的基础色、法线和粗糙度;所选材质金属性为全黑/全白而未画出。作者称atomic实现除Emboss微小差异外逐像素一致,并将这种一致性延伸至组合节点。正文对未支持filter的passthrough策略仍存在,不能将所测节点的精度泛化为任意SBS文档的无损转换。
补充§1、Table 1。本表数字为原表转录;比值为本精读算术计算。
12 · Paper vs. Implementation:不能照默认命令就声称复现
本节检查官方 diffmat-legacy 的只读源码,没有安装或运行材质训练。仓库README称其为legacy并建议使用维护中的新版;新版属于后续实现,不能不加区分地把新功能归给2020论文。
| 位置 | 论文描述 | 读取到的legacy实现 | 复现含义 |
|---|---|---|---|
| model.py / build_fc_after_td | 隐藏宽度3k,ReLU | 宽度 min(3k,960),LeakyReLU负斜率0.2 | 结构并非逐字相同;必须保存实际配置 |
| predictor模板 | 一般10000步,1000步后启用0.05风格权重 | 默认150 epochs,每epoch100次,switch_epoch=100,img_loss_weight=0.1 | 默认次数/切换时间/权重不等于正文;配置可覆盖,不声称论文用错 |
| 训练batch | batch size 5 | param_batch=5,td_batch=1 | 含渲染损失阶段默认改变batch;复现需按阶段记录 |
| 参数损失 | \(\ell_1\) | criterion仅在 --use_l1 时选L1,否则MSE | 不能只用README的 --fix_vgg 就默认满足论文完整训练设置 |
| 风格损失开关 | 后半阶段启用 | 达到switch_epoch自动启用;--use_td_loss可提前启用 | 默认不是永远关闭,但切换点不同;应检查载入配置后的实际值 |
| 学习率衰减 | 文字报告time-based衰减率0.97 | train实际更新为初始lr除以(1+epoch×lr_decay_div_multi),默认乘子0.5;lr_decay_exp=0.97虽被解析但不用于该更新 | 应核对执行路径而非只看参数声明 |
| descriptor.py特征位置 | 五个pooling前的特征图 | hook索引4、9、18、27并加最终输出;对应average pooling后的表示 | 报告实际特征位置,避免把实现差异藏在“同为VGG”中 |
| 优化模板 optimize | Adam,学习率0.0005 | 默认选Adam、同学习率;目标实际为描述子绝对误差均值;默认1000步 | 这部分与主思路吻合;默认迭代数不代表所有论文图 |
| 生成器资产 | SAT预计算 | README要求Substance Automation Toolkit,转换后保存random_seeds纹理 | 需工具/资产依赖与授权,不是纯代码单独就能复现所有88图 |
“只有三层”不意味着参数量很小
源码的单尺度纹理描述子长度为610304;隐藏层取 min(3k,960)。如果 \(k=128\),第一层宽度384,仅第一层权重就有234356736个,FP32约937.4 MB(十进制;不含bias、后两层、梯度、Adam状态和VGG)。这是按源码尺寸的静态估算,不是本次运行的显存实测。作者所谓紧凑应放在其比较背景下理解,不能仅凭“三层MLP”称其为极轻量网络。
相反,测试时只优化一张已选图的128个材质参数,确实与训练这个预测头的资源需求完全不同。因此“游戏显卡可容纳材质图”不能直接替代“88个预测器一起训练/常驻显存”的论证。
model.py · tp_predictor.py · tp_opt.py;读取日期2026-09-30,文件哈希随证据包保存。未完成所有节点实现与全部训练配置的逐行审计。
13 · 补充材料阅读地图
- 补充§1,第1页:88图的组成、平均/最大规模、翻译耗时、Cook–Torrance/GGX、逐像素一致性说明、完整性能表。它支撑系统工程能力,不直接量化捕获正确率。
- 补充§2,第2–4页:21atomic与110non-atomic完整功能清单。它让读者定位具体算子覆盖,不能绕过正文限定的FX-map/processor可优化性。
- 补充§3与图S2,第4–5页:额外4个合成材质,列出默认、目标、优化及四类贴图;有exposed则使用preserved模式,否则全部参数模式。
- 补充§4与图S3/S4,第4、6、7页:输入照片、优化渲染和四类贴图的完整图集。该节文字计45个,与正文44不一致,已保留此差异。
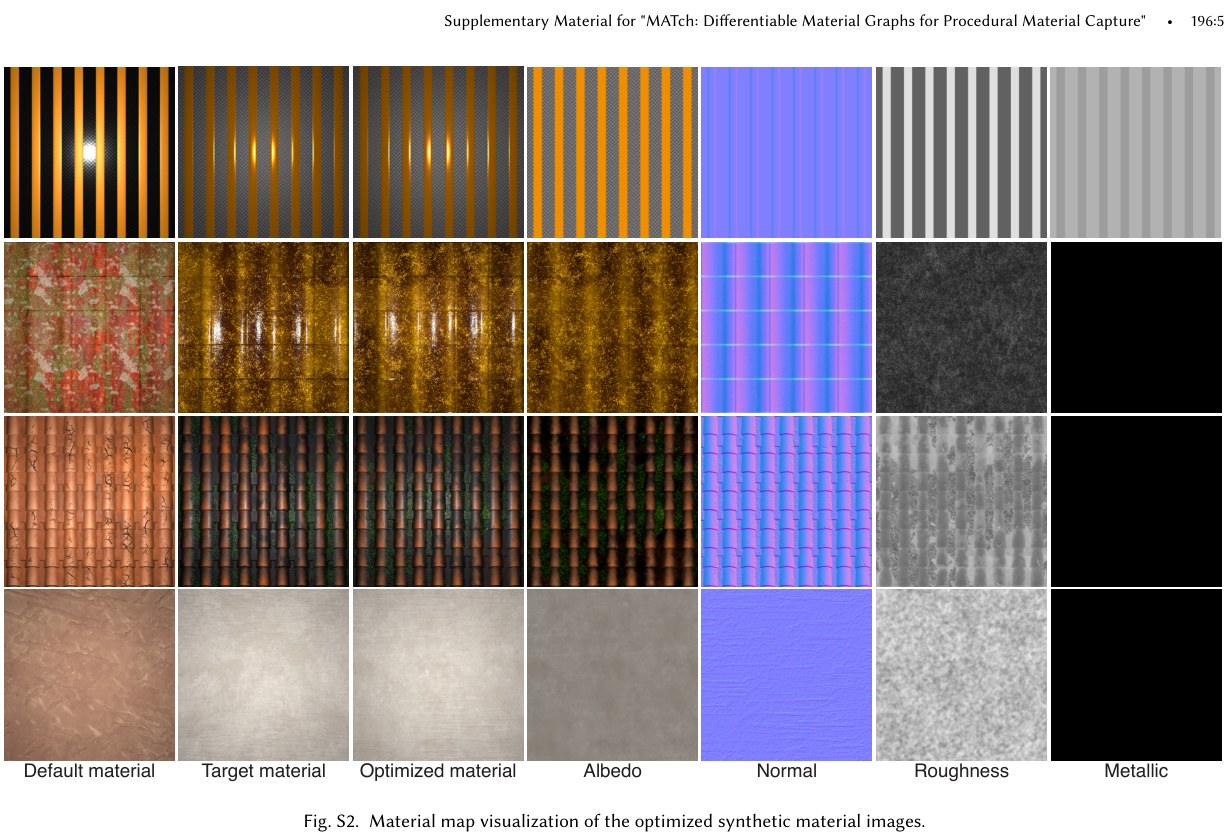
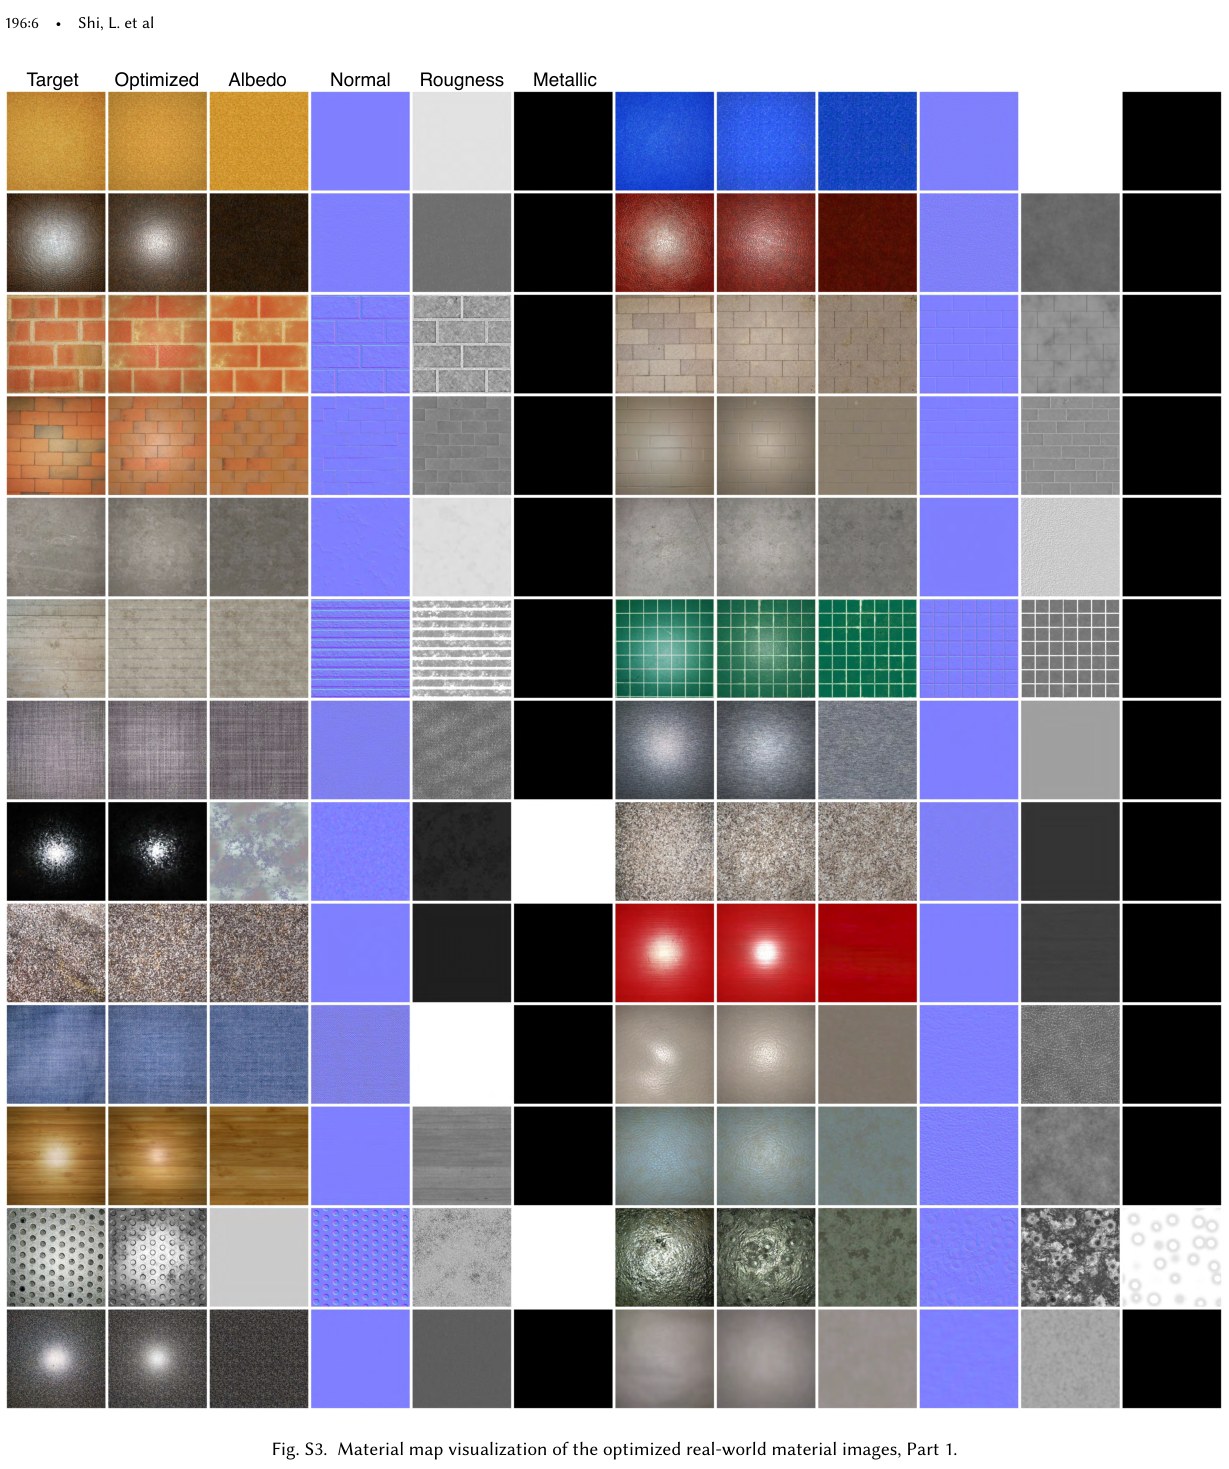
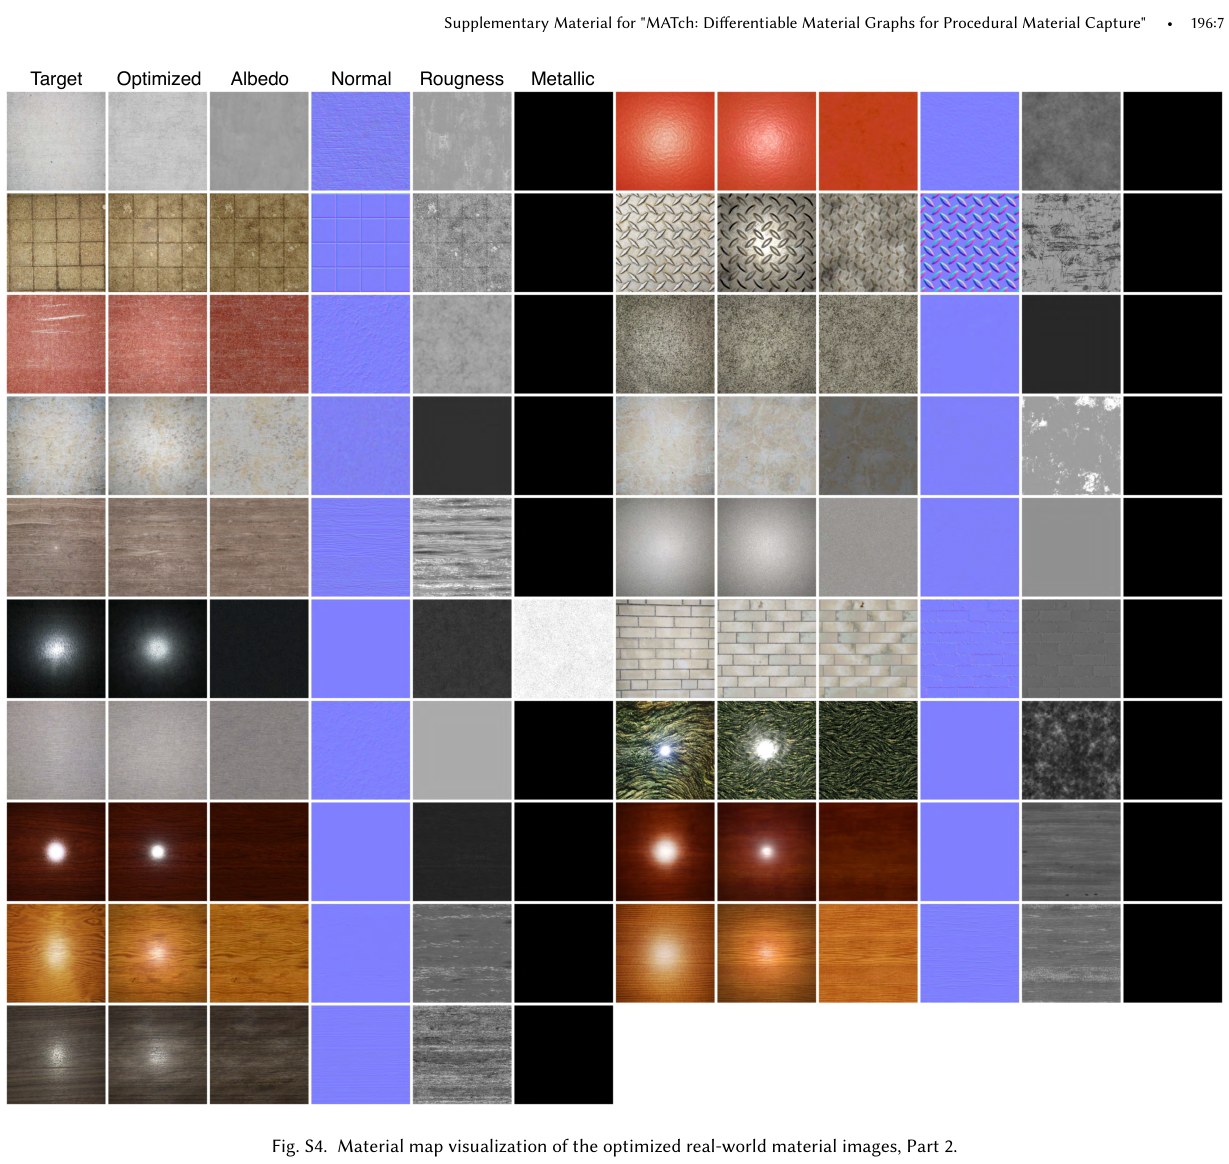
阅读这些图应同时看渲染和各通道:若高光靠错误的粗糙度纹理补偿法线结构,目标视角仍可像,却可能在新的光照下失效。补充提供观察这种分解的机会;它没有提供材质通道物理真值的定量误差。
14 · Reviewer:贡献成立在哪里,证据还欠什么
Strengths
- 可执行表示选择正确。输出图+参数保留了工业流程中的编辑、平铺、分辨率重求值,而不是只追求一张好看的重建图片。
- 优化与学习的分工合理。学习提供初始化/候选,可微执行修正网络回归;不要求端到端预测器解决所有细节。
- 工程贡献真实。自动XML翻译、依赖分析、参数wrapper和大量算子覆盖,把简短手写程序推广到生产规模图;原始节点的复用有实际意义。
- 公开局限较具体。作者展示不匹配生成器、缺失底层、法线细度不足等失败,不只展示成功材质。
Weaknesses 与复现风险
- 结果以定性为主。没有标准统一数值表、统计不确定性、随机重启方差;“更准确”在此主要是展示图的感知比较。
- 库先验与搜索覆盖未被充分分离。没有系统对比图库大小、top-k、候选初始化误差与最终最佳图召回。
- 单图分解不可辨识。高光、法线、粗糙度可互相补偿;缺少新视角/新光照实拍真值的广泛验证。
- 自动翻译可能静默失真。passthrough、有限FX-map、固定processor都要求显式unsupported报告,否则输出程序虽然可执行却偏离源图。
- 预测器开销被“浅层”叙述掩盖。高维Gram使首层很大;应报告逐图参数量、训练显存、总训练成本和检索延迟。
- 依赖与版本差异。资产许可证、SAT、旧软件版本、节点行为、默认配置与论文差异都会影响可复现性。
最有价值的补充实验
固定同一图库与测试照片,比较默认/随机/学习初始化,在相同总渲染次数下评价;对每个输入记录所有候选的优化后排名,画top-k召回与成本曲线;用多个真实光位检查泛化;报告unsupported节点数量、源图/翻译图差值与每类失败率。这样能区分“表示好”“初始化好”和“多花了优化预算”。
15 · 对 Procedural Material Generation 的研究启发
Research Extension,以下均不是MATch已经完成的实验。MATch适合作为可执行优化内核,但不能单独承担开放域图生成。对于从文本/参考图像生成新材质图的研究,可借用其边界来安排模块与评价。
A. 离散拓扑外循环 + 连续参数内循环
外层提出节点替换、连线、生成器类型或模块组合;每个候选先做类型、无环性、资源上限和可执行性检查,再交给内层DiffMat参数优化。比较优化后的误差而非初始渲染,可降低因参数没调好而错杀拓扑的风险。必须计入每候选的渲染预算,避免搜索方法靠更多计算获得不公平优势。
B. 将失败原因变成结构修复信号
当参数优化停滞时,不要无限迭代。用多光照残差、各通道中间预览与节点梯度诊断区分颜色误差、法线容量不足、生成器布局不对、缺少底层。若是图10式底层缺失,应增加层或子图;若只是色调,可继续连续优化。这比让模型每次重写整图更可控。
C. 保留可编辑性作为显式目标
同一目标照片可能由大量参数组合实现。可以同时优化视觉误差、图复杂度、exposed控制的语义一致性和对seed的稳定性。设计held-out seed与新光位测试,检查编辑滑块是否仍有可预期效果;不要只把一个目标图上的最低Gram损失当唯一奖励。
D. 更廉价的候选检索与参数预测
高维Gram直接接巨大全连接层是明显优化点。可尝试压缩描述子、共享预测网络、图结构条件化与低秩预测头;但必须保留足够的细纹理和高光信息。消融应同时报告首层参数量、top-k召回、最终材质质量和每张新增图的训练成本。
一个可检验的研究问题
在固定执行预算下,“识别结构性失败后局部修图”能否比“扩大top-k并反复调参数”更快恢复图10类型的目标?最小实验应含有已知缺失子图的合成目标与真实目标两部分,固定输入照明与可用节点词表,报告成功率、视觉误差、新光照误差、程序规模和实际执行次数。这样研究目标由已有失败证据推出,而不把设想冒充结果。
16 · 实际复现路线与交付检查
- 先选单个可转换图。记录源SBS、工具版本、节点列表、生成器种子和输出范围;先比较Substance与DiffMat默认四通道,确认未被passthrough破坏。
- 先运行固定图优化。使用共置闪光设置和512²目标,建立默认初始化、目标渲染与loss曲线;保存参数、噪声和渲染配置。此步无需训练全部预测器。
- 建立合成可控测试。在已知参数上生成目标,用另一噪声实例拟合;分别检查外观与通道误差,理解不对齐的损失行为。
- 再训练预测器。明确冻结VGG,核对L1/风格开关、阶段batch、迭代数与loss权重;代码默认不能代替论文配置。统计模型参数量与GPU占用。
- 最后做图库选择。逐图记录初始与优化后分数;比较人工选图、自动top-3和更多候选,并将训练成本与测试时成本分别报告。
- 检查最终程序能力。重光照、2048²重求值、平铺、exposed编辑、换seed;避免仅验收一张目标视角渲染。
本次交付状态:原始PDF与附录已全文读取;真实图像来自官方图源或原PDF裁切,表格已结构化转录;HTML是单文件并内嵌MathJax 3。数学源、HTML结构、体积、图片数据与原笔记前缀进行静态检查。按本批次要求,浏览器DOM、图片真实加载、MathJax实际排版、导航点击与1440/760/390px布局检查均deferred,未宣称通过。未执行训练、未接入用户笔记库、未发布网站。
17 · 一手来源与定位
- 正式出版记录与DOI;本次主文为用户提供的出版PDF,SHA-256:6e480ecf3cba94620d3662b8e9a1dcdc85c24bcd5eeb83e65de57aa081384e5d。
- MATch官方项目页:题名、作者、SIGGRAPH Asia 2020、论文/补充/代码入口。
- 官方7页补充材料:表1在第1页,节点清单第2–4页,S1第2页,S2第5页,S3/S4第6–7页;SHA-256:0ce1c0d4059bb710bb6d6d4469826fbcc692ab1fe5883bfc502535f60933fab4。
- 官方legacy源码:README、model.py、descriptor.py、tp_predictor.py、tp_opt.py只读核查;本次未运行其训练/优化。
- Adobe Research论文页:交叉核对作者与发表身份。
正文图1–12均标出原编号;补充S1–S4同样保留原编号。裁切图署名 Shi et al., 2020,仅用于本次个人精读。外部主图仍需联网加载;其他裁切图内嵌以维持单文件使用。详细取源、文件哈希与静态验收见配套证据记录。