输入
一个材质参考图、目标图,以及从目标提取/提供的 mask、深度和灰度光照条件
Images Are All You Need for Material Transfer via Diffusion Transformer|统一视觉序列、Cross-Bias 与深度 LoRA
Nisha Huang · Henglin Liu · Yizhou Lin · Kaer Huang · Chubin Chen · Jie Guo · Tong-yee Lee · Xiu Li
MaTe 把材质参考、目标光照与目标深度都变成可共同参与注意力的视觉 token,用一个跨模态 logit 偏置调节材质影响,再借助预训练深度 LoRA 与逐步背景融合完成二维材质迁移。最重要的变化是条件之间可以直接交流,而不是各走一条独立控制支路。
固定阅读对象:用户原始 CVF 开放版本,正文印刷页 15117–15126,共 10 页;ICCV 2025 身份由 PDF 水印、页码与官方 proceedings 核实。arXiv:2605.15660v1 于 2026-05-15 才上传,不能据此把会议年份改成 2026。另完整阅读 CVF 官方 Supplementary Material,17 页,作为独立补充来源;不是把 10 页正文重复计为附录。
作者为 Nisha Huang、Henglin Liu、Yizhou Lin、Kaer Huang、Chubin Chen、Jie Guo、Tong-yee Lee、Xiu Li。第一作者双单位为清华大学与鹏城实验室。固定 PDF 在 Jie Guo、Xiu Li 后标有 †,但可提取正文未找到该符号的明确说明;本页不仅凭符号擅自升级通讯作者认证,保留原笔记,并将二人角色列为待核实。
一个材质参考图、目标图,以及从目标提取/提供的 mask、深度和灰度光照条件
目标几何与背景尽量不变、前景外观参考材质图的 RGB 图像
不是 BRDF 测量、PBR 通道恢复或可执行材质程序生成;不保证物理正确
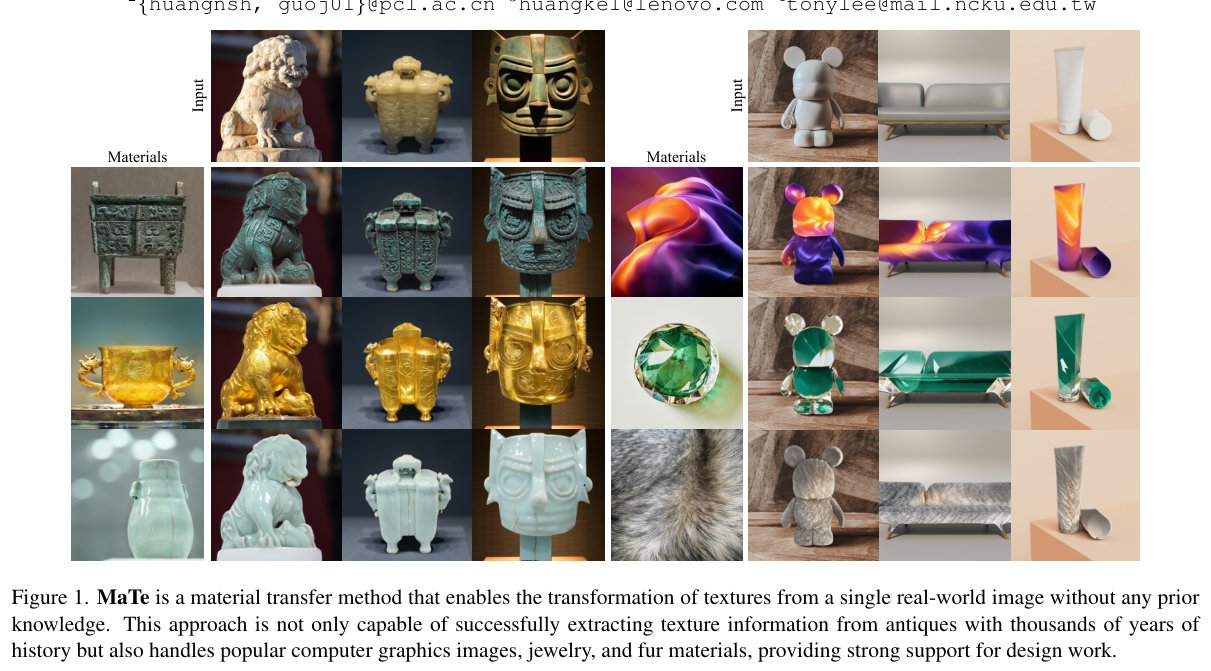
Paper Verified:1024×1024、8 步、CFG=30、单张 A100;主表中 SSIM 0.8617、LPIPS 0.1319、CLIP 0.8825,单次推理 11 秒。Reviewer:“training-free”指无需对新样本再训练,仍依赖已训练的 FLUX.1 与约 622M 参数的深度 LoRA;“轻量”是相对于额外 ControlNet,而非小模型。
材质参考包含颜色、细纹理、反射外观,也混有参考物体形状与拍摄光照;目标图包含需要保持的轮廓、曲率和环境,同时也带着不想保留的原材质。把材质用 IP-Adapter 编码、结构由 ControlNet 注入、再以文本描述协调,可能让各条件在不同表示空间中相互竞争。作者认为应让这些图像条件在同一 latent/token 空间交互,从而减少“材质像贴纸覆盖上去”的结构错位。

Figure 2:对比按图微调、额外 reference/control 网络与 MaTe 的组织方式。本文的简化不是没有任何辅助信息:仍需前景分割、深度估计、灰度化及深度 LoRA。图中抽象结构不应遮蔽这些实际依赖。
| 路线 | 主要优势 | 本文针对的限制 |
|---|---|---|
| 参数化 BRDF / procedural material | 物理含义和可编辑结构明确 | 需要几何、光照或可用材质库;作者希望接受任意参考图 |
| ProSpect、U-VAP 等微调 | 把特定外观编码进模型/概念 | 按样本优化成本、文本标识依赖、过拟合 |
| IP-Adapter + ControlNet | 复用通用图像条件与几何控制 | 额外网络、特征空间差异、跨条件融合不足 |
| MaterialFusion | 专门处理零样本材质迁移 | 论文指出反演与多路条件带来成本和折中 |
| MaTe | 统一视觉序列、推理期调权、无需新样本训练 | 依赖大模型先验,语义与材质仍可能混淆 |
Author Claim:统一空间让条件语义更自然对齐。Our Interpretation:共享 encoder 与 attention 消除了部分架构不匹配,但不等于数学上完成材质、几何、光照的可识别分解。后文失败例正说明信息仍然纠缠。
依据:固定 PDF Sec. 1–2,pp. 15117–15119。
| 符号 | 含义 | 注意事项 |
|---|---|---|
| \(I_{\mathrm{input}}\) | 需要更换前景材质的目标图 | 应保持其结构、光照和背景 |
| \(I_M\) | 材质参考图 | 不要求目标与参考空间对齐;可能混有多个材质 |
| \(F,m\) | 图像前景 mask / latent 融合 mask | 都约定对象为 1;需正确缩放到相应分辨率 |
| \(I,I_D\) | 灰度前景光照图、目标深度图 | 灰度图不是纯 shading 的物理分解;深度可能丢失细结构 |
| \(C_M,C_I,C_D\) | 材质、光照/目标、深度视觉 token | 共同进入 DiT attention;其中目标/光照序列承载生成状态 |
| \(M,N,d\) | 材质 token 数、目标/深度 token 数、注意力维度 | 原先文本背景公式也用 M,进入 MaTe 公式后需重新按材质数理解 |
| \(\gamma,w\) | 材质跨模态注意力倍率参数、深度 LoRA 权重 | 两个不同控制旋钮,不是同一个 guidance strength |
| \(I_o\) | 最终材质迁移 RGB 图 | 没有输出程序图、SVBRDF、normal/roughness ground truth |
这里的“材质”主要指照片可观察到的外观。金属度、粗糙度或透明度可以被视觉上模仿,但单张图像无法唯一决定物理参数。材质参考的纹理被目标表面整合是任务目标,不代表获得可重新照明的资产。
\(x_0\) 为数据样本,\(t=1\) 接近噪声端,\(t=0\) 为干净端。直线路径的速度是 \(\epsilon-x_0\),网络学习相应的 flow;实际生成从噪声端向数据端积分。在 MaTe 中计算在 VAE latent 中进行。该式解释基础模型,不是新提出的材质损失。
式 2 保留原文写法。\(\epsilon_\theta\) 是重参数化后的噪声预测,\(w_t\) 是时间权重,\(\lambda'_t\) 是信噪比参数化的导数记号;不能只见负号就把它当作负 MSE,无视时间权重符号。原文以 \(\mathcal U(t)\) 简写时间采样,但没有在 MaTe 中训练新的 CFM 网络。不能自行补造 optimizer 或训练步数。
原 DiT 把图像 \(X\) 与文本 \(C_T\) 拼为序列,投影为 Q/K/V,并通过带位置编码的注意力交互。MaTe 借用这个全序列交互结构来处理图像条件,不只是把一个全局 image embedding 加到 hidden state。
前景去掉原有颜色,保留灰度明暗;背景维持原图。目的在于减小原物体颜色对新材质的干扰,同时保留光照线索。灰度仍包含 albedo 变化、阴影与镜面分量,因此这里只是光照代理,不能解释为精确 intrinsic decomposition。
原权重 W 冻结,BA 是预训练低秩增量,w 控制深度信息影响。原文说采用公开 FLUX.1-Depth-dev-lora,不是为每个待编辑样本学习 A/B。应区分“预训练 LoRA 的训练”和“MaTe 的无训练推理”。
式 6 是作者用来解释传统空间对齐的加法注入,而不是 MaTe 自身的主算子。加法要求 token 能逐位置对齐;任意材质照片通常不满足该条件。MaTe 用拼接序列让目标位置可与任意参考位置交互。
偏置只加在材质与光照/深度之间,且是双向的。光照与深度之间没有额外偏置;各模态内部 logit 也不直接改变。注意 \(B(\gamma)\) 是 attention 偏置,与 LoRA 的矩阵 B 不是同一对象,复现代码应使用不同变量名。
Our Interpretation,严格展开:某一 query 行中,跨材质的键集合为 J。若原 logit 为 \(a_j\),则新权重为:
因此 \(\gamma=1\) 才是无额外偏置;趋近 0 时跨材质注意力被抑制;大于 1 时相对加强。不是给最终 attention 概率简单乘 \(\gamma\) 后不归一化。重要纠正:论文与补充材料称对角块为零让模态内部“attention weights 不变”,严格来说只保证原始 logits 不直接偏移;Softmax 分母改变后,模态内概率也会改变。其内部相对赔率保持不变,而总概率质量不保持不变。
生成 foreground latent 与相同噪声层级的原图 background latent 混合,再继续去噪,让下一步模型修复接缝。最后在图像域把 mask 外区域替回原图,严格保留背景像素。作者用“逐步投影回自然图像流形”解释其效果,这是启发式假设,不是流形投影定理。
公式 1–9:固定 PDF pp. 15119–15121。概率展开及对 Softmax 分母的分析为本页推导。

“Images Are All You Need”针对不必人工书写编辑 prompt 的使用方式,不表示无需 mask、深度、基础模型预训练或权重许可。正文称无需 inversion;这区别于把每个输入执行完整 DDIM 反演,仍然需要编码、加噪/初始化和图像融合。
MTB 数据来源:正文报告 60 张材质图、30 张目标照片,来自 Unsplash;补充 F 节称覆盖 30 类典型材质风格与 30 类对象。60 张与 30 类并不必然矛盾,但文中没有逐类张数映射。不能把它擅自解释为 60×30=1800 个全部评测对;实际量化组合数和随机采样协议未完整报告。Unsplash 图像具有许可条款,原文的“copyright-free”用语不等于无版权或任意再分发。
材质覆盖金属、陶瓷、石雕、织物、纤维、食物、宝石、晶体、玻璃、皮革与塑料;对象包括文物、雕塑、家具、装饰物、食品、玩具、相机、水果和数字艺术。没有新训练集 train/val/test 划分,因为本文不新增训练,但仍应为超参数选择与最终评测分离验证样本。
| 设置 | 作者报告 | 解释与缺项 |
|---|---|---|
| Backbone | FLUX.1 latent rectified-flow Transformer | 公开深度 LoRA 适用于 FLUX.1-dev;正文主表简写 Flux.1 |
| 深度模块 | 正文约 620M;补充精确 622.13M 参数 | 对照 ControlNet 1593.37M;不是整个模型参数量 |
| 推理 | 8 steps,1024×1024,CFG=30,A100 单卡 | 未披露全部 scheduler、精度、seed、显存峰值 |
| 材质强度 | 消融 0.2、0.6、1.0、1.4、1.8、2.2;1.8 效果较满意 | 正文未清楚列出完整逐图默认 \(\gamma\) |
| 深度权重 | w∈{0.7,0.8,0.9,1.0} | 给出可调范围,但没有唯一全测试集默认值 |
| 训练 | MaTe 不进行按图训练或微调 | 学习率、epoch、optimizer 等不应编造;预训练 LoRA 自有训练来源 |
| 用户研究 | 16 位有视觉/图形经验者,34 组×7 方法×3 问题 | 每位每组每项选 1,故 16×34×3=1632 票,不是 1632 独立参与者 |
| Method | Used implementation | Training configuration | Inference configuration |
|---|---|---|---|
| U-VAP | 官方仓库 | Epochs: 100 | Steps: 50;Guidance Scale: 7.5 |
| ProSpect | 官方仓库 | Maximum Training Steps: 600 | Steps: 50;Strength: 0.6 |
| IP-adapter-sd15 | 官方仓库 | N/A | Steps: 50;Strength: 0.7 |
| IP-adapter-sdxl | 官方仓库 | N/A | Steps: 50;Strength: 0.7 |
| Zest | 官方仓库 | N/A | Steps: 30;Strength: 0.9 |
| MaterialFusion | 官方仓库 | N/A | Steps: 50;Strength: 1.0 |
| Ours | — | N/A | Steps: 8;Strength: 1.0 |
补充表中的 Strength 不应自动当作 Cross-Bias \(\gamma\)、LoRA w 或 CFG;作者用通用字段记录各管线配置,但没有把其语义逐方法完全说明。IP-Adapter SD1.5/SDXL 额外加入对应的 depth ControlNet;IP-Adapter、U-VAP、ProSpect 还加入 mask 分割操作以改善比较公平性。
| Method | SSIM ↑ | LPIPS ↓ | CLIP ↑ | Texture ↑ | Structure ↑ | Overall ↑ | Base model | Preprocessing (s) | Inference (s) | Fine-tuning | Text conditions | Reference networks |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ProSpect | 0.8048 | 0.1693 | 0.8009 | 2.57% | 2.57% | 1.84% | SD1.4 | 200 | 16 | ✓ | ✓ | — |
| U-VAP | 0.7176 | 0.2612 | 0.7698 | 0.37% | 0.18% | 0.00% | SD1.5 | 522 | 7 | ✓ | ✓ | — |
| IP-Adapter SD1.5 | 0.7489 | 0.2537 | 0.8271 | 0.74% | 0.37% | 0.00% | SD1.5 | 0 | 10 | — | — | ✓ |
| IP-Adapter SDXL | 0.8152 | 0.1876 | 0.8358 | 7.35% | 2.94% | 3.49% | SDXL | 0 | 20 | — | — | ✓ |
| ZeST | 0.7231 | 0.2430 | 0.8627 | 14.34% | 0.18% | 0.37% | SDXL | 0 | 21 | — | — | ✓ |
| MaterialFusion | 0.8263 | 0.1565 | 0.8521 | 11.21% | 20.04% | 10.48% | SD1.5 | 0 | 43 | — | ✓ | ✓ |
| MaTe (Ours) | 0.8617 | 0.1319 | 0.8825 | 63.42% | 73.71% | 83.82% | Flux.1 | 0 | 11 | — | — | — |
重建自用户固定 PDF 第 7 页 Table 1,粗体为质量/用户研究最优,下划线为第二。保留原始 63.42%,冲突见下文。所有 7 行 × 13 列完整保留。
原始数值冲突:主表 MaTe Texture 为 63.42%,本页保持原样;补充 B 节与图 2 则为 62.42%。其他方法 texture 相加为 36.58%,因此主表该列合计 100.00%,补充值则合计 99.00%。算术一致性支持主表 63.42%,提示补充可能存在排印错误,但未取得作者确认,不能静默修正。Structure 与 Overall 分别为 73.71%、83.82%,两处一致。
| 比较 | 从主表计算的变化 | 含义 |
|---|---|---|
| SSIM vs MaterialFusion | 0.8617−0.8263=0.0354 | 对输入结构相似度提高;不直接测材质真实性 |
| LPIPS vs MaterialFusion | 0.1565→0.1319,降低约 15.72% | 与输入感知距离下降;也可能受背景保留影响 |
| CLIP vs ZeST | 0.8627→0.8825,增加 0.0198 | 参考材质与输出的语义/视觉相似度更高 |
| Inference vs MaterialFusion | 43/11≈3.91 倍 | 在作者报告的不同配置下,MaTe 更快 |
| Inference vs ZeST | 21/11≈1.91 倍 | 不是固定相同 backbone/steps 的纯架构加速 |
| Inference vs U-VAP / IP-A SD1.5 | 11 秒 vs 7 秒 / 10 秒 | MaTe 并非每个方法中单次推理最快 |
| Overall preference vs MaterialFusion | 83.82%−10.48%=73.34 个百分点 | 在该组七选一用户研究中占明显优势 |
预处理时间栏 ProSpect 200 秒、U-VAP 522 秒包含其适配成本;MaTe 为 0 不意味着深度提取、分割、加载模型或 VAE 编码零耗时,而是表格统计口径未完整说明。若直接相加得到首次样本成本,应先确认哪些步骤计时、是否可复用。

Figure 4:完整列序为 Input、Material、Ours、MaterialFusion、ZeST、IP-Adapter SDXL、IP-Adapter SD1.5、U-VAP、ProSpect。椅子镂空结构、彩色丝带的渐变/透明/光泽、可乐冰块与水果等案例说明定性优势。作者关于“理解参考中未展示的苹果内部”的说法,是生成先验的解释,不是物理材质推断被验证。

Figure 5,\(\gamma\):0.2 到 2.2 的六列控制材质相对影响;接近 0 时几乎不传材质,约 1.8 后收益趋缓。注意极限 0 不能直接代入 log;代码应使用足够小的正数或显式屏蔽。没有定量最优曲线,1.8 是展示经验而非所有材质的通用常数。

Figure 6,w:0.7、0.8、0.9、1.0 四列展示深度强弱,可与材质表达发生竞争。该图证明可调,不说明某个权重始终最佳。

Figure 7,光照初始化:原输入、随机噪声与灰度光照代理比较。直接输入会残留原颜色;随机噪声忽视目标光照,可能倾向参考光照;灰度代理作折中。但它仍保留原对象强度/纹理,并未实现精确照明分解。

Figure 8,CFG:10、20、30、40、50 的五列;增加强度可提升细节与条件表现,过大产生颜色失真、高频噪声;作者选 30。需要核查实际管线中 guidance 是显式 CFG 还是蒸馏式 guidance 输入,不能从别的 FLUX 例程直接照搬。
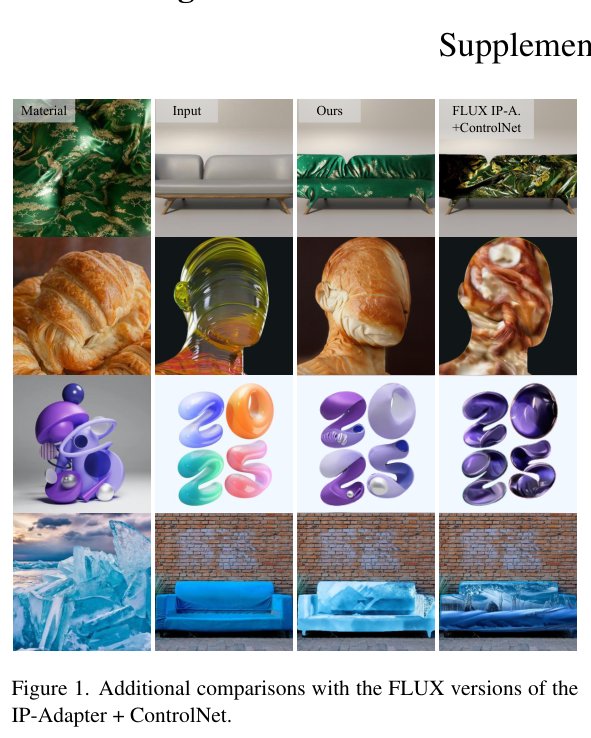
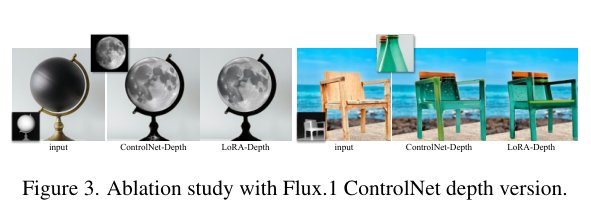
补充 Figure 1 对比 FLUX 版 IP-Adapter+ControlNet;Figure 3 将 depth LoRA 换为 FLUX ControlNet,作者观察最终结果无显著视觉差异。因此选 622.13M LoRA,而不是 1593.37M ControlNet,约减少 60.96% 的该辅助模块参数。正文另宣称 1.8 倍推理加速,但未提供足够详细的同模型计时表支撑独立复算,应该保持为作者报告。
| 补充 A 的公开指标 | Depth LoRA | ControlNet Depth | Reviewer 边界 |
|---|---|---|---|
| 模型文件大小 | 1.24 GB | 3.19 GB | 辅助权重大小,不等于总显存 |
| ELO score | 1098 | 931 | 作者援引公开结果,非本文 MTB 同协议统计 |
| 上月下载量 | 36,170 | 1,332 | 历史流行度,不能当用户材质偏好或质量证据 |
这些数字是补充原文的历史快照,不是 2026-09-30 实时状态。补充补上了同 FLUX 的定性比较,改善了公平性,但仍缺完整同基础模型定量消融与误差统计。
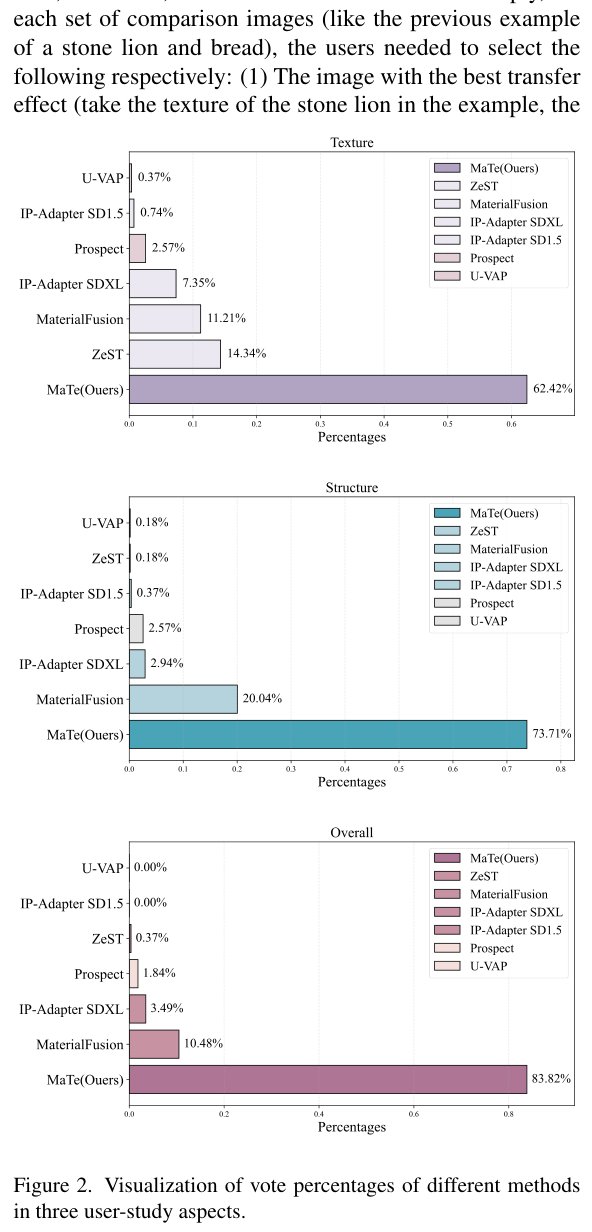
补充 Figure 2:用户研究三类票数可视化,texture 显示 62.42%。流程为 16 人、34 组、7 个随机排列选项,分别选择纹理、结构、整体最优。每方面 544 票,总计 1632;没有报告更大非专业人群的偏好。
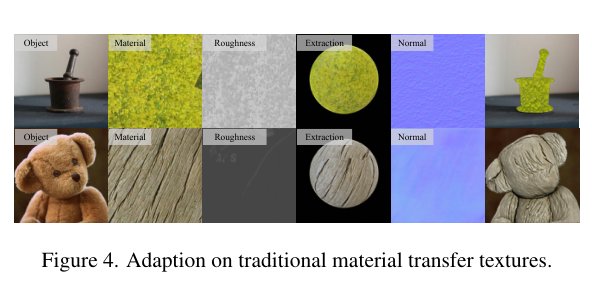
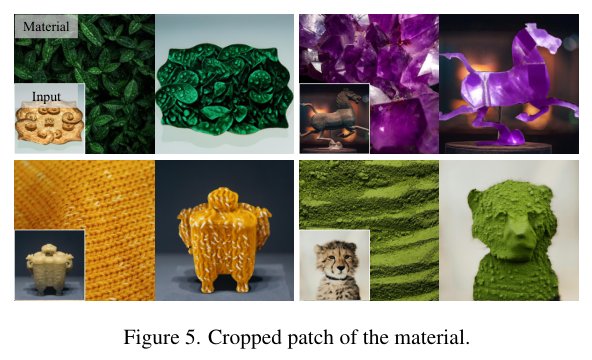
补充 Figure 4/5:展示对传统材质贴图场景的适应与裁切参考 patch 的影响。补充把不裁切的可用性归因于 bias 的对角块为零;本页数学节解释了这不意味着完整 attention 概率保持不变。PBR 图例并不代表本文训练或输出完整多通道物理材质。
以下三列保留补充表的 30 条原始推理 prompt,按相同对象对齐。星号是 ProSpect 的概念占位符,不是本页省略。U-VAP 表格只给 inference prompt;其训练所用 target/non-target descriptions 由 GPT 生成,但没有公开完整 system prompt 或全部生成记录。补充举例把面包椅的 target description 改为金属椅、non-target description 改为面包狗,用来区分目标与非目标属性。
| MaterialFusion | ProSpect | U-VAP |
|---|---|---|
| A photo of a dog-like robot made of blue glass | A photo of a dog-like robot made of * | A photo of a dog robot object made of glass material |
| A photo of a sculpture made of terracotta | A photo of a sculpture made of * | A photo of a sculpture object made of terracotta material |
| A photo of a pottery vessel made of aventurine | A photo of a pottery vessel made of * | A photo of a vessel object made of aventurine material |
| A photo of a majestic stone lion statue made of sesame seed-covered pastry | A photo of a majestic stone lion statue made of * | A photo of a stone lion statue object made of pastry material |
| A photo of a figurine with mouse-like ears made of glass filled with cola | A photo of a figurine with mouse-like ears made of * | A photo of a figurine object made of cola material |
| A photo of a sliced mango made of apple | A photo of a sliced mango made of * | A photo of a mango object made of apple material |
| A photo of a chair made of bread | A photo of a chair made of * | A photo of a chair object made of bread material |
| A photo of a sofa made of blue and white porcelain | A photo of a sofa made of * | A photo of a sofa object made of porcelain material |
| A photo of a poseable mannequin made of glass iridescent ribbon | A photo of a poseable mannequin made of * | A photo of a mannequin object made of ribbon material |
| A photo of the number “2025” made of a pink jacket | A photo of the number “2025” made of * | A photo of a 2025 object made of jacket material |
公平性判断:作者努力让不同方法的语义对应,但 prompt 的详细程度并不完全一致。MaTe 不需人工编辑文本是一项操作便利性;对照方法的 prompt、适配预算与模型差异仍可能影响最终排名。

Figure 9:用多对象分割代替单前景提取,对沙发、桌子、地板等分别指定材质。它展示场景编辑潜力,但没有报告复杂遮挡、多材质边界与顺序依赖的定量评估。

正文 Figure 10:参考线稿的狼语义会迁到牛油果上;参考图黄色背景也可能被当成材质。两类失败分别对应语义/纹理未解耦、多个材质来源未分离。不能把统一 token 空间误解为自动获得材质分割。
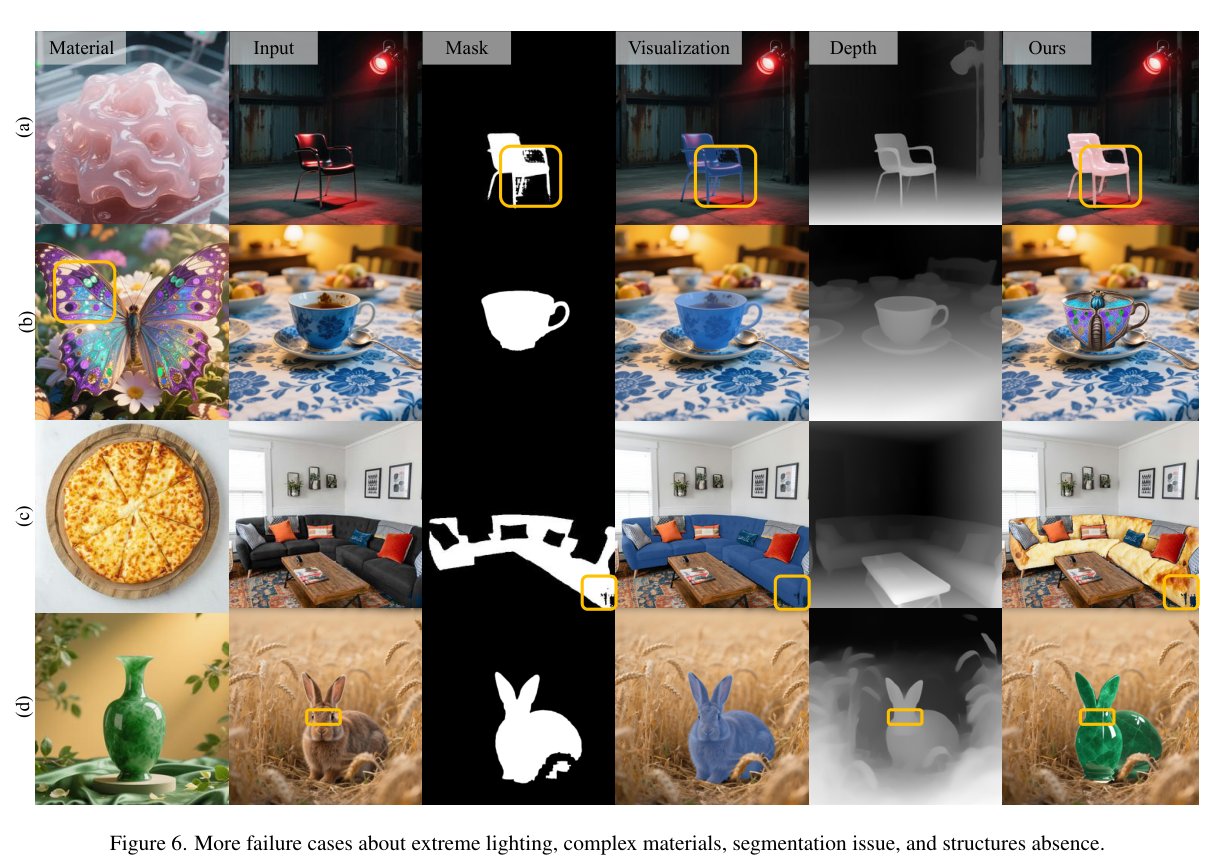
补充 Figure 6:四个额外失败来源:极端光照使 mask 含噪并误解反射;复杂材质难在狭窄区域充分表达;SAM2 分割漏覆盖对象;深度图缺少眼睛等细结构,导致几何约束不足。这些例子显示外围预处理对结果具有实质影响。
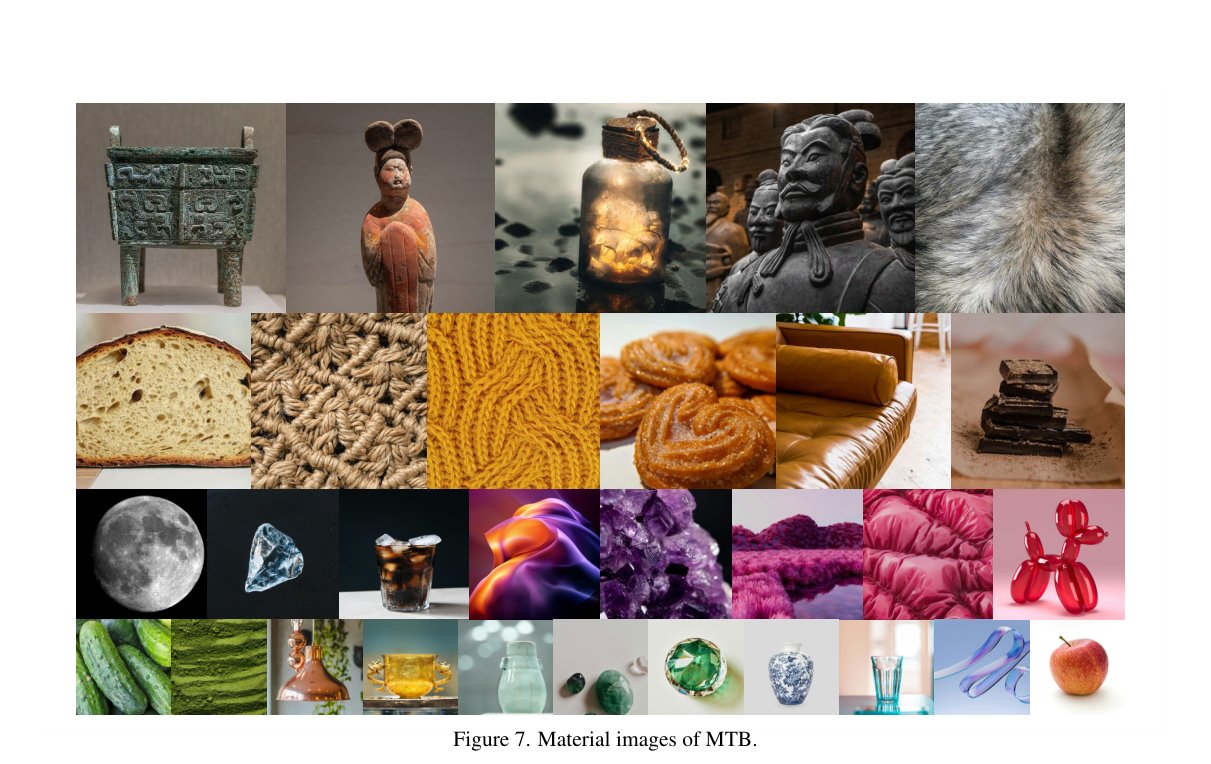
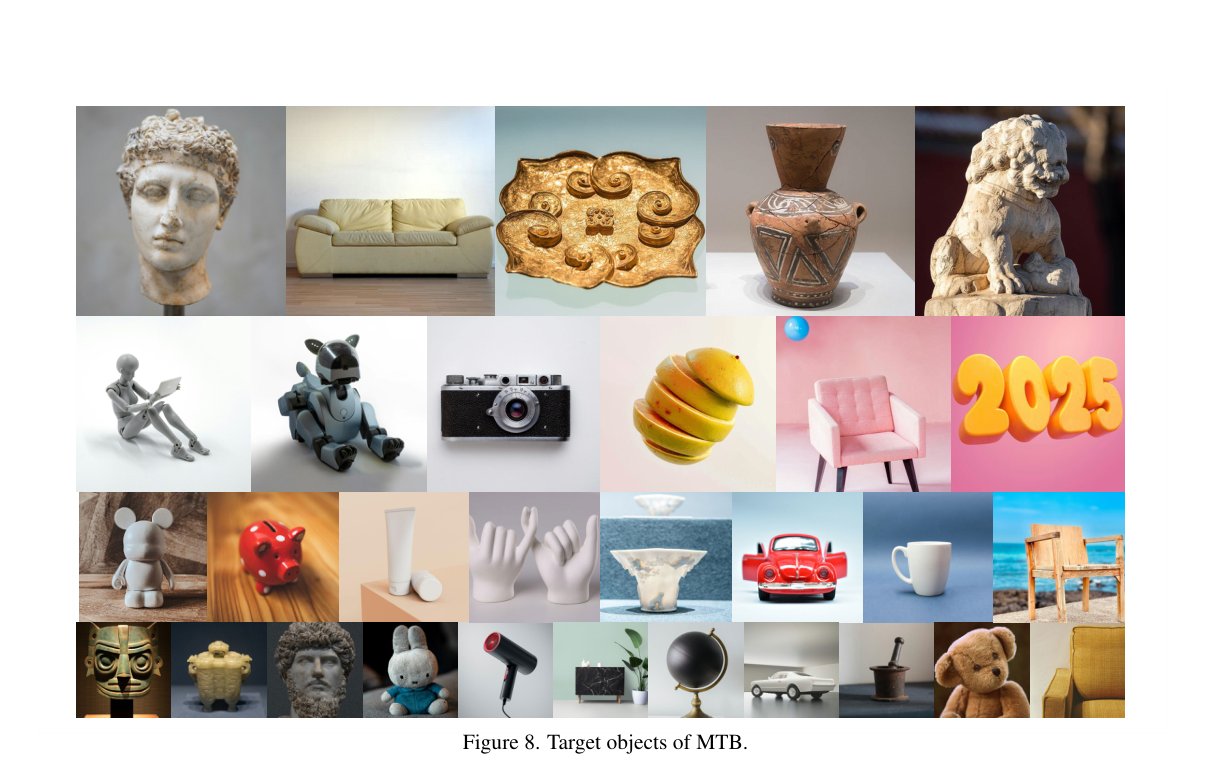
补充 Figure 7/8:MTB 的材质与目标对象图册,用于理解覆盖范围;这不是自动证明全部图像两两组合都被评测。
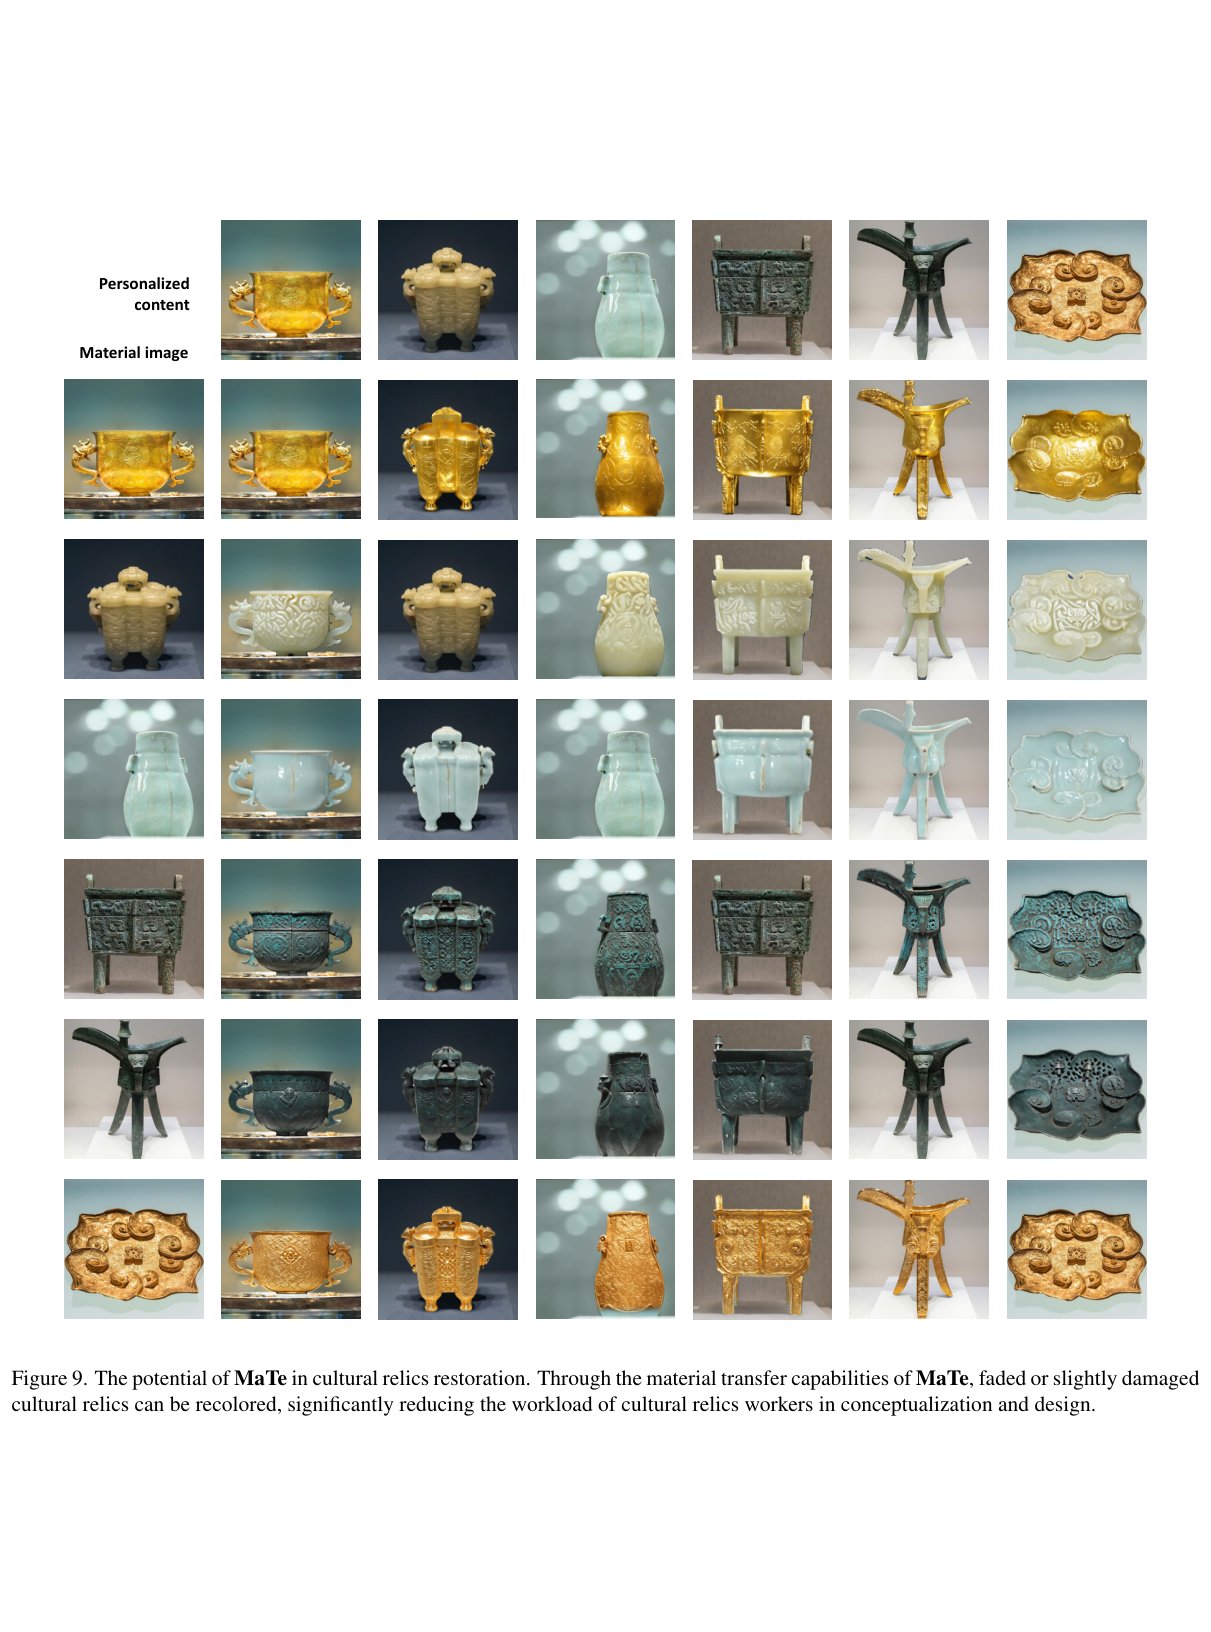
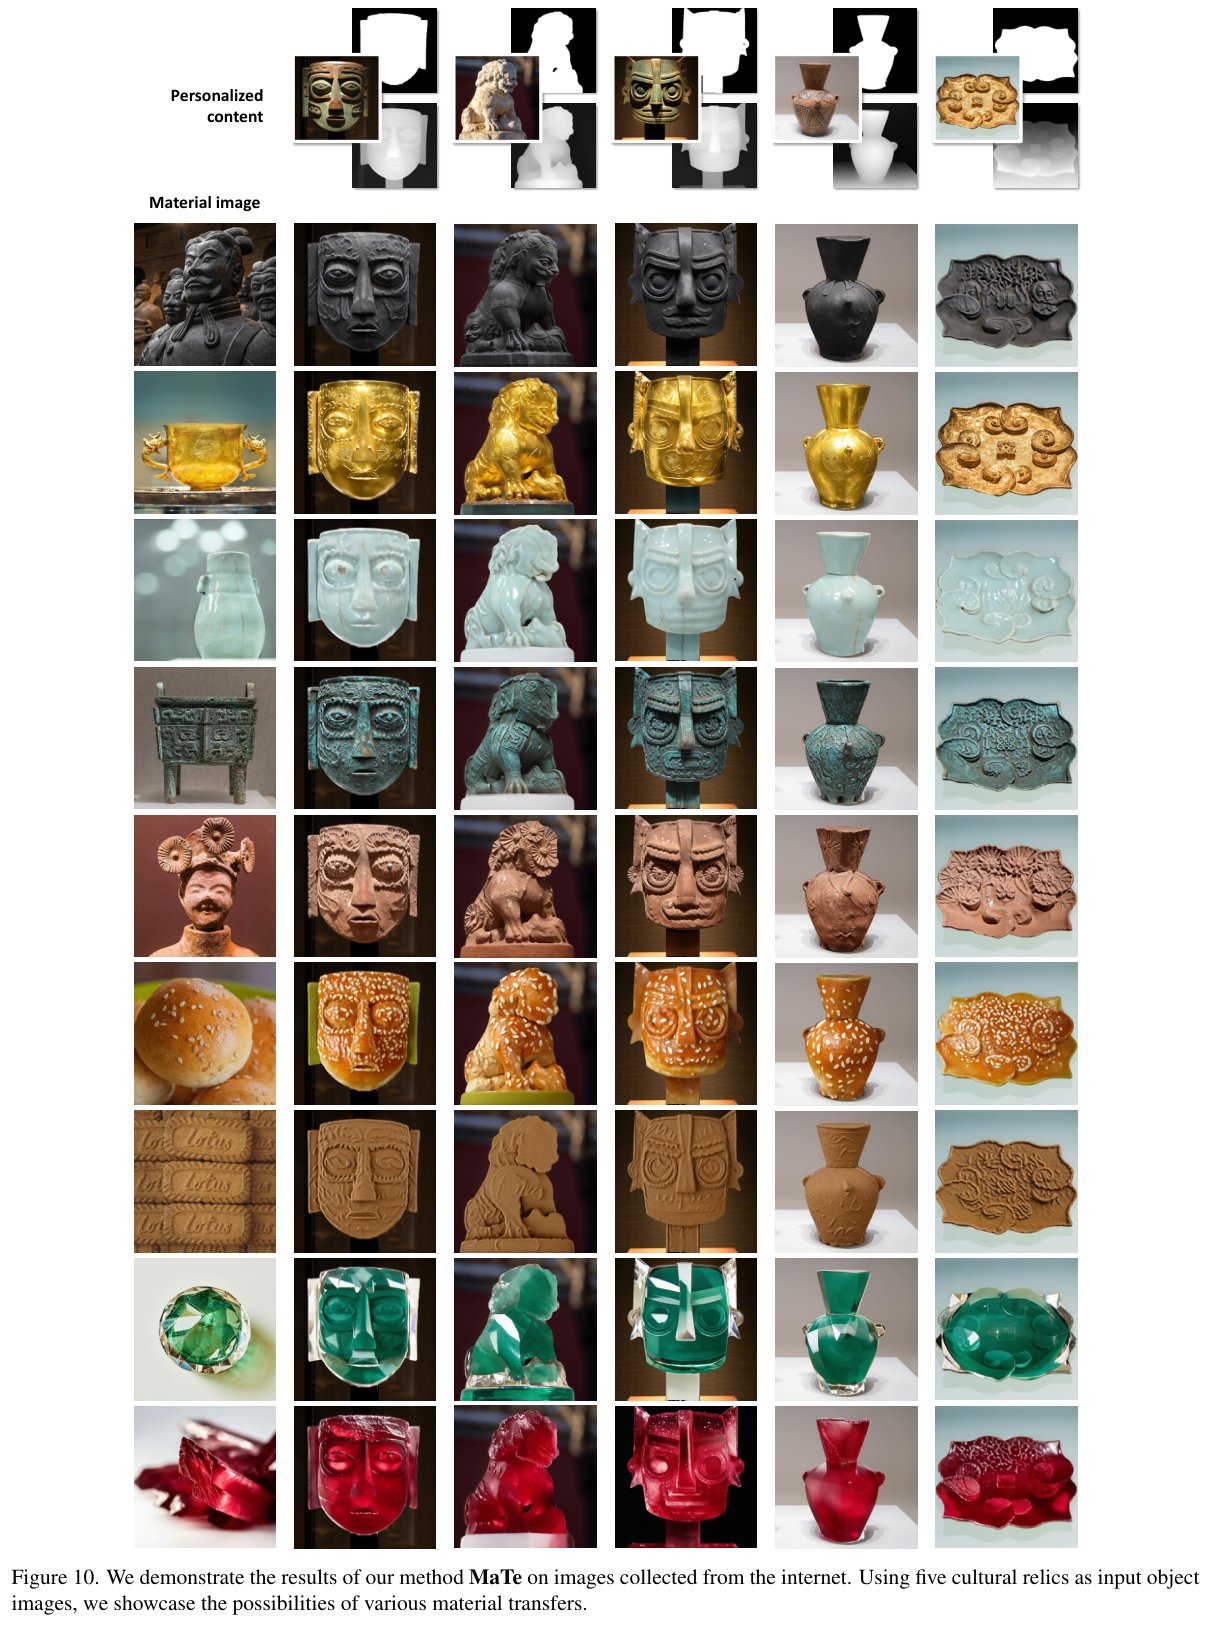
补充 Figure 9/10:文物与雕塑外观重设计。可以作为方案预览,但生成“修复”色彩不是真实历史原貌的证据;不应替代考古/修复学验证。
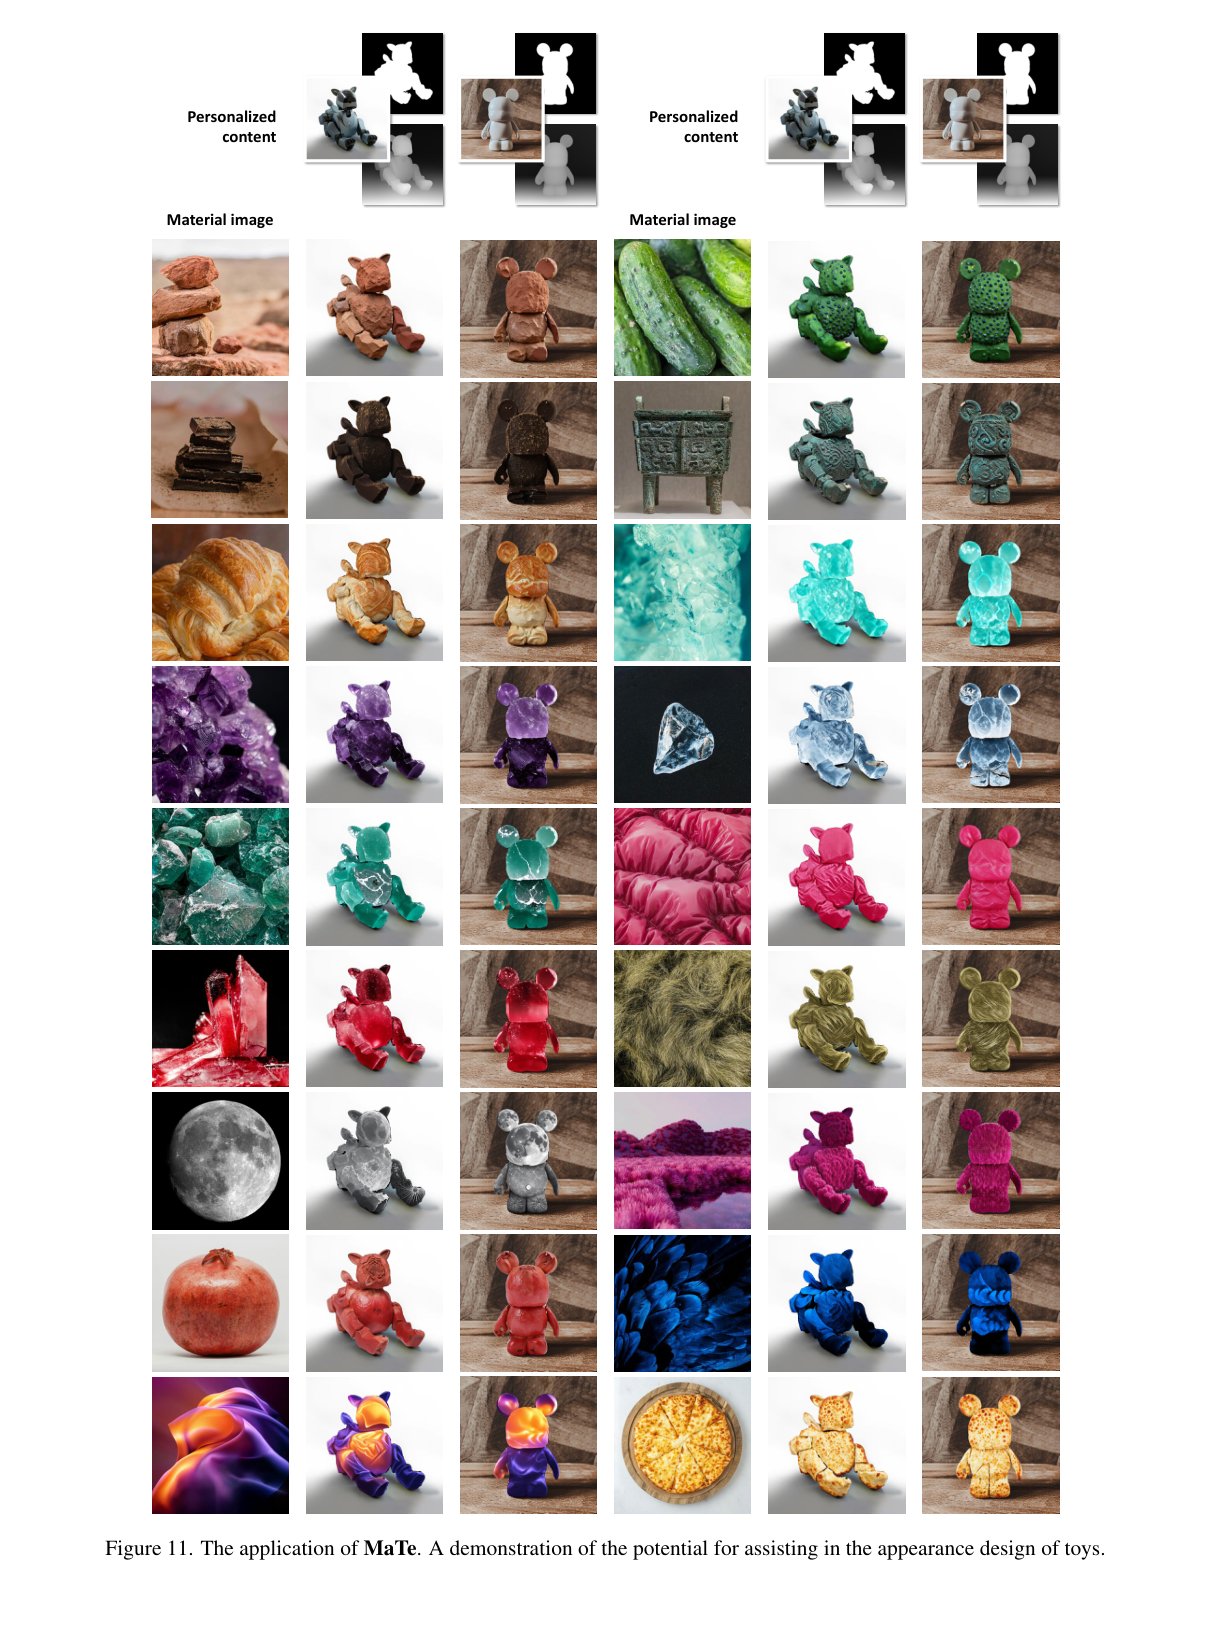
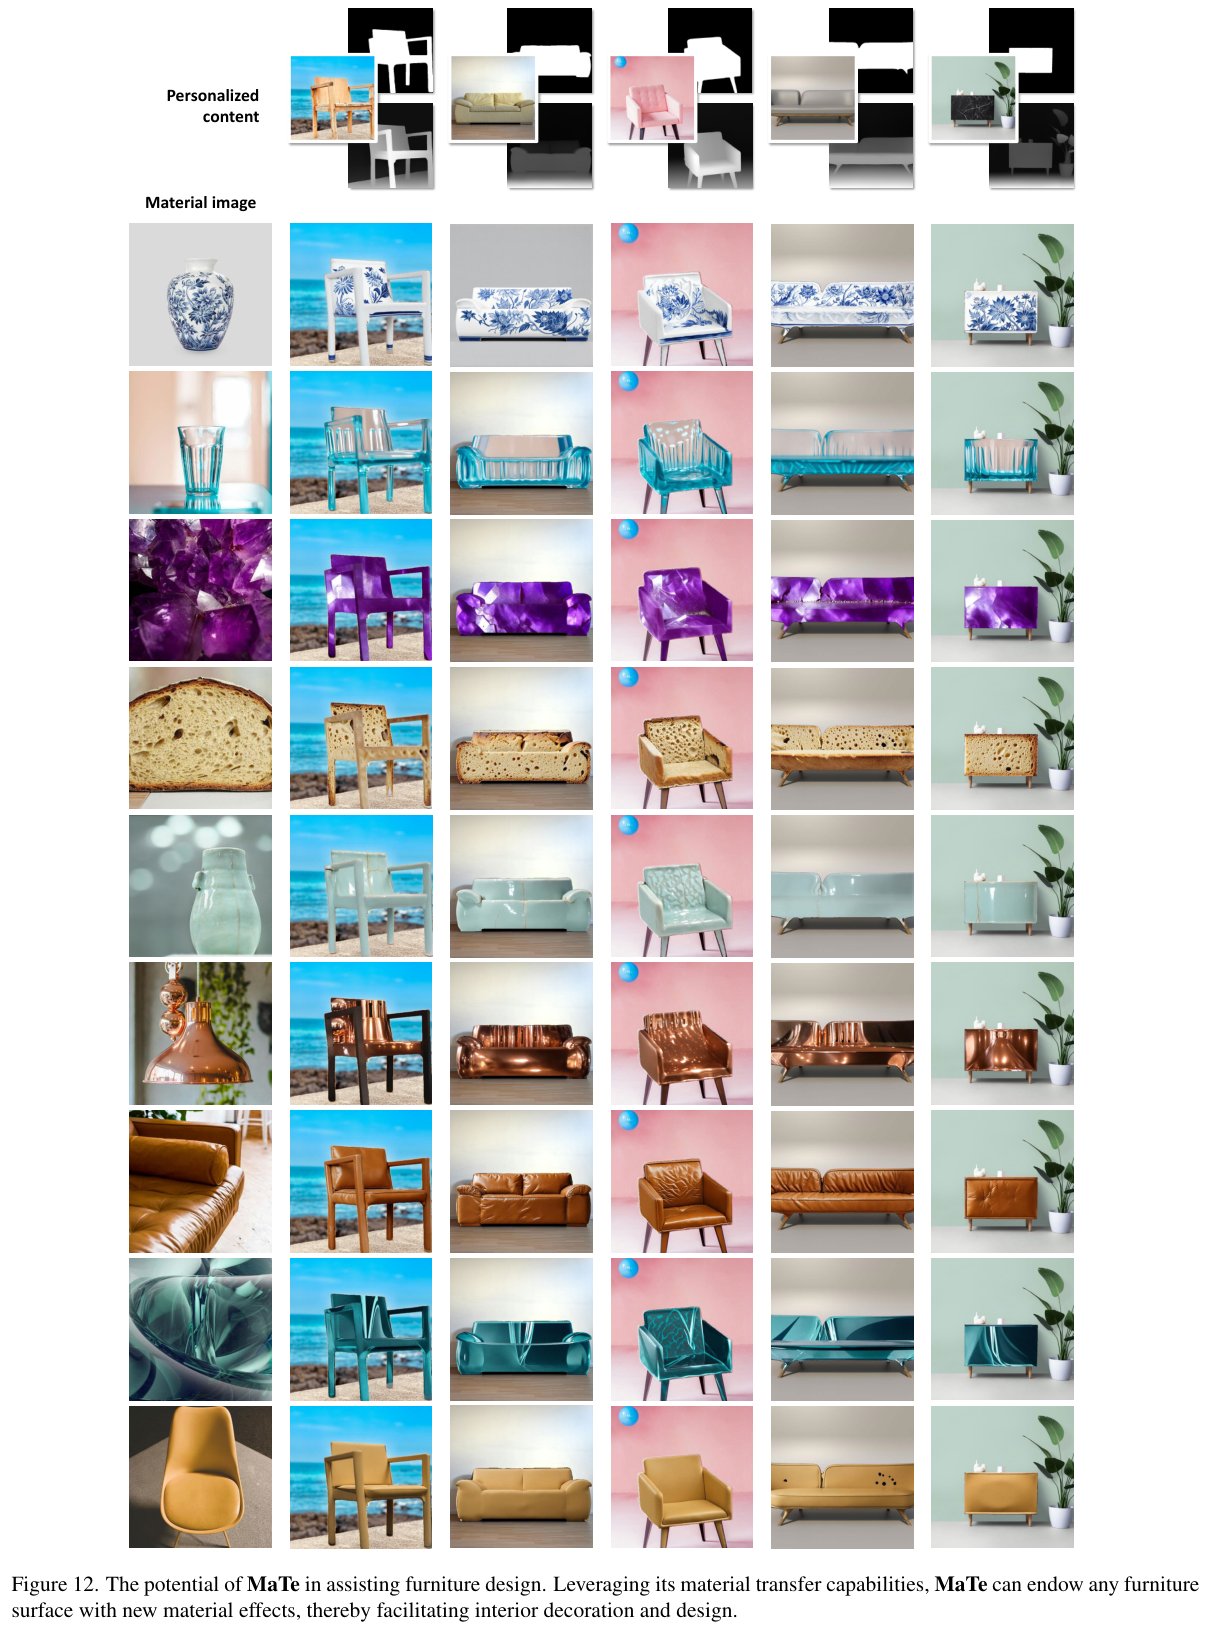
补充 Figure 11/12:玩具和家具设计,强调快速试材质的视觉用途。几何、制造约束、真实材料强度与成本不在输出中。
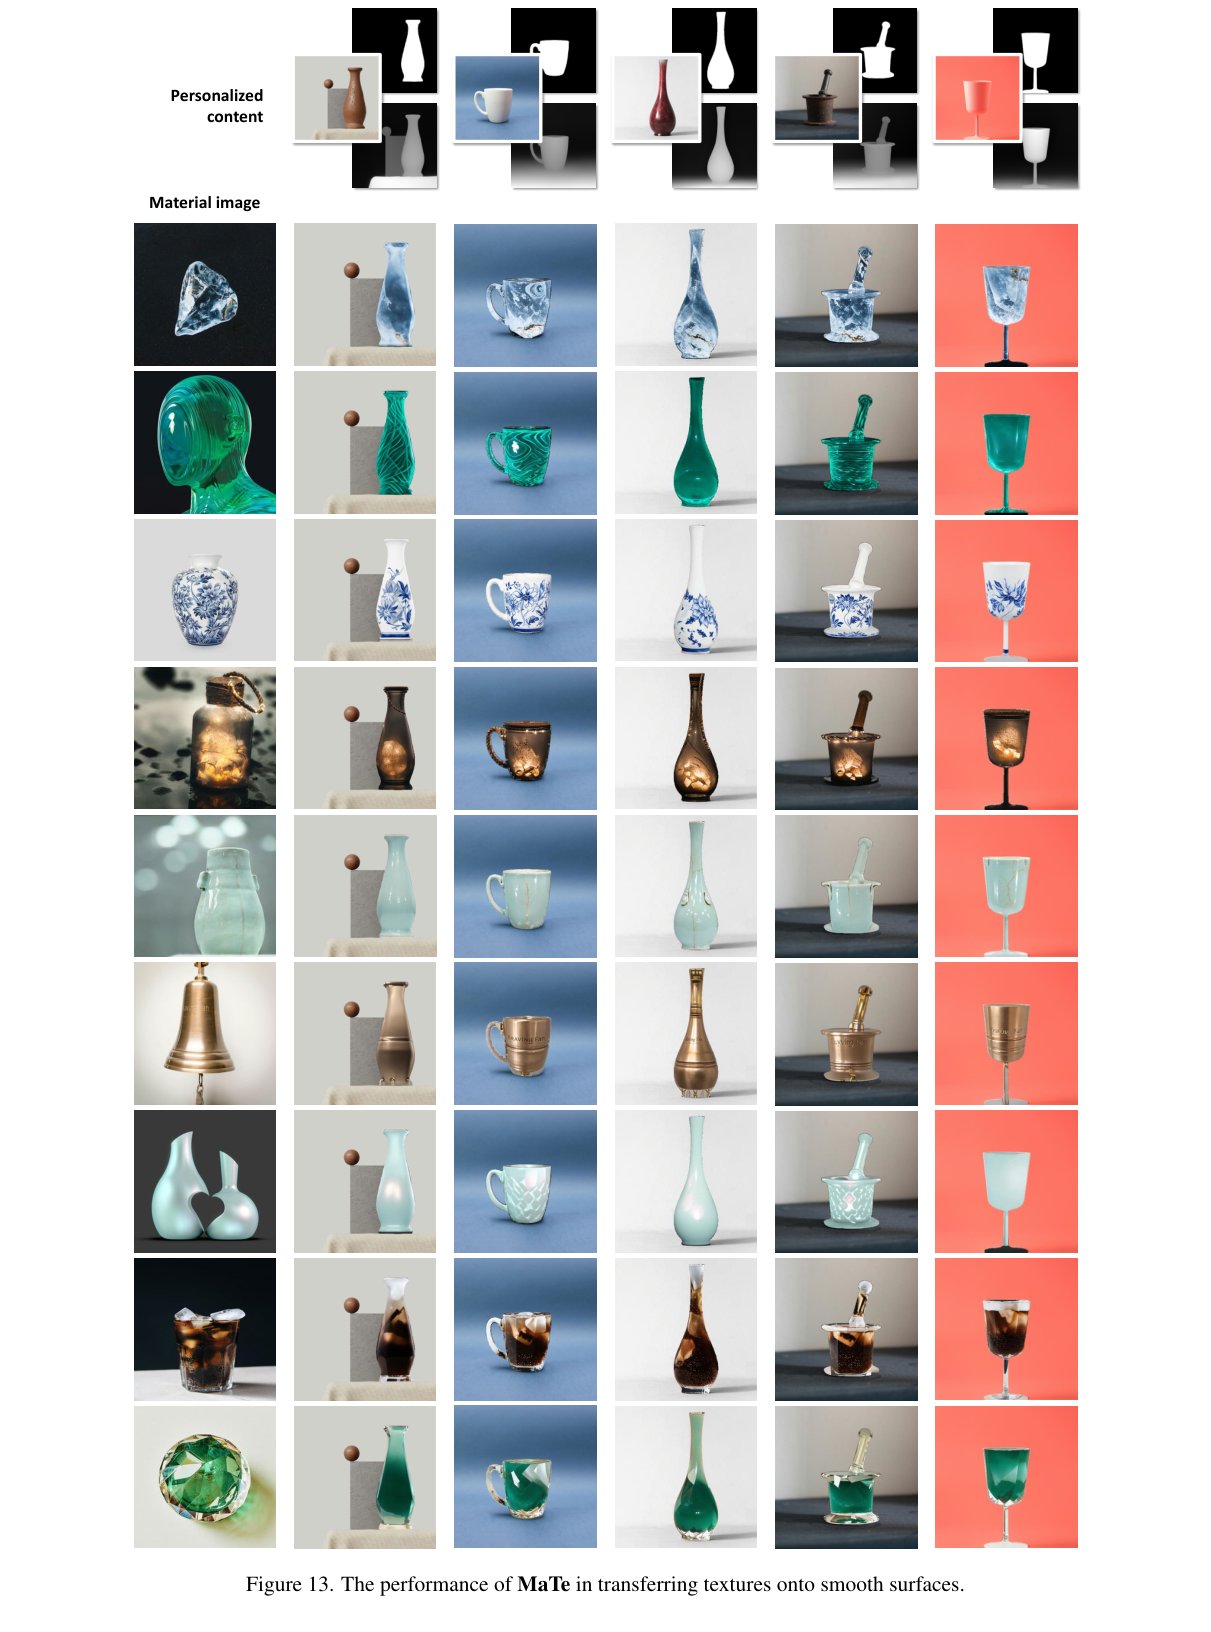
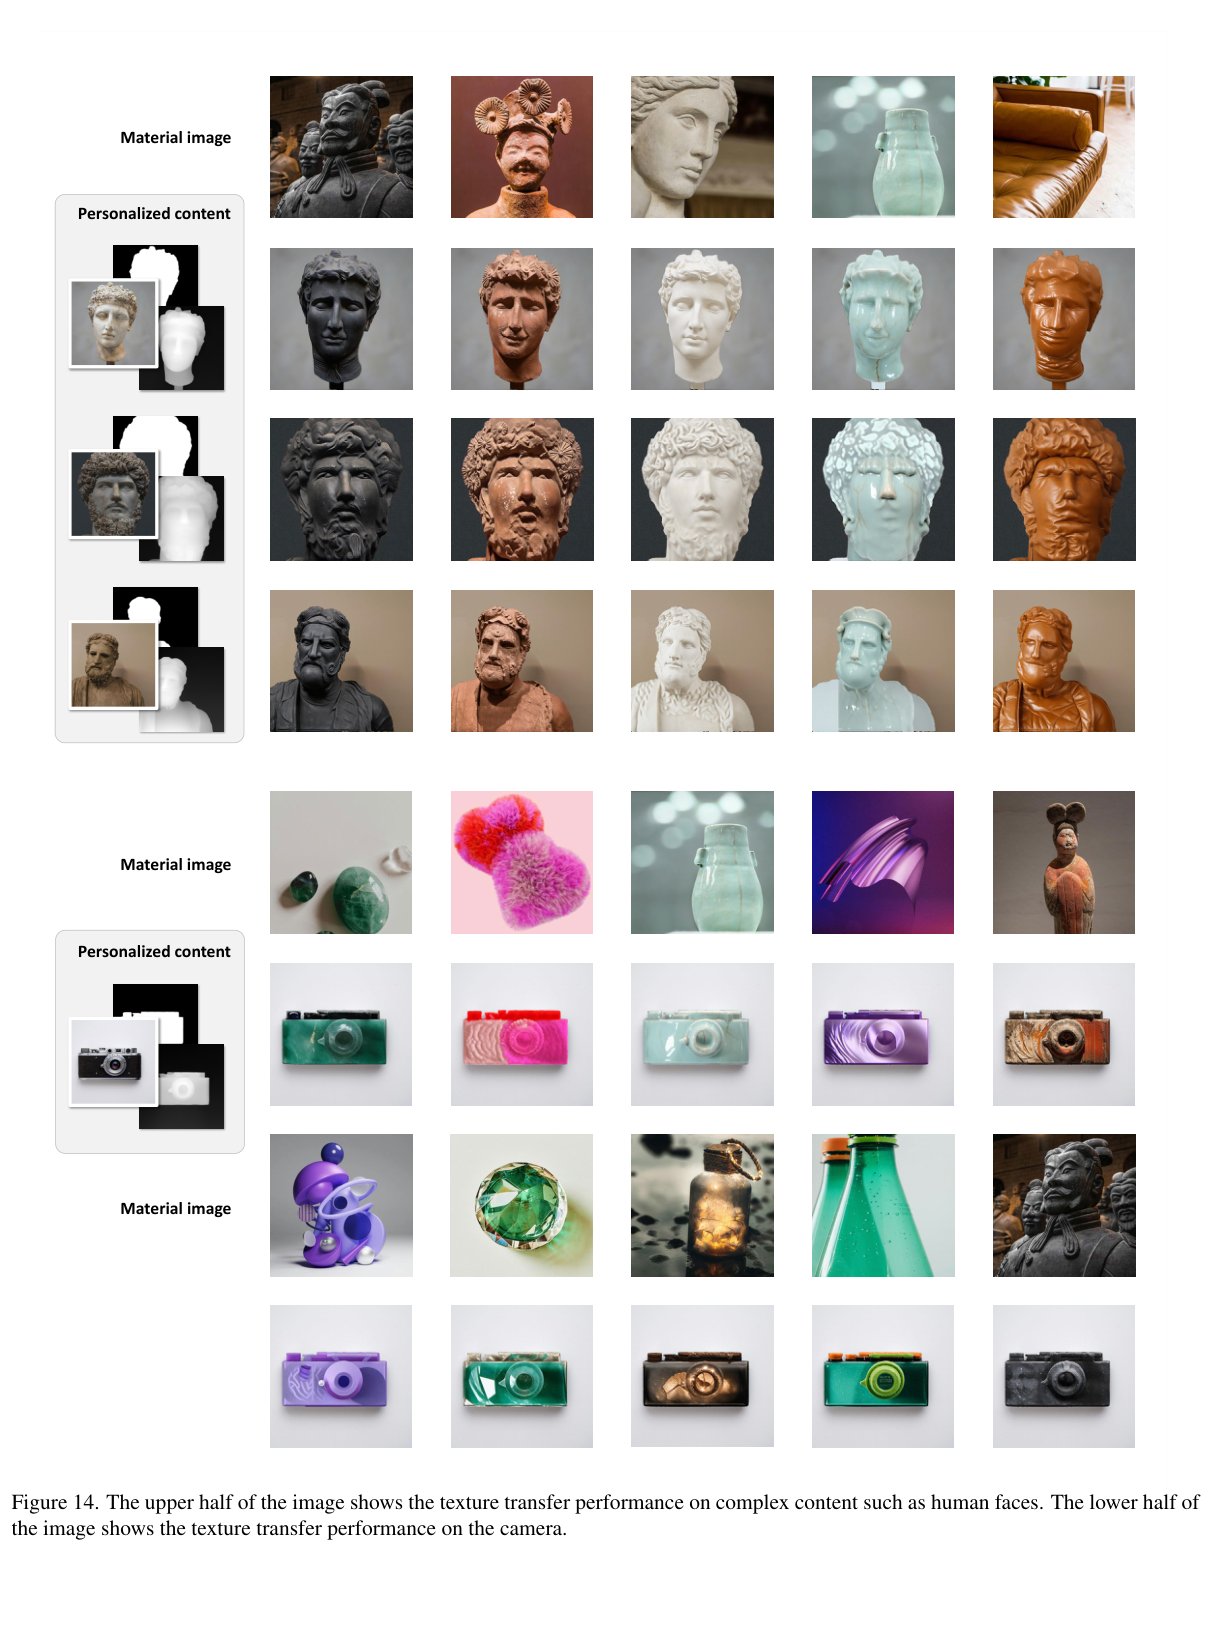
补充 Figure 13/14:光滑表面、人脸与相机等复杂对象。特征与局部几何保留应逐例检查,不能因画面逼真推断可编辑三维一致性。
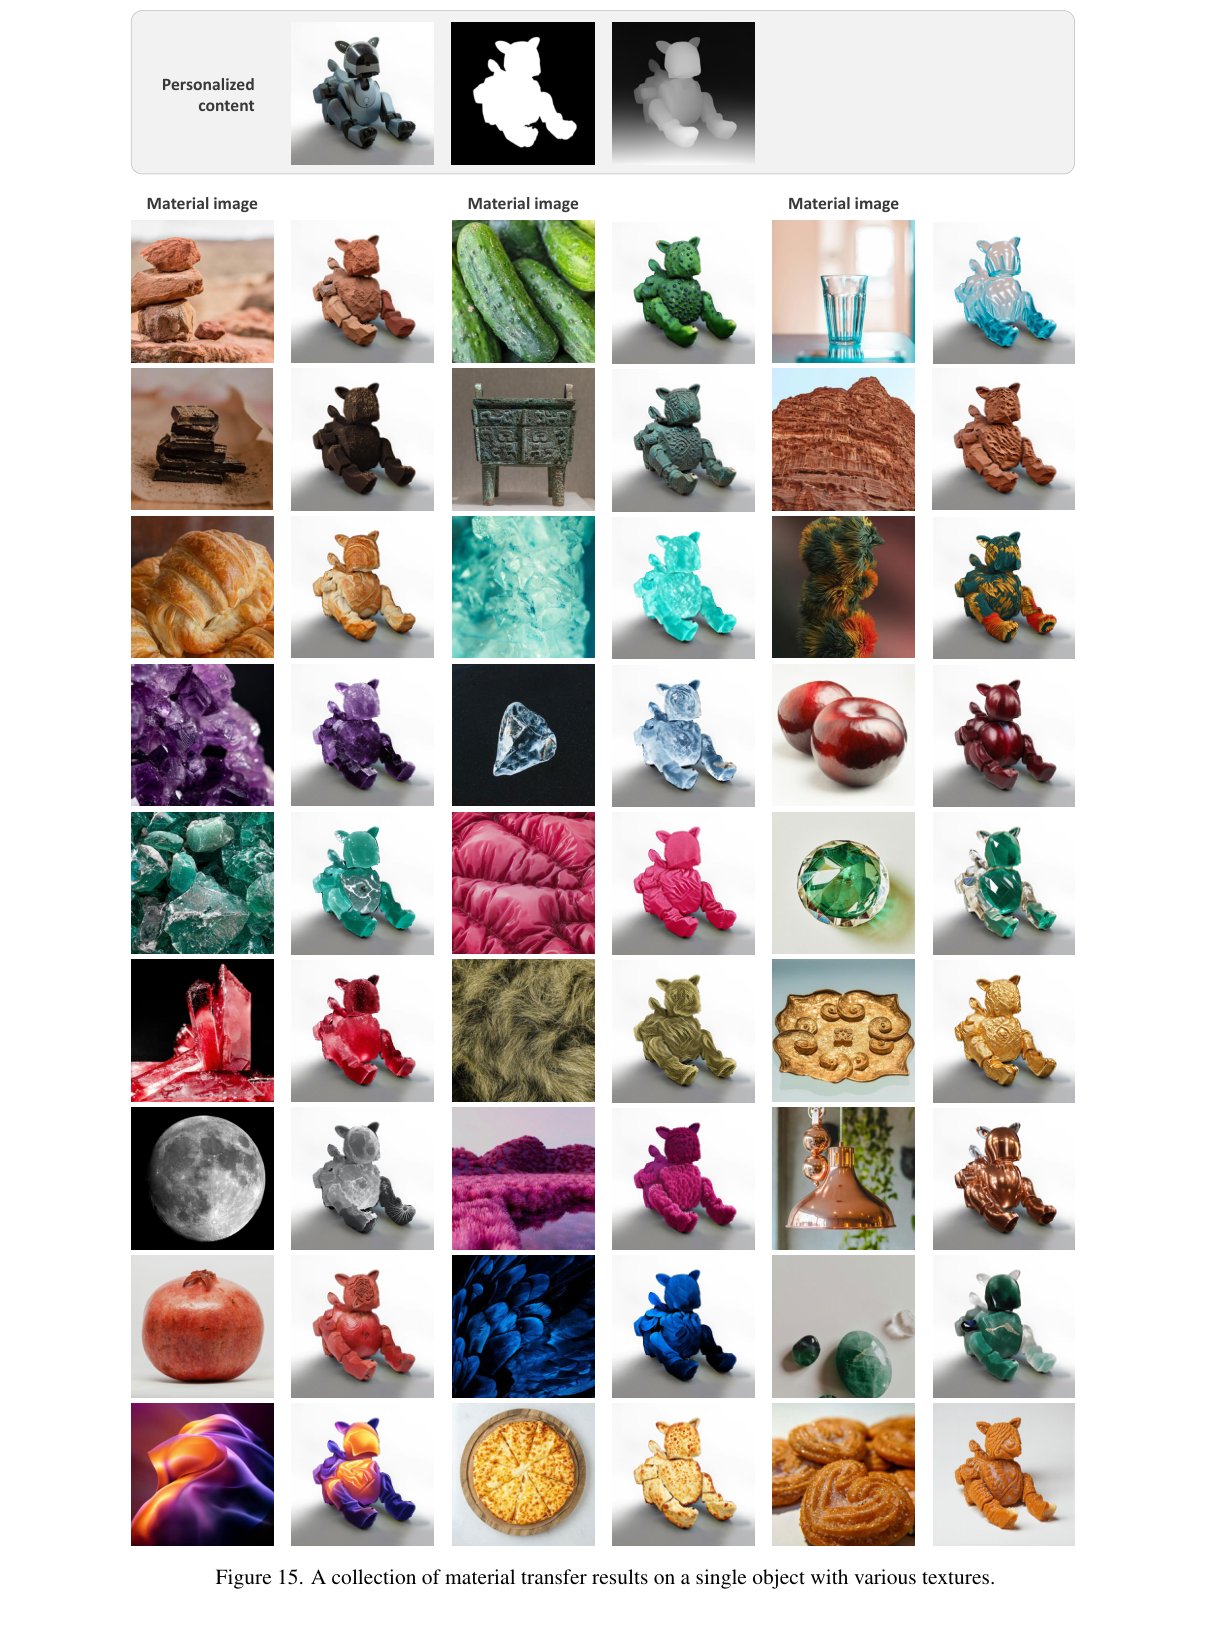
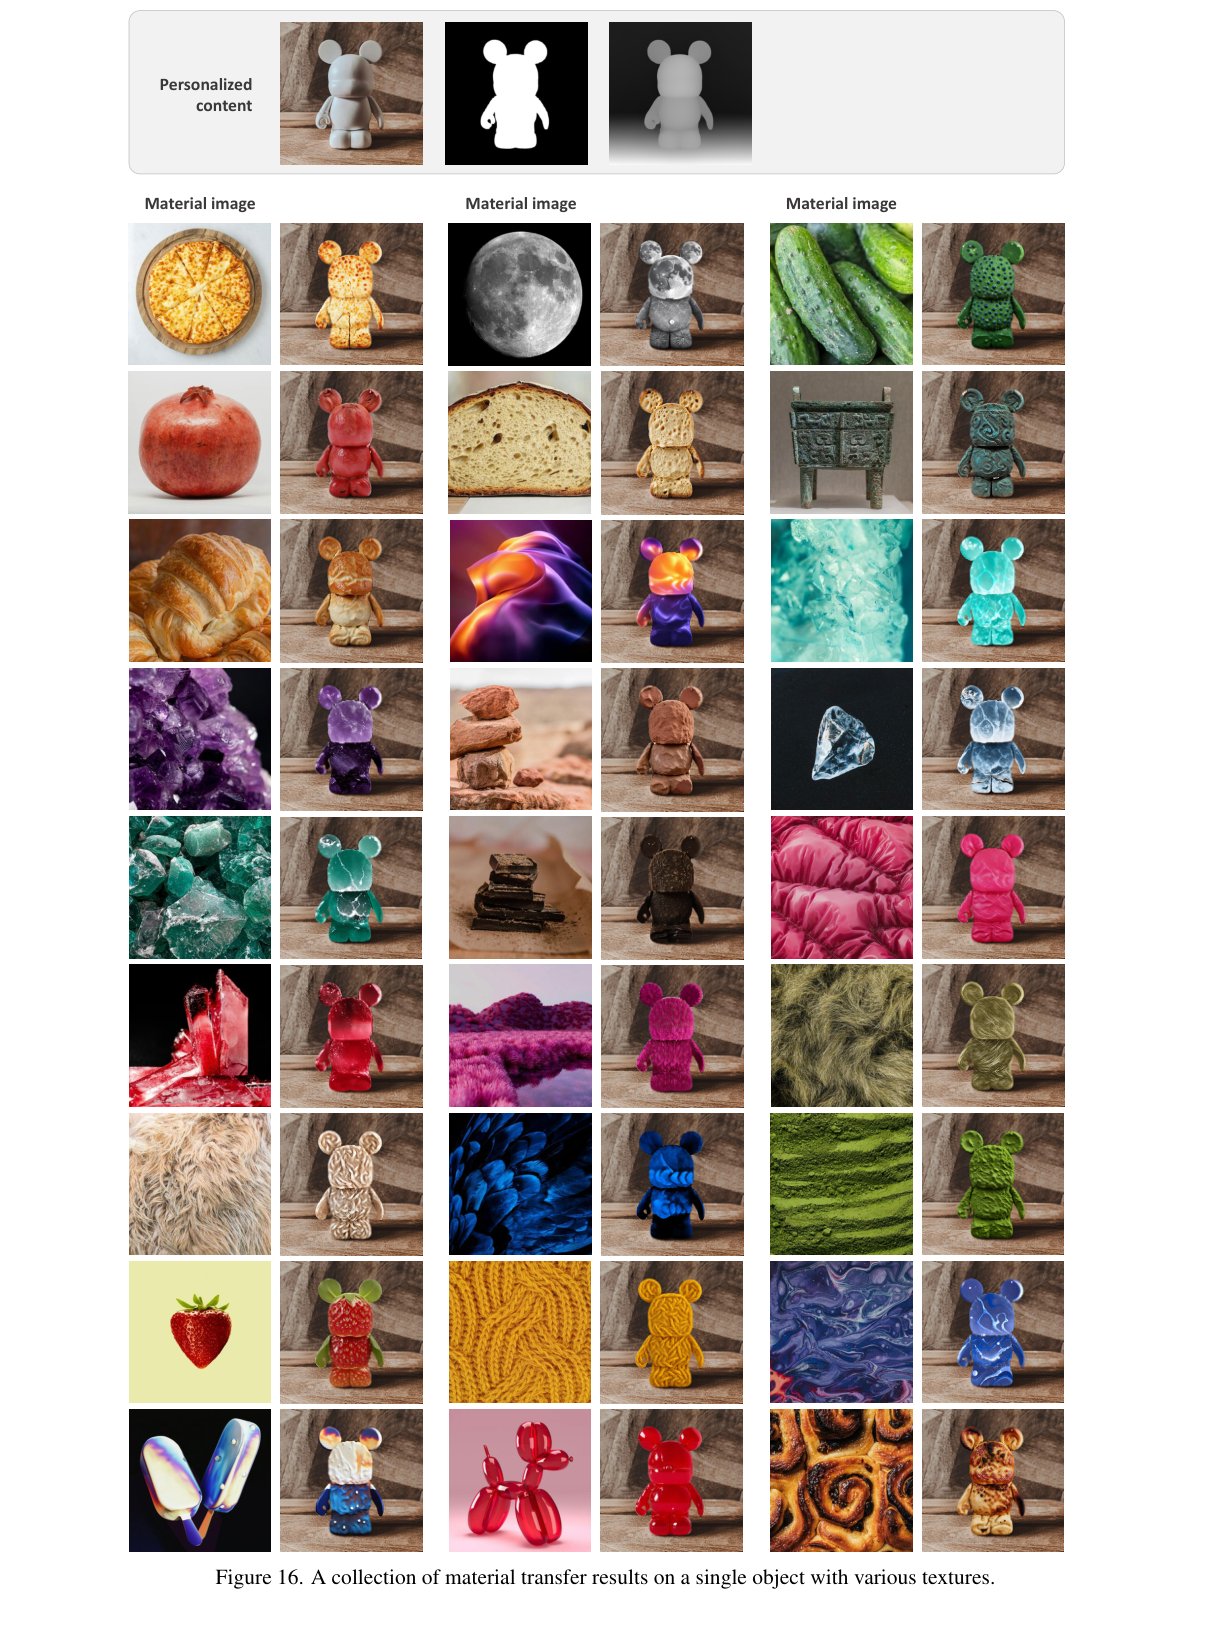
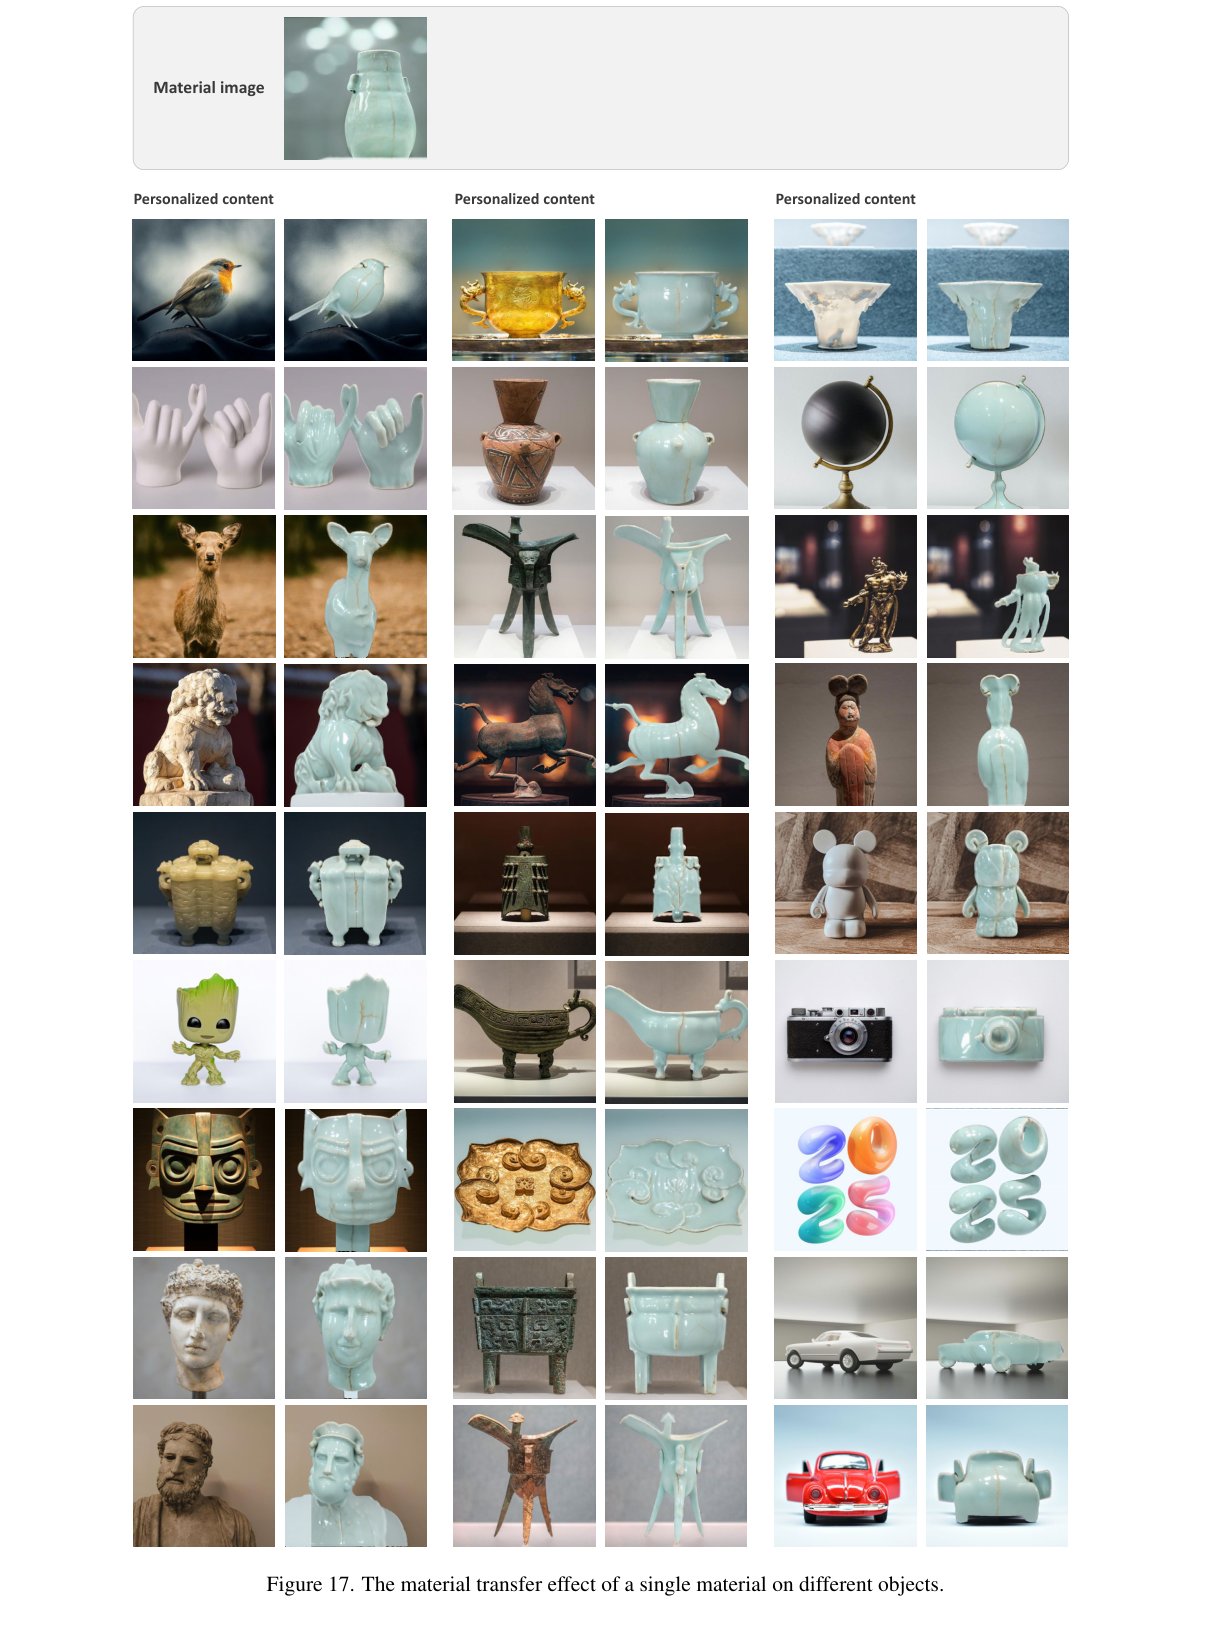
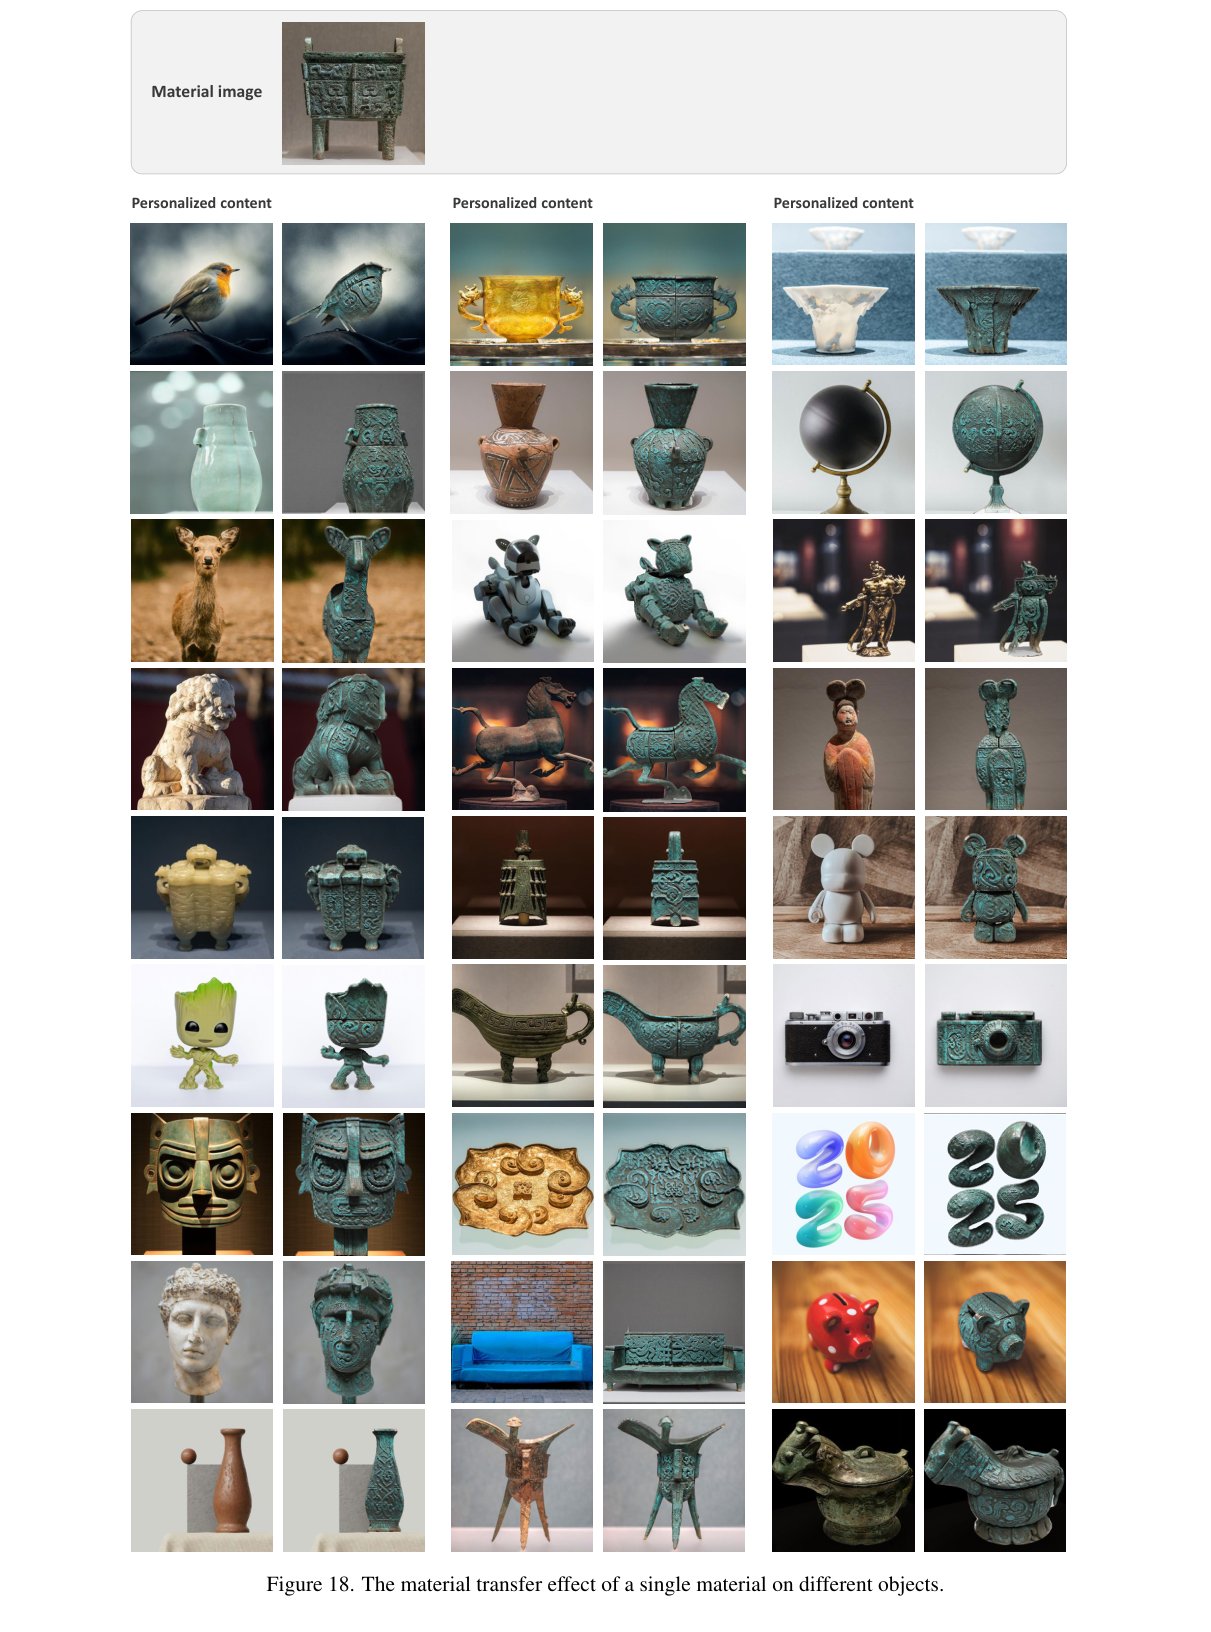
补充 Figure 15–18:前两图是单对象多材质,后两图是单材质多对象。支持视觉迁移多样性,但没有多视角、重光照或物理参数一致性验证。全部补充图以独立 S 编号前缀保留,避免与正文 Figure 1–10 混淆。
CVF 正文与补充公开了基线仓库、预训练深度 LoRA 来源,但补充配置表 Ours 的实现列为“—”。本次未找到可确证对应 ICCV 2025 MaTe 的独立官方代码版本。已查阅同作者 DealMaTe 仓库与 inference.py;这是另一个 2026 扩展工作,不能用于声称完全复现 MaTe。
实现区别:已读 DealMaTe inference.py 使用 Redux、depth/normal/lighting 三种 LoRA、25 步与 guidance 3.5;MaTe 本文报告深度 LoRA、8 步、CFG 30。后续代码末端按 mask==255 逐像素合成,也不能据此证明 MaTe 的式 9 逐步 latent blending 已正确实现。这一核查只用于隔离来源,未运行或安装该代码。
官方深度 LoRA 模型卡确认它从已训练的 FLUX.1 Depth dev 提取,并适用于 FLUX.1 dev;模型许可和 gated 权重访问另有要求。本任务只读取公开说明,没有接受协议或下载权重。
固定 FLUX checkpoint、采样步数、精度与分辨率,比较统一序列、加法注入、IP-Adapter+ControlNet,以及无 bias/无 LoRA/无灰度/无逐步 blending;分开报告前景、边界带和背景指标。统一 seed 列表、调参预算与遮挡/强反射难例。给出端到端时间、显存峰值、辅助模块参数和所有预处理耗时,才能证明“简化”真正落在用户成本上。
Research Extension,非原论文成果:MaTe 很适合产生“这个对象换成这种材质会怎样”的目标图,尚不提供可执行节点图。把它接到 PMG 系统时,应把输出作为视觉目标或候选,而不是直接称为材质资产。
将 \(C_M\) 从一段混合外观拆为 albedo、粗糙度、法线细节、磨损区域等条件组;给每对条件设置可解释偏置,避免参考光照污染 base color。需要专门的合成/分解监督,不能假定 RGB VAE 自然完成物理解耦。对照固定全局 \(\gamma\)、分区 \(\gamma\)、学习门控,评估额外自由度是否只是过拟合参考。
这是本页提出的目标,不是 MaTe 公式。G 是有类型的材质图,\(\phi\) 是节点参数,R 是真实渲染器,c 表示光照/视角,合法性项要求图可编译、节点连接类型正确、参数范围有效。MaTe 可以生成初始外观目标,但多条件目标必须具备一致来源;不能随意生成多张互相矛盾的 RGB 后要求一个真实材质同时拟合。
评价应同时包含参考外观、目标结构、物理重光照、程序合法率、图复杂度和渲染调用次数。单一 CLIP 得分不能评价可编辑性;背景 SSIM 更不应作为材质图恢复质量的主要证据。
覆盖清单:正文 Figure 1–10、公式 1–9、Table 1 全覆盖;补充 Figure 1–18、30 条原始 prompts、7 行 baseline 配置全部覆盖。保留主文/补充的数字冲突,未虚构训练超参数、评测配对总量或物理精度。
交付状态:中文 HTML 与完整 Markdown 新增段、原笔记前缀保留的合并候选仅作为下载产物。未发布、未改用户仓库。浏览器数学渲染、图片加载和 1440/760/390 像素布局验收依用户要求延期;静态检查与哈希验证记录随文件提供。