一张自然照片,以及人工或分割器给出的若干材质区域;不要求已知场景几何、相机或光照
01 · 一张照片,生成一组可重新打光的材质
Material Palette: Extraction of Materials from a Single Image,Ivan Lopes、Fabio Pizzati、Raoul de Charette。第一作者与末位作者署名 Inria,Fabio Pizzati 署名 University of Oxford。本文以 arXiv 2311.17060v1,2023-11-28 为固定主文;该工作后来发表于 CVPR 2024。阅读覆盖固定 PDF 全部 10 页(正文 8 页、参考文献 2 页),另读官方 CVPR 2024 补充材料 12 页。补充材料属于后续会议版,以下明确标记其来源,避免把版本差异混成同一实验。
每个区域独立优化一个 LoRA / DreamBooth 材质概念,再生成近似俯视、可平铺的 RGB 纹理
每种材质的 albedo、normal、roughness 贴图,可重新打光并替换 3D 场景材质
核心判断:本文最值得记住的是“先把难以直接分解的照片区域转成生成式纹理,再用域适应把纹理转成反射属性”的问题重构。它获取的是与观察区域相似、可用来渲染的材质资产,而不是对原场景真实 BRDF 的唯一物理测量。这个区别决定了如何解释生成细节、定量指标和后续程序化材质研究。
主文 p.1–2 · 官方项目与 CVPR 2024 署名 · 固定版本与来源清单
02 · 问题缺口:纹理复制不等于材质提取
传统材质采集通常依赖近距离正视图、受控光源、多视角或偏振设备。普通照片则把表面颜色、微表面方向、粗糙度、几何透视、阴影与照明混在一起。把一块照片直接平铺到模型上,会把原照片的阴影也当作 albedo;直接送进训练于正视 PBR 材质库的分解网络,又会遇到很强的分布偏移。
另一条直觉路线是先识别“砖、木、石”等类别,再让文生图模型生成该类纹理,但类别标签丢掉了这块材料特有的风化、污渍、排列与颜色。作者因此让模型学习区域实例的概念,而非只查询一个类别名称。纹理生成器负责把局部外观转成更适合分解的规范化纹理;分解器负责将“看上去像材质”的 RGB 图转成能参与光照计算的属性。
| 相邻任务 | 通常输入 / 输出 | 与本文的关键差别 |
|---|---|---|
| 图像 intrinsic decomposition | 整幅图像 → albedo / shading 或场景属性 | 更关注原场景逐像素解释;本文产生可复用、可平铺的区域材质 |
| 受控 SVBRDF capture | 材料近照 / 多视角 → 反射贴图 | 有较强采集假设;本文面对未知几何和光照的自然图像 |
| Texture scraping / synthesis | 区域或 patch → 更大 RGB 纹理 | 颜色排列不等于反射属性,残留阴影也不会自动消失 |
| PhotoScene | 场景图像与 CAD、有限程序化材质图 → 材质和光照适配 | 依赖场景 / 材质图先验;本文输出的是贴图,不预测图拓扑 |
| Material Palette | 照片与区域 → 多种 A / N / R 材质 | 借助生成先验获得可用资产;不能由此断言恢复了真实微观表面 |
论文验证:多区域输入、可平铺纹理、域适应与 3D 替换示例均有实验。作者解释:扩散模型能把材质外观从几何 / 光照中解耦。本文解读:这种解耦是统计生成先验提供的近似规范化,不是已证明的可辨识逆问题解。
03 · 输入、输出与符号
| 符号 | 含义 | 在系统中的位置 |
|---|---|---|
| \(\mathcal{I},\mathcal{R}_{i}\) | 输入 RGB 图像、其中第 i 个材质区域 | 区域可以由用户、SAM 或 Materialistic 提供 |
| \(P_{\mathrm{C}}\) | 从区域内部取出的正方形图像裁块 | 每个材质概念的少样本训练集 |
| \(S^{\ast},S^{c}\) | 特定区域的学习概念、已知材质类别词 | 前者用于实例提取;后者用于构造 TexSD 与 prompt 实验 |
| \(P_{\mathrm{SD}}\) | 概念条件下生成的 RGB 纹理 | 分解网络的测试输入;并非 ground-truth albedo |
| \(\widetilde{M},\widehat{M},M\) | 真实标签、源模型伪标签、预测材质 | 区分监督信息的可靠程度 |
| \(M=\{A,N,R\}\) | albedo RGB、表面法线、roughness | 材质像素属性;这里 R 与区域 \(\mathcal{R}\) 不同 |
| \(\rho_i,\rho_{\mathrm{rand}}\) | 给定光照 / 视角的渲染操作、随机配置渲染 | 生成训练输入和跨配置的渲染损失 |
| \(\mathcal{S},\mathcal{T},f^{\mathcal{S}},f^{\mathcal{T}}\) | 有标签材质域、生成纹理目标域、适应前 / 后分解器 | 监督预训练与无监督域适应 |
\[
\mathcal{I},\{\mathcal{R}_{i}\}_{i=1}^{K}
\longrightarrow \{S_{i}^{\ast}\}_{i=1}^{K}
\longrightarrow \{P_{\mathrm{SD},i}\}_{i=1}^{K}
\longrightarrow \{M_i=\{A_i,N_i,R_i\}\}_{i=1}^{K}.
\]
上式是对论文流程的整理,K 表示区域数量,避免与 normal map 的 N 混淆。每个区域独立处理,输出材质贴图与原照片坐标没有一一对应要求;纹理重复、放大、变化是资产生成的特性,不是像素忠实重建指标。
论文不输出 mesh、物理尺度、材质节点图、SBS/SBSAR、shader program 或完整 BRDF 族参数,也不直接估计原场景光源。金属度、透射、各向异性等没有成为主要预测通道。后续 Blender 中的 displacement 是由 normal 经外部 DeepBump 推导,用于展示,并非分解网络的第四个预测头。
主文 Eq.(1)、Figure 2 · 补充材料 §C,Blender rendering

04 · 区域概念:从裁块学习可采样的材质身份
裁块与分辨率为什么重要
输入区域可能很小、很细或边缘不规则。作者用滑动窗口寻找区域内的正方形裁块,在可容纳的尺度中优先选最大的裁块,以保留局部图案而减少把背景混进材质。补充材料列出 \(c_x\in\{32,64,128,256\}\),步幅为 \(c_x/5\);当前官方代码的候选尺寸则为 512、256、192、128、64,掩码覆盖率阈值 0.99,最多保留 100 块,选到某尺度就停止向更小尺度搜索;不足 2 块时跳过该区域。这些差异不能默认为同一次实验的精确设置。
学习概念时统一缩放到 \(c_{\mathrm{in}}=256\)。若 64 像素的真实 patch 强行放大到 SD 原生 512,尺度失真会更严重;反过来,把概念训练分辨率降低并不要求推理也只能输出 256。论文 Figure 9 以 64 / 128 裁块和 128 / 256 / 512 训练尺寸展示这种权衡。
LoRA DreamBooth,而非只优化一个孤立词向量
训练 prompt 为 an object with S* texture
。正文把学习结果称作概念 token \(S^{\ast}\),但实现是把稀有标识词与区域裁块关联,并微调 LoRA 适配器;不能将其理解为标准 textual inversion 中只学习一枚 embedding。代码冻结 VAE,并在 U-Net 的 query/value 投影与文本编码器 q/v 投影中加入低秩可训练参数。
\[
W=W_0+\frac{\alpha}{r}BA,\qquad
\mathcal{L}_{\mathrm{concept}}
=\mathbb{E}_{P_{\mathrm C},t,\epsilon}
\left\|\epsilon_{\theta+\Delta\theta}
(z_t,t,E_{\phi+\Delta\phi}(p(S^{\ast})))-\epsilon\right\|_2^2.
\]
代码机制的数学整理:\(W_0\) 是预训练权重,A、B 是低秩矩阵,r 是 rank,\(\alpha\) 控制更新缩放;\(z_t\) 是裁块经 VAE 编码后加噪的 latent,E 是文本编码器,p 是 prompt。代码默认用噪声预测 MSE,也保留 v-prediction 分支。它让生成器记住实例纹理,但没有直接施加“输出必须等于真实 albedo”的监督。
训练 prompt 与生成 prompt 分工
训练要覆盖“带有此纹理的物体”这一概念;生成时用 top view、realistic、texture 等词把概念投影到平面纹理图。作者使用四个生成模板:realistic S* texture in top view
、high resolution realistic S* texture in top view
、top view realistic S* texture
、top view realistic texture of S*
。它们不是 LLM agent 的系统提示,也不存在工具调用、搜索树或外部推理链。
论文对同一概念可采样多个候选,并依据与区域裁块的 LPIPS 选择合适纹理;正文没有充分给出候选数、跨裁块聚合方式、候选 seed 列表。发布代码明确不包含 LPIPS 过滤 / 排序,每个区域只生成一个样本。因此“跑通公开 pipeline”和“复现论文 best-of 候选协议”是两项不同工作。
05 · 平铺与高分辨率:扩散边界和解码边界分别处理
训练概念不自动保证无缝。作者借鉴 ControlMat,在每个去噪时间步将整幅 latent 随机循环平移,再预测噪声并反向移回。这样固定边界不会一直位于网络看到的同一接缝处,材料结构可跨原边界延续。
\[
\widehat{\epsilon}_t=
T_{-\delta_t}\!\left(
\epsilon_{\theta}(T_{\delta_t}(z_t),t,S^{\ast})
\right),\qquad
z_{t-1}=\mathrm{Step}(z_t,\widehat{\epsilon}_t,t).
\]
算法示意:\(T_{\delta_t}\) 是二维循环位移,\(\delta_t\) 每步随机。实际代码先把 patches 拼成大 latent、roll、重新切块,分批预测后再 unroll,并用 CFG 合并条件与无条件预测。平铺连续性来自跨边界的一致去噪;它不恢复真实毫米尺度或图案周期。
补充材料说明 SD 1.5 的 VAE 直接输出到 1024 仍有可用质量;更高分辨率则采用重叠 512×512 patches 解码,四周重叠 8 像素,使用加权平均消除拼块接缝。正文 / 补充材料还提到用 Poisson solving 去掉边界残余缝;固定公开代码 concept/infer.py 可见的是 circular padding 与 weighted blending,没有独立 Poisson 步骤,不能把文字里的后处理当作已由这份入口完整执行。
\[
P(x)=\frac{\sum_j w_j(x)P_j(x)}
{\sum_j w_j(x)},\qquad
P'_c=\mathrm{clip}_{[0,1]}
\left(\frac{P_c-\mu_{P,c}}{\sigma_{P,c}}
\sigma_{\mathcal{R},c}+\mu_{\mathcal{R},c}\right).
\]
第一式解释重叠块加权融合;第二式解释按输入区域逐颜色通道进行的均值 / 标准差重归一化,c 在这里表示 RGB 通道。颜色校正减少色偏,但参考统计本身仍含输入光照,所以它并非真正的 illumination calibration。实现还先排除区域灰度分布两端约 0.5% 的像素,再计算参考颜色统计。
补充材料 Table 3:50 步去噪的完整时间表
| 输出边长 | 1024(1K) | 2048(2K) | 4096(4K) | 8192(8K) |
|---|---|---|---|---|
| 512 patch 数 n | 4 | 16 | 64 | 256 |
| 去噪时间 | 11 s | 43 s | 170 s,约 3 min | 685 s,约 11 min |
| GPU / 显存 | Tesla V100,16 GB;高分辨率按 16 patches 分批处理 | |||
这是十次运行的去噪计时,不包括每区域约 3–5 分钟的概念优化、区域分割、候选筛选、分解和场景渲染。近似 \(t\simeq 2.7n\) 秒,边长翻倍使 patch 数约四倍;“任意分辨率”不代表常数算力,也不等于所有细节都来自输入照片。
06 · SVBRDF 分解:监督、多视角约束与伪标签桥接
为什么单视角回归还不够
对于已知渲染条件的材料,论文写成 \(P=\widetilde{\rho}(\widetilde M)\),希望 \(f(P)=M\simeq\widetilde M\)。即便光照已知,单幅图像中也能通过改变 normal 与 roughness 获得相近颜色,Figure 3 显示单视角训练会退化。因此训练同时看属性贴图误差与同一材质在多种配置下的渲染差。
\[
\mathcal L_{\mathrm{reg}}=\|M-\widetilde M\|_1,\qquad
\mathcal L_{\mathrm{ren}}=\sum_{i=1}^{n}
\|\widetilde\rho_i(M)-\widetilde\rho_i(\widetilde M)\|_1.
\]
\[
\mathcal L_{\mathrm{source}}
=\lambda\mathcal L_{\mathrm{reg}}+\mathcal L_{\mathrm{ren}},
\qquad M=f^{\mathcal S}(\rho_{\mathrm{rand}}(\widetilde M)),
\qquad n=9.
\]
Eq.(2) 的 regression loss 限制属性本身,rendering loss 限制属性组合所产生的外观。9 个光照 / 视角配置包含 6 个对称配置以强调镜面反射,以及 3 个均匀随机配置。训练输入另用随机光照生成,以免分解器记住一个固定拍摄配置。补充材料给出 \(\lambda=0.1\)。
目标域没有真实属性:用源模型给出起点
ACG 的渲染贴图和 SD 生成的纹理仍不服从相同分布。TexSD 用类别 prompt 生成纹理,并不为每个样本采集多视角或真实属性。作者先以源模型产生伪标签 \(\widehat M=f^{\mathcal S}(\widetilde P_{\mathrm{SD}})\),再将这些伪材质重新渲染,构造目标域伪多视角监督。
\[
\widehat M=f^{\mathcal S}(\widetilde P_{\mathrm{SD}}),\qquad
P_{\mathcal T}^{\mathrm{train}}=\rho_{\mathrm{rand}}(\widehat M),\qquad
\mathcal L_{\mathcal T}
=\lambda\|f^{\mathcal T}(P_{\mathcal T}^{\mathrm{train}})-\widehat M\|_1
+\sum_{i=1}^{9}
\|\rho_i(f^{\mathcal T}(P_{\mathcal T}^{\mathrm{train}}))-\rho_i(\widehat M)\|_1.
\]
最后一式是对正文训练叙述的展开,不是额外宣称论文提供了这一独立编号公式。适应阶段同时保留源域真实标签和目标域伪标签,避免仅用生成数据导致遗忘。推理时才直接把区域生成的 \(P_{\mathrm{SD}}\) 输入适应后的 \(f^{\mathcal T}\)。
解释边界:伪多视角是同一估计材质在多个已知条件下的合成观察,不是拍到了更多真实信息。它能加强物理一致性与分布覆盖,但源模型的系统性偏差也可能被继承。TexSD 本身不含真实 SVBRDF,因此域适应的主要数值证明使用 PH / CGB 等有标签替代域,不能直接等同于真实场景物理参数已得到准确恢复。

分解网络与属性参数化
共享 ResNet-101 encoder,U-Net 式 skip connections,三个独立 upsample-conv decoder;输出通道为 albedo 3、normal 2、roughness 1。补充材料说 normal 将 z 设为 1 后归一化;当前实现具体先将 tanh 输出的 x/y 乘以 3,再拼 z=1 并单位化。A 与 R 的 tanh 输出映射到 [0,1],R 为渲染复制为三通道,导出 albedo 时做 gamma encode。
\[
A=\frac{\tanh(a)+1}{2},\qquad
R=\frac{\tanh(r)+1}{2},\qquad
N=\frac{(3\tanh(n_x),\,3\tanh(n_y),\,1)}
{\|(3\tanh(n_x),\,3\tanh(n_y),\,1)\|_2}.
\]
这组式子是固定代码的后处理,而非从正文直接抄出的模型定义。由于 z 正且固定,法线不是无约束三维向量。损失实现对 A、R 使用 \(\log(x+0.01)\),对 rendered RGB 使用 \(\log(x+0.1)\),normal 用普通 L1。log 的作用应理解为改变亮暗 / 相对误差权重,不宜简单转述成“只会加重绝对大误差”。
Eq.(1–3)、Figure 3–4 · 补充 §A.2 / Figure 15 · routine.py · loss.py
07 · 数据、训练与推理配置:可复现到什么程度
| 模块 / 数据 | 论文及补充材料公开设置 | 需要区分的限制 |
|---|---|---|
| AmbientCG,源域 | 约 2,000 PBR 材质、约 50 类,使用 2K 贴图 | 材质数量并非随机 crop 数;当前代码按清单顺序 95% / 5% 划分 train / valid |
| PH / CGB | 两库各约 320 材质;ID 子集分别为 53 / 58 个材质;正文称 PH 另测 47 个 OOD 类别 | 是有标签适应评估域;这不是端到端自然照片真值集 |
| TexSD,目标域 | v1:9,000 张 1024×1024,130 类,ACG 词表加 ChatGPT 提出的补充类别 | 同类图片是不同实例变化,不是同材质多视角;当前项目发布页写 10,000,版本不同 |
| OpenSurfaces | 自然照片与材料区域标签;映射为与 ACG 共同的 14 类 | 区域标签是材料类别,不是逐像素 A/N/R 真值 |
| 概念训练 | SD 1.5;LoRA DreamBooth;800 steps;batch 1;lr 10⁻⁴;256 输入;随机水平 / 垂直翻转;V100 16GB,3–5 min / 区域 | 补充 Figure 13 显示 400 步有时已可用,但默认取 800;不做随机旋转以避免改变方向性纹理 |
| 源分解器 | ResNet-101 + 3 decoder;1000 epochs;batch 4;Adam,lr 10⁻⁴;λ=0.1 | 512 crops、翻转、90° 增量旋转;总参数量、完整训练时长、完整 seed 统计未在正文 / 补充中明确 |
| 域适应 | 源+目标继续训练 100 epochs;batch 2+2;源真实标签、目标伪标签 | 不能把 target pseudo-label 当实测 truth;公开 retraining 路径完整性需额外核查 |
| 纹理推理 | 多个 prompt / seeds 可产生变化;论文用 LPIPS 选择;高分辨率 tile / batch decoding | 代码默认:1024,50 denoising steps,CFG 7.5,seed 1,p1,wmean,每区域单样本 |
| 分解推理 | 适应后的分解器单次预测 A/N/R | 公开 predict 配置 input_size=512,不能把“8K 纹理生成”直接写成“8K 神经分解” |
代码公开的补充超参数
固定版本概念训练默认 U-Net LoRA rank 16 / alpha 27、text encoder rank 16 / alpha 17、dropout 0,AdamW 的 β=(0.9,0.999)、weight decay=0.01、epsilon=10⁻⁸、gradient clip=1,constant scheduler / warmup 0、fp16。VAE 冻结,U-Net 与默认启用的 text encoder 通过 LoRA 训练。分解器实现的 Adam weight decay=10⁻⁴。它们来自 2026-09-30 核查的代码快照,而不是声称 v1 主文逐项列出。
推理代码沿用所加载 StableDiffusionPipeline 的 scheduler,并没有在这份入口中显式替换 sampler,因此复现时应记录所用 checkpoint 的 scheduler 配置,不能凭经验填成 DDIM 或 DPM-Solver。代码 negative prompt 为空字符串,使用固定步数终止,未做 beam search、top-k、重试或自动重排名;这些自回归生成术语不应机械套到扩散采样上。
本文没有“基础模型 vs 大模型”两套规模结果,只有 SD 1.5 与 ResNet-101 这套系统,以及 1K / 2K / 4K / 8K 分辨率扩展。论文没有公开一个更大的 backbone ablation;不得将高分辨率输出误写成大模型配置。
区域提议的实际人工参与
SAM 先保留 16 个最大 masks;若两 mask IoU 大于 0.5,丢掉较大的,以减少一个 mask 含多种材质。Materialistic 实验的查询点来自每个人工定义区域内的随机点,所以该分支有人工区域先验,不能按“完全没有人工信息”与 SAM 等同。人工区域由单一标注者给出。补充材料还公开:仅为可视化,若生成图与裁块 LPIPS 大于 0.65,就丢弃该区域;这会影响展示质量分布,不应悄悄当成所有数据的定量测试协议。
08 · 主结果一:域适应究竟改善了哪些通道
Table 1 用 PH / CGB 的真实贴图评估分解器,指标是 A/N/R 的 MSE 与 SSIM。SurfaceNet 基线在同一架构上重实现并从同一 ACG 源模型继续训练;Deep Materials 是现成分解网络。前者更适合隔离适应策略贡献,后者还混合了架构、训练域和配置差别。
下面完整重建原 Table 1 的三组、四种方法与全部指标。MSE 按原表标记 MSE (10e1) 保留原报数,不自行猜测其记法对应的还原倍率。Δ 为作者报告的跨属性相对综合增益;不是本文计算的显著性检验。加粗表示该数据组、该指标最优,等值共同加粗。
| 测试组 | 方法 | DA | MSE A ↓ | MSE N ↓ | MSE R ↓ | SSIM A ↑ | SSIM N ↑ | SSIM R ↑ | Δ% ↑ |
|---|---|---|---|---|---|---|---|---|---|
| PH ID | Deep Materials | 否 | 0.264 | 0.380 | 0.453 | 0.379 | 0.235 | 0.358 | — |
| PH ID | Source-only | 否 | 0.083 | 0.300 | 0.475 | 0.610 | 0.304 | 0.458 | 基准 |
| PH ID | SurfaceNet | 是 | 0.071 | 0.298 | 0.427 | 0.626 | 0.304 | 0.472 | +5.18 |
| PH ID | Ours | 是 | 0.069 | 0.291 | 0.443 | 0.630 | 0.309 | 0.476 | +5.87 |
| CGB ID | Deep Materials | 否 | 0.590 | 0.465 | 1.940 | 0.392 | 0.228 | 0.346 | — |
| CGB ID | Source-only | 否 | 0.098 | 0.221 | 0.555 | 0.662 | 0.437 | 0.476 | 基准 |
| CGB ID | SurfaceNet | 是 | 0.101 | 0.230 | 0.615 | 0.657 | 0.445 | 0.471 | −3.00 |
| CGB ID | Ours | 是 | 0.084 | 0.219 | 0.588 | 0.669 | 0.457 | 0.482 | +2.62 |
| PH OOD | Deep Materials | 否 | 0.264 | 0.380 | 0.453 | 0.379 | 0.235 | 0.358 | — |
| PH OOD | Source-only | 否 | 0.065 | 0.247 | 0.439 | 0.608 | 0.284 | 0.518 | 基准 |
| PH OOD | SurfaceNet | 是 | 0.053 | 0.250 | 0.415 | 0.608 | 0.283 | 0.524 | +3.94 |
| PH OOD | Ours | 是 | 0.053 | 0.246 | 0.409 | 0.618 | 0.288 | 0.531 | +5.24 |
可支持的结论:本文综合 Δ 在 PH ID / CGB ID / PH OOD 分别为 +5.87%、+2.62%、+5.24%,且多数单通道更好;相对 Source-only,PH ID albedo MSE 从 0.083 到 0.069,下降约 16.9%。不可省略的反例:PH ID roughness MSE 仍差于 SurfaceNet;CGB roughness MSE 从源模型的 0.555 升到 0.588,约恶化 5.9%,即使 SSIM R 提升。这是像素精度与结构相似度的 trade-off,不能简写为“全部指标提升”。这些百分比为本页直接按表格算出的描述统计,无置信区间。
PH OOD 的 SurfaceNet normal MSE / SSIM 分别 0.250 / 0.283,略差于 Source-only 的 0.247 / 0.284;作者方案在该域维持更均衡的结果。不过未报告多 seed 均值方差,不能据 0.001 的差值做强显著性断言。

输入纹理

Source-only A

Source-only N

Source-only R

Source-only 渲染

UDA A

UDA N

UDA R

UDA 渲染
09 · 主结果二:相似材料、正确类别与真实实例是三层证据
Table 2 左:跨数据集类内相似性
OpenSurfaces 与 ACG 没有同一真实物体的材质配对。作者将两套标签映射成 14 个共同类别,每类抽取 100 对材料,计算 A/N/R 的 LPIPS 并在类别间平均。被称作 upper bound 的一行把提取材质与其他类别的 ACG 配对;lower bound 则让源库材料自身经单视角分解后与同类 ground truth 配对。这里是参考对照,而非数学意义上有保证的上下界。
| 来源 / 区域提议 | LPIPS A ↓ | LPIPS N ↓ | LPIPS R ↓ |
|---|---|---|---|
| Upper bound:跨类别对照 | 0.8288 | 0.5915 | 0.7255 |
| Ours:OS ground-truth masks | 0.7959 | 0.5730 | 0.7142 |
| Ours:SAM | 0.8048 | 0.5692 | 0.7096 |
| Ours:Materialistic | 0.8077 | 0.5678 | 0.7169 |
| Lower bound:ACG 自身分解对照 | 0.6789 | 0.4629 | 0.6843 |
加粗只在三种 Ours 区域方案中比较。所有方案优于跨类别上界对照,但都没有优于 ACG 自身分解对照;v1 p.7 有一句“improving over the lower bound”的措辞与低者为优的数值不一致,应以表中事实为准。OS mask 的 albedo 相对跨类别对照只下降约 4.0%;这支持“保留某些类内特征”,不能证明找回了拍摄对象的独特 BRDF。
Table 2 右:CLIP zero-shot 分类
将预测材质在随机光照下重新渲染,再以 CLIP ViT-B/32 做共同材质类的零样本分类。较高分说明渲染仍具有类别可识别性;CLIP 不能替代 BRDF 实测、能量守恒、镜面 lobe 或粗糙度数值准确度的评估。
| 渲染材质 | Top-1 ↑(%) | Top-5 ↑(%) |
|---|---|---|
| ACG ground truth | 47.78 | 85.88 |
| Ours:OS masks | 47.03 | 85.12 |
| Ours:SAM | 43.71 | 80.83 |
| Ours:Materialistic | 50.89 | 86.82 |
Materialistic Top-1 比 ACG 高 3.11 个百分点,不能推出它在物理上比 ground truth 更真实;更可能同时反映类别典型性、图案清晰度、区域筛选与分类器偏好。SAM 低于 OS masks,说明区域提议方式不是无关变量。
Figure 8 表内结果:合成场景的端到端还原
作者在两个 3D 场景、四个视点中替换 ACG 材料,报告总计 174 张图,涉及 16 个主要类别、每类 10 个候选材质。论文没有完整展开组合如何筛成 174,不能直接把几项数字相乘当样本总量。因替换材质具有已知贴图,可以将整条“区域 → 概念 → 纹理 → 分解”管线与 ground truth 比较。结果如下,保留三种方法全部值。
| 端到端候选 | LPIPS A ↓ | LPIPS N ↓ | LPIPS R ↓ |
|---|---|---|---|
| SD rand.:用真实类别词随机生成 | 0.8163 | 0.6895 | 0.7441 |
| Ours(user regions) | 0.6839 | 0.6254 | 0.5951 |
| ACG rand.:同类库中随机材质 | 0.6547 | 0.4508 | 0.5600 |
相对类别条件随机 SD,本文 A/N/R 的 LPIPS 分别下降约 16.2% / 9.3% / 20.0%,说明实例区域条件有价值;但同类别随机 ACG 在三通道仍更好,尤其 normal。原因可能包括分解误差、生成误差与 ACG 域一致性的共同作用。这一事实削弱“已忠实捕获实例物理材质”的强说法,同时并不否定其对材质库之外独特外观的实用性。
补充材料 Table 4:14 类映射全表
| OpenSurfaces 类(标签 id) | ACG 对应类 |
|---|---|
| brick(01) | brick |
| cardboard(02) | cardboard |
| carpet(03) | carpet |
| fabric(05) | fabric |
| laminate(11) | wood floor |
| leather(12) | leather |
| paper(16) | paper |
| plastic(17) | plastic |
| polished stone(18) | marble / granite |
| stone(21) | paving stone |
| tile(22) | tiles |
| wallpaper(23) | wallpaper |
| wicker(24) | wicker |
| wood(25) | wood |
主文 Table 2、§4.4、Figure 8 · 补充 Table 4

已知 ACG 材质渲染的输入场景

选定材料区域

提取后重渲染场景
10 · 消融:prompt、尺度、收敛、接缝与色偏
Figure 10:全部生成 prompt 数字
每个 ACG 类生成 10 张图,再经分解网络,以 ACG 的属性 / 渲染数据评估 FID、KID。以下严格保留原图的缩放:FID 数值为实际 FID 乘 \(10^{-2}\),KID 数值为实际 KID 乘 \(10^{2}\)。例如表中的 FID 1.55 对应未缩放的 155。它们是生成分布的指标,不是逐实例匹配误差。
| 类别词生成模板 | FID A ↓ | FID N ↓ | FID R ↓ | KID A ↓ | KID N ↓ | KID R ↓ |
|---|---|---|---|---|---|---|
| a photo of a Sᶜ | 1.89 | 1.74 | 1.83 | 2.60 | 6.52 | 3.75 |
| a Sᶜ material | 1.83 | 1.60 | 1.67 | 2.38 | 5.42 | 2.74 |
| a Sᶜ texture | 1.72 | 1.54 | 1.63 | 1.82 | 5.27 | 2.86 |
| realistic Sᶜ texture in top view | 1.55 | 1.27 | 1.59 | 1.54 | 3.34 | 3.32 |
| high resolution realistic Sᶜ texture in top view | 1.55 | 1.30 | 1.55 | 1.71 | 3.48 | 3.34 |
“texture”“top view”明显有助于 albedo / normal 分布,但 roughness KID 最好的是较简单的 a Sᶜ material
。所以更详细 prompt 并非每项都更好。并且表同时改变多个词,不能因其相关性就把效果归因于一个词的独立因果作用。
其他消融的证据与局限
| 图 / 改变因素 | 实验观察 | 可以得出的结论 | 未证明的内容 |
|---|---|---|---|
| Figure 9 上:crop 尺度、输入缩放 | 64 / 128 裁块;训练尺寸 128 / 256 / 512;选择较大裁块 + 256 输入 | 少样本纹理概念对尺度失真敏感 | 没有全面的按材质类别统计最优尺度 |
| Figure 9 下:4 个训练模板 | 比较 photo-of-texture、S*、photo-of-a、object-with-texture,跨 3 种生成模板展示 | 生成模板的影响比训练模板更明显 | 不是所有训练 / 生成组合的定量置信区间 |
| 补充 Figure 12:concat vs weighted mean | 直接拼接出现缝,重叠加权较平滑 | VAE 解码边界需要单独处理 | 没有客观 seam-energy 指标或所有尺度统计 |
| 补充 Figure 13:50 至 1200 steps | 400 有时已可用,800 通常更好 | 概念优化不是必须固定跑到最大步数才出现结构 | 没有全数据集速度质量 Pareto 曲线 |
| 补充 Figure 14:颜色归一化 | 输出颜色更贴近输入区域 | 降低生成器色偏 | 不证明输入区域颜色已去光照、已校准成真实 albedo |
| Table 1:加入域适应 | 多数属性改善,但 R 的 MSE 有反例 | 目标分布与渲染伪监督有帮助 | 缺少逐一移除伪标签、源域混合、九视角的完整 factorial ablation |

crop64 原区域

crop64 / train128 样本1

crop64 / train128 样本2

crop64 / train256 样本1

crop64 / train256 样本2

crop64 / train512 样本1

crop64 / train512 样本2

crop128 原区域

crop128 / train128 样本1

crop128 / train128 样本2

crop128 / train256 样本1

crop128 / train256 样本2

crop128 / train512 样本1

crop128 / train512 样本2
11 · 真实图像证据与 3D 应用
Figure 5 比较 DeepTex、image quilting、PSGAN 与 Li 等的区域纹理提取方法。作者使用与 Li 等相同区域,统一展示 2048×2048 输出与局部放大。Material Palette 的核心优势是能产生平面、近似均匀照明的纹理变化,而简单复制 / 合成可能继续携带照片阴影和几何畸变。下图采用官方项目页的 Figure 5 展示版,包含四种材料的完整比较;固定 arXiv HTML 的相关子图地址返回 404,因此改用可访问的作者原图,保留明确来源。
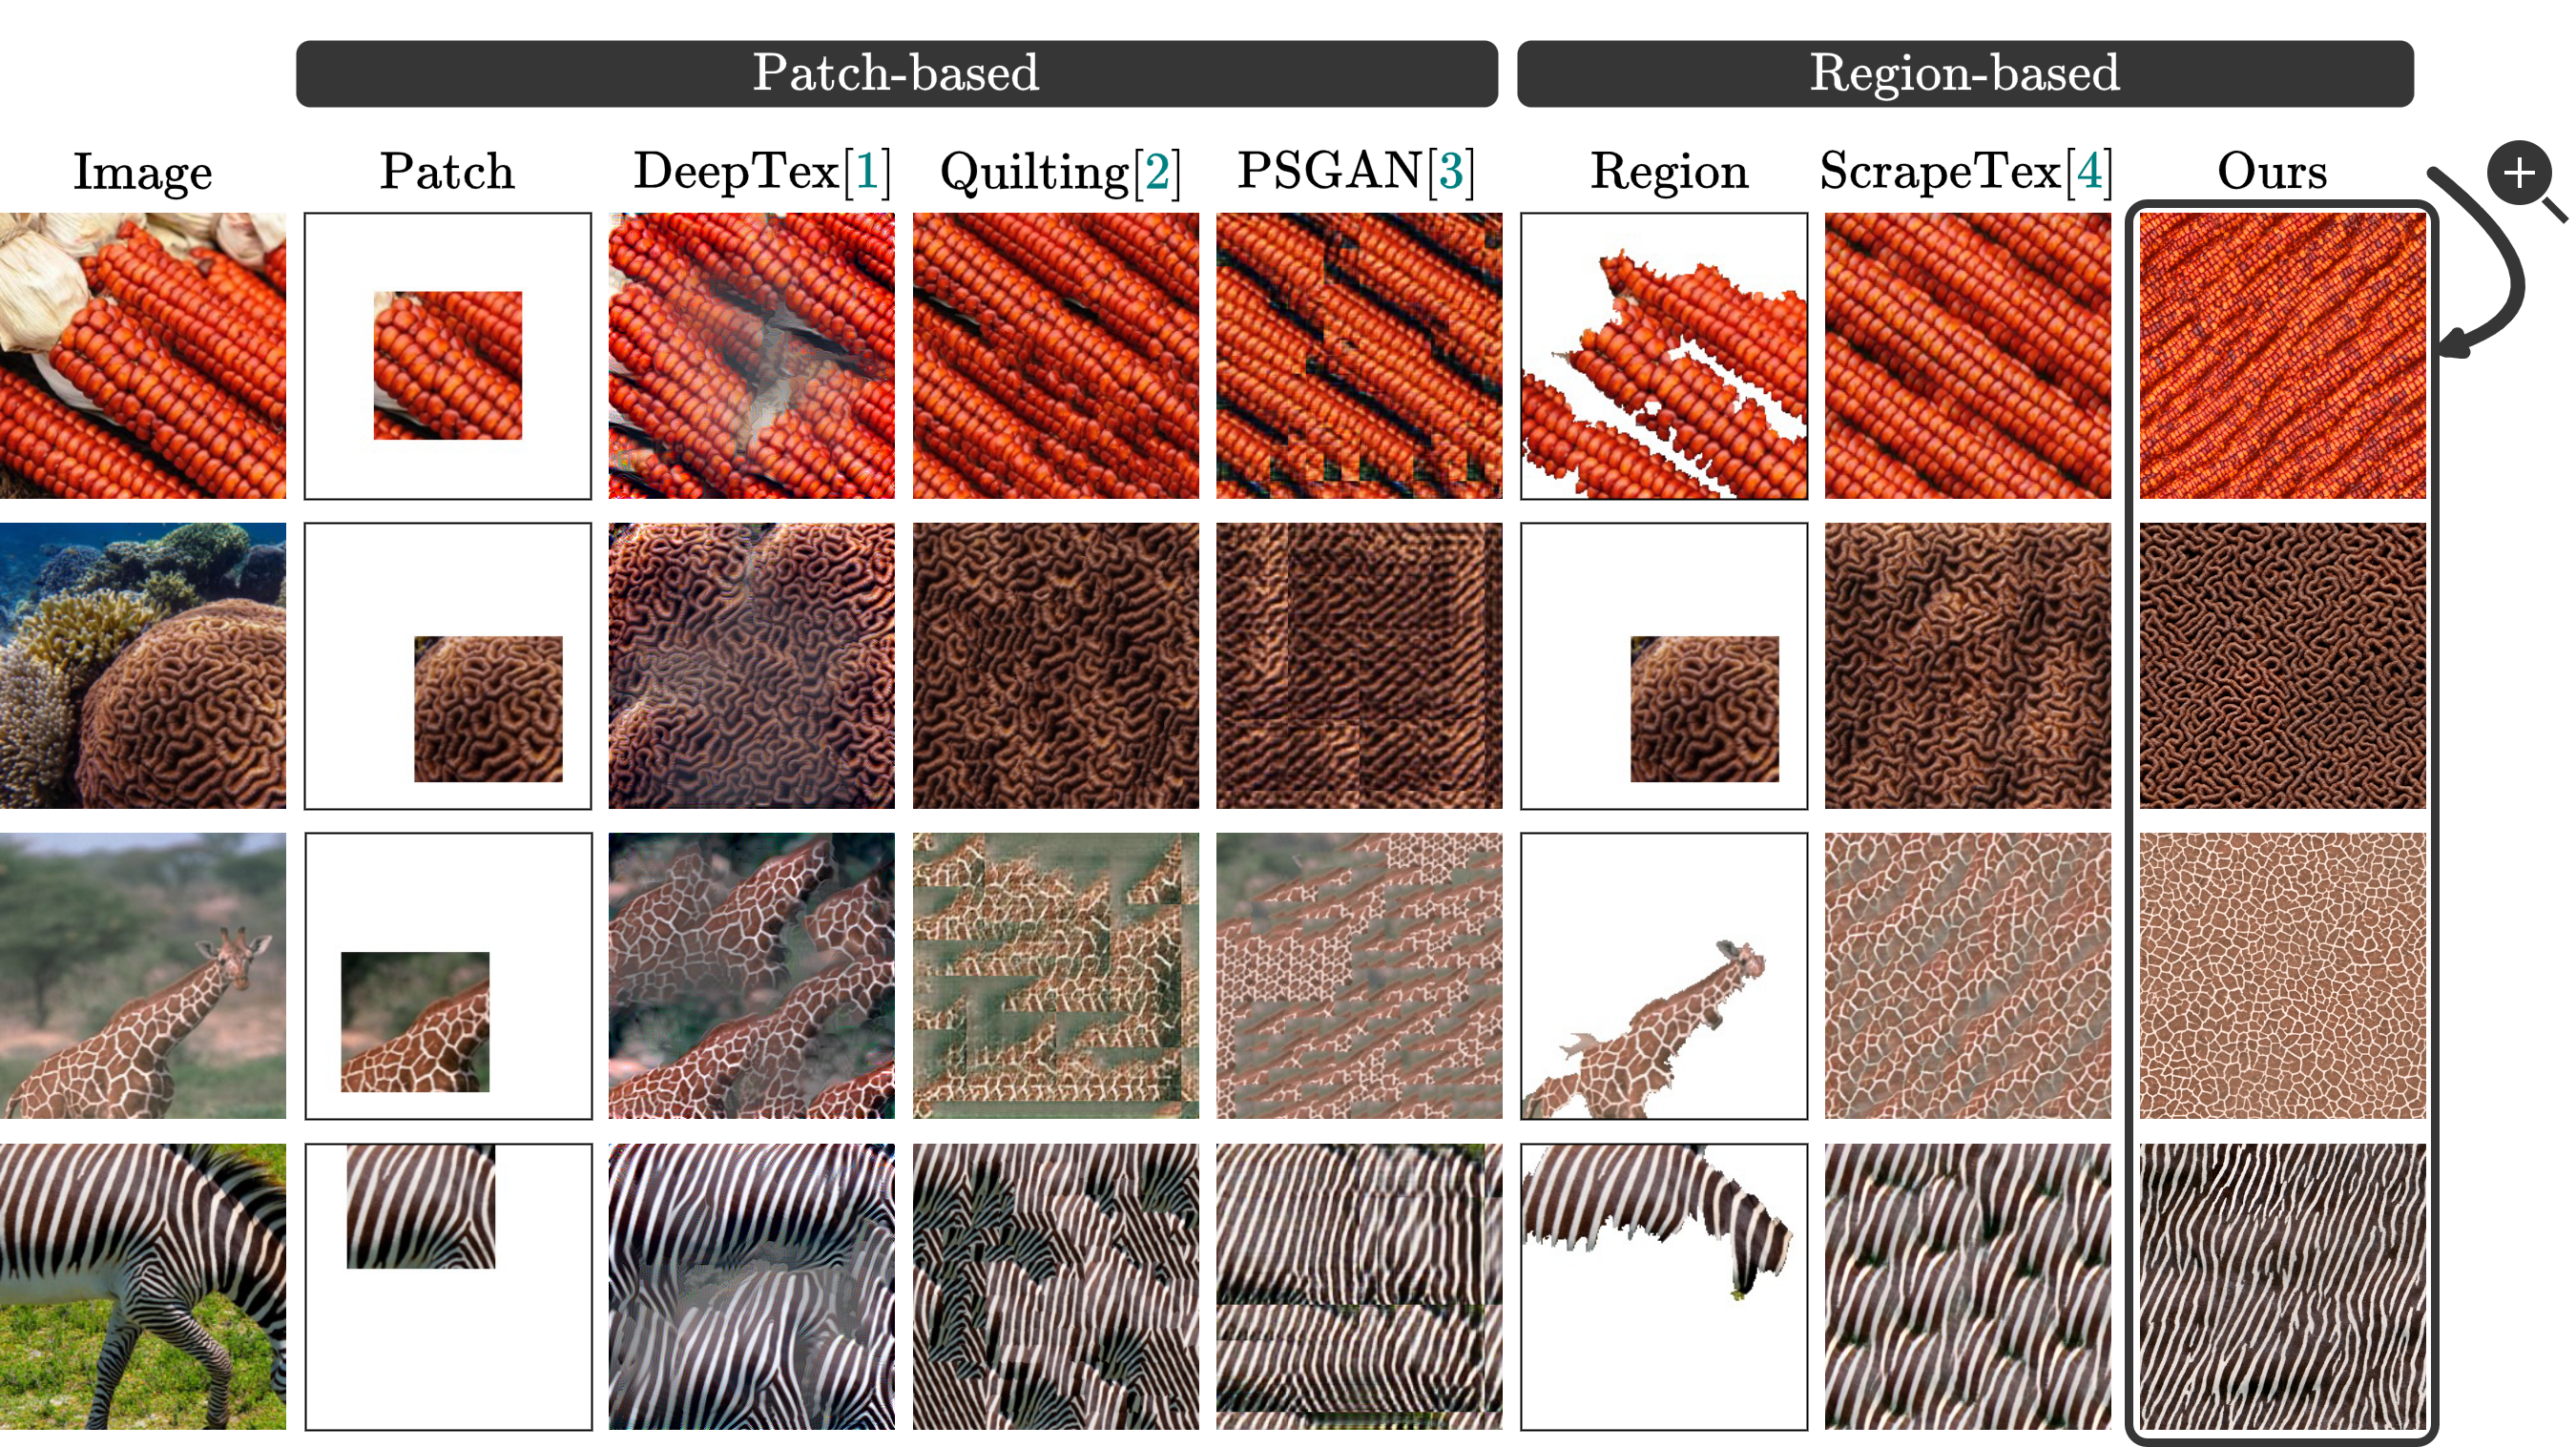
Figure 6 展示 source-only 在 SD 纹理上 normal / roughness 过强、albedo 偏色的例子,UDA 后渲染更自然。Figure 7 与补充 Figure 21 展示砖、瓷砖、动物皮毛、破损墙面等多种提取;这种多样性是资产制作价值的主要证据,但展示集含可视化筛选,需要与前述定量协议区别。
Figure 11 展示把估计材质替换到课堂、房间等 3D 场景。补充材料使用 Blender Cycles 与 Principled BSDF,A/N/R 接入材质,DeepBump 从 N 得到位移并作为 bump;某些物体如地板使用较低 displacement scale,以免表面不自然。作者强调不逐材质调 shader 参数,但对象相关的位移缩放仍是展示流程的一部分。

classroom 编辑结果

flat-front 编辑结果

flat-back 编辑结果
理解这些效果时要问三件事:相机 / HDRI 是否固定,纹理尺度是否可比,是否需要人工过滤或后处理。图中“好看”证明了可用的外观迁移,不等于光度测量精确,也没有证明提取材质在所有环境光、所有视角、所有尺度上都成立。
12 · Paper vs. Implementation:不能省略的复现差异
官方仓库核查固定到 0ddd360467cce8879c9772fb791924b0dc0b9d9b。以下是静态源码核查,没有安装其训练环境、下载模型权重或执行 GPU 训练,因而不声称重现论文指标。
| 项目 | 论文 / 补充说法 | 固定公开实现 | 复现影响 |
|---|---|---|---|
| LPIPS 候选选择 | 多个候选与区域裁块比较,选最匹配纹理 | README 明说不含 LPIPS filtering / ranking;单样本 | 单次 pipeline 不等于论文候选筛选协议 |
| 裁块尺寸 | 补充 32 / 64 / 128 / 256 | 512 / 256 / 192 / 128 / 64;threshold=.99;topk=100;少于2块跳过 | 小区域覆盖率与丢弃区域数量可能变化,应记录实际参数 |
| Tileability 后处理 | noise unrolling + Poisson solving + overlap blending | infer.py 可见 roll/unroll、circular padding、wmean;未见独立 Poisson 调用 | 应单独验证接缝;不可假定所有论文后处理已执行 |
| 颜色校正 | 按区域均值 / 方差校正 | pipeline 打开 renorm;单独 infer 默认关闭;裁掉亮度分布两端约0.5% | 命令入口不同会改变输出颜色 |
| Normal 后处理 | 2通道输出,z=1并归一化 | 归一化前 x/y 额外乘3 | 法线倾斜幅度属于实际模型约束 |
| 数据划分 | 正文给出库规模与若干测试子集 | 源按清单95/5,目标98/2;不等于已恢复当年精确测试清单 | 需固定资产清单及版本,避免 patch 级或同材质泄漏 |
| UDA retraining | 目标伪属性 + 随机重渲染 + 伪多视角监督 | 可见 StableDiffusion.__getitem__ 只返回 input / path / name;DenseReg 却要求目标 A/N/R/displacement/input_params,pseudo_labels 标志未在该取样函数填充它们 | 静态数据契约缺口,必须补充伪标签生成 / 加载与训练配置;未运行,不宣称具体异常栈 |
| 配置与模型下载 | SD1.5 + 1000/100 epoch 训练 | 仓库仅见 predict.yml,没有完整论文两阶段训练 YAML;README 标记原 runwayml checkpoint 已不再可用 | 预测权重可用性与全训练复现要分开;不要静默替换基座后仍声称完全复现 |
仓库的整体 MIT 声明、基座模型许可与文件中继承的 third-party 说明也需分别保留;这里仅记录依赖来源,不提供法律结论。参数量、原训练随机种子列表、完整训练机器 / 总时长、完整 LPIPS 筛选细节及精确数据快照均不应凭经验填造。
建议的复现顺序
- 先固定 PDF、代码 commit、SD 1.5 兼容权重、分解权重和资产清单;将训练与推理环境依赖单独锁定
- 用一个人工 mask 检查 crop coverage、至少两块裁块、颜色与尺寸,保存被跳过区域,避免只记录成功样本
- 先运行概念学习与 1K 单样本推理,确认 LoRA 可加载和 normal 导出约定;再加入论文所需的多候选 LPIPS 流程
- 通过 seam metric / 周期拼接图检验平铺,按不同材质记录颜色归一化带来的变化
- 重训前补齐目标伪标签数据契约,验证目标损失确实读取了固定源教师预测,且渲染输入与标签同步增强
- 重建 PH/CGB 数值,再做 OS 类别统计与合成场景端到端评估;分开报告每个阶段、每种输入区域和随机种子的误差
13 · Reviewer 视角:贡献成立,物理恢复仍有距离
值得肯定的部分
首先,任务定义贴近实际资产创作:自然图像包含远超过现有 PBR 库的外观,材质 palette 比整场景分解更直接可复用。其次,生成式纹理规范化和 UDA 是合理的模块分工,避免让一个网络同时解决区域选择、几何矫正、纹理补全和属性反演。最后,作者没有只放 3D 效果图,而是结合有标签的域适应测试、类内 LPIPS、CLIP 类别识别与合成场景还原,尝试缓解真实素材没有 SVBRDF 标注的困难。
主要证据缺口
- 实例 fidelity:类别相似和语义正确不能保证独特材质被保留;端到端指标中随机同类 ACG 仍更好,需要更直接的实例级、多光照真值
- 目标域适应的可辨识性:伪标签不是新的物理观测。即使九视角自一致,也可能稳定地维持一个错误 BRDF
- 对人工操作与筛选的依赖:Materialistic 查询点依赖人工区域,展示另有 LPIPS 阈值;没有系统统计被过滤和失败样本的比例
- 成本与可扩展性:每区域独立 LoRA,复杂照片可包含多种材质;概念学习和高分辨率采样成本逐区域增加,论文没有完整大规模吞吐量分析
- 物理属性范围:A/N/R 表示不能自然覆盖透射、复杂各向异性、真实纤维、体散射或金属光学参数。动物皮毛的视觉示例不等于建模了真实毛发散射
- 实验严谨性:没有多 seed 置信区间、全面模块交互消融、用户研究或几何尺度恢复评价,微小数值差别和美观提升不宜过度解释
失败模式与版本差异
固定 v1 §5 指出:简单均匀材料可能概念塌缩并出现颜色伪影;阴影会导致颜色不一致;大透视倾斜、镜头畸变和景深难以校正。后续补充 Figure 23 进一步展示复杂几何约束纹理、斜面、强阴影、高饱和物体的失败;Figure 24 又展示部分均匀材料在复杂光照中可成功。二者应合读为“能力依实例和条件而变”,不是把后续成功示例当作已经全面修复 v1 的局限。
建议评价:这是有实用意义的生成式材质采集系统,贡献主要在问题拆分、数据桥接与可用性;强项不是有严格保证的真实场景逆渲染。若研究目标是数字孪生或计量级材质采集,还需要受控多光照数据、材质参数误差与视角外泛化测试。
14 · 对 Procedural Material Generation 的研究启发
以下全部为研究延伸,不是论文已实现或验证的结果。Material Palette 的输出仍是 bitmap 材质,它没有 node type、edge、node ordering、graph token、程序执行状态或可编辑材质图。最自然的延伸不是把这些名词加到原管线上,而是明确引入一个新的“从视觉资产到可执行结构”的学习目标。
方向一:概念先验指导材质图搜索
把 \(S^{\ast}\) 及多次采样的纹理视为不确定的外观证据,再搜索图结构 G 与参数 θ。图执行器输出多属性贴图,渲染器在不同光照下评价。比起直接拟合一张带阴影照片,概念采样可提供纹理变化;但不能把生成幻觉当真值,应给与区域不一致的样本低权重。
\[
(G^{\ast},\theta^{\ast})
=\arg\min_{G,\theta}
\left[
\sum_{k,j}w_k\,d\!\left(\rho_j(\mathrm{Exec}(G,\theta)),
\rho_j(M^{(k)})\right)
+\beta\,\Omega(G)+\gamma\,\mathcal L_{\mathrm{seam}}
\right].
\]
这是建议目标:\(M^{(k)}\) 为多个估计材质,\(\Omega(G)\) 控制节点数、bitmap 依赖与复杂度,seam 项显式约束周期边界。离散拓扑可用检索、beam / tree search、grammar constrained decoding;连续参数可用 DiffMat 或可微 renderer 优化。首先要分别比较固定图调参、自由图搜索和直接 bitmap 拟合,才能知道“可执行程序先验”带来了什么。
方向二:不确定性驱动的区域与观测选择
让多个概念 seed、多个分解器或多种裁块尺度产生属性分布,找出 roughness / normal 分歧最大的区域。系统可以提示用户再拍一张斜视或改变光源的近照,再减少属性后验的不确定性。该扩展真正引入了新信息,有机会改善物理可辨识性,而不只是在伪标签闭环内强化一致性。
方向三:把平铺与尺度写入表示
图中显式维护周期域、重复单元、纹理方向和世界尺度,避免最终才靠 Poisson 修缝。可设置几何矫正模块预测局部 homography,另设材料图负责内在 pattern;实验需覆盖砖缝、织物、木纹等方向性强的对象,分别测周期边界能量、图案频谱、透视误差与多光照一致性。
一个可以落地的最小实验
- 从已知程序化图渲染 20–30 类材质,在多形状、多相机、多 HDRI 下形成照片与图真值对;同图不同参数只能落在同一数据分区
- 比较直接图拟合、Material Palette bitmap 拟合、概念引导图检索+参数优化三组,保持 renderer 与预算一致
- 评估 A/N/R 误差、未见光照渲染 LPIPS、图执行有效率、节点数、无 bitmap 占比、编辑可控性、tile seam、总计算成本
- 消融单候选 / 多候选、源域伪标签置信权重、区域矫正、周期约束;报告失败区域比例,不能只选择成功示例
可发表的关键问题应是“生成式规范化是否使材质程序更可识别、更易搜索、更可编辑”,而非仅把扩散、agent、renderer 串起来。本文提供了从照片到材质外观的桥,程序化表示与执行可控性仍需要独立证据。
15 · 来源、版本、归档计划与验收边界
- 固定主文 arXiv 2311.17060v1;PDF;HTML。PDF 43,472,786 bytes,SHA-256
87fffc09a40de7df1554f655fc50118982f02bb54840f3910af2e2768fbcbeef,与交接固定文件一致 - 官方 CVPR 2024 supplementary:独立 12 页;含训练、推理、分割、计时、类映射、TexSD ontology、额外结果与失败案例。没有用会议补充替换既有 v1 PDF 或其锚点
- 官方项目页:CVPR 2024、作者与机构、演示、数据发布说明。当前页面的 TexSD 10,000 与 v1 的 9,000 分开记录
- 官方代码固定 commit:阅读 README、crop / inversion / inference、颜色校正、分解模型、loss、routine 与 data path。只做静态核查,未执行模型
- 作者 TexSD 数据集链接:供后续按版本核对下载;本次未下载整个数据集
原有笔记保留:新增精读与原 note 的逐字节前缀合并候选分别提供,既有正文、代码摘录、重复归档段落和 PDF++ anchors 不改写。原 note 的 Oxford 独立行容易误解:论文第一作者机构应为 Inria,Oxford 对应 Fabio Pizzati;本次只在新增说明 / 归档计划中建议核实,不直接覆写 frontmatter。
人物与元数据:第一作者 Ivan Lopes 已明确。未在核查的 PDF / 项目署名中发现明确通讯作者标记,因此保留末位作者 Raoul de Charette 为候选并维持 unverified。现有分类维持,未来可依据 LoRA / CNN / rendering 机制审查是否补充已有 canonical tags,不在本次批处理中写共享索引或 People。
本次交付范围:中文单文件 HTML、完整 Markdown 增补、原 note 前缀保留的合并候选、来源 / 归档计划 / 静态 QA。文件体积、链接目标、数学源码、表格完整性、图片 HTTP 与图像可解码性做静态检查。按本轮明确安排,浏览器 MathJax 渲染、移动宽度、导航及实际图片加载验收留待下载后;此处不声称 browser QA 通过,也没有写入 Obsidian、发布网站或修改线上内容。