IP-Adapter 编码参考材质图,将图像条件通过独立 cross-attention 分支注入 UNet
01 · 先给结论:有效的编辑组合,而非物理材质恢复
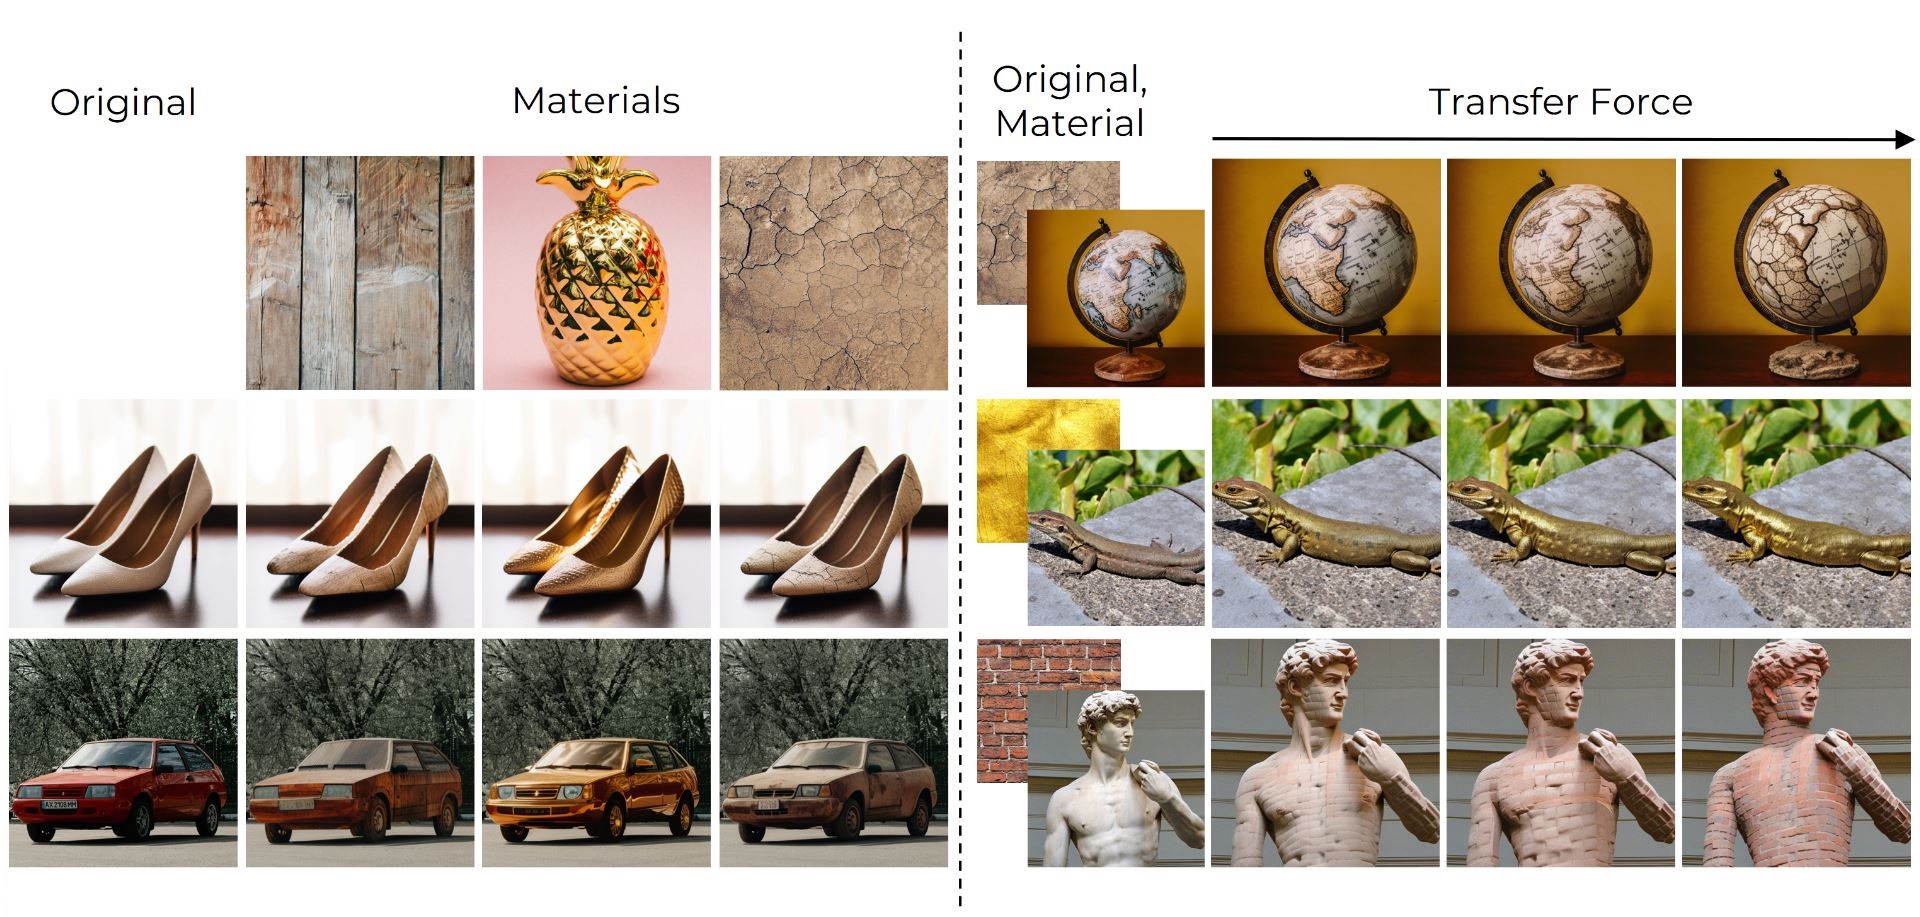
MaterialFusion 的目标是让一张物体照片“看起来换了材质”,同时尽量保留物体轮廓、姿态、细节与背景。它不输出 BRDF、SVBRDF、法线贴图、可重光照资产或 Substance 材质图,而是输出一张编辑后的 RGB 图像。方法把已经训练好的 Stable Diffusion v1.5、IP-Adapter 和 Guide-and-Rescale(GaR)结合起来,在推理时用原图的扩散内部表示约束生成,并在两个位置施加物体掩码。[正文 §3]
GaR 对齐原图反演轨迹的 self-attention 与 feature,减轻新外观覆盖物体身份的问题
图像注意力分支的空间掩码 + 采样中的背景 latent 回填,分别控制影响范围与背景漂移
最可信的贡献是互补组件形成可用的零样本编辑流程。需要保持克制的地方是:“几何保持”主要由图像观感、整图 LPIPS 和少量用户判断支持,没有真实几何恢复指标;“迁移力”实际就是 IP-Adapter 图像分支权重,没有对应物理单位;用户偏好总体更高,也不代表材质保真度全面领先。
证据标签:“论文事实 / Paper Verified”表示固定论文明确给出的设计或观测;“作者解释 / Author Claim”表示作者对结果的解释;“我们的解读 / Our Interpretation”表示技术推论;“研究延伸 / Research Extension”表示尚未由该论文验证的方向。本文不把有图示支持的现象升级为普遍规律。
02 · 身份、版本与阅读范围
正式标题为 MaterialFusion: High-Quality, Zero-Shot, and Controllable Material Transfer with Diffusion Models。作者依次为 Kamil Garifullin、Maxim Nikolaev、Andrey Kuznetsov、Aibek Alanov。此处固定分析 arXiv:2502.06606v2,2025 年 2 月 12 日,PDF 合计 16 页:正文与参考文献为文件第 1–10 页,Supplementary Material 为文件第 11–16 页,附录内部页码重新从 1 开始。[固定版本入口]
第一作者署名为 AIRI、Skolkovo Institute of Science and Technology;Maxim Nikolaev 与 Aibek Alanov 署名 HSE University、AIRI;Andrey Kuznetsov 署名 AIRI。PDF 首页没有明确的通讯作者标记,因此 Aibek Alanov 只能按末位作者作为未核实的通讯候选,不能把邮箱或作者顺序当作通讯身份的证明。
官方仓库 README 后来加入“accepted by CVPR 2025”的说明,但本轮固定 PDF 仍是上述 arXiv v2;没有用未经核验的 proceedings、DOI 或不同版本替换它。网页对 venue 保持“arXiv 固定版本”,把仓库的录用说明作为待单独核对的公开声明。注意不要与 MatFuse 混淆,后者是另一篇面向材质生成的论文。[官方仓库]
实现核查固定到官方仓库提交 fb04772144b629e033cedab2ae9e45ff72ad235f。这是一份静态代码核查,没有下载模型权重或运行 GPU 推理;因此“代码中写了什么”与“实际执行后是否完全复现论文”分别表述。阅读覆盖正文 §1–5、全部附录 A–J、Algorithm 1、两张原表及 15 张原图。
03 · 为什么材质迁移不能只靠一句提示词
物体照片里,材质外观与几何、光照、相机、纹理及语义高度耦合。把南瓜改成木头,不只是把橙色换成棕色:需要有木纹,同时保留南瓜的棱、柄和体积感;把一件复杂摆件改成金属,也不能把局部装饰熔成一整块光滑表面。单张参考材质照片还会带有自身物体与光照信息,图像编码器并不会自动给出纯净的“材质向量”。
论文提出的互补假设是:GaR 更擅长保持原内容,IP-Adapter 更擅长引入具体参考图外观。单用文本编辑可能得到类别先验最常见的外观,例如木制南瓜仍保持普通南瓜的橙色;单用图像条件又可能让材质参考的外观压倒目标物体细节。因此要让“改变”和“保持”在每个扩散步骤中同时发生,再限制改动的空间范围。[§3.2]
与最接近的基线 ZeST 相比,论文强调不用显式三维信息,而用模型内部注意力与特征约束保形。应避免将其说成一种新的几何求解器:self-attention 是几何与布局的代理信号,不是三维坐标;feature 也同时编码外观和语义,保持它可能与强材质变化冲突。这个冲突正是后面强度扫描出现 Pareto 权衡的原因之一。

读 Figure 3:第三列 GaR 保留物体但迁移不足;带掩码的 IP-Adapter 能迁移材质却损坏物体身份;组合方法减少这种冲突;完整掩码版进一步保护背景。右侧强度序列支持“存在可调的外观变化”,但不能独自证明线性、单调、跨物体一致或物理可解释的控制。
04 · 输入输出、表示与符号

| 符号 / 输入 | 实际含义 | 在系统中的用途与边界 |
|---|---|---|
| \(x_{\mathrm{init}}\) | 包含目标物体的 object-centric RGB 图像 | VAE 编码与 DDIM 反演;提供需要保持的内容、背景和姿态 |
| \(y_{\mathrm{im}}\) | 参考材质图,可以是纹理图片,也可以是带材质的物体照片 | CLIP 图像编码器与 IP-Adapter 投影;不是显式 PBR 参数 |
| \(y_{\mathrm{src}},y_{\mathrm{trg}}\) | 描述原内容与期望结果的源、目标提示词 | 源词用于反演与保持引导;目标词用于编辑 CFG。代码允许二者相同 |
| \(M\) | 目标物体的掩码,理想定义为前景 1、背景 0 | 区域化材质注入与背景 latent 混合;代码存在软化步骤 |
| \(z_{t},z_{t}^{\ast}\) | 当前编辑轨迹 latent、原图 DDIM 反演轨迹 latent | 在对应时间步比较内部表示并回填背景;星号不表示人工标注的理想材质答案 |
| \(c_{\mathrm{text}},c_{\mathrm{img}}\) | 文本与参考图的条件特征 | 原文用 \(c_t,c_i\),此处加下标名称以免把 \(c_t\) 误解成时变文本 |
| \(A_{\ell},\Phi\) | 选定层 self-attention map 与 UNet 特征 | 分别作为布局/几何、视觉细节保持的代理表示 |
| \(w,\lambda,v_{\mathrm{self}},v_{\mathrm{feat}},\gamma\) | CFG、图像条件、两种能量及动态 rescale 系数 | 不同层级的控制量,不能把 CFG 与 material transfer force 混为一谈 |
| \(T,\tau_g,\tau_m\) | 总采样步数、启用保持引导的前若干步、背景回填的前若干步 | 计数方向从高噪声开始去噪;不是同一参数 |
| \(x_{\mathrm{edit}}\) | VAE 解码得到的编辑 RGB 图 | 没有 mesh、UV、可编辑 shader graph、材质节点顺序或三维一致性保证 |
一个清楚的任务表述是:给定原图、材质 exemplar、两段文字及前景掩码,在预训练扩散先验中寻找兼顾参考外观、源结构与背景保持的输出。论文没有监督式的成对“换材质真值”损失,也没有一个单独训练的 MaterialFusion 网络。其优化发生在推理中的 latent/noise guidance,而不是更新 SD 权重。
05 · 公式逐层拆解:改变什么,约束什么
5.1 冻结模型上的 classifier-free guidance
\[\widehat{\epsilon}_{\theta}(z_t,c,t)=\epsilon_{\theta}(z_t,\varnothing,t)+w\left[\epsilon_{\theta}(z_t,c,t)-\epsilon_{\theta}(z_t,\varnothing,t)\right].\]
这与原式 (1) 的 \(w\epsilon_{\theta}(z_t,c,t)+(1-w)\epsilon_{\theta}(z_t,t)\) 等价。UNet 预测噪声;括号内是条件相对于无条件分支的变化方向。\(w=7.5\) 时并不是两项权重相加为一的温和插值,而是沿条件方向外推。加入 IP-Adapter 后,条件变成文本与图像的联合条件,即原式 (3)。[§3.1,式 (1)–(3)]
5.2 IP-Adapter 的解耦 cross-attention 与迁移力
\[\operatorname{Attn}(Q,K,V)=\operatorname{softmax}\!\left(\frac{QK^{\mathsf T}}{\sqrt{d}}\right)V.\]
\[Q=ZW_q,\quad K=c_{\mathrm{text}}W_k,\quad V=c_{\mathrm{text}}W_v,\quad K'=c_{\mathrm{img}}W'_k,\quad V'=c_{\mathrm{img}}W'_v.\]
\[Z_{\mathrm{new}}=\operatorname{Attn}(Q,K,V)+\lambda\operatorname{Attn}(Q,K',V').\tag{6}\]
\(Z\) 是 UNet 的查询特征;文本和图像使用分开的 key/value 投影与注意力计算,输出相加。上面给出的 scaled dot-product 形式是标准注意力展开;最后一式是论文原式 (6)。\(\lambda\) 放大或缩小图像分支,不改变文字分支的系数,所以它更准确地表示图像条件相对贡献,并非严格的“文本占 \(1-\lambda\)、图像占 \(\lambda\)”凸组合。代码的空间掩码施加在图像分支输出上,可解释为 \(Z_{\mathrm{new}}=Z_{\mathrm{text}}+\lambda M_{\mathrm{attn}}\odot Z_{\mathrm{img}}\)。此处最后一式是对实现的显式写法,不是新增论文公式。
调大 \(\lambda\) 会改变多层注意力的结果,经扩散非线性演化后产生更强纹理、颜色乃至形状变化。它不等于真实的粗糙度、金属度或透明度,某种材质上“先纹理、后颜色”的现象不能推广为普遍解耦规则。
5.3 用反演轨迹定义需要保留的结构
\[z_0^{\ast}=\operatorname{Enc}(x_{\mathrm{init}}),\qquad z_{t+1}^{\ast}=\operatorname{DDIMInv}(z_t^{\ast},y_{\mathrm{src}}),\qquad z_T=z_T^{\ast}.\]
反演把原图送回扩散噪声状态,并保存中间 latent。编辑从同一个最噪 latent 出发,却用新条件去噪。对同一噪声层级的当前 latent 和原轨迹 latent 分别做源提示词条件的 UNet 前向,可得到当前与参考的内部特征。使用源词来比较,是为了尽量让能量评估“是否仍保留原物体”,而不让目标材质文字直接改变参照。
\[g_{\mathrm{self}}=\sum_{\ell=1}^{L}\operatorname{mean}\!\left\|A_{\ell}^{\ast}-\overline A_{\ell}\right\|_{2}^{2},\qquad
g_{\mathrm{feat}}=\operatorname{mean}\!\left\|\Phi^{\ast}-\overline\Phi\right\|_{2}^{2}.\tag{7,8}\]
原式 (7) 比较多层 self-attention,原式 (8) 比较最后一个 up-block 的输出特征;二者都对 \(z_t\) 可微。\(L\) 是被收集的层数,不是图像像素数。self-attention 通常反映位置间关系,feature 更多保留局部视觉属性,但这只是代理机制与定性证据支持的分工,不是严格的几何/材质因子分解。实现中的 feature 能量采用 L1,而非这里论文写出的平方 L2,后文单独核对。[附录 A]
5.4 把保持能量放回噪声预测
\[\widehat\epsilon=\epsilon_{\mathrm{uncond}}+\Delta_{\mathrm{cfg}}+\gamma\nabla_{z_t}\left(v_{\mathrm{self}}g_{\mathrm{self}}+v_{\mathrm{feat}}g_{\mathrm{feat}}\right),\qquad
\Delta_{\mathrm{cfg}}=w(\epsilon_{\mathrm{cond}}-\epsilon_{\mathrm{uncond}}).\tag{9}\]
原式 (4) 将引导写为单一能量梯度,附录式 (9) 展开成两个加权 guider。这不是给 SD 重新计算参数梯度并训练模型,而是利用冻结 UNet 反向传播得到对当前 latent 的梯度,再改变采样用的噪声。不要把噪声预测中的正号直接解释为“最大化差异”:DDIM 更新中噪声如何进入 latent 更新同样重要,噪声空间的正号不等于对图像做梯度上升。
数值上 \(v_{\mathrm{self}}=700000\)、\(v_{\mathrm{feat}}=1500\) 看起来很大,因为不同特征的均方差尺度并不相同。不能跨能量定义比较这两个系数,更不能认为 self-attention 的影响精确等于 feature 的 466.7 倍。动态 rescaling 和实际梯度范数会改变最终占比。
5.5 Rescale 的可复现含义
论文 Algorithm 1 写出 \(r_{\mathrm{cur}}=\|\Delta_{\mathrm{cfg}}\|_2^2/\|\nabla_{z_t}E\|_2^2\),并把 \(\gamma=f_\gamma(r_{\mathrm{lower}},r_{\mathrm{upper}},r_{\mathrm{cur}})\) 的细节交给 GaR。官方实现则直接对未平方的梯度范数比做截断:
\[q=\frac{\|u\|_2}{\|\Delta_{\mathrm{cfg}}\|_2},\qquad
\gamma=\frac{\operatorname{clip}(q,0.33,3)}{q},\qquad u=\nabla_{z_t}E.\]
当范数均非零时,结果是使其他引导噪声相对于 CFG 的范数比落在给定区间内;过强则缩小,过弱则放大。实现对零范数有分支处理。该表达是代码推导,不能悄悄替换论文算法而宣称二者逐字相同。不同范数定义、比例取倒数和平方都会影响自写复现。[RangeNoiseRescaler]
06 · 双层 masking:注意力定位与背景回填
第一层掩码限制图像条件 cross-attention 的输出位置。它告诉模型“材质参考主要影响这里”,却不能保证最终背景严格不变,因为卷积、self-attention、跨尺度路径与 VAE 解码都可以传播局部变化。论文 Figure 4 正是这一点的反例:材质已经进入目标区域,但桌面等背景仍可能改变。

第二层掩码直接混合当前生成 latent 与原图反演 latent。为避免原式 (5) 中左右 \(z_t\) 同名造成误读,可以把它展开为赋值:
\[z_{t-1}\leftarrow M_{\mathrm{lat}}\odot z_{t-1}^{\mathrm{edit}}+(1-M_{\mathrm{lat}})\odot z_{t-1}^{\ast}.\]
物体区域保留编辑结果,背景区域取相同噪声层级的原轨迹。该机制类似 diffusion inpainting 的轨迹混合,比只在最终 RGB 图上硬贴背景更有机会获得边界协调。它同时意味着整图 LPIPS 的改善有一部分直接来自恢复背景,不能把全部改善都归因于物体几何保持。[§3.2,式 (5)]
论文选择在 50 步去噪中的前 40 步执行第二层 masking:只做很少的早期步骤,后续背景仍漂移;全部步骤都回填,边界融合或生成质量可能受损。最后一段自由去噪给编辑区域与背景重新协调的机会,但也说明“背景保持”不是像素恒等的数学保证。该 40 步是经验选择,附录没有完整数值统计或跨数据集稳定性检验。

回答原笔记里“为什么 mask 不全是 0/1”的疑问:官方采样代码用 bilinear interpolation 将 512×512 掩码降到 64×64,然后广播到 latent 的 4 个通道。即使输入是硬掩码,边缘插值也会产生介于 0 与 1 的值;此时上式变成软混合,这是可从实现直接解释的来源。它不保证原笔记所见的每张 mask 都只由这一操作造成,但比把软值当作理论错误更准确。
07 · 完整推理流程与时间轴

- 准备输入:物体图、材质图、源提示词、目标提示词、目标掩码、\(\lambda\) 与 guider 配置。官方入口先中心裁成方形再缩放到 512×512,因此细长物体和边缘内容可能在输入阶段已经丢失
- 编码材质:使用预训练 CLIP 图像编码器,投影到 IP-Adapter 的图像上下文 token;本次实现默认 4 个额外图像 token。文字与图像条件分别进入解耦 cross-attention
- 反演原图:VAE 编码后做 50 步 DDIM inversion,保存从干净 latent 到高噪 latent 的轨迹,生成从最终反演 latent 开始。参考材质图不沿同一条 DDIM 反演轨迹处理
- 每步评估条件方向:计算当前 latent 的无条件噪声、文本加材质条件噪声,得到 CFG 方向
- 每步评估保持方向:原轨迹 latent 与当前 latent 都用源提示词提取表示,构造 self-attention 与 feature 能量,对当前 latent 反向传播。前 30 步启用非零 guider 权重
- 范数平衡与去噪:rescale 后的保持梯度与 CFG、无条件噪声相加,交给 DDIM scheduler 更新 latent
- 背景回填:在规定的前期步骤内,用原反演轨迹的背景 latent 混合;图像条件分支的区域掩码仍是另一条机制
- 解码输出:最后 VAE 解码成 RGB;对不同 \(\lambda\) 可生成一组强度候选。论文没有自动评分挑选、beam search、top-k、重试或程序执行修复
| 论文设计的去噪阶段 | 步数索引 | 启用的关键项 | 作用 |
|---|---|---|---|
| 前段 | 第 1–30 步 | CFG + 材质图像条件 + 两种 guider + 背景回填 | 在高噪声到中噪声阶段约束物体结构与编辑位置 |
| 中后段 | 第 31–40 步 | CFG + 材质图像条件 + 背景回填 | 停止显式特征保持梯度,继续限制背景变化 |
| 最后阶段 | 第 41–50 步 | CFG + 材质图像条件 | 让局部边界和外观继续协调;不是纯背景锁定 |
上表是Algorithm 1 与附录 B 的设计,并非对当前仓库循环计数的保证。仓库存在 39 次背景回填及时间索引核对事项,详见实现差异。图 5 的英文 caption 对“原图和 exemplar 的 DDIM inversion”容易造成歧义;正文流程、Algorithm 1 和代码只对原物体图执行反演,材质 exemplar 经图像编码器。
计算成本解读:代码每个编辑步都构造无条件、原轨迹源词、当前轨迹源词、当前轨迹目标条件四路 UNet 前向,并在 guider 非零时反传 latent 梯度。即便全部权重冻结,也有显著激活内存和反传成本;“training-free”不等于“只有普通 SD 的一遍前向成本”。论文没有统一硬件耗时、每图秒数或峰值显存表,不能补造速度优势。
08 · 训练、推理与 baseline 配置全表
训练范围:MaterialFusion 本身不增加任务训练,不用 25×15 图像对微调 UNet,也没有报告新的 optimizer、学习率、batch size、epoch、warmup 或训练时长。这些项目对本文新增方法属于“不适用”,而不是缺失了一个待猜测的训练方案。SD v1.5、CLIP 与 IP-Adapter 本身当然经过预训练;zero-shot/training-free 指本任务无需再训练,不能称为从未训练的模型。
原 Table 2
| Method | Used Implementation | Configuration Settings |
| ZeST | ZeST github-repo | N/A |
| IP-Adapter + masking | IP-Adapter github-repo | \(\tau_{m}=40\) |
| Guide-and-Rescale | GaR github-repo | \(w=7.5\), \(\tau_{g}=30\), \(v_{\mathrm{self}}=300000\), \(v_{\mathrm{feat}}=500\), \(r_{\mathrm{lower}}=0.33\), \(r_{\mathrm{upper}}=3\) |
| Our | - | \(w=7.5\), \(\tau_{g}=30\), \(\tau_{m}=40\), \(v_{\mathrm{self}}=700000\), \(v_{\mathrm{feat}}=1500\), \(r_{\mathrm{lower}}=0.33\), \(r_{\mathrm{upper}}=3\) |
原 Table 2 保留了全部 4 行方法与 3 列信息。ZeST 的 N/A 表示该表未列出配置,不表示没有超参数。GaR 与完整方法采用不同的 guider 权重;完整方法的 self/feature 权重分别由 300000/500 提高到 700000/1500。它们不是相同设置下只加一个模块的比较,读消融时要记住这一点。[附录 H]
| 复现项 | 正文 / 官方实现可核实的值 | 解释 |
|---|---|---|
| 生成骨干 | Stable Diffusion v1.5;入口模型标识 runwayml/stable-diffusion-v1-5 | 不是 SDXL、FLUX 或更大参数版本;论文没有大小模型对比 |
| VAE | 入口单独载入 stabilityai/sd-vae-ft-mse | 属于实现细节;解码会影响局部细节与背景像素一致性 |
| 材质条件 | IP-Adapter 的 ip-adapter_sd15.bin;CLIPVisionModelWithProjection;默认 4 个图像 token | 仓库从本地 IP-Adapter 模型目录载入,不是重新训练的材质专用 encoder |
| 分辨率 | 512×512 图像;背景混合代码固定 64×64 latent | 入口中心方形裁剪;任意分辨率扩展需要同步修改相关假设 |
| scheduler | DDIM,50 步,beta_start=0.00085,beta_end=0.012,scaled_linear,set_alpha_to_one=False | 官方 main.py 直接写入;不是从图示推断 |
| 保持引导 | 前 30 步;self 700000、feature 1500 | best 与 colab 配置均相同;feature 具体损失以代码 L1 为准 |
| CFG / rescale | 7.5 / 区间 [0.33,3.0] | CFG 与 image scale 是分离控制 |
| 背景混合 | 入口 background_mask=40 | 当前循环执行条件产生 39 次,需复现者确认 |
| best 配置 | 未设置 gradient_checkpointing;默认 self-attention 层范围 [0,6)、[0,1)、[0,9) | 覆盖 down/mid/up 的默认范围 |
| colab 配置 | gradient_checkpointing=true;层范围 [2,6)、[0,1)、[0,4) | 同一个 SD v1.5 的省内存配置,不是“小模型” |
| 源/目标 prompt | 官方例子两者均为“A photo of a car” | 材质图可在目标词不变时驱动迁移;更明确的目标词可能帮助编辑 |
| 随机性与候选选择 | 入口未提供统一 seed 参数;强度列表逐项生成 | 未公开论文逐例 seed 与自动候选排序;不能假设完全确定性 |
| 环境声明 | README:Linux、Python 3.8.5、PyTorch 2.0.1、Diffusers 0.29.1 | README 的“NVIDIA V100 with 40GB RAM”表述含混,不能当作已验证的最低显存门槛 |
这些实现值来自固定提交的 main.py、best 配置、colab 配置。没有运行的 benchmark 不标成实测;参数量、训练语料规模、推理吞吐等没有在此人为补齐。
不要把类中的负提示词默认字符串直接认定为实际 CFG 的 negative branch。代码虽然生成了 negative image/text embeddings,构建数据字典时真正的无条件分支取自空字符串 prompt;该中间变量未用于那一路 UNet 前向。准确的复现需要沿调用路径看数据流,而不是只摘函数默认参数。
09 · Paper vs. Implementation:六个关键核对点
| 问题 | 论文写法 | 固定提交的实现证据 | 复现影响 |
|---|---|---|---|
| Feature energy | 附录式 (8) mean squared L2 | opt_guiders.py 的 app_result 为 mean(abs(features_cur-features_orig)),即 L1 | 梯度大小、异常值权重、1500 的尺度解释均不同;必须明确论文版或代码版 |
| 背景回填次数 | 前 40/50 步 | 循环 i 从 0 开始,判断 i < background_mask-1;默认值 40 时执行 i=0…38 | 静态可数出 39 次;不是 40 次,不能静默宣称完全匹配 |
| 回填时间索引 | 更新到 \(z_{t-1}\) 后使用 \(z_{t-1}^{\ast}\) | 采样更新后使用 inv_latents[-i-1];构造当前步参照也用该表达式 | 存在时间对齐疑点;要结合反演列表与 scheduler 时间点实测,未运行前不武断判定性能损失 |
| Mask 的二值性 | 公式称 binary mask | 背景混合前 bilinear 下采样到 64×64 | 边界产生软权重;可解释原笔记观察,但不是独立物理混合模型 |
| Mask 来源 | Algorithm 1 将 mask 作为输入 | main.py 用 rembg 自动处理,再转 RGB、逐通道阈值化、转灰度 | 自动分割失败可污染编辑;入口未直接提供用户 mask 路径,颜色阈值处理与 alpha mask 不能想当然等同 |
| 公开评估代码 | 图像 crop 与参考图 crop 的 CLIP 图像相似度 | 仓库通用 CLIPMetric 计算编辑图与目标文字相似度;未在所核查入口发现论文 crop-pair 评估驱动 | 直接跑这个通用指标不等于复现 Fig.7/12,不能借其 ViT-B/32、ViT-L/14 配置填论文未报告的编码器 |
代码定位:guider 损失 · 采样与 mask · mask 构造 · 通用 CLIPMetric
其他工程细节同样有用:scale scheduler 的数组长度写死为 50;main.py 关闭 xformers memory-efficient attention;每个 material scale 再调用一次完整编辑接口,包括反演准备,未显式缓存多次扫强度共享的反演结果。程序把结果写入 output/,入口没有看到创建该目录的语句,因此复现前需要检查目录与模型路径。以上是静态可见风险,不等于我们已经运行并遭遇错误。
对原笔记观点的补充:“force-scale 是 IP-Adapter 权重”有公式和代码支持,确实不构成一个新的物理控制模块;但“完全没用”是更强的判断,现有证据支持它作为用户选择保真度/编辑强度的实用旋钮。更精确的结论是:控制接口有用,控制机制新颖性与属性解耦证据较弱。关于“GaR 代替 ControlNet”的启发也值得保留,但本文没有给出相同骨干、同等预算的 GaR-vs-ControlNet 独立因果消融。
10 · 数据集和评估协议:指标究竟测了什么

论文自建评估集合包含 25 张物体中心照片与 15 张材质图,来源描述为免费图库照片。它们是评估输入,不是训练数据。若做全组合应为 375 个物体-材质任务,但正文用户研究写的是 365 对;不能未经证据把实际实验数改成 375。固定论文未提供完整可复核的 train/val/test 划分、物体类别分层、每张图版权清单、去重策略、全量 prompt/seed 表或配对结果 CSV。仓库有少量示例图片,不应等同于完整 benchmark。
10.1 整图 LPIPS:保持原图的代理
\[\overline d_{\mathrm{LPIPS}}=\frac{1}{N}\sum_{n=1}^{N}\mathrm{LPIPS}_{\mathrm{AlexNet}}(x_{\mathrm{init}}^{(n)},x_{\mathrm{edit}}^{(n)}).\]
这是依据附录 I 重述的聚合方式:用 AlexNet 提取 LPIPS 特征,比较原图与编辑图,最后按样本平均,越低代表感知变化越少。原论文把它用于背景、几何与细节保持,但它没有把这三部分分开。材质迁移本就需要改变外观,因此低 LPIPS 也可能来自“几乎没编辑”;背景面积很大时,直接回填背景会显著降低整图数值,即使物体内部仍被改坏。
10.2 Crop CLIP:局部材质相似度的代理

作者从输出物体内部、排除背景的区域采样 64×64 与 128×128 两种尺寸的裁块;参考材质图也取裁块;计算两组 crop 的 CLIP 图像特征余弦相似度并平均。用数学记号重述,令 \(\mathcal C_o,\mathcal C_m\) 是相应裁块集合:
\[S_{\mathrm{clip}}=\frac{1}{|\mathcal C_o|\,|\mathcal C_m|}\sum_{a\in\mathcal C_o}\sum_{b\in\mathcal C_m}
\frac{\langle f(a),f(b)\rangle}{\|f(a)\|_2\,\|f(b)\|_2}.\]
这是对论文文字协议的解释性公式,不是新增报告数字。它强调局部外观,减少背景与物体类别的直接影响;但 CLIP 特征仍受颜色、语义、图案和裁块尺度影响,并非 BRDF 参数距离。论文未明确给出所用 CLIP 骨干、每图裁块数、随机采样规则、掩码边缘排除阈值、无有效 crop 时处理、两种尺寸的权重及多样本随机性。公开通用 metrics.py 不是这个协议的完整实现,严格复现仍需这些信息。
公平性方面,论文声称使用各方法官方实现与默认配置,但仅给出有限配置表。主比较包括 ZeST、GaR、带掩码 IP-Adapter、完整方法,扩展图加入无掩码组合。材质强度、保持引导和 mask 设置都会移动结果点;如果只比较某个方法一个默认点,而另一方法扫描多种强度,结论应是“所展示配置之间的比较”,不是对所有可调配置的全局统治。
11 · 定量与定性结果:优势来自折中

Figure 7 的横轴是材质 CLIP 相似度,越高越好;纵轴是相对于原图的 LPIPS,越低越好,因此作者希望落在右下方。正文给出经验观测:CLIP 低于 0.82 时迁移不足,高于 0.84 时材质迁移较成功;LPIPS 高于 0.21 时原细节损失明显。作者据此在图上标出偏好的绿色区域,完整方法 \(\lambda=0.5\) 与 \(\lambda=0.8\) 两个点进入其中。[§4.2]
不要把阈值当成通用验收标准。0.82/0.84/0.21 来自作者对本数据与生成结果的经验判断,不是预注册的人类感知边界;编码器、裁块规则、对象面积或测试域变化,阈值可能失效。本文没有把图中未标出的坐标臆测成精确表格,也没有凭肉眼制造几位小数的 CLIP/LPIPS 数值。

| 方法 / 变体 | 论文可支持的结果 | 保留的解释边界 |
|---|---|---|
| GaR | 整图保持较好,材质迁移偏弱 | 低 LPIPS 可能包含少编辑;不能把它只解释成结构更准确 |
| IP-Adapter + masking | 参考纹理迁移明显,物体细节保持不足 | 空间限制无法单独解决内容身份保持 |
| ZeST | 材质转移较强,但更容易压过源物体细节 | 用户研究的材质保真度指标确实领先本方法 |
| MaterialFusion 无 masking | 相较完整方法 LPIPS 明显更高 | 改善可包含背景恢复,不能隔离成物体几何改善 |
| MaterialFusion,\(\lambda=0.5,0.8\) | 位于作者所定义的较好折中区域 | 是本评估条件下的选点,不是普适最优超参数 |
| MaterialFusion,\(\lambda=1.5\) | 附录称性能指标接近 ZeST,材质更强同时细节牺牲更大 | 接近某些感知指标不代表输出逐像素或机制等价 |
附录 F 对完整方法、带掩码 IP-Adapter、无掩码组合扫描 0.5 到 1.5 的迁移力;整体趋势是提高 \(\lambda\) 往往同时提高 CLIP 与 LPIPS,即材质更像参考、原图变化也更大。它支持存在可调的折中,不支持“一次性解决保真度与保持性矛盾”。

Figure 6 的价值是把数字映射回图像:查看轮廓、原有凹凸、局部装饰、接触关系以及背景是否仍可信。不要只看颜色是否匹配 exemplar。Figure 13 提供更多简单与复杂物体的对照,作者认为复杂物体更能体现 GaR 保持内部特征的好处;但没有按物体复杂度分组的定量统计。

12 · 用户研究全表与样本数问题
原 Table 1
| Questions | Results |
| Overall Preference (Q1) | 88% |
| Material Fidelity (Q2) | 41% |
| Detail Preservation (Q3) | 73% |
原 Table 1 的结果都是选择 MaterialFusion 而非 ZeST 的比例,不是绝对质量得分。对应三项是总体偏好 88%、材质保真度 41%、细节保持 73%。由互补比例可得 ZeST 为 12%、59%、27%,这里只是二选一结果的算术补数,原表并没有把它们另列为方法列。
| 问题 | 被要求判断的内容 | 实际说明 |
|---|---|---|
| Q1 Overall Preference | 整体图像质量、是否增删细节、噪声/模糊、是否真实 | 88% 支持总体视觉整合;不等同于物理材质正确 |
| Q2 Material Fidelity | 是否更好迁移参考材质特征,物体是否像由该材质制成 | 41% 明确低于 ZeST 的互补比例 59%,不存在所有维度全面获胜 |
| Q3 Detail Preservation | 原对象轮廓、细节及深度感是否保持 | 73% 支持感知细节保持,仍不是三维深度真值误差 |
重要一致性问题:正文说有 3 名受访者,每人比较 365 对结果,随后写每题得到 1,125 个回答。然而 \(3\times365=1095\),而 \(3\times375=1125\),后者又恰好等于 \(25\times15\times3\)。这提示作者可能把 375 误写成 365,但这只是合理猜测,没有原始记录就不能擅自修正文献。此处保留所有原始数字并指出冲突。[§4.3]
3 名受访者才是评审者数量,多次图片判断不是 1,125 名独立用户。论文没有详细报告人群背景、展示顺序随机化、盲测方式、任务耗时、评审一致性、置信区间或统计显著性;反复评同一组物体也带来相关性。数据足以给出小规模主观倾向,但“comprehensive user study”需要谨慎理解。

作者解释:ZeST 某些结果像把材质“剪贴”上去,因此材质可能更像参考,却破坏原结构。我们的解读:这解释了两项偏好指标发生分歧的一种可能原因,但 Figure 8 是选例,不是对全部 ZeST 结果的机制证据;不能以“过强迁移不算好”否认 Q2 的实际劣势。
13 · 消融证据与强度控制的真实含义
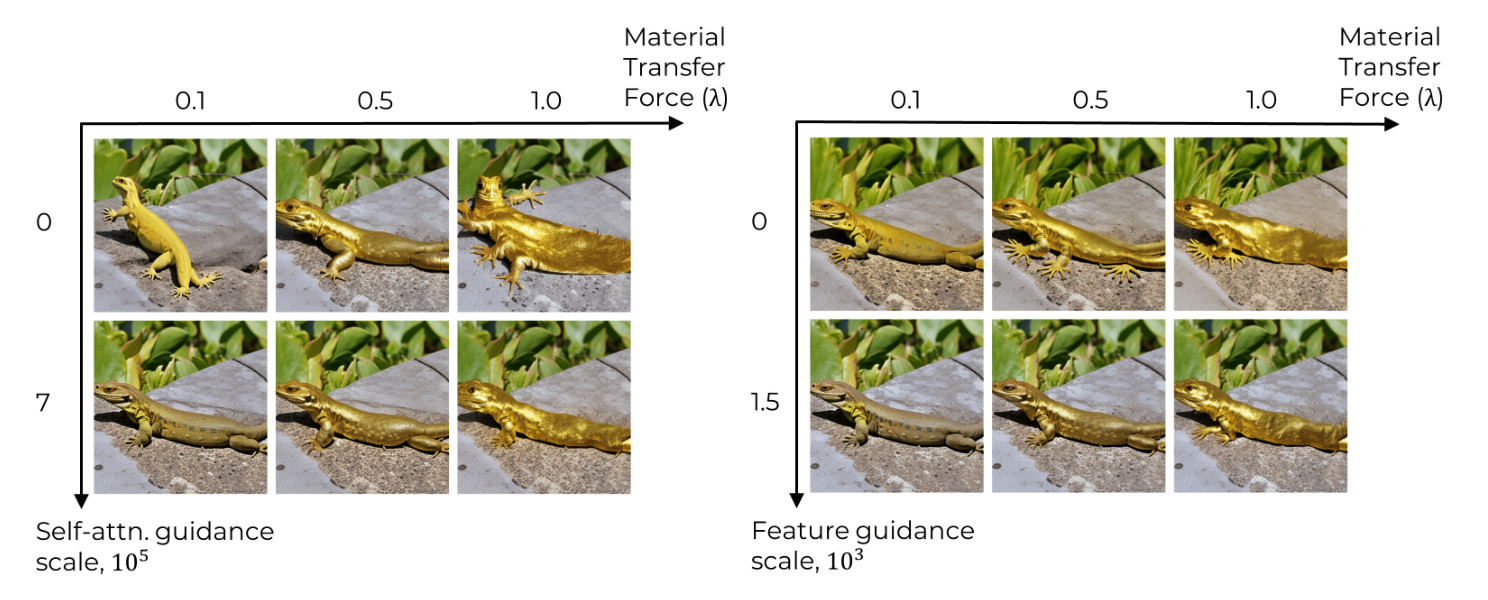
附录 A 的 Figure 9 对两种 guider 提供定性必要性示例:移除 self-attention guider 后物体姿态、几何更易改变;缺少 feature guider 后视觉特征更难保持。论文将 self-attention 主要解释为保布局/姿态,把 feature 解释为保视觉细节,同时承认 feature 也帮助几何。该观察符合表示的直觉,但没有单独移除组件的完整 CLIP/LPIPS 表或置信区间。
| 消融 / 扫描 | 来源 | 论文观测 | 不能据此推出 |
|---|---|---|---|
| 单独 GaR、单独 IP-Adapter、组合 | Fig.3、6、13 | 保持与转移功能互补 | 每一个替代结构先验都必然不如 GaR |
| 移除两类 guider 的局部对照 | Fig.9,附录 A | 轮廓/姿态与视觉细节各有损失 | 两类能量完全解耦,或对所有材质均有同等效果 |
| 只用 cross-attention mask | Fig.4 | 材质区域较受控,背景仍会漂移 | 第一层掩码无价值,或第二层可以完全替代第一层 |
| 背景回填持续时长 | Fig.10,附录 B | 较少步骤保护不足,全程有质量代价,作者选 40/50 | 40 步是不同分辨率/采样器/物体的稳定最佳点 |
| 完整方法 vs 无 masking | Fig.12 | 无 masking 的 LPIPS 更高 | 两种 mask 的独立贡献或交互已经被充分量化 |
| \(\lambda\) 扫描 | Fig.1、3、12、15 | 转移增强通常伴随更大源内容变化 | \(\lambda\) 可映射到 roughness、metallic、透明度的统一量尺 |

附录 J 描述一些序列先转移纹理再转移颜色,图示也包含物理属性观感变化。这里的“物理属性”应理解为视觉效果,不是测量到真实折射率或反射模型。方法没有为纹理、颜色、光泽分别提供独立通道,没有证明参数单调性,也没有相邻 slider 值的感知连续性度量。
更有信息量的后续消融应使用固定原图、相同 seed/起始 latent、固定 prompt 与同一套 mask;分别开关两类 guider 和两类 mask;记录对象内部保持、背景保持、边界伪影、材质相似度以及耗时。所有组合都扫相同强度范围,再比较 Pareto 曲线,而非只看单个最漂亮的输出。
14 · Reviewer 视角:值得借鉴与需要补证
优势
- 机制与任务匹配:参考图提供难以用短文字表达的细粒度外观,源图内部表示提供保持约束,区域掩码直接限制空间作用范围;各模块的职责清楚
- 无需本任务训练:无需收集大量成对材质替换真值,适合探索性编辑;对有固定扩散模型工作流的人,能量引导比再训练一个条件网络更容易试验
- 不是只报单一指标:CLIP 与 LPIPS 放在同一平面承认编辑/保持的冲突;用户研究也保留了材质保真度输给 ZeST 的结果
- 公开实现可追踪:配置、主入口与 guider 代码可查,有利于发现文字概念和真实执行之间的区别;双掩码的具体位置尤其有迁移价值
弱点与证据边界
- 模块组合的新颖性有限:IP-Adapter、GaR、DDIM 反演和 latent blending 都来自已有范式;迁移力直接使用 adapter 权重,主要是系统设计与应用落地
- “几何保持”缺少专门测量:整图 LPIPS 和有限主观判断无法隔离形状、姿态、纹理与背景;模型可能保留图片细节,却不具备稳定三维结构
- benchmark 偏小且信息不全:25 个物体与 15 种参考材质覆盖范围有限;缺少独立验证集来确定强度与阈值,存在同一评估集上选择超参数的可能
- 用户研究强结论不足:3 名评审者、样本数算术冲突、没有原始投票与统计不确定性,削弱大范围用户偏好推断
- 物理材质与视觉风格未区分:参考图片中的照明、颜色与语义都可能被迁移;没有跨光照、跨视角实验或真实 PBR 属性测量
- 成本缺乏系统报告:多次 UNet 前向、反传和 attention 存储使零训练不等于低成本;没有 matched-compute 评价,也没有分辨率扩展研究
- 实现与论文的差异影响复现:L1/L2、mask 次数、rescale、时间对齐和评估驱动都需要确认;不能只按表格数值就保证论文图可重现
适用场景:单物体中心图、明确前景、局部视觉原型、在几种强度候选里人工挑选。高风险场景:细线/毛发/透明边界、多物体相互遮挡、强反射或透明材质、需要保持文字与精密花纹的对象、需要 UV 可复用或多视角一致的生产级材质资产。
总体判断:将它视作一个有研究借鉴价值的图像域材质编辑工作流最合适。它证明了在作者有限测试集合上,组合约束能把材质迁移推向更好的视觉折中;并未证明取得了物理正确、跨视角一致、可程序化编辑的材质表示。
15 · 对 Procedural Material Generation 的可操作延伸
以下全部属于 Research Extension,论文没有做过这些实验。MaterialFusion 没有图拓扑、节点类型、边、参数程序、SBS/SBSAR 或 DiffMat 执行,也没有 renderer-in-the-loop。它对 PMG 更有价值的是“外观变化与结构保持分离”“在中间表示上施加约束”“空间局部化编辑”的思想,而不是把其 RGB 结果直接当作可用材质资产。
15.1 把图像强度旋钮变成受约束的程序参数编辑
给定程序图 \(G\)、参数 \(\vartheta\)、材质参考图 \(I_{\mathrm{ref}}\),保持图的语义骨架和关键节点,优化材质外观参数。用渲染器 \(R\) 生成多视图图像,在材质相似度之外加上几何/结构保持与参数复杂度约束:
\[\min_{\vartheta}\ \mathcal L_{\mathrm{mat}}\!\left(R(G,\vartheta),I_{\mathrm{ref}}\right)+
\alpha\mathcal L_{\mathrm{structure}}+\beta\mathcal L_{\mathrm{physical}}+\eta\|\vartheta-\vartheta_0\|_1.\]
这里的 \(\vartheta\) 是程序参数,区别于上文冻结扩散网络的 \(\theta\)。原图背景混合可类比为“冻结不需要编辑的图子结构”;但是参数掩码与像素掩码并不等价,一个上游节点可能影响全部输出。应先做节点依赖分析与敏感度估计,再决定可编辑子图。
15.2 Renderer-in-the-loop 的多视角一致性约束
让同一候选材质在多个固定形状、视角和照明下渲染,分别检查色彩/频谱、纹理尺度、法线方向与反射性质。检验目标从“某张图看起来像金属”升级为“同一套物理参数在变化照明下仍表现像金属”。为防止优化把参考照明烘焙进 base color,可引入跨光照的材质特征一致性和能量守恒约束。
最小验证实验:使用一组已知程序材质,固定几何、渲染照明组与参考相机,比较 RGB 单视图条件、图像+结构代理约束、显式多视图物理约束三组。报告 held-out 视角/照明下的误差、参数偏差和纹理平铺接缝;不能只用训练视角 CLIP 提升判断成功。
15.3 从固定强度到自动预算分配
以每步/每层动态权重 \(\lambda_{t,\ell}\) 替代全程统一 \(\lambda\),根据当前材质相似度与结构损失分配编辑强度。早期保护拓扑和大尺度布局,后期允许细纹理变化;对于 PMG 则先锁定图合法性和重要节点,再优化颜色、频率、粗糙度等可解释参数。应与简单的多强度网格搜索比较预算,不要用更多模型调用伪装算法收益。
15.4 把双掩码扩展为“生成约束 + 执行约束”
第一道约束放在生成器的条件/节点选择阶段,让修改仅指向指定材料区域或子图;第二道放在执行/渲染后,把未授权的参数差异、非法连接或区域泄漏反馈给搜索器。若使用 LLM agent,工具观测应是图校验、渲染指标、边界误差与失败原因,而不是凭语言自评“材质更好”。执行失败应回溯或修复图,不应该靠最终图片涂抹掩盖。
15.5 一个足够具体的研究问题
能否在保持程序材质图的可编辑性与跨照明一致性前提下,将参考图材质外观按单调感知强度迁移到可控子图?核心贡献应落在可解释参数路径、约束传播与多视图验证,而不是再增加一个全局 guidance scale。验证需同时包含材质相似度、几何/结构不变性、图合法率、编辑局部性、强度单调性、用户偏好和耗时。
16 · 复现清单与读完后应该记住什么
- 固定 PDF v2 与上述仓库提交,保留论文版和代码版配置的区别;不要让后来的仓库修改改变本次证据
- 确认模型 checkpoint、CLIP 图像编码器、VAE、Diffusers 版本;best 与 colab 属于同骨干的不同激活/attention 配置
- 检查中心裁剪后物体是否完整;检查 rembg 生成的前景 mask、灰度阈值与 bilinear 下采样,尤其关注黑色物体、细边界和透明部分
- 先测试 identity edit:相同图像、源/目标词、零或低图像强度,测 VAE+inversion 的基础重建误差;否则无法知道哪些变化来自材质迁移
- 单独核对 self L2、feature L1、范数 rescale、39/40 次 mask、原轨迹索引;修改这些项时一次只改一项
- 对固定输入扫 \(\lambda\),保持相同 seed/反演起点,保存原始输出与完整配置;不要只留人工挑选的最佳图
- 分开评估背景、物体内部与边界;对图像 crop 的 CLIP 协议补齐骨干、裁块数、随机种子与聚合权重后,才能声称复现 Fig.7/12
- 用户研究至少保存匿名原始投票与呈现顺序,核清 365/375/1125 的关系,并按受试者和对象考虑相关性
一句话记忆:IP-Adapter 负责给新外观,GaR 负责拉住原物体,两层 mask 负责把编辑留在目标区域;三者组成一个可调的感知折中,而不是可辨识的物理材质模型。
本轮交付边界:完整中文精读、关键表格重建、原图引用、公式源码与静态结构检查已按本轮范围处理;真实浏览器的 MathJax 渲染、图片加载、导航和 1440/760/390px 布局验收按用户要求延期。HTTP 可达性与图片解码检查不能代替浏览器验收;本轮也未运行模型推理、未发布网站、未修改现有 vault。
17 · 一手来源与可追溯入口
- MaterialFusion 固定 arXiv v2 元数据;原始 PDF(16 页,含全部附录);原文 HTML
- MaterialFusion 官方代码固定提交:本轮实现核查的唯一代码版本
- main.py:模型、VAE、50 步 DDIM、自动 mask、强度扫描入口
- guidance_editing.py:条件嵌入、四路前向、latent 梯度、背景混合、图像注意力 mask
- opt_guiders.py:self-attention L2、feature L1、选层与 feature hook
- noise_rescales.py:范数比例截断;scale_schedulers.py:固定 50 步引导日程
- image_utils.py:中心裁剪与 512×512 缩放;metrics.py:通用指标代码,不能直接视为论文 crop-pair 协议
- Guide-and-Rescale 官方仓库、IP-Adapter 官方仓库、ZeST 官方实现:原 Table 2 的 baseline 入口;本轮没有另行运行这些方法
原始 PDF 的 SHA-256:db4de54d1e397a12259978fbac8c57248da1b70113a1e06ae9fd92d7e58c0d65。图 1 引用官方仓库原图;图 9 从固定 PDF 第 11 页直接提取;其余图像引用固定版本 arXiv 的原图资源。所有图表版权与原始学术贡献归原作者。