有图像条件时:照片、mask、五张材质图。时间轴被重新解释为通道类型轴。
01 · 从照片中“取出”可重光照的材质
一句话结论:MaterialPicker 把预训练视频 Diffusion Transformer 改造成多通道材质生成器:照片裁剪占据一个条件帧,目标区域 mask 与五张 PBR 贴图占据待生成帧。它学习把带透视、弯曲、遮挡和光照的观察,转换成近似正视、可重新渲染的材质样本,同时保留文本控制能力。它输出的是栅格材质贴图,不是 Substance 节点图、shader 程序或可编辑 procedural graph。
Scenes 与 Materials 两种训练数据;前者学习几何去畸变,后者补充材质多样性。
A100 上论文报告的单次生成;原生 256²,再上采样至 512²。
核心阅读问题不是“DiT 能不能生成纹理”,而是:如何同时保留输入外观、解除输入与输出的像素对齐约束,并维持输出各物理通道的一致性?论文将数据构造和视频表示两条路线结合起来,但没有提供独立的受控实验,证明效果完全来自 self-attention 或视频预训练中的某一个因素。
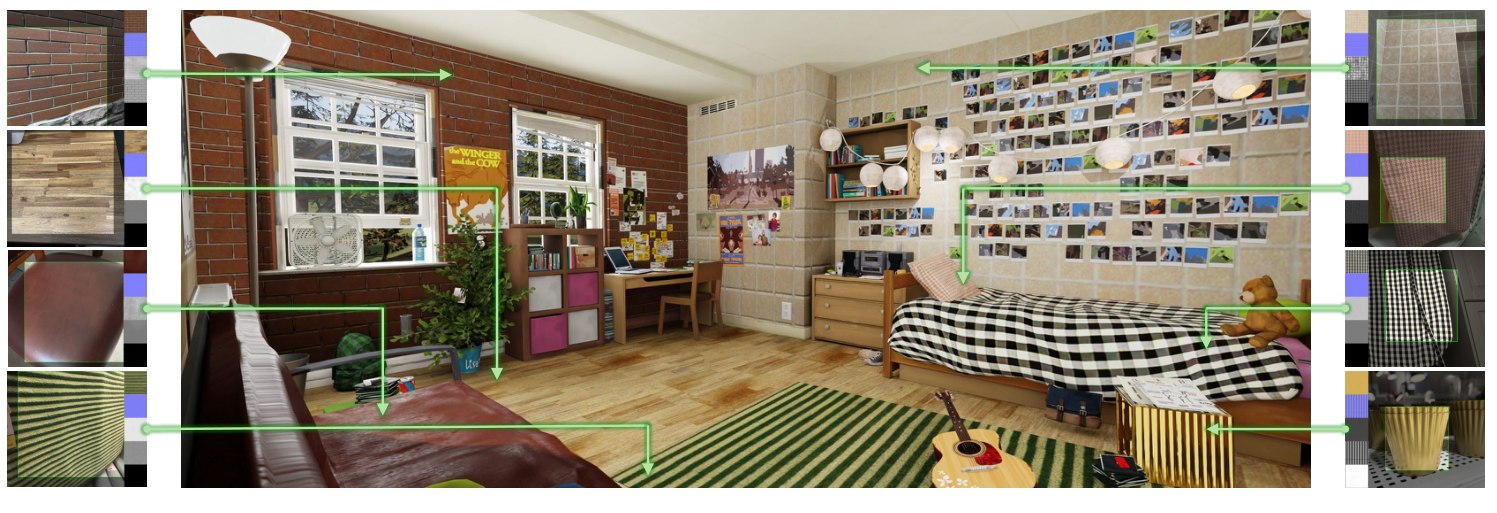
主依据:固定版本 arXiv:2412.03225v2,正文第 1–8 页及随附 Supplement 第 1–10 页。页面中“论文事实”“作者解释”“本文解读”“研究延伸”分开标注。原图从同一固定 PDF 提取,未用后续版本替换。
02 · 论文身份、版本与原笔记纠正
| 项目 | 已核实内容 | 使用边界 |
|---|---|---|
| 本次精读对象 | MaterialPicker: Multi-Modal Material Generation with Diffusion Transformers;2412.03225v2;2024-12-06 | 20 页 PDF:10 页正文/参考文献,10 页 Supplement;固定文件 SHA-256 已核验 |
| 作者 | Xiaohe Ma、Valentin Deschaintre、Miloš Hašan、Fujun Luan、Kun Zhou、Hongzhi Wu、Yiwei Hu | 正文列出的浙江大学与 Adobe Research;v2 未明确标注通讯作者 |
| 后续正式发表 | MaterialPicker: Multi-Modal DiT-Based Material Generation;ACM TOG 44(4),Article 133,2025;DOI 10.1145/3731199 | 作者主页标为 SIGGRAPH 2025;仅作身份补充,不将新版实验和细节混入 v2 |
| 原笔记的 venue | 原笔记写 CVPR,与该论文正式出版记录不符 | 原 frontmatter 与原文保留不动,纠正在新增段落中明确提出,等待用户后续合并判断 |
| 代码/权重 | 本次核查的作者官方项目页仅提供 Paper、arXiv 与结果展示,未找到其链接的训练代码、推理代码或权重 | “未核实到公开实现”不等于断言不存在;无法开展真实 Paper vs. Implementation 行级审计 |
重要版本隔离:v2 将基础模型描述为类似 Brooks 等人视频生成架构的预训练 DiT,没有给出可下载 checkpoint 名、参数量或完整网络配置。不能据此把它称为实际使用 Sora 权重;也不能把后续版本关于其他视频模型、编码器或新增实验的说明,倒填为 2024 年 v2 已披露的事实。
03 · Research gap:生成式材质提取
输入照片为什么不是一张可以直接使用的贴图?
真实照片中的颜色同时受 albedo、法线与微结构、粗糙度、金属属性、相机姿态、照明和遮挡影响。把桌面一角裁下来当 albedo,会把高光与阴影一起烘焙进纹理;再在新场景照明下使用时,会出现双重光照。透视还会使规律纹理变成非均匀尺度的梯形排列。对弯曲表面,单个 homography 也不足以恢复平面纹理。
论文事实:现有单图 SVBRDF capture 常依赖接近正视的平面样本或相机共位闪光。Material Palette 已放宽输入几何约束,但需要每张图单独优化 DreamBooth/LoRA,再经材质估计网络得到贴图。文中报告其每例约 3 分钟;Hao 等方法主要做纹理整流,输出纹理而非完整 PBR 参数图。
两条互补假设
- 数据假设:利用随机几何、相机和光照建立“畸变场景裁剪 → 平面材质图”的大量监督,可以学习去遮挡、去透视及去光照,而不要求输入严格对齐目标。
- 表示假设:把不同材质图作为视频帧,比把一个 RGB 图像模型硬改成大量通道更容易复用已有生成先验;跨帧注意力可共享结构信息,同时允许条件照片与目标图的坐标不同。
本文解读:它更接近“符合照片外观的材质再合成”,而非逐像素精确反演。生成图可以改变纹理元素的相位、局部位置,甚至补出不可见区域。作者因此主要使用语义/感知特征相似度,而不是像素误差。这个任务定义有利于开放世界建模,但意味着看起来相似不等于恢复了唯一真实 BRDF。
来源:v2 §1、§2、§4.1,PDF 第 1–3、5 页。
04 · 输入、输出与表示契约
| 符号/对象 | 含义 | 容易混淆的边界 |
|---|---|---|
| \(I\) | 包含主导材质的 RGB 照片方形裁剪 | 不是完整照片自动场景分解;用户仍需指定粗裁剪 |
| \(c\) | 可选文本材质描述 | 提供类别与反射性质线索,不包含 LLM 工具调用或程序约束 |
| \(V\) | 裁剪中主导材质的分割 mask | 默认是模型输出;正文此符号也用于 token 数,本文避免混用 |
| \(M=(A,N,H,R,Q)\) | albedo、normal、height、roughness、metallicity 五图 | 这里用 Q 记金属度以避开 M 集合符号;展示图的列顺序有时为 A、N、R、H、Q |
| \(x\) | 沿“时间”维堆叠的 7 帧训练样本 | 帧是语义通道,不是物体运动的物理时刻 |
| \(y\)、\(\hat{x}\) | VAE latent 与 patch token | 不是 graph token;论文未公开 latent 尺寸、patch size 或 token 数 |
| \(f_{\theta}\) | 学习预测噪声的条件 DiT | 全套五图与 mask 联合去噪;没有逐节点自回归生成 |
\[ x=\operatorname{stack}(I,V,A,N,H,R,Q)\in\mathbb{R}^{7\times3\times H_{\mathrm{img}}\times W_{\mathrm{img}}}. \]
该式对应正文 §3.3 的堆叠表示,本文用空间高度下标避免与 height map 混淆。7×3 是网络接口而不是“21 个独立物理参数”。mask、height、roughness、metallicity 本质上可为单通道;v2 写为 RGB 帧,但没有明确说明其数值编码、通道复制方式或解码后通道合并规则,复现必须补齐这份接口协议。
作者解释:各目标材质图应彼此结构对齐,但输入照片可以不对齐。审慎理解:self-attention 提供跨位置交互能力,本身不构成对齐的数学保证;需要训练数据与损失共同诱导。mask 表示输入中主导区域,而输出材质图经过整流,二者坐标语义尤其需要在实现中确认,不能简单断言 mask 与 rectified maps 逐像素同构。
仅文本条件时移除输入图像帧,得到 6 帧序列;mask 的目标内容为全白占位图。无条件生成也使用全白 mask。fps=1 只是计算 temporal position 的约定,不表示真正存在一秒一次的物理事件。
来源:v2 §3.1–3.3,PDF 第 3–4 页。
05 · 数据构造决定它学到什么
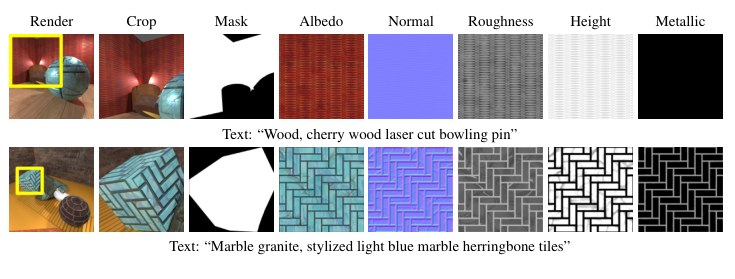
Scenes:通过场景随机化学习去畸变
- 搭建类似随机 Cornell box 的室内场景,含平面墙/地面以及 cube、sphere、cylinder、cone、torus 等几何体。
- 从约 3,000 种 stationary 材质中随机分配给物体。“stationary”指近似平移不变的局部纹理统计,不等于没有结构。
- 随机相机、点光源和面积光源,得到约 100,000 张高分辨率场景渲染;Figure 2 说明示例为 2K 渲染。
- 裁剪目标区域,主导材质必须占裁剪面积至少 70%,保存 image、mask、材质图与可选的材质名称文本。
- 利用 UV 坐标缩放目标材质图,使目标图中纹理元素的尺度匹配输入裁剪,最终得到 800,000 组 text-image-mask-material 数据。
\[\rho=\frac{\sum_{u,v}\mathbf{1}[V(u,v)=1]}{H_{\mathrm{img}}W_{\mathrm{img}}}\ge0.70.\]
这是对论文 70% 规则的显式化,不是新增损失函数。它使“选主导材质”成为可学习问题,也限定了训练分布:当用户只框到一小块目标,或者两个材质各占约一半时,模型的选择可能不稳定。不能把训练阈值理解为推理时运行的硬判定器。
Materials:增加复杂纹理与文本语义
第二套数据仅需 text-material pairs,使用材质名称作文字条件,经增强/裁剪达到 800,000 个样本,补充 Scenes 中较少的复杂、非 stationary 图案。两个 800K 是训练样本/裁剪数量,不是 160 万种独立原始材质。两者按 5:3 混合,偏重有图像的 material picking。
来源歧义必须保留:v2 Introduction 将文字到材质数据关联到参考文献 [47] ControlMat,而 §3.2 将 Materials 数据关联到 [30] MaterIA。正文未给清晰的数据清单、版本号或公开下载索引,因此不能无条件把某个外部库认定为本实验精确训练集。
| 数据 | 数量与来源 | 作用 | 未公开/需确认 |
|---|---|---|---|
| Scenes | 约 3K 材质 → 100K 渲染 → 800K 裁剪 | 任意视角/几何与照明下的材质条件生成 | 资产清单、材质来源去重、相机/灯光分布、UV 缩放算法、train/val 划分 |
| Materials | 增强后 800K text-material crops | 开放纹理覆盖与文本生成能力 | 原始独立材质数量、具体 dataset release、裁剪增强分布 |
| 合成评测 | 531 PolyHaven 材质 × 3 Archinteriors 场景 = 1,593 图 | 与 Material Palette 定量比较 | 精确 asset IDs、随机种子;场景独立不自动等于所有训练材质都无重叠 |
| 真实照片评测 | 手机拍摄,室内/室外、多种材质 | 看真实域泛化、复杂照明与遮挡 | 总样本数、采样准则、完整失败率与统计汇总未披露 |
来源:v2 §3.2、§4.1;Figure 2、Supplement A.3。
06 · 数学机制:条件帧不加噪,目标帧联合去噪
从普通扩散目标到材质目标
正文 Eq.1 是噪声回归:从数据、时间步和高斯噪声构造带噪样本,让网络预测噪声。下面用标准条件期望重写,去除原式多余右括号;未补设具体 noise schedule:
\[\mathcal{L}_{\mathrm{denoise}}=\mathbb{E}_{x,t,\epsilon}\left[\left\|\epsilon-f_{\theta}(x_t;c,t)\right\|_2^2\right],\qquad\epsilon\sim\mathcal{N}(0,\mathbf{I}).\]
其中 t 表示噪声水平/去噪时间,c 为文本等条件,θ 为模型参数。训练中的“预测噪声”不是让模型最终输出噪点,而是利用预测量逐步反演加噪过程。论文采用 VAE latent 以降低 token 数,但为解释方便在帧空间记号下写公式;不应把式中的 x_t 误读为确定在 RGB 像素空间执行扩散。
\[x_t=\operatorname{stack}(I,V_t,M_t),\qquad\mathcal{L}_{\mathrm{MP}}=\mathbb{E}_{x,t,\epsilon}\left[\left\|\epsilon_{V,M}-f_{\theta}(x_t;c,t)_{V,M}\right\|_2^2\right].\]
这对应 Eq.2 的 last-six-frames 选择:第一帧 I 始终干净,只有 mask 和五图加噪,并在它们上计算损失。干净 I 让模型在每一步都能读取明确条件;目标六帧同时存在,使颜色、法线、凹凸和反射属性可以交换信息。它不是先生成 albedo 再独立估计其他图,也不是把六张 RGB 拼成一张空间大图。
VAE、patch 与位置编码分别做什么?
\[x\xrightarrow{E_{\mathrm{VAE}}}y\xrightarrow{\operatorname{Patchify}}\hat{x},\qquad \hat{x}\in\mathbb{R}^{N_{\mathrm{tok}}\times D}.\]
VAE 压缩空间/时序表征;patchify 把 latent 变成 token;spatial-temporal position 告诉 DiT 某 token 属于哪张图、哪个位置。文本编码到相容特征维度作为条件。v2 提到预训练文本编码器并引用 CLIP,但没有给出完整编码器版本、融合层细节或冻结策略。因此这里只解释职责,不把概念图扩写成已验证的具体实现。
作者解释:复用视频先验可以带来更强语义和纹理分布,避免材质训练集太小导致多样性下降。证据边界:论文没有同架构 scratch 与 pretrained 的定量对照,也没有容量匹配的 U-Net vs. DiT 实验;这一机制解释有合理性,但尚未被独立拆解。
CFG 与多模态条件
训练随机丢弃条件以支持 classifier-free guidance。标准 CFG 可用如下形式帮助理解:
\[\hat{\epsilon}=\epsilon_{\mathrm{uncond}}+s\big(\epsilon_{\mathrm{cond}}-\epsilon_{\mathrm{uncond}}\big).\]
教学性表示:s 是引导强度,不是该论文公开的数值配置。v2 没有给条件 dropout 概率、图像与文本是否分别引导、CFG scale 或采样器名称,不能据此擅定参数。beam search、top-k、top-p、temperature、graph constrained decoding 不属于已描述流程。
mask-input 消融如何改变训练?
\[x_t^{\mathrm{mask\mbox{-}input}}=\operatorname{stack}(I,V,M_t),\qquad\mathcal{L}_{\mathrm{mask\mbox{-}input}}=\mathbb{E}\left[\left\|\epsilon_M-f_{\theta}(x_t^{\mathrm{mask\mbox{-}input}};c,t)_M\right\|_2^2\right].\]
Supplement A.2.1 将 V 也设为干净条件,只对五图加噪与计算损失。这个对照问的是“省去人工/外部分割输入,会不会明显损失生成质量”,而不是“mask 生成能否作为材质估计的因果监督”。实验只给可视化,没有 mask IoU 或大规模质量显著性检验。
来源:v2 §3.1–3.4 Eq.1–2;Supplement A.2.1。
07 · Training:可复现配置与缺失项
| 配置 | v2 明确给出 | 复现含义 |
|---|---|---|
| 基础模型 | 预训练 DiT text-to-video model,类似 Brooks et al. 架构 | 准确模型/权重不可从正文确定 |
| 优化器 | AdamW | β、ε、weight decay 没有列出 |
| 学习率 | \(0.99\times10^{-4}=9.9\times10^{-5}\) | 未公开 schedule、warmup 与分层学习率 |
| 有效 batch | 64 | 每卡 batch、梯度累积与梯度裁剪未知 |
| 训练长度 | 约 70K steps,90 小时 | 按 8 卡计算约 720 A100 GPU-hours,为本文算术换算 |
| 硬件 | 8 × Nvidia A100 | 显存型号、并行策略、precision 未披露 |
| 分辨率 | 256 × 256 | 原生训练/生成分辨率;512 结果经过后处理 |
| 混合数据 | Scenes:Materials = 5:3 | 按期望比例约 62.5% / 37.5%;具体 batch 组织未知 |
| 条件与损失 | 随机丢弃条件;噪声预测损失;目标六帧 | 没有公开额外 rendering loss、normal-height consistency loss 或物理约束 |
| 参数更新范围 | 描述为 finetune 预训练模型 | 没有详列 VAE/文本编码器冻结情况,不能断言全参数或 LoRA 微调 |
训练循环重建(依据论文的最小逻辑,不是官方源代码):按 5:3 采样数据 → 构建 7 帧或 6 帧张量 → 处理可用图像/文字条件并进行随机条件丢弃 → VAE 编码与 token 化 → 对目标部分施加采样时间对应的噪声 → DiT 预测 → 只在需生成部分回归噪声 → AdamW 更新。若要真实复现,首先需要确定被保留的干净条件在 3D VAE 的时间压缩下如何避免和目标帧相互污染;v2 没给足实现细节。
算术而非作者结果:70,000 × 64 ≈ 448 万次样本暴露;这不是精确 epoch 数,因为有混合采样、增强、可能重复和未公开的 epoch 定义。按固定比例估计,Scenes 与 Materials 暴露约 280 万和 168 万次,不能把这些推导当作日志实测。
来源:v2 §3.4,PDF 第 4–5 页。
08 · Inference:从裁剪到新场景重渲染
- 选择目标:用户提供粗方形裁剪;可附文字说明来减少金属/非金属、图案类别等歧义。论文没有要求手工 mask,但也没有自动“全图找所有材质”的流程。
- 建立条件:有图像时保持其条件帧干净;文字经过文本编码;无图像时使用 6 帧设置。
- 初始化目标:为 mask 与五张材质图对应的 latent 准备噪声,联合执行 50 个 diffusion steps。具体噪声 scheduler、seed、CFG 系数未报告。
- 解码五图:得到原生 256² 栅格输出及主导区域 mask。不同随机样本可以符合相似外观,但论文没有提供候选采样数、reranking 或一致性筛选规则。
- 上采样:使用参考文献 [32] waifu2x-ncnn-vulkan,将每张材质图提高到 512²。具体模型、降噪档位以及 normal renormalization 未说明。
- 应用与评估:将结果送入渲染器,在平面或场景中于不同环境光下渲染。渲染用于展示/评估,不是论文已公开的逐例 test-time optimization 环。
与 Material Palette 比较时,两者均在 A100 上测得约 12 秒 vs. 180 秒,即 15 倍。这个结论支持减少逐图 LoRA 拟合开销,但不应外推为所有 GPU、batch、分辨率都固定 15 倍。文中没有给完整端到端 breakdown,也未明确 12 秒是否涵盖裁剪、上采样、渲染和 I/O。
Prompt 情况:训练主要使用材质名称;图中展示的短语如蓝色格纹织物、陶砖墙或带槽金属体现材质属性控制。没有 system prompt、few-shot、工具描述、reflection/retry prompt,也没有 LLM agent。“文本引导”在这里是 diffusion conditioning。
执行契约缺口:normal 的坐标约定、height 的量纲、roughness 参数化、颜色空间、metallic 裁剪范围与平铺边界处理,v2 均不足以直接落地。先把这些作为实现检查项,而不是暗中采用自己常用的 Blender/Substance 默认值。
来源:v2 §3.4、§4.2;参考文献 [32]。
09 · 评测协议:外观相似,不是像素真值恢复
合成评测使用 531 个 PolyHaven 材质,分别施加到 3 个独立 Archinteriors 场景中的指定物体,在 Blender Cycles 中按场景默认照明渲染,总计 1,593 张图。给两个方法同一目标裁剪;由于 Material Palette 只产生 albedo、normal、roughness,定量比较限于这三通道及重渲染图。MaterialPicker 的 height、metallicity 没有在主定量表中得到独立准确度验证。
\[\operatorname{sim}_{\phi}(a,b)=\frac{\phi(a)^{\mathsf T}\phi(b)}{\|\phi(a)\|_2\|\phi(b)\|_2}.\]
CLIP-I 使用 ViT-L/14 的图像 embedding;DINO 按论文写为 ViT-L/16 特征,相似度越高越好。上式解释它们共享的 cosine 运算,论文写“平均 pairwise cosine similarity”,没有给完整实现细节,尤其 crop/resize、mask 使用方式以及特征归一化/聚合代码。
\[\operatorname{FID}=\|\mu_g-\mu_r\|_2^2+\operatorname{Tr}\!\left(\Sigma_g+\Sigma_r-2(\Sigma_g\Sigma_r)^{1/2}\right).\]
这是 FID 的标准教学性定义:在特征分布中比较生成集与参考集的一阶、二阶统计,越小越好。v2 说明以 531 组输出和对应真值计算,并在 3 个场景间平均;具体分组措辞并不完全清晰,未公布实现,因此这里不擅自指定“每张图单独算 FID”或隐藏 patch 采样方案。复现前应取得准确评估脚本。
哪些结论可以从这些指标中得到?
- 可以比较感知外观和分布匹配,适合不严格对应每个纹理元素位置的生成任务。
- 不能仅凭高 CLIP/DINO 分数证明 normal 数值正确或 roughness/metallic 解耦正确;这些特征不是为 BRDF 参数误差设计的。
- 重渲染相似度比单贴图更接近下游用途,但若光照/几何固定,错误的参数组合也可能得到相似图像,需要跨光照/视角验证。
- 真实照片主要为定性展示,没有相应材质真值;代表性样例支持可行性,不构成无偏的总体成功率估计。
来源:v2 §4.1–4.2,PDF 第 5–6 页;Table 1、Supplement Table 2。
10 · 关键定量结果:完整重排原表
以下保留 Table 1 的全部方法、通道和数值。加粗表示该指标/通道中更好的均值;并非所有单元格均由 MaterialPicker 获胜。
原 Table 1 · CLIP-I ↑
| 方法 | Albedo | Normal | Roughness | Render |
|---|---|---|---|---|
| Material Palette | 0.816 | 0.867 | 0.791 | 0.955 |
| MaterialPicker | 0.857 | 0.874 | 0.866 | 0.967 |
原 Table 1 · DINO ↑
| 方法 | Albedo | Normal | Roughness | Render |
|---|---|---|---|---|
| Material Palette | 0.503 | 0.631 | 0.502 | 0.797 |
| MaterialPicker | 0.494 | 0.672 | 0.566 | 0.863 |
原 Table 1 · FID ↓
| 方法 | Albedo | Normal | Roughness | Render |
|---|---|---|---|---|
| Material Palette | 112.249 | 92.620 | 155.354 | 26.828 |
| MaterialPicker | 107.310 | 91.057 | 79.785 | 12.224 |
本文计算:Render FID 从 26.828 降到 12.224,绝对下降 14.604,相对约 54.4%;roughness FID 下降约 48.6%。Render DINO 增加 0.066,roughness CLIP 增加 0.075。最大的收益集中在反射/整体渲染相关外观;normal FID 只从 92.620 到 91.057,约 1.7% 相对下降。不能用总体优越掩盖各通道改善幅度差异。
原 Supplement Table 2 · 95% confidence intervals
| 指标 | 方法 | Albedo | Normal | Roughness | Render |
|---|---|---|---|---|---|
| CLIP-I ↑ | Material Palette | (0.814, 0.820) | (0.864, 0.870) | (0.788, 0.794) | (0.954, 0.956) |
| CLIP-I ↑ | MaterialPicker | (0.855, 0.860) | (0.872, 0.876) | (0.863, 0.869) | (0.966, 0.968) |
| DINO ↑ | Material Palette | (0.494, 0.513) | (0.622, 0.640) | (0.493, 0.512) | (0.792, 0.802) |
| DINO ↑ | MaterialPicker | (0.484, 0.503) | (0.663, 0.680) | (0.556, 0.576) | (0.859, 0.867) |
不能错读 albedo:DINO 均值是 0.494 vs. 0.503,MaterialPicker 更低;两区间重叠。CLIP 的 albedo 区间不重叠且 MaterialPicker 较高。因此不能笼统说“albedo 无提升”,也不能说“全部指标显著领先”。区间是否重叠也不能替代与样本相关结构相匹配的成对统计检验,论文没有公开置信区间估计方法。
原 Table 1,PDF 第 6 页 · 原 Supplement Table 2,PDF 第 12 页
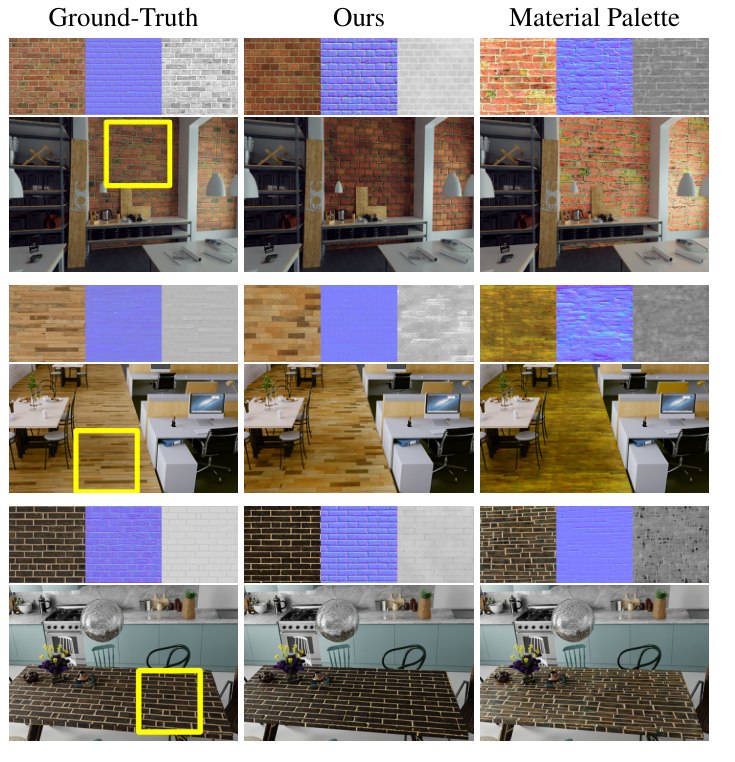
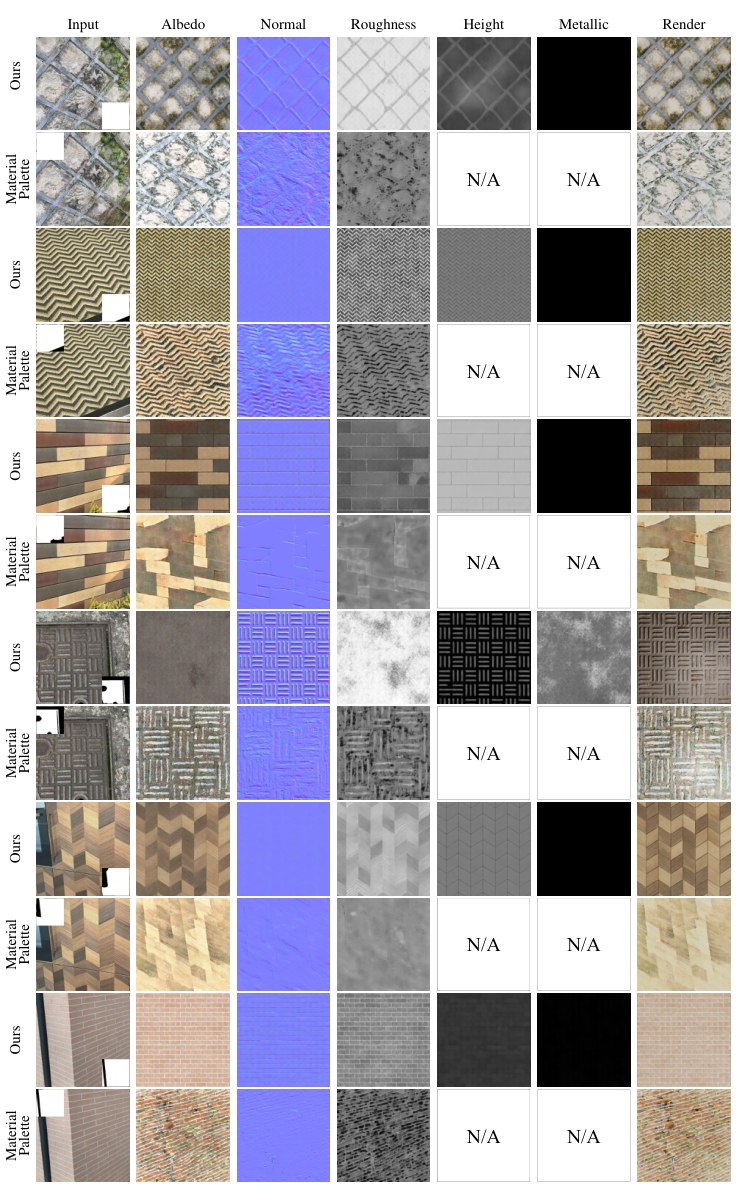
Figure 3 的黄框是输入 crop;比较时应看结构规律性和新材质替换后渲染,而不是要求每块砖/木纹位置一一重合。Figure 4 中 Material Palette 的 height、metallicity 标为 N/A,这是输出能力差异,不应作为其已有三个通道“失败”的证据。
11 · 纹理整流与文本生成:证据强度不同
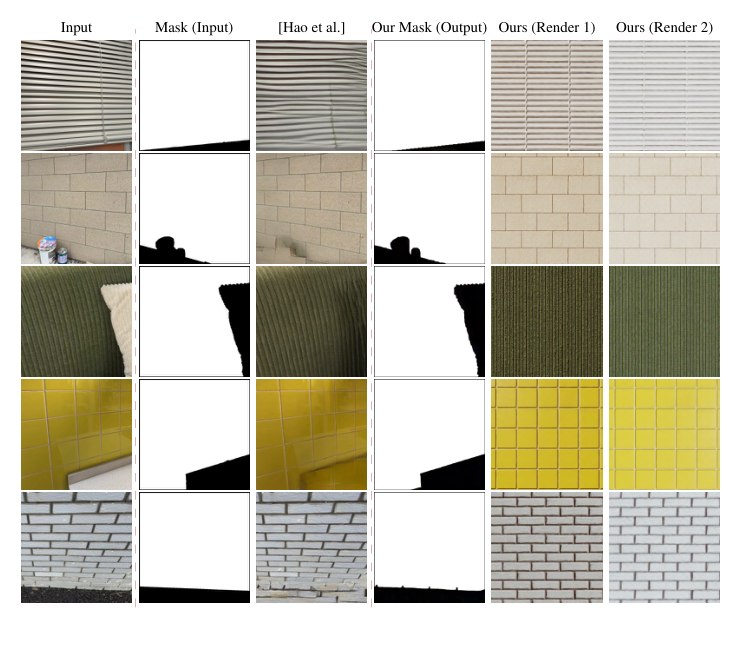
整流对照:Hao 等方法接收纹理照片和输入 mask,输出 rectified texture;MaterialPicker 不需输入 mask,输出五图,再在两种环境光下显示渲染结果。例子显示它对非正视纹理和弯曲表面更稳健,并能减少原照明泄漏。由于两个方法输出任务不同,这主要证明工作流可用性与视觉效果,不能当作等价 PBR 逆渲染误差的受控比较。
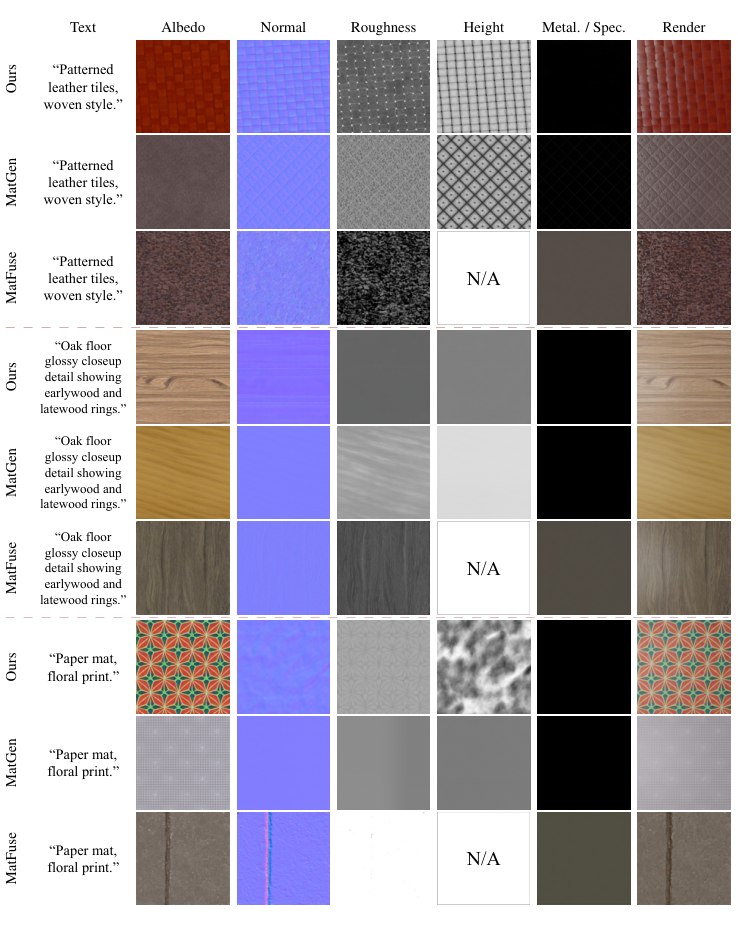
文本对照:Figure 6 对比 MatGen(文中引用 ControlMat [47])和 MatFuse [48]。MatFuse 输出 specular 而非 metallic,且缺少 height,原图已标 N/A。论文展示生成语义复杂图案的能力,例如木材年轮或花卉印花,但没有给文本对齐分数、样本多样性统计、FID 汇总或人类偏好研究。因此准确表述是“定性上表现相当且有复杂语义能力”,而不是量化证明全面超越这些 text-to-material 方法。
| baseline | 比较任务与配置 | 本文结果支持 | 公平性/证据边界 |
|---|---|---|---|
| Material Palette | 同裁剪图;对方需 mask 与逐例 LoRA;比较三图与 render | Table 1 多数指标改善,12 s vs. 3 min | 不同 pipeline;不把额外输出通道纳入定量胜率 |
| Hao et al. | 纹理整流;对方接收输入 mask | 真实照片定性去畸变展示 | 纹理输出 vs. 五图重渲染,缺少统一数值评估 |
| MatGen / MatFuse | 相同文本提示的材质生成 | 复杂图案与语义的定性可用性 | BRDF 参数化/输出图不同;无全量 quantitative ranking |
来源:v2 §4.2–4.3,Figure 5–6。
12 · Ablation:哪些设计被真正检验?
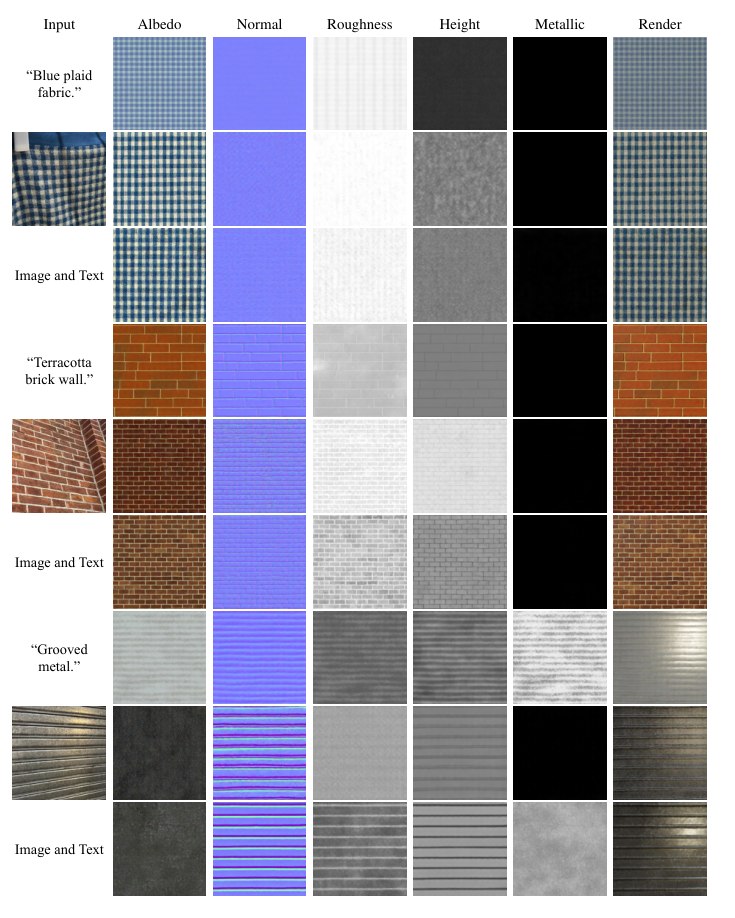
多模态:Figure 7 比较 text-only、image-only、image+text。图像更明确约束图案外观,文字能帮助区分反射性质;金属样例展示双条件减少歧义。该实验是可视化展示,未报告各模式在完整测试集上的误差或对提示词冲突的鲁棒性。
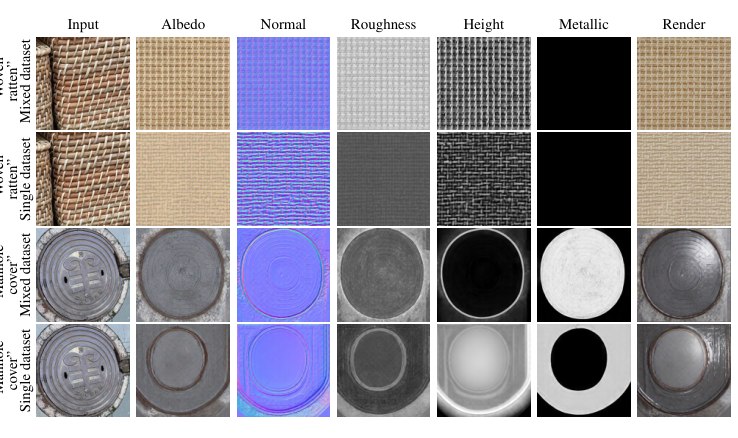
混合数据:Figure 8 将混合训练与 Scenes-only 对比,后者对编织纹理和井盖类结构较弱。它支持额外 Materials 数据有帮助,但没有等训练步数/等样本量/等独立材质数的完整控制,因此不能唯一归因于“non-stationary 数据类别”或“预训练语义被保存”。
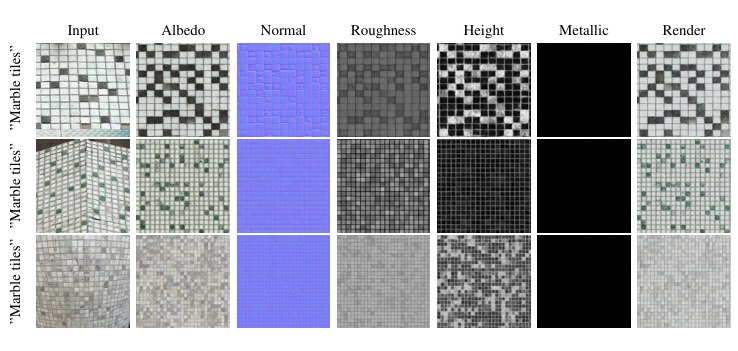
输入尺度:Figure 9 随 crop 的纹理尺度改变,输出图保持相应尺度趋势。该结果与 UV scale matching 数据设计一致;没有给连续尺度误差、极端尺度范围或移除 UV 缩放的严格定量消融。它验证现象,不完成对训练步骤因果作用的隔离。
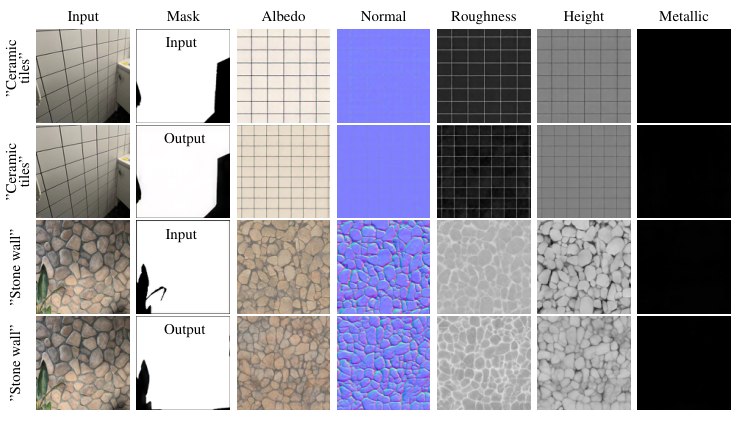
mask 输入 vs. 输出:Supplement Figure 11 两种模型分别使用干净输入 mask 与生成输出 mask。示例显示后者未明显损失质量,减少用户标注负担;没有 IoU、边界 F-score 或难分割/多材质案例的统计。
| 实验 | 改变的因素 | 论文给出的证据 | 尚不能声称 |
|---|---|---|---|
| 多模态 | 图像/文字条件组合 | Figure 7 定性样例 | 双条件在所有材质、所有提示上必然更优 |
| 数据混合 | 是否加入 Materials | Figure 8 定性样例 | 已隔离数据量与数据多样性两个因果因素 |
| 输入尺度 | 照片中图案尺度 | Figure 9 趋势展示 | 精确恢复物理单位或任意缩放都可靠 |
| mask 策略 | 预测 V 或输入 V | Supplement Figure 11 | 两者统计等效、mask 数值已充分验证 |
| 架构/先验 | DiT vs. U-Net、scratch vs. pretrained | v2 未提供受控实验 | 性能提升完全由 self-attention 或视频预训练造成 |
来源:v2 §4.4.1–4.4.3;Supplement A.2.1。
13 · Appendix:畸变、光照与更多实例
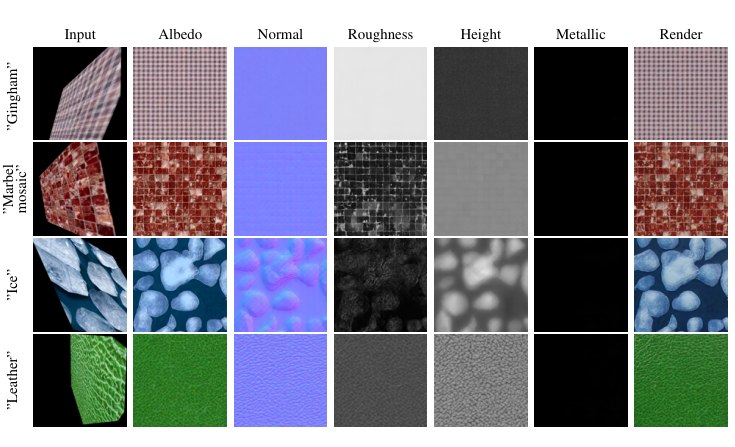
Supplement A.3 从 TexSD 纹理构造测试,沿用 Hao 等方法的处理步骤,施加 homography 与 thin-plate spline 变换,覆盖透视、非线性扭曲、拉伸及变换带来的模糊。Figure 12 展示仍能生成接近正视的材质。没有给变换参数范围、每类扰动样本数、失真强度曲线或总体量化结果,因此将其标为“定性 robustness stress test”。
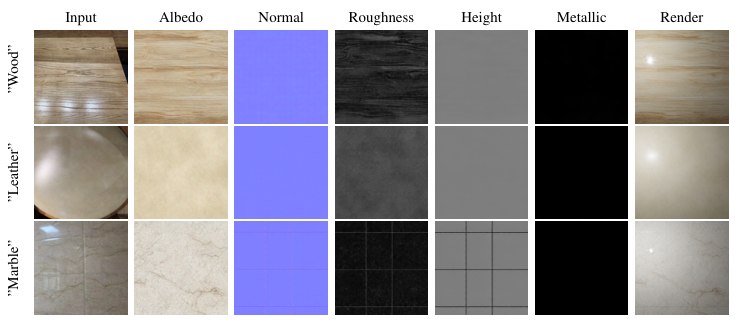
Figure 13 展示强高光、阴影、环境反射不明显泄漏到材质图的成功实例。它与正文 Figure 10 的阴影失败并不矛盾:同一模型可以在一些条件中分离光照,在另一些条件中把阴影当纹理。稳健性应报告成功与失败的分布,而不是用几张图概括为照明不变。
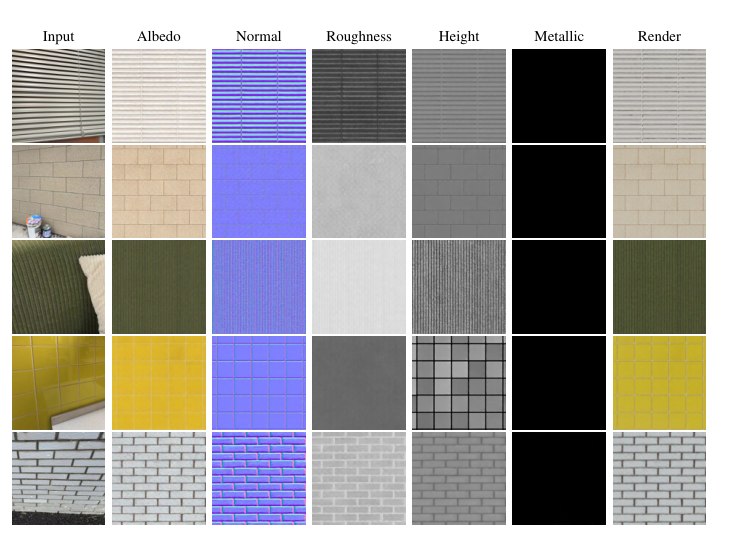
Figure 14 补齐正文 Figure 5 五个整流案例的材质图,让读者看到两种重渲染背后的 albedo/normal/roughness/height/metallicity,而非只比较最终 RGB 输出。
展开原 Figure 15–16:更多合成材质替换对照
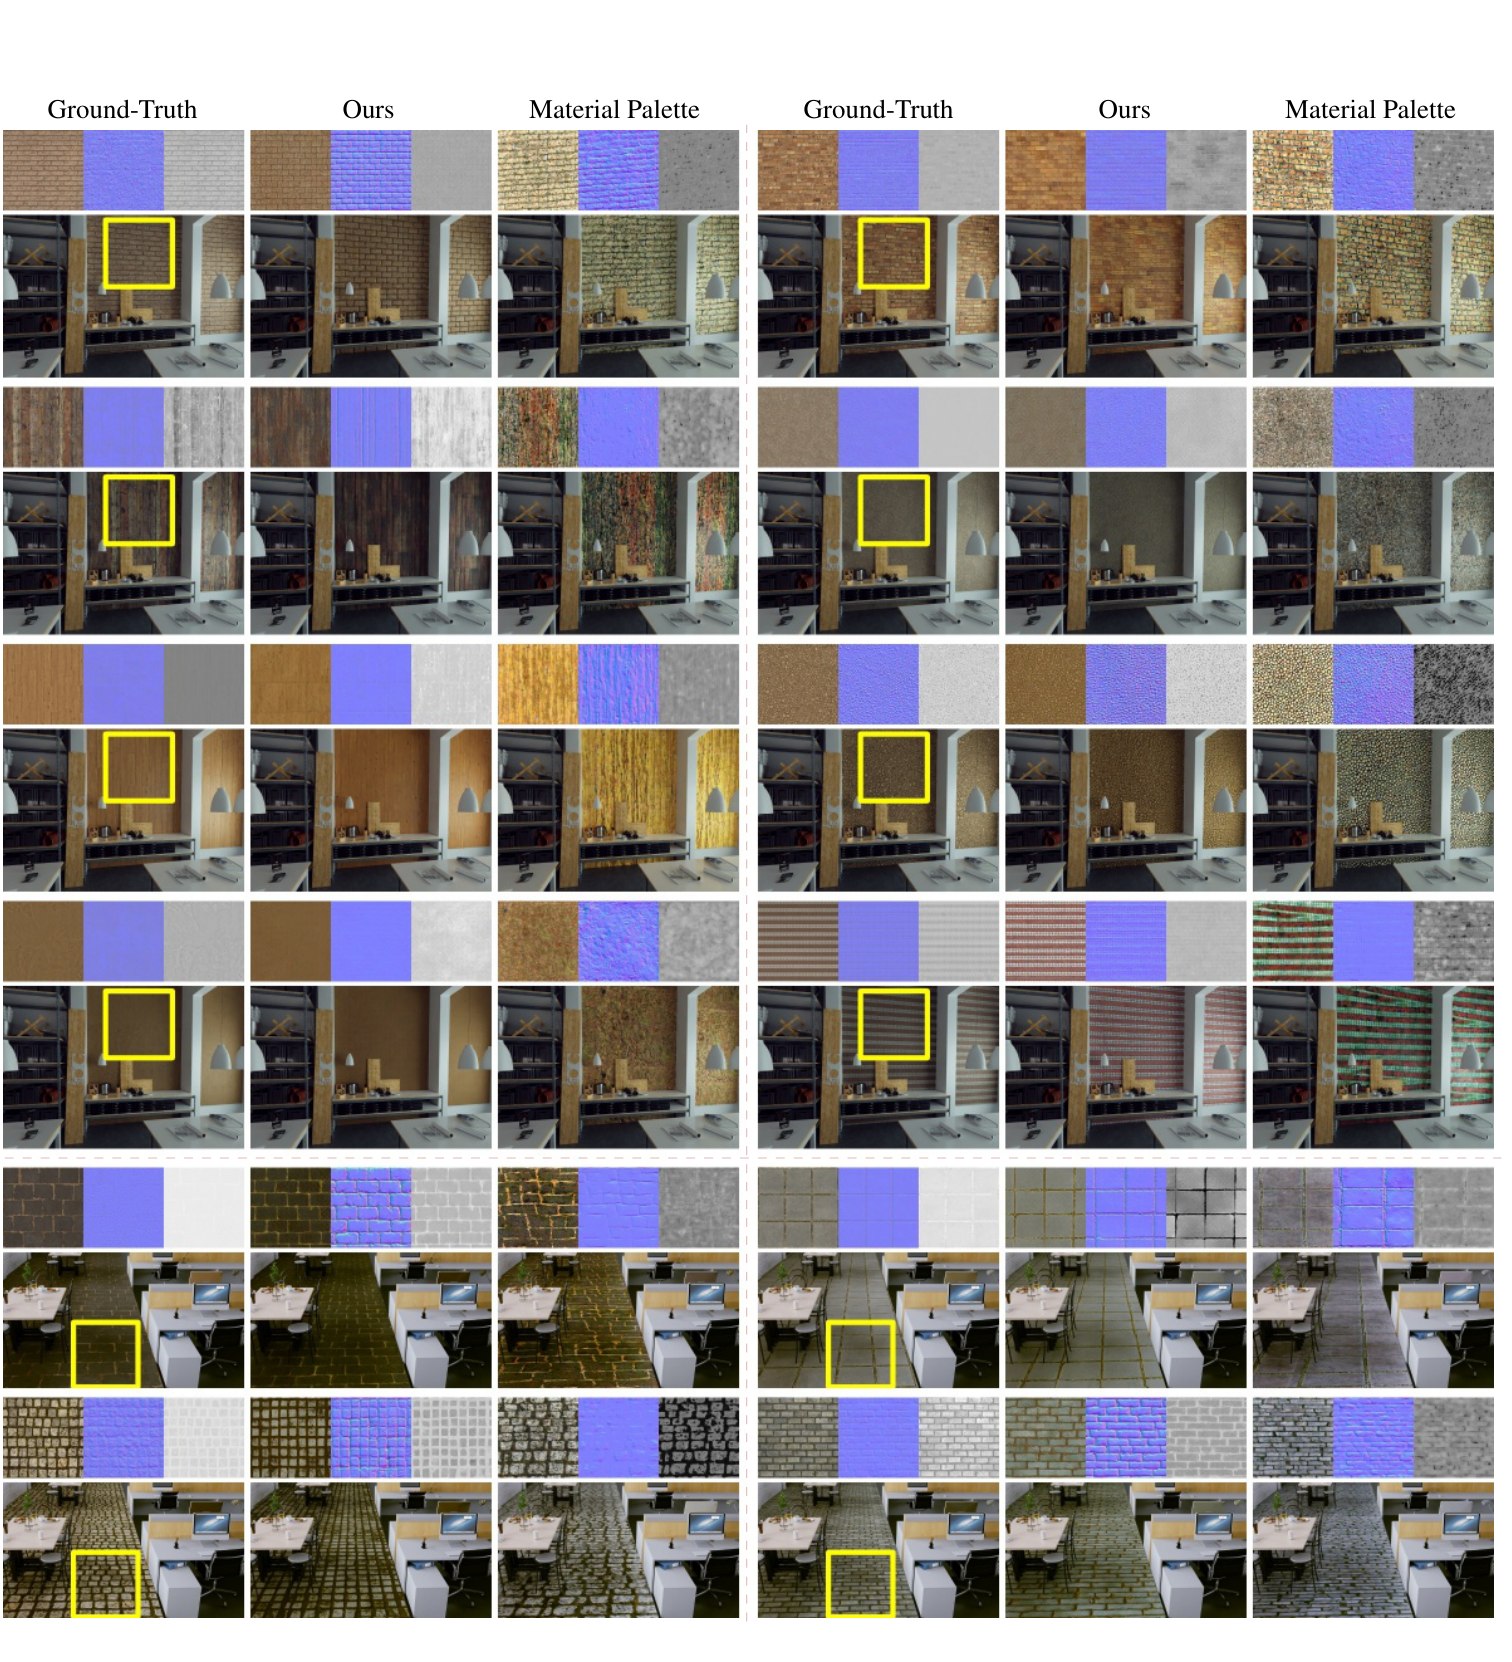
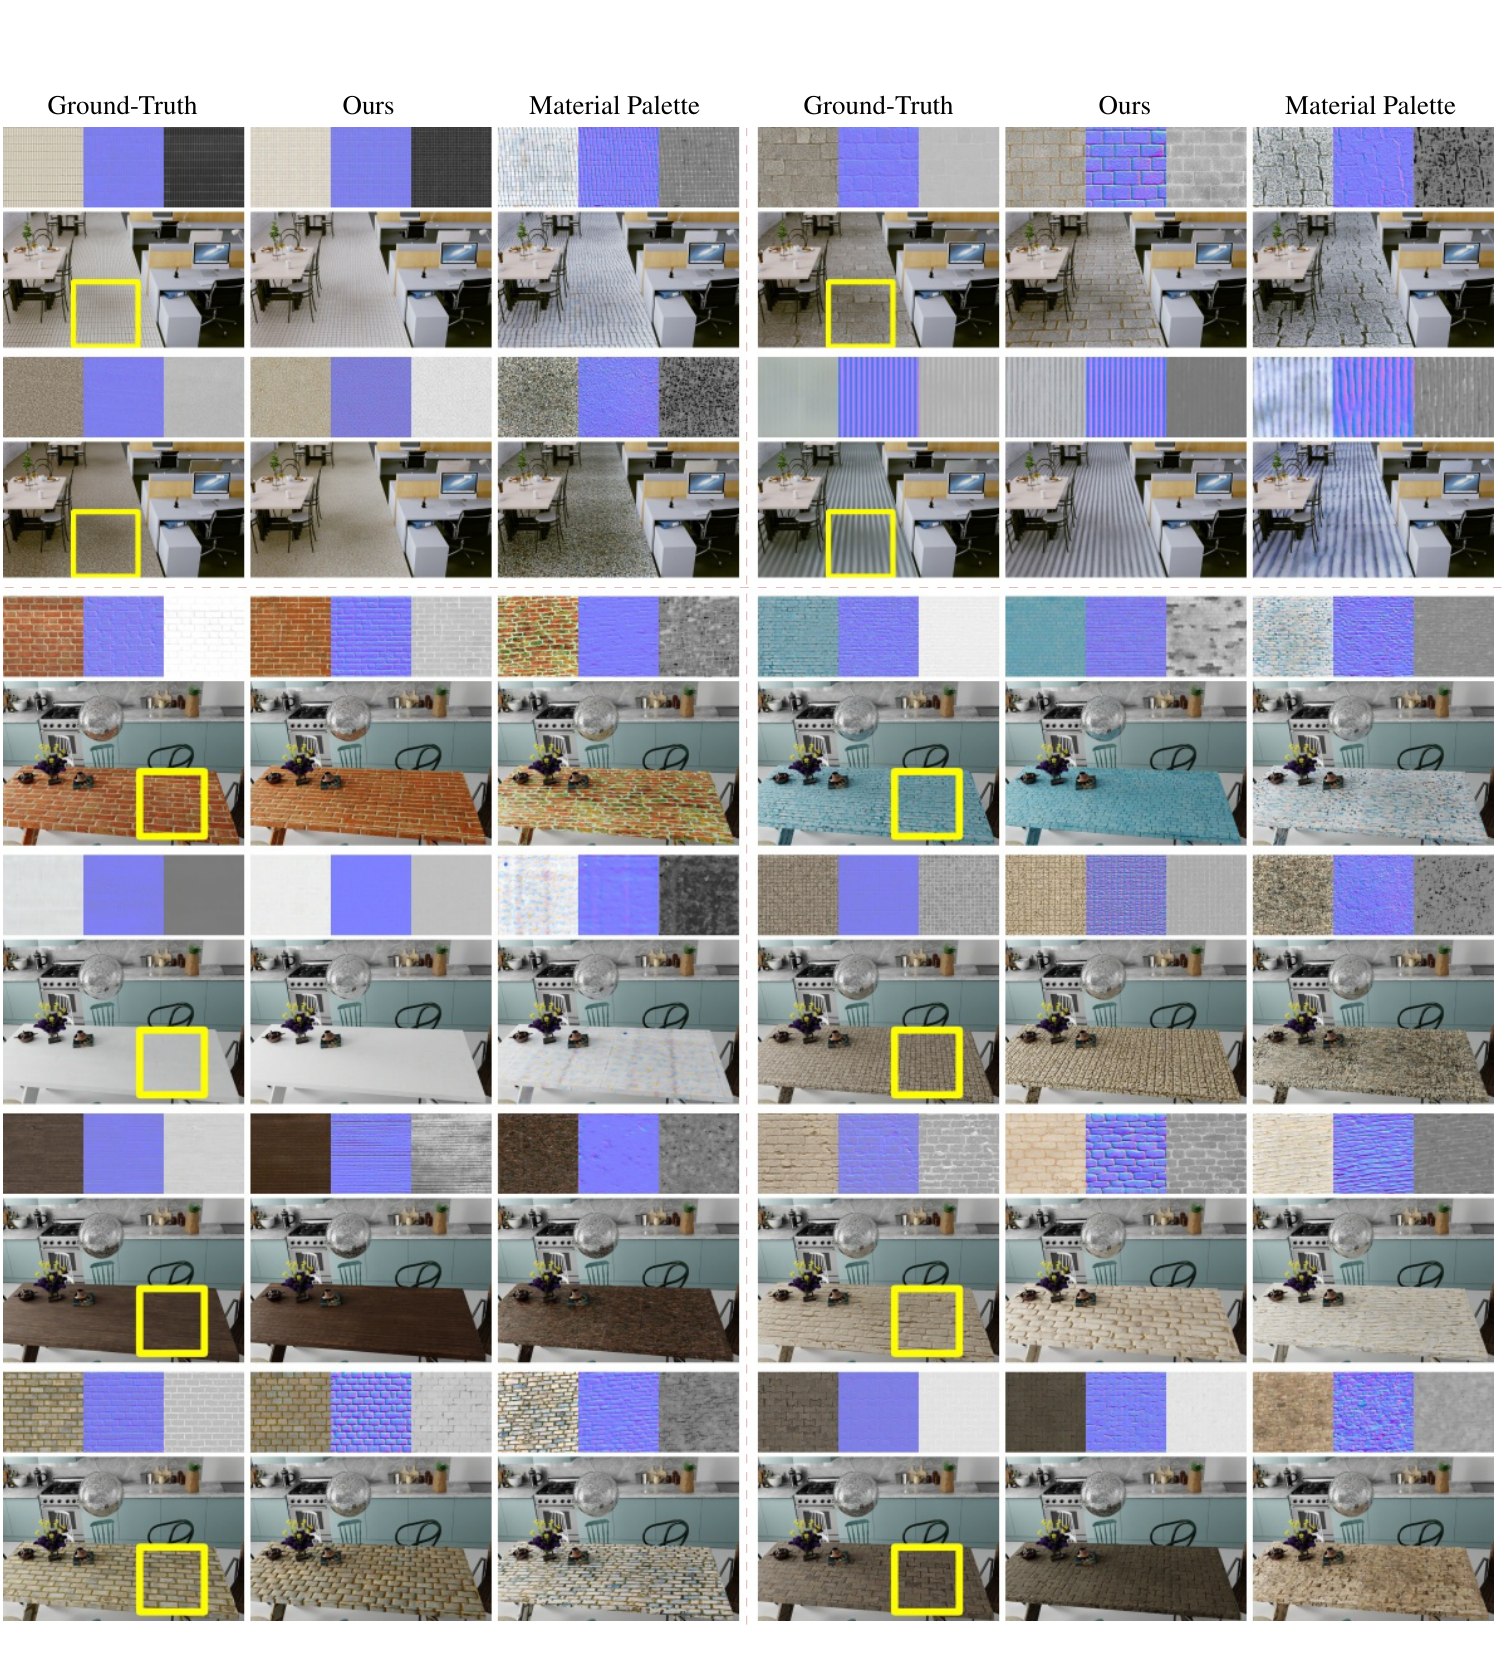
每组列为 ground truth、MaterialPicker、Material Palette;上方材质图与下方场景重渲染相互对应。应观察规则结构、材质尺度和反射外观,同时留意低频误差和图案变化。更多成功图不能取代完整测试集的误差分布。
展开原 Figure 17–22:完整真实照片扩展图集
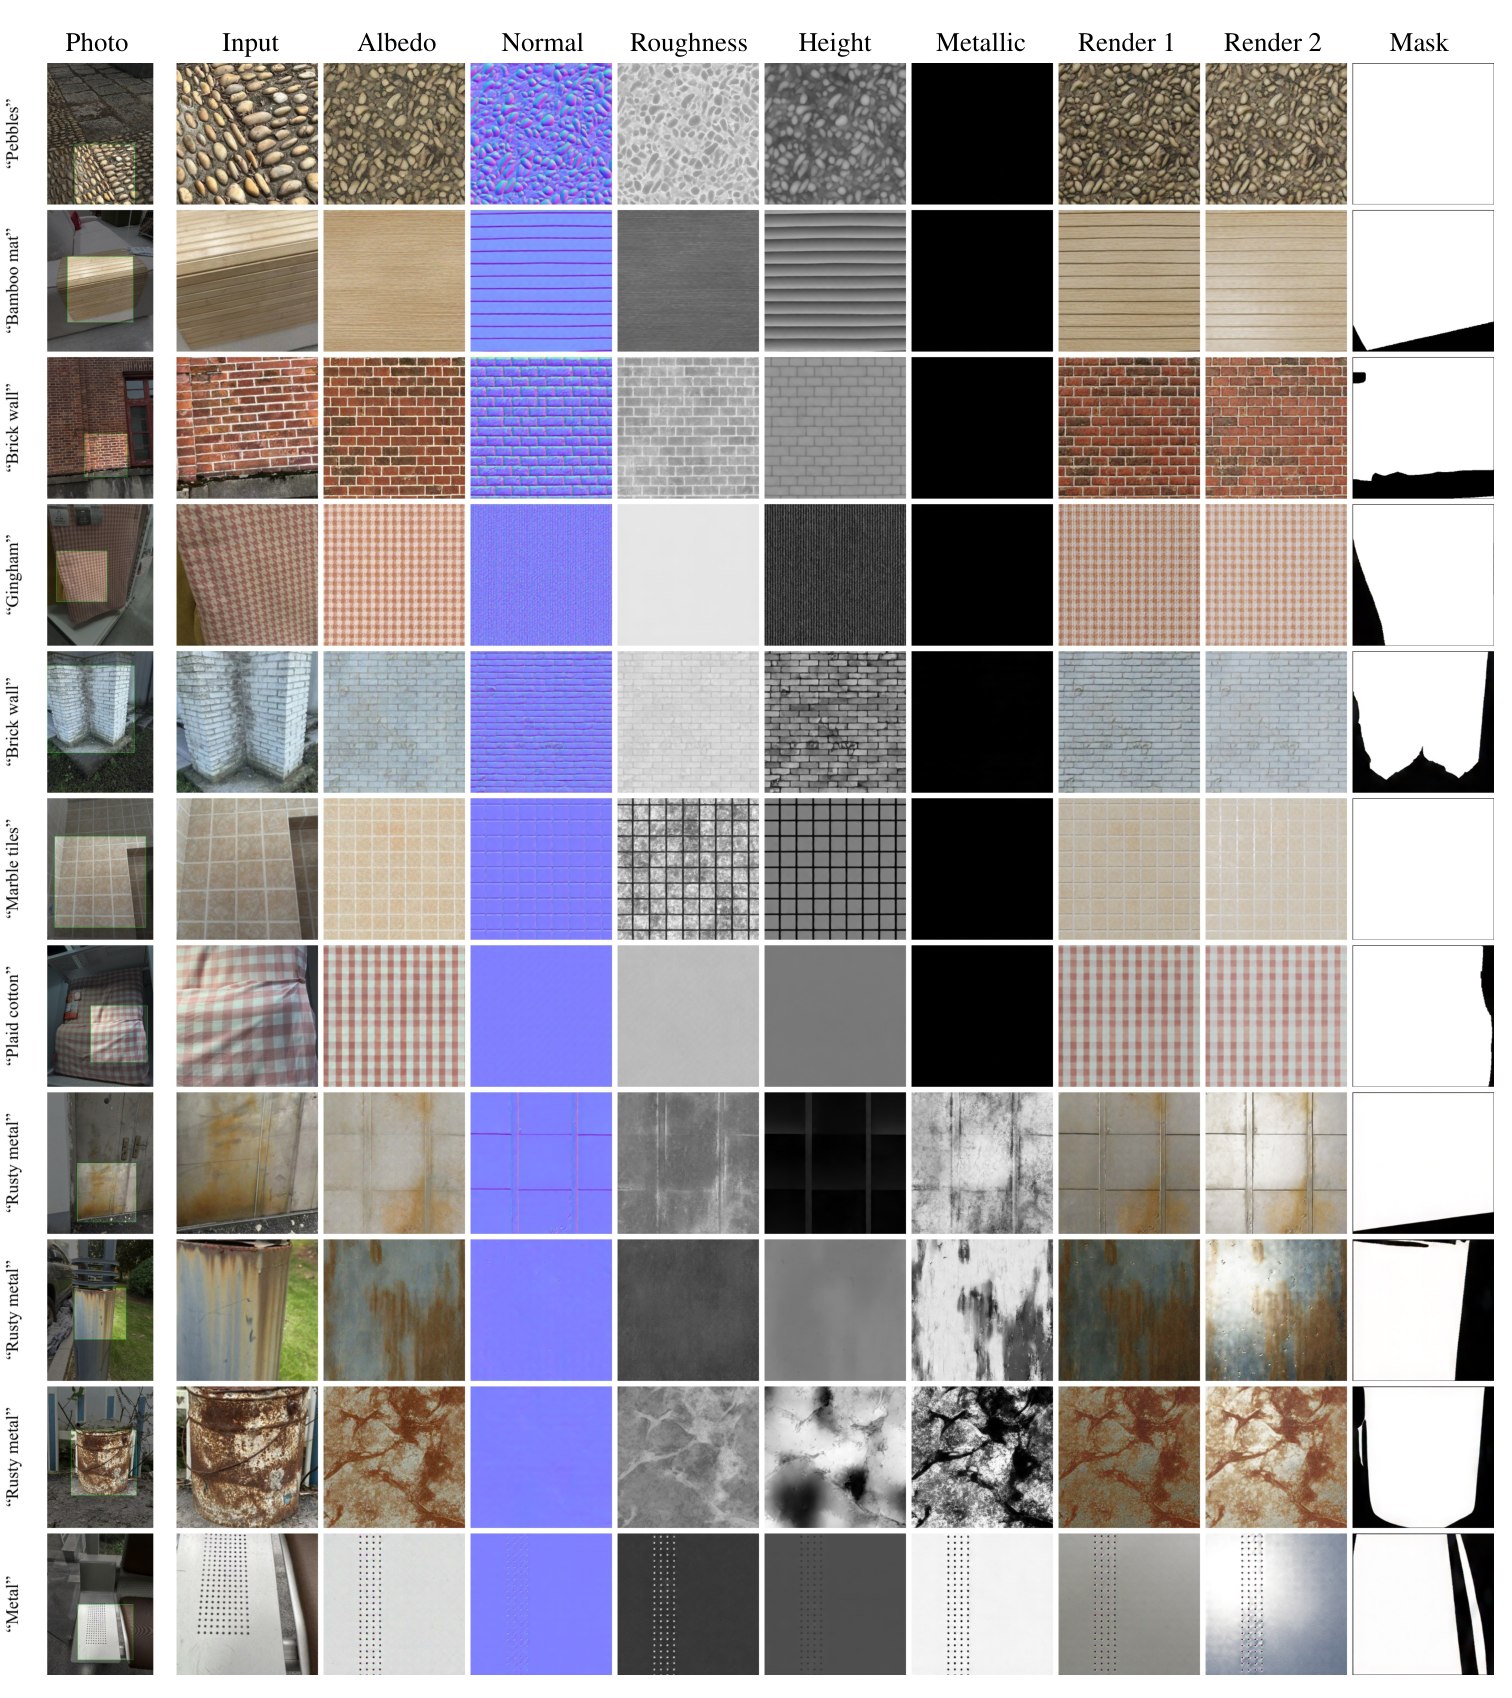
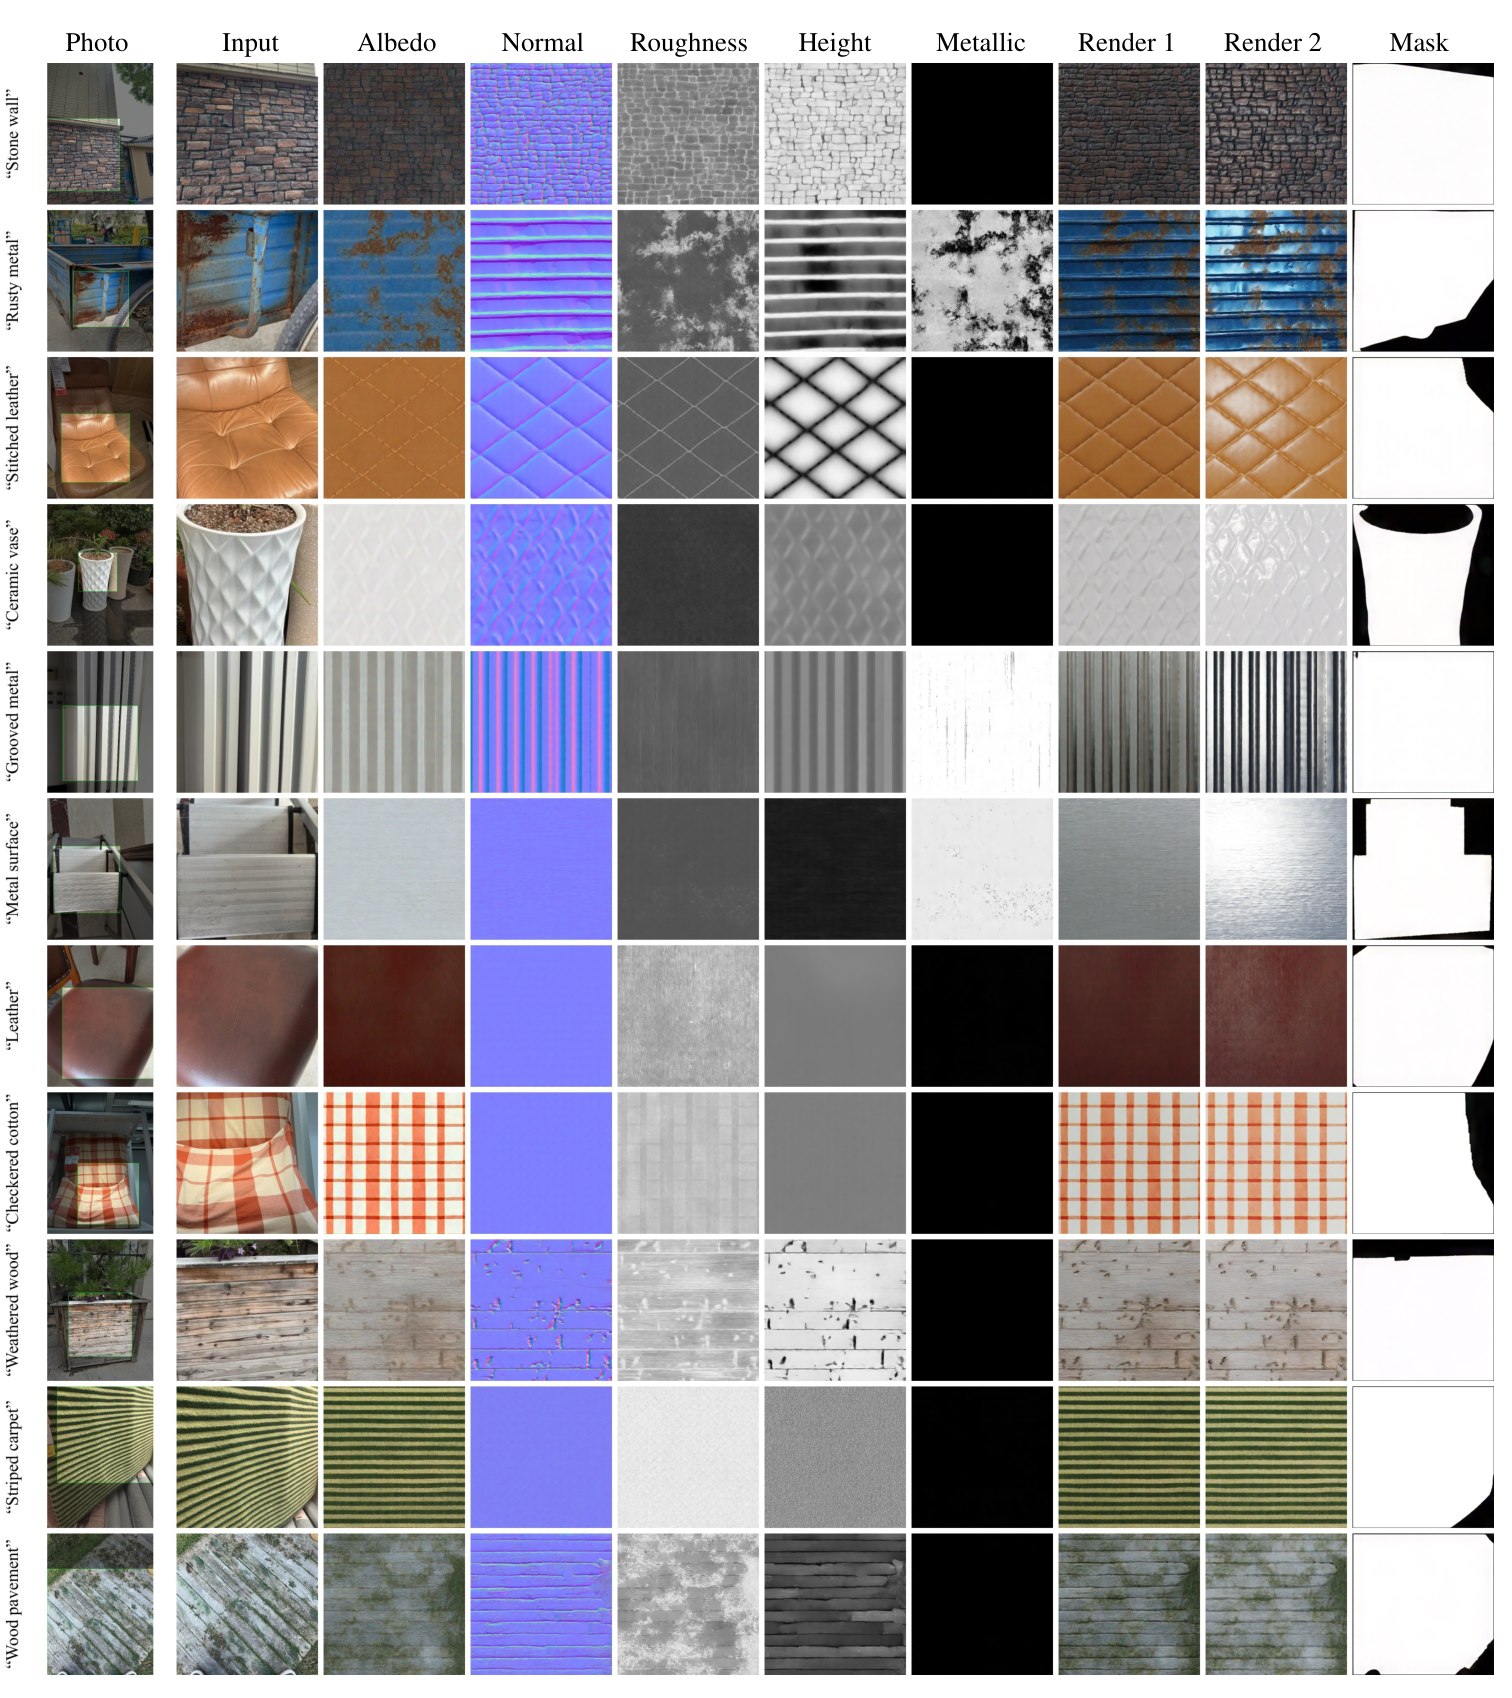
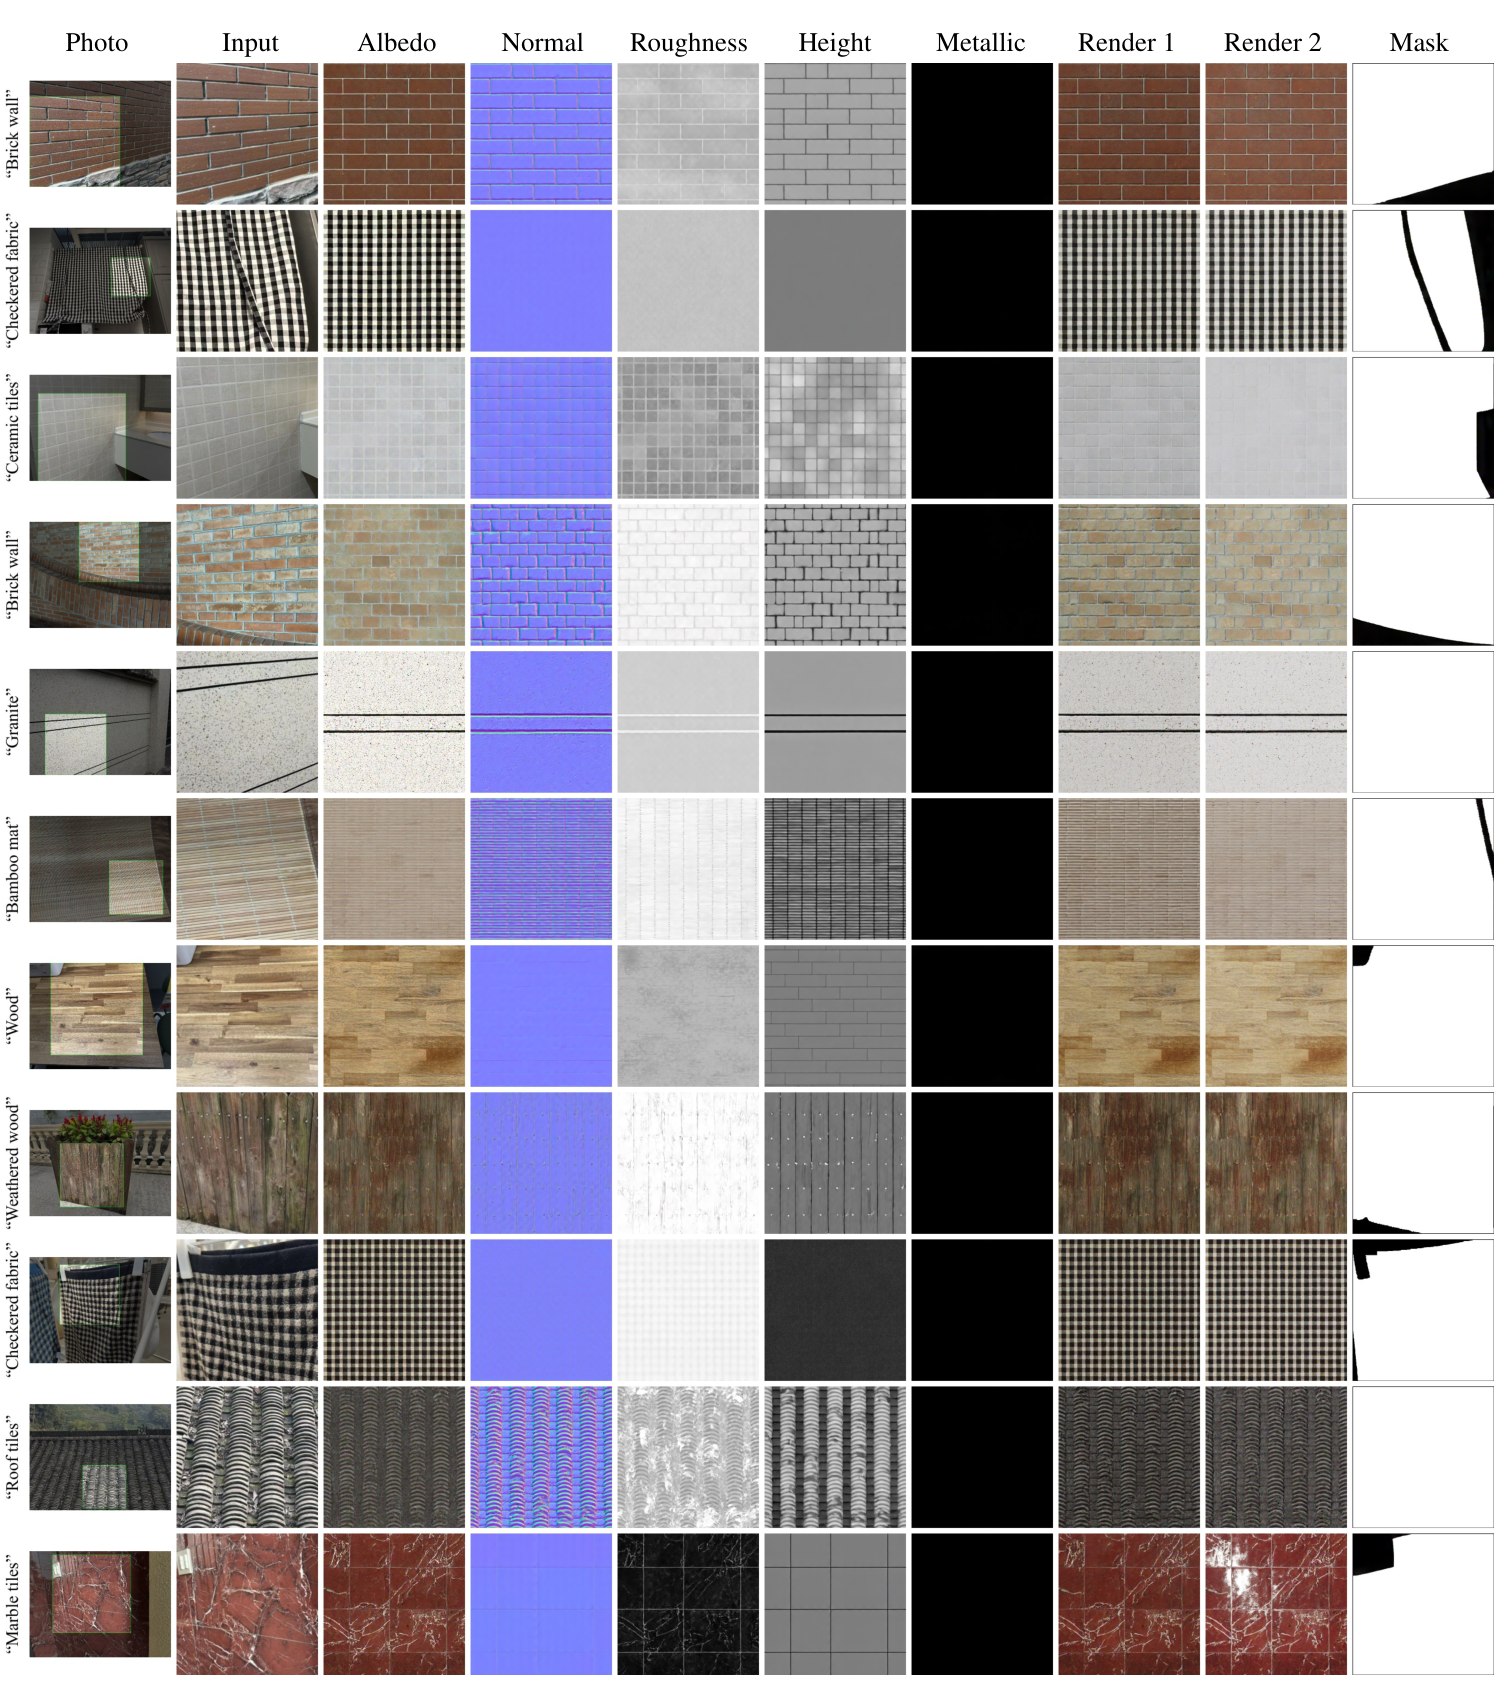
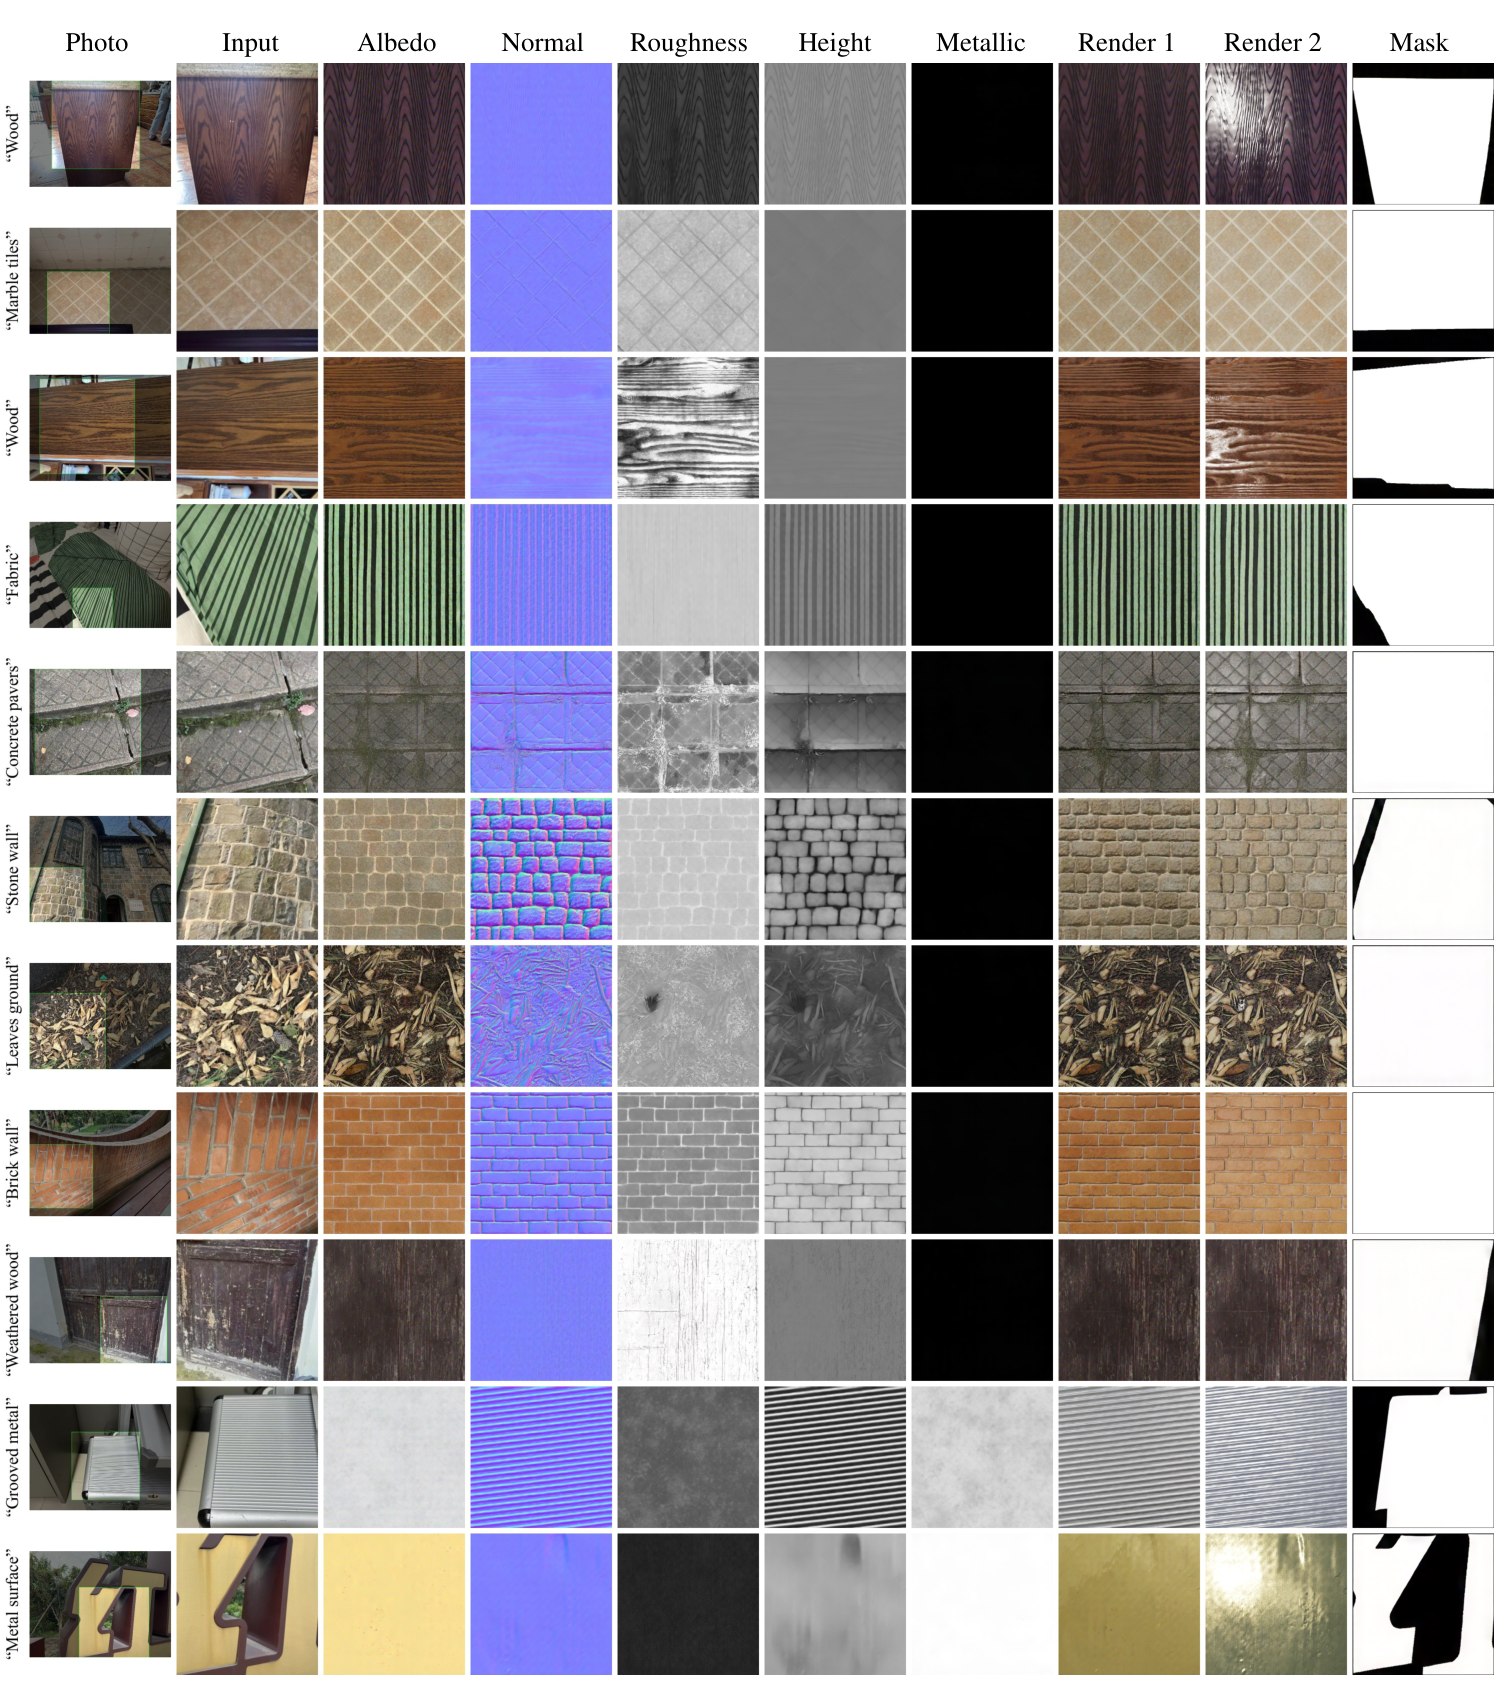
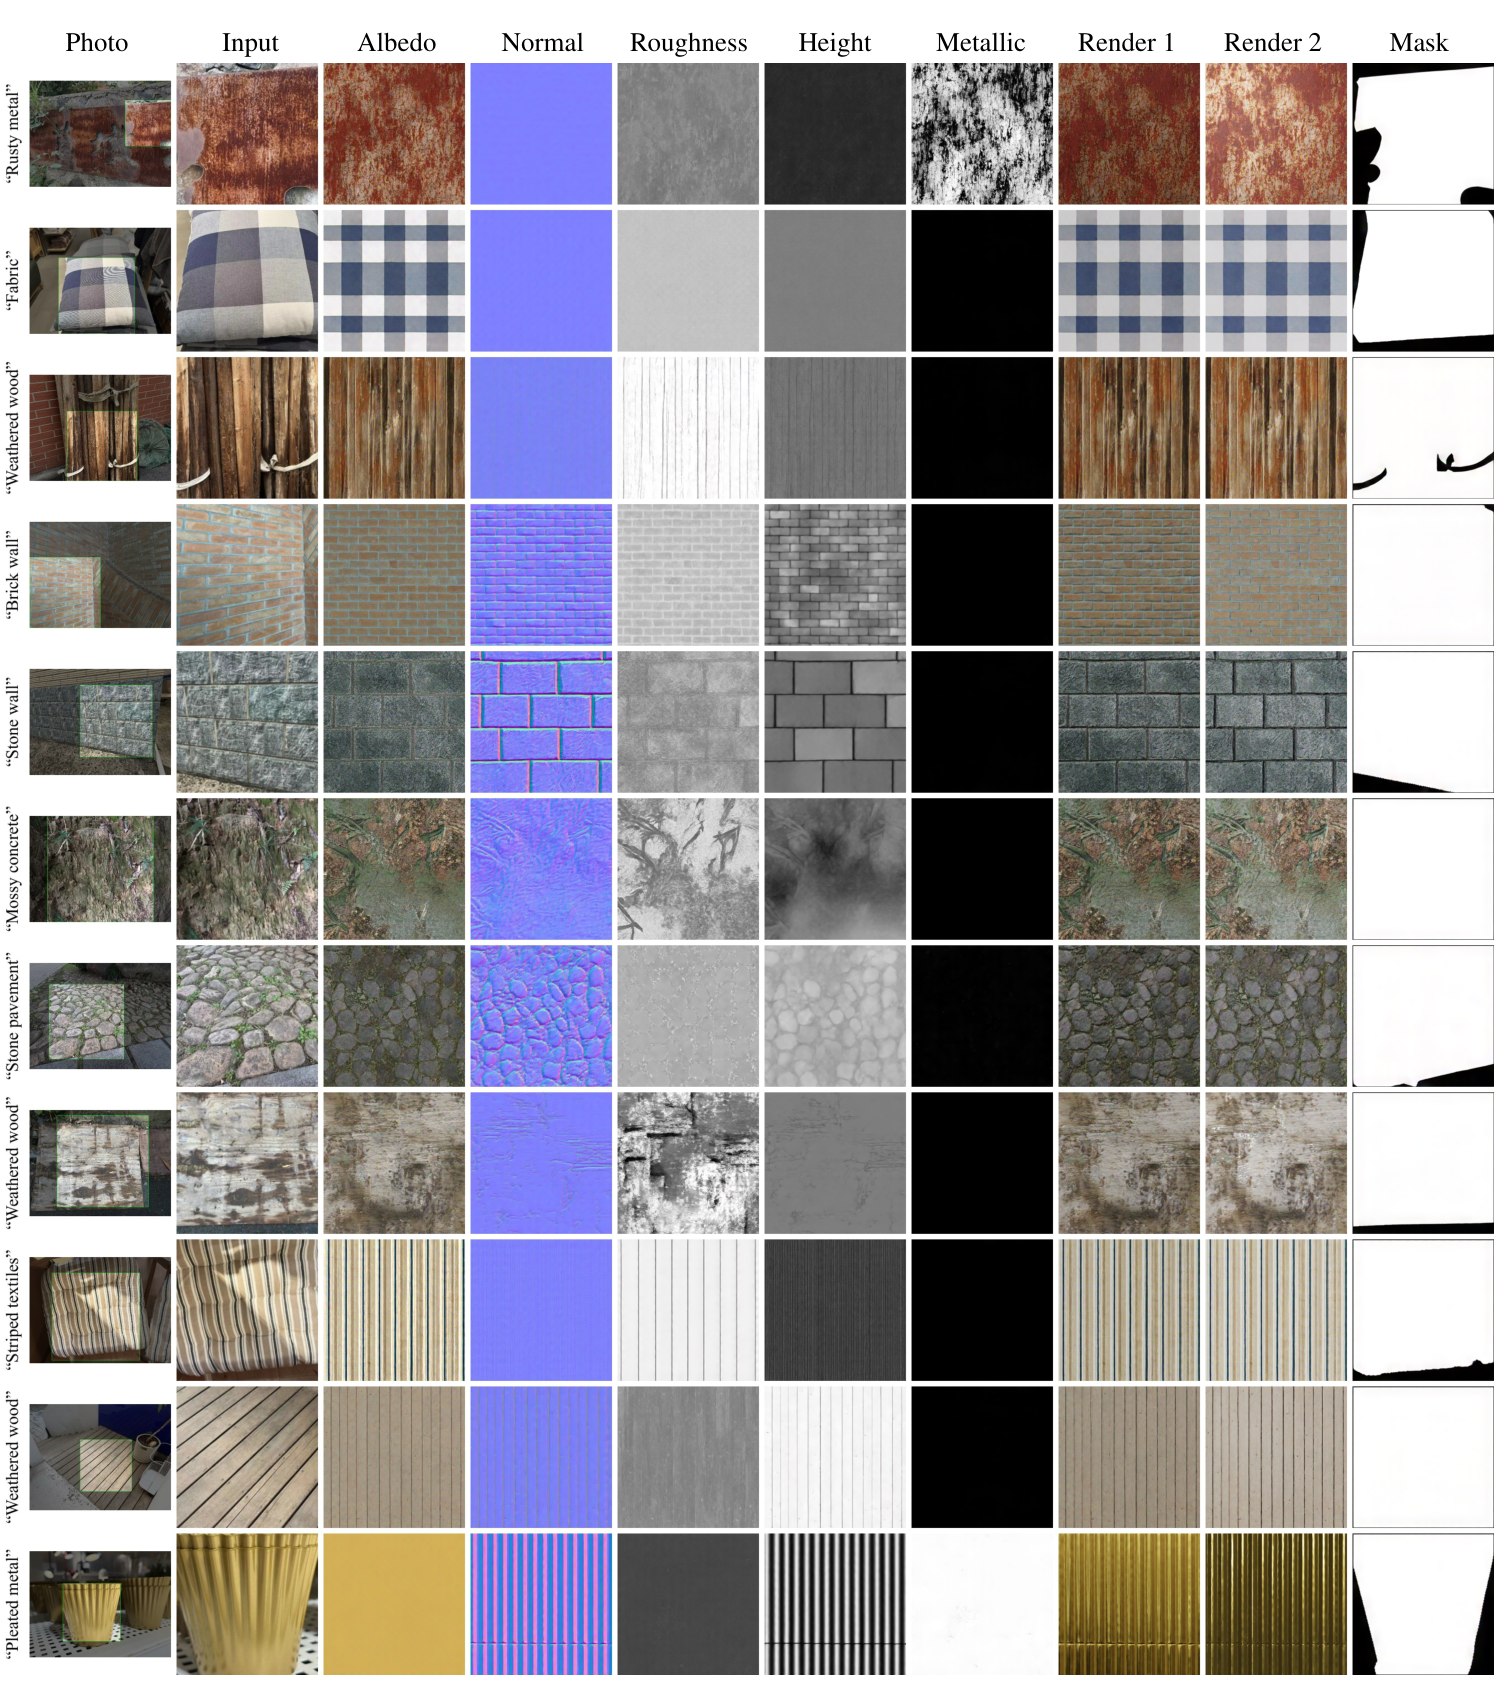
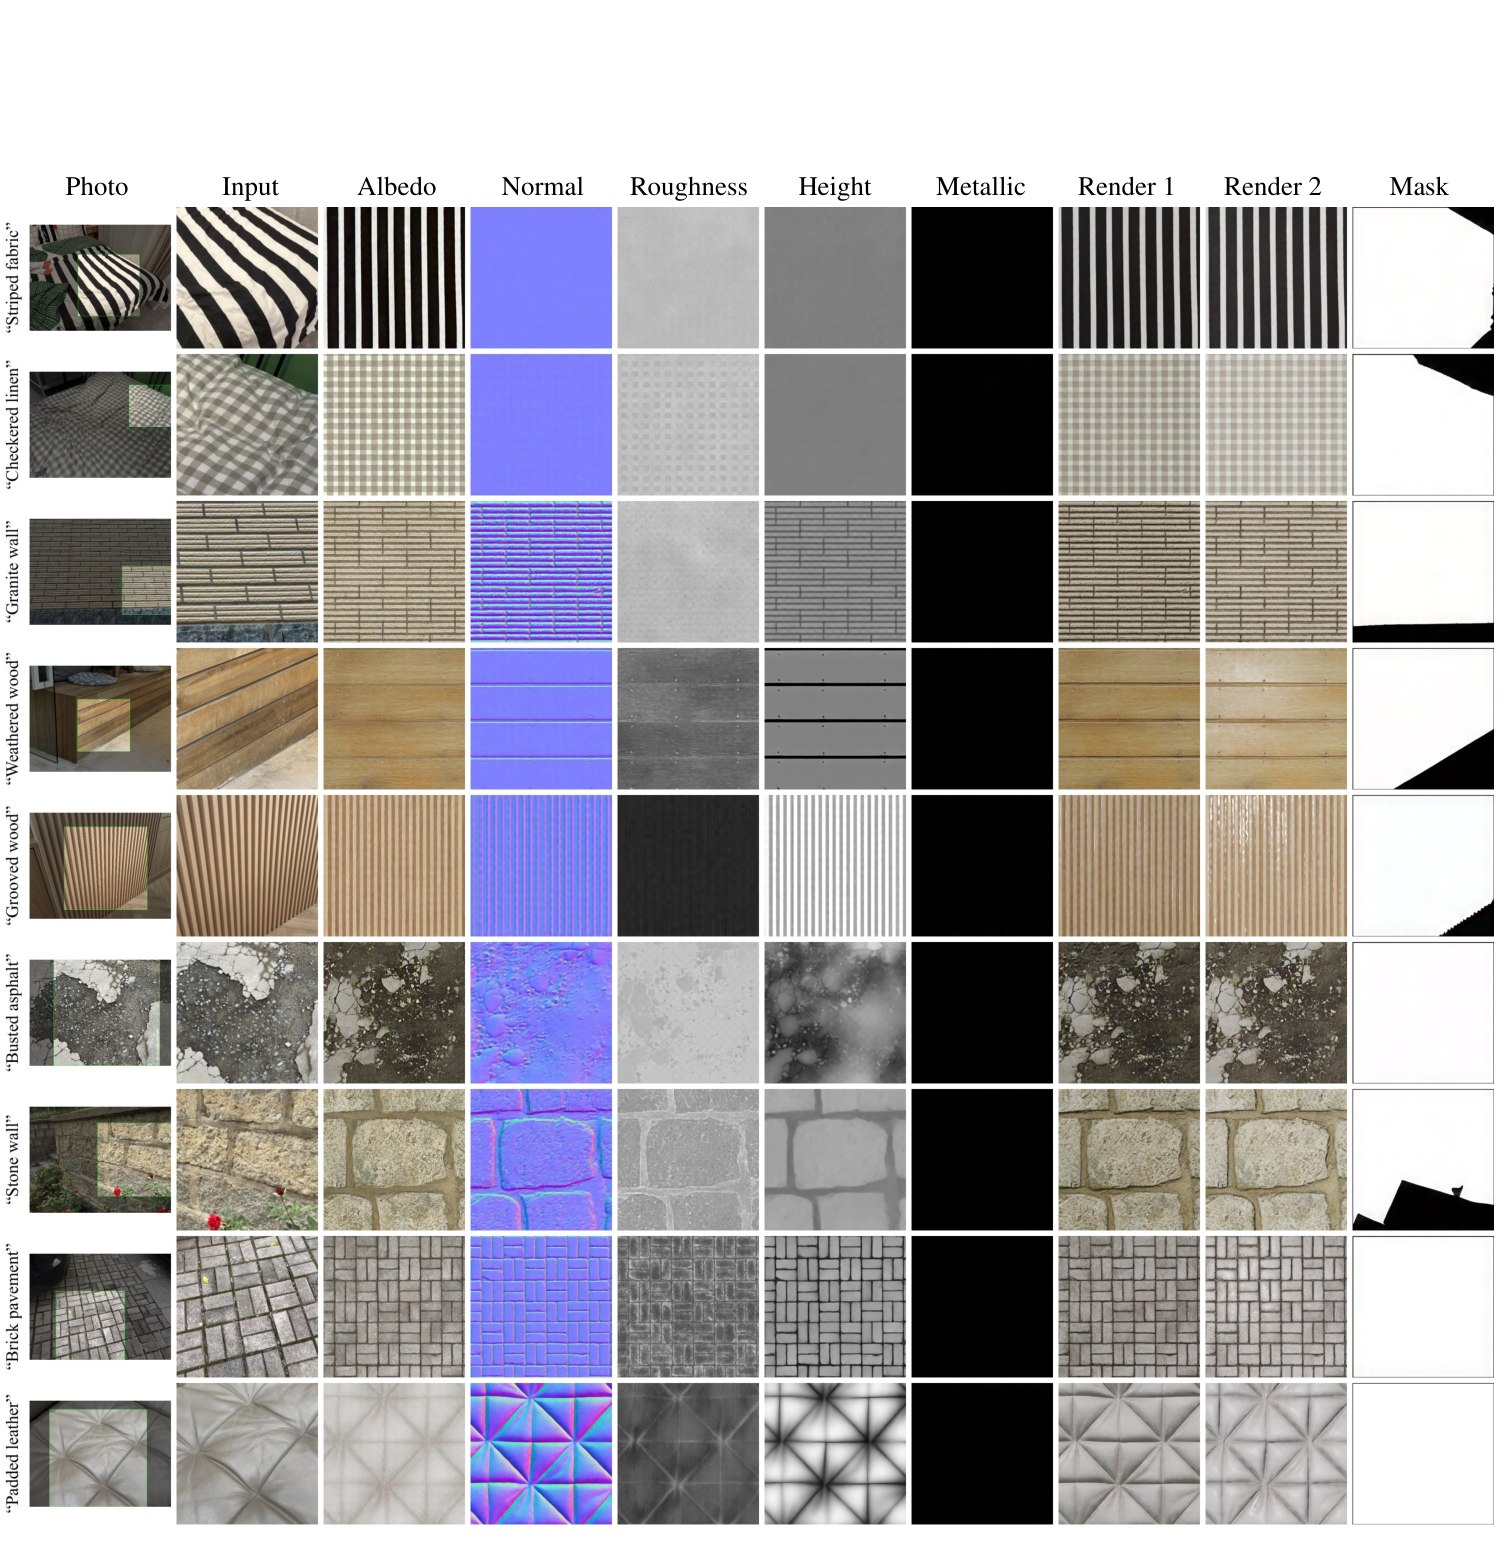
各图包含完整照片、输入 crop、五张材质图、两个环境光 render 和输出 mask。这个排列很重要:完整照片不是直接输入,真正输入是第二列裁剪;双照明显示重光照能力,但仍没有真实材质参数作为 ground truth。
来源:Supplement A.1–A.3、B,PDF 第 11–20 页。本页面收录全部 22 幅原图;折叠仅控制页面长度,不省略补充材料。
14 · Limitations 与严格 reviewer 视角
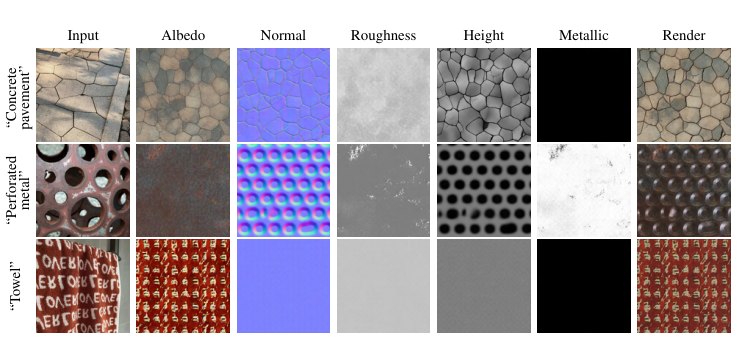
论文明确承认的失败
- 阴影与 albedo 混淆:复杂照明可能被当作固定纹理;反映单图反演的歧义没有被完全消除。
- 孔洞/穿孔材质:模型没有 opacity map,不能正确表示真实开孔;平面颜色和凹凸不能代替几何可见性。
- 语义图案:文字等必须精确保真的结构难以保留。局部统计合理不代表字符可读或标识正确。
Strengths
- 表示简洁:用视频帧承载不同材质通道,绕开固定 RGB 输出接口,统一文字、照片和 mask 生成。
- 数据方案正面面对场景域照片:随机几何与光照、占比筛选、UV 尺度对应比纯平面材质渲染更贴近任务。
- 流程效率实用:无需逐图 LoRA 拟合或外部分割,在已测试硬件上明显减少等待时间。
- 主表不仅给外观 feature score,还给重渲染与 FID;附录补充置信区间,并坦率展示失败。
Weaknesses 与需要补的实验
- 可复现性:基础模型、权重、网络大小、训练/推理配置与源代码不可核实,阻碍独立验证与算力公平比较。
- 关键归因不完整:缺少等容量架构对照与预训练消融,不能单凭系统效果把因果归到 DiT 的无卷积 bias。
- 物理准确性有限:height 与 metallic 未纳入关键定量表;normal-height 一致性、能量/参数边界、跨光照误差未系统报告。
- 泛化证据偏定性:真实照片总量和选择准则不清楚,尚需完整测试集、失败分类和无选择 bias 的评价。
- 后处理隐藏风险:每图独立上采样可能改变跨通道边缘对齐或法线长度;v2 未给相关一致性消融。
- 训练分布边界:70% 主导材质规则可能降低混合材质、细小目标、严重遮挡输入的稳定性。
- 编辑性与分辨率:生成的 raster maps 没有程序图的语义参数、可无限重采样或拓扑编辑能力。512² 是 upsampled,不是原生高分辨率生成能力。
综合判断:它是很有价值的“自然图像 → 材质候选”系统方案,主定量结果支持相对于 Material Palette 的大部分外观指标和效率改善;其最强贡献是输入灵活性与通道表示。关于物理参数识别、基础模型先验的独立作用和完整开放复现,证据仍有明确缺口。
来源:正文 §5 与前述逐项证据;reviewer 评价为本文解读,不是作者原文结论。
15 · 面向 Procedural Material Generation 的研究延伸
以下均为 Research Extension,未被 MaterialPicker v2 实现或验证。最有价值的联系是把它当作不依赖输入几何对齐的“外观规范化前端”,再将规范化材质转换为可执行程序,而非宣称它已经解决 procedural graph generation。
方向 A:先生成多通道外观目标,再反求材质图
\[(I,c)\rightarrow \widehat{M}\rightarrow (G,\theta)\rightarrow\mathcal{R}(G,\theta;\ell,v).\]
\(G=(\mathcal{V},\mathcal{E})\) 是节点与连边,θ 是连续参数,\(\mathcal{R}\) 是 renderer,ℓ/v 表示光照和视角。第一步利用 MaterialPicker 去除相机/光照扰动;第二步在图库检索或程序生成后执行,最后比较多通道及多光照渲染。这是显式的新 pipeline,不属于原论文。
\[\min_{G,\theta}\;\lambda_m d_{\mathrm{maps}}(F(G,\theta),\widehat{M})+\lambda_r\mathbb{E}_{\ell,v}\,d_{\mathrm{render}}(\mathcal{R}(G,\theta;\ell,v),\mathcal{R}(\widehat{M};\ell,v))+\lambda_c C(G),\quad G\in\mathcal{G}_{\mathrm{valid}}.\]
\(F\) 执行 graph 得到 maps,\(C(G)\) 惩罚过度复杂程序,合法集合约束端口类型、DAG 和节点支持。不能只最小化 albedo CLIP,否则图可能视觉相近却反射错误。也不能把 \(\widehat{M}\) 当绝对真值:它会幻觉。可用多种候选材质/多光照一致性来降低错误传播。
方向 B:跨通道物理约束,而非只靠注意力共享
\[\mathcal{L}_{\mathrm{NH}}=\mathbb{E}_{u,v}\left[1-\left\langle N(u,v),\frac{(-\partial_u H,-\partial_v H,1)}{\|(-\partial_u H,-\partial_v H,1)\|_2}\right\rangle\right].\]
这是特定平面/坐标与尺度约定下的研究损失示例。真实 PBR 的 normal 可包含 height 无法表达的频段,不能机械地把不一致全判为错误。需要分频或容差约束,并记录 tangent-space convention 与 height scale。消融应比较仅噪声损失、加跨通道约束、加 rendering loss,评估真实重光照收益而非只看单图 feature score。
方向 C:把 mask 从便利输出变成置信度与交互接口
针对 70% 阈值带来的分布局限,可以增加多材质区域条件或用户点选,让模型知道要选择哪个材质;输出区域置信度及多候选贴图。测试中按目标面积占比、遮挡比例、材质相似度分层报告成功率,防止多样性增加却目标选择变差。
方向 D:视频帧表示与 graph preview 对齐
可将最终 maps、局部 node previews 与渲染帧放到结构化条件中,帮助程序生成器知道“在哪个通道、哪个尺度出现错误”。但连续视频 token 不直接表达离散图合法性,需要独立 graph compiler、端口检查和 execution-aware repair。添加一帧预览并不会自动产生可执行 shader。
| 最小可验证实验 | 关键对照 | 必须记录的指标 |
|---|---|---|
| 图生成前端规范化 | 直接照片 → graph;rectified albedo → graph;五图 → graph | 执行成功率、重光照误差、拓扑规模、可编辑性、端到端时间 |
| 多通道一致性 | 独立图生成;联合帧;联合帧 + 物理约束 | 边缘配准、normal-height residual、跨光照误差、细节保真 |
| 非主导/多目标 | 单主导裁剪;带选点/区域条件;多候选 | 区域分割 IoU、目标一致率、失败率随面积占比的曲线 |
| 测试时搜索 | 一次采样;多候选筛选;renderer-in-loop 参数优化 | 质量-时间 Pareto、不同随机种子波动、graph 复杂度 |
首选研究切入点:把生成式五图当作不确定中间表示,为程序材质搜索提供多通道、多照明约束。这与用户关注的 PMG 直接关联,同时承认其输出并非 ground truth,也保留 procedural representation 的可编辑性优势。
16 · 复现与归档清单
拿到实现后应优先核查的项目
- 基础 DiT、VAE、文本编码器的 exact checkpoint、许可证、参数量、冻结范围与预训练数据边界。
- 输入/输出帧排列、单通道图的 RGB 编码、normal convention、height scale、颜色空间与 mask 所处坐标系。
- 时间压缩下干净条件帧如何保留;noise scheduler、训练 timestep 分布、条件 dropout 与 CFG 组合。
- Scenes 脚本的主导占比、UV texture scale、遮挡关系;训练/测试 assets 是否发生重复。
- 采样步骤、随机种子、50 步的 solver、12 秒计时范围;waifu2x 配置及上采样后的物理修正。
- 表 1/表 2 的特征模型、输入预处理、FID 分组、置信区间计算、mask 使用与渲染设置。
- 是否存在未公开的 filtering、固定 prompt、hard-coded channel、样本挑选或失败回退;目前没有代码证据,不能宣称发现了这些实现问题。
Paper vs. Implementation 的诚实状态
当前能完成的是“Paper vs. Reproduction Requirements”核查:正文与附录给出了损失、数据规模、优化器、训练资源、采样步数和主要结果;没有找到经官方链接确认的实现供运行。不能伪造训练命令、假装跑通代码、声称复现表格,或用同名 UI 色彩选择器 GitHub 仓库冒充本论文代码。
本次交付与验收状态
交付为单文件中文 HTML、详细新增 Markdown、原笔记字节前缀完全保留的合并候选、固定 PDF 与来源/静态 QA 记录。全部留在隔离云端产物目录;没有写入用户 Obsidian vault、没有替换原笔记、没有发布网站。单 HTML 严格小于 20,000,000 字节,图片与 MathJax 主脚本内嵌;浏览器实际 MathJax、导航、图片与 1440/760/390 宽度验收按当前安排留待本地下载后进行,静态通过不冒充浏览器通过。
17 · Sources 与阅读路线
- Ma et al.,MaterialPicker 固定 v2 PDF:完整正文与 Supplement,是算法、数字与原图的主来源。
- 固定 v2 arXiv HTML:用于结构/公式/图表交叉核对;不能替换原 PDF 图像证据。
- arXiv v2 版本元数据:v2 为 2024-12-06,后续 v3 为 2025-07-26。
- 作者官方项目页:确认团队与后续工作身份;本次访问未找到其链接的模型代码与权重。
- Xiaohe Ma 官方主页与ACM DOI:核实正式发表的标题、SIGGRAPH 2025 / TOG 信息。
建议复读路线:先看 §3.2 数据和 §3.3 7 帧表示,再读 Table 1 与 Supplement Table 2,最后对照 Figure 10 失败与 Figure 11 mask 消融。这样可以把“系统表现好”“某设计有定性支持”“某机制尚未独立证明”三类结论分开。
核查日期:2026-09-30。原图版权归论文作者;仅作论文精读中的引用与说明。Figure 1 使用场景的原论文许可说明见 PDF 第 1 页,不将其场景资产另行分发或宣称可商业使用。