节点类型与深度 → 每节点的异构参数 → 指向输入/输出槽位的边。
01 · 用序列模型生成一张可执行的材质图
MatFormer: A Generative Model for Procedural Materials 将材质程序拆成节点、逐节点参数、连接三个生成阶段。它生成新的图结构,而非只从图库挑一张固定图调参数;同时,输出始终来自已有节点词表和有长度上限的程序空间,不是无限规模、任意shader语言的程序合成器。
Substance Source筛选后的程序资产;每图参数扰动100次,约28万增强样本不等于28万独立拓扑。
最佳后向BFS序列相对Pairwise基线86.9更好,但专业用户平均可用性仅1.82/5。
核心认识:图生成不仅需要知道“下一个节点是什么”,还要知道一个标量属于哪种参数、该连接哪个输入口、某条边是否会造成环。Transformer负责统计规律,显式序列编码与合法性mask承担大量程序结构约束。

原图1 · Guerrero et al., 2022。场景制作从200个生成图中挑出21个材质,属于人选资产后的应用展示,不能当成无筛选平均输出质量。
02 · 版本、发表身份与原笔记校正
| 字段 | 本次核实 |
|---|---|
| 作者 | Paul Guerrero、Miloš Hašan、Kalyan Sunkavalli、Radomír Měch、Tamy Boubekeur、Niloy J. Mitra |
| 发表 | ACM Transactions on Graphics 41(4),Article 46,2022年7月,SIGGRAPH 2022;DOI 10.1145/3528223.3530173 |
| 读取版本 | 用户提供的12页作者版本PDF,含第12页Appendix A–D,SHA-256固定。未用哈希不同的公共arXiv文件替代它。 |
| arXiv | 2207.01044,当前条目为v2(2022-08-15);用户原件与该文件的字节一致性未成立,因此不把原件冒称为v2。 |
| 作者机构 | 第一作者Adobe Research;末位作者同时列Adobe Research和UCL。未见明确通讯作者标记,Niloy J. Mitra仅保留为末位候选、unverified。 |
| 技术类别 | 自回归Transformer、程序化图生成;不是扩散模型,不使用LLM提示词,也不是强化学习训练。 |
原文保留,新增说明优先用于后续阅读
- 原笔记venue写“arXiv preprint”,但原件与作者主页均明确正式发表信息;DOI可在日后授权归档时补入,不在本次偷偷改写原YAML。
- 参数和边不是前后条件耦合。正文§4.1.4明确二者在当前方法中完全独立:它们都依赖节点信息,边生成没有把已预测参数作为条件。原笔记“基于节点和参数生成边”应据此校正。
- “任意数量”指可采样很多材质,并非无限图长。模型最多400节点、700边、800槽位,每节点参数序列最多512个标量值,均不计起止token。
- 无条件生成不等于图像条件捕获。2022版本不支持直接按目标图像生成;后续CondMatFormer和RL工作扩展了能力,不能反向归给本论文。
- 已有正文中的“diffusion models”主题不反映方法。本次只在新增部分指出,原笔记与图片链接保持原字节不变。
03 · 研究问题:为什么现成图生成模型不够
程序材质的优势是紧凑、可编辑、可铺贴和按分辨率求值,但设计一张50多个节点的有效图仍需要专业知识。图中的节点是不同函数,不像图像网格一样每格同构:噪声节点没有输入,blend需要多个图像,颜色参数是向量,有些渐变参数是变长向量数组;节点之间还可能有长距离依赖。
直接把“所有节点+所有参数+所有边”塞进一个序列,会让注意力长度和二次开销迅速增长。简单局部连接统计又难以理解长操作链的最终作用。MatFormer的解决方式不是一个通用大语言模型,而是三个专门的小Transformer生成器,配合节点上下文编码器与slot编码器。
研究假设:给定整张图将出现哪些节点及其深度,已经有足够线索分别决定合理参数和连接。这个分解使建模更轻,但忽略了“具体参数如何依赖实际邻接关系”的联合性,论文将进一步耦合列为未来工作。
与MATch的角色区别
MATch主要做固定结构内的逆向材质参数优化;MatFormer学习图结构的分布并向前采样。两者可以互补:生成器提出结构,可微执行器再调连续参数。但这条结合路线在本论文是未来设想,不是表1结果实际包含的后处理。
正文§1–3及§5。关于模块分工的归纳为 Our Interpretation;本篇实验不包含图像目标损失反传。
04 · 材质图是一种受类型和依赖约束的程序

正文定义 \(g=(N,E)\) 为有向无环多重图。节点 \(n=(\tau,P)\) 指定算子类型 \(\tau\) 和参数列表 \(P\);一个算子可以有多个输入/输出图像,因此边不能只记录“节点A到节点B”,还需要记录具体slot。两个节点间允许多条边,只要终点是不同输入口。
\[
(I^{\mathrm{out}}_1,I^{\mathrm{out}}_2,\ldots)
=o_k(I^{\mathrm{in}}_1,I^{\mathrm{in}}_2,\ldots\mid P),
\qquad P=(p_1,p_2,\ldots).
\]
这是正文式(1)。输入输出可为灰度/RGB图;参数可为标量、向量、变长向量数组。无图像输入的算子称generator。每个输入口至多一条入边,输出口可连接多个下游口;未连接的输入使用默认值,通常为零图。特殊output节点只标记最终通道,不执行新图像操作。
| 对象 | 例子/功能 | 易混淆点 |
|---|---|---|
| 节点类型 \(\tau\) | 噪声、滤波、混合、变形、复合macro | 词表1207种,不是1207个训练样本 |
| 参数 \(P\) | 强度、颜色、角度、渐变控制点 | 浮点参数被离散化,不是直接输出任意精度实数 |
| 有向边 \(e=(\mathrm{out}_k^i,\mathrm{in}_l^j)\) | 第i节点第k输出到第j节点第l输入 | slot对才确定数据流;节点索引对不充分 |
| material channels | albedo、roughness、metallicity、normal、height等 | 图输出可以多通道,不要照搬MATch固定四通道描述 |
| UI布局 | 节点在Substance画布中的位置 | 论文另用标准图布局工具,模型没有学出易读的画布排版 |
执行只要求拓扑合法,而作者采用的训练序列顺序可以反向于执行方向。不要把后向BFS生成顺序当成实际图像数据流方向;图的求值仍按依赖的拓扑顺序。
05 · 概率分解与训练目标
\[
p(S\mid\theta)=\prod_{i=1}^{|S|}
p(s_i\mid s_{\lt i},\theta).
\]
正文式(2)把任一序列分解成逐token条件分布。起始token \(\alpha\) 启动采样,停止token \(\omega\) 或长度上限结束。每次生成器只看已有前缀;用于conditioning的encoder则读取完整给定节点/槽位序列,产生带全局上下文的局部embedding。
把论文的条件关系压缩写成下面的示意分解,有助于解释独立性;这是本精读重述,而非原文编号公式:
\[
q(N,P,E)\approx q_n(N,d)\,
\left[\prod_{j}q_p(P_j\mid N,d,j)\right]\,
q_e(E\mid N,d).
\]
\(d\) 是节点深度序列的辅助预测,\(P_j\) 是第j节点参数。边模型的条件中没有 \(P\);参数模型也看不到最终边。因此“分三阶段执行”不应被误读为“后三者严格链式使用前面所有产物”。
Teacher forcing 与损失名称的谨慎处理
训练时前缀使用真值token,参数/边模型使用真值节点;各阶段单独训练,编码器与对应生成器联合训练。推理时真值前缀换成自己生成的token,因而存在误差累积与阶段间分布偏移。正文§3.6称目标为binary cross-entropy,同时各处描述多类token分布、边模型使用softmax。缺少原版可核验训练代码时,不能擅自声称其具体loss实现是某种PyTorch函数。
作为一般自回归最大似然的说明,可写 \(\mathcal{L}_{\mathrm{NLL}}=-\sum_i\log p(s_i^{\ast}\mid s_{\lt i}^{\ast})\)。这只是帮助理解监督目标的标准形式,不替代论文对loss名称的原始记载。训练没有GAN判别器、扩散去噪损失、RL奖励或渲染器梯度回传。
合法性掩码不是“模型自己学会所有规则”
\[
\widetilde p_i(v)=
\frac{p_i(v)\,\mathbf{1}[v\in\mathcal{A}_i]}
{\sum_{u\in\mathcal{A}_i}p_i(u)}.
\]
此式是正文§3.2“非法概率置零后重新归一化”的解释,\(\mathcal{A}_i\) 为当前合法选项集合。它提高执行合法性,却不保证视觉真实、通道语义合理或图易于人理解;用户研究中不真实法线和过饱和基础色说明了这一区别。
06 · 第一阶段:节点类型、深度与顺序
节点类型序列 \(S^n=(\alpha,\tau_1,\tau_2,\ldots,\omega)\) 附加全局位置 \(S^{ni}\) 与深度 \(S^{nd}\)。深度不能只由类型列表计算,所以模型同时预测下一节点类型与深度;它还没有实际边可用于直接计算深度。
\[
(p_i^n,p_i^{nd})=
f^n(s_{\lt i}^{n},s_{\lt i}^{nd},s_{\lt i}^{ni}).
\]
这是正文式(3)。后向顺序的深度是距最近output的图距离;其他顺序是距最近generator的距离。深度提供“靠近源头还是输出”的结构提示,但论文未说明采样后用最终边严格重新强制所有深度一致。
| 顺序 | 定义 | 偏好与用途 |
|---|---|---|
| \(\pi_r\) | 从output出发逆边方向BFS,父节点按输入slot顺序访问 | 最一致;默认无条件生成,表1最佳FID |
| \(\pi_{rr}\) | 把 \(\pi_r\) 整体反转 | 从前向后,适合从generator开始的交互补全 |
| \(\pi_b\) | 从前向后BFS;按输出slot排序,同slot子节点随机化 | 增加训练顺序多样性,但任务更不确定 |
| \(\pi_t\) | 随机合法拓扑顺序 | 最不一致;多种等价序列增加建模难度 |
标准化顺序降低等价图的排列歧义,却使某些用户给定前缀不在熟悉分布中。这是规范化和交互灵活性的真实权衡。最佳无条件模型不必是最佳补全模型;论文为两种应用分别使用 \(\pi_r\) 与 \(\pi_{rr}\)。
Appendix A:节点生成阶段不做语义合法性检查;后续参数/边阶段才施加规则。不能把最终“semantic validity”概括成每一阶段都具有相同强度的程序验证。
07 · 第二阶段:异构参数如何变成序列
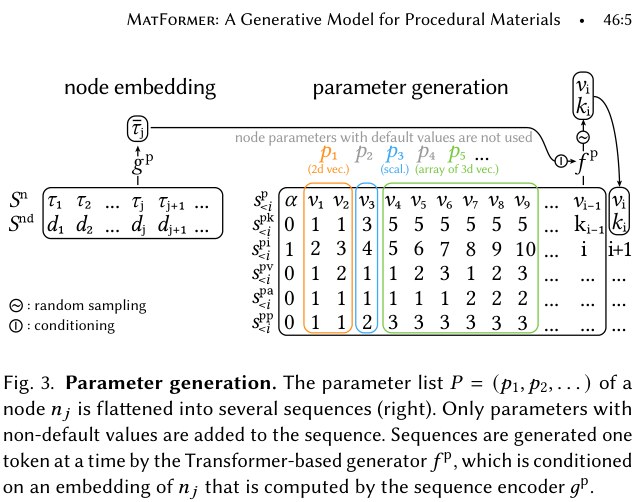
每个节点单独生成一个参数序列,避免整图所有参数拼成超长序列。参数按名称字母序排列;艺术家通常只改少数参数,模型只输出非默认项,未出现的项用该节点定义中的默认值恢复。
为区分“第三个值究竟是哪一个参数”,模型同时生成值序列 \(S^p\) 和原完整参数列表的索引序列 \(S^{pk}\)。向量被展平成标量;变长向量数组也被展平,数组长度由该参数生成的标量数除以向量维度重构。若最后不能整除,则丢弃末尾不足一个向量的值,这是明确的启发式修复,不是完整无损编码保证。
| 序列 | 角色 | 是否预测 |
|---|---|---|
| \(S^p\) | 量化后的标量参数值 | 是 |
| \(S^{pk}\) | 值对应完整参数表中的哪一项 | 是 |
| \(S^{pi}\) | token全局位置 | 从前缀推导 |
| \(S^{pv}\) | 向量内部的元素位置 | 从类型与前缀推导 |
| \(S^{pa}\) | 变长数组中的元素序号 | 从类型与前缀推导 |
| \(S^{pp}\) | 扁平流中的参数位置标记 | 上下文编码,不应与预测的原参数索引混为一谈 |
\[
\bar{\tau}_j=g_p(j,S^n,S^{nd}),\qquad
(p_i^p,p_i^{pk})=
f^p(s_{\lt i}^{p},s_{\lt i}^{pk},s_{\lt i}^{pi},
s_{\lt i}^{pv},s_{\lt i}^{pa},s_{\lt i}^{pp}\mid\bar{\tau}_j).
\]
正文式(4)用节点上下文embedding \(\bar{\tau}_j\) 条件化参数生成。它看到了全图“有什么节点”,但没有看到最后生成的邻接关系。两个同类型节点可因全局位置和上下文不同获得不同embedding。
32级量化意味着什么
连续参数在数据中观察到的最小/最大值之间均匀量化成32级。若采用包含两端点的常见编码,量化步长可解释为 \(\Delta=(v_{\max}-v_{\min})/31\),最近格点误差最多约 \(\Delta/2\);这只是量化精度的解释,论文未给出舍入/边界实现细节。训练数据范围不等同于算子理论全部有效范围,窄范围有利于常见外观,却可能抑制极端控制值。
Appendix A限制离散参数的合法值和参数索引上界。它没有公开详尽说明所有参数间关联约束、量化常量范围处理或非法token集合为空时的回退,复现时应单独决定并记录。
条件注入,而非默认交叉注意力
\[
\operatorname{FFBlock}(x)=x+\operatorname{MLP}(\operatorname{LN}(x)),
\qquad
\operatorname{CFFBlock}(x,c)=\operatorname{FFBlock}(x)+
\operatorname{MLP}(\operatorname{LN}(c)).
\]
Appendix B式(6)(7)在feed-forward block上增加条件分支。\(x\) 是当前隐藏特征,\(c\) 为节点条件。不要仅因出现“conditional Transformer”就替它写成标准encoder-decoder cross-attention,或引入本文没有的CLIP图像条件。
08 · 第三阶段:用Pointer Network连接槽位
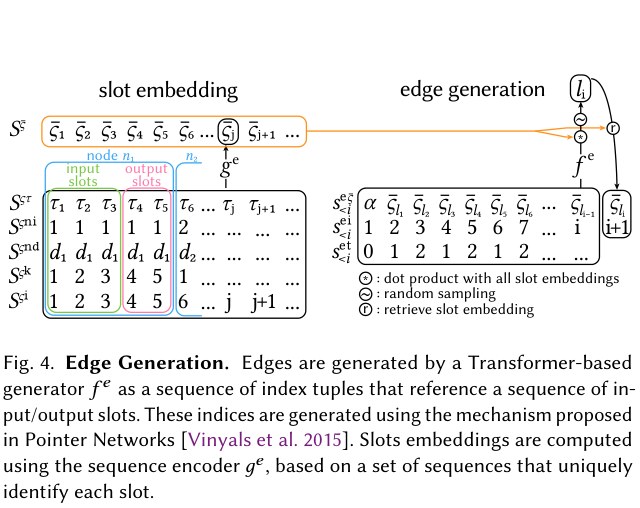
全部节点确定后,按规定列出每个节点的输入和输出槽位,形成槽位表 \(S^{\varsigma}\)。边序列 \(S^e=(\alpha,l_1,l_2,l_3,l_4,\ldots,\omega)\) 每两个索引是一条边:先输出slot,再输入slot。词表因此是当前图的槽位集合,规模随图变化,而不是固定的“第17个节点”标签。
槽位编码器 \(g_e\) 联合读取:节点类型、节点索引、节点深度、节点内部slot索引以及全局slot位置,得到每个slot的上下文向量 \(\bar{\varsigma}_j\)。这让模型区别同类型算子的不同输入口,并了解它所属节点在整图的位置。
\[
p_i^e(j)=\operatorname{Softmax}_{j}
\left(
\bar{\varsigma}_j\cdot
f^e(s_{\lt i}^{e\bar{\varsigma}},s_{\lt i}^{ei},s_{\lt i}^{et})
\right).
\]
正文式(5):边生成器输出query向量,与所有slot embedding点积,softmax后抽取slot索引。已有前缀不是只输入枯燥的整数,而是取出其对应slot embedding;另附全局位置与边二元组中的第1/2位置编码。
显式约束和没有得到的保证
- 边的首个索引只能指向output slot,第二个只能指向input slot。
- 输入slot不能被两条边同时占用,正文§3.2以此解释非法概率mask。
- 新边不能指回当前起点的祖先,避免形成有向环。
- 未接的输入可以使用默认值;因此合法图不要求所有输入都连接。
- 正文并未给出完整的颜色空间、normal/albedo语义通道类型系统。方向合法、无环仍可能把不合适的运算链连到颜色输出,引发可执行但难看的结果。
Our Interpretation:需要维护占用集合与可达性/祖先状态,每次采样前更新合法集合。这个状态来自已生成图,不是模型隐状态能替代的硬约束。论文未说明使用DFS、增量传递闭包还是其他算法;不可把某一种具体实现伪装成作者代码。
09 · 数据、架构和训练设置全表
资产筛选与增广
原始Substance Source约4000图,剔除复杂参数化节点(例如小型pixel shader)后约3500;再去掉超过400节点、700边、单节点超过21输入或14输出slot的图,剩约2800,正文明确基础数为2816。其节点词表共1207种,包含macro节点,不能把每个节点都视作简单原子算子。
每个参数值 \(v\) 在 \([0.8v,1.2v]\) 附近均匀扰动,每张基础图生成100个变体,约28万图样本。拓扑没有因此增加100倍;离散值如何取整、负值区间如何规范以及参数越界如何裁剪,论文没有给出完整实现说明。验证集500个变体只来自5个不同基础图,结构覆盖很窄;原文未详述去重与基础图隔离流程,不能凭此断言绝无泄漏,也不能直接指控泄漏。
| 模型 | 功能 | 层/头/隐藏维 | 长度上限(不计起止) |
|---|---|---|---|
| \(f^n\) | 节点类型+深度生成器 | 2 attention层 / 4头 / 64维 | 400节点 |
| \(g_p\) | 参数模型的节点序列编码器 | 2 / 4 / 64 | 400节点 |
| \(f^p\) | 每节点参数值+索引生成器 | 2 / 4 / 64 | 512个标量值/节点 |
| \(g_e\) | slot上下文编码器 | 2 / 4 / 64 | 800槽位 |
| \(f^e\) | slot指针序列生成器 | 2 / 4 / 64 | 700边=1400token |
“GPT-2 architecture”在这里指结构实现,不等于使用预训练GPT-2语言权重或拥有通用语言能力。它是为材质序列训练的小型模型;论文没有报告每个模块的完整可训练参数数,不能以标准GPT-2型号参数量代替。
| 训练项 | 节点生成 | 参数生成 | 边生成 |
|---|---|---|---|
| 优化器 / 初始学习率 | Adam / \(10^{-4}\) | Adam / \(10^{-4}\) | Adam / \(10^{-4}\) |
| batch size | 64 | 64 | 16 |
| 达到最低验证loss的epoch | 30 | 11 | 10 |
| 训练硬件 | 每个生成模型配一张V100;作者报告训练约2–3天,不据此虚构单张图推理时间 | ||
| 输入监督 | 真值节点/深度前缀 | 真值节点条件+参数前缀 | 真值节点条件+边前缀 |
| 未报告 | 具体Adam betas、weight decay、scheduler、warmup、精度、梯度累积、dropout完整配置、随机种子、全流程推理延迟 | ||
正文§3.6、§4 Dataset,Appendix D。表中架构和训练数值均来自固定用户原件。
10 · 从空图或部分图采样:可复现的流程边界
- 选训练顺序:无条件使用后向BFS \(\pi_r\),交互前缀补全使用 \(\pi_{rr}\)。保持训练与序列化方式一致。
- 从 \(\alpha\) 或用户节点前缀生成类型与深度,遇 \(\omega\) 或400节点上限停止。
- 编码全部节点,针对每个节点生成非默认参数索引和值,按合法范围mask;反量化并重组向量/数组,补齐默认参数。
- 枚举实际slot并编码;逐对采样出/入slot指针,实时检查方向、占用、环;最多700边并受800slot编码上限约束。
- 反序列化成材质图,用节点算子执行,输出材质贴图并渲染供浏览。UI画布排版由标准图布局工具完成。
- 用户挑选完整图,或固定喜欢的子集再次补全。固定节点越多,通常保留的外观结构越多,但本文没有给出每种任意子图都能作为合法前缀的形式化保证。
没有给出的采样设置:原文未报告temperature、top-k、top-p、beam width、所有非法候选被mask后的回退、超长边序列截断后的完整修复策略。文中未来提到beam search,不代表实验已经采用beam search。本文不自行补齐这些数值。
训练和执行的界线:运行Substance算子得到图像是输出与评估的一部分;当前生成过程没有renderer-in-the-loop reward,也没有用目标图像误差进行回溯修图。其可编辑程序输出给后续优化提供了接口,但没有在本篇表1中额外施加DiffMat精修。
11 · 四个评价量,不能统一理解为“越低越好”
| 指标 | 计算对象与定义 | 正确解释 |
|---|---|---|
| \(E_g\) | 生成/数据图的结构统计直方图之间的Earth Mover's Distance | 越低越接近训练资产的图统计;不是材质美观分数 |
| \(E_{\mathrm{fid}}\) | 将材质渲染在面向相机的平面,以同方向spotlight照明;比较Inception图像分布 | 越低越好;只针对该渲染分布,不自动说明所有几何/光照下质量 |
| \(D_{\mathrm{nns}}\) | 生成渲染到最近数据样本的VGG Gram风格距离,除以数据内部最近邻平均距离 | 理想约1;远小于1提示复制/过拟合,远大于1提示偏离分布 |
| \(D_{\mathrm{nne}}\) | 类似归一化,但用图编辑距离,包含节点和边插入/删除;仅算至少50节点图 | 理想约1;不应以越大当成越创新;宏节点基线无满足规模的图,故n/a |
Appendix C的图统计完整包含:节点总数、连通分量数、最长路径;每种算子的节点数、该类型节点到最近output的距离、已连接input槽数;以及各对算子类型之间的图距离。低 \(E_g\) 可说明结构分布相近,仍无法保证某个特定材质的物理语义。
\[
D_{\mathrm{nns}}\approx
\frac{\mathbb{E}_{x\sim\mathrm{generated}}\min_{y\in\mathcal{D}}d_{\mathrm{style}}(x,y)}
{\mathbb{E}_{y\in\mathcal{D}}\min_{z\in\mathcal{D},\,z\ne y}d_{\mathrm{style}}(y,z)}.
\]
这是文字定义的数学重述,帮助识别分母;不是新增作者公式。分母和被选数据集有关,近1也不是无记忆生成的严格证明。样本量约1000,论文未提供多次随机试验的误差条。
12 · 原Table 1全表:基线、参数消融和节点顺序
| 组别 | 方法 | \(E_g\) ↓ | FID ↓ | \(D_{\mathrm{nns}}\) ≈1 | \(D_{\mathrm{nne}}\) ≈1 |
|---|---|---|---|---|---|
| Baseline | Macro-nodes | 0.142 | 232.0 | 0.65 | n/a |
| Baseline | Pairwise Statistics | 0.068 | 86.9 | 0.93 | 2.16 |
| 参数消融 | MatFormer \(P_d\),\(\pi_r\) | 0.047 | 94.2 | 0.88 | 1.52 |
| 参数消融 | MatFormer \(P_a\),\(\pi_r\) | 0.047 | 76.4 | 1.04 | 1.52 |
| 顺序消融 | MatFormer \(\pi_t\) | 0.068 | 66.4 | 0.93 | 2.21 |
| 顺序消融 | MatFormer \(\pi_b\) | 0.070 | 68.4 | 0.84 | 2.08 |
| 顺序消融 | MatFormer \(\pi_{rr}\) | 0.060 | 62.8 | 0.80 | 1.84 |
| 完整默认 | MatFormer \(\pi_r\) | 0.046 | 48.6 | 1.01 | 1.34 |
原PDF第9页Table 1,所有方法行与指标列均转录。该表仅有一个完整模型规模,不能自行制造“大模型配置”比较。
基线如何构造
Macro-nodes:仅用一个可包含复杂子图的macro节点生成,测试质量是否只来自内置强节点而非多节点组合。Pairwise:统计每类输入slot连到何种算子/输出slot的概率(含不连接),从output反向扩展,可创建新节点或连接已有节点但禁止环;图结构完成后仍用本文参数生成器。因此它是“局部连线建模”的对照,不是完全不用学习参数的弱基线。
参数生成不是可有可无
\(P_d\) 全部参数用默认值,\(P_a\) 用数据平均值再加同样随机扰动。图统计几乎不变,FID却由94.2/76.4降至48.6,说明相同节点/边生成骨架下,参数分布显著影响最终图像;相对默认值FID降低约48.4%,相对平均值降低约36.4%。这是指标的相对变化,不是“视觉质量提高48.4%”。
顺序效果与结论限度
后向BFS相对Pairwise的FID从86.9降至48.6(低约44.1%),相对补全使用的 \(\pi_{rr}\) 从62.8降至48.6(低约22.6%)。作者认为更一致的序列更易学习。不过 \(\pi_b\) 的FID68.4比最不一致的 \(\pi_t\) 66.4还高,所以不能写成所有指标都严格随“更规范顺序”单调改善。
最佳模型 \(D_{\mathrm{nne}}=1.34\) 仍偏离理想1,表明结构最近邻关系未完美对齐。基线与架构对照也不能单独证明Transformer优于所有GNN/GRU/LSTM:本文并未报告同等预算、同等约束下这三种网络的直接替换实验。
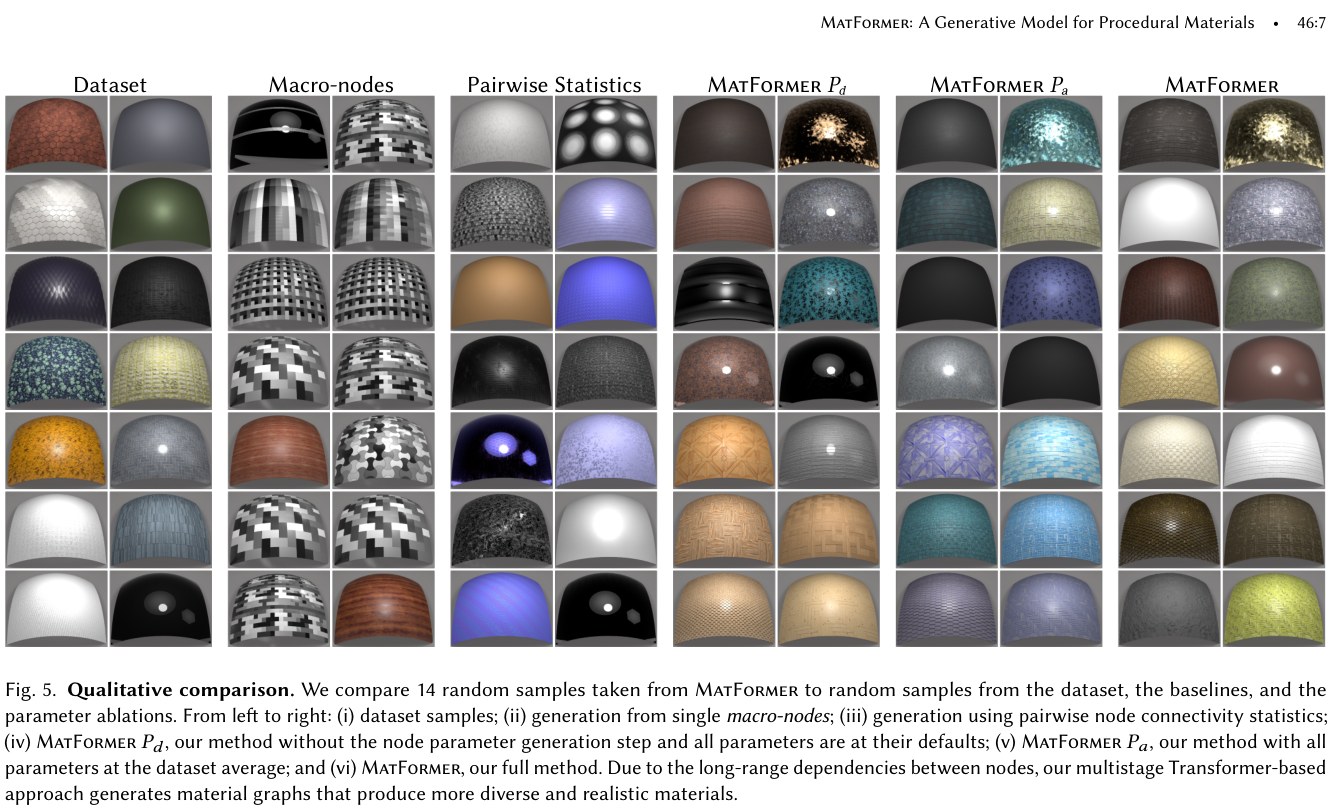
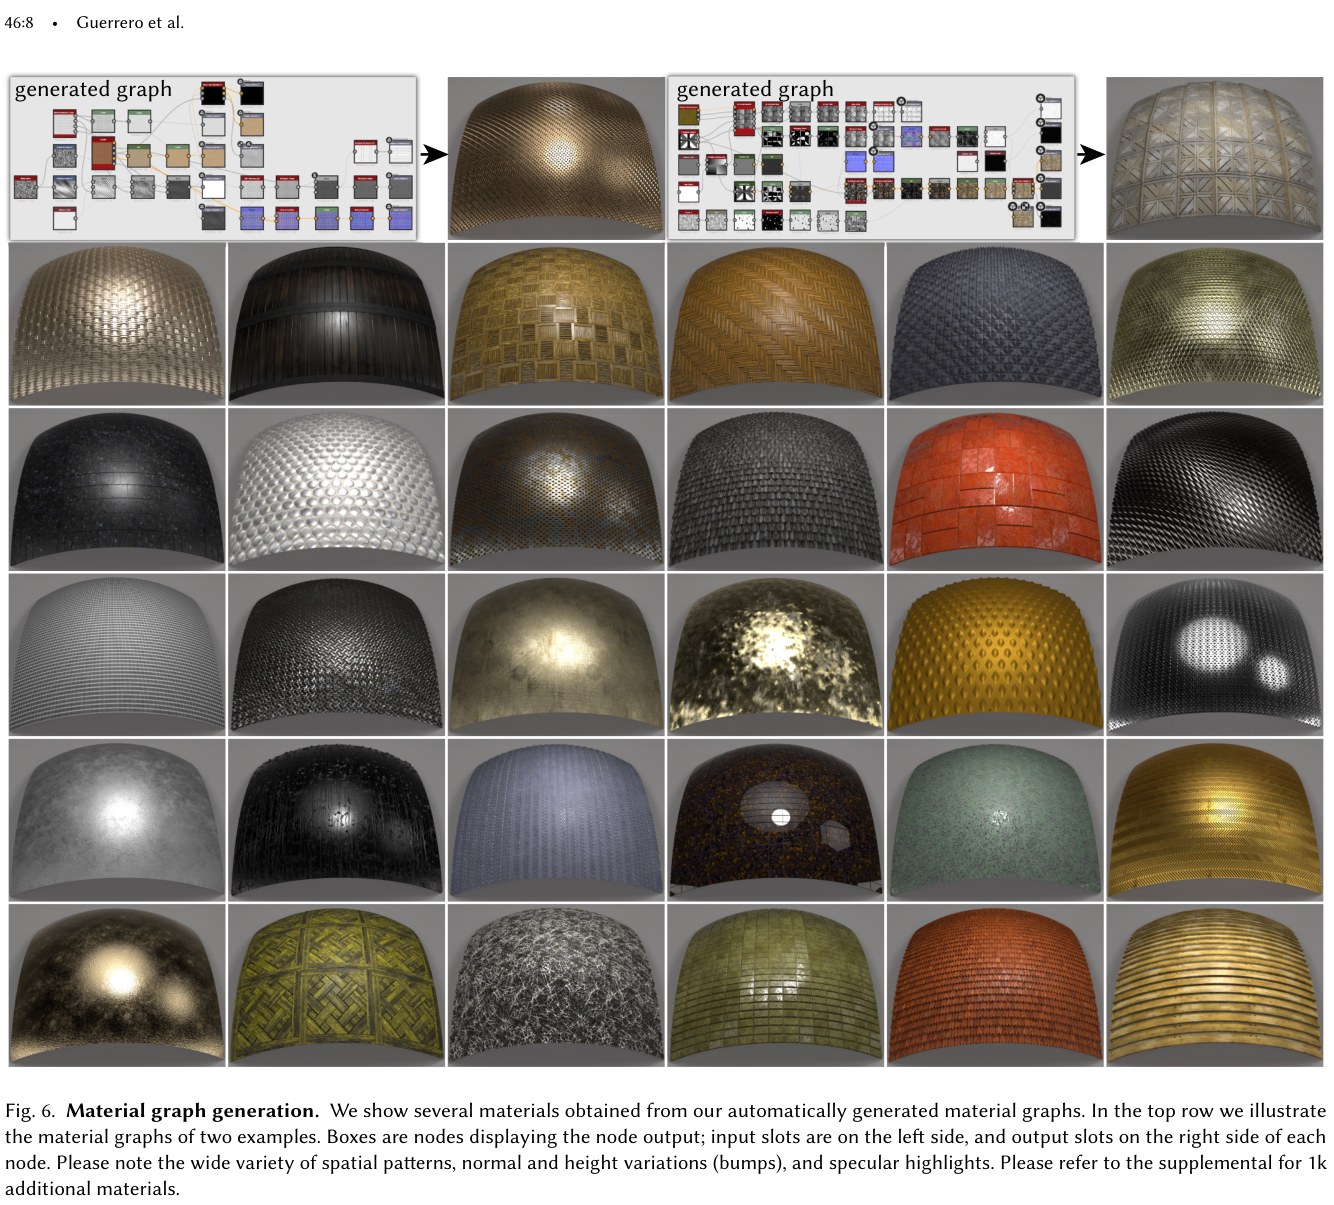
13 · 编辑与补全:有实际能力,也有低可用性警报
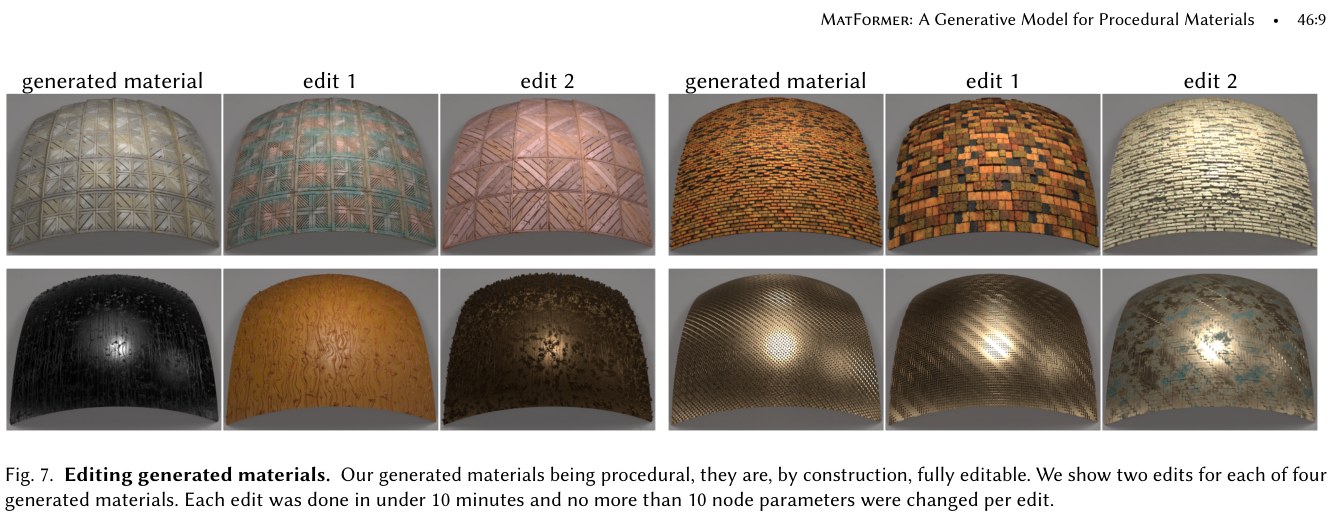
图7四种生成材质各有两次编辑,每次少于10分钟,改动不超过10个节点参数;作者说明很多时间花在重新排列UI节点,而非调整参数本身。它支持程序可编辑,但不是一个大规模任务完成率或专家生产效率实验。
盲测用户研究,正文数值完整整理
| 方法 | 每位专家检查图数 | 平均可用性(0–5) | 评分≥3比例 |
|---|---|---|---|
| MatFormer \(\pi_r\) | 20 | 1.82 | 40% |
| Macro-nodes | 10 | 0.35 | 10% |
| Pairwise Statistics | 10 | 0.48 | 0% |
两位专业材质艺术家可在Substance中自由检查和交互,评分0到5并提供简短意见。MatFormer明显优于本文基线,但1.82/5和仅40%的≥3评分说明多数输出还不能直接视为成熟生产资产。反馈包括有趣材质、图难理解、基础色过饱和、法线不真实。样本与专家数很小,原文无显著性检验或置信区间。
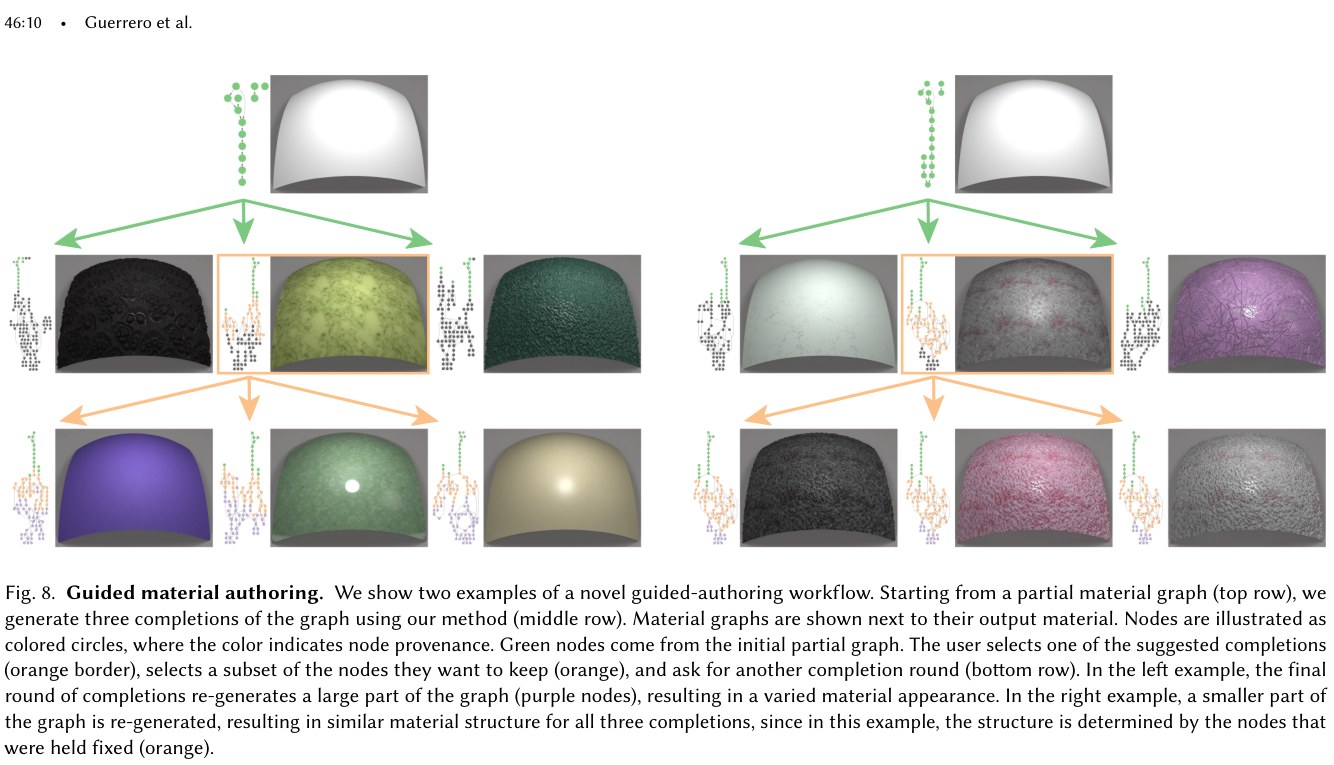
图8展示两轮补全:起始绿节点 → 生成三个候选 → 选一个并保留橙色子集 → 再生成紫色节点。保留更多决定结构的节点,后续外观变化通常更小。正文说明这些演示中每一层保留的节点是随机选的,因此不能把它说成正式的用户主动选择实验;它证明工作流能执行,不量化实际创作效率。
正文§4.1.5–4.2。表为对正文数字的重组,不冒充另一张原论文表。
14 · 官方资料与代码边界
作者项目页和个人主页能确认题名、DOI与论文,但本次读取的2022项目页Code入口被注释,主页“code”没有实际链接;未核实到一个可完整对应此12页原件的原版训练发布。因此本精读不宣称进行了2022代码复现。
官方后续仓库 adobe-research/ProcMatRL 说明它是2024 SIGGRAPH Asia强化学习论文的conditional MatFormer实现,保留原MatFormer代码血统。本次只读核查README和模型/评估入口;该仓库包含图像条件、RL微调、渲染评估与可微后优化等扩展,不把这些当成2022实验配置。
| 本篇原始证据 | 不能从后续仓库反推的内容 |
|---|---|
| 无条件图生成与部分图补全 | 不等于CLIP图像条件或文本条件已在2022实现 |
| teacher forcing监督学习 | 不把PPO训练、轨迹buffer、RL reward归入本篇 |
| Appendix D的小型架构与V100设置 | 不拿后续RTX3090配置、不同hidden size或预训练流程替换 |
| 表1约1000个无条件样本 | 不加上后续Differentiable post-optimization后再比较原表 |
后续仓库还说明用于其论文结果的数据与预训练模型不能发布,并给出非商业研究许可。这个声明属于后续仓库,不是本次核验到2022训练资产可直接取得的证明。复现原论文仍须先确认原始图库授权、完整算子/参数schema、量化与mask实现、训练划分和权重。
本地保留了原始PDF、取源记录和读取到的代码文件哈希;没有执行陌生训练脚本、购买资产、登录Substance或创建任何外部资源。
15 · Reviewer:程序合法性、视觉质量与编辑性须分开
贡献
- 表示拆分贴合工业图。按节点、逐节点参数、slot连接分解,既解决异构值,也缓解一条超长序列的注意力代价。
- slot pointer是关键。它在当前图的动态槽位集合上建模,保留节点类型和端口语义,比纯节点索引更接近真实函数调用。
- 输出确实是程序。能进一步编辑与补全,和一次性贴图生成具有本质不同的交互能力。
- 评价覆盖了图与图像。不仅给FID,还给结构统计、最近邻新颖性与专家可用性;专家低分也坦诚呈现。
限制与混淆风险
- 参数/边独立:同类型节点在不同邻接环境里可能需要截然不同参数,单靠节点集合与深度无法完全确定用途。
- 数据结构多样性有限:约28万参数扰动样本的拓扑仍源自2816基础图;验证只有5个基础结构,不能代表广泛跨结构泛化。
- 量化与词表边界:32级参数、1207节点词表、长度/slot上限限制精细控制和开放域程序表达;含shader参数节点预先剔除。
- 合法不等于合理:无环与槽位占用正确也可能产生不真实法线或错误颜色链。缺少明确物理/语义可行性约束。
- 顺序敏感:好的规范化提升分布拟合,却限制用户任意子图补全的自然性;节点UI布局与语义分组仍难理解。
- 统计缺少方差:单表约1000样本、两位专家;没有直接强网络替代实验、端到端推理成本和完整invalid-rate表。
审稿判断:作为程序化材质图生成的早期完整系统,创新集中在可执行表示与分阶段序列建模,实验支持相对所选基线的进步;“高质量可自动投入生产”则超出了1.82/5用户分数所支持的范围。图像拟合、语义滑块和层次macro发现均属于作者未来工作。
16 · PMG研究延伸:如何接上执行反馈而不混淆贡献
Research Extension,以下均未由本篇实验验证。
A. 先图结构,再邻接感知参数,而非继续假定独立
可改为节点/边先生成,再用实际邻接关系条件化参数;或交替修正参数和边。对照必须控制模型规模、渲染次数和数据split,比较FID、结构新颖性、invalid rate与专家编辑性,避免只改善训练token似然而损伤实际渲染。
B. 让类型检查与视觉反馈分层工作
第一层保证DAG、slot占用、输入输出类型和参数域;第二层检查通道约定、极端法线、过饱和基础色与空输出;第三层对参考图像或多光照目标做视觉评分。执行失败可局部回溯修边,视觉不佳可换模块或调参数。必须分别统计每一层的拒绝原因,不能把重试后成功率当作一次采样成功率。
C. MatFormer负责提案,MATch负责连续精修
给定图像后,外层在候选结构间搜索,内层用可微材质执行拟合可支持的连续参数;离散生成器/未知节点由另一路处理。这个组合要显式保留不支持节点清单、外部位图依赖、回退与预算,不能让自动翻译passthrough静默改变候选语义。
D. 从“可编辑”迈向“容易编辑”
学习或发现重复子图macro,为每个子图标出颜色、颗粒、磨损等作用,再提供少量语义控制与允许范围。检验方式应是盲测指定编辑任务耗时、成功率和意外外观变化,而非仅展示两张编辑前后图片。论文已有UI重排耗时与难懂图反馈,提供了具体研究动机。
E. 更诚实的benchmark
以基础图族隔离训练/验证/测试,再做参数增强;公布资产许可允许的结构schema与去重哈希。对比纯概率采样、合法性mask、执行约束、渲染筛选、可微精修,保持总预算一致。除FID外报告多光照、不同几何承载、平铺边界、图规模、依赖资源、编辑可用性与最近邻复制率。
17 · 最小复现步骤与本次验收边界
- 固定论文版本及节点词表/参数schema;确认macro定义和外部资源可合法访问。
- 实现DAG与slot表示,先做真实资产序列化→反序列化→执行一致性测试,覆盖默认参数、向量、变长数组和未连接输入。
- 按基础图划分后再增广;记录过滤数、1207类词表及32级量化范围,不把参数变体当独立结构。
- 分别训练2层、4头、64维的三个生成系统;保留teacher forcing与对应encoder;按验证loss停止。
- 实现并单元测试参数域、slot方向、占用与无环约束;明确长序列、半条边、半个向量和空合法集合的处理。
- 生成约1000图,固定平面/spotlight渲染协议,完整计算表1四指标;图编辑距离只在至少50节点子集上报。
- 单独测试 \(\pi_{rr}\) 的补全和人类编辑,不将更差的无条件FID自动解释成交互失败。
已做:用户原始12页PDF连同Appendix A–D全文读取,官方网页交叉核验,完整Table 1和用户研究数字重建,全部八张原图纳入,数学源及文件大小静态检查,原Markdown全文作为不可改动前缀保留。未做:训练/推理复现;浏览器DOM、MathJax渲染、图片实际加载、导航点击和1440/760/390px布局检查,均按用户要求deferred。未进入GuaguaHome、未修改用户库、未发布网站。
18 · 一手来源与证据定位
- ACM正式发表记录。主文以用户原PDF为准,SHA-256:433e6c4e07ef5227a6c6bfb87321a37680254a9232bd730ea80e57464df0ea87;12页包含正文、参考文献和Appendix A–D。
- 作者项目页与作者公开PDF入口。本次没有用公开文件覆盖用户固定原件。
- arXiv 2207.01044版本记录。当前条目v2,不代表本地原件字节等同。
- Adobe Research论文页;UCL收录记录交叉核实正式身份。
- 官方后续代码:只用于区分2024conditional/RL实现与2022原始论文的边界,不能代替原版配置证据。
原图1–8署名 Guerrero et al., 2022。表1在第9页;语义合法性、条件注入、图统计、架构训练细节都在第12页Appendix A–D。正文提到的约1000样本supplement gallery未在本次访问的官方项目页找到可用链接,因此不宣称已检查那1000个图;核心附录已包含在原PDF并完整读取。