四张贴图分别编码与量化,拼接后由同一个 decoder 联合还原
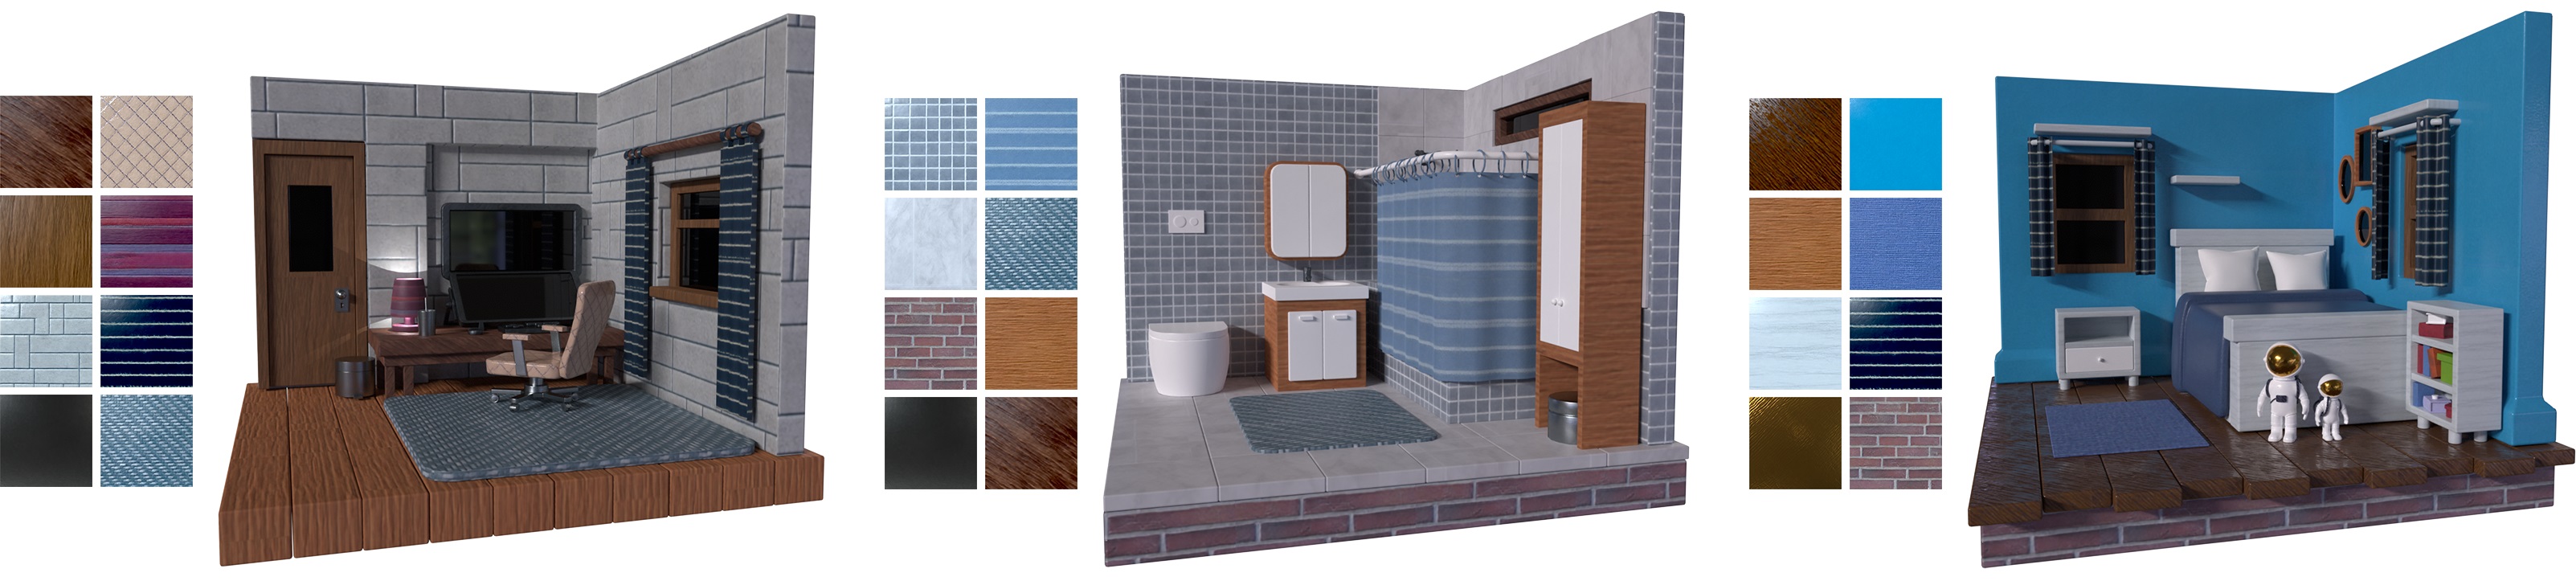
01 · 把材质生成变成可组合、可局部编辑的联合分布
一句话结论:MatFuse 用四个独立的编码器保留 SVBRDF 贴图的语义边界,再在拼接后的共同潜空间中学习扩散生成。文字、参考图、调色板控制整体外观,草图控制空间布局;编辑时同时沿空间和贴图通道掩码,因此既能补一个区域,也能只重生成某一张贴图。它输出的是可渲染的像素贴图,不是可执行的 Substance 节点图或材质程序。
无条件生成渲染图的 FID;TileGen 184.81,LDM baseline 231.64
多编码器重建的 Render RMSE;单编码器 16384-code baseline 为 0.227
阅读主线:真正值得迁移的是“按物理属性组织潜变量,并在联合生成中维持跨贴图一致性”。代价是四张像素图仍缺少程序结构、分辨率无关性和显式拓扑约束;论文版本还不保证可平铺。不要把“可以渲染”误读为“物理参数完全正确”,也不要把“有图像条件”误读为严格的单图材质反演。
事实来源:固定版 PDF §1、§3、§4,Table 1–3;评价性判断为本精读解释。原 PDF
02 · 版本、作者与证据边界
| 项目 | 核实内容 | 边界 |
|---|---|---|
| 正式标题 | MatFuse: Controllable Material Generation with Diffusion Models | 不要与 MatFusion 混淆 |
| 作者 | Giuseppe Vecchio、Renato Sortino、Simone Palazzo、Concetto Spampinato | PDF 明确前两名等贡献;原笔记只列一位第一作者,需要将 Renato Sortino 作为共同第一作者补入归档建议 |
| 机构与通讯 | University of Catania | 原文未明确通讯作者;Concetto Spampinato 仅为末位作者候选,不把等贡献星号当通讯标记 |
| 固定论文 | arXiv:2308.11408v3,2024-03-13;10 页合计,其中正文至第 8 页,参考文献为第 9–10 页 | 本次保留原 PDF SHA-256,不以最新网页替换原论文 |
| 正式发表 | CVPR 2024,4429–4438;DOI 10.1109/CVPR52733.2024.00424 | 原笔记 venue=arXiv、DOI 空白,列入建议修订;不直接改动原前言 |
| 补充材料 | CVPR 官方 supplement ZIP;10 个 HTML 页面与配图 | 不是额外 10 页 PDF,也不是固定 PDF 内附录;架构说明与全部实验画廊均纳入阅读 |
| 代码核查 | 官方 giuvecchio/matfuse,提交 a699a2187b44256cbe7d170b11ee3fad653e7683 | 2026-09-30 获取的当前实现,不能追认成 2024 年全部实验的精确实现 |
下文用四种标签区分证据:Paper Verified 是原论文或官方补充明确给出的设定、数据和结果;Author Claim 是作者解释或愿景;Our Interpretation 是根据方法及实验作出的分析;Research Extension 是尚未被本文验证的后续研究设计。代码静态核查另标为 Implementation Verified;本次没有训练或执行原模型。
03 · 动机与研究空缺:同时约束结构、外观和物理贴图
Paper Verified:游戏、美术和场景渲染需要材质的漫反射、法线、粗糙度与镜面反射参数。人工创建要理解复杂工具,单一图像生成只提供已经混入光照的外观。以往材质模型通常聚焦从照片估计属性,或依赖特定类别训练;想同时满足“砖缝布局像草图、表面像参考图、颜色像调色板、粗糙度响应‘shiny’”仍很困难。
论文把问题拆成两个层面。第一,表示必须能区分每种物理属性,否则编辑潜变量时难知道在改什么。第二,分布必须联合建模这些属性,否则逐图独立生成会出现法线凸起与颜色纹理错位、粗糙度与高光关系不协调。多编码器解决输入侧的属性分组,共同 U-Net 和 decoder 学习组间关系。
| 相关方向 | 本文的比较逻辑 | 不能据此推出 |
|---|---|---|
| MaterialGAN / 示例驱动编辑 | 强调材料捕获或在已有输入附近优化,而 MatFuse 强调多条件生成与补全 | 不能笼统说 GAN 没有任何生成能力;论文此处批评的是使用方式与控制范围 |
| TileGen | 类别专用、支持平铺和结构控制;作为主要材质生成对照 | FID 更低不代表 MatFuse 在平铺、每个类别或每个物理属性上都更强 |
| LDM / Composer | 继承潜空间去噪和可组合条件思想,扩展到多张反射属性图 | 本文不是从零提出扩散、cross-attention 或 classifier-free guidance |
| 单图 SVBRDF capture | 图像可以作语义外观条件,但原文把更强的单图估计列为未来工作 | 不等于恢复参考照片的真实几何、光照或参数 |
Our Interpretation:贡献更接近面向材质的表示设计与生成系统整合,而不是新的扩散概率理论。它最有用的场景是“需要一组相互协调、可由多种方式控制的纹理资产”,而非“必须精确还原某个实物”或“必须交付可编辑节点图”。
04 · 问题定义与张量:分开的属性,联合的材质
令一个材质为 \(\mathbf{x}=\{M^{d},M^{n},M^{r},M^{s}\}\),四个上标依次表示 diffuse、normal、roughness、specular。论文将每张图表示为 \(H\times W\times3\);粗糙度虽然物理上是标量,在所用网络中仍按三通道图处理。输出不包含 height、metallic、AO、displacement 或可执行 graph。渲染器接收这些属性和光照、视角,产生 RGB 外观。
| 符号 | 含义与形状 | 作用 |
|---|---|---|
| \(E^{i},Q^{i}\) | 第 \(i\) 张图的编码器和向量量化器 | 保留属性块对应关系,避免输入侧混合 |
| \(z^{i}\) | \(h\times w\times c^{i}\);当前代码每图 \(c^{i}=3\) | 该图的压缩空间,\(h=H/8,w=W/8\) |
| \(z_{0}\) | 四块按通道拼接;256 输入时为 \(32\times32\times12\) | 扩散模型需要学习的完整材质潜变量 |
| \(D\) | 共享 decoder,当前代码输出 12 通道 | 同时重建所有贴图,允许跨图耦合 |
| \(y,\tau(y)\) | 条件集合及其 embedding | 全局条件走 cross-attention,草图走空间拼接 |
| \(m\) | 与材质 latent 可广播的二值掩码 | 本页约定 1 为保留、0 为重生成;需与实际 UI 掩码反转核对 |
| \(\epsilon_{\theta}\) | U-Net 噪声预测器 | 联合去噪 12-channel 材质 latent |
\[
z^{i}=Q^{i}(E^{i}(M^{i})),\qquad
z_{0}=\operatorname{concat}_{c}(z^{d},z^{n},z^{r},z^{s}),\qquad
\hat{\mathbf{x}}=D(z_{0}).
\]
这里 \(Q^{i}\) 是按最近 codebook 向量进行量化的操作,上式把论文文字中的量化阶段显式写入,是本精读的流程整理。四个 codebook 各有 4096 项,总计 16384 项;独立 codebook 的意义不是扩大同一个词表,而是为各属性分配专用容量。补充材料报告 compression model 为 156M 参数。它不是四套独立 decoder,也不是先生成 diffuse 再逐图自回归补全。
关键边界:“disentangled”在这里主要指可定位的属性分块。共享 decoder 仍会混合四块特征,潜变量分块并不能严格证明输出之间统计独立,亦不保证冻结某块 latent 就能逐像素冻结对应输出。原有笔记关于“一次性 decode 所有 SVBRDF maps”的观察与论文一致;对 RGB-X 的进一步比较需单独核实该论文,不在此扩写成结论。

PDF §3.1、Figure 3;supplement/architecture.html;当前实现 autoencoder.py 的 VQModelMulti、multi-vq_f8.yaml。
05 · 压缩模型训练:贴图误差之外,还要看渲染误差
Paper Verified:第一阶段训练 VQ-GAN,组合 pixel L2、LPIPS 感知损失、patch discriminator 对抗损失、codebook commitment,以及新增 rendering loss。生成 latent 的扩散模型是在这个压缩空间学好后训练的;不能把两阶段合并成一次端到端联合优化。
\[
\mathcal L_{\mathrm{AE}}
=\lambda_{\mathrm{pix}}\mathcal L_{\mathrm{pixel}}
+\lambda_{\mathrm{perc}}\mathcal L_{\mathrm{perc}}
+\lambda_{\mathrm{adv}}\mathcal L_{\mathrm{adv}}
+\lambda_{\mathrm{comm}}\mathcal L_{\mathrm{comm}}
+\lambda_{\mathrm{render}}\mathcal L_{\mathrm{render}}.
\]
上式是概念性汇总,不是论文给出的完整超参数公式;正文未逐项公布所有权重。VQ 的标准最近邻及承诺项可以写成:
\[
k^{i}=\arg\min_{k}\|e^{i}-b^{i}_{k}\|_{2}^{2},\quad
Q^{i}(e^{i})=b^{i}_{k^{i}},\quad
\mathcal L_{\mathrm{VQ}}^{i}
=\|\operatorname{sg}[e^{i}]-b^{i}_{k^{i}}\|_{2}^{2}
+\beta_{\mathrm{VQ}}\|e^{i}-\operatorname{sg}[b^{i}_{k^{i}}]\|_{2}^{2}.
\]
\(e^{i}\) 是量化前特征,\(b^{i}_{k}\) 是第 \(i\) 个 codebook 的第 \(k\) 项,\(\operatorname{sg}\) 阻断梯度。第一项更新 codebook,第二项让 encoder 接近被选向量。此为理解 VQ 的标准示意;当前代码调用外部 VectorQuantizer2 且传入 beta=0.25,其具体 legacy loss 语义仍取决于依赖版本,不能仅凭这个数字复刻完整训练。
\[
\mathcal L_{\mathrm{render}}
=\mathbb E_{\ell,v}\left[
\|R(\mathbf{x};\ell,v)-R(\hat{\mathbf{x}};\ell,v)\|_{2}^{2}
\right].
\]
这是将论文“真实与重建材质渲染图的 MSE”写成显式期望的解释式。\(\ell\) 和 \(v\) 表示灯光及视角。相同贴图 RMSE 对视觉外观的影响不一定相同:粗糙度偏差可能改变整片高光,法线偏差改变高光位置;通过渲染误差反传,可以约束四张图如何共同产生外观。它仍可能允许多组参数产生近似渲染,因此不是物理可辨识性的证明。
Implementation Verified:当前 MaterialLoss 将 12 通道按 3 通道分四次调用图像损失,再增加渲染误差;diffuse、specular 先以 2.2 次幂近似从 sRGB 转为线性。代码里的两个分别命名为 diffuse/specular 的渲染分支实际都调用 generateDiffuseRendering(1,9,...)。这值得复现时检查,而不能在未运行的情况下断言已覆盖专门的镜面光照采样。当前 VQLPIPS 默认 pixel_loss="l1",与正文 L2 不同,详见实现核查。
PDF §3.1、§4.2、Table 3;代码 MaterialLoss、VQLPIPS。
06 · 潜空间扩散与多模态条件融合
第二阶段将真实材质压缩为 \(z_{0}\),按时间步加噪,让 U-Net 预测加入的噪声。下面第一式是标准 DDPM/LDM 的解释性展开,后两式对应论文 Eq. 1 与 Eq. 2:
\[
z_{t}=\sqrt{\bar\alpha_{t}}z_{0}
+\sqrt{1-\bar\alpha_{t}}\epsilon,\qquad
\epsilon\sim\mathcal N(0,I),\qquad
\bar\alpha_{t}=\prod_{s=1}^{t}(1-\beta_{s}).
\]
\[
\mathcal L_{\mathrm{diff}}^{\mathrm{uncond}}
=\mathbb E_{t,z_{0},\epsilon}
\big[\|\epsilon-\epsilon_{\theta}(z_{t},t)\|_{2}^{2}\big].
\tag{1}
\]
\[
\mathcal L_{\mathrm{diff}}^{\mathrm{cond}}
=\mathbb E_{t,z_{0},\epsilon}
\big[\|\epsilon-\epsilon_{\theta}(z_{t},t,\tau(y))\|_{2}^{2}\big].
\tag{2}
\]
\(\beta_{t}\) 决定噪声强度,\(\bar\alpha_{t}\) 决定原信号保留量,\(\epsilon_{\theta}\) 是学习的噪声预测。本文仍是 epsilon prediction,并非直接预测程序节点或离散 codebook token 的自回归模型。去噪在联合 latent 内进行,self-attention 支持不同区域和属性之间的信息交换。
| 条件 | 预处理/编码 | 注入位置 | 能控制什么 / 不能保证什么 |
|---|---|---|---|
| 文字 | 冻结 CLIP 文本表征;补充指 ViT-B/16 对应 CLIP,当前实现用 sentence-transformers/clip-ViT-B-16 | 全局 cross-attention context | 材质类别、语义、shiny 等属性;无严格数值参数约束 |
| 参考图像 | CLIP 图像 embedding;当前代码 ViT-B/16 | 全局 cross-attention | 整体风格与外观;不是逐像素空间对应或逆渲染标定 |
| 调色板 | 正文以 CIE76 距离合并颜色后取最常见 5 色;两层线性层+GELU | 全局 cross-attention | 颜色分布;不指定每种颜色的精确空间区域 |
| 草图 | 训练时从漫射光照渲染图提取 Canny 边缘;小 CNN 下采样 8 倍 | 与 noisy latent 按通道拼接 | 纹理布局与几何边缘;未提供严格边缘遵循率 |
补充材料给出 CLIP 约 150M 参数、palette MLP 约 160K、每个空间编码器约 395K,整个 condition encoder 约 150M 且可训练参数少于 1M。其文字称有“五个 heads”,但正文列举四类条件,当前 MultiConditionEncoder 也明确实现 image/text/sketch/palette 四分支;没有证据把第五个分支自行补成 segmentation。
\[
Q=W_{Q}\operatorname{flat}(z_{t}),\quad
K=W_{K}c_{\mathrm{global}},\quad
V=W_{V}c_{\mathrm{global}},\quad
\operatorname{Attn}(Q,K,V)
=\operatorname{softmax}(QK^{\mathsf T}/\sqrt d)V.
\]
这是 cross-attention 的机制解释:材质空间位置提出 query,条件向量提供 key/value。当前代码把 image、text、palette 的 embedding 沿 token 维拼接,并将 sketch 放入 c_concat;不要把不同条件都简单相加。256 输入时 noisy latent 为 12 通道,草图编码后为 4 通道,U-Net 输入合计 16,输出仍是 12 通道噪声。
可组合训练:正文说每类条件以 50% 概率随机丢弃,另以 10% 概率丢弃全部条件;当前配置还显式设 all.keep=0.1,all.drop=0.1。训练见过缺失条件,推理才可以接受文字独立、图片独立或图文草图组合。这个策略支持“缺哪些条件都能生成”,不自动保证矛盾条件之间的优先级、权重可解释性或任意组合都稳定。
\[
\hat\epsilon_{\theta}
=\epsilon_{\theta}(z_{t},t,\varnothing)
+s\big[\epsilon_{\theta}(z_{t},t,y)
-\epsilon_{\theta}(z_{t},t,\varnothing)\big].
\]
上式是 classifier-free guidance 的标准解释,\(s\) 是引导强度。正文没有给统一的实验 guidance scale;当前 Gradio 默认 5.0,Diffusers 示例使用 4.0,均不能当成论文实验设置。空条件应经过同一编码链,不能随意用最终 embedding 的全零张量替代。

PDF §3.1–3.2、Figure 2;supplement/architecture.html;固定提交的 multicondition.py 与 matfuse-ldm-vq_f8.yaml。
07 · Volumetric inpainting:编辑区域 × 编辑属性
Paper Verified:“volumetric”指对二维空间和 latent 通道这三个轴联合掩码,不是生成三维体素,也不是 3D 几何编辑器。四个属性块已知,因此可保留 normal、重生成 diffuse/roughness/specular,或只填一张贴图中的小洞。
\[
\tilde z_{t}
=z\odot m+z_{t+1}\odot(1-m).
\]
这按正文 §3.3 的写法重述:\(z\) 来自输入材质,\(m=1\) 保留输入,\(m=0\) 使用生成分支。原文此处没有把已知区的前向加噪显式展开。Implementation Verified:DDIM 代码实际先以 q_sample(x0,t) 将已知 latent 加到当前噪声级别,再混合:
\[
z_{t}^{\mathrm{known}}
=\sqrt{\bar\alpha_{t}}z_{0}^{\mathrm{known}}
+\sqrt{1-\bar\alpha_{t}}\epsilon,\qquad
\tilde z_{t}
=m\odot z_{t}^{\mathrm{known}}+(1-m)\odot z_{t}^{\mathrm{sample}}.
\]
这避免把完全干净的已知块直接塞入高噪声 latent,属于复现时不能略过的细节。UI 中 mask_all 或缺图会产生全零保留掩码;手绘 mask 被取第一层、缩放、二值化再反转,并复制到三条 latent 通道。复现前应使用简单测试图确认“涂黑/涂白”和“保留/重画”的实际含义。
- 按 diffuse → normal → roughness → specular 打包输入,四编码器将其压缩成共同 latent
- 为每张图选择完整缺失或局部编辑区域,映射到对应 latent 通道块
- 输入可选文字、图像或调色板,构造同一条件编码
- 每个 DDIM 步骤把已知区重置到正确噪声水平,在未知区继续条件去噪
- 共享 decoder 输出四张图,检查已知区域漂移、边界连续性和重光照一致性
Our Interpretation:编辑能力的关键不是“在 latent 里画 mask”本身,而是 latent 通道已有稳定的属性含义。但 decoder 的感受野及跨属性混合意味着输入保护不是严格像素恒等映射;若生产工具要求完全不变,应另做输出端 compositing,并验证边界及物理一致性。本文未报告已知区漂移指标。
| Input maps | Edited maps | ||||||||
| Condition | Diffuse | Normal | Roughness | Specular | Diffuse | Normal | Roughness | Specular | Render |
 |
 |
 |
 |
|
 |
 |
 |
 |
 |
|
 |
 |
 |
 |
 |
 |
 |
 |
 |
| “brick wall” | |
 |
|
|
 |
 |
 |
 |
 |
PDF §3.3、§4.6、Figure 8;代码 DDIM mask 分支、inference_helpers.py。
08 · 数据构建:160K 材质样本与 3.2M 多光照渲染
Paper Verified:训练组合 Deschaintre et al. 2018 的约 20,000 个混合合成材质,以及来自 PolyHaven 的 320 个材料。每个材料有 diffuse、normal、roughness、specular 四图。前者沿用原数据集的 train/test 划分,后者做多尺度裁剪;两者相加作者报告约 160K 样本。每个 crop 用五个 environment maps、每个四个旋转角 0°/90°/180°/270° 渲染,得到 20 张外观,报告共 3.2M renders。
| PolyHaven 裁剪层级 | 每材料声明数量 | 原裁剪分辨率 | 训练输入 |
|---|---|---|---|
| 全尺度 | 1 | 4096 × 4096 | 统一缩放到 256 × 256 |
| 一半尺度 | 4 | 2048 × 2048 | |
| 四分之一 | 16 | 1024 × 1024 | |
| 八分之一 | 64 | 512 × 512 | |
| 十六分之一 | 256 | 256 × 256 |
数量核查,不能静默修正:正文写“每材料 431 crops,总共 140,508 crops”,但列出的五层计数满足 \(1+4+16+64+256=341\),不是 431;\(320\times431=137{,}920\),也不是 140,508;按层级加总则 \(320\times341=109{,}120\)。这至少说明文字与总数不能同时成立。没有完整数据清单,不能选某个数当真实训练量。160K 和 3.2M 应标记为作者报告的近似总量。
复现重要事项:必须以材质原始资产为单位划分 train/test,再裁 crop,而不能随机拆 crop 造成同一父材质跨集合泄漏。论文未明示 PolyHaven 的独立划分及每个 split 精确数量。当前 README 明确不计划发布原训练数据,建议新训练使用 MatSynth;替换 MatSynth 可做后续实验,但不再是论文数据复现。
当前 MatFuseDataset 递归寻找 diffuse.png,用 metadata.json 中 tags 拼成文字;随机选择 renders/*.png 作图像条件;读取 palette 或按频率提取五色;读取 sketch.png。这个流程表明 captions、render 配置和草图均是模型之外的数据依赖。源码没有自动恢复论文全部裁剪流程及原始 asset 列表。配置中训练、验证 data_root 都指向 sample_materials,正式实验必须改成真正互斥的数据目录。
PDF §4.1;官方 Dataset 实现;计数等式为本次独立算术核查。
09 · 训练、推理与复现清单
论文报告设置,完整列出已知与缺失
| 阶段 | 正文/补充明确报告 | 未明确或不能据此还原 |
|---|---|---|
| 压缩模型 | Adam;batch 4;LR \(10^{-4}\);4,000,000 iterations;300,000 iterations 后启用 adversarial loss;下采样因子 8;四 encoder/codebook;156M 参数 | 完整 loss 权重、全部 Adam 超参数、训练硬件/用时、精度、训练随机种子、warmup/weight decay 细节未在正文给齐 |
| 扩散模型 | AdamW;batch 20;500,000 iterations;LR \(10^{-4}\);从 \(10^{-6}\) 线性 warmup;linear beta schedule;U-Net+attention | warmup 长度、完整 schedule、GPU 数量、梯度累积、精度、训练墙钟时间、完整参数量未给齐 |
| 条件训练 | CLIP ViT-B/16 冻结;palette MLP、空间 CNN 与 U-Net 共同优化;每条件 50% drop、全条件 10% drop | 不同随机丢弃事件的优先级需查代码;条件冲突处理没有系统协议 |
| 推理 | DDIM,50 steps;512 × 512 定量评估;512 约 18GB VRAM、768 略低于 24GB | 统一 guidance scale、eta、单样本耗时、精确测量硬件及 batch 条件未报告 |
| 基础/大模型 | 没有单独 MatFuse-Large 实验;Table 2 的 Base 是单 encoder VQ compression baseline,4096/8192/16384 为 codebook 尺寸 | 不能称这些行为扩散模型 Base/Large,也不能给不存在的大模型训练配置 |
当前公开配置是启动示例,不是论文训练日志
| 组件 | 固定代码快照参数 | 复现含义 |
|---|---|---|
| VQ config | embed_dim=3;n_embed=4096;z_channels=256;ch=128;ch_mult=[1,1,2,4];2 residual blocks;dropout=0;out_ch=12 | 每图最终量化 latent 是 3 通道,不是 z_channels 的 256 通道 |
| VQ 优化默认 | base_learning_rate=4.5e-6;batch_size=2;accumulate_grad_batches=2;disc_start=50001;disc_weight=0.5;Adam betas=(0.5,0.9) | 与正文 batch/对抗启用时刻不同;main.py 可按 GPU 数、batch 和累积放大 base LR |
| U-Net | in/out=16/12;model_channels=256;channel_mult=[1,2,4];num_res_blocks=2;head channels=32;spatial transformer depth=1;context_dim=512 | 12 材质 latent + 4 草图通道;block 宽度为256/512/1024 |
| diffusion config | 训练时间步1000;beta 起止0.0015/0.0195;image_size=32;channels=12;base LR=1e-6;batch=8 | 正文的有效 LR 和 batch 20 不能由该示例直接等同得到 |
| 预训练依赖 | CLIP image ViT-B/16;CLIP sentence-transformers;阶段一 checkpoint 需填 first_stage_config.ckpt_path | 不是使用一段大语言模型 system prompt;没有 LLM temperature/top-p/beam search |
| 界面默认 | 512 输出、50 steps、guidance 5.0、eta=0.0;seed=-1 时随机;支持256–1024界面范围 | 界面范围不意味着所有分辨率已在论文中定量验证 |
可复现实验顺序
- 先冻结原论文 v3、代码提交、Python/PyTorch/依赖版本、资产清单及 split。官方 README 的测试环境为 Python 3.10、PyTorch 1.13.1;不自动安装或执行
- 建立每材质文件夹,提供四张图、sketch.png、metadata.json、renders;检查通道顺序、色彩空间、法线约定与粗糙度三通道表示
- 先训练 VQ 并验证每张图和多光照渲染 RMSE;单 encoder 对照总 codebook 容量对齐
- 把 VQ checkpoint 接入 diffusion,检查实际可训练参数和冻结状态;记录每种条件是否缺失、dropout 分支频率及有效学习率
- 用固定 seeds 分开评估无条件、单条件、组合条件、整图/局部编辑;记录 EMA、guidance、eta 与 sampler 参数
- 重建论文的 2,000 材质渲染评测,保持 renderer、光照、参考数据、FID feature pipeline 一致,再报告延伸实验,避免把协议变化当模型收益
PDF §4.2、§5;supplement/architecture.html;固定代码的两份 YAML、main.py、ddpm.py、gradio_app.py。当前配置不补造缺失的原论文实验设置。
10 · 条件生成结果:每张图到底证明什么
全局条件:类别、颜色与外观语义
| Condition | Diffuse | Normal | Roughness | Specular | Render |
| “terracotta brick wall” |  |
 |
 |
 |
 |
| “shiny parquet” |  |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
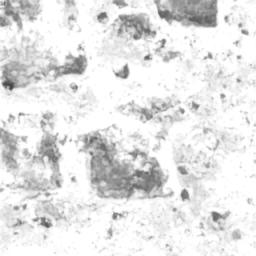
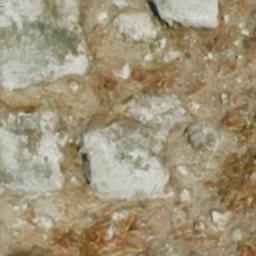
Figure 4 的六行依次是两个文字、两个图片和两个调色板条件。作者以“terracotta brick wall”“shiny parquet”说明文字能影响材质类别及光泽;图片传递外观特征;palette 影响 diffuse 颜色。它证明了展示样本中存在可理解的控制响应;没有定量证明各种形容词都能映射到正确 roughness 数值,也没有控制属性单调性实验。
局部条件:草图布局
| Condition | Diffuse | Normal | Roughness | Specular | Render |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
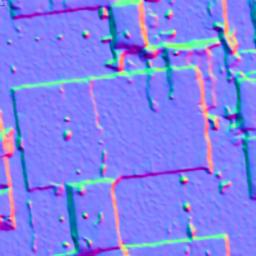
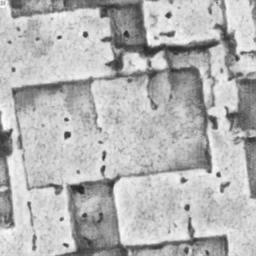
Figure 5 包含手绘的干净草图和 Canny 提取的更嘈杂草图。作者认为结构被转移到 normal 及最终渲染。这说明系统能接收不同质量的结构线索;“robustness”证据仍是展示样例,而非跨噪声强度的完整曲线。
组合条件:一条局部信号加一条全局信号
| Cond. | Sketch | Diffuse | Normal | Rough. | Specular | Render |
| “rusty metal” |  |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
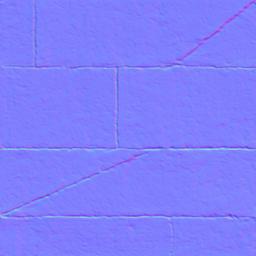
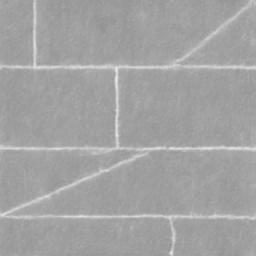
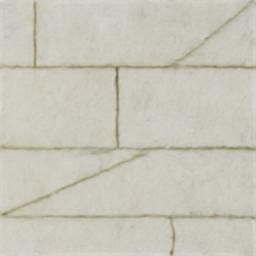
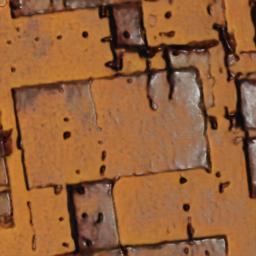
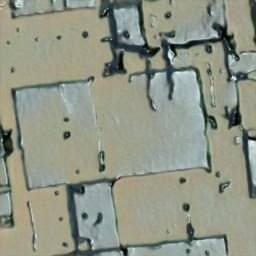
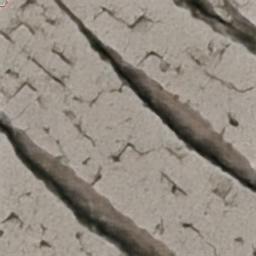
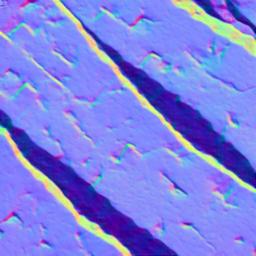
Figure 6 三行分别为 text+sketch、image+sketch、palette+sketch。草图约束布局,全局条件决定外观;“rusty metal”一行用于展示语义与形状同时生效。没有展示完整四条件所有组合的成对冲突分析,也没有多目标遵循分数。官方补充提供更多同草图搭配不同文字的例子,适合检查不同属性如何随条件变化。
Our Interpretation:对工具设计而言,可组合输入比“只给一段 prompt”更有价值;对研究验证而言,还需量化局部位置遵循、全局语义、跨贴图物理一致性,以及在相同随机种子下对照各条件。
11 · 定量结果与用户研究:质量、覆盖度和偏好的边界
评测协议:论文将 2,000 个无条件生成的材质渲染到 512×512,以 CLIP-IQA 的 “high-quality / low-quality” 对比词衡量外观质量,同时计算 FID。对照包含真实材质渲染、TileGen、训练成无条件材质生成的 LDM baseline。TileGen 当时未公开模型,生成样本由其作者提供。真实样本的 CLIP-IQA 被作者称为 upper bound,但它只是参考分布的观测均值,并不是数学上限。
原 Table 1 · 生成质量,全部方法与指标
| Model | CLIP-IQA ↑ | FID ↓ |
|---|---|---|
| Ground Truth | 0.471 ± 0.191 | — |
| TileGen [54] | 0.433 ± 0.161 | 184.81 |
| LDM (baseline) | 0.269 ± 0.118 | 231.64 |
| MatFuse | 0.431 ± 0.151 | 158.53 |
MatFuse 相对 LDM 的 FID 下降 73.11,约 31.56%;相对 TileGen 下降 26.28,约 14.22%。CLIP-IQA 相对 LDM 增加 0.162,但比 TileGen 低 0.002,所以准确结论是:在该协议下,FID 更优,CLIP-IQA 与 TileGen 接近,而不是每个指标都胜出。± 的统计口径不能擅自解读为 95% 置信区间。
Author Claim:较好的 FID 可能来自更多样的样本,因为 TileGen 类别限制更强。Our Interpretation:这是合理假设,表格本身无法把质量、类别分布匹配、样本多样性及训练数据范围的贡献分开。FID 对参考集选择与特征分布敏感,CLIP-IQA 又不是为物理材质正确性设计;两者均未测量法线长度、能量守恒、平铺边界或参数可辨识性。
用户研究
100 位计算机科学硕士/博士学生,每人比较 25 对材料,共 2,500 次选择;样本从 100 个样本的较大池中随机选取,类别为 leather、wood、marble、stone、ceramic。MatFuse 使用类别名作全局条件,TileGen 使用对应类别专用模型;参与者根据 realism 和 rendering quality 选择。
| 选择 | 票数 | 全部票比例(本页计算) |
|---|---|---|
| MatFuse | 1078 | 43.12% |
| TileGen | 949 | 37.96% |
| No preference | 473 | 18.92% |
MatFuse 领先 129 票,即全部票的 5.16 个百分点;排除无偏好后 MatFuse 约占 53.18%。作者报告 \(\chi^{2}=16.41,p\lt0.05\),认为有统计显著偏好。正文没有完整给出检验列联表、随机化/盲测细节、参与者与样本重复测量处理,不能直接用聚合票数重建其全部统计过程;也不能把这组学生偏好外推为专业材质艺术家的生产效率提升。
| Diffuse | Normal | Roughness | Specular | Render | ||
|
TileGen |
Leather |  |
 |
 |
 |
 |
|
MatFuse |
 |
 |
 |
 |
 | |
|
TileGen |
Wood |  |
 |
 |
 |
 |
|
MatFuse |
 |
 |
 |
 |
 | |
|
TileGen |
Marble |  |
 |
 |
 |
 |
|
MatFuse |
 |
 |
 |
 |
 |
PDF §4.4–4.5、Table 1、Figure 7;差值、比例为本页基于原始数值计算,未重新运行实验。
12 · 消融:收益主要来自哪一步?
原 Table 2 · 单编码器与多编码器,全部结果
| Architecture | Diffuse RMSE ↓ | Normal RMSE ↓ | Roughness RMSE ↓ | Specular RMSE ↓ | Render RMSE ↓ |
|---|---|---|---|---|---|
| Base (4096) | 0.057 | 0.061 | 0.114 | 0.166 | 0.267 |
| Base (8192) | 0.049 | 0.052 | 0.098 | 0.144 | 0.233 |
| Base (16384) | 0.047 | 0.051 | 0.102 | 0.152 | 0.227 |
| Multi Enc. | 0.016 | 0.024 | 0.022 | 0.020 | 0.041 |
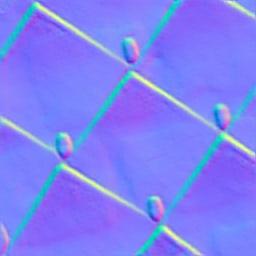
与总 codebook 项数相同的 Base(16384) 比较,Multi Enc. 在五项都更好;Render RMSE 减少约 81.94%,Specular RMSE 减少约 86.84%。从 8192 扩到 16384 并非每项都改善,roughness 从 0.098 变 0.102,specular 从 0.144 变 0.152。因此“只增大 codebook”不能解释多 encoder 的全部优势。
实际证明:属性专用编码在这套重建任务中有效,且单编码器扩大词表不能弥补差距。尚未证明:这是 reconstruction 指标,不是最终生成 FID 的逐项因果分解;总 codebook 容量对齐也不等同于总参数量、计算量和训练预算严格对齐。“解耦”未以独立性或互信息指标专门验证。
原 Table 3 · Rendering loss 的贡献,全部结果
| Losses | Diffuse RMSE ↓ | Normal RMSE ↓ | Roughness RMSE ↓ | Specular RMSE ↓ | Render RMSE ↓ |
|---|---|---|---|---|---|
| Σ losses from [11] | 0.038 | 0.030 | 0.047 | 0.033 | 0.064 |
| + rendering loss | 0.016 | 0.024 | 0.022 | 0.020 | 0.041 |
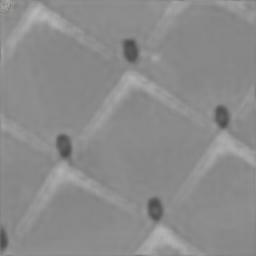
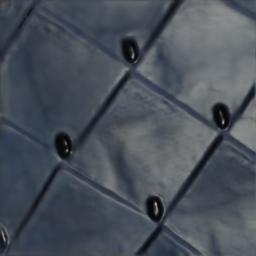
增加渲染监督后,Render RMSE 从 0.064 降到 0.041,减少约 35.94%;各贴图 RMSE 也改善。Normal 的变化为 0.030→0.024,20%;Diffuse 为 0.038→0.016,约57.89%。表明外观层监督与图级误差改善并不冲突。但渲染器、光照分布、loss 权重的独立消融不足,不能断言任意 renderer loss 都同样有效。
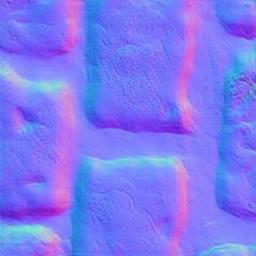
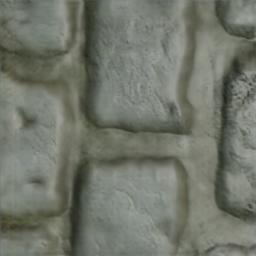
官方补充的 loss 画廊分别展示 Ground Truth、L1 Loss、Rendering Loss、Adversarial Loss、Perceptual Loss;架构画廊展示 Ground Truth、Base、Multi-Encoder。它们是定性实例而不是一张新增的完整定量消融表,下方保留全部原始图片行,不能把标签顺序擅自理解成逐步累计训练。
补充 A · 完整训练损失与架构消融画廊(40 个原始分图)
Training Losses
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| Ground Truth |  |
 |
 |
 |
 |
| L1 Loss |  |
 |
 |
 |
 |
| Rendering Loss |  |
 |
 |
 |
 |
| Adversarial Loss |  |
 |
 |
 |
 |
| Perceptual Loss |  |
 |
 |
 |
 |
Architecture Ablation
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| Ground Truth |  |
 |
 |
 |
 |
| Base |  |
 |
 |
 |
 |
| Multi-Encoder | 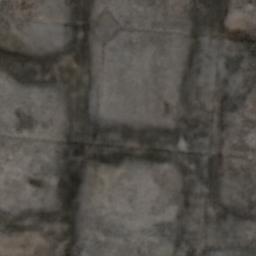 |
 |
 |
 |
 |
官方补充文件 ablation/index.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
PDF §4.7、Table 2–3;官方补充 ablation/index.html;相对下降为本页算术。
13 · Paper vs. Implementation:必须显式记录的偏差
本节针对当前官方提交静态阅读,并未宣称找到“造成论文结果错误的 bug”。许多差异可能来自后续重构、演示默认值或配置样例;实验重现时必须区分这些可能性。
| 主题 | 论文/补充 | 当前公开实现与影响 |
|---|---|---|
| tileability | §5 明确说当前方法缺乏可平铺性 | 推理 helper 与 Diffusers decoder 前对 latent 做7格 circular padding,再中心裁剪;Hugging Face 文案称 tileable。后处理存在不等于周期边界已在论文中验证;应测试多层边界、导数及渲染缝隙 |
| pixel loss | §3.1 写 L2 | VQLPIPSWithDiscriminator 默认 L1,配置未覆盖 pixel_loss;官方补充画廊也标 L1。需要选择“按正文”还是“按该提交”重现并记录 |
| adversarial warm start | 300,000 iterations | 当前 YAML disc_start=50001;不是同一设定 |
| batch / LR | VQ batch4、diffusion batch20,均报告 LR1e-4 | YAML 分别batch2+累积2、batch8,base LR4.5e-6/1e-6;main.py 默认可按 GPU×batch×累积放大,因此要记录最终有效值 |
| 渲染采样 | 渲染图间 MSE 保持跨图一致性 | MaterialLoss 的两个分支都调用 generateDiffuseRendering。应核查 sampling、roughness 与 specular 的实际梯度,不能凭变量名理解成两种渲染器 |
| 数据分割 | 沿用第一数据源 train/test,PolyHaven split 未详细列出 | Dataset 不自动划分,递归读取路径下所有 diffuse.png;示例 train/validation 同指 sample_materials,不能直接用作有效验证集 |
| 调色板 | 正文 CIE76 合并,取5色 | 主 Dataset / helper 使用 Pylette 五色;另一个 material_utils.extract_palette 辅助函数只取3色,不能拿该未必在主路径调用的函数代表整个系统 |
| 推理额外开销 | DDIM 50步 | Gradio helper 顺序输出普通采样、EMA采样、当guidance>1时再输出CFG采样;一次按钮可能执行三轮采样。做速度比较应计入实际路径,不能当成单次50步 |
| 文本预处理 | 描述性 prompt 条件 | Dataset 用 metadata tags 拼接文本,CLIP sentence wrapper 直接编码传入文本;未见在该主路径强制添加统一前缀。生成与训练应保持一致,不能引用其它论文的 MatFuse baseline prompt 当作这里的默认 |
| 缺失输入 | 缺图补全是能力之一 | Dataset 对缺失图构建默认 placeholder,缺 sketch 返回None;公开脚本含示例/遗留路径,需要预检查。不能把缺失数据默认为真实物理值 |
静态风险样例:Dataset 的十六进制颜色分支先将字符串存入 color,随后却索引 hex;若走此分支可能失败,RGB 三元组分支不受这一点影响。此为源码可见的不一致,尚未运行复现;准备数据时可优先使用明确 RGB 三元组并加校验。另需检查 specular/diffuse 的 gamma、normal 方向约定和所有图分辨率是否一致。
固定提交:inference_helpers.py · matfuse.py · encoders/modules.py · 当前模型卡。
14 · 官方补充材料完整读图索引
官方补充包提供一页技术细节、一个消融页、六个结果/对照页与导航页。它没有单独的附录 PDF,也没有新增编号定量表。所有实质性画廊在下面折叠区域保留原行列和真实图片;标题按原包语义翻译,原图版权属于作者。主文图编号沿用固定 PDF,避免 arXiv HTML 漏掉 teaser 后整体少一号的问题。
| 补充页 | 覆盖内容 | 如何使用证据 |
|---|---|---|
| architecture.html | 四个4096词表、156M压缩模型、CLIP与条件编码器参数 | 已整合到表示与训练章节;注意“五heads”文字与四条件实现的差异 |
| ablation/index.html | 全部loss与架构对照图片 | 上一节完整保留;只作为定性佐证 |
| results/unconditional.html | 四组无条件材料,每组完整四图与render | 观察没有条件时的纹理先验;不能只凭四例估计分布覆盖度 |
| results/single-condition.html | 文字、调色板、参考图片、手绘和图片提取草图 | 文字包括 Wall、Grass、Snow、Wood、Bark;评估语义与具体贴图变化 |
| results/multicondition.html | sketch+palette、sketch+text、sketch+image | 同结构配石材/木材、锈钢/亮钢、混凝土/皮革的不同条件 |
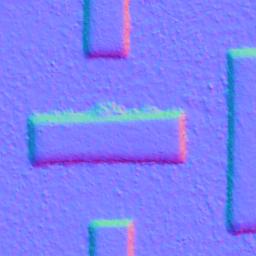
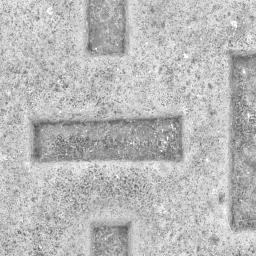
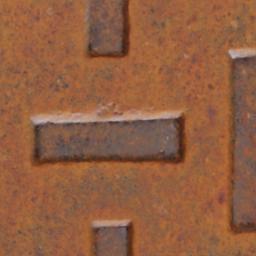
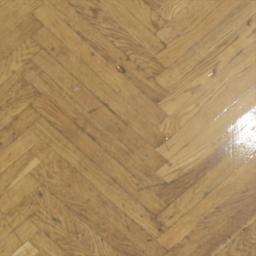
| results/editing.html | diffuse颜色、normal几何、roughness/specular反射性质、局部补洞 | 关注编辑后其它属性与已知区是否保持,论文没有对应数值误差 |
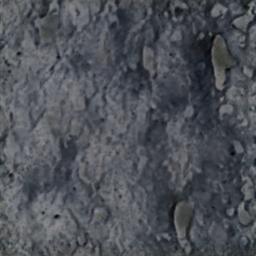
| comparison/tilegen.html | Wood、Stone、Leather、Marble,多例完整对照 | 两模型输出不是同一个真实材质的逐像素配对,不能按内容一致性直接排名 |
| results/search.html | 生成图与 CLIP 近邻,四个 query、每个五个 nearest neighbors | 提供未简单复制训练图的直观线索;没有距离阈值、精确检索协议或全数据统计,不能严格证明无记忆 |
补充 B · 完整无条件生成画廊(20 个原始分图)
| Diffuse | Normal | Roughness | Specular | Render |
|---|---|---|---|---|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
官方补充文件 results/unconditional.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
补充 C · 完整单条件生成画廊(109 个原始分图)
Text conditional
| Condition | Diffuse | Normal | Roughness | Specular | Render |
| Wall |  |
 |
 |
 |
 |
| Grass | 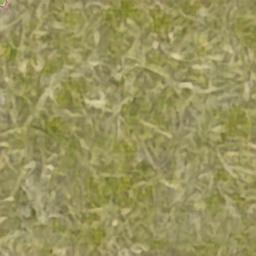 |
 |
 |
 |
 |
| Snow |  |
 |
 |
 |
 |
| Wood |  |
 |
 |
 |
 |
| Bark |  |
 |
 |
 |
 |
Palette conditional
| Condition | Diffuse | Normal | Roughness | Specular | Render |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
Image-prompt conditional
| Condition | Diffuse | Normal | Roughness | Specular | Render |
 |
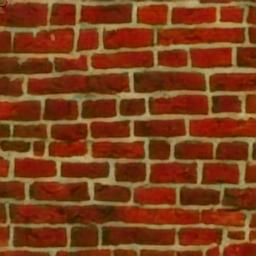 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
Sketch conditional
| Condition | Diffuse | Normal | Roughness | Specular | Render |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
官方补充文件 results/single-condition.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
补充 D · 完整多条件生成画廊(99 个原始分图)
Sketch + Palette
| Sketch | Condition | Diffuse | Normal | Roughness | Specular | Render |
 |
|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
|
|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
|
 |
Sketch + Text
| Condition | Sketch | Diffuse | Normal | Roughness | Specular | Render |
| Stone floor tiles | 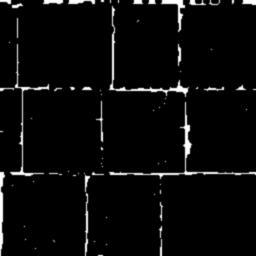 |
 |
 |
 |
 |
 |
| Wooden floor tiles | |
 |
 |
 |
 |
 |
| Rusty steel surface |  |
 |
 |
 |
 |
 |
| Shiny steel surface | |
 |
 |
 |
 |
 |
| Cracked concrete | 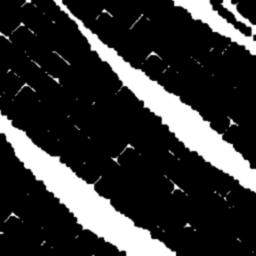 |
 |
 |
 |
 |
 |
| Black leather surface with ridges |  |
 |
 |
 |
 |
 |
Sketch + Image Prompt
| Condition | Sketch | Diffuse | Normal | Roughness | Specular | Render |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
官方补充文件 results/multicondition.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
补充 E · 完整材质属性编辑与补洞画廊(146 个原始分图)
Diffuse color Editing
| Condition | Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|---|
| (Masked) | ||||||
| Input |  |
 |
 |
 |
 |
|
| ↓ | ||||||
| Edit 1 |  |
 |
 |
 |
 |
 |
| Edit 2 |  |
 |
 |
 |
 |
 |
| Input | 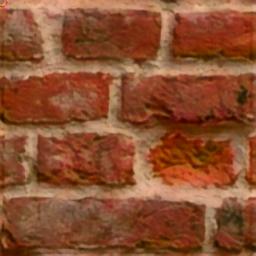 |
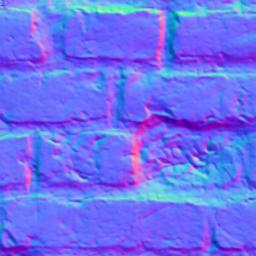 |
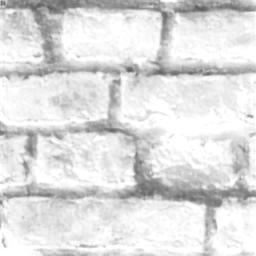 |
 |
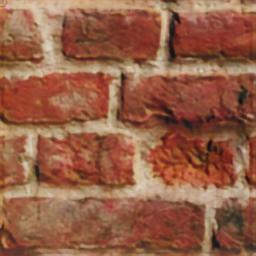 |
|
| ↓ | ||||||
| Edit 1 |  |
 |
 |
 |
 |
 |
| Edit 2 |  |
 |
 |
 |
 |
 |
Geometry (Normal Map) Editing
| Condition | Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|---|
| (Masked) | ||||||
| Input |  |
 |
 |
|
 |
|
| ↓ | ||||||
| Edit |  |
 |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
|
| ↓ | ||||||
| Edit |  |
 |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
|
| ↓ | ||||||
| Edit | Flat surface | 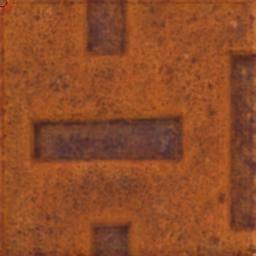 |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
|
| ↓ | ||||||
| Edit | Bumpy, irregular surface |  |
 |
 |
 |
 |
Reflectivity (Roughness, Specular) Editing
| Condition | Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|---|
| (Masked) | (Masked) | |||||
| Input | |
|
|
|
 |
|
| ↓ | ↓ | |||||
| Edit | Shiny surface |  |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
|
| ↓ | ↓ | |||||
| Edit | Rough surface, opaque |  |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
|
| ↓ | ↓ | |||||
| Edit | Rough surface, opaque |  |
 |
 |
|
 |
| Input |  |
 |
 |
|
 |
|
| ↓ | ↓ | |||||
| Edit | Rough surface, low reflectance | 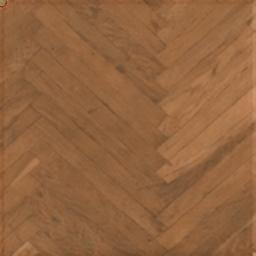 |
 |
 |
 |
 |
Map Inpainting
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| Input |  |
 |
 |
|
 |
| Edit |  |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
| Edit |  |
 |
 |
 |
 |
| Input |  |
 |
 |
|
 |
| Edit |  |
 |
 |
 |
 |
官方补充文件 results/editing.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
补充 F · 完整 TileGen 对照画廊(80 个原始分图)
Wood
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| TileGen |  |
 |
 |
 |
 |
| TileGen |  |
 |
 |
 |
 |
| MatFuse |  |
 |
 |
 |
 |
| MatFuse | |
|
|
|
|
Stone
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| TileGen |  |
 |
 |
 |
 |
| TileGen | 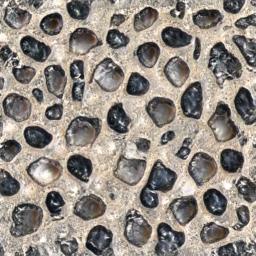 |
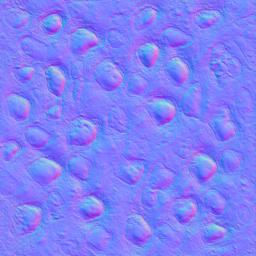 |
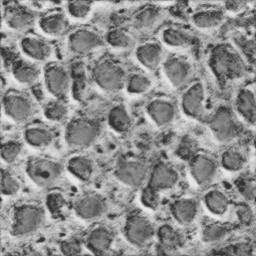 |
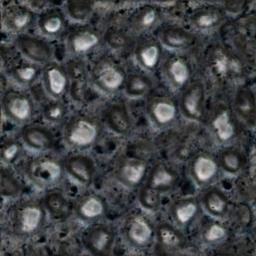 |
 |
| MatFuse |  |
 |
 |
 |
 |
| MatFuse |  |
 |
 |
 |
 |
Leather
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| TileGen |  |
 |
 |
 |
 |
| TileGen |  |
 |
 |
 |
 |
| MatFuse |  |
 |
 |
 |
 |
| MatFuse |  |
 |
 |
 |
 |
Marble
| Diffuse | Normal | Roughness | Specular | Render | |
|---|---|---|---|---|---|
| TileGen |  |
 |
 |
 |
 |
| TileGen | 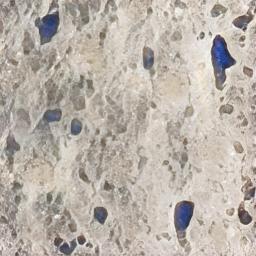 |
 |
 |
 |
 |
| MatFuse |  |
 |
 |
 |
 |
| MatFuse |  |
 |
 |
 |
 |
官方补充文件 comparison/tilegen.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
补充 G · 完整 CLIP 最近邻画廊(24 个原始分图)
| Input (MatFuse output) | Nearest Neigbor #1 | Nearest Neigbor #2 | Nearest Neigbor #3 | Nearest Neigbor #4 | Nearest Neigbor #5 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
|
官方补充文件 results/search.html · CVPR ZIP 来源 · 图片保留原始布局,不重新绘制
完整官方补充材料。画廊原图内嵌以确保该部分离线可用;主文网络图来自固定 arXiv 版本,需联网加载。
15 · Reviewer commentary:强项、证据缺口与失败模式
有依据的强项
- 表示与交互一致:四个 latent 块与材质属性对应,让缺图补全和 map-specific editing 有明确控制入口;不是生成 RGB 后再做不可控拆分
- 跨图一致性考虑完整:共享 decoder 与 rendering loss 将评价对象从单张贴图扩展到组合后的可见外观;Table 3 所有 RMSE 改善支持其实际作用
- 控制接口广:文字、图片、palette、sketch 可组合,适合不同技能水平的创作方式;同一模型接受缺失条件
- 不只展示图:有完整生成主表、100人用户研究、两类重建消融和官方补充样例,同时提供公开代码
不能被结果表掩盖的不足
- 评测目标偏外观:CLIP-IQA/FID 衡量渲染图片,不保证材质参数与光照解耦正确;无多视角/多光照分布外重渲染系统评估
- 控制效果缺少定量:没有结构遵循率、palette分布距离、文本属性一致率、编辑外区域漂移量等关键指标
- 公平性与容量:TileGen 类别专用,MatFuse 更广;VQ消融虽对齐总词表项数,但模型参数/算力预算仍需进一步对齐
- 高分辨率成本:512约18GB、768接近24GB,细节与可用性受到限制;未给训练墙钟成本和明确推理时间
- 平铺与分辨率无关性:固定论文不支持无缝平铺,也不是解析程序;当前的circular padding需独立验证,不能用最新文案替代原论文证据
- 复现信息不闭合:数据计数存在算术冲突,原训练集不发布,代码默认参数与论文不完全一致,condition encoder描述也存在分支数量歧义
作者未来工作与本页分析分开
Author Claim / Future Work:patch-based 方案减小高分辨率成本;引入更高级局部控制(如 ControlNet)支持单图 SVBRDF 估计;扩展 segmentation 等输入条件、加强可平铺控制。Our Interpretation:这些都需要新的训练与实验,不能从现有结果直接推导其可行收益。若优先做复现,应先关闭数据/配置差异,再讨论新架构,否则提升无法归因。
16 · 面向 Procedural Material Generation 的可执行研究延伸
Research Extension:以下均是建议实验,不是 MatFuse 已实现的功能。MatFuse 可以当目标贴图先验或评价参照,但它本身不生成 SBS/SBSAR、CompactSBS、节点类型、连线、节点顺序、shader程序;没有图有效性校验、compiler、拓扑搜索、agent反思或 renderer-in-the-loop 的测试时优化。
| 研究方向 | 具体方案与变量 | 必须做的对照 | 成功指标与风险 |
|---|---|---|---|
| 属性分块的程序生成 | 把结构、颜色、粗糙度子图设为可识别子程序,共享底层pattern节点;从图程序执行结果监督多属性latent | 无分块单序列;只分token不分执行图;同参数量模型 | 节点/边有效率、共享结构一致性、局部编辑外区域漂移;过度解耦可能破坏真实属性耦合 |
| MatFuse → 程序蒸馏 | 先生成SVBRDF目标,再检索或合成可执行材质图 \(G\),优化参数 \(\theta\) 逼近多光照渲染 | 直接图生成、仅单RGB拟合、仅贴图误差拟合 | 重渲染误差、graph复杂度、可编辑性、分辨率外推;随机贴图细节可能无法由短程序表达 |
| 执行反馈驱动搜索 | 候选图执行后比较法线/roughness/渲染残差,用具体差异选择节点替换或参数更新 | 无反馈、只CLIP打分、随机编辑、固定预算beam search | 固定执行次数下的成功率、修复率、成本;需区分拓扑搜索和连续参数优化 |
| 周期一致的联合扩散 | 训练与推理同时处理周期边界,结合shift-equivariant约束而非只decoder前padding | 原方法、仅circular padding、周期训练、周期训练+边界loss | 所有四图边界值/梯度及多尺度平铺render误差;边界变好不可牺牲整体多样性 |
| 受控属性编辑基准 | 固定结构逐步增加roughness语义,固定normal只改颜色;测量目标变化与非目标泄漏 | latent mask、像素mask、独立decoder、共享decoder | 单调性、局部遵循、像素保护、重光照稳定;需要真实物理参数标注 |
\[
(G^{\ast},\theta^{\ast})=\arg\min_{G,\theta}
\sum_{\ell,v}w_{\ell,v}
d\!\left(R(G,\theta;\ell,v),R(\hat{\mathbf{x}};\ell,v)\right)
+\lambda_{c}\operatorname{Complexity}(G)
+\lambda_{b}\operatorname{BoundaryError}(G).
\]
这是“生成贴图→可编辑程序”的建议目标:\(G\) 为节点拓扑,\(\theta\) 为连续参数,目标 \(\hat{\mathbf{x}}\) 可来自 MatFuse,\(d\) 可组合感知与像素距离。复杂度项鼓励短程序,边界项控制平铺。此目标不保证可微:连续参数可经 DiffMat 等可微执行器优化,离散节点/连线仍需搜索或结构生成;应分别记录执行失败、不可支持节点和bitmap依赖。
最值得先做的一项:在统一父材质 split 和固定预算下比较“单RGB外观loss”“四图loss”“多光照rendering loss”,并报告非目标属性编辑泄漏。它直接检验 MatFuse 最关键的物理一致性主张,且能自然连接到可执行程序拟合,而无需先训练一个庞大 agent 系统。
17 · 来源、复核路径与交付边界
- 固定原 PDF 2308.11408v3:正文、公式、Figure 1–8、Table 1–3;SHA-256 13e67b8ac17cc0964b62ae89a8e3687fa10384ee31a0ab7ecbd5e789e246d6d3
- 固定 arXiv HTML:获取主文原图资源;该转换漏了PDF teaser,图号较PDF偏移1,因此本页按PDF编号重标
- CVPR 2024 官方页:venue、页码、supplement入口;正式 DOI
- 官方 supplement.zip:架构参数、全部消融/生成/编辑/对照/近邻画廊
- 官方代码固定提交:两份config、multi-encoder、DDIM、条件编码、loss、Dataset、inference helper及后续Diffusers路径
- 作者 Hugging Face 模型卡:当前权重与集成说明,和2024论文设定分开解释。原项目页在本次直连核查返回404,未将失效页面当作唯一来源
本页完成的是原文精读、补充材料整合和静态代码审阅,不声称重新训练模型、复现实验数值或执行推理。HTML 保留单文件,MathJax 3 内嵌;主文的外部原图需联网,补充图已内嵌。按用户要求,本轮仅做静态校验,浏览器中的公式渲染、图片加载和响应式布局验收延后,没有将其标成通过。