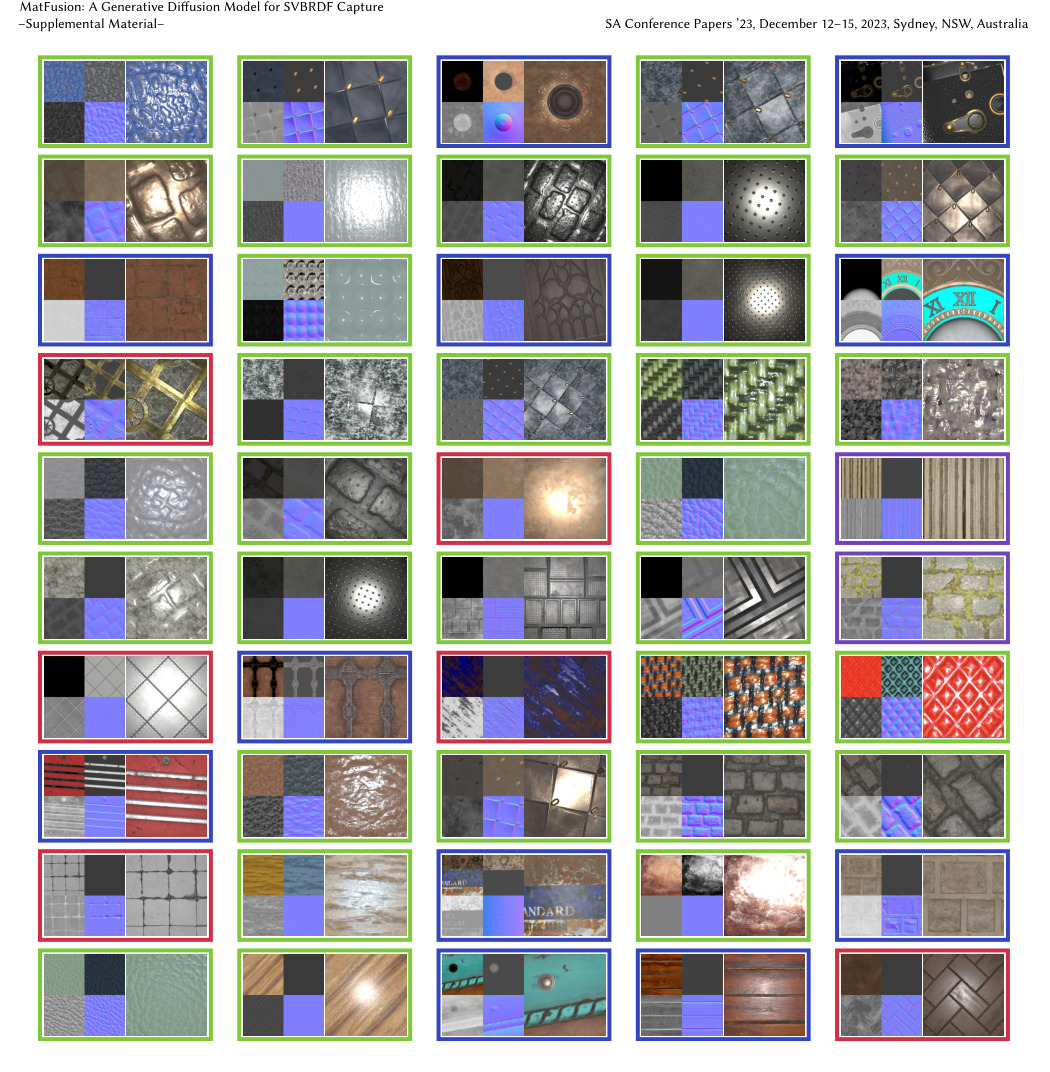
合成与增广的训练SVBRDF示例,不是312,165种独立原始实测材料
01 · 论文身份与固定版本
MatFusion: A Generative Diffusion Model for SVBRDF Capture,Sam Sartor、Pieter Peers,College of William & Mary,SIGGRAPH Asia 2023 Conference Papers,DOI 10.1145/3610548.3618194。精读依据用户保存的10页正式论文原件,另读作者主页提供的5页补充。后来的 arXiv 2406.06539v1 是2024年上传记录,不能把论文年份改成2024。
本文与2024年的 MatFuse、2025年的 MaterialFusion 是不同论文。此处 MatFusion 主要解决由照片估计平面材料的SVBRDF贴图,不是图像中的局部材质迁移,也不直接生成Substance节点图。两位作者的联系邮箱不是通讯作者角色的充分证据,未明确标记的角色保持原笔记候选状态。
02 · 核心思想:把“唯一回归答案”改成可采样的材料分布
单张照片不能唯一确定漫反射、镜面反射、粗糙度与法线;直接回归模型往往只能交付一个答案,错误时缺少替代解。MatFusion先训练一个不依赖拍摄光照的无条件SVBRDF扩散先验,再分别适配闪光照片、自然光照片、闪光/无闪光图像对。换随机seed就能得到多个合理候选,用户或评价器再选。
它直接生成10通道属性图:diffuse RGB 3、specular RGB 3、roughness 1、normal XYZ 3。不是对自然RGB图片训练好的Stable Diffusion直接套壳,也没有用VAE把材质先压进低维latent;论文在属性图空间建模。
无条件扩散底座参数量,ConvNeXt U-Net
EulerA采样;10个seed的筛选预算与单次生成不同

03 · 动机:为什么不直接最小化照片渲染误差?
照片中的亮点可能来自镜面反射,也可能被错误解释成明亮的diffuse texture。单张图的像素拟合越强,越可能把高光“烘进”漫反射、粗糙度或法线。这些解在原照明下好看,换光后却暴露物理分解错误。
作者希望生成先验提供多种符合材料分布的解释,而不是让一个优化器在欠定条件下只追逐原图误差。其训练损失在SVBRDF属性空间计算,因此条件图片可以用昂贵的路径追踪渲染,不需要对该renderer反向传播。
不要误读为“不需要rendering”:训练数据仍要渲染照片;定量评估和一种候选筛选策略也依赖渲染。省去的是穿过renderer的训练梯度,并不是省去所有光照模拟或图像生成成本。
研究目标是合理材料外观与可选候选,而不承诺严格逐像素重建或唯一真实SVBRDF。自然光未知时尤其如此。
04 · 扩散、velocity目标与信号恢复
把真实SVBRDF张量记为 \(x\)。加噪分布原文写为 \(p(x_t\mid x_0)=\mathcal N(x_0,\sigma_t^2)\),随着t增加噪声增强。在不额外缩放信号的约定下,概率流形式为:
\[\mathrm dx=-\dot\sigma(t)\sigma(t)\nabla_x\log p(x;\sigma(t))\,\mathrm dt\tag{2}\]
score指向高概率材料区域,沿反向时间数值积分逐渐去噪。作者随后归一化网络输入,写为 \(y=ax+bn\),其中高斯噪声n与系数满足 \(a^2+b^2=1\)。网络不直接输出x或n,而预测velocity:
\[v=an-bx,\qquad \mathcal L=\mathbb E_{x,n,t}\|D_{\theta}(y;t)-v\|_2^2\tag{3}\]
该目标在不同噪声强度下兼顾信号与噪声尺度。将y与v看作二维旋转变换,可反解为:
\[\widehat n=by+aD_{\theta}(y;t),\qquad \widehat x=ay-bD_{\theta}(y;t)\tag{4–5}\]
推导:把 \(y=ax+bn\)、\(v=an-bx\) 分别组合,\(by+av=(a^2+b^2)n=n\),\(ay-bv=(a^2+b^2)x=x\)。实际网络存在误差,因此公式里的恢复量是估计,不是每一步已经得到真值。
第一步与直接回归的关系
高噪声时 \(a\approx0,b\approx1\),所以 \(v\approx-x\),\(\widehat x\approx-D_{\theta}\)。论文相关段落把velocity近似写为x时省略了负号,但其Eq.(5)包含正确的负号;本页保留这一符号边界,避免实现错误。条件网络此时主要依赖照片给初步材料估计,随后迭代再修正高光烘焙、法线细节和diffuse/specular分离。
这解释“第一步像直接推断网络”,不代表初始随机场完全没有影响,也不意味着20步只是重复同一输出。这里没有每步对照片render loss做梯度下降;采样是在学习到的分布上求解去噪过程。
| Input | First Step \(\mathbb{E}_{x}\) | Full Diffusion |
|---|---|---|
 |
 |
 |
 |
 |
05 · 架构与低成本条件适配
底座参考ImageNet-256的六分辨率U-Net;输入10通道以3×3卷积映射到128特征。用ConvNeXt block替换ResNet block,希望在相近参数预算下增加激活数量,容纳更丰富的属性通道。时间t经Fourier embedding与两层MLP成为512维特征,注入各block;使用32组GroupNorm,32/16分辨率层及瓶颈含8-head self-attention。
这些是本文SVBRDF网络,不是预训练文字到图像FLUX或SDXL。论文名称里的“k-diffusion”对应其采用的velocity/采样建模方式,读者仍应按实际方程和实现检查,不把所有不同diffusion参数化混用。
\[\text{输入头:}\quad 3\times3\times10\times128\ \longrightarrow\ 3\times3\times(10+k)\times128,\qquad k=3N\]
N为条件RGB照片数;新条件通道对应权重以零初始化,保留已有先验后微调整个条件模型。与ControlNet另外复制控制分支相比,这里只扩展输入头,开销较小,但会改变原始无条件网络。不能称作保持底座完全冻结的插件。
共置闪光模型还拼接逐像素view vector作为额外条件,因为相机距离/FOV可变化。因此通用k=3N只计照片通道,不应忽略文中另加的视线向量。自然光与flash/no-flash使用不同捕获条件训练,各自有一个专用模型,不是一个通用权重无条件适配所有照明。

06 · 数据集构建与完整增广流程
| 来源/过程 | 数量 | 关键细节 |
|---|---|---|
| INRIA已有数据 | 199,068 | 由150基础SVBRDF扰动、缩放、旋转与混合得到,分辨率288² |
| Polyhaven原材料 | 307 | CC0、2K贴图;未提供specular时采样均匀值0.04–0.08 |
| AmbientCG原材料 | 1,570 | 274个带metalness,用于diffuse/specular转换 |
| 新增基础裁剪 | 1,877×16=30,032 | 裁剪512–1400像素、随机位置/旋转,再双线性缩至512² |
| 粗糙度增强 | 约6,000 | 修改上述基础集约20%,不是在总量上额外再加6,000 |
| 分段混合材料 | 83,065 | 约2/3混两材质、1/3混三材质,最后288² |
| 最终训练总数 | 312,165 | 199,068+30,032+83,065 |
| 测试集 | 50 | 31 Deep Inverse Rendering、6 Look-ahead、11 Polyhaven、2 AmbientCG;未包含在训练集 |
没有specular map的介质材料被赋予均匀specular先验;带metalness者按metalness调整diffuse并把albedo贡献加入specular。训练标签在这一步已经包含建模假设,并非所有通道都来自独立实测。
粗糙度增强(补充)
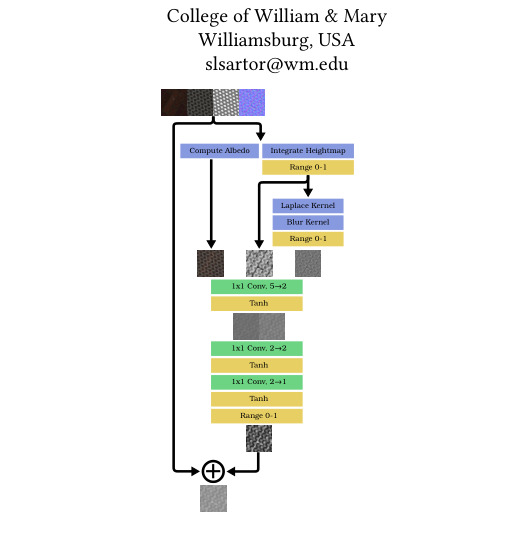
把法线积分为height并归一化,结合diffuse+specular RGB及height的高斯模糊Laplacian(σ=3)构成5通道输入。随机初始化的1×1/逐像素网络采用5→2→2→1与tanh,产生归一化R;该网络不训练,只提供非线性随机变换。与原roughness r混合:
\[r'=\sqrt{wR^2+(1-w)r^2},\qquad w=0.3+0.6R\]
对平方粗糙度混合与直接线性平均不同,不能省掉平方根或把w误当固定0.6。增强只是在标签层构造更多变化,不是论文新增一个可学习roughness predictor。
空间分段混合(补充)
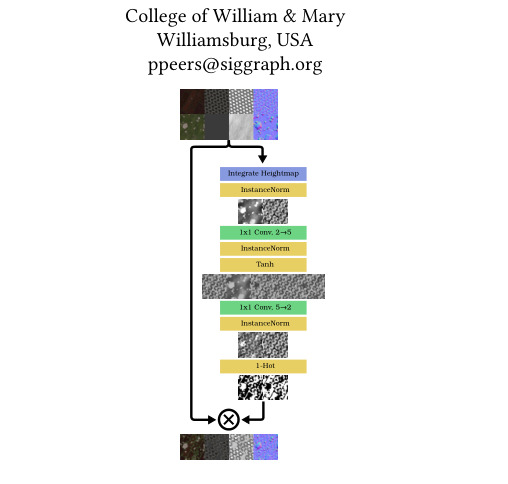
用height与颜色相关信号,经随机网络和one-hot选择形成材料区域,再把候选贴图按同一权重组合,保证多通道材料的一致混合。先对随机288²裁剪做2倍双线性放大,再平均下采样,缓解硬边。源材料在混合集中不重复使用;原材料本身仍存在于训练的其他部分,因此“混合集不重复使用”不等于所有训练样本统计独立。
补充图示与文字对混合网络输入通道描述并不完全清楚,精确复现应以数据处理脚本核对。这里不把网络结构图中的某个简化箭头臆测成所有输入的精确维度。
07 · 训练、光照渲染与采样预算
| 项目 | 无条件底座 | 每个条件模型 |
|---|---|---|
| 框架 | FLAX / JAX | 基于同底座微调 |
| 训练输入 | 312,165 SVBRDF,裁到256² | 同材料集+对应条件照片 |
| epoch | 50 | 19 |
| 优化器 | AdamW | 相同 |
| batch / LR | 32 / 2×10⁻⁵ | 相同 |
| warmup / EMA | 100,000 iteration / 使用EMA | 主文称相同超参 |
| 硬件与耗时 | 4张48GB A40,约255h | 4张A40,约102h |
| 推理 | EulerA,20步,guidance scale=1;多seed筛选需额外生成预算 | |
255/102≈2.5表示条件微调相对从头训练的时间比,不能把整个底座加三个条件模型的总成本也说成仅102小时。AdamW的完整beta、weight decay与EMA衰减未在主文列全,本页不代填默认值。
Colocated:共置相机闪光,用direct illumination即可近似背向散射条件;相机距离按相对材质尺寸的 \(\tfrac12\Gamma(2,2)\) 采样,并提供view vector。Gamma参数是scale还是rate应按代码定义核验,不能仅凭符号猜测。
Natural / Flash-no-flash:先积分normal成height geometry,用原normal作shading normal,在Blender Cycles中以32spp、OpenImageDenoise渲染,包含阴影、遮挡与间接光。从560张CC0 HDR中选择并随机旋转。两模型使用35mm虚拟相机;flash/no-flash的闪光/环境相对强度在log(1/50)至log(3/2)间采样。
| Flash w/o GI | Flash w/ GI | Natural w/o GI | Natural w/ GI |
|---|---|---|---|
 |
 |
 |
 |
训练时不对Cycles求导,因此可用更完整光照形成条件图;但输入图生成本身昂贵。当前官方README估计完整OpenEXR渲染约需1TB磁盘和数天,不能用“无需可微renderer”推导训练廉价。本文没有下载模型或这些大规模数据。
08 · 候选选择是结果的一部分
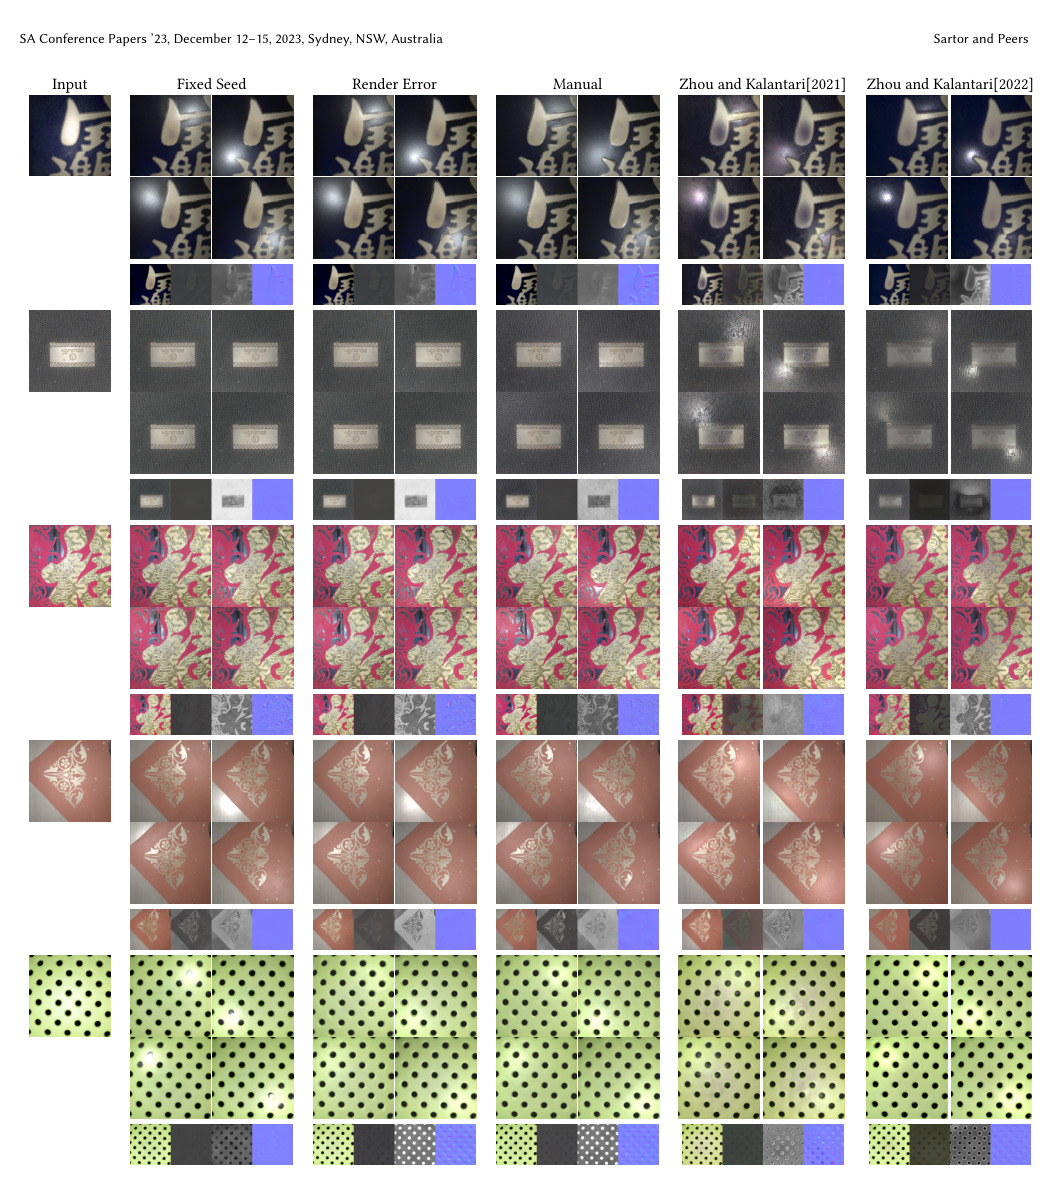
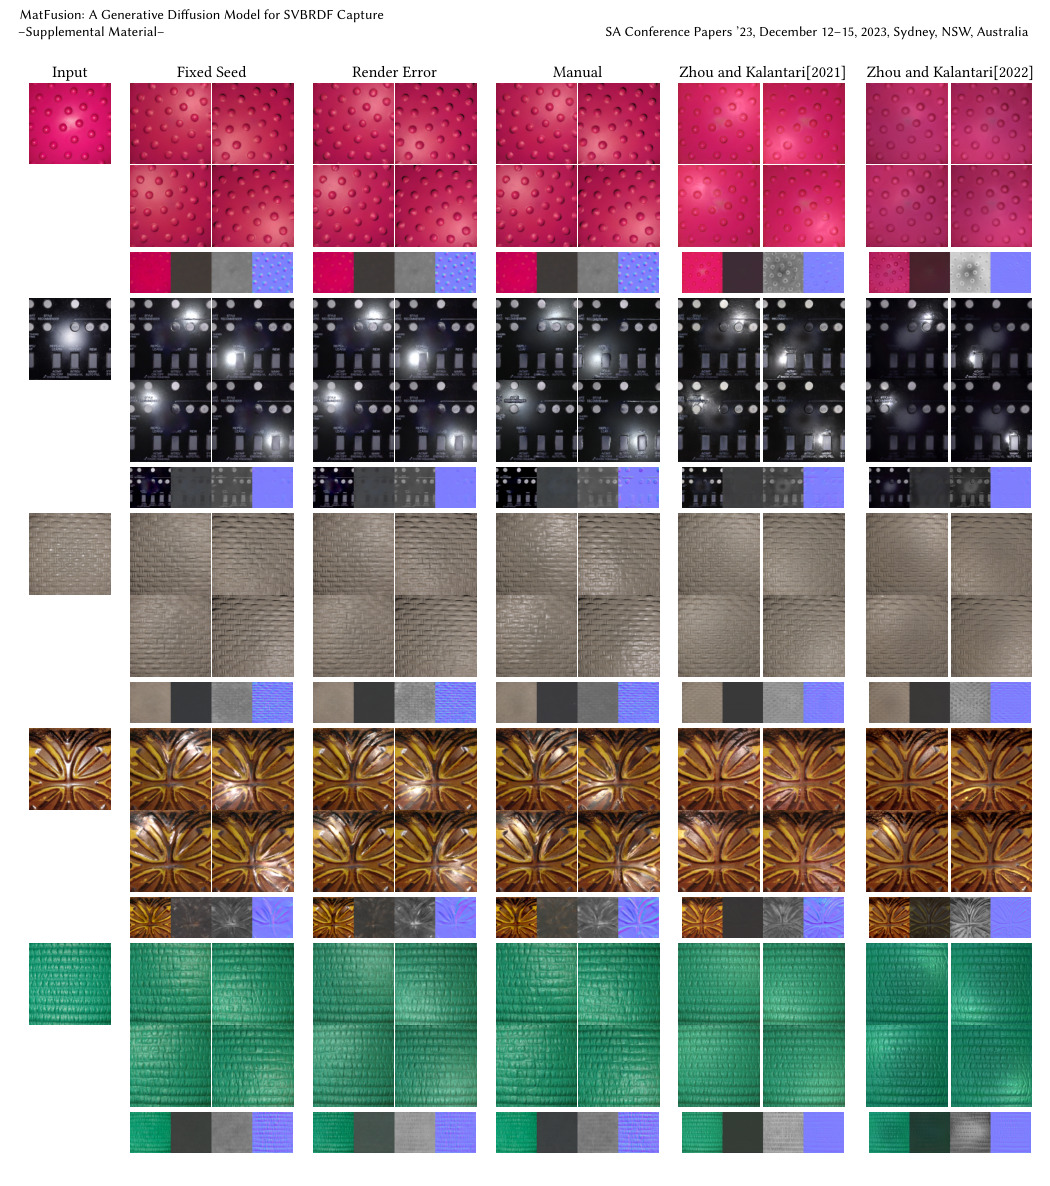
- Fixed seed:所有输入使用同一个固定seed,最接近单次自动结果
- Render error:生成10个seed,在原捕获光照下渲染,以LPIPS与输入差最小者为结果
- Manual:给用户看10个候选,主观选最合理的材料
不同策略的预算和人工参与不同,不能把manual最优数字当成一次自动推断的平均性能。render-error策略需要知道原照明,自然光未知时无法直接使用同样流程;即使知道照明,高光过曝也可能使原图误差无法区分物理合理与不合理解。
作者尝试直接优化输入随机场以降低render error,发现容易走向高光burn-in。这个观察支持“更多测试时优化不一定更物理”,但不构成对所有seed优化、所有正则和所有多视角观察的否定定理。
| Input | Fixed Seed | Render Err. | Manual | |||||||
|---|---|---|---|---|---|---|---|---|---|---|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
09 · 完整主结果与数值解读
50个测试材料各在128个半球均匀采样点光源下重新渲染,点光半径2.41以匹配对照训练设置;LPIPS评估外观,RMSE分别评估diffuse、specular、roughness与normal图,均越低越好。
原 Table 1
| LPIPS | RMSE | ||||
|---|---|---|---|---|---|
| Render | Diff. | Spec. | Rough. | Normal | |
| Adversarial | 0.2304 | 0.0439 | 0.0859 | 0.1358 | 0.0577 |
| Adversarial (retrained) | 0.2292 | 0.0405 | 0.0795 | 0.1276 | 0.0545 |
| Look-ahead | 0.2647 | 0.0591 | 0.0727 | 0.1424 | 0.0572 |
| MatFusion (fixed seed) | 0.2282 | 0.0427 | 0.0691 | 0.1252 | 0.0561 |
| MatFusion (render err.) | 0.2138 | 0.0440 | 0.0657 | 0.1282 | 0.0543 |
| MatFusion (manual) | 0.2056 | 0.0412 | 0.0666 | 0.1265 | 0.0524 |
Manual的render LPIPS=0.2056,相对原Adversarial 0.2304降低约10.8%,相对重训Adversarial 0.2292降低约10.3%。Fixed seed只有0.2282,对重训baseline的改善约0.4%。因此论文最强结果包含10候选和人工选择,不能隐藏这个条件。
各属性并非全面最优:重训Adversarial的diffuse RMSE=0.0405优于Manual 0.0412;MatFusion render-error的specular=0.0657略优于Manual 0.0666;fixed的roughness=0.1252优于manual0.1265。外观指标、像素配准和各物理通道需要分别看。
生成模型允许纹理位置微变,可能生成细节合理但不逐像素对齐的图,因此RMSE与感知外观有取舍。反过来,不能仅以“生成模型不追求对齐”为理由忽视错位对下游3D资产的影响;规整直线或特定图案需要专门评价。
| Reference | Colocated | Natural | Flash/no-flash | ||||
|---|---|---|---|---|---|---|---|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||
| Input | Reference | Fixed Seed | Render Error | Manual | Zhou et al. (2021) | Zhou et al. (2022) |
 |
 |
 |
 |
|
 |
 |
 |
 |
 |
|
 |
 | |
| Average LPIPS Render Error: | 0.1762 | 0.0984 | 0.0984 | 0.2450 | 0.2170 | |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | |
| Average LPIPS Render Error: | 0.2324 | 0.2391 | 0.2146 | 0.2930 | 0.3076 | |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | |
| Average LPIPS Render Error: | 0.3067 | 0.3129 | 0.2897 | 0.3297 | 0.3213 | |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | |
| Average LPIPS Render Error: | 0.2192 | 0.2317 | 0.2080 | 0.2350 | 0.2656 | |
 |
 |
 |
|
 |
 |
 |
 |
 |
|
 |
 |
 | |
| Average LPIPS Render Error: | 0.1764 | 0.1764 | 0.1728 | 0.2797 | 0.3967 | |
 |
 |
 |
 |
|
 |
 |
 |
 |
 |
|
 |
 | |
| Average LPIPS Render Error: | 0.3273 | 0.3044 | 0.3044 | 0.3312 | 0.3932 | |
10 · 架构消融与结论边界
原 Table 2
| LPIPS | RMSE | ||||
|---|---|---|---|---|---|
| Render | Diff. | Spec. | Rough. | Normal | |
| ResNet+Control | 0.2655 | 0.0525 | 0.0813 | 0.1536 | 0.0545 |
| ConvNeXt+Control | 0.2731 | 0.0517 | 0.0764 | 0.1428 | 0.0604 |
| ResNet+Direct | 0.2093 | 0.0432 | 0.0682 | 0.1055 | 0.0528 |
| ConvNeXt+Direct | 0.2056 | 0.0412 | 0.0666 | 0.1265 | 0.0524 |
Direct相对同backbone的Control在表中所有指标均改善,支持本任务下直接条件化有效;这并不证明ControlNet对任意扩散任务都较差。本文照片是较强约束,与sketch之类宽松条件不同,作者也明确限制结论范围。
ConvNeXt也不是所有指标一律更优:Direct中LPIPS由0.2093改善到0.2056,但roughness由0.1055变差到0.1265;Control中ConvNeXt的LPIPS0.2731还差于ResNet0.2655,normal0.0604差于0.0545。作者归因某些roughness差异为离群材料,仍不应删除反例。
缺少多seed方差与显著性统计,小幅LPIPS差异不宜过度解释。比较manual选择与网络结构时,还需确保各变体采用一致候选数和选择准则;本页保留原表,不补造未披露的选择细节。
11 · 真实材料、补充结果与失败
| Input | Reference | Ours | Zhou and Kalantari (2021) | Zhou and Kalantari (2022) | ||||
|---|---|---|---|---|---|---|---|---|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||||
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 | ||||||
| Input | SVBRDF | Render | |
|---|---|---|---|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
| Input | SVBRDF | Render | |
|---|---|---|---|
 |
 |
 |
 |
共置闪光的真实数据中有不同点光参考照片,可观察重新光照质量;作者自己用Pixel5a在自然光下拍摄的例子没有真实SVBRDF或其他光照下参考,因此只支持视觉合理性,不支持精确恢复真值。
补充展示全部50测试材料来源,以及更多自然真实材质的候选/对照。其结论包括:漫反射与粗糙度的高光烘焙减少,法线细节更均匀;许多specular图接近单色,部分源于训练集中介质先验。这些图像级观察不能等同于对每一通道的真实测量验证。
作者明确承认:难保证pixel-perfect;规则直线和人工规整图案较难;可能产生不自然blob-like法线;输出限制256×256;未知照明使自动选种子困难。Flash/no-flash的相对亮度未知可能低估diffuse或roughness,更多输入并非在所有维度必然优于共置单图。
补充 · 原始增广图与完整测试结果
以下来自作者5页补充材料;Figure1–2是数据增广流程,Figure3列全50个测试材料,Figure4–5补充真实材料对照。它们没有增加额外真值评估,仍应按正文所述证据边界阅读。
12 · 官方实现与实际复现准备
当前仓库同时提供JAX与Diffusers预训练权重,unconditional backbone标注“v1 corrected”,而条件模型列为v1。没有足够依据说明修正具体原因,不把当前corrected权重直接当成论文原训练日志。README训练例子还引用旧目录名,下载后应核对实际checkpoint名称。
基础环境声明Linux测试,CUDA≥11、CUDNN≥8.2;完整数据流水线另涉及Blender≥3.6、Rust≥1.65、Julia1.7等,而只跑demo notebook不需要全部预处理依赖。它们是当前代码部署信息,不是论文每个实验的完整环境锁文件。
数据许可也不同:新收集Polyhaven/AmbientCG材料为CC0;INRIA数据README标为CC BY-NC-ND2.0,混合集继承不同来源约束。不能因部分素材CC0就称全部训练数据与模型任意商用。本文只做私有阅读与源码核对,没有分发训练数据或模型。
可复现清单:固定checkpoint与数据版本;核对通道顺序和色彩空间;确认normal积分与GI条件;明确1样本还是10样本筛选;在新光照下计算128视角LPIPS,同时报告属性RMSE、成本和人工选择。未公开或未核验的optimizer细节保持缺失。
13 · Reviewer 与 PMG 研究延伸
优势:将欠定SVBRDF恢复显式视为条件分布;无条件先验可适配多种拍摄条件;属性空间训练避免对昂贵renderer反传;提供完整主结果、反例与候选选择策略。
不足:最强指标包含人工筛选;低分辨率、纹理对齐和规律结构不足;训练标签带有specular构造先验;真实自然光缺少真值评估;仍需为不同光照训练专用条件模型;图像漂亮不保证材料可辨识或可程序化编辑。
Research Extension:为程序化材质agent保留多个候选graph/参数解释,用多光照渲染、结构复杂度和材质合理性共同评分,而不是只最小化单张输入的LPIPS。比较单候选、固定10候选自动选、人工选与多视角选,控制相同渲染预算,才能量化evaluator真正带来的收益。
还可以将材质贴图先验与graph生成连接:先生成物理通道候选,再检索/优化可执行graph逼近。必须记录graph表达不足造成的误差,不能把贴图生成能力直接当作节点图合成。MatFusion原文没有实现这一程序化转换或LLM agent。
14 · 来源与归档说明
主文10页与补充5页均已阅读,完整重建两张原表,讨论全部主要原图及补充的数据增广/测试集/真实图像分析。官方README和公开源码仅只读检查,没有下载权重、运行推理或复现实验。
原笔记保留全部字节与PDF++锚点,新增内容追加在合并候选末尾,未改People、共享索引或用户vault。正文中的数学反解与指标计算为本次阅读推导,原文符号和证据限制已单独说明。
原图表署名Sartor & Peers,SIGGRAPH Asia2023。原图使用官方联网资源,正文和表格包含在单文件内;联网图加载、MathJax实际显示和响应式布局留待用户下载后统一验收。