先知道这篇论文证明了什么
MatLoom 的关键不是“让 LLM 写更长的 shader”,而是给它一个更小、更明确的可执行空间:共享二维场 → 有序 alpha 图层 → PBR maps。推理阶段先改设计,再在固定设计内挑噪声实现。程序与外观一起成为最终资产。
精选 prompt
4 个来源、6 个 LLM backbone、每个 prompt 3 个 run;不是训练数据集。
保留程序的中位长度
跨 backbone 汇总。短输出不等于少算力,也不证明高可编辑性。
四选一盲测偏好份额
30 人 × 20 个 prompt;固定 Flat 输出,非全面材质质量胜率。
| 资料 | 核查范围 |
|---|---|
| 完整标题 | MatLoom: Layered Text-to-Material Generation in a Compact Program Space |
| 作者 / 机构 | Anson Y. Lam · Shuqing Li · Michael R. Lyu;The Chinese University of Hong Kong |
| 版本 / 时间 | arXiv:2609.40322v1,2026-09-30;本页资料核查日期 2026-10-02;未在所读来源确认正式 venue |
| 证据基线 | 正文 §1–6、Appendix A–R、原始 Tables 1–16、Figures 1–8;官方仓库固定 commit 00d80e204497770dfbf545c5217c6971aa8db215 |
| 阅读边界 | 本页为独立中文研究解析和静态交互说明;未独立执行论文 benchmark,代码审查不等于实验复现 |
为何不直接生成贴图,或使用通用 shader 语言?
问题来自生成后的修改
光有 PBR raster maps 可以渲染,却难以追问“哪些规则把砖缝、砖块颜色和凹凸联系起来”。如果把 grout 加宽,用户真正想改的是结构参数,而不是重画几张各自独立的贴图。MatLoom 把这种关系留在源码中,使规则本身可检查、可重采样。
核心假设是一种归纳偏置
相较开放的 Blender Python 或大节点库,固定的噪声、图案、形状与层合成规则减少了 LLM 必须做出的自由选择;共享场鼓励跨通道一致。代价是表达域更窄。这个假设合理,但论文的 diffusion 对照并未隔离表示的因果贡献。
| 系统 / 标准 | 用户条件 → 输出 | 执行依赖 / 与 MatLoom 的关键区别 |
|---|---|---|
| Raster generators | 文本 → PBR raster maps | 渲染器消费贴图;缺少生成这些贴图的显式构造程序 |
| Conditional MatFormer | 文本、图像或部分图 → 程序节点图 | Substance 生态;已有文本条件程序生成先例 |
| VLMaterial | 图像 → 构造 shader graph 的 Python | Blender API;图像条件与微调方式不同 |
| MultiMat | 图像或无条件 → CompactSBS / YAML 图程序 | Substance Designer;有视觉反馈与增量验证,但原实验未评估自然语言条件生成 |
| MatLayerNet | 文本 → layer plan、参数和库内 masks | 多 agent 框架与人工整理的 mask-generator 库 |
| Material Apprentice | 文本、可选参考图与编辑指令 → 专家流程再编译成图 | Blender;最接近 text-to-procedural 的直接系统对照,但本论文未做匹配预算实验 |
| MDL / MaterialX | 作者程序或图 → 材质描述 | 语言和交换标准;是表示先例,不是学习型生成 baseline |
| MatLoom | 文本 → 共享二维表达式 + 有序图层程序 | 独立 maps executor;刻意限制原语,以可检查的局部结构换表达广度 |
研究空白不应写成“此前无法文本生成可编辑材质”。更精确的问题是:这个受限输出空间,能否让未经任务微调的模型产生足够好的外观,同时保留有用的构造关系?
把材质定义成二维场,而不是一张图
输入是自然语言材质描述 \(t\)。输出首先是可解析程序 \(P\),随后由执行器在采样窗口上评估成多通道 maps,再交给渲染器。这里的“latent”不是学习到的向量空间:论文直接在符号程序结构、数值参数和 seed 组成的空间中搜索。
View
指定 \(XY\) 平面的采样矩形;默认 (0,0,1,1),先于 Define。它改变观察区域与图案尺度,而不改变场本身。方形 raster 配非方形 window 会拉伸外观。
Define
给表达式命名;只能引用更早的定义,形成无环依赖图。共享的是同一构造关系,不是仅起说明作用的标签。
Material / Layer
Layer 自下向上排列;每层把 coverage 与表面响应组合在一起。后层覆盖先层,但 height 有独立规则。
| 对象 | 数学含义 / 单位 | 生成与编辑时的作用 |
|---|---|---|
| 位置 \(u=(x,y)\) | 二维坐标;x 向右、y 向上,长度和 height 共用 coordinate unit | 没有默认物理米制;必须配合 View 与渲染尺度解释 |
| 表达式 \(f(u)\) | 常数、坐标、算术、noise、pattern、shape 的可组合标量场 | 同一表达式可进入 mask、RGB 分量、roughness、height |
| coverage \(\alpha_i(u)\) | 0–1;对有限值进行 clamp | 决定层的可见份额;其依赖会传播到多个合成通道 |
| surface channels | sRGB color 0–255;roughness / metallic / sheen / coat / transmission / subsurface / anisotropy 为 0–1 | 表达 renderer 输入子集;不是完整 BSDF 或层内辐射传输 |
| IOR / emission / height | IOR ≥ 1;emission RGB 0–255,strength ≥ 0;height 不 clamp | height 导出 normal 与近似 AO;负高度需要能保存其范围的导出格式 |
| 种子 \(z_{\rm seed}\) | 程序中的显式整数 seed | 把结构设计和一次随机 realization 分开;同值引用一起更换 |
固定词汇表:适合哪类结构?
fBm 提供多频随机细节;Worley 提供胞元、脊线与裂缝;Bricks / Weave 提供确定的周期格点;Rect、Ellipse、Path 经 Fill 或 Stroke 转成 mask;Translate、Scale、Rotate 改写采样坐标。算术和 Threshold 把这些元素拼起来。没有通用三维几何建模、任意 shader closure 或无限节点目录。
对二值 masks,并、交、补、差可分别写为 \(\max(a,b)\)、\(\min(a,b)\)、\(1-a\)、\(a(1-b)\)。软 mask 的数值行为需要另行理解,不能直接套用集合语义。周期原语只能在兼容周期上 tile;任意程序加任意 View 并不保证无缝。
语法不是 constrained decoding:看懂 canonical grammar 的边界
program  = [ view ], { define }, material
view     = View(x1, y1, x2, y2)
define   = Define(name, expression)
material = Material(layer, ...)
layer    = Layer(coverage).channel(expression)...
这是为阅读压缩的语法示意,不是 standalone recognizer。实际语言支持算术 precedence、函数参数约束与 shape 子语法。生成器收到的是 operational reference;解码 token 没有被 grammar 强制约束。Parser 在输出以后检查 syntax、reference 和 constructor。
附录的 grammar regression 只验证 30 个生成例及选定的 malformed cases。接受集合与 canonical grammar 是否完全一致、所有表达式是否处处有限,都不能由这有限测试推得。
Appendix C / Listing 2两种合成规则,不能混为一谈
所有下式都在同一像素位置 \(u\) 上计算,省略 \(u\)。令第 1 层在最底部,\(n\) 为总层数。上层的遮挡决定第 \(i\) 层还剩多少可见权重:
\(V_i\) 是该层未被上层覆盖的份额;\(\alpha\) 是整个堆栈的总 coverage。对有限标量通道 \(x_i\),原 Eq. (1) 为:
因为 \(\sum_i V_i=\alpha\),除去透明部分后,这是各层值的凸组合。全透明点返回零,不能直接除以零。RGB 先转换到 linear light 再混合,最后映射回颜色输出;直接平均 sRGB 数值不是同一操作。
这是对原文规则的显式写法,不是新损失函数。只要上层 coverage 为正,它的高度就可以完整参与 max,哪怕 alpha 很小;被颜色遮住的底层高度也可能继续主导。因此边缘缓坡要在 height 表达式中显式乘 mask 或构造 taper。
可交互数值实验 · 本页自制
把上层 alpha 拖到接近零
底层固定 \(\alpha_1=1\)、roughness=0.85、height=0;上层 roughness=0.10、height=0.016。只模拟一个点,不运行 MatLoom renderer。
alpha 混合了 roughness,但未把实际 height 缩成一半。
Implementation Audit normal 从中心差分近似的高度梯度构造 \(\mathbf n\propto(-\partial H/\partial x,-\partial H/\partial y,1)\),归一化后按 OpenGL/+Y 约定导出。AO 使用局部均值与本地高度差的 cavity-darkening 近似,默认 radius 为 8 texels,非真实光线追踪遮蔽。窗口和分辨率共同影响坡度。normal / AO
没有被优化的训练目标
这里没有 MatLoom 专属的可微训练 loss,也没有把 renderer 梯度反传到 LLM。训练后的模型权重保持不变;Parser 提供离散错误反馈,critic 提供语言反馈,MobileCLIP2 提供排序分数,最终在程序候选集合上做选择。
依赖局部性:什么真的保持不变?
把程序分成固定结构 \(G\) 与数值/seed 坐标 \(z\),第 \(k\) 个导出通道写成 \(F_k(u;G,z)\)。\(D_k\) 是它的传递源码依赖包含的参数集合,必须包含合成时用到的 coverage 依赖。原 Eq. (2) 说:
前提是 engine 版本、设置、采样坐标固定,求值有限且确定。它是程序依赖关系的直接结果:若通道没读到任何改变的输入,输出就相同。它没有声称用户语义一定被准确分解,或屏幕上变化只发生在局部。
| 编辑 | 直接触及的依赖 | 能说什么 / 不能说什么 |
|---|---|---|
| glazeGrain | 只在上层 roughness 中出现 | 其他源固定时 color / height maps 保持;但整个反射高光可能变化 |
| glazeRipple | 同时进入 color 与 height | 颜色和浮雕一起变,normal / AO 也可能跟随变 |
| tileMask 的 mortar | 上层 coverage 和 height | 露出的 grout 与边缘 relief 同时变化,多通道改变是预期行为 |
| noise seed | 同一整数的全部引用一起替换 | 维持 seed 等价组与非 seed 文本;不能保证感知属性不变 |
| raster resolution | 采样网格、normal / AO 离散化 | 重采样同一场;不等于不同分辨率渲染逐像素或感知一致 |
Listing 1 · 原文完整两层瓷砖程序
对应 “black shiny ceramic floor tiles”,来自旗舰 seed-123 的最终程序。这里只调整排版,没有改动表达式。
View(0, 0, 2, 2)
Define(tileMask, Bricks(brick_width=0.48, brick_height=0.48, offset=0, mortar=0.02, feather=0.008))
Define(glazeRipple, fBm(octaves=3, base_freq=7, to_01=True, seed=1145088217))
Define(glazeGrain, fBm(octaves=5, base_freq=35, to_01=True, seed=1007923142))
Define(groutNoise, fBm(octaves=4, base_freq=30, to_01=True, seed=891377204))
Material(
  Layer(1)
    .basecolor((40 + (groutNoise * 12)), (42 + (groutNoise * 12)), (45 + (groutNoise * 12)))
    .roughness((0.85 + (groutNoise * 0.1)))
    .height(0),
  Layer(tileMask)
    .basecolor((12 + (glazeRipple * 6)), (13 + (glazeRipple * 6)), (16 + (glazeRipple * 6)))
    .roughness((0.04 + (glazeGrain * 0.05)))
    .coat(0.95)
    .ior(1.53)
    .height(((tileMask * 0.016) + ((tileMask * glazeRipple) * 0.0012)))
)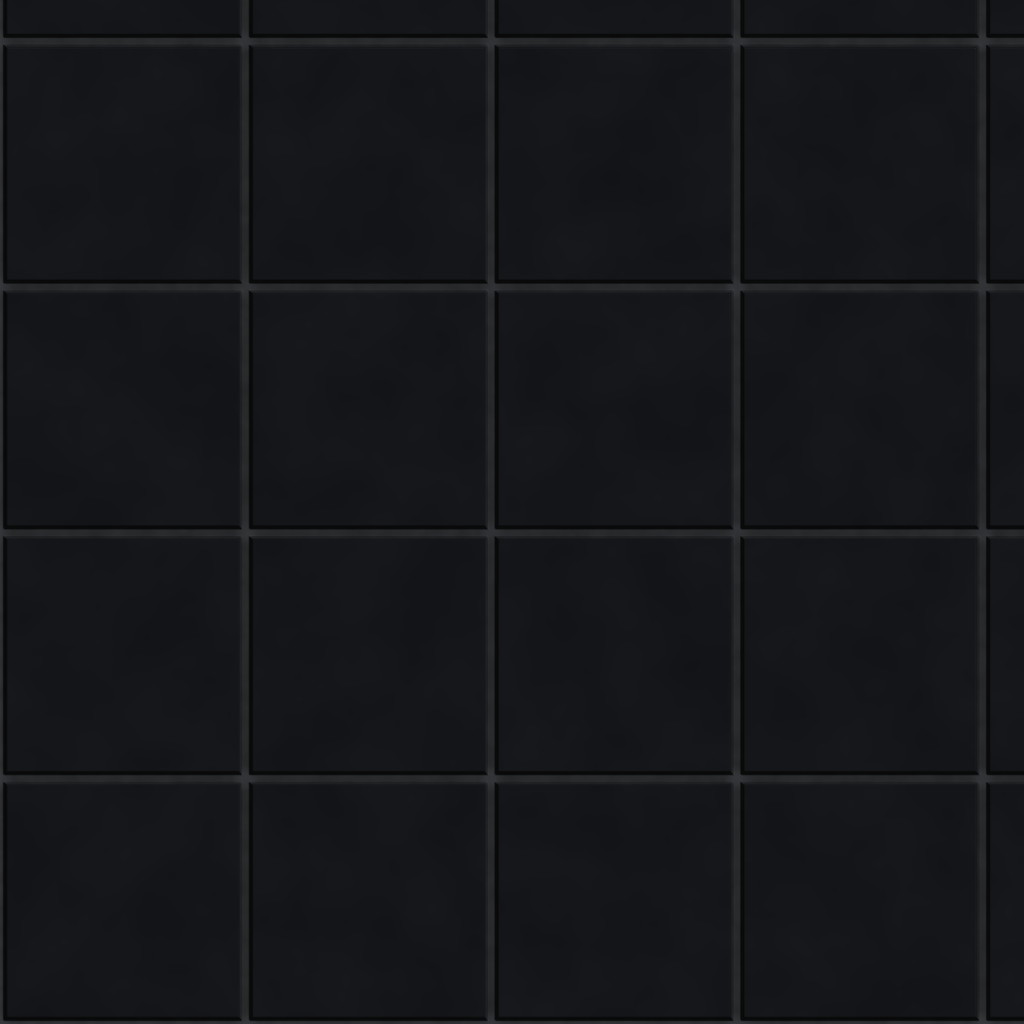 Original · 原始程序
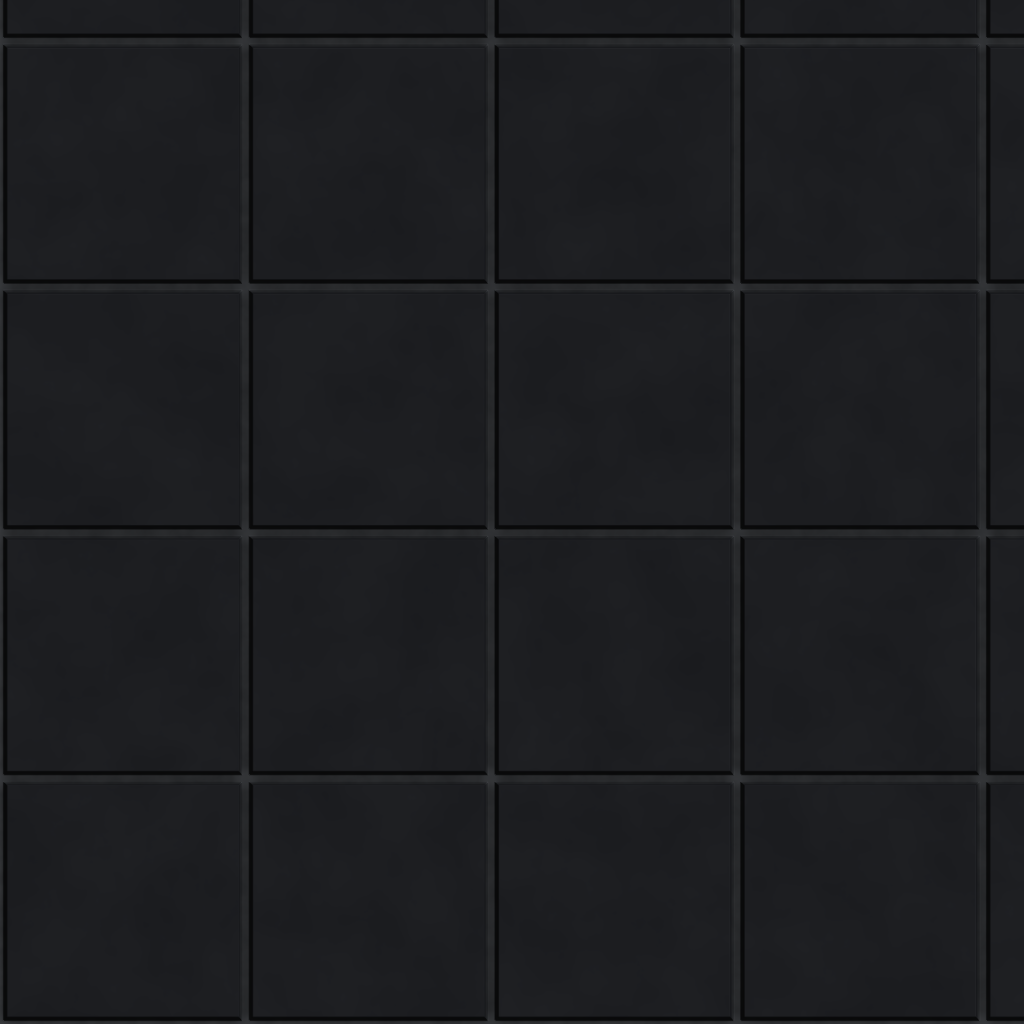 Higher roughness · 0.04 → 0.75
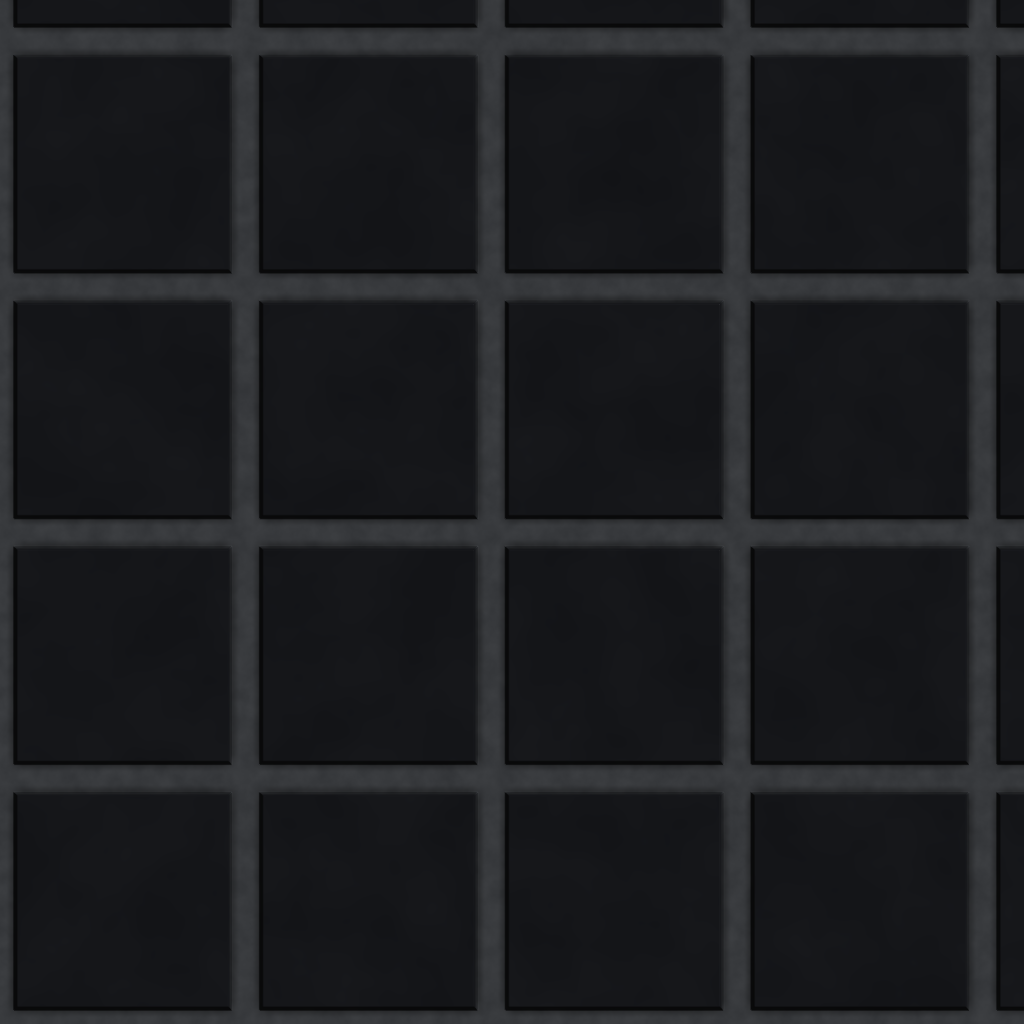 Wider grout · 0.02 → 0.06
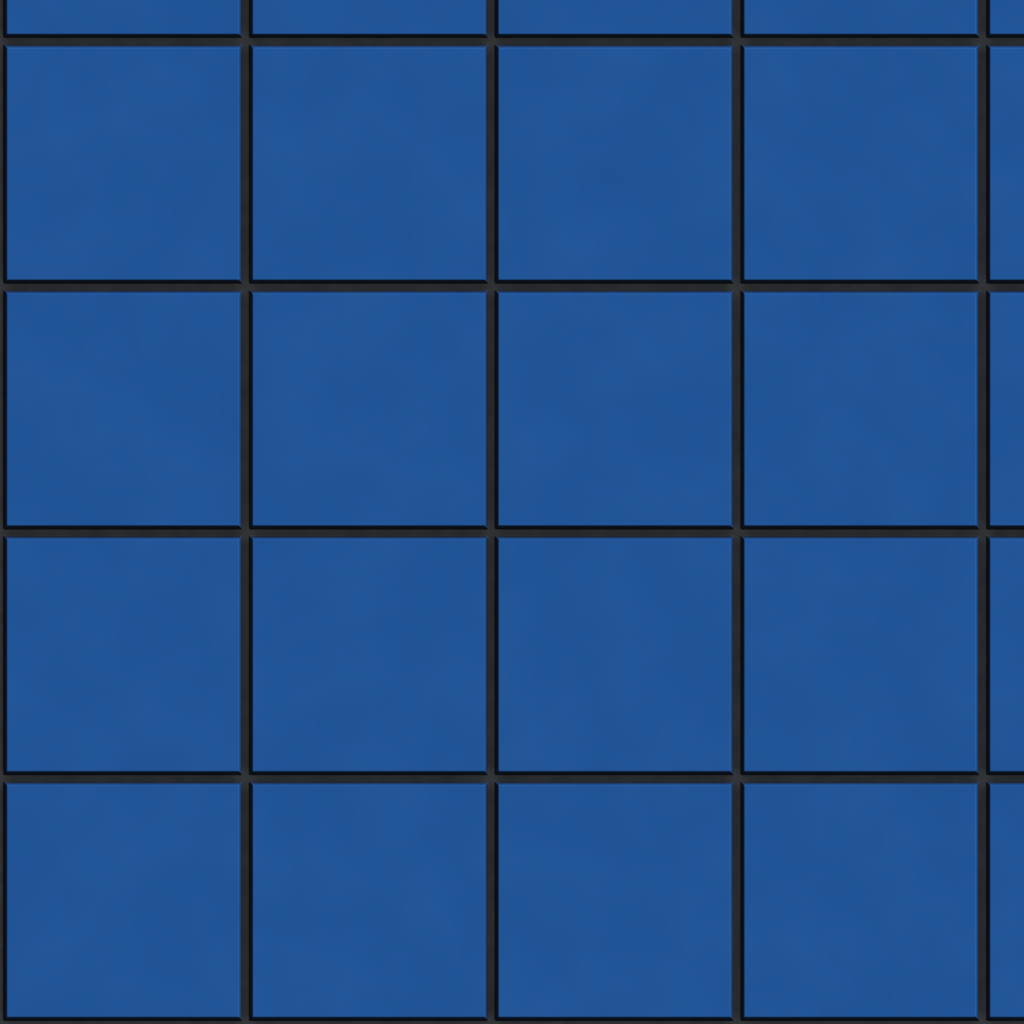 Blue glaze · RGB offsets (25,75,140)
依次为原始、提高 roughness、加宽 grout、蓝色釉面。其余源码和三个噪声种子保持不变。它验证一个程序的依赖关系,未评估自动编辑成功率。 原图与 caption
命名字段是否不可替代?已有一个有价值的语义控制
2,538 个保留的初始程序中,2,514 个(99%)使用 Define。把每个引用替换成表达式副本、保持显式 seed 后,源码长度中位增加到 1.4 倍,全部测试程序能重新 parse 且导出 maps byte-identical。
这说明命名字段是可测的序列化与复用选择,而不是不同视觉语义。以后可在同一语义下比较 named / inlined 对生成、错误率、编辑的影响。相反,去除图层分组的等价表示尚未建立:它必须同时保留零 coverage 分支、linear-light color 和 max-height 规则,普通加权和不能替代。
Appendix Q.4执行器、预览器与验证的层级
确定的是字段求值
Python reference 采样并导出 maps;TypeScript port 供浏览器检查编辑。canonical program 把所有随机 seed 固定下来。只有同 engine、同 settings、同 sampling coordinates,才能把差异归因于编辑。
渲染器是不同的观察环境
quick preview 是正视 swatch 与固定方向光,近似 Blinn–Phong、Fresnel、sheen、subsurface、transmission;最终外部评价使用 Blender。前者没有完整 global illumination 或物理折射。
| 检查层 | 能建立的事实 | 无法推出的保证 |
|---|---|---|
| Parse / constructor | 语法、命名引用、构造器参数能被接受 | Sqrt 的输入仍可能在局部为负;不保证所有字段有限、所有输出可渲染 |
| Canonical grammar fixtures | 有限的 serialization 与错误样例通过 | 不证明所有 parser-accepted 程序等于规范语言的全集 |
| Python ↔ TypeScript exact fixtures | 选定 arithmetic、hard pattern、shape fill、序列化和 packed bytes 的测试值一致 | 硬边界测试避开边缘;不能推出所有坐标相同 |
| Approximate fixtures | 超越函数与多 octave noise 约 10⁻¹¹;fBm / relief 约 10⁻⁶–10⁻⁵ 等容差 | 浮点路径仍可能不同;容差不是渲染图像相等 |
| Worley / GPU / export 特例 | Python 64-bit hash,TypeScript 32-bit hash;WebGPU preview 不在跨 engine 比对里 | 同 Worley seed 不保证相同场;browser IOR packing 到 [1,3],Python 可保留更大值 |
执行成功、数值有效、视觉可信、跨引擎一致、用户编辑正确,是五个不同命题。MatLoom 的 parser 是第一道门,而不是完整 verifier。
真正的 Agent 在哪一层?
MatLoom 是由 harness 固定编排的生成—执行—反馈循环。LLM 没有任意控制 Blender 或动态发明工具;它的 action 主要是返回程序或修订程序。解析、预览、统计、排序、seed 重写与终止预算由 Python orchestration 决定。
Mermaid 源码 · 本页自制流程图(根据 §4 与原 Figure 7)
静态 SVG 从以下 Mermaid 节点与连线生成;没有引入在线 Mermaid runtime。原 Figure 7 的算法摘要采用 HTML/矢量排版,本页重新绘制信息流,不能作为原实验图像。
flowchart TD
    T["用户文字 + DSL 规范 + 6 个示例 + playbook"]
    G["Generator:产生 material 程序"]
    P["Parser:语法 / 引用 / 构造器检查"]
    R["最多 3 次纠错响应"]
    C["Canonicalize:所有 noise seed 显式化"]
    O["512² preview + 128² 通道统计 + source"]
    K["Fresh critic:score / differences / suggestions"]
    U["原 author 对话追加反馈并 revision"]
    S["6 个轨迹程序:q512 选择 j"]
    V["去重候选:P0、Pj、P5"]
    W["各保留原程序 + 1000 个 seed 变体;q256"]
    B["最佳 P*:固定源程序资产"]
    E["环外:Blender Flat / Staged + 4 个对齐指标"]
    T --> G
    G --> P
    P -->|错误| R
    R --> G
    P -->|通过| C
    C --> O
    O --> K
    K -->|前 5 次| U
    U --> P
    K -->|末次不再修订| S
    S --> V
    V --> W
    W --> B
    B --> E
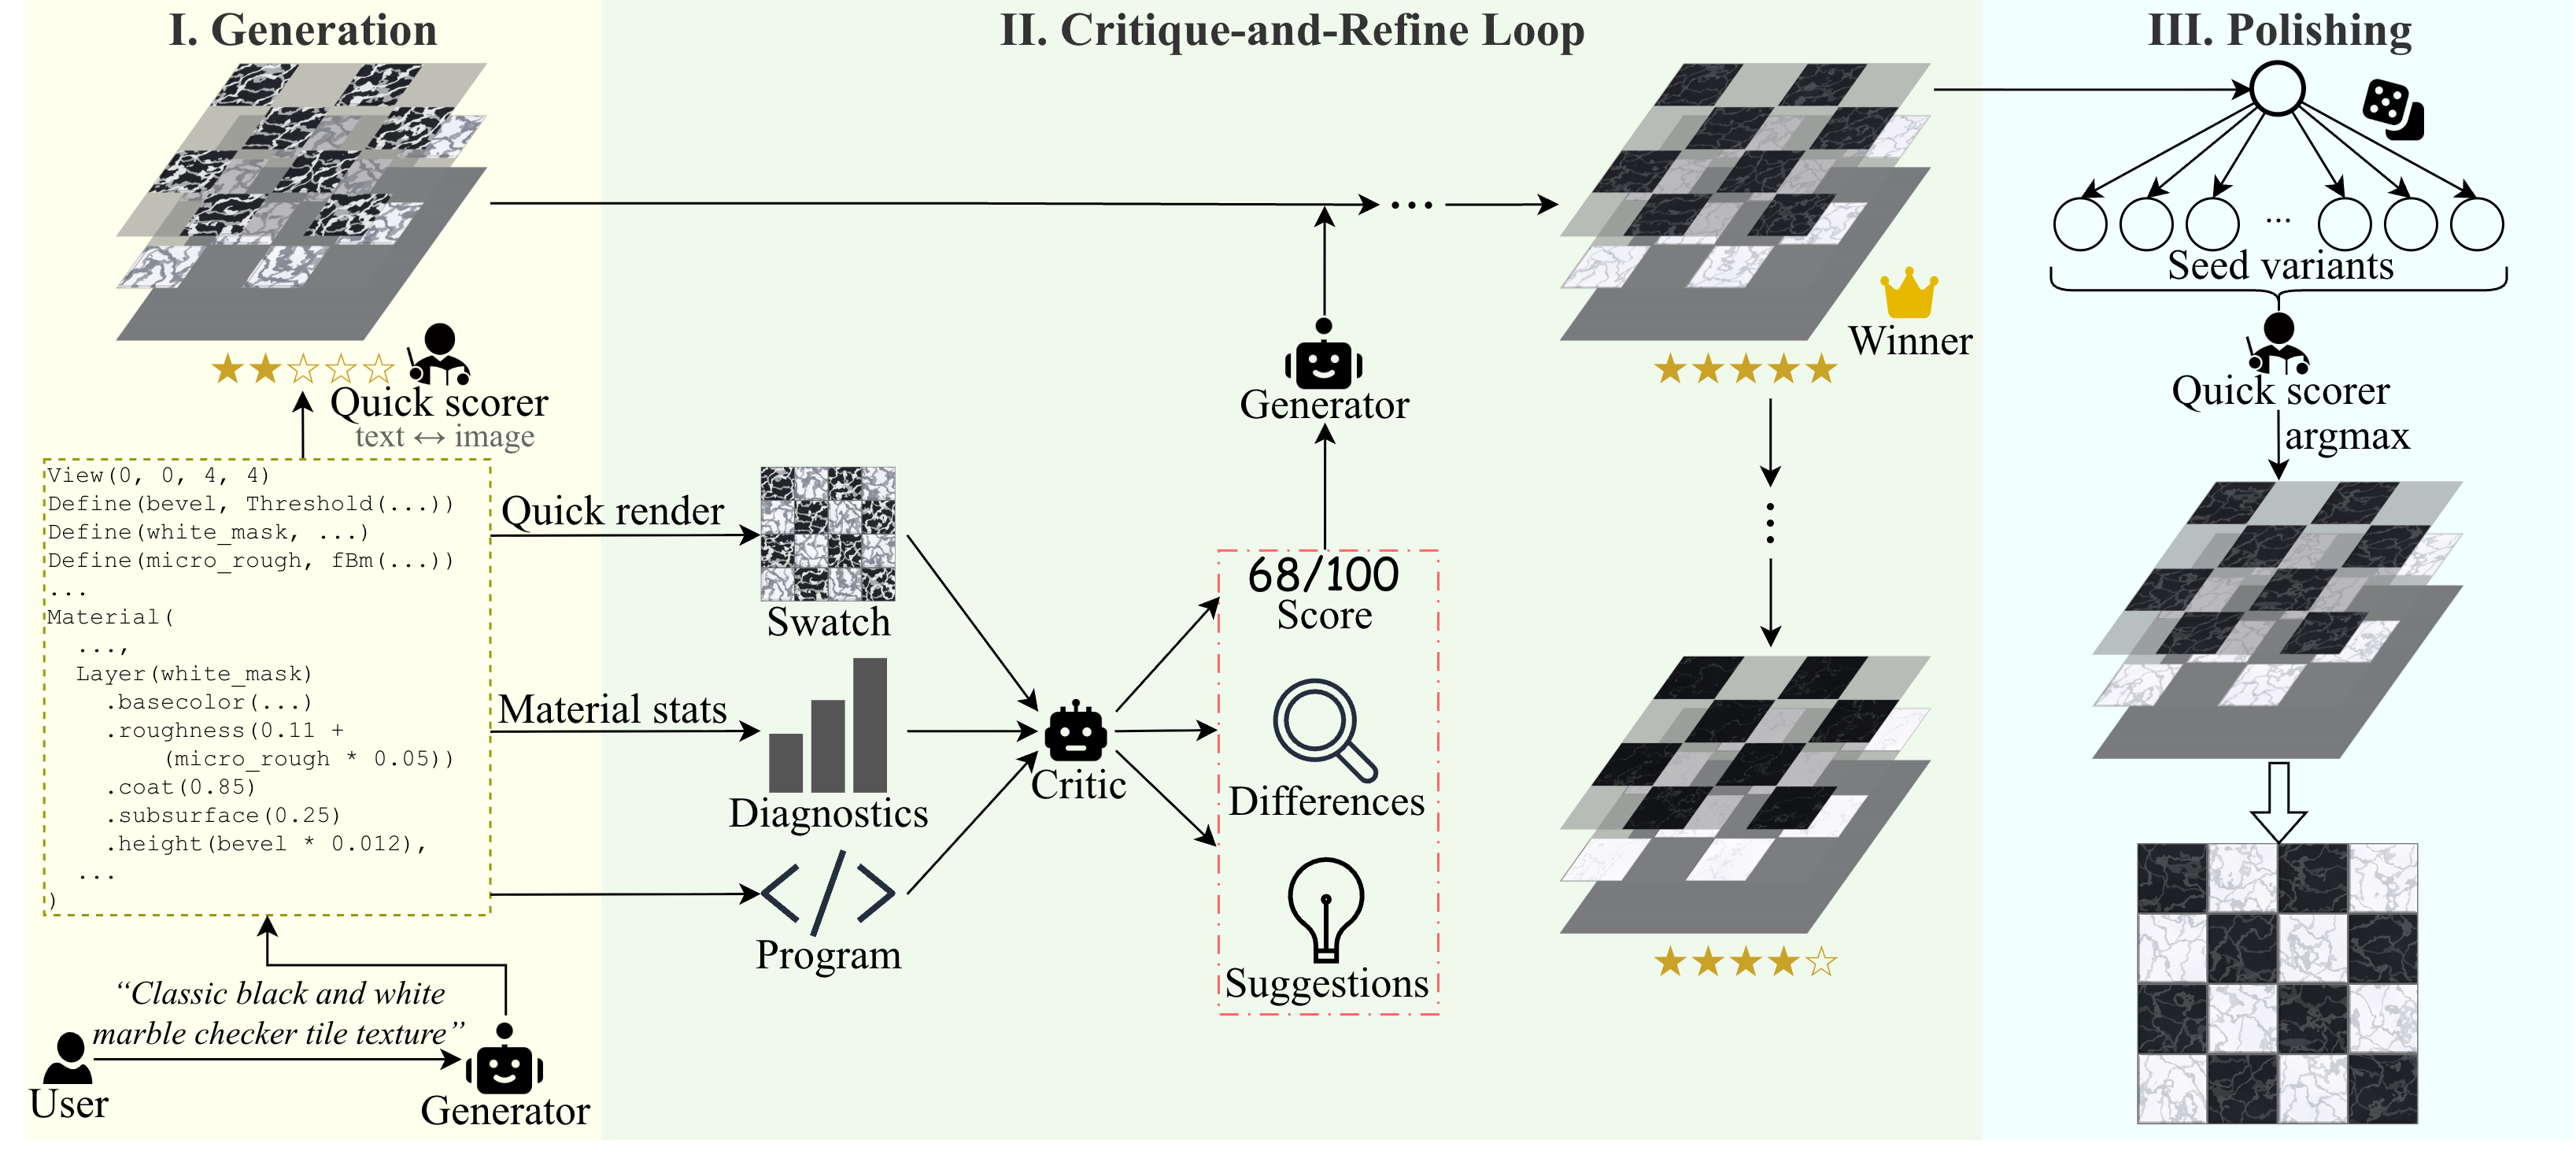 原 Figure 3 · authoring 概览
原图只画一个候选的 seed sweep,真实算法会对初始、选中、末轮程序去重后分别搜索。图中的中间程序、星级与 68/100 是信息流示意,不是测量轨迹。 原图与 caption
| 术语 | 在本系统中的具体对象 | 发生在哪里 |
|---|---|---|
| Reasoning / planner | 模型依据 DSL、案例、prompt 组织图层与表达式;没有单独训练的 planner | author generation / revision;内部 reasoning token 未作为可复现实验记录 |
| Action / executor | 输出完整 material 源;Python parser 与 maps evaluator 负责执行 | 每轮解析与 canonicalization |
| Observation | parser error;512² quick preview;28 个 128² unlit-map descriptors;可选 source | repair / critic 输入;DeepSeek 与 GLM 不收图片 |
| Critic / reflection | fresh critic 返回 match_score、differences、suggestions;author 接收文字反馈再写完整程序 | critic 新对话,author 保持生成对话 |
| Trajectory / memory | P₀…P₅ 与对应反馈;保留 author 对话上下文 | 当前 run 的短期历史;没有跨任务学习的记忆模块 |
| Evaluator / reward | MobileCLIP2 quick score 排序与 seed search;不是 critic 自报的 match_score | Stage III;不更新 LLM 权重 |
| Harness / retry | 固定工具顺序、parse retry、canonical seeds、候选去重、打分与预算 | 真正控制 test-time computation 的外层程序 |
Stage I:产生可执行初稿
system context 包含角色、DSL reference、六个例子、organic-texture playbook,要求单个 material block。Parser 拒绝时把错误文字送回 author,至多三次 corrective response;这不是三轮视觉优化。成功后 canonicalize,补全随机 seed,得到 \(P_0\)。
Stage II:改变“设计”
每个 \(P_d\) 都可生成 preview、统计与源码输入给 fresh critic。critic 默认与 author 同 backbone 和 sampling settings。author 收到原 prompt 与 critique 后修订,提示要求未变层连 seed 一起逐字保留。五次 revision 形成六个程序;六次 critique 的最后一次不再触发 revision。
Stage III:从设计中挑“实现”
令 \(q_r(P,t)\) 为程序的 \(r\times r\) quick render 与文本 “A photo of t” 的 MobileCLIP2 分数。先在 512² 预览上选轨迹位置,平分时取最早:
此式是原文算法的明确写法。每个候选 \(P_d\) 的 \(\mathcal S_K(P_d)\) 包含原程序及 \(K=1000\) 个仅替换 seed 的变体。所有相同 seed 引用同步替换,非 seed 文本保持。用 256² preview 选最终程序:
无 seed literal 的候选不会产生新 seed 变体,搜索退化为原程序。具体预算还受候选去重影响。同一 run 中 winning design 可以来自初稿、被选中的中间轮或最后一轮。因此它不只是“给最后程序换 seed”。从 512² 到 256² 也改变输入图,两个 proxy 的排序不必一致。
Prompt 与 context:工程细节也是方法的一部分
公开材料提供了实际 operational specification、六个 few-shot、critic schema 与 revision instruction。它们不是训练样本,而是每次 authoring 的上下文。本文不把 prompt 设计包装成新增模型架构。
| Prompt 部件 | 包含什么 | 为什么重要 |
|---|---|---|
| 角色与 output contract | 技术美术角色;只返回一个 <material>…</material> block | 让程序提取边界稳定;输出格式仍要事后检查 |
| DSL operational reference | View / Define / Material 顺序、channel range/default、原语签名、compositing | 缩小误用空间;只是上下文,不是 token-level constrained decoding |
| 两个易错点 | constant height 没有坡度,linear height 才有倾斜;颜色遮挡与 max-height 分开 | 防止模型把高度当亮度或把 over 规则错误搬到 relief |
| 六个 few-shot | 一至四层的材质案例 | 提供可模仿的分解;有效性需要公平对照,不能从有例子即推收益 |
| critic output schema | match_score(0–100)、differences、suggestions | 前者是 critic 自评;后两项经文字转成 author 的下一轮输入 |
| revision instruction | 围绕原描述修正;完整返回程序;未修改层及其 seed 保留 | 减少不必要漂移,但这是提示要求,不是所有生成过程都自动满足的证明 |
| Idiom | 中文解释 | 潜在通道耦合 |
|---|---|---|
| Multi-octave layering | 低频 fBm 控制大形,高频 fBm 控制细粒 | 分别复用不同尺度,而不是把一份 noise 到处硬套 |
| Anisotropic striation | 不同 x/y frequency 拉成长条 | 树皮、拉丝金属方向结构 |
| Coordinate-domain warping | 先用 noise 扭曲坐标,再送入 Sin 等周期图案 | 颜色条纹与 height 共享扭曲后的 pattern |
| Micro-gloss grain | 高频低幅 fBm 只加入 roughness | 皮革、树皮、石材细小光泽变化 |
| Substrate-matrix-first | 底层 Layer(1) 连续基底,上层 threshold mask 离散特征 | 覆盖为空的位置自然露出基底 |
28 个统计量:补充观察,但不是隐藏的真实答案
统计来自未打光的 channel maps,覆盖 albedo、texture、roughness、metallicity、height、normal tilt、occlusion 和其他表面通道,并带有解释。它们能指出“高度几乎平坦”“metallic 很低”等源状态,减少仅从照明后的 RGB 反推通道的歧义。
统计量不含目标材质的 ground truth,也不能判断“这个图案是不是长颈鹿皮”。它们与 source code 都可能增加 context 长度,甚至把 critic 注意力拉离图像;Table 9 的结果正提醒不能预设“信息更多一定更好”。
Q.7matloom/engine/diagnostics.py评测协议:比较的是完整系统
数据与 run 单位
141 个 prompt 来自 Hu et al. (2023) 类别(30)、MatSynth 描述(11)、StableMaterials(50)、text2fabric(50)。超过 50 条的来源用 sentence-embedding space 的 farthest-point sampling 压缩到 50,选定列表固定用于所有方法。包含 figurative 与高度具体的 motif,因而测试了受限词汇的边界。
没有 MatLoom train/validation split、optimizer、learning rate、batch size、epoch 或 LoRA:该方法无任务专用训练。六个 pretrained backbone 直接推理,procedural seeds 为 42、123、2026,每个 backbone 每个 prompt 三个记录 run。模型名中看似参数量的字符串不应被当作论文核实的架构规格。
| Backbone(原文标识) | critic 是否接收 preview | 角色 |
|---|---|---|
| gemini-3.6-flash | 是 | 事后比较六个 backbone 后选出的旗舰 |
| gpt-5.6-luna | 是 | 主实验之一;组件与 cross-critic 诊断固定使用它作为 generator |
| gemma-4-26b-a4b-it | 是 | 主实验 / cross-critic |
| qwen3.6-35b-a3b | 是 | 主实验 / cross-critic |
| deepseek-v4-flash-0731 | 否 | 文本-only critique,source + stats |
| glm-5.2 | 否 | 文本-only critique,source + stats |
同场景,不等于同通道路由
全部系统导出 512×512 maps,用同一 Blender 场景评估 Flat 和 Staged。但 MatLoom 的 height 接 geometric displacement;StableMaterials 的 height 接 bump;MatFuse 与 IntrinsiX 无 height;例子中的 transmission 只由 MatLoom 提供。Staged 更能展示 relief / transmission,也更受这些不等路由影响。
| Method | Backbone | Steps | Guidance | Height map |
|---|---|---|---|---|
| MatFuse | latent diffusion | 50 | 5.0 | ✗ |
| StableMaterials | SD-class LDM + LCM | 4 | 10.0 (LCM) | ✓ |
| IntrinsiX | FLUX.1-dev + LoRA | 28 | 3.5 | ✗ |
| MatLoom (ours) | LLM program | n/a | n/a | ✓ |
四个 alignment proxy 与一个独立质量诊断
| Metric | 测量对象 / 本文口径 | 主要限制 |
|---|---|---|
| BLIPScore | BLIP 系列图文匹配代理;原表归一化到 0–100,越高越好 | 语义匹配不等于物理材质正确;不能解释成用户成功概率 |
| CLIPScore | 图像与文本 embedding 相似度,评估文本套用 photo template | 可能对纹理、全局语义敏感;同属 CLIP 家族的优化 proxy 相关性需警惕 |
| VQAScore | 视觉问答模型对图像符合给定文字的判断分数 | 继承 VQA 模型偏差,细小材质差异和布局会改变判断 |
| MLLM Judge | claude-sonnet-5,原文报告 temperature 0;0–100 fidelity 判断 | 不是人类共识;模型、prompt、render route 都影响评分 |
| MobileCLIP2 | 推理环内 quick-render scorer;512² selection / 256² seed search | 它是优化目标,不是主结果列;提高它不保证提高上面四项 |
| CLIP-IQA | 不读取目标描述的 image-quality proxy,单独在 Table 14 报告 | 图像质量与 prompt alignment 不同,不能选择性互相替代 |
指标实现:两个确切公式与其余 wrapper 的范围
Implementation Audit 只读固定 commit,没有加载或运行评分模型。令 \(\ell_0,\ell_1\) 为 BLIP2 ITM 两类 logits,匹配类分数为:
代码加载 blip2_image_text_matching、model_type=pretrain、head=itm。这个归一化模型分数不是人类正确率。
CLIPScore 使用 OpenCLIP ViT-L-14、laion2b_s32b_b82k。对图文向量 \(v_I,v_t\) 各自 L2 归一化:
这是该仓库口径,不额外套其他 CLIPScore 文献中的 2.5 缩放。VQAScore wrapper 默认 t2v_metrics.VQAScore(model=clip-flant5-xl),将输出 clamp 到 [0,1] 后乘 100;MLLM judge 为 VqaDirect 的 JSON reasoning + score,temperature 默认 0;CLIP-IQA 使用 TorchMetrics quality prompt pair,不读取本题目标 prompt。
BLIP2 ITMCLIP normalizeCLIP backboneVQAScoreCLIP-IQA统计单位与置信度
主均值先对同一 prompt 的三个 run 平均,再跨 141 个 prompt 平均。成对推断使用 per-prompt means、双侧 Wilcoxon signed-rank、10,000 次 percentile bootstrap。Holm correction 覆盖旗舰相对三 baseline 的 24 个对照(两布局 × 四指标 × 三 baseline)。旗舰在看完六 backbone 后选出,所以即便校正,论文仍将检验定位为探索性。
主结果:读均值,也要读不一致
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Method | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| IntrinsiX (Kocsis et al., 2025) | 29.94 | 24.29 | 43.61 | 56.10 | 20.96 | 21.80 | 41.97 | 49.60 |
| MatFuse (Vecchio et al., 2024) | 8.27 | 20.12 | 30.61 | 36.36 | 8.58 | 19.25 | 30.56 | 33.63 |
| StableMaterials (Vecchio, 2026) | 28.57 | 25.66 | 45.36 | 57.41 | 21.33 | 23.59 | 45.53 | 54.29 |
| MatLoom (gemma-4-26b-a4b-it) | 33.56 | 25.46 | 47.12 | 47.48 | 22.07 | 22.48 | 47.43 | 40.17 |
| MatLoom (qwen3.6-35b-a3b) | 35.64 | 25.70 | 46.36 | 45.80 | 21.93 | 22.55 | 46.60 | 37.47 |
| MatLoom (deepseek-v4-flash-0731) | 46.42 | 27.29 | 51.06 | 53.38 | 30.49 | 23.93 | 51.04 | 45.11 |
| MatLoom (glm-5.2) | 42.44 | 26.78 | 50.36 | 53.88 | 27.85 | 23.78 | 50.50 | 46.28 |
| MatLoom (gpt-5.6-luna) | 48.78 | 27.61 | 49.56 | 56.80 | 31.55 | 24.51 | 49.75 | 47.02 |
| MatLoom (gemini-3.6-flash) | 56.06 | 28.80 | 54.71 | 67.01 | 36.14 | 25.30 | 54.26 | 57.34 |
粗体为原表最优均值;虚线下划线为本页额外标出的第二高均值。默认保留原表全部方法、两种布局与四个指标,不删负面结果。
旗舰的 Flat 优勢明显
相对 StableMaterials:BLIPScore +27.49,CLIPScore +3.14,VQAScore +9.35,Judge +9.60。原文把它们四舍五入成 +27.5 / +3.1 / +9.3 / +9.6;BLIPScore 差的 95% CI 为 [21.8, 33.3],这组 Flat 检验均报告显著。
不是“所有 LLM 在所有指标胜出”
六个 MatLoom 配置在 Flat BLIPScore 上都高于最强 diffusion baseline;但 Flat judge 只有旗舰超过 StableMaterials。其余五个为 45.80–56.80,StableMaterials 是 57.41。
表格交互 · 数据来自 Table 1
换一个评价视角
条形图轴固定 0–100;“相对最佳 baseline”仅为均值差,不据此追加显著性结论。
Alignment 与 image quality 的分叉
Table 14 的 Flat CLIP-IQA 最好的是 StableMaterials(52.17),旗舰为 47.21;Staged 最好的是 GLM 配置(30.12),旗舰为 24.63。这不是与主实验矛盾:它问的是未给 prompt 的图像质量,主实验问的是 prompt fidelity。
Table 14 · 完整 image-quality diagnostic
| Method | Flat CLIP-IQA | Staged CLIP-IQA |
|---|---|---|
| IntrinsiX | 46.51 | 24.08 |
| MatFuse | 19.39 | 10.68 |
| StableMaterials | 52.17 | 21.27 |
| MatLoom (gemma-4-26b-a4b-it) | 47.51 | 28.95 |
| MatLoom (qwen3.6-35b-a3b) | 44.65 | 28.42 |
| MatLoom (deepseek-v4-flash-0731) | 49.68 | 29.00 |
| MatLoom (glm-5.2) | 49.19 | 30.12 |
| MatLoom (gpt-5.6-luna) | 44.09 | 24.25 |
| MatLoom (gemini-3.6-flash) | 47.21 | 24.63 |
按 prompt 来源看,Judge 排名也会变
旗舰在四个来源的 BLIP / CLIP / VQA 均值都高于 StableMaterials,但 judge 在 Hu et al. 与 StableMaterials 来源更低;MatSynth 和 text2fabric 的 judge 优势较大。因此总体均值携带了 benchmark 组成信息,不能假设对任意材质请求同样有利。
Table 15 · 完整 per-source breakdown
| BLIPScore | CLIPScore | VQAScore | Judge | |||||
|---|---|---|---|---|---|---|---|---|
| Source (\(n\)) | ours | SM | ours | SM | ours | SM | ours | SM |
| Hu et al. (\(30\)) | 45.12 | 30.30 | 27.53 | 26.12 | 63.50 | 58.39 | 71.43 | 72.59 |
| MatSynth (\(11\)) | 73.72 | 28.46 | 30.83 | 25.05 | 59.04 | 42.69 | 76.30 | 38.82 |
| StableMaterials (\(50\)) | 48.24 | 34.34 | 26.83 | 25.17 | 43.98 | 36.64 | 56.35 | 59.40 |
| text2fabric (\(50\)) | 66.55 | 21.80 | 31.09 | 26.00 | 59.21 | 46.85 | 72.97 | 50.39 |
多轮与搜索:何时有收益,何时只是 proxy 变高?
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Stage | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| Round 0 | 48.31 | 27.70 | 53.34 | 61.35 | 30.95 | 24.37 | 52.67 | 52.98 |
| Round 5 | 51.86 | 28.25 | 52.93 | 67.61 | 33.23 | 24.91 | 53.43 | 56.82 |
| Selected | 54.17 | 28.71 | 53.97 | 66.56 | 35.50 | 25.25 | 54.07 | 57.20 |
| Final (full) | 56.06 | 28.80 | 54.71 | 67.01 | 36.14 | 25.30 | 54.26 | 57.34 |
初稿已达到 Flat BLIPScore 48.31,超过所有三个 diffusion baseline;后续过程不是把零能力“修成可用”。Round 0→5:BLIP +3.55,Judge +6.26,但 VQA −0.41。Selected 相对 Round 5 的 BLIP +2.31,Judge 却 −1.05(原 Table 6 基于未四舍五入分数报告 −1.04)。最终 67.01 的 Judge 仍低于 Round 5 的 67.61。
Selection 的 42.1% 胜率如何理解?
对 Flat BLIPScore,Selected 比 Last 胜 178/423(42.1%),负 137(32.4%),平 108(25.5%)。胜率低于 50% 并不代表大部分 run 变差,因为还有大量平局。每指标 Oracle 每次偷看外部评价来选不同程序,是可达上界,不是可部署 selector。
Tables 5–7 · round-wise、selection 与 seed-search 完整数值
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Round | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| 0 | 48.31 | 27.70 | 53.34 | 61.35 | 30.95 | 24.37 | 52.67 | 52.98 |
| 1 | \(+\)1.30 | \(+\)0.13 | \(-\)0.76 | \(+\)3.71 | \(+\)0.57 | \(+\)0.27 | \(+\)0.02 | \(+\)1.80 |
| 2 | \(+\)1.74 | \(+\)0.22 | \(-\)0.41 | \(+\)4.19 | \(+\)1.38 | \(+\)0.40 | \(+\)0.22 | \(+\)2.28 |
| 3 | \(+\)1.89 | \(+\)0.31 | \(-\)0.40 | \(+\)3.87 | \(+\)1.66 | \(+\)0.46 | \(+\)0.37 | \(+\)3.32 |
| 4 | \(+\)2.95 | \(+\)0.38 | \(-\)0.75 | \(+\)3.32 | \(+\)2.02 | \(+\)0.46 | \(-\)0.02 | \(+\)3.04 |
| 5 | \(+\)3.55 | \(+\)0.55 | \(-\)0.41 | \(+\)6.26 | \(+\)2.28 | \(+\)0.54 | \(+\)0.76 | \(+\)3.84 |
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Program | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| First | 48.31 | 27.70 | 53.34 | 61.35 | 30.95 | 24.37 | 52.67 | 52.98 |
| Selected | 54.17 | 28.71 | 53.97 | 66.56 | 35.50 | 25.25 | 54.07 | 57.20 |
| Last | 51.86 | 28.25 | 52.93 | 67.61 | 33.23 | 24.91 | 53.43 | 56.82 |
| Oracle | 64.80 | 30.01 | 60.71 | 79.24 | 44.48 | 26.31 | 60.42 | 69.07 |
| Win rate | 42.1 | 41.4 | 38.1 | 30.5 | 42.8 | 43.3 | 36.4 | 35.0 |
| \(\Delta\) | \(+\)2.31 | \(+\)0.45 | \(+\)1.04 | \(-\)1.04 | \(+\)2.27 | \(+\)0.34 | \(+\)0.64 | \(+\)0.38 |
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Polished | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| First | \(+\)2.22 | \(+\)0.17 | \(+\)0.49 | \(+\)0.64 | \(+\)0.23 | \(+\)0.08 | \(+\)0.33 | \(+\)0.27 |
| Selected | \(+\)1.54 | \(+\)0.12 | \(+\)0.22 | \(+\)0.13 | \(+\)0.17 | \(+\)0.04 | \(+\)0.09 | \(+\)0.59 |
| Last | \(+\)1.63 | \(+\)0.18 | \(+\)0.36 | \(+\)0.11 | \(+\)1.09 | \(+\)0.09 | \(+\)0.25 | \(+\)0.90 |
| Mean | \(+\)1.80 | \(+\)0.16 | \(+\)0.36 | \(+\)0.30 | \(+\)0.50 | \(+\)0.07 | \(+\)0.22 | \(+\)0.59 |
搜索预算回放:便宜的前缀能拿走多少 proxy gain?
| Budget \(K\) | Mean gain | % of \(K{=}1000\) | Runs at best (%) |
|---|---|---|---|
| \(1\) | \(+0.25\) | 18 | 0 |
| \(10\) | \(+0.68\) | 48 | 1 |
| \(50\) | \(+0.96\) | 67 | 6 |
| \(100\) | \(+1.07\) | 75 | 9 |
| \(250\) | \(+1.21\) | 85 | 22 |
| \(500\) | \(+1.34\) | 94 | 50 |
| \(1000\) | \(+1.42\) | 100 | 100 |
预算滑块 · 仅重述已记录的 replay
上限按三个 distinct designs 计算;若 selected 与首/末轮重合则更少。10 个变体拿到 48% 的 quick-score gain,不能推成拿到 48% 的外部 fidelity 提升,也不能当作准确 runtime 预测。
CMA-ES 为什么没有成为主搜索?
探索性版本改连续 numeric literals,frequency 用 log space,channel 权重带 bounds,排除 View 与底层 alpha;\(\sigma_0=0.25\),每候选 500 次评价。对于一个 red-brick prompt,匹配 500 budget 时 continuous search 的平均 proxy 增量 +1.6,大于 seed-only 的 +0.2,却有视觉结构变坏的例子;13 个候选中 3 个未提高起点分数。
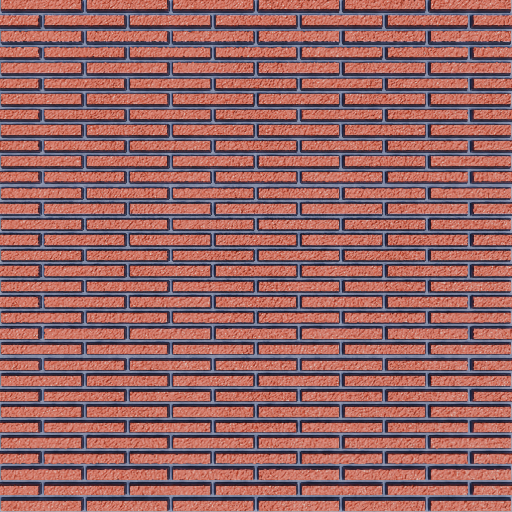 独立 run 1 · proxy +2.0
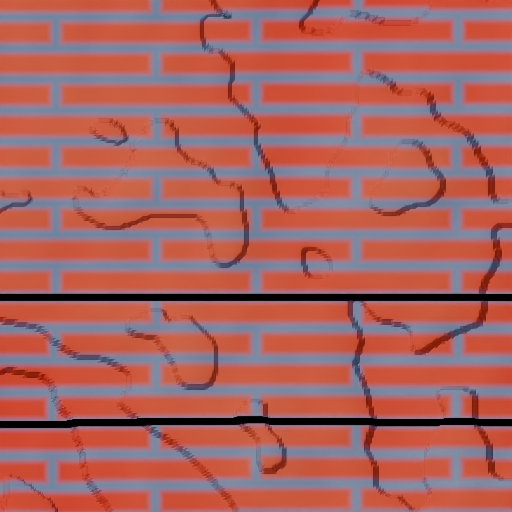 独立 run 2 · proxy +3.7
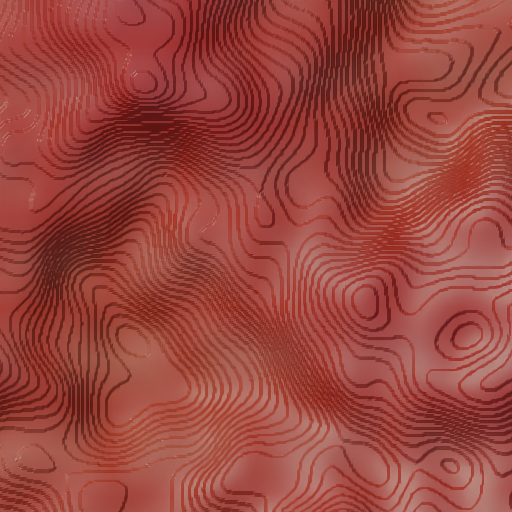 独立 run 3 · proxy +0.7
这是“a red brick wall”的三个独立 run,按作者主观视觉判断排列,不是优化的连续三个步骤。quick scorer 分别提高 +2.0、+3.7、+0.7,中间样本得分涨得最多。 原图与 caption
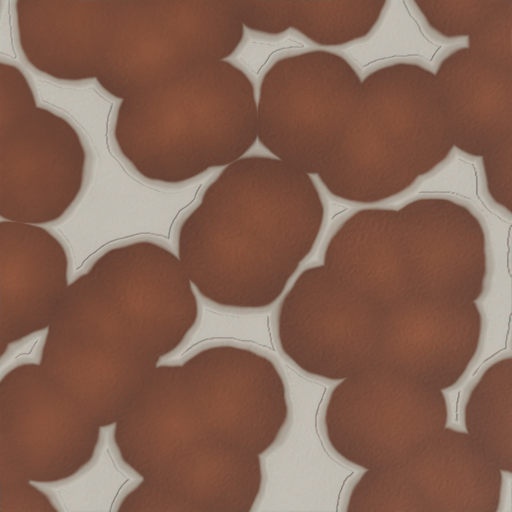 Round 0
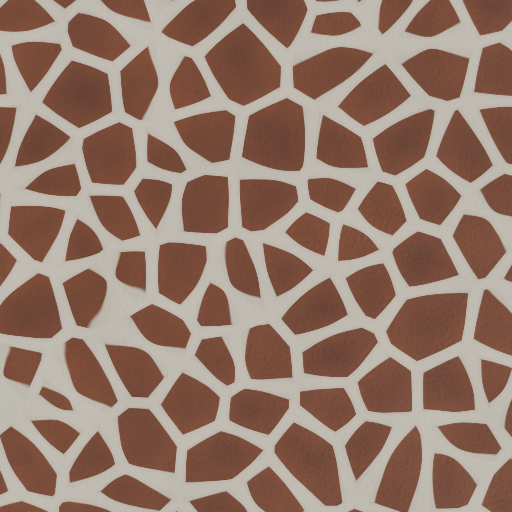 Round 1
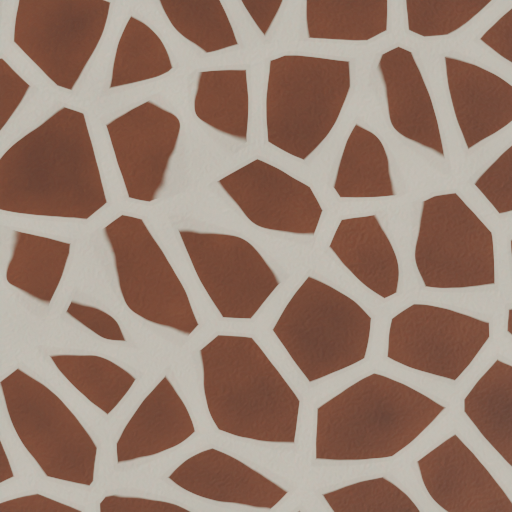 Round 2
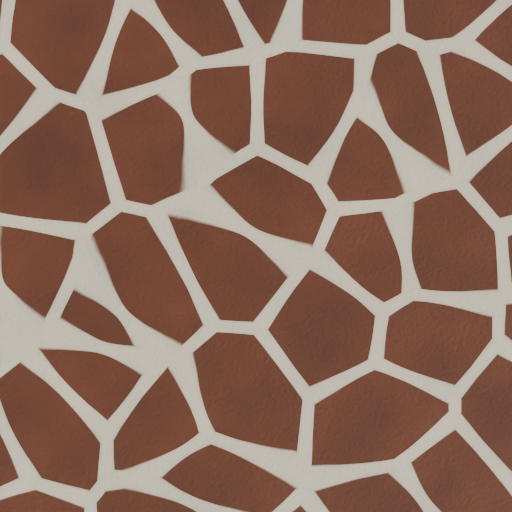 Round 3
 Round 4
 Round 5
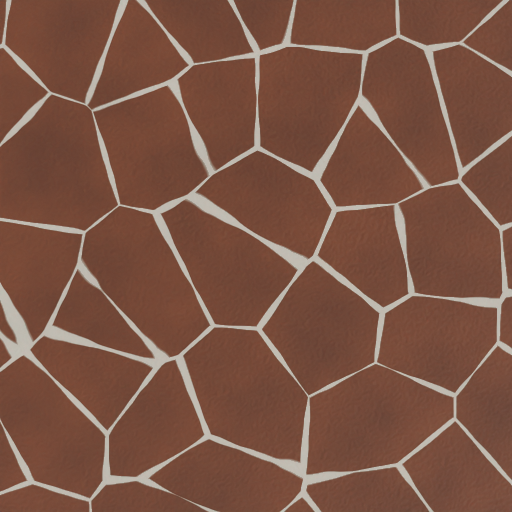
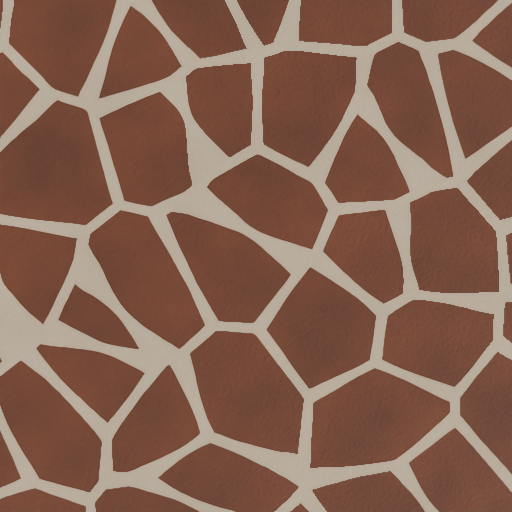
Round 0–5 展示形状与边界变化。该例 Flat BLIPScore 从 2.8 到 99.8,Round 5 judge 比 Round 0 高 16;经过筛选,不能视为典型轨迹。polished final 因 scorer 接受了污斑而未展示。 原图与 caption
组件分析:一组有价值但受混杂的反例
Table 9 的 full reference 与其他 variants 存在 temperature 不匹配,而且每个 prompt 只有一次 GPT authoring run。其形式像 ablation,证据等级却是探索性 configuration comparison。成对 prompt 控制不了 sampling temperature 或 stochastic run variance。
移除 source 反而更高
w/o code critique 在八项指标的均值都高于 reference:Flat BLIP +6.96,Judge +7.59。这提醒 context 不是越多越好,但不能隔离为“code input 有害”的因果效应。
不同 critic 优化不同外观
换 Gemini critic 的 Flat BLIP 增量最大(+3.56);Gemma 的 Flat / Staged judge 增量最大(+11.53 / +13.77)。DeepSeek 与 GLM 又缺少视觉输入,改变的不只是模型身份。
Table 9 · 组件配置原始数值
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Configuration | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| Full (ours) | 51.23 | 27.53 | 50.01 | 56.76 | 32.90 | 24.48 | 49.95 | 47.60 |
| w/o playbook | \(-\)4.99 | \(-\)0.52 | \(-\)1.47 | \(-\)0.08 | \(-\)4.66 | \(-\)0.54 | \(-\)1.30 | \(-\)1.87 |
| w/o few-shot | \(-\)1.06 | \(+\)0.32 | \(+\)1.60 | \(+\)0.69 | \(-\)2.53 | \(+\)0.18 | \(+\)2.06 | \(+\)2.40 |
| w/o both | \(+\)0.52 | \(+\)0.31 | \(+\)0.78 | \(+\)0.21 | \(+\)0.17 | \(+\)0.14 | \(+\)0.61 | \(+\)0.64 |
| w/o render critique | \(-\)6.84 | \(-\)1.03 | \(+\)0.08 | \(-\)2.42 | \(-\)4.27 | \(-\)0.55 | \(-\)0.10 | \(-\)1.64 |
| w/o code critique | \(+\)6.96 | \(+\)0.99 | \(+\)2.57 | \(+\)7.59 | \(+\)4.10 | \(+\)0.96 | \(+\)3.06 | \(+\)4.72 |
| w/o diagnostics | \(-\)1.32 | \(-\)0.06 | \(-\)0.34 | \(+\)2.75 | \(-\)3.67 | \(-\)0.21 | \(+\)0.29 | \(-\)0.71 |
| w/o render + code | \(-\)4.10 | \(+\)0.30 | \(+\)1.32 | \(+\)2.12 | \(-\)0.83 | \(+\)0.29 | \(+\)1.43 | \(+\)2.05 |
| w/o render + diag. | \(-\)4.92 | \(-\)0.36 | \(-\)0.70 | \(-\)3.28 | \(-\)4.04 | \(-\)0.32 | \(-\)1.59 | \(-\)1.13 |
| w/o code + diag. | \(+\)2.73 | \(+\)1.62 | \(+\)2.71 | \(+\)8.50 | \(+\)3.76 | \(+\)1.07 | \(+\)2.98 | \(+\)4.45 |
Table 10 · cross-critic 原始数值
| Flat | Staged | |||||||
|---|---|---|---|---|---|---|---|---|
| Critic | BLIPScore | CLIPScore | VQAScore | Judge | BLIPScore | CLIPScore | VQAScore | Judge |
| Self (gpt) | 51.23 | 27.53 | 50.01 | 56.76 | 32.90 | 24.48 | 49.95 | 47.60 |
| Gemini | \(+\)3.56 | \(+\)0.99 | \(+\)1.74 | \(+\)5.08 | \(+\)1.77 | \(+\)0.83 | \(+\)2.01 | \(+\)2.99 |
| DeepSeek | \(-\)0.40 | \(-\)0.13 | \(+\)1.22 | \(-\)2.80 | \(-\)0.04 | \(+\)0.09 | \(+\)1.17 | \(+\)0.65 |
| GLM | \(-\)8.57 | \(-\)0.51 | \(+\)0.87 | \(+\)7.16 | \(-\)2.20 | \(-\)0.14 | \(+\)2.23 | \(+\)10.20 |
| Qwen | \(-\)5.75 | \(-\)0.53 | \(-\)1.22 | \(-\)4.71 | \(-\)4.37 | \(-\)0.34 | \(+\)1.75 | \(-\)2.44 |
| Gemma | \(-\)6.92 | \(-\)0.28 | \(+\)0.40 | \(+\)11.53 | \(+\)0.53 | \(+\)0.20 | \(+\)1.75 | \(+\)13.77 |
人类盲测支持什么,样本不确定性在哪里?
| Method | Share of forced choices (%) | Mean fidelity (\(1\)–\(7\)) |
|---|---|---|
| MatLoom (ours) | \(\mathbf{59.2}\) \([55.8,62.7]\) | \(\mathbf{4.98}\) \([4.73,5.21]\) |
| StableMaterials | \(19.3\) \([16.5,22.3]\) | \(3.60\) \([3.31,3.89]\) |
| IntrinsiX | \(15.3\) \([13.3,17.2]\) | \(3.01\) \([2.77,3.26]\) |
| MatFuse | \(6.2\) \([4.3,8.2]\) | \(2.27\) \([2.07,2.49]\) |
30 位参与者、20 个 prompt(每来源 5 个)、80 张 seed-123 的 Flat renders。每题四个匿名结果以 2×2 展示,选择最符合描述的一张,并给每张图 1–7 分。MatLoom 在每个位置恰好出现五次;位置随 prompt 固定,不随参与者重新随机。trial order 对每人随机,分两组,中间有 attention check。
全部参与者通过 attention check,无排除,共 600 次选择。MatLoom 份额 59.2%,StableMaterials 19.3%,相差 39.9 个百分点;平均评分 4.98 对 3.60。原始 paired rating gap 为约 1.37,95% CI [1.15,1.61];仅用表中四舍五入均值相减会得到 1.38。
prompt-level Wilcoxon p=4.4×10⁻⁴,participant-mean p=6.5×10⁻⁷。30 人都比偏好任一单一 baseline 更常选择 MatLoom,每人选中 8–17 次;20 个 prompt 中 13 个独占 plurality,另 1 个并列,17 个的平均评分高于 StableMaterials。
来源与参与者背景
| Prompt source | MatLoom | StableMaterials | IntrinsiX | MatFuse | Rating gap |
|---|---|---|---|---|---|
| GenProc | \(40.7\) | \(35.3\) | \(12.0\) | \(12.0\) | \(+0.35\) |
| MatSynth | \(62.0\) | \(8.7\) | \(26.7\) | \(2.7\) | \(+1.95\) |
| StableMaterials | \(57.3\) | \(18.7\) | \(17.3\) | \(6.7\) | \(+1.13\) |
| text2fabric | \(76.7\) | \(14.7\) | \(5.3\) | \(3.3\) | \(+2.06\) |
无图像创作经验的 10 人,MatLoom 份额 60.0%;有经验的 20 人为 58.8%。来源层面 GenProc / Hu 类别仅 40.7%,text2fabric 为 76.7%;每来源只有五题,差异仅描述性。题目完成中位耗时 36.5 秒,600 trial 中 192 条提供自由文本理由。
问卷中英双语,参与自愿并有 informed consent;可选收集后续联系邮箱,所以是 confidential 而非严格 anonymous。分析排除了邮箱并使用去标识数据。
真实 Figure:展示能力,也展示选择条件
 Wood planks
 Black slate flooring
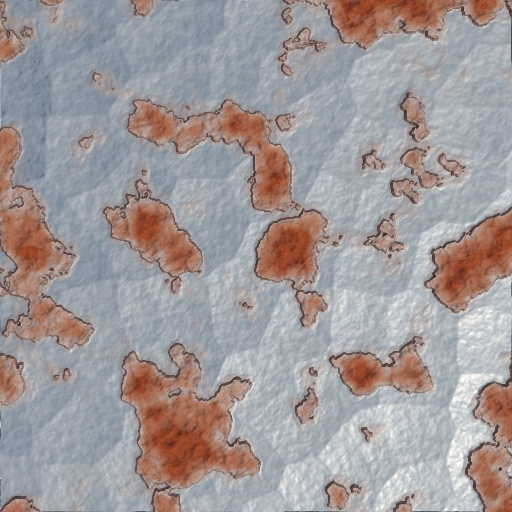 Hammered rusty metal
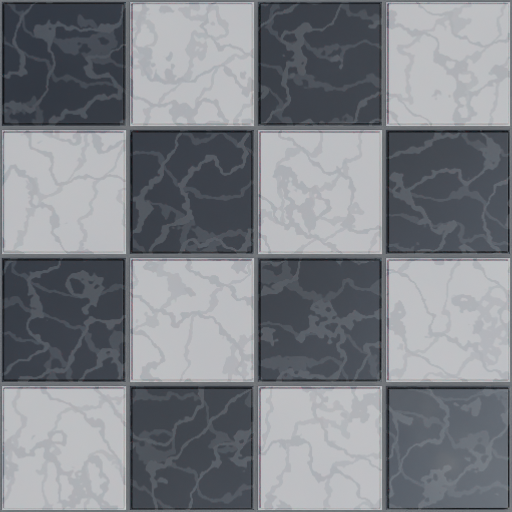 Black and white marble checker tile
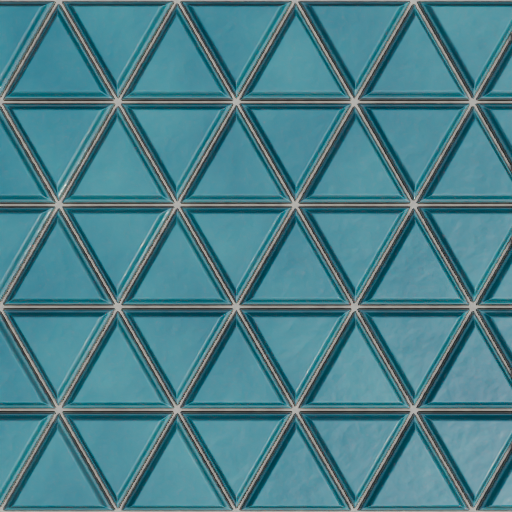 Triangle ceramic tiles
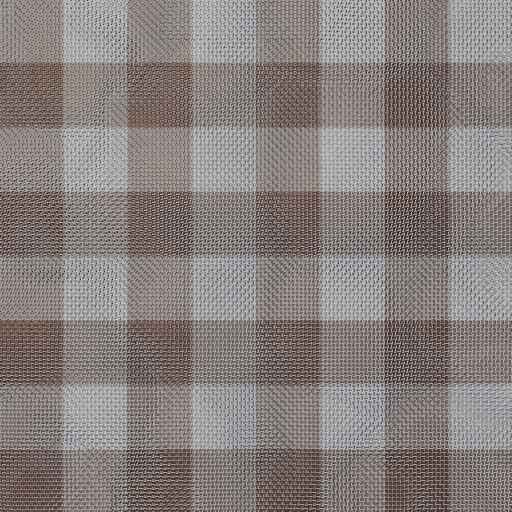 Brown and white checkered cotton fabric
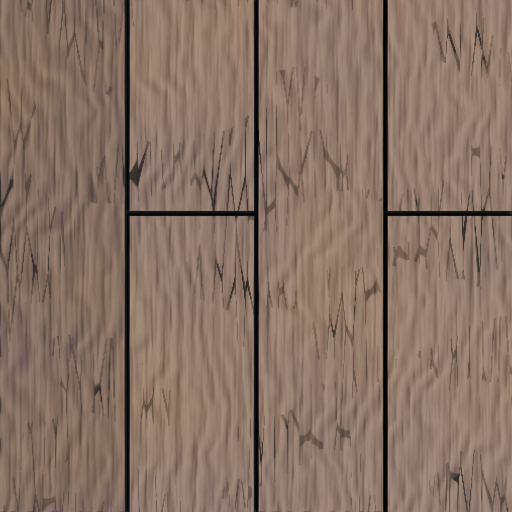
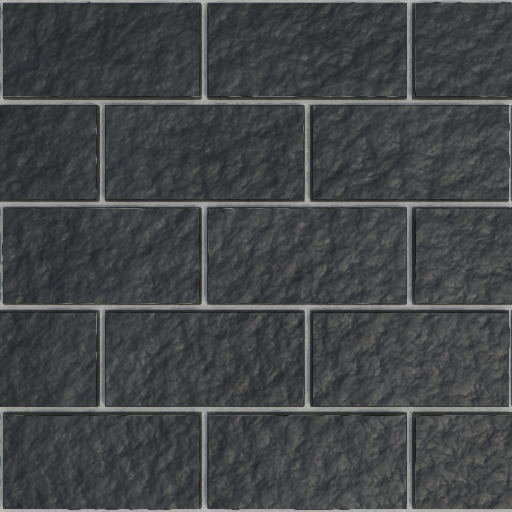
六张 Flat 示例分别是木板、黑板岩、锤击锈金属、黑白大理石棋盘、三角陶瓷砖、棕白格棉布。它们说明该词汇能表达规则布局与不同表面响应;这是作者选择的展示样本,不能估计成功率。 原图与 caption
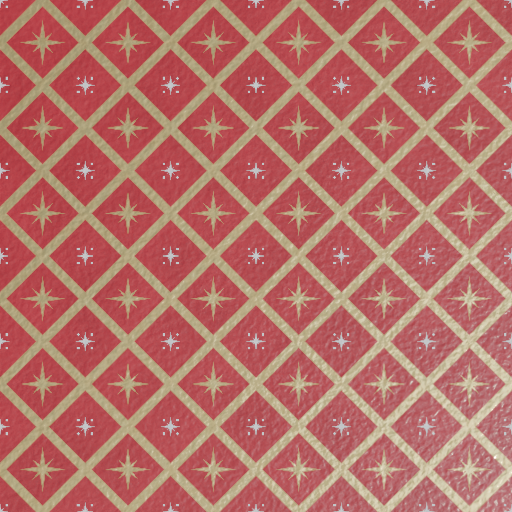 Holiday wrapping paper · MatLoom · Flat
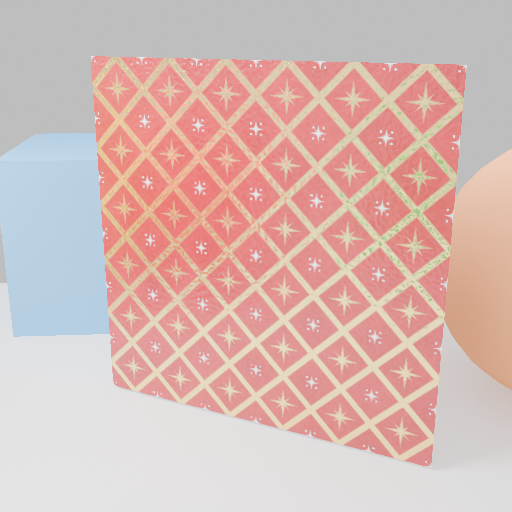 Holiday wrapping paper · MatLoom · Staged
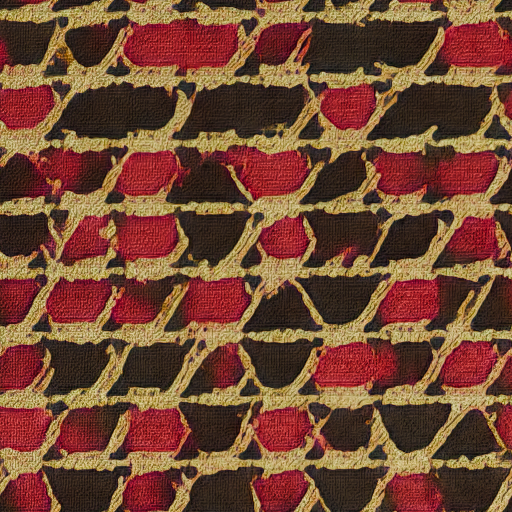 Holiday wrapping paper · StableMaterials · Flat
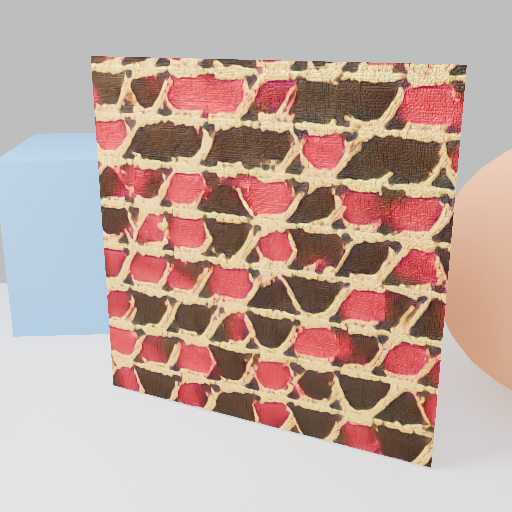 Holiday wrapping paper · StableMaterials · Staged
 Holiday wrapping paper · IntrinsiX · Flat
 Holiday wrapping paper · IntrinsiX · Staged
 Holiday wrapping paper · MatFuse · Flat
 Holiday wrapping paper · MatFuse · Staged
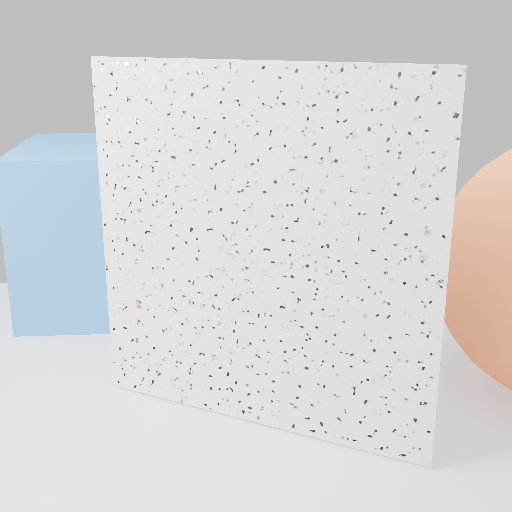
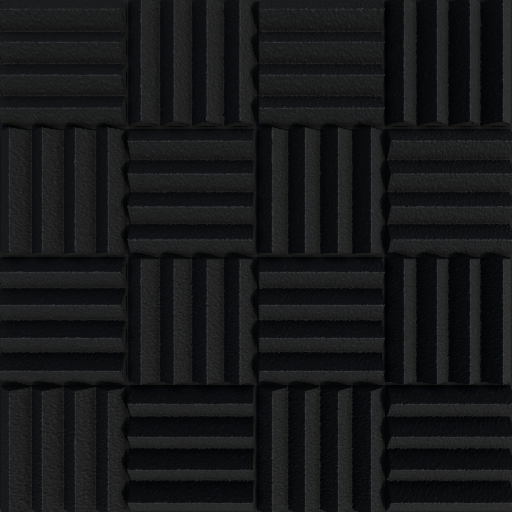 Acoustic panels · MatLoom · Flat
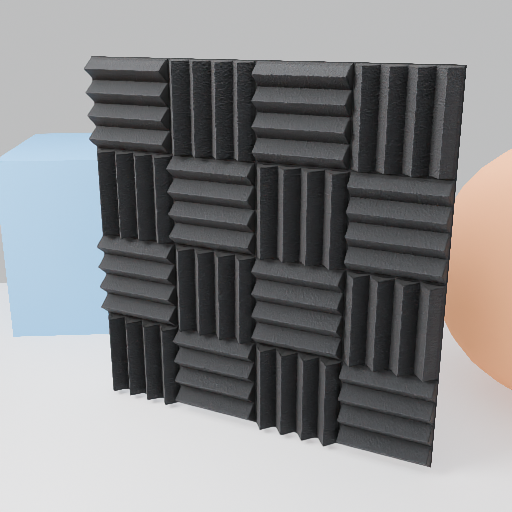 Acoustic panels · MatLoom · Staged
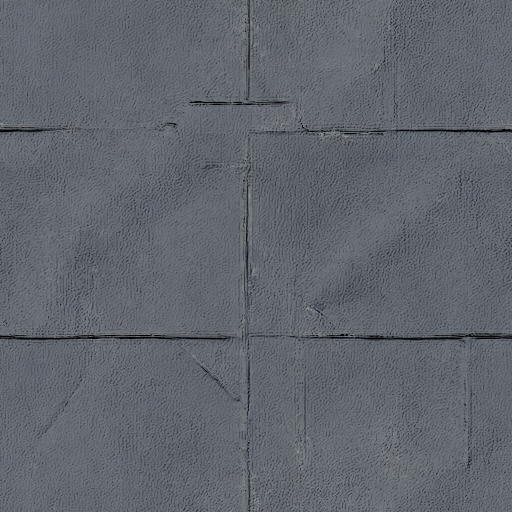 Acoustic panels · StableMaterials · Flat
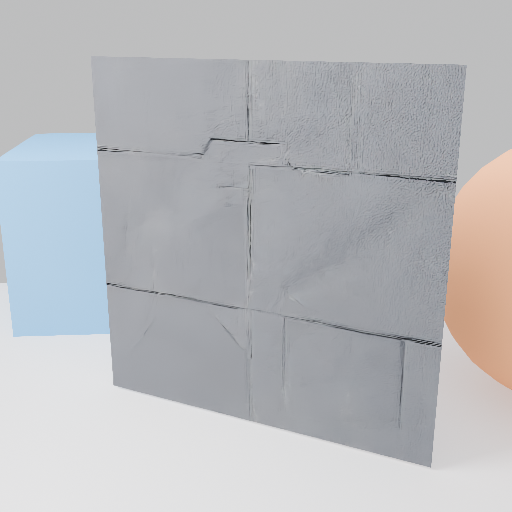 Acoustic panels · StableMaterials · Staged
 Acoustic panels · IntrinsiX · Flat
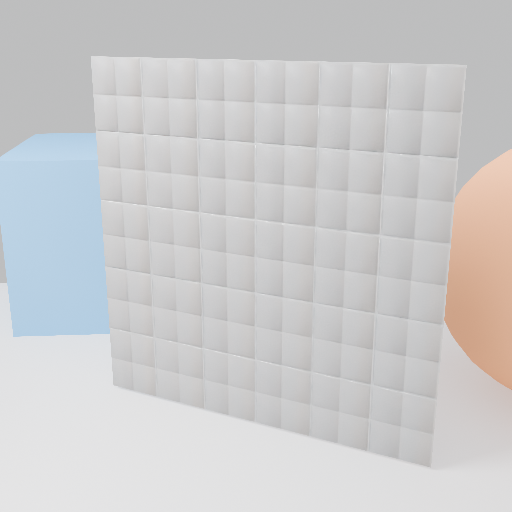 Acoustic panels · IntrinsiX · Staged
 Acoustic panels · MatFuse · Flat
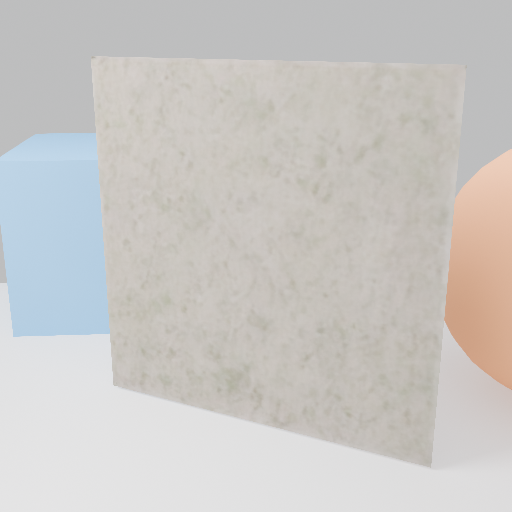 Acoustic panels · MatFuse · Staged
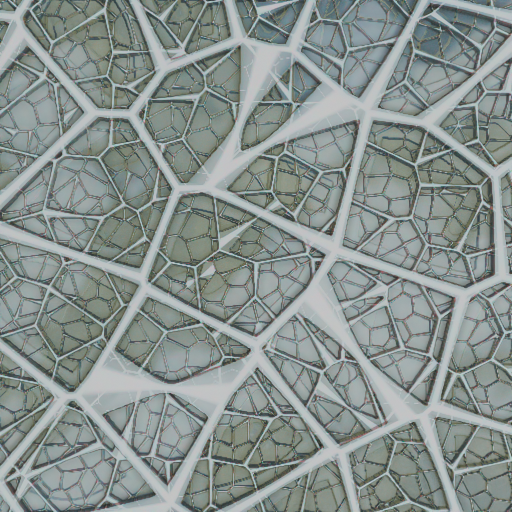 Cracked ice · MatLoom · Flat
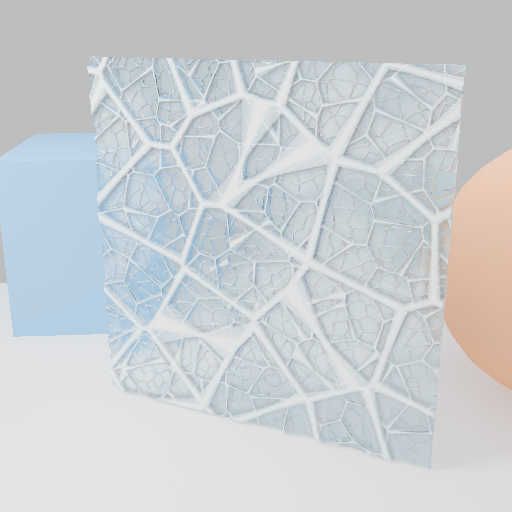 Cracked ice · MatLoom · Staged
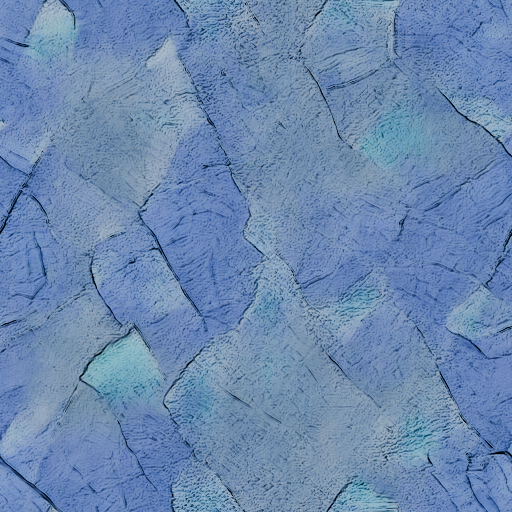 Cracked ice · StableMaterials · Flat
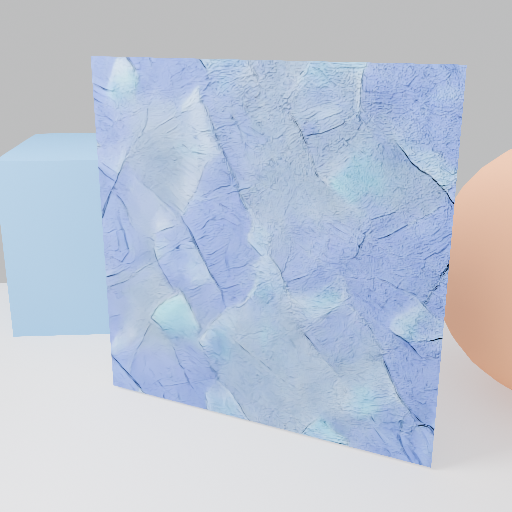 Cracked ice · StableMaterials · Staged
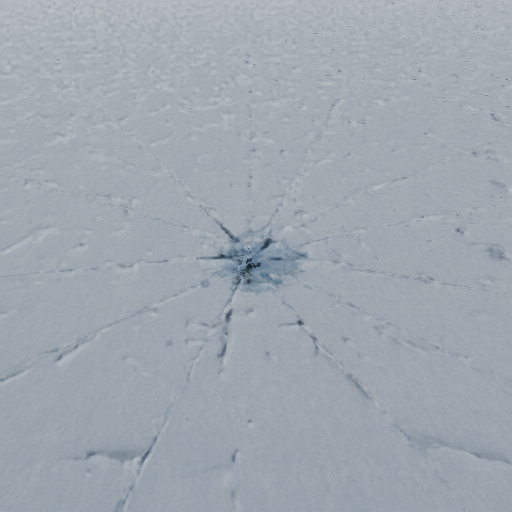 Cracked ice · IntrinsiX · Flat
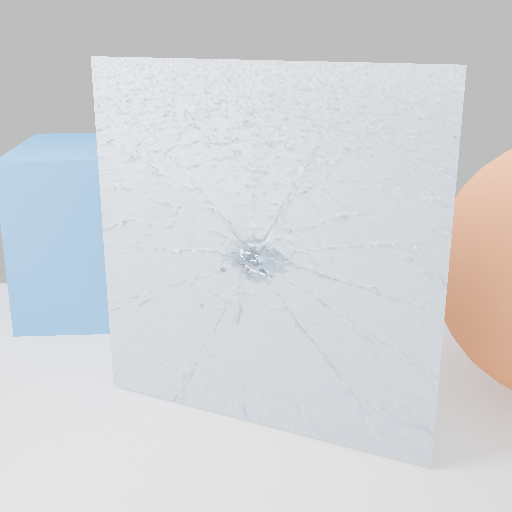 Cracked ice · IntrinsiX · Staged
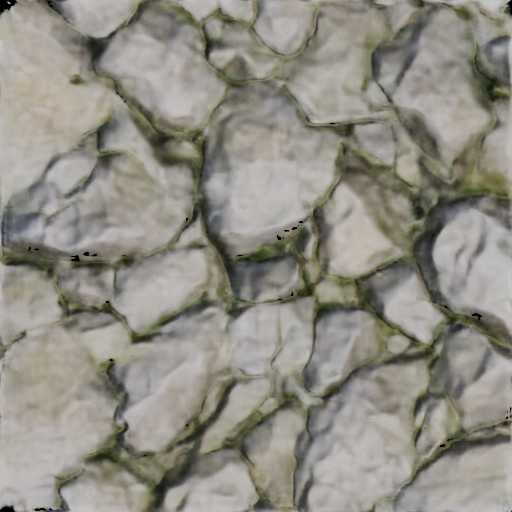 Cracked ice · MatFuse · Flat
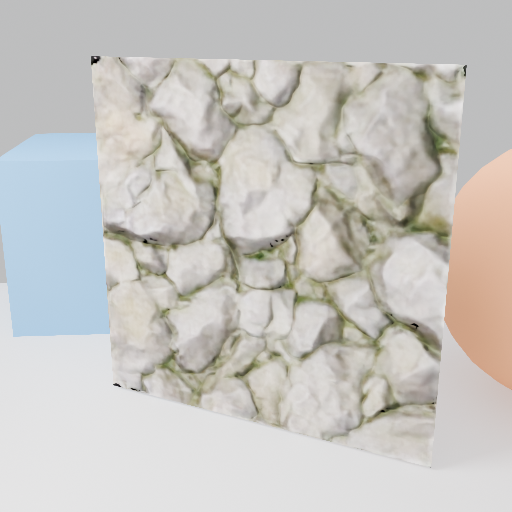 Cracked ice · MatFuse · Staged
每个方法、每个 prompt 都给两个布局。包装纸看重复图案;吸声板看楔形方向与浮雕;裂冰看裂纹与透射。展示样本是刻意选择的,且高度、透射通道路由不一致,不能据此归因于 DSL 本身。 原图与 caption
- 先确认同一 cell 的 Flat / Staged 是否来自同一输出,而不是不同 best-of。
- 看 topology、周期、裂缝和 relief 是否匹配 prompt,而非只看渲染是否有光泽。
- 对 ice 的透射、acoustic panel 的 displacement,回到 Table 13 的通道路由限制。
- 用 Table 1、per-source 和盲测衡量整体,不从选中的 Figure 4 推平均表现。
短程序不等于低成本
| Backbone | Median total (min) | Median polish share (%) | Polish p90 (min) |
|---|---|---|---|
| gemini-3.6-flash | 4.6 | 68 | 5.6 |
| gpt-5.6-luna | 6.3 | 43 | 5.2 |
| gemma-4-26b-a4b-it | 7.7 | 33 | 3.6 |
| glm-5.2 | 10.3 | 27 | 4.7 |
| qwen3.6-35b-a3b | 12.8 | 20 | 3.6 |
| deepseek-v4-flash-0731 | 20.0 | 18 | 7.2 |
旗舰总耗时中位数
六次 generation 合计 40 秒,六次 critic 42 秒,轨迹 selection 1.7 秒,seed search 181 秒;其余包含 lazy loading 与 canonicalization。
单个 design 的 seed sweep
256² preview 与 scorer encode,约 70 ms / candidate;所有 stage 每 prompt 单进程顺序运行。
polish 占总耗时中位比例
各 run 的 ratio 再取中位,不能简单用各 stage 的中位数相除精确复得。
初稿中位 11 秒;每次 revision / critique 约 5–7 秒。slowest backbone 的 LLM calls 合计中位可达 910 秒。文中没有记录硬件与 scorer-device 规格,也没有 token usage;这组数字是系统内部的记录,不是与 diffusion 的公平速度 / 费用竞赛。
Paper vs. Implementation
审计对象固定为官方仓库 commit 00d80e204497770dfbf545c5217c6971aa8db215。以下将论文实验设置、库默认行为、复现入口分开:存在参数不代表主实验用了它,README 的最小命令也不自动等于完整论文 pipeline。
| 检查项 | 论文层面 | 固定 commit 的实际实现 | 对复现 / claim 的影响 |
|---|---|---|---|
| 固定词汇 / 执行范围 | 受限字段语言,独立执行为 maps | Parser 的固定 function registry 构造表达式树;不是把 LLM 文本直接当任意 Python 执行,也没有 bitmap-import 原语。registry / parser | 限制攻击面与表达域;可以组合已有原语,但不能自行发明未注册节点 |
| 默认运行 ≠ 主实验 | 5 次 revision + feedback + selection + seed1000 | 库与 CLI 均默认 refine=0,critic 三信号=False,select_best=False,polish=False。库默认CLI | README 的最短 text2dsl 命令只产生程序,不能作为完整论文配置 |
| Few-shot / playbook 默认分层 | 论文上下文包含二者 | Python text_to_material 参数默认 True;CLI --few-shot / --playbook 默认 False。CLI flags | 完整命令需显式传两个 flag,不能混称“默认开启” |
| 三层 retry 不能混同 | 每次程序解析失败最多 3 次 corrective response | DSL 纠错:初始响应之外最多再修 3 次;同消息空响应/structured-output 格式局部重试 3 次;SDK 处理 rate-limit / 5xx / connection,构造器设 max_retries=5。DSL repair局部格式重试SDK config | _TRANSPORT_RETRIES 名称/注释不能代替实际调用路径;三种 retry 也不等于 5 次视觉 revision |
| LLM 请求上限 / sampling | 论文报告调用次数与耗时,未给 token usage | build_llm 设 max_completion_tokens=65536、timeout=600 秒、SDK max_retries=5;temperature / reasoning_effort 参数缺省 None,交给 provider。请求上限sampling 参数 | 这些是当前实现上限和默认,不是论文实际 token 消耗,也不能填补历史 sampling 设置缺失 |
| 确定性 / seed | 显式种子、固定 engine 与采样保持可重复字段求值 | 每轮 deserialize→serialize 后把 canonical 程序写回对话;--seed 固定噪声与搜索 RNG,没有固定 provider 的 LLM sampling seed。canonical seeds回写 | 不保证跨服务调用、模型版本或跨 Python/TS 的端到端相同文本与图像 |
| 最大 3003 而非总是 3003 | 初始 / selected / last 去重,原稿 + K seeds | 重复旧 seed 一起替换;没有 seed literal 的程序只评分原程序。reseedsweep | 预算是上界;无噪声的纯规则图案不能从 seed sweep 获得新变体 |
| 运行时顺序 | 论文记录:每 prompt 单进程顺序执行 | 库下层 polish_program 默认顺序;text2dsl 入口默认可开 min(4, CPU数) 渲染池,--polish-parallel-renders 0 关闭。pool底层参数 | 重现 paper wall time 应显式记录并关闭并行池;不能照默认值直接比速度 |
| Selection fallback | 主方法用 MobileCLIP2 quick scorer | 实际选择顺序为 MobileCLIP2 index → critic index → last。polish 缺 score_fn 时仍尝试加载默认 MobileCLIP,不能笼统说整个流程可 fallback 到 critic。selector fallbackpolish scorer | 需要把 scorer 初始化失败与正常选中结果分开日志记录 |
| 可选 CMA-ES | 主结果只搜索 seed | polish_cma_evals 默认 0;正值时才调连续 literals,View 与结构参数排除,frequency log-space,bounds 由人工规则定义。bounds默认预算 | 可选功能不应被混入主论文 claim;存在 schema-driven heuristic,而非端到端学习 |
| Preview 与缓存 | 快速 fixed-light 近似支持便宜搜索 | preview 的 render-scoped memo 可复用 Define 子树;Python export 不在同一 memo scope。CLI help 部分文字仍提 Blender,实际 selection 调 fixed_light_preview。previewselector | 行为以执行路径为准;不能把缓存或 preview 性能推广到全部导出入口 |
| 通道与导出 | PBR maps + height-derived normal / AO | Python 总计 13 张图;coverage 在 basecolor RGBA 的 A 中,没有独立 alpha.png。默认 roughness=0、color 黑色。HDR 不能保留负 height;EXR 可。defaultsexport | 教学程序必须写明确 roughness;负高度与浏览器 IOR packing 需要格式级检查 |
| 错误处理与 finite slots | 论文报告保留评分没有非有限值 | VqaDirect 捕获评分异常并返回 0.0;polish 对失败候选可记 finite floor −10⁶。judge fallbackfitness floor | 这只是代码策略,未证明实验发生失败;结果 finite 不足以单独排除调用异常 |
做过的验证,精确到执行层
- 直接调用官方 TypeScript parseImportedLayers → serializeMaterial → evalSpec;README 两层砖程序在 256×256 产生 map arrays,canonical round-trip 后 basecolor bytes 一致。
- 对仓库保留的 Python-generated fixtures 抽查 200 个 scalar 点、31 条 serialization、6 个 shape grids、48 个 fBm values,按各自官方容差通过。没有重新生成 Python fixtures,也没有运行完整 test suite。
- 单独加载 Python relief.py 验证 alpha=0 / 0.01 / 1 的 max-height 参与规则、负高度与非有限层处理;没有启动完整 Python export CLI。
- 另一个原创蓝釉砖教学例在 256² 成功 round-trip;只改 grain seed 或 roughness offset 仅影响 roughness,改 mortar 则影响多个 maps。这是单个依赖图的验证。
没有执行:LLM/API 调用、MobileCLIP 打分、Blender 成像、完整 Python PNG/HDR/EXR 文件导出、原论文 benchmark 重算、浏览器或视觉验收。
可重复阅读的原创建模例与实测边界
本页教学简化例,不是原论文 Listing 1;采用官方 TypeScript 引擎实际 parse/serialize/256² array 求值。它把 grain 只接到 roughness,故在此例中改 seed 不改 color / height。
View(0, 0, 2, 2)
Define(tile, Bricks(brick_width=0.48, brick_height=0.48, offset=0, mortar=0.02, feather=0.008))
Define(grain, fBm(octaves=3, base_freq=12, to_01=True, seed=17))
Material(
  Layer(1).basecolor(95, 100, 105).roughness(0.9).height(0),
  Layer(tile).basecolor(25, 75, 140).roughness(0.08 + grain*0.04).coat(0.9).height(tile*0.02)
)
所有 map arrays 在 round-trip 前后逐字节一致;height 范围 0–0.01999999955(Float32 对 0.02 的表示)。seed 17→18 只改变 ORM 的 G(roughness);roughness offset 0.08→0.18 同理;mortar 0.02→0.04 改变 basecolor、ORM、PBR1、normal、displacement。PBR1 变化包含 coat 的 coverage 混合,并非泄漏。
这不证明所有程序、不同分辨率或不同渲染器都保持相同依赖效果。
parseImportedLayersevalSpecfixture contractReviewer:贡献、漏洞与下一步实验
成立的贡献
- 表示目标明确:把 coverage 与 PBR channels 组织为共享字段和图层,源码可直接检查依赖,而非只交付黑箱贴图。
- 结构与 realization 分离:LLM 改设计,seed sweep 改随机实现;可以为不同搜索对象分配预算。
- 系统可执行:parser、canonicalizer、map engine、preview、统计、critique、selection 连成闭环。
- 报告有反证意识:披露 judge 回退、image-quality 排名、非严格消融、跨引擎例外与 qualitative selection。
- 证据横向覆盖:六 backbone、四来源、三 runs、两 layouts、多指标与盲测;比只展示 few-shot gallery 更有说服力。
尚不足以支持的外推
- 表示的因果收益:缺少相同模型/预算/renderer 的 direct Blender、MDL 或其他 procedural 表示对照。
- 组件必要性:温度混杂与单 run 限制 Table 9/10;去掉某组件的差不能直接解释为该组件贡献。
- 物理与编辑质量:没有物理 ground truth、系统性 edit benchmark、跨分辨率一致性指标。
- 成本公平性:最高约 3,003 个 scorer 候选,没有与 diffusion 的 search budget 匹配,缺硬件、tokens 与失败日志。
- 表达与泛化:固定 primitive/channel 库对细微结构、具体图案、参与介质和任意反射模型受限;benchmark 是精选分布。
| 优先级 / 研究问题 | 建议实验 | 应记录的结果 |
|---|---|---|
| P0 · 表示本身是否有用? | 同 prompt、backbone、token/compute、通道路由,比较 named DSL / inlined DSL;再做 layer-grouped / channel-explicit 等价形式 | first-pass validity、修复轮数、maps 等价性、fidelity、edit leakage;确认变量只改变表示 |
| P0 · rendering route 是否解释优势? | shared-channel 评估;StableMaterials displacement 的固定标定控制;统一 transmission 条件 | Flat/Staged 外部指标与盲评;逐条件差而非仅总均值 |
| P1 · critic 怎样看最有效? | 相同温度和模型、多 run,交叉 render/source/stats;控制 context token 总量 | 建议可执行率、错误定位、无效修改、每轮增量和方差 |
| P1 · proxy search 何时过拟合? | 预注册预算曲线;固定设计上 seed / parameter / constrained topology search,外部保留 evaluator | quick/external/human 分数相关性;结构退化率;保留原程序的收益 |
| P1 · 编辑性如何量化? | 多材质、多指令、自动与人工编辑;用 dependency graph 预测应保留的 maps | 目标修改成功率、非目标通道漂移、局部/全局感知影响、操作时间 |
| P2 · 更聪明的 test-time budget | 用早停、uncertainty、跨 metric disagreement 分配更多 critic 或 seeds | 相同平均成本下的 fidelity;报告失败与 tail latency,避免用 test oracle 调度 |
初步复现路线:先建立可检查的最小闭环
- 锁版本与环境。固定 paper v1、仓库 commit、依赖和 renderer settings;记录平台、设备、模型真实 endpoint/version、温度、所有 seeds。README 建议 Python 3.13;不要把 API model alias 当永久快照。
- 只测本地 executor。用一个完全显式 seed 的最小程序先 export maps,检查 finite values、channel ranges 与 repeatability;这一步不需要 LLM API。
- 分层验证三类图。分别保存 unlit maps、fixed-light preview、Blender Flat/Staged。统一 naming 与 hash,避免把 quick-score 改善误认为最终渲染改善。
- 再跑单个 authoring trajectory。显式配置五次 revision、各 critic signal、selection 和 seed budget;保存原始响应、parse repair、canonical program、critic JSON、scorer 分数与时间。
- 复做小规模 budget 对照。先比较 K=0/10/100/1000,固定 prompt 与模型;外部 evaluator 不参与搜索。检查 seed equality groups 与非 seed 文本确实不变。
- 最后扩到 benchmark。确认 prompt list、三 seed labels、两布局、baselines map routing 全匹配。统计先聚合 run 再聚合 prompt,保留失败尝试而非只交付成功槽位。
无 API 的 engine smoke test
matloom-export --program "$(cat bricks.dsl)" --output-dir out/maps --width 256 --height 256
OPENCV_IO_ENABLE_OPENEXR=1 matloom-export --program "$(cat bricks.dsl)" --output-dir out/maps-exr --width 256 --height 256
命令来自官方 README:--program 接收程序文本,而非文件路径;默认 floating-point maps 写为 HDR,EXR 路径可保留负 height。这里展示操作步骤,并未实际运行。完整安装还有 Blender 与评价模型依赖,不能将 smoke test 当完整复现。
接近论文结构的显式 CLI 配置(需另行核对模型与 sampling)
matloom-text2dsl --prompt "black shiny ceramic floor tiles" --model MODEL \
  --few-shot --playbook --parse-retries 3 --refine 5 \
  --critic-render --critic-code --critic-diagnostics --select-best \
  --polish --polish-seed-sweep 1000 --polish-cma-evals 0 \
  --polish-parallel-renders 0 --width 512 --height 512 --seed 123 \
  --output-dir out/authoring
这是经 CLI 参数源码核对的配置示意,未执行。MODEL、endpoint、sampling 设置仍须对应可用服务与原始 run records;text-only backbones 应关闭 image critique。CLI 的 width / height 控制 critique 与 selection,polish preview 使用其下层 256² 默认。不能仅靠 --seed 承诺 LLM 响应文本完全复现。
CLI arguments需要向公开材料继续追索的缺项
- 原实验硬件、scorer device、token usage、API request identifiers、失败请求和每轮 parse repair 次数
- 各 backbone 的准确 sampling 参数、不可变模型 snapshot 与可核对的运行记录
- 完整保留结果文件及 Table-generation provenance 是否在当前公开发行版可直接取得
- 匹配 channels / geometry / compute 的 procedural baseline 和 diffusion baseline 复现配置
- 编辑成功率、物理正确性、perceptual resolution consistency 的系统性测试
附录 A–R 阅读地图
| 附录 | 主题 | 本页位置 / 核心证据 |
|---|---|---|
| A | 相关工作边界 | Table 3:文本条件、程序编码、执行依赖不能混同 原附录 |
| B | 完整瓷砖程序 | Listing 1、三次手工编辑及两分辨率重复求值 原附录 |
| C | Canonical grammar | 缩略 EBNF 与有限 regression;不是 constrained decoding 原附录 |
| D | 跨引擎一致性 | 精确 / 容差 / 排除项,Worley hash 与 IOR packing 原附录 |
| E | refinement / selection / polish | Tables 4–7 全数值、非单调、Oracle 与预算 replay 原附录 |
| F | runtime | Table 8、每 stage 成本与硬件缺失 原附录 |
| G | 组件诊断 | Table 9,temperature 混杂,不做严格因果消融解读 原附录 |
| H | cross-critic | Table 10,generator 固定但 critic 模态不同 原附录 |
| I | 连续参数搜索 | CMA-ES 设置与 proxy mismatch;单 prompt、有限样本 原附录 |
| J | 用户研究 | Tables 11/12、设计、统计、来源与 prompt 抽样敏感性 原附录 |
| K | baseline 配置 | Table 13、步数/guidance、weights 与不等 height route 原附录 |
| L | image quality | Table 14:CLIP-IQA 与 prompt fidelity 分开 原附录 |
| M | 结果 provenance | 2,538/1,974/1,269 记录计数与未保留日志 原附录 |
| N | 来源分组 | Table 15,平均优势依赖 prompt composition 原附录 |
| O | prompts | Table 16、role/spec/few-shot/critic/revision 机制 原附录 |
| P | 定性图 provenance | Figure 4 主动挑选,不能估计典型表现 原附录 |
| Q | 表示与方法细节 | Eq. 2、semantics、serialization、execution、Figure 7、prompt/render mechanics 原附录 |
| R | 额外协议与诊断 | text-only critic、runtime、Figure 8 筛选、proxy mismatch 原附录 |
这张地图表示覆盖正文和附录的主要研究内容,不将“约 90%”写成经过测量的完整度。参考文献的所有被引论文没有在本页逐一重新评估;对相关工作的描述按本论文边界作中文整理。
来源、证据标签与阅读约定
如何区分证据
Paper Verified 已核对原文、公式或表格,不表示独立复现实验。
Author Claim 作者提出的动机或解释。
Implementation Audit 对固定 commit 的源码检查。
Our Interpretation 本页分析,不冒充原论文结论。
Research Extension 尚待验证的建议。
所有主实验和附录数值保留原 Table 编号;本页计算的均值差基于展示值,因此与原文未舍入统计量可能差 0.01。图像使用原论文 panel,维持原 Figure 编号及选择条件;Figure 2 和 Figure 7 的原 HTML 结构通过文字与标明自制的 Mermaid 图解释。
本页新增的数值 toy、比较条形图、预算滑块、证据开关仅帮助理解。有限的官方引擎 array / fixture 检查详见实现审计;没有执行文本到材质的 LLM 生成或新的统计研究实验。图片上传确认与本地结构检查不等于最终显示验收;未进行公开图片 GET、浏览器加载、截图或视觉/交互验收,最终显示由接收者检查。
代码示例来源与许可
官方仓库代码 / associated documentation 的引用片段遵循 MIT License,Copyright (c) 2026 Anson Y. Lam。本页新增解释与交互独立编写。arXiv 论文与原图仍按其各自许可与作者权利处理,未将论文全文翻译或重新发布。
MIT License

Copyright (c) 2026 Anson Y. Lam

Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:

The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.

THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE
SOFTWARE.