法线 N 约束表面形状,辐照度 E 保留阴影/明暗,完整原图 x 提供上下文。
01 · 把材质换掉,把场景光照留下
MatSwap 的任务是图像中的材质替换:给定场景照片、目标区域 mask 与一张近似平面的材质 exemplar,生成材质已替换的 RGB 图像。它不重建三维场景,不输出五张 PBR 贴图,也不生成可执行材质图。关键设计是在 Stable Diffusion 的局部像素条件中加入 normal 和 diffuse irradiance,同时用 IP-Adapter 将材质参考图的视觉特征注入 cross-attention。
PBRand 配对渲染;同几何、同照明,只改变选中表面的材质。
发布实现的 UNet 输入:N latent 4 + E 1 + 噪声 4 + x latent 4 + mask 1。
本页结论:主表支持 MatSwap 在被测合成和真实样本上的质量提升,irradiance 是有用的额外条件;但它仍通过生成先验隐式处理投影,不能精确锁定 UV、旋转或纹理相位。尺度控制并非完全缺失:论文和代码均提供基于 exemplar 裁剪的隐式尺度控制。

主来源:固定 arXiv:2502.07784v1,2025-02-11,共 10 页、10 幅图、3 张定量表。固定版没有单独 Appendix;本页完整覆盖第 8–9 页扩展图例及第 10 页参考文献线索。后发布代码单独标注,不当作 v1 当时已公开的内容。
02 · 身份与证据版本
| 证据层 | 核实内容 | 边界 |
|---|---|---|
| 固定论文 | MatSwap: Light-aware material transfers in images;2502.07784v1;2025-02-11 | 本次 PDF 40,985,648 字节,哈希与导出记录相同;不换成 v2 |
| 作者/机构 | Ivan Lopes、Raoul de Charette:Inria;Valentin Deschaintre、Yannick Hold-Geoffroy:Adobe Research | v1 未明确标注通讯作者;原笔记的候选状态保留 |
| 正式发表 | Computer Graphics Forum 44(4),EGSR 2025,DOI 10.1111/cgf.70168 | 出版信息用 Eurographics 官方记录补全,原 frontmatter 不覆盖 |
| 当前官方实现 | astra-vision/MatSwap,固定 commit b5b5ddfc3c95318a86efebab7f69705aae9b3247,2025-08-11 | 只做源代码静态审读;没有下载大模型、运行推理或复训 |
| 公开权重 | 官方 README 链接 Hugging Face ilopes/matswap;模型配置基于 Stable Diffusion 1.5 | 配置用于当前发布实现说明,不反推 v1 未列出的采样参数 |
| 训练开放性 | 核查的仓库树含 pipeline、demo、AOV 估计与示例图片 | 没有在该提交找到训练脚本、全量 PBRand、数据生成器或评测脚本;公开推理不等于完整复现包 |
对旧笔记的更新:“还需等 code release”已过时,现可静态核查推理流程;“不能控制铺贴”需要收窄为“没有显式 UV/旋转/相位控制,尺度可通过裁剪 exemplar 间接调整”。旧笔记、原 PDF++ anchors 与用户研究想法均原样保留,纠正只出现在新增内容。
v1 记录 · Eurographics 官方出版页 · 固定代码提交 · 官方权重
03 · Research gap:材质外观与光照的纠缠
在 3D 编辑器里换材质只需改 shader;在照片里,像素颜色已经混合了材质、视角、几何、遮挡和光照。若直接把 exemplar 贴到目标区域,会丢失透视及阴影;若只写一段文字提示,又很难精确保留织物、砖缝、木纹等复杂结构。MatSwap 希望把“材质长什么样”和“该区域怎么被照亮”分成两种条件。
相比 ZeST 的 training-free IP-Adapter + depth ControlNet,本文用成对合成数据专门训练 material transfer,并把 E/N 直接送入 UNet。与编辑估计 PBR buffers 的 RGB↔X 不同,用户不需要画目标 albedo、roughness 或 UV,而是给一张平面材质图。这减轻了交互负担,但几何映射仍由生成先验推断。
为什么选 irradiance,而不是环境光贴图?
球面 radiance 含方向、HDR 动态范围与场景可见性,难与照片像素一一对应。图像空间的 diffuse irradiance/shading map 已把表面方向与部分照明效应投影到图像上,能直接作为局部条件。它故意排除与材质强耦合的 specular effects,降低“新材质还被旧材质反射属性锁住”的风险。
\[E(\mathbf{p})=\int_{\Omega^+}L_i(\mathbf{p},\omega)\,V(\mathbf{p},\omega)\,\max(\mathbf{n}\cdot\omega,0)\,\mathrm{d}\omega.\]
教学性物理解释:\(L_i\) 是入射 radiance,V 为可见性,n 为法线。这不是论文新增训练公式,而是说明 E 的角色。Lambertian 假设下出射漫反射近似为 \(\rho E/\pi\),所以 E 不直接包含局部 albedo ρ。但全局间接光仍会受周围材质影响,“material-independent”应理解为条件设计目标,而非严格的全局物理不变性。
需要纠正的推断:E 不编码 specular,并不意味着模型绝对不能生成高光或反射。它可借原图与生成先验产生 plausible highlights,论文也展示了例子;真正限制是没有显式 specular transport 条件,物理正确性无法保证。
来源:v1 §1、§2.2、§3.1,PDF 第 1–3 页;物理积分为本文解释。
04 · Problem formulation 与输入契约
| 符号 | 输入/输出含义 | 实际要求 |
|---|---|---|
| \(x\) | 待编辑目标 RGB 照片 | 标准条件使用完整原图,目标区域并未先被挖空 |
| \(p\) | 期望材质 exemplar | 主要是近似平面、正视、覆盖整幅图的照片/渲染纹理;不是任意物体照片均有保证 |
| \(M\) | 用户指定或分割算法产生的编辑区域 | 必须与 x 配准;训练的 conditioning dropout 始终保留 mask |
| \(N,E\) | 法线与漫反射辐照度 | 合成数据由 renderer 提供;真实照片由现成估计器获得 |
| \(I,\widehat I\) | 训练真值替换图与生成替换图 | 输出为 RGB,不是材质属性图或程序节点 |
| \(\mathcal E,\mathcal D\) | 预训练 VAE encoder/decoder | \(\mathcal E\) 与 irradiance E 是不同对象 |
| \(\tau(p)\) | 材质图的 CLIP 视觉条件 | 通过 adapter cross-attention 注入,不是目标区域的逐像素贴图 |
\[\widehat I\sim P_{\theta}(I\mid x,M,N,E,p),\qquad E=\phi_E(x),\quad N=\phi_N(x)\ \text{(真实照片)}.\]
原论文将其视为 3D-aware inpainting:输出应符合输入材质的外观,同时延续场景几何/光照。这不是严格的物理逆渲染解。原图 x 本身仍含旧材质信息,因此“仅用材质无关输入”只准确描述 N/E 的选择,不能描述整个 conditioning stack。
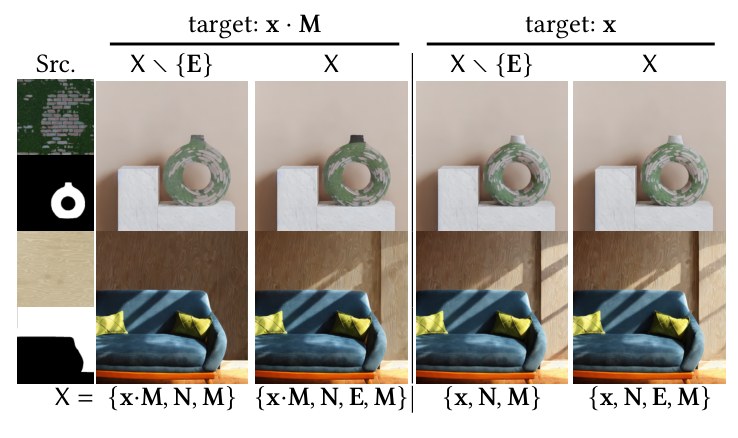
mask 记号注意:Figure 5 用 x·M 表示遮去编辑区域后的输入,但正文没有在此明确二值正负约定。为避免歧义,本页讨论遮挡操作时定义 \(M_{\mathrm{edit}}=1\) 表示需要替换的像素,则“移除原目标内容”写为 \(x_{\mathrm{visible}}=x\odot(1-M_{\mathrm{edit}})\)。这是记号澄清,不能未经核对直接替换代码中的 M。
05 · Architecture:局部场景条件与全局材质条件

\[z_0=\mathcal E(I),\qquad z_X=\operatorname{concat}\!\left(\mathcal E(x),\mathcal E(N),S_{\downarrow}(E),S_{\downarrow}(M)\right).\]
这是 v1 Eq.1 的语义:RGB 原图和 normal 经 VAE 压缩,irradiance 与 mask 直接下采样到 latent 分辨率;每个 timestep 将 z_X 与当前 noisy latent z_t 连接,交给 UNet。它不是并行 ControlNet 分支,也不需要用户为新材质提供目标像素 UV。
回答原笔记的问题:E、M 为什么只下采样?
论文事实:作者明确采用该处理,并引用 Stable Diffusion 与 RGB↔X 的设计,但未提供“VAE 编码 E/M vs. 直接下采样”的消融或证明。本文解释:mask 是离散区域指示,E 是稠密光照标量,直接保留它们的空间布局较简单,也避免把非照片类型的标量图强行通过 RGB VAE。代价是低分辨率丢失细线/高频边界;这正对应论文承认的小物体失败。
当前代码核实:E 用 bilinear resize,M 用 nearest resize;N 和 x 的 encoder 取 posterior mean,再乘 VAE scaling factor,而非采样 latent。demo 把 E 变为单通道,N/x 归一化到合适范围。不要因为函数名叫 open_rgb_linear 就断言它执行了 sRGB 线性化:其实际代码只做图像读取和 to_tensor,没有显式逆 gamma 转换。
\[u_t=\operatorname{concat}\big(z_N^{(4)},E_{\downarrow}^{(1)},z_t^{(4)},z_x^{(4)},M_{\downarrow}^{(1)}\big)\in\mathbb R^{14\times h\times w}.\]
上式为发布代码中的通道顺序,不是 Eq.1 列举顺序。当前 checkpoint config 的 in_channels=14、out_channels=4,与 pipeline 的连接一致。输出 4 通道是被去噪的 RGB latent,并非四张物理属性图。
材质条件如何进入网络?
预训练 CLIP 图像编码器冻结,IP-Adapter 的映射/注意力适配层与完整 UNet 训练。论文不再依赖用户文字提示,将 exemplar 的视觉特征作为 cross-attention 条件。当前代码仍保留 text encoder 并计算空字符串 embedding以兼容底层 pipeline;因此“无文字 prompt 控制”成立,“代码彻底删除 text encoder”不成立。
来源:v1 §3.1、Eq.1、Figure 2;空文本编码、条件准备与 VAE 编码。
06 · 损失函数与条件 dropout
\[z_t=\sqrt{\bar\alpha_t}z_0+\sqrt{1-\bar\alpha_t}\epsilon,\qquad \mathcal L_{\theta}=\mathbb E_{I,X,p,t,\epsilon}\left[\|\epsilon-\epsilon_{\theta}(z_t,z_X,t,\tau(p))\|_2^2\right].\]
第二部分对应论文 Eq.2 的噪声预测损失;第一部分是标准 DDPM 前向过程的教学展开,不是声称论文给出了具体 α schedule。z_0 来自材质已替换的真值 I;x 是替换前场景条件。网络同时学习保持区域外场景并修改区域内材质。完整模型使用 mask 作为输入;表 3 的早期变体只在 masked loss 中使用区域信息。
为什么不能只训练 adapter?
材质替换不仅要求 exemplar 与目标外观相似,还要求理解新增的 E/N/M 通道与原图。训练全 UNet 给模型更强适应能力,新增卷积通道采用 zero initialization 以保护预训练行为。但“更自由”不等于任何单独微调设定都更好:A1–A3 的结果并不单调,需要与区域/场景条件一起看。
| Dropout | v1 描述 | 目的/限制 |
|---|---|---|
| 整体条件 | 10% 概率丢弃所有条件,但保留 mask | 为弱条件/CFG 训练准备;不是字面意义上完全无输入 |
| 模态条件 | 另外 10% 概率丢弃 E、N、x、p 中的输入 | 文本措辞未充分澄清是逐模态独立 Bernoulli 还是一次挑选一种;无训练脚本可核实 |
| Exemplar p | 丢弃时把 CLIP embedding 设为空向量 | 去掉材质条件,不是把照片换成黑色材质作为真实目标 |
| Mask M | 始终保留 | 训练仍知道修改位置 |
代码中的 guidance 具体引导什么?
\[\widehat\epsilon=\epsilon_{\varnothing p}+s\big(\epsilon_p-\epsilon_{\varnothing p}\big).\]
实现事实:pipeline 将完整局部条件 stack 复制两份,再使用 IP-Adapter 的有/无图像条件分支。两支仍共享 x、N、E、M,所以这里的“unconditional”更准确是对 exemplar 不条件化,不是对整个场景条件完全无条件。demo 的 CFG 默认 3.0,底层 API 默认 1.0。v1 本身没有完整列出这些推理超参。
来源:v1 §3.1、§3.3,Eq.2;官方去噪与 guidance 实现。
07 · PBRand:随机几何,但配对监督严格
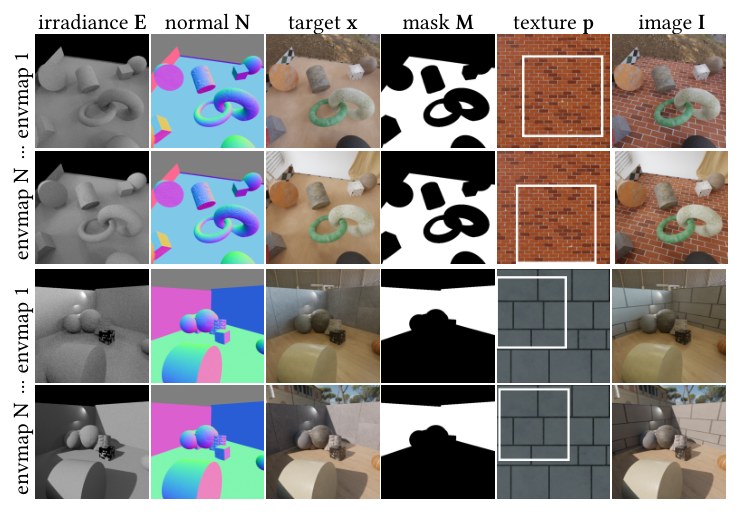
- 在四面墙高度变化的立方体边界内随机放置 sphere、cube、cylinder、torus 等基础几何,随机位置和朝向。
- 共创建 50,000 个 3D 场景,每个场景有 5 种照明变化;从 100 个 PolyHaven HDRI 中抽取并随机旋转,允许投射光和遮挡。
- 给几何分配约 4,000 个 MatSynth 材质;随机选一个对象,把它的材质换成另一个。
- 每个照明配置渲染替换前/后的对应图,以及 E、N、UV、material segmentation,得到 250,000 对样本。
- 从材质渲染提取 16 个随机 crop,以 UV coverage 对 exemplar 尺度进行修正,最后 resize 到 224² 供 CLIP 使用。
\[s_u=\big(\max(U)-\min(U)\big)^{-1},\qquad s_v=\big(\max(V)-\min(V)\big)^{-1}.\]
这里 U/V 是目标表面的 UV 坐标分量。论文用这两个方向的倒数缩放 exemplar,使其纹理元素数量与目标渲染接近。推理无需用户 UV 不等于训练完全不使用 UV。UV 在这里服务于建立尺度监督,而非作为模型推理输入。
数据规模的正确读法
250K 是成对的光照/场景实例,不是 250K 个独立几何布局,也不是 250K 个独立材质。一个实例包含替换前 x 与替换后 I,还附有 buffers。50K × 5 的共享几何结构使随机按图片切分存在泄漏风险;论文未公布 train/validation/test 的完整资产级划分策略,需要未来数据释放时核查。
回应原笔记的“完整场景数据”想法
用户原想法有直接实验价值:本文由 primitives 学习物理关系,却在真实复杂场景应用,存在几何与语义域差异;论文也承认向下法线和细节法线在训练集中缺失。可以比较 primitives-only、artist-scenes-only、混合训练,并保持材质数量/渲染预算/照明分布一致,以判断完整场景是否真正改善几何泛化。不能仅凭数据更复杂就断言一定更好。
复现缺口:当前仓库的 data 目录是几张 demo 照片、mask 和材质图,不是完整 PBRand。正文所说将发布数据,与本次看到的实际可下载范围应区分;本页没有假装拿到 250K 训练集。
来源:v1 §3.2–3.3、Figure 3;固定提交的 data 目录。
08 · 两阶段训练与真正缺少的配置
| 项目 | v1 报告 | 备注 |
|---|---|---|
| 初始化 | Stable Diffusion + IP-Adapter checkpoint | 当前发布配置确认 SD 1.5;论文没列 checkpoint revision |
| 训练参数 | 完整 UNet + adapter;CLIP image encoder 冻结 | 未提供训练脚本,不能从 inference no_grad 反证训练时冻结 UNet |
| 新增输入 | zero-conv 初始化新增卷积 | 发布 checkpoint 已是 14-channel;加载时不重新执行那些初始化 helper |
| 阶段 1 | 256 × 256,100K iterations | 先学习任务,降低前期成本 |
| 阶段 2 | 512 × 512,50K iterations | 原生高分辨率 fine-tuning,不是仅图像放大 |
| Batch / optimizer | 64;AdamW;learning rate \(2\times10^{-5}\) | β、weight decay、warmup、schedule、grad accumulation 未列出 |
| 时间/设备 | 约 5 天,Nvidia A100 GPU accelerator | 没有完整并行/显存/precision 记录,不推断未经说明的多卡配置 |
| 增强 | 水平翻转,并相应调整 normal | 不能仅翻图不改法线方向分量 |
| 条件丢弃 | 10% 整体;另 10% 模态;mask 保留 | 精确联合概率需训练实现核实 |
| Ablation 训练 | 全数据,统一 50K iterations | 与完整 150K 两阶段训练不等价,不能把表 3 LPIPS 直接和表 1横比 |
最小训练逻辑:采样成对数据 → 以 target I 构造 z_0 → 编码 x/N,下采样 E/M → 获得 p 的 CLIP 条件并施加 modality dropout → 随机时间与噪声 → UNet 回归噪声 → 更新 UNet/adapter。此逻辑来自论文,不是可直接运行的官方训练命令。
当前模型结构配置:UNet block widths 为 320/640/1280/1280,cross_attention_dim=768,输入 14、输出 4;CLIP vision 配置 32 层、hidden size 1280、16 heads、patch14、224² 输入、projection1024。这些来自公开 checkpoint 的当前配置,应与固定代码一起归档;它们不证明全部训练设置已公开。
来源:v1 §3.3、Table 3 caption;UNet config、vision encoder config。
09 · 推理流程、尺度与 hue 控制
- 读取三项输入:image、mask、material;demo 将 mask 灰度值大于 0.5 的位置转成 boolean。
- 准备 exemplar:scale=s 时取边长为原宽度除以 \(2^s\) 的中心裁剪;hue 在 OpenCV HSV 空间旋转。它改变输入纹理提示,网络学习将变化传到场景。
- 调整 target 大小:保持近似纵横比,使短边约 512,并把长宽向下对齐到 8 的倍数。输出不自动恢复原始照片分辨率。
- 获取 AOV:优先读取缓存的 N/E;不存在时调用 RGB↔X,分别预测 camera-space normal 与 diffuse irradiance,每次 50 个 DDIM steps。
- 构造条件与采样:编码 N/x,下采样 E/M,加入 CLIP 图像条件,从 4-channel Gaussian latent 开始;MatSwap API 默认 50 个采样 steps,当前发布 checkpoint 使用 PNDM scheduler。
- 解码与保存:VAE decode 得到 RGB,保存 PNG。代码中未见在输出像素或每步 latent 上将 mask 外原图强制贴回。
\[p_s=\operatorname{CenterCrop}\!\left(p,\left\lfloor\frac{W_p}{2^s}\right\rfloor\right),\qquad H'_{\mathrm{HSV}}=(H_{\mathrm{HSV}}+\Delta h)\bmod180.\]
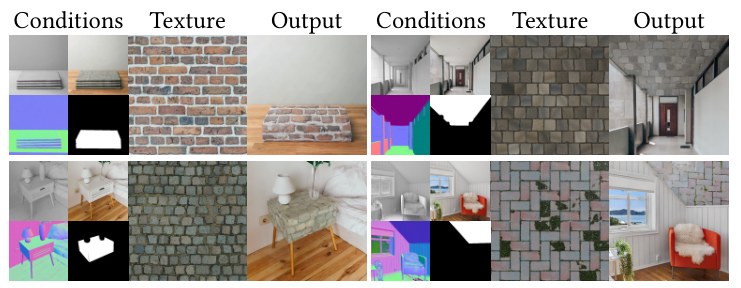
明确能力边界:中心裁剪让图案在 CLIP 输入中变大,模型输出呈现相应趋势;它不提供可校准的纹理“厘米/砖”、精确旋转角、UV 平移或无缝相位。RGB/HSV 外观变化也不等于 PBR albedo 参数的物理独立编辑。
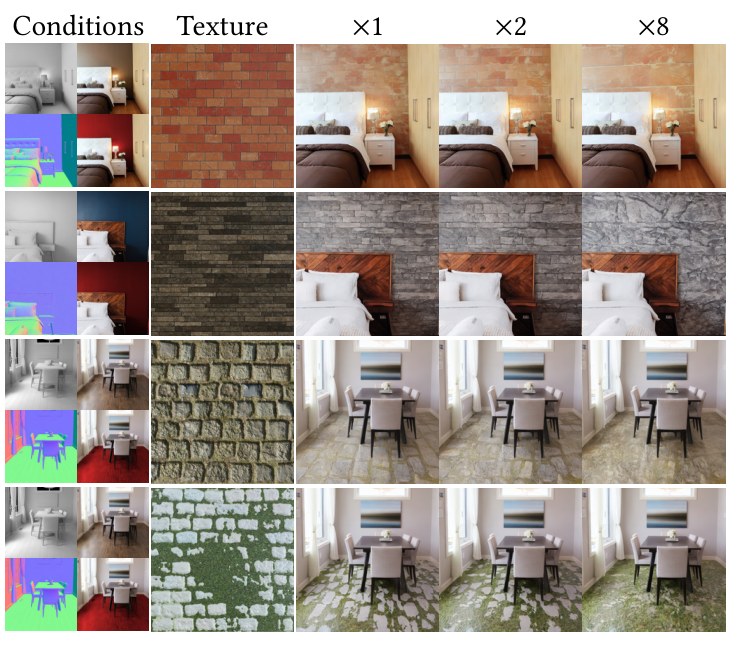
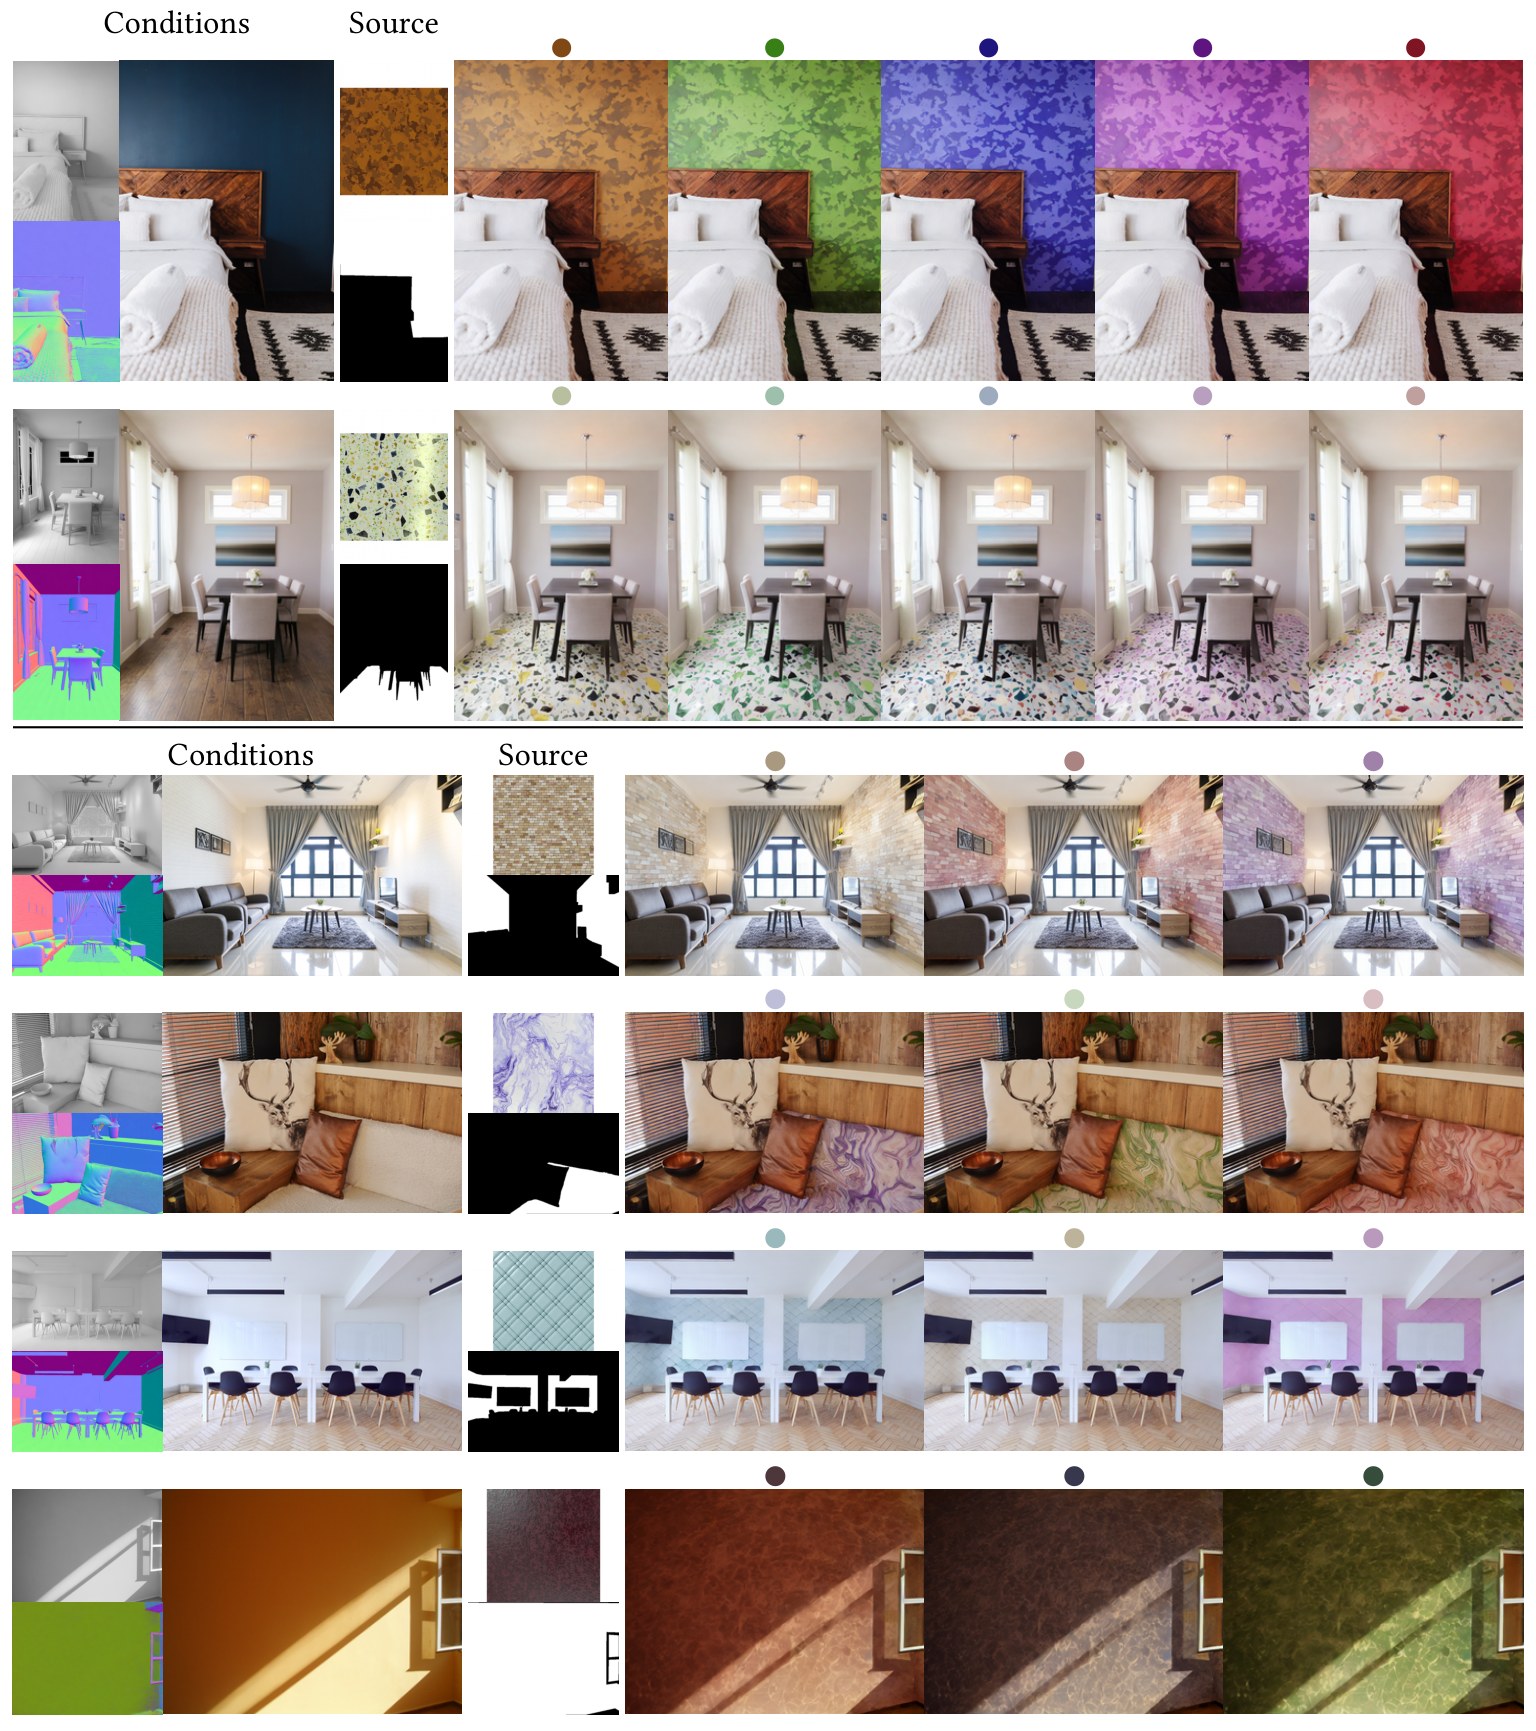
Figure 6 展示 ×1、×2、×8 的尺度趋势;Figure 10 展示不同 hue 的输入条件与输出。这是可视化控制证据,没有尺度绝对误差曲线或色彩校准指标。复制作者示例时,还应记录 seed、exemplar crop、输入 resize 和 AOV 缓存。
时延边界:v1 未提供完整推理耗时/显存/吞吐表。首次使用含两次 AOV 估计加一次 MatSwap,缓存后只需最后一步;不能把“50 步”当作整个端到端流程只有一次 50 步。
demo 预处理与输出 · AOV 估计 · v1 §4,Figure 6、10。
10 · Paper vs. Implementation:逐项核查
这是静态代码审查,未执行模型。源文件固定在 commit b5b5ddfc3c95318a86efebab7f69705aae9b3247。下列潜在问题是可定位的复现风险,不把未运行的代码说成实测失败。
| 事项 | 代码证据 | 如何正确使用 |
|---|---|---|
| Hub 加载路径 | from_pretrained 先调用父类 Hub loader,随后用 Path(pretrained_model_path)/ip_adapter/matswap_adapter.safetensors 读取本地文件 | 直接传 ilopes/matswap 时,该处并未显式解析 HF cache snapshot;若本地同名路径不存在,可能找不到文件。需用本地完整 snapshot 验证。没有声称已运行重现。 |
| 适配器加载 | 先载 placeholder.safetensors 建立 adapter 结构,再把真实 adapter state 载入 UNet,strict=False | 复现应记录 missing/unexpected keys,不能假定宽松加载一定全部匹配 |
| 默认 guidance | API 默认 1.0;demo 默认 3.0;README 写 float,但 argparse 声明 type=int | 默认 3.0 可存在,但 CLI 非整数 2.5 会被 int 解析拒绝;应明确接口层差异 |
| hue 帮助文字 | help 将 180 说成 opposite hue,但实现按 modulo180 | 在该编码中 180 回到原 hue;90 才约对应半圈。以实际公式为准 |
| CPU fallback | demo 允许选择 cpu,但 AOV helper 固定 .to("cuda") 与 CUDA generator | 无预计算 AOV 的 CPU-only 路径存在明显设备不一致风险,不宣传端到端 CPU 可用 |
| AOV 缓存 | 缓存按原图 stem 命名,存在时直接加载;未见严格尺寸/预处理版本检查 | 改变目标输入或分辨率应重核 AOV 配准,防止读取旧缓存 |
| “保持区域外图像” | 最终直接保存整张生成图;未见显式 mask 外像素复合步骤 | 属于学习目标/经验质量,不是像素级恒等保证。应单独测区域外误差 |
| “无 text prompt” | 仍调用空文本 encoder,并传 encoder_hidden_states | 没有用户语义文本控制;并非删掉所有文本模块 |
| 色彩空间 | open_rgb_linear 只是 PIL RGB + to_tensor | 名称不构成 photometric linearity 证据;若复刻照明物理指标需明确 gamma 约定 |
| 训练脚本/数据 | 当前树只有推理、AOV 和 demo 示例;RGBX 以 submodule 引入 | 可审读推理,尚不能从零复训 PBRand 或独立跑评测表 |
这些发现不会推翻论文的实验结果,但会影响“下载就能跑”“论文设置已经完整复现”的判断。本次没有修改官方仓库,也没有下载模型权重;若后续要复现,应先在隔离环境验证加载路径和依赖版本,再测一个已提供示例,之后才扩展到批量对照。
11 · Evaluation:质量与照明保持分别量化
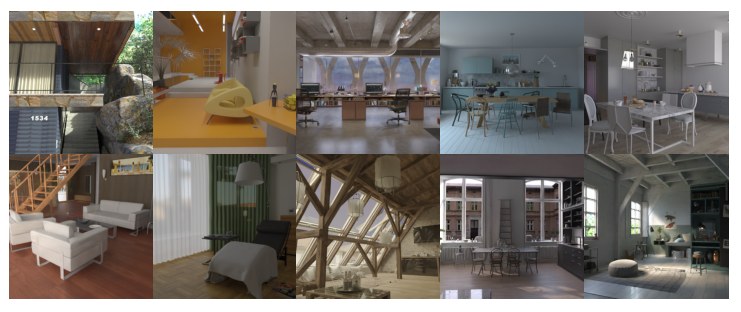
论文使用 300 对合成渲染与 50 张真实照片。合成测试来自 artist-made 3D 场景,经 Blender Cycles 渲染并保存 normal/irradiance;真实图除特别说明外来自 Materialistic evaluation set。比较对象包括 SD v2.1、SD-XL inpainting、FLUX.1 Fill、Blended Latent Diffusion 与 ZeST。
\[\operatorname{PSNR}=10\log_{10}\frac{L^2}{\operatorname{MSE}(I,\widehat I)},\qquad \operatorname{CLIP\mbox{-}I}=\frac{\phi(p)^{\mathsf T}\phi(\operatorname{crop}(\widehat I,M))}{\|\phi(p)\|_2\|\phi(\operatorname{crop}(\widehat I,M))\|_2}.\]
PSNR/LPIPS 在有配对真值的合成样本上比较;真实图没有目标真值,CLIP-I 用 exemplar 与生成目标区域 crop 的 feature cosine。上述公式解释指标职责,论文未公开具体 crop padding、mask 外指标策略、CLIP 型号与评估脚本。
\[d_E= d\big(\phi_E(\widehat I),\phi_E(x)\big).\]
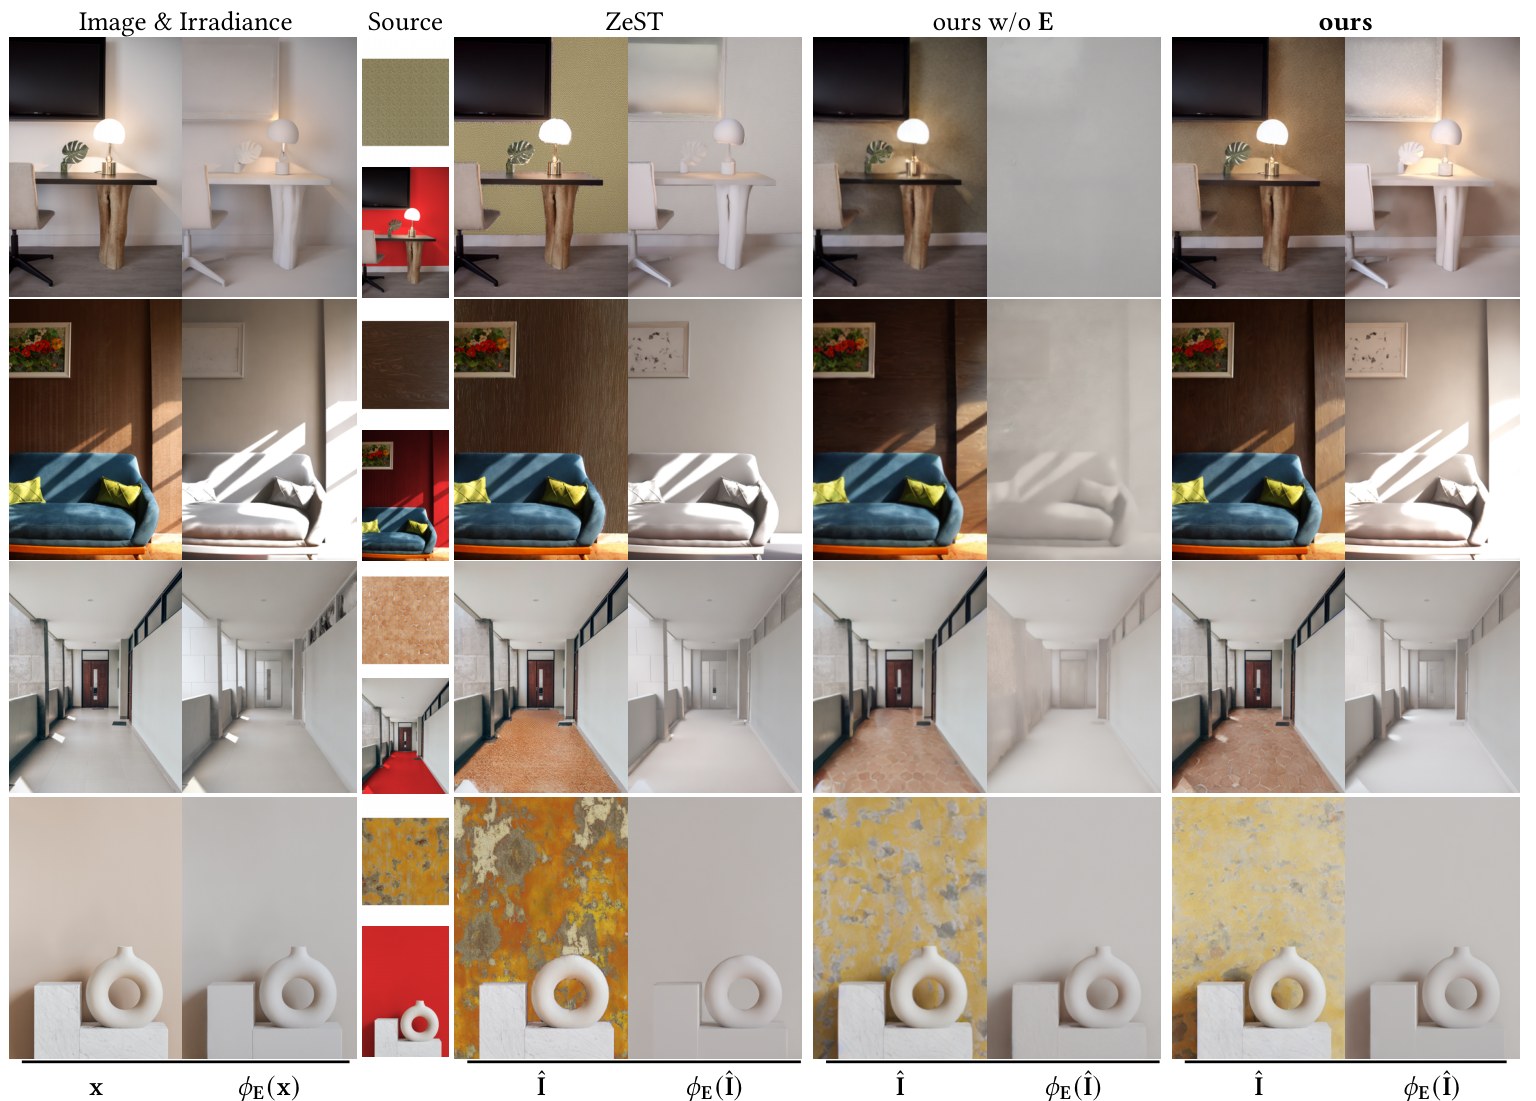
Table 2 比较编辑前后的估计 irradiance,用 PSNR/LPIPS 衡量照明保持。这不是传感器测得的真实照明差,也不是多光照 BRDF 验证。若同一估计器还提供模型条件,存在“在估计器表征中匹配”的偏向;未来应加入合成 ground-truth E 或独立估计器验证。
Baseline 公平性
文中使用作者原模型,但各方法有不同 conditioning:文字模型需要文字描述,ZeST 使用 exemplar 和 depth ControlNet,MatSwap 使用额外 E/N。Figure 9 的文字提示可帮助理解外观提示的局限,却不能将差异全归因于某个网络结构;额外条件、专门训练、参数量和预训练数据都影响结果。论文未给每种 baseline 的完整超参和同预算速度对照。
来源:v1 §4、Figure 7、9;Table 1–2。
12 · 三张关键表:完整数据与谨慎解读
原 Table 1 · Inpainting / material transfer
| Method | Synthetic PSNR ↑ | Synthetic LPIPS ↓ | Real CLIP-I ↑ |
|---|---|---|---|
| SD v2.1 | 18.16 | 0.2214 | 0.7611 |
| SD-XL inpaint | 19.10 | 0.2025 | 0.7462 |
| FLUX.1 Fill | 19.92 | 0.1825 | 0.7552 |
| Blended LD | 19.57 | 0.2282 | 0.7303 |
| ZeST | 19.10 | 0.1879 | 0.7790 |
| MatSwap | 20.62 | 0.1783 | 0.7994 |
本文计算:相对最强合成 baseline FLUX.1 Fill,PSNR +0.70 dB,LPIPS 降低 0.0042,约 2.30%;按表中四位小数计算略不同于作者正文所写约 2.4%,可能与舍入有关,不强行改动原数字。真实 CLIP-I 相对 ZeST 增加 0.0204,约 2.62%。PSNR 以 dB 为单位,对 dB 做 3.5% 的比例不是直接等价的图像误差百分比;按同一峰值 L 换算,+0.70 dB 对应 MSE 约下降 14.9%。
原 Table 2 · Irradiance consistency
| Method | PSNR ↑ | LPIPS ↓ |
|---|---|---|
| SD v2.1 | 16.79 | 0.1275 |
| SD-XL inpaint | 18.86 | 0.1010 |
| FLUX.1 Fill | 20.93 | 0.0821 |
| Blended LD | 20.40 | 0.0847 |
| ZeST | 18.84 | 0.0962 |
| MatSwap w/o E | 18.94 | 0.0925 |
| MatSwap | 21.43 | 0.0668 |
去掉 E 后到完整模型,irradiance PSNR 增加 2.49 dB,LPIPS 下降 0.0257,约 27.8%。相对 FLUX.1 Fill,PSNR +0.50 dB、LPIPS 下降约 18.6%。这一表更直接支持加入 E 能改善该估计器下的光照一致性,但不能据此断言 specular 或间接照明完全物理正确。
原 Table 3 · 全部 architecture/design ablations
✓ 表示该列训练参数或输入条件存在,— 表示不训练/不作为该输入。IP-A 一列表示适配器训练;UNet 一列表示 denoiser 训练。A1–A3 的区域信息用于 masked loss,而不是作为 M 通道输入;不能理解成训练完全不知道编辑区域。
| Variant | Train IP-A | Train UNet | Input M | Input N | Input E | PSNR ↑ | LPIPS ↓ |
|---|---|---|---|---|---|---|---|
| A1 | ✓ | — | — | — | — | 19.06 | 0.3560 |
| A2 | — | ✓ | — | — | — | 18.81 | 0.3626 |
| A3 | ✓ | ✓ | — | — | — | 18.70 | 0.3642 |
| A4 | ✓ | ✓ | ✓ | — | — | 20.04 | 0.3277 |
| A5 | ✓ | ✓ | ✓ | ✓ | — | 19.91 | 0.3284 |
| A6 | ✓ | ✓ | ✓ | — | ✓ | 20.28 | 0.3281 |
| A7 | — | ✓ | ✓ | ✓ | ✓ | 20.22 | 0.3243 |
| A8 | ✓ | ✓ | ✓ | ✓ | ✓ | 20.38 | 0.3256 |
所有 ablation 都只训练 50K iterations;表 3 和最终模型表 1 的训练预算不同,LPIPS 数值尤其不能当成同条件相互比较。原文未给随机种子方差、置信区间或统计检验;小差别应避免写成“显著”。
三张原表均在固定 PDF 第 5 页。所有数值和 ✓/— 条件逐行核对,未删掉与作者叙述不完全一致的行。
13 · 消融读法:看具体对照,不背作者结论
| 对照 | 指标变化 | 能支持的结论 |
|---|---|---|
| A3 → A4:mask 作为输入 | PSNR +1.34;LPIPS −0.0365 | 显式位置条件比仅 masked loss 有明显帮助 |
| A4 → A5:无 E 时增加 N | PSNR −0.13;LPIPS +0.0007 | 两项都略差,不支持“法线无条件提高质量”的泛化说法 |
| A4 → A6:无 N 时增加 E | PSNR +0.24;LPIPS +0.0004 | PSNR 提升,LPIPS 略差;不是两项一致改善 |
| A6 → A8:已有 E,再增加 N | PSNR +0.10;LPIPS −0.0025 | 法线可能与 E 互补,支持条件化而非普遍的收益 |
| A5 → A8:已有 N,再增加 E | PSNR +0.47;LPIPS −0.0028 | 联合场景条件改善两项指标 |
| A7 → A8:训练 adapter | PSNR +0.16;LPIPS +0.0013 | 存在指标 trade-off;最佳 LPIPS 是 A7,最佳 PSNR 是 A8 |
作者文字说 N 有小幅帮助、训练 adapter 改善结果;严格阅读应补充上面的上下文。正常的实验结果允许不同指标不同步,问题在于把它简化成所有因素都单调增加性能。这里没有更改原结果,只限定推断范围。
完整原图与 E 共同提供光照
Figure 5 比较四种条件:目标区域被遮掉且无 E;遮掉但有 E;完整 x 但无 E;完整 x 且有 E。完全移除局部光照线索时结果趋于平坦;恢复任一线索有帮助,两者都保留时最好。这支持 illumination 信息来源互补,同时说明网络并非只从 E 读取照明。
Figure 4 将生成结果再做 irradiance 分解,与原图估计值对照。结果可视化与 Table 2 一致:完整模型较能保留局部投光、高频亮斑与明暗。但这些图中“保留高光”的能力不能直接证明 E 本身存储了 specular 分量,因为网络同时看到了 x。
来源:v1 §4.1、Table 3、Figure 4–5。
14 · 全量比较图与失败模式
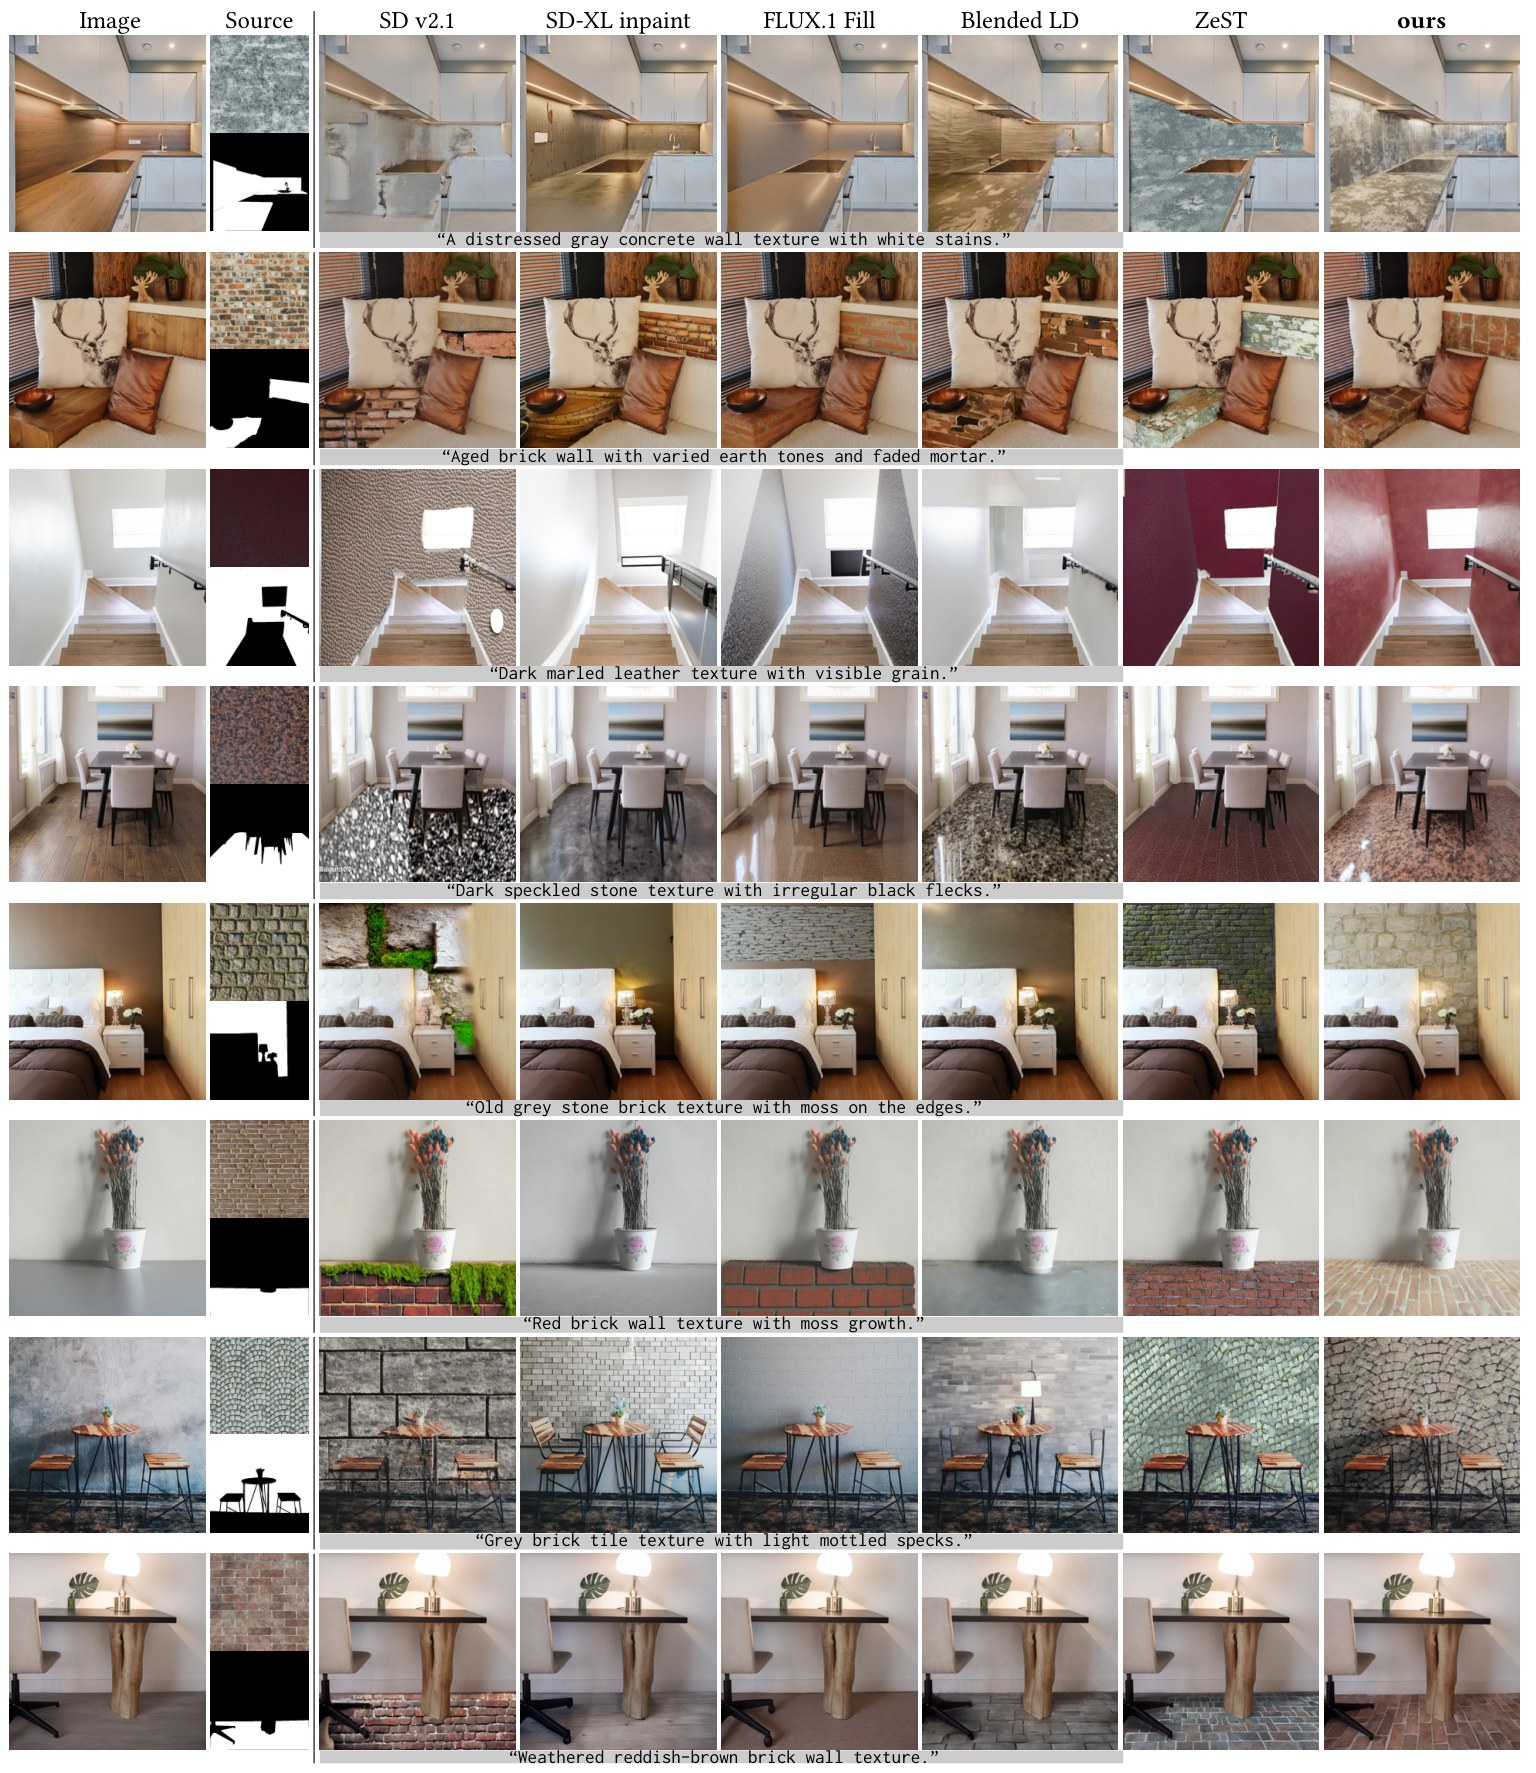
Figure 9 包含 8 行真实场景/材质组合和所有主要 baseline。文字驱动模型的目标描述再详细也难以精确规定纹理相位/细节,部分结果像正交纹理贴在目标上;ZeST 保留一些几何线索但会出现伪影;MatSwap 的定性优势是透视、局部投光与上下文融合。应同时检查例外和区域外变化,不能把作者挑选图例当成真实分布完整统计。
论文承认的限制
- 高频法线细节:局部几何结构可能在材质替换中丢失。
- 向下表面:训练场景缺少此类法线分布,导致泛化失败。
- 薄/小物体:latent-space mask 下采样可能侵蚀目标区域,生成分辨率进一步限制细边。
- 估计器误差:真实照片的 N/E 不是真值,错误几何或 shading 直接影响结果。
额外 reviewer 风险:局部 albedo 变化与 cast shadow 会被错误分解;全图单视角 editing 没有保证多视角材质一致;对强镜面、透明、各向异性或复杂全局反射,diffuse E 条件不足以给出物理约束。后两项是依据表示作出的局限分析,不是论文已系统测过的 benchmark 结论。
来源:v1 §5、Figure 8–9。v1 没有独立附录;Figure 9/10 已在本页完整收录。
15 · Reviewer commentary:贡献、代价与复现优先级
Strengths
- 任务接口实用:目标图、mask、平面材质图,比逐像素编辑 PBR/UV 简单。
- 表示有针对性:用 E/N 保留场景线索,用 exemplar 全局特征控制新材质,避免把旧 albedo/roughness 当硬条件。
- 数据配对干净:几何和照明不变、只有目标材质变化,可直接训练 supervised inpainting。
- 实验分开测编辑质量与照明保持,且给出完整 8 行设计消融;推理代码/权重现在可供审读。
Weaknesses
- 可控性仍是隐式:CLIP global conditioning 不提供每个 texel 的明确对应关系。复杂图案的朝向、重复频率和结构保真仍可漂移。
- 度量不完全独立:CLIP 同时处于条件与评价链路,irradiance estimator 同时用于条件与一致性评估,都可能偏重已有表征而非物理真实性。
- 消融统计不足:无种子方差,若干小变化与文字总结不完全一致;不能把每个组件都描述为普遍增益。
- 资产与训练复现不完整:公开推理代码不含训练/全量数据/评估流程,难以复算表格并控制 domain gap。
- 效率未量化:缺少 AOV 估计开销、显存与速度,用户实际交互延迟无法从论文推导。
- 场景身份是软目标:发布实现没有硬复合区域外像素,需量化编辑外 drift;保留了完整 x 也可能使旧材质泄漏进生成。
优先补充实验:区域内/区域外分别报告误差;使用独立 irradiance/normal estimator 交叉评估;按 mask 尺寸、法线朝向、纹理频率、镜面程度分层;明确不同 exemplar scale 的度量误差;对比等预算训练下 primitives 与完整场景混合;报告首次 AOV 与缓存推理的端到端延迟。
16 · 对 PMG 与用户研究方向的延伸
本节全部为 Research Extension。MatSwap 本身不生成 material graph,但它提供了一个自然的研究接口:将程序材质的 renderer 输出作为 exemplar,把真实场景视为外观验证环境;或把它的条件分离思想移植到程序图搜索中。
A. 显式投影控制:从 exemplar scale 到可标定频率
原笔记提出更精确的铺贴控制,正对准当前方法的薄弱点。可增加目标区域的局部 tangent frame、UV proxy 或可编辑周期场,让“纹理看起来变大”变成“沿表面每米 k 次重复”。保持 E/N 独立,再将材质局部 patch 与相应位置做 attention 或 geometry-aware alignment。
\[\mathbf q(\mathbf u)=A\mathbf u+\mathbf b,\qquad \mathbf k_{\mathrm{scene}}=J_{\mathbf q}^{\mathsf T}\mathbf k_{\mathrm{tex}}.\]
A/b 表示二维仿射材质坐标控制,J 是映射 Jacobian,k 表示局部纹理频率。这只是一个可操作的研究表述,不解决遮挡/非平面完整 UV。评测应量化方向、尺度和相位误差,不能仅用 CLIP-I 判断铺贴准确。
B. Self-attention 材质参考与 cross-attention 的公平对照
原笔记建议以 self-attention 融合替代仅 adapter cross-attention。可将 exemplar tokens 与目标 patch tokens 拼接,加入角色/坐标编码,允许局部纹理细节显式交互。对照必须固定 base checkpoint、训练数据、参数预算和迭代数,否则改架构、增容量与改善空间匹配无法区分。
建议对比 global CLIP adapter、局部 patch cross-attention、共享 self-attention、加入显式变换位置编码四组。分别记录外观相似、纹理局部保真、几何扭曲、区域外 drift 和高频材质失败率。不要预设 self-attention 天然优于所有 cross-attention;关键是保留的信息与匹配约束。
C. Diffuse 与 specular 分离的光照条件
保持 diffuse E 的简洁性,同时引入粗环境光方向/高光结构或反射方向提示,探索对 metallic、低 roughness 材质的稳定控制。要避免把旧材质的高光直接粘到新材质上:新增条件应更接近入射光或可见性,而非旧材质的最终 specular RGB。
\[\mathcal L=\lambda_d\mathcal L_{\mathrm{diffusion}}+\lambda_E d_E+\lambda_G d_G+\lambda_O\|\big(1-M_{\mathrm{edit}}\big)\odot(\widehat I-x)\|_1.\]
上式为研究性多目标示例:d_E 控光照、d_G 控几何,区域外项控制场景身份。各项不能全部由同一估计器自我评判;合成真值与真实人工评价应结合。保持原图非目标区域也可能压制合理 interreflection 变化,需区分“严格局部编辑”与“允许物理全局响应”的任务目标。
D. 与可执行材质图的闭环
\[G,\theta\xrightarrow{\mathrm{execute}}M_G\xrightarrow{\mathcal R(\ell_0)}p_G\xrightarrow{\mathrm{MatSwap}(x,N,E,M)}\widehat I_G.\]
G 是 procedural graph,θ 是参数,\(M_G\) 是执行得到的材质图;固定光照 ℓ₀ 渲染一个平面 exemplar p_G,再测试换到目标照片后的外观。它可作为方案预览或图搜索辅助,但 MatSwap 的幻觉会破坏图与结果的确定对应,不能直接把最终 RGB 当作 graph 的物理真值。仍应回到 renderer 验证多光照与可编辑参数。
| 研究实验 | 最小对照 | 成功条件 |
|---|---|---|
| 完整场景训练 | primitives-only / artist-only / mix,同渲染预算 | 复杂/向下法线泛化改善且没有牺牲材质覆盖 |
| 铺贴控制 | 隐式 crop / 显式坐标 / 可变换位置编码 | 尺度角度误差下降,而非仅图像变漂亮 |
| 参考 token 融合 | global adapter / patch cross-attn / shared self-attn | 细图案保真改善,区域外与光照指标不退化 |
| 程序材质预览闭环 | 纯 render 目标 / MatSwap 辅助 / 双重验证 | 用户选择效率提高,输出图可执行/可编辑且物理渲染一致 |
最值得优先尝试的是可标定的尺度/方向控制 + 几何/光照分离:它直接延续用户已有思路,同时可以用明确误差评价,而不只做更换 backbone 的经验实验。
17 · 复现实务与本次验收边界
依赖证据:官方 README 报告测试 Python 3.11.5,推荐 torch2.3.0、torchvision0.18.0、diffusers0.30.3、transformers4.41.2、accelerate0.31.0,以及 OpenCV;RGBX 是第三方 submodule。当前 checkpoint PNDM 的 training timesteps=1000、scaled_linear beta schedule,beta 从 0.00085 到 0.012,prediction_type=epsilon。配置是发布包证据,不代表所有训练脚本已经恢复。
- 固定代码 SHA、checkpoint revision、RGBX submodule 和依赖版本,先验证本地 snapshot 加载 adapter 的路径。
- 检查 image/mask/N/E 的尺寸、数值范围、相机空间法线与 gamma 约定,避免复用不匹配缓存。
- 选择官方 demo 样本,记录 seed、50-step scheduler、API/CLI guidance 差异;记录结果前后像素尺寸。
- 分别测首次 AOV、缓存 MatSwap 的耗时,量化 mask 外漂移,保存输入与全部 AOV。
- 申请或定位完整训练/评测资产后再复算表 1–3;未拿到时不可声称完整复现。
许可:仓库代码是 MIT;README 明确提示底层 Stable Diffusion 1.5 checkpoint 另受 CreativeML Open RAIL-M 约束,第三方 RGBX、图片、MatSynth 资产各有其许可。代码许可不自动覆盖所有权重与示例数据。本次只下载了少量源码/配置用于阅读,没有执行安装或取得新账号权限。
交付:完整中文 HTML、详细 Markdown 增量、保留原笔记字节前缀的合并候选、来源证据、归档计划和静态 QA。单 HTML 小于 20,000,000 字节;Figure 1/2 优先引用核验的固定版官方原图,其余复合图从固定 PDF 内嵌,MathJax 主脚本内嵌。浏览器 MathJax、图片、导航和 1440/760/390 响应式验收按当前安排留待本地下载后;当前静态检查不能冒充浏览器通过。
18 · Sources 与快速复读路线
- 固定 v1 PDF与固定 v1 HTML:正文全部方法、数据、表 1–3、图 1–10。
- arXiv 版本记录:v1 为 2025-02-11,v2 为 2025-06-25;本页不混用。
- Eurographics 官方记录:正式发表 CGF/EGSR 2025,DOI 10.1111/cgf.70168。
- 官方仓库固定提交:pipeline.py、demo.py、aovs.py、README、submodule、目录树审计。
- 官方 Hugging Face 模型:仅读取 config/model index;未运行模型或替代 v1 源文件。
复读顺序:Figure 2 与 Eq.1 → PBRand 的 UV scale matching → Table 2 的光照一致性 → Table 3 的具体成对消融 → pipeline 的 14 通道、guidance 和输出路径。这样能把方法机制、实验支持与实际复现风险联系起来。
核查日期 2026-09-30。原图版权归 Lopes、Deschaintre、Hold-Geoffroy、de Charette;本页作论文精读引用。未发布网站、未修改用户 vault 或原笔记。