3.43 FID
ImageNet 256×256,XL/2,240 epochs,1-NFE
Mean Flows for One-step Generative Modeling|从瞬时速度到区间平均速度,理解一步生成的数学与实现
Zhengyang Geng · Mingyang Deng · Xingjian Bai · J. Zico Kolter · Kaiming He|NeurIPS 2025 Oral(固定 v1 精读)
Flow Matching 学习“此时此刻往哪里走”;MeanFlow 学习“从当前时刻 t 到目标时刻 r,整段旅程的平均速度”。如果平均速度预测准确,一次网络求值就能跨越完整区间,而不必用许多短切线近似弯曲轨迹。
固定版本:arXiv:2505.13447v1,2025-05-19,共 16 页;正文 pp.1–9,致谢与参考文献 pp.10–13,Appendix A–C pp.14–16。作者 Zhengyang Geng、Mingyang Deng、Xingjian Bai、J. Zico Kolter、Kaiming He;第一作者 CMU,部分工作访问 MIT 完成。论文后续为 NeurIPS 2025 Oral,这里不以新版本替换固定 PDF,也不改原笔记元数据。
ImageNet 256×256,XL/2,240 epochs,1-NFE
XL/2+,1000 epochs,2-NFE;不是同预算 1-NFE 成绩
生成网络从头训练,无蒸馏或时间课程;ImageNet 仍用预训练 VAE
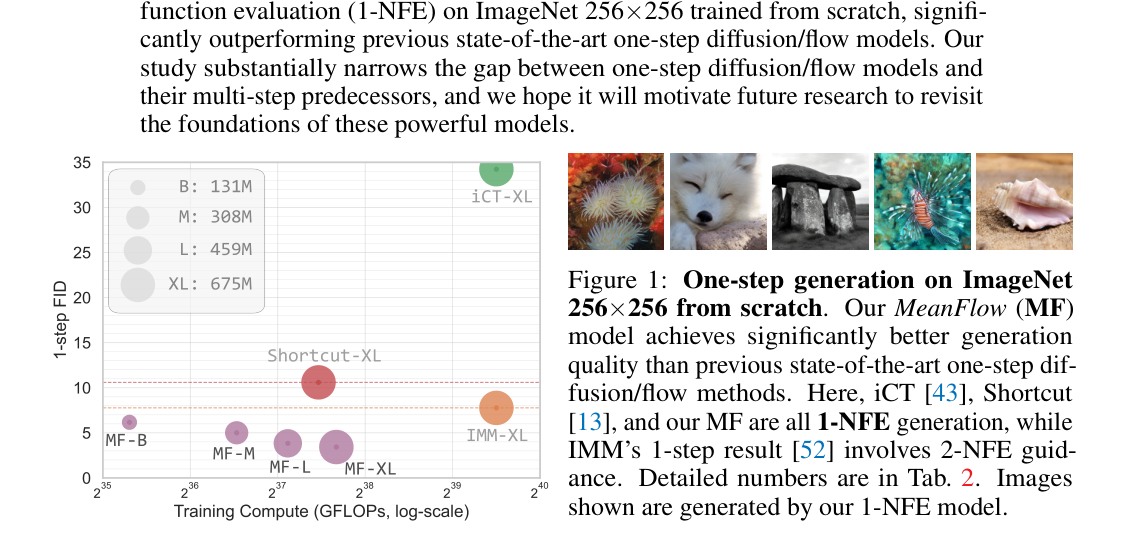
Figure 1:单步质量与训练计算量比较,同时展示生成例。IMM 的“one-step”使用 CFG 而需 2-NFE;MeanFlow 的引导已经进入训练目标,推理仍为 1-NFE。NFE 只计速度网络求值,不等于整个系统仅做一次所有组件前向。
给定数据 x 与独立高斯噪声 \(\epsilon\),线性插值 \(z_t=(1-t)x+t\epsilon\) 是直线,样本条件速度 \(v_t=\epsilon-x\) 是常量。但同一个中间点 \(z_t\) 可以由许多不同的 x、噪声组合得到;网络看到的监督在该位置要对这些速度取条件平均,形成边际速度场。这个边际场的 ODE 轨迹通常是弯的,哪怕每一条训练插值线都笔直。
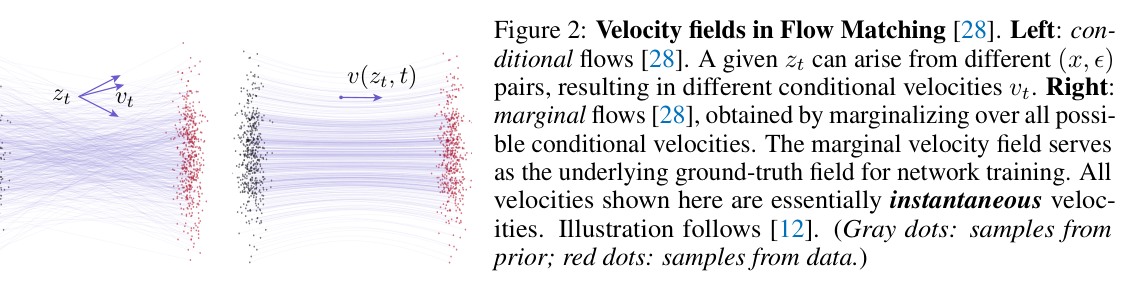
Figure 2:左侧是样本条件流,右侧是边际流;混合不同路径改变了局部方向。由此,一步 Euler 用起点切线跨越整个区间会产生大的积分误差。这不是仅因神经网络不够准造成的,即使瞬时速度网络完美,粗离散化仍可能失败。
| 对象 | 符号/定义 | 用途 |
|---|---|---|
| 样本条件瞬时速度 | \(v_t=\epsilon-x\) | 可从训练样本直接计算,但不是平均速度 u |
| 边际瞬时速度 | \(v(z_t,t)=\mathbb E[v_t\mid z_t]\) | 定义生成 ODE 的切向量 |
| 平均速度 | \(u(z_t,r,t)\) | 沿边际 ODE 轨迹的积分除以区间长度 |
| 位移 | \((t-r)u\) | 从 t 反向到 r 时应减去的总移动量 |
| 网络 | \(u_\theta\) | 近似真平均场;不是直接知道积分标签 |
| sg | stop-gradient | 阻断目标端参数导数,避免对 JVP 再求高阶梯度 |
任务输入是随机噪声与可选类别条件,输出是生成图像;本文没有源图编辑、文本图像对齐、程序图 token 或 renderer-in-the-loop。ImageNet 在 32×32×4 的 VAE latent 中工作,CIFAR-10 在 32×32×3 像素空间工作。
时间约定为数据端 0、噪声端 1;生成时从 1 走到 0。式 1–2 确定的是边际流,不应把积分轨迹误换成某一随机训练样本的直线。
给定当前位置 \(z_t\) 与两端时间,沿同一 ODE 轨迹回到 r;u 指向正时间积分的位移方向,反向生成要减去它。它依赖 r 与 t,并非对不同样本取平均,也不是对网络历次预测做 EMA。
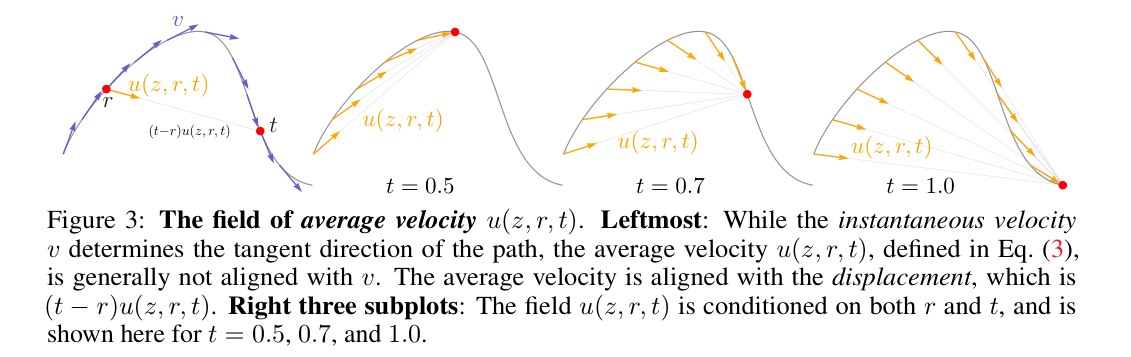
Figure 3:v 与轨迹切线一致,u 与端点位移一致;两者一般不平行。r 趋近 t 时 u 趋近 v。对任意中间时刻 s,平均速度的加权可加性来源于积分可加,而不是额外训练启发式:
固定 r,让 t 沿轨迹变化。左侧用乘积法则,右侧用微积分基本定理:
这就是 MeanFlow Identity。它把难以直接获取的积分标签换成瞬时速度和平均场自身的导数,定义在真实场层面,尚未涉及神经网络。若 r 也随 t 变化,积分下限会产生额外 Leibniz 项,不能继续使用此式。
式 8 用列向量 Jacobian 记法写作 \(J_z u\,v\),对应原文的 \(v\partial_z u\)。这是总导数,不能只保留 \(\partial_tu\),更不能把 r 的切向量设成 1。对函数参数顺序 (z,r,t),正确 JVP tangent 是 (v,0,1);若顺序是 (z,t,r),它必须变成 (v,1,0)。
Appendix B.3 的充分性:只要求导数相等一般会差一个积分常数;MeanFlow 利用 \(S=(t-r)u\) 在 t=r 处自然为零消去常数。这个论证需要 u 在对角线附近有限/足够规则,以及 ODE 轨迹与导数有良好定义;不能把无正则的奇异函数也算成保证对象。
代入 t=r,两边积分和位移均为 0,得到 \(C_1=C_2\)。直接学习任意位移 S 则还需额外保证边界条件。
目标中没有另一个教师模型:它用当前网络的导数,把瞬时速度转换为平均速度的自举监督。stop-gradient 只阻断目标对于参数的梯度,不删除导数数值,也不意味着网络输出分支不需要反传。
边际 v 本身不可直接获得,因此换成可采样的条件 \(v_t\)。在未加自适应权重、固定当前 target/JVP 并使用平方损失的半梯度视角,目标对 \(v_t\) 是线性的,条件期望恢复边际版本。这不表示每一条训练样本的噪声目标都能同时实现零误差,也不意味着加入数据依赖权重后的优化自动拥有同样无偏性。
不能先把整个 u 也 detach;否则没有学习信号。也不能去掉 target 上的 detach;那会改变优化问题,并引入通过 JVP 的参数高阶导数。原文以“额外 backward pass”解释成本;从自动微分术语看,JVP 是方向导数,常由 forward-mode 实现,与 reverse-mode VJP 不同。具体成本取决于库、编译和算子支持。
一次采样不再计算 JVP,不需显式积分许多瞬时速度。两步可以选 \(1\rightarrow s\rightarrow0\) 并调用网络两次,第二次输入是第一步实际输出;步点如何选会影响误差。ImageNet 最后还需 VAE decoder,CIFAR 则直接得到像素。这里 1-NFE 的“1”仅指一次生成网络调用。
第二个期望需要按与当前位置兼容的类别条件分布理解,不能随意替换成均匀类别平均。原文省略了这层条件记号。由引导瞬时场定义引导平均场:
这里使用对角线平均速度=瞬时速度,以及无条件平均引导场与原无条件场的关系。网络学习的已经是 guided field,而不是在推理时另外跑有/无条件两份结果。
注意 JVP 的空间切向量也要换成 \(\tilde v_t\),不是只改 target 首项。类别以 10% 概率丢弃,让无条件输出有训练机会;\(\omega=1\) 回到无 CFG 的公式。推理无需额外线性组合,因此仍为 1-NFE。代价转移到了训练端,包括额外对角线网络调用,不能说引导在训练和推理两端都免费。
把有条件对角线项移到左侧,可得有效引导 \(\omega'=\omega/(1-\kappa)\)。因此 \(\omega\) 不是最终可比较的 CFG 强度;比较 \(\kappa\) 的影响时必须固定 \(\omega'\),同时调整 \(\omega=(1-\kappa)\omega'\)。Table 5 正是这样做的。若固定 \(\omega\) 而增大 \(\kappa\),就混入了 guidance 变强的因素。
| \(\kappa\) | FID,1-NFE |
|---|---|
| 0.0 | 20.15 |
| 0.5 | 19.15 |
| 0.8 | 19.10 |
| 0.9 | 18.63 |
| 0.95 | 19.17 |
\(\Delta=u_\theta-\operatorname{sg}(u_{\mathrm{tgt}})\),c 为防除零常数。大误差样本权重被降低,改变训练动态。原文以幂次范数的导数解释 \(p=1-\gamma\);但默认 p=1 对应 \(\gamma=0\),不能机械声称是在最小化恒定的 \(L^0\)。在固定 target 与平滑项 c 的局部梯度意义上,p=1 对应 \(\log(L+c)\) 的梯度形状;p≠1 对应 \((L+c)^{1-p}/(1-p)\)。这是本页解释,不是论文额外损失公式。
尤其不能直接对 \(L/(L+c)^p\) 完整求导替代 sg 权重:分母的导数会改变优化方向。论文举 c=10⁻³ 为例;当前官方 JAX 默认 norm_eps=0.01,两者需分别记录,不要静默统一。
独立采样两个数,再排序,大的作 t、小的作 r;不是先从有序二维均匀分布之外任意拼接。logit-normal 先采正态,再 sigmoid 到 (0,1)。默认 ImageNet 使用 μ=−0.4、σ=1.0;25% 样本保留 r≠t,其余 75% 设 r=t。后者提供局部瞬时速度训练锚点;100% r=t 退化为普通 FM,无法一步跨越弯曲边际流。
DiT 可以实际输入 (t,t−r) 的位置 embedding,但 JVP 必须对包装函数 \(u_\theta(z,r,t)=\mathrm{net}(z,t,t-r)\) 求导。固定 r 时 t 与区间 t−r 都以速度 1 变化。如果直接对 net 的第二时间槽指定 0,就漏掉链式法则。时间是两个标量,不代表它们不重要;Table 1b 的错误切向量会让 FID 大幅恶化。
已完整读取官方 JAX meanflow.py:内部包装顺序为 (z,t,r),因此使用 (v_g,1,0);target 与权重分母都 stop_gradient;误差先对所有空间/通道求和,再 batch 平均。默认 data_proportion=0.75 表示对角线比例,不是非对角比例。类别丢弃时 guided target 回到样本 v。采样使用一次 u_fn 并按区间长度相减。读取代码用于核查,未训练模型。
当前 run_b4.yml 为 240 epochs,而论文主要 ablation 为 80 epochs;仓库给出的 B/4 sanity checkpoint 约 11.4 FID 也不是论文的无 guidance 61.06。官方 PyTorch CIFAR 仓库提醒,torch.func.jvp 对 DDP 包装器的处理可能绕过梯度同步;应核查其显式同步与梯度 sanity check。无编译时可单独计算带梯度的 u,再在 no_grad 下做 JVP,并保持 dropout RNG 一致。后续 v1 改进脚本与原论文 v0 配置需分开。
一手实现:JAX 核心、B/4 配置、官方 PyTorch 说明。2026-09-30 读取;未锁定历史 commit,未把更新版 iMF/pMF 混入本文结论。
ImageNet 类别条件生成在预训练 VAE latent 训练生成器。DiT/ViT 的 adaLN-Zero blocks 保持不变;两个时间各做 positional embedding + 两层 MLP 后相加。/4 与 /2 是 latent patch size,分别对应 8×8=64 和 16×16=256 个空间 patch token。模型不是直接处理 256×256 RGB token。
| Configuration | B/4 | B/2 | M/2 | L/2 | XL/2 | XL/2+ |
|---|---|---|---|---|---|---|
| params (M) | 131 | 131 | 497.8(原表) | 459 | 676 | 676 |
| FLOPs (G) | 5.6 | 23.1 | 54.0 | 119.0 | 119.0 | 119.0 |
| depth | 12 | 12 | 16 | 24 | 28 | 28 |
| hidden dim | 768 | 768 | 1024 | 1024 | 1152 | 1152 |
| heads | 12 | 12 | 16 | 16 | 16 | 16 |
| patch size | 4×4 | 2×2 | 2×2 | 2×2 | 2×2 | 2×2 |
| epochs | 80 | 240 | 240 | 240 | 240 | 1000 |
| batch size | 256 | 256 | 256 | 256 | 256 | 256 |
| dropout | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| optimizer | Adam | Adam | Adam | Adam | Adam | Adam |
| LR schedule | constant | constant | constant | constant | constant | constant |
| LR | 0.0001 | 0.0001 | 0.0001 | 0.0001 | 0.0001 | 0.0001 |
| Adam \((\beta_1,\beta_2)\) | (0.9,0.95) | (0.9,0.95) | (0.9,0.95) | (0.9,0.95) | (0.9,0.95) | (0.9,0.95) |
| weight decay | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| EMA decay | 0.9999 | 0.9999 | 0.9999 | 0.9999 | 0.9999 | 0.9999 |
| ratio r≠t | Table 1a | 25% | 25% | 25% | 25% | 25% |
| (r,t) condition | Table 1c | \((t,t-r)\) | \((t,t-r)\) | \((t,t-r)\) | \((t,t-r)\) | \((t,t-r)\) |
| (r,t) sampler | Table 1d | lognorm(−0.4,1.0) | lognorm(−0.4,1.0) | lognorm(−0.4,1.0) | lognorm(−0.4,1.0) | lognorm(−0.4,1.0) |
| p for adaptive weight | Table 1e | 1.0 | 1.0 | 1.0 | 1.0 | 1.0 |
| CFG effective scale \(\omega^\prime\) | Table 1f | 2.0 | 2.0 | 2.5 | 2.5 | 2.0 |
| CFG \(\omega\), Eq.21 | \(\omega=\omega^\prime\) | 1.0 | 1.0 | 0.2 | 0.2 | 1.0 |
| CFG \(\kappa\), Eq.21 | \(1-\omega/\omega^\prime\) | \(1-\omega/\omega^\prime\) | \(1-\omega/\omega^\prime\) | \(1-\omega/\omega^\prime\) | \(1-\omega/\omega^\prime\) | \(1-\omega/\omega^\prime\) |
| CFG class-condition drop | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 |
| CFG activated t interval | [0.0,1.0] | [0.0,1.0] | [0.0,1.0] | [0.0,0.8] | [0.0,0.75] | [0.3,0.8] |
固定 v1 异常原样保留:Table 4 把 M/2 参数写为 497.8M,Table 2 为 308M;二者不一致,本页没有擅自挑一个改写。Table 4 的 L/2 与 XL/2 FLOPs 都写 119.0G,值得复现时用实际模型重新核算。报告精确参数与 FLOPs 时应标明采用哪个表/实际实现。
| 项 | 作者报告 |
|---|---|
| 任务 / 表示 | 无类别条件;32×32×3 像素 |
| 模型 / 条件 | 约 55M U-Net;(t,t−r) embedding 拼接;无 EDM preconditioner |
| Optimizer / LR | Adam;0.0006;β=(0.9,0.999) |
| 训练长度 / batch | 800K iterations;batch 1024;10K warm-up |
| Dropout / decay | Dropout 0.2;weight decay 0;EMA 0.99995 |
| 时间分布 / 非对角比例 | lognorm(−2.0,2.0);r≠t 为 75% |
| Loss | 自适应权重 p=0.75 |
| Augmentation | 沿用 EDM 设置,但关闭 vertical flipping 与 rotation;完整其他参数未在固定 PDF 逐项列出 |
ImageNet 表未报告总训练 wall-clock、全部设备规模或峰值显存;不能把 ablation 的局部 JVP benchmark 当作 XL/2 全训练成本。Appendix B.4 使用 JAX、v4-8 TPU、B/4:FM 0.045 秒/iter,MeanFlow 0.052 秒/iter,按原数计算增加约 15.56%,作者取整称 16%。这只说明该环境下的额外 JVP 成本,不保证 PyTorch/任意算子相同。
“from scratch”限定:速度/平均场网络从头训练,无 pretrained diffusion teacher;ImageNet 的 VAE 已预训练。FID 依赖生成 50K 样本及参考统计;本文没有新建训练数据集,也没有文本 prompt、top-k 或 beam search。
全部使用 B/4、80 epochs、ImageNet 256×256、FID-50K,默认 1-NFE。以下各子表完整重建,不把不同控制条件混成同一实验。
| r≠t 比例 | FID,1-NFE |
|---|---|
| 0% (= FM) | 328.91 |
| 25%(默认) | 61.06 |
| 50% | 63.14 |
| 100% | 67.32 |
| Tangent for (z,r,t) | FID,1-NFE |
|---|---|
| \((v,0,1)\)(正确) | 61.06 |
| \((v,0,0)\) | 268.06 |
| \((v,1,0)\) | 329.22 |
| \((v,1,1)\) | 137.96 |
| Positional embedding | FID,1-NFE |
|---|---|
| \((t,r)\) | 61.75 |
| \((t,t-r)\)(默认) | 61.06 |
| \((t,r,t-r)\) | 63.98 |
| \(t-r\) only | 63.13 |
| Sampler | FID,1-NFE |
|---|---|
| uniform(0,1) | 65.90 |
| lognorm(−0.2,1.0) | 63.83 |
| lognorm(−0.2,1.2) | 64.72 |
| lognorm(−0.4,1.0)(默认) | 61.06 |
| lognorm(−0.4,1.2) | 61.79 |
| p | FID,1-NFE |
|---|---|
| 0.0 | 79.75 |
| 0.5 | 63.98 |
| 1.0(默认) | 61.06 |
| 1.5 | 66.57 |
| 2.0 | 69.19 |
| \(\omega\) | FID,1-NFE |
|---|---|
| 1.0(无 CFG) | 61.06 |
| 1.5 | 33.33 |
| 2.0 | 20.15 |
| 3.0 | 15.53 |
| 5.0 | 20.75 |
Reviewer:消融提供有针对性的机制证据,尤其 JVP 破坏测试有解释力。但没有多 seed 方差;61.06 与 61.75 这类小差异不应被写成普适定律。
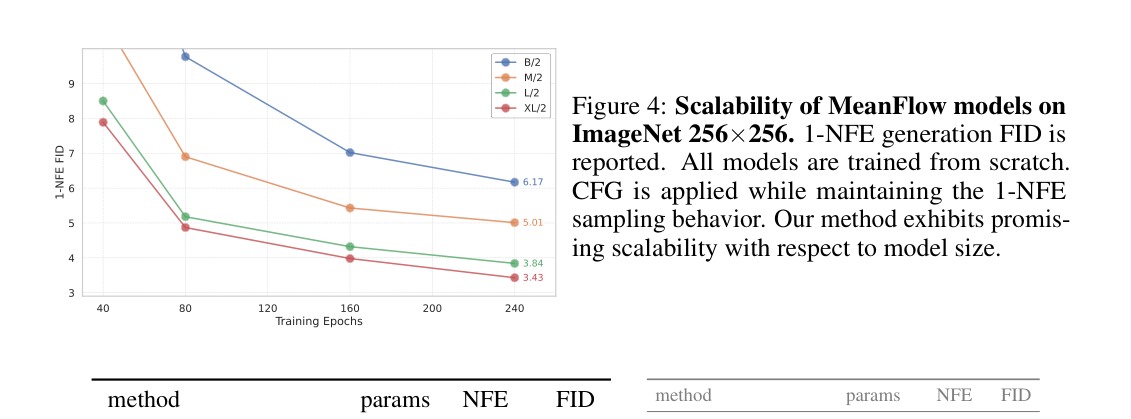
Figure 4:随模型规模和训练 epoch 增大,一步 FID 改善;240 epochs 的 B/M/L/XL 分别为 6.17/5.01/3.84/3.43。不同尺寸使用不同有效 CFG/窗口,因此曲线不完全隔离纯参数规模效应。
| 组别 | Method | Params | NFE | FID |
|---|---|---|---|---|
| 1-NFE | iCT-XL/2 † | 675M | 1 | 34.24 |
| 1-NFE | Shortcut-XL/2 | 675M | 1 | 10.60 |
| 1-NFE | MeanFlow-B/2 | 131M | 1 | 6.17 |
| 1-NFE | MeanFlow-M/2 | 308M | 1 | 5.01 |
| 1-NFE | MeanFlow-L/2 | 459M | 1 | 3.84 |
| 1-NFE | MeanFlow-XL/2 | 676M | 1 | 3.43 |
| 2-NFE | iCT-XL/2 † | 675M | 2 | 20.30 |
| 2-NFE | iMM-XL/2 | 675M | 1×2 | 7.77 |
| 2-NFE | MeanFlow-XL/2 | 676M | 2 | 2.93 |
| 2-NFE | MeanFlow-XL/2+ | 676M | 2 | 2.20 |
| Family | Method | Params | NFE | FID |
|---|---|---|---|---|
| GAN | BigGAN | 112M | 1 | 6.95 |
| GAN | GigaGAN | 569M | 1 | 3.45 |
| GAN | StyleGAN-XL | 166M | 1 | 2.30 |
| AR/masking | AR w/ VQGAN | 227M | 1024 | 26.52 |
| AR/masking | MaskGIT | 227M | 8 | 6.18 |
| AR/masking | VAR-d30 | 2B | 10×2 | 1.92 |
| AR/masking | MAR-H | 943M | 256×2 | 1.55 |
| Diffusion/flow | ADM | 554M | 250×2 | 10.94 |
| Diffusion/flow | LDM-4-G | 400M | 250×2 | 3.60 |
| Diffusion/flow | SimDiff | 2B | 512×2 | 2.77 |
| Diffusion/flow | DiT-XL/2 | 675M | 250×2 | 2.27 |
| Diffusion/flow | SiT-XL/2 | 675M | 250×2 | 2.06 |
| Diffusion/flow | SiT-XL/2+REPA | 675M | 250×2 | 1.42 |
Table 2 原注:适用时使用 CFG;×2 表示每步 CFG 需要两次评估;MeanFlow 常规模型训练 240 epochs,XL/2+ 更长;† iCT 数字由 IMM 论文报告。
明确区分:1-step 是一步更新;1-NFE 是一次网络评估。普通 CFG 一步通常需两次网络输出,因此 IMM 的 1×2 是 2-NFE。MeanFlow 的引导在训练端完成,不在采样时再跑无条件分支。
| 比较 | 由原表计算 | 应该怎样描述 |
|---|---|---|
| MF 3.43 vs Shortcut 10.60 | FID 降低约 67.64% | 1-NFE、相近 XL/2 类别下的显著表中优势 |
| MF 3.43 vs IMM 7.77 | 降低约 55.86% | MF 用 1-NFE,IMM 行为 1-step/2-NFE,不是同 NFE |
| MF-XL/2 3.43 → 2.93 | 增加到 2-NFE,FID 降约 14.58% | 相同常规训练长度下多一次评估的收益 |
| MF-XL/2+ 2.20 vs MF 2.93 | 均 2-NFE,但 1000 vs 240 epochs | 还改变了训练时长/配置,不能把收益全归于采样 |
MF 1-NFE 3.43 不是表中所有生成家族的最优:StyleGAN-XL 2.30、VAR 1.92、MAR 1.55、SiT+REPA 1.42 都更低,但各自表示、预算与 NFE 不同。原文“缩小差距”比“彻底击败所有多步模型”更准确。表 2 SiT 行为 2.06,正文 p.8 写 2.15;本页保留表值并指出冲突。
| Method | Preconditioner | NFE | FID |
|---|---|---|---|
| iCT | EDM | 1 | 2.83 |
| ECT | EDM | 1 | 3.60 |
| sCT | EDM | 1 | 2.97 |
| IMM | EDM | 1 | 3.20 |
| MeanFlow | none | 1 | 2.92 |
CIFAR-10:MeanFlow 2.92 与 iCT 2.83 接近,但没有优于它;比 ECT 3.60、sCT 2.97、IMM 3.20 更低。各方法相同约 55M U-Net、1-NFE,但其他方法使用 EDM preconditioning,MeanFlow 不用。结论应是有竞争力,不能写成全数据集第一。
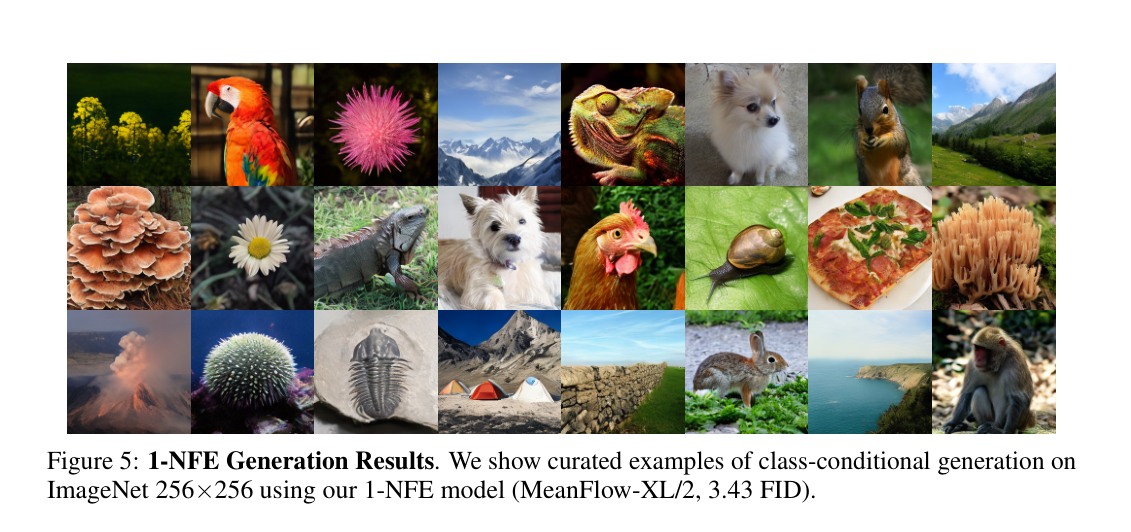
Figure 5:Appendix C 的 XL/2 1-NFE、FID 3.43 图像网格,作者明确标注 curated examples;这不是随机完整测试集,也不直接测多样性或失败率。
同时报告相同模型的 1/2/4-NFE FID、precision/recall 与真实毫秒延迟;对 target detach、adaptive weight 与时间覆盖作稳定性统计;按区间长度测平均场误差及可加性残差。对 CFG 目标求值与 JVP 分别 profile,并以 exact scalar/低维解析 ODE 验证切向量方向,避免只能在大模型 FID 中发现错误。
Research Extension:本文没有生成材质图、shader 或节点参数;以下是把平均流思想迁移到 PMG 的方案,不是已经被 MeanFlow 实验验证的功能。
先固定合法材质图拓扑 G,把连续参数 \(\phi\) 编码到无界 latent,学习 \(u_\theta(\phi_t,r,t\mid c)\),其中 c 可是参考图或材质类别。一步输出参数后通过有界映射还原颜色、粗糙度、频率等,再执行真实 renderer。保留合法拓扑可避免把离散节点直接当欧氏速度的问题。
关键障碍不是仅把 x 换成参数:不同节点参数尺度、等价图/等价参数、多模态逆解、周期角度及约束流形都会改变合理插值路径。参数域的直线也未必对应渲染外观的平滑变化。
将某个固定优化器从当前参数到若干步后参数的轨迹定义为 teacher dynamics,预测跨迭代区间的平均更新;输入包含渲染残差与目标图,输出大步参数修正。这样可以减少 renderer 调用,但它已成为优化轨迹蒸馏,不能沿用原论文“无预训练/无蒸馏”的宣传。接受更新前仍要真实渲染验证、约束投影与失败回退。
离散图结构用有类型的语法/自回归生成,连续节点参数由 MeanFlow 条件生成。显式执行 graph validity 检查后再渲染;图不合法时修复/回退,不能让连续速度负责凭空跨越无效拓扑。比较 1-NFE、2-NFE 与常规多步参数流,在相同图、相同训练数据、相同渲染预算下测试。
| 验证维度 | 建议量度 | 停止/失败处理 |
|---|---|---|
| 视觉外观 | 多光照/视角感知距离、纹理频谱、颜色与尺度 | 输出误差不达标可追加一次更新,报告追加比例 |
| 程序正确性 | 编译率、类型正确率、参数越界率 | 保留最近合法候选,不能隐藏无效样本 |
| 泛化 | 未见图拓扑、材质类别、渲染条件 | 定义分布外检测与拒绝条件 |
| 效率 | 总网络/渲染调用、显存、端到端时间 | 统一预算上限,不只报告 NFE |
这些是本页建议的复现流程,不是宣称已经运行。原文未给出的完整集群成本、精度策略、所有生成 seed 与训练日志均未虚构。
覆盖:Figure 1–5、Table 1a–f、Table 2 左右两部分、Table 3–5、编号公式 1–24、Algorithm 1–2、Appendix A/B.1–B.4/C 全覆盖。原表冲突保留说明;事实、推导、reviewer 与 PMG 设想明确区分。
交付:HTML 小于 20 MB;新增 Markdown 与原文前缀保留合并候选只用于下载。未修改用户仓库、People 或共享索引,未发布。浏览器数学渲染、图像加载、导航交互与 1440/760/390 像素布局验收按用户要求延期;当前只完成内容与静态检查。