把“本来就在基础模型能力内的身份差异”尽量留在更有表达力的概念 embedding 中,降低不同 LoRA 的身份冲突
01 · 核心结论:不要平均身份,要匹配行为
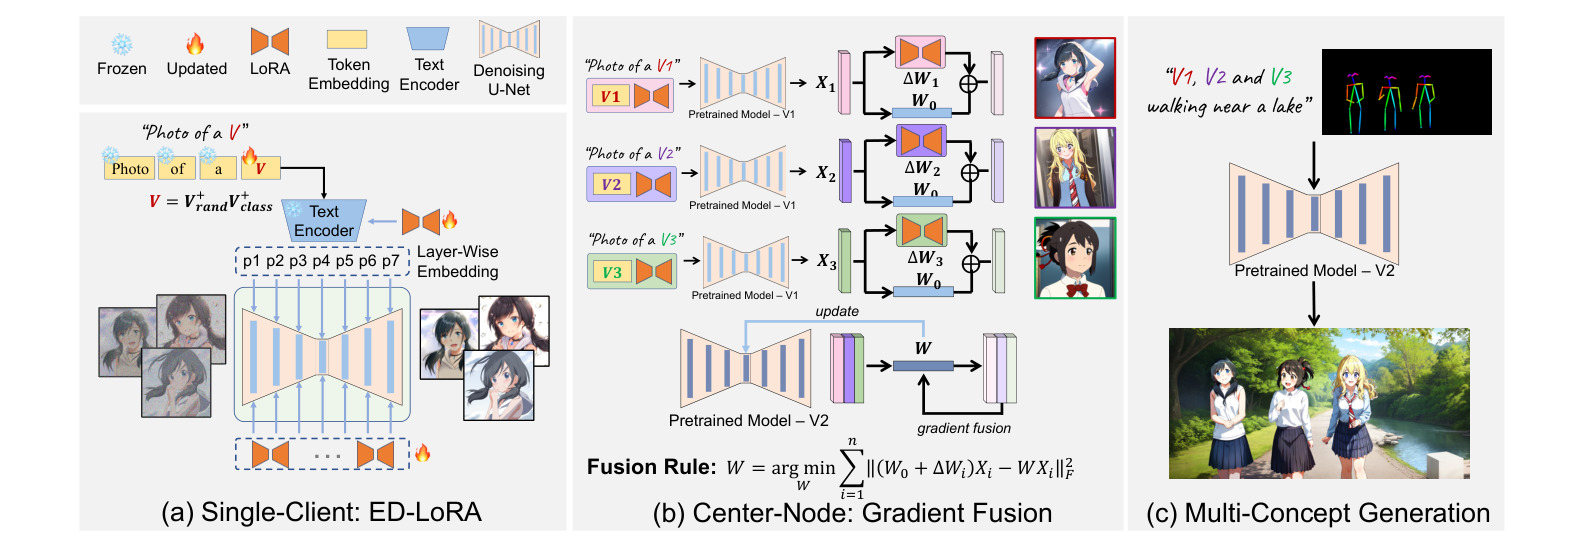
Mix-of-Show 研究的不是“如何训练一个会画很多对象的基础模型”,而是“如何让不同用户独立训练的个性化概念,在同一个模型里继续保持身份并能共同出现”。每个客户端只持有自己的少量图片,训练概念 embedding 与 LoRA;中心节点拿到适配器而不拿原始图片,融合成一个多概念模型;用户再用全局/局部提示词和姿态、草图控制生成。[论文 §3]
用各概念模型自己生成的中间特征,拟合各层的输入输出行为,避免权重平均把单概念身份稀释
在指定区域使用对应概念的局部文字条件,解决“有多个对象,但身份和属性绑错位置”的问题
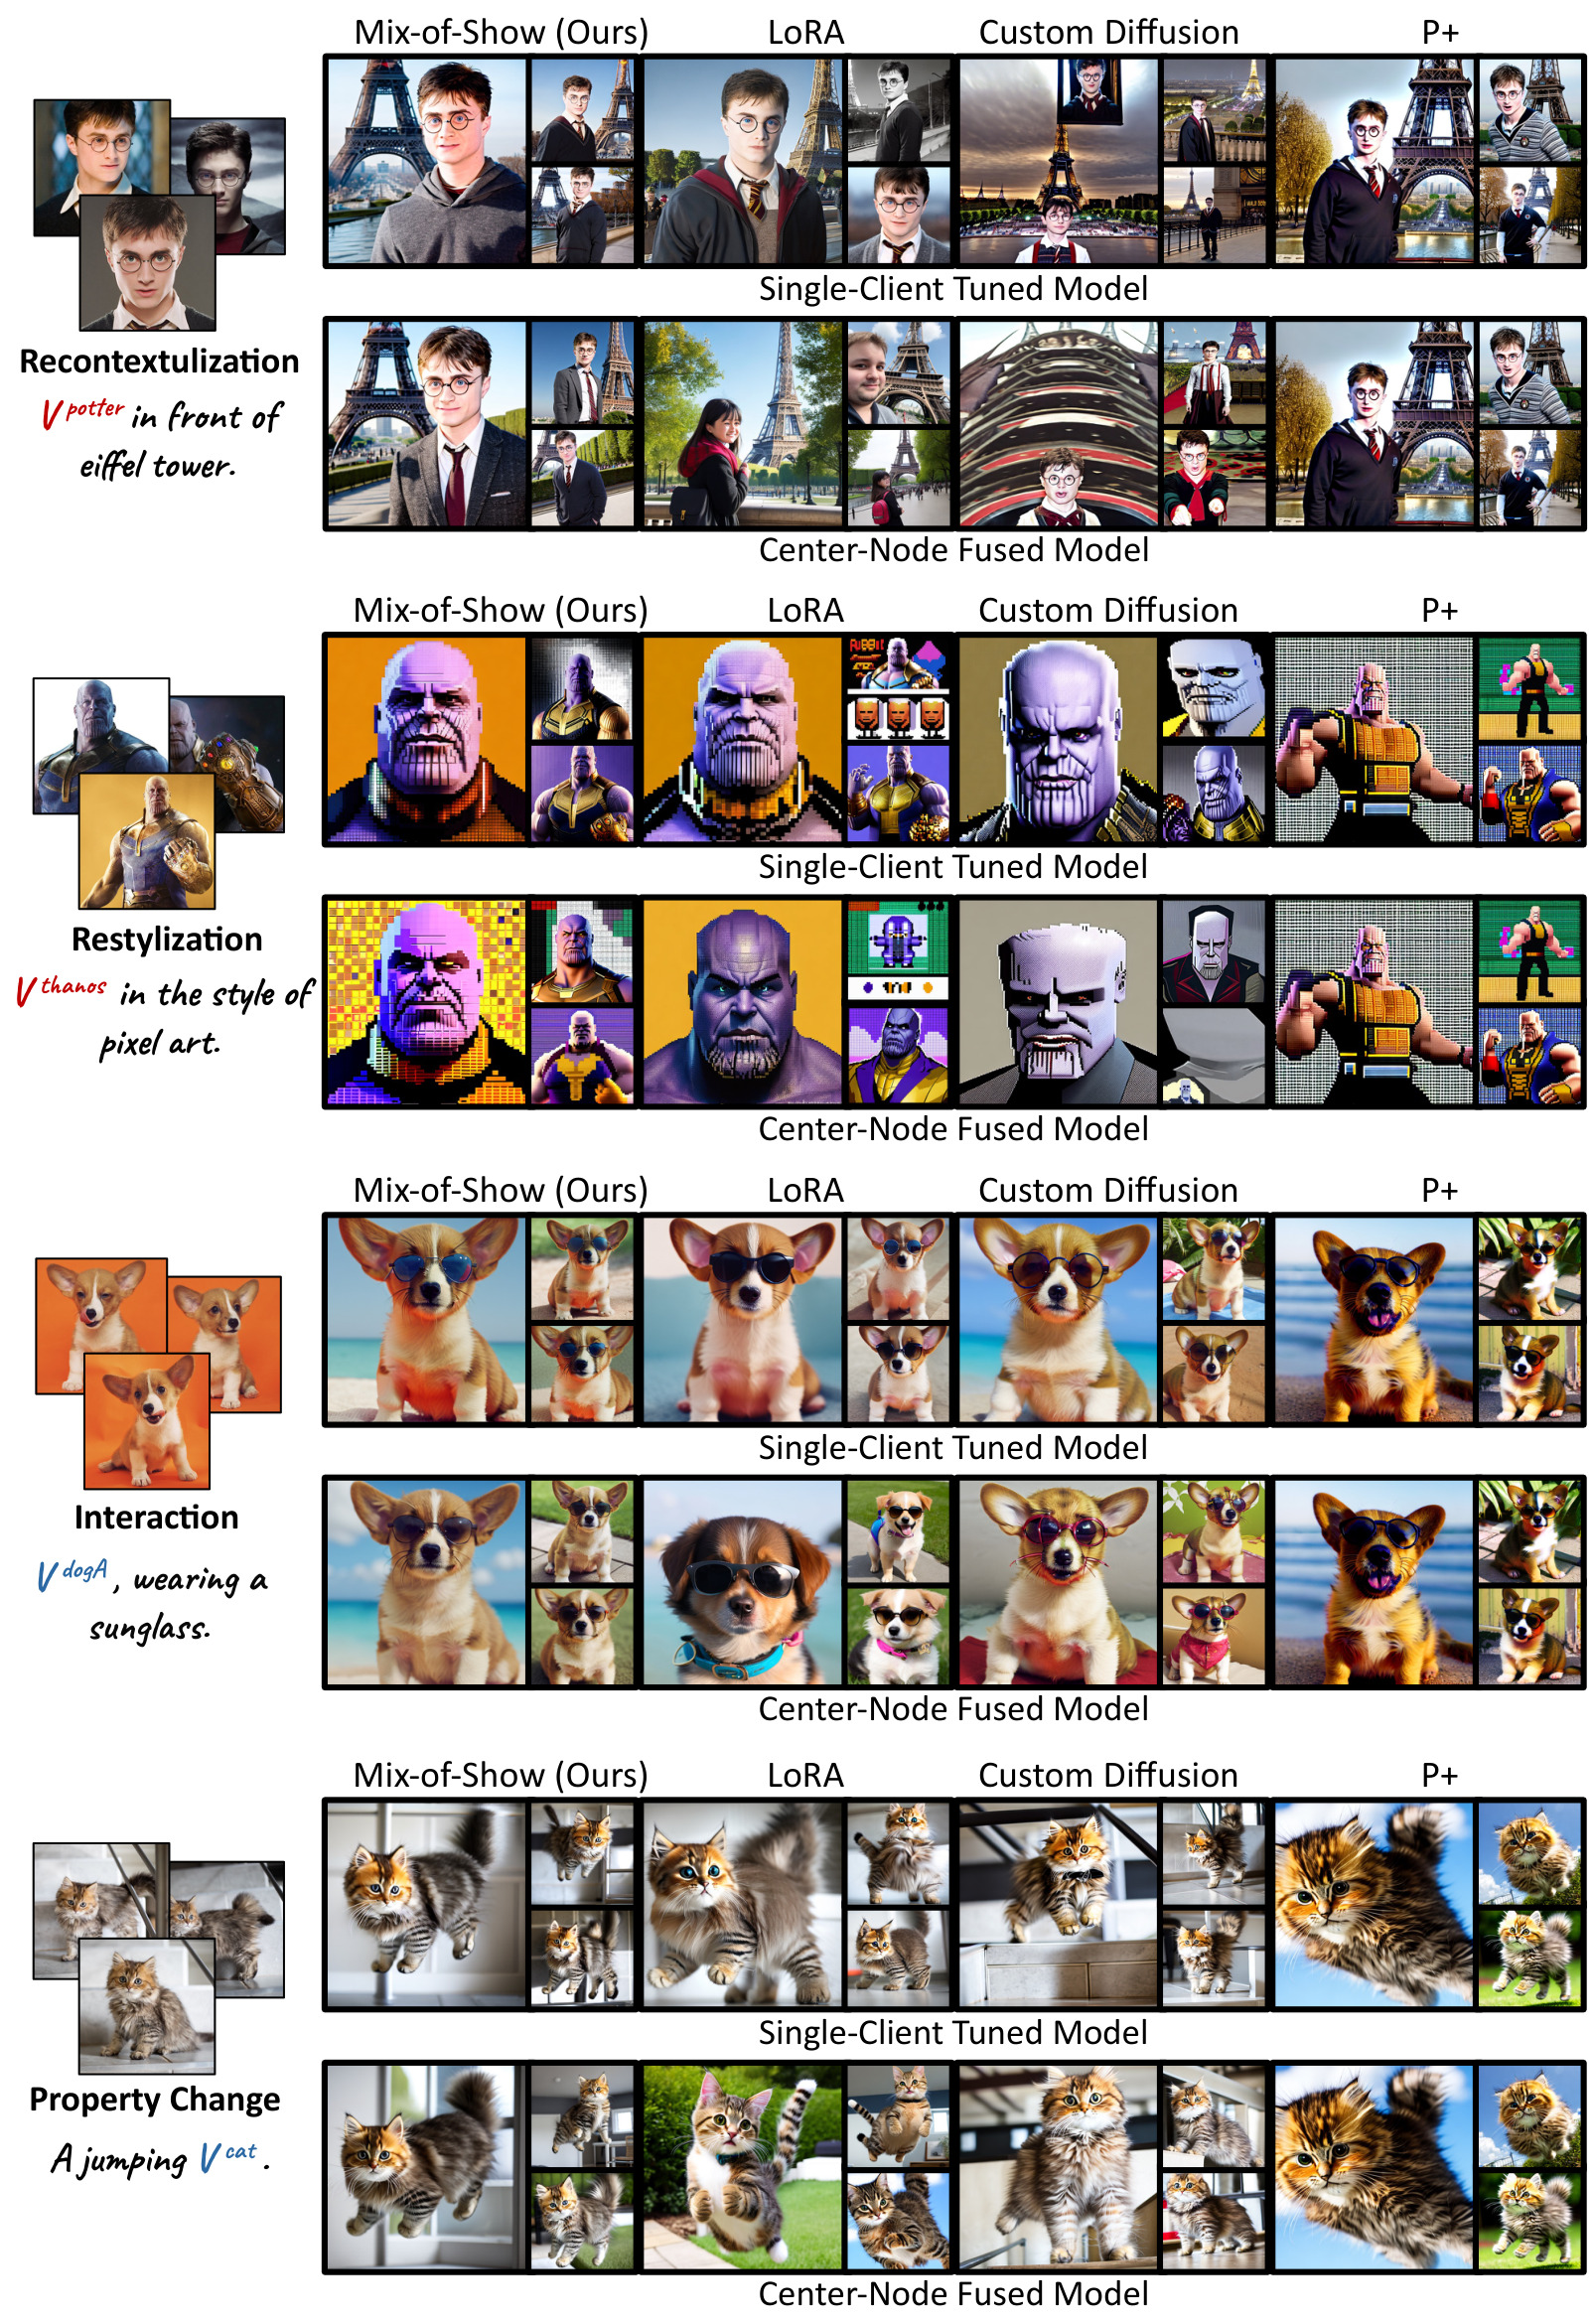
最重要的量化结果不是所有指标都最高,而是融合后的身份损失显著较小:类别平均 image-alignment,LoRA 从 0.816 降到 0.701;Mix-of-Show 从 0.843 降到 0.818。后者仍有损失,而且 text-alignment 并不全面领先。把这个结果理解为“更好保存概念库”,比理解为“全指标最强的生成器”准确。

本文分别标记论文事实 / Paper Verified、作者解释 / Author Claim、我们的解读 / Our Interpretation和研究延伸 / Research Extension。尤其是“theoretically limitless”只是一种可扩展的接口设想,论文没有给出无限容量定理或上千概念的规模验证。
02 · 固定版本与原笔记纠正
固定分析 arXiv:2305.18292v2,2023 年 11 月 10 日。PDF 共 18 页:正文与致谢第 1–10 页,参考文献第 11–13 页,附录第 14–18 页。正式会议为 NeurIPS 2023,Advances in Neural Information Processing Systems 36。官方 proceedings 同时给出 DOI 10.52202/075280-0699。[arXiv 固定版本] [官方会议记录]
完整作者顺序为:Yuchao Gu、Xintao Wang、Jay Zhangjie Wu、Yujun Shi、Yunpeng Chen、Zihan Fan、Wuyou Xiao、Rui Zhao、Shuning Chang、Weijia Wu、Yixiao Ge、Ying Shan、Mike Zheng Shou。PDF 明确用星号标注 Mike Zheng Shou 为通讯作者。署名机构包括 Show Lab、National University of Singapore、ARC Lab / Tencent PCG。
原笔记需要纠正的地方:原作者列表漏了最后三位;frontmatter 与 BibTeX 的 2024 不应作为会议年份;正文“arXiv 2021”也与固定来源不符。原笔记保留不动,以上是新增证据;后续整合时应更新元数据,而不是删改原用户记录。第一作者与通讯作者记录应分别关联 Yuchao Gu、Mike Zheng Shou*,这些是将来 vault 整合目标,不代表本轮已创建或验证人物文件。
官方仓库明确说明 main 是社区应用/性能优化版,论文复现应使用 research_branch。本轮静态核查固定研究分支提交 27213c56b59afbc6023fb4645dfd9cf5610f60a7;另读取 main 的说明,用于确认分支边界。没有训练或运行模型,也不把 main 的新效果倒写成 2023 年论文已验证的能力。论文列出的项目页本轮请求返回 404,所以关键证据来自固定 PDF、arXiv HTML、会议记录与官方仓库。
03 · 两种失败:概念冲突与权重稀释
个性化生成通常给一个主体学习一个特殊 token,再微调部分模型参数。假设两个用户分别训练两个人物,二者都属于“man”或“woman”,单独加载时各自都能生成正确身份。但如果 embedding 只保存了“这是一个人”这样的通用语义,而大多数身份信息埋在不同的 LoRA 权重里,把适配器合起来后,模型就很难仅根据相近的文字 embedding 决定究竟输出哪一张脸。这是论文所说的 concept conflict。
第二个问题即使更换 embedding 也不会自动消失:对 \(n\) 个适配器做归一化平均,会把某个概念完整的参数位移 \(\Delta W_i\) 缩小到约 \(\Delta W_i/n\),还引入其他概念的改动。原本训练得到的函数不再完整保留,因此出现 identity loss。前者关乎“概念如何被编码”,后者关乎“中心如何把函数合并”;Mix-of-Show 必须同时修改两端。

作者通过两类概念观察 embedding 与 LoRA 的分工:in-domain 示例由基础模型采样,embedding-only 可以较好表达;out-of-domain 示例包含基础模型不容易直接表达的风格或细节,单纯 embedding tuning 可能出现过饱和或语义塌缩。LoRA 能补充这部分能力,但常规联合训练会让权重承担过多身份信息。[§3.3]
审慎解读:这是通过可视化得到的功能性解释,不是已经识别出互不重叠的“域内子空间”和“域外子空间”。更强 embedding 能降低冲突,但不能从数学上保证所有身份都被放进 embedding;LoRA 也不会只学习域外细节。
04 · 问题形式与数据流
| 对象 | 符号 | 实际含义 |
|---|---|---|
| 客户端概念图片 | \(\mathcal D_i\) | 仅客户端用于训练的小图集,中心融合阶段不读取这些原始图片 |
| 基础模型 | \(\Phi_0=\{\theta_0,\psi_0\}\) | UNet 与 CLIP text encoder;VAE 作为冻结的图像 latent 编解码器 |
| 客户端适配器 | \(\Delta\Phi_i\) | 文本编码器与 UNet attention 中的低秩参数变化,不是新的完整基础模型 |
| 概念 embedding | \(V_i\) | 标识用户概念的可学习 token 表示;ED-LoRA 每个概念使用多词、逐层表示 |
| 中心融合权重 | \(W\) | 在被适配过的线性层上优化得到的稠密权重;融合后不保证仍是 rank-4 增量 |
| 层输入输出样本 | \(X_i,Y_i\) | 第 \(i\) 个概念的教师模型通过自身采样或文字前向产生的激活 |
| 扩散输入 | \(z_t,t,c\) | 带噪 latent、时间步、文字条件;不是图节点或材质参数程序 |
| 全局和区域提示词 | \(P_g^{\ast},P_{r_i}^{\ast}\) | 描述整体场景与局部主体、服饰、动作、背景关联 |
| 区域与空间条件 | \(M_i\) | 指定主体区域,配合 keypose/sketch;概念融合本身不负责决定布局 |
形式上,中心的任务是 \(W=f(W_0,\Delta W_1,\ldots,\Delta W_n)\),让同一模型仍然能调用所有概念。客户端原图不上传,并不意味着服务器没有数据:服务器通过已有生成模型合成中间训练信号。更精确的说法是融合阶段无需访问原始概念图,而非“完全无数据、无计算、无优化”。
本方法有两个不同终点:一是融合后模型单独生成每个已学概念,检查记忆是否保留;二是在同一图像中组合多个概念,检查布局与属性绑定。论文的主要定量表测的是第一个,复杂组合更多通过定性示例展示。两类能力相关,但不能用前者分数替代后者成功率。
05 · ED-LoRA:让 token 承担更多身份
5.1 共同的扩散训练目标
\[\mathcal L_{\mathrm{denoise}}=\mathbb E_{z,c,\epsilon,t}\left[\|\epsilon-\epsilon_{\theta}(z_t,t,c)\|_2^2\right],\qquad c=\psi(P^{\ast}).\tag{1}\]
图像先经 VAE 得到 latent;随机选择时间步并加噪,UNet 根据文本条件预测噪声。概念 token 的 embedding、文本编码器中的 LoRA 和 UNet 中的 LoRA 都通过这一目标更新。VAE 和原有大部分权重冻结。代码还有 masked loss、embedding regularization 与部分配置的 adapter dropout,详见实现核查。
5.2 低秩更新与简单融合的局限
\[W_i=W_0+\Delta W_i=W_0+B_iA_i,\qquad
W_0\in\mathbb R^{d\times k},\quad B_i\in\mathbb R^{d\times r},\quad A_i\in\mathbb R^{r\times k},\quad r\ll\min(d,k).\]
论文全部实验的 rank 为 4。单客户端只需学习低秩因子和新增 embedding,适合独立训练与共享;不是给每个概念训练一份全量模型。常规权重融合是:
\[W_{\mathrm{avg}}=W_0+\sum_{i=1}^{n}w_i\Delta W_i,\qquad \sum_{i=1}^{n}w_i=1.\tag{2}\]
参数平均不关心 \(\Delta W_i\) 在哪些输入激活上有意义。若概念需要完整位移才表现出身份,平均会削弱它;如果不同概念在相同方向上有相反要求,也会互相抵消。这个分析解释平均可能失败,但不是说所有 LoRA 合并都必然失败,效果依赖概念相关性、base checkpoint、权重尺度和评估任务。
5.3 多词 + 层特定 embedding
\[V_i^{(\ell)}=\big[V_{i,\mathrm{rand}}^{(\ell)},V_{i,\mathrm{class}}^{(\ell)}\big],\qquad \ell=1,\ldots,L.\]
这里方括号表示两个文字 token 的组合,不是两个向量先做算术相加。随机 token 用于承载个体差异,class token 从已有类别词初始化以保留语义锚点;两个 token 都学习。每个 cross-attention 层使用自己的概念表示,类似 P+ 的扩展条件空间。不同层可以表达不同尺度的主体属性,不必把所有细节压进一个向量。
研究分支写死 \(L=16\) 个 cross-attention 层。一个概念的两个对外标识,内部共对应 \(2\times16=32\) 个新增 embedding 向量;同一提示词被展开成 16 份,每份替换成该层的 token,再交给对应 cross-attention。它不是新增 16 个独立 text encoder,也不是把全部概念都接到同一个超长提示词上。人物配置使用随机初始化标准差 0.013 加 class “man”,宠物示例用 “cat”。[研究分支 EDLoRA]
方法直觉:如果卸掉 LoRA 后,概念 embedding 已经能在原模型里生成“身份的大致核心”,融合时即使少量权重变化受干扰,主体也不至于完全退回同一个类的平均形象。Figure 3 与 Figure 7(a) 展示这种诊断:只加载 embedding 与同时加载 embedding+LoRA 的输出要分开看。
06 · Gradient Fusion:逐层的教师行为回归
6.1 目标函数
\[Y_i=(W_0+\Delta W_i)X_i,\qquad
W^{\ast}=\underset{W}{\operatorname{argmin}}\sum_{i=1}^{n}\|Y_i-WX_i\|_F^2.\]
这是论文 §3.3.2 的核心目标。\(X_i\) 的列是第 \(i\) 个概念在某一层遇到的输入激活,\(Y_i\) 是该概念专用模型对此输入的输出。中心把不同概念的激活对合在一起,寻找一个 \(W\) 同时近似多个教师的行为。权重平均只看到参数,gradient fusion 还看到参数在实际输入分布上如何作用。
\[\nabla_W\mathcal L=2\sum_i(WX_i-Y_i)X_i^{\mathsf T}.\]
上式是对论文目标的直接求导,说明“fused gradient”来自多概念行为残差,不是把客户端训练时保存的梯度上传后平均。论文实现采用 L-BFGS,逐层从基础权重初始化进行优化;它不是端到端反传完整图片重建损失,也不是继续拿所有用户原图联合训练。
6.2 为什么优于参数平均,但不能保证无限概念
在固定 \(X_i,Y_i\) 且相关矩阵可逆的理想线性问题下,可以推导:
\[W^{\ast}=\left(\sum_iY_iX_i^{\mathsf T}\right)\left(\sum_iX_iX_i^{\mathsf T}\right)^{-1}.\]
该闭式是我们的分析,不是论文实际采用的求解器。它表明融合具有“激活加权”的性质:若不同概念占据不同输入方向,一个共享矩阵更容易同时拟合;若输入方向高度重叠却要求不同输出,约束冲突不会因换一个 optimizer 自动消失。矩阵奇异时需要伪逆或正则,并且未被采样覆盖的方向仍不受约束。
层局部目标小,不等于完整扩散轨迹或任意组合 prompt 上误差小。因为融合后上游层会改变下游激活分布,教师记录的 \(X_i\) 未必等于学生真正运行时的输入。有限 token、参数容量、激活存储、概念冲突与生成轨迹覆盖都约束规模。因此“理论上不限概念数量”不应写成“实证支持无限无损合并”。
6.3 实际中心节点流程
- 读取各概念 embedding、text encoder LoRA 与 UNet LoRA,确认共享兼容的基础模型和层形状
- 为各概念分配不碰撞的内部 token ID,合并 embedding 表与 token 映射;这一步主要是登记,不是平均两个主体的 embedding
- 先融合文本编码器:对每个概念载入其 adapter,使用简短概念提示词收集文本层输入输出,以 L-BFGS 拟合共享文本层
- 融合 UNet cross-attention 的 K/V 投影:它们的输入来自文字特征,可从概念 prompt 直接建立约束
- 融合空间相关层:对单概念模型采样去噪轨迹,记录 attention 相关层的 latent 激活,用这些激活对拟合融合层
- 保存更新后的文本/UNet 权重与概念 embedding,供单概念或多概念采样使用
研究分支默认给文本编码器与 UNet cross-attention K/V 使用 500 次 L-BFGS 最大迭代预算,其他空间相关层用 50;生成约束时每概念 1 条 50 步 DDIM 轨迹、记录全部 50 个时间点。原文“文本编码器 500、UNet 50”的概括没有完全展开 K/V 这条特殊路径。L-BFGS 的 max_iter 也不等于同等次数的完整扩散图像采样。[官方融合脚本]
存储与隐私边界:客户端共享低秩参数较轻量,但中心最终优化的是完整层矩阵,产物不保证仍是 rank-4 LoRA。无需上传原始照片也不等于差分隐私、不可重建或不可提取身份;适配器本来就是为了让接收者再现概念外观。这里的 decentralized 更接近“数据留在客户端、模型模块集中融合”,不是去中心化共识系统,也没有隐私安全证明。
07 · 区域可控采样:哪里出现谁
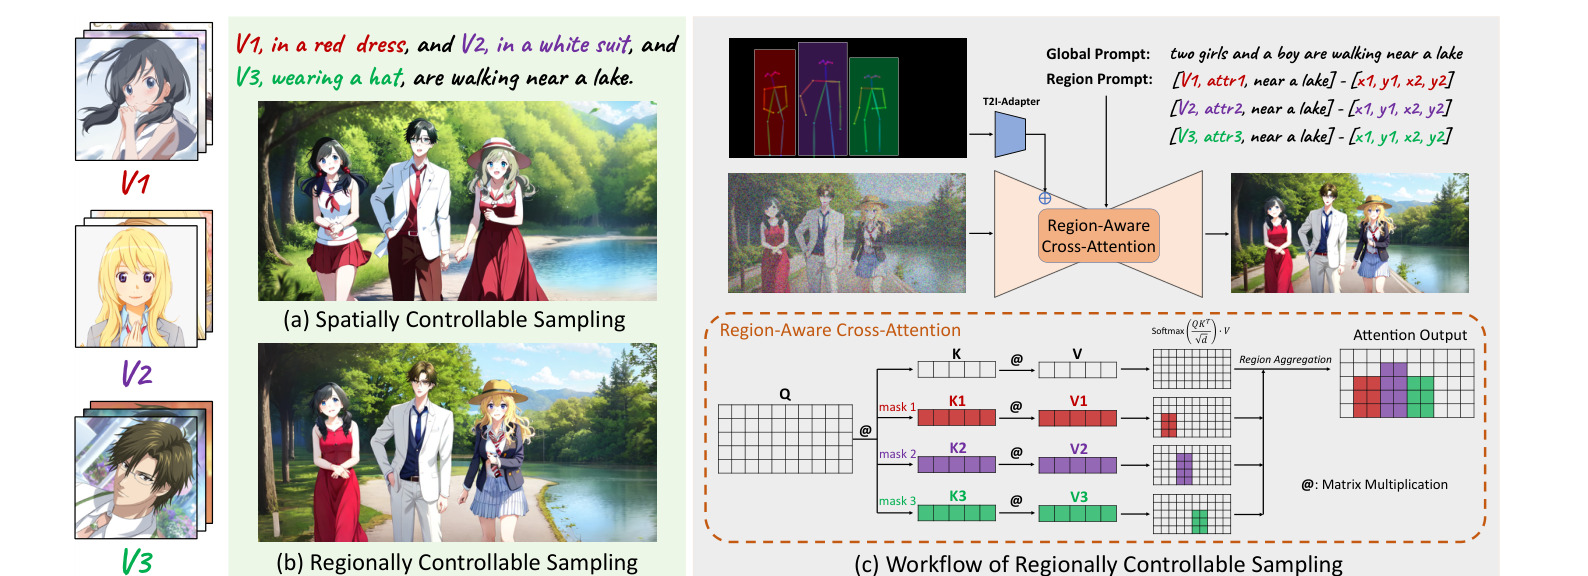
ControlNet/T2I-Adapter 的姿态或草图能约束“这里有一个人体”,但不会天然知道“左边的姿态属于概念 A,右边属于概念 B”,也可能把 red dress 绑定到错误人物。Mix-of-Show 因此把空间存在性与语义身份绑定分开:全局 prompt 描述总场景,每个指定区域有自己的概念与属性 prompt。
\[h_g=\operatorname{softmax}\!\left(\frac{Q(z)K(P_g^{\ast})^{\mathsf T}}{\sqrt d}\right)V(P_g^{\ast}),\qquad
z_i=z\odot M_i.\]
\[h_i=\operatorname{softmax}\!\left(\frac{Q(z_i)K(P_{r_i}^{\ast})^{\mathsf T}}{\sqrt d}\right)V(P_{r_i}^{\ast}),\qquad h[M_i]\leftarrow h_i.\]
公式将正文未明确书写的转置显式补齐,以保持标准注意力维度:空间 query 与 token key 的内积生成区域内的注意力权重,再聚合 value。实际实现从 query 网格切出矩形区域,用局部 prompt 的 K/V 计算该区输出;非区域部分保持全局输出,不是把最终 RGB 图片切块拼起来。
研究分支对重叠区域按覆盖次数平均贡献,replace_ratio 固定为 1.0;区域坐标缩放到各分辨率 feature map 后,起点 ceil、终点 floor。极小区域可能在低分辨率层消失,重叠提示词可能竞争。局部负提示词也被编码,原文建议用它缓解属性泄漏。空间条件与区域框均需要预先给定,论文没有自动规划布局的 agent。[region-aware attention 实现]
局部文字覆盖 cross-attention 不会隔离全部网络:self-attention、卷积与全局上下文仍跨区域传递信息。因此它缓解属性绑错,却不提供严格的区域独立性或“另一人物完全不受影响”的保证。论文末尾的属性泄漏案例应与成功图一起阅读。

08 · 数据、骨干、训练与计算预算
8.1 不是原生 SD1.5 的统一实验
论文用 Stable Diffusion 系列架构,但明确采用 Chilloutmix 处理现实域概念,Anything-v4 处理动漫概念,原因是原生 SD v1.5 的人脸质量问题。两者是同类架构的不同基础 checkpoint,不是“大模型和小模型”配置。所有比较方法在同一概念实验中使用相同基础模型,以减少骨干差异。本文没有模型参数规模扫描、SDXL 实验或跨不同骨干直接混合 LoRA 的验证。[附录 §6.1]
评估数据包含 19 个概念:6 个现实域人物、5 个动漫人物、6 个现实物体、2 个现实场景。物体部分借用 DreamBooth 与 Custom Diffusion 的数据。主定量表覆盖现实域 14 个概念;动漫是在另一基础模型上的一组实验,不能写成“19 个概念全部融合到一个跨骨干模型”。
| 概念组 | 概念与训练图片数量(Table 3) | 总数与备注 |
|---|---|---|
| 现实物体 | Cat 5,DogA 5,Chair 5,Table 4,DogB 5,Vase 6 | 6 个概念、30 张图;对象类别内部也存在相近概念 |
| 现实人物 | Potter 14,Hermione 15,Thanos 15,Hinton 14,Lecun 17,Bengio 15 | 6 个概念、90 张图;这里“现实域”包含真人影像形式的影视角色 |
| 现实场景 | Rock 20,Pyramid 20 | 2 个概念、40 张图 |
| 动漫人物 | 5 个概念;论文 Table 3 未列逐概念图片数 | 官方配置覆盖 Hina、Kaori、Mitsuha、Son Goku、Tezuka;不从文件夹名猜图片数 |
上述现实域总图数 \(30+90+40=160\) 是根据原表相加得到的值,不是全 19 概念总量。论文没有把这些图分成标准训练/验证/测试图像集合;评价使用训练概念图作身份参考,同时变化 prompt 和 seed。它测的是少样本个性化与可编辑性,不是传统独立图像分类泛化。
8.2 论文设置与研究代码设置
| 项目 | 论文明确设置 | 研究分支补充 / 区别 |
|---|---|---|
| 可训练模块 | 新 text embedding、text encoder 与 UNet 全部 attention 的低秩线性层 | 冻结 VAE 与基础权重;固定 16 层概念映射;UNet 类名 CrossAttention 同时覆盖相关 self/cross attention 模块 |
| LoRA rank | 全部实验 \(r=4\) | 配置 alpha=1.0;不同 checkpoint 和层形状仍须兼容 |
| 学习率 | embedding \(10^{-3}\),text encoder \(10^{-5}\),UNet \(10^{-4}\) | 配置 scale_lr=false,不额外按 batch 自动缩放 |
| 优化器 | 正文与附录称 Adam | 所查研究配置为 AdamW,weight_decay=0.01,betas=(0.9,0.999),不能静默视作完全相同 |
| noise offset | 所有实验 0.01 | 代码在逐元素噪声之外加每通道空间共享的随机偏移;作者称有助于稳定身份,但未给单独定量消融 |
| 人物/动漫/场景示例训练 | 未在正文逐概念列步数 | Potter、Hina、Rock 配置:2 GPU,每卡 batch=2,总 batch=4,1000 iterations |
| 物体示例训练 | 未在正文逐概念列步数 | Cat 配置:2 GPU,每卡 batch=1,总 batch=2,500 iterations;不能用这个例子推断所有配置完全相同 |
| scheduler / warmup | 正文未细列 | 所查配置为 LinearLR,warmup_iter=-1;不要把注释“5 epoch”当成真实全图遍历次数 |
| 数据增强 | 强调数据选择与细节,未全面列出 | 512 分辨率、裁剪、Normalize、ShuffleCaption、EnhanceText;人物和物体裁剪策略不同,场景示例不读取 caption 文件 |
| 附加训练约束 | 主文只列基本去噪目标 | 配置 KDE loss weight=0.002、bandwidth=0.5;Cat cross-attention K/V LoRA dropout=0.2,Potter/Hina/Rock 示例为0 |
| 中心融合 | L-BFGS,text encoder 500 步、UNet 50 步 | 脚本把 UNet K/V 也归入500预算;其他空间层50;lr=1、history_size=25、strong_wolfe |
| 评估采样 | DPM-Solver,20 步 | 所查 fused-model evaluation YAML 指定 DDIM、50 步、CFG=7.5;复现时必须核清最终采用哪个入口 |
| 训练时间 | 每概念约10–20分钟,2张 NVIDIA A100 | 作者报告值,未实测;没有完整峰值显存或精度对照表 |
| 融合时间 | 14个概念约30分钟,1张 A100 | 作者指出 UNet 大空间激活是瓶颈;不是即时文件拼接 |
Potter 训练配置 · Cat 训练配置 · 融合模型评估配置
论文所有方法共用负提示词:longbody, lowres, bad anatomy, bad hands, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality。这是原文公开的完整 sampling 设置之一,不是本页自行补写的 prompt。用户还必须提供局部区域、姿态/草图等条件,生成失败不能全部归因于融合算法。
09 · 评价协议:两种 CLIP 分数不是同一量尺
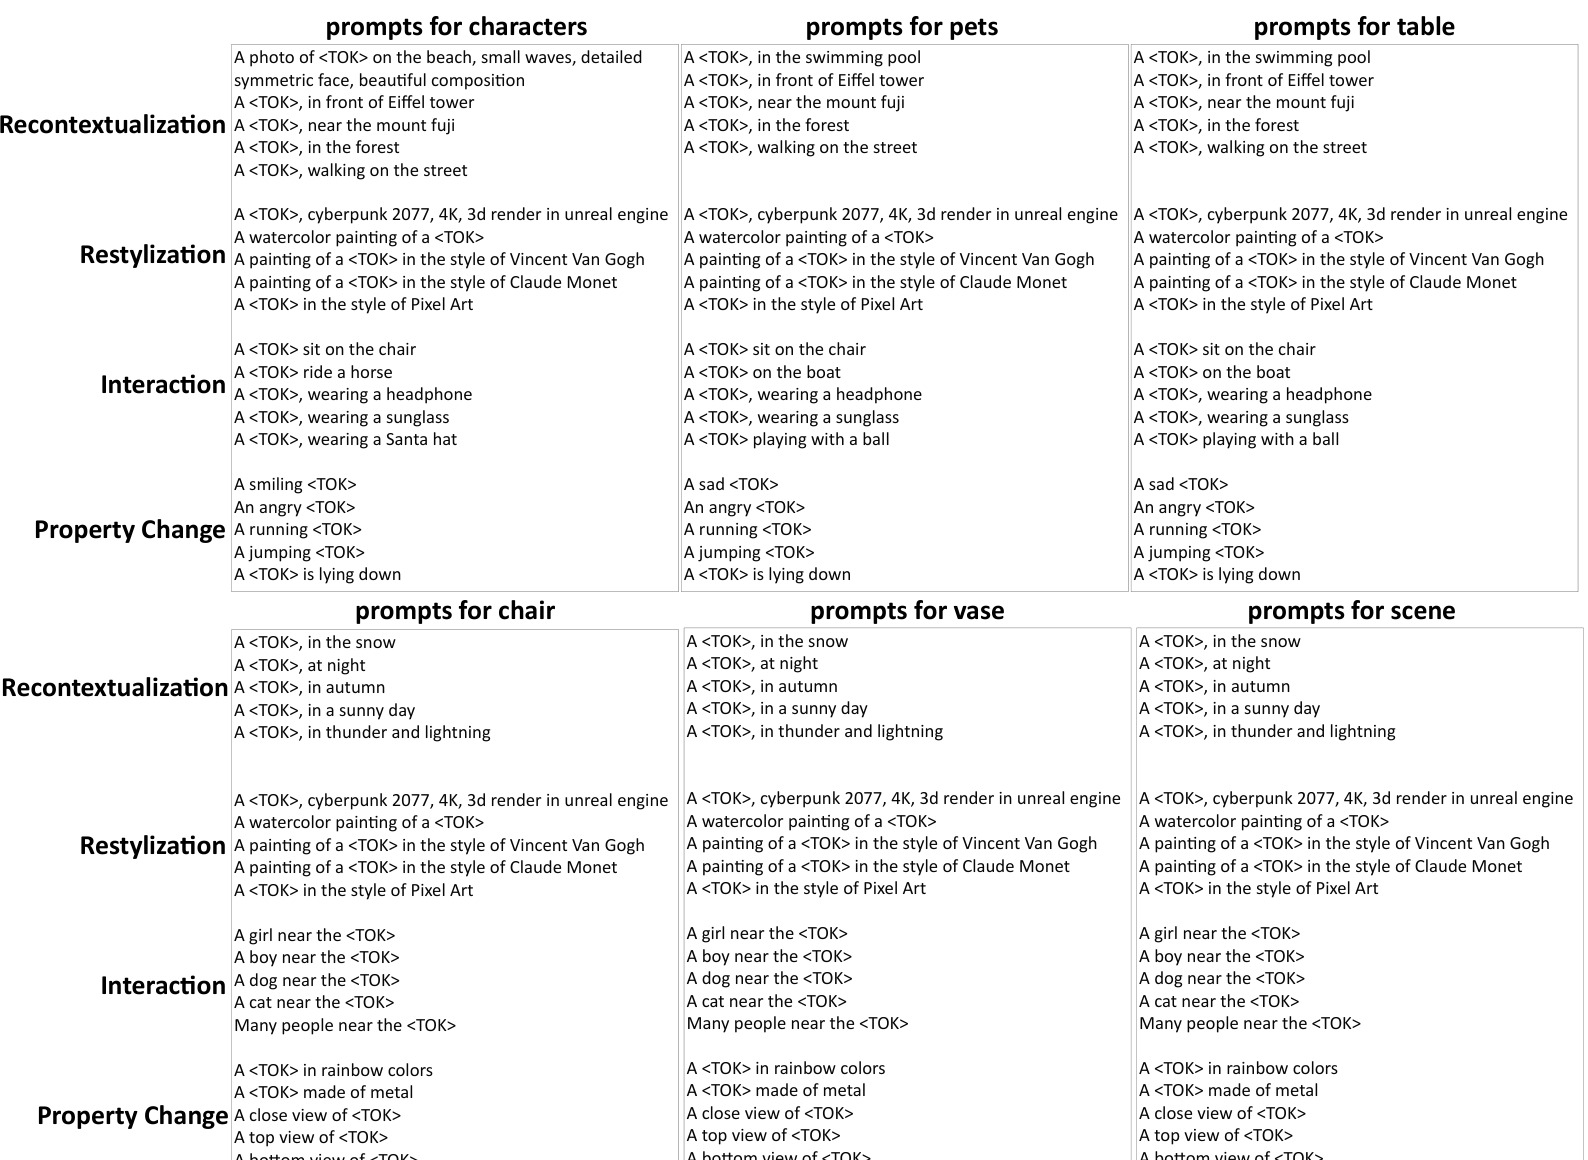
每个概念有 20 个 evaluation prompts,分为 4 类、每类 5 个:Recontextualization(换场景)、Restylization(换风格)、Interaction(与其他对象互动)、Property Modification(属性或姿态变化)。每个 prompt 用固定 seed 1–50 生成 50 张图,因此每概念每个被测模型有 1000 张图。现实域14概念对应每模型14,000张;这里的乘法是按协议计算,不能等同于完整实验实际保存文件数。
身份评价对单客户端模型和中心融合模型都逐概念进行。即使权重已经能表示多个主体,计算主表时仍是一个概念一组 prompts;这没有直接测多人物图像里的每个身份是否都正确、关系是否成立、有没有漏对象。区域组合能力主要来自 Figure 2/5/6/7 的图示与局部消融。
9.1 Text-alignment
\[s_{\mathrm{text}}(I,P)=2.5\max\!\left(0,\cos(f_I(I),f_T(P))\right).\]
论文采用 CLIP-Score toolkit;研究分支提供的脚本加载 ViT-B/32,并沿用上述 2.5 缩放及截零。它衡量图像是否符合评价文字,而不是概率或百分比。尤其当主体退化为通用类别时,文字匹配可能上升,因此 text score 的提高不一定代表个性化更好。[文本指标代码]
9.2 Image-alignment
\[s_{\mathrm{image}}=\frac{1}{NM}\sum_{j=1}^{N}\sum_{k=1}^{M}\max\!\left(0,\cos(f_I(I_j^{\mathrm{gen}}),f_I(I_k^{\mathrm{ref}}))\right).\]
这里 \(N\) 为生成图数量,\(M\) 为目标概念参考图片数量。对应脚本同样用 ViT-B/32 图像编码器,但默认倍率是1.0;遍历全部参考图与生成图的成对相似度再平均。它是主体身份的粗粒度代理,仍会受背景、风格、构图影响,不是人脸识别准确率,也不保证每个细节保存。代码还提示 NumPy 版本改变归一化方式可能导致微小差异。[图像指标代码]
表里的 text upper bound 与 image lower bound 是把概念 token 换成 class token、使用原始预训练模型采样得到的参照值。它们不是对任意方法成立的严格数学上下界。回到“dog”类通常能提高对通用文本的匹配,却不必像指定的那条狗,正好用来观察身份丢失。
Table 1 的 Mean 是三个类别均值再平均。例如本方法 single image-alignment 为 \((0.868+0.802+0.858)/3\approx0.843\)。它不是将14个概念等权直接平均,也不是将160张训练图按张数平均。场景仅2概念,却在类别 macro-average 中占三分之一,解释总体数字时应保留这个权重结构。
10 · 主表全量结果与正确读法
原 Table 1 · 分类平均与融合前后变化
| Methods | Real-Objects Single\(\rightarrow\)Fused | Real-Characters Single\(\rightarrow\)Fused | Real-Scenes Single\(\rightarrow\)Fused | Mean Change | |
|---|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.811 | 0.767 | 0.834 | 0.804 |
| P+ [4] | 0.771\(\rightarrow\)0.771 (-) | 0.686\(\rightarrow\)0.686 (-) | 0.759\(\rightarrow\)0.759 (-) | 0.739\(\rightarrow\)0.739 (-) | |
| Custom Diffusion [11] | 0.745\(\rightarrow\)0.747 (+0.002) | 0.674\(\rightarrow\)0.650 (-0.024) | 0.748\(\rightarrow\)0.738 (-0.010) | 0.722\(\rightarrow\)0.712 (-0.010) | |
| LoRA [3] | 0.720\(\rightarrow\)0.795 (+0.075) | 0.654\(\rightarrow\)0.700 (+0.046) | 0.717\(\rightarrow\)0.760 (+0.043) | 0.697\(\rightarrow\)0.752 (+0.055) | |
| Mix-of-Show (Ours) | 0.724\(\rightarrow\)0.745 (+0.021) | 0.632\(\rightarrow\)0.662 (+0.030) | 0.716\(\rightarrow\)0.736 (+0.020) | 0.691\(\rightarrow\)0.714 (+0.024) | |
| Image-alignment | Lower Bound | 0.721 | 0.471 | 0.595 | 0.596 |
| P+ [4] | 0.790\(\rightarrow\)0.790 (-) | 0.670\(\rightarrow\)0.670 (-) | 0.796\(\rightarrow\)0.796 (-) | 0.752\(\rightarrow\)0.752 (-) | |
| Custom Diffusion [11] | 0.842\(\rightarrow\)0.808 (-0.034) | 0.714\(\rightarrow\)0.694 (-0.020) | 0.804\(\rightarrow\)0.750 (-0.054) | 0.787\(\rightarrow\)0.751 (-0.036) | |
| LoRA [3] | 0.864\(\rightarrow\)0.778 (-0.086) | 0.761\(\rightarrow\)0.555(-0.206) | 0.824\(\rightarrow\)0.769 (-0.055) | 0.816\(\rightarrow\)0.701 (-0.115) | |
| Mix-of-Show (Ours) | 0.868\(\rightarrow\)0.846 (-0.022) | 0.802\(\rightarrow\)0.770 (-0.032) | 0.858\(\rightarrow\)0.838 (-0.020) | 0.843\(\rightarrow\)0.818 (-0.025) |
原 Table 1 的两个指标块、全部基线、参照界限、三类概念与 Mean Change 均完整保留。核心比较是同方法 single→fused 的变化,而不是只盯融合后的单列排名。
- 身份保持:LoRA 的 macro image-alignment 从0.816降到0.701,下降0.115;Mix-of-Show从0.843降到0.818,下降0.025,融合后分数高0.117
- 人物最敏感:LoRA真实人物0.761→0.555,下降0.206;Mix-of-Show0.802→0.770,下降0.032。多个语义相近人物的身份冲突比不同物体平均更突出
- 文字匹配不全面获胜:融合后本方法Mean text-alignment为0.714,低于P+的0.739与LoRA的0.752,仅略高于Custom Diffusion的0.712
- P+不变有机制原因:它主要添加概念embedding,没有要平均的LoRA权重,因此single/fused相同。数值不下降不等于原本的身份精度最高
- 基线适配范围不同:P+只调embedding,Custom Diffusion主要调cross-attention K/V;LoRA与ED-LoRA还涉及空间相关attention,单概念身份优势也可能来自更广的可训练范围
作者称所有多概念视觉比较都采用相同 regional sampling,这控制了一个重要混杂因素。但训练参数数量、caption增强、K/V dropout、是否用专门融合优化和计算成本仍不同。不能把结果解释成仅由“多一个随机token”造成全部提升。
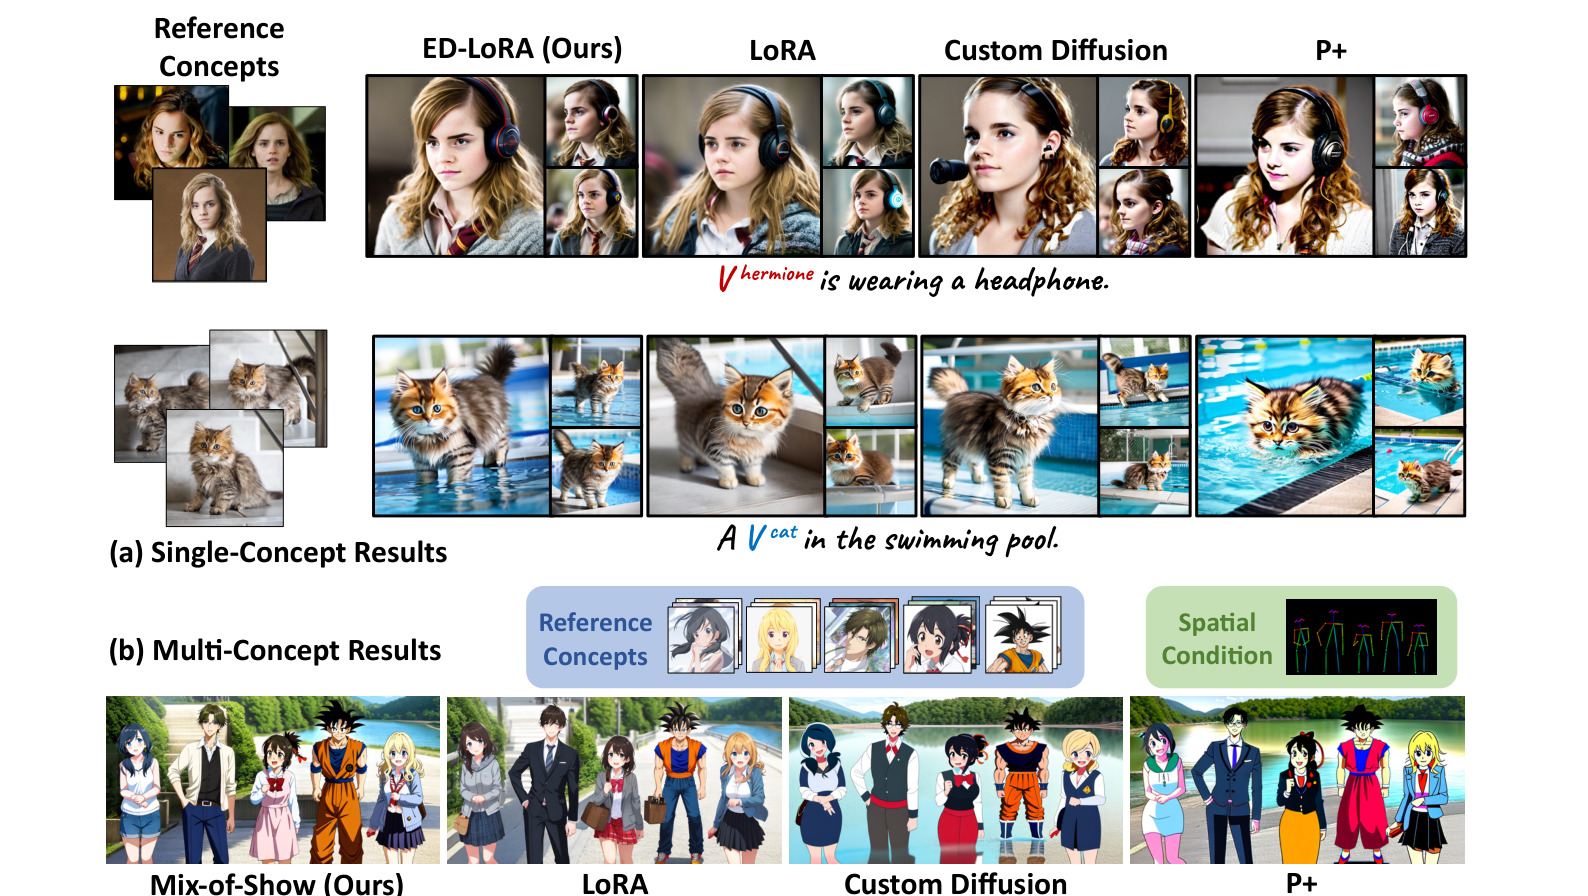
图像阅读顺序:先看single-client时四种方法是否都学会主体,再看fused时同主体是否变得泛化、脸型或物品细节是否改变;最后才看多主体组合。若一个方法单概念就没学好,后续融合效果低不能全部归咎于合并规则。
11 · 每概念完整结果:附录 Table 3
下面按原表的真实物体、真实人物、真实场景三部分展开,每部分保留 single-concept 与 fused 两块,包含每个概念训练图数、两种指标、全部方法与参照值。没有把长表截成只剩均值,也没有把小数重新估计。
原 Table 3a · 真实物体:单概念模型
| Single-Concept Model | Methods | Cat (5) | DogA (5) | Chair (5) | Table (4) | DogB (5) | Vase (6) | Mean |
|---|---|---|---|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.832 | 0.821 | 0.795 | 0.792 | 0.821 | 0.807 | 0.811 |
| P+ [4] | 0.828 | 0.801 | 0.726 | 0.696 | 0.799 | 0.776 | 0.771 | |
| Custom Diffusion [11] | 0.784 | 0.744 | 0.698 | 0.689 | 0.786 | 0.768 | 0.745 | |
| LoRA [3] | 0.761 | 0.673 | 0.655 | 0.670 | 0.779 | 0.779 | 0.720 | |
| Mix-of-Show (Ours) | 0.771 | 0.703 | 0.666 | 0.671 | 0.772 | 0.759 | 0.724 | |
| Image-alignment | Lower Bound | 0.753 | 0.755 | 0.674 | 0.682 | 0.769 | 0.692 | 0.721 |
| P+ [4] | 0.783 | 0.753 | 0.809 | 0.810 | 0.825 | 0.761 | 0.790 | |
| Custom Diffusion [11] | 0.869 | 0.830 | 0.825 | 0.888 | 0.848 | 0.794 | 0.842 | |
| LoRA [3] | 0.859 | 0.871 | 0.872 | 0.917 | 0.887 | 0.778 | 0.864 | |
| Mix-of-Show (Ours) | 0.874 | 0.864 | 0.890 | 0.879 | 0.889 | 0.811 | 0.868 |
原 Table 3a · 真实物体:融合模型
| Fused Model | Methods | Cat (5) | DogA (5) | Chair (5) | Table (4) | DogB (5) | Vase (6) | Mean |
|---|---|---|---|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.832 | 0.821 | 0.795 | 0.792 | 0.821 | 0.807 | 0.811 |
| P+ [4] | 0.828 | 0.801 | 0.726 | 0.696 | 0.799 | 0.776 | 0.771 | |
| Custom Diffusion [11] | 0.756 | 0.735 | 0.726 | 0.724 | 0.782 | 0.758 | 0.747 | |
| LoRA [3] | 0.827 | 0.803 | 0.757 | 0.766 | 0.814 | 0.801 | 0.795 | |
| Mix-of-Show (Ours) | 0.801 | 0.738 | 0.673 | 0.709 | 0.786 | 0.761 | 0.745 | |
| Image-alignment | Lower Bound | 0.753 | 0.755 | 0.674 | 0.682 | 0.769 | 0.692 | 0.721 |
| P+ [4] | 0.783 | 0.753 | 0.809 | 0.810 | 0.825 | 0.761 | 0.790 | |
| Custom Diffusion [11] | 0.871 | 0.813 | 0.774 | 0.794 | 0.823 | 0.773 | 0.808 | |
| LoRA [3] | 0.805 | 0.800 | 0.761 | 0.778 | 0.808 | 0.715 | 0.778 | |
| Mix-of-Show (Ours) | 0.852 | 0.863 | 0.864 | 0.816 | 0.880 | 0.800 | 0.846 |
原 Table 3b · 真实人物:单概念模型
| Single-Concept Model | Methods | Potter (14) | Hermione (15) | Thanos (15) | Hinton (14) | Lecun (17) | Bengio (15) | Mean |
|---|---|---|---|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.765 | 0.776 | 0.765 | 0.765 | 0.765 | 0.765 | 0.767 |
| P+ [4] | 0.640 | 0.744 | 0.622 | 0.708 | 0.693 | 0.711 | 0.686 | |
| Custom Diffusion [11] | 0.654 | 0.720 | 0.594 | 0.717 | 0.683 | 0.674 | 0.674 | |
| LoRA [3] | 0.580 | 0.696 | 0.568 | 0.716 | 0.681 | 0.684 | 0.654 | |
| Mix-of-Show (Ours) | 0.575 | 0.650 | 0.562 | 0.665 | 0.680 | 0.662 | 0.632 | |
| Image-alignment | Lower Bound | 0.485 | 0.458 | 0.510 | 0.422 | 0.510 | 0.441 | 0.471 |
| P+ [4] | 0.778 | 0.608 | 0.809 | 0.582 | 0.614 | 0.629 | 0.670 | |
| Custom Diffusion [11] | 0.737 | 0.663 | 0.852 | 0.627 | 0.694 | 0.710 | 0.714 | |
| LoRA [3] | 0.866 | 0.679 | 0.917 | 0.683 | 0.716 | 0.705 | 0.761 | |
| Mix-of-Show (Ours) | 0.869 | 0.785 | 0.921 | 0.731 | 0.723 | 0.782 | 0.802 |
原 Table 3b · 真实人物:融合模型
| Fused Model | Methods | Potter (14) | Hermione (15) | Thanos (15) | Hinton (14) | Lecun (17) | Bengio (15) | Mean |
|---|---|---|---|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.765 | 0.776 | 0.765 | 0.765 | 0.765 | 0.765 | 0.767 |
| P+ [4] | 0.640 | 0.744 | 0.622 | 0.708 | 0.693 | 0.711 | 0.686 | |
| Custom Diffusion [11] | 0.604 | 0.678 | 0.624 | 0.699 | 0.651 | 0.641 | 0.650 | |
| LoRA [3] | 0.693 | 0.717 | 0.656 | 0.694 | 0.714 | 0.725 | 0.700 | |
| Mix-of-Show (Ours) | 0.632 | 0.677 | 0.611 | 0.673 | 0.678 | 0.701 | 0.662 | |
| Image-alignment | Lower Bound | 0.485 | 0.458 | 0.510 | 0.422 | 0.510 | 0.441 | 0.471 |
| P+ [4] | 0.778 | 0.608 | 0.809 | 0.582 | 0.614 | 0.629 | 0.670 | |
| Custom Diffusion [11] | 0.765 | 0.680 | 0.749 | 0.603 | 0.693 | 0.671 | 0.694 | |
| LoRA [3] | 0.558 | 0.600 | 0.792 | 0.412 | 0.523 | 0.447 | 0.555 | |
| Mix-of-Show (Ours) | 0.827 | 0.756 | 0.867 | 0.710 | 0.729 | 0.733 | 0.770 |
原 Table 3c · 真实场景:单概念模型
| Single-Concept Model | Methods | Rock (20) | Pyramid (20) | Mean |
|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.869 | 0.798 | 0.834 |
| P+ [4] | 0.801 | 0.716 | 0.759 | |
| Custom Diffusion [11] | 0.809 | 0.686 | 0.748 | |
| LoRA [3] | 0.737 | 0.697 | 0.717 | |
| Mix-of-Show (Ours) | 0.754 | 0.677 | 0.716 | |
| Image-alignment | Lower Bound | 0.672 | 0.517 | 0.595 |
| P+ [4] | 0.821 | 0.770 | 0.796 | |
| Custom Diffusion [11] | 0.808 | 0.800 | 0.804 | |
| LoRA [3] | 0.863 | 0.784 | 0.824 | |
| Mix-of-Show (Ours) | 0.859 | 0.857 | 0.858 |
原 Table 3c · 真实场景:融合模型
| Fused Model | Methods | Rock (20) | Pyramid (20) | Mean |
|---|---|---|---|---|
| Text-alignment | Upper Bound | 0.869 | 0.798 | 0.834 |
| P+ [4] | 0.801 | 0.716 | 0.759 | |
| Custom Diffusion [11] | 0.793 | 0.682 | 0.738 | |
| LoRA [3] | 0.786 | 0.734 | 0.760 | |
| Mix-of-Show (Ours) | 0.770 | 0.702 | 0.736 | |
| Image-alignment | Lower Bound | 0.672 | 0.517 | 0.595 |
| P+ [4] | 0.821 | 0.770 | 0.796 | |
| Custom Diffusion [11] | 0.742 | 0.757 | 0.750 | |
| LoRA [3] | 0.810 | 0.728 | 0.769 | |
| Mix-of-Show (Ours) | 0.832 | 0.844 | 0.838 |
值得从明细看到的例外:单概念桌子上LoRA image-alignment为0.917,本方法为0.879;融合后的猫,Custom Diffusion为0.871,本方法为0.852。因此“本方法平均最好”不等于每个概念每种设置都第一。Lecun的本方法image-alignment反而从0.723略升到0.729,说明融合后不是所有条目都单调下降。
人物中Potter在LoRA融合后从0.866降到0.558,而本方法从0.869降到0.827;Hermione的本方法0.785→0.756,与LoRA的0.679→0.600形成不同幅度的保持表现。具体身份与训练图集仍影响难度,不能把人物宏平均当作每个人都同样稳定。
原表只覆盖现实域14概念,不能依据这些列给5个动漫人物捏造CLIP结果。图片数反映few-shot输入规模,也不是评估样本数:每概念的1000张生成图来自前述20×50协议。
12 · 消融与人类偏好:拆开两个贡献
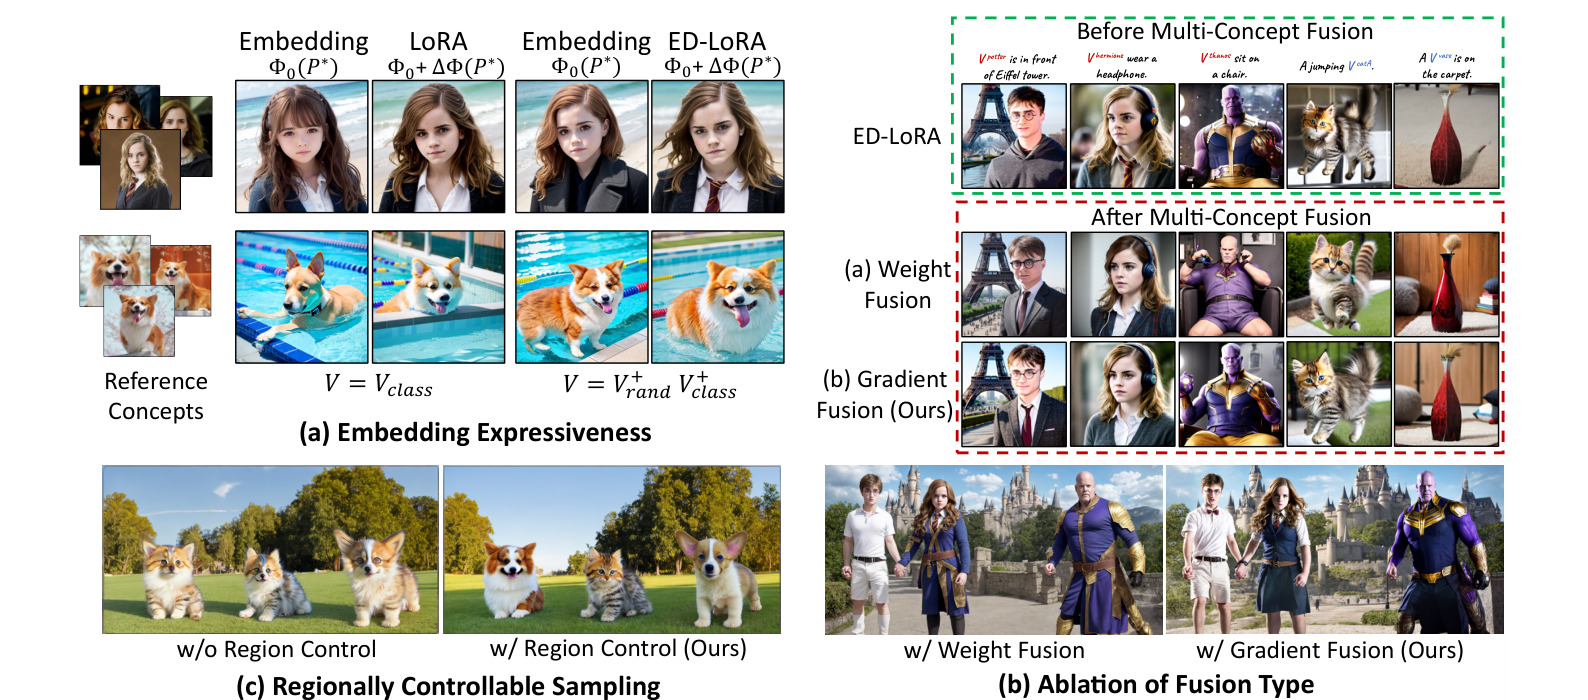
原 Table 2a · Image-alignment 消融
| Methods | Real-Objects Single\(\rightarrow\)Fused | Real-Characters Single\(\rightarrow\)Fused | Real-Scenes Single\(\rightarrow\)Fused | Mean Change | |
|---|---|---|---|---|---|
| Image-alignment | Lower Bound | 0.721 | 0.471 | 0.595 | 0.596 |
| LoRA + Weight Fusion | 0.864\(\rightarrow\)0.778 (-0.086) | 0.761\(\rightarrow\)0.555(-0.206) | 0.824\(\rightarrow\)0.769 (-0.055) | 0.816\(\rightarrow\)0.701 (-0.115) | |
| ED-LoRA + Weight Fusion | 0.868\(\rightarrow\)0.798 (-0.070) | 0.802\(\rightarrow\)0.634 (-0.168) | 0.858\(\rightarrow\)0.816 (-0.042) | 0.843\(\rightarrow\)0.749 (-0.094) | |
| ED-LoRA + Gradient Fusions | 0.868\(\rightarrow\)0.846 (-0.022) | 0.802\(\rightarrow\)0.770 (-0.032) | 0.858\(\rightarrow\)0.838 (-0.020) | 0.843\(\rightarrow\)0.818 (-0.025) |
原 Table 2c · 人类偏好
| Human Evaluation | Image Alignment | Text Alignment |
|---|---|---|
| ED-LoRA + Weight Fusion | 33.5% | 47.5% |
| ED-LoRA + Gradient Fusion | 66.5% | 52.5% |
Table 2a 的全部方法行与3类别、均值列均保留;Table 2c 的全部人类偏好比例也独立重建。Table 2b 是Amazon Mechanical Turk的比较界面示意,不是额外数值表;可以在原PDF第9页核对。
12.1 更好的 embedding 有帮助,但不够
在保持weight fusion时,从LoRA换成ED-LoRA,macro身份下降量从0.115减到0.094;对应fused score由0.701提高到0.749。这个消融支持增强embedding表达能够减少身份丢失,但剩余下降仍然很大。ED-LoRA并没有单独消除平均权重的稀释效应。
12.2 Gradient fusion 是更大的融合收益来源
同一组ED-LoRA采用gradient fusion后,下降从0.094减到0.025,fused score从0.749升至0.818。相对于常规LoRA+weight fusion,平均下降量减少约78.3%,这是对两个下降量的计算,不是“身份准确率提升78.3%”,也不是多概念图像正确率。
12.3 用户偏好只说明有限范围
ED-LoRA+gradient fusion获得66.5%的image-alignment偏好,weight fusion为33.5%;text-alignment为52.5%对47.5%,优势较小。论文给出AMT界面与比例,但没有在固定正文/附录中充分列出受访人数、题量、置信区间、随机化与统计显著性。不要把52.5%描述成显著全面改善。
区域采样的消融主要展示身份混合与属性绑错缓解,没有与概念数、重叠比例、框误差等变量对应的完整成功率表。多词与逐层embedding也没有做完整的2×2量化因子实验,现有消融不能精确分离二者各自的贡献。
13 · Paper vs. Implementation:复现不能只抄摘要
| 核对项 | 论文层面 | 研究分支实际证据 | 复现建议 |
|---|---|---|---|
| Optimizer | Adam | 示例YAML明确AdamW,weight_decay=0.01 | 将差异写入实验记录,不以名称近似掩盖差别 |
| 额外损失 | 主要展示denoising loss | EDLoraModel实际调用KDE embedding regularization;默认示例有非零权重 | 报告是否启用,不把它从复现中无意删掉 |
| K/V LoRA dropout | 正文未系统说明逐概念差异 | Cat示例0.2,Potter示例0,Hinton配置文件名另带dropkv03 | 以每概念实际配置为准,文件名只用于定位,值仍需读取确认 |
| 评估采样器 | 所有评估DPM-Solver20步 | 所查fused YAML为DDIM50步;main示例又使用50步DPM-Solver | 固定论文设置和调用入口,报告差异,不声称本轮已解决数值复现 |
| 融合层预算 | text encoder500,UNet50 | UNet cross K/V调用optimize_textenc_iters;其他空间attention调用optimize_unet_iters | 不能笼统地给所有UNet层设50就称为代码一致 |
| 区域重叠 | 用局部输出替换全局输出 | 区域框离散化,重叠部分按区域数量平均,replace_ratio=1 | 极小/重叠区域单独测试,避免错误的前后遮挡解释 |
| 概念兼容性 | 每个用户独立训练 | 相同UNet/text-encoder布局、16层token映射、可识别adapter键名 | 独立训练不等于可任意合并不同架构、不同base或不同tokenizer |
| 文档完整性 | 官方代码可用 | 固定研究分支docs/Config.md与docs/Dataset.md为空文件;main有应用版数据说明 | 空文件不是核实证据,依靠可读配置与源代码,不补写成“官方已说明” |
代码中的loss先在latent上预测噪声,再用mask加权并按mask覆盖量归一;因此实际训练目标有空间权重。人物/物体的caption读取、增强和裁剪方式不同,场景配置则不使用caption文件。本文没有把它们归纳成一个虚构的“所有类别统一数据预处理”。
初始化、layer-wise prompt展开、基础token梯度冻结、LoRA dropout开关与图像采样均可在研究代码中追溯。中心fusion则先更新text encoder,再更新cross K/V,再拟合空间相关层,是顺序过程。它对每层行为的拟合不是所有网络参数联合求一个全局最优,也没有保证新增一批概念以后旧概念永不遗忘。
14 · Reviewer:优势、漏洞与适用范围
优势
- 提出一个现实工作流问题:社区共享的是独立适配器,不一定能集中重训全部原图;明确single-client与center-node职责,让概念库具备可组合接口
- 把失败机制拆开:embedding能力不足与weight fusion稀释是两个问题,ED-LoRA与gradient fusion分别应对;有单独权重融合消融支持这种拆分
- 行为对齐比参数混合更有针对性:激活与目标输出让服务器知道每个adapter“需要保留什么”,而不只是计算均值
- 评价包含融合前后:同一概念从single到fused的变化揭示身份遗忘,比只展示多人物最好看的图片更有说服力
- 附录细节丰富:有每概念图片数、完整明细表、20类prompt模板与失败案例,适合做系统复现与后续方法比较
主要局限
- 规模证明不够:14现实概念和5动漫概念不足以支持“无限”容量;没有随概念数增长的误差/内存/时间曲线,也没有长期增量融合实验
- 定量代理与组合目标有间隙:单主体CLIP保持不代表多主体场景每个身份都对;缺少区域身份、关系、数量、属性绑定的系统指标
- 没有正式隐私保证:保留原始图片在本地减少直接共享,但概念适配器仍能再现人物外观;没有成员推断、重建或隐私预算实验
- 教师采样覆盖有限:短prompt与有限轨迹不能保证未见风格、复杂互动、稀有姿态上的行为一致;层局部回归还存在学生输入分布漂移
- 基础能力保持未充分测量:融合可能改变未参与概念训练的普通类别和开放域生成能力,主表没有完整回归测试
- 算力与实现公平性:中心额外优化30分钟不能与廉价权重平均视作同一成本;Adam/AdamW、附加损失和采样器差异仍需厘清
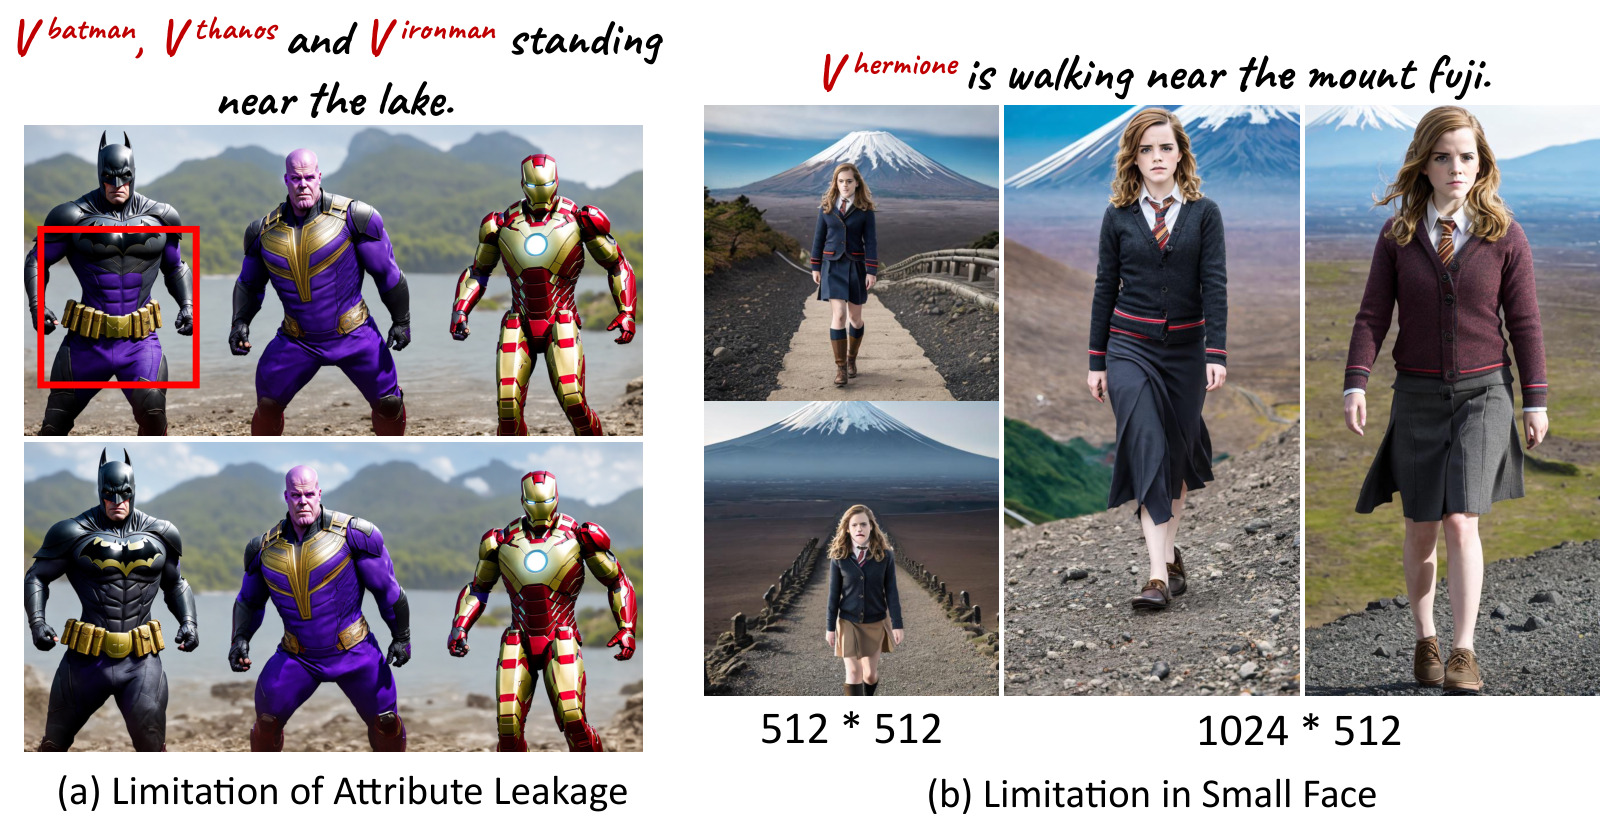
论文承认三个具体问题:区域之间仍有属性泄漏;UNet空间特征导致fusion耗时;小人脸受VAE信息损失影响,完整人物图中的脸容易模糊,增大采样分辨率可能缓解。把最后一点当作“无条件支持任意分辨率”会过度解读,Figure10只说明一个经验补救。
适合:同类基础模型上的少样本主体库、影视/插画角色组合、人工预设布局的图像创作。不应直接承诺:任意来源LoRA即插即用无损混合、自动理解复杂人与物的关系、视频时间一致性、3D身份一致性、可编辑物理材质生成。人物概念还应取得适当授权并标注合成来源;论文自己也提醒虚构真实人物互动可能误导观看者。
15 · 对 Procedural Material Generation 的研究延伸
以下为 Research Extension,未由该论文验证。Mix-of-Show生成RGB图像,没有材质图节点、边、程序token、SBS/SBSAR、BRDF贴图或renderer执行闭环。可借鉴的是“把概念身份从局部参数中解耦出来,并按实际执行行为融合”,不是直接把生成图当作可用材质资产。
15.1 材质模块库:分开语义标识与程序残差
让每个材质概念有稳定的语义/尺度描述,再用独立程序子图承载特殊纹理与反射细节。比如“锈蚀金属”的基础金属反射、锈蚀分布、划痕尺度分别有明确接口。融合多个模块时,先保留各自标识和作用区域,再连接图,不要把所有程序参数直接平均成一个失去身份的材质。
与ED-LoRA相似,模块身份可用多尺度预览或分层特征表示;但程序接口必须额外记录输入/输出类型、单位、纹理坐标、随机种子和执行依赖。Embedding可组合不代表shader graph可执行,图合法性应是硬约束。
15.2 用渲染行为对齐代替参数平均
\[\min_{\vartheta}\sum_{i}\sum_{v,\ell}
\left\|F_{\ell}\!\left(R(G,\vartheta;c_v,L_v)\right)-
F_{\ell}\!\left(R(G_i,\vartheta_i;c_v,L_v)\right)\right\|_2^2+\lambda\mathcal C(G,\vartheta).\]
\(G_i,\vartheta_i\) 是单材质教师程序与参数,\(R\) 为渲染器,\(c_v,L_v\) 是相机与光照,\(F_{\ell}\) 是可比较的多尺度特征,\(\mathcal C\) 表示合法性/复杂度或物理先验。不同于Mix-of-Show的线性层输入输出回归,这里是执行后的可微或黑箱渲染目标;需要明确不能照搬其L-BFGS逐层假设。
最小实验可固定图拓扑,仅融合一组连续参数,比较参数平均、单视图感知回归、多视图多照明行为回归。先报告held-out光照/相机误差与参数偏差,再考虑拓扑可变的程序搜索。否则视觉模型可能只学到一种灯光下的“像金属”,没有得到真实金属响应。
15.3 Regional prompt 对应材质区域绑定
图像中的“人物A在左侧”可迁移为资产上的“木纹只作用于桌面,金属只作用于支架”。但图像矩形区域不足以表示三维遮挡、曲面与UV接缝;应由语义部件、几何mask或UV分区定义区域。重叠区需要物理混合模型或明确层叠顺序,不应把颜色/BRDF盲目平均。
15.4 可增长的材质专家库与遗忘测试
将不同用户独立制作的材质模块作为“客户端专家”,中心只接收模块与一套标准渲染探针结果,保持原始项目文件的最小共享。每加入一个模块,测试已有材质在固定球、平面、复杂mesh以及多照明下的响应是否改变。报告旧概念遗忘、模块冲突、渲染成本和库容量,才有依据讨论可扩展性。
一个明确的研究问题:在程序图合法、跨光照一致、可编辑参数保留的约束下,能否利用少量标准渲染探针将独立材质模块融合为统一的条件生成器,并保持每个模块的行为?关键实验应包括图合法率、参数语义保真、held-out视角/光照、无缝性、区域绑定准确度、概念数增长曲线与新增概念后的旧库回归。
16 · 端到端复现与验收清单
- 固定论文v2、research_branch提交、预训练Chilloutmix/Anything-v4的具体文件校验值;先检查各adapter确实来自兼容base
- 逐概念记录图片数、caption、裁剪与mask、两词初始化、训练步数、batch、KDE与K/V dropout;不要仅复制一个人物配置训练全部对象
- 先做single-client验证,并分别检查embedding-only与embedding+LoRA的输出,确认ED-LoRA是否真的把身份核心保留进embedding
- 用同一批概念与同一强度系数对比weight fusion和gradient fusion,保存服务器各层输入输出约束与L-BFGS损失,不把融合成本隐藏
- 核清论文20步DPM-Solver与公开YAML50步DDIM的差别;固定scheduler、CFG、负prompt、seed与生成分辨率后再做数值对齐
- 完整执行每概念20 prompts×50 seeds,分别计算single/fused的两类CLIP指标,保留原始逐图分数;按原表类别宏平均重算总数
- 额外对多概念图片进行区域身份、数量、属性绑定与关系评价;在相同姿态/草图、区域框与seed下比较
- 测试重叠框、小框、小人脸、相似身份、不同风格、未见基础类别以及概念数增长,报告失败而不只挑选图像
一句话记住:客户端让概念更好地“说出自己是谁”,中心按模型的实际行为合并,采样阶段再明确“谁属于哪个区域”。三者解决的是不同层面的冲突。
交付范围:本文完成固定源阅读、内容生成、原图表整理和静态源码检查;没有模型训练、GPU推理、基线实验或真实浏览器验收。浏览器中的MathJax、图片加载、导航和1440/760/390px布局检查按用户要求延期;未修改既有vault、未部署或发布网站。
17 · 完整评估 prompt 清单
下表来自固定research_branch中的六类benchmark文本文件,共120条,方便实际复现时逐行核对;与Figure8对应。保留原英文句法及某些不自然组合,不替作者修订为更容易生成的prompt。占位符<TOK>应替换成对应概念的两个标识,不能直接作为普通类别词使用。仓库还存在plushy模板,但本文现实域Table3未单列该概念,因此不把它加入本页的原图六类清单。
| 对象组 | 类别 | 组内序号 | 官方 benchmark prompt(保留原英文) |
|---|---|---|---|
| 人物 | Recontextualization | 1 | A photo of <TOK> on the beach, small waves, detailed symmetric face, beautiful composition |
| 人物 | Recontextualization | 2 | A <TOK>, in front of Eiffel tower |
| 人物 | Recontextualization | 3 | A <TOK>, near the mount fuji |
| 人物 | Recontextualization | 4 | A <TOK>, in the forest |
| 人物 | Recontextualization | 5 | A <TOK>, walking on the street |
| 人物 | Restylization | 1 | A <TOK>, cyberpunk 2077, 4K, 3d render in unreal engine |
| 人物 | Restylization | 2 | A watercolor painting of a <TOK> |
| 人物 | Restylization | 3 | A painting of a <TOK> in the style of Vincent Van Gogh |
| 人物 | Restylization | 4 | A painting of a <TOK> in the style of Claude Monet |
| 人物 | Restylization | 5 | A <TOK> in the style of Pixel Art |
| 人物 | Interaction | 1 | A <TOK> sit on the chair |
| 人物 | Interaction | 2 | A <TOK> ride a horse |
| 人物 | Interaction | 3 | A <TOK>, wearing a headphone |
| 人物 | Interaction | 4 | A <TOK>, wearing a sunglass |
| 人物 | Interaction | 5 | A <TOK>, wearing a Santa hat |
| 人物 | Property Modification | 1 | A smiling <TOK> |
| 人物 | Property Modification | 2 | An angry <TOK> |
| 人物 | Property Modification | 3 | A running <TOK> |
| 人物 | Property Modification | 4 | A jumping <TOK> |
| 人物 | Property Modification | 5 | A <TOK> is lying down |
| 宠物 | Recontextualization | 1 | A <TOK>, in the swimming pool |
| 宠物 | Recontextualization | 2 | A <TOK>, in front of Eiffel tower |
| 宠物 | Recontextualization | 3 | A <TOK>, near the mount fuji |
| 宠物 | Recontextualization | 4 | A <TOK>, in the forest |
| 宠物 | Recontextualization | 5 | A <TOK>, walking on the street |
| 宠物 | Restylization | 1 | A <TOK>, cyberpunk 2077, 4K, 3d render in unreal engine |
| 宠物 | Restylization | 2 | A watercolor painting of a <TOK> |
| 宠物 | Restylization | 3 | A painting of a <TOK> in the style of Vincent Van Gogh |
| 宠物 | Restylization | 4 | A painting of a <TOK> in the style of Claude Monet |
| 宠物 | Restylization | 5 | A <TOK> in the style of Pixel Art |
| 宠物 | Interaction | 1 | A <TOK> sit on the chair |
| 宠物 | Interaction | 2 | A <TOK> on the boat |
| 宠物 | Interaction | 3 | A <TOK>, wearing a headphone |
| 宠物 | Interaction | 4 | A <TOK>, wearing a sunglass |
| 宠物 | Interaction | 5 | A <TOK> playing with a ball |
| 宠物 | Property Modification | 1 | A sad <TOK> |
| 宠物 | Property Modification | 2 | An angry <TOK> |
| 宠物 | Property Modification | 3 | A running <TOK> |
| 宠物 | Property Modification | 4 | A jumping <TOK> |
| 宠物 | Property Modification | 5 | A <TOK> is lying down |
| 桌子 | Recontextualization | 1 | A <TOK>, near the beach |
| 桌子 | Recontextualization | 2 | A <TOK>, near the Eiffel tower |
| 桌子 | Recontextualization | 3 | A <TOK>, near the mount fuji |
| 桌子 | Recontextualization | 4 | A <TOK>, in the living room |
| 桌子 | Recontextualization | 5 | A <TOK>, in times square |
| 桌子 | Restylization | 1 | A <TOK>, cyberpunk 2077, 4K, 3d render in unreal engine |
| 桌子 | Restylization | 2 | A watercolor painting of a <TOK> |
| 桌子 | Restylization | 3 | A painting of a <TOK> in the style of Vincent Van Gogh |
| 桌子 | Restylization | 4 | A painting of a <TOK> in the style of Claude Monet |
| 桌子 | Restylization | 5 | A <TOK> in the style of Pixel Art |
| 桌子 | Interaction | 1 | A cat sit on the <TOK> |
| 桌子 | Interaction | 2 | A book is placed on <TOK> |
| 桌子 | Interaction | 3 | A teapot is placed on <TOK> |
| 桌子 | Interaction | 4 | A vase is placed on the <TOK> |
| 桌子 | Interaction | 5 | A dog sit on the <TOK> |
| 桌子 | Property Modification | 1 | A close view of <TOK> |
| 桌子 | Property Modification | 2 | A top view of <TOK> |
| 桌子 | Property Modification | 3 | A bottom view of <TOK> |
| 桌子 | Property Modification | 4 | A <TOK> in rainbow colors |
| 桌子 | Property Modification | 5 | A broken <TOK> |
| 椅子 | Recontextualization | 1 | A <TOK>, near the beach |
| 椅子 | Recontextualization | 2 | A <TOK>, near the Eiffel tower |
| 椅子 | Recontextualization | 3 | A <TOK>, near the mount fuji |
| 椅子 | Recontextualization | 4 | A <TOK>, in the living room |
| 椅子 | Recontextualization | 5 | A <TOK>, in times square |
| 椅子 | Restylization | 1 | A <TOK>, cyberpunk 2077, 4K, 3d render in unreal engine |
| 椅子 | Restylization | 2 | A watercolor painting of a <TOK> |
| 椅子 | Restylization | 3 | A painting of a <TOK> in the style of Vincent Van Gogh |
| 椅子 | Restylization | 4 | A painting of a <TOK> in the style of Claude Monet |
| 椅子 | Restylization | 5 | A <TOK> in the style of Pixel Art |
| 椅子 | Interaction | 1 | A girl sit on a <TOK> |
| 椅子 | Interaction | 2 | A cat sit on <TOK> |
| 椅子 | Interaction | 3 | A dog sit on <TOK> |
| 椅子 | Interaction | 4 | A vase is placed on the <TOK> |
| 椅子 | Interaction | 5 | A boy sit on the <TOK> |
| 椅子 | Property Modification | 1 | A grey <TOK> |
| 椅子 | Property Modification | 2 | A close view of <TOK> |
| 椅子 | Property Modification | 3 | A top view of <TOK> |
| 椅子 | Property Modification | 4 | A <TOK> in rainbow colors |
| 椅子 | Property Modification | 5 | A broken <TOK> |
| 花瓶 | Recontextualization | 1 | A <TOK>, in the ocean |
| 花瓶 | Recontextualization | 2 | A <TOK>, near the Eiffel tower |
| 花瓶 | Recontextualization | 3 | A <TOK>, near the mount fuji |
| 花瓶 | Recontextualization | 4 | A <TOK>, buried in the sands |
| 花瓶 | Recontextualization | 5 | A <TOK>, in times square |
| 花瓶 | Restylization | 1 | A <TOK>, cyberpunk 2077, 4K, 3d render in unreal engine |
| 花瓶 | Restylization | 2 | A watercolor painting of a <TOK> |
| 花瓶 | Restylization | 3 | A painting of a <TOK> in the style of Vincent Van Gogh |
| 花瓶 | Restylization | 4 | A painting of a <TOK> in the style of Claude Monet |
| 花瓶 | Restylization | 5 | A <TOK> in the style of Pixel Art |
| 花瓶 | Interaction | 1 | A <TOK> on a table |
| 花瓶 | Interaction | 2 | A <TOK> on a chair |
| 花瓶 | Interaction | 3 | A <TOK> with a colorful flower bouquet |
| 花瓶 | Interaction | 4 | Milk poured into a <TOK> |
| 花瓶 | Interaction | 5 | A <TOK> on a carpet |
| 花瓶 | Property Modification | 1 | A green <TOK> |
| 花瓶 | Property Modification | 2 | A grey <TOK> |
| 花瓶 | Property Modification | 3 | A multi-color <TOK> |
| 花瓶 | Property Modification | 4 | a fallen <TOK> |
| 花瓶 | Property Modification | 5 | A broken <TOK> |
| 场景 | Recontextualization | 1 | A <TOK>, in the snow |
| 场景 | Recontextualization | 2 | A <TOK>, at night |
| 场景 | Recontextualization | 3 | A <TOK>, in autumn |
| 场景 | Recontextualization | 4 | A <TOK>, in a sunny day |
| 场景 | Recontextualization | 5 | A <TOK>, in thunder and lightning |
| 场景 | Restylization | 1 | A <TOK>, cyberpunk 2077, 4K, 3d render in unreal engine |
| 场景 | Restylization | 2 | A watercolor painting of a <TOK> |
| 场景 | Restylization | 3 | A painting of a <TOK> in the style of Vincent Van Gogh |
| 场景 | Restylization | 4 | A painting of a <TOK> in the style of Claude Monet |
| 场景 | Restylization | 5 | A <TOK> in the style of Pixel Art |
| 场景 | Interaction | 1 | A girl near the <TOK> |
| 场景 | Interaction | 2 | A boy near the <TOK> |
| 场景 | Interaction | 3 | A dog near the <TOK> |
| 场景 | Interaction | 4 | A cat near the <TOK> |
| 场景 | Interaction | 5 | Many people near the <TOK> |
| 场景 | Property Modification | 1 | A <TOK> in rainbow colors |
| 场景 | Property Modification | 2 | A <TOK> made of metal |
| 场景 | Property Modification | 3 | A close view of <TOK> |
| 场景 | Property Modification | 4 | A top view of <TOK> |
| 场景 | Property Modification | 5 | A bottom view of <TOK> |
官方完整benchmark prompts目录。该清单属于采样输入模板,不是作者训练caption全量清单,也不是用户研究所有题目。
18 · 一手来源与证据边界
- arXiv固定v2元数据 · 固定PDF(18页) · 原文HTML
- NeurIPS2023官方记录:会议年份、13位作者与正式DOI;没有替换本次固定版本PDF
- 官方研究分支固定提交 · main分支及分支用途说明
- ED-LoRA结构与32个概念embedding向量 · 训练、KDE约束与dropout
- Gradient Fusion脚本 · Weight Fusion对照脚本
- 区域采样、局部negative prompt与重叠平均
- 训练和测试配置 · CLIP评分脚本
固定PDF SHA-256:70c0600748d1b04523260f04c4313567b15b2fff884f14a2ee2cb872d05023b0。Figure1–3引用arXiv原图;其余Figure4–10因arXiv HTML资源空缺,从固定PDF相应页面直接提取,并在Markdown中链接原PDF页码。Table1、Table2a/2c、Table3全部六个子块均按原源重建,所有原图表版权与学术贡献归原作者。