Paper Reading · MultiMat
ICLR 2026 · arXiv v2 · 深度精读
Multimodal program synthesis for procedural materials

MultiMat

把程序化材质图视为视觉空间程序,让模型在每个节点之后看见执行结果,再用增量验证和回溯搜索维持程序有效性。

论文Belouadi, Boubekeur, Kaiser
发表ICLR 2026 Poster
对象Adobe Substance Designer 图

身份核查。 本页以 arXiv v2,2026 年 2 月 9 日版本为分析主体。arXiv 当前已列出 v3,日期为 2026 年 5 月 13 日。ICLR Proceedings 已正式收录该文,因而 “ICLR 2026” 身份无歧义。arXiv v2 · ICLR Proceedings

核心结论

MultiMat 的关键贡献不是简单地向模型多喂一张目标图,而是把程序执行产生的中间视觉状态持续放回上下文。由此,图生成从一次性文本解码变成带环境执行、错误检测和回溯的多步过程。

6,878训练材料规模
128保留的最大节点数
80%+CompactSBS 平均压缩幅度
8,192统一最大序列长度
论文结论视觉上下文越完整,综合表现越强无条件生成中,Graph 版本 KID 为 2.365,优于 Mixed 的 6.752 和文本基线的 14.155。条件生成中,Graph 版本的 DreamSim、CLIP 与 Style 指标均为未优化模型中的最佳。论文第 6 节
分析判断这是一种具备智能体结构的生成器它具有状态、动作、环境执行、验证器、局部修复和回溯,但缺少显式的长期目标分解、记忆策略和基于渲染相似度的搜索价值函数。因此,更准确的定位是“带工具执行的自回归程序搜索”,而不是完整的通用 Agent。

问题定义与 CompactSBS

程序化材质图 \(G\) 是有向无环图。节点集合写作 \(\{v_1,v_2,\ldots,v_N\}\),边描述图像数据流。每个节点可以是生成器或滤镜,并产生中间图像。论文把当前步骤已经执行得到的视觉状态记作 \(I_t\)。节点参数同时包含连续量、离散量和向量。

\[ G_t=\{v_1,v_2,\ldots,v_t\},\qquad I_t=\{i_1,i_2,\ldots,i_t\}. \]

这里的 \(I_t\) 应理解为步骤 \(t\) 时可用的中间输出集合,不只是第 \(t\) 个节点的一张预览。因此公式中不另写 \(I_{\lt t}\),并不意味着历史视觉状态被丢弃,而是历史已经包含在当前执行状态中。

CompactSBS 是什么

原生 SBS 是冗长 XML,包含二进制数据、历史元数据和大量不适合语言建模的实现细节。作者实现双向 transpiler,把 SBS 转为按拓扑顺序排列的 YAML 风格 CompactSBS,再把生成结果转回 SBS 执行。论文声称完整保留 Substance 图功能,程序平均缩短超过 80%。论文第 5 节

# 结构示意,并非逐字复制论文附录
s7:
  function: multi_directional_warp_grayscale
  connections:
    input: { node: s4, id: output }
    intensity_input: { node: s5, id: output }
  outputs:
    output: grayscale

s10:
  function: safe_transform_grayscale
  dependency: sbs://safe_transform.sbs
  connections:
    input: { node: s9, id: output }
  params:
    absolute: { rotation: 0.25, tile: uU_vV }
语言模型得到的收益

  • 拓扑排序让连接只能指向已生成节点
  • YAML 风格减少无效 token 与 XML 噪声
  • 显式字段区分 function、dependency、connections、params 与 outputs
  • 同一表示可以做文本上下文,也可以转回 SBS 执行

仍然存在的风险

  • “完整功能”缺少公开兼容性测试矩阵
  • 标准库中的非原子节点仍保留外部引用
  • 层级图被展开后,结构长度和可读性可能显著变化
  • 未公开 transpiler 与数据,外部团队难以验证可逆性
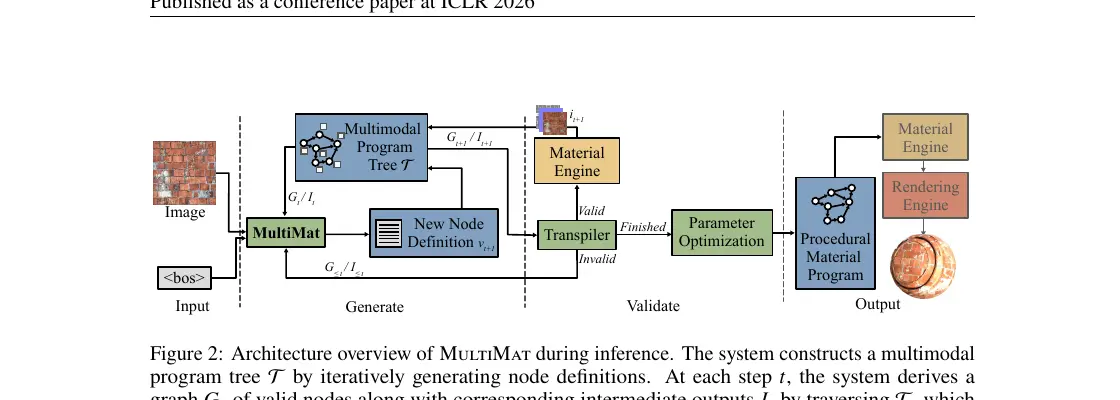
MultiMat 推理架构图,展示图生成、转译、材质引擎执行、视觉反馈与回溯
Figure 2,论文原图裁切。 系统逐节点生成 CompactSBS,经转译和材质引擎执行后形成视觉状态。有效节点进入下一步,无效节点触发回滚。来源:论文 PDF,第 3 页。

文本、视觉与 mixed conditioning

论文实际上比较三种上下文表示强度:完整文本图,文本与节点预览交错,以及完整节点图截图。目标图像只负责给出“要生成什么”,而过程条件负责告诉模型“当前已经构造到哪里”。
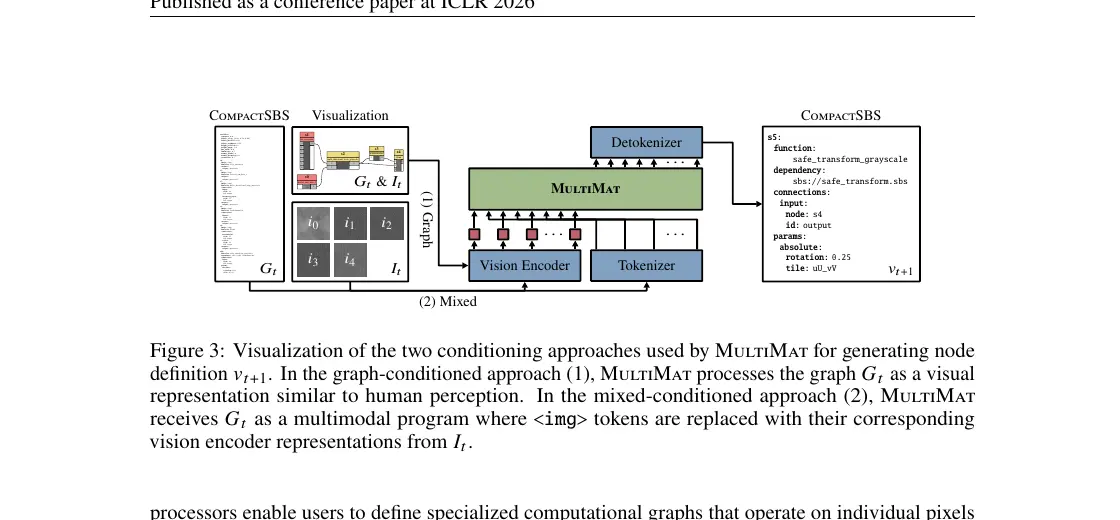
Mixed conditioning

  • 保留 \(G_t\) 的 CompactSBS 文本骨架
  • 每个节点增加 image 占位,随后被视觉编码器表示替换
  • 为控制上下文长度,省略节点参数
  • 显式保留输出类型,因为灰度或彩色不能仅靠预览可靠判断
  • 节点预览为 140 × 140,每张图形成 25 个 patch embeddings

Graph conditioning

  • 只输入完整节点图的可视化
  • 图中嵌入每个节点的中间输出
  • 不显式提供底层 CompactSBS 节点定义
  • 最多使用 6,144 个视觉 token,过大截图会缩小
  • 更接近人类在 Substance Designer 中看图操作的方式
论文 Figure 3,比较 graph conditioning 与 mixed conditioning
Figure 3,论文原图裁切。 Graph 分支将整个 \(G_t\) 与 \(I_t\) 合成为一张节点图视觉输入。Mixed 分支在 CompactSBS 中插入 image token,再由视觉编码器写入对应节点预览。来源:论文 PDF,第 4 页。

mixed conditioning 中参数去了哪里

参数没有以文本字段继续输入模型。论文明确说,为限制图像 embedding 增加后的上下文长度,Mixed 版本省略参数,并认为参数效果被中间可视化隐式编码。这是一项强假设,因为不同参数可能产生近似预览,视觉状态不必然具有参数可辨识性。

分析判断Graph 更强,但它支付了 OCR 税Graph 版本综合质量最佳,却有较高 NER。论文把主要错误归因于读取节点图中名称和 function type 时出现的 OCR 类错误。这说明视觉表示更贴近任务语义,同时也把原本精确的符号信息变成了有损像素。

Autoregressive graph generation 与 constrained tree search

模型按拓扑顺序一次生成一个节点定义 \(v_{t+1}\),其中包括节点类型、参数和连接。每个新节点只能连接到已经存在的节点,天然避免前向引用。两种多模态版本仍是自回归语言模型,以 token 级交叉熵训练:

\[ \mathcal{L}=-\sum_{t=1}^{T}\sum_{s=1}^{S}\log p\!\left(v_{t,s}\mid v_{t,{\lt s}},G_t,I_t,x;\theta\right). \]

其中 \(v_{t,s}\) 是第 \(t\) 个节点 CompactSBS 表示中的第 \(s\) 个目标 token,\(v_{t,{\lt s}}\) 是该节点内此前 token,\(x\) 是外部条件。无条件生成时 \(x\) 为空或由 beginning of sequence token 启动,条件生成时 \(x\) 是参考渲染图。

生成节点采样 \(v_{t+1}\)
→
转译执行CompactSBS 到 SBS
→
更新状态\(S_{t+1}=(G_{t+1},I_{t+1})\)

execution state 与 backtracking

可把执行状态写为 \(S_t=(G_t,I_t)\)。若转译和材质执行成功,新节点进入 \(G_{t+1}\),预览进入 \(I_{t+1}\)。若出现语法错误、语义错误或执行失败,当前候选被丢弃并重采样。重复失败时,回溯深度按指数增长:

\[ d_i=2^{i-1},\qquad i=1,2,3,\ldots \]

第一次回退 1 个节点,第二次回退 2 个,第三次回退 4 个。其含义是:持续局部失败可能源于更早的结构决定,因此搜索需要返回更深的祖先状态。论文称其为 constrained tree search,约束主要来自 CompactSBS 转译器、图静态规则和材质引擎的可执行性,而不是来自目标外观 reward。
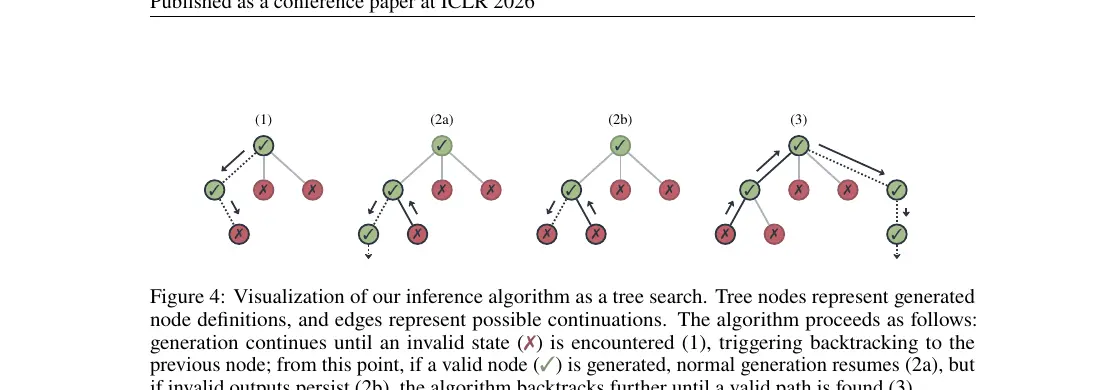
论文 Figure 4,展示增量树搜索与指数回溯
Figure 4,论文原图裁切。 绿色节点代表有效状态,红色节点代表无效候选。连续失败使搜索返回更早的有效祖先。来源:论文 PDF,第 5 页。

自动修复

系统会删除节点类型不支持的多余参数,并在 color 到 grayscale 的连接中插入灰度转换节点,在 grayscale 到 color 的连接中插入 gradient map。修复不会反馈给模型,因此后续上下文可能显示已修复后的执行图,但模型并未得到明确的错误解释。

研究建议让修复进入过程轨迹当前课题可把错误类别、修复动作和修复后的渲染增益写入 process trace。这样 context optimizer 能学会哪些历史应该保留,而 Agent 能避免重复犯同一类连接或参数错误。

数据构造、训练与实现细节

作者从 Adobe Substance 3D Assets Repository 收集生产级材质,并排除许可不适合训练的 Community Assets。预处理向五类 PBR 输出反向追踪:base color、normal、roughness、metallic 与 height。未连接组件和其他输出图被裁掉,包含 bitmap 或 SVG 的图被排除,超过 128 节点的图被过滤,嵌套子图和自定义依赖被展开。

Table 1,数据规模与表达能力
模型规模最大节点功能集程序系统
MatFormer2,820≤ 400,上界SubsetDesigner
Conditional MatFormer4,667≤ 80,上界SubsetDesigner
VLMaterial3,66330LimitedBlender
MultiMat6,878128Complete,作者主张Designer
公开实现配置与缺失项
项目论文报告复现判断
基础模型Qwen2.5 VL 7BMixed、Graph 与条件基线
无条件文本基线Qwen3 8B对文本基线略有模型规模优势
训练5 epochs,AdamW,学习率 5e-5,batch 128可建立主干配置
上下文最大 8,192 tokens所有变体一致
采样temperature 0.8,top p 0.95生成多样性参数已给出
无条件评估每模型 100 个输出样本量偏小
条件输入512 × 512,增加 324 image patches保留 100 个测试样本
训练硬件8 × A100 80GBMultiMat 数日,文本基线数小时
训练 prompt未报告关键复现缺口
随机种子与调度器未报告无法精确复现
DiffMat 迭代数、学习率、损失组合未报告优化结果不可严格复现
官方代码与数据下载公开页面未链接截至本页核查时不可获得

实验设计与结果

Baselines 与公平性

由于原始 VLMaterial 面向 Blender,作者在同一 SBS 数据上重训 VLMaterial 风格基线。无条件设置中,文本基线使用 Qwen3 8B,两个 MultiMat 版本使用 Qwen2.5 VL 7B。条件设置中,因为需要视觉输入,所有模型均基于 Qwen2.5 VL 7B。GPT 4o 与 Claude 4 未纳入,理由是它们不熟悉 CompactSBS 且无法稳定产生有效 SBS。

KID,越低越好生成材质分布与数据集材质图分布的距离
ROUGE L,越低越好屏蔽参数后与训练程序的连续最长公共子序列,用于检查记忆
NER,越低越好被丢弃节点数占全部生成节点数的平均比例
DreamSim,越高越好面向人类感知对齐的学习型图像相似度
CLIP,越高越好输入与重建渲染的图像 embedding 余弦相似度
Style,越低越好VGG 特征 Gram 矩阵之间的 L1 距离
Table 2,无条件生成,所有数值 × 100
模型KID ↓ROUGE L ↓NER ↓
VLMaterial (SBS)14.1553.64114.846
MultiMat (Mixed)6.7522.1958.923
MultiMat (Graph)2.3651.91515.024
Table 3,条件生成,所有数值 × 100
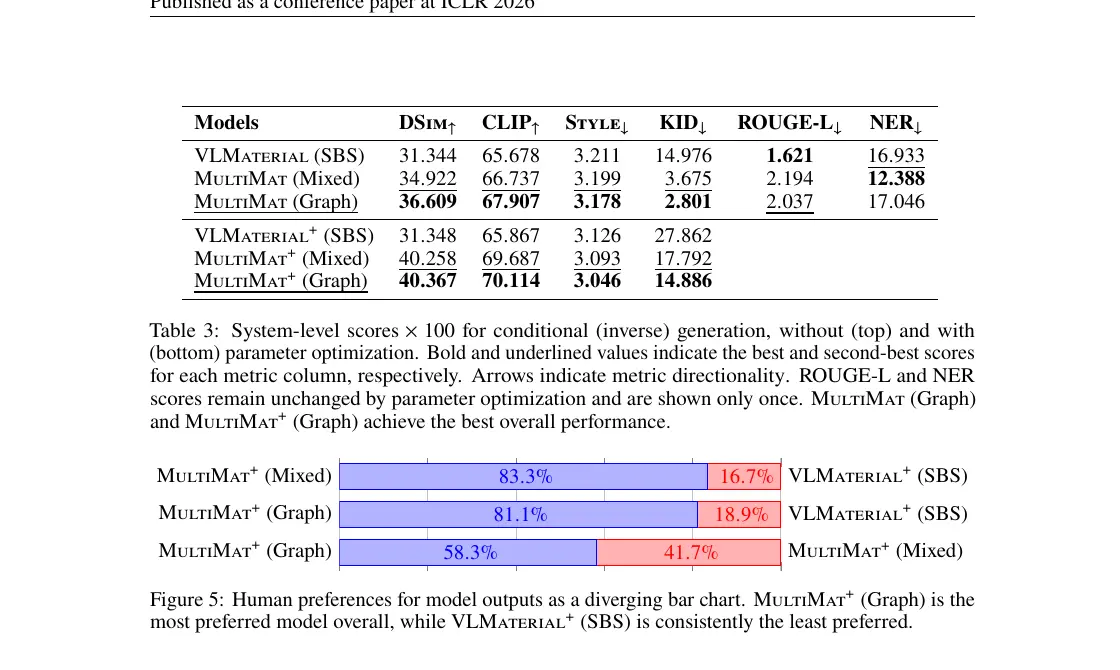
模型DSim ↑CLIP ↑Style ↓KID ↓ROUGE L ↓NER ↓
VLMaterial (SBS)31.34465.6783.21114.9761.62116.933
MultiMat (Mixed)34.92266.7373.1993.6752.19412.388
MultiMat (Graph)36.60967.9073.1782.8012.03717.046
VLMaterial+ (SBS)31.34865.8673.12627.862不变不变
MultiMat+ (Mixed)40.25869.6873.09317.792不变不变
MultiMat+ (Graph)40.36770.1143.04614.886不变不变

DiffMat 参数优化

MultiMat 先生成离散图结构和初始参数,DiffMat 随后把可微节点参数视为优化变量,通过可微执行让渲染结果逼近输入图像。优化版记为 MultiMat+。论文只明确“使用 DiffMat 做 gradient based optimization”,没有给出参数选择范围、迭代次数、学习率、损失权重或停止条件。

\[ \theta_G^{\ast}=\arg\min_{\theta_G}\mathcal{D}\!\left(\mathrm{Render}(G,\theta_G),I_{\mathrm{ref}}\right). \]

上式是对论文优化意图的抽象,不是论文原文给出的完整目标函数。结果上,Graph 的 DSim 从 36.609 提升到 40.367,Mixed 从 34.922 提升到 40.258,文本基线几乎不变。作者据此判断,结构越接近正确答案,连续参数优化越有效。与此同时,所有优化版本的 KID 显著上升,说明面向单个输入的拟合与整体生成分布质量并不一致。

Human evaluation

作者在 33 个高难度输入上评估,每个模型对每张图生成 \(N=40\) 个程序,再以 DreamSim 选出最好候选。8 名具程序化材质经验的专家比较三模型结果。Graph+ 对 VLMaterial+ 的偏好率为 81.1%,Mixed+ 对 VLMaterial+ 为 83.3%,Graph+ 对 Mixed+ 为 58.3%。
Mixed+ 胜文本基线
83.3%
Graph+ 胜文本基线
81.1%
Graph+ 胜 Mixed+
58.3%

关键 Figure 与 Table 解读

论文 Table 3 与 Figure 5,展示条件生成指标和专家偏好
Table 3 与 Figure 5,论文原图裁切。 自动指标与专家排序总体一致。需要注意,专家评估经过每图每模型 40 次采样再按 DreamSim 挑选,因此反映的是 best of 40 系统能力,不是单次生成成功率。来源:论文 PDF,第 7 页。
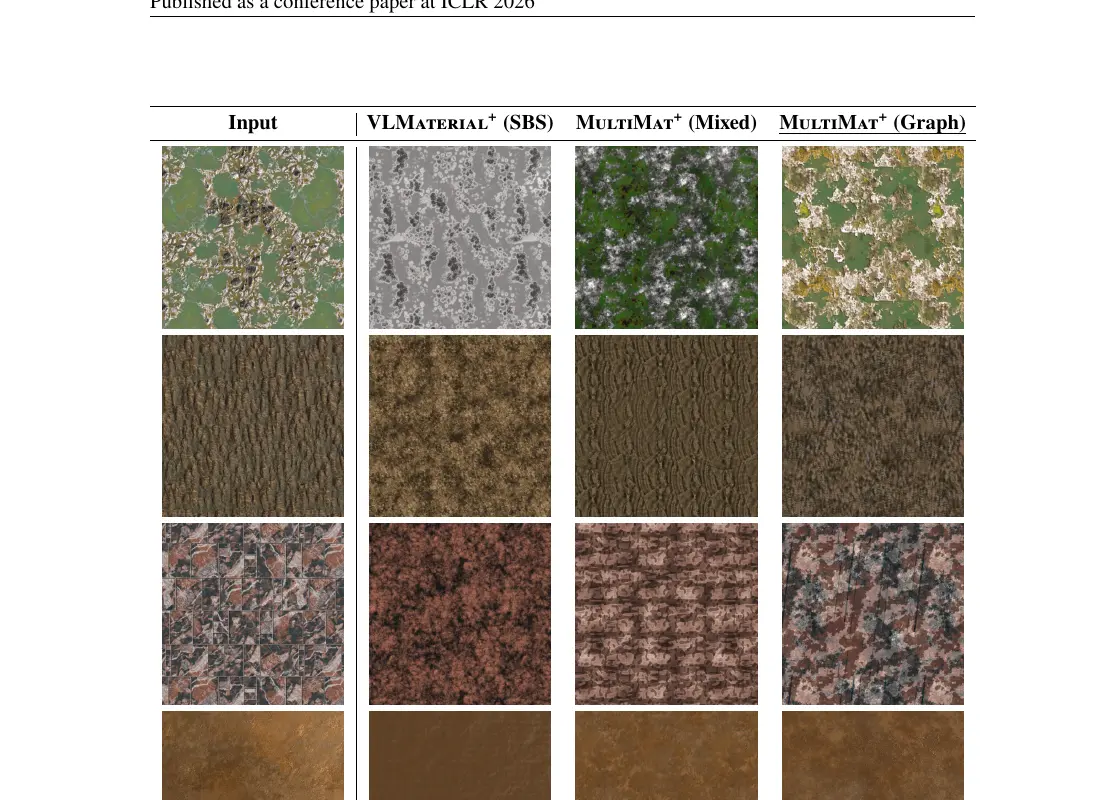
论文 Figure 6,目标图与三种方法的重建材质比较
Figure 6,论文原图裁切。 左列是预处理阶段被过滤的复杂图所产生的输入,因此属于刻意选择的高难集合。Graph 通常更接近整体结构和材质布局,但细纹理、规则结构与长程空间关系仍会失败。来源:论文 PDF,第 9 页。
Table 4,自动修复节点比例,越低越好
模型删除多余参数插入类型转换
VLMaterial (SBS)2.71%12.26%
MultiMat (Mixed)1.18%3.51%
MultiMat (Graph)1.10%6.49%
Figure 7,附录中的更多条件生成结果

设置与 Figure 6 相同,继续展示高难输入。作者总结 Mixed+ 持续优于文本基线,Graph+ 整体最佳。附录只给定性图,没有额外定量分层分析。

Figure 8,失败案例

复杂细密 pattern 是共同失败点。Graph 与 Mixed 仍比文本基线更接近输入,但并不能忠实复现。这类案例提示模型可能掌握材质类别和局部统计,却没有可靠恢复精确的程序结构。

Figure 9 与 Figure 10,无条件样本和完整 CompactSBS

Figure 9 将无条件生成材质与其节点图并列,说明 Graph 条件训练能够产生视觉上合理的复杂图。Figure 10 给出一份完整 CompactSBS,用于展示字段层级、依赖、连接与参数的实际组织方式,但论文没有提供正式 grammar 或 schema。

局限、失败模式与 reviewer 式锐评

论文明确承认

  • 逐节点构造视觉上下文使训练样本膨胀,MultiMat 在 8 × A100 80GB 上训练数日,文本基线仅数小时。
  • 图数据仍然稀缺,作者未来计划用无条件模型生成图,再渲染得到合成监督数据。
  • Graph 版本容易因图内文字产生 OCR 类节点名和 function type 错误。
  • 复杂精细 pattern 的重建仍明显失败。

审稿视角

1. “视觉反馈”与“图截图”没有完全解耦Graph 版本同时改变了表示模态、布局先验和上下文压缩方式。现有消融不足以判断收益来自节点预览、图拓扑布局、去除文本冗余,还是它们的组合。
2. tree search 保证的是可执行,不是外观正确搜索判据主要检测静态与运行错误。一个程序可以完全有效,却在视觉上远离输入。没有 value model、rendering feedback reward 或 beam score,搜索无法主动偏向更忠实的结构。
3. best of 40 放大了系统表现专家评估每模型每输入采样 40 次再以 DreamSim 选择最佳结果。该协议适合展示上限,但没有同时报告单次成功率、采样成本和质量随预算变化曲线。
4. KID 与单样本重建指标目标冲突DiffMat 优化显著改善 DSim、CLIP 和 Style,却恶化 KID。论文给出合理解释,但更好的实验应报告按材质类别分层的分布指标,并区分结构正确性与纹理外观拟合。
5. 复现性仍不足数据、transpiler、训练脚本和 DiffMat 配置尚未在公开入口中链接。尤其 CompactSBS 被描述为核心基础设施,但缺少 grammar、schema、转换覆盖率和 round trip 测试结果。

与 Procedural Material Generation、Context Optimization、Agent 的关系

三条研究线的映射
研究线MultiMat 已做仍未解决
Procedural Material Generation从参考图像或空条件生成 Designer 程序化材质图精确结构恢复、真实照片域、可编辑语义参数
Context Optimization比较文本骨架加预览与完整节点图两种上下文表示根据任务动态选择、压缩、排序和更新 context
Agent逐节点行动,调用转译器与材质引擎,维护状态并回溯显式规划、目标 reward、长期记忆、预算感知搜索

当前研究框架

下面两式是本课题的研究框架,不是 MultiMat 的原始贡献。MultiMat 最接近其中“以图可视化组织上下文”和“Agent 调用 Renderer 获得执行状态”的部分,但它没有显式求解最优上下文 (C^{\ast})。

\[ I \xrightarrow{\mathrm{Context\ Optimizer}} C^{\ast} \xrightarrow{\mathrm{Agent}} G \xrightarrow{\mathrm{Renderer}} \hat I \]
\[ C^{\ast}=\arg\max_C R\!\left(\mathrm{Render}(\mathrm{Agent}(C)),I\right). \]

对 context optimized agentic procedural material generation 的具体启示

  1. 把上下文优化器做成可学习模块。 候选表示至少包括原图、多尺度分解、材质区域分割、频谱与方向特征、当前节点图、节点预览和错误历史。目标不是简单堆叠,而是在固定 token 预算内选择最有决策价值的证据。
  2. 保留精确符号通道与视觉通道。 Graph 的 OCR 失败说明纯截图会损失节点名、端口类型和参数。可采用双轨 context:结构以 typed graph serialization 输入,外观以节点预览输入。
  3. 让 rendering feedback 进入搜索分数。 有效性验证只淘汰不能执行的候选。下一步应以结构有效性、局部视觉增益、全局相似度、复杂度和编辑性组成多目标 reward。
  4. 从回溯升级为预算感知 agentic search。 记录每个动作的渲染变化和失败原因,以 best first search、MCTS 或 learned value function 分配分支预算。
  5. 建立中间表示的专门实验。 对比直接图生成、语义层次分解、材质层分解、频率分解与节点草图,控制相同 base model、token 预算和推理采样数。
建议的最小可发表问题固定 Agent,只优化 context representation在相同模型、相同生成器、相同渲染器和相同搜索预算下,仅改变 \(C\) 的构造策略。主要终点同时报告图有效率、单次成功率、best of \(k\) 曲线、视觉相似度、节点编辑距离和推理成本。这样可以把创新明确归因于 Context Optimization,而不是模型规模或采样次数。

复现清单

阶段 1,数据与表示
  • 获得许可明确的 SBS 材质库,并建立 5 个 PBR 输出的反向可达子图。
  • 排除 bitmap 与 SVG,过滤 128 节点以上图,展开自定义子图。
  • 实现 SBS 与 CompactSBS 双向转换,并做 round trip 图像一致性测试。
  • 为每个拓扑前缀渲染节点预览与完整节点图截图。
阶段 2,训练
  • Qwen2.5 VL 7B,最大序列长度 8,192。
  • Mixed 使用 140 × 140 节点预览,每图 25 patches;Graph 最多 6,144 视觉 tokens。
  • 5 epochs,AdamW,学习率 5e-5,batch 128。
  • 分别训练无条件与条件模型,条件样本前置 512 × 512 渲染图。
阶段 3,推理与搜索
  • temperature 0.8,top p 0.95。
  • 每生成一个节点就转译、执行、验证并更新 \(S_t\)。
  • 重复失败按 1、2、4、8 个节点的深度回溯。
  • 记录额外参数删除与类型转换插入。
阶段 4,评估
  • 无条件:KID、ROUGE L、NER,至少复现论文的每模型 100 个样本。
  • 条件:DreamSim、CLIP、Style、KID、ROUGE L、NER,使用 100 个 held out 样本。
  • DiffMat:需要自行确定并完整公开迭代数、优化器、学习率、参数范围、损失权重和停止条件。
  • 人评:同时报告单次与 best of 40,避免只展示高采样预算上限。

References

  1. Jonas Belouadi, Tamy Boubekeur, Adrien Kaiser. MultiMat: Multimodal Program Synthesis for Procedural Materials using Large Multimodal Models. arXiv:2509.22151v2, 2026.
  2. ICLR. MultiMat, ICLR 2026 Conference Proceedings. 2026.
  3. Adobe Research. MultiMat publication record. 2026.
  4. Liang Shi et al. MATch: Differentiable Material Graphs for Procedural Material Capture. ACM TOG, 2020.
  5. Beichen Li, Liang Shi, Wojciech Matusik. End to End Procedural Material Capture with Proxy Free Mixed Integer Optimization. ACM TOG, 2023.
  6. MIT CSAIL. DiffMat official repository. Accessed 2026.
  7. Shuai Bai et al. Qwen2.5 VL Technical Report. arXiv:2502.13923, 2025.
  8. Adobe. Substance 3D Assets. Accessed 2026.