表示
位置决定密度;位置+方向决定辐射颜色。无显式高分辨率 voxel grid
Representing Scenes as Neural Radiance Fields for View Synthesis|连续体积、位置编码与分层采样的完整精读
Ben Mildenhall · Pratul P. Srinivasan · Matthew Tancik · Jonathan T. Barron · Ravi Ramamoorthi · Ren Ng|ECCV 2020
NeRF 用 MLP 把连续空间位置与观察方向映射为密度和颜色,再用体渲染把沿射线的输出积成像素。训练不是生成一张独立图片,而是让同一个场景函数同时解释多张已知相机位置的照片。
固定对象:用户 PDF 的实际版本为 arXiv:2003.08934v2,2020-08-03,共 25 页,含 Appendix A–D。官方项目确认 ECCV 2020 Oral / Best Paper Honorable Mention。Ben Mildenhall、Pratul P. Srinivasan、Matthew Tancik 为共同第一作者,另有 Jonathan T. Barron、Ravi Ramamoorthi、Ren Ng。固定 PDF 未明确指定通讯作者,原笔记候选状态保留。
位置决定密度;位置+方向决定辐射颜色。无显式高分辨率 voxel grid
多视图 RGB、已知内外参和场景范围;真实场景利用 COLMAP 估计相机
每场景单独优化,V100 上约 1–2 天;原版渲染约 30 秒/帧

Figure 1:Drums 场景的 100 张半球采样输入图、优化场景函数和新视图。本文是原始 NeRF,不是无需相机标定的 NeRF--,也不是之后的加速/泛化模型。
最应记住的三点:PE 帮助拟合高频;视角条件表达非朗伯外观;coarse-to-fine 采样把计算集中到可见内容。它学习的是给定照明下的 radiance,不直接恢复可重光照 BRDF 或可执行材质图。
隐式形状网络已经能把坐标映射为占据或 SDF,但在仅 RGB 监督下,找到准确表面交点并优化复杂几何很困难。SRN 通过学习式 ray marching 选择单个终止位置,容易过平滑;离散 voxel 方法可微且适合遮挡,却在高分辨率下受空间成本限制。NeRF 以连续 MLP 存储场景,把单一硬表面交点改成沿射线的软密度积分。
“连续”指网络可以在任意坐标查询,不表示实际渲染无需离散采样,也不保证无限分辨率细节。表示容量受 MLP、训练视图、PE 带宽及采样率约束。每个场景优化独立权重,不是预训练一个能理解所有场景的通用模型。

Figure 2:从相机像素射线采样 5D 坐标、查询 MLP、体渲染、用 RGB 残差反传的闭环。渲染器在训练梯度路径内,是方法成立的关键,而不是结果出来后用于展示的外挂。
| 输入/变量 | 含义 | 不是什么 |
|---|---|---|
| \(\mathbf x\in\mathbb R^3\) | 场景内的连续采样位置 | 不是三角网格顶点列表 |
| \(\mathbf d\) | 观察射线单位方向,用三维向量表达两个角自由度 | 不是额外光照方向 |
| \(\sigma(\mathbf x)\) | 体密度/单位长度不透明度,非负 | 不是二值 occupancy、SDF 或材质金属度 |
| \(\mathbf c(\mathbf x,\mathbf d)\) | 该位置沿给定方向的 RGB 辐射外观 | 不是单独 albedo 或可重光照 BRDF |
| \(\Theta\) | 每场景 MLP 权重 | 不是所有场景共享的预训练 encoder |
| \(\mathbf r(t)=\mathbf o+t\mathbf d\) | 从相机发出的射线 | NDC 情况下 t 不再是原世界空间距离 |
整体写作 \(F_\Theta:(\mathbf x,\mathbf d)\mapsto(\mathbf c,\sigma)\)。为鼓励多视图一致性,密度只依赖位置;如果密度也随相机方向变化,网络更容易为不同照片各自放置不一致结构。颜色允许随方向变化,才能拟合高光等非朗伯现象。
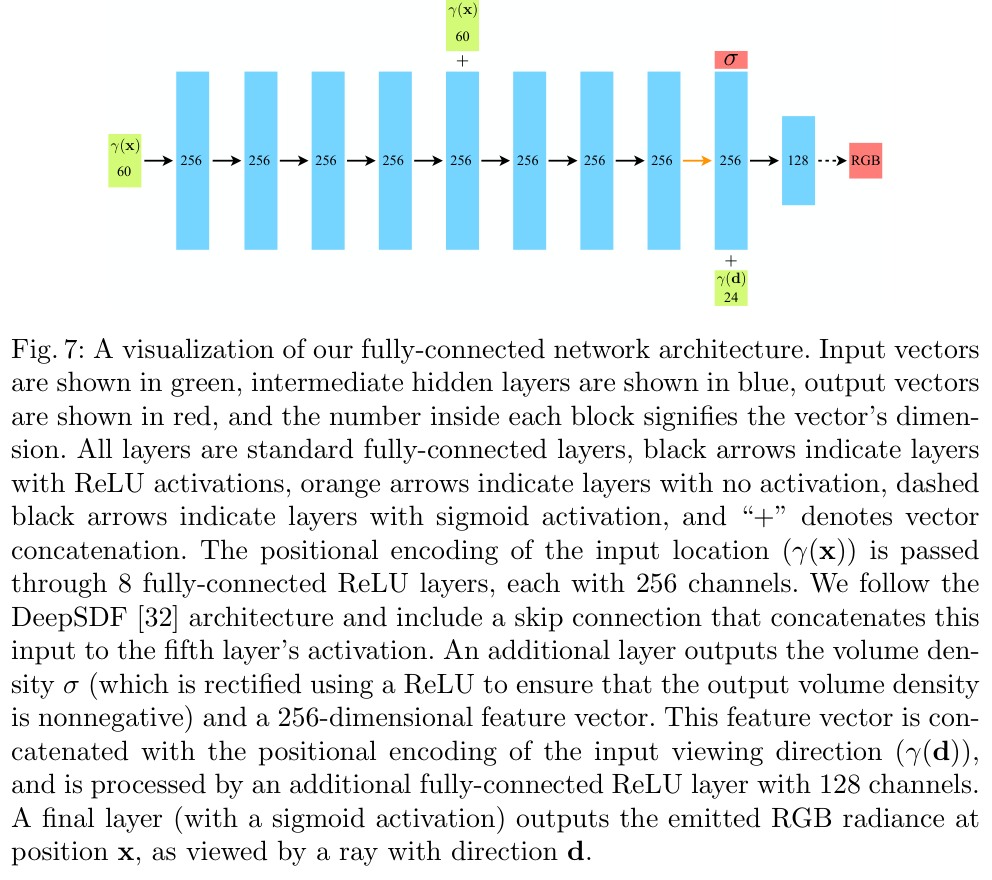
Figure 7(附录 A):位置 PE 经过 8 层、每层 256 通道 ReLU MLP;将位置编码 skip-concat 到第五层激活之后。位置分支输出未经激活的密度 logit 与 256 维 feature,密度在渲染时 ReLU。feature 与方向编码拼接后经过一层 128 通道 ReLU,再以 sigmoid 输出 RGB。图中“+”表示拼接而不是逐元素相加。
coarse 与 fine 是两套独立参数、同类结构的网络。最后只用 fine 的渲染作为最终图像,但 coarse 自身也需训练。原版不是共享一个网络后只改变采样点,也没有 CNN 特征提取器。

Figure 3:Ship 船体与水面固定 3D 点在不同相机观察方向下呈现不同高光。该能力能模仿反射外观,但并未显式建模光源、法线、能量守恒或折射路径。出现高光不代表已经分解了材质。
\(T(t)\) 是从近端到当前位置未被吸收的透射率;\(T(t)\sigma(t)\) 是在该位置终止的概率密度形式。前方高密度会遮挡后面颜色,因此不仅某个点的 RGB,前方所有密度都会影响像素。式 1 没有独立表面交点求解,也没有显式光传输多次散射。
把区间分成 N 个 bins,每段随机取一点。训练期扰动让不同迭代访问连续位置,而不是永远只看固定采样格点。测试期官方实现关闭扰动,保证给定相机与模型的渲染稳定;“训练随机”不等于“每次测试必须随机抖动”。
\(\delta_i=t_{i+1}-t_i\),\(\alpha_i=1-\exp(-\sigma_i\delta_i)\),所以权重 \(w_i=T_i\alpha_i\)。这就是前向 alpha compositing:越靠后越被前面衰减。若射线方向未单位化,代码还把 \(\delta_i\) 乘 \(\|\mathbf d\|\),转换为该坐标空间中的实际段长。
Our Interpretation:密度与间距必须一起决定 alpha。把 \(\sigma\) 直接当 [0,1] alpha,会导致改变采样数就改变物体不透明度。权重之和通常不大于 1,剩余透射率属于背景;白背景渲染要加 \((1-\sum_iw_i)\mathbf1\),不是把空区域随意夹成白色。
RGB sigmoid、密度 ReLU 与累积乘积形成可微链。空空间也参与梯度,模型可从多视图约束中把密度逐渐集中到合理位置,但仍存在形状/外观歧义;照片重建误差小不等于几何真值准确。
对 x 的三个分量分别编码,L=10;对单位方向 d 的三个分量分别编码,L=4。按论文公式纯正余弦维度分别为 60、24。这里的 PE 提升 MLP 访问高频变化的便利性,不是给无序 Transformer token 标位置。频率太高也不保证更好:观测图像与样本密度限制了可恢复信息。
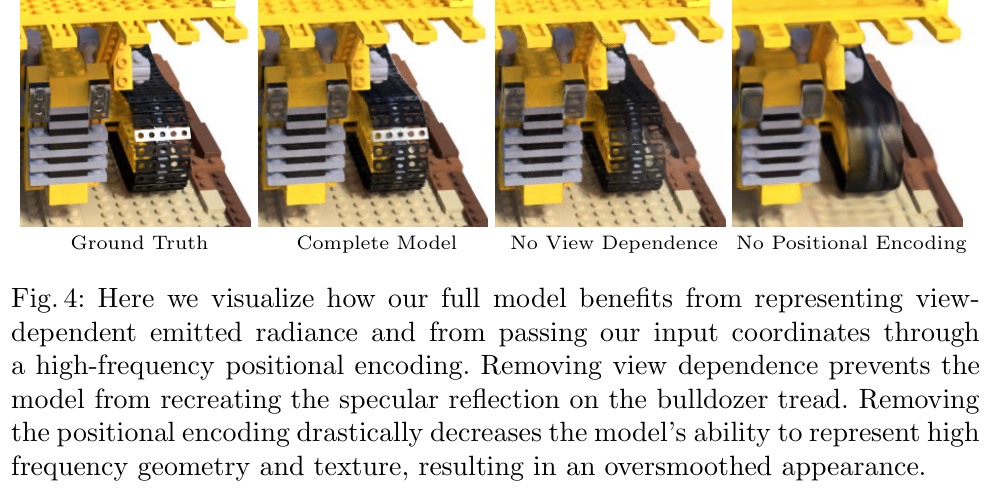
Figure 4:移除方向条件会丢失履带反光,移除 PE 会让几何与纹理整体过平滑。注意这是消融示例,定量判断要看全部场景表 2 与表 6。
它类似 importance sampling,但论文明确说最终仍是对完整域的非均匀积分离散,不是每个样本独立的蒙特卡洛全积分估计。因此不要额外把每个颜色权重除以采样 PDF,那会改变作者的渲染公式。
coarse 的采样依据不只是密度:权重含透射率,被遮挡区域即使密度高也不一定获更多 fine 点。对空空间、遮挡部分减少查询能提升效率,但并没有完全跳过所有空域;原版成本仍很大。
两个分支都监督真实像素。coarse loss 让它产生有意义的采样分布;fine loss 优化最终画面。本文不使用深度 ground truth、法线损失、LPIPS 训练损失或预训练生成先验。LPIPS 是评测指标,不要与训练目标混淆。
| 配置 | 论文报告 | 说明 |
|---|---|---|
| 每次 batch | 4096 rays | 不是 4096 张图;默认从训练视图像素采样 |
| 采样数 | coarse 64;fine 64+128 | 两网络共 256 点/射线 |
| Optimizer | Adam,β1=0.9、β2=0.999、ε=10⁻⁷ | 学习率 5×10⁻⁴ 指数衰减到 5×10⁻⁵ |
| 训练长度 | 每场景约 100–300K iterations | 单 V100,约 1–2 天,非固定所有场景同一终止步 |
| 真实图正则 | density logit 加均值0、标准差1高斯噪声 | 加在 ReLU 前;测试关闭 |
| 场景范围 | 合成场景缩放到中心立方体边长2 | 真实 forward-facing 用 NDC 有界化近处至无穷远 |
| 存储 | 网络权重约 5 MB | 不等于训练显存;不包括照片、优化器及渲染缓存 |
| 测试成本 | 约 30 秒/帧,V100 | 800×800 约 1.64 亿点查询;不是实时渲染 |
已读 run_nerf.py 与 helpers。编码器 include_input=True,会把原始坐标一起拼接,实际默认 63/27 维;代码 sin/cos 使用 \(2^kp\),没有论文公式显式 π。复现应保留实现的坐标尺度与编码配对,不能混搭后仍宣称严格同配置。
层次采样使用 midpoint bins 与去首尾的 coarse weights,加 10⁻⁵ 防止零 PDF;对新采样位置 stop_gradient。因此 fine loss 不通过选点反传给 coarse,coarse 必须靠自己的 loss 学习。渲染末段距离用 10¹⁰ 近似无限,累积乘积加 10⁻¹⁰ 稳定项,白背景用剩余 opacity 合成。
官方 paper_configs 的 Blender/Lego 设置为 1024 rays、单图 no_batching、500K iterations 注释;与正文“4096、100–300K”并不完全一致。LLFF/Fern paper config 为4096 rays、200K、factor=4、64+128。仓库根目录 demo config_fern.txt 则是1024 rays、64+64、factor=8,不能拿 demo 设置直接声称复现论文主表。代码训练循环上限100万也不等于所有报告结果都训100万。
源码注释提到旧补充曾写方向分支4层、实际实验为1层;当前固定 v2 Figure 7 已画成1层,因此应以具体版本核对,不能把旧勘误重复写成 v2 仍存在的错误。本次只阅读与静态核查,未训练模型。
真实 forward-facing 场景包含远背景,直接按米均匀采样会浪费点。NDC 把视锥映射到有界空间,深度变为近似视差参数。以下为避免符号混淆,用 \(r_f,t_f\) 表示投影近平面的右/上边界,用 \(\tau\) 表示沿射线参数;原附录同时使用 r,t 表示不同概念。
相机朝 −z,n/f 是近/远裁剪距离。齐次投影先乘矩阵,再除以第四坐标 −z:
排印核查:固定 PDF 与 arXiv HTML 的式 8 第三分量写有重复负号,与式 7 的矩阵乘法不符。此处给出按式 7 推导的标准化结果,明确修正而非伪称原式逐字无误;式 9 及后续结果与这个修正一致。
令 \(a_x=-n/r_f,\ a_y=-n/t_f,\ a_z=(f+n)/(f-n),\ b_z=2fn/(f-n)\),寻找新射线满足:
取 τ=0 对应 τ′=0。把原点项减去,原式 12–14 是同一代数化简的三个阶段:
因此 τ→∞ 时 τ′→1。投影保持射线是直线,但射线参数不保持距离;一般透视变换也不能理解为保持所有世界空间平行关系。注意 d_z、o_z 的非零条件。
在像素焦距 \(f_{\mathrm{cam}}\)、图像宽高 W/H 下,以及远平面 f→∞:
实现先把原点移到 z=−n 近平面:\(\tau_n=-(n+o_z)/d_z\),\(\mathbf o_n=\mathbf o+\tau_n\mathbf d\),再做上述转换。之后在 [0,1] 线性采 NDC 参数对应原空间的视差采样。用于颜色的 viewing direction 应保留原世界相机射线的归一化方向,而不是误用 NDC 方向;官方代码先计算 viewdirs,再转 NDC。
这一技巧针对 forward-facing 捕获。它不是任意360°大场景都可直接套用的通用收缩映射;原代码也对非 LLFF 数据默认关闭 NDC。
| 数据 | 场景与视图 | 分辨率 | 相机/范围 |
|---|---|---|---|
| Diffuse Synthetic 360° | DeepVoxels 4 个简单朗伯对象;479 输入、1000 测试/场景 | 512×512 | 半球相机;合成真值 |
| Realistic Synthetic 360° | 新建 8 场景;每场景100输入、200测试;6个半球、2个整球 | 800×800 | Blender Cycles path tracing;几何/材料更复杂 |
| Real Forward-Facing | 8 个手机场景(5个沿用LLFF、3个新增);每场景20–62图,留出1/8测试 | 正文1008×756 | COLMAP 相机与边界;NDC |
合成八场景为 Chair、Drums、Ficus、Hotdog、Lego、Materials、Mic、Ship。真实八场景为 Room、Fern、Leaves、Fortress、Orchids、Flower、T-Rex、Horns。这里的“稀疏视图”是相对于连续光场采样,不等于只需一两张图即可可靠重建。
| 基线 | 表示/训练方式 | 公平性边界 |
|---|---|---|
| NV | 每场景 CNN,128³ RGBα voxel +32³ warp grid | 适合有独立背景的有界物体;无法评测本文真实forward-facing,因此主表留空 |
| SRN | 每场景隐式feature/颜色,RNN ray marching | 显存限制使评测分辨率更低,不能视为完全同分辨率 |
| LLFF | 多场景预训练3D CNN,为每输入视图预测MPI并融合 | 与每场景从零优化不同;设计目标是密集forward-facing,合成大视差对它不利 |
Appendix B 细节:SRN 用512×512合成图、504×376真实图;其他方法在较高分辨率评测。附录写其他真实图为1008×752,与正文1008×756不一致,本页保留该冲突。SRN即便4张V100仍受显存限制。因此必须记录分辨率、resize、mask和指标实现,不能只抄主表数字。
PSNR/SSIM 越高越好,LPIPS 越低越好。它们测新视图图像质量,不直接提供表面误差、材质参数真实性或可编辑性。论文未报告统一多seed方差或置信区间。
| Diffuse Synthetic 360° [41] | Realistic Synthetic 360° | Real Forward-Facing [28] | |||||||
| Method | PSNR↑ | SSIM↑ | LPIPS↓ | PSNR↑ | SSIM↑ | LPIPS↓ | PSNR↑ | SSIM↑ | LPIPS↓ |
| SRN [42] | 33.20 | 0.963 | 0.073 | 22.26 | 0.846 | 0.170 | 22.84 | 0.668 | 0.378 |
| NV [24] | 29.62 | 0.929 | 0.099 | 26.05 | 0.893 | 0.160 | - | - | - |
| LLFF [28] | 34.38 | 0.985 | 0.048 | 24.88 | 0.911 | 0.114 | 24.13 | 0.798 | 0.212 |
| Ours | 40.15 | 0.991 | 0.023 | 31.01 | 0.947 | 0.081 | 26.50 | 0.811 | 0.250 |
完整重建固定v2 Table 1全部方法行与指标列。同版本原表
主表的合成场景优势清晰:Realistic Synthetic PSNR 31.01,相比 NV 26.05 提高4.96 dB,相比 LLFF 24.88 提高6.13 dB。真实场景 PSNR 26.50 比 LLFF 24.13 高2.37 dB;但真实 LPIPS 为0.250,差于LLFF的0.212。不能复述为所有数据、所有指标都最佳。
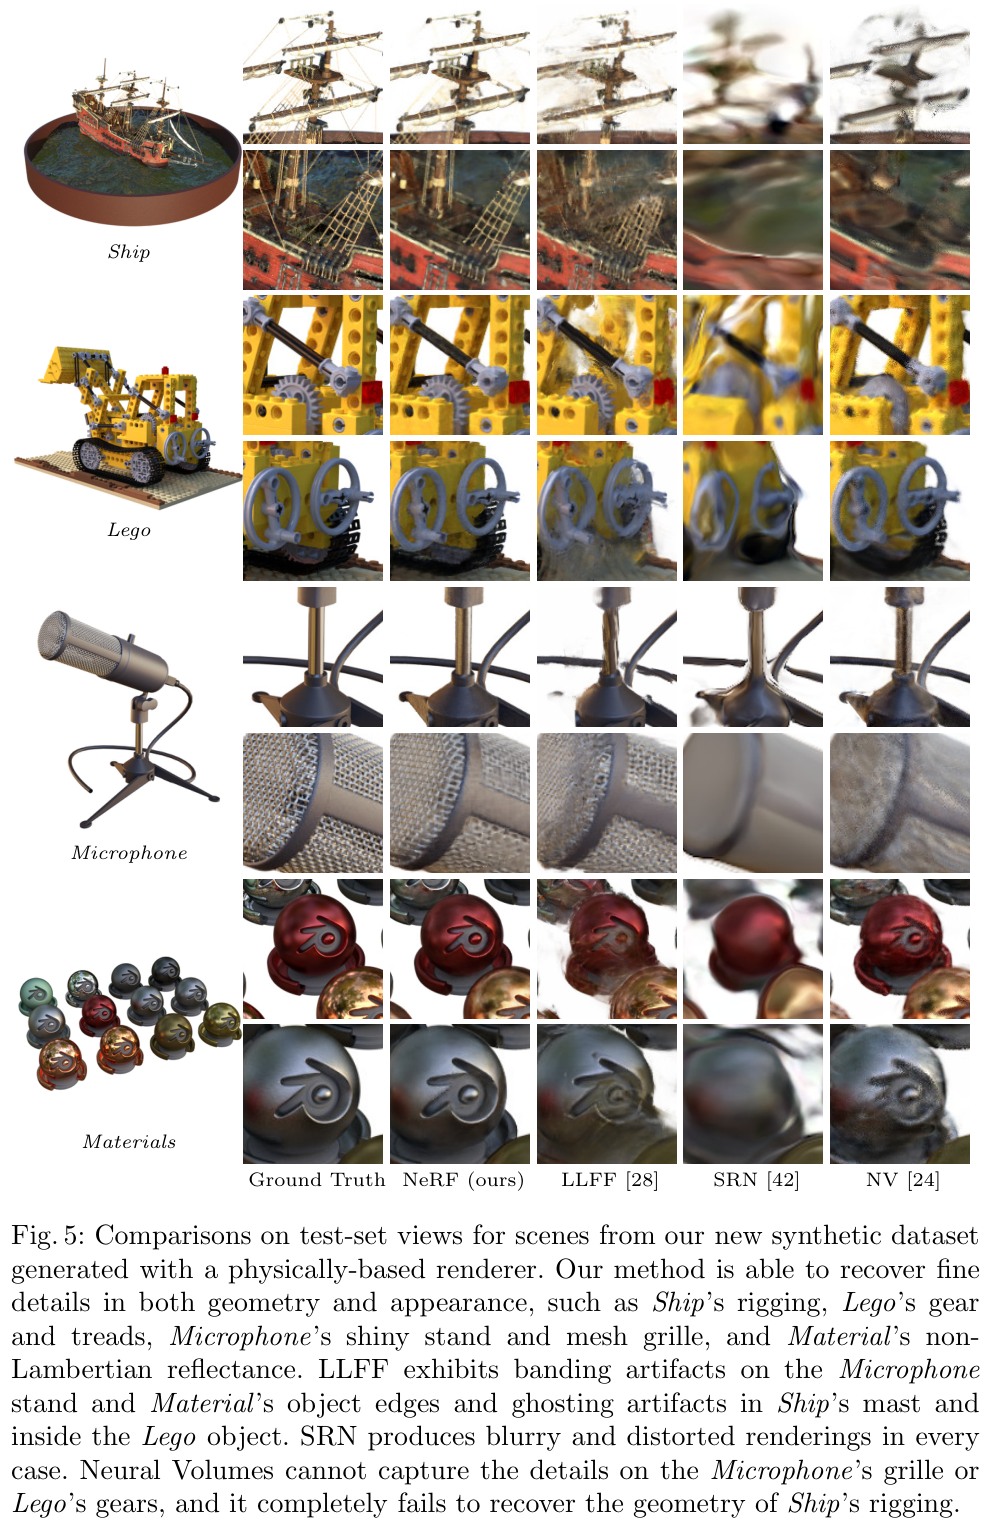
Figure 5:完整比较 Ship索具、Lego齿轮/履带、Mic网格与高光支架、Materials复杂外观。NeRF呈现更细结构,LLFF可能出现重影/条带,SRN偏平滑,NV受离散容量限制。定性图支持细节能力,但不应替代逐场景指标。
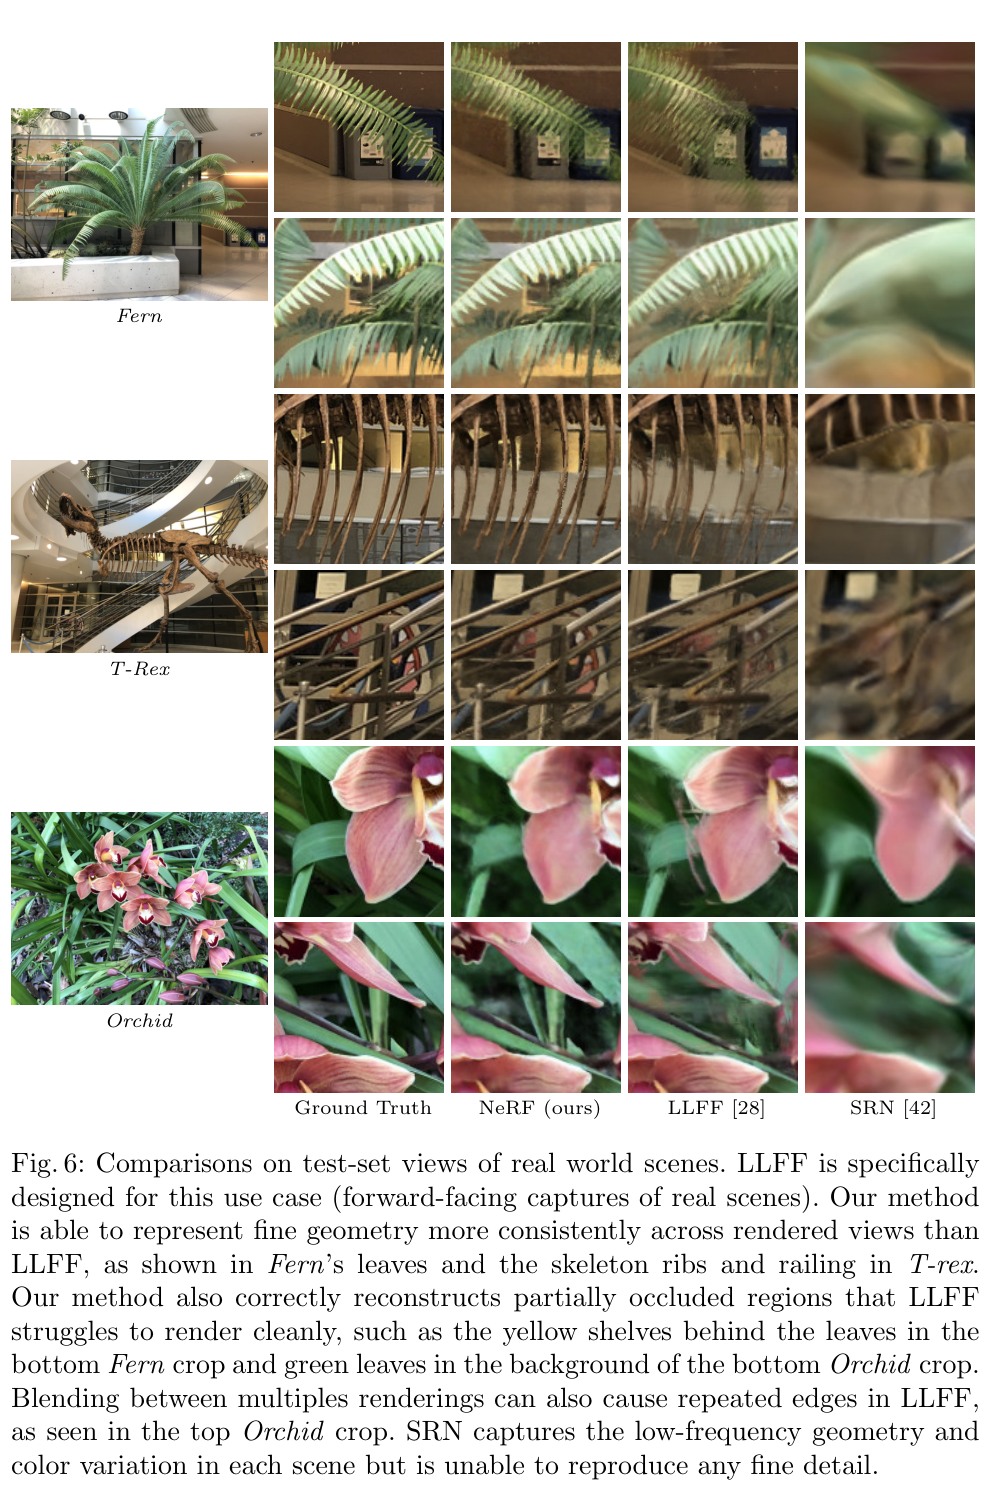
Figure 6:真实Fern叶片与后方遮挡区域、T-Rex骨架与栏杆、Orchids重复边缘的比较。作者强调跨视角一致性,但本页未播放视频,不能声称已经独立验证所有动态路径上的时序质量。
| PSNR↑ | SSIM↑ | LPIPS↓ | ||||||||||
| Chair | Pedestal | Cube | Vase | Chair | Pedestal | Cube | Vase | Chair | Pedestal | Cube | Vase | |
| DeepVoxels [41] | 33.45 | 32.35 | 28.42 | 27.99 | 0.99 | 0.97 | 0.97 | 0.96 | - | - | - | - |
| SRN [42] | 36.67 | 35.91 | 28.74 | 31.46 | 0.982 | 0.957 | 0.944 | 0.969 | 0.093 | 0.081 | 0.074 | 0.044 |
| NV [24] | 35.15 | 36.47 | 26.48 | 20.39 | 0.980 | 0.963 | 0.916 | 0.857 | 0.096 | 0.069 | 0.113 | 0.117 |
| LLFF [28] | 36.11 | 35.87 | 32.58 | 32.97 | 0.992 | 0.983 | 0.983 | 0.983 | 0.051 | 0.039 | 0.064 | 0.039 |
| Ours | 42.65 | 41.44 | 39.19 | 37.32 | 0.991 | 0.986 | 0.996 | 0.992 | 0.047 | 0.024 | 0.006 | 0.017 |
完整重建固定v2 Table 3全部方法行与指标列。同版本原表
| PSNR↑ | ||||||||
| Chair | Drums | Ficus | Hotdog | Lego | Materials | Mic | Ship | |
| SRN [42] | 26.96 | 17.18 | 20.73 | 26.81 | 20.85 | 18.09 | 26.85 | 20.60 |
| NV [24] | 28.33 | 22.58 | 24.79 | 30.71 | 26.08 | 24.22 | 27.78 | 23.93 |
| LLFF [28] | 28.72 | 21.13 | 21.79 | 31.41 | 24.54 | 20.72 | 27.48 | 23.22 |
| Ours | 33.00 | 25.01 | 30.13 | 36.18 | 32.54 | 29.62 | 32.91 | 28.65 |
| SSIM↑ | ||||||||
| Chair | Drums | Ficus | Hotdog | Lego | Materials | Mic | Ship | |
| SRN [42] | 0.910 | 0.766 | 0.849 | 0.923 | 0.809 | 0.808 | 0.947 | 0.757 |
| NV [24] | 0.916 | 0.873 | 0.910 | 0.944 | 0.880 | 0.888 | 0.946 | 0.784 |
| LLFF [28] | 0.948 | 0.890 | 0.896 | 0.965 | 0.911 | 0.890 | 0.964 | 0.823 |
| Ours | 0.967 | 0.925 | 0.964 | 0.974 | 0.961 | 0.949 | 0.980 | 0.856 |
| LPIPS↓ | ||||||||
| Chair | Drums | Ficus | Hotdog | Lego | Materials | Mic | Ship | |
| SRN [42] | 0.106 | 0.267 | 0.149 | 0.100 | 0.200 | 0.174 | 0.063 | 0.299 |
| NV [24] | 0.109 | 0.214 | 0.162 | 0.109 | 0.175 | 0.130 | 0.107 | 0.276 |
| LLFF [28] | 0.064 | 0.126 | 0.130 | 0.061 | 0.110 | 0.117 | 0.084 | 0.218 |
| Ours | 0.046 | 0.091 | 0.044 | 0.121 | 0.050 | 0.063 | 0.028 | 0.206 |
完整重建固定v2 Table 4全部方法行与指标列。同版本原表
| PSNR↑ | ||||||||
| Room | Fern | Leaves | Fortress | Orchids | Flower | T-Rex | Horns | |
| SRN [42] | 27.29 | 21.37 | 18.24 | 26.63 | 17.37 | 24.63 | 22.87 | 24.33 |
| LLFF [28] | 28.42 | 22.85 | 19.52 | 29.40 | 18.52 | 25.46 | 24.15 | 24.70 |
| Ours | 32.70 | 25.17 | 20.92 | 31.16 | 20.36 | 27.40 | 26.80 | 27.45 |
| SSIM↑ | ||||||||
| Room | Fern | Leaves | Fortress | Orchids | Flower | T-Rex | Horns | |
| SRN [42] | 0.883 | 0.611 | 0.520 | 0.641 | 0.449 | 0.738 | 0.761 | 0.742 |
| LLFF [28] | 0.932 | 0.753 | 0.697 | 0.872 | 0.588 | 0.844 | 0.857 | 0.840 |
| Ours | 0.948 | 0.792 | 0.690 | 0.881 | 0.641 | 0.827 | 0.880 | 0.828 |
| LPIPS↓ | ||||||||
| Room | Fern | Leaves | Fortress | Orchids | Flower | T-Rex | Horns | |
| SRN [42] | 0.240 | 0.459 | 0.440 | 0.453 | 0.467 | 0.288 | 0.298 | 0.376 |
| LLFF [28] | 0.155 | 0.247 | 0.216 | 0.173 | 0.313 | 0.174 | 0.222 | 0.193 |
| Ours | 0.178 | 0.280 | 0.316 | 0.171 | 0.321 | 0.219 | 0.249 | 0.268 |
完整重建固定v2 Table 5全部方法行与指标列。同版本原表
逐场景的限制更具体:真实数据中 NeRF 的 PSNR 在八场景均高于LLFF,但SSIM在Leaves、Flower、Horns等并不更高;LPIPS仅Fortress略好,其他七场景LLFF更好。合成Hotdog的LPIPS,NeRF为0.121,LLFF为0.061,说明合成均值领先也不等于每个scene/metric都领先。
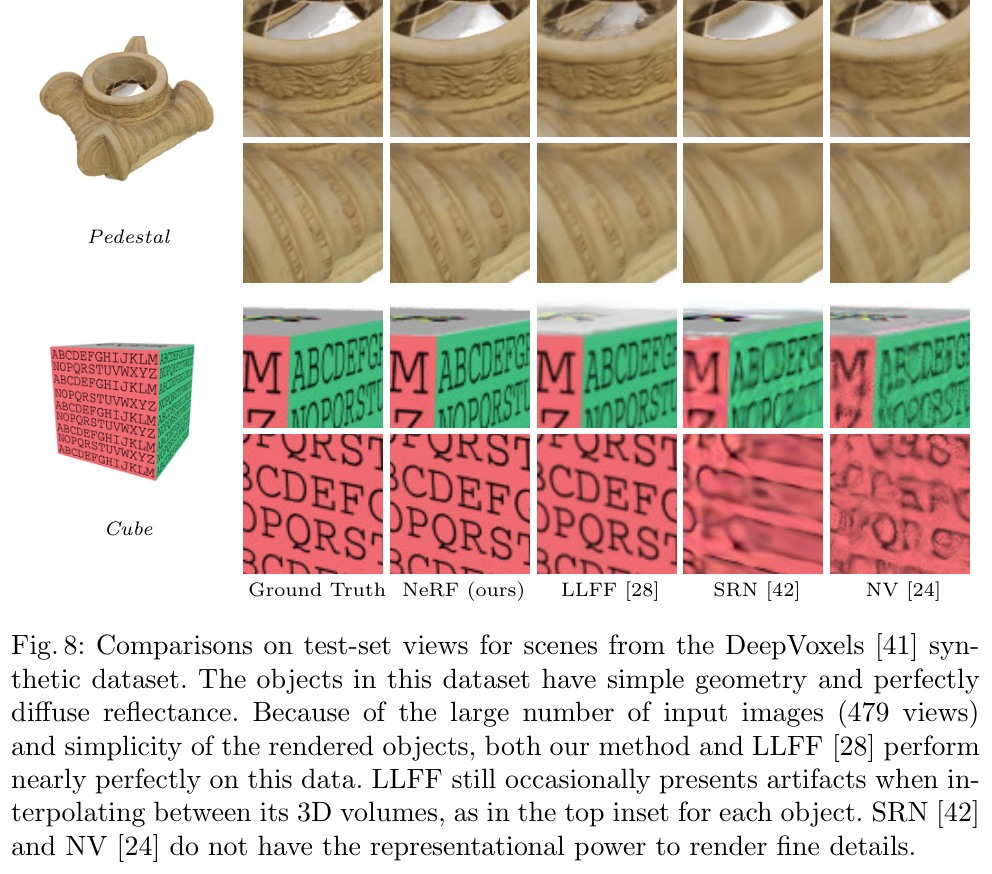
Figure 8:DeepVoxels 简单朗伯对象的Pedestal/Cube对比。479视图与简单几何使NeRF和LLFF接近完美,不能用此结果代表困难少视图真实场景。Table 3的DeepVoxels方法数值来自其原论文,LPIPS缺失、SSIM仅两位有效数字,保持缺项而不补造。
时间与空间:单场景学习方法至少约12小时,而LLFF可在10分钟内处理小输入集;LLFF每图MPI使某合成场景存储超过15GB,NeRF权重约5MB,作者称约3000倍压缩。不同方法的运行阶段与缓存范围不一致,这个比值不是整体系统显存或训练数据压缩率。
| Input | 输入图数 | L | (N_c,N_f) | PSNR↑ | SSIM↑ | LPIPS↓ | ||
| 1) | No PE, VD, H | xyz | 100 | - | (256, - ) | 26.67 | 0.906 | 0.136 |
| 2) | No Pos. Encoding | xyzθφ | 100 | - | (64, 128) | 28.77 | 0.924 | 0.108 |
| 3) | No View Dependence | xyz | 100 | 10 | (64, 128) | 27.66 | 0.925 | 0.117 |
| 4) | No Hierarchical | xyzθφ | 100 | 10 | (256, - ) | 30.06 | 0.938 | 0.109 |
| 5) | Far Fewer Images | xyzθφ | 25 | 10 | (64, 128) | 27.78 | 0.925 | 0.107 |
| 6) | Fewer Images | xyzθφ | 50 | 10 | (64, 128) | 29.79 | 0.940 | 0.096 |
| 7) | Fewer Frequencies | xyzθφ | 100 | 5 | (64, 128) | 30.59 | 0.944 | 0.088 |
| 8) | More Frequencies | xyzθφ | 100 | 15 | (64, 128) | 30.81 | 0.946 | 0.096 |
| 9) | Complete Model | xyzθφ | 100 | 10 | (64, 128) | 31.01 | 0.947 | 0.081 |
完整重建固定v2 Table 2全部方法行与指标列。同版本原表
移除PE下降2.24 dB;移除view dependence下降3.35 dB;移除hierarchical下降0.95 dB。重要的是无层次版本用单网络256点,而完整模型64 coarse+192 fine也为256次查询,总点查询预算相近,消融比单纯减少样本数更有解释力。
25张输入PSNR27.78、50张29.79,均低于100张31.01。25张平均指标仍优于主表中用100张的几个基线,但不能推为任意25视角分布或任意场景都足够。L从10增至15没有提升均值,降低到5也仍有较强表现;高频带宽应与观测分辨率、采样和优化一起选。
| PSNR↑ | |||||||||
| Chair | Drums | Ficus | Hotdog | Lego | Materials | Mic | Ship | ||
| 1) | No PE, VD, H | 28.44 | 23.11 | 25.17 | 32.24 | 26.38 | 24.69 | 28.16 | 25.12 |
| 2) | No Pos. Encoding | 30.33 | 24.54 | 29.32 | 33.16 | 27.75 | 27.79 | 30.76 | 26.55 |
| 3) | No View Dependence | 30.06 | 23.41 | 25.91 | 32.65 | 29.93 | 24.96 | 28.62 | 25.72 |
| 4) | No Hierarchical | 31.32 | 24.55 | 29.25 | 35.24 | 31.42 | 29.22 | 31.74 | 27.73 |
| 5) | Far Fewer Images | 30.92 | 22.62 | 24.39 | 32.77 | 27.97 | 26.55 | 30.47 | 26.57 |
| 6) | Fewer Images | 32.19 | 23.70 | 27.45 | 34.91 | 31.53 | 28.54 | 32.33 | 27.67 |
| 7) | Fewer Frequencies | 32.19 | 25.29 | 30.73 | 36.06 | 30.77 | 29.77 | 31.66 | 28.26 |
| 8) | More Frequencies | 32.87 | 24.65 | 29.92 | 35.78 | 32.50 | 29.54 | 32.86 | 28.34 |
| 9) | Complete Model | 33.00 | 25.01 | 30.13 | 36.18 | 32.54 | 29.62 | 32.91 | 28.65 |
| SSIM↑ | |||||||||
| Chair | Drums | Ficus | Hotdog | Lego | Materials | Mic | Ship | ||
| 1) | No PE, VD, H | 0.919 | 0.896 | 0.926 | 0.955 | 0.882 | 0.905 | 0.955 | 0.810 |
| 2) | No Pos. Encoding | 0.938 | 0.918 | 0.953 | 0.956 | 0.903 | 0.933 | 0.968 | 0.824 |
| 3) | No View Dependence | 0.948 | 0.906 | 0.938 | 0.961 | 0.947 | 0.912 | 0.962 | 0.828 |
| 4) | No Hierarchical | 0.951 | 0.914 | 0.956 | 0.969 | 0.951 | 0.944 | 0.973 | 0.844 |
| 5) | Far Fewer Images | 0.956 | 0.895 | 0.922 | 0.966 | 0.930 | 0.925 | 0.972 | 0.832 |
| 6) | Fewer Images | 0.963 | 0.911 | 0.948 | 0.971 | 0.957 | 0.941 | 0.979 | 0.847 |
| 7) | Fewer Frequencies | 0.959 | 0.928 | 0.965 | 0.972 | 0.947 | 0.952 | 0.973 | 0.853 |
| 8) | More Frequencies | 0.967 | 0.921 | 0.962 | 0.973 | 0.961 | 0.948 | 0.980 | 0.853 |
| 9) | Complete Model | 0.967 | 0.925 | 0.964 | 0.974 | 0.961 | 0.949 | 0.980 | 0.856 |
| LPIPS↓ | |||||||||
| Chair | Drums | Ficus | Hotdog | Lego | Materials | Mic | Ship | ||
| 1) | No PE, VD, H | 0.095 | 0.168 | 0.084 | 0.104 | 0.178 | 0.111 | 0.084 | 0.261 |
| 2) | No Pos. Encoding | 0.076 | 0.104 | 0.050 | 0.124 | 0.128 | 0.079 | 0.041 | 0.261 |
| 3) | No View Dependence | 0.075 | 0.148 | 0.113 | 0.112 | 0.088 | 0.102 | 0.073 | 0.220 |
| 4) | No Hierarchical | 0.065 | 0.177 | 0.056 | 0.130 | 0.072 | 0.080 | 0.039 | 0.249 |
| 5) | Far Fewer Images | 0.058 | 0.173 | 0.082 | 0.123 | 0.081 | 0.079 | 0.035 | 0.229 |
| 6) | Fewer Images | 0.051 | 0.166 | 0.057 | 0.121 | 0.055 | 0.068 | 0.029 | 0.223 |
| 7) | Fewer Frequencies | 0.055 | 0.143 | 0.038 | 0.087 | 0.071 | 0.060 | 0.029 | 0.219 |
| 8) | More Frequencies | 0.047 | 0.158 | 0.045 | 0.116 | 0.050 | 0.064 | 0.027 | 0.261 |
| 9) | Complete Model | 0.046 | 0.091 | 0.044 | 0.121 | 0.050 | 0.063 | 0.028 | 0.206 |
完整重建固定v2 Table 6全部方法行与指标列。同版本原表
逐场景消融显示“完整配置”不总是每个单格最优,例如较少频率在部分scene/metric更好。单项删除通常支持组件价值,但结果还受优化噪声、场景材质和观测布局影响。PE、VD、H的作用是互补的,不能只按一个PSNR差把所有贡献线性相加。
固定训练预算、样本数和相机分布,联合报告图像质量、表面误差和端到端速度;对相机扰动、视角稀疏、遮挡比例和曝光变化做受控测试。检查白背景合成/测试裁切是否影响指标,报告完整相机轨迹而非挑选视图。把“渲染正确”和“可物理编辑”分开验收。
Research Extension,非NeRF既有能力:NeRF的核心可迁移思想是“让真实渲染过程参与梯度与验证”,不是把密度场直接当作材质图。它从多视图中压缩了几何和外观,但没有输出SBS/SBSAR、shader nodes、albedo/normal/roughness/metallic贴图。
先从多视图恢复目标外观/几何代理,再固定几何与灯光,优化程序图参数 \(\phi\),使真实renderer的多视角结果接近目标。需要明确目标NeRF可能含烘焙光照;直接把其RGB监督给base color会把高光错误固化。
这是本页提出的目标:G为有类型的材质程序图,\(\mathcal G\)为几何,\(\ell_k,c_k\)为灯光/相机,合法性项限制节点、参数范围与连接类型。先在固定G上优化参数,再考虑拓扑搜索,可减少表示歧义。
coarse-to-fine的启示是根据可见贡献分配计算。PMG可先低采样渲染,估计哪些区域的残差与可见性对材质参数最敏感,再增加那些像素/光照的评估预算。必须保留探索采样,避免只关注当前高误差区域而漏掉新出现的材质缺陷;评测要使用固定全图预算,不能只看被优化区域。
PE能帮助拟合高频材质细节,但神经纹理函数本身缺少艺术家熟悉的节点语义。可把程序生成的多尺度基础纹理与小型神经残差结合,对残差频率/幅度约束并检查贴图无缝性、多分辨率抗混叠、物理通道范围。比较纯程序、纯神经场与混合表示的外观、编辑稳定性、执行成本,而非只比较图像误差。
| 需验证的能力 | 证据 | 不能用来替代的指标 |
|---|---|---|
| 真实材质可编辑 | 修改粗糙度/频率后,在多光照下变化符合预期 | 单一视角PSNR |
| 程序有效 | 图编译成功、参数合法、无循环依赖 | NeRF可成功渲染 |
| 泛化 | 未见相机、光照、几何的渲染表现 | 训练相机重建 |
| 效率 | 总渲染调用、训练与推理时间、显存/存储分开报告 | 仅5MB权重 |
覆盖:Figure1–8、Table1–6(含全部逐场景和消融行列)、主文公式1–6与附录NDC公式7–26均完整整理。原图复用/裁切明确来源;本页新增分析与PMG目标不是原作者实验。视频未播放,不宣称独立视频验收。
状态:内容与静态检查完成;HTML小于20MB。浏览器MathJax、图片加载、导航、1440/760/390像素布局验收依用户要求延期。新增Markdown及原笔记字节前缀保留合并候选仅供下载,未写回仓库或发布。