基底 mesh 承载坐标系,密度场承载中尺度结构,Phong+SH 处理外观
01 · 阅读结论与版本边界
NeRF-Texture 把真实物体表面的中尺度几何与外观做成可重组的神经纹理。它先从多视角照片重建一个粗基底,再把剩余的凸起、叶片、织物孔隙和视角相关反射编码到基底表面的潜特征中。生成阶段在潜空间做 exemplar-based patch matching 与 quilting,扩大纹理后映射到带 UV 的新形状。理解本文的关键,是区分“从照片拟合一个纹理场”和“重排已拟合的纹理块”两个阶段。
128×128 implicit patches;聚类约束改善潜特征的匹配度量
原 Table 2 的平均 SIFID;相对同协议二维纹理降低约 42.9%
Paper Verified 本文是 SIGGRAPH 2023 的 NeRF-Texture: Texture Synthesis with Neural Radiance Fields,DOI 为 10.1145/3588432.3591484,固定输入 PDF 共 10 页。第一作者 Yi-Hua Huang;Lin Gao 在第 1 页脚注被明确标为通讯作者。作者次序为 Yi-Hua Huang、Yan-Pei Cao、Yu-Kun Lai、Ying Shan、Lin Gao。第一作者的首列机构属于 Chinese Academy of Sciences,另列 University of Chinese Academy of Sciences。
版本隔离:官方网页和仓库现同时覆盖 TPAMI 2024 的 NeRF-Texture: Synthesizing Neural Radiance Field Textures。仓库 2024-04-09 的最新提交增加任意流形上的直接合成。下文只把固定 2023 PDF 的内容当作本文实验;代码以 2023-08-06 提交 14e2bcd6676026216ee8295212bb4205cdab9c18 为主要复核点,同时对照当前提交 1246ec5c8c18beb10657f8fd3691f6c0de63c16c。八个关键实现文件在两提交间逐字节相同。
资料缺口:主文明确提到 supplementary 中的颜色约束合成细节。作者项目链接的 PDF 仍是 10 页主文,未包含独立附录;ACM 主文及补充入口返回 HTTP 403,官方网页源码和仓库树未发现单独补充文件。因此本文完整覆盖可得主文、全部 13 幅主图、两张定量表与官方实现,但不能声称已读到不可得的独立 supplement,也不补造其中的设置。
固定论文 p.1–2 · 官方项目 · 官方 README · 版本历史
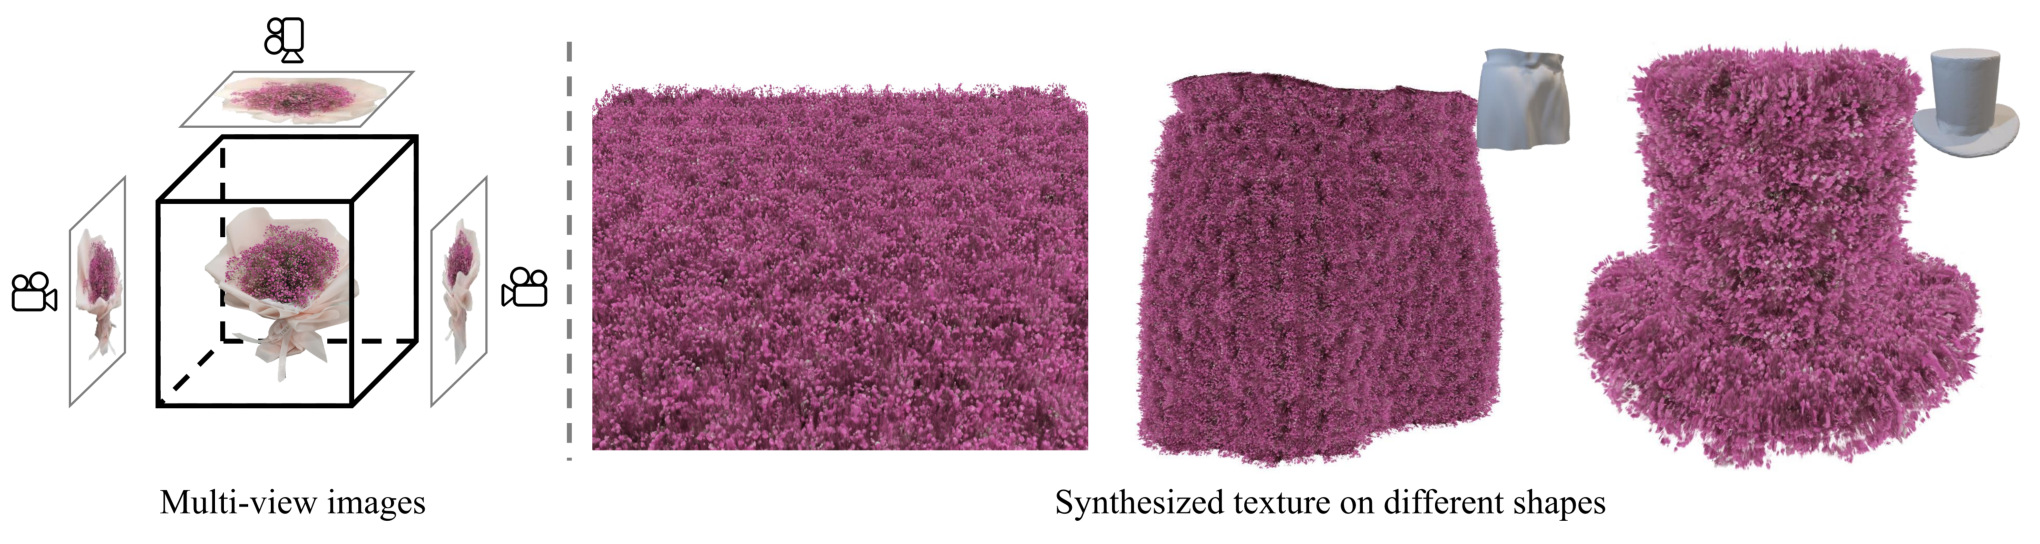
02 · 为什么需要神经纹理
二维颜色贴图能在正视角模仿一簇叶子的颜色,却不能在斜视角正确表现叶片间的遮挡、厚度和轮廓。法线图能改变局部反射方向,但通常没有真实体积遮挡;位移图依赖单值表面,难以统一表达不封闭、相互穿插的草叶和织物。直接用高精度 mesh 表达所有细节又会增加建模、存储与渲染负担。本文把这种介于宏观形状和微观 BRDF 之间的结构称为 meso-structure。
普通 NeRF 可以拟合输入场景,但坐标与外观绑定在原场景中,不能直接把榴莲刺搬到香蕉表面。NeuTex 的二维参数化适合相对平滑的表面;NeuMesh 的顶点特征贴近精细表面,编辑方便,却没有把中尺度结构作为可重复利用的纹理抽出来。NeRF-Tex(Baatz et al., 2022)则以已知、紧包围的平面纹理单元训练,主要把单元放到目标表面,并未解决本文的真实采集与连续纹理块合成问题。不要将 NeRF-Tex 和 NeRF-Texture 当成同一论文。
Our Interpretation 作者的核心假设是:如果每个空间点先用“基底上的位置+离基底多远”描述,那么与粗形状无关的局部几何和反射属性就能集中在一个表面潜场里;如果该潜场还具有可用的相似度结构,传统纹理合成就能移植到神经表示上。这里的创新组合是可迁移表示、可匹配潜度量、坐标系正确的拼接,不是使用大规模预训练生成模型。
03 · 输入 输出 与符号
| 对象 | 实际含义 | 作用与边界 |
|---|---|---|
| 多视角 RGB 与前景 masks | 手机视频的不同视角帧;相机通过 COLMAP 获取 | 每个纹理场景单独拟合,不是跨场景训练的通用生成器 |
| 粗基底 mesh \(M\) | NGP 密度场经 Marching Cubes、Co-ACD、union、平滑和 remeshing 得到 | 承担低频形状与局部坐标系;质量直接限制可捕获纹理 |
| \(x,x_c,s(x)\) | 三维查询点、投影 footpoint、相对基底的有符号投影距离 | 不是把场景限制为二维表面;法向距离保留厚度 |
| \(f(x),\hat f(x)\) | 两组在 footpoint 查询的多分辨率 hash 特征 | \(f\) 负责密度、反射和倾角并参与匹配;\(\hat f\) 负责坐标系相关的方位角 |
| \(\sigma,k_d,k_s,g,\theta,\phi\) | 密度、漫反射、镜面反射、glossiness、细法线的倾角和方位角 | 由潜特征与 Fourier 距离编码预测;不是标准金属度/粗糙度 PBR 贴图 |
| \(T_c,T_s,\tilde T_c\) | 原基底切线框架、采样平面的框架、目标形状切线框架 | 搬运细法线时必须一起搬运这些方向信息 |
| 合成输出 | 扩大后的潜特征纹理、方位特征和 frame 信息,以及共用解码器 | 可渲染密度和外观;不直接输出 SBS、SBSAR、shader graph 或可编辑节点程序 |
| 目标 mesh 与 UV | 待装饰的新形状 | 2023 方法先在二维纹理域合成,再映射到表面;曲面直接合成属于后续扩展 |
为清晰起见,用 \(\mathcal D=\{I_i,A_i,K_i,P_i\}_{i=1}^{N}\) 表示 RGB、mask、相机内参和位姿;这里是精读整理符号。训练优化场景参数 \(\Theta\),得到可供查询的编码器与解码器。合成则操作冻结后的样本特征块集合 \(\mathcal P\),寻找低重叠误差的排列。两者的优化变量不同,不应把合成理解成再次训练 NeRF。
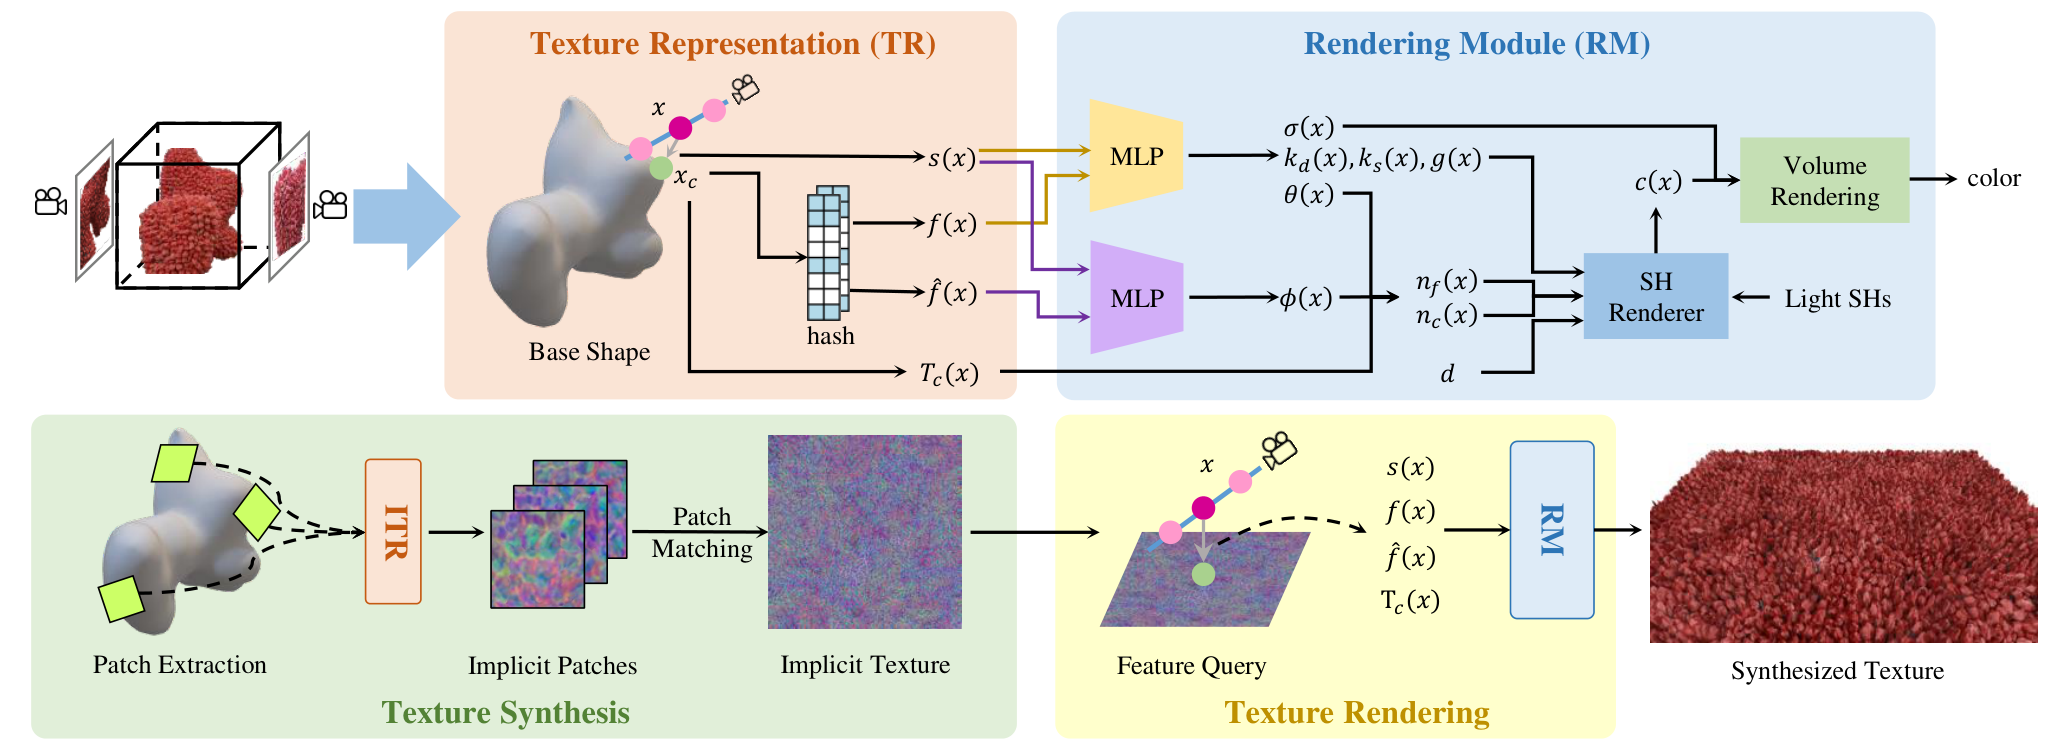
04 · 基底提取与可微投影
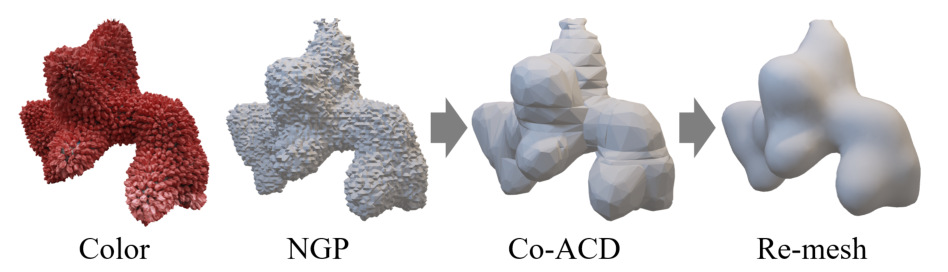
先确定什么属于形状,什么属于纹理
- 由 COLMAP 估计相机,训练 Instant-NGP 重建原场景
- 对密度场做 Marching Cubes,得到含细节的初始几何
- Co-ACD 近似凸分解再取并集,去掉不希望留在基底中的细小结构
- 平滑、重新网格化,让顶点在表面较均匀分布
这不是学习出来的唯一“正确分解”。基底粗到什么程度由处理方式和场景阈值决定。若把榴莲刺留在基底里,潜纹理会缺少应迁移的刺;若把把手、孔洞等宏观结构也抹平,场必须用纹理密度补偿错误基底。论文 Figure 12 的失败由此可以预期。
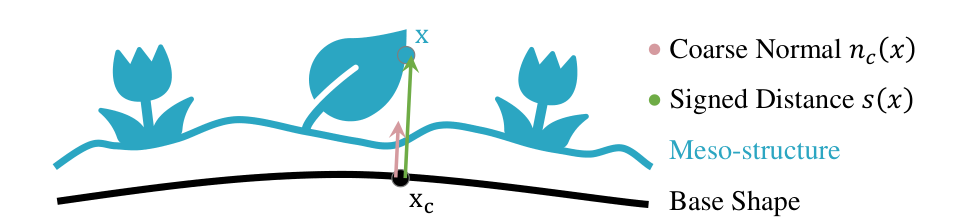
原式 1:估计投影方向
为避免最近三角形切换带来的不稳定,作者使用 \(K=8\) 个近邻顶点法线,并加入从近邻指向查询点的方向项。按原 PDF 排版,式 1 的两个分式一起置于求和括号内:
\[\tilde n_c(x)=\sum_{k=1}^{K}\frac{1}{W}\left(\frac{n_v(v_k)}{\lVert x-v_k\rVert_2}+\frac{x-v_1}{w\lVert x-v_1\rVert_2}\right),\quad
W=\sum_{k=1}^{K}\frac{1}{\lVert x-v_k\rVert_2}+\frac{1}{w},\quad
n_c(x)=\frac{\tilde n_c(x)}{\lVert\tilde n_c(x)\rVert_2}.\]
\(v_k\) 是第 \(k\) 个近邻,\(n_v\) 是其顶点法线,原文取 \(w=0.01\)。距离近时,逆距离加权法线提供局部方向;离基底远时,指向基底的方向项帮助射线命中。由 \(x\) 沿 \(-n_c(x)\) 发射射线,取交点 \(x_c\) 和投影距离 \(s(x)\)。这里的距离是沿该投影方向得到的值,不宜不加条件地等同于全局精确欧氏 SDF。
Implementation Verified 代码并非逐项实现上述括号:MeshProjector.knn 使用所有近邻方向的逆距离加权均值,先与平均法线校正朝向,再作为一个额外法线参与权重归一化,默认 dir_vec_wdist=0.05。这与论文最近邻方向及 0.01 不同。代码还沿正负两个方向追踪,选较近的交点并设正负距离。保留原式、文字解释与实现差异,不能悄悄改成自己认为合理的公式。
原式 2:人为规定 backward
\[\frac{\partial x_c}{\partial x}=I-n_c n_c^{\mathsf T},\qquad
\frac{\partial s}{\partial x}=n_c^{\mathsf T}.\]
这里统一将法线写作列向量,因此投影 Jacobian 是 \(3\times3\) 的切平面投影矩阵。原文采用的向量排列写成 \(n_c^{\mathsf T}n_c\);不能照抄成列向量约定下的标量。实际 backward 为 \(\nabla_x L=(I-n_c n_c^{\mathsf T})\nabla_{x_c}L+n_c\,\partial L/\partial s\)。它把沿表面的梯度和法向距离梯度分别送回查询坐标,使密度梯度法线和相机位姿优化可行。
Reviewer Commentary 这是一种局部投影近似的自定义梯度,不是 ray-triangle intersection 全过程的精确导数。曲率大、最近面切换、掠射、孔洞附近,其光滑局部假设可能不成立。论文没有单独量化该近似的误差,也没有对“无相机优化/无自定义 backward”给出定量消融。
05 · 表示 解码器 与模型规模
潜特征的存储坐标是三维 hash grid,但查询位置被限制在基底投影点,因此承担的是表面纹理场。将基底顶点直接当高分辨率特征节点会带来网格密度和查询开销;hash lookup 在固定层数下有常数级查询代价。这里的常数级不包含 KNN、射线碰撞、体渲染采样的总成本。
\[f(x)=H_{\mathrm{tex}}(x_c),\quad \hat f(x)=H_{\phi}(x_c),\quad
(\sigma,h)=D_{\sigma}\bigl[f(x),\gamma(s(x))\bigr].\]
\(\gamma\) 是 Fourier distance embedding;\(h\) 是中间几何/外观特征。主文把密度、反射、倾角绘在同一路径,实际代码再以 \(h\) 预测 BRDF,倾角网络直接使用 texture feature 与部分距离编码。另一路 \(\hat f\) 预测方位角。网络不需要大规模文本或图像编码器。
| 组件 | 2023 官方代码的默认结构 | 输入输出与训练状态 |
|---|---|---|
| 纹理 hash | 8 层,每层 2 维,分辨率 512→1024,每层最多 \(2^{19}\) entries | 3D footpoint→16 维 \(f\),可训练并受聚类约束 |
| 方位 hash | 4 层,每层 2 维,512→1024,容量同上 | footpoint→8 维 \(\hat f\),不作为 patch matching 主特征 |
| 距离编码 | 1D frequency encoder,multires=12 | 含原始输入时为 25 维;密度网络使用全部,法线网络截取前 12 维 |
| 密度 decoder | FullyFusedMLP,1 个 32 宽 ReLU 隐层,16 维输出 | 输出 1 个密度 raw 值+15 维 \(h\);密度用 trunc_exp 激活 |
| BRDF decoder | 2 个 64 宽隐层,5 维输出 | RGB albedo、1 维 specular、1 维 glossiness;sigmoid 与 softplus+1 |
| 倾角 decoder | 2 个 16 宽隐层,输出 1 维 | 16 维 \(f\)+12 维距离;主入口关闭 lip_mlp 与 angle bounding |
| 方位 decoder | 2 个 16 宽隐层,输出 1 维 | 8 维 \(\hat f\)+12 维距离;与倾角组合成单位法线 |
| 光照 | SH order=3,16 个系数;默认 white_light=True | 场景光照可训练;预计算积分矩阵固定;实现有更细的 SH 截断,见后文 |
| 外部固定部分 | 粗 mesh、采样框架、投影规则 | NeRF-Texture 拟合阶段不联合优化粗 mesh 拓扑;相机参数可训练 |
基础模型与大模型:论文没有 base/large 两档实验,没有 transformer、LLM 或 diffusion backbone。代码还有 SG、Envmap、无显式光照、vertex-feature、概率特征和 Lipschitz 网络分支,不能把这些开关当作已验证的大模型消融。总参数量和显存没有在可得主文中报告。按公开默认容量计算,两组 hash 的参数上限合计为 \(8\times2^{19}\times2+4\times2^{19}\times2=12{,}582{,}912\),这是代码结构推算,只计 feature entries,不是作者报告的完整模型参数量。
06 · 倾角 方位 与光照解耦
细法线 \(n_f\) 在局部 tangent frame 中表示。倾角 \(\theta\) 是细法线相对基底法线的角度,不依赖切线朝向;方位角 \(\phi\) 则依赖局部切线的选择。同一块凸起纹理如果只因基底三角形的 tangent 换了方向而拥有完全不同的匹配特征,latent matching 就会混淆内容与坐标系。于是作者让主特征负责 \(\theta\),另一路特征负责 \(\phi\)。
\[R(\theta,\phi)=
\begin{pmatrix}\sin\theta\cos\phi\\\sin\theta\sin\phi\\\cos\theta\end{pmatrix},\qquad
n_f=T_c R(\theta,\phi).\]
材质采用 Phong 的 \(k_d,k_s,g\),光照以 SH 表示,通过球谐卷积计算 diffuse 和 specular,再用体渲染合成像素。下式是帮助理解的渲染整理,而非论文新增编号式:
\[c(x,d)=k_d(x)E_{\mathrm{diff}}\bigl(n_f(x)\bigr)+
k_s(x)E_{\mathrm{spec}}\bigl(r(x,d),g(x)\bigr),\qquad
C(r)=\sum_i T_i\bigl(1-e^{-\sigma_i\Delta_i}\bigr)c_i,\quad
T_i=e^{-\sum_{j\lt i}\sigma_j\Delta_j}.\]
\(r(x,d)\) 为反射方向,\(\Delta_i\) 为采样段长度,\(T_i\) 是到第 \(i\) 个样本的透射率。几何遮挡由密度积分产生,材质反射由显式光照模块计算,二者不能互相替代。解耦允许目标表面的法线发生改变后重新计算外观,而不是直接把原图中的阴影烘死在 RGB patch 中。
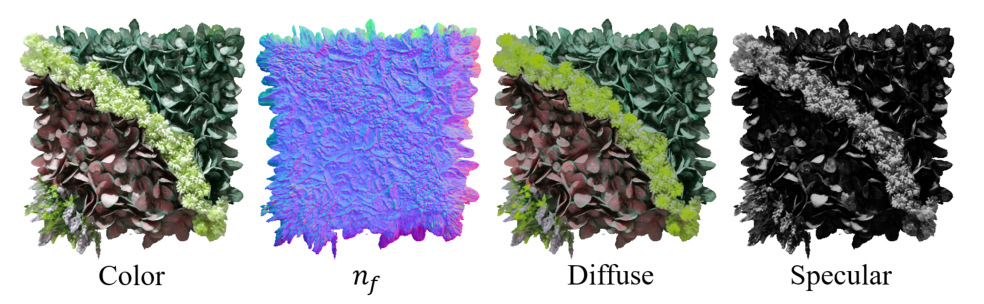
Implementation Verified SH 材质实现的 albedo 为 RGB、镜面系数为单通道,glossiness 经 softplus 后至少为 1,默认 gamma=2.4。初始化虽然存 16 个 SH 系数,diffuse 分支切片到前 9 个,specular 分支也使用前 9 个;order_coeff 从批次轴 envSHs.shape[0] 构造,在普通单环境分支该轴为 1。静态上这与按 SH 阶数衰减 specular 的意图存在可疑差异,须用多阶环境光单元测试核实。本次没有运行模型,因此不将潜在实现问题直接等同于论文实验无效。
Reviewer Commentary 分解不等于物理量可唯一识别。未知光照下,albedo、specular、密度、法线与相机误差都可相互补偿;低阶 SH 难以表达尖锐高频光照。主文有外观分量可视化,但没有地面真值 BRDF/法线误差或系统的重光照泛化量化。应称“支持重定位的显式着色分解”,而非已经恢复真实物理材质。
07 · 训练目标与聚类度量
四个目标共同约束每个场景
\[L=L_{\mathrm{rec}}+\lambda_1L_{\mathrm{clu}}+
\lambda_2L_{\mathrm{dis}}+\lambda_3L_{\mathrm{nor}},\qquad
(\lambda_1,\lambda_2,\lambda_3)=(10^{-5},10^{-2},1).\]
\(L_{\mathrm{rec}}\) 是渲染 RGB 对照片的 L1 误差;\(L_{\mathrm{dis}}\) 借用 mip-NeRF 360 的 distortion regularizer 压制沿射线的浮动密度;\(L_{\mathrm{nor}}\) 用负密度梯度监督预测法线。聚类项改变的是 feature space 的组织方式,使“重建内容相近”更可能意味着“潜特征距离相近”。重建好并不保证这一逆向关系:非线性 decoder 可以把相距很远的 latent 映成类似结果。
原式 3:软聚类与自强化目标
\[q_{ij}=
\frac{(1+\lVert f_i-\mu_j\rVert_2^2/\kappa)^{-(\kappa+1)/2}}
{\sum_{j'}(1+\lVert f_i-\mu_{j'}\rVert_2^2/\kappa)^{-(\kappa+1)/2}},
\qquad
p_{ij}=\frac{q_{ij}^2/\sum_iq_{ij}}
{\sum_{j'}(q_{ij'}^2/\sum_iq_{ij'})}.\]
\[L_{\mathrm{clu}}=\mathrm{KL}(P\Vert Q)
=\sum_{i,j}p_{ij}\log\frac{p_{ij}}{q_{ij}}.\]
\(f_i\) 为某层 hash 的 embedding,\(\mu_j\) 为可训练聚类中心;\(\kappa\) 是 Student-t 自由度。先计算到各中心的重尾软分配 \(Q\),再平方并按 cluster mass 校正形成更尖锐的 \(P\),以 KL 使分配向 \(P\) 靠近。它没有语义标签,不是 k-means 一次离线预处理,也不是 VQ 的离散码本替换:连续特征仍被插值并送入 decoder。
实现默认每层 4 个二维 cluster centers、\(\kappa=1\),每步随机挑一个 hash level 计算聚类,target distribution detach,KL 使用 reduction='mean'。不能直接把正文 KL 求和的系数和代码 mean 系数比较成训练力度的精确倍率;不过代码常用权重注释为 \(10^{-5}\),活动分支明确改成 glossy surface 的 \(10^{-8}\),确有配置差异。
原式 5 与可执行法线损失不等价
令 \(\alpha=\angle(-\nabla_x\sigma,n_f)\)。固定 PDF 的排版是:
\[L_{\mathrm{nor}}^{\mathrm{printed}}=-\cos\bigl(\min(\alpha,\pi/8)\bigr).\]
如果 angle 符号按通常夹角理解,则误差大于 \(\pi/8\) 时此式为常数,反而不给较差方向纠正梯度。官方 utils.py 实际计算归一化法线点积后截断:
\[L_{\mathrm{nor}}^{\mathrm{code}}=
-\min\bigl(\bar n_{\mathrm{grad}}^{\mathsf T}\bar n_f,\cos(\pi/8)\bigr)
=-\cos\bigl(\max(\alpha,\pi/8)\bigr),\quad 0\le\alpha\le\pi.\]
代码形式在误差小于 22.5° 时饱和,较大误差继续受惩罚,更符合“允许密度梯度噪声”的文字动机。这里明确记录论文符号与代码不同,并未替作者发布勘误。梯度法线还被 detach,避免法线监督反向改变作为目标的密度梯度。
式 3 与 clustering · 训练目标与式 5 · 聚类实现 · 损失实现
08 · 从隐式 patch 到大纹理
采样时保存特征,也保存方向
在粗基底的切平面放置 128×128 射线阵列,向基底投射,逐像素查询 footpoint 的 \(f,\hat f\)。同时保存采样局部框架 \(T_s\) 与原基底框架 \(T_c\)。这张“图”每个 texel 包含潜特征而不是普通 RGB,其高度方向的结构仍由 decoder 接收距离值后生成。不同 patch 的物理尺寸由采样间距决定;128 只是分辨率,二者不能混为一谈。
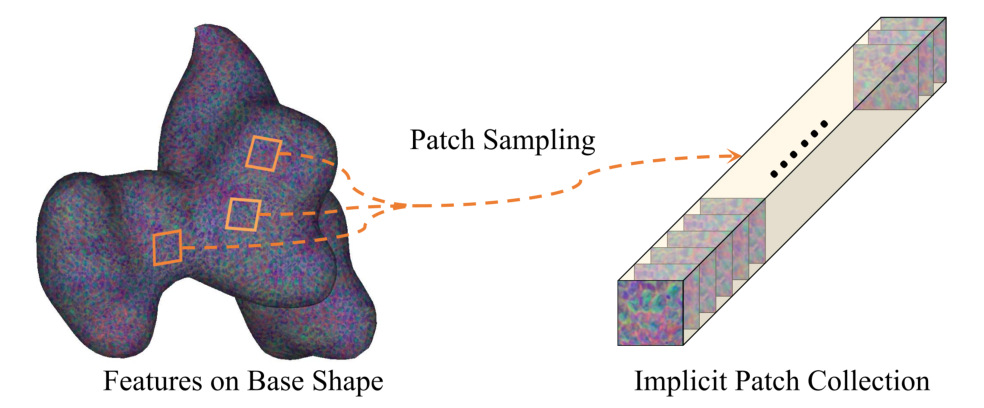
官方采样器上限 2,000 个候选,默认 Poisson-disk 采样;间距等于基底平均边长乘 pattern_rate。它允许人工指定 picked_faces.obj 限定区域,并用 PCA 主轴或 direction.obj 设采样方向。离扫描点云过远、射线未命中或产生无效方向的 patch 会被丢弃。这些筛选使“任意对象都自动提取完整纹理”不成立。
匹配与 quilting 的执行过程
- 随机取 seed patch 填入输出域
- 按 raster order 扩展已填区域,收集上方、左方或二者的重叠边界
- 仅用 \(f\) 的重叠特征距离检索候选;\(\hat f,T_c,T_s\) 随块搬运,但不混入相似度
- 根据距离转成的概率随机选块;在重叠区域以动态规划寻找最小代价路径
- 沿接缝切换来源;记录来源 patch ID 和切线变换;持续填满目标 canvas
以下将匹配和接缝目标写成便于理解的形式,属于算法解释而非原论文编号公式:
\[E(P,\Omega)=\sum_{u\in\Omega}\lVert f_{\mathrm{out}}(u)-f_P(u)\rVert_2^2,\qquad
\Gamma^{\ast}=\arg\min_{\Gamma\in\mathcal C}\sum_{u\in\Gamma}
\lVert f_{\mathrm{out}}(u)-f_P(u)\rVert_2^2.\]
\(\Omega\) 是重叠区域,\(\mathcal C\) 是合法单调接缝路径集合。低重叠代价保障局部一致,无法保障长程条纹闭合、语义文字正确或全局周期。论文采用的策略是贪心扩展,没有 beam search、全局回溯或生成失败后的语义修复。
公开脚本的可复核细节
入口默认输出 2048×2048,patch 内部非重叠宽度设为输入边长的四分之一,重叠宽度为剩余的一半:输入 128 时分别为 32 和 48,步长 80。canvas 根据块数向上取整,默认实现会分配比请求尺寸略大的容纳区,不能仅看到 outputSize 就认定保存结果恰好 2048。KD-tree 将重叠方向压缩到最多约 32 个采样点,角落在左右边界拼接中被计算两次。
候选检索从 16 个开始,无合法候选时将数量翻倍。距离概率先按 \(1-d/d_{\max}\) 归一化,strict_match 将其取三次方再归一化,NaN 时回退均匀分布。主入口 strict_match=True,但水平、垂直镜像与旋转均关闭;正文则描述使用水平和垂直翻转增强。quilt=False 这个名字容易误读:它仍执行最小代价接缝切割,只关闭接缝两侧的宽混合,在路径本身取均值。
Reproducibility Risk 有限候选集下,检索数量翻倍缺少显式上限保护;非正方形输出时,required_size_Y 中用了 X 方向块数。这些是静态代码风险,未做运行复现。脚本无固定 seed 的独立初始化,完整复现实验还需记录候选顺序、随机状态、采样区域和 physical scale。
09 · 目标映射与推理流程
原式 4:正确搬运法线的三个坐标系
\[\tilde n_f(x)=\tilde T_c(x)T_s^{-1}(x)T_c(x)
R\bigl(\theta(x),\phi(x)\bigr).\]
先用原基底框架把 local fine normal 变成原世界方向,再用 \(T_s^{-1}\) 转到抽取 patch 的平面坐标,最后用目标的 \(\tilde T_c\) 旋转到新表面。若只拷贝角度、忽略来源框架,法线方向会随不同来源三角形任意跳变。镜像 patch 时也必须镜像相应框架。2023-08-06 官方提交的说明正是修复 sampled frame 的 TBN 变换。
对目标查询点投影得 \(\tilde x_c,\tilde s(x)\),使用其 UV 双线性读取合成特征,再以新的距离解码密度和反射参数。原文对 frame map 使用最近邻读取,避免直接把不同旋转矩阵混合为非正交矩阵;潜特征可插值,方向框架则需更谨慎处理。代码还提供 UV 利用率、SDF scale/offset 和纹理厚度调节,说明纹理在目标上的尺度与厚度是实际控制量。
| 阶段 | 需要的输入 | 计算与停止条件 | 产物 |
|---|---|---|---|
| 采集预处理 | 视频、用户选定场景 | 抽帧、去模糊、MiVOS mask、COLMAP | images、transforms.json |
| 粗基底 | 分割多视图 | NGP 拟合与 mesh 后处理;README GUI 手动停 | surface_coacd_remesh.obj、点云、厚度阈值 |
| 纹理拟合 | 粗 mesh、照片、相机 | 优化 hash/decoder/光照/相机;保存 checkpoint | 每场景神经纹理 |
| 合成 | 采样 patches 与 frame 信息 | KD-tree 匹配、概率选择、最小接缝,直到 canvas 所有块填满 | texture.npz,含 features、phi_embed、frame 和 ID |
| 应用与渲染 | 目标 UV mesh、合成纹理、decoder、相机 | 投影、查纹理、变换法线、SH 着色、ray marching | 新视角 RGB、深度与分量预览 |
默认代码采用 CUDA ray marching,上限 1024 个 samples/ray;非 CUDA 备用路径默认 512 个步长样本和 0 次上采样。GUI 默认 1920×1080,max_spp=64,这些是界面配置,不是论文报告的实时速度测试条件。主文称支持 real-time rendering,但可得正文没有明确 FPS、GPU、分辨率和同条件测量,不能把“实时”换成自造帧率。
Prompt 与 agent 项:主方法没有 system prompt、few-shot、temperature、top-p、LLM tool call 或 reasoning trajectory。仓库继承的 clip_text 参数不证明论文采用 CLIP 指导;默认随机位姿选项为 -1。Figure 7 的 text image 通过 patch 渲染颜色施加图像约束,不是自然语言语义理解。
10 · 数据与训练复现清单
Paper Verified 真实纹理包括 durian、tree bark、woven fabric、leaves/grass 和 flowers,使用手机采集多视角。主文未给出每个真实序列的总帧数、分辨率、曝光控制、相机覆盖统计和完整 train/validation split。官方仓库目前只发布四个示例场景,不能将它们当作完整实验数据集。
| 项目 | 主文能确认 | 官方代码/README 补充与边界 |
|---|---|---|
| 优化器 | Adam | LR 0.01,betas=(0.9,0.99),epsilon=1e-15;具体参数组见 get_params |
| 训练长度 | 正文未给固定 iterations | --iters=40000 用于 scheduler;GUI start/stop 实际手动停止,不保证恰好 40000 |
| 学习率计划 | 正文未报告 | 每步乘 \(0.1^{\min(t/40000,1)}\);约从 0.01 降到 0.001,无显式 warmup |
| batch | 正文未报告 | 每 step 取一帧,默认 4096 rays;不是 4096 张图 |
| 精度与 EMA | 正文未报告 | 入口强制 -O 行为,FP16 与 CUDA ray;EMA 0.95;preload 最后被设回 False |
| 损失 | L1+clustering+distortion+normal | 活动代码禁用 distortion,clustering 使用 1e-8,normal 采用截断 cosine |
| 相机 | COLMAP;可微投影支持优化 | optimize_camera=True;对照评测应确保所有 baseline 有可比相机条件 |
| 预处理 | 分割的多视图输入 | prepare 脚本每 15 视频帧取一帧;局部 Laplacian 清晰度窗口 10、阈值比 0.8;MiVOS 交互分割;COLMAP |
| 数据 split | DTU 每场景随机 5 个 test views | GUI 默认 COLMAP trainval 使用全部输入 frames;该入口不是表 1 的 holdout 评测脚本 |
| 耗时与设备 | 合成通常数分钟;声称实时显示 | README 建议 NGP 约 1 分钟、纹理拟合 10–20 分钟;未说明统一 GPU、显存及所有场景统计 |
| 随机性 | 正文无实验种子 | 训练入口 seed=0;独立 patch 脚本另需固定 NumPy 与 Python RNG |
| 未公开/未核实 | 全实验数据 manifest、DTU 五张 held-out 图像 ID、完整超参数搜索、重复次数/置信区间、weight decay 的独立实验设定、gradient accumulation、统一 GPU 与完整参数总数 | |
当前 data_args.py 的 star_flower 默认 CoACD threshold=0.8、pattern_rate=1/8;注释示例 wall 为 1.0 与 1/16,durian 为 0.1 与 1/16,putian_flower 示例使用另一变量名 data 且关闭显式光照,复制时需核查。入口若缺粗 mesh,会查找已有 NGP mesh 和点云,并计算厚度阈值:扫描点到基底绝对距离的约 70% 分位再乘 2。这些启发式可能明显改变输出。
复现顺序:首先固定 2023 提交和依赖版本、校验四个可得数据包;然后记录 coarse mesh、所有筛选 masks 和 scale;先复现 view reconstruction,再保存 patches、来源 frames 与随机 seed;最后分别跑论文损失和公开活动代码配置。不要在未跑相同 holdout 的情况下把 GUI 中的训练 PSNR 用来复核 Table 1。
论文 Optimization · DTU 协议 · 默认训练参数与覆盖 · 预处理 · 数据 split
11 · 定量结果全部行列
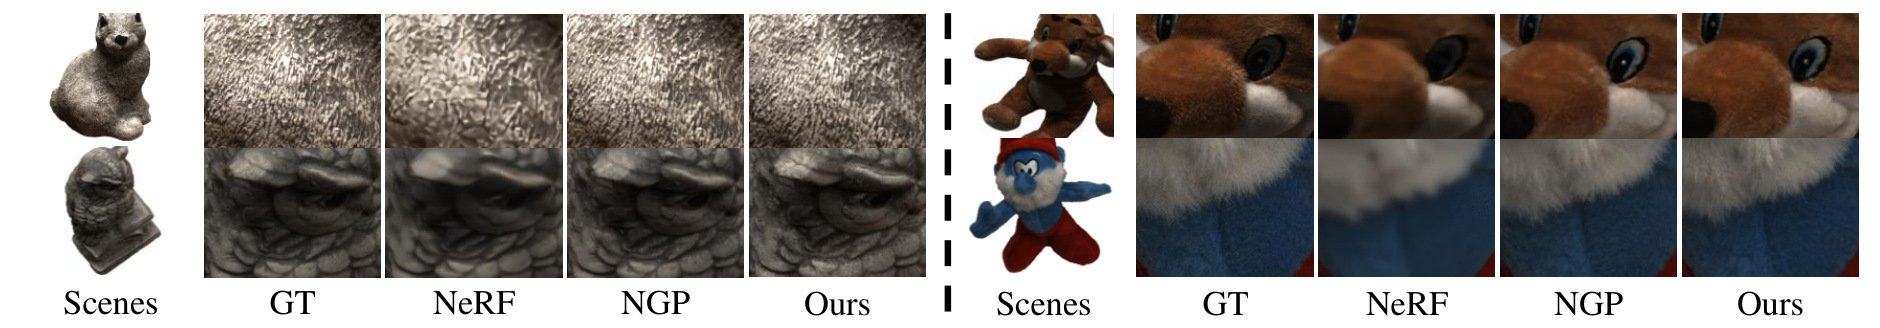
原 Table 1:DTU novel view synthesis
选择 4 个适合纹理表示的 DTU 场景,使用 IDR 提供的 masks,每个场景随机保留 5 张测试图。PSNR 越高越好,SSIM 越高越好,LPIPS 越低越好。主文没有说明随机划分种子及逐帧 ID,统计是各 scan 的测试平均。表内粗体标最佳,下划线标次佳。
| 方法 | Scan 55 | Scan 83 | Scan 105 | Scan 122 | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| PSNR ↑ | SSIM ↑ | LPIPS ↓ | PSNR ↑ | SSIM ↑ | LPIPS ↓ | PSNR ↑ | SSIM ↑ | LPIPS ↓ | PSNR ↑ | SSIM ↑ | LPIPS ↓ | |
| NeRF | 28.244 | 0.940 | 0.212 | 37.816 | 0.990 | 0.092 | 34.152 | 0.947 | 0.208 | 36.464 | 0.979 | 0.135 |
| NGP | 34.108 | 0.991 | 0.086 | 42.602 | 0.996 | 0.049 | 38.247 | 0.991 | 0.085 | 41.976 | 0.996 | 0.057 |
| Ours | 32.378 | 0.988 | 0.104 | 43.842 | 0.998 | 0.027 | 36.809 | 0.990 | 0.067 | 42.704 | 0.998 | 0.031 |
Our Calculation 对四个 scan 等权平均,NeRF 为 34.169 dB/0.9640/0.16175,NGP 为 39.23325 dB/0.9935/0.06925,Ours 为 38.93325 dB/0.9935/0.05725。这不是作者新增表格,只是原数字的算术汇总:相对 NGP,平均 PSNR 低 0.300 dB,SSIM 相同,LPIPS 低约 17.3%。逐场景看,Scan 55 的三项指标都落后 NGP;Scan 105 的像素指标落后但 LPIPS 更好。结论应是保留可合成表示的同时获得接近 NGP 的重建质量,而不是所有指标全面胜出。
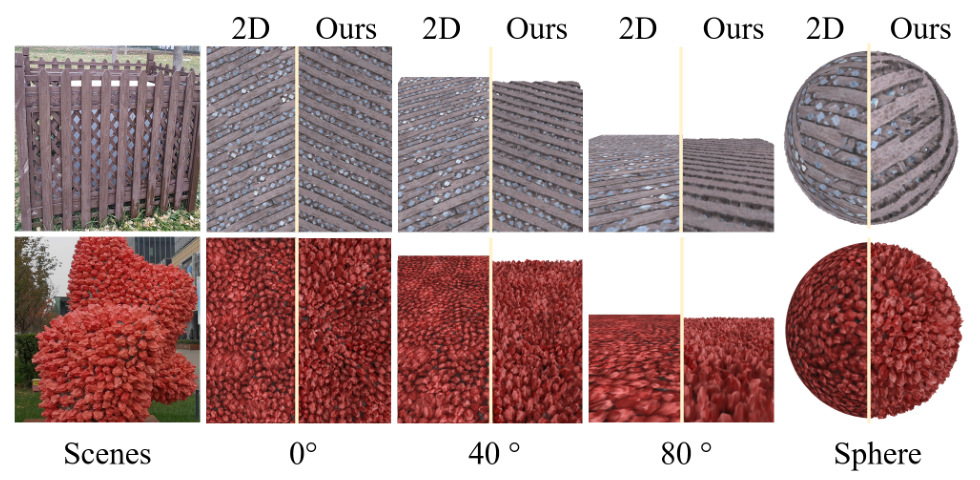
原 Table 2:与二维纹理的 SIFID 比较
作者在提取 latent patches 的同时渲染 RGB patches,再用 patch matching 合成同尺寸二维纹理。两种表示分别在 0°、20°、40°、60°、80° elevation 下渲染。真实图像中近似平面的纹理区域作为参考,选择相对平面视角最近的 ground-truth crop 计算 Single Image Fréchet Inception Distance。它测的是图像特征分布相似性,不是精确几何误差;不同纹理样本数与每角度方差未在主文报告。
| 方法 | 0° | 20° | 40° | 60° | 80° | Average |
|---|---|---|---|---|---|---|
| 2D | 0.73 | 0.75 | 0.82 | 1.21 | 1.75 | 1.05 |
| Ours | 0.52 | 0.51 | 0.56 | 0.58 | 0.82 | 0.60 |
Average 采用原表舍入值,不重新替换。平均差 0.45,按 1.05 归一化约下降 42.9%;80° 时从 1.75 降到 0.82,约下降 53.1%。随斜视程度增加,二维表示受缺少体积结构影响更大,这与机制相符。不过此比较仅包含普通 RGB 纹理,不能直接推断比高度图、视差遮挡映射、BTF、显式细 mesh 或现代材质生成方法更优。
12 · 定性应用与对照的适用范围
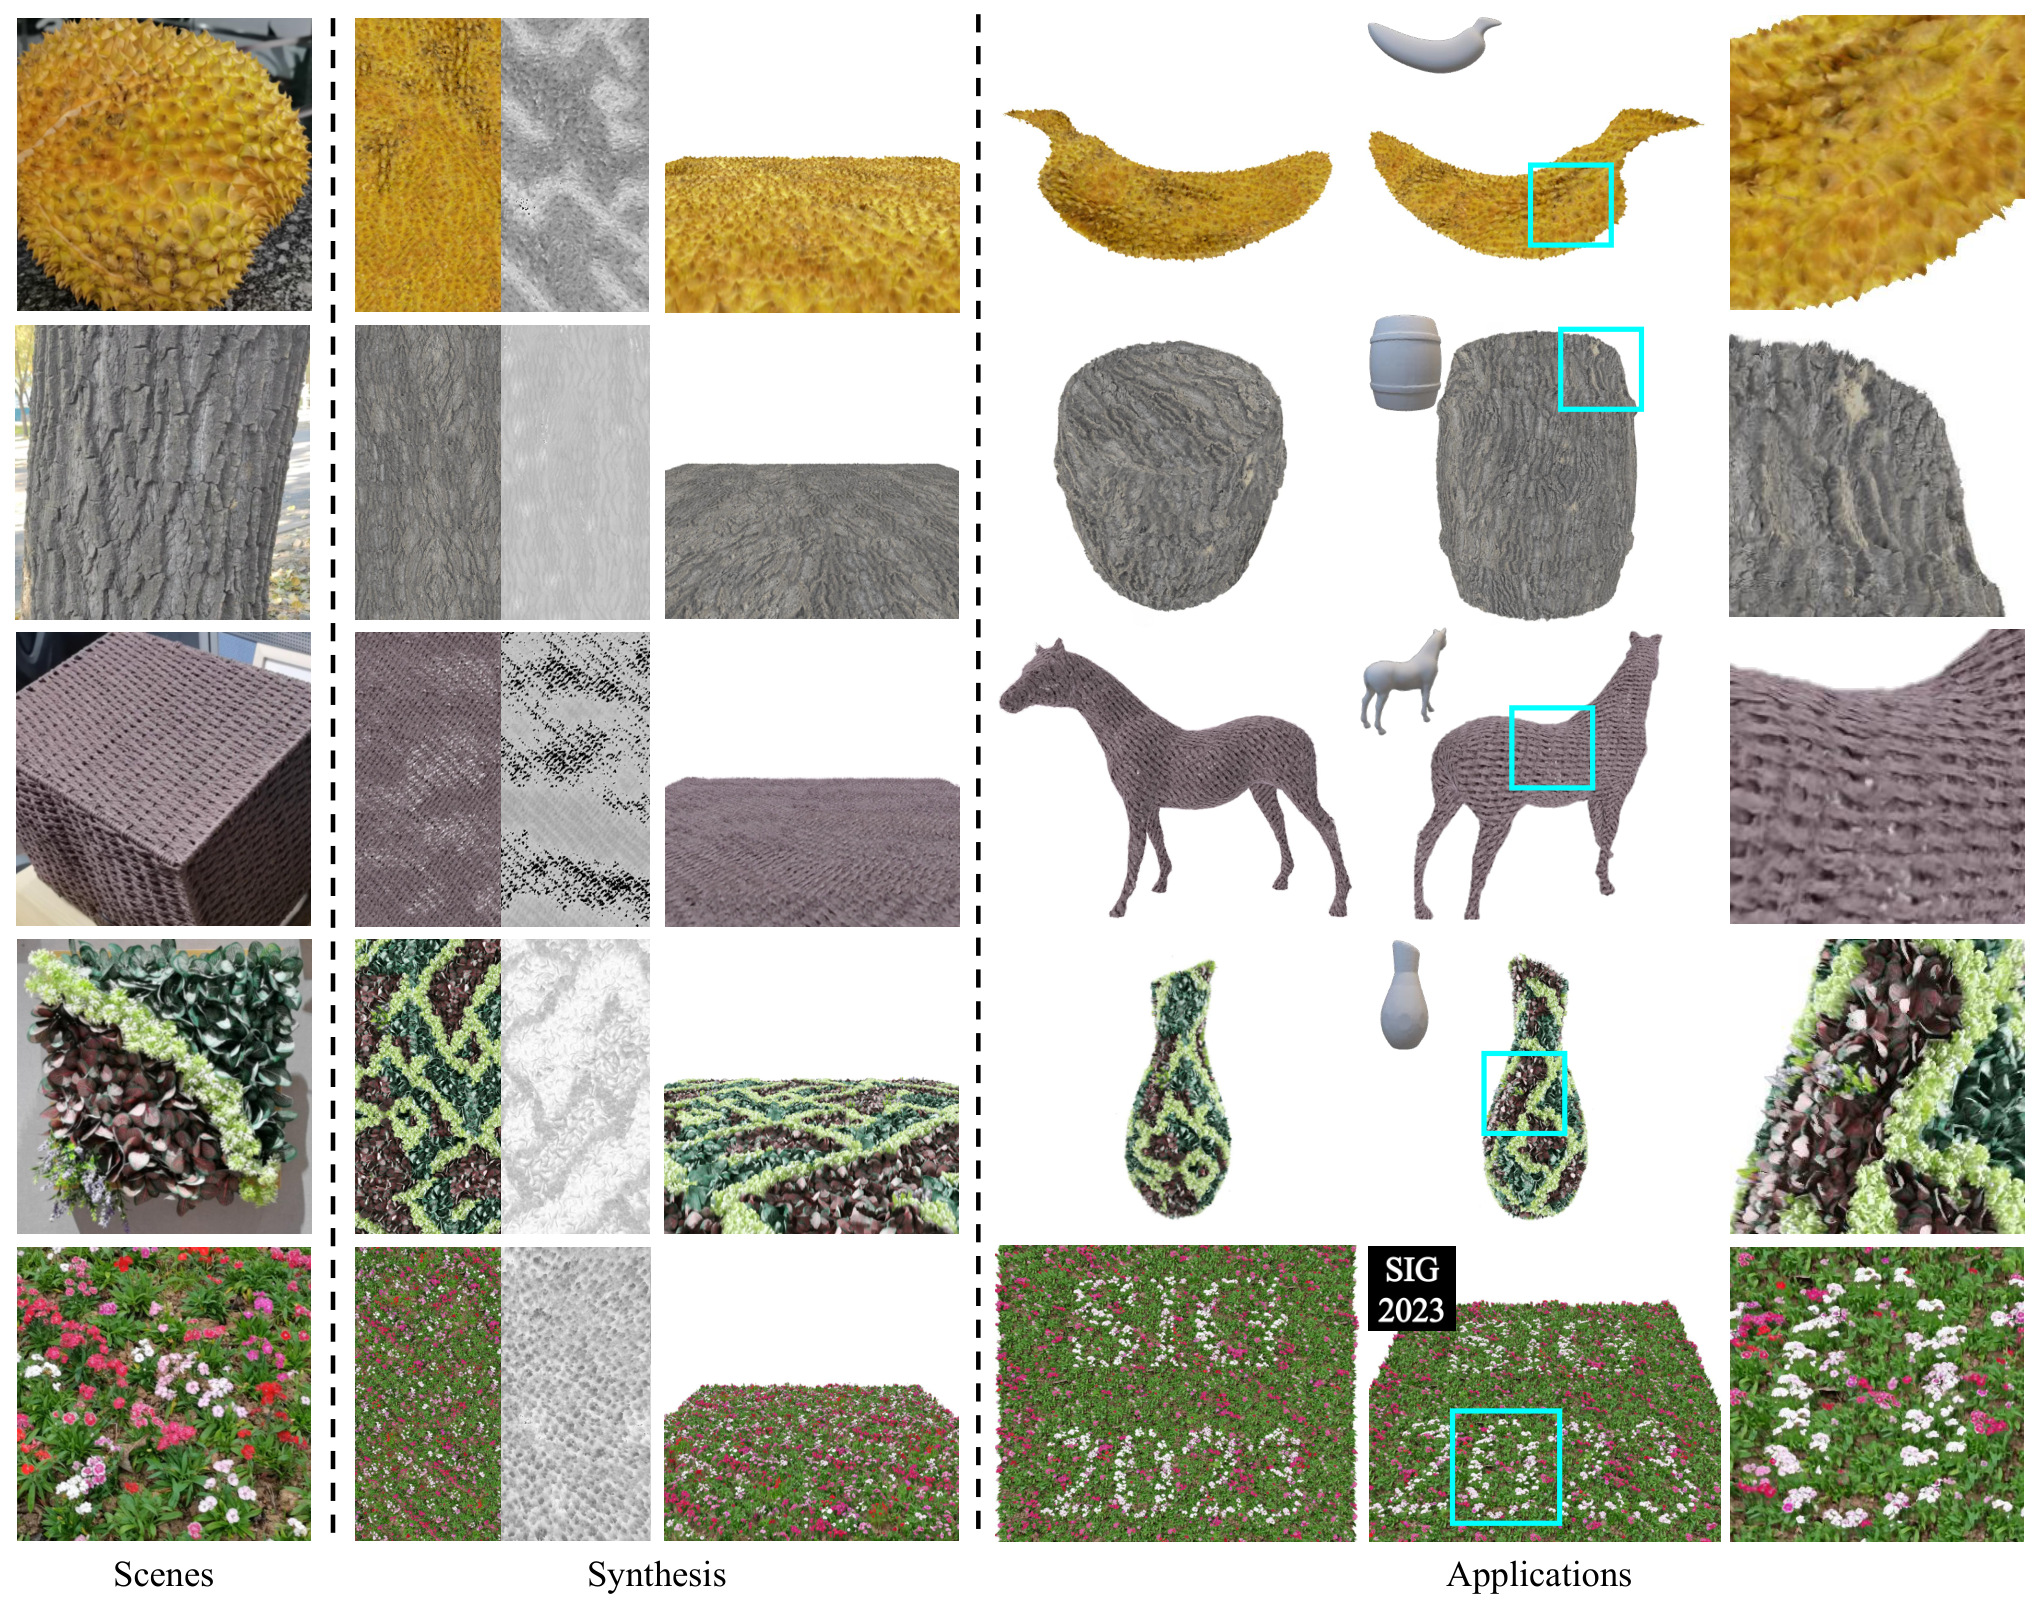
Figure 7 完整保留五行场景、合成外观/深度和目标应用:榴莲刺转到香蕉、树皮沟壑转到木桶、编织纹理转到马形、叶片转到花瓶,以及花朵图像约束合成。对大掠角和目标边界的展示有价值,因为这些位置最能区分真正体积纹理与表面颜色贴图。图像并未证明任意目标拓扑、任意照明或任意材质均可成功。
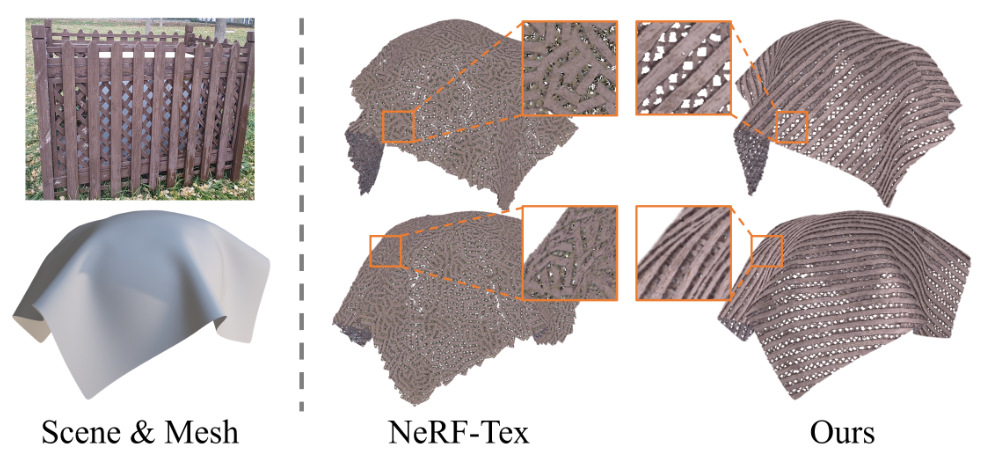
与 NeRF-Tex 的比较是视觉对照,没有给出定量表或用户研究。NeRF-Tex 的原始训练设置依赖已知平面、紧包围几何,作者先用自己的粗细分解表示生成包围盒中的真实纹理多视图,再把这些图提供给 NeRF-Tex 训练。这样使数据域更可比,却也引入了依赖本文重建结果的输入适配。结果支持连续 patch matching 比不规则重复摆放更适合某些有结构纹理,但不能视为两个端到端真实采集系统完全同条件的优劣排序。
没有用户研究、跨场景泛化训练实验、重复运行置信区间、统一显存表或有控制的逐阶段耗时表。可得图像的证据范围应保持为示例质量和表示功能,而不是统计稳健的通用质量保证。
13 · 消融与失败案例
聚类约束是主文唯一单独展示的组件消融
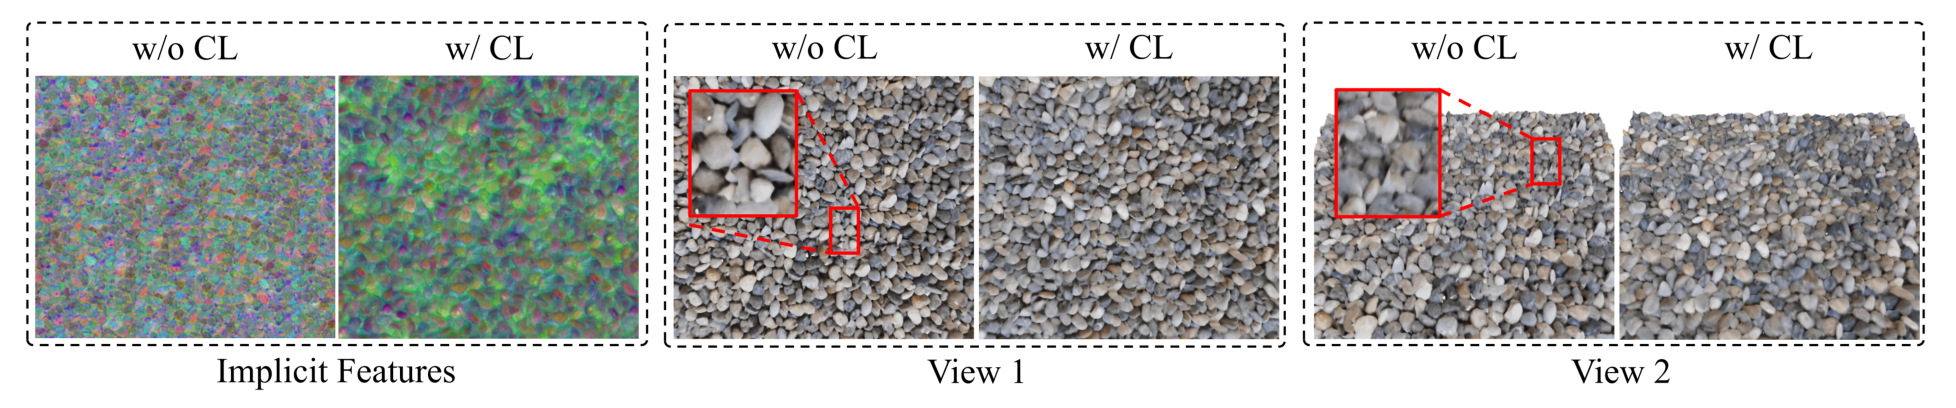
作者把合成特征 PCA 降为 3 维并映射到 RGB,比较有、无 clustering loss 的 latent 分布和最终结果。带约束的分布更紧凑、方差更小,展示样例中的合成伪影较少。该图是定性证据,没有定量 ablation table,不能补写 PSNR、SIFID 或显著性数字。
| 问题 | 主文证据 | 仍未建立的结论 |
|---|---|---|
| 聚类是否改善拼接? | Figure 11 的 latent 与渲染对照支持这一解释 | 平均改善量、跨场景稳定性、不同 cluster 数与权重敏感性未知 |
| 紧凑度是否等于正确度量? | PCA 视觉更集中 | 没有 latent distance 与内容距离的相关系数、检索准确率或塌缩检查 |
| 两组特征是否必要? | 表示动机合理 | 没有与共享方位特征或旋转不变网络的受控对照 |
| 粗基底/投影/SH 是否必要? | 完整系统能工作 | 没有逐项固定其余条件的性能/耗时消融 |
捕获失败和合成失败是两类问题
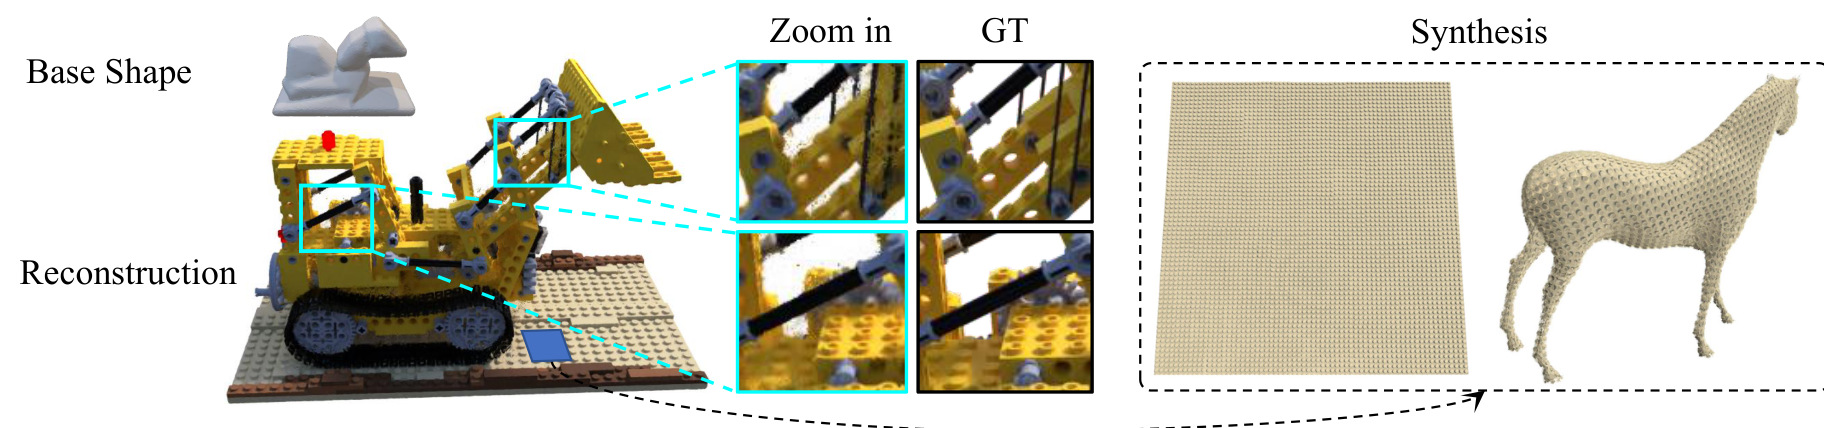
复杂 Lego 的几何难以由平滑粗 mesh 近似,穿孔区域又没有足够空间放置完整 patch,导致重建和捕获失败;同一对象底板上的规律凸点反而容易抽取。此处失败发生在建立可用 exemplar 之前,换一个更强的 patch 匹配器不一定能修复。
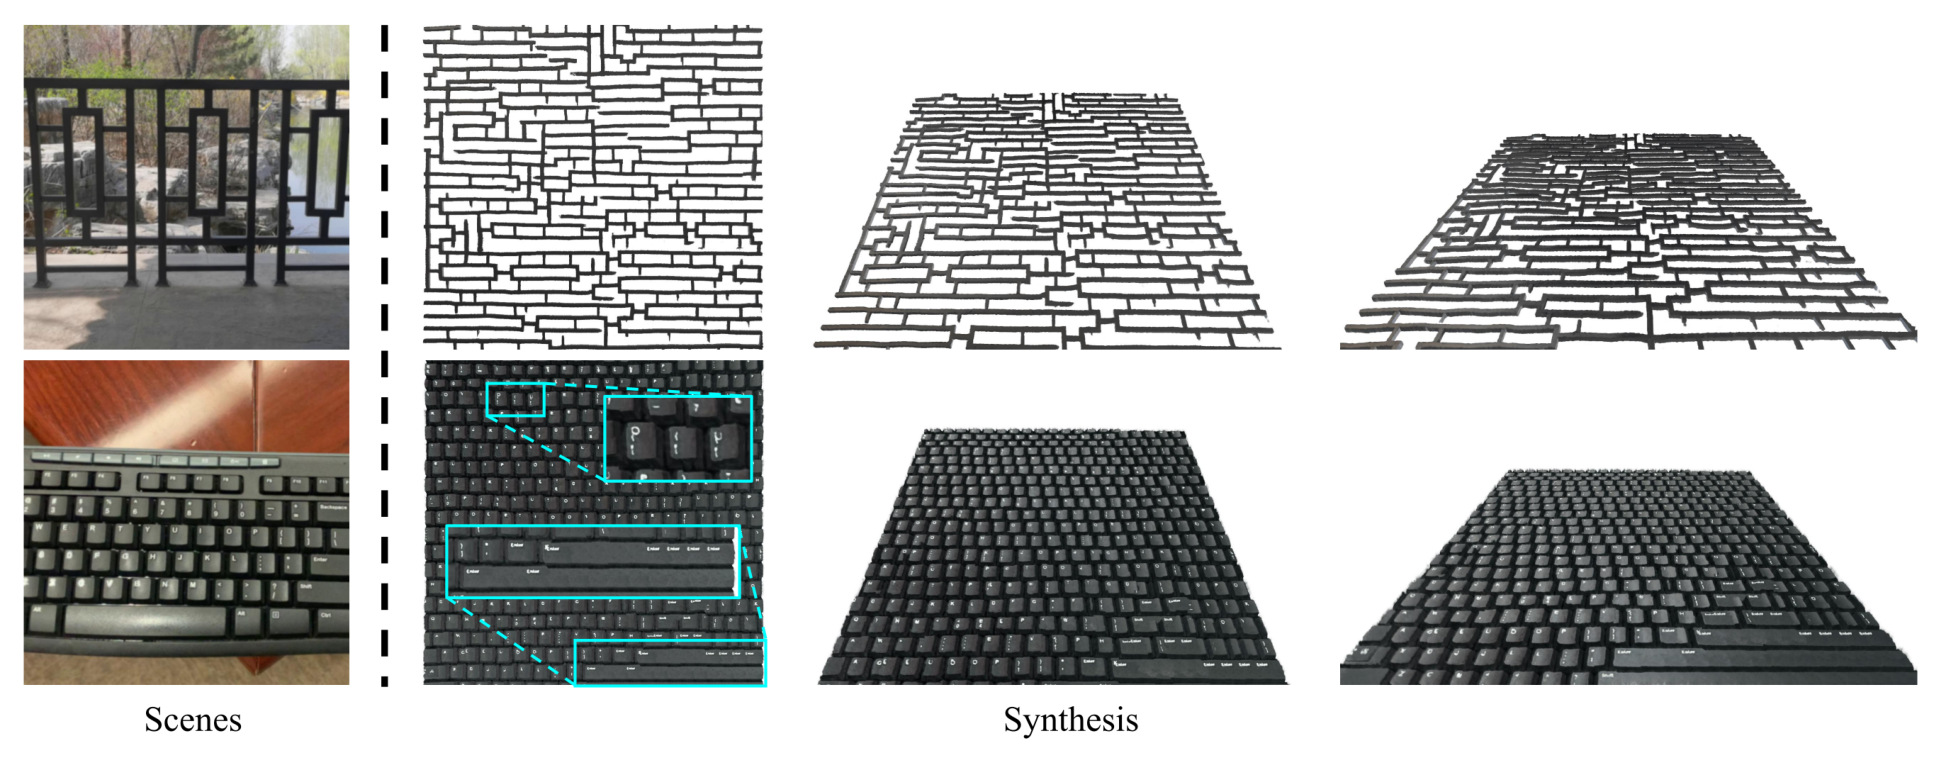
严格结构纹理需要全局协调,贪心的局部接缝只能保证近邻兼容;有限样本可能打断结构。键帽和字符带有语义,局部特征相近也可能合成无意义字符或扭曲形状。作者把 diffusion 作为潜在改进方向提出,本文并未实现、训练或评估 diffusion 模型。这也是原笔记“diffusion models”主题需要复核的原因。
14 · 论文与官方实现差异汇总
以下均来自固定源码阅读;没有执行训练、合成或模型推理。核心文件在 2023-08-06 和当前版本间相同,因此不能把差异全部归因于 2024 扩展。
| 位置 | 论文描述 | 代码事实 | 复现影响 |
|---|---|---|---|
| projection | 最近邻方向项、w=0.01、沿负法线投影 | 均值方向项、默认 0.05、正负方向追踪 | footpoint、距离和法线可能不同 |
| normal loss | 打印为角度 min 截断 | dot product min 截断,等价角度 max | 低误差/高误差区的梯度行为相反 |
| clustering | 权重 1e-5,每层约束 | 活动分支 1e-8;每次随机一层;KL mean | 需报告归一化和实际权重,不能照抄正文 |
| distortion | 权重 1e-2 | main.py 传 cal_dist_loss=False,并注明库升级后效果异常 | 默认训练不是论文列出的完整目标 |
| augmentation | 水平和垂直 flip | 合成入口两种 flip 关闭,rotate=False | 候选数与多样性不同 |
| 停止规则 | 模型训练后合成 | GUI 手动停止;40000 是 schedule 尺度 | 需记录真实 step,不只记录命令默认值 |
| 数据 | 多个真实采集与 DTU | 仅公开四个示例;默认 trainval 用全部帧 | 不能自动重现主文全部测试划分 |
| lighting | SH convolution 近似 Phong | SH 切片、glossiness 的 order 系数轴需额外测试 | 要检查高光方向与宽度随 g 的实际变化 |
| 目标表面 | 先合成 UV 纹理再映射 | 当前另外加入 curved-surface synthesis 文件 | 2024 结果不能混入 2023 主文成绩 |
工程依赖包括 PyTorch/CUDA、tiny-cuda-nn、自编译 grid encoder/ray marcher、PyMesh、FRNN、RayTracer、CoACD、Manifold、COLMAP,以及用于采集分割的 MiVOS。README 中安装指令和路径需要实际适配。仓库保留示例文件名和 dataset path 占位,这不是一条命令即完成的封装。当前仅静态审计,不将安装是否成功、模型是否能在本环境运行写成已验证事实。
15 · Reviewer 视角
值得肯定的贡献
表示与操作相互配合。粗表面提供可迁移坐标,latent patch 保留三维密度与反射,frame transport 保证方向一致,聚类专门为后续匹配服务。它没有把“重建”当成“生成”的替代,而是构建了从捕获到扩大纹理再到形状应用的闭环。使用小型解码器和 hash field 也符合交互图形系统的实际需求。
对中尺度结构问题切中要害。斜视角和轮廓边界上的差异有明确几何原因,Table 2 的结果与之对应。保留 Scan 55 等落后 NGP 的数字、复杂形状和语义纹理的失败案例,使论文能力边界相对清楚。
证据与建模上的弱点
- 粗细分解依赖人工尺度选择:CoACD、remeshing、厚度和 pattern_rate 共同决定“纹理”的定义,未证明其对超参数鲁棒
- 度量验证不足:PCA 紧凑不能排除特征塌缩,聚类损失未与 contrastive metric、render-space matching 等直接比较
- 指标覆盖有限:DTU 测重建,SIFID 测渲染图像分布,都没有直接衡量合成多样性、长程结构连续性或跨 UV seam 质量
- 物理真实性未充分核实:未知光照分解存在歧义,Phong 和低阶 SH 的表现力有限,缺少受控重光照 ground truth
- 复现细节不齐:官方实现与打印公式/权重不同,独立 supplement 未能获取,完整数据与 test IDs 不公开于可得正文
优先补做的实验
先建立一个可重现小 benchmark,固定相机、粗 mesh、patch 列表和 seeds;分别统计重建质量、接缝误差、结构破坏率、多样性、显存和各阶段时间。再做聚类开关/权重/中心数、共享或独立方位特征、精确与近似投影、不同基底精度的 factorial ablation。对材质分解,应使用已知照明和 BRDF 的合成场景测试可识别性。只有这样才能区分提升来自表示、采样启发式还是实际匹配度量。
16 · 面向 Procedural Material Generation 的研究延伸
Research Extension 本节是研究设想,不是作者已验证结果。NeRF-Texture 的产物是神经场和特征 atlas,尚不具备程序材质图的可读性、可编辑性、拓扑约束和跨引擎执行性。它更适合作为程序生成的目标观测、局部结构先验或渲染教师。
方向 A:将中尺度神经纹理蒸馏成可执行材质程序
输入多视角拍摄,经 NeRF-Texture 得到密度、法线、外观和多角度渲染作为 teacher;学生输出离散图 \(G\) 与连续参数 \(\eta\)。程序节点可包含点过程、实例分布、位移、噪声、颜色映射与反射控制,不能只拟合一张正视 RGB。可用下式作为研究目标:
\[\min_{G,\eta}\sum_{v,\ell}D\!\left(
R_{\mathrm{prog}}(G,\eta;v,\ell),R_{\mathrm{teacher}}(v,\ell)\right)
+\lambda_c\,\mathrm{Complexity}(G)+\lambda_b\,E_{\mathrm{boundary}}(G,\eta),
\qquad G\in\mathcal G_{\mathrm{valid}}.\]
\(v,\ell\) 是视角和光照,\(D\) 应组合轮廓/深度/法线/渲染外观误差;\(\mathcal G_{\mathrm{valid}}\) 强制节点类型、端口和无环约束。难点是普通二维材质图可能根本无法表达草叶状非单值体积结构,因此必须先界定输出程序的几何能力。成功指标应包含执行成功率、节点数、编辑稳定性、多视角保真,而不是单张图的 CLIP 相似度。
方向 B:将局部匹配升级为有结构的全局搜索
把 patch 当离散变量,把邻接相容性、方向场、周期约束、语义区域当图上的能量项。agent 若参与,应只负责选择候选、调用 renderer、读取测量误差和有限回溯;不让语言模型直接“猜”法线变换。每步保存来源 patch、frame、重叠代价、执行结果,失败时回滚明确状态。与贪心、beam、图优化作同预算对照,测结构完整性与采样时间。加入 diffusion 先验也必须单独报告训练数据与幻觉风险。
方向 C:为方向相关材质设计等变潜空间
本文把倾角和方位拆开,提示程序纹理中的“内容”和“朝向”应不同对待。可以让可旋转属性在 SO(2) 或切线框架下按已知变换搬运,匹配时比较方向不变量,渲染时恢复等变信息。研究问题包括镜像的手性、anisotropy、旋转插值、UV seam 和曲率失真。基线应包含现有 frame transport、简单特征拼接、旋转增强,而不能只和二维 RGB patch 比较。
方向 D:把可复现性本身做成受控贡献
构建包含原照片、相机、粗基底、采样有效域、潜 patch、程序图和多光照测试视图的数据链,显式记录每个阶段的版本与随机种子。将“能重建”“能合成”“能迁移”“能重光照”“能编辑”分成五类指标。尤其保留本文失败类型:孔洞基底、严格周期、字符纹理、粗 mesh 错误。这样形成的是可检验的能力评估,而不是仅增加漂亮示例。
17 · 复用决策与最小实验方案
适合复用:已有多视角纹理样本,需要保留草叶、花朵、织物的厚度遮挡,并愿意为每个样本单独拟合;目标表面有可接受的粗 mesh 与 UV,输出主要在神经渲染系统中使用。
先做可行性试验:只有单张图、需要严格无缝周期、需要文字结构正确、必须输出可解释 SBS graph,或要求强重光照真实性。现成系统不足以直接保证这些需求。
- 固定一个规则基底和一个具有孔洞/高曲率的难基底,各自保存训练与 5 个测试视角,锁定尺度
- 用同一份 patches 比较无聚类、论文系数、活动代码系数,避免采样差异掩盖损失效应
- 固定 seed 与候选数,分别比较贪心、结构约束和全局回溯,评测 seam 与长程连续性
- 对程序材质学生输出同时检查图是否合法、可执行、可编辑,以及多视角/多光照差异
- 逐项记录训练步数、GPU、显存、预处理、采样、合成和渲染时间;不把 GUI 建议时间当 benchmark
本地静态 QA 覆盖原表数字、图片可解码、数学源码、链接锚点、原笔记字节前缀与文件大小。浏览器布局和 MathJax 实际排版按要求暂缓;因此没有声称完成浏览器视觉验收或运行复现。
18 · 一手来源与归档说明
- Huang et al.,SIGGRAPH 2023 出版 PDF(Cardiff 作者机构存档)。本次以用户原始 PDF 为唯一页码和数字基准;身份由标题、作者、DOI 和 hash 核实
- ACM DOI。出版入口和 supplement 页面本次 HTTP 403,未取得独立补充文件
- 作者项目页;其 公开 PDF 已取得并核对为另一份 10 页主文版本
- 2023-08-06 官方源码固定提交:主入口、地图投影、网络、SH 光照、聚类和 patch quilting
- 当前官方源码固定提交:用于确定 2024 TPAMI arbitrary-surface 扩展的边界
- Cardiff ORCA 元数据:2023 会议版本和 DOI 交叉核对
归档候选:保留原 note 和全部已有 PDF++ anchors,在末尾追加此次精读。第一作者与通讯作者分别复用 Yi-Hua Huang、Lin Gao;本次不写 People 或共享索引。建议补充官方 project_page,保留已核实 correspondence;“diffusion models”和“text modality”列为分类复核候选,不自动改写原元数据。本文实际核心方法为 NeRF、neural rendering、differentiable rendering 和 exemplar-based texture synthesis。
阅读与静态复核日期:2026-09-30 · 原图版权属于 Huang et al. · 固定出版 PDF 标明 CC BY 4.0 · 论文事实、源码事实、研究评论与延伸已分别标记