01 · 论文身份与阅读地图
OBJect 3DIT 把“编辑一个物体”变成保持场景关系的反事实图像生成:把杯子移远时,模型不仅移动像素,还应缩小杯子、改变可见表面、重画阴影,并补出原来被挡住的背景。其关键资产是程序化合成的成对编辑数据;其输出仍是二维 RGB 图像。
| 字段 | 核实结果 |
|---|---|
| 正式标题 | OBJECT 3DIT: Language-guided 3D-aware Image Editing |
| 作者顺序 | Oscar Michel;Anand Bhattad;Eli VanderBilt;Ranjay Krishna;Aniruddha Kembhavi;Tanmay Gupta |
| 机构 | Michel、VanderBilt、Kembhavi、Gupta:Allen Institute for Artificial Intelligence;Bhattad:UIUC;Krishna:AI2 与 University of Washington |
| 发表与原笔记差异 | NeurIPS 2023,卷 36;原笔记的 year: 2024 不作为本页年份依据。原笔记内容原样保留,修订建议另列。 |
| 通讯作者 | 所查 PDF、项目页未见明确通讯标记;Tanmay Gupta 仅为末位作者候选,保持 unverified |
| 两种名称 | OBJect = Objaverse Editing in Context(数据集);3DIT = 3D-aware Diffusion Image-editing with Text(模型) |
全文使用四种证据标签:论文事实表示作者实际给出的方法或数字;作者解释表示其因果解释或推广性主张;实现核查表示固定公开提交中的可观察行为;研究延伸表示本文为后续研究提出、尚未验证的设计。尤其不要把定性照片编辑成功,升级成已证明恢复了正确三维场景。

图 1 同时展示 OBJect、CLEVR、真实照片的四类操作。后两组提供迁移示例,不是有规模和置信区间的真实场景基准。
02 · 动机:物体变化会传递到整个场景
对象级编辑的困难不在于“把某块区域变漂亮”,而在于编辑和图像形成的耦合。移动物体会改变透视大小、遮挡和受光;旋转会暴露输入照片从未观察到的侧面;删除不仅要清除物体,还要清除它的阴影、补出被它遮住的另一个物体。把检测、分割、单物体新视角合成和修复串起来,容易在接口处丢失统一的相机、地面和照明约束。
论文抓住的数据缺口是编辑前图像、精确操作、编辑后图像的配对监督。互联网图文数据很丰富,但同一场景中只改变一个物体的反事实图像对很少。作者让 Blender 中的场景先执行真实的物体操作,再渲染两张图,从而把几何、遮挡和光传输的变化一并写进目标像素。训练时模型可以看到大量这种对应关系,推理时不需要场景文件。
作者解释:以上是三阶段 curriculum。审慎理解:本文直接执行最后的微调,前两阶段来自预训练权重,并没有从零重训完整课程。v1 没有去掉每个阶段的受控消融;正式版后来补充了初始化比较,但也不能单凭课程叙述证明模型内部具有显式、可操作的三维世界模型。
与 Zero-1-to-3 的区别也不只是“多了文本”:Zero-1-to-3 主要改变孤立对象的观察视角,3DIT 在固定相机下改变场景内的某个对象,其他对象、地面和照明关系都应随之保持或合理更新。与 NeRF/mesh 重建再编辑相比,3DIT 省去了显式重建,但也失去了可验证的几何实体、多个视角之间的硬一致性以及可重新打光的资产。
03 · 任务定义、输入输出与数值控制
设场景为 \(S\),渲染器为 \(f\),原图为 \(x_1=f(S)\)。自然语言 \(l\) 指定要编辑的物体及操作,数值 \(v\) 指定角度或二维位置;在真实场景上执行操作的函数记为 \(M\)。监督目标是:
\(x_1,x_2\in\mathbb{R}^{H\times W\times3}\) 是 RGB 图像;\(\theta\) 是扩散模型可学习参数。左边的 \(f,M,S\) 用来构建监督,右边的神经模型只接收图像与编辑条件。推理没有输入网格、深度、材质、相机内外参、光源位置或实例分割。语言和数字是并行条件,数字不必被模型从一句长指令中解析。
| 任务 | 用户提供的控制 | 期望的三维语义 | 图像必须同步变化的内容 |
|---|---|---|---|
| Translation | 对象描述、目标二维坐标 | 在地面移动;保持角向姿态和地面接触 | 透视尺度、可见侧面、阴影、原位置遮挡补全 |
| Rotation | 对象描述、角度 | 绕通过对象质心且垂直地面的轴逆时针旋转 | 新表面、轮廓、受光、投影阴影 |
| Insertion | 新对象描述、目标二维坐标 | 生成接地且姿态稳定的对象 | 生成对象本体、遮挡、与原光照一致的阴影 |
| Removal | 对象描述;v1 任务设置另写提供点位置 | 从场景删除指定对象 | 删除其阴影、补全地面和被遮挡物体 |
实现核查:当前公开数据和推理代码的 removal 使用全零数值向量,只依赖描述指认目标;论文的 removal baseline 则明确获得一个对象内点。这与 v1 §4 把 removal 也列入 x-y 数值条件的写法不同,应在比较输入公平性时单独记录。
这是公开实现的四维编码:\(\phi\) 由角度转为弧度;\(u,v\) 为归一化图像坐标,接口说明范围是 \([0,1]\)。旋转编码的常数 \(\pi/2\) 用于沿用 Zero123 输入格式,并不意味着模型接收到真实相机姿态。正余弦避免 0° 和 360° 在数值上相距很远。图像中的二维目标位置与地面三维位置的对应,由数据分布和图像线索隐式学习。
输出是一张新的照片式图像,没有输出对象的 3D transform、材质图、SBS/SBSAR、shader program、PBR 通道或可继续操作的场景图。任何“可编辑三维资产”的解释都超过了本论文的输出定义。
04 · OBJect:从可执行场景制造反事实样本
资产筛选、文字标注与长尾划分
作者从超过 80 万个 Objaverse 资产出发,结合 Sketchfab 元数据和人工筛选,去掉不可正常渲染、无纹理、多个对象合成一个资产等情况。人工查看旋转展示,为对象选择类别并写出能区分同类对象的描述;类别候选约 1,400 个,来自 LVIS,允许新增类别,再清理拼写和罕见类别。最终使用 1,613 个类别,随机选取 1,513 个训练可见类别,余下 100 个留给 unseen 验证与测试。
v1 Table 3 · 数据统计(正式版改编号为Table 4)
| 统计量 | 原表数值 |
|---|---|
| Total objects | 62950 |
| Total categories | 1613 |
| Object per category median | 6.0 |
| Object per category mean | 39.03 |
| Object per category std | 138.00 |
均值 39.03、中位数 6、标准差 138.00 说明类别规模极不均衡;宏平均与按样本加权平均可能给出不同结论。seen/unseen 是类别层面的划分,不等于严格证明同一 mesh UID、近重复资产和预训练内容均不重叠。论文没有提供足够的预训练资产排除审计,Zero123 本身也使用 Objaverse,因此“编辑训练未见”不能直接替换为“整个学习过程从未见过”。
场景构造与物理约束
- 每个场景采样 1–4 个对象,地面从 17 张木地板、鹅卵石、砖等纹理中选择
- 先在 Blender 中让对象落到 XY 平面,记录稳定的静止姿态,减少漂浮和不合理支撑
- 根据对象 x-y 宽高比采样包围盒,均匀缩放资产。拒绝外接圆相交的摆放,使对象绕竖直轴转动时尽量不碰撞
- 限制不同对象包围盒最长边的最小值/最大值大于 0.8,避免极小物体与极大物体混在同一场景
- 相机位于上半球并朝向地面原点,仰角限定 40°–80°;若目标物体不可见,向外移相机,直到编辑前后都可见
- 执行单个对象操作,用 Cycles 渲染前后图像及实例、地面、背景分割掩码

这些约束使监督更干净,却也限定了分布:大致等尺寸的少量对象、单一平面、较高观察角。它们不能覆盖层叠支撑、抽屉开合、形变、复杂室内布局等情况。外接圆排斥还会减少某些密集接触场景,因此“物理合理数据”与“完整真实世界物理多样性”不是同一个结论。
为什么混合三类光源
18 张来自 Poly Haven 的 CC0 环境贴图提供不同室内外入射光;随相机适配的 key/fill/back 三点光帮助显示对象形体;额外的方向光在负 z 方向附近的圆锥中采样,产生可见而一致的地面阴影。方向光由强度和方向描述,不需要有限距离的光源位置。编辑前后共享这些条件,所以阴影变化由对象操作产生,而不是重新随机照明。
训练每个任务 100k 个编辑例,总计 400k 个有方向的任务例;v1 文字写为验证和测试生成 1,024 个场景,但没有把每个任务/每个 split 的完整计数表说清。当前代码验证加载器每个任务分别读取 seen 512 与 unseen 512。代码的 insertion 直接反转 removal 图像对,因此 400k 不能无条件理解成 400k 个互相独立的场景或 800k 张不重复渲染。


05 · 模型:空间图像条件与跨注意力条件
3DIT 沿用 Zero123 的 latent diffusion U-Net,不增加显式 3D decoder。它同时保留两条源图路径:VAE 潜变量保留空间布局,CLIP 图像 embedding 提供整体语义;再加入 CLIP 文本 tokens 与四维数值条件。U-Net 每一步预测目标潜变量中的噪声,最终由 VAE 解码器回到 RGB。
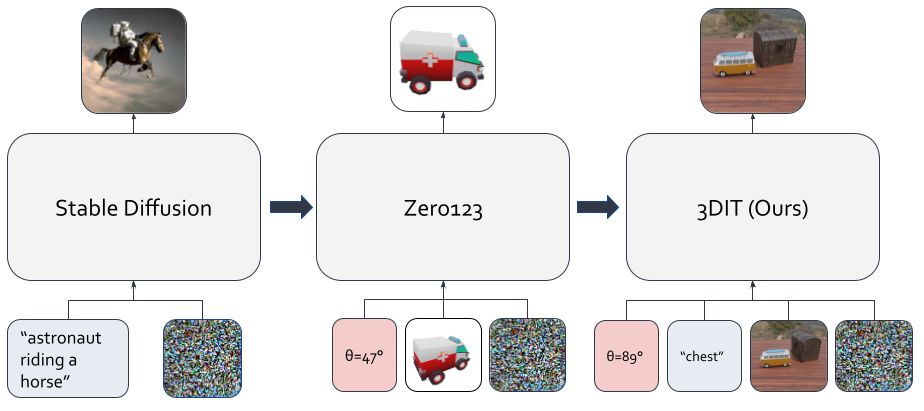
先理解论文描述,再对照公开张量路径
v1 描述:把 768 维 CLIP 图像特征与 4 维操作编码拼接为 772 维,经称为 MLP 的模块映射回 768 维,再拼上文本 token 条件。论文把条件写作 \(c(x_1,l,v)\in\mathbb{R}^{768\times N}\)。这是按“特征维 × token 数”记法表达的一串向量。
实现核查:仓库先把 CLIP 文本的 77 个 768 维 tokens 与 1 个 CLIP 图像 token 拼成 78 个,再把同一个四维操作向量附到每个 token后,统一经过单层 Linear(772,768)。因此它不是只投影图像 token,也不是多层非线性 MLP。对应代码张量顺序是 batch × 78 × 768。
\(W\) 是可训练的 768×772 投影矩阵,\(b\) 是偏置;\(C'_i\) 进入 U-Net 的 cross-attention。文本中的对象描述用于定位和属性区分,数值向量用于控制变换。没有语言模型解析器、chain-of-thought、工具调用或自动搜索程序。
这是对该 cross-attention 作用的标准数学解释,并非论文新增公式:中间图像特征 \(h\) 作为 query,条件 token 提供 key/value,使不同空间位置在去噪时选择与目标对象和操作相关的信息。它没有显式强制“只改某个掩码内的像素”,所以仍可能产生全局意外改动。
空间路径把带噪目标 latent 与原图 VAE latent 沿通道拼接。当前 YAML 的 U-Net 输入 8 通道、输出 4 通道,基础宽度 320、通道倍率 [1,2,4,4]、每层两残差块、8 个 attention heads、context dimension 768,启用空间 Transformer 和梯度 checkpoint。潜变量空间大小为 32×32;这不是以 Diffusion Transformer 替换 U-Net。
该式突出空间拼接机制。代码对目标 latent 使用 VAE 的 scale factor 0.18215,而源图拼接直接取编码分布的 mode;复现时应照实际张量路径检查数值尺度,不要只依据概念图把两条路径机械写成同一个缩放函数。
06 · 学习目标与完整训练配置
训练的目标潜变量应来自编辑后的图像 \(x_2\)。以 \(\bar{\alpha}_t\) 表示累计保留信号比例,\(\epsilon\sim\mathcal{N}(0,I)\) 表示采样噪声,前向加噪为:
模型必须结合原图与操作条件区分“保留内容”和“需要改动的内容”,而监督只通过目标图像的噪声回归进入;没有额外的显式深度、接触、法线、阴影或碰撞损失。几何能力主要来自初始化与渲染数据中的统计规律。
first_stage_key: image_target、默认 L2 噪声损失重写,不将原排版疑点默默当成正确训练定义。训练与采样配置对照
| 设置 | 论文报告 | 当前源码补充/边界 |
|---|---|---|
| 初始化 | Zero123 16,500-step checkpoint | train.sh 指向 zero123.ckpt;权重名本身不能验证16,500步身份 |
| 基础分辨率 | 256×256 RGB;32×32 latent | 4通道目标latent,空间拼接后U-Net输入8通道 |
| batch | effective 1,024;local 64;累积2次 | train.sh 指定8个GPU;64×8×2=1,024 |
| 硬件 | 原文写“40GB NVIDIA RTX A6000 GPUs” | 按论文原样记录;具体硬件型号/显存组合待核对运行日志 |
| 优化器 | AdamW | 调用未显式设betas/weight_decay;不把库默认值冒充论文报告 |
| U-Net学习率 | 1e-4 | base_learning_rate: 1e-4;关闭按批量缩放学习率 |
| 条件投影学习率 | 1e-3 | 优化器对cc_projection设为基础学习率10倍 |
| 训练长度 | 20,000 steps | 公开默认YAML/脚本未显式设置max_steps=20000 |
| 选择checkpoint | unseen验证集指标最好 | main.py 的monitor/save_top_k赋值被注释;未直接给出论文选择器 |
| 冻结 | 论文明确冻结CLIP text encoder | 代码还冻结CLIP image encoder与VAE;U-Net和投影训练 |
| 调度与warmup | v1未说明 | 公开YAML warm_up_steps=[100],注释却写10000;之后近似常数 |
| 前向扩散 | 正文沿用latent diffusion | 代码1,000 timesteps,linear_start=0.00085,linear_end=0.0120 |
| 精度/seed/耗时 | v1未完整说明 | train.sh seed=42;没有实际训练时长或显存测量 |
| 采样 | DDIM 200 steps;CFG=1.0 | demo默认50步/8候选;shell示例CFG=3.0,eta默认1.0 |
| 评估候选数 | 4 | run_eval.py 每例读取恰好4张,并按PSNR选最优 |
论文的 1,024 effective batch 与当前 8 GPU 脚本、每 GPU 64、累积 2 次一致:\(8\times64\times2=1024\)。若“20,000 steps”指 optimizer updates,则单次训练约对应 2,048 万次样本呈现;这是推算,不能直接写成作者报告的 epoch 数。单任务和多任务数据总量不同,相同步数也不代表相同 epoch。
冻结与可训练:论文明确冻结 CLIP text encoder。当前 YAML 把整个 conditioner 设为不可训练,VAE 也冻结,优化 U-Net 与数值投影层;use_lora: False,因此这份默认实现不是 LoRA 微调。CLIP 图像骨干为 ViT-L/14,文本模型为 openai/clip-vit-large-patch14,文本上限 77 tokens。
训练条件 dropout:代码默认 uncond=0.05。概率区间分别令 cross-attention 的全部 CLIP tokens 归零、源图空间 latent 归零或两者归零,各占 5%;其注释称“text/image dropout”,但 cross-attention 那组实际上同时包括文字与图像 token。操作向量仍被拼入。剩余 85% 保留完整条件。这是为 guidance 提供训练路径,不意味着论文测试用了大于 1 的 CFG。
未公开到可直接照抄的设置:v1 未给精确训练时长、实际显存峰值、总参数量、随机种子、AdamW 的 betas/weight decay、mixed precision 和完整 checkpoint 选择公式。公开代码补充了一些配置,但未给固定 20k 步终止或对应实验日志;不能借通用 Stable Diffusion 默认值补成作者的已验证运行设置。
v1 附录 §8.1 · 固定 YAML · 训练入口
07 · 推理、采样与一个可复核的运行流程
- 读入原图,转换 RGB、缩放到 256×256,再映射到 [-1,1];非正方形图像会被当前 demo 强制拉伸,应预先决定裁剪策略
- 用户给对象短描述,程序添加固定前缀:
rotate the、move the、insert the或remove the。角度和位置走独立数值路径,不需要把完整操作句重复塞进对象描述 - 提取冻结的图像/文本条件与源图 VAE latent,组装数值向量,经投影进入 cross-attention
- 从随机高斯目标 latent 开始,用 DDIM 反向去噪。论文协议为 200 步、CFG=1.0
- VAE 解码、裁剪到有效 RGB 范围、输出候选图像。没有 renderer-in-the-loop 验证,没有在线权重更新或 3D 资产重建
上式解释为什么论文称“不使用 classifier-free guidance”:比例为 1 时不放大条件差分。当前 demo CLI 却默认 50 DDIM 步、8 个候选,示例 shell 额外设置 CFG=3;sample_model 的 eta 默认 1.0。它们适合演示,但不能直接拿来复现 200 步、4 候选的论文评估协议。
论文未提供 temperature、top-k、top-p、beam search,因为它不是自回归语言 token 解码。best-of-four 是评估时借助 ground truth 的候选选择,普通用户没有 ground truth,不能在生产中原样使用该 oracle 排序。
generate_scripts/rotate.sh 写成 --task insert,同时加载 rotate.ckpt 并传旋转角度。按 run_generation.py 分支,这会走插入条件并忽略旋转角度。复现时应先核对任务参数,不应把这个演示脚本的异常输出归咎于论文方法。当前推理 CLI 仅列 rotate/remove/insert/translate,没有单独的 multitask 选项;已发布多任务权重的使用方式需要人工核对配置与加载日志。2026-09-30 所查官方 Hugging Face 根目录可见 insert、rotate、translate、multitask 和 zero123 权重,未在该根目录列表中看到独立 remove.ckpt;这里只记录查看范围,不断言所有渠道都没有 removal 权重。没有下载这些约 16GB 的 checkpoint,也未运行模型。
08 · Baseline:模块串联在哪里失去场景关系
v1 为四个任务构造四套零样本工具组合,受到 VisProg 和 Socratic Models 的模块化思想启发。对比意义是“用现成模型链能否完成同一任务”,而不是在相同 OBJect 数据上训练的等预算强基线。
| 任务 | 组合与关键启发式 | 预期失败点 | 公平性与复现边界 |
|---|---|---|---|
| Removal | SAM 先全图生成掩码,选包含给定点且面积不超过全图 1/3 的掩码;无结果则用点提示 SAM。用对象包围框区域做 SD inpainting | 对象阴影落在掩码外;补全被遮挡物体缺乏完整上下文约束 | 作者发现框比精细 mask 好;baseline 有点提示,当前 3DIT removal 实现没有该点 |
| Insertion | 在目标位置放 200×200 固定方形 mask,用 SD 和类别 prompt 生成对象 | 固定框不反映对象尺度、地面姿态或空间容纳关系 | 200×200 是论文 baseline mask 设置,不应无依据换算为 256 图上占比;完整 baseline 运行配置未随主代码给出 |
| Translation | OWL-ViT 以类别定位,SAM 分割,SD 修复原区域,再把原对象粘到目标位置 | 直接复制很难正确改变透视尺度、可见面与受光;阴影也难同步 | 分类提示和丰富人工对象描述的信息量不同;工具链误差与方法建模能力共同影响结果 |
| Rotation | OWL-ViT 定位、SAM 分割到白背景,Zero123 生成旋转后对象,再粘回并 SD 修复空洞 | 孤立对象的视角变化不等于完整场景中的刚体旋转;接地、遮挡、光照易不一致 | 需要多模型推理,但论文未报告公平的 GPU 时间/显存/候选数成本表 |
两个 SD 提示的语义分别是“没有物体的整洁纹理地面渲染”和“纹理地面上的指定类别三维渲染”。它们把修复目标偏向合成地板,也会影响真实照片上的泛化。这里没有把自行设计的新 prompt 冒充原实验配置。
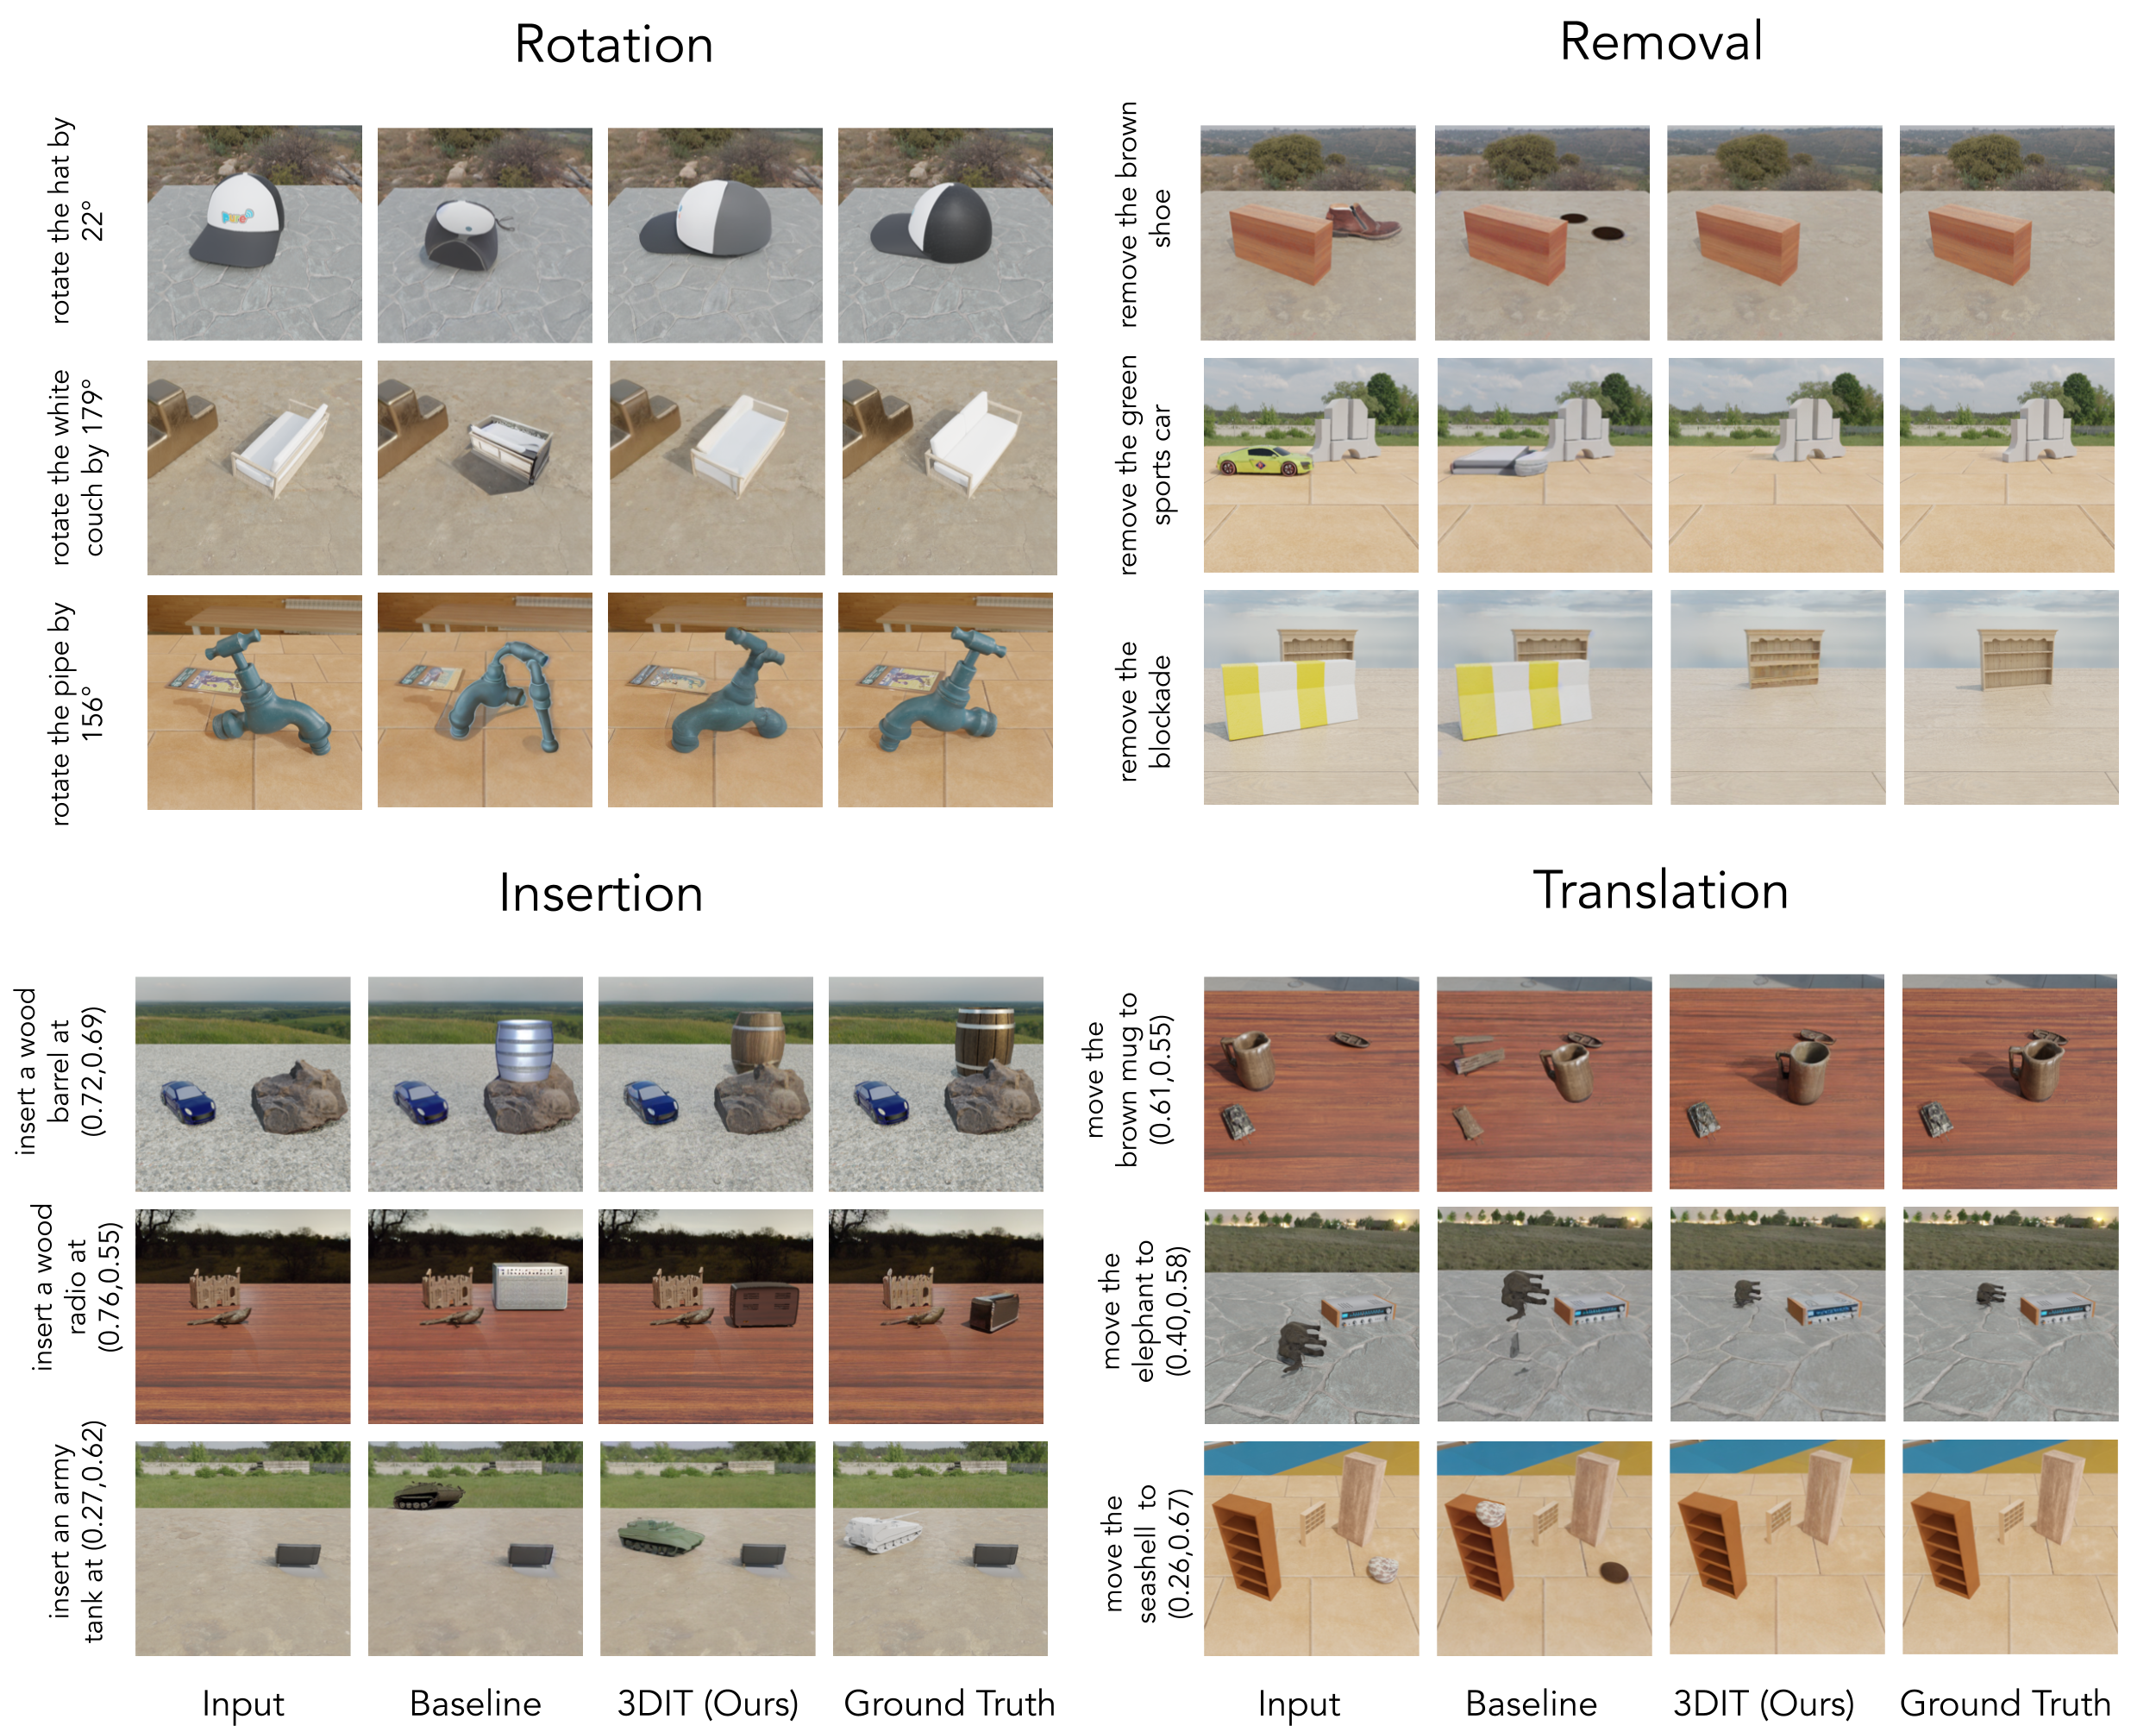
图 3 每个任务比较 Input、Baseline、3DIT、Ground Truth;观察时应同时看对象是否被正确指认、阴影是否消失或转向、空出来的遮挡区是否合理,而不能只看主体局部是否锐利。
09 · 自动评估:完整主表与协议冲突
论文采用 PSNR↑、SSIM↑、LPIPS↓、FID↓。前三项比较预测与对应 ground truth,FID 比较生成集和真实目标集的特征分布。v1 的表头拼写为 LPIP,本页沿用数值并注明它指 LPIPS;不凭数字的小量级推断其实现一定是标准 FID-2048。
这里 \(L\) 为像素动态范围;FID 的 \(\mu,\Sigma\) 取决于选用的特征提取层。不同特征维度、裁剪规则和样本数量会改变数值,不能把本表 0.x 直接与其他论文几十的 FID 横向比较。
run_eval.py 明确取 max(psnr_mask),与 caption 一致。我们保留原表,不把公开后版本的实现反向当成作者当年全部运行日志的替代品。v1 Table 1 · 全部自动评估结果
| 任务 | 方法 | Seen PSNR ↑ | Seen SSIM ↑ | Seen LPIPS ↓ | Seen FID ↓ | Unseen PSNR ↑ | Unseen SSIM ↑ | Unseen LPIPS ↓ | Unseen FID ↓ |
|---|---|---|---|---|---|---|---|---|---|
| Translation | Baseline | 13.699 | 0.309 | 0.485 | 0.942 | 14.126 | 0.326 | 0.467 | 0.968 |
| Translation | 3DIT (1-task) | 14.546 | 0.273 | 0.494 | 0.254 | 14.400 | 0.262 | 0.498 | 0.261 |
| Translation | 3DIT (Multitask) | 15.21 | 0.300 | 0.472 | 0.244 | 15.200 | 0.292 | 0.477 | 0.253 |
| Rotation | Baseline | 13.179 | 0.269 | 0.540 | 0.997 | 12.848 | 0.270 | 0.538 | 1.693 |
| Rotation | 3DIT (1-task) | 16.828 | 0.386 | 0.428 | 0.291 | 16.293 | 0.372 | 0.445 | 0.280 |
| Rotation | 3DIT (Multitask) | 16.859 | 0.382 | 0.429 | 0.248 | 16.279 | 0.366 | 0.447 | 0.236 |
| Insertion | Baseline | 12.297 | 0.269 | 0.594 | 0.969 | 12.542 | 0.275 | 0.584 | 1.325 |
| Insertion | 3DIT (1-task) | 13.469 | 0.267 | 0.549 | 0.254 | 12.974 | 0.261 | 0.566 | 0.233 |
| Insertion | 3DIT (Multitask) | 13.630 | 0.263 | 0.551 | 0.222 | 13.088 | 0.261 | 0.568 | 0.214 |
| Removal | Baseline | 12.494 | 0.383 | 0.465 | 0.801 | 12.123 | 0.379 | 0.459 | 1.047 |
| Removal | 3DIT (1-task) | 24.937 | 0.588 | 0.254 | 0.241 | 24.474 | 0.561 | 0.260 | 0.258 |
| Removal | 3DIT (Multitask) | 24.980 | 0.585 | 0.249 | 0.236 | 24.661 | 0.568 | 0.260 | 0.240 |
原 v1 Table 1 的全部 12 个方法行、seen/unseen 的 8 个指标列。每个任务与数据 split 内,粗体绿色为最好、下划线为次好,并列均保留;“最好”只按该列指标方向计算。
数字实际支持什么
- Removal 的改进最突出:seen 单任务 PSNR 由 12.494 到 24.937,增加 12.443 dB;unseen 多任务由 12.123 到 24.661,增加 12.538 dB。它说明这套数据和 ROI 协议下,端到端学习比简单分割修补有效。
- Rotation 稳定改善:seen 多任务 PSNR 从 13.179 到 16.859,增加 3.680 dB;unseen 从 12.848 到 16.279,增加 3.431 dB。LPIPS 和 SSIM 也相对 baseline 改善。
- Translation 有明确取舍:seen 多任务 PSNR 更高、LPIPS 更低,但 SSIM 0.300 仍低于 baseline 0.309;unseen 多任务的 SSIM 0.292 低于 0.326,LPIPS 0.477 也差于 0.467。单任务 translation 的 LPIPS 两个 split 都差于 baseline。
- Insertion 不是全指标领先:seen/unseen 的 baseline SSIM 分别 0.269/0.275,均高于两个 3DIT 变体;3DIT 的 PSNR、LPIPS 和表中 FID 则更好。
- 多任务没有普遍负迁移:PSNR/FID 往往接近或优于单任务,但旋转和插入的部分 SSIM、LPIPS略退化。不能把“一个模型支持四任务”写成“每项质量都更好”。
因此 v1 正文“所有任务在 PSNR、SSIM、LPIP 上都优于 baseline”的概括过强。其 FID 段落还一边写 baseline FID 更高,一边用剪贴保真解释模型更容易降低图像保真;这段文字与表内 FID 方向不构成一致的因果证据,应直接回到指标实现与实际数值。
当前公开评估脚本的关键细节
- 每个 UID 强制读取 0.png–3.png 共 4 个候选,使用 max PSNR 的同一个候选计算所有最终指标
- PSNR/SSIM/LPIPS 在目标物体 mask 的矩形 ROI 上计算;removal 取删除前的 mask;若 mask 空则回退为整图。translation 的 mask 来自目标位置,因此旧位置残影或远处阴影不一定完整进入 ROI
- FID 实际传入选中的整幅图像,并使用
FrechetInceptionDistance(feature=64),与“全部指标都只看编辑区域”的文字不能完全等同 lpip返回-lpips(x,y),而论文表给正数、方向向下。要复现原表,必须确认日志符号转换,不能直接把输出 JSON 的负值贴进论文式表格- ROI 的
fix_bounds包含最小尺寸扩展;y 分支的边界条件引用 x 变量,且 Python 切片排除上界。属于应审计的实现细节,本次未运行模型来量化其影响
评估含义:best-of-four 使用真值,是带额外采样预算的 oracle 上界;用户实际选择可能只看到输入与指令。图像相似度也不能分辨“轮廓正确但物体身份变了”和“物理不正确但像素很像”。最合理的报告应同时保留单样本、best-of-four、局部编辑和全局保留四种视角。
10 · 人工偏好、场景能力与真实照片迁移
人工实验给出两张候选图,并要求参照 ground truth 选择几何更正确或光照更正确的一张,也允许 Tie。每种成对评估使用 30 个测试样本;比较的是单任务 3DIT和相应 baseline。几何标准包括尺度、位置、接地和遮挡关系;光照标准包括目标与其他对象的阴影方向、大小及显露变化。
v1 Table 2 · 人工偏好(%)
| 任务 | 几何:Baseline | 几何:3DIT | 几何:Tie | 光照:Baseline | 光照:3DIT | 光照:Tie |
|---|---|---|---|---|---|---|
| Translation | 20.0 % | 73.3 % | 6.6 % | 3.3 % | 80.0 % | 16.6 % |
| Rotation | 3.3 % | 80.0 % | 16.6 % | 6.6 % | 73.3 % | 20.0 % |
| Insertion | 13.3 % | 70.0 % | 16.6 % | 10.0 % | 73.3 % | 16.6 % |
| Removal | 3.3 % | 86.6 % | 10.0 % | 0.0 % | 86.6 % | 13.3 % |
3DIT 的几何偏好为 70.0%–86.6%,光照偏好为 73.3%–86.6%。这是相对于这些 baseline 的偏好比例,不是严格物理正确率。按 30 例换算,70%约为21例,86.6%约为26例;1例就相当于约3.33个百分点。原表一位小数舍入使部分行和为99.9%,本页不强制修成100%。
样本数量很小,文中未充分报告每例评价人数、评价者独立性、置信区间、左右顺序随机化与一致性。Tie 既可能表示两个结果都坏,也可能表示都好,混在一起不能作为成功率。对复杂真实照片的定量结论尤其应保守,因为本人工比较主要围绕 OBJect 测试样本。
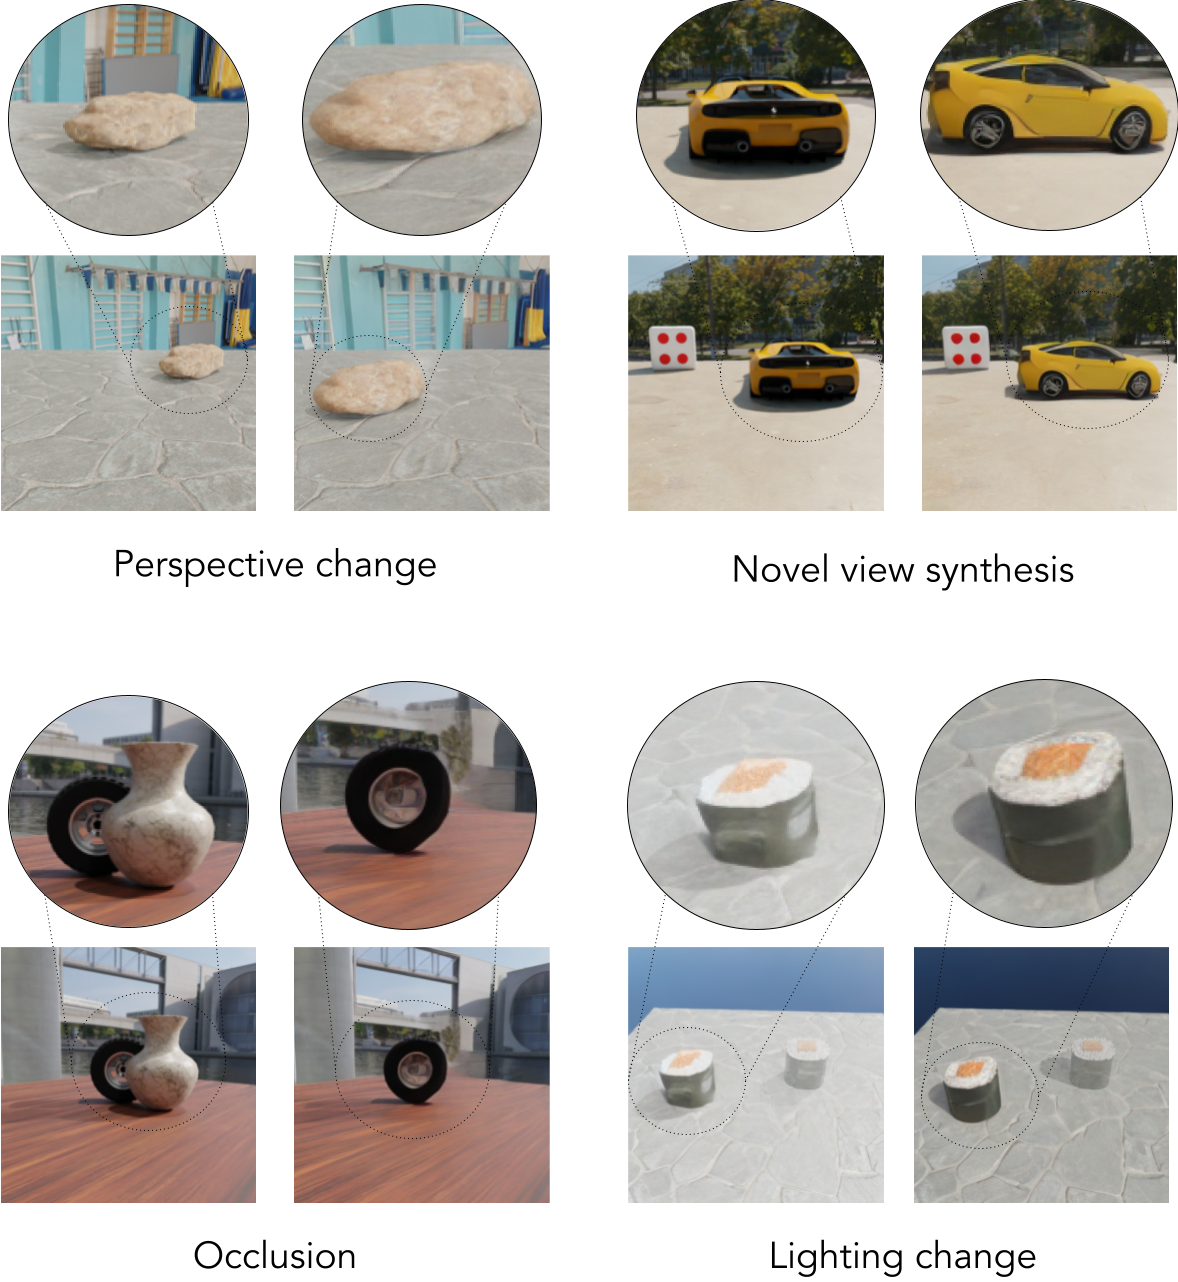
图 4 分别展示透视尺度、新视角合成、遮挡补全和照明/阴影调整。它们说明模型可以出现期望行为,而不证明所有图像都满足同样约束。
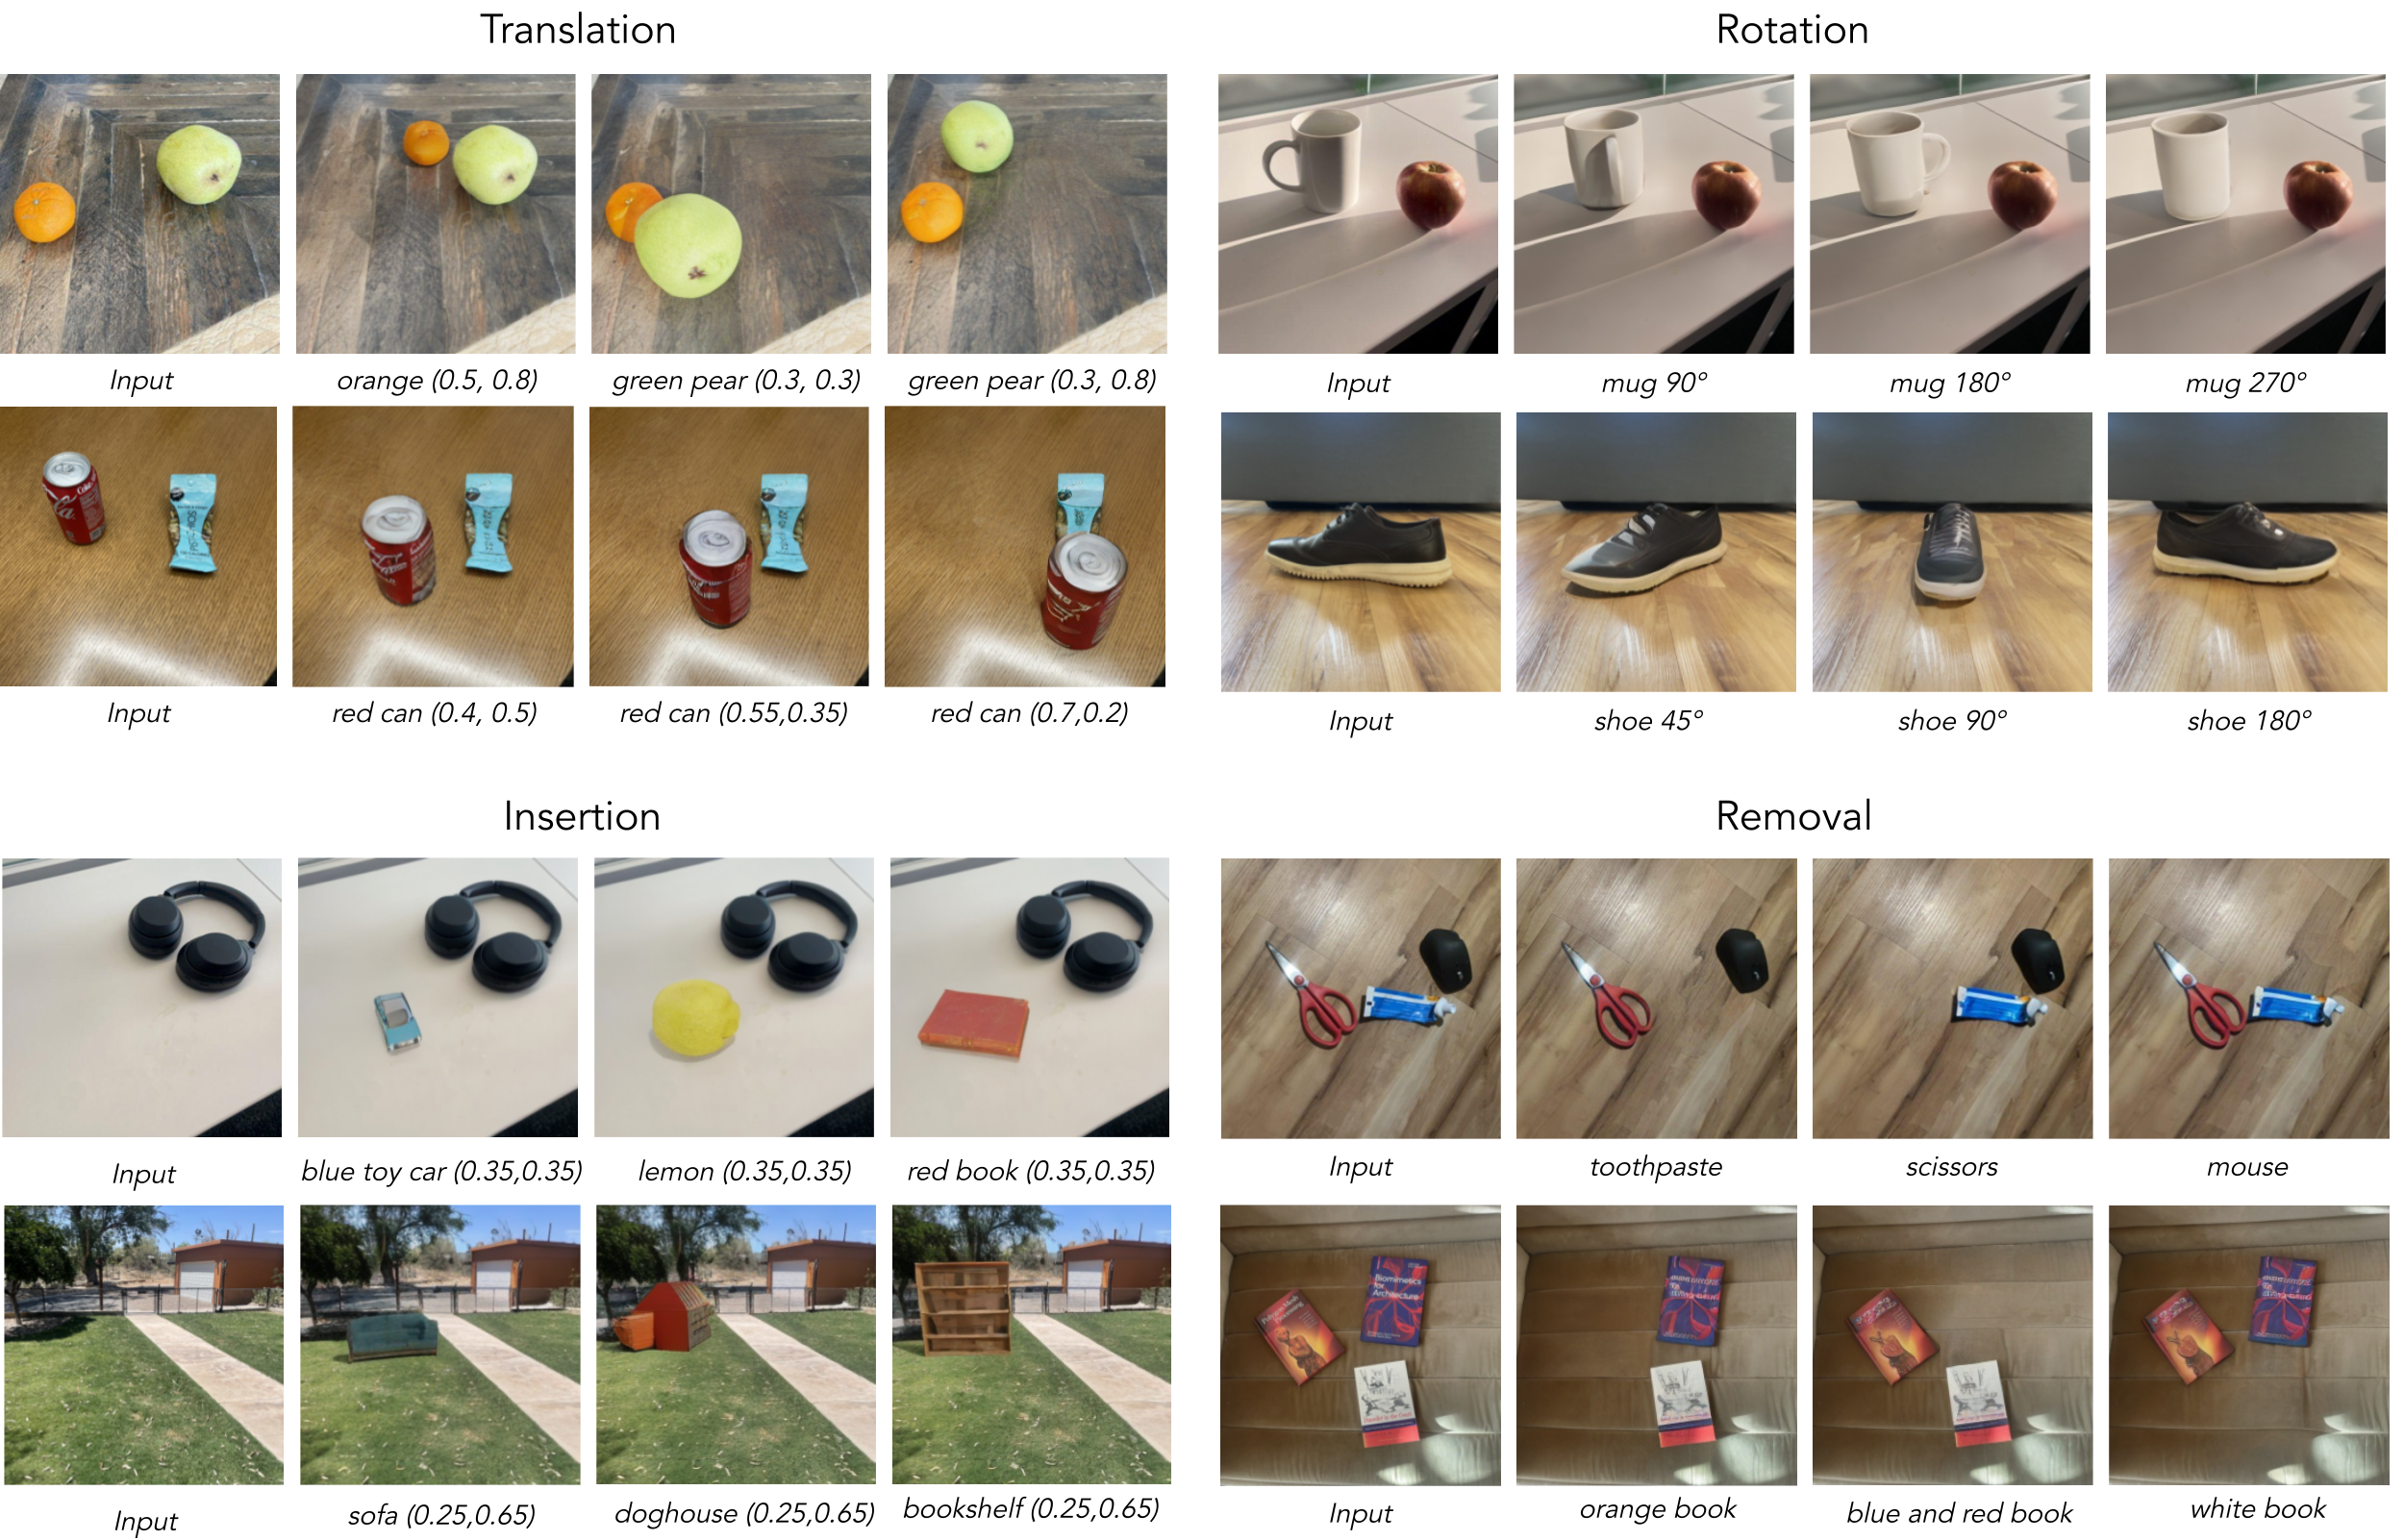
图 5 用同一真实输入的多组角度、位置或对象描述展示可控性;训练没有使用真实编辑对,但基础扩散权重已经学习了真实图像分布。因此更准确的说法是“只用合成编辑监督进行适配后,保留并迁移到真实图像”,而不是“模型一生从未见过真实图片”。CLEVR 也主要通过示例展示,没有独立列出的完整定量结果表。
11 · 鲁棒性与后续正式版消融
v1:场景复杂度和旋转幅度


Figure 6 的单任务旋转 Mask PSNR 随物体数从 1 到 4 略降;原柱状图没有标注精确数值,故这里保留原图和趋势,不把肉眼估读伪装成精确表。Figure 7 的六个角度桶分别为0–60、60–120、120–180、180–240、240–300、300–360度;颜色表示平均 Mask PSNR,扇区面积并不表示样本占比。接近0°或360°较容易,中间的大视角变化更难。两图都没有给误差条或各桶样本数。
这是按属性分组的鲁棒性分析,不是“移除某组件”的因果消融。物体更多也可能伴随遮挡、目标尺寸等其他变化;角度和外观可见性同样耦合。v1 没有系统分别去掉文本、数值、图像 latent、照明多样性或 Zero123 初始化。

NeurIPS 2023 正式版新增:初始化比较
以下为正式版附录 §8.4、Table 3,不属于固定 v1 的 Table 3。它比较 Image-conditioned Stable Diffusion、Zero123、Zero123-XL(后者基于更大的 Objaverse-XL 资产集合)三种初始化,保留全部四任务、seen/unseen 的八列指标。
正式版 Table 3 · 初始化消融,全部行列
| 任务 | 方法 | Seen PSNR ↑ | Seen SSIM ↑ | Seen LPIPS ↓ | Seen FID ↓ | Unseen PSNR ↑ | Unseen SSIM ↑ | Unseen LPIPS ↓ | Unseen FID ↓ |
|---|---|---|---|---|---|---|---|---|---|
| Translation | SD | 14.373 | 0.264 | 0.510 | 0.101 | 14.351 | 0.253 | 0.510 | 0.102 |
| Translation | Zero123 | 15.210 | 0.300 | 0.472 | 0.244 | 15.200 | 0.292 | 0.477 | 0.253 |
| Translation | Zero123-XL | 15.121 | 0.294 | 0.477 | 0.252 | 15.052 | 0.286 | 0.478 | 0.239 |
| Rotation | SD | 15.074 | 0.368 | 0.430 | 0.089 | 14.558 | 0.359 | 0.438 | 0.095 |
| Rotation | Zero123 | 16.859 | 0.382 | 0.429 | 0.248 | 16.279 | 0.366 | 0.447 | 0.236 |
| Rotation | Zero123-XL | 15.433 | 0.381 | 0.420 | 0.241 | 15.008 | 0.378 | 0.429 | 0.243 |
| Insertion | SD | 13.220 | 0.253 | 0.570 | 0.108 | 13.131 | 0.255 | 0.572 | 0.100 |
| Insertion | Zero123 | 13.630 | 0.263 | 0.551 | 0.222 | 13.088 | 0.261 | 0.568 | 0.214 |
| Insertion | Zero123-XL | 13.481 | 0.264 | 0.557 | 0.274 | 13.094 | 0.259 | 0.566 | 0.258 |
| Removal | SD | 23.882 | 0.576 | 0.263 | 0.117 | 23.352 | 0.542 | 0.270 | 0.115 |
| Removal | Zero123 | 24.980 | 0.585 | 0.249 | 0.236 | 24.661 | 0.568 | 0.260 | 0.240 |
| Removal | Zero123-XL | 24.775 | 0.585 | 0.255 | 0.247 | 24.830 | 0.568 | 0.253 | 0.215 |
数字也不支持“Zero123 在所有方面最好”。SD 初始化的 FID 在全部任务与两个 split 都最低;Zero123 通常提升 PSNR,但有插入 unseen 等例外。Zero123-XL 在 unseen removal PSNR(24.830)、LPIPS(0.253)和 FID(0.215)比 Zero123 更好;rotation 的部分 SSIM/LPIPS也更好。作者“更强单物体 base model 没有整体提升”的结论可以作为综合观察,但不存在一个所有指标一致排序的赢家。
NeurIPS 正式版新增:失败归因
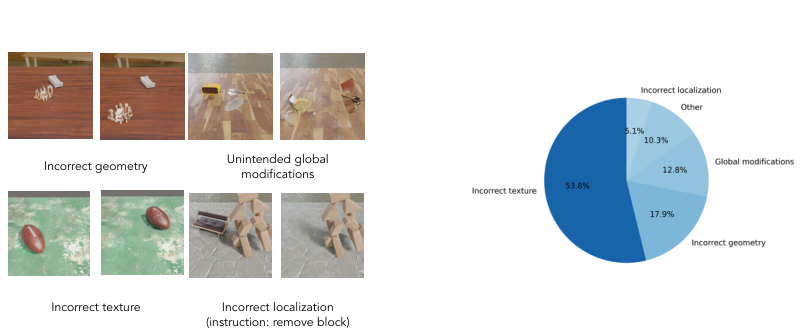
正式版 Figure 9 · 错误类别百分比重建
| 错误类型 | 原图占比 | 解读 |
|---|---|---|
| Incorrect texture | 53.8% | 表面细节/身份未保留 |
| Incorrect geometry | 17.9% | 对象形状错误 |
| Global modifications | 12.8% | 改动了不应编辑的区域 |
| Other | 10.3% | 原图未进一步细分 |
| Incorrect localization | 5.1% | 操作了错误对象 |
正式版 Figure 9 说明检查了50个随机输出,但图中百分比是错误类型的分布,未清楚给出所有输出中有错比例及多重错误计数规则。不能读成“53.8%的所有测试图都纹理失败”。主要风险是对象纹理/身份漂移,其次是几何失真、无意全局改动与错误定位。图表为作者诊断;本页没有独立重跑并归类50张输出。
12 · 论文与实现:复现前必须固定的边界
本次源码核查固定在官方提交 054bb09b8989754169a49bdce73bb767d745750b。读取了训练/推理/评估入口、全部任务 YAML、任务数据集、CLIP 编码和 U-Net 条件/损失/优化器的相关路径;未安装环境、下载大权重或执行 GPU 推理。因此下述结论是可定位的静态证据,不冒充端到端复现成功。
关键复现差异
| 项目 | 论文/旧记录 | 公开证据 | 处理原则 |
|---|---|---|---|
| 论文身份 | 原note写2024 | 官方proceedings为NeurIPS2023 | 建议更正年份;原note字节不改 |
| 资产规模 | 正文59k;附录62,950 | 项目约62k;注释文件名64k | 不能当作同一精确计数 |
| Removal条件 | v1 §4含点坐标 | 数据与demo用全零4D向量 | 单独报告输入信息差异 |
| 条件融合 | 图像投影后追加文本;称MLP | 78个token都追加操作向量,单层Linear | 复现以实际checkpoint架构为准 |
| loss公式 | 期望下标写源图x1 | first_stage_key是目标image_target | 按目标噪声回归理解并明示勘误 |
| 候选选择 | 表注PSNR;正文SSIM | max psnr_mask | 报告协议冲突,不偷偷统一原文 |
| FID | 正文称编辑区域指标 | 全图,feature=64 | 不能与标准FID-2048直接比较 |
| LPIPS | 表值为正,越小越好 | 函数返回负号 | 核对日志符号,禁止直接混填 |
| 推理设置 | 200步/CFG1/评估4候选 | demo50步/8候选,shell CFG3 | 演示默认不等于实验配置 |
| 旋转demo | 应旋转指定对象 | rotate.sh设置task=insert | 运行前修正并记录,不当成论文性能 |
| 初始化消融标签 | 正式版Table3称single-task | Zero123行等于主表multitask行 | 缺少日志,归因保留不确定性 |
| 训练结束/选择 | 20k步、unseen验证最优 | 默认入口未固定20k,monitor逻辑被注释 | 需补齐实验运行约束 |
可交给复现者的最小核对顺序
- 锁定实验版本:先声明复现 v1 表还是正式版扩展表,记录代码 commit、权重 hash、seen/unseen UID 清单和数据版本。图片、数据许可与模型许可分别核查。
- 先验证一个样本的条件:确认旋转用 rotate 任务、角度转弧度后进正余弦;移动/插入的位置在[0,1];删除条件是文字加全零向量。直接检查训练和推理的 token 拼接是否一致。
- 校准输入预处理:训练 resize 与推理强制256×256并不保证非正方形图同样处理;验证RGB值域、latent缩放和mask色彩解码,不只看文件是否能打开。
- 先测评估器:用预测等于真值、明确错位、空mask与边缘小mask等例子检查PSNR/SSIM/LPIPS的符号和ROI,确认FID-64的全图协议。公开
preprocess_mask把8-bit RGBA数组与0–1颜色常量比较,也值得核实范围是否需归一化;本次未验证其对真实掩码的影响。 - 显式设置论文采样参数:200 DDIM steps、CFG=1、每个例子4候选;记录随机seed和eta。输出单候选平均及oracle结果,避免只报告最优样本。
- 训练时补齐运行约束:显式设20,000 optimizer steps、记录8×64×2的批量、验证集选择规则、精度、实际硬件、训练耗时。YAML的warmup注释与数值不同时以执行值为准并说明。
- 重新检查真实图像:逐任务报告定位、纹理、几何、阴影、背景保留与失败率,不能用几张成功图代替平均质量。
代码的读取失败处理会把出错样本替换为第一个样本,目录枚举又使用未排序的 os.listdir 后截取数量。规模化复现时应把坏样本显式记录并冻结清单,否则可用样本数、顺序和重复次数可能与预期不同。配置也没有暴露完整的原始 Blender 合成流水线;当前仓库可复现训练与推理框架,并不意味着所有资产过滤和场景生成细节都已可一键重建。
固定代码树 · README · 任务与 mask 加载
13 · Reviewer 视角:贡献成立,但证据要按层级阅读
Strengths
可执行环境驱动的数据设计很有价值。一次真实的场景变换自然产生对象外观、阴影、遮挡的联合目标,优于分别给每种像素变化造规则。四个任务共享统一的图像条件与语言/数值接口,多任务结果表明这种统一并不必然牺牲全部单任务性能。数据的类别留出、定量表、几何/光照人工标准和迁移示例,从不同角度提供了证据。
建模改动克制。复用 Zero123 的图像 latent 条件与跨注意力,加入文字指认能力,说明合理监督与已有先验组合可以使模型出现更完整的场景编辑行为。其研究贡献主要是任务、数据和系统适配,而非全新扩散理论或显式三维表示。
Weaknesses
- 协议与实现不一致:PSNR/SSIM候选选择、FID范围/维数、LPIPS符号、removal点条件、单任务/多任务消融标签,均会直接影响结论解释。
- 基线公平性有限:主模型有数十万合成编辑例监督,baseline主要是现成模型拼接;没有等数据、等采样、等算力下的现代图像编辑器对照。
- “3D-aware”缺少几何闭环:看起来接地的图像未必对应某个一致3D场景;未报告旋转再旋回、组合操作交换性、多视角重建一致性或几何误差。
- 真实世界证据主要定性:少对象平面场景、高仰角与相近尺寸都缩小了sim-to-real距离;复杂照片、多个同类目标和多步编辑的失败分布尚不足。
- 评价偏向目标ROI:远处阴影、非目标物体漂移和旧位置残留可能被低估;最终用户更在意完整图像是否仍可信。
- 复现成本透明度不足:没有完整运行日志和耗时,公开demo与论文采样配置不同,正式版消融也存在表注歧义。
最有信息量的追加实验
优先补一个版本锁定的评估包,报告相同4候选预算下每个方法的单样本均值与oracle差距,并明确FID-64/2048、全图/ROI。再做去文本、去数值、去源图latent、SD/Zero123初始化、无阴影/固定光/随机光的成套消融。最后对100个以上真实编辑例做盲评,按任务和目标属性分层,给出置信区间及纹理、几何、定位、全局保留失败率。
总体判断:它充分说明程序化反事实监督可改善单图对象编辑,尤其是删除和旋转;它尚未证明通用、可度量精度的三维操作器。研究价值在于把“动作引起的完整像素后果”教给生成模型,而不是输出可验证的物理场景。
14 · 面向 Procedural Material Generation 的研究延伸
RESEARCH EXTENSION · 以下设计未在本论文中验证
对程序化材质研究,最可迁移的不是它的对象旋转接口,而是在可执行图形环境中制造仅一个因素变化的成对监督。设材质图 \(G=(V,E)\),节点参数为 \(\theta\),几何/相机/照明条件为 \(\omega\),渲染器为 \(R\)。给定材质编辑指令 \(l\),先在可执行图或参数上做变换 \(T\),再渲染:
例如“只增大裂纹尺度”“减小粗糙度”“保持木纹方向但提高凹凸幅度”。保持 \(\omega\) 不变能控制图像差异来自哪类材质修改;同时随机化几何、光照和尺度,防止网络把“更亮”当作“更光滑”。这类数据可以训练材质外观编辑器,也可以监督图程序的局部修改。
方向一:从对象描述条件转向 typed graph edit
将自然语言先映射为有类型的编辑动作,例如修改某个 roughness 节点的参数、替换 noise 频率或添加合法的 blend 分支。动作只允许连接兼容的通道/尺寸类型,再由 Substance Designer、DiffMat 或独立图执行器验证。图拓扑、节点顺序、边引用和参数范围应在结构层面保证,不能期待RGB扩散输出自动具备这些性质。
\(\mathcal C\) 是类型正确、可执行、参数合法的图集合;\(\mathcal L_{\mathrm{edit}}\) 度量目标属性变化,\(\mathcal L_{\mathrm{keep}}\) 约束未编辑属性,\(\mathcal L_{\mathrm{phys}}\) 检查物理边界,\(|V|\) 惩罚过大图。多照明集合 \(\Omega\) 防止只匹配一张图片。它是后续系统的优化定义,原 3DIT 没有图搜索、编译器或这些损失。
方向二:把“局部修改”定义在材质属性而非图像掩码上
对象编辑的数据揭示,一个局部原因可能造成远处阴影变化;材质编辑同样如此,改变金属度会同时影响多个位置的高光。可把保持约束分别作用于几何、albedo、normal、roughness及频谱结构,允许渲染结果出现必要的全局光传输变化。只用图像外mask保持损失,可能反而惩罚正确的反射变化。
方向三:加入组合、可逆性和循环检查
对于可逆参数编辑,先变粗糙再恢复、先旋转纹理再旋回,应该回到同一材质;对于不可逆拓扑删除不强制该约束。与3DIT的单次图像质量相比,这能检验程序编辑是否保持身份和可继续操作性。再引入不同编辑顺序的可交换性测试,区分本应独立的参数是否被错误耦合。
一个最小、可证伪的实验计划
| 环节 | 设计 | 要检验的假设 |
|---|---|---|
| 数据 | 同一材质图跨多几何、多灯光渲染,分别编辑颜色、粗糙度、法线幅度、纹理尺度;按图家族留出 | 学到编辑属性,还是记住渲染外观/模板? |
| 基线 | 纯RGB条件扩散;固定拓扑参数回归;图编辑+执行;图编辑+多视图验证 | 图约束和renderer反馈分别贡献多少? |
| 指标 | 目标属性误差、未改通道误差、跨光照一致性、图有效率、节点数、时间、用户偏好 | 画面好看是否对应可复用资产? |
| 消融 | 去照明随机化、去保留约束、去类型约束、单视图/多视图验证、不同候选预算 | 收益来自哪一项,是否只是增加搜索成本? |
| 失败定义 | 错误通道、贴图烘焙阴影、拓扑非法、属性互相污染、跨尺度失效 | 提前定义失败类别,避免只展示成功样本 |
对本项目最值得借鉴的一条经验是:先让编辑在一个有明确语义的可执行表示上成立,再用渲染监督或验证它的视觉结果。如果最终只保留RGB结果,3DIT展示的纹理身份漂移和全局意外变化也可能在材质工作流里再次出现。
15 · 来源、复核范围与归档建议
- 固定主 PDF:2307.11073v1,18页,全文与附录已读;SHA-256:
a03d174cb2dc27d6d28e5b1126630ecb445dc18ee47070909761c7c3701bd523 - 同版本 arXiv HTML,交叉核对三张表及原图资源
- NeurIPS 2023 官方 proceedings;20页正式版 PDF,用于新增失败分析、初始化消融及年份核实
- AI2 官方项目页,数据、模型示意和原论文图组
- 官方源码固定提交,2024-04-30;当前实现与2023年论文描述分别标注
- 官方数据与checkpoint目录,读取目录和元数据,未下载大型数据或权重
归档建议:复用已有 PDF 与唯一论文 note,保留原文字、旧图片和所有 PDF++ 锚点。建议把发表年份更正为2023,并继续将Tanmay Gupta标成未核实通讯候选;作者链接复用Oscar Michel,检查并复用Tanmay Gupta的人物记录。当前交付为新增精读Markdown和保持原文字节前缀的合并候选,未写回仓库或共享人物/索引。
验收范围:已完成内容和数值静态核对、HTML结构/导航/公式源码检查、文件大小检查以及外链原图HTTP与解码检查。浏览器MathJax执行、实际图片加载与1440/760/390px布局验收依用户安排,待下载后进行;本页不把静态检查标记成浏览器通过。