01 · 先给结论与版本边界
OminiControl 把控制图像当作另一组可参与自注意力的视觉 token:复用 FLUX 的 VAE 与 Transformer,只在条件分支启用低秩适配,用位置索引决定“逐位置对应”还是“跨位置寻找同一主体”。它的价值在于统一条件接口与降低额外参数,而不是把所有控制任务塞进一个无需切换权重的万能模型。
阅读对象:arXiv 2411.15098v5,PDF 标示 2025-03-11;共 18 页,其中正文与参考文献 11 页、合订补充材料 7 页。作者依次为 Zhenxiong Tan、Songhua Liu、Xingyi Yang、Qiaochu Xue、Xinchao Wang,均列 National University of Singapore。初稿发表于 2024 年;后续正式收录 ICCV 2025,页码 14940–14950。本文所有主实验以 v5 为准,后续会议版与仓库更新不回填为 v5 实验。
源与实现的时间切片:审计官方仓库在 v5 日期前最近的 commit 21e5420a19512eb4003a243d6b9f16d925416a47(2025-03-05)。这只是可核验的历史快照,不能保证恰为论文训练提交。另查当前 65d929e390a3f785b11e71344de082bb58a2c527(2026-07-02)的公开说明,专门标记 OminiControl2、Art、1024 权重与新版本依赖,避免混淆。
固定 PDF · 固定 HTML · ICCV 正式书目 · 历史实现
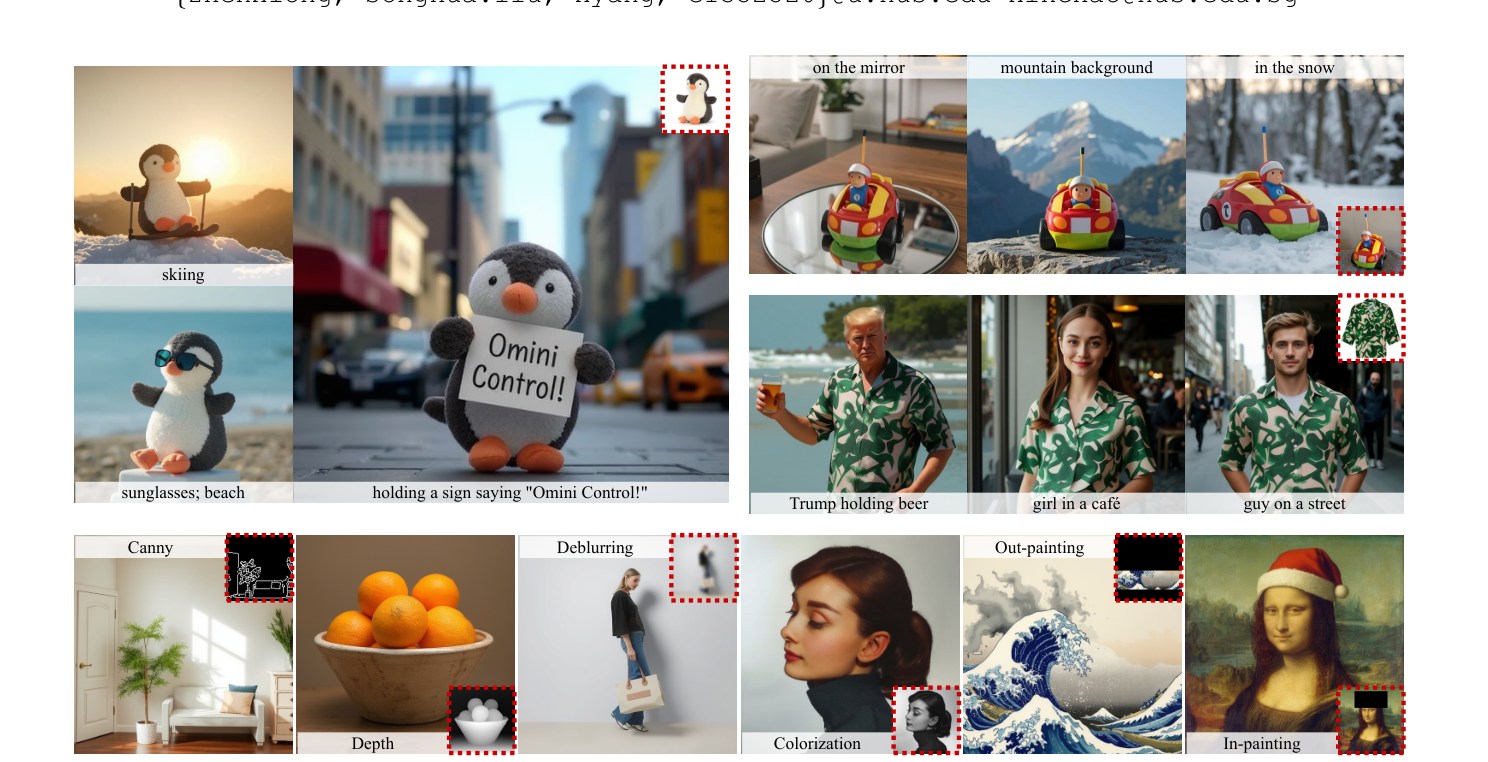
证据标签:下文以“论文事实”表示 v5 可直接核实内容;“作者解释”表示其机制解释;“我们的分析”表示推导或批判;“研究延伸”均为待实验假设。主图 1 展示同一框架的主体、边缘、深度、修复、去模糊与着色能力,不能单凭这些样例证明多条件同时控制或所有对象类别均泛化。
02 · 为什么简单的 concat 值得研究
文本条件善于描述“要什么”,不擅长精确指定轮廓、纹理身份与局部位置。传统控制方案常为不同输入增加专用编码器或控制网络:ControlNet/T2I-Adapter 的空间特征相加适合 edge/depth;IP-Adapter 的图像编码器与额外注意力更适合参考外观。它们在 UNet 上形成的设计习惯,不一定是 DiT 上最省参数、最灵活的接口。
本文的假设是:预训练 DiT 已会处理图像 latent 与文本,额外图像也可映射进同一个视觉 latent 空间,利用现成注意力学习对应关系。需要研究的不是“能否连接张量”,而是连在 channel 还是 sequence、条件是否保持独立状态、位置是否重叠、在哪些层交互、哪类 token 允许 LoRA 改写。
| 条件方式 | 约束与代价 | 本文切入点 |
|---|---|---|
| 特征直接相加 | 隐式要求空间位置与特征含义对应;参考主体换位置时容易冲突 | 保留两组 token,让注意力选择对应关系 |
| 通道拼接 | 每个位置接收额外通道;通常要求对齐,需适配输入投影 | 沿 token 轴扩展序列,不要求条件和输出一一对应 |
| 额外 CLIP 图像编码器与 adapter | 引入独立表示与参数,可能弱化局部精细信息 | 复用现有 VAE 的空间表征 |
| 复制控制网络 | 适配参数多;参数少与运行少是两回事 | 共享基础权重、条件分支小 LoRA,全深度处理 |
我们的分析:这不是“无需架构实现改动”。模型权重结构可高度复用,但 forward、RoPE、attention mask、分支 LoRA 开关与输出切片都要改变。更准确的 minimal 是新增可学习模块很少,而不是任意原生 FLUX pipeline 直接 concat 就能运行。
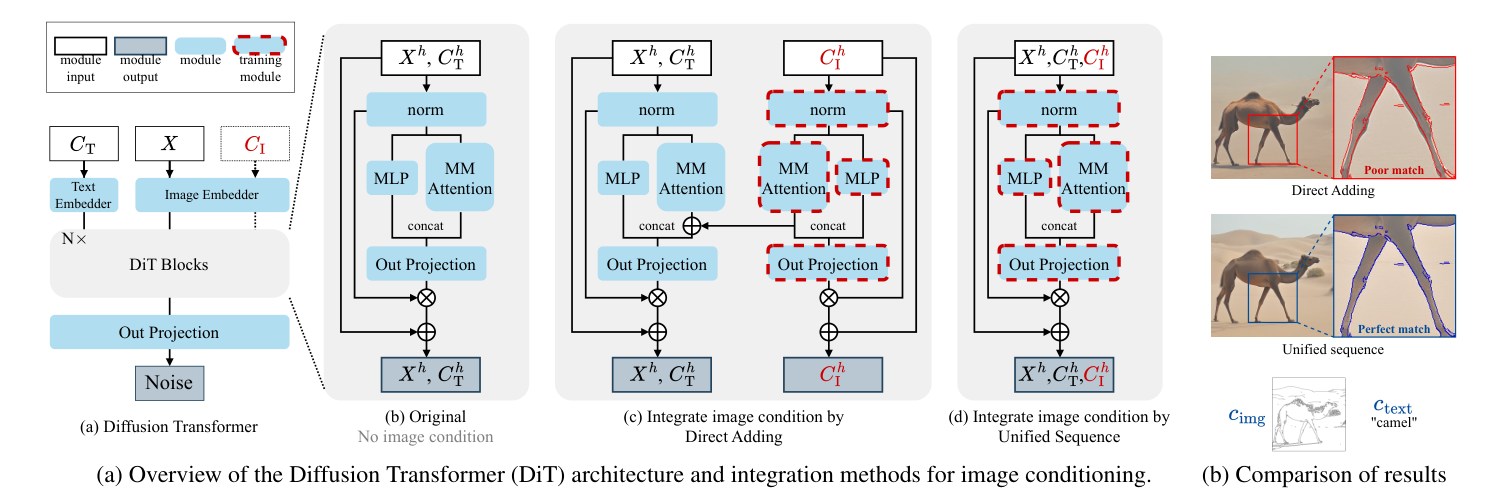
来源:v5 §1、§2、§3.2、Figure 2;方法原文
03 · 输入、输出与 token 到底是什么
输入是文本提示 \(c_T\)、控制图像 \(I_C\) 与随机初始噪声;输出是受控 RGB 图像 \(I_{\mathrm{out}}\)。控制任务包括 aligned 的 canny、depth、mask、colorization、deblur,以及不要求参考与输出坐标相同的 subject-driven generation。每次推理不需要为新主体再训练 DreamBooth,但任务 LoRA 本身已经训练过。
| 符号 | 含义与维度 | 需要避免的误解 |
|---|---|---|
| \(z_0,z_t,z_1\) | 干净目标 latent、时刻 t 的混合 latent、Gaussian noise | 这里是 rectified flow 路径,不能直接抄成 DDPM epsilon 目标 |
| \(X\in\mathbb{R}^{N\times d}\) | 投影后的目标噪声图像 token | 并非原始 RGB 像素 |
| \(C_I\in\mathbb{R}^{K\times d}\) | 由同一 VAE 编码并打包的干净控制图像 token | 起点未加噪;经过每层后隐藏状态会更新 |
| \(C_T\in\mathbb{R}^{M\times d}\) | 文本 token;另有 pooled 文本嵌入进入时间调制 | 既有文本编码器仍保留,省去的是额外图像 CLIP encoder |
| \(P_X,P_C,\Delta\) | 目标与条件位置索引、条件位置平移量 | 修改 RoPE 坐标,不是挪动图像像素或平移物体 |
| \(\gamma\) | 条件与其他 token 间 attention logits 的偏置强度 | 不等于 LoRA scale,也不等于文本 distilled guidance |
本文许多推导取 \(K=N\)。512×512 图像最终成为 32×32、即 1024 个 packed image tokens;代码顺序是 VAE latent 编码后再做 2×2 packing,不应把原始 VAE 特征网格和 Transformer token 网格混为一谈。沿序列拼接后 token 数为 \(L=M+N+K\),不是把 embedding width 变成三倍。
这一表达补全实现路径:E 是固定 VAE,缩放与 shift 来自模型配置,Pack 重新组织局部 latent,Embed 是共享图像输入投影。历史代码使用 VAE posterior sample,而非 posterior mean。本文为方便统一采用代码真实顺序 \([C_T;X;C_I]\),与正文简写 \([X;C_T;C_I]\) 只是排列约定差异,前提是位置与 mask 同步排列。
来源:v5 §3.1–3.2、PDF p3–4;历史 pipeline_tools.py 与 transformer.py
04 · 共享权重、分支 LoRA 与全深度交互
论文事实:复用基础模型 VAE 和 DiT blocks;默认 LoRA rank 4;处理非条件 token 时默认把 LoRA scale 置零,以尽量保留原模型能力。后者是本文易被“统一 sequence”叙述掩盖的关键:统一 attention 不要求每类 token 使用完全相同的有效投影权重。
这是 LoRA 的标准解释式,不是 v5 新增编号公式。旧配置取 \(\alpha=r=4\);基础权重冻结,条件分支用低秩增量。目标与文本也会通过共享 attention 接收到条件信息,因此“非条件 token 不启用 LoRA”不等于它们的隐藏状态不受条件影响。
- 准备三条分支:目标噪声 latent 经原图像投影;控制 latent 经同一投影加 LoRA;文本使用原有上下文投影。
- 双流阶段:文本有其 normalization/MLP;目标与条件复用图像模块,但目标关 LoRA、条件开 LoRA。各分支的 Q/K/V 拼接后执行联合双向 attention,再拆回各自分支做残差和 MLP。
- 单流阶段:目标和文本先合并;条件仍为可单独切换 LoRA 的分支,attention 内再统一计算。条件不在早期阶段后丢弃。
- 输出:只保留目标图像的 token 进入最终 normalization/projection,预测 flow velocity。文本与条件 token 不被解码成输出图片。
实现补充:历史 forward 给条件分支固定 clean-time embedding \(c_t=0\),目标分支用当前 t;条件分支仍接收 pooled 文本和 guidance embedding。每个去噪步从同一编码条件重新进入网络,但条件在一次 forward 的层与层之间会更新并与目标互动。这解释了为什么原始方案不能直接跨去噪步缓存所有条件 K/V。
代码可为 x_embedder、norm 的线性调制层、attention 的 Q/K/V/out、FFN 后层以及 single block 的 MLP/out 等注册 LoRA。默认不是只训练 Q/K;Figure 10 对部分组件的消融是后续“可减参”启发,不能把它直接说成所有实验使用的最小配置。
来源:v5 §3.2.1、§4.1;历史 block.py、lora_controller.py。原 PDF 参考文献 [8] 错指无线通信 LoRa 综述;不应据此误解为通信技术。
05 · 位置编码不是装饰:对齐和解耦
RoPE 使 attention 与相对位置有关。与论文为说明概念而写的“旋转 token”简式相比,实现实际先投影 Q/K,再施加 rotary embedding,V 不作同样旋转。用标准相对位置表达可以看到偏移如何改变匹配偏好:
在 Canny/depth 等任务中,同位置控制像素对应输出同位置内容,令条件与目标共用坐标。主体参考图中的杯子可能从左边移到右边,若仍共享坐标,会额外鼓励错误的局部对应。作者因此按任务选位置索引:
512 token 网格的行列范围为 0–31。论文例子 \(\Delta=(0,32)\) 让两个网格并排;历史 Condition 默认与训练 data.py 用 \((0,-32)\),subject notebook 则显式用 \((0,32)\)。两种方向都实现不重叠,但公开证据未证明任意符号、距离、分辨率都等价,复现须记录实际设置。
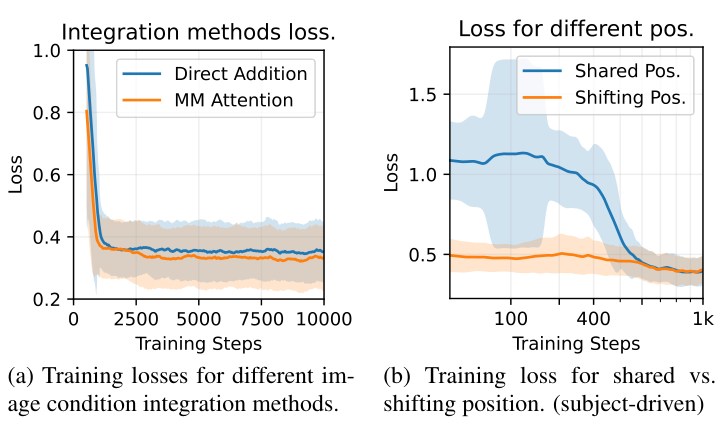


Figure 3a 中 sequence attention 的训练损失低于直接相加;Figure 3b 中 shifted position 收敛更快。Figure 4 中 Canny attention 的对角结构支持空间对应,主体 attention 聚焦于参考物体;Figure 5 比较训练 15k 次后共享/偏移坐标的主体结果。
来源:v5 §3.2.2、Figures 3–5;历史 Condition.encode 与 data.py
06 · 用 attention bias 调节图像条件强度
特征相加可以直接乘强度,但 joint attention 没有天然的单独残差控制旋钮。本文在 softmax 之前的跨组 logits 加 \(\log\gamma\):
\(d_h\) 是每个 attention head 的维度;原文以 d 简写。本文式 (6) 的块尺寸与 token 排列互相不一致:首行看似按 M/N/N 分组,但右上与左下标成 N×N,另有 M×N 被放进 N 行块。不能照抄该矩阵当可执行定义。
下面是根据历史代码重建、维度一致的矩阵,不是原文公式的无声修正:令 \(U=[C_T;X]\),长度 \(M+N\),条件长度 K,则:
历史 block.py 的 slice 同时覆盖条件↔目标与条件↔文本,因此比正文只说 X↔CI 更广。如果只关直接图像-条件路径,却允许条件先影响文本再影响图像,就不能保证“γ=0 完全移除条件”。代码对全部非条件 token 的隔离消除了这个间接路径。
该等式解释了效果:γ 乘的是 softmax 归一化之前跨组权重。它不是把最终某个 attention probability 简单乘 γ 而保持其他项不变。γ=1 恢复无偏置;0<γ<1 减弱、γ>1 增强跨组耦合;γ=0 应按极限或负无穷 mask 处理,负数没有实数 logarithm 语义。

Figure 9 展示 0.25/0.5/0.75/1 的深度与主体样例。它证明可调趋势,未提供 γ 的系统指标曲线或全任务最优值。旧 generate() 已有 condition_scale 参数,不能因为 2026 README 新闻重新强调它就认定这个功能是 2026 才出现。此旋钮也不等价于调 adapter rank、LoRA scale 或 classifier-free guidance。
来源:v5 §3.2.3、式 (5)(6)、Figure 9;历史 attn_forward 的 c_factor 分支
07 · Subjects200K:从一张双联图得到跨场景监督
用同一张图像的裁剪、旋转、颜色增强组成训练对,模型容易学会复制输入而不是保留身份后改变场景和视角。作者利用 FLUX.1-dev 在一张画布里生成同一物体的两幅图,再用 GPT-4o 检查,构成 identity-consistent pairs。GPT-4o 用于离线描述生成和质检,并非推理时在线控制器。

| 阶段 | v5 Appendix A 可核验设置 | 复现含义 |
|---|---|---|
| 对象层级 | 42 类;4,696 个具体对象;每个对象 brief description、8 个 scene descriptions、1 个 studio photo description | 主文“超过 30,000 描述”与附录分层粒度不同,不当作 30k 独立对象 |
| 两个 split | Split-1:场景与场景;Split-2:场景与 studio photograph | 附录主要展开 Split-2,不是随机 train/test split |
| 生成 | FLUX.1-dev;1056×528 双联画布;每个 prompt 5 个随机 seed | 不能把每个 composite 记录当作一张 512 输出图 |
| 切分 | 水平方向拆分,再中心裁到 512×512 | 边缘 padding 降低非精确中线导致的跨边污染 |
| 质检 | 两幅并排结构、同物体一致性、视觉质量;5 次 GPT-4o 独立评估全部通过 | 独立调用仍可能共享系统性 judge 偏差 |
| Split-2 统计 | 生成 211,320 对;保留 111,767 对;合计 223,534 单张训练图 | 保留率约 52.89%;“200K”不可不加单位地套用到所有统计 |

Figure S1 的失败类型是未产生两个独立画面、左右主体身份变化、低视觉质量。筛掉这些错误对于避免把“换物体”学成“保持主体”很重要;同时质检可能偏向 FLUX/GPT-4o 都熟悉的物体与风格。
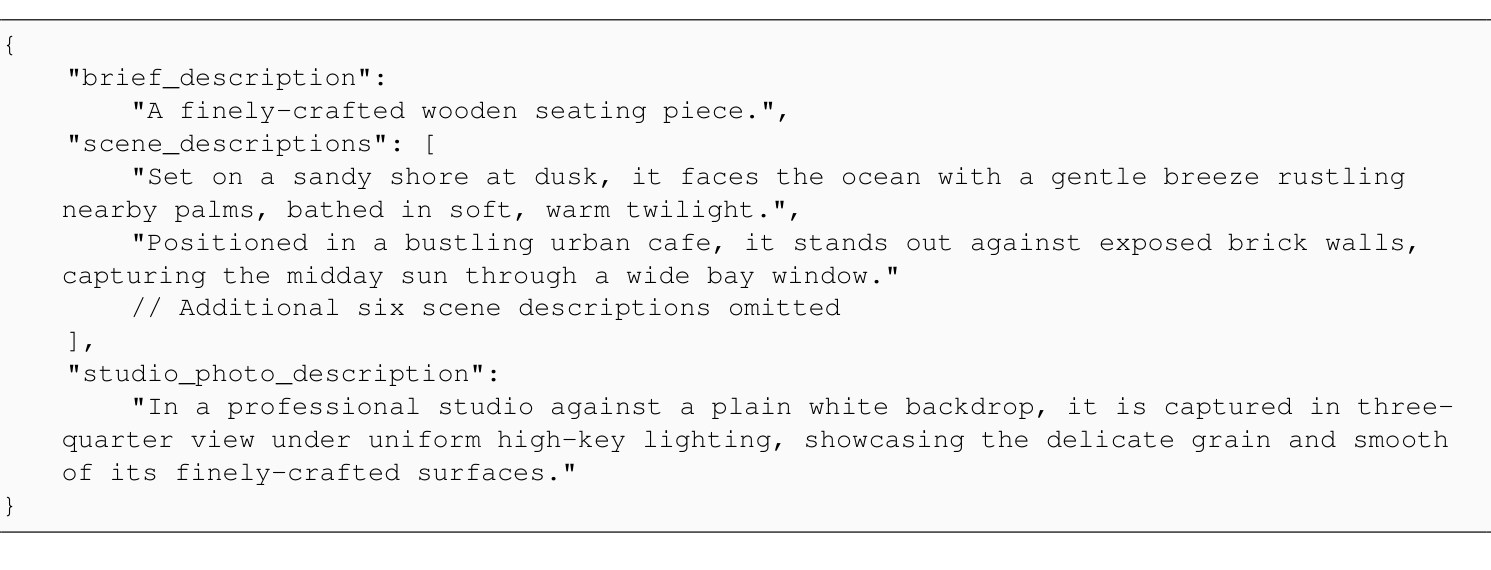
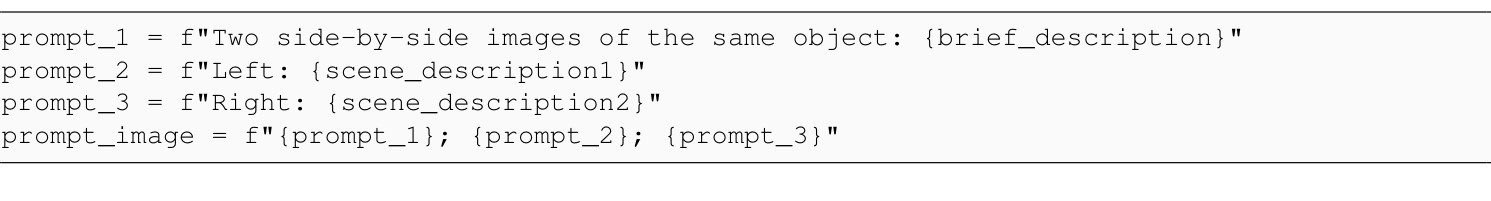
公开 prompt 结构:Figure S3 由“同一对象的两个并排图像 + brief_description;Left: scene_description1;Right: scene_description2”组合。Figure S2 给出 wooden seating piece 的描述实例,明确省略额外六个场景。附录没有完整给出描述生成的 system prompt、全部对象列表或 GPT-4o 质检 rubrics/模型 snapshot;此处不补造。完整英文模板与示例在真实原图中保留。
数据发布口径另列:当前官方 HF card 的 metadata 有 206,841 composite rows;其 Collection1/2 文字分别记 18,396/187,840 对,和为 206,236,与 metadata 差 605。Collection2 保留 111,767 对与论文吻合,但其公开总数 187,840 不等于论文生成总数 211,320。可能对应发布/筛选阶段差异,来源未解释,不能擅自合并成单一精确总量。Collection3 的 1024 数据已在所查2025-01-17数据仓库README出现;它不属于v5附录所展开的两个split,不能仅凭发布页存在就认定主表使用了它。
历史训练脚本按三个质量字段均 ≥5 筛选,未按 collection_2 限定;数据卡 quick start 则给出可限定 collection_2 的过滤例子。subject 数据集每对左右互换各做一个训练样本,长度为合格 pair 数的两倍。复现报告须同时保存原始数据 revision、过滤规则、pair 数、展开后的 sample 数与对象划分,不能仅写“使用200K”。
生成流水线公开程度:数据项目在v5之前最近提交 f7a4ba35cf9008f81561455458ac4c061b0f30b7(2025-01-17)的完整树只有README、展示图、dataset example和src/dataset.py。该脚本是下载、过滤、切分与采样封装,并非GPT-4o描述/质检或FLUX批量合成脚本。论文称释放完整generation pipeline,但在所审时间快照中未找到这些生成脚本;不能把dataset loader说成端到端合成已完全开源。
08 · 训练目标与可复现配置
论文把 FLUX 称为 latent rectified flow transformer,却没有完整列出 training loss 与 t 分布。下面以历史 model.py 为证据补全,而不是声称这是 v5 中的新增公式。
\(\theta\) 是冻结基础模型,\(\phi\) 是条件 LoRA;t 越接近 1 越接近纯噪声。目标为噪声端减数据端的恒定直线路径速度。训练只对目标输出的速度做 MSE,条件图像没有单独的重建 loss,也没有身份 classifier、PBR loss 或 rendering loss。
| 项目 | v5 §4.1 | 历史公开配置/代码 |
|---|---|---|
| 基础模型 | 空间任务 FLUX.1-dev;主体生成用 schnell,因观察到更佳视觉质量 | subject 与 canny 训练 YAML 均载入 dev;subject 推理 notebook 用 schnell。训练与部署底座需分别记录 |
| LoRA | rank 4;非条件 token scale 0 | r=4,alpha=4,gaussian 初始化;latent_lora=false,union_cond_attn=true |
| optimizer | Prodigy;bias correction 与 safeguard warmup;weight decay 0.01 | Prodigy lr=1,weight decay 0.01;不能把自适应 Prodigy 的 lr=1 解读成 AdamW 的普通一步学习率 |
| batch | batch 1,积累 8,作者称 effective batch 8 | YAML accumulation=1;多 GPU 的 global batch 还取决于 world size,原文没有澄清是否每卡 |
| 训练数据 | 空间:text-to-image-2M 最后 300k 图;主体:Subjects200K | canny YAML 只列两个 tar shard 作为示例;subject 按三个质量字段过滤,不限定 collection |
| 预算 | 空间 50k iterations;主体 15k;2×H100 80GB | max_steps=-1、max_epochs 默认 -1;不能不改配置就期待自动在论文预算停止 |
| 精度/显存 | 精度与 wall time 未明确 | bfloat16、gradient checkpointing;training README 推荐 2 H100、最低 1 L20 48GB,为代码建议非计时实验 |
| dropout | 未给完整细节 | 文本与图像各独立概率 0.1;文本置空、图像置黑,条件 token 不删掉 |
| 调度/裁剪 | 未完整给出 LR schedule、随机种子与日志 | 训练 t 为 sigmoid-normal;Trainer gradient_clip_val 默认 0.5;未设置 scheduler 返回值 |
| 文本 guidance | 未披露训练 embedding 值 | 历史 model.py 在模型支持 guidance_embeds 时传全 1;当前 2026 README 说后续训练值 3.5,不能混用 |
与原笔记的核对:旧 note 中保存了 AdamW lr=1e-4、weight_decay=0.001 片段;这可作为当时个人实验记录保留,但不代表 v5 论文训练配置。本文不修改原文,而在新增精读中明确区分论文 Prodigy 与该片段。
未公开/未确认项:论文没有精确 wall-clock、总能耗、完整 baseline 采样超参、各 task checkpoint step、训练多 seed 方差和完整 GPT judge prompt。公开训练代码有用,但示例配置与论文预算不同,因此不能仅靠一条 shell 命令宣称复现全部表格。
来源:v5 §4.1;历史 model.py、subject_512.yaml、canny_512.yaml
09 · 推理流程与隐藏的预处理选择
- 选 task checkpoint:空间任务加载 experimental/canny、depth、coloring、deblurring、fill;主体论文权重为 experimental/subject。历史 notebook 却用更大数据训练的 omini/subject_512,不能当作同一实验权重。
- 构造条件图:对输入做指定裁剪/缩放,然后生成 edges/depth/grayscale/blur 或以遮黑图作为 fill。主体参考图使用自身视觉内容。
- 编码:文本经原模型文本 encoder;控制图经 VAE、Pack、共享图像投影。aligned offset 0,subject offset 单独记录。
- 初始化与采样:生成目标 noise,使用基础 flow scheduler 的 sigmas/timesteps;每一步联合处理文本、目标与条件 token,预测目标 velocity,更新目标 latent。
- 解码:最终目标 latent unpack、逆缩放/shift、VAE decode 得到 RGB;没有材质图、程序或 3D renderer 执行。
这是说明 flow integration 的 Euler 形式;实际步长/时间偏移交给 FLUX scheduler,不能把它当作固定所有版本的完整采样实现。旧 generate 默认 512×512、28 steps、guidance_scale=3.5、max text length=512;subject notebook 明确改为 schnell、8 steps。这些是代码例子,论文未明确规定全 benchmark 都用相同采样步数。
| 控制类型 | 历史实现 | 影响 |
|---|---|---|
| Canny | 阈值 100/200;训练先 RGB→gray,推理 helper 直接将数组传 cv2.Canny | 图像处理路线并非完全同一函数;应锁定通道、resize 与阈值 |
| Depth | Depth Anything small HF;训练 CPU lazy cache,推理 helper 构造 CUDA pipeline | 条件生成有独立模型与算力成本;非真实米制深度 |
| Coloring | 转换为 L 再转回 RGB | 保留亮度约束,不含目标真彩色答案 |
| Deblur | 训练 GaussianBlur 半径随机整数 1–10;推理 helper 固定 10 | 退化分布与评估半径要单独记录 |
| Fill | 训练随机矩形 mask,50%概率反转,以黑色填未知处;Condition(mask=...) 直接断言不支持 | 支持“遮黑图像条件”不等于 API 有独立 mask 通道;没有硬性保证已知像素逐像素不变 |
| Subject | 推荐 this item / the object / it;默认按 width/16 移动位置 | 减少给主体重新命名导致的语义替换;不是特殊 learnable subject token |
复现防坑:旧 README 写“自动 center crop”,但通用 generate/Condition 未执行这种中心裁剪;空间 notebook 显式 crop,主体 notebook 直接 resize。使用者要在入口固定预处理。条件 VAE 采样未接收传给目标 noise 的独立 generator,仅设目标 seed 可能不足以重现条件 token;旧 seed_everything 同时设置 torch/numpy,可覆盖部分路径,但未设 Python random 的训练增广种子。
该历史 generate 显式断言 conditions 长度 ≤1,且用 condition_type 选 adapter。它没有 temperature、top-k、beam search、reranking、test-time gradient optimization 或渲染回路。这是连续 latent flow 采样,不能拿语言模型 decoding 参数套用。
来源:历史 generate.py、condition.py、data.py、examples;v5 §4.1
10 · 参数效率完整表与运行成本
原 Table 1 的全部行与列如下。IP-Adapter 包含 CLIP image encoder;OminiControl 额外报告把原有 VAE encoder 也计入部署条件编码成本时的数值。48.7M 不是把所有这些参数都训练了,也不是又新增一个 VAE。
原 Table 1 · 额外参数
| 方法 | 底座 / 参数 | 条件相关参数 | 相对底座比例 |
|---|---|---|---|
| ControlNet | SD1.5 / 860M | 361M | 约42% |
| T2I-Adapter | SD1.5 / 860M | 77M | 约9.0% |
| IP-Adapter | SD1.5 / 860M | 449M | 约52.2% |
| ControlNet | FLUX.1 / 12B | 3.3B | 约27.5% |
| IP-Adapter | FLUX.1 / 12B | 918M | 约7.6% |
| FLUX.1 Tools | FLUX.1 / 12B | 612M | 约5.1% |
| Ours | FLUX.1 / 12B | 14.5M / 48.7M 含 Encoder | 约0.1% / 约0.4% 含 Encoder |
14.5M / 12B 实际约 0.121%,四舍五入约 0.1%;加 encoder 的 48.7M 约 0.406%。与 FLUX ControlNet 的 3.3B 相比,LoRA 增量参数约少 228 倍,但不能据此推导运行速度快 228 倍。
我们的理论估算:若 512² 输出 N=K=1024、文本 M=512,则 attention pair 数比为 2.78;1024² 时 N=K=4096 则约 3.57。这里假设等长条件、完整 attention,不等于实测 latency 或显存倍率;投影、MLP、VAE、融合 attention kernel 与内存策略会改变端到端代价。
论文结论明确承认新增 token 降低推理效率,未给完整 FLOPs/latency/peak VRAM 表。参数高效是强结论;推理高效只靠参数占比不能成立。OminiControl2 的 KV-cache 是另一项后续方法,不能用于替 v5 填补缺失的速度证据。
来源:v5 Table 1、§5;原参数表
11 · 五类空间任务:全量 Table 2 与 trade-off
协议:COCO 2017 validation 的 5,000 张图 resize 至 512×512,由图像构造 task condition,以相关 caption 作 prompt,固定 seed 42。Canny controllability 是输入与输出提取边缘的 F1;其他任务为条件 map 的 MSE。图像质量包含 FID、SSIM、CLIP-IQA、MAN-IQA、MUSIQ、PSNR;CLIP Text/Image 衡量语义或图像对齐。MSE 数值尺度依赖条件预处理,不能跨不同任务直接相加排名。
以下按任务拆开宽表,保留原 17 个方法行及每行 9 个指标。粗体为该任务该列最优、下划线为次优(并列保留);原表把 MUSIQ 拼为 MUSICQ,此处统一常见名称并标明,不改数值。↑越高越好,↓越低越好。
原 Table 2 · Canny
| 方法 | 底座 | F1 ↑ | FID ↓ | SSIM ↑ | CLIP-IQA ↑ | MAN-IQA ↑ | MUSIQ ↑ | PSNR ↑ | CLIP Text ↑ | CLIP Image ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ControlNet | SD1.5 | 0.35 | 18.74 | 0.36 | 0.65 | 0.45 | 67.81 | 10.27 | 0.305 | 0.752 |
| T2I Adapter | SD1.5 | 0.22 | 20.06 | 0.35 | 0.57 | 0.39 | 67.89 | 9.53 | 0.305 | 0.748 |
| ControlNet Pro | FLUX.1 | 0.21 | 98.69 | 0.25 | 0.48 | 0.37 | 56.91 | 9.22 | 0.192 | 0.537 |
| Flux Tools | FLUX.1 | 0.20 | 22.13 | 0.32 | 0.66 | 0.60 | 75.47 | 9.69 | 0.308 | 0.701 |
| Ours | FLUX.1 | 0.50 | 24.20 | 0.45 | 0.66 | 0.62 | 74.87 | 11.34 | 0.305 | 0.785 |
原 Table 2 · Depth
| 方法 | 底座 | MSE ↓ | FID ↓ | SSIM ↑ | CLIP-IQA ↑ | MAN-IQA ↑ | MUSIQ ↑ | PSNR ↑ | CLIP Text ↑ | CLIP Image ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ControlNet | SD1.5 | 923 | 23.03 | 0.34 | 0.64 | 0.47 | 70.73 | 10.63 | 0.308 | 0.726 |
| T2I Adapter | SD1.5 | 1560 | 24.72 | 0.28 | 0.61 | 0.39 | 69.99 | 9.50 | 0.309 | 0.721 |
| ControlNet Pro | FLUX.1 | 2958 | 62.20 | 0.26 | 0.55 | 0.39 | 66.85 | 9.38 | 0.212 | 0.547 |
| Flux Tools | FLUX.1 | 767 | 24.56 | 0.32 | 0.68 | 0.59 | 75.30 | 10.15 | 0.308 | 0.715 |
| Ours | FLUX.1 | 537 | 31.04 | 0.39 | 0.68 | 0.60 | 74.04 | 10.53 | 0.305 | 0.749 |
原 Table 2 · Mask
| 方法 | 底座 | MSE ↓ | FID ↓ | SSIM ↑ | CLIP-IQA ↑ | MAN-IQA ↑ | MUSIQ ↑ | PSNR ↑ | CLIP Text ↑ | CLIP Image ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ControlNet | SD1.5 | 7588 | 13.14 | 0.68 | 0.58 | 0.42 | 67.22 | 18.96 | 0.300 | 0.848 |
| Flux Tools | FLUX.1 | 6610 | 11.40 | 0.73 | 0.56 | 0.45 | 68.92 | 18.37 | 0.305 | 0.874 |
| Ours | FLUX.1 | 6351 | 10.20 | 0.78 | 0.59 | 0.49 | 70.78 | 19.59 | 0.305 | 0.892 |
原 Table 2 · Colorization
| 方法 | 底座 | MSE ↓ | FID ↓ | SSIM ↑ | CLIP-IQA ↑ | MAN-IQA ↑ | MUSIQ ↑ | PSNR ↑ | CLIP Text ↑ | CLIP Image ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ControlNet Pro | FLUX.1 | 994 | 30.38 | 0.75 | 0.40 | 0.31 | 54.38 | 16.23 | 0.279 | 0.781 |
| Ours | FLUX.1 | 73 | 10.37 | 0.92 | 0.56 | 0.48 | 69.40 | 21.56 | 0.305 | 0.884 |
原 Table 2 · Deblur
| 方法 | 底座 | MSE ↓ | FID ↓ | SSIM ↑ | CLIP-IQA ↑ | MAN-IQA ↑ | MUSIQ ↑ | PSNR ↑ | CLIP Text ↑ | CLIP Image ↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| ControlNet Pro | FLUX.1 | 338 | 16.27 | 0.64 | 0.55 | 0.43 | 70.95 | 20.53 | 0.294 | 0.853 |
| Ours | FLUX.1 | 62 | 18.89 | 0.58 | 0.59 | 0.54 | 70.98 | 21.82 | 0.301 | 0.856 |
- Canny:Ours F1=0.50,对 ControlNet SD1.5 的 0.35 增 0.15;但 FID=24.20,比 18.74 差。Flux Tools 的 MUSIQ 75.47 也略高于 74.87,CLIP Text 0.308 高于 0.305。
- Depth:MSE=537,较 FLUX Tools 的 767 下降约30.0%,较 ControlNetPro 2958 下降约81.85%。然而 FID=31.04,比 ControlNet SD1.5 的23.03和Tools24.56差;PSNR10.53也低于SD1.5的10.63。
- Mask:MSE6351、FID10.20、SSIM0.78、PSNR19.59均优于列出的两种基线,CLIP Text与Tools并列0.305。没有给 unmasked-region exact preservation 指标。
- Colorization:MSE994→73,降低92.66%;FID30.38→10.37,PSNR16.23→21.56。主要对照只有ControlNetPro,不能由此推出相对所有着色专用模型的SOTA。
- Deblur:MSE338→62,降低81.66%,PSNR20.53→21.82;但FID16.27→18.89、SSIM0.64→0.58。锐化与分布保真可能有trade-off,论文未给误差分解。

公平性:既有 SD1.5 与 FLUX 两套底座、不同模型规模和训练数据。与旧 SD 比较可以说明系统实用效果,但不能把差值全部归因于 OminiControl 架构。FLUX ControlNetPro 在 Canny 的 FID98.69异常高,值得检查条件预处理、强度和checkpoint适配;论文缺少完整baseline调参记录,不能直接判定对方架构本质很差。
来源:v5 §4.1–4.2、Figure 7、Table 2。全部百分比变化为本精读按原表计算。
12 · 主体生成:GPT-4o 评估、best-of-five 与用户实验
DreamBooth 测试集采用 30 个主体×25 个 prompts=750 text-condition pairs,每对5个随机种子,故每种方法名义上有3,750次生成;每个主体选一张参考图。与训练合成主体集区别明确,但未公开所有reference选择与完整judge调用细节。
GPT-4o 的五项判断:Identity Preservation 检查logo、品牌与独特图案;Material Quality 检查材质表面特征;Color Fidelity 检查未要求更改区域的颜色;Natural Appearance 检查自然协调;Modification Accuracy 检查文本要求是否执行。它们是视觉judge百分比,不是 PBR 参数误差、BRDF测量或逐像素真实性。
原 Table S1 · 五种子平均(%)
| 方法 | Identity ↑ | Material ↑ | Color ↑ | Natural ↑ | Modification ↑ | Average ↑ |
|---|---|---|---|---|---|---|
| IP-Adapter (SD 1.5) | 29.4 | 86.1 | 45.3 | 97.9 | 17.0 | 55.1 |
| SSR-Encoder | 46.0 | 92.0 | 54.2 | 96.3 | 28.5 | 63.4 |
| IP-Adapter (FLUX) | 11.8 | 65.8 | 30.8 | 98.1 | 57.7 | 52.8 |
| Ours | 50.6 | 84.3 | 55.0 | 98.5 | 75.8 | 72.8 |
原 Table S1 · 五种子best score(%)
| 方法 | Identity ↑ | Material ↑ | Color ↑ | Natural ↑ | Modification ↑ | Average ↑ |
|---|---|---|---|---|---|---|
| IP-Adapter (SD 1.5) | 56.3 | 98.9 | 70.1 | 99.7 | 37.2 | 72.5 |
| SSR-Encoder | 64.3 | 99.2 | 74.4 | 99.1 | 53.6 | 78.1 |
| IP-Adapter (FLUX) | 27.5 | 86.1 | 53.6 | 99.9 | 74.9 | 68.4 |
| Ours | 82.3 | 98.0 | 88.4 | 100.0 | 90.7 | 91.9 |
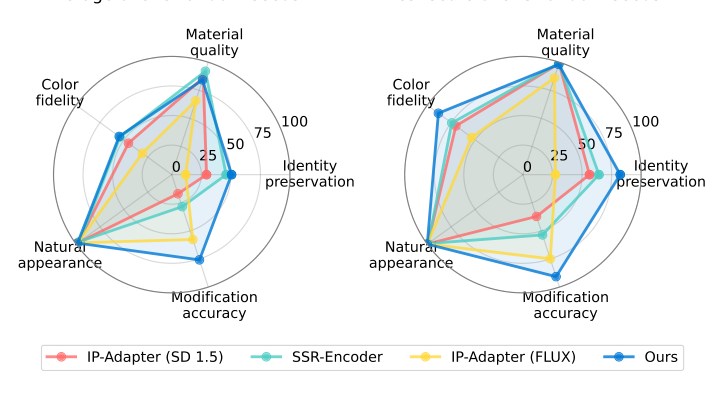
平均五种子:Ours 平均72.8%,高于最强整体SSR-Encoder63.4%,差9.4个百分点;Modification75.8%高于FLUX IP-Adapter57.7%,差18.1个百分点;Identity50.6%只比真正最强SSR46.0%高4.6个百分点。主文强调相对SD1.5 IP-Adapter29.4%的身份优势,需注意它不是该列最强基线。
不能忽略的弱项:Material84.3%低于SSR92.0%,也低于SD1.5 IP-Adapter86.1%;Color55.0%与SSR54.2%仅差0.8个百分点。Natural各方法已在96.3–98.5%间接近饱和,对细微控制质量区分力有限。
best score over 5 seeds:Ours Identity82.3%、Modification90.7%,相对最佳基线64.3%/74.9%分别高18.0/15.8个百分点;总体91.9%,但Material98.0%仍低于SSR99.2%。论文没有充分说明“best”是每个指标分别取max,还是选同一张图后评五项;若分别取max,各列可能对应不同样本,不意味着一次生成可以同时达到整行分数。部署成本与可用性应优先看平均行,并单独报告选择器。
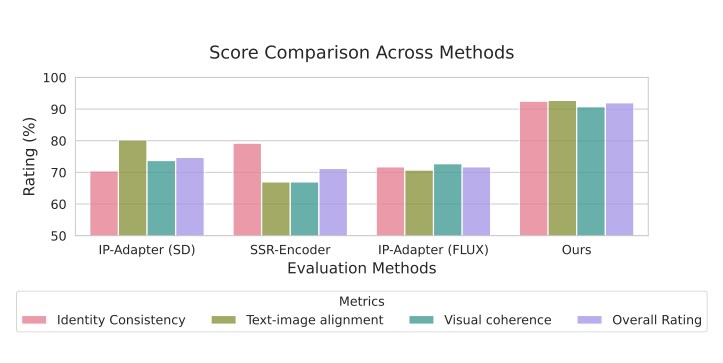
用户研究:375份有效 responses,评价主体身份一致性、文本对齐、主体与背景视觉协调;Figure S5 还画出overall。论文只给柱图,没有完整数值表、人数与每人题量关系、置信区间或随机呈现协议。这里保留真实柱图,不从像素猜造精确分数。375个response也不能自动当成375位独立参与者。
来源:v5 §4.1–4.2、Appendix B.2、Table S1、Figures 8/S5
13 · 消融能证明什么,不能证明什么
原 Table 3 · LoRA rank
| Rank | FID ↓ | SSIM ↑ | F1 ↑ | CLIP Score ↑ |
|---|---|---|---|---|
| 1 | 21.09 | 0.412 | 0.385 | 0.765 |
| 2 | 21.28 | 0.411 | 0.377 | 0.751 |
| 4(默认) | 20.63 | 0.407 | 0.380 | 0.761 |
| 8 | 21.40 | 0.404 | 0.3881 | 0.761 |
| 16 | 19.71 | 0.425 | 0.407 | 0.764 |
原 Table 3 · Condition blocks
| 注入范围 | FID ↓ | SSIM ↑ | F1 ↑ | CLIP Score ↑ |
|---|---|---|---|---|
| Early | 25.66 | 0.369 | 0.23 | 0.72 |
| Full(默认) | 20.63 | 0.407 | 0.38 | 0.76 |
LoRA rank:rank16的FID19.71、SSIM0.425、F1 0.407均为此组最佳;rank1的CLIP0.765反而略高于rank16的0.764。rank不是单调改善:1→2的四项都变差;rank8比4的FID/SSIM更差。默认rank4是成本折中而非表内绝对最优。没有多seed方差,0.001级CLIP差值不应过度解读。
注入深度:Early→Full令FID25.66→20.63、SSIM0.369→0.407、F1 0.23→0.38、CLIP0.72→0.76。支持让条件贯穿双流与单流阶段的设计,不能直接推出“所有UNet的早期控制都无效”。Table3默认F1 0.380与Table2的Canny0.50不一致,原文未给足消融预算解释,不能混拼两表当同一run。

组件:Figure10移除norm、MLP、output的LoRA,并比较去掉Q/K/V、Q/K、V的结果。作者观察norm和Q/K尤为重要,V影响较小,提出控制更可能通过normalization与attention routing传播。只有蒙娜丽莎示例,缺少跨数据定量误差和模块参数预算匹配;这是值得进一步检验的机制假说,不是V永远可以删去的证明。

数据:Figure S4 对比传统随机crop/rotation/scale/contrast/saturation/color增广与Subjects200K。前者更像复制参考姿态,后者可改变视角和场景同时保留身份;但只给两个定性案例,未量化对数据量、图像质量、变化幅度分别控制后的贡献。更严格实验需要等样本数、等预算并报告身份与编辑性的Pareto曲线。
拼接与位置:Figures3–5分别支持joint sequence和位置偏移,未给全面offset sweep、不同任务共用/分开训练的对照、不同尺度泛化结果。attention热图对角或聚焦物体是可解释线索,不能替代干预实验。
来源:v5 §4.3、Table 3、Figure10、Appendix B.1
14 · Paper vs. Implementation:读代码后的复现清单
本节是静态源码审计,没有下载权重、运行模型或训练。历史commit位于v5前6天,已包含名为independent_condition的实验开关;不能因此认定后续OminiControl2的完整方法和加速已在v5实验证明。
| 观察 | 精确位置/行为 | 使用时的结论 |
|---|---|---|
| 统一框架≠同一权重包 | generate根据condition_type选择adapter,并assert最多一个condition | 多种任务支持与多条件同时组合分别验证 |
| type ID并未注入位置 | Condition生成type_id;transformer内设置condition_ids第一维的语句被注释 | 不要宣称模型通过该task-ID embedding做多任务识别;task LoRA已承担区分 |
| 条件并未带噪 | 条件latent来自VAE;cond_temb默认c_t=0 | 和为condition加同样diffusion noise是不同训练方案 |
| 关闭非条件LoRA | enable_lora临时置scale0并恢复 | 同一权重对象按分支调用;误开latent_lora会改变实验 |
| attention bias更广 | c_factor改变condition↔所有剩余token | 覆盖text路径;与原公式块矩阵不完全一致 |
| mask优先级 | c_factor分支重新分配attention_mask,会覆盖之前union/independent mask | 组合condition_scale与independent_condition时要写单元测试,不假定两个约束自动叠加 |
| clean-up非finally | generate末尾删除c_factor;中途异常可能跳过 | 复用同一pipeline前检查残留属性,特别是下一次scale=1时 |
| 参数域未严格校验 | 直接log(c_factor),无显式非负检查 | 负值可产生NaN;γ=0需验证mask数值稳定性 |
| Subject crop坐标 | padding=8时左crop为(8,8,520,520),右为(528,8,1040,520) | 与文字“每半中心crop”的理想第二起点536有差异;原数据布局应实测,不擅自修正训练分布 |
| 数据缓存 | 过滤cache路径固定data_valid.arrow,未显式绑定dataset revision | 复现需记录HF revision和清楚区分旧cache |
| 模型恢复 | init_lora(lora_path)抛NotImplementedError;默认关闭Trainer checkpointing,只保存LoRA | 公开入口不等价于完整optimizer-state训练续跑 |
| 随机性 | VAE posterior sample、torch t/noise、Python random增广 | 单独固定目标noise generator不足以控制训练全部随机源 |
依赖与后续修复:历史 inference requirements未锁diffusers版本,training锁0.31.0,其余多为未pin包。当前2026-07-02提交改到diffusers0.38,并解释多GPU DDP未使用参数导致首步报错、LoRA dropout未被实际调用的修复。这里把它作为后续维护说明,不把“旧代码必定在本文硬件失败”当作已经运行验证的结论。复现应使用隔离环境、固定所有版本,并单测分支梯度。
当前模型说明的界限:新README支持subject在dev上用real image guidance,说明distilled guidance固定3.5;介绍OminiControl2需independent_condition训练的KV-cache。它还区分experimental/subject为论文模型、omini/subject_512为更多数据训练、subject_1024_beta为1024训练。旧论文结果不要拿更新权重或新CFG实现冒名复现。
来源:历史 源码;2026提交与维护说明。未进行运行性验证,风险项为可定位的静态推断。
15 · 原文矛盾登记,避免把笔误写成结论
| v5文本 | 更可靠的交叉证据 | 本精读处理 |
|---|---|---|
| §4.2说depth-to-image最高F1=0.38 | Table2定义仅Canny用F1;Depth用MSE,Ours537;Canny F1为0.50 | 按表报告,保留叙述冲突,不猜0.38来自哪个run |
| deblur MSE降低77%,FID30.38→11.49 | Table2 deblur MSE338→62,FID16.27→18.89;30.38属于Colorization,表中无11.49 | 重算81.66%并明确FID变差 |
| Equation6块尺寸与顺序 | M/N标注不自洽;代码条件↔text+image统一bias | 展示实现重建矩阵并标清不是原式照抄 |
| rank16“best results” | Table3 rank1的CLIP0.765高于rank16的0.764 | 说明三个指标最佳而非四个全部第一 |
| LoRA参考文献[8] | 书目标题是LoRa technology无线通信概述 | 按代码与低秩公式解释;原文引文错误单列 |
| Figure S6 caption说DreamBooth更多结果 | 图中实际有空间控制、主体对照与ID preservation;S7才是DreamBooth大网格 | 保留原编号,描述按实际图内容 |
| 200K images / pairs混合表述 | 附录Split2的111,767pairs=223,534images;当前数据卡另有record统计 | 每个数字均标单位和版本 |
| 原note AdamW片段 | 论文与历史主配置Prodigy | 原note保持字节前缀,只追加解释 |
这类矛盾降低的是报告精确性,并不自动否定所有实验。最合理的态度是保留可直接核对的表格、明确疑点、要求作者或复现提供原始配置与日志,而不是用自己认为合理的值悄悄修补论文。
来源:固定v5 PDF p5–8、p9参考文献、p15–17补充材料;数值复核以固定HTML相同版本为第二来源。
16 · Reviewer 视角:真正的贡献与证据缺口
Strengths
- 表征选择合理:复用VAE保留空间细节,减少为新条件学习独立表示的成本;sequence接口既容纳对齐线索,也容纳跨位置主体身份。
- 实现细节有洞察:条件分支LoRA与原分支隔离、位置偏移、全深度交互形成可迁移的DiT控制设计。
- 数据贡献直接回应失败:跨场景同主体对减少简单复制倾向;附录给出了生成、筛选、crop和关键计数。
- 公开范围较好:有代码、训练入口、数据、任务权重与真实定量表,方便搭建基线和做模块审计。
Weaknesses
- “universal”范围有限:共享架构和多task LoRA,不等于单模型joint training,更不是多条件无冲突组合;人的身份数据不足,主体部分偏物体。
- 参数与token成本脱钩:缺少真实latency、显存、吞吐和质量-计算曲线;高分辨率token规模更重。
- 评估judge依赖:GPT-4o用于构造/过滤训练数据,也用于主体评估,可能存在相似的偏好;没有证明judge与人的偏差在各方法上均匀。
- 公平性与可复现性:不同基础模型、训练数据、默认采样与公开配置不一致;best-of-five选择语义不清;无完整置信区间。
- 机制证据不足:attention图和单案例组件消融难支持广义“控制走Q/K而不是V”的强因果论断。
- 学术报告质量:表文矛盾、错引与公式尺寸问题增加复现负担,需避免继续传播。
最有价值的补实验
固定FLUX、数据、训练预算与采样,比较feature-add、channel-concat、sequence-concat;对位置offset的距离/符号/尺度做网格实验;用同一参数预算比较QK/norm-only和全模块LoRA;以真实拍摄主体holdout评价身份与编辑性的平衡;报告平均样本、可实现的best-of-k选择器以及人类盲评区间。最后同时报告训练参数、token数、显存、端到端时延,避免单维度效率叙述。
风险与使用边界:主体保真可用于正常商品展示,也可能产生未经同意的身份或品牌误用;仓库承认人类主体训练覆盖不足。代码Apache-2.0、数据卡license以及FLUX各底座权重条款应分别核查,不能把代码license当成所有模型与生成内容的统一授权。
17 · 面向 Procedural Material Generation 的研究延伸
这一节全部是 Research Extension。OminiControl输出RGB图像,没有SBS/SBSAR、shader graph、节点拓扑、边、程序语法、图执行器或可微材质renderer。Material Quality这个评估名称也不代表论文已生成或恢复物理材质。
A. 让“空间对齐”成为有意义的材质坐标约束
在PMG中,height/normal/roughness/albedo图若共享UV域,应共用位置索引;参考照片或材质球渲染与目标UV图通常不对齐,应使用独立位置域。直接照搬“shift一次就够”还不充分:UV接缝、平铺周期、旋转、真实纹理频率和曲面投影不会由不重叠坐标自动解决。
可检验实验:对同一材质生成多组已知UV scale/rotation和照明渲染;对照共享坐标、固定shift、显式尺度坐标、可学习warp。除CLIP外测周期频谱、接缝误差、normal integrability与重渲染误差。这样才能知道位置策略是在学材质结构,还是只记住图像外观。
B. 用节点预览作为条件,而不是冒充图节点token
可以把graph中间node preview或最终render编码成条件token,帮助生成目标材质图像;但VAE token与程序node token属于不同空间。若最终输出是可执行图,需要独立的graph decoder、类型检查、端口兼容与无环约束,不能只把RGB latent序列改名“graph representation”。
这里G是程序图,R为真实材质执行与渲染器,\(\ell,v\)是光照/视角,\(\Omega\)惩罚复杂度或bitmap依赖。OminiControl可提出参考外观或候选监督,图必须独立执行验证;单张RGB相似不能证明粗糙度、法线或可编辑参数正确。
C. 面向材质的 Subjects200K 式成对数据
保持同一个程序图身份,渲染不同光照、几何、UV尺度、参数编辑前后对;记录哪些属性允许变、哪些须保留。相比FLUX双联图,用renderer可以获得真实对应与精确参数差分,同时要加入现实照片域以避免纯合成偏移。对象身份一致并不等于材质身份一致,数据split应按程序族/节点组合分离,防止同一graph微调参数泄漏到test。
D. 把强度旋钮从“整张参考”细化到属性
可以设外观参考、几何法线、照明、空间mask等多个条件组,并为组间attention设计独立bias。研究问题是不同控制是否冲突、属性能否解耦,而不是假定把多个LoRA相加即解决。旧实现的单condition限制与mask覆盖风险提示必须重新设计分组mask和组合训练。
此式是研究框架,不是论文已有目标;对离散graph validity也不能假装处处可微。训练中可以用可执行率约束或独立选择器,连续材质参数再通过renderer优化。需要评估控制强度是否单调、有无identity-vs-editability冲突、输出是否超出物理可行域。
E. 一个可落地的最小验证
- 固定一个可执行程序材质库,按图族划分训练/测试,构造同材质多UV尺度、视角和光照的pairs。
- 以Omini风格reference-token为外观输入,以aligned normal/height为结构输入;先做单条件,再严格实现两条件版本。
- 比较shared/shifted/scale-aware positions,以及全LoRA/QK+norm-only;保持参数预算、数据量、采样步数一致。
- 输出PBR maps时测跨通道一致性和多光照重渲染;输出graph时增加语法、执行、可编辑性与未支持node比例。
- 记录条件强度扫描、平均与best-of-k、显存和时延;失败案例按UV接缝、频率、材质身份、光照泄漏拆分。
最值得借鉴的是条件表示与位置关系的设计原则,不是把一篇RGB控制论文直接宣称为程序材质生成解决方案。
18 · 补充原图:看能力,也看测试覆盖

原Figure S6虽题注写DreamBooth,实际展示空间任务对照、主体生成基线以及ID preservation示例。它提供更丰富的质性覆盖,不能代替每一子任务的定量表。

原Figure S7:DreamBooth主体在不同场景中的完整网格。检查的不只是“像同类物体”,还应关注局部图案、颜色、轮廓和新增场景是否同时成立。

原Figure S8:scene variation与try-on。衣服外观进入人物照片不等于获得可控3D服装或物理布料模型;新视角看似合理也不意味着多视图几何严格一致。
来源:固定v5 PDF p16–18。所有主图1–10及补图S1–S8均在本页出现,矢量图/复合图使用固定PDF渲染,存在可靠官方完整原图时优先联网引用。
19 · Sources、归档边界与阅读检查
- OminiControl固定v5 PDF:2025-03-11,18页,完整正文、参考文献、附录。
- 固定v5 HTML:逐行复核Table1/2/3/S1与图编号。
- arXiv版本记录:初稿年份与v5日期分开。
- CVF ICCV2025正式书目:后续venue确认,不替换固定PDF。
- OminiControl历史仓库:方法、训练、数据与推理静态审计。
- 2026维护快照:OminiControl2与后续接口边界。
- 官方模型页与官方数据卡:论文模型/更新模型与数据口径区别。
- Subjects200K官方数据项目:生成过程补充来源;本文不将后续collection当作v5训练集。
元数据建议:原note的2024/arXiv条目是历史记录;可在后续本地整合时补充ICCV2025书目。v5第一页未显式给通讯作者标记,Xinchao Wang仍按末位候选保留,不仅凭email或末位推定已验证。新增建议包括flow matching、parameter-efficient fine-tuning、multimodal conditioning,以及image/text模态,PMG仅为延伸不作为本文已验证任务。
交付状态:完成深度内容、全部关键表、18幅原图、源码与数值静态核验;原note完整保留为合并候选的字节前缀。HTML严格小于20MB。浏览器MathJax、图片实际加载、导航与1440/760/390布局验收按用户要求留待本地下载后,未声称已通过;联网图需要网络。未运行模型,不把静态代码风险写成实测故障。
复习自测:为什么sequence concat不同于channel concat?条件latent是否随去噪t加噪?LoRA对哪些token生效?偏移的是图像还是位置索引?γ如何改变softmax?为何0.1%参数不等于0.1%开销?Depth的537是什么单位口径?best-of-five是否来自同一张图?这八个问题能准确回答,才真正掌握本文的机制与证据边界。