01 · 身份、结论与阅读边界
一句话:pMF 把“网络应当输出什么”与“训练应当匹配什么”分开:Transformer 直接输出近似干净的像素图像场,再转换为平均速度与瞬时速度完成 MeanFlow 训练,最终从噪声一次前向生成 RGB 图像。
Paper Verified:固定阅读版本为 arXiv:2601.22158v1,2026-01-29,13 页合订本:正文 1–8、致谢及参考文献 9–10、附录 A 实现细节第 11 页、附录 B 样本图第 12–13 页。覆盖公式 1–12、算法 1–2、Table 1–8(含 3a/3b)与 Figure 1–6。本文不是 2025 年的 Mean Flows,也不是 Improved Mean Flows。
作者按原文顺序为 Yiyang Lu、Susie Lu、Qiao Sun、Hanhong Zhao、Zhicheng Jiang、Xianbang Wang、Tianhong Li、Zhengyang Geng、Kaiming He。前四人共同一作;除 Zhengyang Geng 为 CMU 外,其余为 MIT。固定 PDF 未明确标注通讯作者,原笔记的 Kaiming He 仍仅为未验证候选。
身份交叉核查:PMLR 官方出版记录已确认 ICML 2026,PMLR 306:81265–81277。该出版信息与固定 v1 技术内容分别记录,不以更新论文替换用户 PDF。原笔记的 preprint 字段保留,仅在归档建议中提出更新。
| 核心结果 | 精确范围 | 不能推出什么 |
|---|---|---|
| 256²:FID 2.22,IS 268.8 | pMF-H/16,360 epochs,1-NFE,50k 样本 | 并非所有生成器中最优;iMF 1.72、多个多步方法更低 |
| 512²:FID 2.48,IS 284.9 | pMF-H/32,1-NFE,272 Gflops | 不代表 1024² 同样达到 2.48;1024 消融为 B/64、FID 4.58 |
| 不用 latent tokenizer / decoder | 训练及推理状态位于 RGB 像素空间 | 不等于“没有中间隐藏表示”或“完全不用预训练网络” |
| 生成器从头训练,无蒸馏 | 不用预训练扩散教师蒸馏生成映射 | 感知损失仍依赖预训练 VGG / ConvNeXt;Figure 1 可视化使用预训练 JiT |
证据:固定 PDF 摘要、§6、附录 A–B;官方 JAX 仓库。本文仅完成内容与静态检查;浏览器公式、图片加载和移动端布局验收按用户要求延后。
02 · 为什么像素一步生成难
多步扩散把困难映射拆成很多小修正;latent diffusion 则先用独立 tokenizer 压缩图像。两者都降低主生成网络的负担,但引入迭代与解码开销。一步、无 latent 同时拿走这两种“辅助分解”:网络不仅要跨越很长的生成轨迹,还必须在高维像素输入中自己提取低维结构。
关键并非把既有 MeanFlow 的 latent tensor 放大。平均速度包含噪声与图像,往往占据高维空间。对具有有限宽度、使用大 patch 的 Transformer 来说,直接回归这类量可能远比预测干净图像难。作者因此沿用 JiT 的图像预测原则,但不能直接照搬普通去噪器:MeanFlow 的对象依赖起点和终点两个时间,而非仅一个噪声时间。
Author Claim:广义去噪图像场近似落在较低维流形,因而更容易学习。边界情形有明确数学解释,中间时间区间主要由模拟与消融支持,没有一般性流形定理。Our Interpretation:这是有限容量网络的归纳偏置设计;代数可逆的输出参数化,不会在有限网络、特定优化器和损失权重下自动具有相同的优化难度。
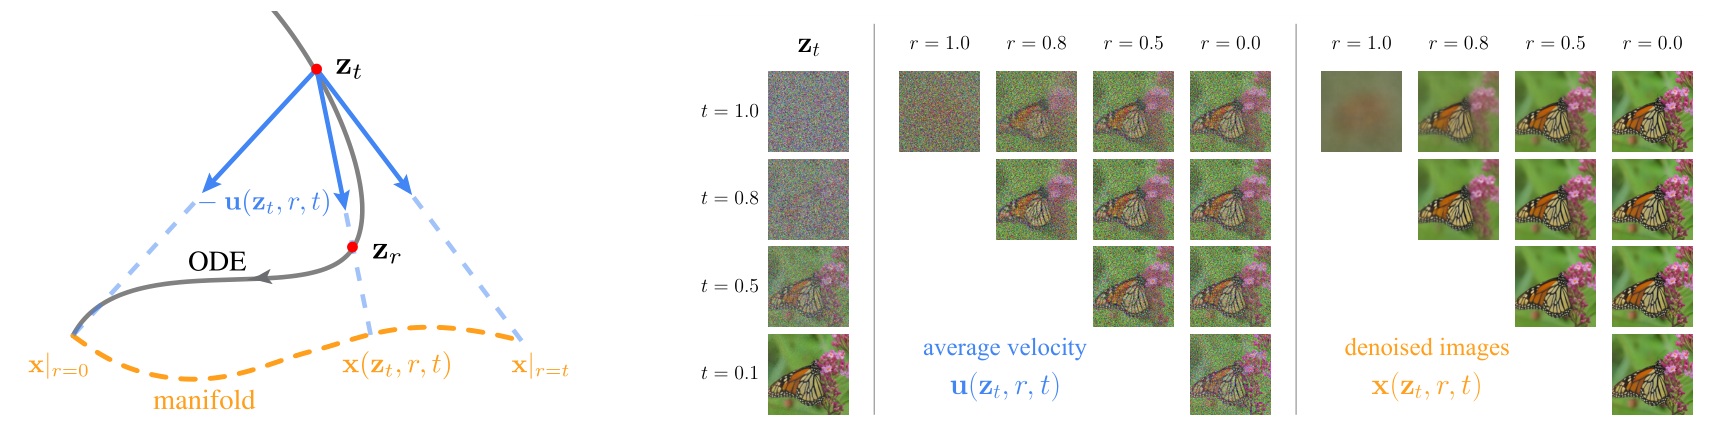
Figure 1 左侧解释轨迹与图像流形;右侧比较同一轨迹上的状态、平均速度与广义图像。附录 A.2 特别说明:使用预训练 JiT-H/16 求瞬时速度、数值积分得到轨迹,图中的速度为 负的平均速度以便显示。这张图是定义的可视化,不是 pMF 训练中额外调用教师,也不是对所有轨迹的证明。
03 · 从 Flow Matching 到广义图像场
| 符号 | 含义与维度 |
|---|---|
| \(x,\epsilon,z_t\) | 数据图像、随机噪声、插值状态,均为 \(H\times W\times3\) 像素张量;噪声尺度随分辨率或训练设置改变 |
| \(t,r\) | \(0\le r\le t\le1\),0 是数据端,1 是噪声端;JiT 原文时间方向相反 |
| \(v=\epsilon-x\) | 单个数据噪声配对的条件速度;与边缘场 \(v(z,t)=\mathbb E[\epsilon-x\mid z_t=z]\) 必须区分 |
| \(u(z_t,r,t)\) | 沿边缘 ODE 轨迹,在时间区间上的平均速度 |
| \(X(z_t,r,t)\) | 本文为避免与训练数据 x 混淆,用大写 X 记原论文的广义图像场 \(\mathbf{x}(z_t,r,t)\) |
| \(X_\theta,u_\theta,V_\theta\) | 网络直接输出、由输出转换的平均速度、加入 stop-gradient JVP 的复合瞬时速度预测 |
3.1 条件直线与边缘曲线不是同一条轨迹
\[z_t=(1-t)x+t\epsilon.\tag{1}\] \[v=\epsilon-x.\tag{2}\] \[\mathcal L_{\mathrm{FM}}=\mathbb E_{t,x,\epsilon}\|v_\theta(z_t,t)-v\|_2^2.\tag{3}\]给定配对的插值是直线,但训练 MSE 的最优预测是条件期望,即边缘速度。用于生成的 ODE 从 \(t=1\) 向 \(t=0\) 积分,边缘轨迹一般是弯的。不能拿单个配对的直线代替 MeanFlow 定义中的真实边缘 ODE 轨迹。
\[v_\theta(z_t,t)=\frac{z_t-X_\theta(z_t,t)}{t}.\tag{4}\]这是 JiT 的图像预测参数化:直接输出干净图像,损失却仍在速度空间。在这里 \(t=0\) 是奇点,训练实现需要数值处理;推理的一步入口为 \(t=1\),没有该除零问题。
3.2 平均速度与 iMF 的复合预测
\[u(z_t,r,t)=\frac{1}{t-r}\int_r^t v(z_\tau,\tau)\,\mathrm d\tau.\tag{5}\] \[v(z_t,t)=u(z_t,r,t)+(t-r)\frac{\mathrm d}{\mathrm dt}u(z_t,r,t).\tag{6}\]对积分上限求导,且固定 r,便得到 MeanFlow Identity;总导数沿 ODE 轨迹变化,包含状态与显式时间两部分。端点相等时用连续极限定义 \(u(z_t,t,t)=v(z_t,t)\)。
\[V_\theta=u_\theta+(t-r)\operatorname{sg}\!\left[\frac{\mathrm d u_\theta}{\mathrm dt}\right].\tag{7}\]iMF 以复合预测 V 回归瞬时速度,不再让网络裸输出直接对应训练回归量。stop-gradient 保留 JVP 的前向值,但阻断其参数反向传播,避免对 JVP 再求参数导数的高阶计算。它是训练策略,不能写成“恒等式证明网络无误差”或“整个损失完全不可导”。
3.3 pMF 的新对象
\[X(z_t,r,t)=z_t-t\,u(z_t,r,t).\tag{8}\] \[X(z_t,t,t)=z_t-t\,v(z_t,t).\tag{9}\] \[X(z_t,0,t)=z_0.\tag{10}\]当 r=t,边缘场条件期望给出熟悉的去噪估计。高噪声下它会平均多个可能的图像而模糊;“模糊”不意味着网络失败。当 r=0,由积分位移关系得到轨迹终点,因此理想情况下服从数据分布。这两条边界解释了为什么输出像图像。
额外推导:对一般中间 r,有
\[X(z_t,r,t)=\frac{t z_r-r z_t}{t-r},\qquad z_r=\frac{r}{t}z_t+\left(1-\frac{r}{t}\right)X(z_t,r,t).\]第一式是端点的仿射外推而非凸组合,因此中间场不必严格位于真实图像流形;第二式说明 X 也不是任意 r 下的终点图像 \(z_r\)。只有 r=0 才直接等于最终样本。作者对一般区间的“广义流形假设”应保持假设身份。
3.4 输出空间与损失空间的完整分工
\[u_\theta(z_t,r,t)=\frac{z_t-X_\theta(z_t,r,t)}{t},\qquad X_\theta=\operatorname{net}_\theta.\tag{11}\] \[\mathcal L_{\mathrm{pMF}}=\mathbb E_{t,r,x,\epsilon}\|V_\theta-v\|_2^2,\quad V_\theta=u_\theta+(t-r)\operatorname{sg}[\mathrm{JVP}].\tag{12}\]参数化链条是 图像 → 平均速度 → 复合瞬时速度 → 速度监督。这与直接在图像输出上使用像素 MSE 不同。训练样本 x 是数据配对,广义 X 的精确目标则取决于真实 ODE;无需提前计算真实 X 标签,恒等式与速度回归提供训练约束。
原 Table 1
| pred. space | conversion | loss space | |
|---|---|---|---|
| DiT | \(\boldsymbol{\epsilon}\) | - | \(\boldsymbol{\epsilon}\) |
| SiT | \(\mathbf{v}\) | - | \(\mathbf{v}\) |
| MF | \(\mathbf{u}\) | - | \(\mathbf{u}\) |
| iMF | \(\mathbf{u}\) | \(\mathbf{u}\rightarrow\mathbf{v}\) | \(\mathbf{v}\) |
| JiT | \(\mathbf{x}\) | \(\mathbf{x}\rightarrow\mathbf{v}\) | \(\mathbf{v}\) |
| pMF | \(\mathbf{x}\) | \(\mathbf{x}\rightarrow\mathbf{u}\rightarrow\mathbf{v}\) | \(\mathbf{v}\) |
完整重建固定 v1 Table 1,保留全部行、列、分组及原始数字。同版本原表
Table 1 的区别值得逐行记住:DiT 为噪声预测与噪声损失;SiT 为速度预测与速度损失;原 MF 平均速度预测与平均速度损失;iMF 是 u→v;JiT 是 x→v;pMF 是 x→u→v。网络输出形状相同,不等于预测语义相同。
04 · JVP、训练算法与真正的一步推理
4.1 Algorithm 1 的可复现解释
- 采样干净图像 x、噪声 ε 与满足顺序的 t、r,构造线性插值 z。
- 定义图像网络和 Eq.11 的 u 函数。以对角时间调用它,得到预测切向速度 \(\widehat v=u_\theta(z_t,t,t)\)。注意算法 1 使用的是预测场,不是直接把 \(\epsilon-x\) 用作 JVP 切向量。
- 对输入三元组 \((z,r,t)\) 计算 JVP,切向量为 \((\widehat v,0,1)\)。r 固定,t 增加,状态沿预测速度移动。
- 将 JVP 输出 detach,构造 Eq.7,再用 Eq.12 回归配对速度。通过 u 的直接分支更新参数。
对 Eq.11 展开还有
\[\frac{\mathrm d u_\theta}{\mathrm dt} =\frac{\widehat v-\mathrm dX_\theta/\mathrm dt}{t} -\frac{z_t-X_\theta}{t^2}.\]实际应让自动微分穿过图像到速度的整个转换,不能只求图像网络的 JVP 而忘掉除 t 与状态 z 的导数。该展开用于核对语义,不建议在实现中手工拼接不稳定分式。
4.2 训练与推理的成本完全不同
\[z_r=z_t-(t-r)u_\theta(z_t,r,t).\] \[z_0=\epsilon-u_\theta(\epsilon,0,1)=X_\theta(\epsilon,0,1).\]从噪声端 t=1 一次跨到 r=0,代数上恰好返回网络的图像输出。推理没有 JVP、没有优化循环、没有 VAE 解码器,也不需要同时运行条件与无条件两次网络。训练则包含额外速度头、引导目标构造、JVP 与感知网络,不能把 1-NFE 理解成训练每步也只做一次廉价前向。
官方采样代码保留多步接口:均匀时间网格,每步按平均速度更新。但本文主要结果都用 1-NFE;本文没有将未评估的多步质量改进当作结论。该任务为 ImageNet 类条件生成,不包含自然语言提示词、top-k、beam search、reranking 或外部 renderer。
4.3 感知损失为何可以直接接上
\[\mathcal L=\mathcal L_{\mathrm{pMF}} +\lambda_{\mathrm V}\mathbf1[t\le t_{\mathrm{thr}}]\, d_{\mathrm{LPIPS}}(A(X_\theta),A(x)) +\lambda_{\mathrm C}\mathbf1[t\le t_{\mathrm{thr}}]\, d_{\mathrm{ConvNeXt}}(A(X_\theta),A(x)).\]这是将正文总损失写成两种感知项的展开说明,不是新增论文编号公式。A 为两张图共享参数的随机裁剪缩放到 224²。标准权重 0.4 和 0.1,阈值 0.8;长程设置阈值为 0.6。只在噪声较低时使用,以减轻高度模糊预测与单个配对标签不相容的问题。
Reviewer:一般 r 的理想 X 未必等于训练配对 x;感知监督是一种有经验支持的额外偏置,不是 Eq.6 的严格推论。其改善说明该偏置有效,但不证明学到完全精确的概率流。当前代码对速度损失与每个感知损失均加入 detached adaptive weighting,实际训练不只是此处裸加权 MSE。
05 · CFG 如何被纳入一个网络
pMF 继承 iMF 的训练内引导。网络同时接收类别、引导强度和引导区间,学习在一次调用内产生具有引导效果的输出。不能将这里的 w 简单理解为推理时再把两张图线性混合。
\[v_c=u_\theta(z_t,t,t,w,c),\qquad v_u=u_\theta(z_t,t,t,w,\varnothing).\] \[v_g=(\epsilon-x)+\left(1-\frac1w\right)(v_c-v_u).\]固定 Algorithm 2 用上式构造目标,并把 \(v_g\) 放进 JVP 的状态切向量;其余条件变量的切向量为 0,t 的切向量为 1。算法中的 u 函数定义省略了 w、c 参数,但调用又传入它们,这是为简洁而写的伪代码,不能原样当可运行 Python。
为何不是常见的 w 倍公式?在理想对角固定点,若条件预测自身出现在目标内,则 \(v_c=\bar v_c+(1-1/w)(v_c-v_u)\) 整理为 \(v_c=w\bar v_c+(1-w)v_u\)。这解释了隐式目标与普通 CFG 的联系;实际有限模型与非对角区间不能保证恰好达到这个固定点。
| 细节 | 固定论文 | 当前官方实现核查 |
|---|---|---|
| JVP 切向量 | Algorithm 1 用预测对角速度;Algorithm 2 用 v_g | pmf.py.forward 使用预测条件辅助头 v_c;顺序为 (z,t,r),切向 (v_c,1,0) |
| 引导区间 | 正文称严格沿用 iMF,算法 2 明确省略区间实现 | 起点均匀 [0,0.5],终点均匀 [0.5,1];区间外 w=1;对角 FM 样本使用全区间 |
| 强度采样 | B 的分布 β=1,L/H 为 2 | 采样密度正比 \(w^{-\beta}\);cfg_max=7 时函数用 log1p,实际区间为 [1,8] |
| 无条件预测 | 伪代码向空标签分支也传同一 w | 实际空标签分支将 w 设为 1;类别置为 num_classes |
| 类别丢弃 | 概率 0.1 | 先采样丢弃数量,再将 batch 前部相应数量标签置空,并把目标恢复为未引导速度;不是逐元素直接保留原 Bernoulli mask |
| 停止梯度 | JVP detach | JVP 和 v_g 目标均 detach,辅助 v-head 单独监督 |
这些差异是固定论文与当前公开版本之间的可复现性记录,不能自动判定为 bug,也不能在复现报告中混成同一个实验。公开 B/16 配置的评估 w=8.5 甚至略超过上述默认采样上界 8;L/16 配置为 w=7.0,区间 [0.2,0.7]。最佳论文结果使用最优 CFG 与 EMA 搜索,不是所有模型固定同一组 w。
06 · 像素 Transformer、基础与大模型
pMF 使用 iMF 的 DiT 变体,固定空间序列为 16×16=256 个 patch。256² 图像用 16² patch;512² 用 32²;1024² 用 64²。单 patch 原始维度分别为 768、3072、12288,远大于 B 模型的宽度 768。因此“大 patch”带来的压缩压力是实验的核心,不是 incidental implementation detail。
| 计算路径 | 当前官方代码可验证的操作 | 对复现的影响 |
|---|---|---|
| 输入 | RGB patch→bottleneck embedding→hidden width;B/L bottleneck 128,H 256 | 不是独立预训练 VAE;和生成网络联合训练。Table 2 公平消融明确不用 bottleneck |
| 条件 token | 类别 8、时间差 4、引导强度 4、区间起终点各 2 | 合计 20 个条件 token,含图像共 276;“序列长度 256”指图像 patch,不是完整 Transformer 序列 |
| 时间条件 | 只显式嵌入 h=t−r,w 嵌入使用 1−1/w | 网络不显式接收绝对 t embedding;但输出到速度的转换仍依赖 t |
| block | RMSNorm、Q/K RMSNorm、二维 RoPE、SwiGLU、零初始化残差向量门;另有 learned positional embedding | 不是未经修改的原始 DiT adaLN 配方 |
| 分支 | 共享 depth−8 层,平均速度路径与辅助瞬时速度路径各 8 层;两者实际先输出图像再转速度 | 训练有两条 head,评估可删除辅助 head;参数/计算比较应注明统计路径 |
| 输出 | RMSNorm→零初始化 linear→unpatchify→(z−image)/clip(t,0.05,1) | 变量名 u/v 不等于最后线性层直接预测裸速度 |
原 Table 8
| configs | pMF-B | pMF-L | pMF-H |
|---|---|---|---|
| depth | 16 | 32 | 48 |
| hidden dim | 768 | 1024 | 1280 |
| attn heads | 12 | 16 | 16 |
| patch size | image_size / 16 | ||
| noise scale | image_size / 256 | ||
| aux-head depth | 8 | ||
| class tokens | 8 | ||
| time tokens | 4 | ||
| guidance tokens | 4 | ||
| interval tokens | 4 | ||
| bottleneck dim [1] | 128 | 128 | 256 |
| linear layer init | \(\mathcal{N}(0,\sigma^{2})\), \(\sigma^{2}=0.1/\mathrm{fan}_{\mathrm{in}}\) | ||
| epochs | 160† / 320 | 320 | 360 |
| batch size | 1024 | ||
| optimizer | Muon [2], with \((\beta_{1},\beta_{2})=(0.9,0.95)\) | ||
| learning rate | constant 1e-3 | ||
| lr warmup [3] | 0 epoch | ||
| weight decay, dropout | 0.0 | ||
| ema half-life (Mimgs) | {500, 1000, 2000} | ||
| ratio of \(r{\neq}t\) | 50% | ||
| \((t,r)\) cond | \(t-r\) | ||
| \(t,r\) sampler | logit-normal(0.8, 0.8) | ||
| cls drop [3] | 0.1 | ||
| CFG dist \(\beta\) | 1 | 2 | 2 |
| LPIPS weight | 0.4 | ||
| ConvNeXt weight | 0.1 | ||
| threshold \(t_{\text{thr}}\) | 0.8 | ||
完整重建固定 v1 Table 8,保留全部行、列、分组及原始数字。同版本原表
Table 8 完整保留了基础/大模型训练设置。B/L/H 的推理路径深度为 16/32/48、宽度 768/1024/1280、注意力头 12/16/16,辅助 head 深度均为 8。初始化方差写为 0.1/fan_in;代码中相关缩放常数 0.32,其平方约 0.1024,数值接近但不应混成完全相等的常量。
参数与算力:256² 的 B/L/H 为 119/411/956M、34/117/271 Gflops;512² 为 123/416/962M、34/118/272 Gflops。提高 patch 大小使主干 token 数不变,开销主要增在 patch embedding 与输出投影。这是结构 FLOPs 的优势,不是无损保证,更不是实际时延测试。
来源:Table 4–8;官方 pmfDiT.py。本节代码细节来自当前 main 源码快照,没有执行模型训练。
07 · 数据、训练配置与实现审计
7.1 数据和评价
任务是 ImageNet 1000 类条件 RGB 生成。论文默认在 256² 做 160-epoch 消融;系统比较包含 256² 与 512²,并额外用 1024² 说明固定 token 数的扩展能力。FID 与 IS 用 50,000 张生成图像,FID 越低越好,IS 越高越好。论文没有在本实验节重述数据集逐 split 的精确图像数,也没有提供独立文本到图像、跨域或视频实验。
官方实现读取 ImageNet train/val 文件夹;CPU 先按 ADM 风格缩放并中心裁剪,TPU 转 float32 并归一化到 [-1,1]。公开默认 use_flip=False,不能擅自补上惯常的随机水平翻转。感知损失使用成对随机裁剪,在生成图与真值上共享裁剪参数;裁剪尺度 [0.08,1]、宽高比 [3/4,4/3]、输出 224²。评估 reference statistics 必须匹配:仓库指出 TPU/JAX 与 GPU/PyTorch 的统计可能略有差异。
当前 ConvNeXt loader 明确读取 facebook/convnextv2-base-22k-224 预训练模型,感知距离使用全局平均池化及 LayerNorm 后的特征向量,分类 head 不参与,两个向量做平方差求和。因此“ConvNeXt variant”不应擅自描述成多层空间 LPIPS,也不能忽略 ImageNet-22k 预训练表示的贡献。
7.2 标准消融与长程系统训练分开复现
| 项目 | 标准 / 消融 | 正文系统比较的长程补充 |
|---|---|---|
| 时间分布 | logit-normal(0.8,0.8),排序保证 r≤t;50% 非对角 | logit-normal(0.0,0.8),另 10% 概率对 t/r 用均匀采样 |
| 噪声 | 尺度 image size/256 | 附录同时叙述 double noise scale;不可将改变时间分布与物理噪声尺度混为同一个开关 |
| 感知阈值 | 0.8 | 0.6 |
| 训练长度 | 消融 160 epochs;Table 5 同时 160/320 | B/L 320;H 系统最佳 360,Table 5 的 H-320 是 2.29 |
| 优化 | batch 1024;Muon;constant LR 0.001;warmup 0;weight decay/dropout 0;论文 β1=0.9、β2=0.95 | |
| EMA | 同时维护多个平滑尺度,挑最优;原表单位存在问题,见下面核查 | |
| 环境 | 基于 iMF 的 JAX/TPU;固定论文未给出每种模型的总 TPU 小时、峰值显存或完整墙钟训练时长 | |
长程设置措辞:附录“double noise scale by using a logit-normal...”的表述将两个量紧接在一起。本文保留其噪声翻倍、分布改为 (0,0.8)、均匀混合和阈值下降四项,不私自断言一种变换精确等价于另一种。当前 B/L 的公开 YAML 仍为 P_mean=0.8、noise_scale=1、阈值 0.8,且未开启 tr_uniform,故不能仅凭训练 epoch 相同就说完全复现 Table 6 的长程配方。
7.3 官方实现中必须单独记录的细节
- 时间 clipping 改变近数据端的精确代数。预测与目标都除 clip(t,0.05,1),所以当 t<0.05 时,目标不再严格等于 ε−x。此区间重建的 pred_x=z−t·u 也不再严格等于 head 的原始图像输出。正文 Eq.11 与一阶推理 t=1 不受这个等式差异影响。
- 辅助 v-head 与实际损失。训练 loss_u 和 loss_v 都对所有像素的平方误差求和,再做 detached adaptive weighting。感知项也分别重加权,最后 batch 平均。默认 norm_p=1、norm_eps=0.01;不是简单把像素平均 MSE 加两项感知损失。
- EMA 单位。原 Table 8 标题写“half-life (Mimgs)”并列 {500,1000,2000}。当前 ema_util.py 参数名明确为 kimg,并乘 1000,实际对应 0.5/1/2 million images,还用 step×1024×0.05 ramp-up。原表原样保留,但不能照其 Mimgs 字面配置成 500 million images。函数还硬编码 batch 1024,改变 batch 时应检查 EMA 等效时间。
- 配置重复键。B/L YAML 各出现两次顶层 dataset,前面指定 root,后面指定 image_size。官方 load_config.py 使用 yaml.FullLoader;本次仅对下载的文本做本地解析检查,确认 dataset 结果只剩 image_size=256,前一个 root 被覆盖。应修复重复键或在最终合并配置中核实 root;没有实际启动训练,不能声称已经观察到训练崩溃。
- 评估搜索。train.py 遍历 EMA、CFG interval 与 omega 选择最佳 FID,并报告对应 IS。应保存每次配置及完整网格,避免将 best-of-grid 与固定配置比较误认为相同预算。
这个表达式的反向梯度只是分母视作常量后的加权梯度;p=1 时不能把它当作常数 1 而声称没有梯度,也不能对分母求导。像素误差以 sum 而非 mean 汇总,会影响它与 norm_eps、感知项之间的标度。
08 · 全部消融:什么证据支持什么结论
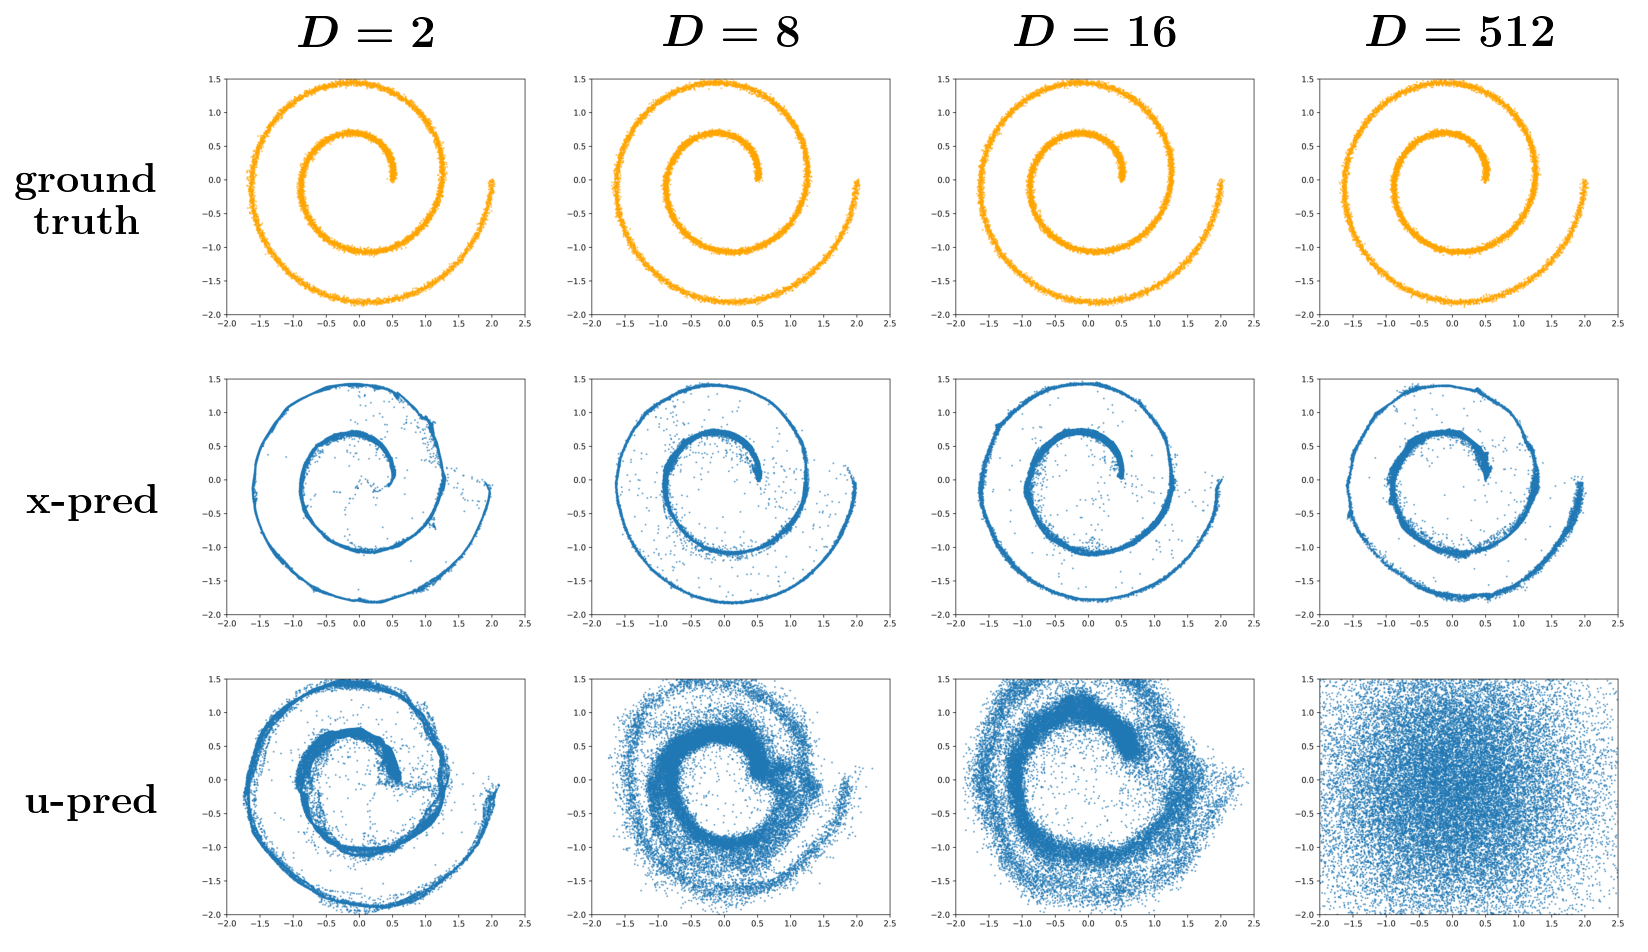
Toy experiment:把二维 Swiss roll 用列正交的 D×2 矩阵投影到 D∈{2,8,16,512} 的观察空间。相同 7 层、hidden 256、ReLU MLP,比较 u 与 x 参数化,二者都在 v-space 训练。随着观察维度提高,u 预测快速恶化,x 保持合理结果且训练损失更低。它隔离了低维数据嵌入高维空间的难点,但线性嵌入的 toy data 比自然图像简单,不能单独证明真实图像流形结构。
原 Table 2
| img | model | patch | seq | patch | 1-NFE FID | ||
|---|---|---|---|---|---|---|---|
| size | arch | size | len | dim | \(\mathbf{x}\)-pred | \(\mathbf{u}\)-pred | |
| (a) | 64\(\times\)64 | B/4 | 4² | 16² | 48 | 3.80 | 3.82 |
| (b) | 256\(\times\)256 | B/16 | 16² | 16² | 768 | 9.56 | 164.89 |
完整重建固定 v1 Table 2,保留全部行、列、分组及原始数字。同版本原表
64²、patch 4² 时,patch 维度仅 48,x/u 的 FID 3.80/3.82 几乎无差异;256²、patch 16² 时维度 768,x 为 9.56,而 u 达 164.89。表中保持 256 个 patch、B 模型、Muon、MSE、160 epochs,并刻意不使用 bottleneck embedding。证据强烈支持“当前容量与 patch 配置下输出参数化至关重要”,却不等于 u 在任意更宽架构或更小 patch 下都必然失败。


| Figure 3 定量读数 | FID | 比较条件 |
|---|---|---|
| Adam / Muon,160 epochs | 18.88 / 9.56 | B/16,MSE,图中终点 |
| Adam / Muon,320 epochs | 11.86 / 8.71 | 图注额外报告,不能当作 160-epoch 曲线终点 |
| MSE / 加 VGG-LPIPS / 再加 ConvNeXt | 9.56 / 5.62 / 3.53 | B/16,Muon,160 epochs |
Muon 的早期拟合可能改善自举 JVP/目标质量,从而放大收益,这是作者解释而非单独验证过的机制。感知项累计带来 6.03 FID 点改善,其贡献大到不能把最终 2.22 全部归功于 x 参数化本身。
原 Table 3 · a
| pre-conditioned \(\mathbf{x}\)-pred | \(\mathbf{x}\)-pred | |||
|---|---|---|---|---|
| linear | EDM-style | sCM-style | (no pre-cond) | |
| 1-NFE FID | 34.61 | 14.43 | 13.81 | 3.53 |
原 Table 3 · b
| time sampler | 1-NFE FID |
|---|---|
| only \(r=t\) | 194.53 |
| only \(r=0\) | 389.28 |
| only \(r=t\) and \(r=0\) | 106.59 |
| \(0\leq r\leq t\) (ours) | 3.53 |
完整重建固定 v1 Table 3,保留全部行、列、分组及原始数字。同版本原表
3a:加入线性、EDM、sCM 预条件后 FID 分别为 34.61、14.43、13.81,直接 x 输出为 3.53。若输出包含输入跳连,裸网络要预测的量可能重新含噪声,偏離图像流形;这一解释与结果一致,但不同预条件亦改变数值标度,不是纯粹测量流形维度的实验。
3b:只采 r=t 为 194.53,只采 r=0 为 389.28,只采这两条边界为 106.59,完整三角区域为 3.53。对角仅训练局部 FM,再要求一步跨全程本就非常苛刻。r=0 退化设置在概念上近似 consistency regime,但没有包含所有一致性模型专用训练机制,不能据此断言所有 CM 都失败。
原 Table 4
| img | model | patch | seq | patch | hidden | 1-NFE |
|---|---|---|---|---|---|---|
| size | arch | size | len | dim | dim | FID |
| 256\(\times\)256 | B/16 | 16² | 16² | 768 | 768 | 3.53 |
| 512\(\times\)512 | B/32 | 32² | 16² | 3072 | 768 | 4.06 |
| 1024\(\times\)1024 | B/64 | 64² | 16² | 12288 | 768 | 4.58 |
完整重建固定 v1 Table 4,保留全部行、列、分组及原始数字。同版本原表
分辨率从 256²→512²→1024²,B 模型维持 256 个图像 token,patch 维度从 768→3072→12288,FID 为 3.53→4.06→4.58。相对稳定表现支持 aggressive patch 的可行性;最高分辨率仍有退化,且不是完整 1024² SOTA 基准比较。
原 Table 5
| 1-NFE FID | ||||||
|---|---|---|---|---|---|---|
| depth | width | 参数量 | Gflops | 160-ep | 320-ep | |
| B/16 | 16 | 768 | 119 | 34 | 3.53 | 3.12 |
| L/16 | 32 | 1024 | 411 | 117 | 2.85 | 2.52 |
| H/16 | 48 | 1280 | 956 | 271 | 2.57 | 2.29 |
完整重建固定 v1 Table 5,保留全部行、列、分组及原始数字。同版本原表
扩大模型和训练时间均有效:160 epochs 下 B/L/H 为 3.53/2.85/2.57,320 epochs 下 3.12/2.52/2.29。最佳 H=2.22 属于 360 epochs 的系统结果,不应把 Table 5 的 320 epoch 单元格改成 2.22。没有多随机种子误差条,微小差距需谨慎解读。
来源:固定 PDF §5–6.2,Figure 2–3,Tables 2–5;原表各行各列保留于本页。
09 · 完整系统比较与计算预算
以下两表保留固定论文全部方法、NFE、空间、参数、Gflops、FID、IS 列及组别。括号为 latent decoder 参数/开销;Gflops 是一次生成器前向,不是完整多步采样的总开销。NFE 的 ×2 已包含条件/无条件 CFG 的双倍调用,不应再次乘 2。
原 Table 6
| ImgNet 256\(\times\)256 | NFE | space | params | Gflops | FID \(\downarrow\) | IS \(\uparrow\) |
| Multi-step Latent-space Diffusion/Flow | ||||||
| DiT-XL/2 [1] | 250\(\times\)2 | latent | 675M (49M) | 119 (310) | 2.27 | 278.2 |
| SiT-XL/2 [2] | 250\(\times\)2 | latent | 675M (49M) | 119 (310) | 2.06 | 277.5 |
| SiT-XL/2 + REPA [3] | 250\(\times\)2 | latent | 675M (49M) | 119 (310) | 1.42 | 305.7 |
| RAE + DiT\({}^{\text{DH}}\)-XL/2 [4] | 50\({\times}\)2 | latent | 839M (415M) | 146 (106) | 1.13 | 262.6 |
| Multi-step Pixel-space Diffusion/Flow | ||||||
| ADM-G [5] | 250\(\times\)2 | pixel | 554M | 1120 | 4.59 | 186.7 |
| SiD, UViT [6] | 1000\({\times}2\) | pixel | 2.5B | 555 | 2.44 | 256.3 |
| VDM++ [7] | 256\({\times}2\) | pixel | 2.5B | 555 | 2.12 | 267.7 |
| SiD2, Flop Heavy [8] | 512\({\times}\)2 | pixel | - | 653 | 1.38 | - |
| JiT-G/16 [9] | 100\(\times\)2 | pixel | 2B | 383 | 1.82 | 292.6 |
| PixelDiT-XL/16 [10] | 100\(\times\)2 | pixel | 797M | 311 | 1.61 | 292.7 |
| 1-NFE Latent-space Diffusion/Flow | ||||||
| iCT-XL/2 [11] | 1 | latent | 675M (49M) | 119 (310) | 34.24 | - |
| Shortcut-XL/2 [12] | 1 | latent | 676M (49M) | 119 (310) | 10.60 | 102.7 |
| MeanFlow-XL/2 [13] | 1 | latent | 676M (49M) | 119 (310) | 3.43 | 247.5 |
| iMF-XL/2 [14] | 1 | latent | 610M (49M) | 175 (310) | 1.72 | 282.0 |
| 1-NFE Pixel-space GAN | ||||||
| BigGAN-deep [15] | 1 | pixel | 56M | 59 | 6.95 | 171.4 |
| StyleGAN-XL [16] | 1 | pixel | 166M | 1574 | 2.30 | 260.1 |
| GigaGAN [17] | 1 | pixel | 569M | - | 3.45 | 225.5 |
| 1-NFE Pixel-space Diffusion/Flow | ||||||
| EPG-L/16 [18] | 1 | pixel | 540M | 113 | 8.82 | - |
| pMF-B/16 (ours) | 1 | pixel | 119M | 34 | 3.12 | 254.6 |
| pMF-L/16 (ours) | 1 | pixel | 411M | 117 | 2.52 | 262.6 |
| pMF-H/16 (ours) | 1 | pixel | 956M | 271 | 2.22 | 268.8 |
完整重建固定 v1 Table 6,保留全部行、列、分组及原始数字。同版本原表
原 Table 7
| ImgNet 512\(\times\)512 | NFE | space | params | Gflops | FID \(\downarrow\) | IS \(\uparrow\) |
|---|---|---|---|---|---|---|
| Multi-step Latent-space Diffusion/Flow | ||||||
| DiT-XL/2 [1] | 250\({\times}\)2 | latent | 675M (49M) | 525 (1230) | 3.04 | 240.8 |
| SiT-XL/2 [2] | 250\({\times}\)2 | latent | 675M (49M) | 525 (1230) | 2.62 | 252.2 |
| SiT-XL/2 + REPA [3] | 250\({\times}\)2 | latent | 675M (49M) | 525 (1230) | 2.08 | 274.6 |
| RAE + DiT\({}^{\text{DH}}\)-XL/2 [4] | 50\({\times}\)2 | latent | 831M (415M) | 642 (408) | 1.13 | 259.6 |
| Multi-step Pixel-space Diffusion/Flow | ||||||
| ADM-G [5] | 250\({\times}\)2 | pixel | 559M | 1983 | 7.72 | 172.7 |
| SiD, UViT [6] | 1000\({\times}\)2 | pixel | 2.5B | 555 | 3.02 | 248.7 |
| VDM++ [7] | 256\({\times}\)2 | pixel | 2.5B | 555 | 2.65 | 278.1 |
| SiD2, Flop Heavy [8] | 512\({\times}\)2 | pixel | - | 653 | 1.48 | - |
| JiT-G/32 [9] | 100\({\times}\)2 | pixel | 2B | 384 | 1.78 | 306.8 |
| 1-NFE Latent-space Diffusion/Flow | ||||||
| sCT-XXL [10] | 1 | latent | 1.5B (49M) | 552 (1230) | 4.29 | - |
| MeanFlow-RAE [11] | 1 | latent | 841M (415M) | 643 (408) | 3.23 | - |
| 1-NFE Pixel-space GAN | ||||||
| BigGAN-deep [12] | 1 | pixel | 56M | 76 | 7.50 | 152.8 |
| StyleGAN-XL [13] | 1 | pixel | 168M | 2061 | 2.41 | 267.8 |
| 1-NFE Pixel-space Diffusion/Flow | ||||||
| pMF-B/32 (ours) | 1 | pixel | 123M | 34 | 3.70 | 271.9 |
| pMF-L/32 (ours) | 1 | pixel | 416M | 118 | 2.75 | 276.8 |
| pMF-H/32 (ours) | 1 | pixel | 962M | 272 | 2.48 | 284.9 |
完整重建固定 v1 Table 7,保留全部行、列、分组及原始数字。同版本原表
9.1 结果该怎么读
- 256² pMF-H/16 的 FID 2.22,明显优于表中同类一步像素 diffusion/flow EPG-L/16 的 8.82,差 6.60;EPG 的自监督预训练、参数与配方不同,因此不是严格单变量消融。
- 256² 相比 StyleGAN-XL 的 2.30,FID 接近且 pMF FLOPs 更低;IS 268.8 对 260.1。512² StyleGAN-XL 的 FID 2.41 仍略优于 pMF-H/32 的 2.48,而 IS 267.8 低于 284.9。不能把“competitive”改写成全面超过 GAN。
- 一步 latent iMF-XL/2 在 256² FID 1.72 优于 pMF 2.22;它需要 decoder,但这不是质量指标的扣分理由。多步 latent RAE+DiT 在两个分辨率均为 1.13,多个像素多步方法也比 pMF 更低。本文补齐的是速度、空间与质量的组合,而非赢下每一列。
- B/16 只有 119M/34G,FID 3.12;L/16 为 411M/117G、2.52;H/16 为 956M/271G、2.22。实际部署若计算预算很小,基础模型可能比最高 FID 结果更 relevant。
9.2 将解码器计入端到端预算
\[C_{\mathrm{sample}}\approx N_{\mathrm{FE}}C_{\mathrm{generator}}+ C_{\mathrm{decoder}}.\]| 例子 | 由原表计算的单样本 Gflops | 解释 |
|---|---|---|
| 256² iMF-XL/2 | 175+310=485 | pMF-H 为 271,约少 44.1%,但 iMF 的 FID 更低 |
| 256² DiT-XL/2 | 500×119+310=59,810 | 不能把表中的 119 与 pMF 271 直接当端到端生成成本比较 |
| 512² sCT-XXL | 552+1230=1782 | pMF-H/32 为 272;约 6.55 倍理论 FLOPs 差距 |
| 512² MeanFlow-RAE | 643+408=1051 | pMF-H/32 为 272,FID 2.48 对 3.23 |
上述是本页根据原表计算的预算,不是测得速度比。batch、硬件、算子利用率、内存、编译与分辨率都会影响真实吞吐。VAE 解码通常只在最后执行一次,不能每个 NFE 都加一遍。论文强调标准 SD-VAE decoder 在 256/512 下为 310/1230G,确实超过其单个 pMF 生成器,但此结论针对所列解码器,不代表所有可能的轻量解码器。
9.3 官方发布权重与原论文分列
| 模型 | 论文 FID / IS | 官方仓库 FID / IS |
|---|---|---|
| B/16,256² | 3.12 / 254.6 | 3.11 / 256.4 |
| L/16,256² | 2.52 / 262.6 | 2.50 / 266.0 |
| H/16,256² | 2.22 / 268.8 | 2.11 / 270.5 |
| B/32,512² | 3.70 / 271.9 | 3.64 / 274.4 |
| L/32,512² | 2.75 / 276.8 | 2.73 / 276.6 |
| H/32,512² | 2.48 / 284.9 | 2.37 / 285.3 |
仓库说明其结果在 TPU v5p-64 上计算,并提示统计/计算环境差异。这不是本次复测,也不能拿更新权重的数字替换固定 PDF 单元格。需要验收复现时,记录 checkpoint、EMA、CFG、统计文件、代码快照和硬件,并使用同一评估实现。
10 · 全部定性结果与展示条件


Figure 4 是 H/16 的 256² 单次前向样本,列出 house finch、bee、palace、stone wall、coral reef 五类。所有面板均保留,不只挑一个最漂亮的样本。论文称给定类别下 uncurated,但类别选择仍是展示设计的一部分,不能等同随机抽取所有 ImageNet 类的统计检验。


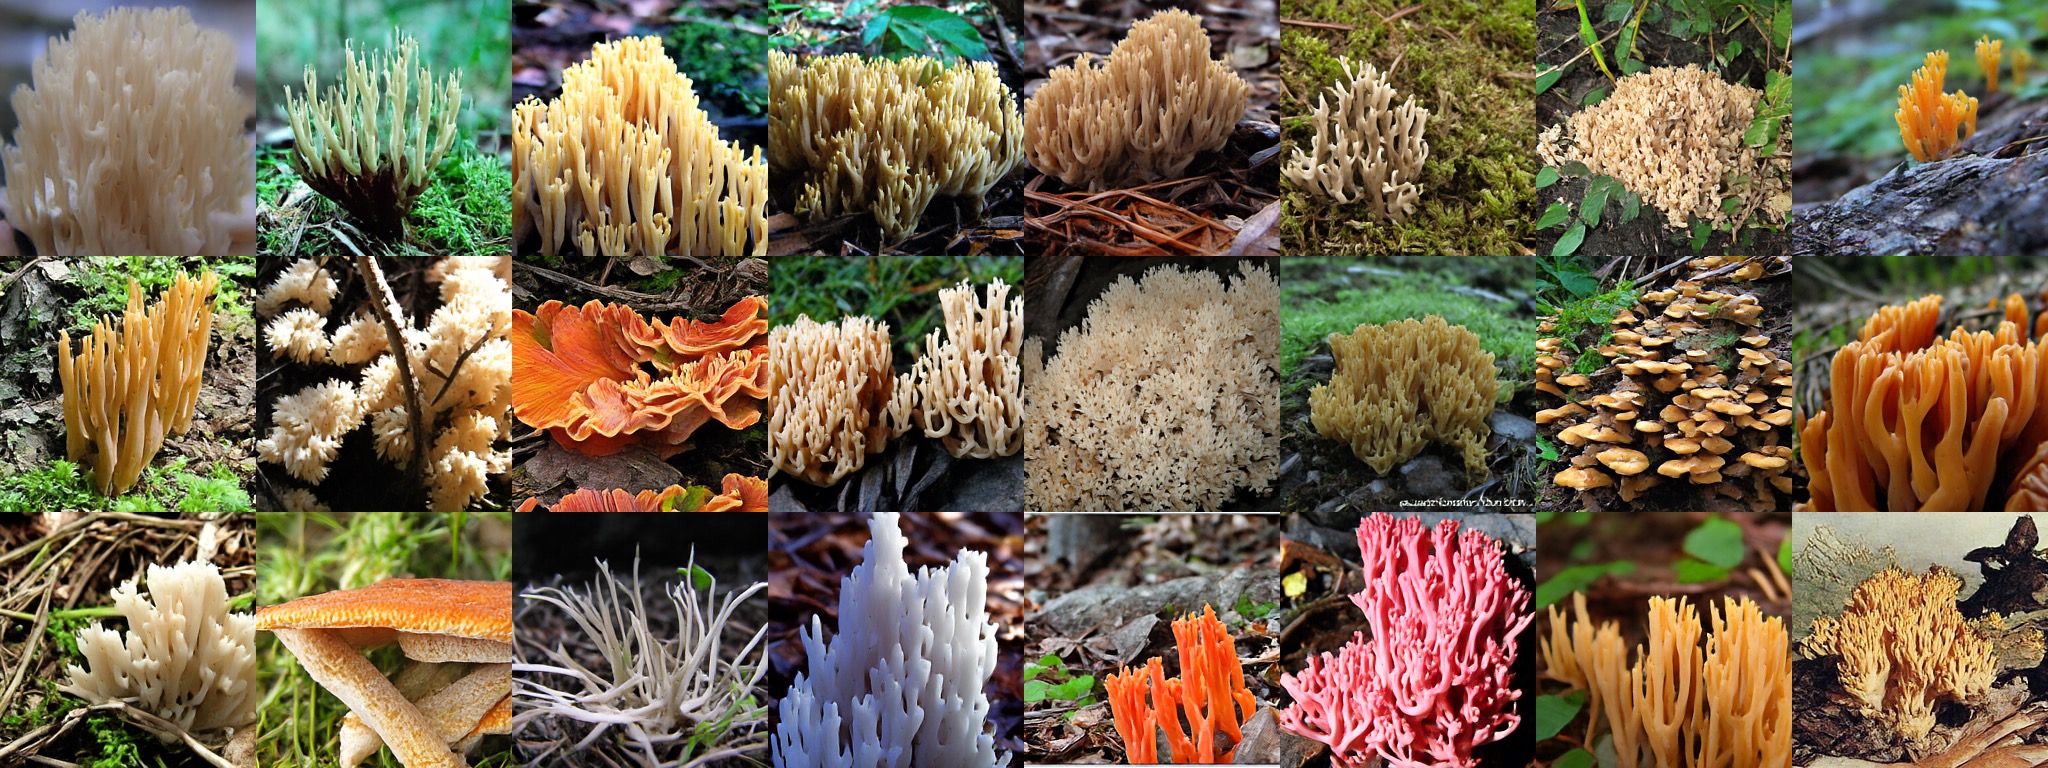
附录 Figure 5 与 6 各覆盖 12 类,从动物、交通工具到建筑、地形和材质外观,展示语义多样性。附录明确采用 w=7.0、区间 [0.1,0.7],对应 FID 2.74、IS 290.0,不是摘要的 FID 2.22、IS 268.8。更高 IS 与更低 FID 不必同时出现,这些图不能作为“2.22 配置的直接示例”来标注。
图片用于观察大尺度结构、类别一致性、局部纹理与重复模式,不是物理正确性、3D 一致性、文本遵循或材质参数可辨识性的测试。浏览器真实加载与缩放可读性待下载验收;远程图资源保留官方 URL,缺少可用图资源的 Figure 1 从固定 PDF 内嵌。
11 · Reviewer:强项、疑点与最有价值的复现
强项
- 一个简单、可解释的 reparameterization 将 JiT 与 iMF 对接,不需要用黑箱蒸馏掩盖一步生成机制。
- 明确区分 prediction space 与 loss space,有完整边界解释,并用 toy、维度变化和自然图像消融串成证据链。
- 系统比较计入 latent decoder,修正了在一步时代容易误导的 FLOPs 比较;基础和大模型均报告。
- 公开训练、模型、采样与权重,使论文简洁公式之外的工程选择可以被检查。
限制与需要降调的结论
- 流形论证并不封闭。中间 r 的广义图像只是经验上像干净图;模糊图像也未必严格处于真实图像流形。损失、网络容量与预条件数值尺度均可能解释部分收益。
- 质量来自组合。x-pred、Muon、两种感知损失、辅助头、CFG、EMA、长程配方共同作用。已有消融很有价值,但没有完整 factorial design,也没有量化每项的训练算力成本。
- 训练仍有外部视觉知识。latent-free 排除独立 tokenizer,不排除感知特征网络。若比较“完全从零数据学习能力”,必须把预训练感知模型计入资源。
- 理论与工程有间隙。JVP 切向、时间 clipping、辅助损失、EMA 单位、配置覆盖等均影响复现。公式简洁不等于默认脚本与每个表的配方完全对应。
- 评价范围有限。主要是 ImageNet FID/IS;没有文本、多视角、物理材质、强组合语义、训练集记忆分析或任务级人评。未提供多种 seed 的区间估计。
- 速度论据是 FLOPs。没有统一硬件上的完整训练/推理延迟与能耗;模型大到 956M,单步不保证对所有设备轻量。
优先复现实验
| 实验 | 固定项 | 观察量 / 判别作用 |
|---|---|---|
| v_g 与 v_c 的 JVP tangent | 同 seed、架构、时间样本、感知项 | 收敛、FID、JVP 范数;回答算法 2 与代码差异是否重要 |
| clip 0.05 与更小阈值 | 同时间分布与 loss scaling | 近数据端误差、数值稳定性与梯度异常;不能仅看最终 FID |
| x/u 参数化 × patch × width | 匹配 FLOPs 和训练预算 | 容量阈值是否能解释失败,避免只在一组 B/16 得出普遍结论 |
| 无感知 / VGG / ConvNeXt / 二者 | 固定数据与训练步,计入感知前向成本 | FID、precision/recall、纹理频谱、类覆盖;检验外部表示贡献 |
| 统一端到端测速 | 同设备、batch、分辨率、精度;包含 decoder | p50/p95 latency、吞吐、峰值显存、能耗;验证 FLOPs 推断 |
12 · 面向 Procedural Material Generation 的研究延伸
Research Extension,均未由 pMF 验证:最有价值的迁移不是“用一次 RGB 图像生成代替程序材质图”,而是学习它如何选择网络容易表达的直接输出,并在真正的任务空间施加约束。自然 RGB 像素、材质贴图、着色器程序属于不同对象。
方向 A:一次生成联合材质贴图,再用多光照约束
将输出扩为 base color、roughness、metalness、normal 等连续通道,直接预测物理上容易解释的最终贴图,MeanFlow 在相应连续张量上建模。但各通道支持集不同,法线单位长度、roughness 范围与能量守恒需显式参数化,不能套用 RGB 的 perceptual distance 就宣布可用。
\[\mathcal L_{\mathrm{mat}} =\mathcal L_{\mathrm{flow}} +\lambda_R\sum_{\ell\in\mathcal L} d\!\left(R(M_\theta,\ell),I_\ell\right) +\lambda_{\mathrm{phys}}\mathcal C(M_\theta).\]此式为研究提案:R 是多光照 renderer,C 检查范围、法线和物理约束。用多光照、多视角监督降低把阴影烘焙进 albedo 的风险。验证应报告渲染误差、贴图误差、跨光照泛化、接缝与材质多样性,不能只报告单光照 FID。
方向 B:程序图的“干净目标”与执行反馈
程序拓扑包含离散节点、类型化端口和 DAG 约束,不能直接把 Eq.11 对像素的线性运算套在 graph token 上。较可行的两阶段方向是:先产生合法 typed graph 骨架,再用一次连续参数场预测节点参数;生成后的编译/执行验证负责检测未支持节点、循环、参数越界与 bitmap 依赖。
网络直接输出可执行参数,loss 则放在多尺度节点预览或最终 renderer 的行为上,对应“输出空间与监督空间分开”的原则。必须有非微分执行失败处理,不要只对能渲染的样本报告平均质量;失败率应计入主结果。若使用不可微编辑器,采用安全约束搜索或黑箱优化,而非声称 pMF 自带可微 graph compiler。
方向 C:把快生成省下的预算用在可验证的候选搜索
一步生成可以快速提出多个贴图/参数候选,再用 renderer、物理规则与用户目标排序,最后只局部修正。这是系统级方案,不再是严格 1-NFE 端到端输出;报告时必须计入候选数、执行次数与优化耗时,避免用“一步”掩盖后处理成本。
| 最小可行实验 | 对照 | 成功标准 |
|---|---|---|
| 固定图拓扑的连续参数 pMF | 多步 flow、直接回归、随机搜索 | 相同总 renderer 调用预算下,合法率、渲染相似度、多样性同时有竞争力 |
| tileable 多通道贴图 | RGB pMF 后处理、VAE 材质 diffusion | 周期边界梯度连续,法线合法,换光照不失真;不能只靠裁掉边缘 |
| 程序重建蒸馏的偏差检查 | 只有图像感知损失与含节点级监督 | 区分“渲染相似”与“真实程序结构正确”,评估可编辑性及参数可识别性 |
潜在负结果同样重要:高维材质参数未必比 RGB 更低维;程序的多解性可能使配对 MSE 产生平均化的无效参数;感知分类器可能偏好语义形状而忽略微表面统计。应先在小型受控材质族上检验,再扩展到开放图生成。
13 · 来源、覆盖与待验收事项
- 固定原 PDF v1:正文、参考文献、附录 A/B 全 13 页;全部 12 个编号公式、2 个算法、8 张编号表及 6 张编号图。
- 同版本 arXiv HTML:用作完整原表与官方图片定位,关键数字回查固定 PDF;缺图用固定 PDF 裁图。
- PMLR ICML 2026 正式记录:核实出版身份,不替换 v1 分析对象。
- 官方 pMF 仓库:README、pmf.py、models/pmfDiT.py、训练主循环、B/L 配置、default、EMA、感知和输入工具等;读取当前源码快照,未运行训练、下载权重或复测 FID。
事实层级:原 PDF 的定量结果为 Paper Verified;流形普遍性、Muon 自举解释为 Author Claim;推理代数、预算和实现差异为 Our Interpretation / Code Verified;材质图、物理约束与候选搜索为 Research Extension。
交付状态:中文 HTML 与全量 Markdown 新增内容、原笔记逐字节前缀保留的合并候选、证据与归档建议均用于下载验收。没有修改原 vault、People 或共享索引。浏览器实际图片加载、MathJax 渲染和 1440/760/390px 布局检查按用户要求延后;静态检查不能冒充浏览器验收。