01 · 论文身份与阅读结论
Paint by Example 把“参考图里的物体放进这块区域”做成通用图像条件补全模型。关键是主动丢弃可直接复制的空间细节,再用生成先验、上下文与增强训练,让物体重新适配目标场景。
Paper verified 固定阅读版本为 arXiv:2211.13227v1,2022-11-23,15 页合订 PDF:正文第 1–9 页、参考文献第 10–12 页、附录第 13–15 页。本页原 Figure 1–13、Eq. 1–5 和 Table 1–3 均使用该版本编号。另完整核对 CVPR 2023 正式论文(11 页,18381–18391)与独立 supplement(5 页);后者图单独标记“CVPR 补充 Figure”,避免混淆。固定 PDF · 会议记录
作者顺序为 Binxin Yang、Shuyang Gu、Bo Zhang、Ting Zhang、Xuejin Chen、Xiaoyan Sun、Dong Chen、Fang Wen。第一作者机构为 University of Science and Technology of China,合作机构为 Microsoft Research Asia。固定 v1 的星号仅说明 Binxin Yang 在微软亚洲研究院实习;CVPR 正式 PDF 第 1 页的 † 明确 Bo Zhang 为通讯作者。既有笔记的 Fang Wen 未核实候选应在后续归档时更新,本次完整保留原文前缀。2022 是预印本年份,正式发表年份是 2023。作者标记
贡献
用自监督对象裁剪构造训练对;用单一 CLIP 全局 token 与强增强阻断自我复制捷径;训练可读取任意新参考的图像条件补全模型。
证据
COCOEE 3,500 对输入上,CLIP 特征 FID 3.18、QS 77.80、区域 CLIP 84.97;50 人排序实验质量平均名次 1.79。
边界
自然融合与实例细节存在冲突;单 token 不保留精确几何、数量和局部纹理。没有严格身份保持、3D 或材质图生成保证。
阅读警报:“single forward”表示无需逐图优化,实际仍是多步扩散;FID 用 CLIP 特征,不能直接与 Inception-FID 横比;Table 3 最终模型没有最高的 CLIP 相似度,也不是每次叠加都改善全部指标。
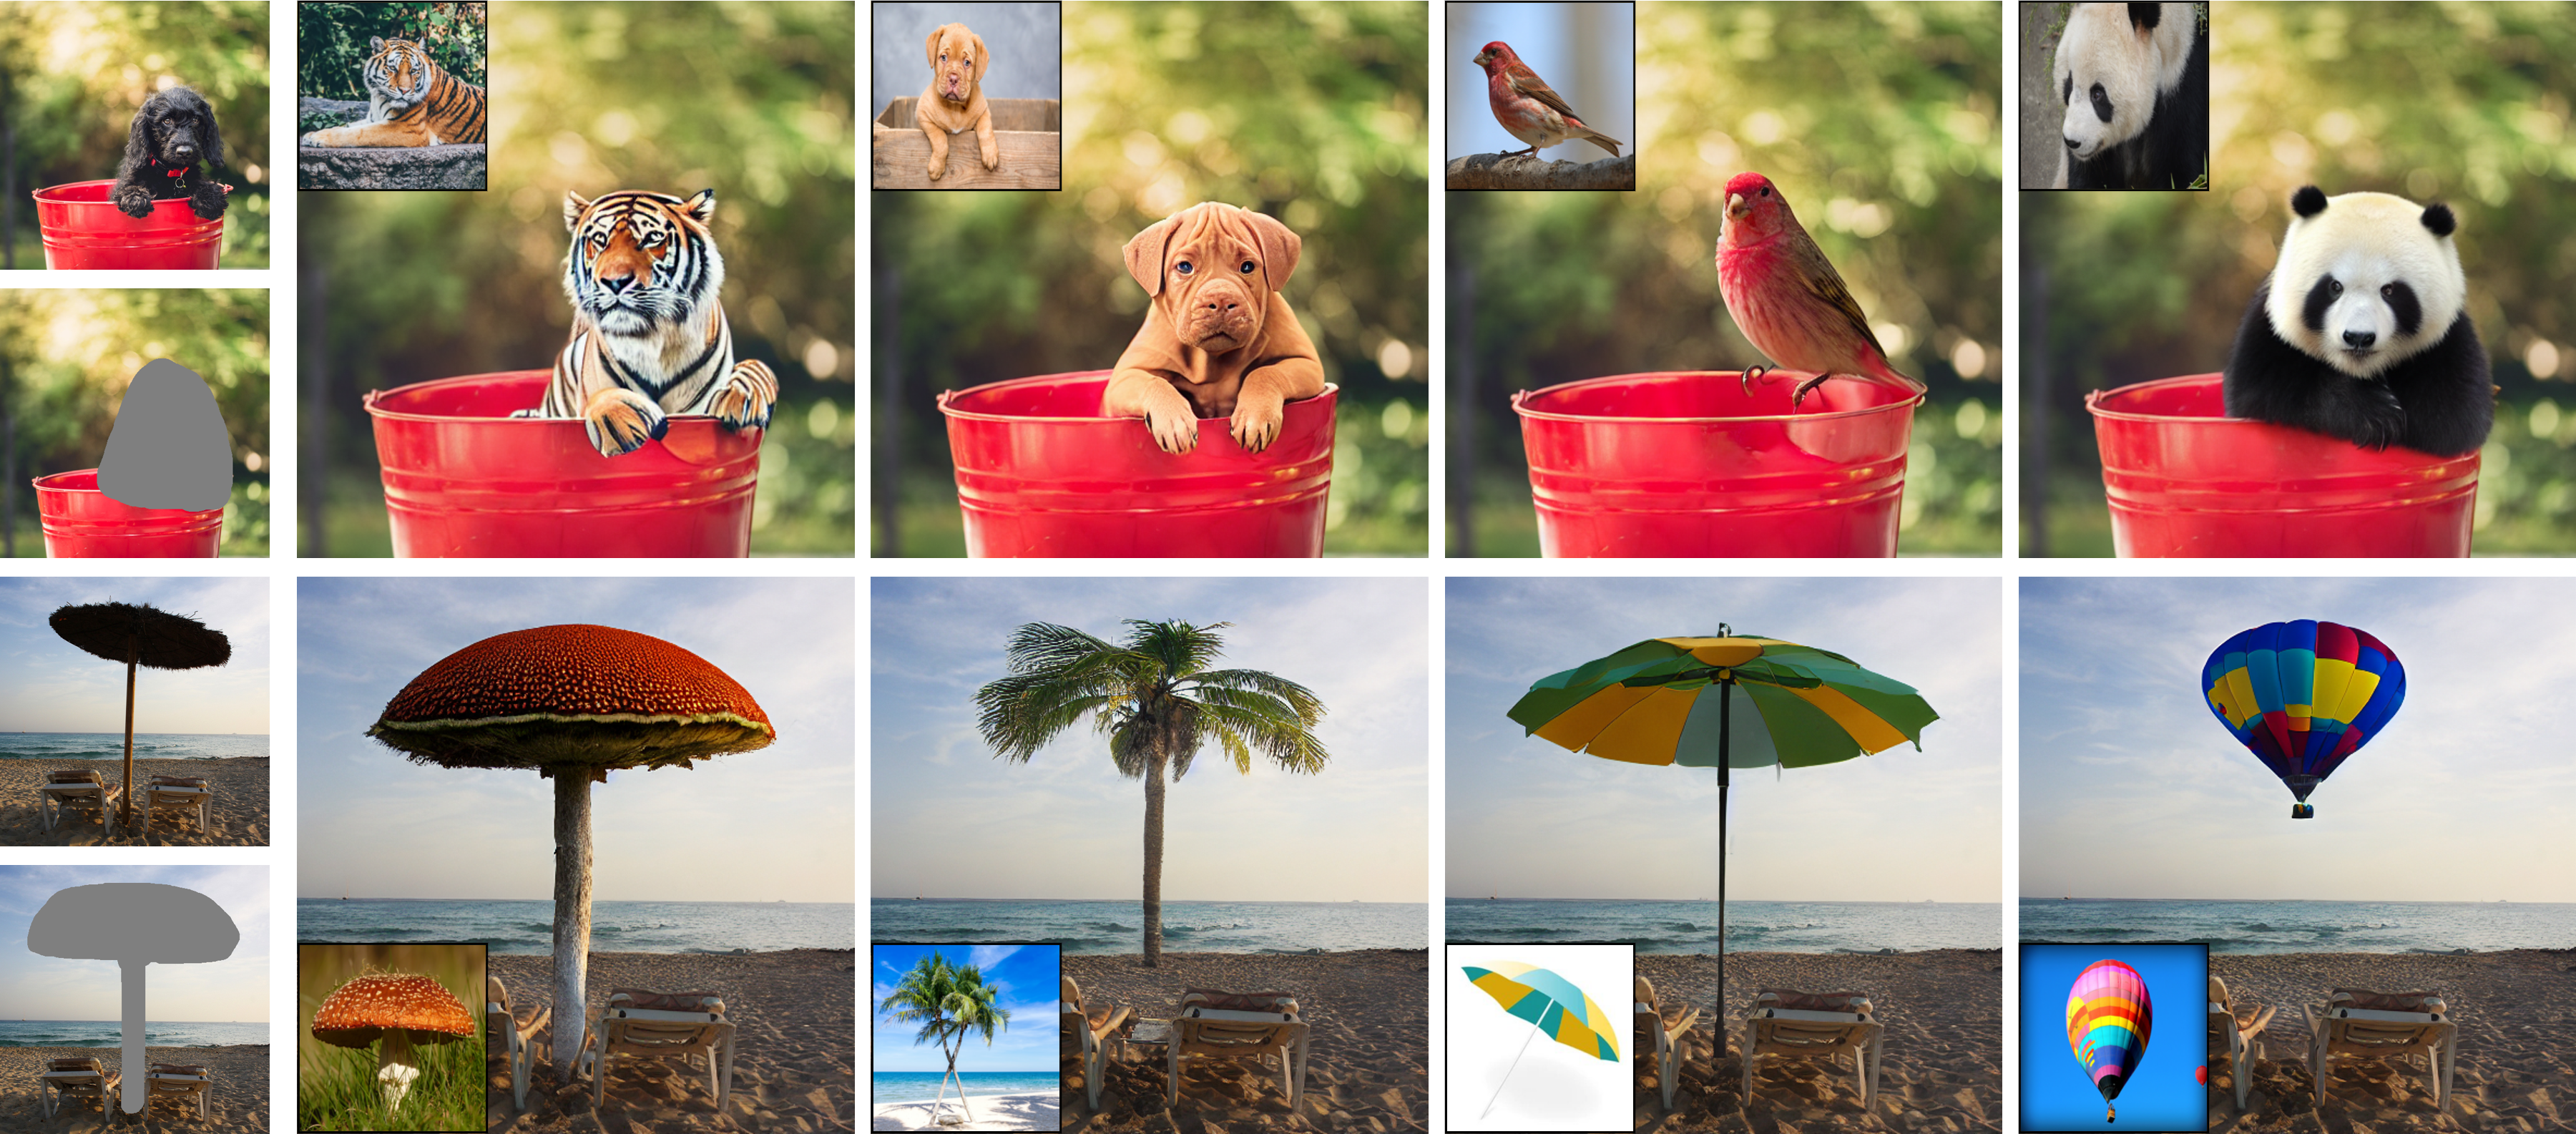
Figure 1 的 arXiv HTML 没有图像资源,本页使用作者官方 teaser;开篇原版排布以固定 PDF 第 1 页为准。其余 v1 Figure 直接引用 arXiv 原图。
02 · 任务定义与方法边界
输入是源图 \(x_s\in\mathbb{R}^{H\times W\times3}\)、参考图 \(x_r\in\mathbb{R}^{H'\times W'\times3}\) 和二值编辑掩码 \(m\in\{0,1\}^{H\times W}\)。论文约定 \(m=1\) 为重绘区域,\(m=0\) 为尽可能保留的区域。输出 \(y\) 在区域内应像参考对象,同时在姿态、尺寸、视角、光照和边界上适合背景。
\(b\) 是抹除编辑区域的背景条件,\(\odot\) 为逐元素乘法。上式统一任务记号,不是额外训练损失。目标同时要求背景保留、参考语义保留和组合合理;三者并不总能最大化。例如参考是侧脸狗,目标适合正脸狗时,就需要牺牲部分像素相似度。§3
| 设置 | 条件和主要能力 | 与本文的区别 |
|---|---|---|
| Harmonization | 已粘贴前景,主要改颜色与光照 | 本文可以重新生成姿态、形状和视角 |
| 文本 inpainting | 背景、mask、类别或描述 | 参考图传达难以逐字描述的外观组合 |
| 实例个性化微调 | 针对一个实例额外训练 | 本文每个新参考无需实例专属微调 |
| 精确像素粘贴 | 几何变换、alpha 合成 | 本文生成新像素,不保证 logo、纹理和数量完全相同 |
| 本文 | 源图 + 区域 + 一张参考图 | 语义合成,无显式 3D、材质、renderer 或布局规划器 |
Our interpretation 它是 reference-conditioned semantic completion。没有输出 mesh、PBR 参数、shader graph、程序或 agent 轨迹;“参考可从数据库检索”仅说明输入来源,并不是另一个受评估的检索模块。mask 形状约束生成空间,不等于精确物体轮廓控制。

Figure 2 显示多种对象与场景的覆盖面,但属于精选定性结果。没有失败率、随机抽样说明和分领域统计,不能由此推到任意对象、任意视角。
03 · 自监督数据与复制捷径
理想监督需要“源图、异源参考、mask、人工编辑结果”四元组,成本很高。作者从普通带框图像中裁出对象作为参考,移除对应区域,再要求模型重建原图。目标 \(y_0=x_s\) 自动获得,bounding box 提供对象级条件。
正文简写 \(x_r=m\odot x_s\),实际代码裁出、缩放并归一化 patch,而不是把黑底整图直接送给 CLIP。危险在于训练参考本来就是答案,网络只需学会把它搬回洞里;测试参考来自另一张图,姿态、背景和光照都变了。
此恒等式说明训练重建损失降低并不代表学会语义适配。朴素方案把文本条件的 77 tokens 换成 CLIP 图像的 257 tokens(1 class + 256 patch),丰富局部信息给复制提供便利。Figure 3 的边界与姿态违和是退化证据;它不证明所有多 token 方法必然失败。§3.1

三个互补约束:生成先验提供自然图像能力;瓶颈削弱精确搬运答案的路径;增强打破源与参考的像素对应。只有先验仍可能在长期微调后学回复制捷径,Table 3 的逐步实验正围绕这一假设。
04 · 信息瓶颈与条件表达
v1 称 information bottleneck,CVPR 正式版称 content bottleneck。核心相同:只保留 CLIP 全局 class 表示,丢弃 256 个 patch tokens。参考由 \(224\times224\times3\) 压成一个 1024 维向量,再由可训练映射送入扩散网络。
这是 Eq. 2 的展开:\(A\) 是参考增强,\(h_r\) 保留总体语义与外观,\(c\) 是 U-Net 条件。瓶颈在参考编码后、cross-attention 前发生。没有互信息最小化、变分信息瓶颈上界或显式 KL;这是表示压缩的工程做法。§3.2.1
当参考不再提供可定位细节,网络必须依赖背景与生成先验重新绘制对象,获得改姿态、改光照的自由度;代价是高频图案、数量和精确轮廓易丢失。高 CLIP 相似度不能保证具体身份。
公开实现的真实结构
Code verified 固定提交 52a7e3736d579889e13c988403b7fd721bb22293 的 FrozenCLIPImageEmbedder 使用 openai/clip-vit-large-patch14,取 pooler_output 并扩成一个 token;接 5 个宽 1024、单头、序列长 1 的 residual Transformer blocks 和 LayerNorm;扩散类中的 proj_out 再投影 1024→768,得到 \(c\in\mathbb R^{B\times1\times768}\)。CLIP 主干冻结,mapper、末端归一化和投影训练。编码器 · mapper
附录写“15 个 FC layers”,当前实现却是 5 residual attention blocks;每块含 QKV、attention 输出和两层 MLP 投影,不能把二者机械视为同一层数定义。本页分别记录,不能仅按一句论文描述搭一个 15 层裸 MLP。pooler_output 也不等于未经后处理的全部 last hidden states。
Our interpretation 当参考序列只有一个 token,cross-attention 每个 query 对唯一 value 的权重均为 1,因此不能在多个参考 patches 中做空间选择。它仍能把全局条件注入各层,由源图特征、残差、自注意力和卷积产生空间差异。这是代数解释,不意味着整体输出空间恒定,也不是作者额外做过的实验。
05 · 模型结构与条件通路

训练有三条支路:完整源图经 VAE 得到目标 latent;masked source 经同一 VAE 提供背景 latent;参考 crop 经冻结 CLIP 和可训练 mapper 提供语义。U-Net 读取加噪目标、干净背景 latent、mask,预测四通道噪声。
\(E\) 简写 VAE 编码及 posterior 取样,\(\bar m=1-m\) 是保留 mask,波浪表示缩到 latent 空间。512 输入下 VAE 下采样 8 倍;通道数为 4+4+1。代码只给前 4 通道目标 latent 加噪,后 5 通道固定提供条件。get_input · p_losses
Stable Diffusion v1-4 文生图首层卷积由 4 通道扩为 9 通道,新增 5 通道权重置零,原权重保留。这样起点不会因随机新权重破坏生成函数,后续逐渐学习利用背景与 mask。没有 LoRA,也不是只训小 adapter:整个 U-Net 参数进入优化器。权重改造
| 组件 | 设置 | 训练或作用 |
|---|---|---|
| 基础模型 | SD v1-4;1000 diffusion steps | 生成先验;U-Net 参与微调 |
| U-Net | 9 输入、4 输出通道;model_channels 320;channel_mult [1,2,4,4];每层 2 residual blocks | 空间条件 concat,语义 cross-attention |
| Attention | 8 heads;resolutions [4,2,1];depth 1;context_dim 768 | 联合源场景与全局参考 |
| VAE | AutoencoderKL,4 latent channels,scale 0.18215 | 冻结,编码目标与背景、解码输出 |
| 视觉编码 | CLIP ViT-L/14,224,1024 维全局表示 | 主干冻结 |
| Mapper | 5 residual blocks + LayerNorm + 1024→768 | 参与训练;与附录 15 FC 描述分开记录 |
| 无参考向量 | 可学习 \(1\times1\times768\) 向量 \(v\) | 条件 dropout 和 CFG 基准 |
配置没有 SDXL 或更大生成主干的独立实验。ViT-L 是条件编码器,ViT-B 是评估器,不是两种生成模型规模。总参数量、FLOPs、峰值显存未明确报告,本页不猜测。
06 · 扩散目标与公式版本修正
固定 v1 在 §3.1 写 \(y_t=\alpha_t y_0+(1-\alpha_t)\epsilon\)。这不是代码所用标准方差保持 DDPM 形式。CVPR 正式版第 3 页已改成平方根累积系数形式。下方给出与实际实现相符的 latent 公式,并保留版本差异说明。
\(t\) 是随机时间步,\(\beta_t\) 是噪声 schedule,\(\bar\alpha_t\) 是累计信号系数。加噪对象是目标 latent,背景和 mask 不加噪。不能因固定 v1 而把旧式直接当复现公式。CVPR 修正
这是原 Eq. 1 的 latent 展开;噪声预测与已知噪声做 MSE,\(\theta\) 包括 U-Net 与可训练映射。代码对全部 latent 空间平均,而不是只对 mask 内算损失。没有另加 CLIP、LPIPS、边界或对抗损失。模型通过重建同时学习背景保留和对象重绘。损失实现
基类提供可选 log-variance 和 VLB 分支,但当前默认 learn_logvar=False、original_elbo_weight=0,不能把未开启分支当本文技巧。训练阶段优化参数;测试的反复网络调用属于采样,不是逐图梯度优化。
Author claim 作者用预训练图像先验及 CLIP 相关语义表征解释条件迁移。这个设计动机合理,但不能推出任意隐藏向量必然生成自然图像,也不能推出无需训练就能把一个图像 token 替换全部文字条件。
07 · 两类增强与数据细节
参考增强减弱同源答案泄漏。附录和代码顺序为 resize 224、HorizontalFlip(概率 0.5)、Rotate(limit 20)、Blur(0.3)、ElasticTransform(0.3)。旋转没有显式给概率,实际默认值取决于锁定的 Albumentations 版本,不自行补成 100%。增强保留大致语义,打破局部形状与像素对应。附录 B · 数据代码
mask 增强处理“训练只见矩形框、用户却画不规则洞”的 gap。论文写四边用 “Bessel curve”,代码实际调用二次 Bézier 曲线。正文写每边均匀 20 点、1–5 像素偏移;代码 range(1,19) 在 0.05–0.90 取最多 18 点,加整数 −5 至 5 偏移,还有坐标去重。术语、点数和偏移范围差异应显式记录。
左式是 Eq. 3,\(D\) 为 mask 扰动;右式是为解释源码补充的二次 Bézier 标准表达,不是论文新公式。四边中间控制点向剩余空白扩张,连接扰动点成为多边形。代码 inpaint_mask 是白色保留、黑色挖洞,与用户文件中白色编辑区域在读取后反转一次。
- 每图随机选一个框;参考 crop 在边界允许时四周各 padding 最多 10 像素,因此含少量背景
- 编辑框向每边剩余空白随机扩张 0–40%,模型同时补对象周边场景
- 配置 arbitrary_mask_percent=0.5,一半 irregular,另一半扩张矩形
- 选包含编辑区域的随机正方形裁剪,可再利用空余区域随机收缩,最后 resize 512
- 主图归一化至 −1 到 1;参考用 CLIP 均值标准差;mask resize 后边缘可能出现中间值
- 排除 7 个具体坏样本;图片读取路径硬编码 dataset/open-images/images,不会随所有 dataset_dir 修改自动迁移
1.9M 图、16M 框、600 类是论文给的数据集总体规模,不表示每 epoch 遍历 16M 框。Dataset 按图像标注文件索引,每次随机选一个框;有效训练数需按下载和过滤目录统计。validation/test 的增强路径未完全关闭,验证损失仍可能带随机性。完整预处理
08 · CFG 与相似度控制
训练时 20% 概率用可学习向量 \(v\) 替换参考 \(c\)。无参考分支仍看到背景和 mask,准确含义是“无参考图条件”,不是完全无条件生成。代码每 batch 抽一次随机数并替换整批,不是逐样本独立 dropout。条件替换
Eq. 5 省略背景、mask、时间步,本页延续简写。\(s=1\) 回到普通条件预测;\(s\gt1\) 放大参考分支相对基准的方向。它不是参考像素混合比例。论文默认 \(s=5\),Figure 7 比较 1、3、5。
这是 Eq. 4 的 Bayes 展开,\(K(c)\) 与 \(z_t\) 无关,求梯度后可忽略。它解释条件被加强的直觉,但近似噪声网络与离散多步采样不等同精确能量采样;较大 guidance 不是所有质量指标单调改善的定理。

Table 3 瓶颈→CFG 的 CLIP 为 81.41→84.97,FID 3.26→3.18。作者没有给更大 scale 的完整扫描或置信区间,也未证明精确身份保证。
09 · 训练配置与算力账本
作者报告 OpenImages 上 40 epochs,64 张 NVIDIA V100,约 7 天。直算约 10,752 GPU-hours,仅是作者数字的资源占用换算,没有利用率、功耗或货币成本含义,也不是本次运行记录。§4.1
| 项目 | 论文 / 附录 | 公开代码 |
|---|---|---|
| 数据 | 1.9M 图、16M 框、600 类 | 按图读取,每次随机框;有效数量未固定 |
| 初始化 | SD v1-4 text-to-image | 新增 5 输入通道置零 |
| 输入 | 源图 512,参考 224 | latent 4×64×64,两类归一化分别处理 |
| 优化器 | AdamW | 直接调用 torch.optim.AdamW,未显式覆写 betas、weight_decay;按锁定环境核实 |
| 学习率 | constant \(10^{-5}\) | base \(10^{-5}\);10,000 步 multiplier 从 \(10^{-6}\) warmup 到 1,之后恒定 |
| EMA | 附录说使用 | use_ema: False,与论文不同 |
| batch / GPU | 64 V100,未完整披露 batch | batch_size 4,1 node × 8 GPU;无累积时有效 batch 32,不能当作论文实际配置 |
| 长度 | 40 epochs,约 7 天 | max_epochs 40,资源不同不能照搬时间 |
| 条件 dropout | 20% | u_cond_percent 0.2,按 batch 决策 |
| 扩散 schedule | 未完整列出 | 1000 steps,linear_start 0.00085,linear_end 0.0120 |
| mask | 随机形状 | 50% irregular,还有扩张、padding 与随机 crop |
| 精度 | 训练 precision、裁剪未完整交代 | U-Net use_checkpoint=True;推理 autocast 不能反推训练精度 |
YAML · 训练入口 · 优化器。入口显式 --scale_lr False,因此不能再把 base lr 乘 GPU 或 batch。精确默认 optimizer 参数和分布式行为要在环境锁定后确认,不能把未报告值写成作者设置。
训练范围:U-Net、mapper、final LayerNorm、1024→768 projection、learnable vector;VAE 与 CLIP vision 主干冻结。“Frozen” 类名不表示条件映射整体不训练。没有 LoRA 合并、LLM prompt、test-time parameter tuning。
环境也要固定:仓库 environment.yaml 声明 Python 3.8.5、PyTorch 1.11.0、torchvision 0.12.0、CUDA toolkit 11.3、Albumentations 0.4.3、Transformers 4.19.2、PyTorch Lightning 1.4.2。diffusers、bezier 和部分 Git 依赖没有完全 pin 到不可变版本,旧环境不能直接当作今日环境的兼容保证;本次未安装或执行这些依赖。官方环境清单
10 · 推理过程与复现入口
- 读取源图与同尺寸 mask,确认用户文件白色为待编辑区域;脚本反转成保留 mask
- 参考转 RGB、resize 224、CLIP 归一化,经冻结 encoder、mapper、projection 得到 1×768 条件
- masked source 经 VAE 编成背景 latent,mask 缩到 latent 分辨率
- 从四通道高斯噪声开始,每步与固定背景和 mask concat
- scale 不等于 1 时计算参考与 learnable-vector 两分支,CFG 合成,再用 PLMS 或 DDIM 更新
- VAE 解码,转 0–1、截断并保存;不同随机种子可有不同输出
Code verified COCOEE shell 使用 --plms --scale 5,脚本默认 50 步、eta 0、seed 42、512 分辨率、autocast。benchmark 的 n_samples=5 是 DataLoader batch size,即一次处理 5 对不同输入,不是每对生成 5 张再 best-of-5;遍历 3,500 对,每对存一张。单图脚本 n_samples 默认 1、scale 默认 1,应显式设 5 才对齐论文 guidance。命令 · benchmark
python scripts/inference_test_bench.py --plms --outdir results/test_bench --config configs/v1.yaml --ckpt checkpoints/model.ckpt --scale 5本次只读代码并生成文档,没有下载权重或运行模型。单图脚本不自动把源图 resize 成 H/W,源图、mask 和 latent shape 必须自行对齐,不能只改命令 H/W 就假定预处理完成。
一次流程不是一次网络调用
PLMS 有 50 次时间步迭代,起步还需要额外预测,CFG 又有两个条件分支(可拼 batch 一起算)。无需逐图 optimization 的优势是真实的,但不是一步去噪。论文与本次核查未测 CPU 性能、秒级延迟或最低显存。
背景没有严格像素锁定
PLMS 支持可选 mask/x0 原 latent 注入分支,但官方 inference 没有传这组参数,只给条件用的 test_model_kwargs;最终保存也没有按 mask 硬合成原像素。因此“尽可能不变”靠条件与重建学习促进,不保证 mask 外像素完全相同。生产系统若额外硬合成,应披露是新增策略并检查边缘。采样路径 · 实际调用

Figure 10 是同一源图与参考的三个输出,支持随机多样性,但没有 diversity、身份方差或 seed 稳定性统计。
11 · COCOEE 与自动评价
COCOEE 人工从 MSCOCO validation 选 3,500 张源图,每例指定一个 bbox,区域不超过半图;参考 patch 从 MSCOCO training 检索,通常语义相近,以保证组合合理。训练用 OpenImages,评估输入与参考来自 COCO。没有人工编辑 ground truth,故以分布质量、单图质量和参考语义匹配评价。协议
“每图一个框”是编辑条件,不等于画面只有一个对象;小于半图和语义相近的选择也限制了分布。大洞、多实例精确组合、跨风格迁移主要只有定性示例。
CLIP 特征 FID
\(\mu_g,\Sigma_g\) 来自 3,500 张生成整图;真实集合为 COCO test。附录指定 ViT-B,代码具体用 ViT-B/32 的 512 维特征。虽然沿用 InceptionV3 类名、--dims=2048 参数,内部 wrapper 实际调 CLIP,特征数组也是 512 维。不能按文件名字误用标准 Inception-FID。真实图预处理为短边 resize 512、中心裁剪 512,再进入 CLIP preprocess。FID · 实际 wrapper
Quality Score
QS 用 GIQA 密度估计思路。脚本读取预训练 COCO GMM,README 指定 coco2017_gmm_k20;计算 score_samples,以 0 和 300 为固定归一化端点,clip 到 0–1 后乘 100 并平均。不是人类百分制评分或正确概率。需同一 GMM 权重、CLIP 特征与 preprocessing。QS
这是代码后处理的归纳;模型原始 score 依赖具体 GMM。工具强制 batch 50,非整批尾部会忽略;3,500 恰好整除,换数据集必须记录参与数。函数的占位返回值不是 QS,打印的平均分才是可用评分。
区域 CLIP score
结果按 bbox 裁剪,crop 与参考均 resize 224,经 ViT-B/32、L2 归一化后计算余弦乘 100。84.97 不是 84.97% 身份正确率。代码从白色 mask 的最小/最大扁平索引取 bbox,对矩形 benchmark 有意义;任意多连通 mask 不能直接沿用而不复核 crop 规则。分数 · 裁剪
Reviewer 三项都依赖 CLIP 表征,不是三套完全独立证据。整图 FID/QS 包括未大幅改变的背景,可能稀释编辑区域伪影;CLIP 对精细纹理和计数不敏感。人的排序非常重要,但也要读清维度。
12 · Baseline 与完整主表
四个 baseline 分别是:Blended Diffusion-Text 用“a photo of C”类别文本做 CLIP 梯度 guidance;Blended Diffusion-Image 用参考图替换文本;Stable Diffusion 使用官方 v1-5-inpainting 文本模型;DCCF 先以 LaMa 补背景,再用额外语义 mask 提取参考前景并 harmonize。各自可用信息和几何自由度不同。§4.2 · 附录模型版本
原 Table 1 · 完整方法比较
| Method | FID (\(\downarrow\)) | QS (\(\uparrow\)) | CLIP Score (\(\uparrow\)) |
|---|---|---|---|
| Blended Diffusion-Image [3] | 4.60 | 67.14 | 80.65 |
| Blended Diffusion-Text [3] | 7.52 | 55.89 | 72.62 |
| DCCF [67] | 3.78 | 71.49 | 82.18 |
| Stable Diffusion [52] | 3.66 | 73.20 | 75.33 |
| Ours | 3.18 | 77.80 | 84.97 |
相比 SD:FID 3.66→3.18,下降 0.48,约 13.1%;QS +4.60;CLIP +9.64。相比 DCCF:FID −0.60、QS +6.31、CLIP +2.79。13.1% 只是 FID 数值相对变化,不能写成“真实感提高 13.1%”。
这支持作者 COCOEE 协议下三列均最优,不支持所有输入、所有后续方法或精确实例身份的普遍优势。大规模 OpenImages 专项训练模型与通用文本模型比较,也不是单纯换一个条件向量的消融。

Figure 5 对应不同失败:类别文本丢细节;CLIP 梯度难保证自然局部像素;DCCF 保留原外观但不适配姿态大小;本文重新生成改善融合却可能改变细节。论文没有统一所有 baseline 的训练 compute。
原始提示词披露范围
公开基线模板为 a photo of C。Figure 8 的四个具体文本依次为 A poochon、A pure white poochon、A pure white smiling poochon、A pure white smiling poochon with droopy ears。本文模型自身不要求文本;没有 LLM system prompt、few-shot、top-p、工具调用或重试提示。未公开的逐样本文本清单不能自造后当原设置。

Figure 8 说明在这个示例里,图像更容易表达毛发、表情和项圈组合;不能推广为图片对所有意图都胜过文字,抽象属性、计数或硬约束可能相反。
13 · 人类排序与逐步消融
原 Table 2 · 完整人类排序
| Method | Quality (\(\downarrow\)) | Consistency (\(\downarrow\)) |
|---|---|---|
| Blended Diffusion-Image [3] | 3.83 | 3.84 |
| Blended Diffusion-Text [3] | 3.93 | 3.95 |
| DCCF [67] | 3.09 | 1.66 |
| Stable Diffusion [52] | 2.36 | 3.48 |
| Ours | 1.79 | 2.07 |
50 名参与者评 30 组,每组两个输入与五方法输出,结果随机排序并排展示,无时间限制。分别对质量和参考一致性排 1–5,1 最好。CVPR 正式版补充参与者为无相关背景的学生。若每人完成 30 组,每维是 1,500 次排序任务;这是协议算术,不是 1,500 个独立参与者。用户研究
本文质量 1.79 优于 SD 2.36,但一致性 2.07 弱于 DCCF 1.66。直接保留参考在人眼看来更像,却融合较差;自动 CLIP 又把本文排在 DCCF 前,显示自动指标与人的一致性排序不同。未给方差、显著性、置信区间和人群外推证据。
原 Table 3 · 完整逐步消融
| Method | FID (\(\downarrow\)) | QS (\(\uparrow\)) | CLIP Score (\(\uparrow\)) |
|---|---|---|---|
| Baseline | 3.61 | 76.71 | 85.90 |
| + Prior | 3.40 | 77.63 | 88.79 |
| + Augmentation | 3.44 | 76.86 | 81.68 |
| + Bottleneck | 3.26 | 76.62 | 81.41 |
| + Classfier-Free | 3.18 | 77.80 | 84.97 |

Table 3 是逐步叠加:Baseline → Prior → Augmentation → Bottleneck → CFG,不是从最终模型独立删除各项。因此一条路径不足以分离交互和顺序影响。
| 相邻步骤 | FID | QS | CLIP | 解释 |
|---|---|---|---|---|
| Baseline → Prior | −0.21 | +0.92 | +2.89 | 三列改善,但定性复制仍在 |
| Prior → Augmentation | +0.04 | −0.77 | −7.11 | 打断复制有代价,并非三列单调改善 |
| Augmentation → Bottleneck | −0.18 | −0.24 | −0.27 | FID 改善,QS 和参考匹配略降 |
| Bottleneck → CFG | −0.08 | +1.18 | +3.56 | 恢复部分参考关联并改善质量 |
不能隐藏:Prior 的 CLIP 88.79 是最高,最终 84.97 低 3.82;Baseline 85.90 也高于最终。价值在质量—相似性的折中,不是把参考信息保留最大化。“完全消除边界伪影”是作者对样例的描述,没有全测试集边界错误率。
更强证据应补 factorial 或独立去除实验、统一训练步数和 seed、独立量化边界与身份,并画 guidance 的 Pareto 曲线。这是 reviewer 建议,非作者已完成的研究。
14 · 全部定性图与正式补充

Figure 9 是更多 in-the-wild 组合。读图时同时检查参考细节哪些保留、哪些被先验替换,而不仅看结果是否漂亮;没有稳定性量化。

固定 v1 附录 Figure 11 在同一源图不同位置编辑,证明给定 mask 可换区域,没有自动决定位置的模块。

Figure 12 把同对象放进不同源场景,包括 Big Ben;支持一定场景适配,不提供 3D 对应、多视图一致性或重投影验证。

v1 附录 C 的油画、恐龙等失败说明域外风格与稀有对象较弱。数据覆盖与条件压缩可能同时影响,论文没有完全区分。
CVPR supplement 新增证据
正式 supplement 独立 5 页,不能当作固定 v1 附加的 5 页。其 Figure 1、2 与 v1 Figure 11、12 主题相同,不重复展示;新增或扩展的 Figure 3–6 由官方 PDF 直接裁切,编号独立。
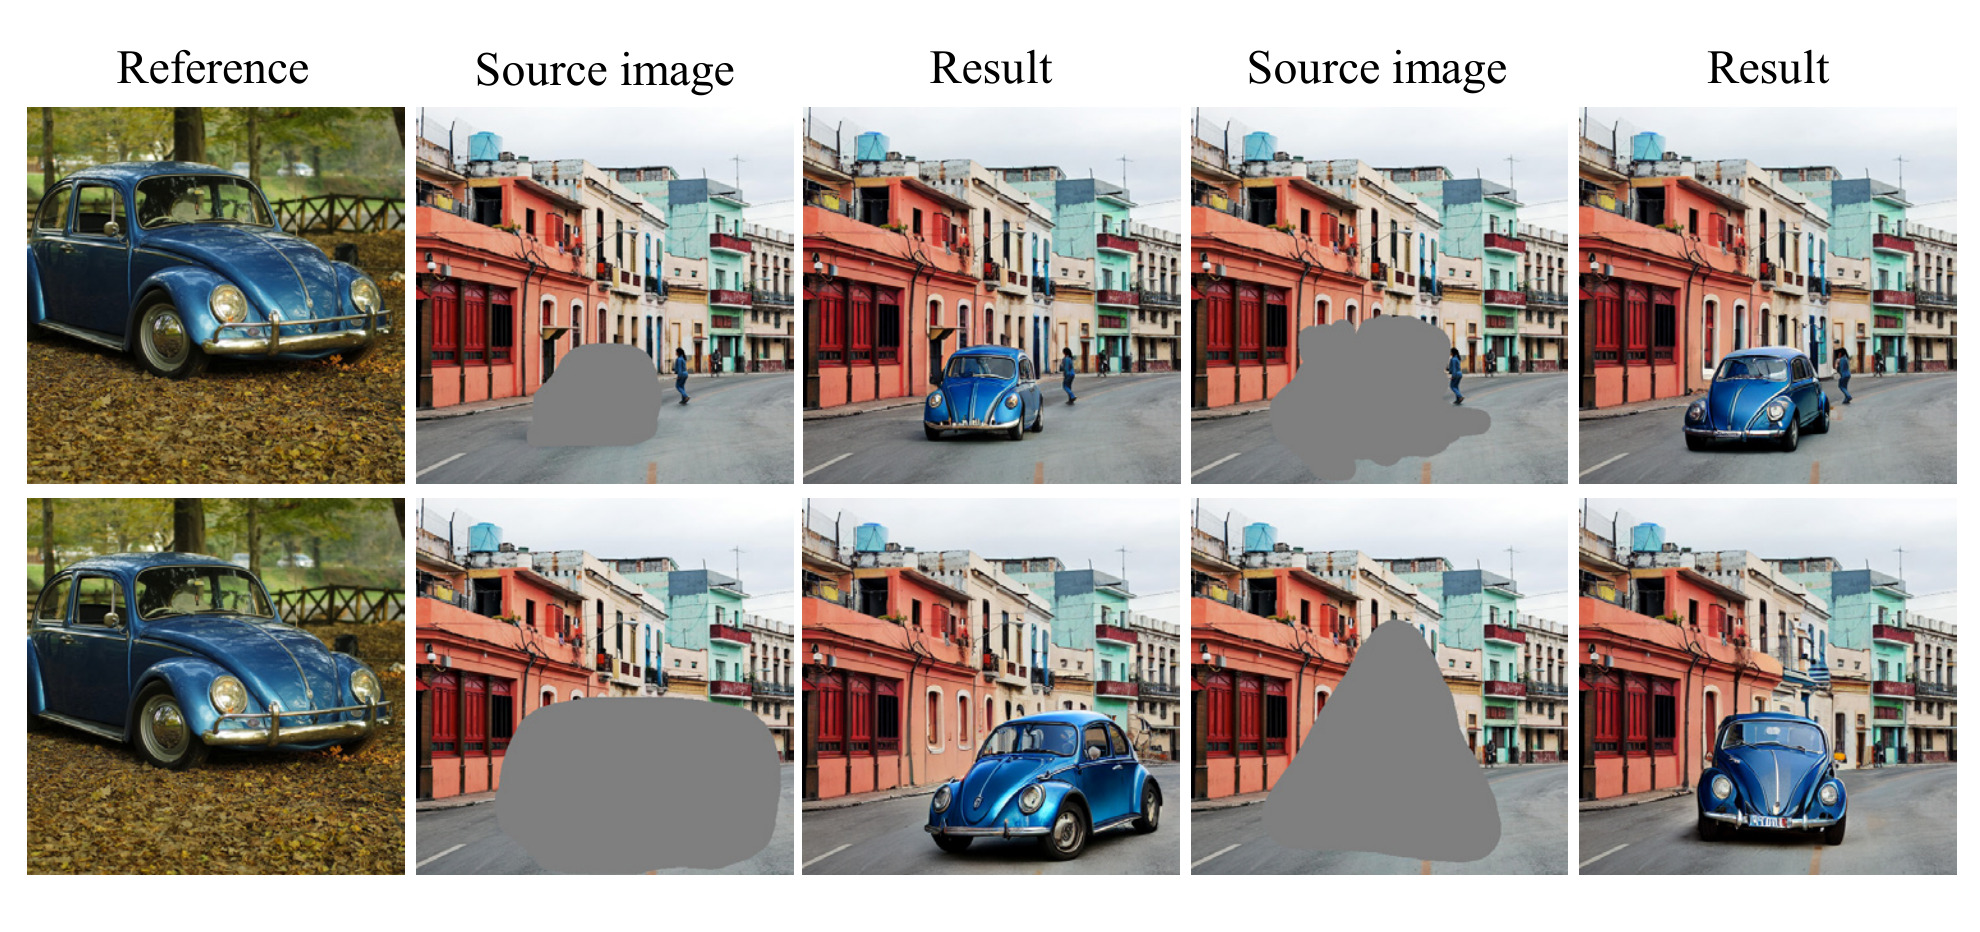
补充 Figure 3 展示 mask 形状的影响;这是视觉控制证据,不是精确轮廓误差量化。
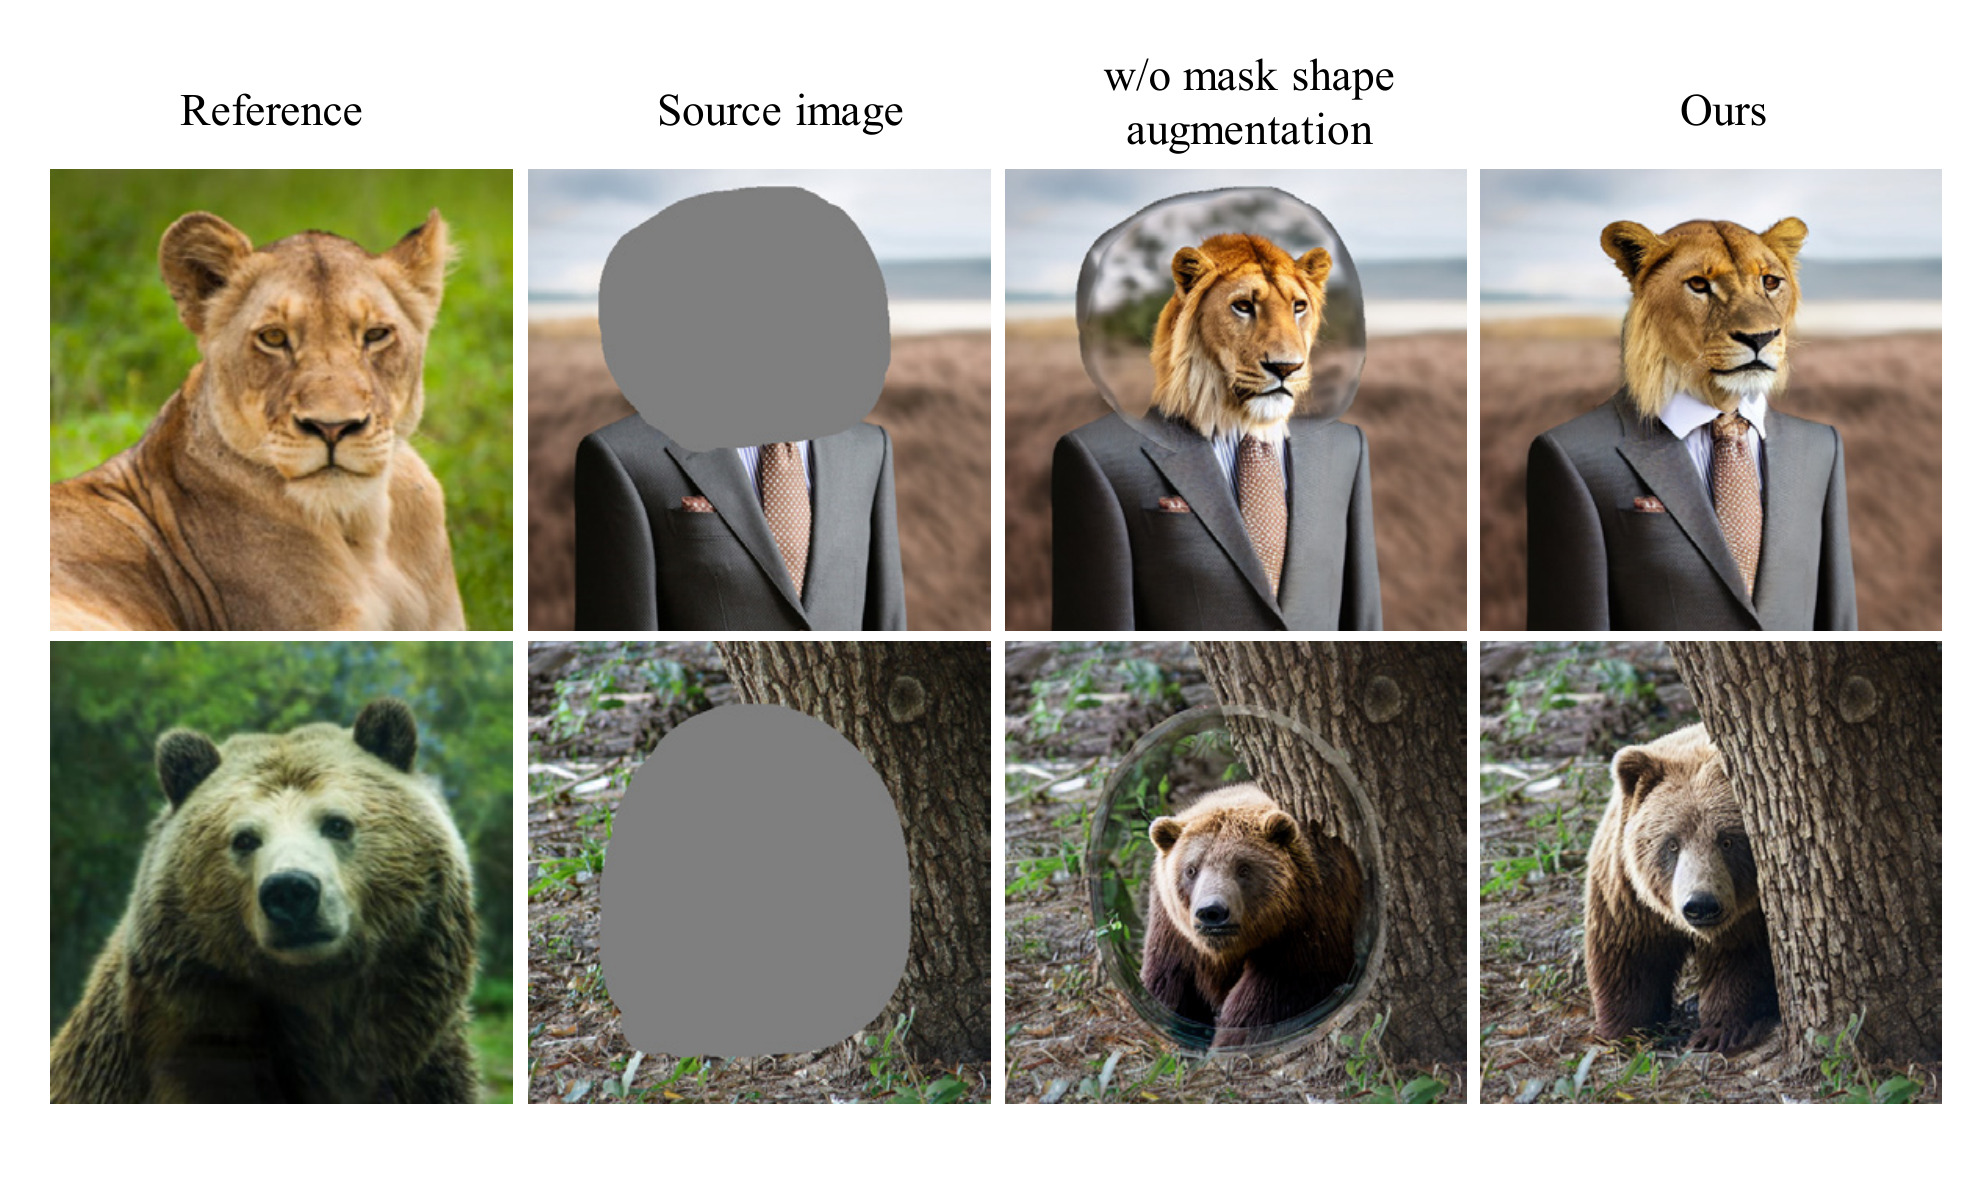
补充 Figure 4 比较是否有 mask shape augmentation;缺少它时不规则洞泛化较差,补充了主表未分离两类增强的不足,但仍主要是定性。
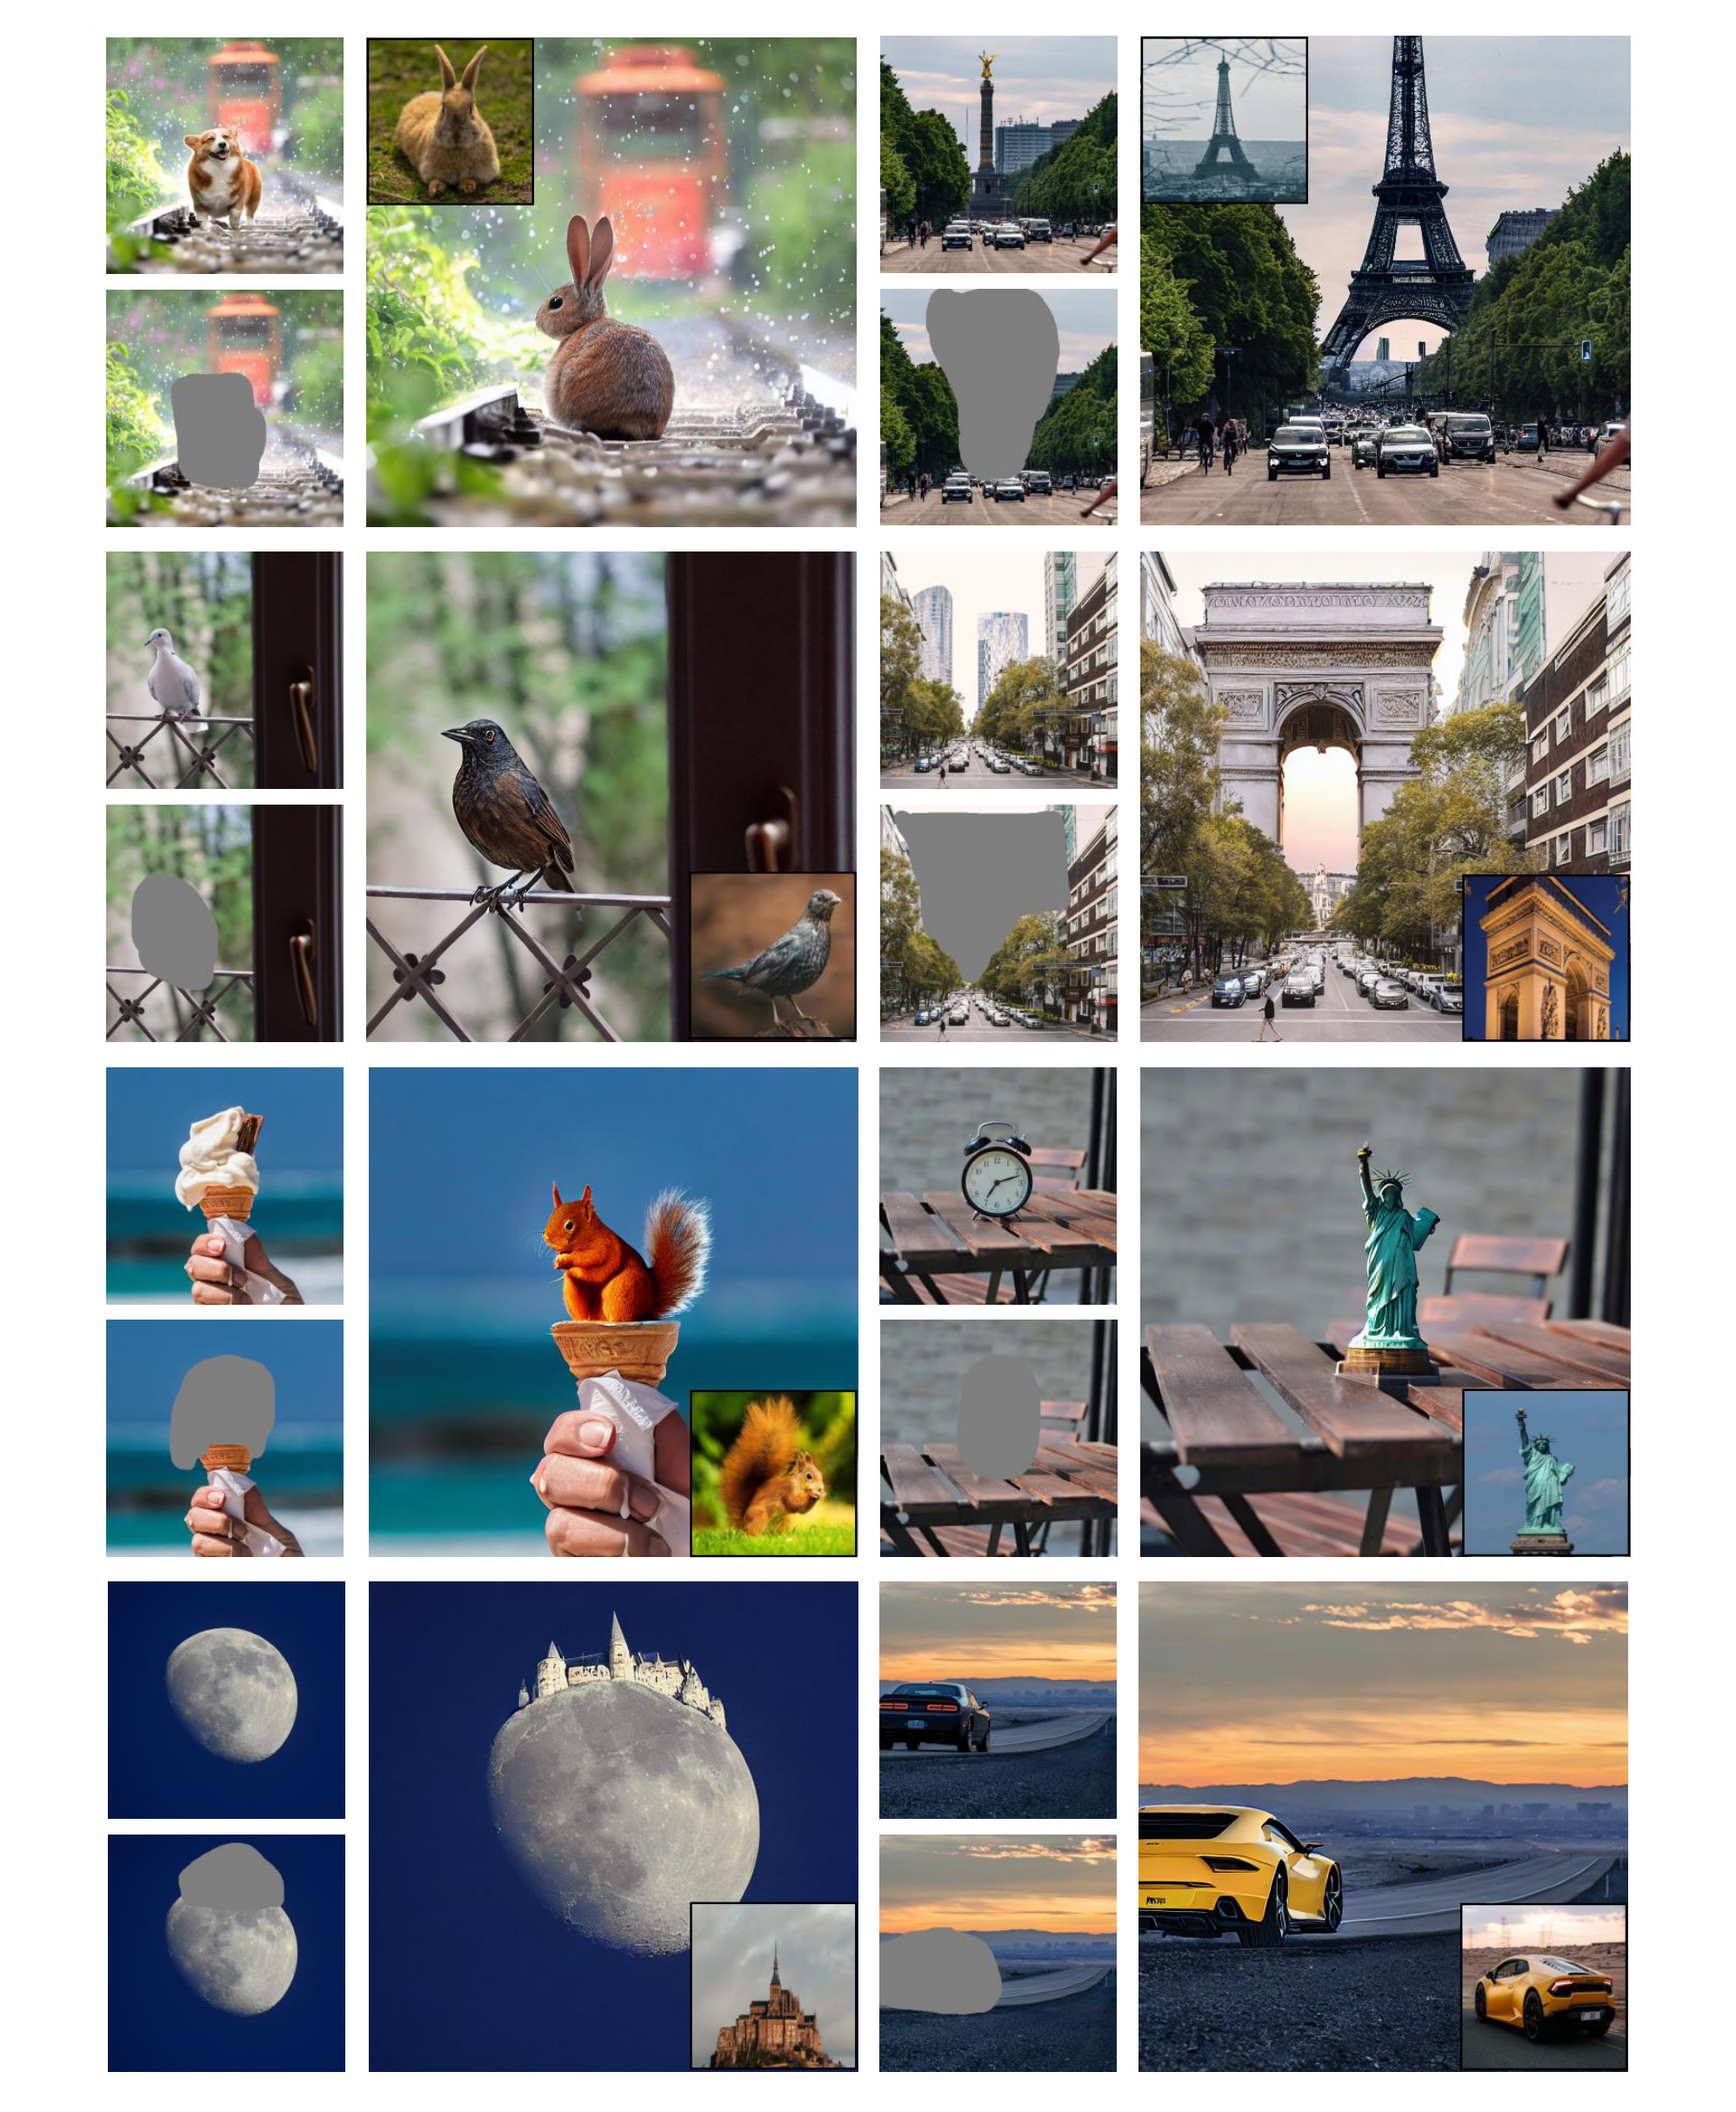
补充 Figure 5 扩展参考合成的展示覆盖面,不改变主表测试样本数。
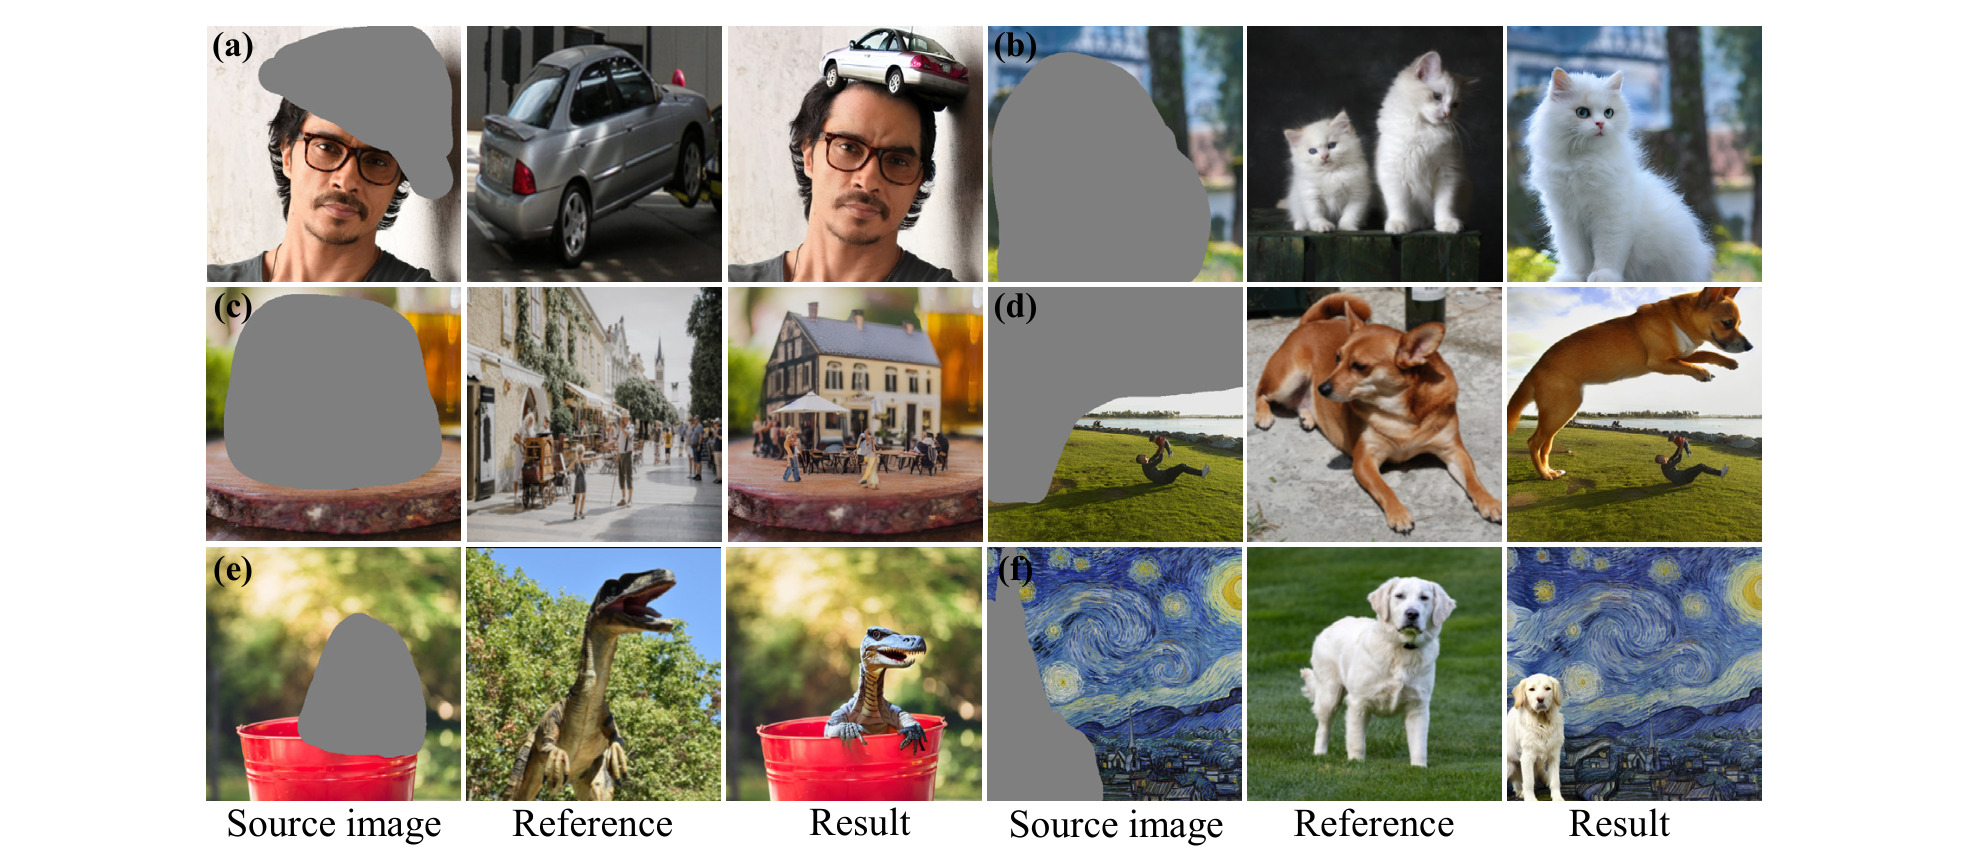
补充 Figure 6:a 头上放车是罕见组合成功例;b 多实例数量可能错;c 非单对象近景仍可合成有意义组合;d 超大洞容易产生过大对象;e 稀有恐龙难理解;f 油画域较弱。不能把整张图每项都称失败,也不能只挑 a 声称无限泛化。官方困难案例
15 · Paper versus Implementation
静态核查提交 52a7e3736d579889e13c988403b7fd721bb22293。当前公开快照不一定等于论文全部实验使用的内部配置。以下是复现风险,不是实测 bug 或对作者未公开实现的猜测。
| 项目 | 论文 | 可核实实现 | 复现含义 |
|---|---|---|---|
| 加噪 | v1 线性系数 | CVPR 修为平方根累积系数,代码标准 DDPM | 不传播旧式为实现公式 |
| Mapper | 15 FC | 5 residual Transformer blocks、LayerNorm、projection | 按真实模块复现 |
| EMA | 附录使用 | 配置 False;ema_scope 开启才切权重 | 有调用名不代表实际 EMA |
| LR | constant 1e−5 | 10k warmup 后恒定 | 早期训练不同 |
| GPU | 64 V100 | 示例 8 GPU、batch 4 | 公开示例不能当论文实际运行 |
| 曲线 | Bessel、20 点、1–5 像素 | Bézier、最多 18 点、−5 至 5 | 固定数据生成选择 |
| Dropout | 20% 条件替换 | 每 batch 一次决策 | 与逐样本随机的噪声结构不同 |
| 背景 | 尽可能相同 | 默认无最终硬覆盖 | 单独测 mask 外误差 |
| FID | CLIP 特征 | 旧 InceptionV3 类名包装 ViT-B/32 | 不能误算标准 FID |
| 采样数量 | 3500 图 | n_samples=5 是 batch | 不是 best-of-5 |
另外,数据路径有硬编码;QS 需要单独 GMM 权重并忽略尾批;单图代码加载和调用安全检查器后又把输出变量赋回原采样图,不能仅看到 import 就认定发布路径具有有效审核。这里只描述静态行为,没有运行该路径,也不提供关闭防护的操作。实际应用需独立审核安全与许可。
仓库声明代码与模型为 CreativeML OpenRAIL M;COCOEE 属于 COCO Consortium,README 标为 CC BY 4.0。应分别遵守模型和原始图像许可。许可
16 · Reviewer 评价
贡献与价值
最值得保留的是对自监督捷径的诊断。更强图像条件因与答案同源反而令任务过于容易;有控制地压缩与扰动条件,改善跨图参考迁移。工作把任务、模型、benchmark、自动指标和人类排序结合,构成 exemplar editing 的有用早期基线。
零初始化新增输入通道、冻结视觉主干和保留预训练生成先验是清晰的工程设计。大规模训练后的模型对新参考无需再微调,适合交互式试 mask 和参考。它不是 training-free,而是每个新实例无需单独训练。
限制与未验证问题
- 实例细节:全局 CLIP 不保证 logo、字符、纹理周期和计数,补充已有多实例数量错位
- 分布限制:COCOEE 语义相近、单编辑框、区域不超过半图,与随意混搭不同
- 指标相关:条件与评价都依赖 CLIP;整图指标可能被背景主导;人的一致性排序与 CLIP 不完全相同
- 消融识别:顺序叠加不足以分解交互,没有误差条和多 seed 统计
- 背景保持:无 mask 外 LPIPS、像素误差、结构漂移或边界专用指标
- 成本复现:64 V100 × 7 天并不轻;EMA、LR、mapper、GPU 数存在公开差异
- 主观研究:学生样本、人群覆盖、方差与显著性信息有限
最小后续实验
固定噪声与场景比较 1、4、16、257 tokens,同时拆出低频语义/高频细节分支,报告质量、身份、边界、背景四条曲线。对 crop margin、mask 扩张和参考背景残留做因子实验,检查背景泄漏。最后预定义大 mask、多对象、域外风格的失败率,保留全部输出而不只选优。
Our interpretation 在 2022–2023 的任务背景下,本文有明确问题诊断和工程价值;证据支持任务内质量与相似性折中改善,不支持无损身份迁移或通用视觉组合推理。
17 · Procedural Material Generation 延伸
Research extension 以下是本页提出的研究设计,论文没有生成 Substance 图、shader 程序或 PBR maps,也没做 renderer-in-the-loop。单视图像参考不保证换光照、换几何后材质仍正确。
方向一:材质因素的瓶颈
PMG 自监督也有复制捷径:把参考渲染烘焙成 bitmap,单视图 loss 很低,却没恢复材质。可以分离语义和微细节:全局条件表示金属、织物、风化等类别,局部分支表示频谱、颗粒尺度与各向异性;明确防止一次渲染的阴影被固化为 base color。
\(G\) 是带类型材质图,\(G_{\mathrm{context}}\) 是保留子图;多光照/多视角参考帮助分离光照和反射。不能照搬单 CLIP token 当充分的微表面表示,本文的压缩代价正提醒细节会丢。
方向二:可执行子图替换
把 mask 换成允许编辑的节点集合,保留端口边界条件;输出须满足节点类型、维度、DAG 拓扑、参数范围与无悬空引用。图像区域和图节点不天然一一对应,需材料层或语义部件映射。除了图像相似,要检验执行、bitmap 依赖和可编辑性。
\(\mathcal G_{\mathrm{valid}}\) 通过类型与执行检查,\(R\) 是 renderer,\(\ell_k,v_k\) 是光照视角,\(\mathcal C\) 是复杂度。此目标是研究建议,不是本文的方法。
方向三:物理一致增强
照片语义常可容忍翻转、blur,但材质方向、尺度、微法线有物理含义。可随机光照、几何、相机、曝光、背景,保持材料参数;旋转拉丝金属时同步更新各向异性方向,不能把方向信息作为“无关细节”丢弃。
方向四:保真与可编辑性的 guidance
可以训练参考分支和仅上下文分支再扫 guidance,但每个 scale 要同时测跨光照误差、合法率、节点数、参数可编辑性、周期边界。较大 scale 可能把照片阴影刻进程序,单张 CLIP 分数不足以判优。
| 假设 | 最小对照 | 指标 | 否证信号 |
|---|---|---|---|
| 瓶颈降低 bitmap 捷径 | 全 patch / 单 token / 双分支 | 跨光照误差、纹理谱、bitmap 依赖、图复杂度 | 单视图提升但跨光照恶化或细节丢失 |
| 子图自监督能跨参考迁移 | 同材质重建 / 异材质配对 | 执行率、上下文保持、局部变化 | 只会还原训练原图,异源普遍失效 |
| 物理增强优于图像增强 | blur/旋转 / 光照几何随机化 | 反射参数误差、视角稳定、方向误差 | 语义上涨但物理量不可辨识 |
| guidance 有合理区间 | 固定 seed 扫 scale | render fit、合法率、编辑性、旧子图变化 | 只改善拟合,破坏执行与编辑 |
最可迁移的思想是检查训练答案是否通过条件通路偷渡,再设计保留必要因素、去掉捷径因素的表示。对 PMG,区分材质本体与一次渲染偶然性,比简单压成一个向量重要。
18 · 复现检查单与来源
- 保留固定 v1 PDF 和旧 PDF++ 页码,会议元数据及通讯更正单独归档
- 锁定仓库、依赖、CLIP/VAE 权重;记录 EMA、warmup 与实际 batch
- 统计过滤数据;核对 padding、crop、mask 方向和 irregular 分支
- 先检查源图与 mask 形状;不要把 benchmark batch 当候选筛选
- 使用 COCOEE 原配对与 bbox;真实 FID 集合是 COCO test,特征用 CLIP
- 另报告背景、边界、细节和计数;新增硬合成或 reranking 要披露
- 保存所有 seeds 和失败输出;对配置差异逐项确认,不声称未做的复现
一手来源
- 固定 arXiv 身份 · 15 页 PDF 含附录 · 图表 HTML
- CVPR 2023 正式记录 · 正式正文 · 5 页 supplement
- 官方仓库 · 固定提交 · 配置 · 训练数据
- 参考 encoder · mapper · 训练 · 采样
- FID · QS · 区域 CLIP
论文数值是作者报告,本次未运行训练、推理或重算指标,代码核查是静态阅读。已做结构、完整表格、图片 HTTP 与解码、公式源码、体积、原笔记前缀检查。浏览器布局、MathJax 实际渲染和真实页面图片加载按用户要求延后,静态检查不能代替。主文件内嵌 MathJax,可单独打开;外部图需要联网。研究延伸均明确标记。