01 · 先抓住论文的因果问题
同样做五个原型、收到五份反馈、花同样的时间,为什么先做多个版本再听意见,可能胜过每做一个就立即修改?本文把“反馈何时出现”变成可操纵的实验条件,用真实广告点击、盲评、设计多样性和自我效能问卷检验它。
这里的 parallel 是一个人保留多个候选方案,并非多名设计师同时协作,更不是 GPU 并行。实验中的人始终独立工作。关键干预是“3 个原型→一起看反馈→2 个原型→一起看反馈→最终稿”,对照是“每个原型后马上看反馈”。
- 研究类型:设计过程的受控人因实验,辅以真实线上投放和两项后续研究;不是生成模型,没有网络结构、训练集或推理参数。
- 创新单位:保持预算近似一致,改变探索与反馈的组织方式,并把质量、探索、信心同时测量。
- 最需要记住的限制:实验只有 33 个独立设计者;大量点击和相似度评分不等于同等数量的独立实验单位。
02 · 版本、作者与原笔记核对
论文发表在 ACM Transactions on Computer-Human Interaction,17(4),Article 18,December 2010,24 pages。首页标准引文和逐页页脚均标 2010;原笔记 BibTeX 的 year=2011 与 issue_date=December 2010 不一致。本次保留原记录,建议后续人工整理时优先采用 PDF 明示的 2010,同时留下数据库导出差异的说明。
六名作者依次为 Steven P. Dow、Alana Glassco、Jonathan Kass、Melissa Schwarz、Daniel L. Schwartz、Scott R. Klemmer,均列 Stanford University。首页把 Dow/Klemmer 归于计算机科学,另四名归于教育学院。页面列出全体作者联系邮箱,没有明确单列通讯作者;因此不把原笔记 Scott R. Klemmer 的 unverified 状态擅自变成 confirmed。
原笔记已经包含理论贡献、经验贡献和两种 HCI 研究分类框架下的个人判断。这些是用户原有思考,本次逐字保留。本精读提供补充证据和边界,尤其修正“所有表现都显著更好”的过强读法,而不删除个人观点。本文没有另附机器学习代码需要复现;下文的统计解读不等于拿到原始数据后重跑分析。
03 · 理论链条:比较、探索、心理距离
| 假设 | 作者提出的解释 | 实验怎样测 | 不能混淆的层次 |
|---|---|---|---|
| H1 质量更高 | 并排比较不同候选及其反馈,有助于发现设计变量之间的关系和一般原则 | 真实点击率、站内访问行为、专家盲评 | 质量差异不直接等于“比较学习”这一中介已经被测量 |
| H2 探索更广 | 推迟评价,减少围绕第一个点子做局部修补的固着 | 每人六个广告之间的两两相似度 | 视觉不同不必然意味着概念更好或搜索覆盖更全面 |
| H3 信心增幅更大 | 同时持有多个方案,可把“方案受批评”和“我没有能力”分开 | 四题自我效能前后测、访谈 | 自我报告信心不等于实际技能,也不是稳定人格自信 |
设计并非有唯一正确答案的封闭题。问题理解与解决方案共同演化,约束可能协商,审美、客户目标和有效性也未必一致。因此,只把一个方案修得更精细,可能让人更快到达局部最优,却错过另一类方案。另一方面,完全不收敛也会让候选停在粗糙状态。这篇论文真正支持的是探索与收敛的调度值得研究,不是“迭代无用”。
作者用模拟退火作为启发类比:早期多探索,后期再集中优化。但文中没有定义温度函数、搜索算法或全局最优保证。不能把这段讨论改写成已实现的优化方法。过去关于多原型的研究也关注评审者更敢批评;本文强调接受批评的设计者这一侧的心理反应。
04 · 设计实验如何做到预算可比
招募 36 人,3 人未完成,最终 33 人;并行 16 人、串行 17 人。平均年龄 22 岁,19 名女性,约四分之三为学生,14 人自报有广告或平面设计经验,无专业设计师。研究按性别和先前经验做分层随机分配;这有利于组间平衡,但不能代表职业设计团队或长期项目。
| 变量 | 两组共同设置 | 意义 |
|---|---|---|
| 产物预算 | 5 个原型 + 1 个最终稿 | 排除并行组只是画得更多 |
| 原型时间 | 每个 10 分钟 | 并行组也按相同间隔开始下一个 |
| 反馈阅读 | 每原型 5 分钟,总 25 分钟 | 并行组批量阅读,不增加总反馈量 |
| 最终稿 | 15 分钟 | 共同的最终收敛阶段 |
| 反馈准备 | 实验员每广告 2 分钟,在另一个房间挑选语句 | 等待时可浏览客户网站、找图、纸上画草图 |
| 参与总时长与报酬 | 150 分钟,30 美元 | 包括同意、问卷、练习、访谈等 |
| 客户与目标 | Ambidextrous 设计杂志;提高网站访问、符合编辑审美、有效平面设计 | 统一设计简报,避免客户难度变化 |
串行流程可写为 \(D_1\to F_1\to D_2\to F_2\to\cdots\to D_5\to F_5\to D_6\)。并行流程为 \((D_1,D_2,D_3)\to(F_1,F_2,F_3)\to(D_4,D_5)\to(F_4,F_5)\to D_6\),其中 \(D_i\) 是设计,\(F_i\) 是针对它的三条反馈,\(D_6\) 是最终稿。这是本精读对实验日程的符号化,不是原文编号公式。
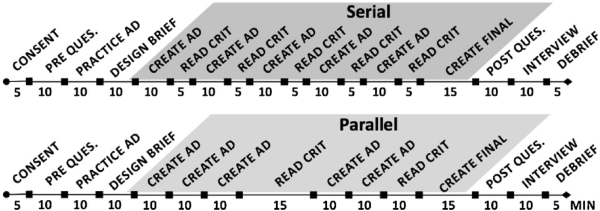
需注意:反馈时机的改变同时改变了反馈批次、可同时比较的候选数和连续创作时段。因而“时机”是实际操纵的流程包,不能声称实验单独识别了等待时间、视觉比较、选择自由三者各自的效应。
05 · 工具、客户简报与反馈控制
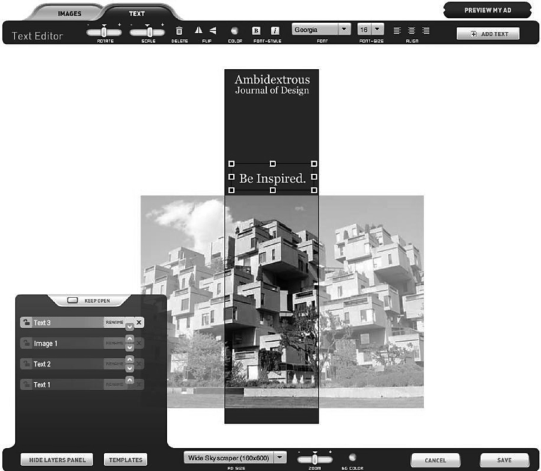
所有人用当时的 MySpace Flash AdBuilder 制作 160×600 像素横幅。没有参与者用过该工具,先要求在十分钟内复刻一幅与主任务无关的样图。这样减少熟悉软件带来的差异,同时保持广告构造门槛较低。Flash/MySpace 是历史实验平台,不是本次交付所依赖的现行服务。
三位广告和平面设计专家预先设计约 50 条描述性意见,分为主题、构图布局、表面元素三类,每类 12–20 条。实验员给每个原型各挑一条,共三条;同一参与者不重复句子。意见提供方向,不直接打正负分。两组均不使用“A 比 B 好”这类明确比较句,并行组的三个广告也是顺次选择反馈,尽量保持挑选过程一致。
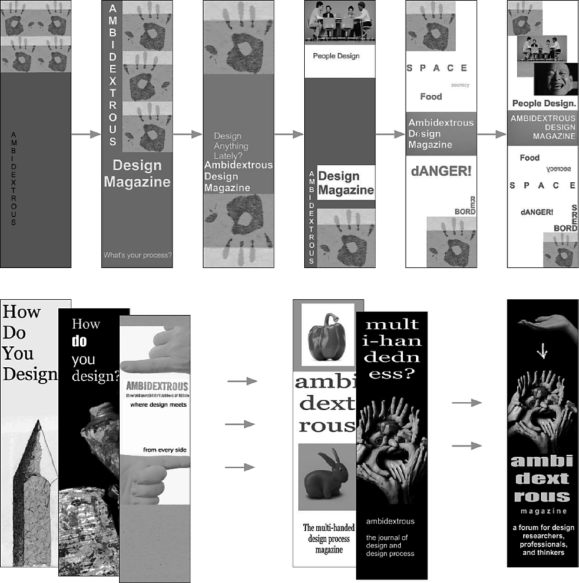
Appendix A 实际覆盖的设计原则包括:信息聚焦、符合杂志主题和目标读者;均衡、阅读路径、邻近关系、对齐、留白、视觉层级;字体可读性、图像数量与旋转、颜色强调和图文对比。本精读概括原则,不把原附录所有措辞误当成跨领域适用的标准量表。反馈库既让干预稳定,也限制它对复杂工程设计的泛化。
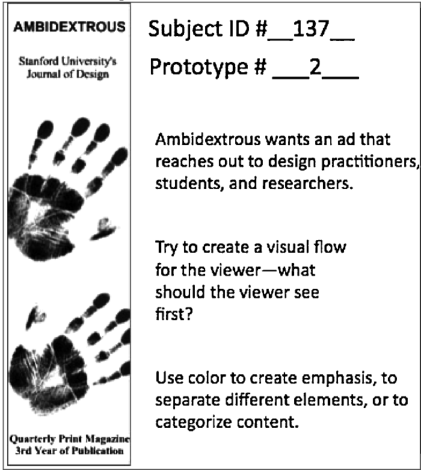
Appendix D 要求广告能引导设计从业者、研究者和学生关注设计过程,传达清晰且专业的杂志形象;不能用他公司标识、受版权限制的图像或不适宜内容,且最终广告不写杂志网址,因为点击即跳转。它是实验任务规范,不是泛用广告设计法则。实验员知道条件,是潜在偏差来源;后续盲评部分检验了这一点。
06 · 四类指标及实验单位
真实投放:33 个最终广告参加 15 天面向设计兴趣用户的 MySpace 广告活动,总投放费用低于 200 美元。平台记录曝光与点击,客户站 Google Analytics 记录访客、停留和浏览页数。最基本的点击率为
这里 CPMClicks 只是“每百万曝光点击数”的自定义记号,避免与广告行业每千次曝光费用的 CPM 混淆。投放系统会给早期表现好的广告更多曝光,因此总点击不是公平效果量。
盲评质量:4 名杂志编辑和 3 名广告专家独立评分,不知实验条件,也不看其他人的评分。五维分别是客户主题匹配、创意、视觉吸引力、品味、设计原则,各 0–10 分,相加 0–50。客户与专业评委可有不同偏好,论文把评委身份纳入分析。
设计多样性:每人 6 个设计组成 \(\binom{6}{2}=15\) 对,每对 30 次 MTurk 判断,合计 \(33\times15\times30=14{,}850\) 次评分。每位评分者至少判断 50 个随机排序项目,以帮助校准标准。方法段说相似度 1–7,结果段说 0–7,端点不一致需保留。低分表示更不同,不能把相似度增加误说为多样性增加。
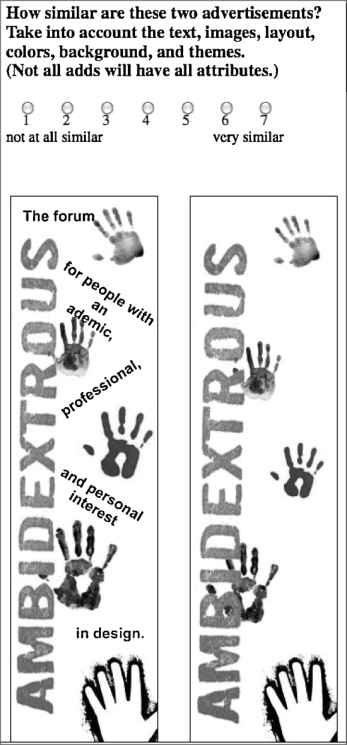
自我效能:Appendix B 四题问的是设计广告、理解设计问题、发现方案问题、整合专家反馈的信心,前后各测一次,间隔约 1¾ 小时;文字规定 1–7 七点量表。结果却写“out of 20”,没有说明变换,故不自行归一化或猜测总分。
Appendix C 半结构访谈追问最终稿优缺点、创作过程、反馈如何影响自己、下次会怎么做;顺序和措辞可变。创意成就问卷涉及十个领域,是另一个个体差异测量,不等于本任务实际广告质量。
07 · 原 Table I 与真实广告结果
原 Table 1
| å Table I ææ | Parallel | Serial |
|---|---|---|
| Advertising host data (MySpace.com) | ||
| Total impressions | 665,133 (43968) | 515,187 (36373) |
| Total clicks | 296 (22.8) | 205 (19.1) |
| Clicks per million impressions | 445.0 (18.3) | 397.9 (19.6) |
| Data from client site (Google Analytics reports) | ||
| Total visitors | 264 (19.9) | 158 (15.3) |
| Average time (sec) per visitor | 31.3 (143) | 12.9 (79.9) |
| Pages visited on site | 394 (31.6) | 198 (21.1) |
| Pages visited per visitor | 1.49 (0.48) | 1.25 (0.41) |
原表的括号明确标为标准差,这里保留其原始值与精度。总量和个体层面离散度并列的呈现不够直观,不将括号改成标准误,也不把汇总 CTR 当作无权重个体均值。
15 天总计 501 次点击 / 1,180,320 次曝光,为约 0.0424%,即每百万 424 次点击。并行组 445.0 对串行组 397.9,每百万差 47.1 次,按表值计算相对高约 11.84%。这是汇总比例的描述,不是参与者层面因果效应的置信区间。最高两名都是并行广告,分别 735 和 578;最低两名串行广告零点击。
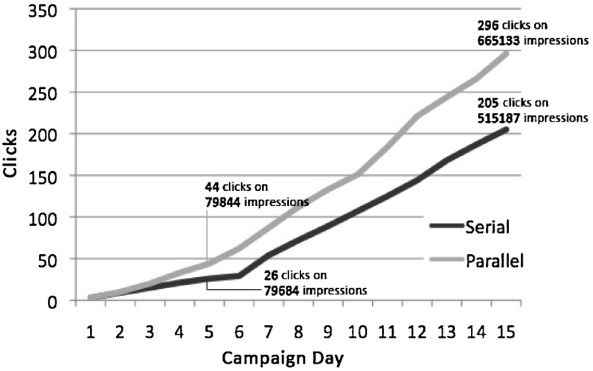
| 检验对象 | 原始结果 | 解释 |
|---|---|---|
| 前 5 天曝光近似平衡窗口 | 并行 44 / 79,800;串行 26 / 79,658;χ²=4.60,p<.05 | 避免后期曝光分配明显倾斜;不是正式保证随机曝光 |
| 全期每广告最终 CTR | F(1,30)=4.227,p<.05 | 条件与创意得分高低为因素 |
| 创意成就高/低组 | 352 / 305 每百万;F(1,30)=3.812,p=.06 | 未达 .05,不称显著 |
| 前五天 CTR 预测后十天曝光 | F(1,29)=23.2,p<.01 | 说明平台的曝光分配与早期表现相关 |
| 访客停留时间 | 31.3 vs 12.9 秒;t(493)=1.781,报告 p<.05 | 统计尾侧未交代,见审计部分 |
| 进入首页外页面 | 71/264 vs 35/158;χ²=1.18,p>.05 | 没有显著组差异 |
| 访客相对曝光 | 264 vs 158;χ²=6.61,p<.05 | 访客数422与平台点击501并不一致 |
论文提出浏览器未完成加载前返回可能解释少 79 个访客,但未实际验证这条归因。停留更久可能表示兴趣,也可能受访客选择、页面加载和极端长停留影响;仅凭平均值不能知道中位数或分布。站内深度浏览没有显著改善,故不能照抄摘要式“所有指标均提升”作为无例外事实。
08 · 专家质量评分与点击并不等价
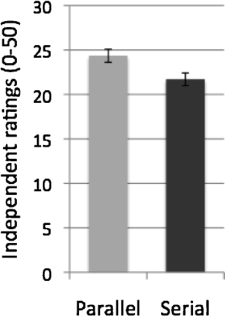
| 比较 | 平均数(SD) | 原文统计 |
|---|---|---|
| 并行 / 串行 | 24.4 (9.7) / 21.7 (8.8) | F(1,203)=3.871,p<.05 |
| 有经验 / 无经验 | 25.7 (9.6) / 21.0 (8.6) | F(1,203)=20.98,p<.05 |
| 客户编辑 / 外部专家 | 24.3 (9.5) / 22.0 (9.1) | F(1,203)=4.376,p<.05 |
| 评委间分数差 | 原文未逐人列均值 | F(5,203)=18.88,p<.05 |
| 品味维度 | 未单列组均值 | F(1,227)=7.527,p<.05 |
| 设计原则维度 | 未单列组均值 | F(1,227)=4.188,p<.05 |
| CTR 预测总评分 | R²=.057,b=.192 | F(1,31)=1.858,p>.05 |
所有广告总平均 23.0/50,最高 35.6、最低 15.0。前三名专家评分来自并行组。条件×经验、评委×条件、评委类型×条件均未报告显著交互。五个分维度虽然均偏向并行,只有品味与设计原则各自达到论文的显著性阈值;不能写成“五维全显著”。
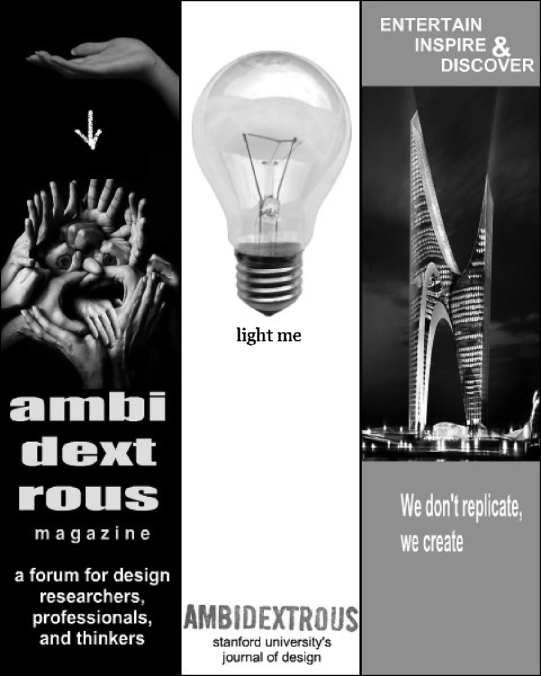
点击高可能靠吸睛,不一定忠实传达客户。串行组两张广告 CTR 排第三、第四,但专家评第 25、第 32,其中一张甚至没提客户。图 6 中间广告的 CTR 排名在图注写第九,正文写第四,这是原文冲突;本精读不擅自选择一个修正。CTR 与专家评分回归不显著,提示两个指标测的是相关但不同的目标。
09 · 多样性:效果、经验与统计陷阱
| 比较/关联 | 原文结果 | 结论边界 |
|---|---|---|
| 串行 / 并行相似度 | 3.25 (1.96) / 2.78 (1.66);F(1,14816)=239.3,p<.05 | 并行候选更不同 |
| 有经验 / 新手相似度 | 3.15 (1.86) / 2.88 (1.80);F(1,14816)=76.70,p<.05 | 经验者更集中,不能因此说能力较差 |
| 条件×经验 | F(1,14816)=36.45,p<.05 | 经验者的串行组最相似 |
| 后期 / 早期相似度 | 3.41 (2.03) / 2.97 (1.77);F(1,14814)=107.835,p<.05 | 后期收敛;早期为1–2、2–3、1–3,后期为4–5、5–6、4–6 |
| 条件×阶段 | F(1,14814)=2.460,p=.085 | 原称边缘显著,不是 .05 显著 |
| 相似度预测 CTR | R²=.032,F(1,31)=.030,p>.05,b=.009 | 照录原报告,不足以证实相关 |
| 相似度预测专家评分 | R²=.030,F(1,31)=1.999,p>.05,b=.246 | R²/F配对也有疑点,勿作二次效应计算 |
最重要的逻辑是:并行组同时“更不同”和“质量更好”,不等于已证明“越不同所以越好”。个体层面的相似度并未显著预测质量,经验者反而产生更相似却更有效的作品。多样性可能避免过早固着,也可能只是探索尚无方向的表现,需要结合任务质量看。
14,850 个评分来自重复评价同一批人的设计,并且评分者也评多个项目。使用数万级自由度会引出独立性疑问:更合适的现代复现会考虑设计者和评分者交叉随机效应、同一设计者内的成对相关,或先在设计者层面聚合。没有原始数据,不能断言修正后显著性一定消失;也不能把这个巨大 F 值当作有一万多名参与者的证据。
10 · 自我效能与反馈体验
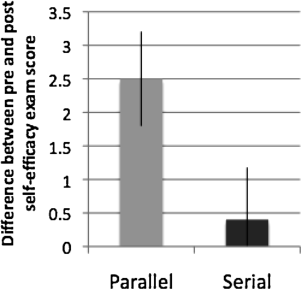
四题的总分前测 10.85、后测 12.12,原文注明满分 20;配对 t(32)=2.355,p<.05。三题分别提高,但“把反馈整合进设计”题 t(32)=.154、p>.05 未变。整体练习本身可以增信心,所以更关键是不同条件的变化量。
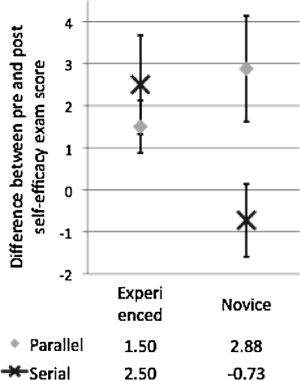
这是对前后差分的解释式。并行平均 +2.5,串行 +0.4,F(1,29)=4.210,p<.05。有经验者 +1.93,新手 +.79,F(1,29)=1.088,p>.05;但经验×条件交互显著,F(1,29)=6.331,p<.05:新手并行 +2.9,串行 −.73。不能由“某组显著、另一组不显著”直接推出组间差异,本文提供的条件分析才是关键依据。
| 访谈/行为意向 | 并行 | 串行 | 原报告 |
|---|---|---|---|
| 说下次会做多个原型并寻求反馈 | 11/16 | 5/17 | χ²=2.63,p>.05 |
| 说反馈有帮助或符合直觉 | 13/16 | 6/17 | χ²=7.13,p<.05 |
| 把反馈体验为负面 | 0/16 | 8/17 | χ²=9.94,p<.05 |
| 留下邮箱表示愿意为杂志志愿工作 | 12/16 | 5/17 | χ²=6.86,p<.05 |
访谈支持作者关于“把自我与单一作品解绑”的解释,但不是对心理距离的直接实验操纵或中介检验。留下邮箱只是意向,不是后续实际参与。第一行比例看起来差距明显,仍须保留原文 p>.05,不把视觉上的差异升级为统计结论。
11 · 先前经验这个调节因素
14 名有经验者产生 350 点击/752,424 曝光,新手产生 151/427,896,χ²=8.10,p<.05;条件与经验没有显著交互。来自经验者广告的访客平均停留 38.0 秒,新手 7.6 秒,F(1,491)=8.456,p<.05。经验者内部并行广告 57.0 秒、串行 18.9 秒,条件×经验 F(1,491)=4.045,p<.05。
经验者广告访客 88/296 浏览首页外页面,新手 12/126,χ²=19.96,p<.05。注意这两组分子共 100,而按并行/串行拆分的上一段分子共 106;原文没有交代缺失或口径差异,本精读不把它们拼成新的交叉表。
经验者更有方向,可能知道哪些设计区域不值得探索,因此原型更相似但效果更好。这个解释可与“避免过早固着”共存:合理的收敛依赖有效先验。研究没有职业专家,不能把“some prior experience”翻译为熟练专业设计师,也不能推出专家无需并行。
12 · 两项后续研究回答了什么
一:实验员是否偏向并行组?
两位不了解实验条件的广告专家,查看每个原型及两组三条反馈,一组是真实实验选择,一组是从反馈库随机抽取;选更合适的一组。作者用双向混合 ICC(3,1) 比较实验员与外部专家选择的一致性,并行 .434、串行 .496,差异不显著,解释为中等一致且两条件接近。它缓解了“并行组拿到更相关反馈”的担心,但没有等价性界限,也不排除反馈语气、选择细节或实验员其他行为的影响。
二:这些脚本化反馈本身有用吗?
新招 30 人,都按串行做三个原型和一个最终广告,随机分 targeted、random、none 三种条件。targeted 由实验员挑相关三条,random 随机三条,none 用同等时间浏览客户网站。三周投放与 20 位专家评分如下(此表是将 §6 文本整理成表,不是原编号表):
| 条件 | 点击 | 曝光 | 点击率(本精读计算) | 专家 0–30 分均值(SD) |
|---|---|---|---|---|
| Targeted | 203 | 49,414 | 0.4108% | 15.9 (5.4) |
| Random | 157 | 49,543 | 0.3169% | 15.1 (5.2) |
| None | 179 | 49,663 | 0.3604% | 14.4 (6.2) |
投放总体 χ²=6.01、p<.05;专家总体 F(2,597)=3.287、p<.05。targeted 在两种结果中最高,但 random 的点击低于 none、专家分却高于 none,说明两种评价并不单调一致。总体显著不等于三个条件两两都显著,原文没有给完整事后比较。这项研究检验反馈相关性,不是一次新的并行对串行复验。
13 · 可信度审计与可复现性
| 原文问题 | 核对结果 | 本次处理 |
|---|---|---|
| 自我效能满分 | 四个 1–7 问题按通常求和应至 28;正文却写 out of 20 | 两者并列,原作者未说明转换,不伪造标准化 |
| 相似度量表 | 方法 1–7,结果 0–7 | 不擅改端点,解释方向不变 |
| 停留时间 t 值与 p | t(493)=1.781 写 p<.05,未说明单/双尾 | 通常双尾不会低于 .05;可能尾侧不同,需原分析确认 |
| 部分 R²/F | 相似度的两组回归数值按常见单预测变量模型不能直接相互吻合 | 照录,禁止据此推出精确相关系数 |
| 评委自由度 | 有7位评委,评委效应写 F(5,203) | 保留报告,缺少完整模型设计无法修正 |
| 图 6 排名 | 中间广告 CTR 图注第9,正文第4 | 显式记录冲突 |
| 导航访客计数 | 按条件分组与按经验分组的深度浏览人数总和不同 | 不从不同口径重建交叉数据 |
| 原笔记年份/通讯作者 | PDF2010;未单列通讯作者 | 保留原文,仅补建议 |
外部效度:单一广告尺寸、单一客户、学生为主、短会话、非专业设计者、人工预置反馈。真实线上投放增加生态真实性,但平台动态分配曝光、访客来源和重复曝光引入新复杂性。长期团队任务、工程原型成本高的任务、已有成熟方案的微调,都不能直接套用。
统计效度:设计者是随机分配单位;专家、作品、相似度评分、访客存在分层与重复。报告大量检验但未见统一多重比较方案;未给关键效应置信区间,未说明排除者分组细节,也未提供本次可获得的原始逐条数据。对 t/p 和模型自由度的疑问要通过原分析解决,而不是本精读自行修改成“正确值”。
构念效度:CTR 不是“美”,视觉多样性不是“创新”,信心不是“熟练”,留下邮箱不是“持续参与”。作者的三条机制合理且有访谈支持,但从并行流程到质量的因果中介尚未识别。复现应记录每次比较行为、反馈阅读顺序、实际修改轨迹,并做预注册分析。
14 · 与原有 HCI 贡献分类笔记衔接
原笔记把 Wobbrock/Kientz 框架下的主贡献看成理论、次贡献看成经验。这是可辩护的解读:比较学习、探索、自我效能三个机制把设计实践组织成可检验命题。但更谨慎地说,文章最直接的新证据是受控经验结果与实验范式,三个机制并未被独立检验到足以排他确认。因此也可以将经验贡献置前、理论解释置后;分类取决于你分析的是作者宣称、论文产物还是证据强度。
原笔记用 Oulasvirta/Hornbæk 框架将问题看成部分未知的经验现象,这与实验内容一致。需要收紧的是“可转移所以构造性贡献”的推论:提出可在别的领域试用的流程,不等于已经验证跨领域迁移或交付经评估的新系统。更有说服力的表述是:论文提供了可操作、可检验的设计流程干预与实验范式,其可迁移性仍是后续研究问题。
原笔记中“按所有指标胜出”的句子建议追加限定:核心广告 CTR、总专家分及效能变化支持并行,而站内进一步导航、未来多原型意向、部分分维度没有显著差异。本次保留用户原判断,并在这里提供可追溯的反例,便于以后写综述时避免过度概括。
15 · PMG/生成式设计的可检验延伸
以下是研究建议,不是原论文实验结果。在人机共创程序化材质、图像编辑或原型生成中,可以借用“等预算、改调度”的思想,但不能把人的自我效能机制直接套在模型上。
- 先批量候选,再共同批评:固定生成次数、总 token/算力、用户操作时间,对比逐次生成逐次修正与3+2批次方案。候选必须有真正结构差异,而非同一材质仅换随机种子。
- 分开三条机制:做反馈时机×是否并排可见的因子实验,另设保留单候选/多候选条件;这样才能判断收益来自延迟、比较还是选择集。
- 质量多目标:材质可以测外观匹配、可平铺性、可编辑性、程序图复杂度和盲评,避免单一 CLIP 分数替代所有设计质量。人类操作负担与控制感应单独测。
- 过程证据:记录分支产生、合并、放弃,测候选间图结构或参数距离;先证明这些指标与人类感知差异相关,再作为探索指标。
- 合适统计:参与者随机分配,任务/评委重复测量用分层模型;预注册主结局和有意义的效应界限,报告置信区间与失败例,而非只挑显著指标。
可先做小规模可行性试验,再据方差与最小有意义效应设计正式样本量。本精读不凭本论文的 33 人照搬功效,也不给未经估计的“至少 N 人”数字。尤其不要把并行候选用更多成本、串行只用少量成本,却宣称是流程本身的优势。
16 · 阅读后应能回答的问题
- parallel 指单个设计者同时保留多个候选,不是多人协作;两组原型数量、每项时间和反馈总量受控。
- 原型安排是 3+2+最终稿,对照逐次反馈;这改变了一个流程包,未单独分解心理机制。
- 主研究 33 人;14,850 是相似度判断次数,不是参与者数量。
- 点击率和专家分均支持并行,但不显著相互预测,质量必须按目标定义。
- 并行候选更不同,却没有证明多样性导致更好结果;经验者的作品更相似但质量更高。
- 四题七点量表与满分20冲突;t/p、图注排名、部分回归数值也应保留待核对。
- 两项后续研究分别检查反馈挑选偏差与反馈本身价值,不是所有机制的完全排除实验。
- 原笔记及 PDF++ 链接保留;本次新增内容是待整合候选,未写回 Obsidian,也未发布网站。
来源:用户原 PDF SHA256 9876e011a07c1f069514d307ab270e396c7d1a724f2cac3bcb47ad87138faed7;原 Table I 全部七行及分类、Figures 1–10、Appendix A–D 均覆盖。图表版权归原作者/ACM,仅作为用户私人阅读材料;浏览器渲染与本地验收按用户安排延后。本次完成内容与静态检查,不声称已经完成浏览器验收。