论文的问题规模;公开运行包另有 20 槽接口及固定槽位,不能混写
01 · 核心结论与版本核实
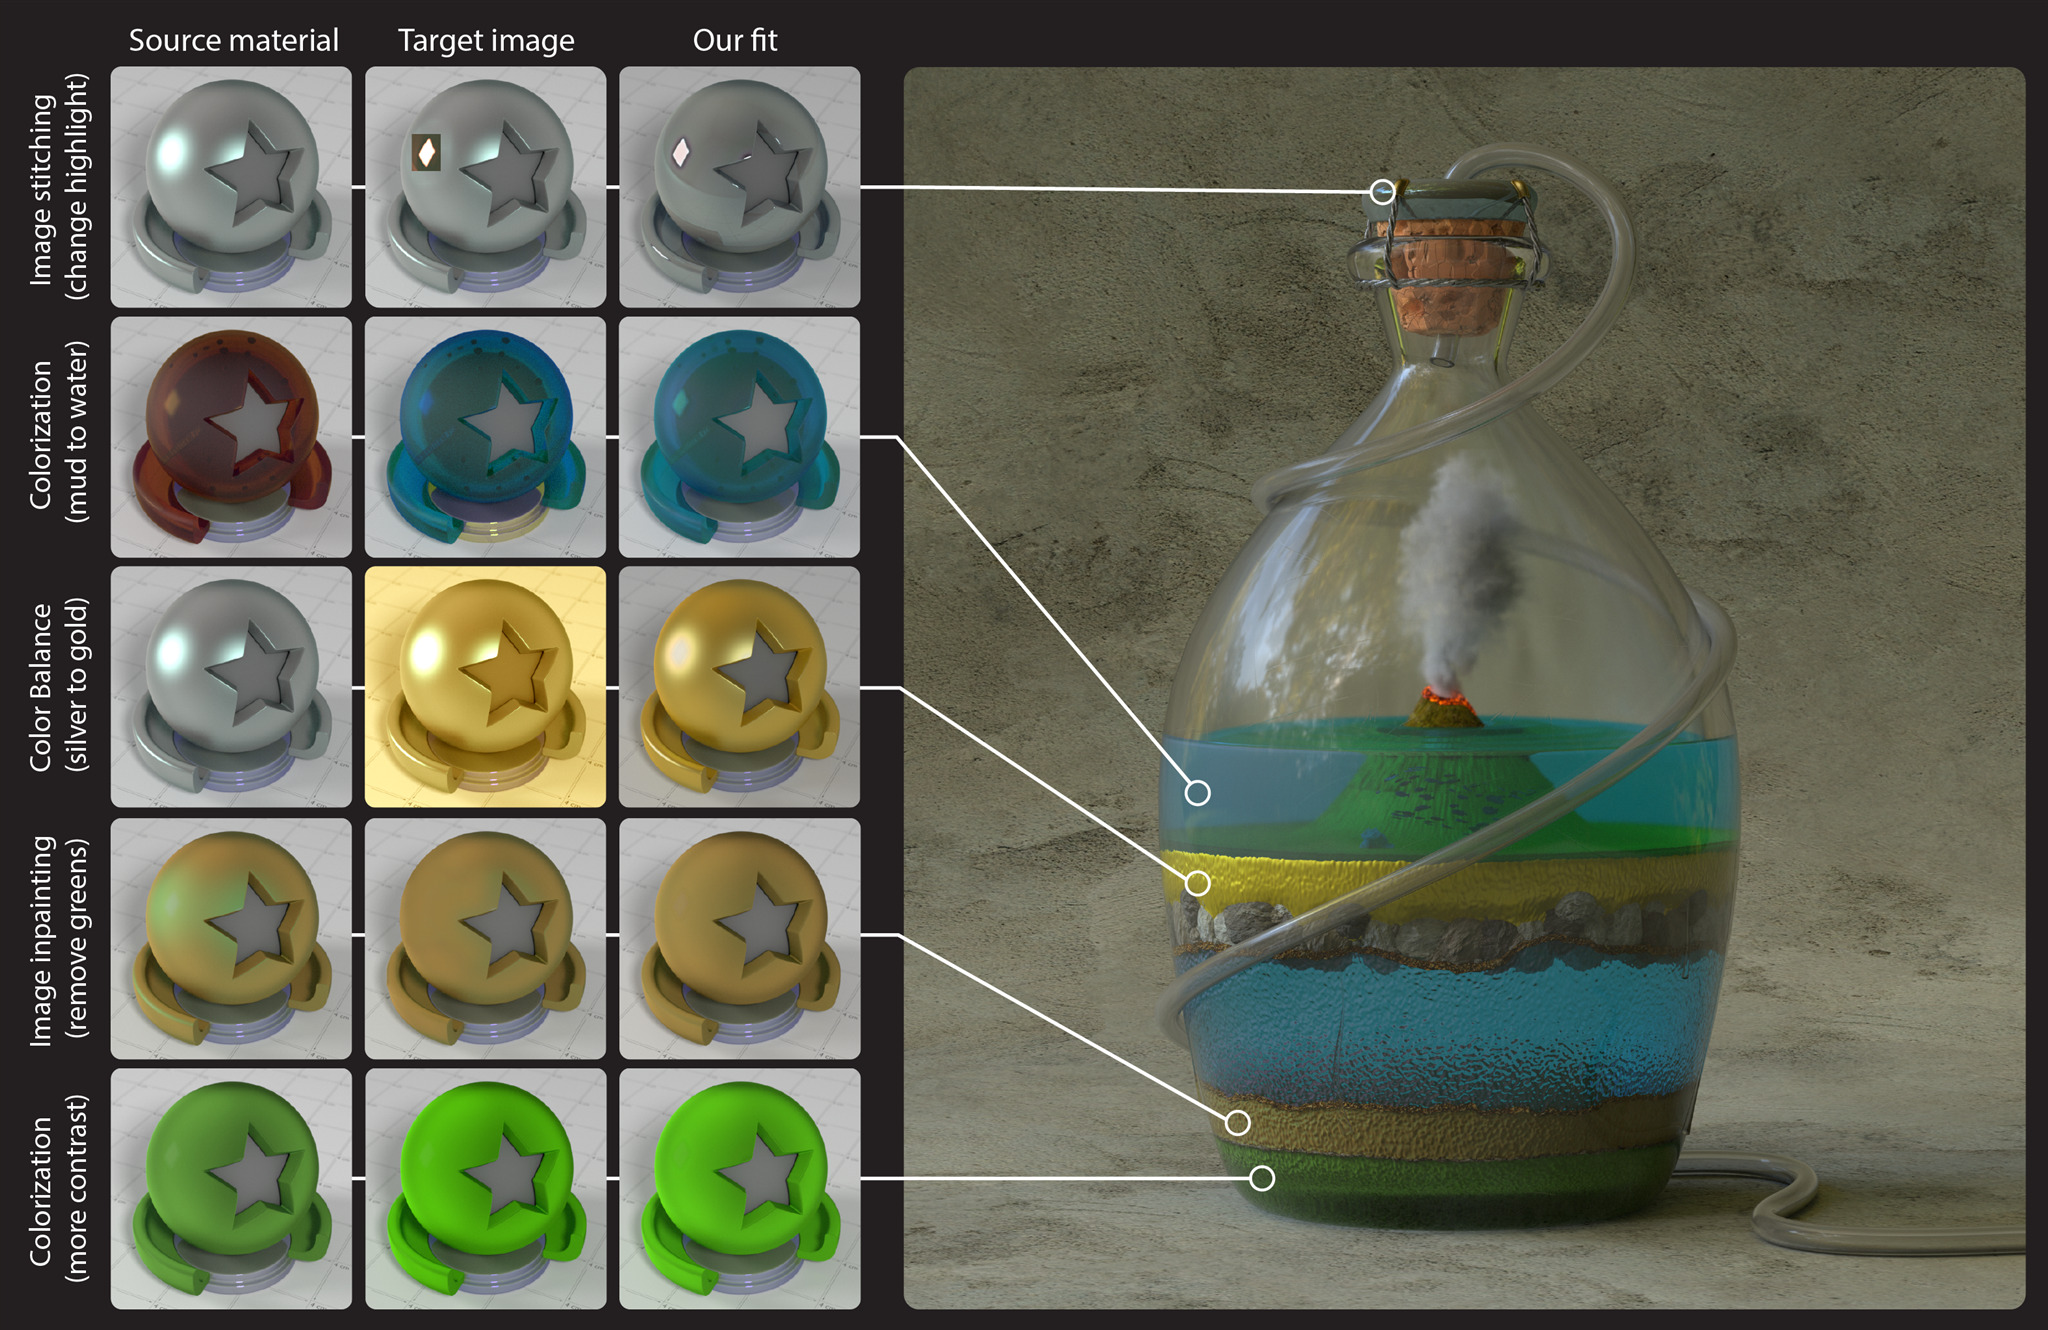
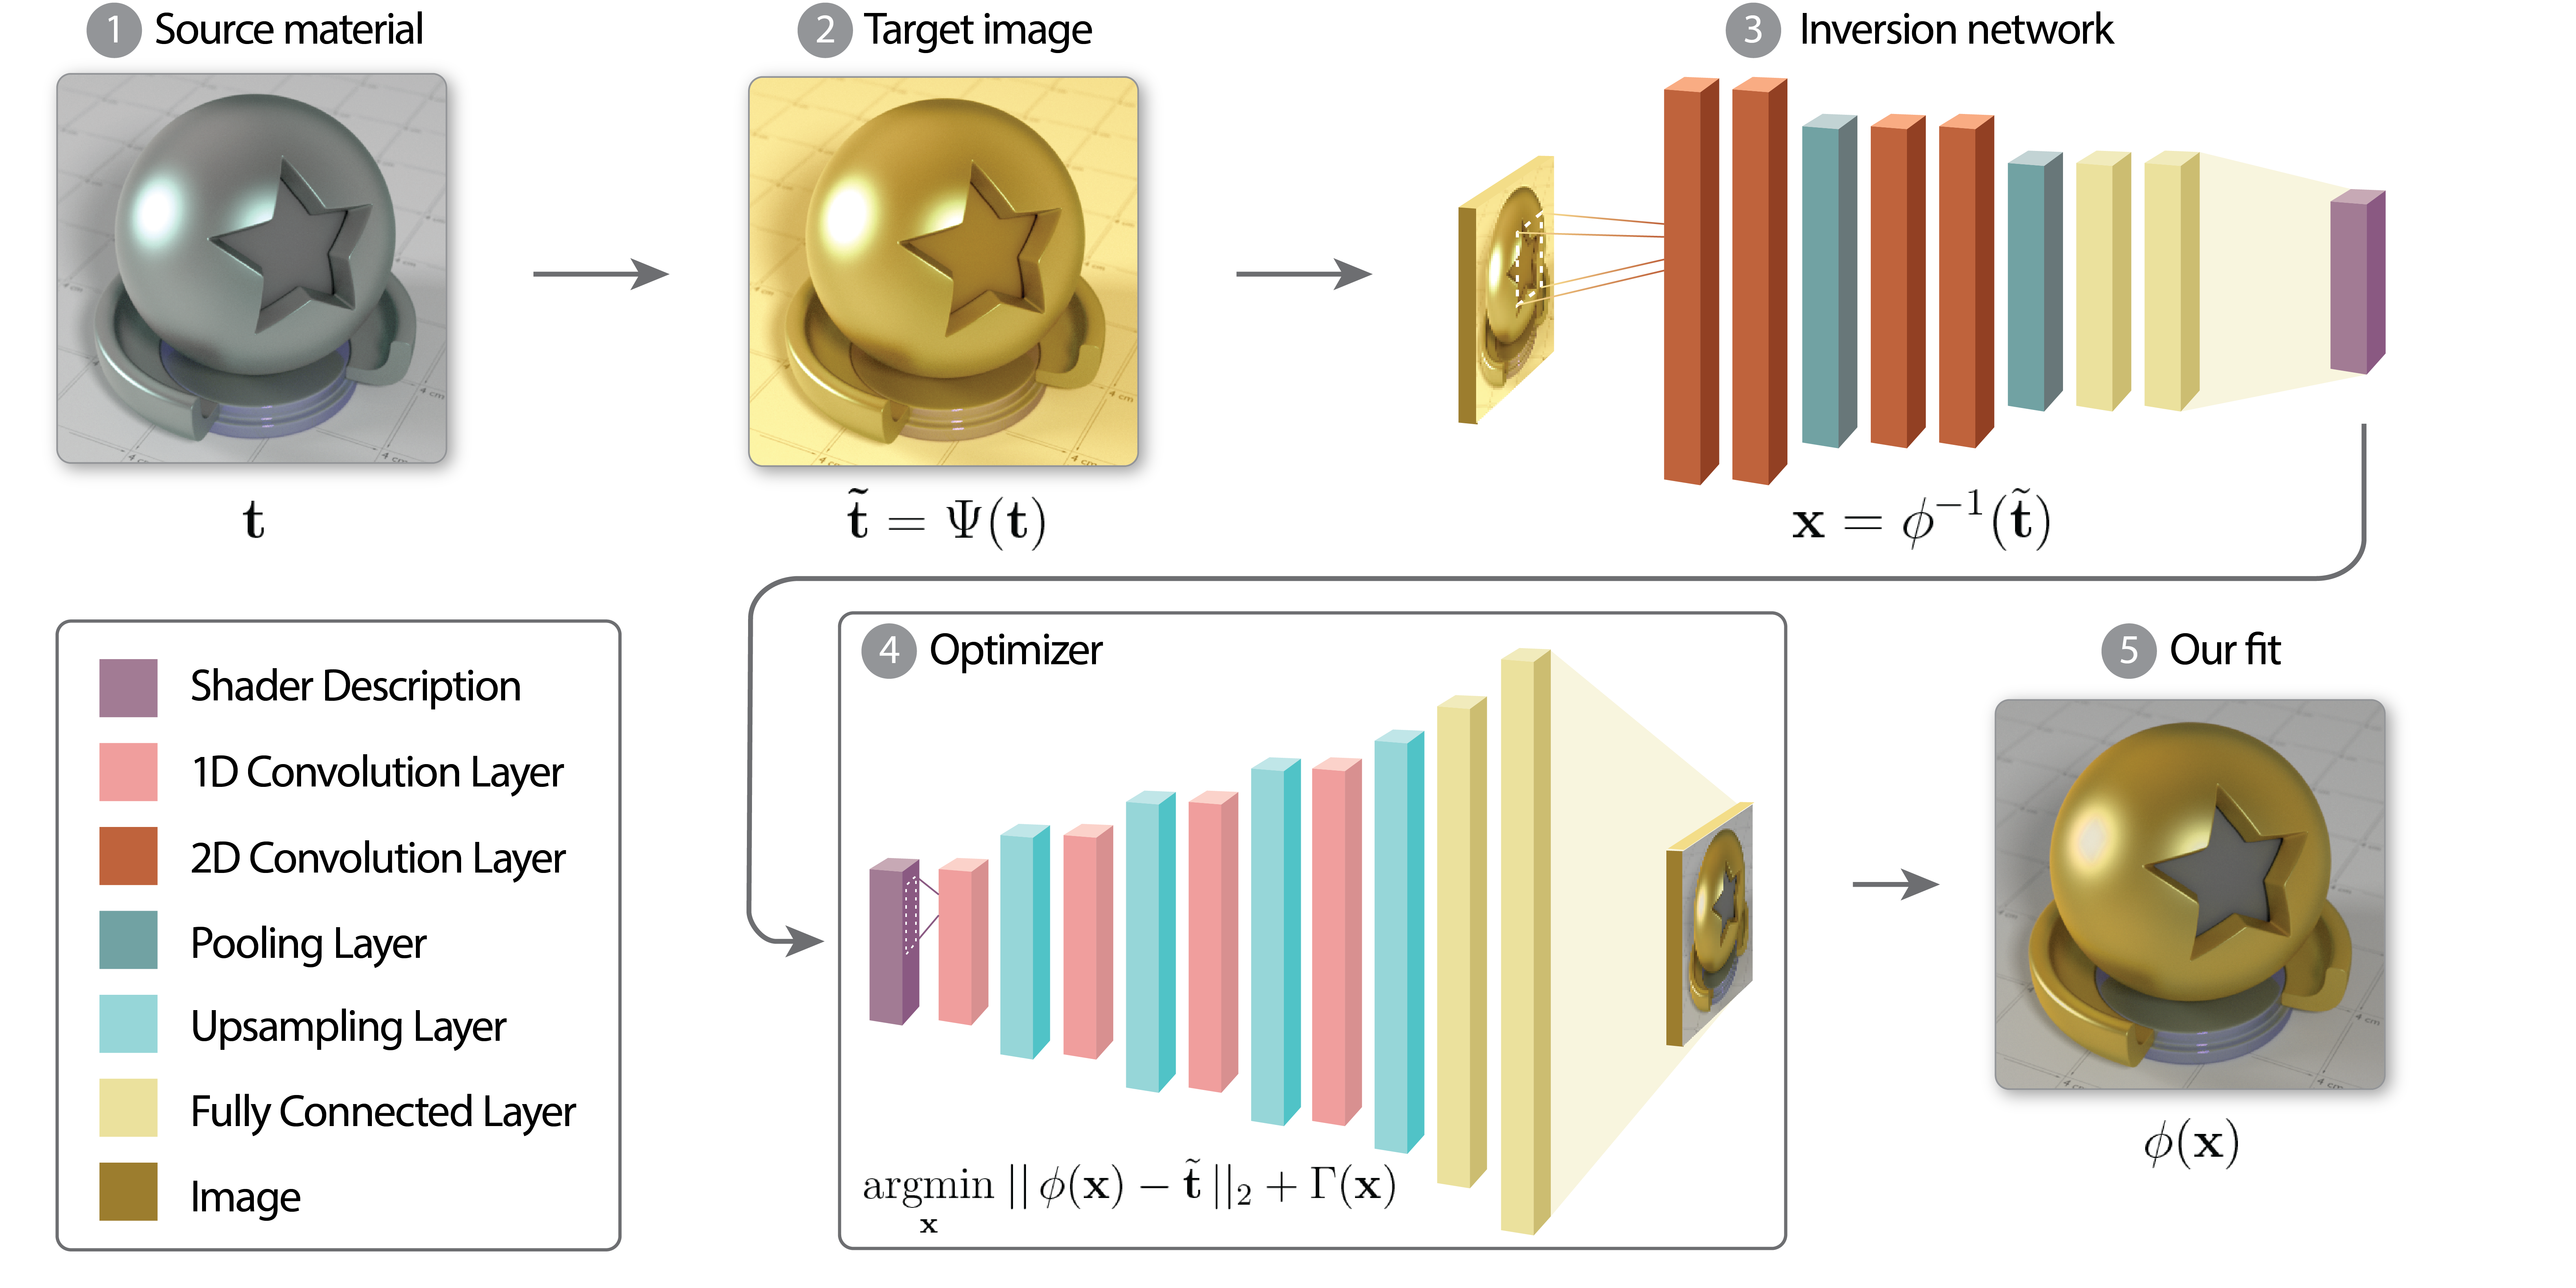
这篇论文把二维图像编辑转换为可重新渲染的材质参数编辑。用户在固定材质测试场景的渲染图上改颜色、拼接高光或局部模糊;系统先用九个逆网络提出参数,再用神经渲染器比较候选,最后从最好的起点运行 Nelder–Mead。产物是固定 principled shader 的参数,可放回 Blender/Cycles 或生产场景,而不是仅有一张改好的图片。
逆网络提供多样化初始化,前向渲染误差决定哪个候选进入优化
论文 1,500 次函数评估预算的典型结果;不是包含离线训练的总成本
Paper Verified 正式标题为 Photorealistic Material Editing Through Direct Image Manipulation,作者依次为 Károly Zsolnai-Fehér、Peter Wonka、Michael Wimmer;发表于 Computer Graphics Forum 39(4), 107–120,EGSR 2020,DOI 10.1111/cgf.14057。固定 PDF 为 14 页,包含 Appendix A 的九个网络规格、Appendix B 的优化器对照和参考文献。
元数据修正:Wiley 的作者信息明确将 Károly Zsolnai-Fehér 标为 Corresponding Author,因此他同时是第一作者与已核实通讯作者;不能继续把末位 Michael Wimmer 当作未核实通讯候选。第一作者机构为 TU Wien,Peter Wonka 为 KAUST,Michael Wimmer 为 TU Wien。预印本 1909.11622v1 于 2019-09-12 提交;下文页码、表格以用户提供的 2020 出版版本为准。
Implementation Verified 作者提供的 code-only ZIP 与 8.36 GB 完整包中的主脚本逐字节相同。本次通过 HTTP byte-range 读取完整包目录及 28 个小型源码/JSON/说明文件,并校验 CRC;另外读取 Blender 材质加载场景中的参数映射,没有执行其中脚本,也没有下载或运行网络权重。运行包仍呈现 2019 年发布配置,与 2020 附录存在多处差异,详见后文。
出版 PDF · Wiley 作者与通讯信息 · 官方项目与代码 · 预印本版本
02 · 研究问题与工作流的边界
节点式材质系统能表达多种反射、透射和体积效果,但调整 IOR、roughness、absorption 及混合比例需要理解参数相互影响。艺术家的目标常常是“这个地方再亮一点”“把高光拉宽”“让颜色更金黄”,这些目标在图像域里直观,在物理参数域里却难以反推。本文利用这一落差,让已有二维图像处理技能成为材质建模界面。
用户修改后的图像通常不在可物理实现的图像集合里:例如在同一材质的一个局部独立移动高光,可能违反全局一致的反射行为。作者不要求精确逆解,而是在固定 shader 能渲染出的图像集合里寻找最接近目标的点。因此,“photorealistic”来自输出依然可由 shader 与光传输渲染,不意味着目标图本身物理正确,也不意味着恢复了某个真实材质的唯一参数。
这里的输入不是任意照片,也不是任意生产场景截图。源图来自已知几何、已知相机和固定照明的测试场景。最终参数可以迁移到别的场景,但优化时使用的神经渲染器仍限定于这个测试场景。更换测试 geometry、lighting 或 shader,需要重新制作相应训练数据并训练代理。
Our Interpretation 本文最重要的系统思想是将学习与优化分工:学习给出快速但不可靠的猜测,渲染器使猜测可以廉价验证,传统优化弥补域外编辑造成的预测偏差。九个网络不是九次投票,也不直接平均参数;谁的结果更接近当前目标,谁获得优化预算。
03 · 问题定义与全部关键公式
| 符号 | 含义 | 输入输出关系 |
|---|---|---|
| \(x\in\mathbb R^m\) | 固定 shader 的参数向量;论文取 \(m=19\) | 不是 graph token,不生成节点拓扑 |
| \(t,\tilde t\in\mathbb R^p\) | 原始渲染图、用户编辑的目标图 | 论文 \(p=3\times410^2=504{,}300\),RGB 范围 0–255 |
| \(\Psi\) | 用户的二维图像操作 | \(\tilde t=\Psi(t)\),可为全局颜色变化或局部操作 |
| \(\phi(x)\) | 固定场景的前向图像生成过程 | 概念上是光传输渲染器,在线实现用训练好的神经 renderer 代替 |
| \(\phi^{-1}_{(i)}\) | 第 \(i\) 个逆网络/encoder | 目标图→参数候选;符号不保证数学上的真实逆函数 |
| \(C,\Gamma\) | 参数可行域与障碍函数 | 保证颜色、IOR 等数值处于指定范围 |
式 1:在材质参数域拟合编辑目标
\[x^{\ast}=\arg\min_x\lVert\phi(x)-\tilde t\rVert_2,\qquad
x_{\min}\le x\le x_{\max}.\]
所有比较在 tone-mapped image space 中进行,以契合用户在图像编辑器里的视觉目标,而不是在线性 HDR radiance 空间中拟合。参数 bounds 逐维约束,例如 albedo 在 0–1,IOR 至少为 1。解通常不唯一,且目标可能不可达;优化得到的是近似投影而非精确反演。
式 2:将盒约束写成硬障碍
\[\min_x \left(\lVert\phi(x)-\tilde t\rVert_2+\Gamma(x)\right),\qquad
\Gamma(x)=
\begin{cases}
0,&x\in C,\\
+\infty,&x\notin C,
\end{cases}
\quad C=\{x\mid x_{\min}\le x\le x_{\max}\}.\]
这使不同优化器可以用统一目标接口比较。它不是平滑 log-barrier,不应假定边界附近有良好梯度。实际代码以 \(10^{20}\) 代替无穷大。标准实验用 RMSE 作为距离:
\[d_{\mathrm{RMSE}}(a,b)=
\sqrt{\frac{1}{p}\sum_{j=1}^{p}(a_j-b_j)^2}.\]
对固定尺寸图像,RMSE 和 L2 norm 仅差常数比例,最小化位置相同;但数值尺度、停止容差和图表单位不应混淆。Table 1–3 的数值是 0–255 图像域 RMSE,不能拿它们直接与 0–1 范围的神经网络训练 loss 比。
式 3:best-of-nine 选择
\[x_i=\phi^{-1}_{(i)}(\tilde t),\qquad
i^{\ast}=\arg\min_{i\in\{1,\ldots,9\}}
\lVert\phi(x_i)-\tilde t\rVert_2,\qquad
x_{\mathrm{init}}=x_{i^{\ast}}.\]
候选是用前向渲染后的图像误差打分,不使用网络自报的 confidence,也不需要真实目标参数标签。该条件非常重要:目标图已经可见,代理渲染又足够便宜,所以可以“生成候选→直接验证→选起点”。最终再优化 \(\phi(x)\) 到 \(\tilde t\) 的误差。
式 1–2 · 式 3 与 hybrid · 公开优化脚本
04 · Algorithm 1 的完整执行含义
| 原步骤 | 操作 | 实际作用与变量 |
|---|---|---|
| 1 | 给定源图、前向 renderer、九个逆网络、上下界 | 所有网络权重在编辑时冻结 |
| 2 | 用户执行图像编辑,形成目标 | 系统不限制编辑器品牌,也没有自然语言 prompt |
| 3–4 | 逐个逆网络推理 | 得到九个 shader 参数向量 |
| 5–6 | 前向渲染并比较目标误差,选择最优起点 | 比较的是候选的当前图像,而非优化后可达到的结果 |
| 7–9 | 定义 \(f_1=x_{\max}-x\)、\(f_2=x-x_{\min}\) 与可行域 | 逐维非负条件实现参数盒约束 |
| 10 | 构造可行域内为 0、域外为无穷的障碍 | 防止输出越界材质 |
| 11–12 | 从候选起点最小化图像误差+障碍 | Nelder–Mead,不用神经网络梯度来更新 shader |
| 13 | 显示结果 | 预览由神经 renderer 提供;最终将参数导回真实场景离线渲染 |
Nelder–Mead 在低维连续空间维护 simplex,通过反射、扩张、收缩和缩小寻找更低目标值。它适合把 renderer 当黑盒调用,避开了对渲染程序求导的要求。论文把它避免坏局部极小值的能力归因于收缩操作,但这不是全局最优保证;好的初始化改变的是进入哪个吸引域。
两种网络角色:逆网络负责 proposal,神经 renderer 负责廉价 objective。所谓 neural-network-augmented optimizer 指后者替代每次昂贵的真实渲染,不是让一个神经 optimizer 学习更新规则。作者没有训练 RL agent、工具调用策略或图生成器。
Reviewer Commentary 在线目标实际依赖代理误差。如果记真实 renderer 为 \(R\)、代理为 \(\hat R\),则 \(\arg\min_x d(\hat R(x),\tilde t)\) 不一定等于 \(\arg\min_x d(R(x),\tilde t)\)。优化还可能主动寻找代理的错误区域。本文用最终场景示例验证可用性,但没有系统给出每次优化后 proxy-to-Cycles gap 的分布。
05 · 固定 shader 与 20 槽接口审计
论文复用 Gaussian Material Synthesis 的 shader,覆盖 diffuse、glossy、specular、translucent,以及 roughness 和 volumetric absorption。它是一个预先定义的组合材质模型,编辑的是节点参数,不是为每个目标生成一个新的节点图。原有笔记中“已知光照、几何、特殊材质模型”的理解成立;方法原则上可换其他 shader,但须有可靠的配套神经 renderer。
完整公开包内含 Blender 2.78 格式的 material-loader.blend。只读提取其嵌入脚本文本后,可以把 optimize_constraints.py 中的 bounds 与加载器对应起来。下表使用从 0 开始的代码槽位,保留所有存储字段:
| 代码槽位 | 加载器对应属性 | 活动范围 | 可变化维数 |
|---|---|---|---|
| 0–2 | Glossy BSDF 1 的 RGB | 0–1 | 3 |
| 3 | Glossy BSDF 1 的 roughness | 固定 1 | 0 |
| 4–6 | Glossy BSDF 2 的 RGB | 0–1 | 3 |
| 7 | Glossy BSDF 2 的 roughness | 0–1 | 1 |
| 8 | Mix Shader 1 factor | 0–1 | 1 |
| 9 | Mix Shader 2 factor | 0–1 | 1 |
| 10 | Mix Shader 3 factor | 0–1 | 1 |
| 11 | Volume Absorption density | 0–2 | 1 |
| 12–14 | Glass BSDF 的 RGB | 0–1 | 3 |
| 15 | Glass roughness | 0–0.04 | 1 |
| 16 | Glass IOR | 1.1–2 | 1 |
| 17–18 | Translucent BSDF 的 R、G | 0–1 | 2 |
| 19 | Translucent BSDF 的 B | 固定 0 | 0 |
活动目标函数每次都强制 x[3]=1、x[19]=0。因此公开实现存 20 个数,却只有 18 个在这套活动 bounds 下可变化;论文的 \(m=19\) 是模型表述,两者不是同一种计数。不能把最终向量随意删一维后导入现代 Blender Principled BSDF:这些数直接赋给多个旧式节点的 sockets,位置与语义必须按加载器核对。
加载器也引用 Musgrave、Noise、Voronoi、Magic 等程序纹理节点,但对应扩展参数赋值被包在注释块中,不属于本次 20 槽优化。不能据这些节点名字声称本文能生成任意 procedural topology。README 中的输出文件名有 recommendations.txt 与 recommend.txt 两种写法,实际主脚本写的是 recommend.txt。
code-only ZIP:minima、maxima、obj_fun_extended · 完整包:2-material-loader-scene/material-loader.blend 与 README(8.36 GB,按需下载)

06 · Appendix A 的九个逆网络
记 C32=Conv2D(32 filters, 3×3 kernel, stride 1),P2=MaxPool(2,2)。下表忠实保留附录简写;FC 的数字为神经元数,dropout 按两个隐藏全连接层与输出层列出。每个网络最终输出 \(m\) 维参数。
| 编号 | 卷积/池化路径(原文简写) | FC 路径 | Dropout |
|---|---|---|---|
| 1 | 2×{C32,P2} → 1×{C64,P2} → 2×{C128,P2} | 1000 → 1000 → m | 0.1, 0.1, 0.0 |
| 2 | 2×{C32,P2} | 1000 → 1000 → m | 0.1, 0.1, 0.0 |
| 3 | 2×{C32,P2} | 1000 → 1000 → m | 0.5, 0.5, 0.0 |
| 4 | 2×{C32,P2} → 1×{C64,P2} → 2×{C128,P2} | 3000 → 3000 → m | 0.5, 0.5, 0.0 |
| 5 | 2×{C32,P2} → 1×{C64,P2} → 2×{C128,P2} | 3000 → 3000 → m | 0.0, 0.0, 0.0 |
| 6 | 2×{C32,P2} | 1000 → 1000 → m | 0.0, 0.0, 0.0 |
| 7 | 2×{C32,P2} | 1000 → 1000 → m | 0.0, 0.0, 0.0 |
| 8 | 2×{C32,P2} | 100 → 100 → m | 0.0, 0.0, 0.0 |
| 9 | 2×{C32,P2} | 1000 → 1000 → m | 0.0, 0.0, 0.0 |
网络 6、7、9 在附录中同构,但训练 epochs 不同,用于观察后期过拟合带来的差异。作者没有逐个报告实际 epoch 数;不能把同构理解成相同 weights。大部分网络在很多编辑目标上会失败,甚至给出不可行域外参数;集成的价值来自不同失败模式,而不是声称每个逆网络都精确反演。
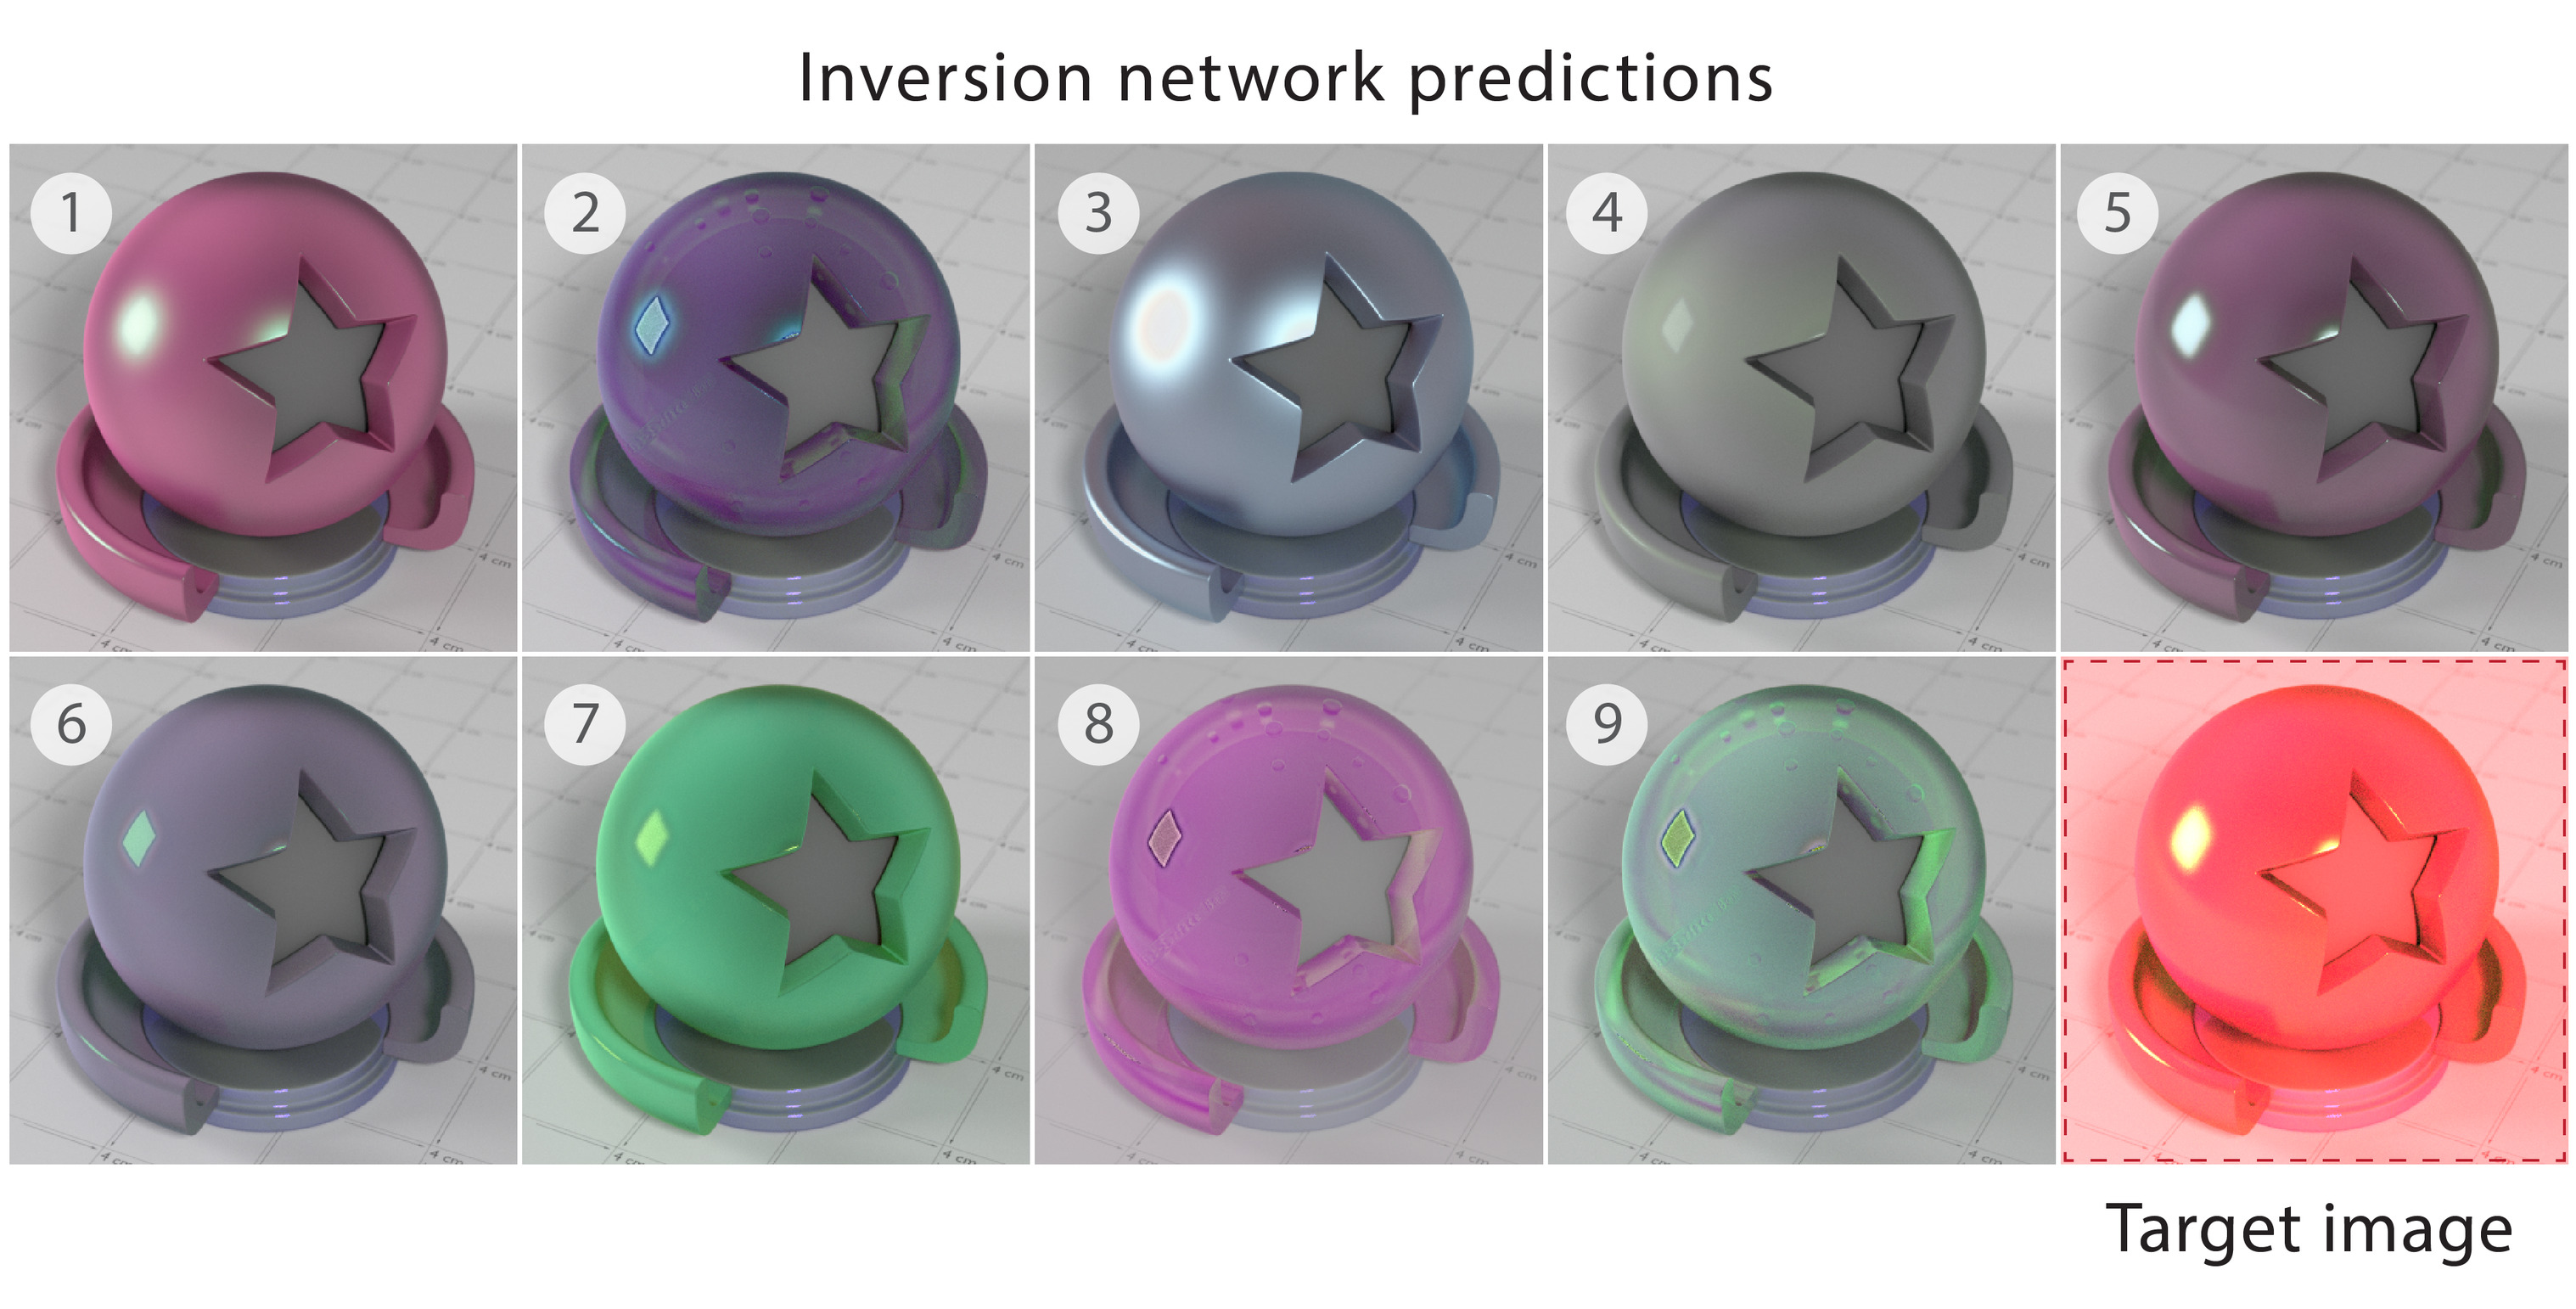
输入是图像,输出是连续参数,没有离散 vocabulary、tokenizer、autoregressive ordering、temperature 或 beam search。训练时网络学的是已渲染图像到参数的近似反演;用户的涂抹、拼接和非物理编辑并不需要逐种出现在训练集里。这种自由同时带来明显的 distribution shift。
基础配置和较大配置
论文没有 foundation model 的 base/large 命名。网络 1、4、5 使用较深卷积路径,4、5 的 FC 宽度增至 3000;网络 8 的 FC 为 100。这是组成九候选集的结构多样性,不是独立的大模型优越性实验。论文称每个逆网络占约 300 MB–1 GB 显存,九个都能驻留 TITAN RTX;显存占用包含运行状态,不能直接等同于参数文件大小。
07 · 公开权重配置与论文简写的差异
Implementation Verified 网络 JSON 是已发布模型的架构描述,比代码中未启用的备用构造函数更接近实际推理结构。所有逆网络 JSON 输入均为 3×419×419,输出 20;前向网络输出 526,683,恰好等于 \(3\times419^2\)。这与论文的 410×410 不同。完整包 HTTP Last-Modified 为 2019-09-09,早于正式出版,当前公开文件不自动等于最终实验 checkpoint。
以下参数量从 JSON 的层形状与 bias 配置静态计算,未加载 weights;不冒充作者报告或实测显存:
| 配置 | 实际卷积/池化 | 全连接输出 | Dropout | 静态参数数 |
|---|---|---|---|---|
| 1 | 10 Conv2D,5 次 P2 | 1000 → 1000 → 20 | .1 | 23,254,692 |
| 2 | 2 Conv2D,一次 P8 | 1000 → 1000 → 20 | .1 | 87,560,164 |
| 3 | 2 Conv2D,一次 P8 | 1000 → 1000 → 20 | .5 | 87,560,164 |
| 4 | 10 Conv2D,5 次 P2 | 3000 → 3000 → 20 | .5 | 74,562,692 |
| 5 | 10 Conv2D,5 次 P2 | 3000 → 3000 → 20 | 0 | 74,562,692 |
| 6 | 2 Conv2D,一次 P8 | 1000 → 1000 → 20 | 0 | 87,560,164 |
| 7 | 2 Conv2D,一次 P8 | 1000 → 1000 → 20 | 0 | 87,560,164 |
| 8 | 2 Conv2D,一次 P8 | 100 → 100 → 20 | 0 | 8,675,164 |
| 9 | 2 Conv2D,一次 P8 | 1000 → 1000 → 20 | 0 | 87,560,164 |
| Forward | 3×{Conv1D64, Up2} | 1000 → 526683 | 无 | 537,475,643 |
深路径的实际配置为五组“两个卷积后接一个 2×2 pooling”,filters 依次 32、32、64、128、128,即 10 个 Conv2D。浅路径则为两个 32-filter 卷积后一次 8×8 pooling。这与 Appendix A 字面上的“重复 Conv2D+MaxPool(2,2)”不等价。dropout 和 FC 宽度大体对应,但需要保留精确配置,不能仅按附录重新搭建后宣称复现公开模型。
继承 GMS 的前向渲染器在文献中写为四组 Conv1D(64,3,1)+Upsampling(2),然后 FC1000 与 RGB 输出,使用 ELU;公开 JSON 则是三组 Conv1D+Upsampling,ReLU,输入 20×1,Flatten 后 FC1000,再接 526,683 维 linear 输出。该最后全连接层使代理有约 5.37 亿参数。网络本身能快速推理,但并不“小”;主要是用大容量固定场景代理换掉昂贵光传输。
序列化元数据记录前向模型为 Keras 2.0.5/Theano,逆网络为 Keras 2.1.2/TensorFlow。旧 API、channels_first 和无作用的 zero-padding 元数据都需要版本兼容检查。最安全的复现路线是先按原 JSON 与张量顺序验证固定样本输出,再做框架迁移。
官方完整包:adjoint-cnn 与 fusion-network1–9 的 my_model_architecture.json · 被引用的 GMS 前向模型规格
08 · 数据构造与训练设置
前向网络学习参数→图像;逆网络把同一对数据交换方向,学习图像→参数。这是受监督的参数回归,并没有用用户真实编辑轨迹或自然语言标签训练。大量训练样本可以通过固定 shader 随机采样再渲染生成,代价被移动到离线阶段。
\[L_{\mathrm{forward}}=\frac{1}{N}\sum_i
\lVert\hat R_{\theta}(x_i)-R(x_i)\rVert_2^2,\qquad
L_{\mathrm{inverse}}=\frac{1}{N}\sum_i
\lVert E_{\omega}(I_i)-x_i\rVert_2^2.\]
上式是依据公开 MSE 配置整理的训练表达,不是本文新增编号公式。不同参数语义与尺度不同,参数 MSE 不等于材质外观 MSE;例如 IOR 和颜色误差具有不同视觉作用。公开训练代码中还保留其他 weighted loss 设想,但活动 compile 使用 MSE。
| 项目 | 来源与确认结果 | 不能推断的内容 |
|---|---|---|
| 主论文实验 GPU | 全部报告结果使用 NVIDIA TITAN RTX | 不能把继承数据制作时的 TITAN X 混为同一设备 |
| 前向训练数据 | 本文明确复用 GMS;其论文报告 45,000 个 LDR shader-image pairs,410×410,250 spp | 未独立确认每个 PME checkpoint 恰好采用相同数据 manifest |
| GMS 数据与训练成本 | 原文报告数据渲染约 4 周、GTX TITAN X;validation 2,500;训练少于 30 小时 | 这些是前作成本,不是九个 PME 逆网络的训练时间 |
| GMS optimizer | Adam:LR 1e-3,β1=.9,β2=.999,epsilon=1e-8,decay=0,Glorot initialization | 不能因 renderer 被复用就把这些数自动赋给全部逆网络 |
| 逆网络可得训练脚本 | 仅部分网络附 nn.py;batch=64,MSE,optimizer='adam',无 augmentation | Adam 具体默认值取决于旧 Keras;脚本没有逐一保存最终训练日志 |
| 数据分片 | 脚本 num_samples=3000,num_val=250,num_test=15;逐块读取训练 | 3000 是读取块大小,不应无依据称总训练集大小 |
| 停止与 epochs | 循环上限 1,000,000,EarlyStopping patience=500,checkpoint 根据 val_loss | 上限不是实际训练一百万 epochs;重复单 epoch fit 的 callback 行为需版本核实 |
| 预处理 | 用前 250 validation 图算全局 mean;减 mean 后除 255;RGB 转 channels_first | 该验证集参与归一化,不能称完全独立的预处理统计 |
| 公开包目录 | imgs-18d 下 6,206 张 PNG;black-level sequence 500 张;其他编辑子集另存 | 目录计数不是原论文训练规模,也不证明这些图全用于训练 |
| 未知项 | 九个模型各自 epoch、完整训练 manifest、统一随机种子、训练精度、gradient accumulation、scheduler/warmup、总 GPU 小时及最终 checkpoint 与论文表格逐一对应关系未完整公开 | |
inverse scripts 中存在本机绝对路径,且不同文件的 train 开关不同;运行前必须检查。主优化脚本设 np.random.seed(1),但这不足以保证旧 GPU 后端所有操作确定。数据读取只取完整块的逻辑也可能跳过最后不足 3000 张的尾部,需记录实际样本 ID,而不能只看文件夹数。
实验设备与数据继承声明 · GMS 数据和前向训练 · 完整包 training scripts、模型 JSON 与数据目录
09 · 在线编辑与序列重初始化
一次编辑的实际路径
- 从参考材质 gallery 选择起始图,在图像编辑器中得到目标
- 归一化目标并依次运行九个逆网络
- 渲染九个参数候选,按当前目标 RMSE 排序
- 处理参数约束,运行有限评估预算的 Nelder–Mead
- 保存参数与神经预览,用 material-loader 导入 Blender,最终离线渲染
论文比较 50、300、1500 次函数评估,约对应 1、6、30 秒。每张神经 renderer 图像约 4 ms,相比真实渲染平均 50 秒,单次图像评估约快 12,500 倍;这只是渲染函数的比值。完整优化的额外 overhead、网络调用、CPU 调度与数据转换使 1500 次评估的总时间约 30 秒,而非简单的 6 秒。九个网络的固定加载成本约 5.5 秒,在用户工作流计时中另有计入。
式 4:把前一帧最优解加入候选池
\[x_{k-1}^{\ast}=\arg\min_x\bigl(
\lVert\phi(x)-\tilde t_{k-1}\rVert_2+\Gamma(x)\bigr),\qquad
\phi^{-1}_{(n+1)}(\tilde t_k)=x_{k-1}^{\ast}.\]
这个“第十个逆网络”只是论文记号,实际上是缓存上一个优化结果,没有训练新网络。当前帧对九个新候选和前一帧解一起评分,选最优后继续优化。若相邻目标 \(\lVert\tilde t_{k+1}-\tilde t_k\rVert_2\) 很小,上一步结果常常提供更好的起点;突然大幅修改则仍可回退到新网络候选。
作者以逐渐提高 black level 的图像序列测试,预算为 100/300/600 次评估,约 2/6/12 秒。摘要提到的 1–2 秒是交互预算目标,不代表全部表格实验都只花 1–2 秒。即使前一帧连续,参数仍可能在等价解之间切换;本文没有显式参数平滑项,也没有测量材质动画在新光照下的 temporal flicker。
式 4 与 reinitialization · 评估预算与速度 · encode_all_animation 与活动入口
10 · 原 Table 1 完整重建
所有数值均为输出图像对目标的 RMSE,越低越好。Random 是随机参数初始化,NN 是 best-of-nine 的初始结果,Ours 是以该结果初始化的 Nelder–Mead。第一行的参考图本来就在 shader 可实现集合中,其余选择了较困难的全局/局部编辑。粗体标同预算下较低者;这里不增加未报告的重复次数或置信区间。
| Input | Initial guess | 50 function evals | 300 function evals | 1500 function evals | ||||
|---|---|---|---|---|---|---|---|---|
| Random | NN | Optimizer | Ours | Optimizer | Ours | Optimizer | Ours | |
| Fig. 5, Row 1 | 41.93 | 5.94 | 33.81 | 4.53 | 9.42 | 2.84 | 5.62 | 2.37 |
| Fig. 5, Row 2 | 78.45 | 32.72 | 68.55 | 32.67 | 40.24 | 32.67 | 40.21 | 32.67 |
| Fig. 5, Row 4 | 35.37 | 18.68 | 30.88 | 16.53 | 17.29 | 14.71 | 16.98 | 14.68 |
| Fig. 5, Row 7 | 41.65 | 22.42 | 38.10 | 22.38 | 26.30 | 22.38 | 26.24 | 22.38 |
| Fig. 5, Row 8 | 29.04 | 19.82 | 26.79 | 18.43 | 22.93 | 15.37 | 22.93 | 15.37 |
| Fig. 8, Row 2 | 23.78 | 12.79 | 20.31 | 11.62 | 8.27 | 7.81 | 8.26 | 7.80 |
| Fig. 8, Row 3 | 21.60 | 9.09 | 16.54 | 8.28 | 6.24 | 5.80 | 6.19 | 5.80 |
| Fig. 8, Row 8 | 29.58 | 9.74 | 22.69 | 7.92 | 6.63 | 5.36 | 6.63 | 5.36 |
在八个列出的任务及三个预算下,hybrid 均低于随机初始化优化器。Fig.5 Row1 在 1500 次评估时从 5.62 降至 2.37,约降低 57.8%;Fig.8 Row2 从 8.26 降到 7.80,仅约 5.6%。改善幅度并不均一,说明对易于随机搜索的局部编辑,较好初始化的优势较小。
多个目标很快平台化:Fig.5 Row2 的 hybrid 在 50 次时已是 32.67,后面不变;Row7 的 22.38 也几乎没有改善。这可能同时包含目标不可达、代理误差和落入局部极小值,不能仅凭平台就认定已经找到物理可行集合的全局最近点。
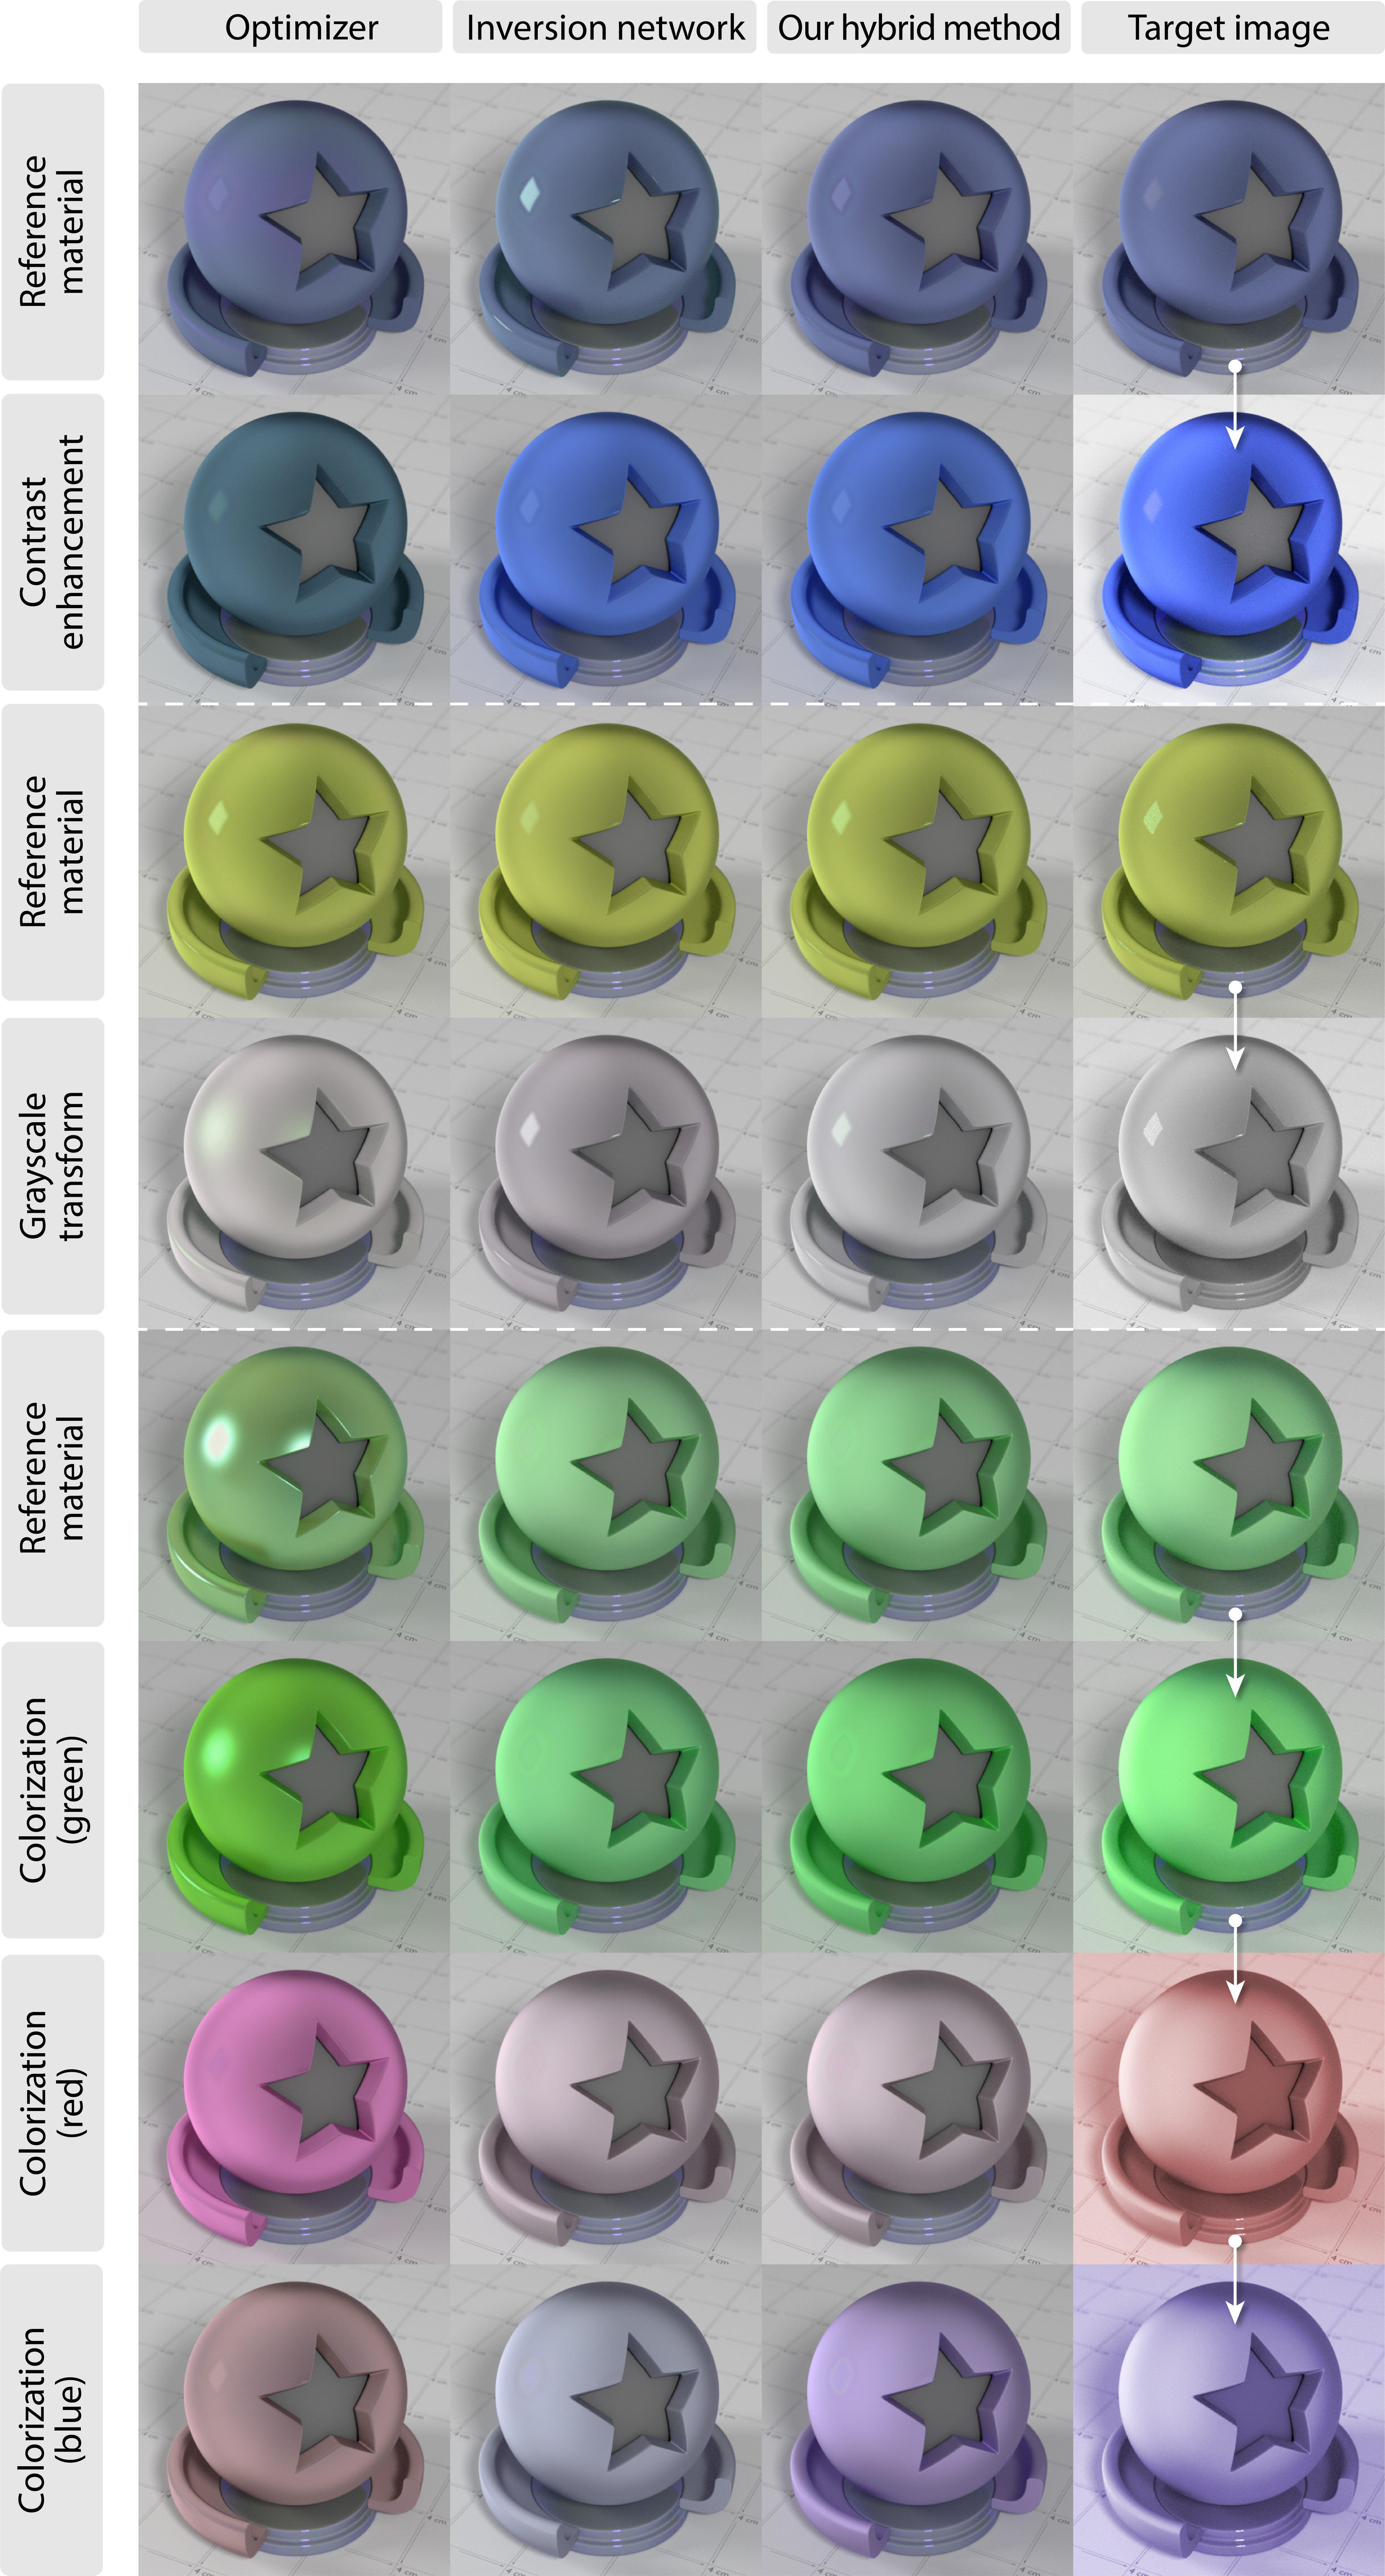
Figure 5 保留全部参考行、变换箭头、目标与三方法输出;它展示 saturation increase、grayscale 等全局颜色操作。不要把参考行的高拟合度和非物理编辑行的拟合度混为一个指标。
11 · 原 Table 2 与序列消融
此表直接比较是否加入前一帧结果,属于论文最清楚的组件消融。保留全部 13 个抽样帧列与 Σ;Σ 是这 13 个报告值的和,不是整段所有帧的总误差。
| F. evals | Technique | 0 | 10 | 20 | 30 | 40 | 50 | 60 | 70 | 80 | 90 | 100 | 110 | 120 | Σ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 100 | No reinitialization | 1.93 | 1.67 | 2.19 | 2.90 | 3.82 | 4.79 | 5.73 | 6.81 | 7.93 | 9.14 | 10.43 | 11.55 | 12.99 | 81.88 |
| 100 | Reinitialization | 1.93 | 1.34 | 1.88 | 2.54 | 3.34 | 4.30 | 5.30 | 6.38 | 7.50 | 8.69 | 9.93 | 11.55 | 12.99 | 77.67 |
| 300 | No reinitialization | 1.64 | 1.47 | 2.07 | 2.80 | 3.70 | 4.62 | 5.70 | 6.75 | 7.86 | 9.00 | 10.21 | 11.41 | 12.82 | 80.05 |
| 300 | Reinitialization | 1.64 | 1.30 | 1.80 | 2.42 | 3.25 | 4.25 | 5.25 | 6.33 | 7.45 | 8.64 | 9.88 | 11.41 | 12.82 | 76.44 |
| 600 | No reinitialization | 1.57 | 1.44 | 2.06 | 2.77 | 3.66 | 4.60 | 5.69 | 6.74 | 7.83 | 8.96 | 10.12 | 11.41 | 12.80 | 79.65 |
| 600 | Reinitialization | 1.57 | 1.29 | 1.80 | 2.49 | 3.33 | 4.20 | 5.18 | 6.27 | 7.38 | 8.58 | 9.81 | 11.41 | 12.80 | 76.11 |
对应 100/300/600 次评估,Σ 从 81.88/80.05/79.65 降到 77.67/76.44/76.11,降幅约 5.14%/4.51%/4.44%。100 次评估+重初始化的 77.67 甚至低于独立逐帧 600 次的 79.65,说明利用局部连续性可减少搜索预算。不过这是单一 black-level 轨迹的展示,不能外推为任意编辑序列的平均六倍提速。
帧 110、120 在同预算下完全一致,因为该阶段目标继续远离可行域,输出已经停在相同解附近。误差继续增加并不等于算法在图像序列中“发散”;也可能是目标本身越来越无法实现。论文的 no-worse 结论来自这些实验和候选池扩展,不是对任何有限精度优化过程的普遍数学证明。
12 · Appendix B 的全部优化器对照
保留 16 行、全部方法列及 Basin-hopping 跨两种初始化共用的单个结果。红色表示相对该行初始值没有改善或更差。Basin-hopping 每例获得 30 分钟和多种参数设置;它是较长预算的参考,不是等时竞争者,也不是已证明的全局真值。
| Input | Init. type | Init. RMSE | Nelder-Mead | L-BFGS-B | SLSQP | CG | Basin-hopping |
|---|---|---|---|---|---|---|---|
| Fig. 5, Row 1 | Rand | 41.93 | 5.62 | 20.47 | 17.96 | 5.24 | 2.01 |
| Fig. 5, Row 1 | NN | 5.94 | 2.37 | 5.84 | 5.94 | 5.94 | |
| Fig. 5, Row 2 | Rand | 78.45 | 40.21 | 78.45 | 78.45 | 78.45 | 32.67 |
| Fig. 5, Row 2 | NN | 32.72 | 32.67 | 32.72 | 32.72 | 32.72 | |
| Fig. 5, Row 4 | Rand | 35.37 | 16.98 | 28.84 | 35.37 | 34.99 | 14.72 |
| Fig. 5, Row 4 | NN | 18.68 | 14.68 | 15.33 | 18.18 | 15.90 | |
| Fig. 5, Row 7 | Rand | 41.65 | 26.24 | 41.65 | 41.65 | 41.65 | 22.38 |
| Fig. 5, Row 7 | NN | 22.42 | 22.38 | 22.42 | 22.42 | 22.42 | |
| Fig. 5, Row 8 | Rand | 29.04 | 22.93 | 29.04 | 26.71 | 28.21 | 15.69 |
| Fig. 5, Row 8 | NN | 19.82 | 15.37 | 19.82 | 28.87 | 19.82 | |
| Fig. 8, Row 2 | Rand | 23.78 | 8.26 | 23.78 | 23.78 | 21.75 | 7.63 |
| Fig. 8, Row 2 | NN | 12.79 | 7.80 | 12.79 | 12.79 | 12.79 | |
| Fig. 8, Row 3 | Rand | 21.60 | 6.19 | 21.60 | 21.60 | 20.83 | 5.86 |
| Fig. 8, Row 3 | NN | 9.09 | 5.80 | 9.09 | 9.09 | 9.09 | |
| Fig. 8, Row 8 | Rand | 29.58 | 6.63 | 29.58 | 29.58 | 29.58 | 5.07 |
| Fig. 8, Row 8 | NN | 9.74 | 5.36 | 9.61 | 9.61 | 9.68 |
Nelder–Mead 对随机初始化及 NN 初始化通常都有较大改善;L-BFGS-B、SLSQP、CG 在很多案例停在初值。这支持“本实验接口与默认设置下,Nelder–Mead 更合适”,但论文没有完整公开各方法的 Jacobian、有限差分步长与停止准则,不足以证明所有梯度优化都不适合此问题。硬障碍、参数尺度和代理数值精度都可能使有限差分困难。
与长预算 Basin-hopping 比,hybrid 在 3 个案例更低(14.68 vs 14.72、15.37 vs 15.69、5.80 vs 5.86),2 个持平(32.67、22.38),3 个更高(2.37 vs 2.01、7.80 vs 7.63、5.36 vs 5.07)。所以应描述为“多数案例接近、部分更好”,而不是全面打败全局优化。差距 0.04–0.32 也缺少随机重复误差条。
最重要的反例:初始分数最好,终点未必最好
主文承认 Fig.5 Row7 中,best-of-nine 起点优化后停在 22.38;单独使用网络 1 起点,300 次评估可达到 19.39。这直接暴露了候选筛选与下游优化目标的不一致:最小 initial error 并不保证最好的 optimization basin。它是设计 top-k refinement、预算分配或 learned basin predictor 的明确研究切入点。
13 · 局部编辑 场景迁移 与用户时间
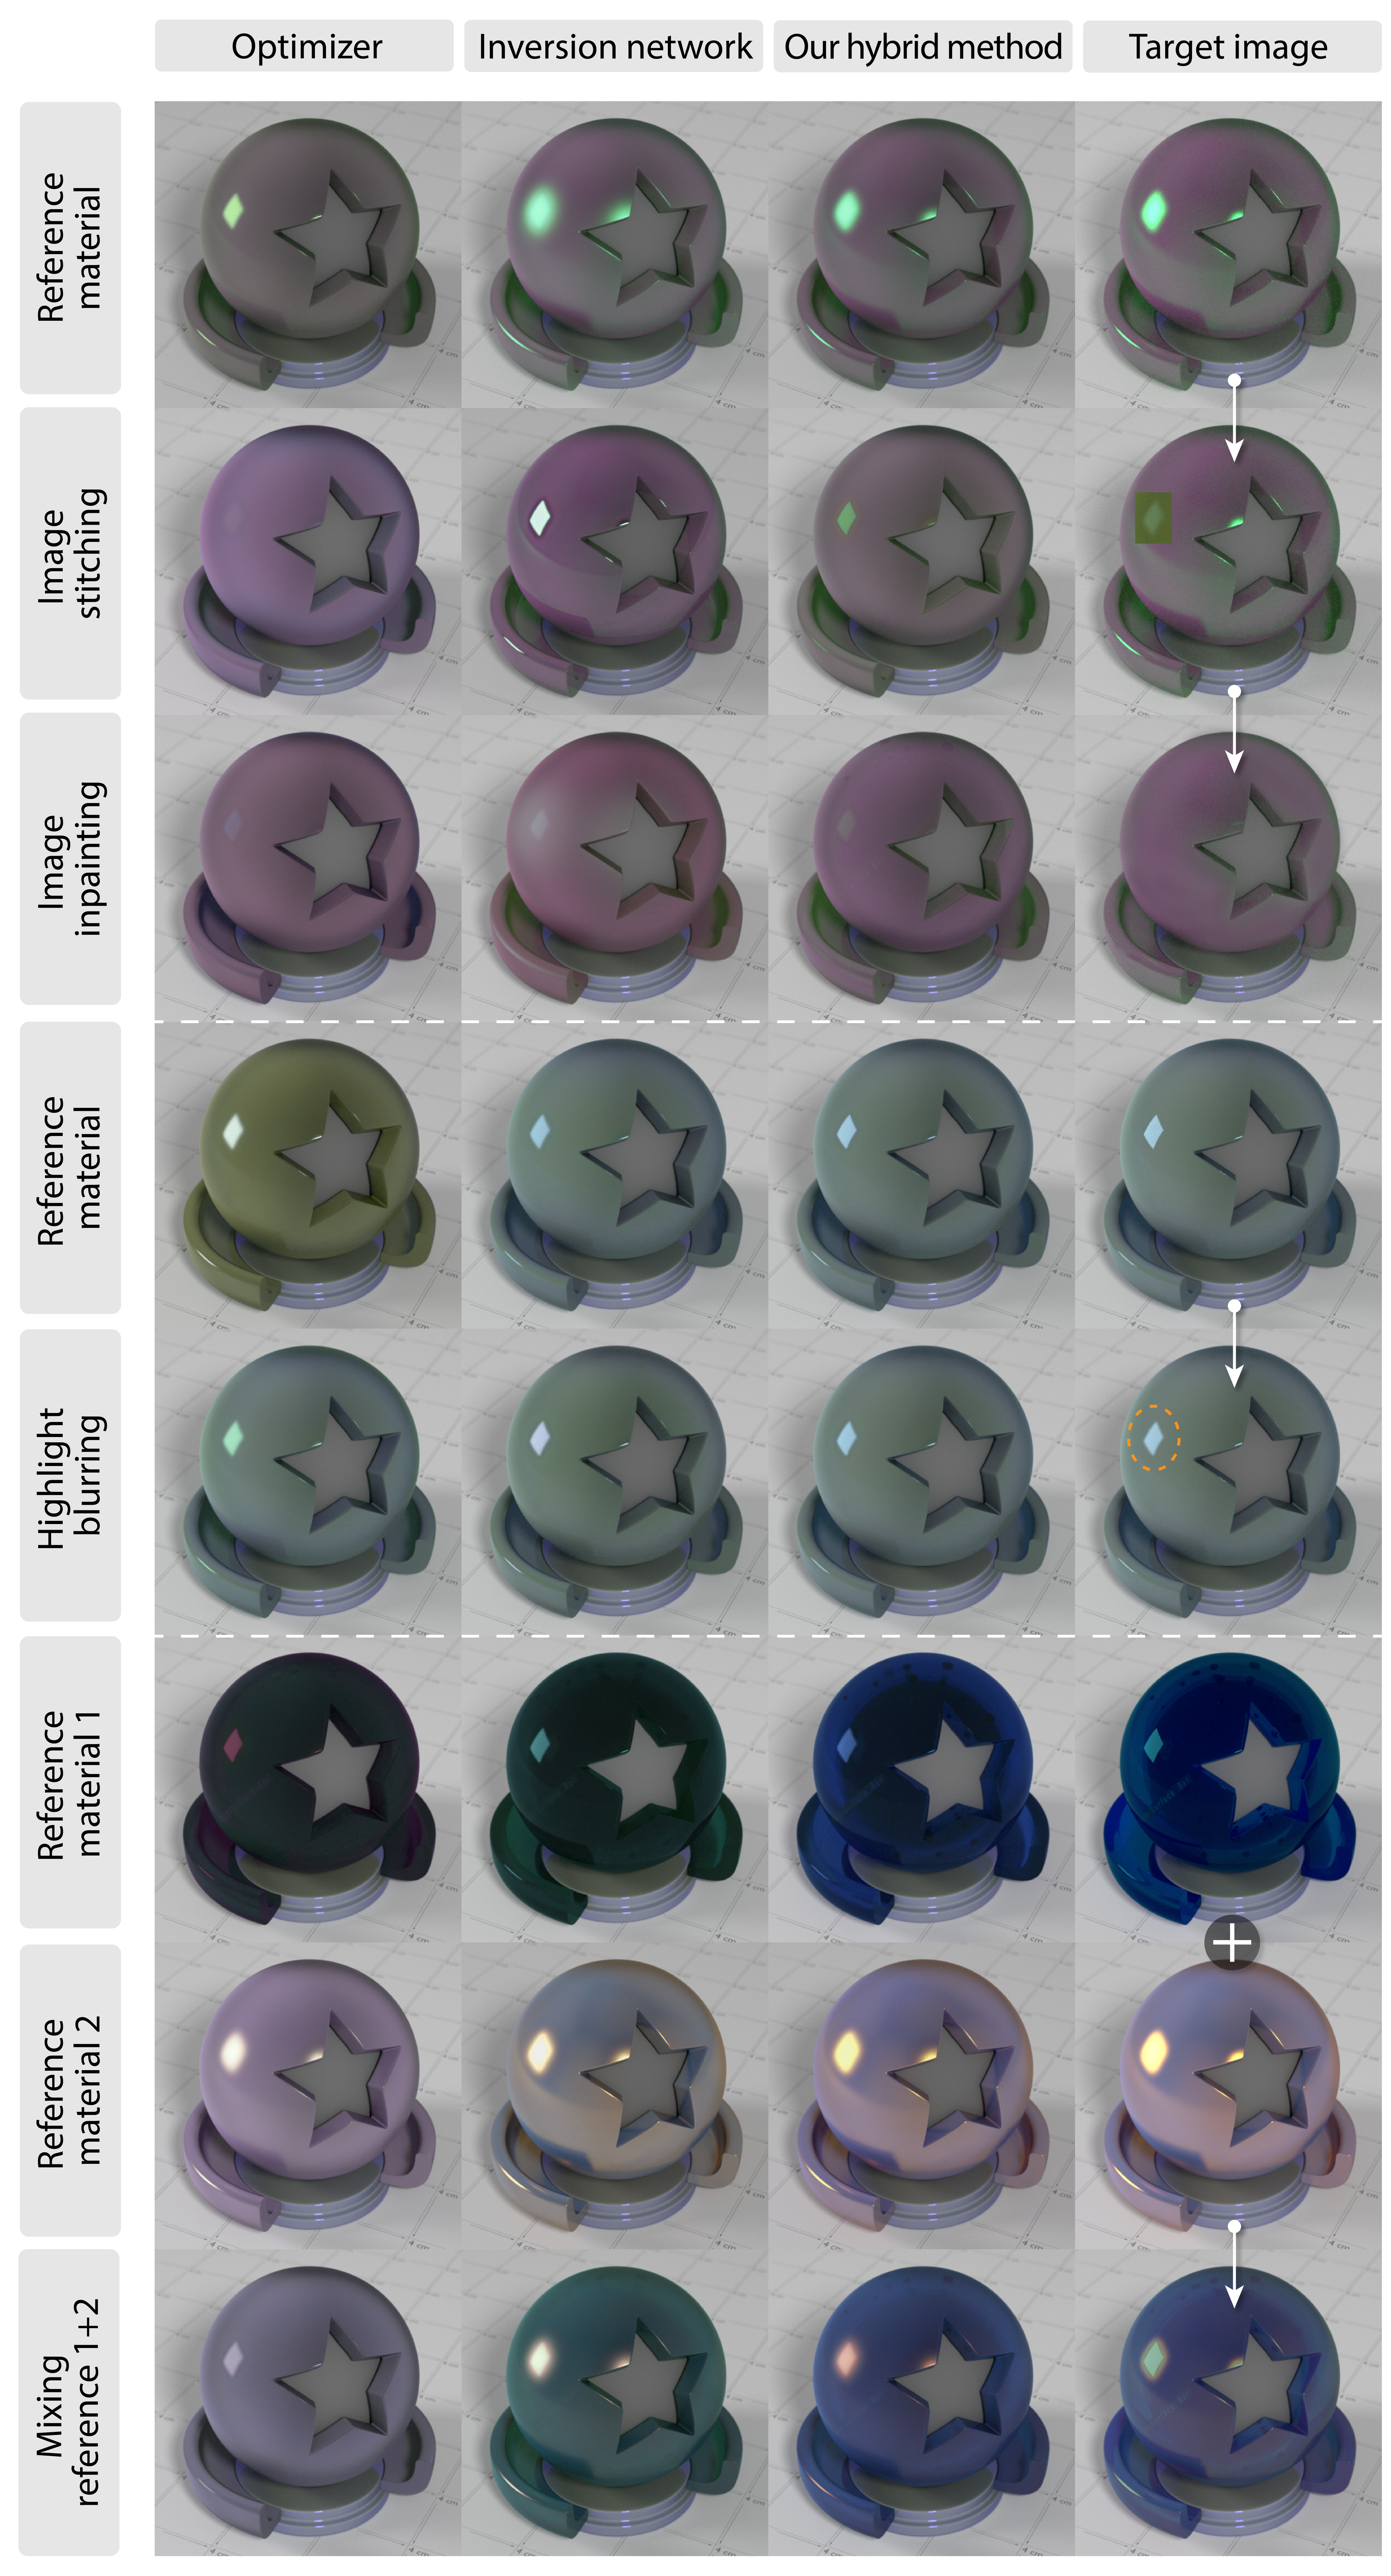
局部操作包括 inpainting、图像混合/拼接、局部颜色处理和高光模糊。Figure 8 的全部行列说明不同方法如何逼近这些人为目标。由于最终材质参数在整个对象上共同生效,“只编辑图片的一小块”不等于输出材质只在那一小块空间发生变化;视觉局部目标可能迫使全局参数折中。
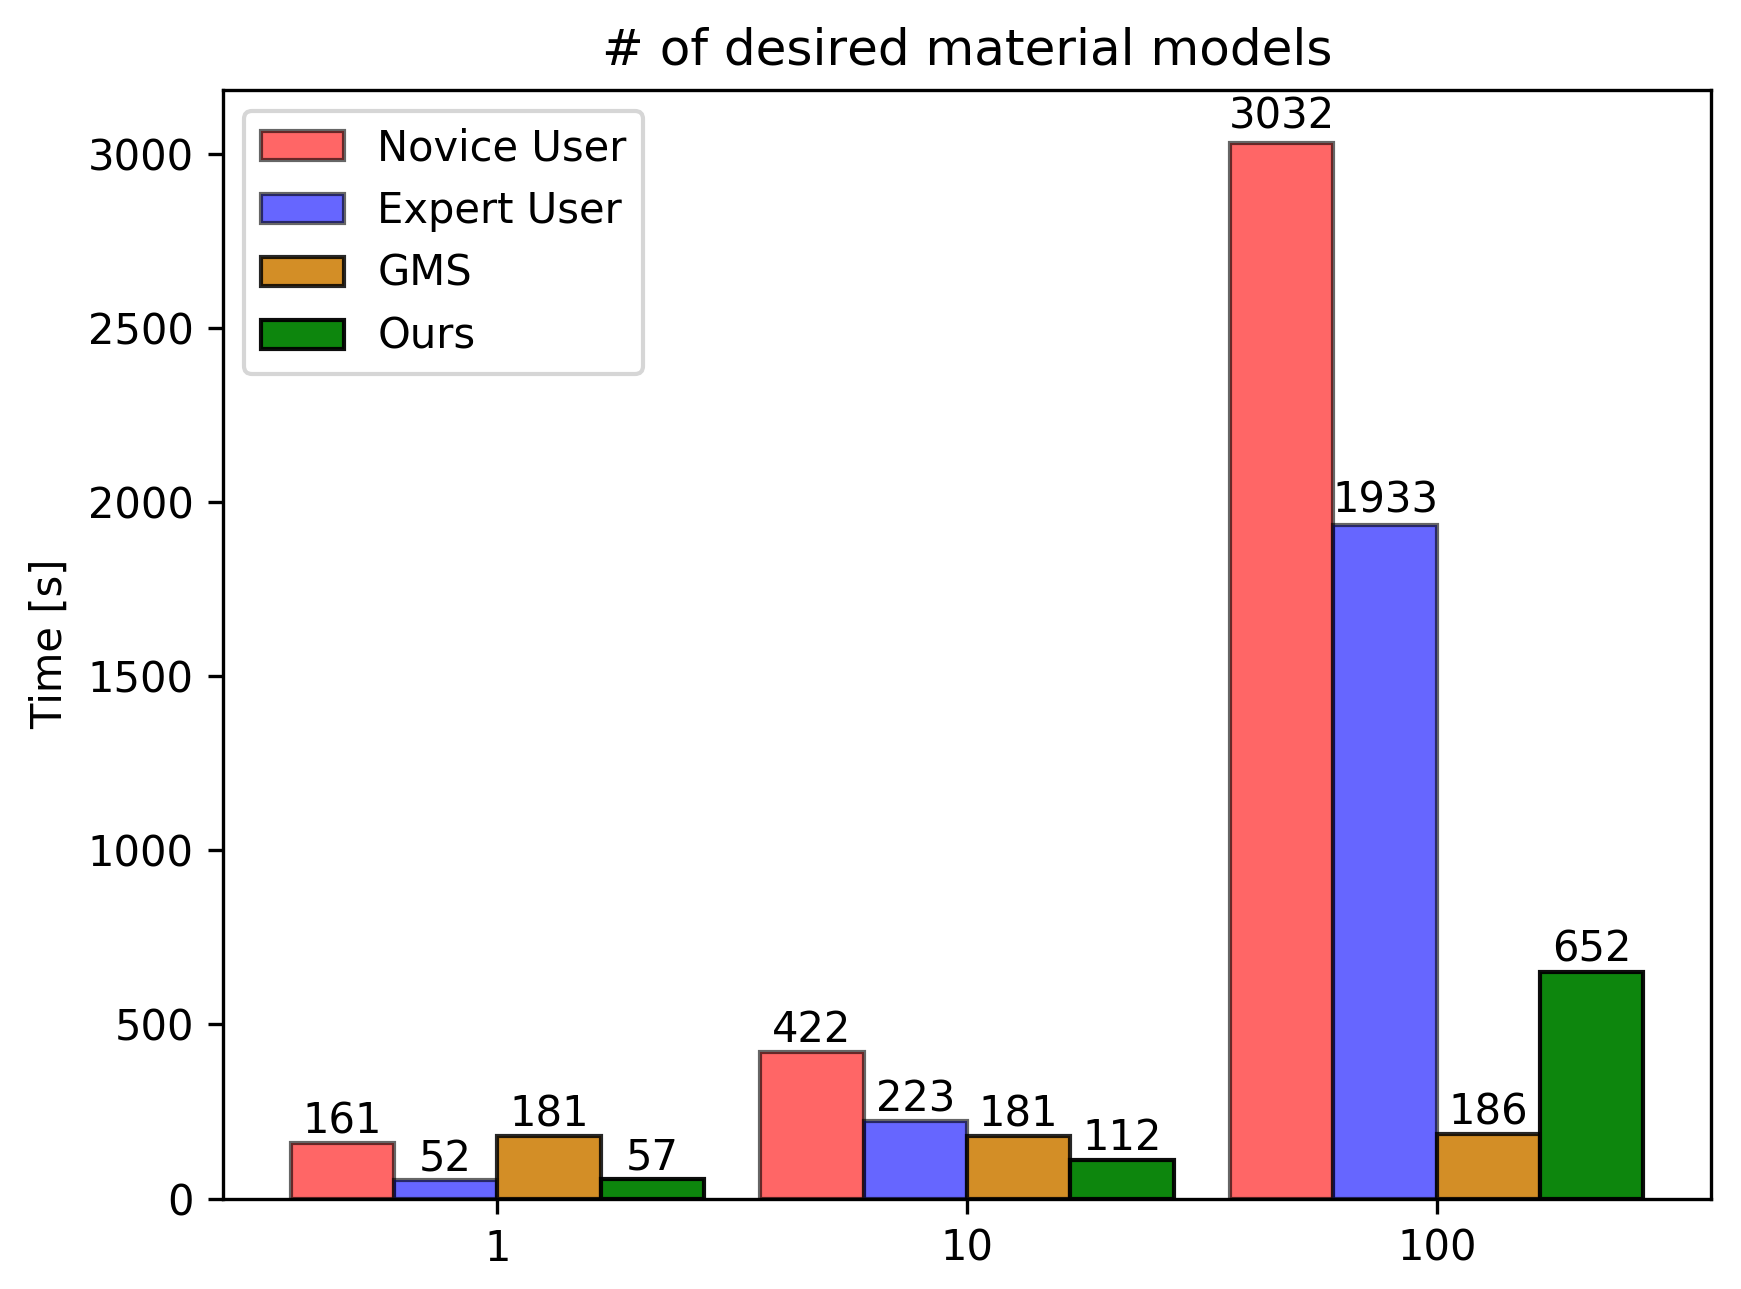
Figure 7 的用户时间包含选起始图、5.5 秒网络加载、图像编辑和计算;GMS 时间包含 gallery 打分、推荐计算和选择,novice/expert 数据引用自 GMS 前作。它不是新招募、统一任务、随机分组的完整用户研究。图中显示:1 个目标时 PME 接近专家效率且优于 GMS;10 个相似材质时使用 reinitialization 后更快;100 个相似材质时 GMS 扩展性更好。
原图完整保留。本次不根据柱高估算未列出的精确秒数,也不将不同任务设置的端到端时间与单次网络推理时间混用。编辑现有材质与从零批量发现材质本来就不是完全相同的使用情境,因此作者也建议二者互补。
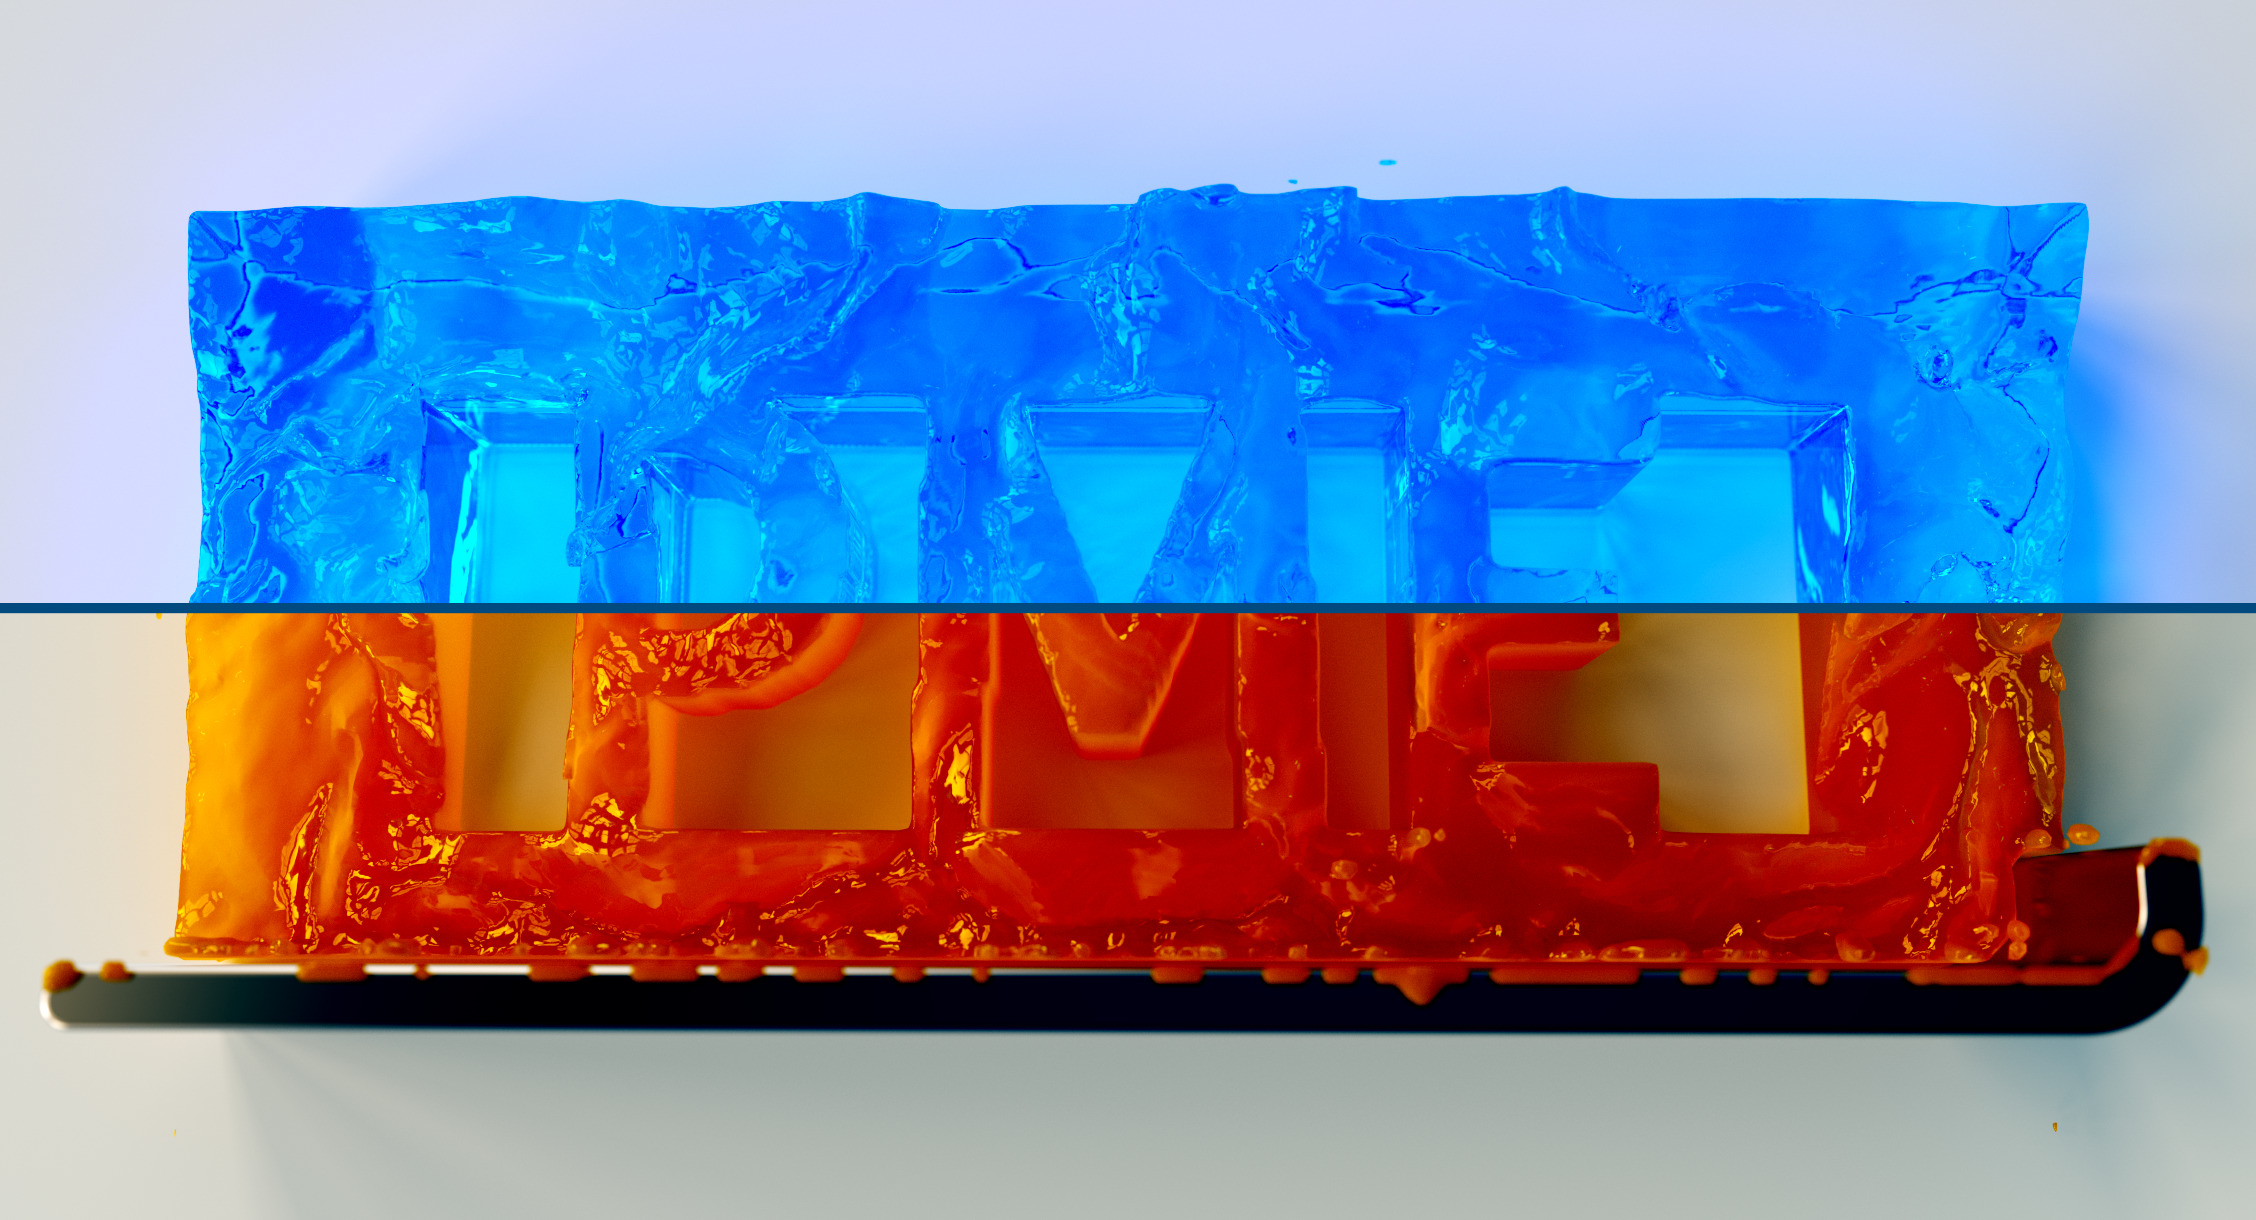
Figure 3 与 Figure 9 展示材质参数被放进新的 Blender/Cycles 场景,支持“输出是可复用材质而不是固定图片”。但目标场景中 geometry、lighting 变化后的观感会变化,这是物理材质的预期行为;不是承诺在任何场景都保持同一张编辑图。补充视频提供动态演示链接,本次没有通过浏览器播放或视觉核验该视频。
14 · 代码差异与复现风险
| 核查项 | 论文/预期 | 公开活动实现 | 影响 |
|---|---|---|---|
| 图像维度 | 410×410 | JSON 419×419;输出 526683 | 预处理、weights shape 和 RMSE 样本数不同 |
| 参数维度 | m=19 | 20 个存储槽,槽 3、19 固定 | 不能直接套用 19 维 simplex 或删除某一维 |
| 九个网络结构 | Appendix A 简写 | 深模型 10 conv;浅模型一次 8×8 pooling | 需使用已发布 JSON,而非猜测重复 block 含义 |
| 前向模型 | 继承 GMS 四组 Conv1D/ELU | JSON 三组/ReLU | 数据与发布版本不能自动等同 |
| 优化预算 | 主表最后一档 1500 evals | 脚本活动两次 minimize 均 maxfev=1000 | 重跑默认脚本不是重跑原表 |
| 序列 reuse | best-of-nine 加 previous optimum | 函数存在,但活动调用整段被注释 | 默认不会得到 Table 2 的 reinitialization |
| 约束与评分 | 可行域与候选质量共同考虑 | 先按未裁剪候选渲染评分,选完后才 clip | 越界候选的排名可能不代表裁剪后排名 |
| 障碍成本 | 不合法输入应高惩罚 | 先 decode 再检查 bounds;目标函数还原地改两槽 | 浪费越界评估,需注意 optimizer 传入数组的别名副作用 |
| 目标图像 | 固定 tone-mapped RGB | 减 mean/除255后先保存 PNG,再读回作为 RMSE reference | 应核查旧 imsave 的 float 缩放和量化规则,不能静默换库 |
| 依赖与路径 | 提供可运行源码与模型 | 旧 Keras/SciPy imread、imsave,训练脚本含绝对路径 | 迁移需做数值回归测试;不是开箱即用的现代环境 |
主脚本同时跑随机初始化对照和 hybrid,保存目标、初猜、两种优化结果、RMSE 表以及参数文件。打印的 elapsed_time 在第二次随机优化前截取,表示第一段优化耗时;不能拿它当整个脚本的总时间。训练脚本里引入 SGD、Nadam 等库不表示这些 optimizer 被使用,活动配置应从 compile 与实际分支判断。
代码-only archive 的 license.txt 与官网写 MIT,完整包 README 却称 BSD;本次仅报告许可证文本不一致,不替作者判定更改许可。模型文件、third-party 场景和图片的复用条件还须各自检查,尤其不要把原图中的外部场景资产认作论文作者原创资产。
逐行读取的 optimize_constraints.py · 官方完整包配置、README、license 与 Blender 场景 · 官方发布说明与第三方资产鸣谢
15 · Reviewer 评价与证据边界
优点
问题设定贴近艺术工作流。输出为可迁移 shader 参数,保留物理渲染管线;用户可以表达无法直接转成参数的视觉意图。候选验证机制简单有效。目标图可见、神经 renderer 便宜,使多个不可靠预测可以经验证后组合使用。实验呈现了阶段贡献。随机起点、NN-only、hybrid 和 sequence reuse 都有明确比较,附录还保留其他优化器。
主要弱点
- 固定场景限定强:不能直接编辑任意照片或在生产场景内部优化,变更几何/光照需重建代理
- 代理可信度没有闭环保证:比较和优化都用同一神经 renderer,缺少系统性真实 renderer 验证及误差校正
- 局部目标被全局 RMSE 稀释:小高光区域的修改仅影响少数像素,优化可能优先拟合未改区域;weighted mask 仅是建议
- 不可识别与多解:单个固定照明视角中相似的参数,在新光照下可能不同;没有多视角或多光照一致性约束
- 评测规模和统计不足:表中选择困难案例,缺少完整随机编辑分布、重复 seed、感知研究和 confidence intervals
- 发布配置与论文不完全对应:分辨率、维度、网络结构、评估次数和动画开关都需复核
结论应如何使用:这是一套有效的“逆网络 proposal+可执行参数搜索”系统范式;论文证明了所展示固定场景及编辑操作的实用性。它没有证明任意图像都能被物理 shader 精确拟合,也没有证明任意材质图都可被生成。普通 topic 中的 diffusion models 与本文机制不符,应列为归档分类复核。
16 · 对程序材质生成的可执行研究延伸
Research Extension 以下是基于本文的研究建议,均不属于原论文已验证结果。优先沿着论文明确暴露的瓶颈设计实验,而不是简单把 optimizer 换成 agent。
A · 从最佳起点选择转向有限预算的候选优化
针对 22.38→19.39 反例,对 top-k 候选各分配少量真实优化步,再用中间收益决定后续预算。对比 best-initial、均匀多起点、successive halving 与 learned basin selection,在相同总 renderer calls 下报告最终 RMSE 和多光照误差。要保存每个候选的初始与最终误差,才能检验“初始分数是否预测终点质量”。
\[(i^{\ast},x^{\ast})=\arg\min_i
d\!\left(R\bigl(\mathrm{Refine}(x_i,B_i)\bigr),\tilde t\right),
\qquad \sum_i B_i\le B_{\mathrm{total}}.\]
这里 \(B_i\) 是分配给候选的预算。若增加候选数量同时增加总调用数,则无法区分算法更好和单纯计算更多。
B · 代理与真实渲染器双层验证
代理筛选大批候选,周期性对最有希望或最不确定的候选调用 Cycles/DiffMat/目标引擎,测量 proxy gap,更新局部误差模型或缩小可信搜索区域。程序图生成时,先检查 graph syntax、node types、端口兼容与执行成功,再比较渲染图。这样 renderer feedback 不只是最后展示,而能纠正代理被搜索利用的问题。
\[L(G,\eta)=\sum_{v,\ell}D\bigl(R(G,\eta;v,\ell),I^{\ast}_{v,\ell}\bigr)
+\lambda_c\,\mathrm{Complexity}(G)+\lambda_e\,\mathrm{EditCost}(G,G_0),
\quad G\in\mathcal G_{\mathrm{valid}}.\]
离散图 \(G\) 和连续参数 \(\eta\) 要分层处理:本文只覆盖固定 \(G\) 的参数搜索;拓扑改写还需要 proposal、编译验证与回滚。衡量时同时报告可执行率、图复杂度、参数可编辑性和真实渲染误差。
C · 以编辑意图分区,而非全图均匀 RMSE
用户画出的编辑 mask 可以区分“需要改变”和“应当保持”。优化目标同时加入编辑区域目标误差和非编辑区域保持误差,再增加颜色/高光/透射等可解释分量。用多视图和多光照区分参数多解,避免只把单张高光涂抹拟合好。原论文提到 weighted mask,但没有做相应受控实验,因此这是可明确验证的扩展。
\[L_{\mathrm{edit}}=
\lambda_{\mathrm{in}}\lVert M\odot(R(x)-\tilde t)\rVert_2^2+
\lambda_{\mathrm{out}}\lVert(1-M)\odot(R(x)-t)\rVert_2^2.\]
D · 稳定的连续编辑与最小改动
缓存前一帧只是 initialization,不能保证参数连续。可以加入按参数灵敏度归一化的 temporal regularizer,以及 topology edit penalty。对于突然改变的目标,允许重新选择候选而非一味贴近历史参数。评测应包含小步连续编辑、大跳变、往返编辑与跨光照播放,记录迟滞、flicker 和恢复时间。
E · 用不完美用户编辑建立鲁棒性 benchmark
系统性构造颜色外溢、背景误改、高光错位、局部 blur 与互相矛盾的 edits,明确哪些是 shader 可实现、哪些不可实现。对每种失真评估感知接近度、物理可执行性和保持性,避免“能够忽略糟糕编辑”与“没有听从有效局部指令”混为一谈。agent 若使用,应记录动作、执行返回、重试原因与预算,不将不可达目标误报为已完成。
17 · 来源与归档候选
- TU Wien 发布的正式 14 页 PDF:本次所有页码与表值以用户原始同论文出版 PDF 为基准;Appendix A–B 位于 PDF p.11–12
- Wiley DOI 页面:通讯作者 Károly Zsolnai-Fehér、出版身份与补充视频;shell 访问 403,web 工具能读取作者元数据
- 作者官方项目页:paper、code-only、full archive、版本说明、版权与鸣谢
- PME-source-only.zip:主优化脚本和 license,已完整读取
- PME-source-and-NNs.zip(8.36 GB):读取目录、源码、九个 encoder JSON、renderer JSON、README 和材质加载器;没有运行模型
- Gaussian Material Synthesis 原始文献:仅用于核实本文明确继承的 shader/数据/前向 renderer 设置
- 2019 预印本版本与TU Wien 正式出版元数据
- 补充演示视频:已定位,未播放或视觉验收
归档说明:保留全部用户原始文字、BibTeX 和两个 PDF++ selection anchors,只在末尾追加精读候选。建议将通讯作者改为已核实的 Károly Zsolnai-Fehér,并复用已有作者记录;补充 project_page 与相关 arXiv,复核不适用的 diffusion topic。保留 inverse graphics optimization/test-time optimization,可建议补充 neural rendering 和 convolutional neural network,但不自动改写原分类或索引。
交付为单文件中文 HTML 与详细 Markdown。静态 QA 校验三张原表、九幅完整原图、数学源码、锚点、图片可解码、原笔记前缀和文件大小;浏览器/MathJax 实际排版按要求暂缓。本次未执行优化、训练、Blender 脚本或库内归档。