01 · 论文身份与核心结论
pixelNeRF 的关键变化是把 NeRF 从“每个场景单独拟合的函数”变成可由少量图像条件化、跨场景共享参数的辐射场。查询一个三维点时,模型将它投影回输入图像,读取与该像素对齐的局部特征,再预测颜色与密度。这样,已观察区域可保留细节,未观察区域可借用训练数据学到的形状先验。
2012.02190.pdf,但实际PDF首页标记 arXiv:2012.02190v3,2021-05-30。本页基于这份20页合订PDF,附录从第10页开始,不能称为“20页额外补充”。官方项目页与CVF proceedings核实发表为CVPR 2021。| 字段 | 核实信息 |
|---|---|
| 标题 | pixelNeRF: Neural Radiance Fields from One or Few Images |
| 作者 | Alex Yu;Vickie Ye;Matthew Tancik;Angjoo Kanazawa,顺序依PDF |
| 机构与角色 | 全部作者列UC Berkeley;Alex Yu为第一作者。未见明确通讯作者标记,Angjoo Kanazawa保留为末位作者候选,unverified |
| 年份/venue | 首次预印本2020-12-03;当前固定版本和正式发表为2021,CVPR。原笔记“arXiv preprint”有可补全信息 |
| 输入 | 一张或少量RGB图像,相机内参与相对位姿,以及希望渲染的新相机视角 |
| 输出 | 可查询的颜色/密度场及体渲染图像;代码也可输出期望深度。不是网格、材质图、PBR分解或程序化资产 |
| 代码审查版本 | 官方提交91a044b,2022-06-10;与2021论文设置分别标明 |
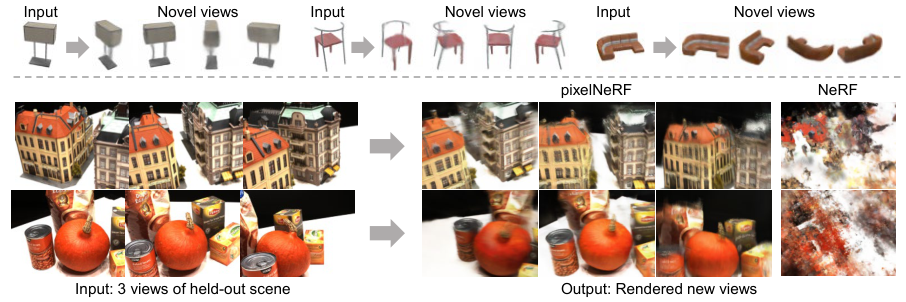
阅读时保留两个边界:“无需test-time optimization”不等于瞬间完成高分辨率渲染;“不需要3D监督”不等于不需要已知相机。实验中,pixelNeRF在极稀疏视角下优势明显,但DTU达到9个输入视角时,逐场景优化的NeRF反而在三项均值指标上更好。
全文将论文事实、作者解释、实现核查和研究延伸分开;原表全部数值保留,相关的协议和标签问题也不会被静默“修正”。
02 · 动机:用跨场景先验填补稀疏观察
普通NeRF把一个场景的几何和外观编码进MLP参数。大量带位姿图像能通过多视图一致性约束这个函数,但一张图片可能对应许多不同三维结构;少量图片也不足以约束背面、遮挡区和复杂反射。逐场景优化既慢,又不能自动使用在其他场景学到的知识。
学习式重建可以跨对象共享先验,但把整张图压成一个global latent容易丢掉细纹理和薄结构;要求所有对象对齐到canonical space,又使模型依赖类别朝向,难处理未知类别和多对象场景。pixelNeRF把两件事结合起来:像素对齐的局部条件保留观察证据,共享的场景先验补足没有看到的部分,并在输入相机的view space中表达查询。
原Table1 · 方法属性比较(转置为方法行)
| 方法 | 学习场景先验 | 监督 | 图像特征 | 支持多视图 | View space |
|---|---|---|---|---|---|
| NeRF | ✗ | 2D | ✗ | ✓ | - |
| DISN | ✓ | 3D | Local | ✓ | ✗ |
| ONet | ✓ | 3D | Global | ✗ | ✗ |
| DVR | ✓ | 2D | Global | ✗ | ✗ |
| SRN | ✓ | 2D | ✗ | ✓ | ✗ |
| Ours | ✓ | 2D | Local | ✓ | ✓ |
Table 1的比较针对论文所讨论的具体版本。“NeRF允许多视图”指以多张图像优化一个场景,不等于能像pixelNeRF那样前馈整合任意数量输入。DVR/ONet等global特征方法更容易丢掉输入局部信息;DISN也使用local特征,但需要3D监督。pixelNeRF的贡献主要是把局部图像条件、view-space查询和NeRF体渲染组合成跨场景学习框架。
§1 · §2与Table 1
03 · 数学基础:辐射场、遮挡与图像监督
一个查询点为 \(\mathbf{x}\in\mathbb{R}^{3}\),目标观看方向为单位向量 \(\mathbf{d}\in\mathbb{R}^{3}\)。辐射场输出体密度 \(\sigma\) 和RGB辐射颜色 \(\mathbf{c}\):
密度描述沿光线的终止/遮挡强度,并非直接给出表面网格或真实材料密度。颜色可随观察方向变化,但这里没有把外观分解成albedo、roughness、法线、BRDF和环境照明。因此模型可以重放训练分布中的外观,却不天然支持物理正确的重新打光。
目标相机产生射线 \(\mathbf r(t)=\mathbf o+t\mathbf d\),起点为相机中心 \(\mathbf o\),采样区间为 \([t_n,t_f]\)。原论文Eq.1的体渲染为:
\(T(t)\) 是射线到达深度 \(t\) 前仍未被遮挡的透射率。靠前的高密度区域会降低后方样本的贡献,这是比直接二维贴图更能组织遮挡关系的原因。实际实现用有限样本离散近似:
该式是标准体渲染离散化解释。ShapeNet用白色背景,DTU用黑色。代码的最后一个间隔是远平面到最后采样点的距离,并未无条件设置为无限大;采样上下界会直接影响残余背景权重。
原Eq.2的训练信号是目标图像像素与渲染像素的平方误差:
\(\mathcal R(P)\) 为目标姿态 \(P\) 对应的相机射线集合。跨场景训练时,输入图像encoder与共享MLP一起学习;模型不需要每个训练对象的mesh或真值深度。损失不显式要求物体边界、拓扑或几何准确,因此好看的新视图并不等价于经过几何指标验证的高质量表面重建。
04 · 单图模型:投影对齐比全局压缩保留更多证据
输入图像记为 \(I\),卷积encoder产生二维特征体 \(W=E(I)\)。对目标射线上的每个三维点,先把点变换到源相机坐标,使用已知内参投影到图像位置,再以双线性插值读取对应局部特征 \(W(\pi(\mathbf x))\)。原Eq.3为:
\(\pi\) 是针孔相机投影,\(\gamma\) 是位置编码。投影到同一个源像素的不同深度点会读到相同二维特征,但其三维坐标不同,MLP仍可预测不同密度。因此这不是简单把图片贴到一个平面,也没有先构建全分辨率3D特征体。

特征金字塔
ImageNet预训练ResNet34保留早期高分辨率特征和后期大感受野特征。标准输入时提取四级:64×H/2×W/2、64×H/4×W/4、128×H/8×W/8、256×H/16×W/16。后三级双线性上采样到H/2×W/2后拼接,得到512×H/2×W/2的局部特征。对于64×64的NMR图像,跳过第一次maxpool,空间比例改为1/2、1/2、1/4、1/8,避免把小图压得过粗。
位置编码与方向的不同角色
六级频率给每个空间维度12个周期特征,加原始xyz共39维;方向不做位置编码,再加3维形成42维输入。论文设置单类别、跨类别与DTU的 \(\omega=1.5\),双对象实验 \(\omega=2.0\)。不同场景单位和采样界限会改变频率的实际物理尺度,因此不是天然尺度不变。
观看方向从网络开始就输入,既能表达视角相关颜色,也告诉网络当前查询方向和源相机观察方向相差多远:接近源视角时更可依赖输入细节,差得远时更依赖先验。这是作者的解释,方向消融支持其有益,但没有直接可视化证据证明网络实现了某种固定的“证据/先验门控”。
残差注入
与把所有东西只拼接一次相比,pixelNeRF用独立线性层把512维图像特征注入前几个全连接ResNet块。简化地写:
\(A_k\) 对每个块独立学习,将图像特征对齐到隐藏空间。默认是加法调制,不要仅因论文类比AdaIN/SPADE就把它描述成实际做了归一化或乘性缩放。公开默认配置关闭use_spade。
05 · 多视角融合:先在各相机坐标中推理,再平均
给定 \(n\) 张输入图像及相对位姿,选择任意世界坐标系作记号。第 \(i\) 个世界到相机变换为 \((R_i,\mathbf t_i)\),查询点和方向分别变换为:
方向只旋转,不加平移。每个视角都有自己的图像特征和局部坐标,但前半网络 \(f_1\) 共享权重。到第三个ResNet块之后,跨源视角平均隐藏特征,再交给后两个块 \(f_2\):
这对应论文Eq.4–6。平均池化使理论结构对输入顺序不敏感,也不把视角数量写死;单图时平均退化为恒等映射。融合的是已经结合坐标与图像证据的隐藏特征,不是直接平均RGB,也不是先分别预测多个NeRF再融合它们的输出。

总MLP为5个ResNet块、隐藏宽度512;前3块逐视角处理,后2块在融合后处理。粗、细两个MLP结构相同、参数不同,共用一套image encoder。网络输出RGB经sigmoid、密度经ReLU。方向较早进入共同干路,因此公开实现并未通过架构硬约束密度一定与方向无关;这对“物理一致的单一几何场”解释是一个需要留意的边界。
多视图融合还没有解决的事情
简单平均没有显式可见性权重:被遮挡的源像素可能对应前景而不是查询点本身;出视锥的点也可能读到边界特征。当前源码使用grid_sample双线性索引、border padding,视锥剔除代码被关闭。模型只能依靠学习的特征与坐标来降低错误证据影响,不能将它描述成已经做了光线遮挡一致性的多视图匹配。
实现核查的坐标细节:论文公式使用完整的 \(R_i\mathbf x+\mathbf t_i\)。公开代码的投影确实使用完整相机坐标;但默认normalize_z=True时,送进位置编码的是仅旋转后的xyz_rot,而非加平移后的xyz,相当于保留了世界原点相关的中心化约定。不能在复现时无视此开关,也不能把理论的坐标选择独立性直接当成当前默认路径在任意重定原点下的已验证不变性。
06 · 训练和渲染配置:数字、阶段与成本
每步采样4个对象/场景,每个对象128条射线,学习率统一 \(10^{-4}\)。当前训练器使用Adam优化整个模型,默认不冻结encoder;coarse与fine的RGB MSE等权相加,alpha regularization默认系数为0。论文没有报告完整optimizer betas、weight decay或mixed precision设置,不能把通用库默认值写成论文已明确披露。
分层采样
每条射线先取64个分层均匀点给coarse网络;根据coarse体渲染权重再取16个importance点,并在coarse期望深度附近,以标准差0.01的高斯分布取16个点,促进表面附近更密集采样。fine网络在全部64+16+16=96个点上重新查询。公开配置写n_fine=32,这里指32个新增点,不是fine网络总共只查32点;coarse与fine合计160次点查询/射线。
公开实现将深度样本截断在near/far范围,importance采样时detach粗权重;它使用未再除以总不透明度的期望深度。少量射线训练节省内存,但完整输出图仍需要大量查询。输入图像特征可以缓存,渲染时间仍随输入视图数近似线性增长。
训练与架构复现配置
| 项目 | 论文配置 | 实现/解释 |
|---|---|---|
| 全部实验 | lr=1e-4;4 instances/batch;128 rays/instance | 当前代码Adam;coarse/fine MSE各权重1;总512条训练射线/step |
| 单类别cars/chairs | 400k iterations;约6天,单Titan RTX | 前300k用tight bbox和2输入视图;后100k全图ray、随机1/2视图 |
| 13类别ShapeNet | 800k iterations;约6天,RTX2080Ti | 前400k bbox采样;64×64;跳过encoder首个maxpool |
| 未知类别泛化 | 680k iterations;约5天,GTX1080Ti | 只训练plane/car/chair;前400k bbox采样 |
| 双对象 | 训练2个随机源view;总steps/耗时未完整报告 | SRN baseline训练1M,并对各视图数反演150k;不可写成本方法训练步数 |
| DTU | 88训练scene;每步3随机view;具体总steps/耗时未在所查附录完整报告 | 同一scene共享color jitter;曝光3;400×300;当前配置每epoch重复32次 |
| Encoder | ImageNet-pretrained ResNet34;四级特征共512维 | 公开默认联合训练;只有显式freeze_enc才detach特征 |
| MLP | 粗、细各5残差块,宽512,第三块后平均 | 两个MLP不共享权重;encoder共享;方向不做位置编码 |
| 采样 | 64粗点;新增16重要性点+16深度邻域点 | fine实际查询96点;Gaussian SD=0.01;白/黑背景依数据集 |
| 未完整公开项 | optimizer细节、精度、显存峰值、checkpoint选择细则、所有运行seed | 本次不以通用默认值补成论文实测记录 |
采样边界与尺度约定
| 数据集 | near | far | 位置编码频率因子 | 背景 |
|---|---|---|---|---|
| ShapeNet chairs | 1.25 | 2.75 | 1.5 | 白 |
| ShapeNet cars | 0.8 | 1.8 | 1.5 | 白 |
| NMR 13类/未知类别 | 1.2 | 4.0 | 1.5 | 白 |
| 双对象 | 4.0 | 9.0 | 2.0(论文);当前multi_obj配置继承1.5 | 白 |
| DTU | 0.1 | 5.0 | 1.5 | 黑 |
论文强调不用额外object masks监督,但训练前期利用对象tight bounding box提高射线利用率。公开数据adapter从已有mask或白色背景中得到边界框;这些框控制采样,并不进入最终3D监督损失。因此准确表述是“无显式3D/分割损失要求”,同时保留实际实现使用前景框的加速事实。真实车辆迁移另明确需要PointRend去背景。
当前CLI的bbox停止默认值为100k,不自动等于各实验的300k或400k;nviews默认1,多视角训练必须显式传参。--epochs和训练日志计数也需要核对,论文给的是iterations,不能把数字直接当epochs填入。当前gamma默认1.0,所以默认无学习率衰减。
07 · 数据、Baseline和评估协议
实验数据地图
| 实验 | 数据/划分 | 渲染/分辨率 | 输入和评价协议 |
|---|---|---|---|
| 单类别ShapeNet | 6,591 chairs;3,514 cars,既有对象split | 128×128;训练每对象50随机view;测试251螺旋view | 主文随机1/2输入;附录明确前300k先2图 |
| 13类别ShapeNet | Kato/NMR renderings与DVR split | 64×64;每对象24个固定仰角view | 随机1图输入,剩23图评价;所有方法共用输入选择 |
| 未知类别 | 训练plane/car/chair;测试其余10类 | 仍用NMR 64×64、24view | 每未见类随机25%测试,剩余验证;不是测试全部对象 |
| 双椅场景 | 2,715 train资产;1,101 test资产 | 128×128;20训练view/50测试view | 随机摆放旋转,训练给2图,测试1/2/3图 |
| DTU | 自定义88 train/15 test,避免相似scene跨split | 400×300;exposure3;世界坐标缩放1/300 | 训练3随机view,测试1/3/6/9固定view |
| Stanford Cars | 真实照片,合成cars模型直接迁移 | PointRend去背景、居中、尺度归一化到128×128 | 仅定性,没有独立定量表 |
每种设置对应不同数据分辨率、视图数、训练时长和baseline适配,不能把它们混成一个统一“ShapeNet准确率”。主结果使用PSNR↑、SSIM↑和LPIPS↓;单类别Table2为对齐既有工作只报告PSNR/SSIM,而消融另报告LPIPS。
| 方法 | 本文使用方式 | 比较时应保留的成本或限制 |
|---|---|---|
| SRN | 共享scene prior、canonical object space;测试时latent inversion | 非纯前馈;chairs反演170k步,更新cars反演100k步;类别无关训练1M+反演260k,总约14天Titan RTX |
| DVR | 2D多视图监督版本,使用公开预训练权重/renderer | global latent;未知类别重训时关闭visual-hull depth采样,因部分数据不提供该信息 |
| SoftRas | 公开ShapeNet模型,加入类别无关的定性比较 | 公开代码不支持颜色推断,因此展示灰度;未放进Table4的彩色数值比较 |
| GRF / TCO / dGQN / ENR | 单类别表引用相应论文或SRN中报告的结果 | 并非全部在同一代码栈重跑;ENR仅单图,缺失项保持“—” |
| 原始NeRF | DTU每个场景/每个输入视图数单独优化,合计60个 | 各400k步,ray batch128,约14小时Titan RTX;5个6/9视图不收敛例改由更少视图权重初始化后续训约200k步 |
指标到底如何聚合
论文使用scikit-image的PSNR/SSIM,LPIPS采用VGG版本,把RGB归一化到[-1,1]。当前官方说明最终论文指标从保存到磁盘、量化后的图像重算,和渲染过程直接输出的浮点指标可能略有不同。代码先按对象平均目标视图,再对对象平均;类别总均值不是简单对13个类别均值再平均。
例如Table4的pixelNeRF PSNR:13类别数值直接平均约27.07,而表中mean是26.80。官方README提供的8,762个对象的类别计数,用它们对舍入后的数值加权可得到约26.8001,说明该差异来自聚合权重,不是表格错误。本文保留原表mean,不自行改成宏平均。
评估复现细节:源码calc_metrics只处理已有渲染输出,缺图可能悄然缩小统计集合;需要核对数量。输入视图和DTU坏曝光视图必须显式排除。静态核查还发现开启--viewlist后该脚本将每项转成Tensor,却随后调用列表的.extend,是应修复/验证的接口问题;本次没有运行该分支来宣称已复现实验。
08 · 单类别结果与关键消融
以下结果表中,粗体绿色表示同一设置/类别下该指标最好,下划线表示次好;并列保留。缺测项不参与排名。
原Table2 · 全部单类别结果
| 类别 | 方法 | 1-view PSNR ↑ | 1-view SSIM ↑ | 2-view PSNR ↑ | 2-view SSIM ↑ |
|---|---|---|---|---|---|
| Chairs | GRF [44] | 21.25 | 0.86 | 22.65 | 0.88 |
| Chairs | TCO [41] * | 21.27 | 0.88 | 21.33 | 0.88 |
| Chairs | dGQN [9] | 21.59 | 0.87 | 22.36 | 0.89 |
| Chairs | ENR [8] * | 22.83 | - | - | - |
| Chairs | SRN [40] | 22.89 | 0.89 | 24.48 | 0.92 |
| Chairs | Ours * | 23.72 | 0.91 | 26.20 | 0.94 |
| Cars | SRN [40] | 22.25 | 0.89 | 24.84 | 0.92 |
| Cars | ENR [8] * | 22.26 | - | - | - |
| Cars | Ours * | 23.17 | 0.90 | 25.66 | 0.94 |
星号沿用原表,表示测试时不需要canonical绝对姿态;它不意味着完全无需相机内参或相对位姿。pixelNeRF在chairs单图PSNR为23.72,比SRN的22.89高0.83 dB;双图26.20比24.48高1.72 dB。cars单图23.17比22.25高0.92 dB,双图25.66比24.84高0.82 dB。全表保留旧方法缺测项,没有用插值填补。


原Table3 · 局部特征与方向消融
| 方法变体 | 1-view PSNR ↑ | 1-view SSIM ↑ | 1-view LPIPS ↓ | 2-view PSNR ↑ | 2-view SSIM ↑ | 2-view LPIPS ↓ |
|---|---|---|---|---|---|---|
| − Local | 20.39 | 0.848 | 0.196 | 21.17 | 0.865 | 0.175 |
| − Dirs | 21.93 | 0.885 | 0.139 | 23.50 | 0.909 | 0.121 |
| Full | 23.43 | 0.911 | 0.104 | 25.95 | 0.939 | 0.071 |
去局部特征改用global code,单图PSNR从23.43降到20.39,损失3.04 dB;双图从25.95降到21.17,损失4.78 dB。去方向输入则分别下降1.50和2.45 dB。LPIPS也显著恶化,支持局部对齐与方向条件在该设置下都有价值。
“方向有用”既可能来自视角相关外观,也可能来自源视图可靠性判断;这一组消融不能分离两种作用。局部特征收益也包括更高信息容量,若要精确归因,还需要控制模型参数量和encoder特征规模。
09 · 跨类别先验与未知类别泛化
同一模型覆盖13类
类别无关设置使用NMR/Kato渲染:每对象24个固定仰角、64×64视图;随机一张作为输入,另外23张评价,各baseline共享同一输入选择。以下把原Table4转成类别/方法为行,PSNR、SSIM、LPIPS为列,完整保留13类和报告mean,避免横向14类挤压指标解读。
原Table4 · 13类别与报告mean,全方法/全指标
| 类别 | 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|
| plane | DVR | 25.29 | 0.905 | 0.095 |
| plane | SRN | 26.62 | 0.901 | 0.111 |
| plane | Ours | 29.76 | 0.947 | 0.084 |
| bench | DVR | 22.64 | 0.866 | 0.129 |
| bench | SRN | 22.20 | 0.837 | 0.150 |
| bench | Ours | 26.35 | 0.911 | 0.116 |
| cbnt. | DVR | 24.47 | 0.877 | 0.125 |
| cbnt. | SRN | 23.42 | 0.831 | 0.147 |
| cbnt. | Ours | 27.72 | 0.910 | 0.105 |
| car | DVR | 23.95 | 0.909 | 0.098 |
| car | SRN | 24.40 | 0.897 | 0.115 |
| car | Ours | 27.58 | 0.942 | 0.095 |
| chair | DVR | 19.91 | 0.787 | 0.173 |
| chair | SRN | 21.85 | 0.814 | 0.152 |
| chair | Ours | 23.84 | 0.858 | 0.146 |
| disp. | DVR | 20.86 | 0.814 | 0.150 |
| disp. | SRN | 19.07 | 0.744 | 0.197 |
| disp. | Ours | 24.22 | 0.867 | 0.129 |
| lamp | DVR | 23.27 | 0.849 | 0.172 |
| lamp | SRN | 22.17 | 0.801 | 0.210 |
| lamp | Ours | 28.58 | 0.913 | 0.114 |
| spkr. | DVR | 20.78 | 0.798 | 0.170 |
| spkr. | SRN | 21.04 | 0.779 | 0.178 |
| spkr. | Ours | 24.44 | 0.855 | 0.141 |
| rifle | DVR | 23.44 | 0.916 | 0.094 |
| rifle | SRN | 24.95 | 0.913 | 0.111 |
| rifle | Ours | 30.60 | 0.968 | 0.066 |
| sofa | DVR | 23.35 | 0.868 | 0.119 |
| sofa | SRN | 23.65 | 0.851 | 0.129 |
| sofa | Ours | 26.94 | 0.908 | 0.116 |
| table | DVR | 21.53 | 0.840 | 0.139 |
| table | SRN | 22.45 | 0.828 | 0.135 |
| table | Ours | 25.59 | 0.898 | 0.098 |
| phone | DVR | 24.18 | 0.892 | 0.110 |
| phone | SRN | 20.87 | 0.811 | 0.165 |
| phone | Ours | 27.13 | 0.922 | 0.097 |
| boat | DVR | 25.09 | 0.902 | 0.116 |
| boat | SRN | 25.86 | 0.898 | 0.134 |
| boat | Ours | 29.18 | 0.939 | 0.111 |
| mean | DVR | 22.70 | 0.860 | 0.130 |
| mean | SRN | 23.28 | 0.849 | 0.139 |
| mean | Ours | 26.80 | 0.910 | 0.108 |
pixelNeRF在全部13类三项指标上优于表内DVR/SRN。总体PSNR 26.80比SRN 23.28高3.52 dB;SSIM 0.910比DVR 0.860高0.050;LPIPS 0.108相对DVR 0.130降低约16.9%。优势尤其体现在薄结构和可见纹理,如屏幕图片、桌面纹理;但64×64分辨率也限制了它能证明的细节精度。

展开原Figures11–13:每类6个随机对象的完整定性样本
作者从13类中各随机抽6个对象,并随机选择源/目标视图。相比主图特选有趣案例,这组图更适合观察普遍失败和模糊程度;它仍不是几何误差统计。


只学飞机、汽车、椅子,测试另外10类
未见类别设置只在airplane/car/chair上训练,在剩余10类测试。由于可用对象超过25k,作者每类随机选25%用于测试,剩余用于验证。因此“未知类别”是未参与训练,但它们并非全部从模型选择流程中隔离;应区分训练类别外推与完全无接触的zero-shot评测。
原Table5 · 挑战性任务主表,保留原数字
| 方法 | 未知类 PSNR ↑ | 未知类 SSIM ↑ | 未知类 LPIPS ↓ | 双椅 PSNR ↑ | 双椅 SSIM ↑ | 双椅 LPIPS ↓ |
|---|---|---|---|---|---|---|
| DVR | 17.72 | 0.716 | 0.240 | - | - | - |
| SRN | 18.71 | 0.684 | 0.280 | 14.67 | 0.664 | 0.431 |
| Ours | 22.71 | 0.825 | 0.182 | 23.40 | 0.832 | 0.207 |
原Table6 · 10未知类与报告mean,全方法/全指标
| 未知类别 | 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|
| bench | DVR | 18.37 | 0.754 | 0.219 |
| bench | SRN | 18.71 | 0.702 | 0.282 |
| bench | Ours | 23.79 | 0.863 | 0.164 |
| cbnt. | DVR | 17.19 | 0.686 | 0.257 |
| cbnt. | SRN | 17.04 | 0.626 | 0.314 |
| cbnt. | Ours | 22.85 | 0.814 | 0.186 |
| disp. | DVR | 14.33 | 0.601 | 0.306 |
| disp. | SRN | 15.06 | 0.577 | 0.333 |
| disp. | Ours | 18.09 | 0.687 | 0.271 |
| lamp | DVR | 18.48 | 0.749 | 0.259 |
| lamp | SRN | 19.26 | 0.685 | 0.321 |
| lamp | Ours | 22.76 | 0.818 | 0.208 |
| spkr. | DVR | 16.09 | 0.657 | 0.266 |
| spkr. | SRN | 17.06 | 0.633 | 0.289 |
| spkr. | Ours | 21.22 | 0.778 | 0.203 |
| rifle | DVR | 20.28 | 0.858 | 0.158 |
| rifle | SRN | 23.12 | 0.875 | 0.175 |
| rifle | Ours | 23.68 | 0.899 | 0.141 |
| sofa | DVR | 18.62 | 0.755 | 0.196 |
| sofa | SRN | 18.76 | 0.702 | 0.248 |
| sofa | Ours | 24.62 | 0.866 | 0.157 |
| table | DVR | 16.20 | 0.644 | 0.280 |
| table | SRN | 17.35 | 0.617 | 0.315 |
| table | Ours | 21.65 | 0.798 | 0.188 |
| phone | DVR | 16.84 | 0.731 | 0.245 |
| phone | SRN | 15.66 | 0.635 | 0.324 |
| phone | Ours | 21.05 | 0.801 | 0.207 |
| boat | DVR | 22.43 | 0.857 | 0.152 |
| boat | SRN | 24.97 | 0.875 | 0.163 |
| boat | Ours | 26.55 | 0.896 | 0.148 |
| mean | DVR | 17.72 | 0.716 | 0.240 |
| mean | SRN | 18.71 | 0.684 | 0.280 |
| mean | Ours | 22.71 | 0.825 | 0.182 |
Table6保留10个类别与mean,展开Table5左半。pixelNeRF在mean PSNR上为22.71,比SRN18.71高4.00 dB、比DVR17.72高4.99 dB。LPIPS为0.182,相对DVR0.240低约24.2%。未见类别中display较难(PSNR18.09、LPIPS0.271),boat较容易(26.55、0.148),说明类间难度差异明显。

原Table9 · 类别缩写映射
| 完整类别名 | 原表缩写 |
|---|---|
| cabinet | cbnt. |
| display | disp. |
| speaker | spkr. |
10 · 多对象场景与Sim2Real
双椅子数据把ShapeNet chairs拆成2,715个训练资产和1,101个测试资产,在各split内随机放置两把椅子并绕各自z轴转动,渲染128×128图片。训练每实例20个半球视角,测试每实例50个螺旋视角,网络训练时给2个随机源视图,测试1/2/3个固定信息量较大的源视图。资产split数不等于生成的场景对数量;论文未给出足以推定全部不同配对数的完整清单。

原Table7 · 双对象1/2/3视图
| 方法 | 1-view PSNR ↑ | 1-view SSIM ↑ | 1-view LPIPS ↓ | 2-view PSNR ↑ | 2-view SSIM ↑ | 2-view LPIPS ↓ | 3-view PSNR ↑ | 3-view SSIM ↑ | 3-view LPIPS ↓ |
|---|---|---|---|---|---|---|---|---|---|
| SRN | 13.76 | 0.658 | 0.422 | 14.28 | 0.660 | 0.432 | 14.67 | 0.664 | 0.431 |
| Ours | 20.15 | 0.767 | 0.274 | 23.40 | 0.832 | 0.207 | 23.68 | 0.800 | 0.206 |
pixelNeRF从1到2视图PSNR增加3.25 dB;从2到3只增加0.28 dB,而且SSIM从0.832降到0.800。可变输入结构不保证所有指标随视图数单调提高,尤其训练只看2视图,第三张的可见区域与错误特征会改变平均融合。
展开原Figures14–15:双对象训练/测试样本及随机结果


真实汽车:有明确预处理的定性迁移
作者把合成cars模型直接用于Stanford Cars照片,不再微调。先PointRend得到前景mask和框,去背景后平移居中、缩放,使框短边为128像素画幅边长的1/4;设源相机姿态为identity,沿用训练时bounds。它演示对象外观和形状先验能迁移,不是未经处理的完整真实场景360°重建。

当前公开预处理改为对mask轮廓拟合椭圆,用短轴×4.37和长轴×0.8中的较大尺度决定裁剪半径,README也明确提示与论文heuristic有改动。使用现代码时应记录这一步,否则合成训练尺度和实际照片尺度不匹配,会影响结果;这也是方法尚未摆脱尺度约定的直接例子。
11 · DTU:极少视图优势与九视图反转
DTU比ShapeNet更接近真实物体和照明,但仍是受控采集,很多场景共享相同相机轨迹。作者发现MVSNet常用split中有高度相似的场景跨train/test出现,于是自建88训练、15测试scene的划分,缩图为400×300,世界尺度乘1/300,只用exposure level 3。训练每次随机3个输入视图,同一场景所有图像应用相同color jitter。

测试scan为8、21、30、31、34、38、40、41、45、55、63、82、103、110、114。训练排除这些及1、2、7、25、26、27、29、39、51、54、56、57、58、73、83、111、112、113、115、116、117。官方代码把该测试集合称为val,是文件组织约定,不应误读成又多了独立held-out验证集。
源view列表按论文顺序为25、22、28、40、44、48、0、8、13,对1/3/6/9视图取相应前缀;计算指标时排除源视图以及坏曝光view 3、4、5、6、7、16、17、18、19、20、21、36、37、38、39。坏曝光图片训练时没有全部剔除,因此训练噪声和测试过滤的边界要记录。

原Table8 · DTU均值与标准差,完整重排
| 输入视图数 | 方法 | PSNR mean ↑ | SSIM mean ↑ | LPIPS mean ↓ | PSNR SD | SSIM SD | LPIPS SD |
|---|---|---|---|---|---|---|---|
| 1 | Ours | 15.55 | 0.537 | 0.535 | 1.87 | 0.127 | 0.081 |
| 1 | NeRF | 8.00 | 0.286 | 0.703 | 3.20 | 0.093 | 0.055 |
| 3 | Ours | 19.33 | 0.695 | 0.387 | 2.59 | 0.131 | 0.105 |
| 3 | NeRF | 9.85 | 0.374 | 0.622 | 4.69 | 0.173 | 0.137 |
| 6 | Ours | 20.43 | 0.732 | 0.361 | 2.66 | 0.115 | 0.102 |
| 6 | NeRF | 18.59 | 0.719 | 0.347 | 4.72 | 0.177 | 0.133 |
| 9 | Ours | 21.10 | 0.758 | 0.337 | 2.71 | 0.102 | 0.094 |
| 9 | NeRF | 22.14 | 0.820 | 0.262 | 4.33 | 0.131 | 0.109 |

Table8完整列出每种方法、视图数、三项指标的mean与标准差(SD),不是置信区间。1视图PSNR从NeRF8.00到pixelNeRF15.55;3视图从9.85到19.33,增加9.48 dB。6视图时pixelNeRF的PSNR/SSIM仍高,但LPIPS0.361已不如NeRF0.347。9视图时NeRF的PSNR22.14、SSIM0.820、LPIPS0.262都好于pixelNeRF的21.10/0.758/0.337。
这不是矛盾:共享先验在信息很少时补足歧义,信息充足后逐场景优化可更精细地拟合具体场景。pixelNeRF仍有无需14小时测试优化的优势,但不能将其摘要式“所有情况领先”理解为所有视图数与所有指标上都领先。Figure10画的是分位数趋势,不能从图中编造每个scan的精确数值;Table8提供了实际可复核的aggregate数字。
展开原Figure16:其余9个DTU测试场景

对5个6/9视图NeRF不收敛情况,作者额外用了同场景更少3个视图的权重初始化,再训练约200k步。它是为了得到合理baseline的补救,不等于所有baseline都只执行一次完全相同的从零训练流程。论文没有与现代稀疏视图NeRF方法比较,它的结论应放在2021年的实验对象范围内。
12 · 公开实现与复现检查点
当前检查固定提交91a044b,而不是把仓库master当成永远不变的“原始实验”。读取了encoder、坐标与投影、ResNet融合、体渲染、训练器、数据adapter、指标脚本、配置和真实车预处理;没有安装依赖、下载checkpoint或运行GPU。下面是静态可观察差异和复现风险。
论文与当前实现的差异
| 事项 | 论文/说明 | 固定公开实现/另一来源 | 处理原则 |
|---|---|---|---|
| 主表/附录双椅SRN | 主Table5标2-view:14.67/0.664/0.431 | 附Table7该组在3-view;2-view为14.28/0.660/0.432 | 保留并标注,无法据现有证据替作者修表 |
| 单类别源view | 附录B.2.1写64、128 | 当前README评估写64、104 | 显式固定列表,不能把二者结果混为同一协议 |
| 坐标编码 | 论文Eq.4完整相机坐标 | normalize_z默认True时位置编码用仅旋转xyz_rot;投影仍加平移 | 必须固定中心化/原点约定 |
| 多对象频率 | 论文omega=2.0 | multi_obj配置只改data format,继承1.5 | 复现论文需记录覆盖值,公开配置不等于原运行 |
| 前景采样阶段 | 实验分别300k或400k后停bbox | CLI默认100k | 使用对应实验参数 |
| 训练视图数 | 双对象应2-view | README双对象示例未传-V,CLI默认1 | 示例不可直接当成已对齐论文的命令 |
| 相机和尺度 | 相对位姿、手动near/far | 不同adapter对坐标、内参和世界尺度转换 | 不等于无标定或尺度不变 |
| 真实车归一化 | 框短边=画幅1/4 | 当前改成拟合椭圆,scale4.37/major0.8 | README承认调整,区分原始和发布版本 |
| 最终指标 | 论文来自保存的量化图片 | eval在线浮点结果与calc_metrics可能略不同 | 以同一最终协议重算 |
| 指标viewlist入口 | 要排除源view | 固定提交Tensor后调用extend,需核对/修复 | 静态发现,未GPU执行验证 |
| 发布说明 | README首段仍称two-object实验缺失 | 当前树已有adapter、配置和渲染脚本 | README状态可能陈旧;未验证权重包内容,不断言全流程完备 |
复现应保存的一份最小实验记录
- 数据身份:具体rendering版本、资产split、对象UID、输入view与目标view清单。SRN cars原版存在相机采样bug,本文使用作者重新渲染版本。
- 相机约定:代码encode接收camera-to-world后求逆;OpenGL风格投影使用负z及y符号处理。确认内参在resize后同步缩放,输入相机与目标相机使用同一单位。
- 空间尺度:记录near/far、频率因子、normalize_z、数据中心化及DTU的1/300。图像对齐不意味着这些约定可以省略。
- 训练阶段:nviews、bbox停止步、总iterations、Adam学习率、是否冻结encoder。公开默认参数不足以替代论文每项训练计划。
- 渲染预算:64个coarse与96个fine查询、ray/point chunk、源视图数、分辨率和seed。当前采样函数在eval也有随机数,不要把前馈误解为无任何采样随机性。
- 指标集合:保存8-bit渲染后重算、确认VGG-LPIPS输入范围、排除源图与坏曝光、检查缺失输出、说明按对象权重还是按类别宏平均。
一个新场景的推理流程是:先encode所有输入图像并缓存局部特征;为目标相机构建射线;逐点回投所有输入视角;前3层融合、后2层解码;粗采样决定细采样;体渲染输出RGB/深度。MLP权重共享且固定,变化的是条件特征缓存;论文并没有一个hypernetwork输出每个场景独立的新MLP权重。
13 · Reviewer评议与可验证的改进
Strengths
证据与先验的分工清晰。可见细节通过pixel-aligned特征进入,而不是全都压进一个全局向量;未见部分仍由跨场景网络学习。局部特征/方向消融提供了直接支持,类别无关、未知类别、双对象和DTU让结论超越单一类别demo。特别是跨类别表保留了逐类结果,能看到收益并非仅来自某一大类。
表示兼容性较好。可微体渲染使训练只需要带位姿图片,跨视图平均能处理不同输入数;无测试优化降低了新场景使用门槛。在2021背景下,它是从逐场景拟合到可泛化NeRF的重要一步。
Weaknesses
- 几何正确性证据有限:主要是图像质量指标,缺少系统表面误差/法线/深度评估。密度和颜色可共同解释观测,无法保证唯一真实形状。
- 可见性融合过于简单:平均池化没有明确剔除遮挡和出视锥证据;输入更多也会引入错误条件,Table7的SSIM下降提示需要细看。
- 广泛场景泛化尚未验证:ShapeNet是单对象或简单双椅,DTU仍受控,真实车演示依赖mask、居中和尺度预处理;不是任意手机图像的通用3D重建。
- 成本被转移而非消失:免去逐场景训练,但训练prior需数天,渲染仍逐射线查询并随输入数增加,mesh提取也不可靠。
- 尺度和坐标仍需手调:采样bounds、频率系数、中心化和真实车裁剪影响大,公开代码的normalize_z路径进一步要求复现者核对坐标。
- 协议小差异会改变数字:25/251目标视图、cars重新渲染、64/128与64/104源view差异、双椅表格行冲突、量化后指标都必须记录。
优先追加的实验
先在固定split上比较平均池化、视角注意力和显式可见性权重,保持encoder/参数量/采样预算一致;对被遮挡点和出视锥点单独统计。再让训练视图数覆盖测试范围,判断9视图饱和是训练分布限制还是架构容量瓶颈。最后加入pose噪声、焦距误差、世界原点重定、物理尺度变化和跨数据域评估,区分几何泛化与预处理对齐的收益。
值得追问而未在本文解决:若辐射场能通过方向改变密度来解释图像,是否应该约束密度只依赖位置?当场景背面无观测时,是否应输出不确定性而非单一平均形状?表面提取质量和真实材质可重用性,应独立于PSNR进行评价。
14 · 对程序化材质研究的可迁移设计
研究延伸,非论文已验证:pixelNeRF没有生成材质节点图,也没有估计BRDF。可借鉴的是将局部观察通过已知投影送到三维查询,再跨视图融合的条件化方式。程序化材质系统可把“所有信息压进单一图像向量”改成“在目标表面点读取对应观察证据”。
方向一:可见性加权的局部材质证据
设表面点 \(\mathbf x\) 对应纹理/程序坐标 \(\mathbf u\),输入视图特征为 \(F_i\),可见性和质量权重为 \(a_i(\mathbf x)\)。构造:
权重可以结合遮挡、入射/出射角、高光饱和及分辨率,避免直接平均不可靠证据。再用局部特征约束材质程序的空间参数,而全局分支决定木纹/石材等结构先验。不同于pixelNeRF本身,这需要已知/估计几何与显式材质任务监督,不能从图像条件自动获得。
方向二:将视角依赖外观和材质参数分离
pixelNeRF允许颜色随方向变化,这对新视图重现有用,却可能把灯光和镜面反射编码进外观场。材质生成应明确引入BRDF参数 \(\theta_m\) 和光照 \(L\),以可重渲染模型解释图像:
\(G\) 是合法的程序化材质图,\(P_i\) 是相机;图损失/约束确保节点类型、边连接、通道范围和执行正确,材质先验抑制把阴影烘焙进albedo。对于单图难以辨别的粗糙度/光照组合,应保留候选或不确定性,并用新的照明或视角验证。
方向三:先做前馈初始化,再有限地优化程序
DTU结果表明,强先验在少观察时有优势,观察变多后针对当前实例的优化可能更准。可将前馈图/参数建议作为初始化,然后用固定预算的renderer反馈优化参数,必要时搜索少量拓扑修改。这样可以明确比较“免优化速度”与“更高精度”,而不是预设所有情况下前馈都应获胜。
这是建议的混合推理方案;原pixelNeRF不执行上述测试时参数更新,也没有图搜索。对于不可微节点或拓扑变化,需要合法编辑动作、编译执行验证和预算受控搜索,不能假设整个Substance图都可直接梯度优化。
| 最小实验 | 控制变量 | 判断成功的证据 |
|---|---|---|
| global vs pixel-aligned材质条件 | 相同encoder容量、数据和渲染预算 | 可见局部结构保留更好,未观察区不确定性可校准 |
| 平均 vs 可见性加权融合 | 相同视图与几何,单独改变遮挡量 | 遮挡区域误差下降,增加视图不会频繁破坏结果 |
| 前馈 vs 有限优化 | 固定总时延/候选预算,分别测1/3/6/9观察 | 报告质量—成本曲线,而非只给最终最好结果 |
| 视角外观场 vs PBR图 | 训练时相同输入,测试换光、换几何、换尺度 | 新光照下有效,图可执行,材质属性不与灯光混淆 |
| 按资产家族留出 | 分离近重复纹理/同一程序的参数变体 | 验证结构泛化,避免图模板和位图泄漏 |
15 · 来源与交付边界
- 固定身份:arXiv v3 PDF,已完整阅读提供的20页文件及附录,SHA-256:
e4b1803f3aa6f7764bf3ebb8f0269c40aaa0e4c3185b5ff9d7bea5ef3a456704。版本由实际首页确认,原文件名和原文保留。 - 同版本arXiv HTML,用于逐值核对全部九张表与真实图资源
- CVPR2021官方条目与作者项目页,用于venue、标题、作者及演示范围交叉核查
- 官方代码固定提交91a044b,2022-06-10,单独标记实现证据,未运行GPU模型
建议在归档时补全原笔记venue为CVPR 2021、project_page为官方项目地址;通讯作者继续标记未核实,作者联系页“有问题联系Alex”也不自动等于明确的论文通讯作者声明。第一作者Alex Yu和候选Angjoo Kanazawa的人物记录应查重后复用,本次仅准备归档计划。
已完成HTML结构、导航、公式源码、完整表值、图片HTTP/解码或SVG结构、文件大小及原笔记字节前缀检查。真实浏览器MathJax执行、图片加载和1440/760/390px响应布局按用户要求待下载后验收;没有声明浏览器通过,也没有写回vault、共享People或发布站点。