01 · 先给结论:PRL 提供的是哪一种过程信号
PRL 将终局奖励与“从当前位置到结尾的策略/参考模型 log-ratio”组合,形成不同位置的训练权重。它不需要在主要实验中额外训练语义判错 PRM,也不做 MCTS;核心是把 KL 正则化回报写成可用于 policy gradient 的 reward-to-go,再加入 GRPO 的组内标准化与 PPO 式 clipping。
v1 在四个1B–7B模型和五个数学集合上有积极结果,但并非全胜:Qwen2.5-Math-1.5B 的加权 average@8 比GRPO高2.77个百分点、pass@8高1.91;Llama-3.2-1B 的pass@8反而低0.39,Llama-3.2-3B 的average@8低0.31。本文保留每一行原表,避免摘要里的“consistently better”遮住例外。
需要认真看待的证据问题:Appendix C标为“Correct answer”的回答讨论二进制weight,题目却问三次序列;末尾0碰巧等于三次序列的gold answer。这个案例不能证明推理正确。官方训练入口与论文配置也存在差异,默认README脚本选择GRPO,PRL分支需要另行启用。

02 · 论文身份、完整阅读范围与版本
题名:PRL: Process Reward Learning Improves LLMs’ Reasoning Ability and Broadens the Reasoning Boundary。作者Jiarui Yao与Ruida Wang标有equal contribution,Tong Zhang为末位作者;机构University of Illinois Urbana-Champaign。固定版本为2026-01-15的2601.10201v1,共17页:主文/参考文献11页,Appendix A证明3页,B超参及C案例合计后续3页(p14兼有B/C开头)。全部附录已读。
arXiv现有2026-05-23的v2;本页没有把v2公式或结果覆盖到原笔记对应的v1。所查官方GitHub默认分支最新提交仍为1ee49faaa3bff849526c5987c44e7577b33de99f,2026-01-15 08:46 UTC,早于v1提交约15分钟。因此代码是接近发布时的可定位快照,但没有日志证明每张表确实由这个commit的默认命令生成。
没有在所查v1与书目页确认正式会议venue,按2026 arXiv预印本记录。共同一作已由首页星号明确;没有显式通讯作者标记,Tong Zhang仍应是候选,不因末位作者或email而自动升级。arXiv-issued DOI可作为仓储标识,与会议/期刊出版DOI分开。
来源优先级:PDF为主要证据;固定HTML用来核对数值,但它没有正确呈现Appendix A,Table1/3还多出一个空RAFT行,因此不能只读HTML。实现部分使用精确commit的代码与配置;数据集口径来自作者代码指定的HF数据卡。
03 · 研究动机与 PRM、GRPO 的关系
Outcome-only RL通常在完整答案后给0/1奖励;长推理轨迹里的多个步骤共享相同信号,难以区分各位置怎样改变成功概率。传统process supervision可以标注步骤、训练判别器或从中间状态多次rollout/MCTS估值,但代价包括标注、额外模型和采样。
PRL试图利用现成的reference log-probability,把已有KL正则项以位置相关的形式分配给policy gradient,而不新增一个重型reward network。与另一个模型逐步判错不同,这个信号衡量“相对参考策略,未来这段生成路径改变了多少概率质量”,再结合终局正确性。
| 对象 | 输入/信号 | 是否在本文主实验额外学习 | 容易混淆之处 |
|---|---|---|---|
| 规则 outcome verifier | 完整回答、gold answer,Math-Verify判答案等价 | 否 | 不验证完整推理证明 |
| reference policy \(\pi_0\) | 同一prompt和已生成token的概率 | 固定 | 是参考分布,不是真理判别器 |
| PRL过程权重 | 终局回报或组内advantage减未来log-ratio和 | 由当前/rollout policy概率计算 | 没有增加独立的语义正确性信息 |
| 可学习 \(r_u\) | prefix value,bootstrap target | §3.3的可选泛化;主实现不需要 | “没有PRM”是主实验简化路径,并非论文从未定义reward model |
| GRPO | 同prompt多答案的相对终局reward | 训练policy | PRL可以在其advantage上增加位置相关项,不是完全替代所有GRPO步骤 |
我们的解释:本文真正值得借鉴的是KL-regularized credit assignment的低开销实现路径。若把它宣传为“从0/1答案标签精确恢复每一步逻辑正确性”,就越过了理论和实验的证据边界。
来源:v1 §1–3,Figure1;本文用词“process reward”在实际训练中也常指return/advantage,以下逐一分开。
04 · 从目标函数到 Theorem 3.1
令x为题目,\(a=[a_1,\ldots,a_L]\)为完整回答,\(a_{\lt t}\)为前缀,\(R(x,a)\in[0,1]\)为固定终局奖励。理论先把策略视为每个x上的完整分布,不考虑神经网络参数化、有限样本与优化局部极值。设 \(\eta\gt0\),目标是:
η的方向:真正的KL penalty系数是\(1/\eta\),不是η。η越大,相对越重视reward、越弱地约束参考偏离;η越小越靠近reference。原note局部把η叫作KL系数,而后文又正确写1/η,这里补充澄清,不修改原笔记。
这就是Theorem3.1的归一化形式。固定x构造Lagrangian,对每个答案概率求导,得到log policy/reference ratio等于η倍reward加一个归一化常数;归一化后得到上式。更直接的等价分解是:
KL非负,所以最大值由\(\pi^\ast\)取得。这种证明同时说明前提:reference支持集上概率比必须有定义;对reference零概率的回答,有限KL优化不能凭空建立新支持;R有界和η有限保证Z有限。LLM对大多数有限token序列理论上都有正概率,所以实验所谓“边界”主要是概率与预算意义的可达性。
KL不是reward-hacking保证:它限制分布偏移,不能保证中间逻辑、语法或内容一定正确;若verifier只检查结尾值,模型仍可能用错误过程碰巧得到正确末尾。奖励设计和验证器覆盖仍然重要。
来源:v1 §3.1、Theorem3.1、AppendixA.1(PDF p12);第二个KL分解为本精读给出的等价推导。
05 · Corollary 3.2 与 Theorem 3.3 的精确含义
这是同一prompt下、最优策略支持内的正则化净收益恒等式。C一般依赖x;不能说所有prompt共享同一个常数,也不能把它解释成“所有答案的原始正确性reward都相同”。错误路径仍可有正概率,只是它的概率比正好补偿较低reward。
固定长度ℓ的前缀,定义最优soft prefix value:
论文记作\(r_\ell^\ast\),这里改用V帮助区分状态value与即时reward。把完整log-ratio按chain rule拆成前缀和后缀:
固定x和prefix后,中间表达式不依赖未来completion,所以在\(\pi^\ast\)下期望确实可以去掉。换另一个prefix,其V可以变;这不是“所有中间步骤都有相同value”。对任意ℓ<p≤L还有递推:
一个四路径例子:哪些量恒定
我们的教学算例:两次二选一产生00/01/10/11,reference各为1/4,仅11奖励1,η=1。最优11概率0.475367,其余各0.174878;全轨迹净收益C=0.357374。对prefix“1”,两种后续的原reward分别0和1,扣除各自未来log-ratio后都等于V=0.620115。
但若当前策略仍等于reference,所有log-ratio都是0;prefix“1”后采到10得0、采到11得1,两个估计显然不相同。它们的期望是0.5,却不能单次精确读出prefix value。这正是理论最优路径恒等式与训练时Monte Carlo return的区别。
来源:v1 Corollary3.2、Theorem3.3、AppendixA.2–A.3(p12–13);算例数值由本精读独立计算,非论文实验。
06 · 当前策略也能用:正确的 policy-gradient 推导
仅指出“训练时不是最优策略”还不够:PRL最简单的token级形式可由标准reward-to-go推导,不需要等待策略已最优。令:
对当前策略的KL正则目标求导。由于reference固定,log policy直接导数项的期望为零,即score-function均值为零,因此:
在选择token t之前,过去的k项已由prefix决定。条件score均值为零,允许减去仅依赖prefix的baseline:
这给出实际使用的detached权重:
注意求和从当前token t开始,而prefix value的future项从ℓ+1开始:前者给“选择当前动作”的gradient做权重,后者给“当前动作已经发生后的状态”估value,不应误当成同一公式的随意off-by-one。
stopgrad避免对这份采样权重再次反向传播,符合score-function估计形式。R由规则判定,通常本来就不可微;k由policy算出,但在此路径中也冻结。过去baseline消去需要on-policy期望和相应可积条件;它不能证明任意clipping、长度归一化、组标准化或分段近似都仍严格等价。
边界:k_t单次可以为负,只在按policy分布取适当期望后对应KL≥0。不能把每个sample上的log-ratio直接称为非负KL散度,亦不能由负k推断某一步逻辑更正确。
来源:v1 Eq3.1与AppendixA.4(p13–14);这里补全原附录省略的因果baseline消去步骤,修正排版中丢失的外层token求和。
07 · 可选 value learning、GRPO 与 clipped surrogate
§3.3先描述可以学习一个prefix reward/value模型\(r_u\)。给较早ℓ与较晚p,使用bootstrap目标:
完整response处强制使用真实终局reward。若p=L,直接用R即可省去r_u。这是主算法最简单、主要实验对应的路径。虽然理论最优soft value可在[0,1]内,非最优policy的采样bootstrap target可能越界;论文没有给出完整target clipping或reward-head训练实现,不能把可选扩展当成已复现组件。
同一prompt采n个回答时,GRPO先形成标准化终局advantage:
若组内reward完全相同,outcome advantage近零,但不同轨迹的KL-to-go仍可产生不同权重。这不意味着模型得到了哪个答案正确的新信息;主要是在reference约束下重新分配概率。reward被组内std缩放以后,固定η相对于reward的强度也改变了,因此不能无条件称为同一原始J。
\(\pi_{\mathrm{old}}\)是采样/更新前策略,\(\pi_0\)是固定reference;两个分母承担完全不同的角色。论文正文还写独立的βKL项,但Table6把KL loss coefficient设为0;额外KL loss为零不代表PRL里没有KL惩罚,后者已经在ρ内乘1/η。
算法框中的Agg为每条轨迹按L归一再batch平均;公开actor默认却是token-mean,并带dual-clip负advantage保护、log-ratio clamp。它们是实际surrogate的工程选择,不能从理想最优分布公式直接推出训练全程数学等价或收敛保证。
来源:v1 §3.3、Algorithm1、Table6;历史 core_algos.py 与 dp_actor.py
08 · Algorithm 1 与 token 分段的实际执行
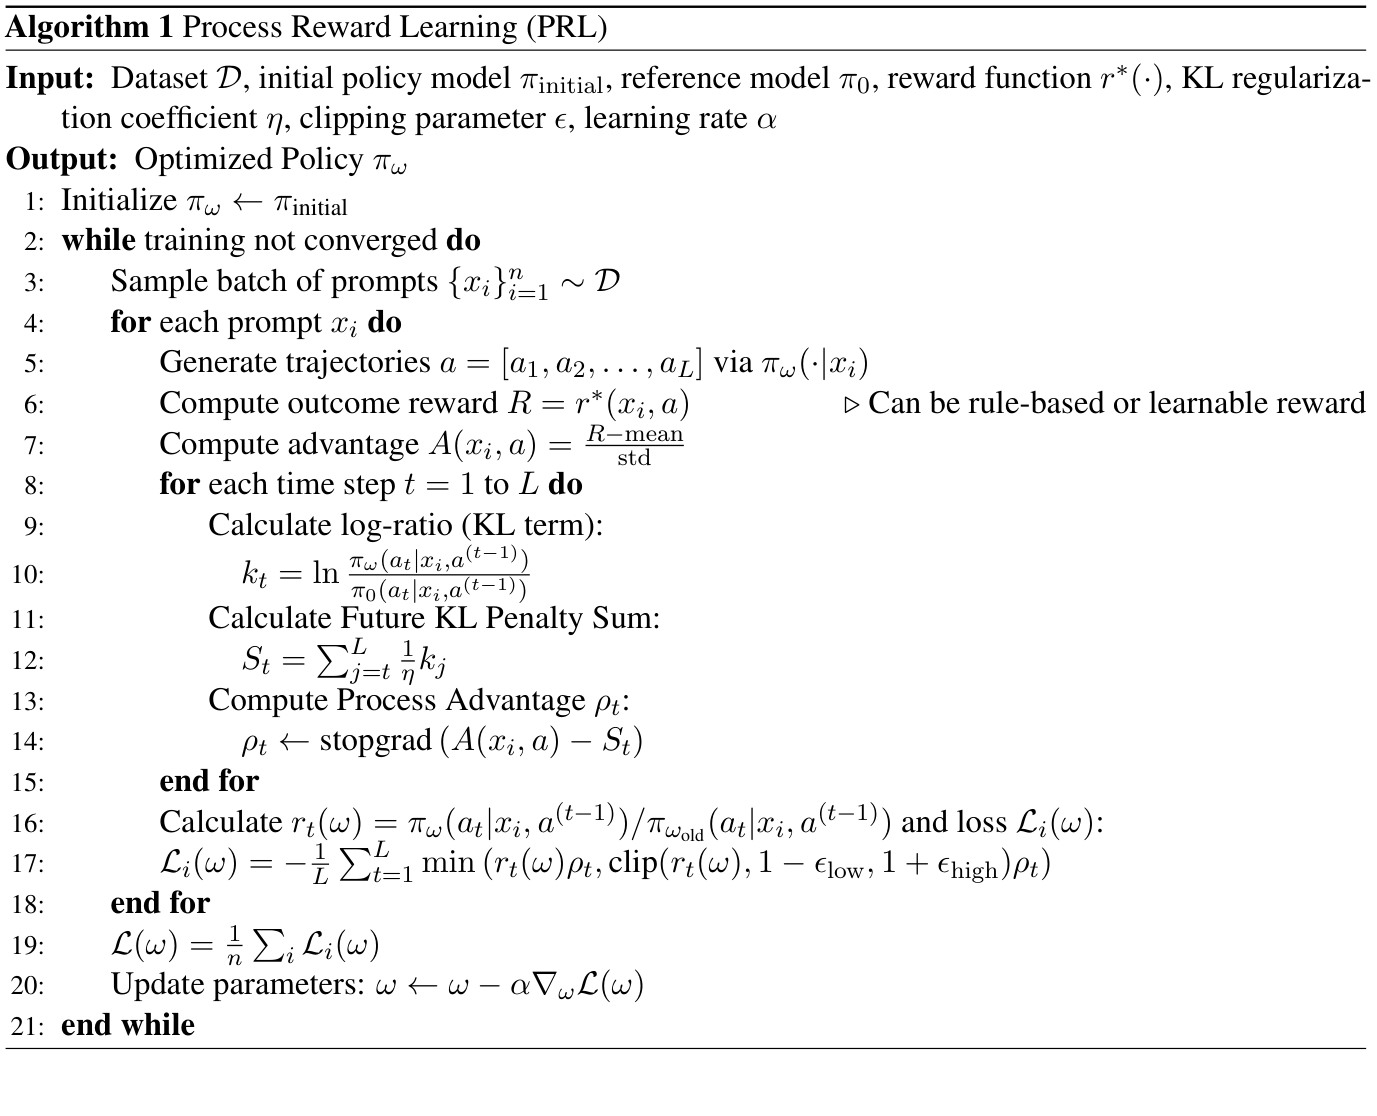
- 抽取一个prompt batch;每题由rollout policy生成n个完整回答,保留response mask、生成时log-probs与题目group ID。
- Math-Verify用gold answer得到终局R;主要实验每组n=5,先算GRPO outcome advantage。
- reference在相同token序列上teacher-force,得到reference log-probs;与旧policy log-probs做差。
- 从序列尾部反向累加k,得到每个位置的suffix penalty;减去它的1/η倍。
- 按固定token长度或newline定义step boundary;实现把boundary上的值向左填充到整段token。
- 冻结advantages,用current/old ratio、clipping与response mask更新actor;不训练独立critic或PRM。
- 重复采样与更新,按保存的checkpoint、相同评价budget比较五个数学集合。
反向cumsum仅线性复杂度O(L),不需要从每个prefix重新采样多个completion。成本仍包括policy rollout、旧policy/reference概率计算和actor训练;“不用MCTS/额外PRM”不等于不用reference或没有额外forward。
分段的真实含义:在固定step_len=256时,代码计算所有token的suffix值,只保留256、512等段尾和最后有效token,再把右侧最近非零值向左传播。因此一个256-token段共享其段尾权重,段内前255个token自己的局部KL项未逐一进入该段共享权重。这个粗粒度近似不等于严格token级Eq3.1,更不保证每256token就是一个有语义的数学步骤。
原Figure1把log-ratio称为“entropy ratio”,更准确是likelihood log-ratio之和;它包含relative probability变化,不是两个熵标量相除。图示中prefix/suffix索引也不是完全统一,复现以Eq3.1与代码实际suffix cumsum为准。
来源:v1 Figure1、Algorithm1;ray_trainer.py的PRM分支
09 · 模型、训练数据、prompt 与 verifier
论文设置:Qwen2.5-Math-1.5B/7B和Llama-3.2-1B-Instruct/3B-Instruct,覆盖数学专用base与通用instruct两组。训练使用NuminaMath约150k子集,题目带可验证答案。这里没有VLM、图像encoder、检索、外部工具执行或agent环境。
代码补充:预处理直接读取ScaleML-RLHF/numina_math_15_all;所查数据卡有149,882条problem/answer记录。脚本按train_start/train_end连续select,默认取全部;shuffle与长度700过滤代码被注释。因此论文所说“random subset”可能在上游数据制作完成,不能把当前脚本说成以seed42随机采出了150k,论文未给精确上游抽样manifest。
| 使用位置 | 公开文本/行为 | 注意 |
|---|---|---|
| 训练system prompt | Please reason step by step, and put your final answer within \boxed{}. | 与结构化step分割是两件事 |
| 训练question suffix | Let's think step by step and output the final answer within \boxed{}. | 完整题目后追加;evaluation suffix末尾标点略有不同 |
| chat formatting | evaluation调用各自tokenizer的apply_chat_template,add_generation_prompt=True | 不同model tokenizer/template revision应锁定 |
| 训练reward | ground_truth是answer;按data_source进入math_verify | 不使用完整标准解做step监督 |
| evaluation gold | answer是list时仅取第一个;转字符串、包装为boxed形式比较 | 多答案题的表达覆盖需检查 |
Math-Verify在这里比较最终可提取表达式与gold的数学等价。它没有读取题目语义来逐步证明,也不判断完整推理是否回答同一问题。代码将大多数异常计为0;应保存parse failure、timeout与数学错误的分开统计,而不是把所有0都叫推理失败。
仓库提供五个evaluation JSONL,Olympiad Bench确有675条;其中三次序列案例缺失part(a)条件,另一个weight题也缺定义上下文。数据来源公开有助审查,但公开并不等于题目语义完整或没有污染。没有找到完整训练/测试去重审计或所有checkpoint选择日志。
来源:v1 §4.1;数据预处理、作者采用的数据卡、verifier封装
10 · average@8 与 pass@8:可靠性和覆盖不能混读
原 Table 2 · 测试集规模
| Benchmark | 题数 |
|---|---|
| MATH500 | 500 |
| Minerva Math | 272 |
| Olympiad Bench | 675 |
| AIME24 | 30 |
| AMC23 | 40 |
五集合合计1,517题,每题评估8次,共12,136个回答/模型/配置。MATH500与Olympiad Bench合计约77.46%权重;再加Minerva达到95.39%。AMC23和AIME24合计仅4.61%,所以“5 Avg”不是五个百分比的等权平均。
Y是答案是否通过verifier。average@8是8个sample的平均成功率估计,不是“八个答案投票”的准确率;pass@8把同题任意一次正确记为1,默认存在oracle知道哪一个正确,也不是实际用户任选一个答案的可靠性。
在独立同分布采样假设下,同一题的单次成功概率p只要重新加权变大,pass@n也能变大,无需创造新支持。跨题还有成功率分布效应:更平均地分配成功概率可改变coverage。只有n=8、没有大n曲线或对base极大采样预算的对照,不能区分“新能力”与“已有低概率解被提权”。
不确定性:AIME24只有30题,pass@8多/少一题就是3.33个百分点;AMC23每题2.5个百分点。没有给独立training seeds、evaluation seed重复或置信区间。应报告按题配对bootstrap、成功集合交并与大量sampling curve,不能把小样本单格变动都当显著。
代码与论文汇总不同:论文明确size-weighted;公开eval/aggregate.py和eval/eval.py的“5 average”却用五行mean,是macro平均。本文按原表保留数值,并另做加权算术检查,不直接采用脚本末行作为论文总分。
来源:v1 §4.2、Table2;聚合代码。独立采样公式与权重比例为本精读解释。
11 · 原 Table 1:全部 pass@8 结果
所有值为百分比。按基础模型分组展示完整14行×6个数值;粗体为组内列最优、下划线为次优(并列保留)。模型名称沿用原表,5 Avg为论文报告值,算术疑点不静默改写。
原 Table 1 · Qwen2.5-Math-1.5B
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Qwen2.5-Math-1.5B | 81.60 | 35.66 | 48.15 | 65.00 | 20.00 | 56.82 |
| + RAFT | 87.40 | 42.65 | 52.00 | 77.50 | 33.33 | 62.23 |
| + GRPO | 88.00 | 44.85 | 56.44 | 70.00 | 20.00 | 64.40 |
| + PRL | 89.40 | 45.59 | 58.07 | 85.00 | 30.00 | 66.31 |
原 Table 1 · Qwen2.5-Math-7B
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Qwen-2.5-Math-7B | 82.00 | 31.03 | 51.56 | 72.50 | 40.00 | 58.24 |
| + RAFT | 91.80 | 51.84 | 62.22 | 82.50 | 46.67 | 70.34 |
| + GRPO | 92.60 | 52.21 | 65.33 | 85.00 | 46.67 | 72.12 |
| + PRL | 93.60 | 52.57 | 65.19 | 85.00 | 43.33 | 72.38 |
原 Table 1 · Llama-3.2-1B-Instruct
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Llama-3.2-1B-Instruct | 45.20 | 8.46 | 12.89 | 20.00 | 6.67 | 22.81 |
| + GRPO | 57.80 | 17.65 | 22.81 | 30.00 | 13.33 | 33.42 |
| + PRL | 60.60 | 17.65 | 20.15 | 30.00 | 6.67 | 33.03 |
原 Table 1 · Llama-3.2-3B-Instruct
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Llama-3.2-3B-Instruct | 67.80 | 28.31 | 28.30 | 45.00 | 23.33 | 41.66 |
| + GRPO | 76.80 | 36.03 | 39.56 | 55.00 | 16.67 | 51.16 |
| + PRL | 74.00 | 36.40 | 41.33 | 67.50 | 16.67 | 51.42 |
- Qwen1.5B:PRL 66.31 vs GRPO64.40,+1.91个百分点;MATH500+1.40、Minerva+0.74、Olympiad+1.63、AMC+15.00、AIME+10.00。不过AIME30.00仍低于RAFT33.33,不能说每列最好。
- Qwen7B:72.38 vs72.12,只+0.26。MATH+1.00、Minerva+0.36,但Olympiad65.19低于65.33,AIME43.33低于46.67,AMC并列85.00。
- Llama1B:33.03 vs33.42,−0.39;MATH提高2.80,但Olympiad低2.66、AIME低6.66。平均样本更好并不保证finite-budget覆盖更好。
- Llama3B:51.42 vs51.16,+0.26;MATH低2.80,Minerva+0.37、Olympiad+1.77、AMC+12.50,AIME并列。
表内算术疑点:Qwen1.5B+RAFT的五个数据集数值按500/272/675/40/30加权得到约62.2945%,应约62.29,而原表写62.23。差0.0645个百分点,大于这些两位小数带来的正常rounding误差。其余主表行的加权值与报告值相容;保留62.23并标记待作者确认。
两组Qwen含RAFT、GRPO、PRL,Llama组没有RAFT行。正文提到REINFORCE作为相关/对比基线,但主表没有其独立结果,不能自行补一条REINFORCE性能或称已全面比较。
来源:固定v1 Table1(p5);固定HTML表;所有delta与算术检查为本精读计算。
12 · 原 Table 3:全部 average@8 结果
原 Table 3 · Qwen2.5-Math-1.5B
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Qwen2.5-Math-1.5B | 38.53 | 11.76 | 18.85 | 24.38 | 3.75 | 23.91 |
| + RAFT | 62.92 | 23.12 | 28.17 | 37.5 | 9.17 | 38.59 |
| + GRPO | 67.50 | 25.55 | 31.35 | 44.69 | 6.67 | 42.09 |
| + PRL | 71.00 | 28.63 | 33.57 | 45.94 | 9.17 | 44.86 |
原 Table 3 · Qwen2.5-Math-7B
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Qwen-2.5-Math-7B | 41.62 | 12.87 | 19.24 | 28.12 | 9.58 | 25.52 |
| + RAFT | 74.58 | 33.18 | 37.30 | 59.06 | 20.00 | 49.08 |
| + GRPO | 80.72 | 36.76 | 44.20 | 63.12 | 22.08 | 54.96 |
| + PRL | 81.38 | 37.78 | 44.93 | 63.75 | 22.50 | 55.71 |
原 Table 3 · Llama-3.2-1B-Instruct
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Llama-3.2-1B-Instruct | 13.48 | 2.21 | 2.46 | 2.81 | 1.25 | 6.03 |
| + GRPO | 26.30 | 6.16 | 6.06 | 9.38 | 0.00 | 12.72 |
| + PRL | 28.65 | 5.01 | 6.76 | 14.38 | 1.67 | 13.76 |
原 Table 3 · Llama-3.2-3B-Instruct
| Model | MATH500 | Minerva Math | Olympiad Bench | AMC23 | AIME24 | 5 Avg |
|---|---|---|---|---|---|---|
| Llama-3.2-3B-Instruct | 34.95 | 9.97 | 8.06 | 16.25 | 3.33 | 17.39 |
| + GRPO | 48.23 | 16.96 | 17.35 | 22.81 | 5.83 | 27.37 |
| + PRL | 47.50 | 16.82 | 16.93 | 27.50 | 6.67 | 27.06 |
- Qwen1.5B:加权44.86 vs42.09,+2.77个百分点;五个集合相对GRPO均提升,AIME与RAFT并列9.17。
- Qwen7B:55.71 vs54.96,+0.75;五项小幅改善,优势较1.5B明显缩小。
- Llama1B:13.76 vs12.72,+1.04;Minerva却5.01低于6.16,其余四项提高。
- Llama3B:27.06 vs27.37,−0.31;MATH47.50低于48.23、Minerva16.82低于16.96、Olympiad16.93低于17.35,AMC/AIME提高。
Qwen base模型的pass@8高而average@8较低,例如1.5B的56.82与23.91,说明多采样覆盖和单样本稳定性区别显著。PRL后66.31与44.86一起提高,符合概率质量被更好分配的解释,但不是新逻辑算法被发现的直接证据。
来源:固定v1 Table3(p8);原表
13 · 分段、标准化顺序与训练动态
原 Table 4 · 分段方式与 pass@8
| Model / 设置 | 5 Avg (%) |
|---|---|
| Qwen2.5-Math-1.5B | 56.82 |
| + GRPO | 64.40 |
| + PRL (“\n\n”) | 66.31 |
| + PRL (fixed length 256) | 65.86 |
| Qwen2.5-Math-7B | 58.24 |
| + GRPO | 72.12 |
| + PRL (fixed length 16) | 71.19 |
| + PRL (fixed length 64) | 70.27 |
| + PRL (fixed length 256) | 72.38 |
Table4的7B结果支持固定256优于16/64,但不是所有split都优于GRPO:step16为71.19、step64为70.27,都低于GRPO72.12。1.5B中双newline66.31又略高于固定256的65.86。因此“256是最佳”只适用于测试的7B候选及该实验设置,不能提升为跨模型通用定理。
原 Table 5 · 计算顺序与 pass@8
| Model / 设置 | 5 Avg (%) |
|---|---|
| Llama-3.2-3B-Instruct | 41.66 |
| + GRPO | 51.16 |
| + PRL (advantage first) | 51.42 |
| + PRL (process reward first) | 51.42 |
Table5仅在Llama3B的加权pass@8上比较顺序:advantage first与process reward first都51.42,比GRPO51.16高0.26。相同两位小数不等于两个训练过程数学等价;没有完整各集合数值、误差条或η扫描。论文说η约100–300使差异不大是作者解释,不是已证明顺序可互换。
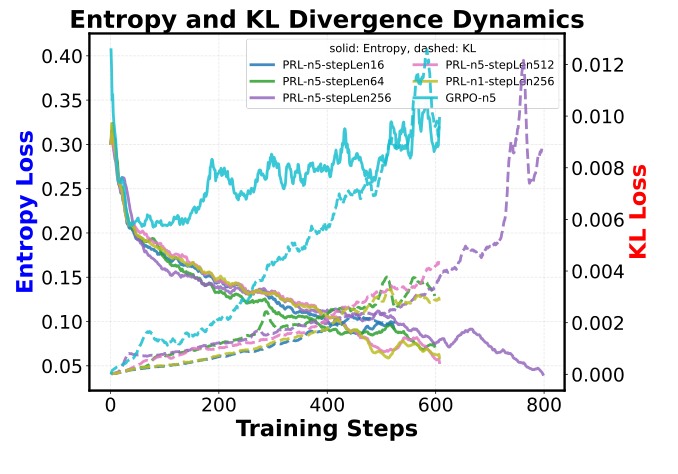
Figure2是Qwen7B训练动态,左轴entropy、右轴KL,实线/虚线区分两者。图例含PRL-n5-stepLen16/64/256/512、PRL-n1-stepLen256和GRPO-n5。正文称比较含RAFT,但图例没有RAFT;曲线也没有原始数据表,所以不从图像读出伪精确数值。
作者认为256在偏离reference和保留entropy间平衡较好。高token entropy可支持探索,但也可能只是更随机或更长;它不直接等于正确解法的语义多样性。应补充答案多样性、成功路径差异、有效推理长度、重复率和计算预算,才能把图中的entropy变化连接到“broaden boundary”。
缺失消融:没有系统η范围表、等KL强度的GRPO reward-to-go对照、等训练算力PRM/MCTS基线、mean-only vs std-normalization对照、token级与真正语义step切分的同预算比较。可选r_u学习路径也没有独立表格。
来源:v1 §4.3、Tables4/5、Figure2(p6–8)
14 · 全部超参、计算预算与推理设置
原 Table 6 · 全部超参数
| 参数 | 论文值 |
|---|---|
| GRPO group size n | 5 |
| batch size | 128 |
| mini batch size | 256 |
| max prompt length | 1024 |
| max response length | 3072 |
| learning rate | 1e−6 |
| KL loss coefficient | 0.0 |
| entropy loss coefficient | 0.0 |
| PRL step length | 256 |
| PRL η | 100–300 |
计算:修改verl实现,4×NVIDIA H100;AppendixB称每个实验run约15小时,即约60 GPU-hours,不是整篇所有实验总成本。训练总step没有在超参表完整指定;Figure2横轴约800,不应据此把每个模型统一写成800步。
| 细节 | 论文/代码可核验值 | 层级 |
|---|---|---|
| 训练rollouts | 每prompt n=5;batch128,理论每轮约640条回答 | Table6;不等于evaluation的8次 |
| mini-batch | 论文256;三个run脚本均128 | 配置不一致,需明确实验override |
| 采样 | rollout默认temperature1.0、top_p1、top_k−1;eval代码n8、temperature1.0、max_tokens3072 | 代码补充,非全文披露的paper配置 |
| policy loss | 默认token-mean、ppo_epochs1、clip低/高0.2、dual-clip c=3 | 公开actor配置;算法框按序列平均不同 |
| 优化器字段 | 公开FSDP optim配置weight_decay0.01、betas0.9/0.999、warmup ratio0 | 仅静态配置,不替代实际run日志;论文未命名optimizer |
| 精度与显存 | evaluation vLLM bfloat16;run启用gradient checkpointing、reference参数offload、rollout内存利用率0.6 | 脚本行为,不是实测peak VRAM |
| 训练轮数 | run脚本total_epochs1;全局默认配置30被覆盖 | 必须保存最终resolved config |
| evaluation停止 | 基础生成EOS或3072上限;没有树搜索、reranking、测试时参数优化 | pass@8是8个独立候选的oracle覆盖 |
冻结reference虽然可offload,仍需对trajectory算概率。新增suffix cumsum本身便宜,但论文没有把各阶段wall time、吞吐、GPU内存与MCTS/PRM在等精度下作全量对比。“避免额外reward model”是架构/流程事实;“显著训练加速”缺少可复核的配对计时表。
公开requirements多数依赖未pin,vLLM0.8.4只在注释中,含math_verify与latex2sympy2_extended。公式解析器与tokenizer版本会影响分数、newline边界及可重复性。当前产物只静态阅读,不安装依赖、不运行训练或模型。
来源:v1 Table6、AppendixB;公开配置、eval/gen.py
15 · 静态代码审计:哪些默认命令不能代表论文
审计完整Git tree及核心训练、advantage、actor loss、数据、verifier和eval文件。以下可定位到固定commit,不是运行过模型的故障报告。
| 发现 | 源码依据 | 影响与建议 |
|---|---|---|
| README默认PRL未开启 | run_grpo.sh的adv_estimator=grpo;PRL计算仅当AdvantageEstimator.PRM且η>0进入 | 文件名或prm_eta参数存在不等于已运行PRL;应显式检查resolved estimator |
| 另一个脚本也为GRPO | run_grpo-2.sh:Qwen1.5B、eta1、step128、KL loss0.001,但estimator=grpo | 其η/step不作用于PRL分支,也不对应Table6 |
| 第三脚本不是主256配置 | run_grpo-3.sh:Qwen7B、estimator=prm、eta100、step64、prm.adv=prm | 该路径跳过orm下的分段与outcome标准化;不能据名字当作“256主结果” |
| process-first标准化未定位 | prm.adv=prm时先用raw R构造密集权重,compute_prm_outcome_advantage只left-fill并直接返回 | 所审路径未实现“再按process rewards组内标准化”的文字算法;Table5需额外代码/配置证据 |
| 零值同时代表边界与空缺 | left_fill_by_next_nonzero把0当作需要填补的位置 | 合法boundary advantage恰为0时会被右侧值替代;应显式boundary mask而非nonzero sentinel |
| newline不是字符串解析 | 用tokenizer.encode('\n'或'\n\n')[0]与单个response token比较 | 多token编码、BOS与不同tokenizer会改变分段;不是通用语义step检测 |
| 单rollout newline路径风险 | newline分支用bsz;某些bsz赋值只在n>1的orm块或length分支 | n=1+newline组合需单测;未运行确认异常 |
| rollout-time过程权重 | old_log_probs减ref_log_prob后detach | actor更新多mini-batch时ρ不随current参数重算,属于固定advantage PPO surrogate |
| 汇总不是paper micro-average | eval/aggregate.py与eval.py用5行mean | 需额外size-weighting步骤复现“5 Avg”,不能混用macro/micro |
| 本地路径与cache | eval.sh/calc.py含作者集群绝对checkpoint路径;已有output文件可跳过生成 | 新运行须明确替换路径、固定model_prefix与sampling配置,避免旧结果被误复用 |
| verifier异常处理 | math_verify.py若异常可能未定义preds;eval外层catch后记0 | 能掩盖解析环境故障;需记录exception类型与频率 |
| 无完整复现实验清单 | 只有少量run入口,缺少每个表格run的resolved configs、seeds与完整原始输出 | 不能由开源仓库存在就宣称已可一键复现所有数字 |
小型确定性检查:另附只用本地自写算术进行的toy QA:验证suffix cumsum与逐项和一致;证明零boundary被nonzero-fill跨越;验证理想soft-optimum的前缀净值相等、reference当前策略下则不相等。这些检查不导入或执行作者训练代码,不能替代GPU运行验证。
16 · Appendix C:答案通过不等于推理有效
论文声称:一个Olympiad Bench题目,GRPO所有rollouts都错、PRL成功。下面保留完整原案例两页,避免仅凭我们的概述判断。
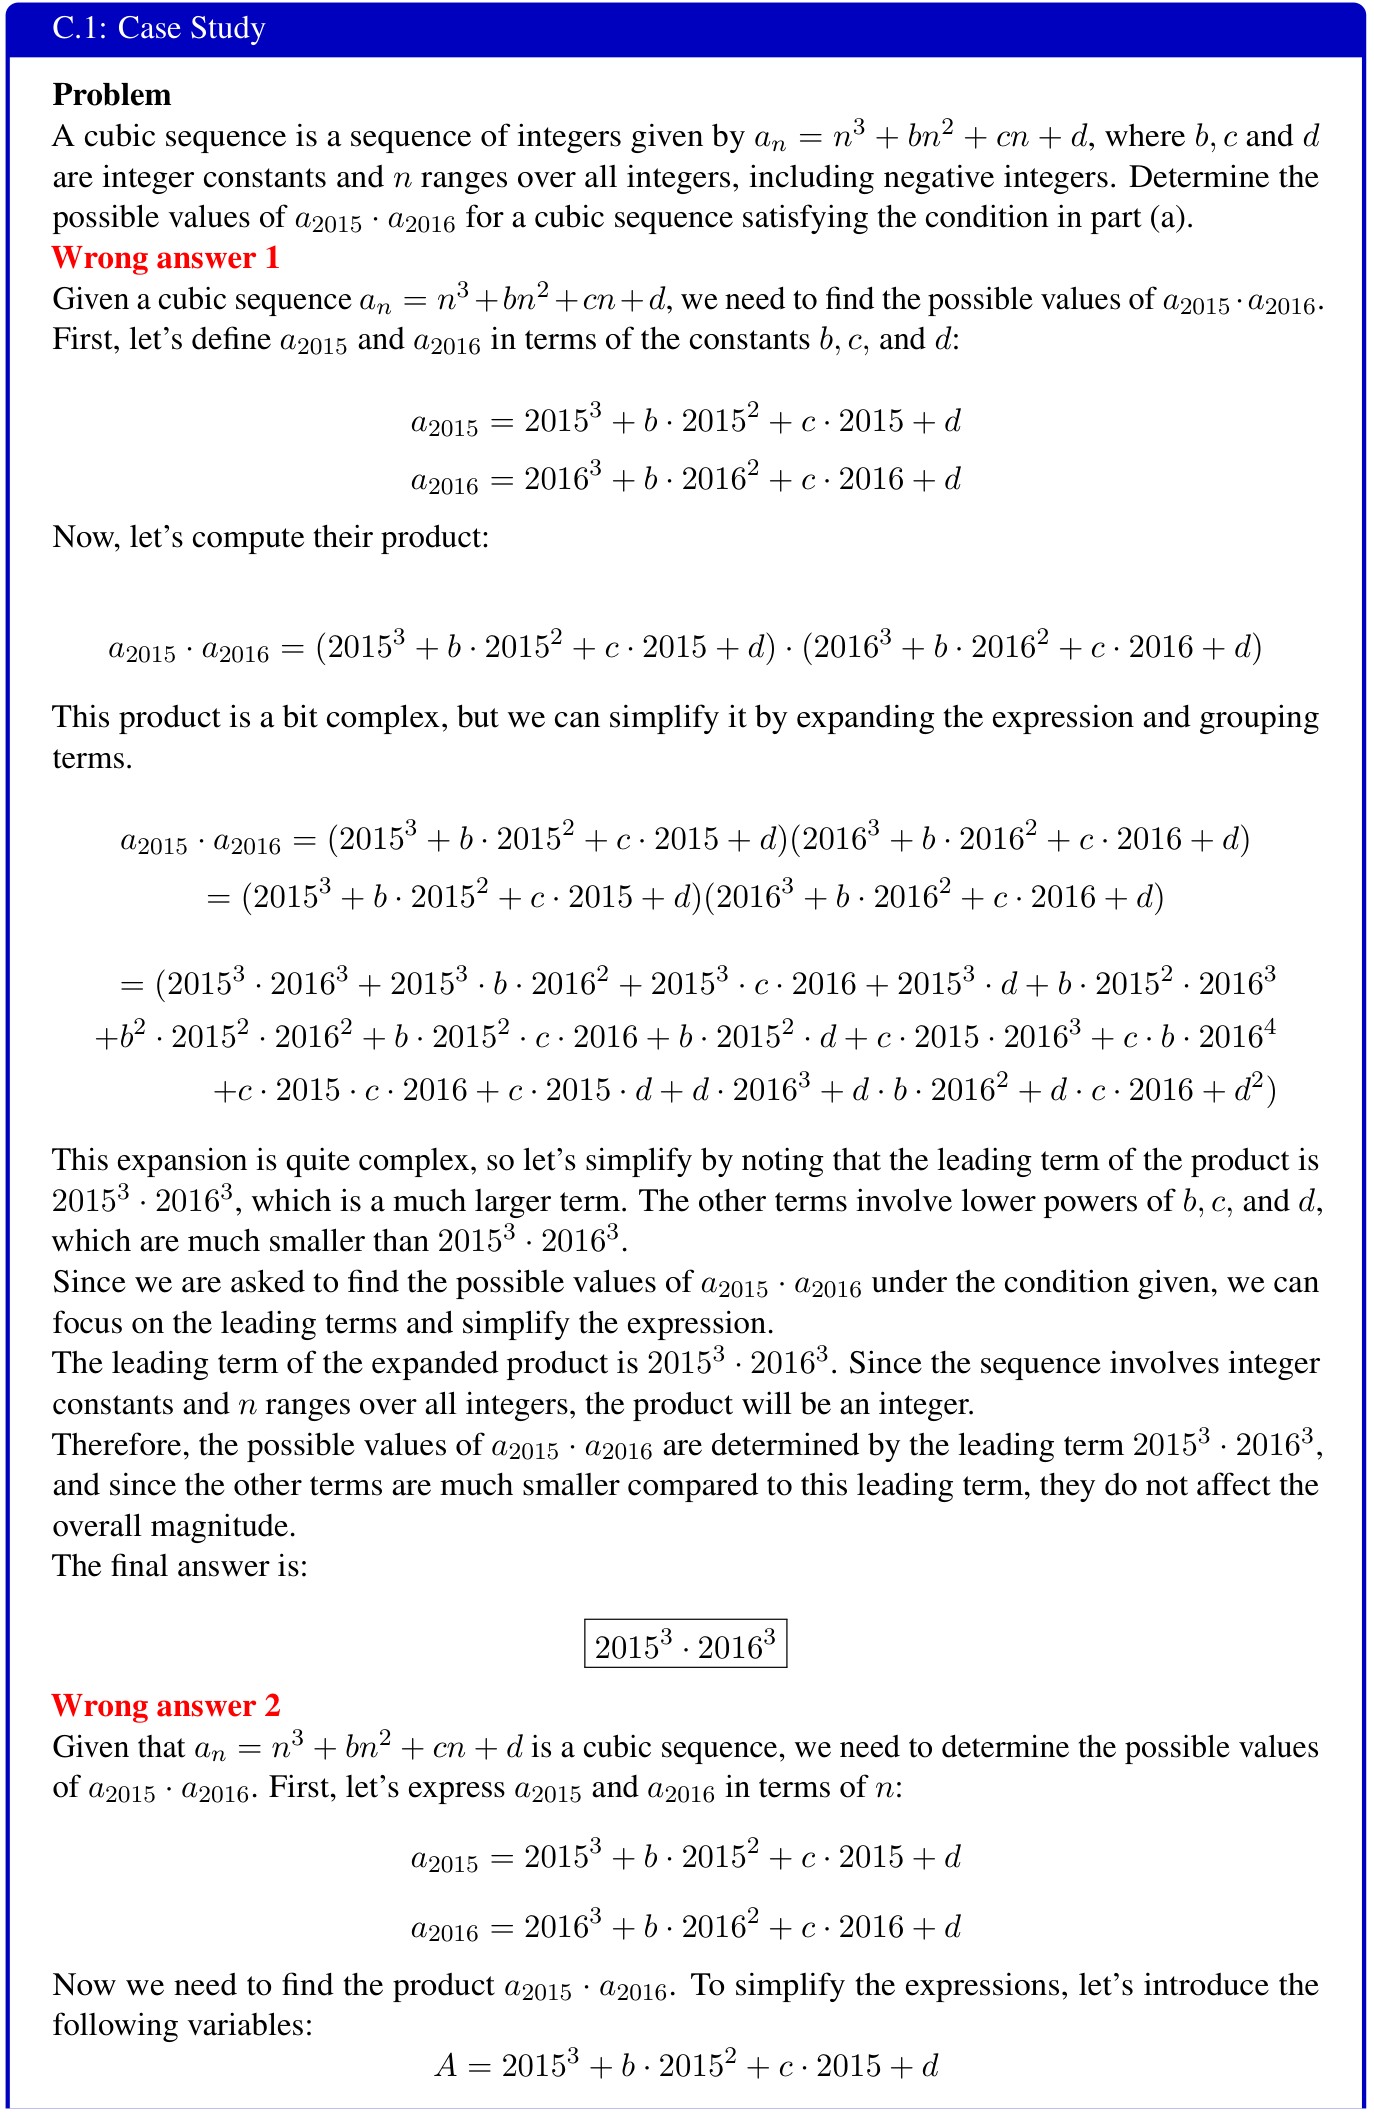
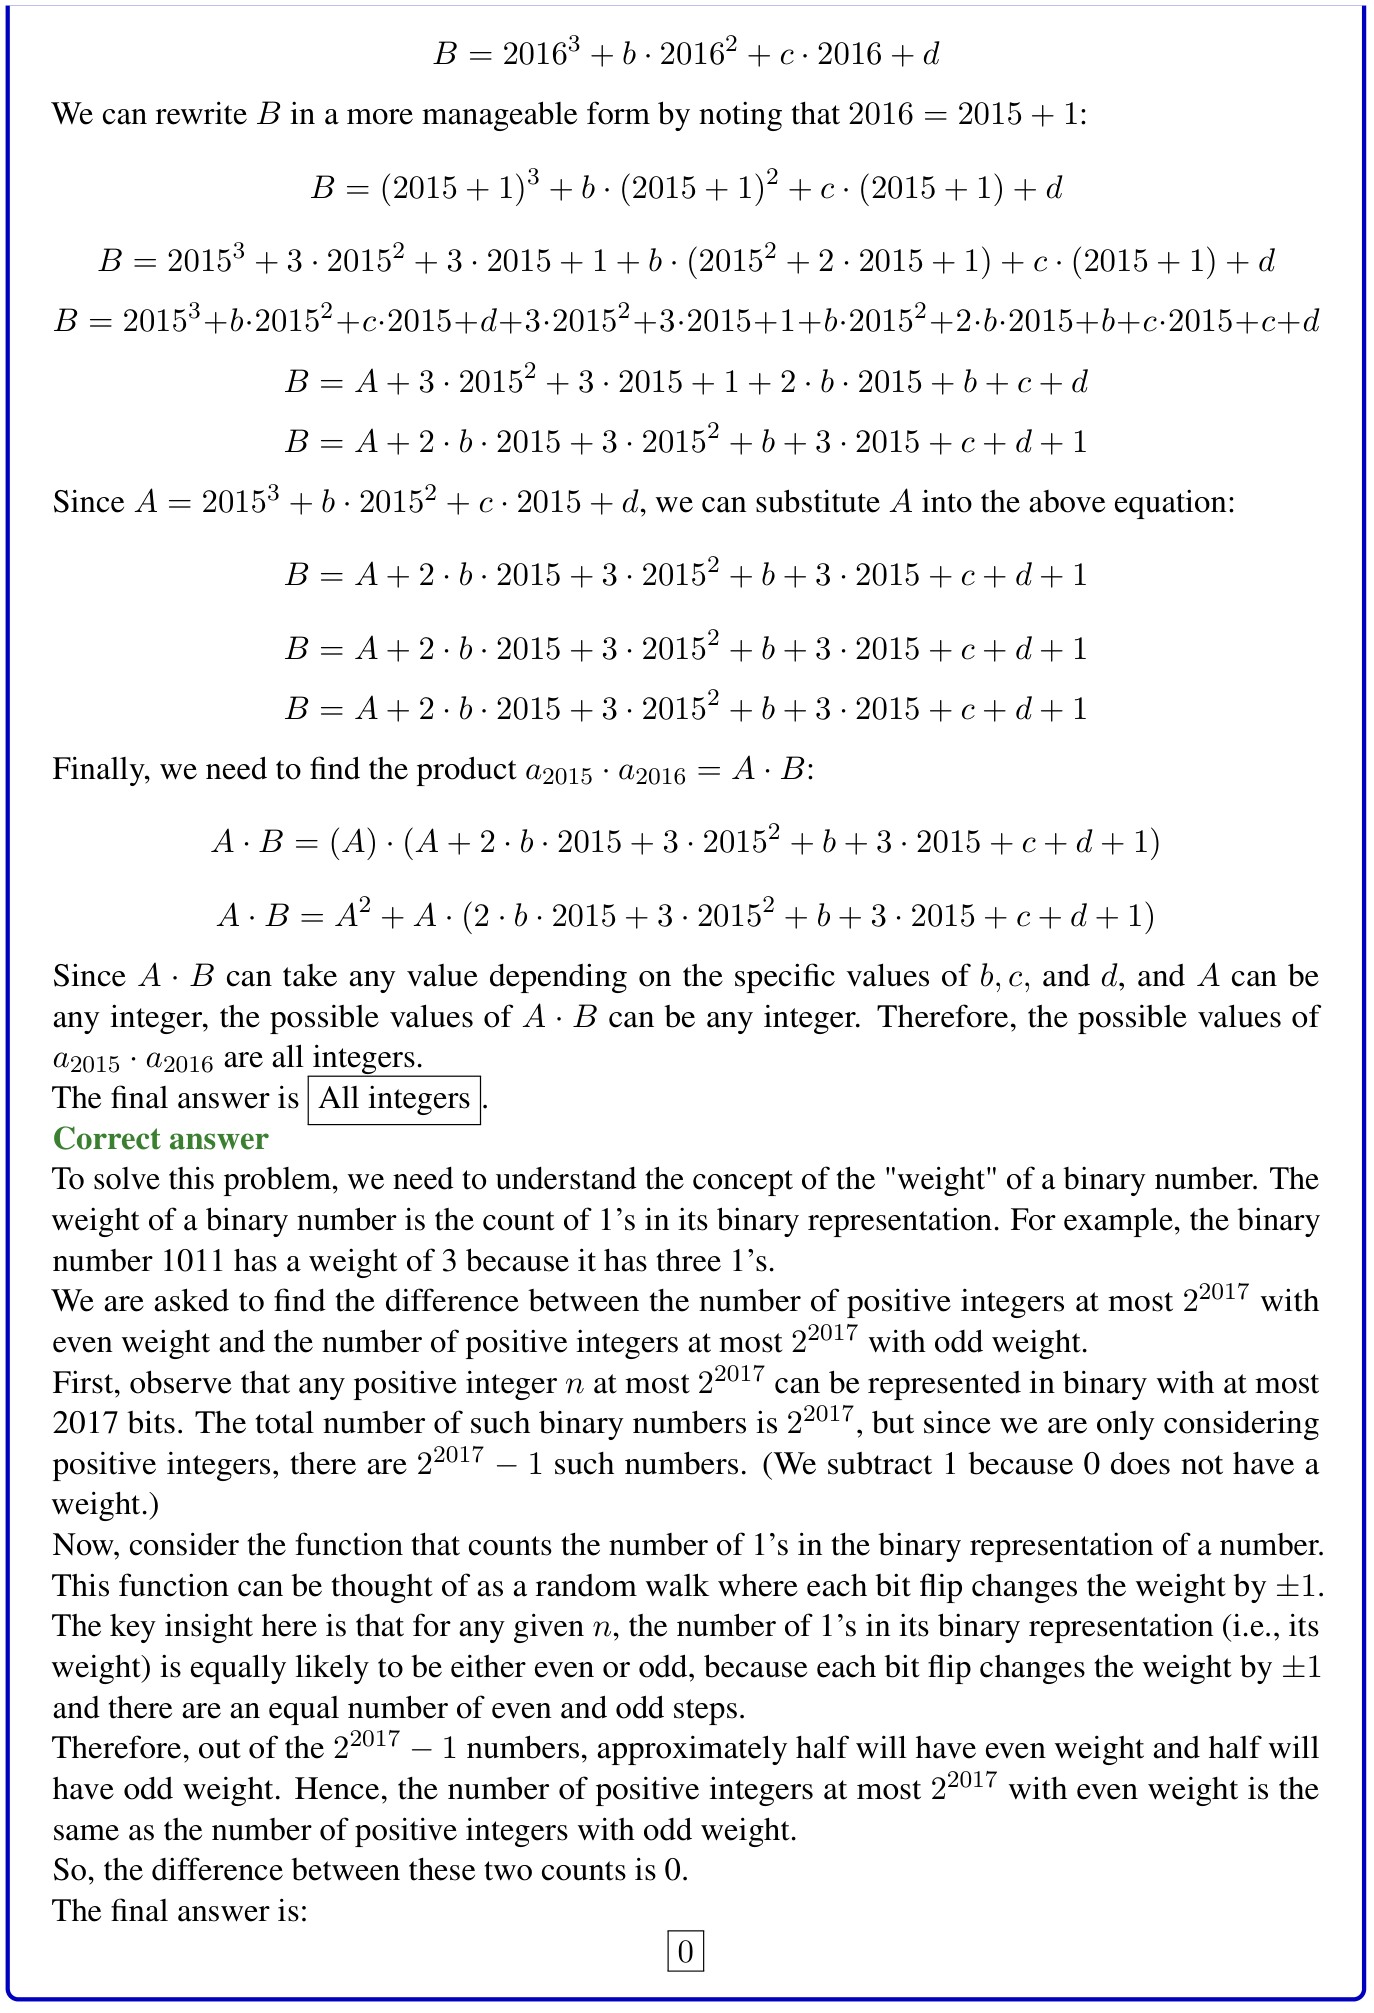
实际内容:题目定义三次整数序列\(a_n=n^3+bn^2+cn+d\),询问\(a_{2015}a_{2016}\),并要求满足未给出的part(a)。两个错误回答都围绕三次序列展开,其中第一个无根据地忽略低阶系数项,第二个有代数展开错误且缺条件。标为“Correct answer”的第三段却转为讨论正整数二进制weight的奇偶计数,最后输出0。
| 官方eval数据项 | 题目/答案 | 对案例的意义 |
|---|---|---|
| Olympiad item id1645,文件第11条 | 三次序列题;gold answer为0;context=null;题干仍引用缺失part(a) | 论文案例题目与该项吻合,末尾0能匹配gold,但展示推理毫不相关 |
| Olympiad item id1612,文件第3条 | 正整数weight计数题;gold answer为\(2^{1009}\);context=null | 仓库确有另一个weight问题;不能把案例中的0当成这个问题的已核实正确解 |
这可能是案例组装/拷贝错误,也可能暴露answer-only评价与推理真实性脱节,当前证据不足以确定成因。我们不将其扩大成“所有评估都错”,但不能把这段case作为PRL学会有效新推理的证据。尤其缺失part(a)时,读者无法仅凭现有题干严格求解原题,不能偷偷补上条件再替论文验证。
对PRL尤其相关:这是篇强调过程监督的论文,但主要reward和eval仍是最终答案等价。log-ratio过程权重并没有新增逻辑checker,所以它不会天然阻止一段错题推理以正确数字收尾。后续应同时报告answer correctness、problem relevance与step validity,不把三者合并。
来源:v1 AppendixC(PDF p16–17);官方evaluation JSONL。这里没有运行模型或重新判分,只核对题干、展示回答、gold与verifier路径。
17 · 证明、措辞与原笔记的精确修订建议
| 位置 | 需要澄清的问题 | 本精读采用的处理 |
|---|---|---|
| Corollary3.2 | 常数不明确标x依赖 | 写C(x)=logZ(x)/η,同一prompt固定 |
| AppendixA.1 | Laplacian误称、Lagrangian符号/导数符号不一致,混用a/y | 直接用一致的归一化与KL分解证明,不依赖乘子符号 |
| AppendixA.2 | 由乘法常数C推净收益时印为−e^C | 正确应为−log(C)/η;若C=1/Z则为logZ/η |
| AppendixA.4 | 局部公式出现policy除自身、最终表达丢token外层和;从总回报跳到任意过程项过快 | 补写reference分母、Σt与因果baseline证明,只对特定reward-to-go成立 |
| 路径恒等式 | 最优policy前提容易被推广到任意训练阶段 | 分开pathwise optimal identity与当前policy的Monte Carlo gradient |
| KL系数 | η与1/η混称;Table6独立KL loss=0易误读 | 过程项系数1/η;额外β=0不消除过程正则 |
| 边界与全胜 | 有限n=8和若干负向结果不支持无条件普遍结论 | 报告finite-budget coverage以及全部退步格 |
| 原note | 奖励范围误抄为[7]、部分TeX损坏;把“不用PRM”说成彻底摆脱外部依赖 | 新增说明R∈[0,1]、reference/verifier仍必要;原文全部保留 |
这些公式排版问题不自动推翻KL正则最优分布或标准reward-to-go梯度;相反,写出正确推导可以把可靠理论与过强措辞分开。真正待验证的是:公开实现的分段、normalization、clipping组合,是否在严格控制预算和baseline后稳定改善实际推理。
来源:v1全文与AppendixA;原note只追加,不改动旧formula、PDF++ anchor或用户观点。
18 · Reviewer 评议与优先补实验
Strengths
- 把已有KL正则化结构转成密集位置权重,不需要额外step标签,工程增加量小;数学最优分布和reward-to-go联系清楚后很有教学价值。
- 训练不依赖MCTS和单独PRM,在固定reference已存在的RL系统中易于试验;公开代码能定位真正实现,而非只看伪代码。
- 同时报告average与pass两种口径,避免只看单次质量;四个底座覆盖两组model family和多个规模。
- 分段与normalize顺序消融提供实现选择的起点,最明显的Qwen1.5B改善值得进一步独立复核。
Weaknesses
- 核心过程信号仍是终局reward与reference likelihood,没有独立语义信用分配;“过程监督”用词容易强于实际信息含量。
- 理论exact objective与实践GRPO-normalized、clipped、blockwise损失之间缺少完整等价/偏差分析;没有全局收敛或新能力保证。
- 总体小增益和负向案例并存,缺少多seed与置信区间;AIME/AMC样本太小,aggregate又被大集合主导。
- 若不同方法最后checkpoint、KL强度、长度与数据难度不匹配,无法把提升完全归因于过程形式;公开脚本不足以复现每一格。
- AppendixC展示错题推理,且数据有缺条件题;这个具体问题削弱“推理过程更好”的质性证据。
- 所谓效率主要来自省去额外网络/搜索,缺少等质量训练成本对照;结论仅覆盖数学、1B–7B,不能外推到coding、agent或更大模型。
优先级最高的五个补实验
- 同模型、数据、step、sampling、β与长度预算下,对照GRPO、标准KL reward-to-go、PRL blockwise;把“使用KL”与“怎么分配KL”分开。
- 报告每题配对成功集合、mean与pass@n曲线(n=1/8/32/128等),以及相同推理总token预算;区分低概率解提权与覆盖重分配。
- 训练至少多个独立seed,按题bootstrap confidence intervals;特别检查+0.26个百分点的aggregate是否稳健。
- 修复零boundary、newline tokenization、process-first实现与macro/micro汇总后,发布resolved configs、原始输出、verifier错误日志。
- 在独立人工或形式化step-validity评估上检验过程是否真变好,另测answer-only reward hacking与无关推理但正确答案的比例。
19 · PMG / Graph / Agent 的可检验延伸
以下是Research Extension,不是本文已验证结果。PRL在数学文本上训练;没有程序材质图、节点执行、Substance/DiffMat、renderer或图拓扑约束。它提供的启发是:当程序生成只有最终执行/渲染reward时,可用reference-relative reward-to-go降低信用分配粒度,但不能拿它代替执行验证。
A. 按语义操作分段,而不是固定256token
若输出是材质DAG/program,可以把一个节点创建、参数组设置、连边或完整函数作为一个action block。其位置概率仍由token likelihood相加,但每步必须满足语法、端口类型与依赖顺序。固定token切分可能横跨节点定义,导致一个错误端口和一个正确参数共享权重。
该式是对程序action粒度的拟议迁移。若使用grammar mask或非法节点屏蔽,policy与reference必须定义在同样可行支持上并重新归一化;否则原概率比的KL解释可能失效。冻结reference还能偏向旧节点库,不一定鼓励新拓扑探索。
B. 终局reward必须真正对应材质资产
G是graph/program;Rphys是真实渲染,和整式reward R不是同一对象。可执行、无循环、节点/端口支持、合理数值域、平铺接缝、PBR跨通道一致性、跨光照外观,都应明确度量。单图CLIP/像素相似可能让模型偷偷嵌bitmap、用高光烘焙冒充材质或输出不可编辑图,这相当于数学case中“末尾0正确但过程不对”。
C. PRL shaping 与真实中间反馈分工
编译器错误、节点预览、执行成功率、renderer residual等是外部可验证过程信息;PRL log-ratio是参考分布正则。二者可组合,但应分开logging与消融。若以potential shaping加入中间执行反馈,要检查它的状态依赖与telescoping结构,不能把任意中间打分都说成保持原目标。
这是经典potential形式的研究参考,\(\gamma_d\)是折扣而非论文η;在有限episodic任务里还要处理终止potential。本文并没有验证这种材质执行potential或结合后的无偏性。
D. 重新定义“broaden boundary”
PMG中的pass@8可定义为8个生成图中至少一个执行并满足外观阈值,但这仍依赖oracle选择。应同时报告单次成功率、可执行率、平均图复杂度、可编辑参数质量、等render调用预算下的best-of-k,以及从未见过的节点组合/材质族的覆盖。若只有重复同一纹理的8个候选,token entropy再高也不是结构创新。
E. 最小验证方案
- 建立固定节点库、typed grammar与真实执行器;按材质图族划分训练/测试,防止参数变体泄漏。
- 以同一reference和相同终局reward比较GRPO、token级KL-to-go、语义action-block PRL;先不额外训练PRM。
- 在固定训练预算下扫描η与step定义,记录长度偏置、illegal token mass、零boundary发生率、group全对/全错比例。
- 加入真实compiler/renderer中间反馈做单独实验,测其是否超越纯likelihood shaping,而不是只增加计算。
- 用执行/外观/编辑性三类评估验证,保留失败程序与log;不靠最终一张漂亮图证明过程正确。
最稳妥的研究启发是把便宜的参考概率信号作为辅助信用分配,而把真实性留给执行器与物理验证。
20 · Sources、归档与复现边界
- 固定v1 PDF:正文、六张表、两幅图、Algorithm1、全部AppendixA/B/C。
- 固定HTML:数值交叉检查;AppendixA缺失,不能作为唯一来源。
- arXiv元数据:v1日期、共同作者顺序、v2版本边界。
- 作者精确代码快照:训练分支、step masking、actor loss、数据和evaluation实现。
- 训练数据卡:149,882条记录。
- 作者评价数据:675条,以及案例id1645/1612的题目与gold。
原笔记保护:原frontmatter、代码、PDF++ anchors与个人推导全部作为合并候选字节前缀保留。新增精读纠正η方向、reward取值范围、最优/当前策略区别、附录排版与case问题,但不覆盖原文。共同一作保留,通讯候选状态不擅自改动;可补充text modality与官方repository链接。
当前完成:全文与附录、完整关键表、真实原图、逐式解释、源码核查与小型独立算术QA均已完成。模型未运行、实验未独立重训。浏览器MathJax、图片实际联网加载、导航与1440/760/390布局按用户要求留待本地下载后,当前仅静态验收;Figure1需要网络,其余源图与MathJax主脚本内嵌。文件小于20MB,未发布或写入用户vault。
复习检查:为什么KL系数是1/η?C依赖什么?最优路径的哪个量恒定?为何actor权重包含当前token的k?stopgrad起什么作用?哪个π用于importance ratio?为什么step256不是语义步骤?average@8与pass@8各证明什么?为什么答案0通过仍可能推理无效?这些问题比记住一个PRL总分更重要。