01 · DietNeRF 究竟给 NeRF 加了什么
普通 NeRF 只能在有照片的相机位置检查像素是否正确。只有少量视图时,它可以记住照片,却在没见过的位置产生遮挡、漂浮物和错误几何。DietNeRF 用预训练图像编码器检查新视角是否仍“像同一个东西”,把监督扩展到没有对应真值照片的相机位置。

- 八视图从零训练:NeRF 合成场景平均 PSNR 从 14.934 到 DietNeRF 23.147,再以 MSE 微调达 23.591。
- 单视图:基于已在多视图数据预训练的 pixelNeRF 再优化,而不是普通 NeRF 从一张图就恢复真实三维。
- 核心代价:语义合理、纹理锐利可以改善,但不保证隐藏几何正确;单视图 DTU 的 PSNR/SSIM 实际下降。
精读基准:用户原始 arXiv 2104.00677v1,2021-04-01,15页,包括 Appendix A–D。固定 PDF · 同版本 HTML · 官方项目页
02 · 身份、版本与适用范围
作者 Ajay Jain、Matthew Tancik、Pieter Abbeel,机构 UC Berkeley。官方项目页确认后续发表于 ICCV 2021,5885–5894 页;本次指标和附录以用户持有的 v1 为准,不把后续会议版本与 v1 无标注混合。原笔记 venue 为 arXiv preprint,可在人工整合时补充正式发表信息。首页列三人邮箱,未明确单列通讯作者,原来的 Pieter Abbeel unverified 不擅自升级。
输入是带相机姿态的照片。DietNeRF 没有解决未知相机标定;相机内外参应已知或由既有流程获得。输出是可从新相机渲染 RGB 的辐射场,不直接输出可编辑材质图或可靠闭合网格。颜色可依赖视向以表示高光,但不是显式光照与 BRDF 分解,所以不能直接拿来做物理材质重打光。
必须区分两条路径:DietNeRF 每场景从零优化,使用冻结的二维图像语义先验;DietPixelNeRF 从跨场景多视图预训练的 pixelNeRF 出发,再用单张输入进行场景适配。后者额外拥有三维训练先验,单图结果不能作为前者无需多视图训练的证明。
03 · 背景公式与少视图歧义
辐射场 \(f_\theta(\mathbf x,\mathbf d)=(\mathbf c,\sigma)\) 把空间位置和观察方向映射为颜色、体密度。\(\mathbf x\in\mathbb R^3\),单位方向 \(\mathbf d\) 对应两自由度,\(\mathbf c\in\mathbb R^3\),密度 \(\sigma\) 只依赖位置。光线 \(\mathbf r(t)=\mathbf o+t\mathbf d\) 从近界 \(t_n\) 积分到远界 \(t_f\):
这是原 Eq.1 与透射率定义的标准清晰写法。粗网络定位重要采样区域,细网络在追加样本上积分;可微渲染让像素或语义损失通过颜色、密度回传给 MLP。正弦位置编码让网络拟合细节,也给了它拟合错误近场结构的能力。
分别对应原 Eq.2/3;\(H,W\) 是图像尺寸,\(\mathcal R\) 是已知视图中抽样的射线集合。不同视角的同一像素位置通常不是同一表面点,所以不能直接对两张不同姿态图做像素 MSE 来强迫一致。

少视图时,训练光线只检查有限空间,模型可以把照片贴在各相机附近:从原位置看误差很小,绕过去却变成漂浮遮挡。Simplified NeRF 减少高频编码、去掉分层细网络、调低学习率并必要时重启,能抑制退化,却也丢失纹理。完全没见过的物体背面则缺少观测证据,需要先验给出“可能的”补全,不可能凭空保证真实。
04 · 语义一致性及必须修正的符号方向
令 \(\phi\) 是预训练视觉编码器,输入真实图 \(I\) 和任意相机的新渲染 \(\hat I\)。原 Eq.4 为
如果 \(\phi\) 为恒等映射,就退化为像素距离,需要图像对齐。有效的编码器要保留物体身份、组成、颜色等高层信息,又对相机变化较稳定。作者比较语言监督的 CLIP ViT 与 ImageNet 分类预训练 ViT,训练时仅用图像分支。
对单位特征 \(\mathbf u,\mathbf v\),展开平方可得:
v1 原 Eq.5 写成正的 \(\lambda\phi(I)^\top\phi(\hat I)\),但若 \(\lambda\gt0\) 并最小化它,就会降低相似度,方向与 Eq.4 和方法目的相反。可执行的最小化目标应是负余弦(或者 1−余弦);公开代码也明确计算 negative cosine,并使用正权重 0.1。本精读把原文印式和推导后的实现式分开,不默默照抄错误符号。
固定真实图特征不需要梯度;新渲染一侧必须保留计算图,梯度穿过视觉编码器回到渲染器与 NeRF。编码器不加入 NeRF 优化器,不代表可以对整个编码过程使用 no_grad,否则训练信号会断掉。冻结权重与禁止输入梯度是不同操作。
05 · 为何二维 CLIP 能跨视角工作
CLIP 在大量图文对上学到兼顾语义与视觉属性的表示。文本描述通常不精确依赖相机位置,“推土机”和“带番茄酱的热狗”等概念在不少视角下稳定。ViT 把图像切成非重叠 patch,以全局自注意力聚合表征。因此它不是几何对应器,却能当作物体身份与外观的弱约束。
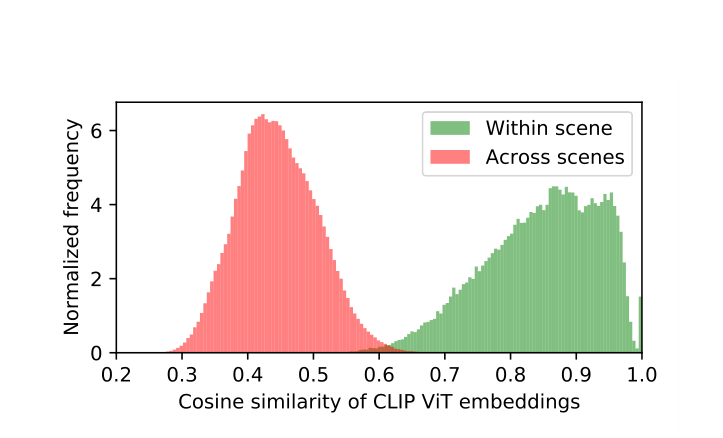
原 Figure 3 比较同场景与不同场景的特征余弦分布:同一对象即使相机差异大,特征仍比较接近。附录 Figure 8 更细致地按八场景的所有组合画相机原点距离与特征相似度,6/8 场景仍表现出一定姿态依赖。故“语义不变”只是近似,不能写成严格视角不变量。

这种先验也有盲点:局部部件位置、厚度或遮挡可以改变,而全局语义仍相近;模型可能造出“看起来像这一类”的错误背面。匹配图像特征比类别标签包含更多外观信息,但仍低于恢复完整几何所需约束。编码器更大不一定更好,后续消融实际支持的是特定预训练和架构组合。
06 · 训练算法与姿态分布
- 给定带姿态集合 \(\mathcal D=\{(I_i,p_i)\}\)、编码器 \(\phi\)、姿态分布 \(\pi\)、间隔 \(K\) 和损失权重,初始化场景 NeRF;预计算每张真实图的特征。
- 每一步从已知相机抽像素射线,体渲染后算 MSE,保留细/粗网络的监督。
- 每隔 \(K\) 步,从真实输入随机抽一张目标图,从 \(\pi\) 抽一个新相机,渲染低分辨率完整视野,计算语义损失。
- 总损失回传,用 Adam 更新 NeRF 参数;相机和预训练语义模型不由该优化步骤联合学习。
- 达到主训练预算后,可去掉语义项,仅在原视图继续 MSE 微调,改善细节但需防止再次过拟合。
上式是原 Algorithm 1 的紧凑表达。目标照片和新相机没有一一配准关系;每次抽不同目标,鼓励新视角保留共同语义,不强迫每个像素复制一张输入。
有界合成对象使用上半球相机与有限半径范围。前向、无界或难以定义环绕分布时,论文提出在三个已知相机之间随机插值,用两个均匀权重。姿态分布决定“未观测监督”覆盖哪些地方:若抽到物体内部、背离对象或空场景,语义目标并不自动有效。它不是任意未知相机都能无条件使用的先验。
07 · 原论文设置与公开代码核查
原论文对 NeRF、Simplified NeRF 和 DietNeRF 主训练统一 Adam、200k 步,使用 400×400 图(原始 800×800 的半分辨率)。Neural Volumes 用 800×800 训练,输出以 2×2 box filter 降到 400×400 再评分。语义渲染只用约完整图 15–20% 的射线,保留全视野的网格抽样,间隔 10–16 步,采用混合精度及反向重计算降低显存。报告单卡 V100 16GB 或 2080Ti 11GB。
| 核查项 | 官方代码快照中的具体设置 | 阅读意义 |
|---|---|---|
| 网络 | 默认8层、宽256,位置编码10级、方向4级;coarse64+追加fine128采样 | DietNeRF并非靠缩小模型实现 |
| Lego八图配置 | 每步1024射线,初始学习率默认5e−4,衰减参数500;前500步中心crop,比例.5 | 配置覆盖默认值,应读实际配置而非只读参数帮助 |
| 语义视图 | 168×168渲染,再双线性缩放224×224编码;每10步,光线jitter开启 | 168²/400²=17.64%,符合论文范围 |
| 相机范围 | theta[-180,180],phi[-90,0],半径[3.5,4.5] | 代码分别均匀采样角度与半径,并非严格的球面面积均匀分布;不是所有场景通用 |
| 损失 | fine和coarse的负余弦权重各.1,随机一个目标CLS特征 | 确认原Eq.5缺少负号的实现方向 |
| 语义特征 | 官方CLIP fork返回token序列,run_nerf.py取CLS;使用CLIP归一化 | 不要随意换成文本编码或均值patch特征 |
| 微调配置 | 从200000.tar恢复,consistency_loss=none,N_iters=400000 | 代码覆盖最长继续200k;表1最佳微调50k是中间检查点,不代表必须跑到最后最好 |
以上来自 官方仓库固定提交 ae5d7b4… 的 run_nerf.py、CLIP fork、几何函数与两个 Lego 配置,只做源码审计,没有安装依赖、下载模型或重跑训练。仓库树包含合成场景实现;本次未发现独立发布的 DietPixelNeRF/DTU 训练入口,因此单视图路径仍有复现交付缺口。README 的批量脚本假设服务器有8张GPU,与论文“单个实验使用单卡”不矛盾。
原 Table 6
| Scene | LR | View dep. | Fine | Coarse | Max freq. |
|---|---|---|---|---|---|
| Full NeRF | \(5\times 10^{-4}\) | ✓ | 128 | 64 | \(2^{9}\) |
| Lego | \(5\times 10^{-5}\) | ✓ | ✗ | 128 | \(2^{5}\) |
| Chair | \(5\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{5}\) |
| Drums | \(5\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{5}\) |
| Ficus | \(5\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{5}\) |
| Mic | \(5\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{5}\) |
| Ship | \(5\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{5}\) |
| Materials | \(1\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{5}\) |
| Hotdog | \(1\times 10^{-5}\) | ✗ | ✗ | 128 | \(2^{3}\) |
原 Table 6 保留每场景 Simplified NeRF 参数:只有 Lego 保留视向依赖,细网络均去掉,学习率从 full 的 5e−4 降至 5e−5 或 1e−5,最大位置频率由 2⁹ 降到 2⁵,Hotdog 更低为2³。该基线逐场景调参、必要时手工重启,是为避免故意设置弱基线,但也增加复现的人工作用。
08 · 数据、划分与评价口径
Realistic Synthetic 有8个对象,每对象100张训练图,从中随机抽8张,无人工精选;另外 Lego 隐藏区域实验人工选14张主要在右侧的图。DTU 使用 pixelNeRF 原工作的同一源视图,在15个测试场景上做单图适配;原任务排除阴影过重的评价姿态,这里跟随相同规则。

| 指标 | 测什么 | 使用时的边界 |
|---|---|---|
| PSNR ↑ | 像素MSE的对数尺度 | 位置准确但模糊可能胜过锐利却略错位 |
| SSIM ↑ | 局部结构相似性 | 不是人类感知偏好的完全替代 |
| LPIPS ↓ | 预训练VGG多层特征差 | 仍逐图对齐比较,与全局语义不同 |
| FID ↓ | Inception特征集合高斯近似分布差 | 小样本有偏,不是某个相机的重建误差 |
| KID ↓ | Inception特征集合的核MMD估计 | 估计无偏不等于样本少时低方差 |
合成场景 FID/KID 用全部划分、全部场景的3200张真图,与200张测试渲染(每场景25张)比较;NV因代码设置使用额外生成样本。DTU用15场景各48张、共720张渲染,与124个训练和验证场景各49张、共6076张真图比较。它们衡量总体视觉分布,不能解释成单一对象隐藏侧的真实重建准确性。为单场景 Lego 实验不报FID/KID是有意避免样本不足。
09 · 八视图:完整主表与分场景结果
原 Table 1
| Method | PSNR \(\uparrow\) | SSIM \(\uparrow\) | LPIPS \(\downarrow\) | FID \(\downarrow\) | KID \(\downarrow\) |
|---|---|---|---|---|---|
| NeRF | 14.934 | 0.687 | 0.318 | 228.1 | 0.076 |
| NV | 17.859 | 0.741 | 0.245 | 239.5 | 0.117 |
| Simplified NeRF | 20.092 | 0.822 | 0.179 | 189.2 | 0.047 |
| DietNeRF (ours) | 23.147 | 0.866 | 0.109 | 74.9 | 0.005 |
| DietNeRF, \(\mathcal{L}_{\text{MSE}}\) ft | 23.591 | 0.874 | 0.097 | 72.0 | 0.004 |
| NeRF, 100 views | 31.153 | 0.954 | 0.046 | 50.5 | 0.001 |
微调版相对原始八图 NeRF,PSNR +8.657、LPIPS −.221、FID −156.1(本精读按表直接相减)。与更强的 Simplified NeRF 比,PSNR仍+3.499、LPIPS−.082。100图 NeRF为参考上限条件,输入预算不同,不能把它列为同成本公平对手;DietNeRF仍明显落后其PSNR与SSIM,不能写成八图等于百图。

原 Table 7
| PSNR \(\uparrow\) | Lego | Chair | Drums | Ficus | Mic | Ship | Materials | Hotdog |
|---|---|---|---|---|---|---|---|---|
| NeRF | 9.726 | 21.049 | 17.472 | 13.728 | 26.287 | 12.929 | 7.837 | 10.446 |
| NV [28] | 17.652 | 20.515 | 16.271 | 19.448 | 18.323 | 14.457 | 16.846 | 19.361 |
| Simplified NeRF | 16.735 | 21.870 | 15.021 | 21.091 | 24.206 | 17.092 | 20.659 | 24.060 |
| DietNeRF (ours) | 23.897 | 24.633 | 20.034 | 20.744 | 26.321 | 23.043 | 21.254 | 25.250 |
| DietNeRF, \(\mathcal{L}_{\text{MSE}}\) ft (ours) | 24.311 | 25.595 | 20.029 | 20.940 | 26.794 | 22.536 | 21.621 | 26.626 |
| NeRF, 100 views | 31.618 | 34.073 | 25.530 | 29.163 | 33.197 | 29.407 | 29.340 | 36.899 |
| SSIM \(\uparrow\) | Lego | Chair | Drums | Ficus | Mic | Ship | Materials | Hotdog |
| NeRF | 0.526 | 0.861 | 0.770 | 0.661 | 0.944 | 0.605 | 0.484 | 0.644 |
| NV [28] | 0.707 | 0.795 | 0.675 | 0.815 | 0.816 | 0.602 | 0.721 | 0.796 |
| Simplified NeRF | 0.775 | 0.859 | 0.727 | 0.872 | 0.930 | 0.694 | 0.823 | 0.894 |
| DietNeRF (ours) | 0.863 | 0.898 | 0.843 | 0.872 | 0.944 | 0.758 | 0.843 | 0.904 |
| DietNeRF, \(\mathcal{L}_{\text{MSE}}\) ft (ours) | 0.875 | 0.912 | 0.845 | 0.874 | 0.950 | 0.757 | 0.851 | 0.924 |
| NeRF, 100 views | 0.965 | 0.978 | 0.929 | 0.966 | 0.979 | 0.875 | 0.958 | 0.981 |
| LPIPS \(\downarrow\) | Lego | Chair | Drums | Ficus | Mic | Ship | Materials | Hotdog |
| NeRF | 0.467 | 0.163 | 0.231 | 0.354 | 0.067 | 0.375 | 0.467 | 0.422 |
| NV [28] | 0.253 | 0.175 | 0.299 | 0.156 | 0.193 | 0.456 | 0.223 | 0.203 |
| Simplified NeRF | 0.218 | 0.152 | 0.280 | 0.132 | 0.080 | 0.283 | 0.151 | 0.139 |
| DietNeRF (ours) | 0.110 | 0.092 | 0.117 | 0.097 | 0.053 | 0.204 | 0.102 | 0.097 |
| DietNeRF, \(\mathcal{L}_{\text{MSE}}\) ft (ours) | 0.096 | 0.077 | 0.117 | 0.094 | 0.043 | 0.193 | 0.095 | 0.067 |
| NeRF, 100 views | 0.033 | 0.025 | 0.064 | 0.035 | 0.023 | 0.125 | 0.037 | 0.025 |
原 Table 7 的 PSNR、SSIM、LPIPS 三个子表、6行方法、8场景均完整保留。平均结果掩盖重要例外:Ficus PSNR 的 Simplified NeRF 21.091 高于 DietNeRF 20.744及其微调20.940;Ship 的 DietNeRF PSNR从23.043微调后降到22.536,虽然LPIPS继续改善。Drums PSNR也略降20.034→20.029。不能把“平均改善”改成“所有场景、所有指标都改善”。

附录显示NV能恢复粗轮廓但有薄雾状失真,Simplified NeRF可能产生未被训练视图发现的遮挡体;DietNeRF较稳定但仍缺少高频细节,椅背有绿色颜色泄漏。这些失败例说明全局语义对局部外观和几何并非充分约束。
10 · 单视图:感知改善伴随几何退化
原 Table 2
| Method | PSNR | SSIM | LPIPS | FID | KID |
|---|---|---|---|---|---|
| NeRF | 8.000 | 0.286 | 0.703 | — | — |
| pixelNeRF | 15.550 | 0.537 | 0.535 | 266.1 | 0.166 |
| pixelNeRF, \(\mathcal{L}_{\text{MSE}}\) ft | 16.048 | 0.564 | 0.515 | 265.2 | 0.159 |
| DietPixelNeRF | 14.242 | 0.481 | 0.487 | 190.7 | 0.066 |
DietPixelNeRF的LPIPS .487、FID190.7、KID.066优于pixelNeRF的.535、266.1、.166;但PSNR从15.550降至14.242,SSIM从.537降至.481。只用MSE微调能把PSNR提到16.048,却几乎没有FID收益。这个对照是整篇最重要的权衡,绝不能只报有利指标。


一张图的背面有无限多种解释。像素最小二乘在不确定位置可能偏向平均、模糊的图像,而语义先验鼓励更锐利、更像对象的完成。论文因此主张图形应用可重视可信外观,但这不等于工程测量、机器人感知或精确重建可以接受错几何。表中普通NeRF只有一图,Figure5还展示三图仍失败的例子,图示条件与表格条件不要混淆。

附录所有额外DTU案例均从相同预训练起点适配20k步,分别MSE-only和MSE+SC。盒子、砖等较规则物体较好,但几何缺陷仍可见。论文没有将CLIP语义一致性等同于几何一致性,也没有证明单图场景的真实隐藏结构。

12 · 附录失败尝试与方法局限
Appendix D 尝试为每个场景训练patch判别器,使新视角像真图,思路类似SinGAN或PatchGAN。无论单独使用对抗项还是与语义损失结合,都在合成场景出现伪影。这是有价值的负结果:有新视角判别监督不等于有可靠先验,少量真图学习的判别器可能更脆弱。
- 语义—几何缺口:CLIP允许一定姿态变化,恰好也可能不敏感于局部几何错误;生成“类别正确”背面不保证对象级真实。
- 姿态假设:依赖已知相机及合理采样分布,没有覆盖任意无界场景的通用解。
- 计算:额外全图语义渲染和编码器反传增加成本,采用lazy loss及重计算只是降低,不是消除;论文未给统一每场景时长表。
- 评估:8个合成场景、15个DTU单图场景,未给跨随机子集完整方差或置信区间;NV样本量和分辨率设置不同。
- 先验来源:使用大规模二维预训练是实质额外信息,“每场景少图”不意味着从零获取所有知识。
- 可复现:v1公式符号须纠正,微调检查点与最长配置须区分,DTU适配入口的公开覆盖不足。
对后来的SDS或扩散三维生成,可把DietNeRF看作利用强二维模型监督可微三维表示的一条早期路线;但这里没有扩散噪声、score蒸馏、文本条件或随机时间步,不能把其loss写成SDS。
13 · PMG 与材质研究如何借鉴
下面是待验证研究设想,不是原论文贡献。
- 对程序化材质图,在可微渲染多个视角/光照后匹配参考的语义外观,可作为像素对齐缺失时的辅助目标;必须同时约束粗糙度、法线和反照率等物理通道,避免以错误光照补偿材质。
- 把单个全局特征扩展为局部区域或多尺度特征时,先验证其对视角和光照的稳定性。更局部通常更精确,但也更不具不变性,不应默认必然更好。
- 沿用两阶段策略:先用语义约束找到合理区域,再以多视图外观或物理误差微调;预注册停止标准,记录是否丢失全局一致性。
- 与pixelNeRF式跨场景几何先验组合时,明确报告预训练数据来源和额外成本,比较感知质量、几何误差、材质可编辑性三条轴,而非只报CLIP相似度。
- 对隐藏区域给多个可能解或不确定性提示,不把单一高语义分数的完成当作可靠测量结果。
14 · 复现清单与最终记忆点
- 已知相机、同姿态MSE、跨姿态语义项三者分工清楚;新相机没有像素真值。
- 语义loss应最小化负余弦,v1 Eq.5正号与目的不符,官方代码确认负号。
- 真实特征缓存,渲染特征允许输入梯度,NeRF为优化对象;不要把冻结编码器误写成切断反传。
- 每10–16步低分辨率全视野语义渲染,主训练200k,微调时长与最佳检查点区别清楚。
- 八图从零优化和单图pixelNeRF适配是不同先验预算;单图感知改善伴随PSNR/SSIM下降。
- 所有7张编号表含Table7三子表、11幅原图及A–D附录覆盖;原笔记逐字保留,本次不发布也不写回vault。
- 静态检查完成,浏览器公式、响应式及用户本地验收仍待下载后进行;没有运行训练或独立重现数值。
核心证据来自用户固定PDF;表格和图像使用对应v1来源。官方代码核查:训练实现、Lego八图配置。远程原图浏览需要网络;仅Figure3以原PDF矢量图栅格化嵌入。