低计算量
模型文件0.14 MB;Pixel 4 XL上TFLite平均推理0.147 ms。这个数不包含手势积累窗口和完整事件响应延迟。
不只识别一次挥手,也要学会在长时间背景动作中保持安静
Eiji Hayashi等八位作者 · 14页原件全文 · 连续流评估、系统设计与来源差异
RadarNet 的贡献不只是把挥手分成几个类别,而是把毫米波信号处理、微型神经网络、历史特征缓存和事件去抖组合成一个持续工作的输入系统。它最有价值的评估,是在长时间没有用户指令、却有大量相似身体动作的背景里,测量每小时误触发。
模型文件0.14 MB;Pixel 4 XL上TFLite平均推理0.147 ms。这个数不包含手势积累窗口和完整事件响应延迟。
已切好的12帧样本各类accuracy超过99%;连续流在检测率80%时,普通干扰背景的三个输出头分别为0.03、0、0.06次误触发/小时。
7647名组织内部参与者、约55.8万手势记录、392万负样本。规模大并不自动代表老年人、运动障碍人群或所有实际环境。
本页覆盖原始14页全文、4张原表、20幅原图和来源审查。原文件没有独立附录;本次未核实到该论文的官方代码、权重或数据下载,不将“构建了数据集”写成“已开放复用”。浏览器验收按用户要求延后。
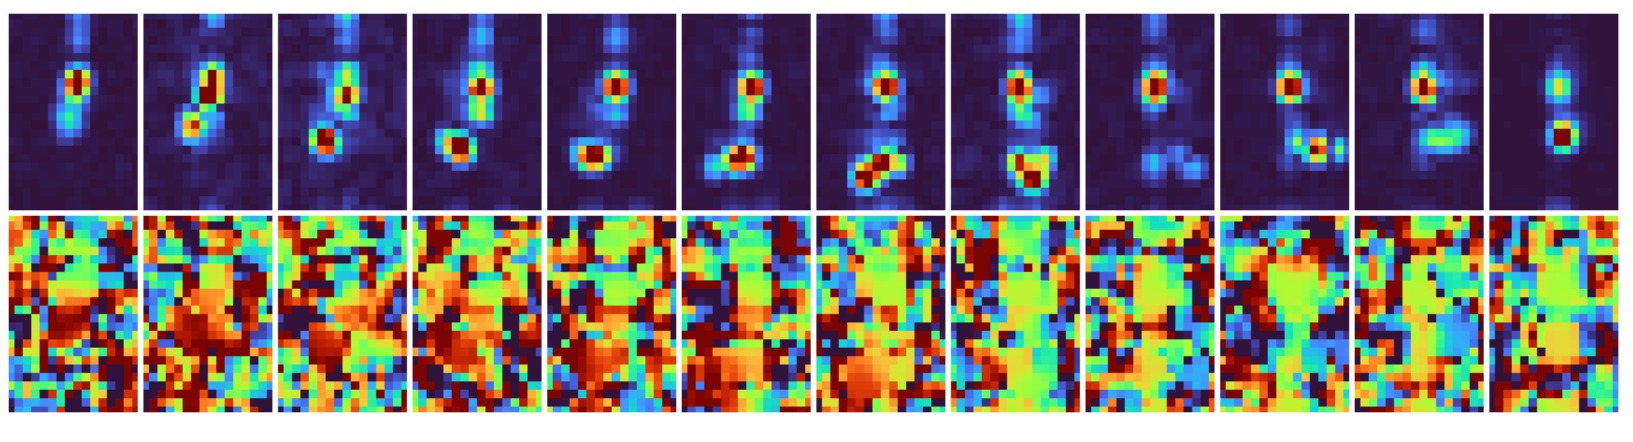
主文摘要、§5、§7–§8。Figure1以同一左挥动展示幅度与干涉相位信息;它是信号说明图,不是网络必须显式计算的两种输入图。
| 字段 | 已核实信息 |
|---|---|
| 标题 | RadarNet: Efficient Gesture Recognition Technique Utilizing a Miniature Radar Sensor |
| 作者顺序 | Eiji Hayashi;Jaime Lien;Nicholas Gillian;Leonardo Giusti;Dave Weber;Jin Yamanaka;Lauren Bedal;Ivan Poupyrev |
| 机构/发表 | 作者均列Google,Mountain View;CHI 2021,Article5,14页 |
| DOI | 10.1145/3411764.3445367;原PDF标注CC BY4.0 |
| 角色与版本 | 第一作者Eiji Hayashi;没有明确通讯作者标记,末位Ivan Poupyrev仅保留为未核实候选;未核实arXiv版本 |
作者个人出版列表与SIGCHI官方报告均列出该工作;部分会议/宣传页面使用“Miniaturized”而原PDF标题为“Miniature”,本页采用原PDF。Google在2020年的Soli技术博文提供产品背景,但不是2021论文所有参数、训练集和模型的逐项复现规格。
对原笔记的补充:将它理解为artifact/constructive contribution很合适:芯片、算法和交互系统被联合构建;大规模连续流实验属于empirical evidence,数据采集与负样本协议有方法价值。但未验证公开数据下载,因此不宜沿用“其他研究者可以直接使用该数据集”的断言。保留原笔记原文,在本次新增内容中明确这个边界。
正式出版记录 · 作者出版列表 · SIGCHI官方报告
屏幕中心的手势交互往往假定用户已经在设备前、正在发出一条命令。环境计算却希望设备待在注意力边缘:用户做饭、听音乐或处理另一件事时,用一次短挥手管理一个小动作。先唤醒识别器、摆出严格姿势或对准摄像头,会破坏这种即时性。
作者提出五项系统要求:always-on、reliable、private、small、invisible。持续工作要求低功耗、低误触;小体积和无开孔利于嵌入外壳;毫米波不依赖可见光,可以穿过塑料、玻璃等非金属表面。雷达更侧重运动而不是可辨识面部图像,因此减少了某些视觉隐私暴露,但不等于不能推断行为或不存在隐私风险。
关键难题是负类不是静止。拿杯子、触屏滑动、伸手取手机、走动或手机自身移动,都可能产生接近挥手的雷达模式。真实系统不仅要回答“这段是什么手势”,还要回答“现在到底有没有指令、何时输出一次、何时允许下一次”。这解释了本文为什么把背景数据和debouncer放在核心位置。
相关工作包括基于摄像头、WiFi、超声、身体电信号的手势识别,以及Soli的手工特征+随机森林、range/Doppler profile+LSTM和CNN+LSTM端到端模型。RadarNet并不声称毫米波解决所有交互问题,而是选择小词表、近距离挥动,换取持续运行能力。主文§1–§2。
Soli采用60 GHz附近的FMCW雷达。每个burst发16个chirp,burst内部脉冲重复频率PRF为2000 Hz,burst频率25 Hz,对应每40 ms产生一帧。宽约150°波束覆盖周围手与身体;多个反射叠加后,通过FFT转成复数range-Doppler图,将不同距离或不同径向速度的反射区分开。
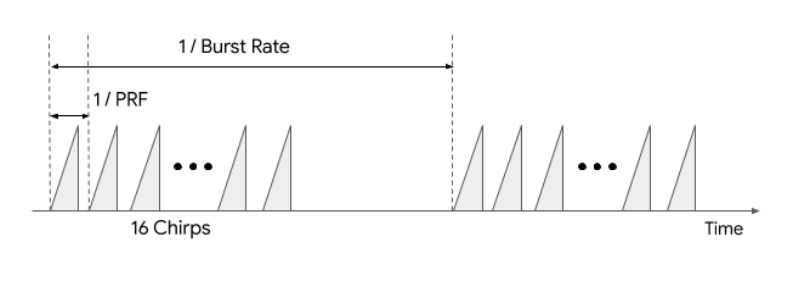
原文式(1)、式(2)为:
c是光速,带宽BW为4.5 GHz,中心频率 \(f_{\mathrm{c}}=60.75\ \mathrm{GHz}\),L为16个chirp。代入近似光速得到3.33 cm和0.309 m/s,与文中四舍五入一致。FFT窗口为64个range bins与16个Doppler bins。距离分辨率是区分反射目标的尺度,不等于所有运动变化只能精确到3.3 cm;相位对微小位移仍可能很敏感。
原文声称发送占空比低于2%。仅由16/2000可算出约8 ms的burst时间尺度,相对于40 ms帧周期约20%;这是包含chirp间空隙的burst包络比例,不是RF实际发射占空比。本文没有充分给出chirp有效发射宽度,不能把20%拿来直接否定2%,也不能据此推算整机耗电。低推理时间、发送占空比与实测电池寿命是不同指标。
原文式(3)把复数图转换为可解释幅度图:
r、d分别为距离和多普勒bin索引。ARD表示反射能量的强弱模式,CRD还保留相位。左右挥动可能有非常相近的接近再远离轨迹,因此仅看幅度未必能区分方向。主文§3、Figure1–2。
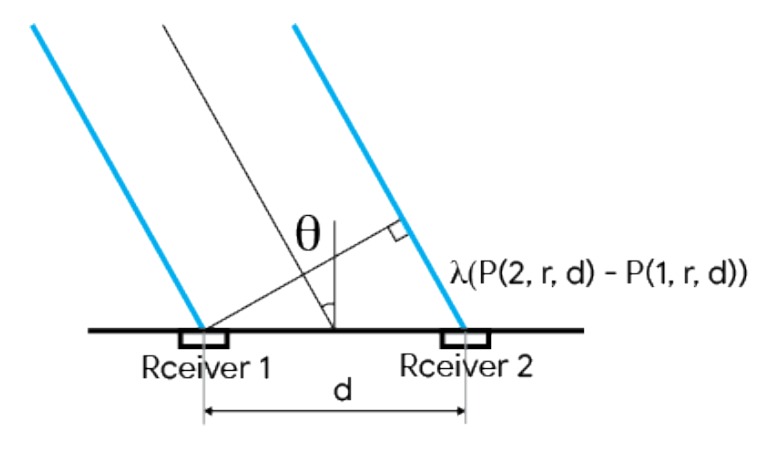
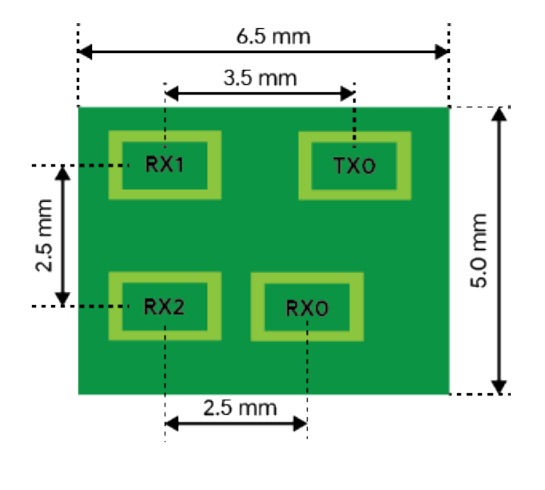
芯片有一个TX、三个RX,RX成L形,间距约2.5 mm。利用RX0/RX2和RX1/RX2两对天线的相位差,分别估计两个平面中的到达角,再结合range估计目标位置。这个解释依赖远场近似:目标距离相对于波长及天线间距足够大。
原PDF式(4)写成如下形式:
λ为波长,a为天线间距,星号表示复共轭。相位单位待澄清:若arg使用常见的弧度单位,路径差与相位差应满足下面的关系,分母会出现 \(2\pi\):
这也是TI官方FMCW教程的约定。只有把原式arg解释成以整周为单位的相位,才与该形式相容;论文没有明确写出这种归一化。本页保留原式并指出条件,不默默改原文,也不把不明约定当作可直接复制的代码。PDF文本和图式OCR都记录了这个缺少显式因子的形式。TI参考:Angle Estimation,式15–16。
取半波长天线间距有利于在约±90°内消除相位绕回歧义。但如果手和身体在同一个range-Doppler bin里,接收的是多目标复数叠加,角度便可能失真。这个混合问题不会因网络输入保存相位而自动消失。
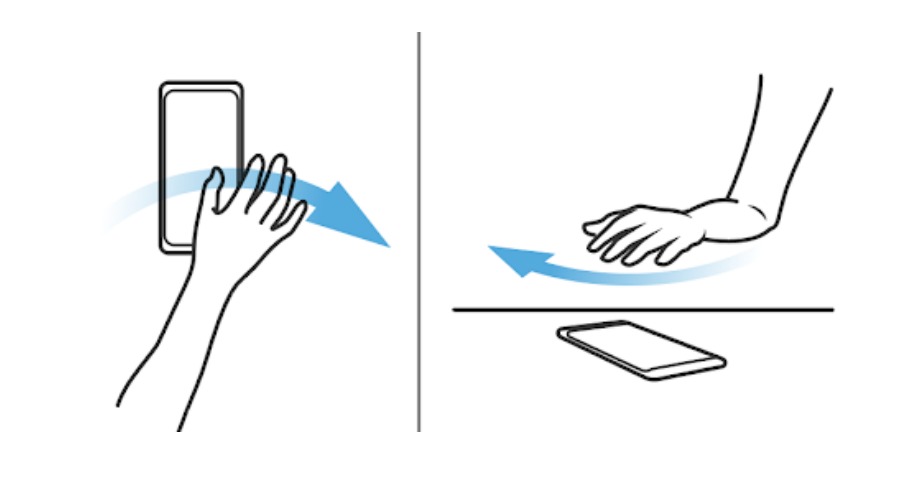
挥动必须满足三个数值条件:物体在0.5秒内从设备一侧移动到相对一侧;高度大于3 cm且小于20 cm;从垂直屏幕方向看,物体至少一部分经过屏幕区域。四个方向为上、下、左、右;omni-swipe包含任意平行于屏幕方向的挥动,包括斜向。
方向采用设备坐标而不是人的固定左右。手机旋转后,同一个世界坐标运动可能对应不同设备方向。手掌平行或垂直屏幕均可,作者没有限定一种手部朝向。由此可见,omni不是与四个方向互斥的第五个动作类别,而是一个包容性的检测目标。
| Prediction | Classes |
|---|---|
| Portrait Prediction | Right、Left、Background |
| Landscape Prediction | Up、Down、Background |
| Omni Prediction | Omni、Background |
各头内部softmax概率和为1,跨头总和为3;头间类别不互斥。斜向挥动可能同时激活portrait与landscape,也属于omni。使用单一“五分类softmax”复现会改变任务定义。非手势负样本在三个头上都标background;正样本至少一个头不是background。
上式是对Table1结构的说明,不是论文新增编号公式。主文§4、§5.2、Table1。
每帧三路接收器各产生64×16复数range-Doppler图,原始组织为64 range×16 Doppler×3 receiver×2 real/imag。由于挥手靠近手机,网络只保留前24个range bins,约0.79 m;这比3–20 cm手势高度范围更宽,不能把输入裁剪范围当作手势有效距离。
实部/虚部与接收器维度合并为6个通道,网络输入写成 \(X_{t}\in\mathbb{R}^{24\times16\times6}\)。这样同一个range-Doppler单元的所有接收器复数值就在同一通道向量中,局部卷积可以比较跨天线相位关系。Figure7采用16×24×6的轴顺序显示;实现时需明确哪一轴是range、哪一轴是Doppler,不能混淆padding方向。
作者试过ARD与干涉图输入,认为性能没有显著差异,因此选择CRD以省去额外转换。这里没有公开数值消融、p值或方差;“没有显著差异”只能按作者报告转述。作者也明确承认,没有证据证明网络内部真的显式学出了干涉图。
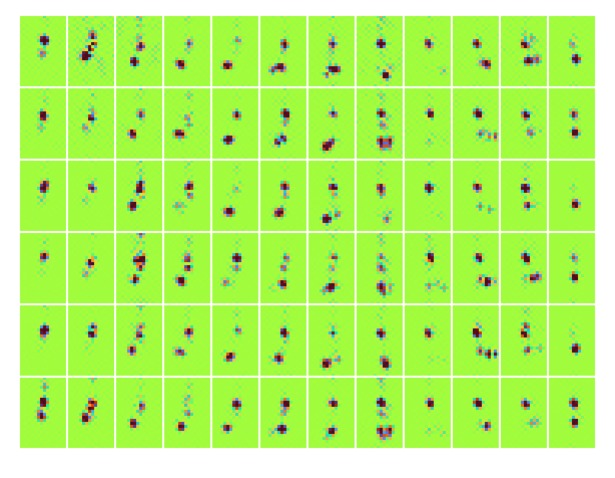
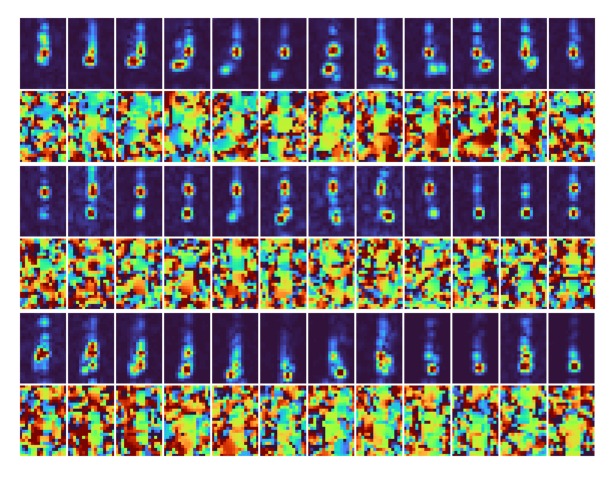
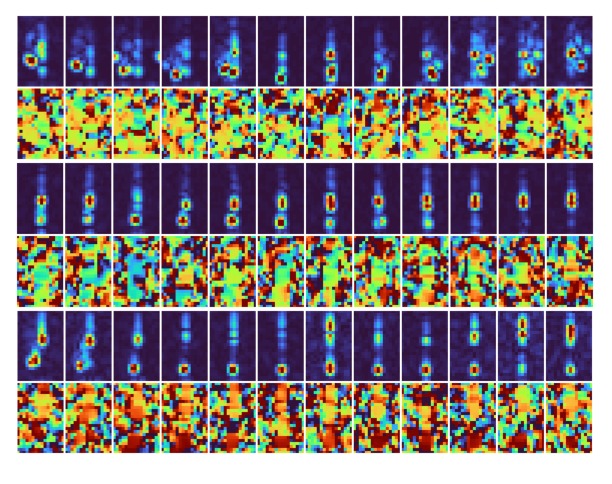
Figure11逐行展示三个RX的实部和虚部,逐列是12帧。Figure12中干净左右挥动容易分辨,但短幅挥动、身体靠近手机会使信号模糊;Figure13的手上下移动、触屏滑动、拿取物体又会模仿接近-远离模式。训练需要这些困难负样本,否则离线分类精度很容易高估实际可用性。
主文§5.1、§7.4。图11图注出现“real and complex components”的措辞,正文明确是real与imaginary,本页据正文解释,不把一行误说成整套复数值。
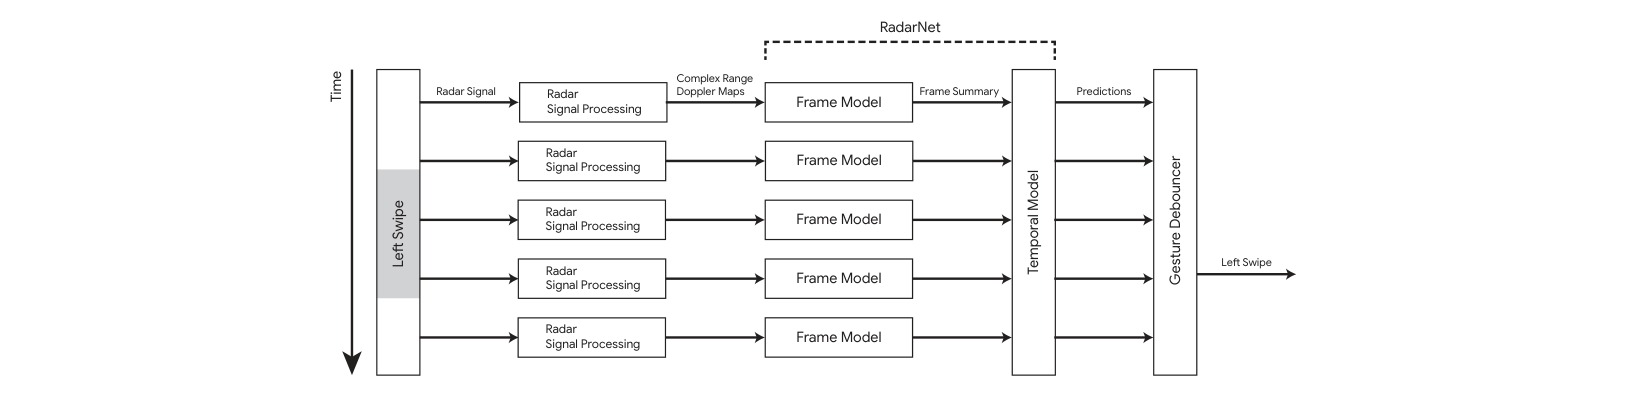
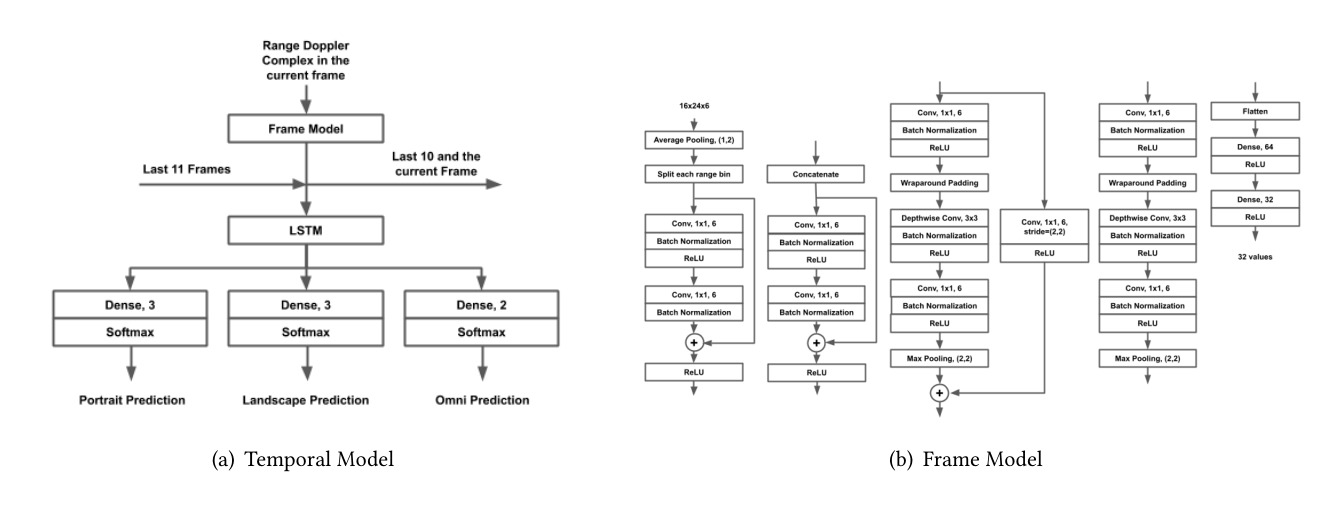
每帧执行一次小型CNN,把24×16×6压缩成32维summary;时间模型读取当前与前11帧summary,通过LSTM,再接三个dense+softmax输出头。模型结合卷积的局部信号模式和LSTM的时间演化,并没有使用Transformer、扩散模型或生成式解码。
| 阶段 | 论文描述与图示 | 设计原因 |
|---|---|---|
| 按range切片 | 每个距离切片先经过1×1 residual block,之后再拼接 | 适应不同距离上的动态范围,并局部混合跨接收器复数通道 |
| 空间压缩 | bottleneck、3×3 residual block;图示含1×1卷积、depthwise3×3、BN、ReLU及池化 | 以较低代价聚合range-Doppler邻域 |
| padding | Doppler轴循环padding;range轴zero padding | Doppler存在aliasing/周期边界,物理距离不能首尾相接 |
| 帧summary | 之后三层卷积、两层dense,输出32值;图中可读dense64→dense32 | 用小特征替代重复处理原始输入 |
| 时间聚合 | 12×32历史summary→LSTM→三组dense/softmax | 识别动作过程并同时产生三个非互斥预测集合 |
本次保存了Figure7完整原图和文本/OCR核查;小字不能可靠恢复的LSTM隐藏宽度、完整逐层shape或精确激活顺序不凭经验补齐。没有官方实现可用于进一步验证,图示并不足以声明已经复现逐层模型。
缓存策略是持续保存已计算的帧summary,新帧到达只需算一个CNN前向,然后更新12帧环形窗口。形式上:
这个说明式突出帧特征复用。12个32维float32值约1536字节,仅是summary缓存的算术估计,不是整个运行时内存。LSTM是否跨窗口保留额外状态、初始化方式和实际部署量化细节没有充分公开;不能擅自把窗口LSTM替换为任意长度的流式状态机。
滑动窗口可能围绕同一次手势连续多帧输出高概率。如果直接把每帧argmax转成命令,一次挥手会跳过多首歌。作者采用两个启发式:
检测阈值通过实验选择,用于折中召回和误触发;论文没有列出三个输出头最终部署的具体阈值。0.3是重置条件,不是所有实验曲线共用的检测阈值。多头同时触发时的最终应用事件仲裁、时间戳归属和多用户行为也没有完整伪代码说明。
这是对连续3帧门槛的说明式,真正输出还需要当前处于可触发状态。其效果是抑制短时噪声及重复触发,代价是增加响应等待,并可能压制连续快速挥动。
25 Hz意味着40 ms更新一次。12帧对应约0.48秒采样覆盖,首尾时间戳相隔0.44秒;三个连续采样点从首个到第三个相隔80 ms。它们都不能简单等同最终交互延迟,因为窗口滚动、动作何时出现及阈值达到时间会影响响应。论文没有测量完整的手势开始/结束到应用响应分布。
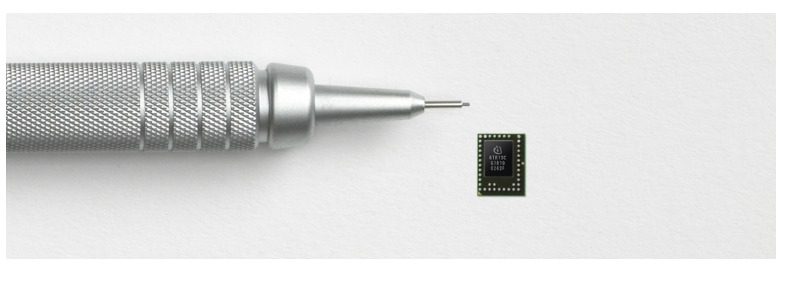
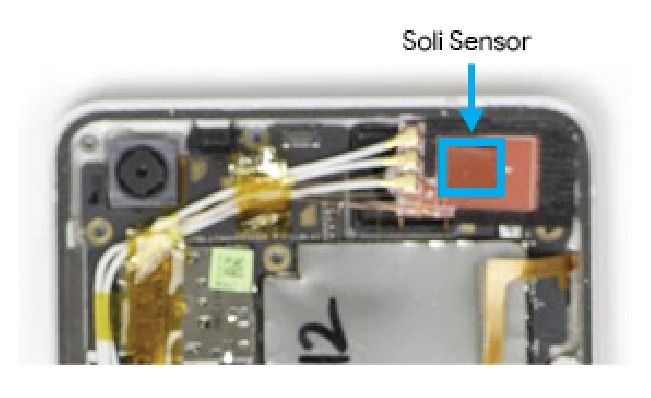
相较早期Soli的2TX+4RX和12×12 mm,新版本用1TX+3RX,牺牲部分信噪比换取手机上边框内的体积。天线间距2.5 mm,外壳可以不为传感器另开孔;材料穿透和堆叠设计仍需工程调试,并非随便装在任意物体后面都能得到相同信号质量。
| 来源位置 | 报告尺寸 | 本页处理 |
|---|---|---|
| 摘要、§6正文 | 6.5×5.0 mm | 采用为主要描述,并明确出处 |
| Figure8图注 | 5.5×6.0 mm | 保留来源差异,不静默改图注 |
| §11结论 | 6.2×5.0 mm | 标为同文报告不一致 |
| Google 2020官方Soli博文 | 5.0×6.5×0.873 mm封装 | 支持主体长宽口径;不是修复原文全部版本问题的证明 |
官方博文还说明产品侧使用低功耗DSP,并为扬声器振动与手机组件干扰设计滤波。这是理解实际部署背景的补充,不能把博客里的所有处理步骤当作RadarNet正文已经公开的实现。本文没有端到端功耗曲线、mW数值或一天电池消耗比例。
Google官方Soli技术说明(2020-03-12);主文§6、Figure8–9、§11。
正样本来自组织内部9个地点的7647名参与者,通过内部邮件和网站招募。报告性别为男性63%、女性36%、未指定1%;惯用手为右手86%、左手5.7%、双手4.6%、未指定3.5%,合计存在小幅四舍五入误差。没有公开年龄范围、设备使用经验或障碍情况的完整分布。
每次研究约30分钟,采集主持人先参加两天培训以统一流程。参与者阅读并签署同意书,观看操作说明及两个角度的手势视频。pilot中给出严格数字条件导致动作像机器人,作者因此改用视觉示范,再在采集后过滤不符合定义的动作。这提高自然性,但也意味着有效样本仍经过规则筛选。
| 条件维度 | 取值 | 实施 |
|---|---|---|
| 身体姿态 | 坐、站 | 与其他因素组合 |
| 手机放置 | 桌面、手持 | 覆盖传感器静止与自身移动 |
| 手机方向 | 竖屏、顶端向右横屏、顶端向左横屏 | 调整选择概率平衡竖/横数据 |
| 单session动作 | 四方向各3次,共12次 | 方向随机顺序;按时间尽量多完成session |
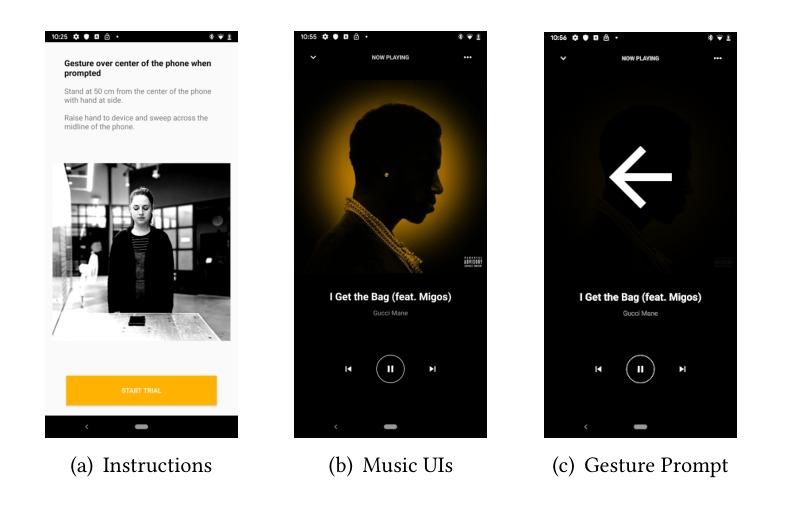
应用先显示说明,再模拟音乐UI,以箭头提示目标方向。动作后插入拿笔、移动杯子、取手机、点屏幕等分心任务,避免连续机械重复。主持人用remote clicker提供看似系统响应的视觉反馈;从箭头出现到clicker按下的时间段记录为手势窗口。这个交互反馈是采集流程,不是实时识别正确率的证明。
提示与动作之间、动作与主持人按键之间都有延迟,所以窗口不是准确的运动起止。后续算法重新定位手离Soli最近的中心帧,再提取12帧样本。标签细化算法没有完整公开实现或误差评估,复现应把这一环节当作重要依赖。主文§7.1、§7.3。
论文报告总采集5019小时,摘要概括558000手势样本与3920000负样本。正文另报告285小时的手机附近交互负数据,并设计52个负场景,归入五组:手持步行、手机附近常见动作、手持手机时动作、手机平放时动作、以及与手机交互的XYZ方向动作。各统计口径是否完全互斥、各部分时长如何组成总数没有完整清单,不能自行补齐。
负场景包含两种性质:自然行为中偶发的类似挥手动作,以及每几秒重复一次的刻意干扰动作。由于按这些场景开展一般参与者研究有IRB执行上的困难,作者让工程团队成员完成协议。示例是把手机放臂带跑步机运动10分钟;要求不做有意挥手,尽量自然,并允许姿势变化增加多样性。不能因此推断研究未获伦理审查,也不能假定工程人员与普通用户行为完全相同。
| Dataset | Gesture Recordings |
|---|---|
| Training | 368×10³ |
| Development | 85.5×10³ |
| Test | 104×10³ |
三项和为557500,与约558000的报告口径一致。按study/参与者归属划分,同一参与者不跨多个集合。开发集用于调参,测试集用于最终评估。原文没有详细报告负数据采集人员跨集合的分配方式,也没有给每个子集的年龄/姿态平衡表。
记录数、增强后的训练窗口数、唯一手势数和负帧数不能混为一谈。正文没有给出最后训练tensor的精确总行数,也没有说明所有重采样细节;不要把55.8万直接乘一个系数,冒充已核实数据发布规模。
| 设置 | 论文报告 | 缺失或不能推出的部分 |
|---|---|---|
| 训练步数 | 1.5×10⁶ steps | 不是epoch;数据增强与采样使遍历次数不能简单换算 |
| Batch | 128 | 未详述正负batch组装和多头损失权重 |
| 训练时间 | 服务器约5–6小时/次 | 未说明完整GPU/CPU型号、并行数量与精度 |
| 网络 | 小型CNN帧模型+LSTM时间模型+三输出头 | 完整代码、参数数量、初始化、dropout细节未核实 |
| 优化目标 | 分类训练 | 未明确optimizer、学习率、scheduler、weight decay及完整loss公式,不补造Adam默认值 |
| 推理 | TFLite转换;缓存帧summary;连续3帧阈值+0.3重置 | 量化、最终检测阈值、状态初始化、硬件线程配置未完整报告 |
标准做法可以是对三个头的交叉熵求和,但原文没有给出该公式或权重,不能把这个合理实现选择冒充原作者使用的训练目标。对复现者而言,比较自己的实现应标“根据论文重建”,而不是声明逐字节等价于Google内部实现。
输入是事先切好的12帧CRD样本,输出每个头一个类别。论文在precision与recall相等的操作点报告下表accuracy,并绘制去掉background后按前景类别平均的PR曲线。没有完整混淆矩阵,不能把每个accuracy直接改名为该类recall、precision或F1。
| Prediction | Class | Accuracy |
|---|---|---|
| Portrait | Right | 0.9943 |
| Portrait | Left | 0.9924 |
| Portrait | Background | 0.9945 |
| Landscape | Up | 0.9928 |
| Landscape | Down | 0.9937 |
| Landscape | Background | 0.9948 |
| Omni | Omni | 0.9930 |
| Omni | Background | 0.9929 |
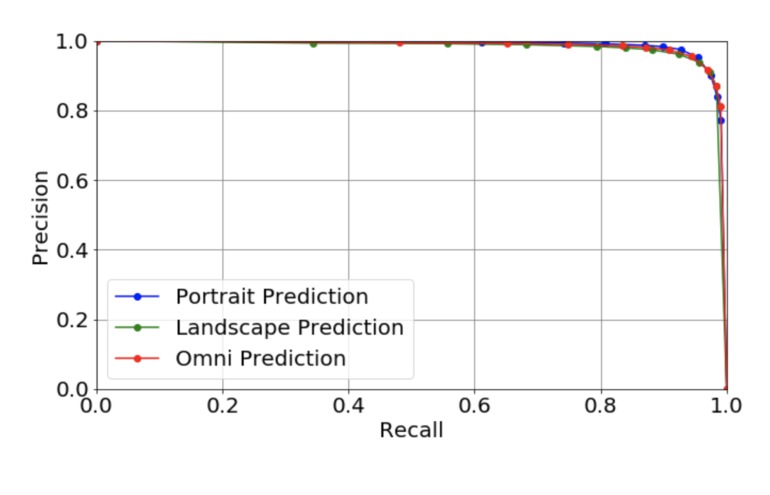
相比只包含干净手势的旧数据,加入相似背景已经提高难度。但“窗口已被正确定位”仍是强先验。背景比例1:6也会改变某些accuracy解释。超过99%的表格不能回答一小时里是否误触发、一次挥手是否连续触发多次,以及用户是否必须重做动作。主文§8.1与Table3。
所有比较模型转成TFLite,使用其performance profiler在Pixel 4 XL上测量5000次平均推理。基线是Wang等2016的雷达CNN+LSTM端到端手势模型和用于移动图像分类的MobileNet。后者是计算规模参照,并非在相同雷达识别任务上的准确率竞争者。
| Model | Model Size [MB] | Inference Time [ms] |
|---|---|---|
| RadarNet | 0.14 | 0.147 |
| RadarNet w/o caching | 0.14 | 0.909 |
| End-to-end [35] | 689 | 1.37×10⁵ |
| MobileNet [19] | 17 | 13.2 |
原表确实将端到端基线写为137000 ms(137秒),本页不擅自把指数改成负号。它反映该论文在此平台和转换条件下的报告;不是所有平台的通用速度,也没有足够信息诊断为何如此慢。基线识别11个手势,RadarNet当前范围较小;旧基线未缓存帧特征,尽管理论上可以加缓存,所以并非完全控制所有因素的架构比较。
| 由原表计算 | 结果 | 解读 |
|---|---|---|
| 去缓存时间/缓存时间 | 0.909/0.147≈6.18倍 | 缓存收益明显;不是精确12倍,因为时间模型等成本仍存在 |
| RadarNet/旧基线文件大小 | 约0.0203%,即1/4921 | 摘要“低于1/5000”与舍入表值略有边界差异,适合作近似量级描述 |
| RadarNet/旧基线推理时间 | 约1.07×10⁻⁶ | 约九十三万分之一,限定本表测量条件 |
| RadarNet/MobileNet文件大小 | 约0.824% | 与正文0.8%近似一致 |
| RadarNet/MobileNet推理时间 | 约1.11% | 正文写11%,与表值不一致;无缓存版本也只是约6.89% |
模型文件0.14 MB不等于运行时总RAM,更不能直接当作参数数目。0.147 ms不含完整雷达采集、FFT、时间窗等待、debounce及UI响应。单次推理低成本支持持续运行的可行性,但论文没有用这些时间值直接测出系统功耗。
正测试流中有104000个标注手势时间窗。一个窗口只有在恰好输出一次且类别正确时计为成功;没有预测、错类或输出多个正确预测都计为失败。这个定义同时惩罚漏检、误分类和重复事件。
这里分子是恰好一次正确事件的窗口数,分母是全部标注手势窗口数;这是根据实验协议整理的说明式。自然负测试流总计40.2小时,包含在手机附近容易产生误触发的实际动作;没有清晰可数的“非手势实例”分母,所以作者选每小时误触发,而不是普通分类false positive rate。
| 负场景 | 检测率 | Portrait FP/h | Landscape FP/h | Omni FP/h |
|---|---|---|---|---|
| 自然行为干扰,40.2小时 | 0.8 | 0.03 | 0.0 | 0.06 |
| 反复相似动作干扰 | 0.8 | 0.5 | 0.5 | 1.0 |
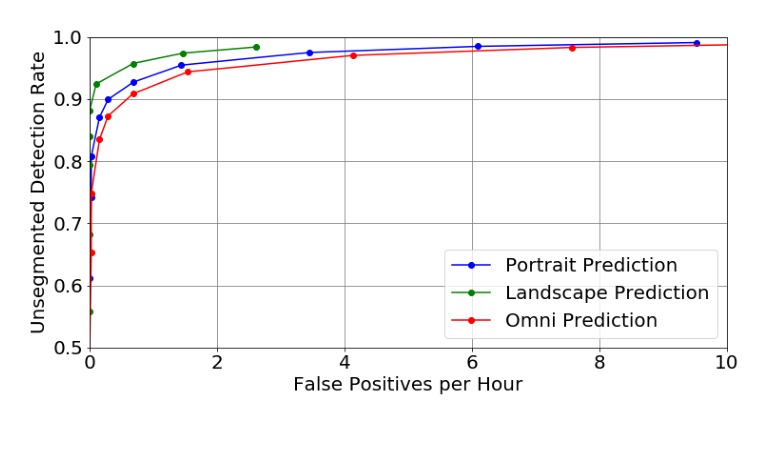
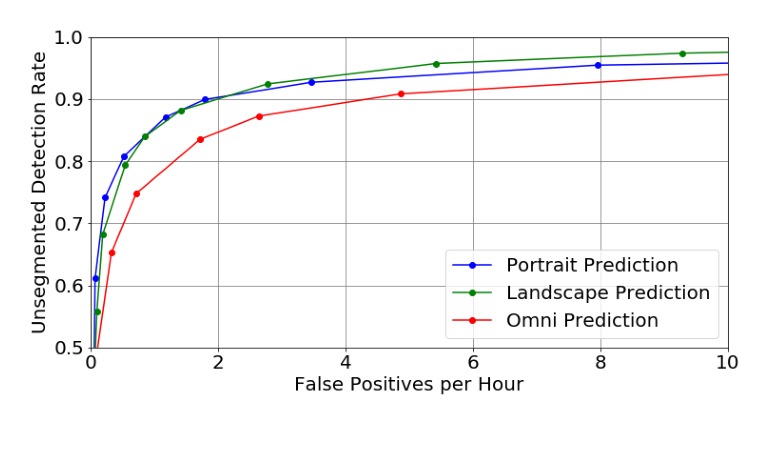
第二类“adversarial”是工程上刻意重复的困难动作:触屏、解锁上滑、把物体跨过手机、手机旁转动方向盘等,不是梯度攻击或对抗扰动。它每小时含数百个相似动作,误触仍相对少,但原文没有明确列出这一子集的总测试小时数。
两个图表示阈值扫描下的trade-off,不是任意阈值都能同时达到80%与这些误触率。自然场景数字被作者解释为较严苛背景下接近上界,而非真实日常均值;这仍是作者对所采场景的解释,不是所有真实环境的统计上界。0.0表示有限观测/报告精度下的结果,不证明永不误触。三个头还可能重叠,不能把误触率简单相加当成应用最终事件率。
80%意味着按这个严格事件标准约有五分之一窗口未成功;这与99%分段accuracy不矛盾,因为任务、阈值和惩罚规则都不同。真正交互系统要评估用户补救、再做手势成本及误命令后果,论文尚未给出这些体验指标。
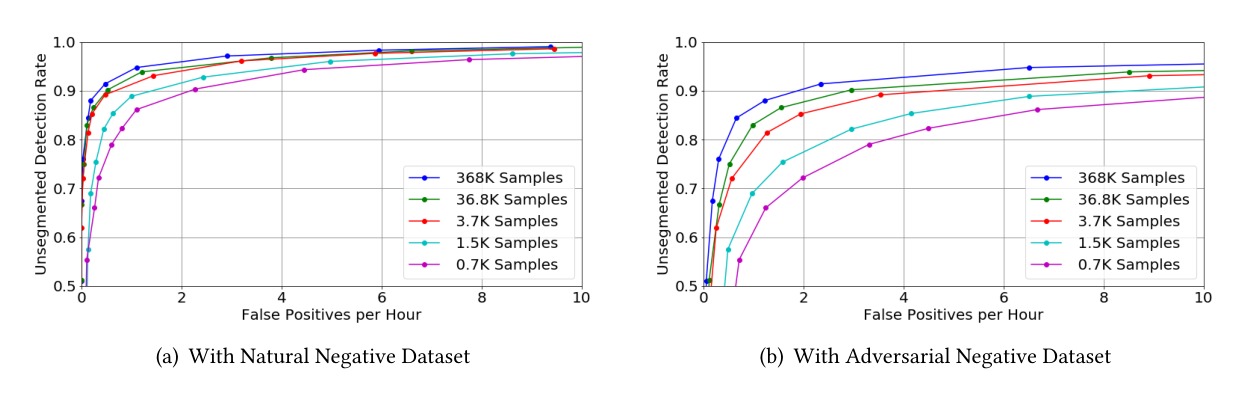
作者用约700到368000条正手势记录构建不同训练集,每条记录取三个时间窗口并做三倍增强,负样本按1:6抽样。Figure17比较portrait输出在自然和困难负背景下的检测率-误触曲线。数据量增加对困难负背景帮助更大,符合“相似动作需要更充分覆盖”的解释。
用约3700条记录、约全量1%,模型达到全数据性能的90%以上,是论文的经验观察。这里的90%不是绝对90%检测率,也不是“随便采3700次就够”。小集合是从全规模记录随机抽样,继承了大量参与者和环境的多样性;如果只找少数人重复很多次,结论不成立。作者明确把样本量建议看作下界,而非通用保证。
| 分析 | 真正变化 | 证据强度 |
|---|---|---|
| 缓存消融 | 同模型重复计算或复用帧summary | 有数值:0.909→0.147 ms |
| 数据量 | 保持抽样覆盖背景的同时减少正记录、相应调整负样本 | 有曲线与3700条近似结论;逐点原始数值、误差带未提供 |
| CRD对ARD/干涉图 | 输入表示 | 作者描述性能无显著差异,没有完整分数表 |
| 硬件天线减少 | 2TX4RX→1TX3RX,换取封装缩小 | 承认SNR下降,但无完整同条件准确率消融 |
| 三头/去抖/卷积块 | 论文解释设计动机 | 未给移除各组件的完整消融,不补造指标 |
原Figure17保留全部曲线,而未用人工目测把每个点伪装成精确数据。未报告多seed均值/方差、置信区间或显著性检验,因此“数据越多收益多少”的精确不确定性仍未知。
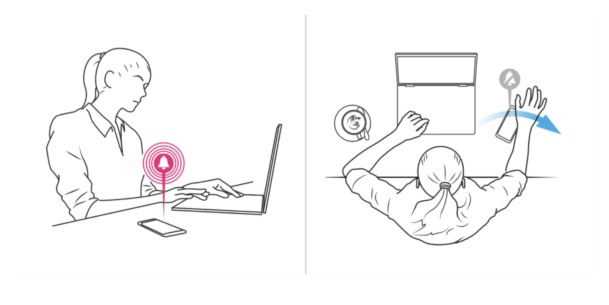
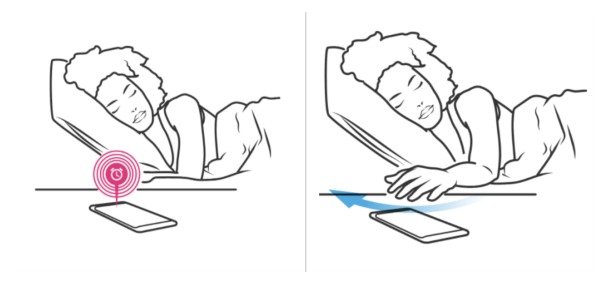
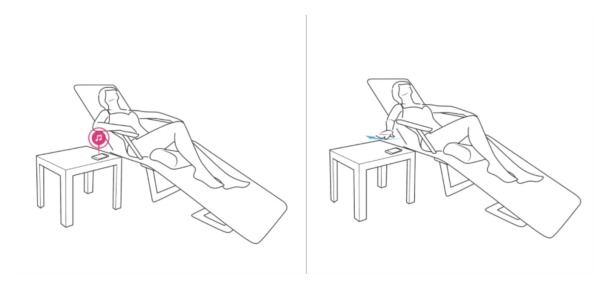
作者展示了挥手静音来电、稍后提醒闹钟、切换音乐等场景:无需解锁屏幕或精确点按,手脏时也可操作。进一步提出语音音箱、公共门、升降机、水龙头,以及利用幅度、节奏等更细动作信息和身体接近线索的可能性。
这些是设计例子和未来方向,不等于已完成的任务效率、认知负荷或可用性比较。尤其驾驶、烟雾报警器等高后果场景不能因“eyes-free”措辞就视为经过安全验证。本研究没有证明减少事故、保证无意图误触可接受或覆盖残障用户。
雷达不产生可识别人脸的普通光学图像,且本地运行可以减少视频传输需求,这是隐私优势的合理动机。但运动、存在和行为仍可能是敏感信息。本文没有进行隐私攻击、用户隐私感知或数据治理实验;“private”是设计目标与相对技术特性,不是形式化隐私保证。
对用户已有HCI贡献框架的理解,本文最强的是artifact/constructive与大规模empirical结合。跨场景采集、困难负类、连续事件指标提供可迁移的方法论价值。它没有直接研究程序化材质生成,本页不强行赋予PMG结果;可迁移的是缓存、事件触发和真实工作流评估等一般系统原则。
硬件约束、信号表示和模型效率一起设计,避免把大图像网络原样移植到雷达。保存复数跨接收器信息,使方向判别拥有必要信号;缓存帧摘要减少滑窗重复计算。更重要的是把负背景与连续事件放进评估,承认识别器在大多数时间都应保持安静。参与者分组划分也比随机切窗口更能防止同一人的模式泄漏。
组织内部样本有明显人群偏差,缺少年龄与运动能力覆盖。正样本仍由提示驱动并经规则过滤,工程成员执行负协议也不同于长期自然使用。系统只验证当前挥动词表,增加手势数量会改变混淆和计算成本。文章虽强调功耗和隐私,却没有直接量化端到端能耗或隐私风险;以计算时间替代能耗只能提供部分证据。
模型规模比较跨越不同手势词表、缓存策略和任务用途;MobileNet只是计算基准。缺少完整loss、optimizer、阈值、公开代码和数据,限制了独立复现。芯片尺寸、式(4)相位约定以及MobileNet百分比的内文差异,也应在后续实现前澄清。
这些是本页建议,没有在本次任务中执行。静态实现审查核实了论文管线及公开来源边界;未找到可确认由作者发布的本文代码/权重或数据集,不能以同名汽车感知RadarNet、后续RadarPose或TinyRadarNN仓库代替。
已完成HTML结构、全部原表数值、图像解码、原笔记字节前缀、PDF++锚点、公式源码、导航目标与文件大小静态检查。8个通用公式fixture与本文分开。MathJax实际渲染、浏览器图片加载、导航点击及1440/760/390像素布局均按要求延期,未标为通过。
没有执行雷达采集、训练、TFLite推理、部署、现场用户研究或用户仓库整合。原笔记中对数据开放性的旧说法保留在原始前缀;新增精读与归档计划明确提出核实建议。Markdown图片使用本下载包的assets相对路径,未来获准归档时需要重映射。
原图署名Hayashi等,CHI2021,遵循原件CC BY4.0标注;本页为中文精读、研究批评和复现说明。论文事实、算术复核、作者解释与本页建议分别标记。