受控结论
在一个保密的电池制造 LD 数据集上,SFT 优于所设定的 BM25-RAG;RAFT-V 又优于 SFT;DPO 再带来较小但一致的 EM 增益。
Paper Reading / Visual Program Generation · Industrial AI
把“相似案例”写进训练,
再让模型学会拒绝近似错误。
Retrieval-Augmented Fine-Tuning With Preference Optimization For Visual Program Generation
这篇论文研究的不是看图生成代码,而是把工业 Ladder Diagram 转成 XML、JSON 或 NetworkX metaprogram,让 7B–8B 语言模型从韩文功能描述生成完整 PLC 图程序。关键设计是:检索案例既在训练时出现,也在推理时出现;随后用图编辑造出“几乎正确”的负例,做离线 DPO。
核心数字来自正式论文 Table 2。这里的“准确”指节点与边属性集合完全匹配标注图,不等于在 PLC 仿真器或真实产线中已验证安全。资料核查:2026-09-22。
01 / Research Motivation
Ladder Diagram(LD)是 IEC 61131-3 PLC 编程语言之一。一个 rung 由 contact、coil、function block 等元素及其连线组成;变量地址、I/O 映射和功能块配置会随产线与硬件改变。通用模型可能懂“定时器”或“互锁”的概念,却没有见过某家工厂的地址命名与组合习惯。把所有配置塞进一次 prompt 不现实,单纯检索若干示例也不一定能让模型稳定吸收这些规则。§1–2,pp.1–3
作者先做一个诊断实验:70B 量化模型做 RAG,8B 模型做 SFT。尽管 RAG 能看到训练集中的相似 prompt–code 对,8B SFT 在 XML、JSON、metaprogram 三种表示上都更好。作者据此提出假设:工业域配置不仅要被临时“看到”,还要在参数更新中被学习;但检索仍然有价值,因为 LD 会重复使用相似子程序。
在一个保密的电池制造 LD 数据集上,SFT 优于所设定的 BM25-RAG;RAFT-V 又优于 SFT;DPO 再带来较小但一致的 EM 增益。
作者认为超过 10 个百分点的 Program EM 提升可减少人工检查、加快 PLC 开发。论文未报告实际开发工时、部署故障率或经济成本。
它把 retrieval 从 inference trick 变成训练分布的一部分,并利用图结构制造可控 hard negatives;创新主要在训练配方和数据构造,而非新模型架构。
RAFT-V 不是“检索后再微调一次”的流水线名称。训练时,模型输入已经含检索到的 prompt–code 对;推理时仍需用同一类检索增强输入。若部署时拿掉 retriever,就出现 train–test mismatch。
| 环节 | 对象 | 论文中的含义 |
|---|---|---|
| 输入 \(q\) | 韩文自然语言 | Program Description + Detailed Description,描述功能、阈值与条件。 |
| 检索上下文 | \((p_i^r,c_i^r)\) | 从训练池用 BM25 找到的相似 prompt 及其 LD 代码;主实验取 top-1。 |
| 输出 \(c_q\) | 文本化 LD | XML、JSON 或可执行 NetworkX Python metaprogram,之后统一转换成图比较。 |
| 目标图 \(G\) | \((V,E)\) | 节点带 element type、变量等属性;边带连接类型与端点。 |
| 优化目标 | 先 CE,后 DPO | 先拟合正确代码,再提高正确图相对图编辑负例的条件概率偏好。 |
02 / Representation
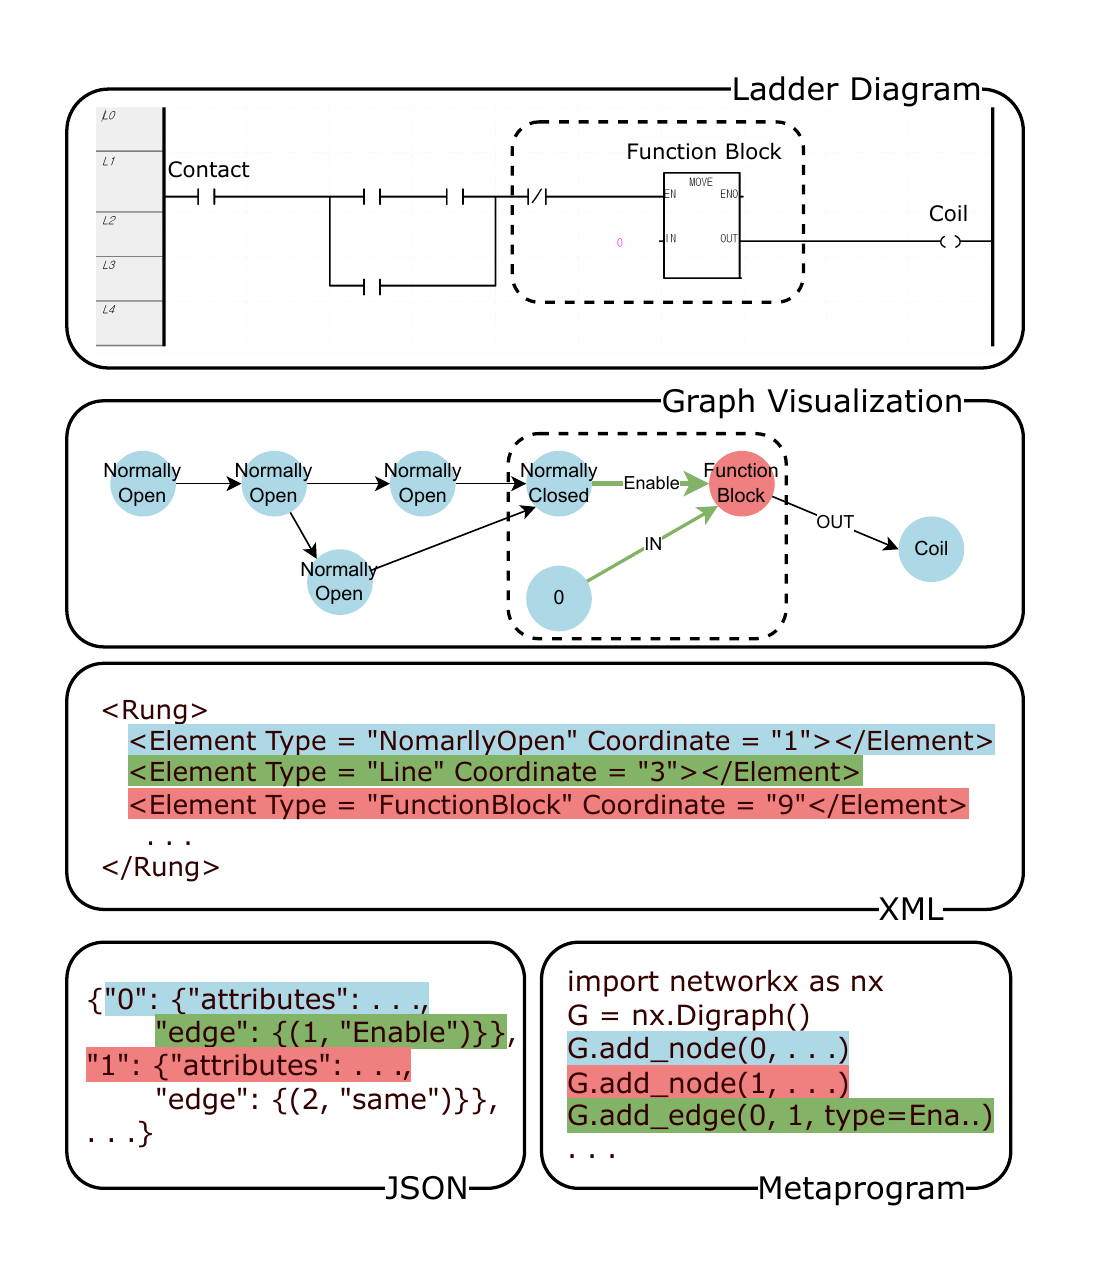
XML 按坐标列出视觉元素,却不显式写出全部拓扑关系。作者用规则读取 element 坐标与 line 位置,忽略 line 节点,以坐标顺序给剩余元素编号,再构造 DAG。JSON 用 node ID 映射属性与 outgoing edges;metaprogram 则输出 G.add_node(...) 和 G.add_edge(...),运行后重建图。
| 表示 | 优势 | 风险 / 论文观察 |
|---|---|---|
| XML | 来自 XG5000,接近原始工业文件 | 关系隐含在坐标和 line 中;模型既要学语法又要学空间规则。 |
| JSON | 结构关系显式,便于解析 | 括号、键和值必须全局一致;长图容易出现小错误。 |
| Metaprogram | 图操作显式且可执行,RAG baseline 的局部 F1 最好 | 论文只验证重建图与标注图一致,未把代码执行等同于 PLC 语义仿真。 |
预测图为 \(\hat{G}=(\hat{V},\hat{E})\)。只有节点/边的全部必要属性精确相等才算集合交集中的匹配项。F1 对“部分图正确”给分;EM 则要求集合完全相等。
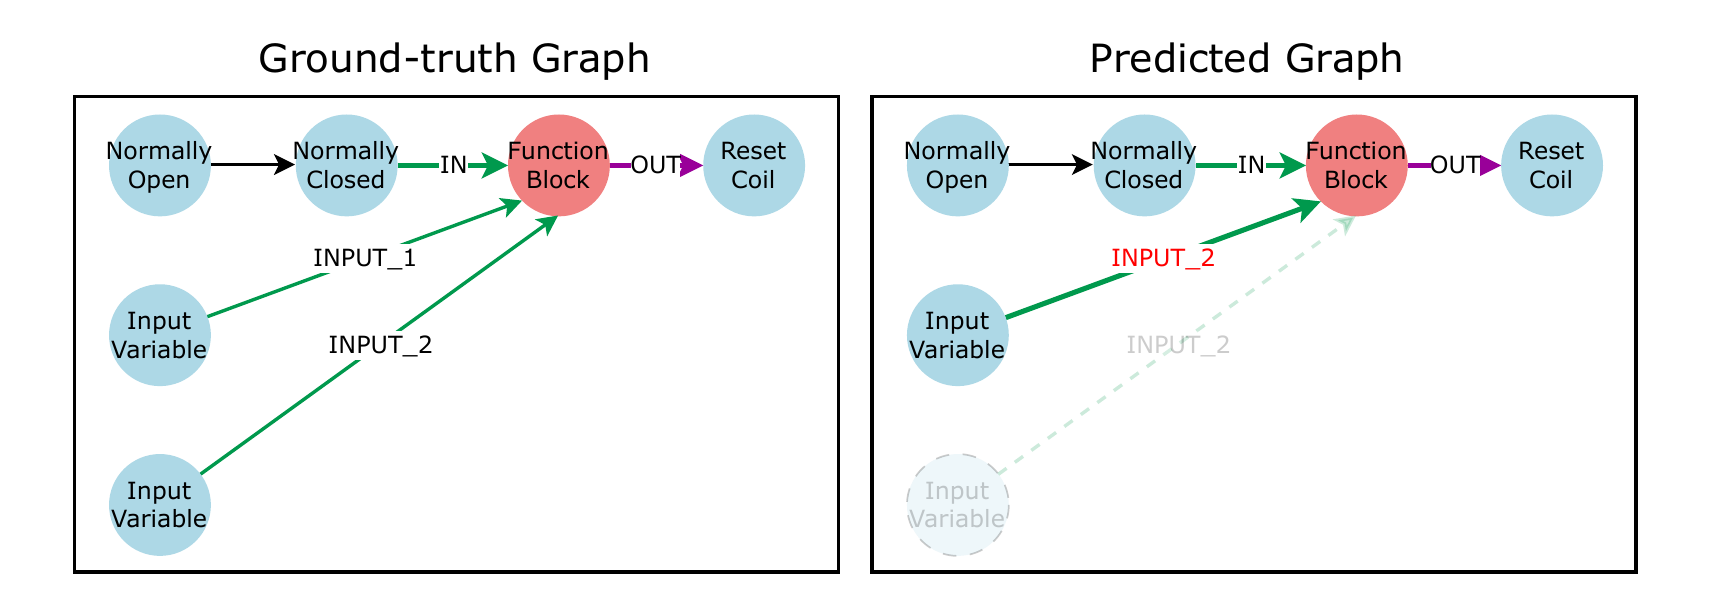
指标很严格地检查结构与字符串属性,但没有执行 PLC scan cycle,也没有检查时序、互锁安全、硬件地址可用性或真实 actuator 行为。
03 / Pipeline
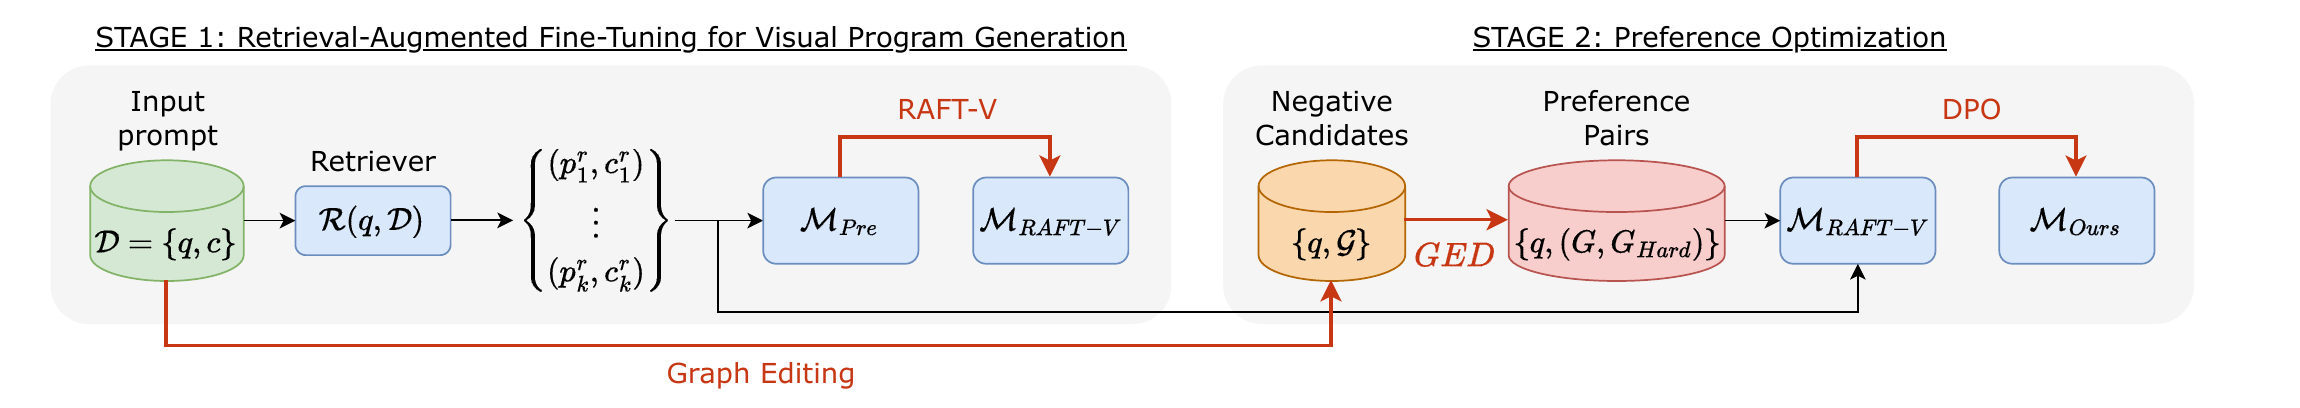
训练集 \(\mathcal{D}=\{(p_i,c_i)\}_{i=1}^{N}\)。给定新 prompt \(q\),检索器 \(\mathcal{R}\) 对训练池排序并返回 top-\(k\) 对:
随后把 query 与示例串接为增强输入:
模型学习 \(q_a\rightarrow c_q\)。主实验 \(k=1\),检索器是 lexical BM25,不是 learned dense retriever。检索池来自训练数据;论文没有说明是否排除了与 query 同源、近重复或同一原始程序切分出的 functional units,这一点关系到泄漏风险。
每个正确图 \(G\) 生成 10 个候选负图。若 \(\lfloor\tau\lvert V\rvert\rfloor\gt0\),随机选节点集合 \(\mathcal{X}\) 删除,并把路径 \(\mathcal{W}\rightarrow\mathcal{X}\rightarrow\mathcal{Y}\) 重连为 \(\mathcal{W}\rightarrow\mathcal{Y}\) 以保持连通;当图少于 10 个节点且主设置 \(\tau=0.1\) 时,不删除,而是复制随机 node–edge pair 并接回图中。这样生成的不是随便乱码,而是结构合法、与真值相近但有语义差异的错图。
删除 1 个节点并重连前后邻居。每个正确图重复 10 个随机种子,再由 GED 选最接近真值的负例。
\(\mathcal{T}(G,G')\) 是把 \(G'\) 变成 \(G\) 的编辑路径集合;作者以 Levenshtein distance 度量 edit path cost,并从 10 个编辑图中选 GED 最低者作为 \(G_{\mathrm{Hard}}\)。直觉是:越接近 ground truth,越能迫使模型学习细粒度结构差异。
04 / Objectives
\(T\) 是输出序列长度,\(\mathcal{V}\) 是词表;\(c_t(v)\) 是 one-hot ground-truth token,\(\hat{c}_t(v)\) 是模型概率。它让模型学会输出正确 LD 文本,但对“正确答案与只错一个节点的答案应有多大差距”没有显式监督。
\(x\) 是自然语言 prompt;\(\mathcal{R}(x)=(p^r,c^r)\) 是检索案例;\(y^+\) 是标注代码,\(y^-\) 是 hard negative;\(\pi_{\theta}\) 是待训练策略,\(\pi_{\mathrm{ref}}\) 是参考模型;\(\beta=0.1\) 控制偏离参考模型的强度。目标不是直接最小化 GED,而是让正确代码的相对 log-probability advantage 高于负例。
论文没有公开代码或数据,因此无法核对 DPO reference model 究竟冻结自哪个 checkpoint、LoRA adapter 如何合并/复制、GED 的 node / edge substitution cost 细节,以及图编辑后的负图如何序列化回三种文本格式。这些步骤会显著影响复现。
05 / Reproduction Sheet
| 来源 | 真实电池 cell 制造产线的 Ladder Diagram,经 XG5000 导出 XML。 |
| 切分单位 | functional unit;每个 unit 含一个或多个互联 rungs,并实现一项功能。 |
| 标注 | 一名有经验的韩国 PLC programmer 为每个 unit 写韩文 Program Description 与 Detailed Description。 |
| 规模 | train 13,124 / validation 500 / test 500,总计 14,124;train 的 80% 用于 Stage 1,20% 用于 preference learning。 |
| 流程分布 | Cell Distribution 2,893;Processing 3,093;Vision Inspection 726;Stacking 3,706;Pack End-plate Supply 2,808;Other 898。 |
| 公开性 | 因商业保密不公开,仅提供匿名样例;这使数据去重、split 独立性和外部复现无法审计。 |
| 项目 | Stage 1 · SFT / RAFT-V | Stage 2 · DPO |
|---|---|---|
| Backbone | Llama-3.1-8B-Instruct;Qwen2.5-7B-Instruct 做跨模型验证 | |
| 参数高效微调 | LoRA rank 256,\(\alpha=256\),dropout 0.05;q_proj、k_proj、v_proj、o_proj | |
| Epoch / batch | 10 epochs / batch 8 | 5 epochs / batch 64 |
| 学习率 | \(5\times10^{-5}\) | \(1\times10^{-7}\) |
| Optimizer | AdamW;未报告 scheduler、weight decay、warmup | weight decay 0.01;warmup ratio 0.03;正文未再次点名 optimizer |
| Early stopping | 每 epoch 看 validation loss,patience 2 | |
| 硬件 / 时间 | 4×A100 80GB;SFT 6 h,RAFT-V 8 h | 4×A100 80GB;6 h |
| 检索 | BM25,主实验 top-1;训练与推理均检索 | |
| 解码 | beam search,beam size 4;未报告 max tokens、length penalty、停止符 | |
Appendix G 给出三套完整 system prompt。共同框架是“你是 PLC ladder logic 编程助手”,要求把自然语言功能说明直接转成目标格式;随后逐条解释 NormallyOpen / NormallyClosed / edge contact、六种 coil、Inverter、FunctionBlock、Variable 等元素语义。XML 版要求输出 <Rung> 与带坐标的 element;JSON 版固定 root graph、node attributes 和 typed edges;metaprogram 版要求 NetworkX directed graph,每个 rung 单独成图。
RAG message template(Appendix F)
system: {对应格式的完整 system prompt}
user:   retrieved_prompt
assistant: retrieved_code
...
user:   test_prompt
RAG 对 malformed 输出做后处理,删除代码围栏和无关片段。论文未说明训练样本的 chat template、示例分隔符、retrieval ordering、token truncation、XML 解析失败率与 beam 候选选择规则。
06 / Main Results
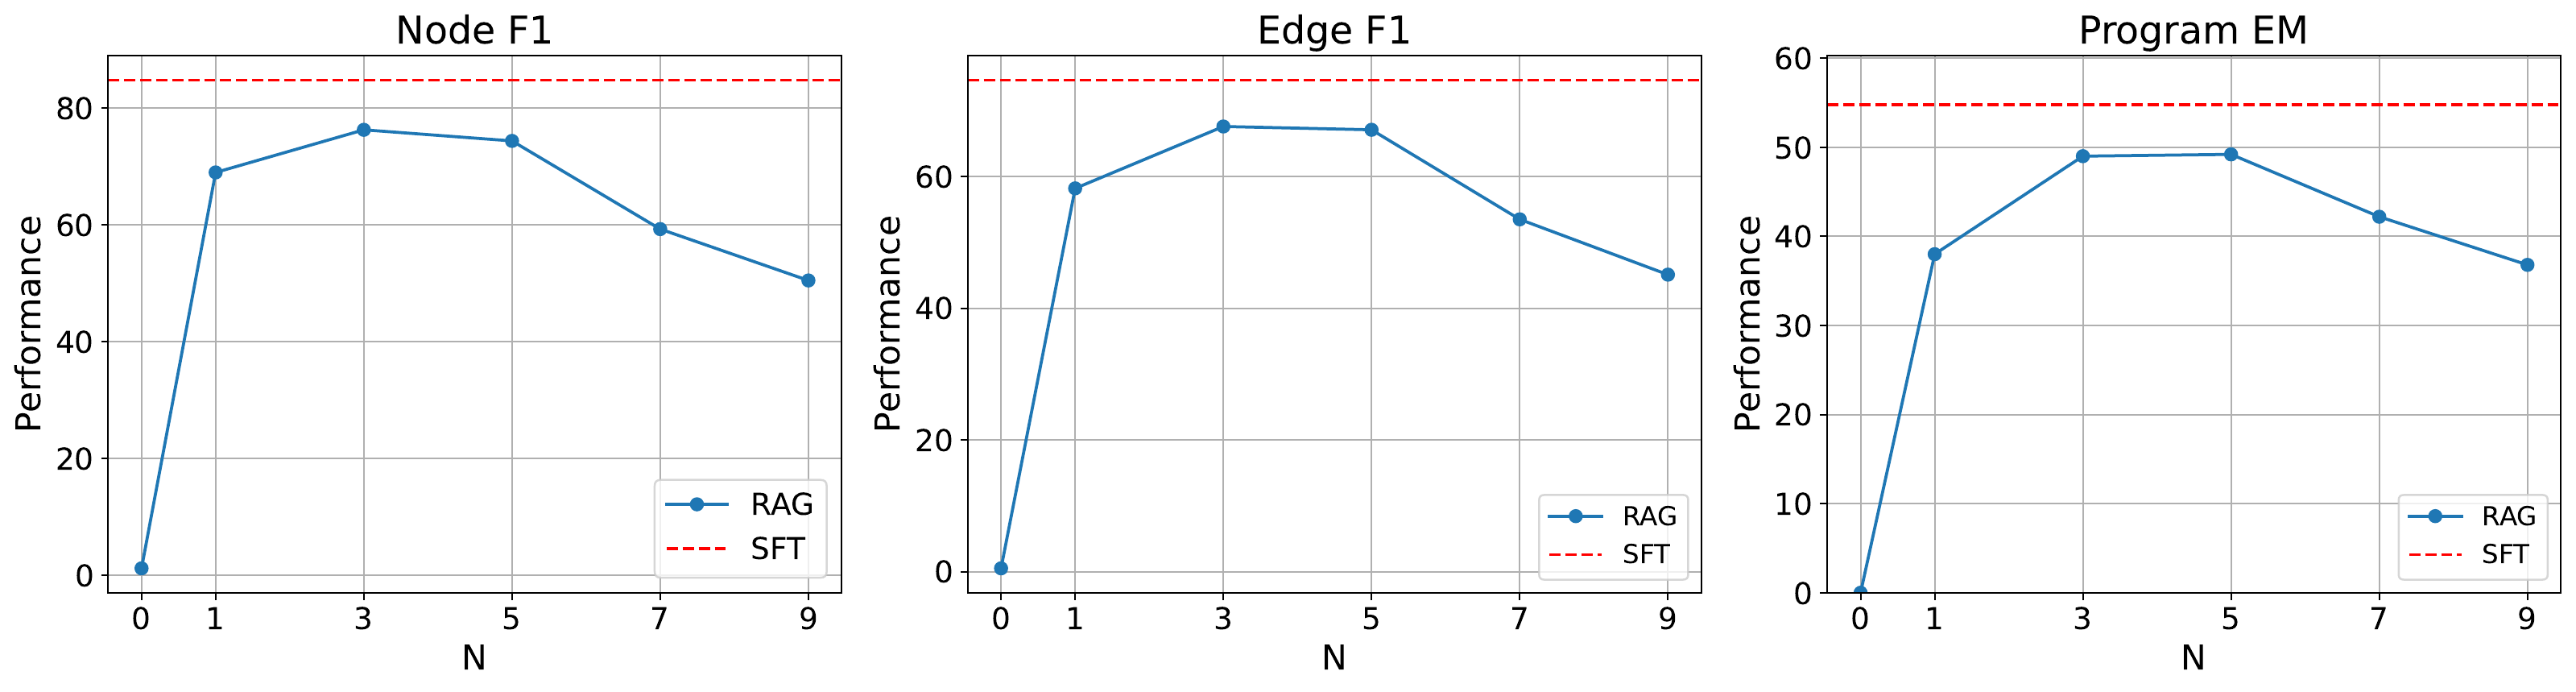
| Format | Method | Node F1 | Edge F1 | Node EM | Edge EM | Program EM |
|---|---|---|---|---|---|---|
| XML | RAG 70B | 74.4 | 67.1 | 49.6 | 49.2 | 49.2 |
| XML | SFT 8B | 84.8 | 74.7 | 55.2 | 54.8 | 54.8 |
| JSON | RAG 70B | 72.6 | 65.7 | 51.6 | 50.8 | 50.8 |
| JSON | SFT 8B | 85.1 | 74.9 | 53.6 | 52.6 | 52.6 |
| Metaprogram | RAG 70B | 80.0 | 71.9 | 52.2 | 51.8 | 51.8 |
| Metaprogram | SFT 8B | 86.3 | 75.7 | 55.2 | 54.0 | 54.0 |
| Format | Method | Node F1 | Edge F1 | Node EM | Edge EM | Program EM |
|---|---|---|---|---|---|---|
| XML | SFT | 84.8 / 79.0 | 74.7 / 68.0 | 55.2 / 46.4 | 54.8 / 45.6 | 54.8 / 45.6 |
| XML | RAFT-V | 88.1 / 87.4 | 80.9 / 78.7 | 63.8 / 59.6 | 62.8 / 58.8 | 62.8 / 58.8 |
| XML | Ours | 89.6 / 87.4 | 82.6 / 79.0 | 66.2 / 61.2 | 65.2 / 60.0 | 65.2 / 60.0 |
| JSON | SFT | 85.1 / 81.2 | 74.9 / 69.3 | 53.6 / 46.0 | 52.6 / 45.4 | 52.6 / 45.4 |
| JSON | RAFT-V | 90.1 / 88.4 | 82.0 / 79.6 | 63.8 / 59.2 | 63.2 / 57.4 | 63.2 / 57.4 |
| JSON | Ours | 90.7 / 88.7 | 83.0 / 80.5 | 66.0 / 61.6 | 65.2 / 60.2 | 65.2 / 60.2 |
| Metaprogram | SFT | 86.3 / 81.7 | 75.7 / 70.2 | 55.2 / 47.6 | 54.0 / 47.2 | 54.0 / 47.2 |
| Metaprogram | RAFT-V | 89.9 / 89.1 | 82.4 / 80.4 | 64.6 / 60.6 | 63.8 / 59.6 | 63.8 / 59.6 |
| Metaprogram | Ours | 90.6 / 89.7 | 83.6 / 81.6 | 68.6 / 63.2 | 67.2 / 61.8 | 67.2 / 61.8 |
对 Llama metaprogram,SFT → RAFT-V 是 54.0 → 63.8(+9.8 个百分点),DPO 再到 67.2(+3.4)。所以总提升 13.2 个百分点中约四分之三来自 Stage 1。Qwen 同方向,但最终 61.8,说明配方可迁移,却没有消除 backbone 差异。
| Method | Functional score(1–5) | Fleiss’ \(\kappa\) |
|---|---|---|
| SFT-only | 4.34 | 0.62 |
| RAFT-V | 4.60 | 0.58 |
| Ours | 4.62 | 0.66 |
3 名获授权的 PLC 工程师评 50 个随机 test cases,先把 metaprogram 转回 XG5000 LD,再看 reference–prediction 截图。RAFT-V 相对 SFT +0.26,而 DPO 相对 RAFT-V 仅 +0.02;这说明 DPO 的 3.4-point Program EM 增益主要在严格字符串/结构完全匹配上,是否有显著实用功能增益并不清楚。论文未报告人评方差、置信区间或显著性检验。
07 / Ablation
| \(k\) | Node F1 | Edge F1 | Node EM | Edge EM | Program EM |
|---|---|---|---|---|---|
| 1(主设置) | 89.9 | 82.4 | 64.6 | 63.8 | 63.8 |
| 2 | 90.6 | 83.5 | 66.4 | 65.6 | 65.6 |
| 3 | 90.9 | 84.0 | 65.4 | 64.6 | 64.6 |
\(k=2\) 的 Program EM 比主设置高 1.8 点,作者仍选 \(k=1\) 并称额外收益 marginal。这个选择有计算效率理由,但主表并非这个消融里的最优 \(k\)。
| \(\tau\) | Program EM |
|---|---|
| 0 | 65.8 |
| 0.1 | 67.2 |
| 0.5 | 66.8 |
| 0.9 | 66.0 |
| Method | Program EM |
|---|---|
| RAFT-V(100%) | 65.2 |
| BoN Random | 65.6 |
| BoN Unstrict | 65.8 |
| BoN Strict | 66.2 |
| Graph edit Random | 66.6 |
| Graph edit + GED | 67.2 |
\(\tau=0.9\) 太容易区分,EM 下降,符合 hard-negative 直觉。Graph edit + GED 比 graph edit random +0.6,比最佳 BoN +1.0。差距不大,且只报告单次点估计,未给随机种子波动;因此可以说设计“表现最好”,不能说 GED selection 已被稳健因果验证。
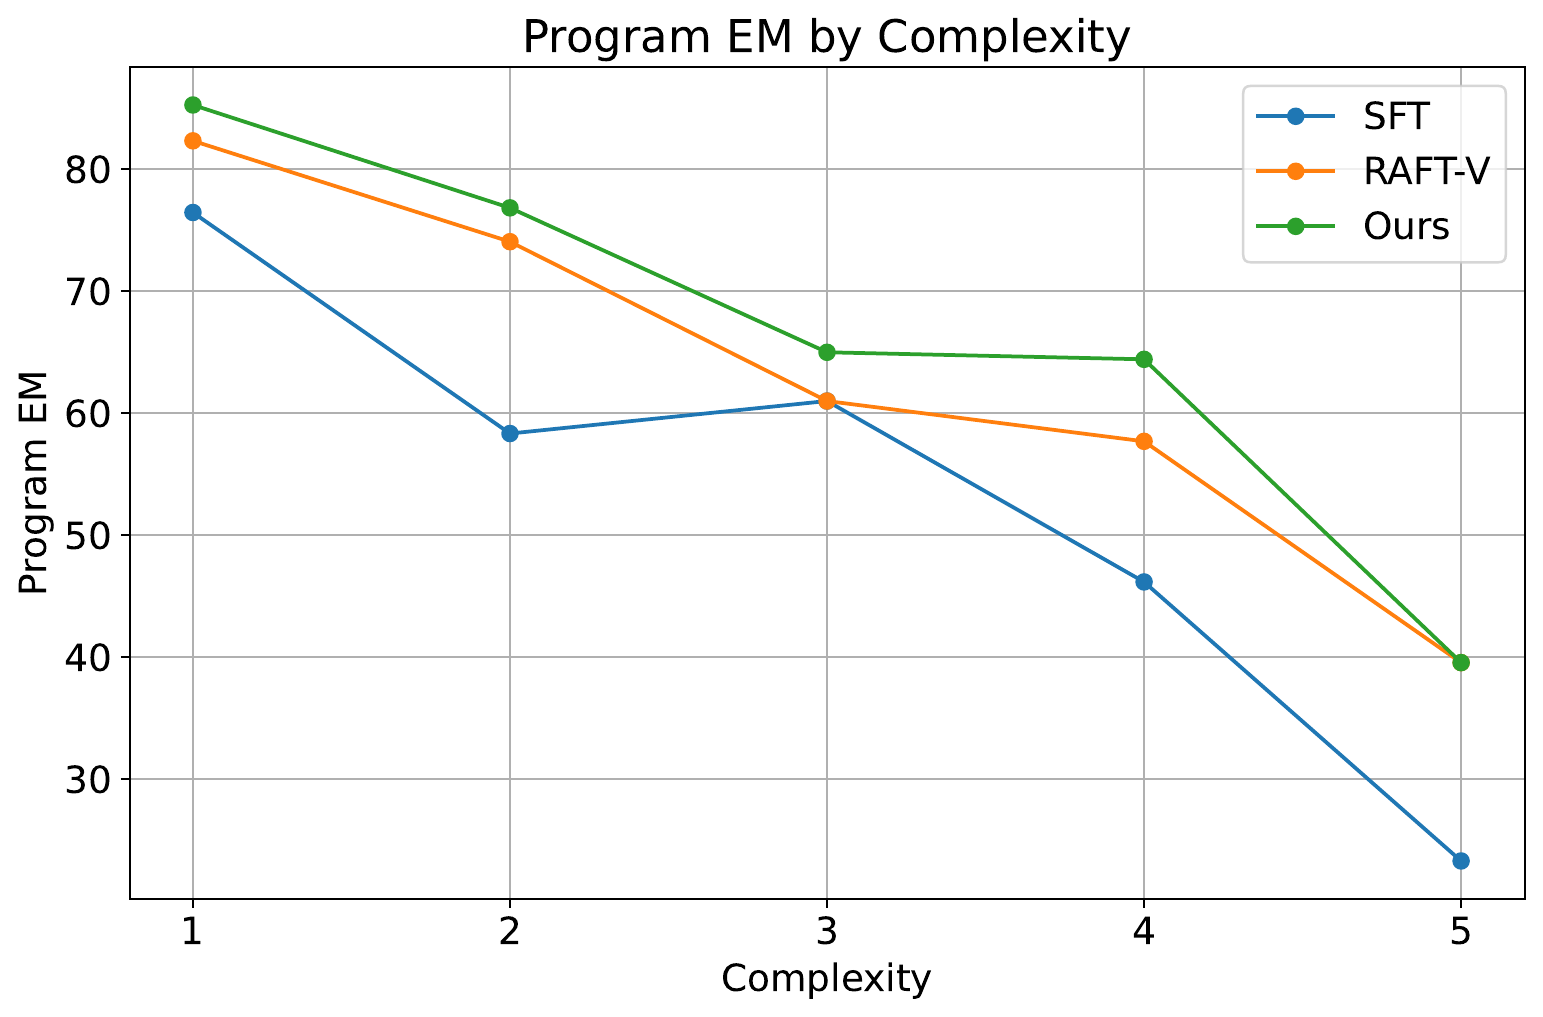
08 / Evidence Audit
两个 7B–8B backbone、三种文本格式、同一私有数据 split 上,RAFT-V 和两阶段方法的自动指标均优于 SFT;50 例人评也给出同方向均值。
“可扩展到其他 IEC 61131-3 LD”是合理期待,却没有跨工厂、跨 PLC 品牌、跨地址方案或公开 benchmark 实验。
BM25 取回相似功能描述与局部子程序,模型结合微调记忆复制/改写结构模式;DPO 主要降低少节点或少边的近似错误。
| 项目 | 论文状态 | 复现影响 |
|---|---|---|
| 数据与 split | 私有;只有匿名样例与类别计数 | 无法检查去重、泄漏、标注一致性,也不能复算结果。 |
| 代码 / checkpoint | 论文、ACL 与 arXiv 一手入口未给官方仓库 | 图转换、GED cost、DPO 序列化与后处理无法核对。 |
| 训练配置 | 主要超参较完整 | 缺 seed、scheduler、precision、gradient accumulation、max length 等。 |
| 推理 | beam size 4 | 缺 beam scoring、长度限制、非法输出率;RAG 有额外后处理。 |
| 安全验证 | graph match + 50 例截图人评 | 没有 PLC simulator、formal verification、runtime test 或产线 shadow deployment。 |
主表中 Qwen SFT 的 XML Program EM 为 45.6,Appendix H 的详细 RAG 表写成 46.0;JSON 为 45.4 vs 46.4;metaprogram 为 47.2 vs 48.0。类似地,正文主表的 Qwen 指标与附录详细表有若干 0.1–1.0 点差异。论文没有解释这些数字是否来自不同运行、camera-ready 更新或抄表误差。网页以主表作为主结论,并透明保留这个不一致。
67.2% Program EM 意味着 32.8% 的 test programs 仍未完全匹配标注图。作者也明确说生成 PLC code 在真实工厂部署前仍需程序员谨慎检查。任何“自动部署 PLC”的宣传都超过论文证据。
09 / Reviewer Commentary
Research Extension · 以下不是论文已验证内容。
| RAFT-V 组件 | 材料图对应物 | 可形成的实验 |
|---|---|---|
| BM25 检索 prompt–code | 按材质描述、节点预览或 graph embedding 检索相似 SBS / shader subgraph | 比较 text-only、image-only、hybrid retrieval,并做 train-time / test-time 2×2 消融。 |
| 图编辑负例 | 删除、复制、错接 material nodes;扰动 blend mode、frequency、roughness path | 用 renderer 验证 hard negative:结构接近且视觉差异细微,而不是只按 GED。 |
| DPO | chosen 为可执行且匹配参考图像的 graph,rejected 为近似错图 | 偏好信号结合 LPIPS、CLIP、法线/粗糙度统计和 graph validity。 |
| Program EM | 拓扑/参数 EM | 必须同时报告 render equivalence、multi-light consistency、editability 与执行成功率。 |
| 人工 review | 材质艺术家评分 | 区分视觉相似、可编辑性、节点组织质量与生产可用性。 |
最值得延伸的不是照搬 DPO,而是把 hard negative 的定义从 graph-near 改成 execution-aware:选择结构距离小、渲染也很像、但在某种光照/尺度/参数编辑下暴露错误的 graph。这会把 preference optimization 真正对齐到 procedural material 的可执行语义。
10 / References
作者顺序:Deokhyung Kang、Jeonghun Cho、Yejin Jeon、Sunbin Jang、Minsub Lee、Jawoon Cho、Gary Geunbae Lee。前两位为共同第一作者。机构:POSTECH Graduate School of AI / CSE、Hyundai Mobis、T&I Company。论文没有显式通讯作者标记;归档时按技能规则将末位 Gary Geunbae Lee 记为未核实通讯候选。