Raven: The Harness of Harnesses for Composable Agentic Intelligence
EverMind AI · arXiv:2609.33439v1 · 2026-09-27 · 中文深度精读 · 2026-10-01
01 · 一页抓住论文
核心判断。 Raven 的研究对象不是一个更大的语言模型,而是如何把“模型 + 执行框架(harness)”变成可调用、可改进、可组合的执行单元。它把异构 agent 的选择与依赖组织成 DAG,把工作产物保存在可追踪的文件记录中,再用独立的完成判断、异常恢复、长期记忆与技能检索支撑长任务。最值得读的地方,是它认真区分了“图结构合法”“模型说完成”“任务客观正确”这三件事。§1–3,pp.4–23
论文验证了什么? 在固定模型的 MAOB 规划比较中,Raven 两个 backbone、四个指标均领先;多个领域 specialist 报告了有竞争力的结果;引自 HarnessBank 的离线 harness 演化与引自 SkillCorpus 的固定技能库比较显示增益。它没有用一个严格同预算的完整端到端实验统一证明“所有模块相加必然超越所有单 agent”,也没有验证默认关闭的 shared group memory。§7;§3.4,p.23;附录 C,pp.77–81
| 快速读数 | 论文报告 | 应如何解释 |
|---|---|---|
| MAOB,140 个任务 | Exact Match:Qwen 0.711;DeepSeek 0.867 | 只评规划图,不执行 worker;比各自最强 baseline 高 10.4、10.5 个百分点 |
| Research,DeepSeek-V4-Flash | 汇总准确率 76.5%,均价 0.0242 USD/题 | 历史观察结果;同题用于开发、未封锁公开答案、预算不完全对齐 |
| Harness 演化,固定 Qwen3.6-27B | AppWorld 41.3 → 56.7 | 引自 HarnessBank 的 held-out 结果,不能归因于 Raven 全系统 |
| 技能库,Raven × Qwen3.5-397B-A17B | SkillsBench 9.2 → 22.6 | 固定检索结果、三次均值;不是在线技能自演化实验 |
| Oncall,内部 17 题 | Claude Opus 5:14/17 对 11/17 | 小样本、人工评判;均价 5.10 对 13.60 USD |
| 证据边界 | group memory 未评估 | 部署机制、理论充分条件和实测结果须分开 |
阅读导航。 想搭系统,读 03–06 与 12;想判断论文是否站得住,读 02、07–11 与 13;想迁移到程序化材质,读 14。以下公式编号沿用论文;没有编号的构造或实验方案均明确标为“解读”或“研究延伸”。原文共 82 页:正文 pp.4–59,参考文献 pp.59–64,理论附录 A pp.65–72,实现附录 B pp.73–76,实验附录 C pp.77–81,作者附录 D p.82。
02 · 动机、任务与理论:增益需要什么条件
2.1 为什么是 harness of harnesses
单域 agent 的能力往往来自很多“模型之外”的细节:什么时候查资料,什么时候读取仓库规范,是否先运行测试,怎样保留上下文,卡住后如何恢复。把这些细节不断堆入一个统一 harness,会同时增加维护成本和领域耦合。Raven 的假设是:让专业 harness 在各自领域改进,由 host 负责匹配与组合,比要求一个通用执行循环包办一切更有潜力。这里的“专业”不是简单替换角色提示词;Claude Code、Codex 等外部 agent 可以保留自己的工具、上下文政策和控制循环,通过 adapter 接入。§1、§3,pp.4–5、13
论文同时保留单 agent 路径。任务不需要多人时,直接调用或单次 spawn 更合适。拆分增加信息覆盖的同时,也增加 planning、handoff、judge、retry 的成本与失败机会,因此“更多 agent”不是优化目标本身。
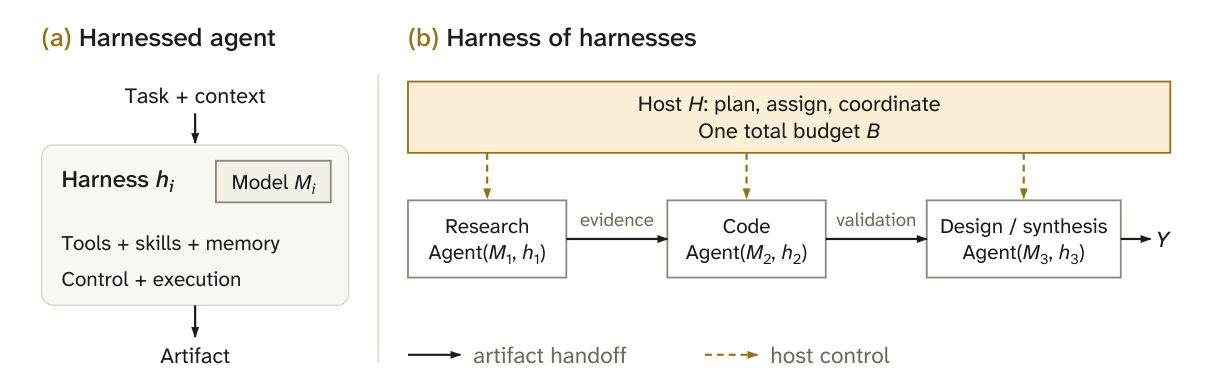
2.2 把能力定义成带预算的任务成功率
式 (1) 把 agent 表示为可观察历史到行动分布的随机策略:
\(M_i\) 是基础模型,\(h_i\) 包括工具接口、记忆、技能和控制规则;\(\mathcal{H}_i\) 只包含该 executor 被允许看到的历史;\(\mathcal{U}_i\) 包括工具调用、返回产物、终止。集合 \(\mathcal{A}\) 也包含禁止跨 roster 委派的 host 执行策略 \(a_0\),因此独立 agent 对照不是被偷偷排除的 host。
任务 \(t=(r_t,\mu_t,E_t,V_t)\):\(r_t\) 是请求,\(\mu_t\) 是初始输入与环境参考条件的分布,\(E_t\) 描述交互后的观察/状态分布,\(V_t\) 判断最终记录是否客观正确。最终记录 \(Y_S\) 包括交付文件及环境改变;崩溃、放弃或不终止记为失败 \(\bot\)。式 (2)–(3) 定义:
\(B\) 是共同资源上限,\(C_S\) 必须把 planning、workers、handoffs、verification、retries 逐项计入且不重复计费。\(\delta\) 是可接受失败率。时间可另设约束,但不能直接把秒、token、美元相加成为一个无单位“成本”。一个 judge 说 accomplished,也不等于 \(V_t=1\)。比较前固定模型、harness 版本、初始记忆分布与原始请求,是这个定义的关键。§2.1,pp.6–7
2.3 DAG 只是骨架,contract 才承载语义
式 (4) 的完整计划是 \(\pi=(G,\sigma,\Phi,\Gamma,\lambda,\mathbf b)\),其中 \(G=(V,E)\) 为有限 DAG;\(\sigma\) 分配 executor;\(\Phi\) 组装输入;\(\Gamma\) 包含合同、实例绑定和不变量;\(\lambda\) 给节点与交接操作排序;\(\mathbf b\) 分配预算。节点与边都是要付费、可能失败的操作,总数 \(K_{\mathrm{op}}=|V|+|E|\)。
节点输入在式 (5) 中为 \(x_v=\Phi_v(d,(m_e)_{e\in\mathrm{In}(v)})\)。\(d\) 是授权任务/context packet,\(m_e\) 是已经记录的传入消息。边可做投影或序列化;真正的额外计算必须成为显式节点,不能藏在“传文件”里。节点合同包含前置条件 \(P_v(x,s)\) 与结果/状态变化条件 \(Q_v(x,s,y,s')\),边合同 \(J_e(y,s,m,s')\) 要求忠实传递及正确状态影响。账本 \(\ell\) 只追加,保存实际输入、输出与执行记录。
兼容性不等于“所有类型相同”。式 (8)–(10) 要求对每个操作 \(j\),不变量逐步建立:
\(A_j\) 表示操作有合法输入且可执行;\(D_j\) 表示它确实完成了所承诺的转换。第一条保证“上一步正确”能启用下一步,第二条维持后续要用的事实,第三条连接局部合同与用户真正的任务。再加式 (11) 的预算条件:
可用归纳法得到 Lemma 1:所有操作成功且预算满足,最终正确记录能够交付并终止。最后一个操作还承担序列化/交付成本;交付失败仍是失败。解读: research 输出“证据不足”,后续 design 不得把它润色成已证实结论;即使所有文件路径存在,语义合同依然可能被破坏。§2.3,pp.7–9;附录 A.2,pp.65–66
2.4 可靠性推导不要求错误独立,但要求分布匹配
式 (13) 的 contract realization 要求 provider \(\kappa\) 对一族允许的输入状态分布 \(\mathcal L\),在预算 \(b\) 内被接受且真正满足合同的成功率至少 \(1-\epsilon\)。这不是在任意独立 benchmark 上取得相同平均分就够了。实际 host 选出的计划、已有成功前缀和隐含状态,会改变后续节点的输入分布。
固定一个合法 planning pair \((\zeta,\pi)\),令 \(F_{j-1}\) 表示前 \(j-1\) 个操作全部客观成功。论文要求式 (15):
第一次失败发生在不同 \(j\) 的事件互斥。逐项求和并取补集得到 Theorem 1:
附录 A.4 还给出更紧的乘积下界 \(\prod_j(1-\epsilon_j)\),依赖的是上述条件概率界,并非假定各节点独立。局部测试到真实工作流的桥梁,是 conditional entry-law membership 与 outcome kernel consistency:真实调用必须属于局部保证覆盖的分布,且采用同一个条件结果机制。
若 host 选到合法计划的概率至少 \(1-\eta_H\),合法计划上的累计错误上限为 \(\bar\epsilon\),式 (20) 给出:
不能省略的限定。 runtime 无须、也未必能判定完整语义合同;有序无环不保证共享状态无竞争;并行执行还需能映射为保留输入、观察、状态效果、acceptance 与成本的合法串行轨迹。仅有不同文件名或不相交状态 footprint,不足以保证时间敏感服务的行为也不变。这个理论提供充分条件,不是给实际 Raven 的每条 workflow 签发可靠性证书。§2.4,pp.9–11;附录 A.4,pp.67–68
2.5 “能力超出单体”的结论究竟有多强
局部互补的定义是每个节点的合格 executor 集合 \(\mathcal R_v\) 都非空,但 \(\bigcap_v\mathcal R_v=\varnothing\):每段有人能做,却没有同一个 executor 满足全部局部合同。然而,一个单 agent 可能换一种整体策略绕过该分解,因此还需要独立的端到端上界。式 (23) 的严格条件为:
论文的构造例子是两个独立公平 bit \(U,W\):一个 agent 只能读 \(U\),另一个只能读 \(W\),host 的非委派版本两个都不能读。单体猜异或 \(U\oplus W\) 的成功率最多 \(1/2\);通过两次精确交接、再由第三节点计算异或,足够预算时组合可达 1。这证明相对于指定工具接口池的新增任务覆盖;给一个单 agent 同时配上两种读接口,它也能解题。不能由此推出新的可计算性等级、所有任务平均更好,或原单体能力并集被严格包含。§2.5,pp.11–12
附录 A.3 的黑盒搜索反例进一步限制泛化:在 \(N\) 个位置中无先验地找目标,最多查询 \(n\lt N\) 个位置并返回已查询位置,平均成功率不超过 \(n/N\);多 agent 共享同一总查询预算也逃不开此界。附录 A.5 构造 primitive、sequential、fork–join 的类型化任务语法;fork/join 与四次连接传输显式计费。限定展开节点与边数量,再给统一预算与错误包络,才得到独立于事后成功案例定义的任务族覆盖。无限长任务族不能仅凭每个任务存在某个有限预算,就说存在一个统一有限预算。附录 A.3–A.5,pp.66–72
03 · 系统运行:从用户目标到可追踪产物
3.1 registry、按需指导与提交前验证
registry 的四类 backend 是 in-process Raven loop、CLI process、ACP connection、OpenAI-compatible API。每个 executor 声明是否 stateful、能否读本地文件、是否报告进度。内置 General Raven 与 Research、Code、Design、Oncall 四个 specialist;外部预设含 Claude Code、Codex、OpenCode、Hermes、OpenClaw。host 从能力说明与当前上下文选择,没有另训 routing classifier,也没有 oracle capability score。§3.1,pp.13–15
host 常驻的只是编排指南摘要;需要多个 agent 时才加载完整规则并在 session 中保留。没有加载指南不会硬性阻止提交,但错误返回包含指南指针。这样把复杂编排规则的 context 开销推迟到确实需要时。
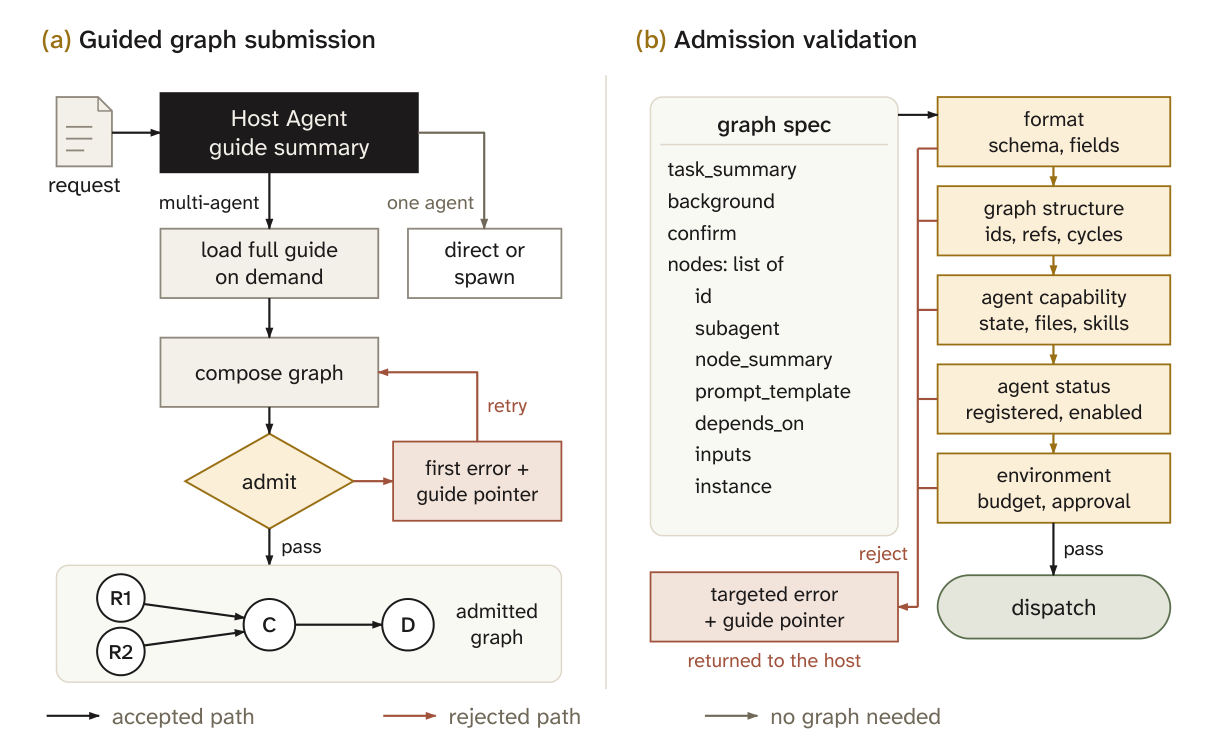
| 接口/检查 | 关键内容 | 防止的问题 |
|---|---|---|
| graph | task_summary、nodes;background 默认 true;confirm 默认 false | 区分异步执行与用户确认流程 |
| node | id、subagent、node_summary、prompt_template;可选 depends_on、inputs、instance | 可定位的任务、执行者、输入依赖 |
| format | 完整 JSON、字段类型、非空值、无未知字段 | 结构无法解释 |
| graph structure | session 唯一 ID、引用存在、依赖声明完整、路径在许可根内、无环 | 重复执行、越界文件、悬空依赖 |
| capability/status | stateful 才能共享 instance,file-capable 才能接收路径;已注册且启用 | 把不可执行接线留到运行时 |
| environment | 禁止 sub-agent 内递归 delegation、预算可用、按需审批 | 无界派生与越权执行 |
表格重建自原 Table 1(p.16)和 Table 9(p.74)。验证按上述顺序遇首错停止;拒绝图不会启动一部分 worker。runner 预留 ID 时重检,避免并发提交争抢同名节点。inputs 可绑定 literal、file 或既有 node;template 可插入上游内容或路径。替换进去的文件/输出标为 untrusted data,不能让引用资料升级成 host 指令。host 必须显式带上相关目标与约束,worker 不自动获得 host 私人对话。
3.2 依赖就绪不等于“上游刚返回文字”
状态为 pending、running、completed、exception、failed、skipped、cancelled。ready 节点必须 pending、未提交且所有图内前驱 completed 并已完成 adjudication。Submitted 集合避免排队节点重复投递,Unsettled 集合避免下游过早读取尚未判完的结果。共享 semaphore 同时约束所有 graph 与单次 spawn;同 instance 的节点顺序运行,不同实例可并发。一个短分支完成后,其后继无需等无关长分支。§3.2,pp.15–18
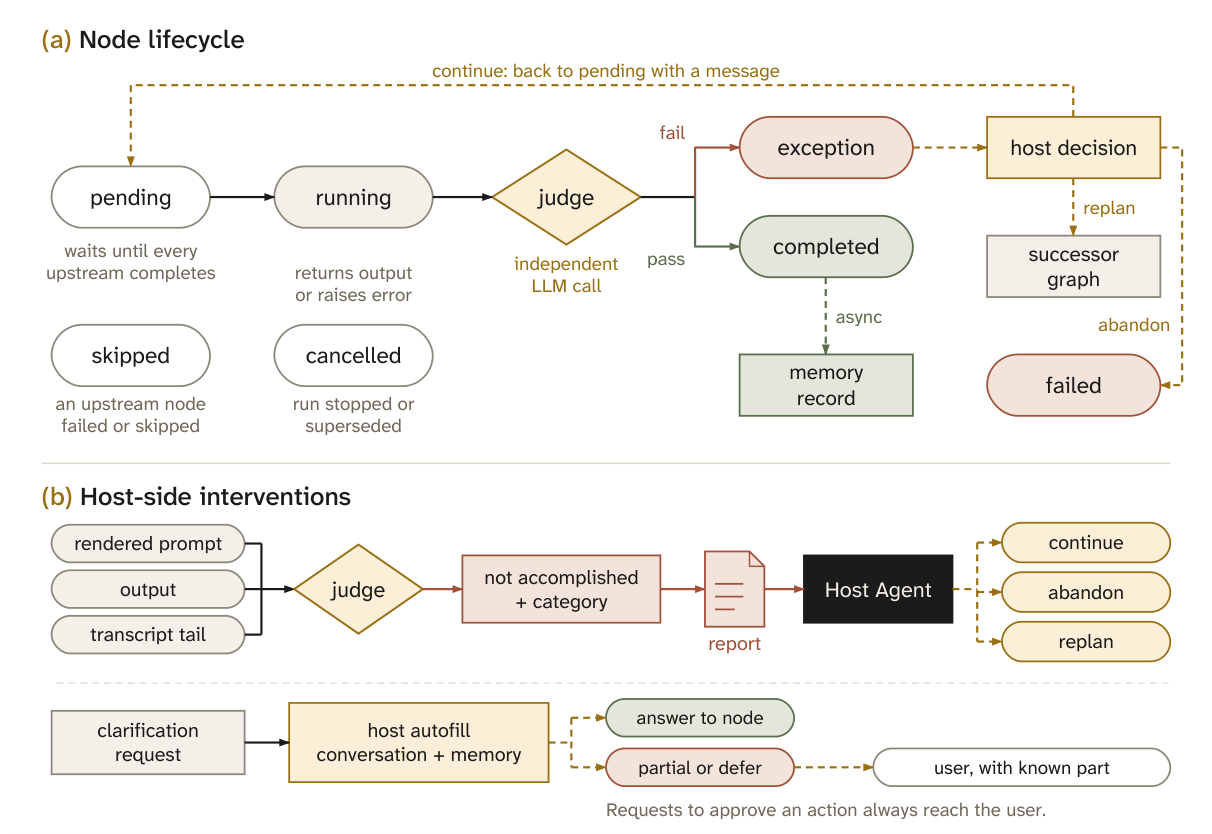
独立 completion judge 看 rendered prompt、output、transcript tail,以及证据完整/输出截断标记,通过 constrained tool 返回 accomplished 或 not_accomplished。负例分 missing user input、credential、tool failure、dependency unusable、output limit 等。证据支持的否定研究结论可算完成;“无法进行研究”不是。判失败会移除 output reference,阻止后继消费。
可靠性缺口。 judge 失败或超时的 availability fallback 会把正常返回的调用视为 accomplished。这是可用性权衡,不是保守的正确性保证。domain tests 和最终产物检查仍不可少。
exception 节点可由 host continue、abandon、replan。默认最多两次额外 continuation,600 秒决策期限。stateful agent 只接续新消息,stateless agent 接原 prompt、旧结果与新消息。replan 启动有新 run ID 的 successor graph,旧 completed 产物仍可引用,未完成节点取消/跳过;不会抹掉原记录。前驱 failed/skipped 会令 pending 后继 skipped,exception 则暂不传播失败,给修复留下机会。
3.3 文件账本与记忆是两条信息通路
每节点保存 prompt、output、transcript;每次 continuation 保留编号版本。host 的 run report 只展开末端节点输出,其他给状态/实例/路径;需要时再读文件。这减少长报告在 host 反复改写、损失细节和重复占 context。session-wide ID 允许后续图复用已完成节点,也允许继续同一实例;失败或运行中的节点不能伪装成已完成依赖。§3.3,pp.19–20,Figure 6
artifact completion 释放依赖,memory recording 异步执行。file-capable 节点获得传递祖先 memory record 的路径,按需读;不支持文件的 agent 不能收到无用路径。worker 自有 backend 与 host captured trace 两条保存路径保留来源身份。解读: 即时产物是这次工作流的必要输入;memory 是未来可能有用的经验,它们不能相互替代。
3.4 shared group memory:机制细致,实证仍为空
该层按 owner 区分个人 user library、host shared library、agent library;host 作为 broker,group 层不读个人 library。planning 前按当前任务检索共享/各 agent 记录;dispatch 时合并共享经验和该 agent 最近 verdict,后者按时间而非语义相关排序。共享 owner 的实例不相互隔离。
round 完成先以执行状态和产物是否被消费生成 deterministic outcomes,再由 host 在回复中产生 attribution。下一次用户回合可追加 feedback verdict,并修订原 outcome;close verdict 不覆盖。append-only provenance ledger 保存原始 assessment,避免后端抽取改写损失作者/对象/来源。记录不自动过期,host judgment 可能错,且同一产物被后继调用不等于质量好。原文明确:默认关闭,本报告未评估,不能把它写成已验证的 credit assignment 学习机制。§3.4,pp.20–23,Figure 7、Algorithm 2
04 · Harness 自演化:冻住模型,改变执行策略
4.1 四个可编辑接口与不可编辑测量核心
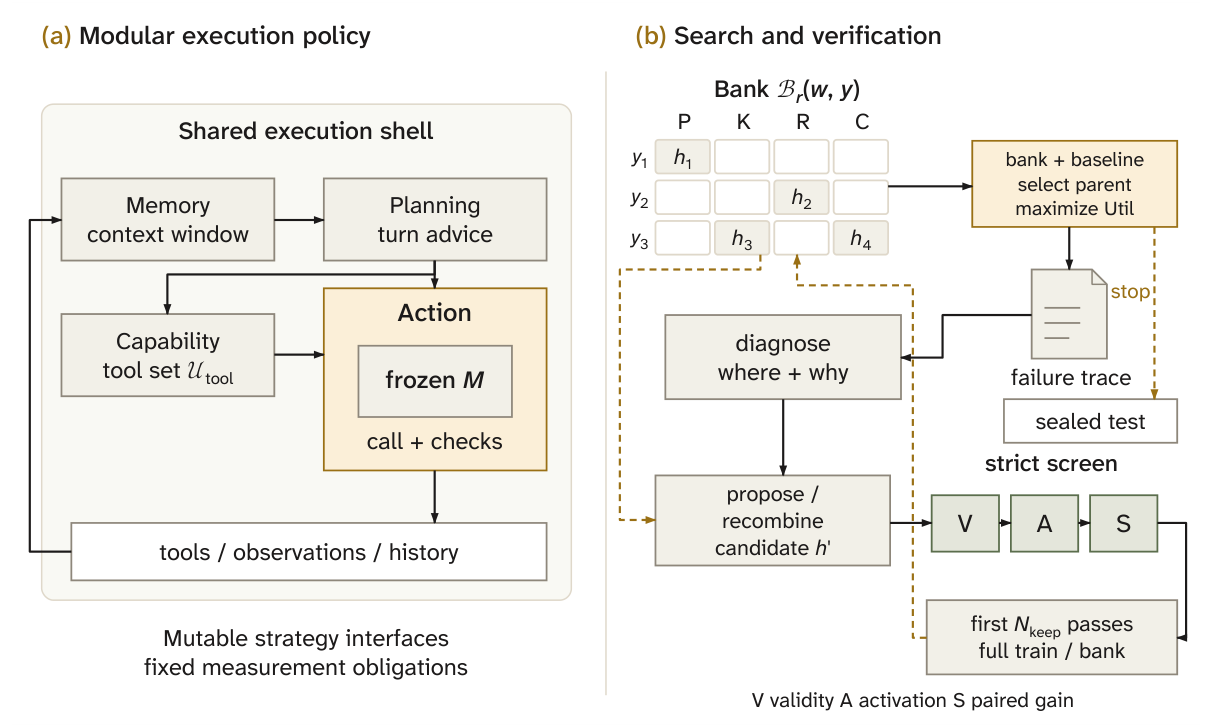
式 (39) 写作 \(h=(\mathrm{id}_h,\mathrm{Mem}_h,\mathrm{Plan}_h,\mathrm{Cap}_h,\mathrm{Act}_h;\theta_h)\)。Memory 决定工作窗口与压缩;Planning 提供 turn guidance;Capability 决定暴露哪些工具;Action 调模型、处理可用响应并判断行为/完成。共享 shell 负责 dispatch、记账、持久化、events 与有限 retry。这里 \(\theta_h\) 是 prompt、领域知识和设置,不是 foundation model 权重。§4.1,pp.24–25
式 (40)–(41) 表示从上下文到工具集合再到动作的接口,不是训练 loss。编辑范围 \(X_{\mathrm{edit}}\) 与固定核心 \(K_{\mathrm{fixed}}\) 不相交;每个候选累计改动都必须维持原 baseline 的限制与 InterfaceValid,不能改评分器、记账或必要执行接口。
4.2 诊断、gene bank 与搜索过程
Task Agent 用冻结模型执行,Evolver 提改动,固定 Evaluator 独立打分。一次诊断应列出症状、trace 证据、可编辑位置、预期改变。例如 reasoning budget 耗尽后空答,适合增加 recovery;代码未验证就 final,适合 finalization check。proposal 还须在评估前声明 activation predicate,测量该机制是否真的执行,而非只接受“我修好了”的描述。
gene bank 的 cell 是“编辑类别 × failure pathology”。编辑类别为 prompt、knowledge、runtime、config,和上述四个 strategy role 不同:修改 Memory 代码也可能是 runtime edit。每 cell 保留一个完整候选与日志,支持不同失败模式的质量多样性。每轮选 baseline 与 bank 中训练分最高的 parent;可从诊断新造 patch,也可重组旧 lineage。组合机制可能互相干扰,必须单独评估,不能把各自提升相加。§4.2–4.3,pp.25–27
4.3 utility 与三个筛选门
训练集 \(D_{\mathrm{tr}}\) 与 sealed test \(D_{\mathrm{te}}\) 分离,每任务 \(K_{\mathrm{att}}\) 次打分。式 (43) 为:
这是每任务尝试成功率的均值,不是至少一次成功的 Pass@K。reference 实验 \(K_{\mathrm{att}}=3\)。agent 失败必须留在分母;infrastructure failure 按声明规则修复,仍无效的评估不能入选。比较 cached parent 记录要求环境稳定,环境变化则共同重测,不能混排不同环境分数。
每轮无放回抽取同一 screening subset \(D_r\) 比所有候选:先检查完整有效日志,再确认至少有一次目标机制 activation,最后做 paired task-level gain:
式 (52)–(56) 先在任务内平均三次尝试,所以统计样本量是 \(n\),不是 \(3n\)。标准误为零时,正增益记 \(+\infty\),负增益记 \(-\infty\),零增益记 0,并显式标记。1.96 是操作阈值;分母是估计方差,形式像 paired t,论文明确不是精确有限样本 5% 检验,也没有 family-wise 显著性保证。activation 仅证实某机制发生过,不证明最新 edit 的因果贡献,更不要求所有 donor 机制都激活。
按固定 proposal order 收前 \(N_{\mathrm{keep}}\) 个通过者,再在完整训练集确认;只用完整有效 full-training log 更新 cell。新 cell 可以保留低于全局 parent 的候选,以利未来重组;选最终 deployed harness 仍看全局训练 utility。cell 平分保留 incumbent,parent 平分按固定创建顺序。达到 round cap、连续无 cell 更新 patience 或开发预算后停止,冻结选中 harness 再测试。cached training utility 单调不降,不代表 unseen performance 单调上升。§4.4,pp.27–29,Algorithms 3–4
复现缺口。 七组结果引用 HarnessBank v2;Task Model 为 Qwen3.6-27B、Evolver 为 Claude Opus 4.8。附录 B.4 明说没有完整 per-run manifest,无法从报告还原各轮 subset、proposal order、全部 \(n,J,N_{\mathrm{keep}},R_{\mathrm{round}},P\) 和 retry limit。不要以“算法写清楚了”替代“结果可原样重跑”。附录 B.4,p.75
05 · Memory:先保存情境,再重建相关证据
5.1 用户事实与 agent 经验分轨
EverOS 以语义边界切连续消息段,形成逻辑 MemCell:episode narrative、atomic facts、foresight、grounding metadata。episode 用第三人称叙述并消解指代;facts 是可独立匹配的原子陈述;foresight 是带有效时间区间的计划或临时状态;metadata 保留时间、来源、owner、session 等。它们在存储里是相关联的独立对象,并非一个不可分 blob。Raven 还会在 completed turn 时 flush,所以回合边界影响记忆粒度。§5.1,p.30
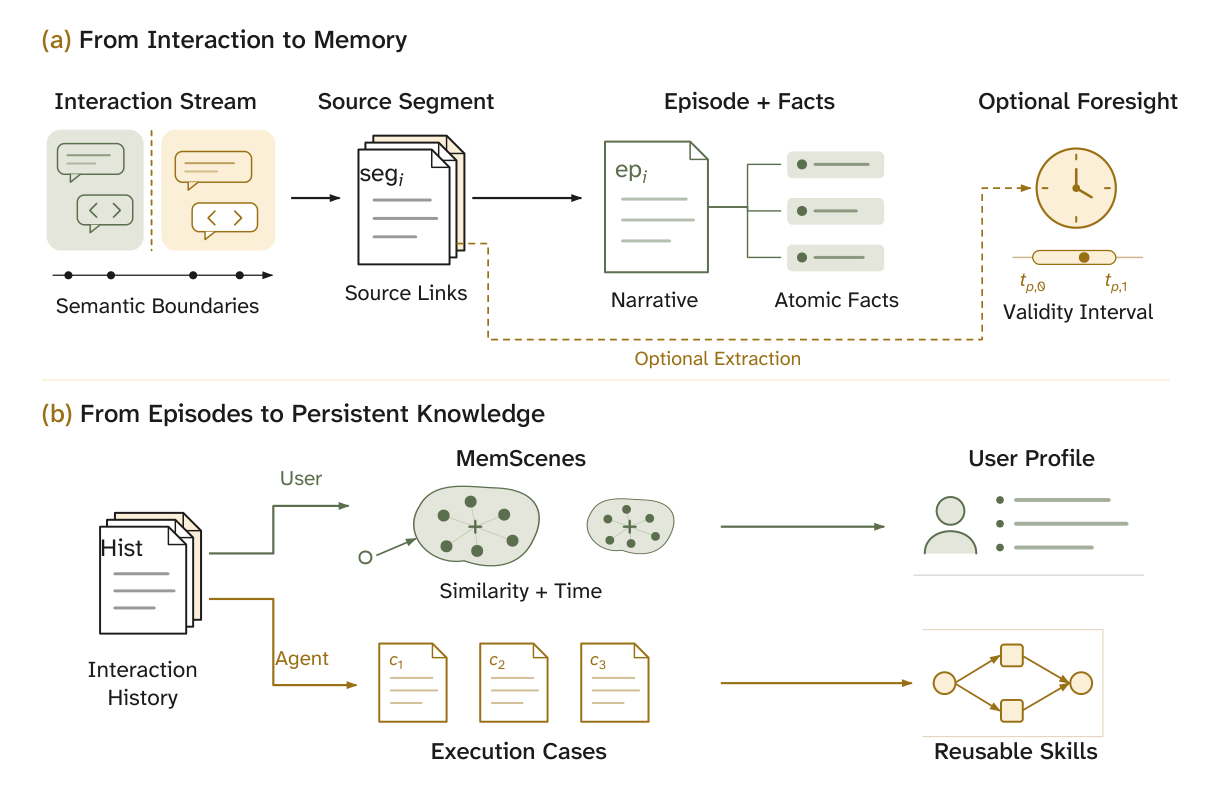
用户 episode 经 embedding online clustering 成 MemScene;默认 cosine threshold 0.65、时间窗口 7 天,数值稳定项 \(10^{-9}\)。取时间窗口内最相似 scene,超过阈值就更新 centroid:
式 (59)–(61) 中,时间窗口只限制聚类,不会让旧 episode 失去可检索性。profile 由最近更新 scenes 对应的 source segments 和旧 profile 生成;乱序摄入的当前 scene 仍强制纳入。无 embedding 时可按时间取近期段更新 profile。可选 reflection 则合并 episode 并将旧 episode/facts 标成 deprecated,这是另一条更强的维护路径,不等于普通聚类。
5.2 HYBRID 的两个分数不能混为一谈
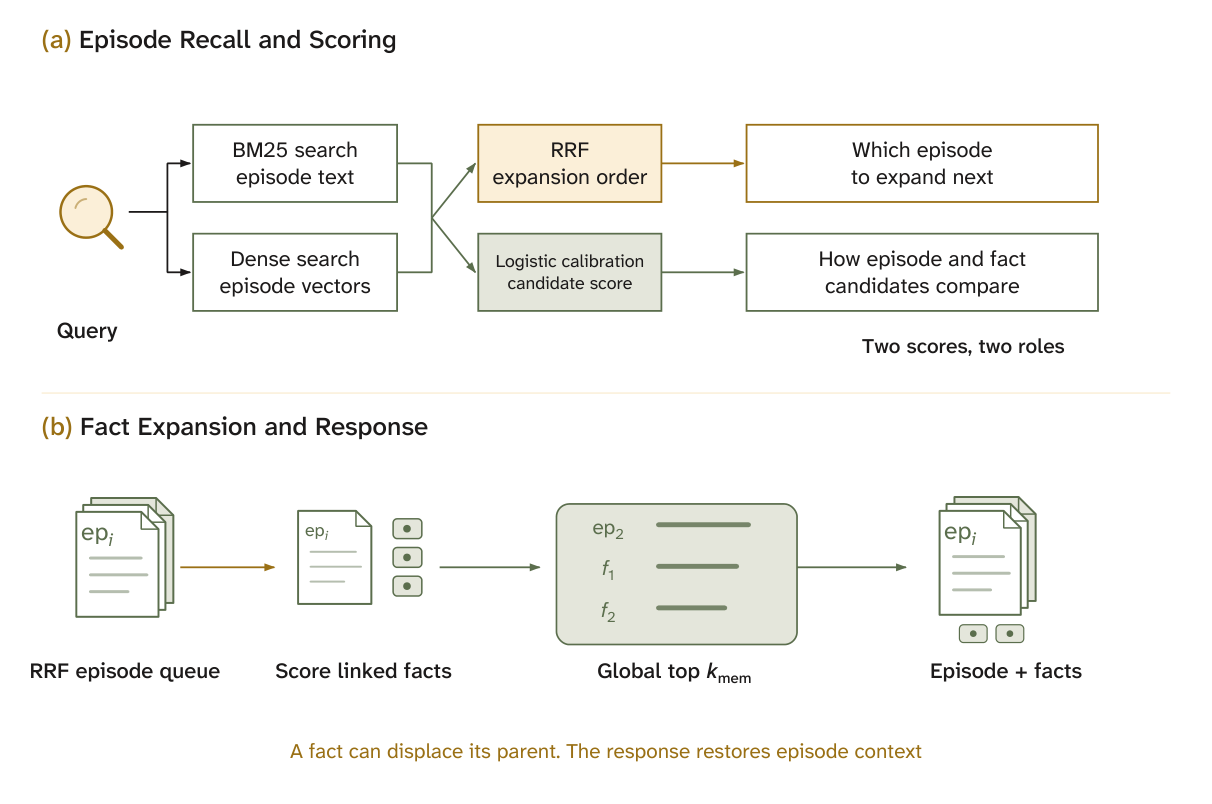
用户查询先用 BM25 与 dense search 找 episode;RRF 决定“先展开谁”,logistic calibrated score 决定“最终谁相关”。式 (62)–(64):
fact 使用自己的 dense score、父 episode 的 lexical score,默认 \(\alpha=1\)。高相关 fact 可以挤掉 parent 的候选槽位,避免重复占预算;返回结果时再按 parent 分组,恢复 episode 情境。RRF damping 60,每次扩展最多 3 个 facts,选中 ID 连续 10 步不变可停止。\(k_{\mathrm{mem}}\) 是 backend 候选上限,\(k_{\mathrm{recall}}\) 是 adapter 最终返回条数,二者不是同一预算。§5.2–5.3,pp.31–33;Table 10,p.75
5.3 上下文注入与持久化边界
host 还有 Markdown archive:普通回合选与输入词面重叠最多的两个 profile sections,加全部 Notes sections。EverOS recall 同时取 episodes 与 profile;profile 被赋 adapter score 1.0 插入同一列表并占最终返回名额,这个 1.0 是排位约定,不是置信概率。Recall 用 untrusted wrapper,和 archive 顺序拼接。任一层不可用就为空,回合继续;无 embedding 时降为 keyword retrieval。
episodes、facts、profiles、cases、skills 保存为 Markdown;SQLite 保存运行状态、source segment payload 与 cluster membership;LanceDB 默认、Milvus 可选提供派生检索索引。索引异步更新,可由记录重建。写入按 session 串行且有队列/重试。agent track 从执行段提取 intent、approach、insight、estimated quality,再进入 skill 流程;不会直接当成用户 profile 内容。§5.4–5.5,pp.33–34
06 · Skill Forge:检索、执行与改进是三件事
6.1 固定语料的清洗与质量分
论文引用的 SkillCorpus snapshot 有 96,401 个 active skills。SKILL.md 分 name、description、procedure body、resources、metadata;名字不是全局唯一 ID。六阶段清洗包括解析、结构/长度过滤、去重、质量与问题标记、release admission、prior/embedding/index。1024 维 embedding 的 cosine 相似度超过 0.995 自动合并,位于 (0.90,0.995] 时交给 LLM 判断。§6.1,pp.34–36
utility、robustness、safety 先给 0–10 整数再归一化。19 种 issue flags 对对应 facet 加上限;prompt injection、command injection、unsafe execution、auth bypass、CSAM risk 是 hard flags。release 要满足 license policy、无 malware、无 hard flags、safety 至少 0.3。
式 (68)–(70) 的 attenuation 在 safety 0.3 → 0.7 区间由 0.5 线性升到 1,高于 0.7 则为 1;scripts 目录加 0.05,references 加 0.02。附录 B.5 的 source prior 对 source 平均内容质量做 pseudo-count 10、先验均值 0.685 的 shrinkage,再混入 license coverage 与 trusted-source bonus。这些是固定 curation heuristics,不是成功率;任何 prior/bonus 不能覆盖 hard rejection。
参考检索模型为微调的 Qwen3-Embedding-0.6B、Qwen3-Reranker-0.6B,检索字段由 body 压缩到 3000 字符。Raven online router 和 SkillCorpus reference stack 有差别:前者多来源融合、给选择器截断片段;后者实验给同一预先选择的完整 skill bodies,二者不能当作同一实验证据。
6.2 online selection 的实际顺序与弱点
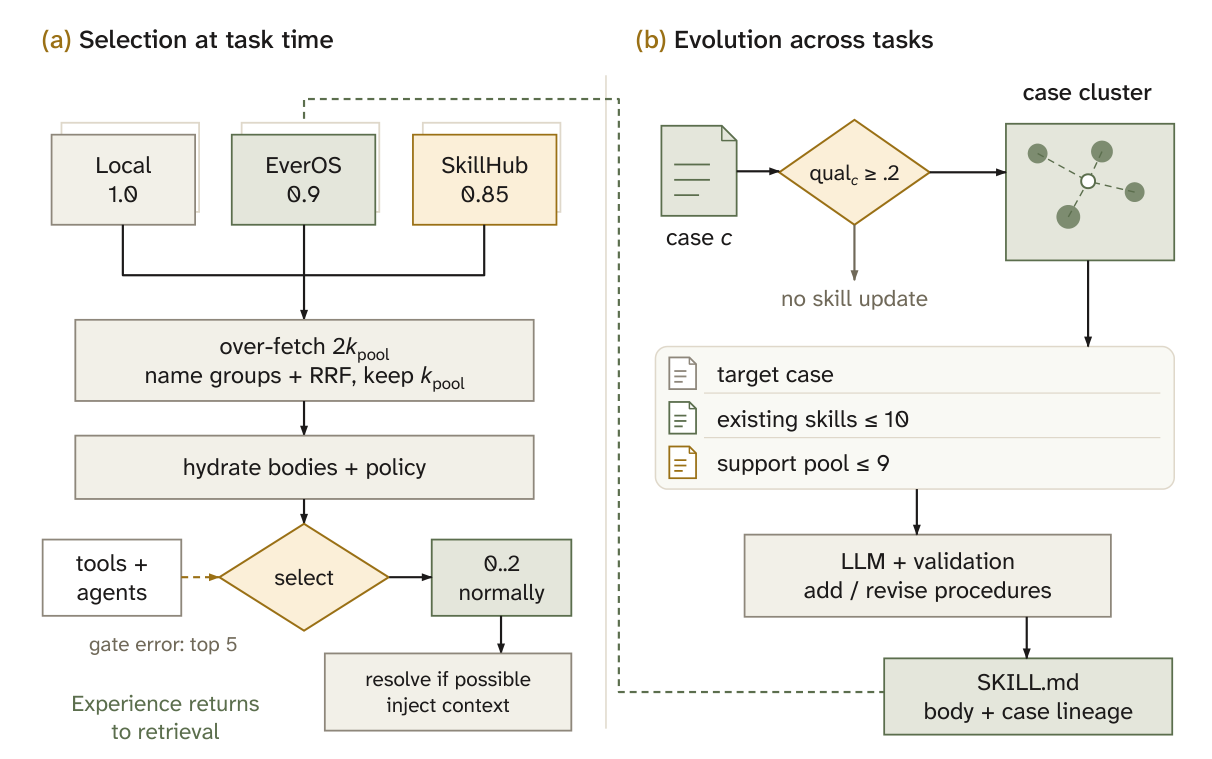
- 可选 rewriter 判断是否需要 skills,清理无关身份信息并形成 query;明确 skip 则无技能,rewriter 失败则用原 query 继续
- local、EverOS memory、SkillHub 同时各取最多 \(2k_{\mathrm{pool}}\) 命中,单 source 失败不阻断其他 source
- 按精确同名分组,用 weighted RRF 排序;默认 weights 为 1.0、0.9、0.85,damping 为 10,gate pool 为 10
- 每个同名组的内容代表另按 source-native score 最大值选;随后去 blocked、获取 body、做 runtime policy,过滤后不从较低排名补位
- LLM gate 看到 query、ID、200 字 description、300 字 body excerpt,以及工具/specialist roster;正常选 0–2 条,成功返回空列表就是不选
- gate call 或 parsing 失败则 fallback top 5;它可能比正常路径注入更多内容,且重复已知 ID 会保留并占 cap
- 最后才按策略解析或下载 resources;安装失败仍可能保留 body 与未解析引用,因此“选中了”不是“可执行”,更不是“执行成功”
上表步骤来自 §6.2、Algorithm 5、Table 10(pp.36–38、75)。一个重要实现细节:RRF 不比较 source 分数尺度,但representative selection 仍比较 native scores;重标定某 source 的分数可能改变注入版本而不改变该 name 的 RRF 排名。精确同名 collapse 也不验证语义相同。SkillHub runtime detail safety 下限是 0.7,区别于 corpus release 的 0.3;missing 或 malformed safety score 不触发这条拒绝,不能理解成“未知一律阻断”。
6.3 online case-to-skill 更新
每个 agent-mode segment 提取零或一个 substantive case;同一经验可复制到多个参与 owner,不能因此算多个独立成功。quality 低于 0.2 或缺 embedding 时不更新;0.2–0.5 用 failure prompt,至少 0.5 用 success prompt。intent clustering 最多召回 30 个 centroid,相似度至少 0.85 直接 merge,否则让 LLM 选 cluster 或新建;不设时间窗。按 owner 加锁,保留最多 5 条 preview。§6.3,pp.37–40
更新 context 最多 10 个已有 skills、9 个 supporting cases,每 skill 最多 3 条 supporting summary。target case 单独加入,不算自己的 supporting evidence。LLM 返回 add/update/none;add 或非空 replacement body 至少 5 个非空行、50 字符。update 指向输入 skill 列表的固定零基索引,且同 batch 每 target 只接受首个处理位置。省略/空文本保留旧值;confidence 会 clamp 到 [0,1],低于 0.1 仍不删除或退休,默认 maturity 1.0 也不是实测效用。
接受的更新追加去重 lineage,按 owner 写 Markdown,后续异步入索引。rename 用先写新名再清理旧名;owner lock 不等于跨文件原子事务。证据边界: §7.7 测的是固定库的检索使用,不是上述 online evolution 长期改善、退化检测或安全维护效果。
07 · MAOB:规划图确实更好,但不是端到端成功率
7.1 数据生成、分布与协议
MAOB 有 140 个纯文本、无附件请求,来自 137 种职业、140 个 templates。四 domain 为 research、coding、content、oncall;2/3/4 domain 的任务分别 66/47/27,覆盖全部 11 种至少双域组合。平均 2.72 nodes、1.84 edges,共 257 条参考边;98 个 serial、42 个允许 parallel。content/research/coding/oncall 分别出现 106/103/102/70 次。§7.1.1、Table 3、Figure 12,pp.41–43
数据不是先随机搜真实请求再标注,而是从 GDPval、JobBench 提取“职业—交付物—材料类型”模式,先用 Claude Opus 5 定参考 DAG,再用 GLM-5.2 反向写请求。自动过滤显式顺序、直说 domain 等泄露词,以及矛盾规格、角色越界、字段不一致;再专家审核节点、偏序与归属。没被请求支持的参考节点在构建阶段移除并重建边。批判性解读: graph-first 和 lexical filter 有助控制结构,但不能排除隐含 cue,也不能保证参考图唯一合理。
比较 Raven、Claude Code、Hermes Agent,同一 backbone 下输入请求、delegation instruction 和 domain 信息一致,保留原生工具 schema 与 loop。只捕获 planning tool call,不 dispatch worker,成本也仅计规划。
7.2 先弄清四个分数
评分先把同 domain 调用折叠为一个节点、去域内边、合并重复跨域边。Node F1 衡量 domain set;Edge F1 比较 transitive reduction,冗余传递边不罚;POA 在共有节点对上比较 before/after/unordered;Exact Match 要节点集合相同且偏序属于允许参考关系,不要求 raw edge list 字面相同。
| 特殊情况 | 评分处理 | 解读风险 |
|---|---|---|
| 仅共享一个 domain | POA=1 | 没有可比较节点对也得到满分,须连同 Node F1 读 |
| 没有共享 domain | POA=0 | 不能把空预测当正确排序 |
| 两边 edge set 都空 | Edge F1=1 | 是明确定义的边集一致 |
| 原调用 DAG 折叠后形成环 | Node F1 保留,其余指标 unavailable | unavailable 从对应指标分母剔除 |
| 普通循环预测 | Node/Edge F1=0,Exact=false | POA 取决于是否有共有 pair |
| 多参考变体 | 按 Node F1、Edge F1、POA 字典序选参考 | Exact 并非要求唯一原图 |
附录 C.1 明确每个 metric 对“有定义记录”分别平均,重复 attempts 算独立记录,所以不同分数可能有不同分母;不能仅凭 140 个 tasks 反推 exact-match 成功数。pp.77–78
7.3 完整结果(原 Figure 13 重建)
| Backbone | System | Node F1 ↑ | Edge F1 ↑ | POA ↑ | Exact Match ↑ |
|---|---|---|---|---|---|
| Qwen3.8-27B | Claude Code | 0.524 | 0.507 | 0.518 | 0.464 |
| Qwen3.8-27B | Hermes Agent | 0.776 | 0.744 | 0.780 | 0.607 |
| Qwen3.8-27B | Raven | 0.923 | 0.812 | 0.950 | 0.711 |
| DeepSeek-V4-Flash-0731 | Claude Code | 0.835 | 0.813 | 0.844 | 0.762 |
| DeepSeek-V4-Flash-0731 | Hermes Agent | 0.854 | 0.776 | 0.803 | 0.748 |
| DeepSeek-V4-Flash-0731 | Raven | 0.963 | 0.897 | 0.918 | 0.867 |
来源:§7.1.4,Figure 13,pp.44–45。相对每指标最强 baseline,Raven 的 Qwen 增益为 0.147/0.068/0.170/0.104,DeepSeek 为 0.109/0.084/0.074/0.105。所有系统 Edge F1 低于 Node F1,说明依赖预测比选择 domain 更难。论文支持: 两个模型下编排接口/设计的整体规划表现较好。没有隔离: staged guidance、schema、loop 各自贡献,或规划改善是否完整传导到文件质量与总成本。
08 · 自演化与 Research:分数之外的协议最重要
8.1 HarnessBank held-out 结果
以下为原 Table 11 全行,固定 Qwen3.6-27B、每任务三次尝试均值;来自 HarnessBank v2,不是本文重新训练一个新基础模型。
| Benchmark | Initial Pass@1 % | Evolved Pass@1 % | 原表 Gain pp |
|---|---|---|---|
| Terminal-Bench-2 | 36.1 | 45.4 | +9.3 |
| LiveCodeBench | 58.1 | 71.8 | +13.7 |
| Omni-MATH | 54.3 | 66.0 | +11.7 |
| BrowseComp+ | 16.9 | 30.8 | +13.9 |
| GDPval | 43.7 | 52.9 | +9.2 |
| AppWorld | 41.3 | 56.7 | +15.4 |
| SWE-bench Verified | 47.4 | 52.6 | +5.1 |
来源:§7.2,Figure 14,pp.45–46;Table 11,p.77。最后一行显示值相减是 5.2 pp,而原表报 5.1 pp;这里忠实保留原表,不能确认是未显示精度还是排版差异。前六组通过源论文 paired-gain criterion;SWE-bench Verified 的 test split 仅 26 题,虽正向变化但未通过。干预案例支持 recovery/final verification 的机制解释,但缺少完整 per-run manifest,且没有在 Raven 新的 host DAG 上单独测试每种演化机制。
8.2 Raven-Research 的执行策略
research-flow 替换 search、fetch、clarification:缓存重复 query,连续搜索无新内容时停止;长 search 序列后强制读页面;fetch 接显式信息需求提取相关段落,页面不足时试替代地址;后期阻止重新从头开始,空答时恢复。独立 reviewer 用另一 model call、无研究 agent context,对 draft 关键主张与已有证据核验。每个数字、日期、引文要求 URL;由 tool-call log 生成 trail,标记引用但没打开的页面。§7.3,p.46
DeepResearch Mixed 汇合 BrowseComp English、FRAMES、HLE text-only exact-match、中文 xBench-DeepSearch 2510。每系统每题一次,运行 2026-08-10 至 08-18;GPT-5.6 Luna Pro、temperature 0 判 short answer 与 reference 语义一致。超时/无答案计错,重判同一答案约有 1.3 pp 波动。报告没有在该附录明确给出所有 source 的题数及 pooled 总题数,不宜自行猜出各 source 权重。
8.3 完整主表(原 Table 4)
Input 包括 cache reads,单位百万 tokens;Output 单位千 tokens;Cost 是每题均值。横线表示未测,不能当 0。
| Backbone / 分组 | System | Accuracy % ↑ | Input M | Output k | Cost USD |
|---|---|---|---|---|---|
| Qwen3.6-35B-A3B | MiroFlow | 47.7 | 1.493 | 11.3 | — |
| Qwen3.6-35B-A3B | DeepSeek-Harness | 49.7 | 4.587 | 16.2 | — |
| Qwen3.6-35B-A3B | Raven-Research | 56.3 | 1.706 | 30.0 | — |
| Qwen3.5-397B-A17B | MiroFlow | 48.0 | 1.799 | 15.3 | — |
| Qwen3.5-397B-A17B | DeepSeek-Harness | 56.0 | 0.679 | 6.6 | — |
| Qwen3.5-397B-A17B | Raven-Research | 59.3 | 1.837 | 7.6 | — |
| DeepSeek-V4-Flash | MiroFlow | 67.2 | 3.737 | 39.3 | 0.0374 |
| DeepSeek-V4-Flash | DeepSeek-Harness | 68.9 | 2.975 | 31.8 | 0.0211 |
| DeepSeek-V4-Flash | Raven-Research | 76.5 | 2.380 | 41.6 | 0.0242 |
| Commercial reference | MiroThinker-1.7 | 50.3 | ≈1.247 | ≈18.5 | 5.62 |
| Commercial reference | Perplexity Sonar Deep Research | 52.0 | — | 11.7 | 0.55 |
| Commercial reference | Gemini Deep Research (2604) | 63.2 | 1.178 | 97.0 | ≈1.67 |
| DeepSeek-V4-Flash 按来源(Figure 15a) | MiroFlow | DeepSeek-Harness | Raven-Research |
|---|---|---|---|
| BrowseComp | 62.4 | 61.4 | 69.3 |
| FRAMES | 86.5 | 93.7 | 95.5 |
| Humanity’s Last Exam | 43.3 | 36.7 | 60.0 |
| xBench-DeepSearch | 60.0 | 66.7 | 63.3 |
| Pooled | 67.2 | 68.9 | 76.5 |
来源:pp.47–48。六组 same-backbone paired comparisons 中五组 exact McNemar \(p\lt0.02\),Qwen3.5-397B 对 DeepSeek-Harness 的 +3.3 pp 为 \(p=0.21\)。Raven 不是所有 source 都赢,xBench 比 DeepSeek-Harness 低 3.4 pp。DeepSeek 组较低 input、较高 output,费用居两 baseline 中间;这是计算分配 trade-off,而非所有维度支配。
8.4 为什么不能把 76.5% 视为干净泛化结果
三 local harness 都用 Serper 与 Jina Reader,但 loop/context/sampling 保留各自设置。MiroFlow 150 turns 且所有组最终答案提取都用 Qwen3.6-35B-A3B;Raven 上限 150 tool iterations、每 call 16,384 output tokens、high reasoning,DeepSeek/Qwen 小/Qwen 大每题时间为 90/120/200 分钟。Qwen 大模型是 4-bit GPTQ、两 Qwen 都 self-hosted thinking enabled。相同 tools/backbone 不能消除不同时间与控制政策的混杂。
更关键: 同一套问题参与 research flow 开发,所有系统未封锁 benchmark 的公开副本。原文主动警告 BrowseComp/HLE 绝对分数可能高估无污染表现。DeepSeek 三系统按同一 list-price 表重算,非实付;商业服务计费口径彼此不同。这里最可靠的是“该历史设置下的观察比较”,不应写成严格 held-out、完全等预算或比商业产品便宜多少倍的因果结论。附录 C.3,p.78
09 · Code:仓库约束、实际执行与完整结果
code-flow 每次 model call 注入 AGENTS.md/CLAUDE.md 等规范,并提示共享目录其他 session。编辑前必须读当前文件版本;Python 写入返回 syntax check;shell 超时返部分输出;按模型族选择 coding instructions,要求先复现、最小根因修复、优先项目测试。结束生成基于真实 repo state 的 manifest,记录 base commit、uncommitted files 与 diff,不只靠模型叙述。§7.4,pp.48–49
9.1 Figure 16 全部方法行
| Benchmark / Backbone | System | Score | 来源类型 |
|---|---|---|---|
| SWE-bench Pro / Qwen3.8-27B | Raven-Code | 54.4 | self-run,resolved % |
| SWE-bench Pro / Qwen3.8-27B | Claude Code | 52.4 | self-run,resolved % |
| SWE-bench Verified / DeepSeek-V4-Flash | Raven-Code | 91.0 | self-run,resolved % |
| SWE-bench Verified / DeepSeek-V4-Flash | DeepSeek-Harness | 90.4 | self-run,resolved % |
| SWE-bench Verified / DeepSeek-V4-Flash | OpenCode | 90.2 | self-run,resolved % |
| SWE-bench Verified / Claude Opus 4.8 | Raven-Code | 87.0 | self-run,resolved % |
| SWE-bench Verified / Claude Opus 4.8 | Claude Code | 85.8 | VALS.ai leaderboard |
| WorkBuddy-Code / DeepSeek-V4-Flash | Raven-Code | 78.1 | self-run,reward % |
| WorkBuddy-Code / DeepSeek-V4-Flash | Claude Code | 76.7 | self-run |
| WorkBuddy-Code / DeepSeek-V4-Flash | OpenCode | 76.1 | self-run |
| WorkBuddy-Code / DeepSeek-V4-Flash | Hermes Agent | 74.1 | self-run |
| WorkBuddy-Code / Claude Opus 4.8 | Raven-Code | 76.7 | self-run |
| WorkBuddy-Code / Claude Opus 4.8 | Claude Code | 77.9 | public leaderboard |
| WorkBuddy-Code / Claude Opus 4.8 | CodeBuddy | 74.4 | public leaderboard |
| WorkBuddy-Code / Qwen3.6-35B-A3B | Raven-Code | 60.2 | self-run |
| WorkBuddy-Code / Qwen3.6-35B-A3B | Claude Code | 58.4 | self-run |
| WorkBuddy-Code / Qwen3.6-35B-A3B | OpenCode | 60.6 | self-run |
| WorkBuddy-Code / Qwen3.6-35B-A3B | Hermes Agent | 53.9 | self-run |
| WorkBuddy-Code / Qwen3.6-35B-A3B | Codex | 50.7 | self-run |
| SWE-Refactor / DeepSeek-V4-Flash | Raven-Code | 16.5 | self-run,mean 0–100 |
| SWE-Refactor / DeepSeek-V4-Flash | Claude Code | 7.0 | public leaderboard |
| SWE-Refactor / GPT-5.6 Luna | Raven-Code | 13.5 | self-run,mean 0–100 |
| SWE-Refactor / GPT-5.6 Luna | Codex | 10.5 | public leaderboard |
Raven 在八个 setting 中六个领先;WorkBuddy 的 Opus、Qwen 小模型分别输 1.2、0.4 分。Pro 多解 15/731 题;Verified DeepSeek/Opus 多解 3/500、6/500。Refactor 增益较大,但 16.5/100 仍是较低的绝对完成质量,不能只强调相对翻倍。Figure 16,p.49
9.2 实验协议与非对称性
| Benchmark | 规模与计分 | 资源 / 网络 / 例外 |
|---|---|---|
| SWE-bench Pro | 731 题、11 repos,官方 grader | Qwen3.8-27B via vLLM;3600 s/题;generation 无网络、删除可能泄漏 fix 的 git objects;grading 可联网装依赖 |
| SWE-bench Verified | 500 题,upstream grading | 3600 s/题;generation 有网络;Opus baseline 来自外部榜单 |
| WorkBuddy-Code | 80 题,每题 3 attempts,hidden-test pass rate 均值 | 3600 s/attempt;Raven DeepSeek/Opus 额外封锁 35 个 code-host/search domains,其他 self-run 不同 |
| SWE-Refactor | 20 个 migration,audit gate → all-or-nothing behavior → 6 轮 adversarial verification | Raven 仅 model gateway 可联网;结果组合了多次 runs;一个被维护者承认不可靠的 audit 对 Raven 重判 |
| AgentEval 共用规则 | disposable Docker,每次记录 usage,fresh grading container | 默认每题一次;基础设施失败算 unsolved,不排除任务 |
来源:附录 C.4,pp.78–79。公开 leaderboard 行提供参照,不能与 self-run 当作完全成对实验;稿件没有给这些小幅 issue-resolution 差异的统一置信区间或显著性证明。
9.3 DataAgentBench:全部榜单比较与计分口径
54 个自然语言 query、12 个 datasets,覆盖 PostgreSQL/MongoDB/SQLite/DuckDB。每题 5 trials,270 次全被 grader 评估。Pass@1 先在 dataset 内平均 query pass rate 再平均 datasets;Pass@5 是每 query 至少一次成功后同样做 dataset 平均,不能把全部 trials 简单池化。§7.4、附录 C.4,pp.49、79
| System | Model | Pass@1 |
|---|---|---|
| Raven-Code | Claude Opus 5 | 0.8762 |
| Permute EQ | Claude Opus 5 | 0.8713 |
| Sentinel (Actioneer) | Fable-5 + Claude Opus 4.7 | 0.8617 |
| Permute Core | Claude Opus 5 | 0.8413 |
| Alkera | Fable-5 + Claude Opus 4.8 | 0.8411 |
| Sarvam Code v0.36 | GLM-5.2 | 0.8208 |
| SCRIBE (Actioneer) | Claude Opus 4.7 | 0.8185 |
| Alkera | Claude Opus 4.8 | 0.8044 |
| LabRat + Cartographer | Claude Opus 5 | 0.8018 |
| Spacedock (Recce) | GPT-5.5 | 0.7850 |
| Sarvam Code v0.35 | GLM-5.2 | 0.7812 |
原 Figure 17,p.50,比较快照 2026-08-24。Raven Pass@5=0.9097;5400 s/trial、24 concurrent、benchmark hints enabled、主模型经 OpenRouter,另有语义映射步骤使用 Claude Haiku 4.5 与 Claude Sonnet 5。因此按榜单分类属于 tuned-prompt system,不是纯单模型配置;论文说明尚未提交给榜单维护者。“该日所列条目最高”不等于当前官方认证第一。
10 · Design 与 Oncall:长任务的执行约束
10.1 Design 方法及 slide-generation 全表
Raven-Design 以 Task State 保存目标与要求,选择 domain skills,渲染 HTML、SVG、Office 输出后 inspect。用户给 template 时内部转 Raven-PPT;先写每页主张 outline,再 python-pptx 构建;68 类检查中 9 类阻止发布,未被 agent inspect 的 slide 交给空上下文第二 reviewer。实验中的 deck pipeline 是固定 coordinates 与 typography、agent 填 layout slots,不应误读为完全自由布局的通用设计模型。§7.5、附录 C.5,pp.49、79
| PresentBench System | Backbone(有披露时) | Overall 0–100 |
|---|---|---|
| Raven-Design | Claude Opus 5 | 80.2 |
| Claude Code | Claude Opus 5 | 78.3 |
| Raven-Design | GPT-5.6 Luna | 72.9 |
| hwc-mmi-aippt | 未披露 | 70.8 |
| NotebookLM | 未披露 | 62.5 |
| Manus 1.6 | 未披露 | 57.8 |
| Tiangong | 未披露 | 54.7 |
| Zhipu | 未披露 | 53.6 |
| Claude Code | GPT-5.6 Luna | 52.4 |
| PPTAgent v2 | 未披露 | 50.2 |
| Gamma | 未披露 | 49.2 |
| Doubao | 未披露 | 48.0 |
| Qwen | 未披露 | 35.9 |
原 Figure 18,p.50。PresentBench 原集合 238 题、五 domain,输出 editable PPTX;五等权维度为 fundamentals、visual/layout、completeness、correctness、fidelity。官方流程转 PDF,由 Gemini 3 Flash 检查每题约 54 个 binary items。Raven 实验给 judge 的文件传输方式不同;配置覆盖不同,生成失败从均分排除。GPT-5.6 Luna 的 Raven 229 个 valid decks、228 个被评分,且未用 image generation/search。其余配置完整 coverage 未在附录逐项报出。不能把 80.2/72.9 直接当“全部 238 题均分”或和外榜完全等口径。
10.2 可视化任务完整比较
| Backbone | Task | Raven-Design | Hermes Agent | Claude Code |
|---|---|---|---|---|
| GPT-5.6 Luna | Dashboard | 69.1 | 68.4 | 53.6 |
| GPT-5.6 Luna | SVG | 77.2 | 76.9 | 72.7 |
| GPT-5.6 Luna | GDPval | 87.6 | 87.3 | 83.7 |
| Claude Opus 5 | Dashboard | 66.3 | 64.4 | 62.8 |
| Claude Opus 5 | SVG | 86.2 | 83.0 | 83.4 |
| Claude Opus 5 | GDPval | 91.9 | 89.1 | 89.2 |
原 Figure 19,p.51。这些是内部 grader 0–100 分,不与官方 leaderboard 可比。ArtifactsBench 删掉有 source defects 的任务,回放冻结 interaction intents、设置 no-action controls,以 10-item checklist 评分;GDPval 仅 public gold 中无音视频且不需 live search 的任务,按 rubric 加权。grader 是 GPT-5.6 Luna,因此 Luna 组 generator 与 judge 同模型。实验是单次尝试、容器 2 CPUs/8 GB、2026 年 8 月,Claude Code 禁用内置 web search。最大 baseline gap 不代表对 strongest baseline gap:六组对最强者提升仅 0.3–2.8 分。
10.3 案例展示是能力存在性,不是成功率估计
| 原 Table 5 案例 | 产物 | Task graph | Design node 时长 |
|---|---|---|---|
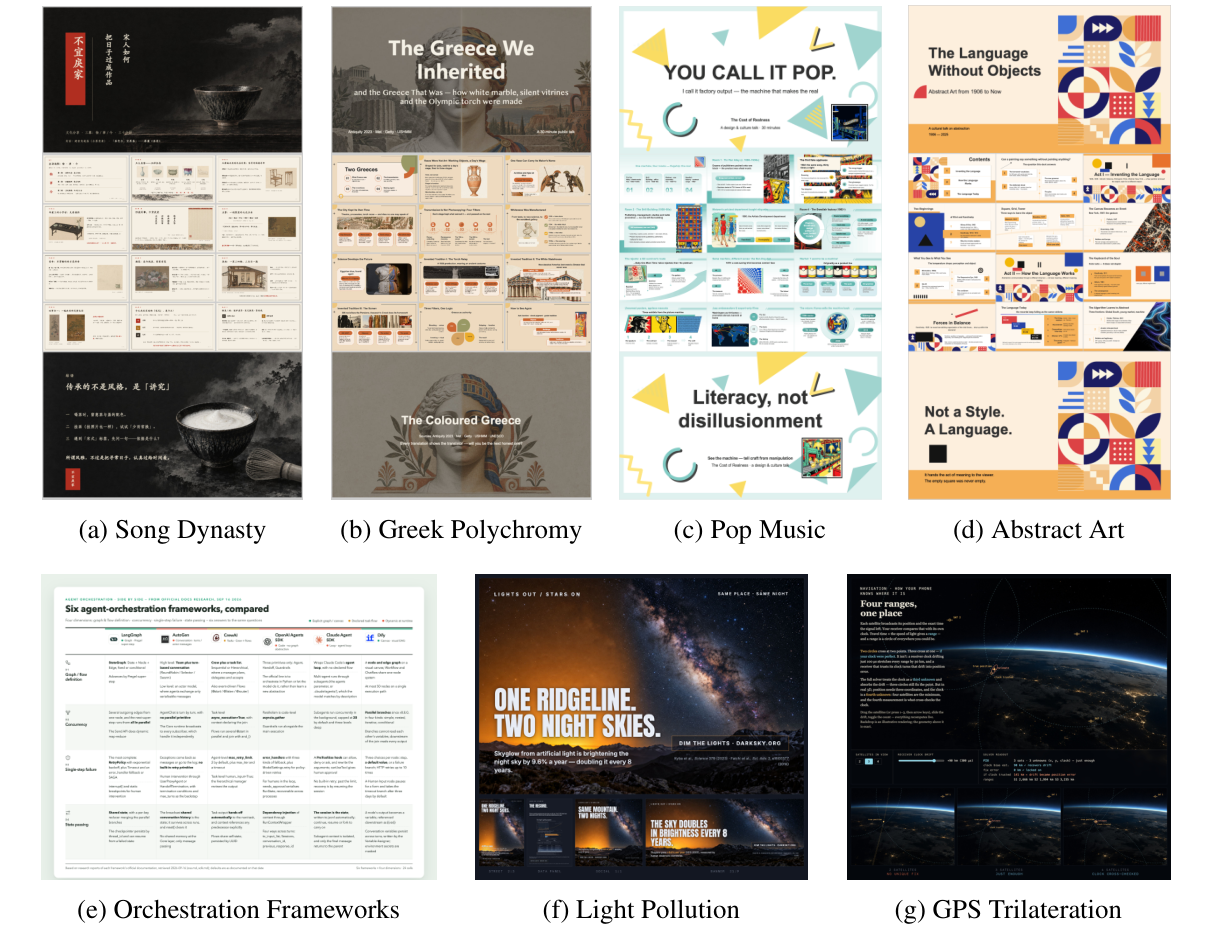
| 宋代生活美学 | 中文 slides | 3R → R → D | 18:45 |
| 希腊雕塑彩绘 | 英文 slides | 3R → R → D | 55:34 |
| 流行音乐 | 英文 slides | 3R → R → D | 47:03 |
| 抽象艺术 | 英文 slides | 3R → R → D | 64:50 |
| 编排框架 | Comparison board | 2R → D | 6:57 |
| 光污染 | Poster series | [(3R → C) ∥ D] → D | 2:58,13:57 |
| GPS trilateration | Interactive website | [(2C → O) ∥ D] → D | 3:03,17:03 |
R/C/O/D 分别是 Research/Code/Oncall/Design,数字计并行节点。四 decks 的 showcase 报约 0.80 USD/deck,这不构成全 DAG 统一成本审计。GPS 例子由两个 Code 独立计算、Oncall 对照,再由 Design 合成,说明“producer—checker—presenter”可以显式分工。七例为选取 showcase,没有人类偏好评分或随机任务成功率。§7.5,pp.51–53
10.4 Oncall 的 campaign,而非反复问模型“好了没”
campaign 保存 target、measurements、permitted actions、budget;每轮提交后注册 wake,在等待期间不调用模型,非模型 monitor 检测完成/发散提前唤醒。wait/terminate/resubmit 必须引用近期 measurement;compute request 被剩余预算 clamp,多 campaign 分享机器容量。closure report gate 要求 baseline 并拒绝与记录状态冲突的声称。§7.6,pp.53–54
| AI4AI / System | Backbone | Final BPB ↓ | Wall runtime h | Tokens M | Cost USD |
|---|---|---|---|---|---|
| Claude Code | Claude Opus 5 | 1.053 | 4.99 | 13.35 | 50.00 |
| Raven-Oncall | Claude Opus 5 | 1.038 | 4.90 | 9.38 | 39.40 |
| Raven-Oncall | DeepSeek-V4.1-Flash | 1.037 | 3.74 | 3.79 | 0.97 |
Figure 21:autoresearch 的约 50M GPT,原始 1.108 BPB;每 run 单 GPU 300 秒,campaign 5 GPU-hours,机器两块 A800 80GB。仅能改 training script,data/tokenizer/held-out shard/evaluator 固定,禁装包,参数不超 50,332,176。最终 BPB 在 20,971,520 validation tokens 上分别平均 5/6/10 seeds;每系统只做一个 campaign。GPT 训练 recipe 的模型内部优化超参数未在本文完整展开,不能把这场搜索结果误当 Raven 本体训练设置。
Opus 同 backbone 下 BPB 改善 0.015,tokens 降约 29.7%,cost 降 21.2%(按表计算);两 Raven 共用一个 prompt,Claude Code 是另写但相同预算/约束的 prompt。成本口径分别为 OpenRouter 实付、DeepSeek peak price、Claude API 价重算;不是同一账单基础,也未量化跨 campaign 随机性。附录 C.6,pp.79–80
| AI4S / System | Backbone | Success % | Solved / 17 | Mean min | Tokens M | Mean USD |
|---|---|---|---|---|---|---|
| Claude Code | Claude Opus 5 | 64.71 | 11 | 113 | 16.328 | 13.60 |
| Raven-Oncall | Claude Opus 5 | 82.35 | 14 | 85 | 6.123 | 5.10 |
| Raven-Oncall | DeepSeek-V4-Flash | 41.18 | 7 | 69 | 1.038 | 0.10 |
Figure 22:内部 17 题含 3 CalculiX、4 OpenFOAM、2 batch inference、3 embedding training,以及 heat equation、BM25 tuning、GitLab review bot、2 molecular simulation。实际题型测试 divergence detection、固定参数不许偷改、预算续申请、恢复任务等。相同机器/预算,人工按隐藏 reference values 和 rubric 判断。Opus Raven 多 3 题,均价少 62.5%,时间少约 24.8%(按表计算);DeepSeek 更便宜但少成功 7 题,是明确 trade-off。仅 17 题,不宜外推所有科学计算任务。
11 · Skills:完整主表、消融与相关性边界
11.1 固定检索结果的较清晰对照
407 tasks = SkillsBench 87 + GDPval 220 + QwenClawBench 100。两 harness(Raven/OpenClaw)× 两 backbone;每 cell 有 no-skill 与 SkillCorpus 条件,三 runs 均值。两 harness 收到完全一样的预计算 skill selections,最多两条完整 body;这比较执行框架使用程序性知识的能力,不测试 Raven 多来源 online fusion。Qwen3.5-397B 为 4-bit GPTQ,Qwen greedy;四个无法 build 的 SkillsBench 题在两条件都计失败。§7.7、附录 C.7,pp.54–56、80–81
| Cell | SkillsBench None | Skills | Gain | GDPval None | Skills | Gain | QwenClaw None | Skills | Gain |
|---|---|---|---|---|---|---|---|---|---|
| Raven × Qwen3.5-27B | 10.0 | 16.5 | +6.5 | 82.6 | 83.8 | +1.2 | 66.9 | 70.8 | +3.9 |
| Raven × Qwen3.5-397B-A17B | 9.2 | 22.6 | +13.4 | 84.0 | 85.2 | +1.2 | 68.8 | 73.2 | +4.4 |
| OpenClaw × Qwen3.5-27B | 8.8 | 13.0 | +4.2 | 81.2 | 83.1 | +1.9 | 65.2 | 66.7 | +1.5 |
| OpenClaw × Qwen3.5-397B-A17B | 11.1 | 16.9 | +5.8 | 82.2 | 84.0 | +1.8 | 65.7 | 67.0 | +1.3 |
| Pooled gain ± 1 SE | — | — | +7.5 ± 2.3 | — | — | +1.51 ± 0.49 | — | — | +2.79 ± 0.70 |
| z-score | — | — | 3.2 | — | — | 3.1 | — | — | 4.0 |
原 Table 12,p.81,SkillsBench 为 Pass@1 %,其余为 reward ×100。Pooled 先平均每任务四 cell 的 paired gain,再按任务计算 SE,不能把 cell–task 当彼此独立。GDPval 个别 cell 小幅增益与零不可区分(每题 reward 标准差 20–27),pooled 显著不能自动传递到每一 cell。单次 Claude Opus 4.7 + OpenClaw 检查为 39.1→47.1,支持强模型也可能受益,但不是同深度重复实验。
11.2 消融完整表(原 Table 13)
| Catalog | Retrieval stack | SkillsBench Pass@1 % | vs No skills |
|---|---|---|---|
| No skills | — | 9.2 | — |
| Curated | Fine-tuned | 22.6 | +13.4 |
| Curated | Off-the-shelf Qwen3 | 13.8 | +4.6 |
| Raw crawl,约 821k files | Fine-tuned | 14.9 | +5.7 |
Raven × Qwen3.5-397B-A17B、87 tasks,每个 ablation 单 run。清洗库与训练检索器都有贡献,不能由单 run 精确归因全部差值,也没有给二者交互项的全 factorial study。独立检索在 75 core SkillsBench(排除 12 generic-only)上,fine-tuned Hit@1 Easy/Hard 均 0.760,SkillRouter 为 Easy 0.760、Hard 0.720。
按最高 reranker score 作为 coverage proxy,SkillsBench 低于 0.45 的 26 题平均 gain 2.2,中间 0.45–0.75 的 40 题 6.2,至少 0.75 的 17 题 25.1;四 cell Pearson \(r=0.31\)–0.40,控制 baseline 后 partial \(r=0.34\)–0.40。该 coverage 分组总数 83,区别于总 87;与四个 build failure 数一致,但本文这段未明确逐题映射,不擅自补齐。Math 4 题、Finance & Economics 9 题在强 Raven cell 上近零收益。相关不是因果: 好匹配技能可能集中在本来更易从 procedures 获益的任务;要证明“提高 coverage 导致增益”,需人为操纵检索候选再比较。
12 · 可复现清单与实现默认值
12.1 Table 10 完整数值
| Mechanism | Setting | Value |
|---|---|---|
| DAG execution | graph/spawn shared concurrency | 8 |
| DAG execution | private fallback concurrency | 5 |
| DAG admission | dispatch budget | 30/hour |
| DAG verdict | judge timeout / transcript tail | 180 s / 8000 chars |
| DAG recovery | additional continuations / decision deadline | 2 / 600 s |
| DAG output | terminal-output cap | 128000 chars |
| Clarification | host autofill timeout | 20 s |
| EverOS clustering | cosine / time gap | 0.65 / 7 days |
| EverOS retrieval | RRF / facts per expansion / unchanged steps | 60 / 3 / 10 |
| Raven recall | result clamp / profile cap | 1–100 / 1200 chars |
| Raven recall | timeout / default count | 5 s / 5 |
| Store queue | per session / global / in flight | 64 / 256 / 4 |
| Store retry | attempts / inter-attempt waits | 5 / 2,5,15,30 s |
| Skill rewriting | input prefix | 2000 chars |
| Skill routing | overfetch / gated pool / ungated pool | 2 / 10 / 2 |
| Skill routing | local / memory / hub weight | 1.0 / 0.9 / 0.85 |
| Skill routing | RRF damping | 10 |
| Skill selection | normal / error fallback cap | 2 / 5 |
| Skill selection | description / body excerpt | 200 / 300 chars |
| SkillHub detail | minimum parseable safety | 0.7 |
| Case admission | quality threshold | 0.2 |
| Case clustering | recall / direct-merge cosine | 30 / 0.85 |
| Skill extraction | existing skills / supporting cases | 10 / 9 |
| Skill extraction | summaries per skill | 3 |
| Skill extraction | description / body prefix | 400 / 5000 tokens |
| Skill extraction | support approach prefix | 200 tokens |
来源:附录 B.3,p.75。这些是 method defaults,不自动等于每个 benchmark 的 run settings;characters 与 tokens 必须分清。正式复现还要锁住 model endpoint/version、quantization、thinking effort、temperature、context compression、tool implementations、grader、timeout、network policy、retry、随机种子及数据版本。
12.2 建议的最小复现顺序(解读)
- 先锁住论文版本、repo commit、模型/工具版本,建立运行 manifest;保存 request、完整 plan、每节点 actual input/output、transcript、judge verdict 与成本
- 不接在线 memory 或 evolution,先重跑 MAOB,导出每指标 valid denominator、projection conflict 与 cycle 数量;在 domain-fold 前后都保存图
- 选一个 specialist 做等模型、等工具、等总预算、相同网络封锁的 paired held-out 任务;失败与超时保留分母,明确“每题一次”或多次平均
- 从最小 execute–verify–fix loop 起加入一项 harness 改动,声明 activation event;保持固定 evaluator,按任务配对、报告 CI 与开发/服务成本
- 单独加入 fixed skills,再测试 query rewrite、fusion、gate、fallback、resource resolution;分别记录 selected、loaded、executed、verified
- 最后才接 memory 与 online skill evolution,安排时序 held-out 与新 domain transfer,测 stale memory、错误 verdict 传播、regression、index lag 和检索成本
- 再做真正端到端 multi-agent vs 强单 agent 同预算比较,给双方同信息/工具范围;把 host、judge、handoff、retry、waiting 与最终 delivery 都纳入
这里没有安装或执行官方 Raven,也没有重跑论文 benchmark。上述是依据论文缺口给出的实验规划,所有数值均为作者报告或明确标记的表内计算。
12.3 Prompt、训练设置与缺失项
本文贡献主要是系统与策略,不存在一套“Raven foundation model 的 learning rate/batch size/epochs/GPU”可照抄。Harness evolution 冻结 task model;SkillCorpus retriever/reranker 的微调属于引用组件,Raven 报告没有完整给出其 optimizer、LR、batch、epochs。Appendix B.2 给接口字段而非所有完整 system/user/few-shot prompts;research 的三 session modes 未在本文完整展开各阈值。各实验的采样与模型配置披露程度不同,不能自行填成统一 temperature 0。正式重跑需要源组件 paper、code、config 与 per-run logs,不能拿本文 pseudocode 冒充原始 prompt。
12.4 论文与当前仓库:明确版本漂移
官方 repository 为 EverMind-AI/Raven,正式产品站为 raven.evermind.ai,文档为 official documentation。2026-10-01 读取到 main commit e84152c52fe4a5a1b87f2e605f4d85afee2ff452,时间 03:37:18 UTC。
当前 README 声明 pre-alpha、接口可能快速变化,且列出 114190 的 live SkillHub catalog;论文是固定 96401 snapshot。README 还描述 experimental runtime Curator,而论文核心演化结果来自独立 Evolver/HarnessBank。它们是不同版本/执行阶段的信息,不能用当前功能倒推 v1 实验已验证。此次只核查官方 README 与版本身份,未逐文件审计执行代码,因此不声称验证了 paper/code 每个默认值完全一致。
13 · Reviewer:最强贡献与最需要补的证据
Strengths
- 组合边界明确。 以 executable model–harness pair 为单位,保留异构 agent 能力,接口不仅是统一 prompt
- 账本与调度设计扎实。 成功前缀、实际输入记录、artifact reference、实例串行、adjudication settlement、bounded recovery,都针对真实长任务中的失败
- 理论限定写得认真。 分清局部互补与端到端单体上界,未要求独立错误,计入交接与交付成本,指出并行序列化和条件分布匹配
- 较有价值的同模型比较。 MAOB 直接隔离 planning;技能实验统一预选 skill input;frozen-model evolution 区分 train/test
- 附录主动暴露协议弱点。 研究污染、设计 coverage、source experiment 的 manifest 缺失、group memory 未评估,都值得在阅读时保留
Weaknesses 与可检验改进
| 风险 | 为什么影响结论 | 更强的补充实验 |
|---|---|---|
| 理论合同 vs 实际 judge | runtime validation 主要结构合法,judge fail-open | deterministic validator 与 semantic judge 分层;报告误接受、误拒绝、fallback 次数 |
| 模块证据拼接 | MAOB、specialists、HarnessBank、SkillCorpus 各测不同对象 | 统一端到端任务池,做 matched budget/full system 与强单体比较 |
| contamination / adaptive development | Research 同题开发且 live web 可查答案 | 新鲜 private held-out、域名/答案污染 containment、审计搜索轨迹 |
| coverage 与分母 | PresentBench 排除失败,MAOB metric denominator 不同 | 同时报 all-task outcome、conditional quality、coverage 与 missingness |
| source / score 不可比 | 外榜、self-run、不同 price schedule 混杂 | 重跑统一环境,独立报告 billed 与 normalized cost |
| online memory 未隔离 | 错误判断可跨会话放大,低 confidence skills 仍检索 | 时间切分、过期/撤回/回滚、污染注入与跨任务 regression |
| evolution 选择偏差 | 1.96 screen + adaptive search 不是校准显著性 | 完整 run manifest,多个独立 evolution seeds,最终 sealed test 与 transfer |
| skill gate 脆弱性 | 300 字 excerpt、失败反而 top5、native-score 选代表 | calibrated source scores、版本化 skill ID、要求可用性检查与 bounded fallback |
证据等级总账
Paper Verified / 作者报告的实验事实: MAOB 两 backbone 全指标领先;若干 specialist setting 更强而非全部;fixed catalog 在 12 个 cell–benchmark 比较均正增益;held-out harness utility 有提升。
Author Claim / 证据有限的解释: 更好编排、执行验证、程序性知识复用是提升来源。trace 与整体对照提供支持,但没有覆盖每个模块的严格因果消融。
Our Interpretation: Raven 最核心的价值是把“知识是否到达、工作是否发生、结果是否合格”分开记录,让系统问题可以定位到输入、执行、验收、恢复,而不是把所有失败统称为模型不够强。
Research Extension: 将这些机制迁移到 PMG、设计新的 evaluator 或联合优化 context 与 graph,需要新的 benchmark 和实验;本文没有验证材质图、渲染损失或特定建模工具。
14 · 对 PMG、Context Optimization 与 Agent–Evaluator Harness 的启发
本节全部是研究延伸,不是 Raven 原文实验结论;不会据此把本文标成已验证的 procedural-material 论文。
14.1 把材质生成拆成带类型的证据链
可考虑任务图:reference analysis → topology/program proposal → compile/validity check → renderer → perceptual/physical evaluator → repair/parameter search → final export。节点产物应分别是结构化需求、material graph、编译日志、带 renderer settings 的图像、评分与错误位置、修复 patch,而非自由文本“看起来不错”。
一个 material graph \(G_m=(V_m,E_m,\theta_m)\) 的合法性至少涉及 node type、端口类型、连接方向、参数范围与可执行性;图正确编译仍不等于渲染接近目标。把 compiler 与 renderer contract 分开,就能避免 evaluator 只看漂亮 preview 却接受不可编辑/依赖 bitmap 的结果。对共享 renderer/project 文件夹做 mutation 时,也必须考虑实例隔离与并发写冲突。
可证伪假设。 在同总模型 token、渲染次数、wall-time 上限下,类型化 handoff 与显式失败归因能提高“有效、可编辑、视觉达标”的联合成功率。对照要包含能调用同一 compiler/renderer 的强单 agent,避免像理论 bit 例子一样把工具权限差异当组合智能增益。
14.2 Context Optimization 应优化证据预算,而不只压缩 token
Raven 给了三个有用模式:orchestration guide 按需加载、artifact 传路径、memory/skills 按 query 限额注入。迁移时可以把“给哪个 agent 看哪段证据、哪个节点 preview、哪些失败日志”设为优化变量。目标不应只最小 context 长度,而应保留保证后续合同所需的信息。
例如 evaluator 需要 target image、当前 render、关键 graph diff、同一 lighting/camera/seed;如果压缩丢掉 renderer 设置,视觉分数变化就无法归因。可比较 full context、naive summary、retrieval-only、contract-aware evidence packet 四组;测最终质量、validity、cost、遗漏约束与重复执行次数。摘要 provenance 应指回原始 image/log/node ID,让修复 agent 可按需展开。
14.3 Agent–Evaluator 分离:固定测量者,优化执行者
HarnessBank 的关键是 immutable evaluator,而不是让 agent 自己说“这次更好”。PMG 可保持同一 renderer、reference split、随机种子与评价协议,允许 evolver 改 prompt、node proposal、repair policy、context retrieval 或 verification timing;禁止修改目标图、评分权重、测试样本与 budget accounting。
建议把 evaluator 分层:结构有效性 → renderer 成功 → 参数/拓扑可编辑性 → 视觉误差 → 多光照/多尺度鲁棒性。可用 LPIPS、颜色/频谱统计等视觉量,但本文没有证明任何一种指标适合该 PMG 任务,具体指标必须重新验证。LLM/VLM reviewer 可以解释失败,但不能替代 deterministic validity 和受控 render test。
14.4 最小消融矩阵与停止规则
| 因素 | 基线 | 干预 | 主要观测 |
|---|---|---|---|
| composition | 同工具强单 agent | typed DAG + specialists | 联合成功率、总 cost、handoff failure |
| context | 全历史/普通摘要 | contract-aware packet + on-demand artifacts | 约束遗漏、token、修复成功 |
| verification | final-only | compile/render 每阶段 gate | 无效图率、错误早发现、额外 overhead |
| skills | 无技能/固定技能 | 可追踪 case-to-skill | held-out 增益、negative transfer、stale skill |
| evolution | 固定 harness | validity + activation + paired screening | 多 seed transfer、开发成本、部署成本 |
用 held-out material families 或结构类型分割,避免同类纹理近重复泄露。预先锁预算与停止条件;“render 数用尽、可靠性/质量阈值达到、连续无实质改善”可作为候选,但不能让模型任意改阈值。报告每阶段 wall time、有效工作时间、外部等待、重试原因和 artifact hash,才能判断收益来自真实机制还是额外 compute。
15 · 附录覆盖、作者与来源索引
完整阅读覆盖
| 原文位置 | 本精读对应 | 保留的重要限定 |
|---|---|---|
| §1,pp.4–5 | 01–02 | 专业化和组合的研究动机 |
| §2,pp.6–12 | 02 | budgeted capability、contracts、条件可靠性、新任务覆盖 |
| §3,pp.13–23 | 03 | runtime states、handoff、memory scope、group memory 未评估 |
| §4,pp.24–29 | 04 | four strategy roles、gene bank、screening 与 test separation |
| §5,pp.29–34 | 05 | MemCell/MemScene、HYBRID、profile、索引异步 |
| §6,pp.34–40 | 06 | corpus、multi-source routing、case-to-skill operator |
| §7,pp.40–56 | 07–11 | 全部关键 quantitative comparisons 与消融 |
| §8–9,pp.56–59 | 02、13–14 | 与框架、演化、memory、skills 工作关系;跨设备网络仍属未来方向 |
| Appendix A,pp.65–72 | 02 | ledger semantics、finite-query bound、kernel consistency、typed grammar、fork/join 成本 |
| Appendix B,pp.73–76 | 03–06、12 | 接口、完整 defaults、演化 manifest 缺口、source-prior 规则 |
| Appendix C,pp.77–81 | 07–12 | 分母、network、失败处理、污染、成本、grader、完整 Tables 11–13 |
| Appendix D,p.82 | 本节 | 集体署名与个人贡献角色分开 |
作者身份
正式标题页和 arXiv citation 署名 EverMind AI。附录 D 明确 Project Leader 为 Chuanrui Hu;Core Contributors 为 Dizhan Xue、Chuanrui Hu;Corresponding Author 为 Yafeng Deng,可核实。Contributors 为 Zuyi Zhou、Hongda Chen、Xingze Gao、Zhao Wang、Pengfei Yao、Zhengwei Wu、Tong Li、Ethan Wang、Xiaotian Luo、Juwei Yue、Jie Huang、Hui Zhang、Weixiang Chen、Chang Zhang、Yuqi Yang、Yifan Chen、Yunyun Han。不能把项目负责人/核心贡献者自动解释为论文第一作者、共同一作或通讯排序;本文没有明确个人 first-author designation。Appendix D,p.82
Sources
- 论文身份与 v1 记录
- 完整 PDF:Raven v1,82 页
- 官方代码仓库
- 本次核查的仓库 commit
- 官方项目网站
- 官方文档
- EverMind 机构网站
- HarnessBank v2(原文参考文献 39):arXiv:2609.26760v2,演化结果在 Raven 中转载
- SkillCorpus(原文参考文献 64):arXiv:2609.01437v1,技能库/检索实验在 Raven 中转载
源 PDF SHA-256:a8c7458b1d93669a7f49961a0f01d9b72dfe1e00a0992438a8abc069350556a6。本文所有“p.”均指 PDF 内实际页码;嵌入原图来自该版本裁取,实验表为文本重建,图表标签不代表第三方重现实验。