01 · 从文本图片到可重打光材质
“兔子雕刻木材”不只是画一张像木头的照片:可用的三维材质还需要知道颜色来自漫反射还是高光、表面法线怎样变化、粗糙度如何分布。ReflectanceFusion 把文本生成分成外观先验与物理参数图两阶段,让大规模图像模型负责语义,让材质专用扩散网络负责十通道 SVBRDF。
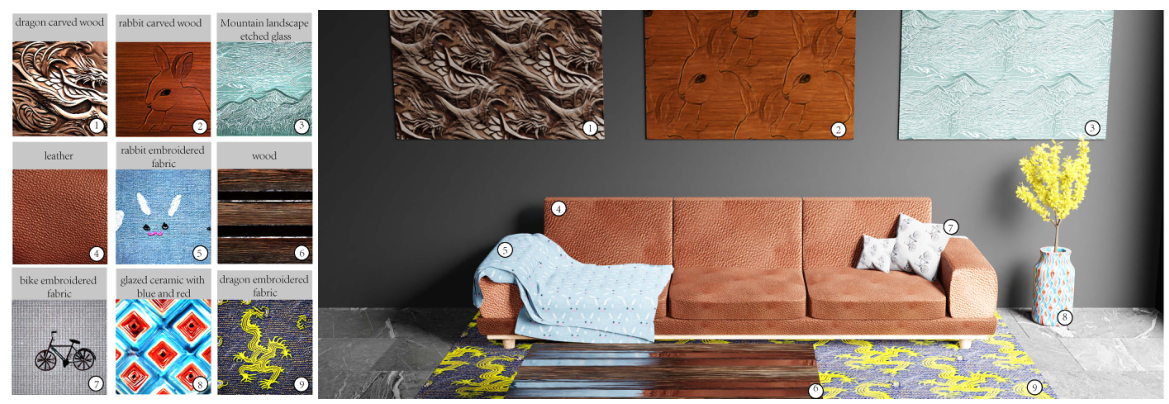
贡献是两阶段分工、语义复杂图案与材质通道生成的结合,以及用额外条件编辑粗糙度/镜面强度。证据主要为定性图像、与一个方法的示例对比和运行时间;没有量化重建误差、FID或用户实验主表,不能把“比现有方法更准确”读成广泛基准已充分证实。
用户固定原文:arXiv2406.14565v1,9页。另核对EGSR2024正式发表及官方6页补充图集;后续版本差异单列。
02 · 身份与版本:别混淆同名作者
作者依次为 Bowen Xue、Giuseppe Claudio Guarnera、Shuang Zhao、Zahra Montazeri,机构分别对应 Manchester(Xue、Montazeri)、York(Guarnera)、UC Irvine(Zhao)。正式论文为 Eurographics Symposium on Rendering 2024,DOI 10.2312/sr.20241152。原笔记的 arXiv、空 DOI 可以在人工整合时补充,但本次不重写其 YAML。
原笔记把 Zahra Montazeri 作为未核实通讯作者;查阅的论文没有明确通讯作者标记,因此保持未核实。作者代码入口目前是 bowenxueai 的官方结果仓库,旧 yley123 链接会重定向;不将其他研究方向的同名 Bowen Xue 页面作为本论文作者证据。
用户PDF首页侧边印有“25 Apr 2024”,arXiv编号属于2406批次;这是文件内日期与发布标识,不能只根据页边印字推断上传时间。本精读以固定 v1 哈希锁定正文。arXiv自动HTML漏掉首页teaser,导致从架构图起编号比PDF小1;为避免错配,下文所有 Figure1–9 均按用户PDF原编号与原页图像。
正式版的作者机构存档含一页仓库说明加十页论文。后续增加的说明会明确标“正式版补充”,不会假装它们都存在于用户9页版本。
03 · 十通道 SVBRDF 具体表示什么
| 参数图 | 通道 | 控制对象 | 不能替代 |
|---|---|---|---|
| Normal | 3 | 局部表面方向,改变受光与高光形状 | 真实位移几何、厚度、轮廓 |
| Diffuse albedo | 3 | 漫反射颜色 | 已烘焙光照的RGB照片 |
| Specular albedo / reflection | 3 | 镜面反射强度和颜色 | 单一metallic标量 |
| Roughness | 1 | 微表面粗糙程度,影响高光宽度 | 图案结构或法线频率 |
上式是本精读的张量表示,原文只有一条编号训练目标。三张RGB图加一张灰度图是四类参数图、十个数值通道,不能把“十通道”说成“十张独立物理贴图”。用于渲染后可以随灯光变化,不像静态图片只能保留原照明。
训练数据的镜面项采用 Schlick 近似,但正文没有完整给出渲染器微表面分布、法线编码范围、粗糙度到BRDF参数的映射和色彩空间。因此本精读不补造统一BRDF公式或声称直接兼容所有PBR引擎。导入引擎时仍需检查切线空间、Y轴、gamma、specular与metallic工作流。
与BTF相比,SVBRDF假设更简化。BTF可包含细微几何自遮挡、互反射等外观,四图模型未必足够表达。本文展示玻璃样例时明确没有透射,因此只呈现类似电介质的反射,不是完整透明玻璃或次表面散射材质。
04 · 两阶段为什么比直接改SD更合理
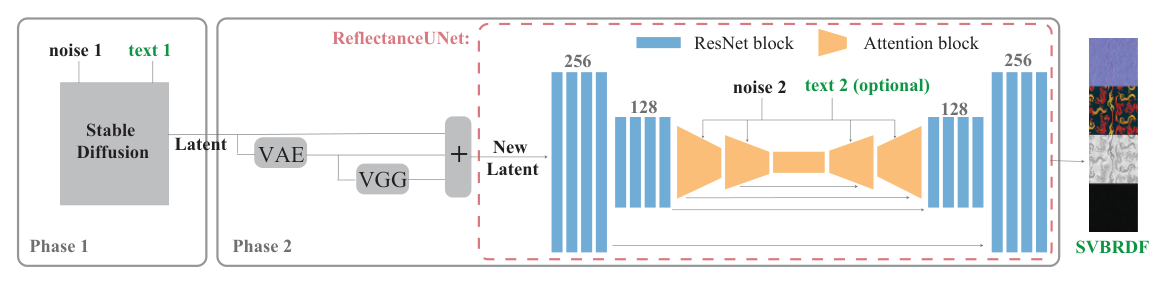
Phase1:预训练Stable Diffusion2.0接受文本、噪声和扩散时刻,提供整体图案与外观表示。大规模自然图像模型能理解“兔子、龙、自行车、刺绣”这样的组合语义,而约20万材质图未必覆盖这些对象关系。
连接模块:论文将第一阶段潜在表示与VAE、VGG低层特征结合,再整理成第二阶段条件。训练时从材质数据的渲染图提取VAE/VGG特征;推理时来自文本生成的第一阶段。这引出训练/推理条件分布可能不完全一致的复现问题,正文没有详细给出数值对齐方案。
Phase2:ReflectanceUNet是单独的材质扩散模型,对十通道图直接去噪,而非在一个另训的SVBRDF-VAE潜空间里去噪。它结合外观条件与可选粗糙度、镜面属性条件,将RGB语义先验转成可渲染参数。两阶段各有随机性,因此同一文本可给多个候选。
“不用材质VAE”与“流程中仍使用预训练图像VAE”不矛盾。作者避免的是为十通道SVBRDF重新训练高质量编码/解码器,不是整套系统从此没有任何VAE。类似SDXL的双阶段仅是设计启发,不能把第二阶段称作原SDXL Refiner。
05 · ReflectanceUNet的分辨率层级
输入输出空间大小256×256。为降低大分辨率注意力开销,256、128层级只用ResNet块;到64及更低分辨率才引入空间Transformer。梯形attention块依次是ResNet→SpatialTransformer→ResNet→SpatialTransformer,末尾卷积改变大小,例如64→32;中间方形块交替使用ResNet和Transformer,编码器/解码器间有skip connection。
| 已明确 | 论文提供的内容 | 未充分披露 |
|---|---|---|
| 输出空间与通道 | 256×256,10通道 | 各通道归一化、法线投影/单位化细节 |
| 高分辨率层 | 256/128仅ResNet | 每层hidden width、卷积核与精确残差配置 |
| 低分辨率层 | 64起用attention,块内交替序列 | head数、text embedding维度和注入细节 |
| 连接条件 | VAE、VGG及第一阶段表示 | 完整shape、concat/add实现和训练/推理对齐 |
| 可选物理条件 | roughness、specular | 从图统计为标量/文本的映射与条件dropout概率 |
图上256/128/64是空间分辨率,不是隐层通道宽度,不能拿它们填网络参数量。正文没有模型参数总数,不能据类似U-Net猜一个规模。正式版补充说原数据288×288,训练256×256;它解释低分辨率限制,但未提供上采样模型或高分辨率实验。
06 · v-prediction、Euler与损失的精确含义
原文选Euler scheduler,预测velocity而非直接预测噪声。为把记号说清楚,设干净十通道材质为 \(x\),高斯噪声 \(\epsilon\),带噪状态和速度目标采用通常的定义:
第二式对应原文给出的V定义;第一式是辅助理解的标准噪声参数化,不是额外宣称作者披露了具体schedule。\(\alpha_t,\sigma_t\)控制信噪比例,\(c\)代表外观与可选条件,\(\tilde v_\theta\)为网络输出。原Eq.1是
这是平方L2误差的期望。引言称root mean square error,但编号公式没有开根号。两者梯度缩放和batch归约可不同,本精读以公式讲解,同时记录文字冲突;没有训练代码,无法断言实际实现是哪一种。
如果 \(\alpha_t^2+\sigma_t^2=1\),由两个线性组合反解可得下式,作为解释v目标如何还原材质/噪声的推导:
上述规范化假设和推导是通用背景;不能从“Euler”推出作者到底用了哪一组时间步、sigma schedule或CFG scale。v-prediction不是物理表面运动速度,也不保证自动减少全部采样方差。原文关于数据少时更稳定的论述缺少独立epsilon/v对照表。
07 · 数据与训练:明确的事实和缺口
数据来自INRIA合成SVBRDF与UBO,合计约200,000材质及对应渲染图,包含皮革、织物、石材等。预训练图像部分保持既有先验,其余网络在材质数据上训练。取渲染图走VAE/VGG构建条件,对真材质逐步加噪,学习反向速度目标。需要物理控制时,从粗糙度/镜面图计算相应输入,但计算方式未详述。
| 项目 | 论文报告 | 不可擅自补全 |
|---|---|---|
| 数据规模 | 约200,000例 | 确切去重数、划分、每类数量 |
| 文本模板 | flat texture of + 描述;图注省略公共前缀 | caption来源、自动标注模型、同图多描述比例 |
| 训练算力 | 4张A100,FP16 | A100显存版本、batch、GPU利用率 |
| 时长 | 每次训练约10天 | 总步数、epoch、优化器、学习率曲线 |
| 目标 | Euler,v-prediction,Eq.1平方误差 | 采样步数、CFG、噪声日程 |
| 输出 | 256×256×10 | 所有引擎的即插即用兼容性 |
文本到图像模型在大规模自然图像上训练,材质模型在更小的物理图集上训练,这是解决数据不足的关键。训练数据“约20万”不能说明它包含所有复杂语义;作者正是利用第一阶段把材质集外的对象图案迁移进来。是否真的组合泛化,需要不重叠的系统测试,而非仅凭几个成功样例。
08 · 三条路线的定性消融
| 路线 | 做法 | 论文观察 | 证据强度 |
|---|---|---|---|
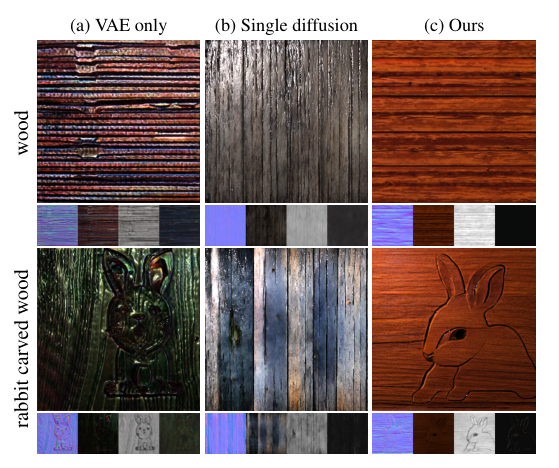
| VAE调整路线 | 冻结encoder,改decoder输出10通道并加层;随后整体端到端训练 | 还能理解部分训练外文本,但材质图不合理,木材镜面色像金属 | 图例,没有参数图误差或样本成功率 |
| 单扩散 | 直接学习text→SVBRDF | 基础材质略好,复杂语义弱,例如不能理解兔子雕刻木材 | 定性对照,未公布完整训练公平性 |
| 双阶段 | 保留SD2外观先验,再材质专用去噪 | 复杂图案与较合理通道兼得 | 支持方案可行,不足以分离每个模块的贡献 |
图注把第一路线简写为“只训练VAE decoder”,但正文明确还有后续端到端阶段,应保留这个过程区别。消融也没有分别移除VGG、连接方式、物理条件或改v为epsilon,所以不能声称这些细节都有量化消融支持。
09 · 平稳、非平稳、金属与玻璃
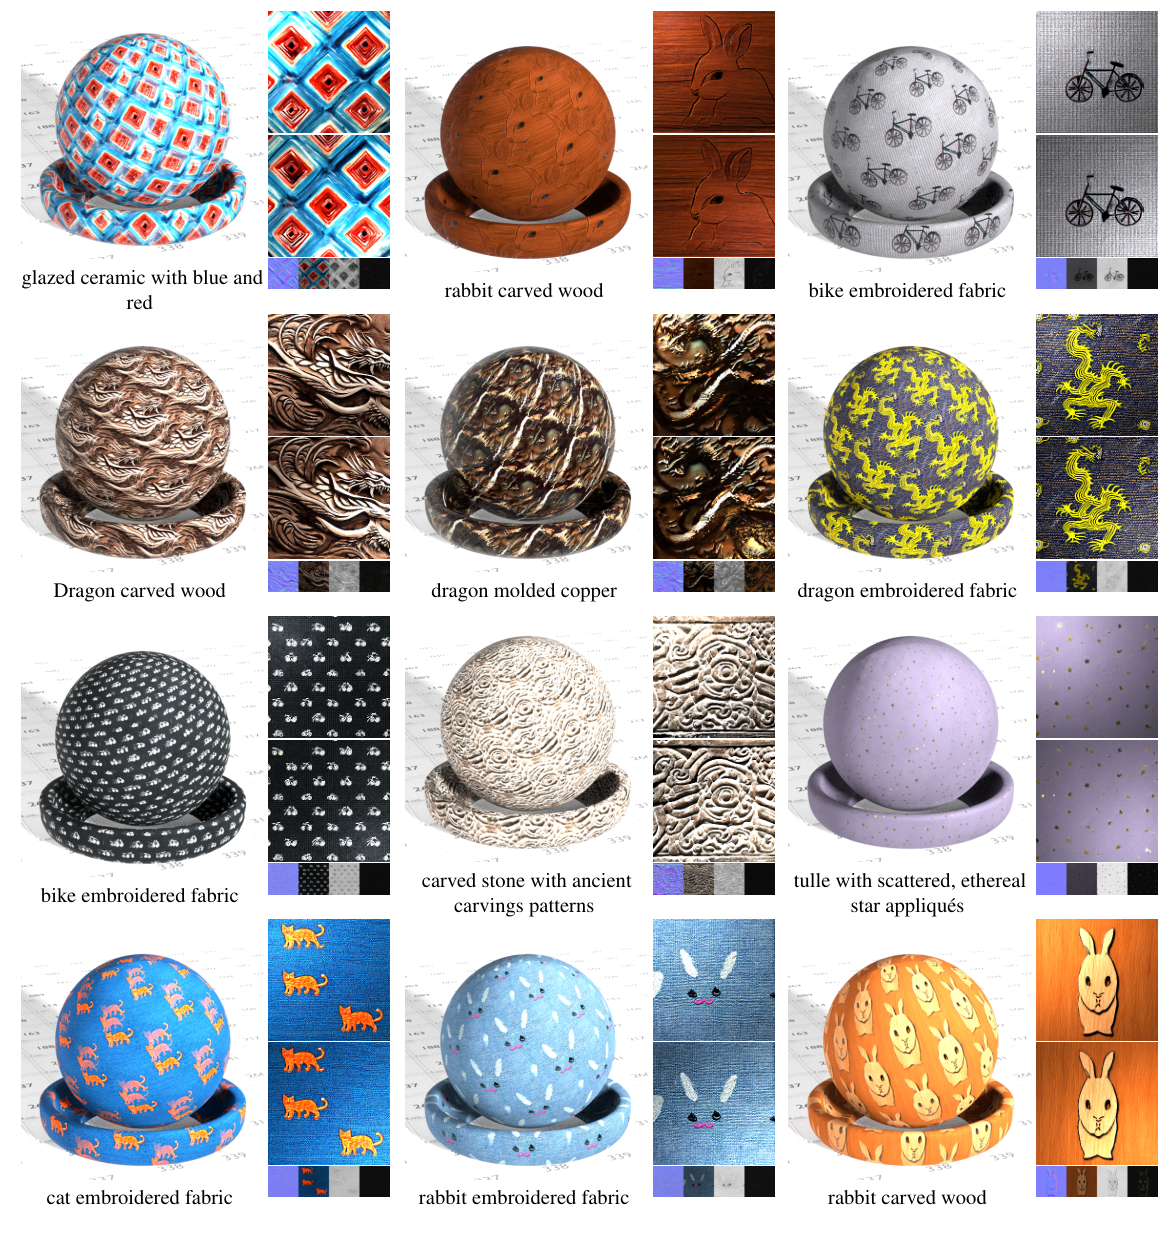
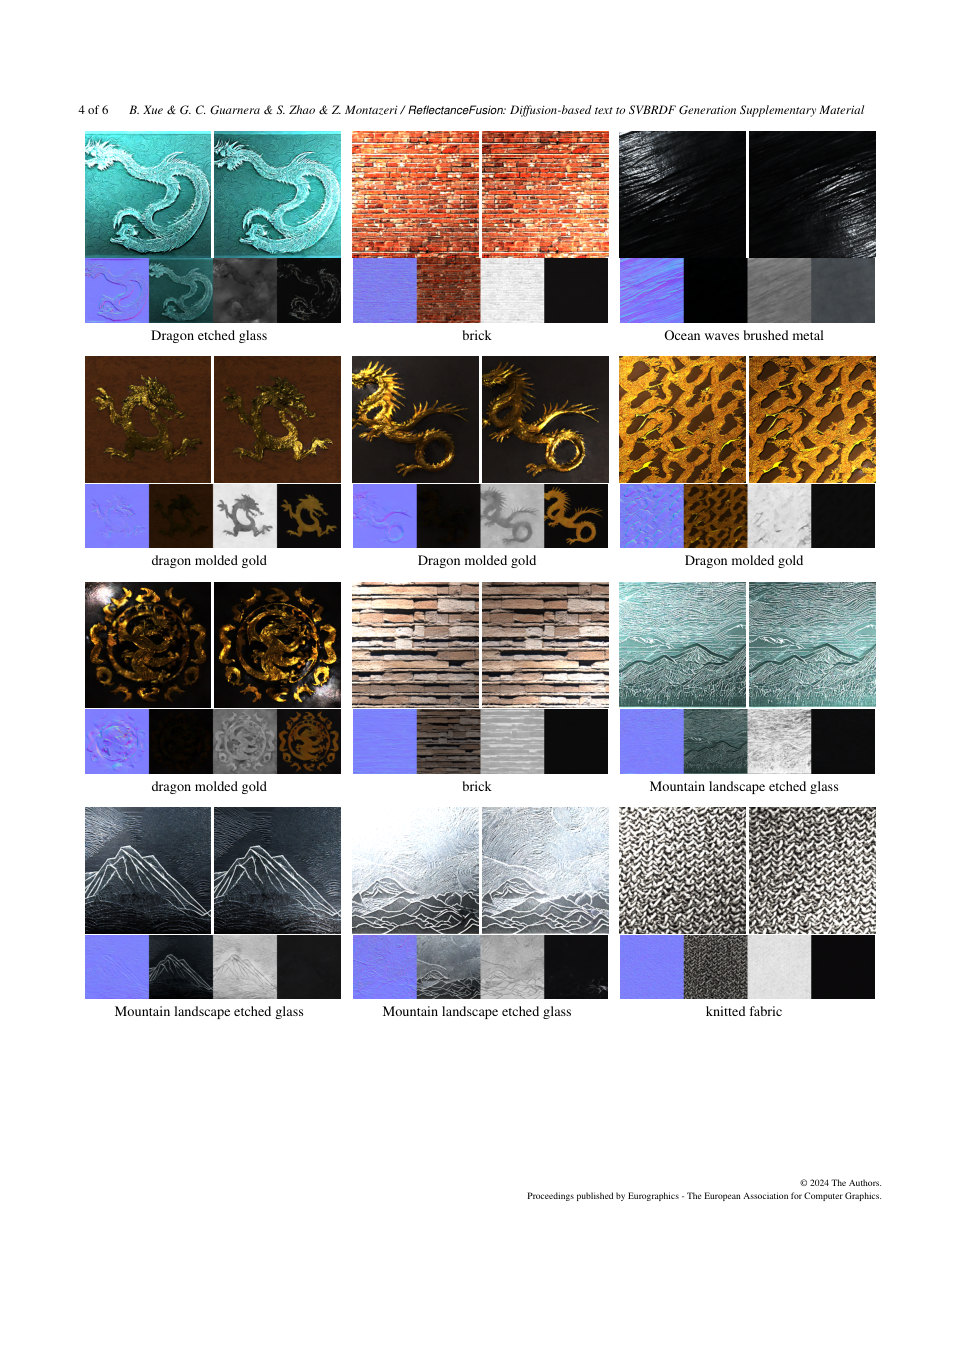
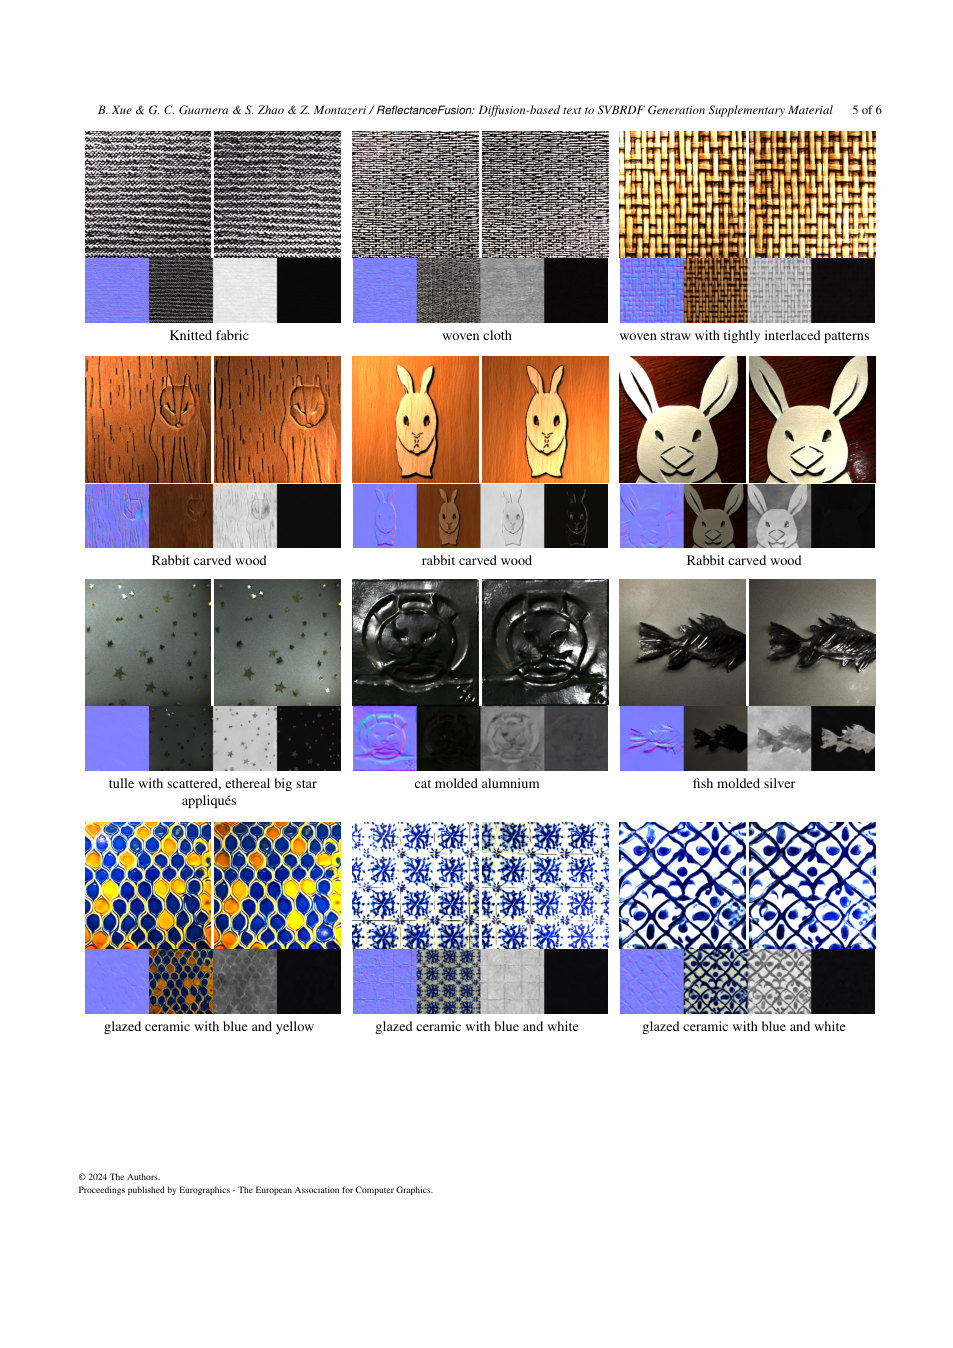
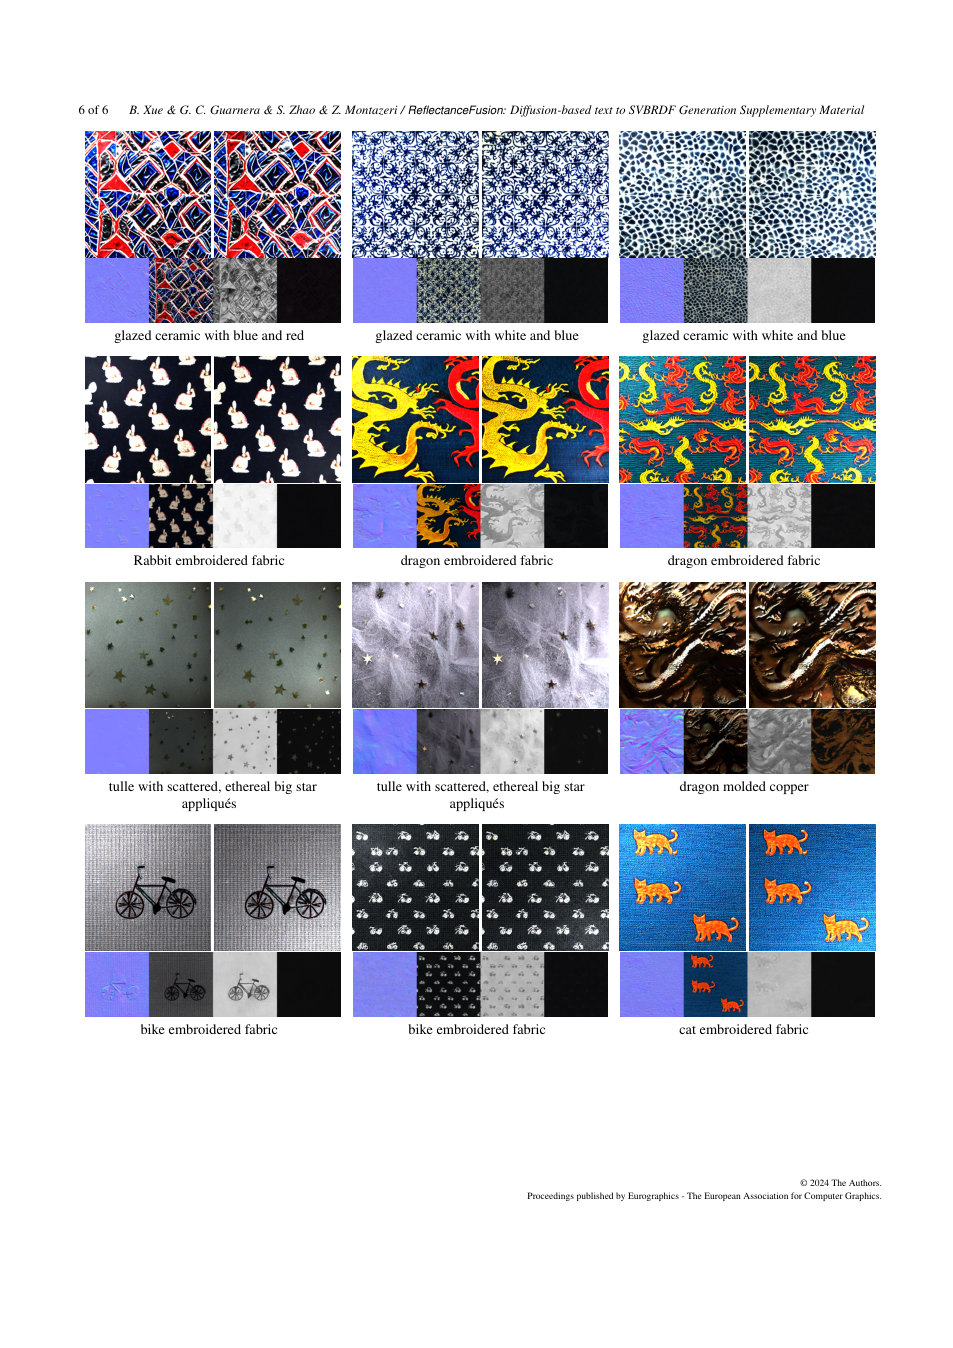
非平稳例子包括动物雕刻木材、龙形铜材、自行车刺绣织物和带局部装饰的薄纱。这里“非平稳”指图案含语义对象或位置结构,不是时间上不断变化的动态材质。展示包含平面两侧光及映射到三维物体的渲染,有助于判断通道是否能随灯光响应。
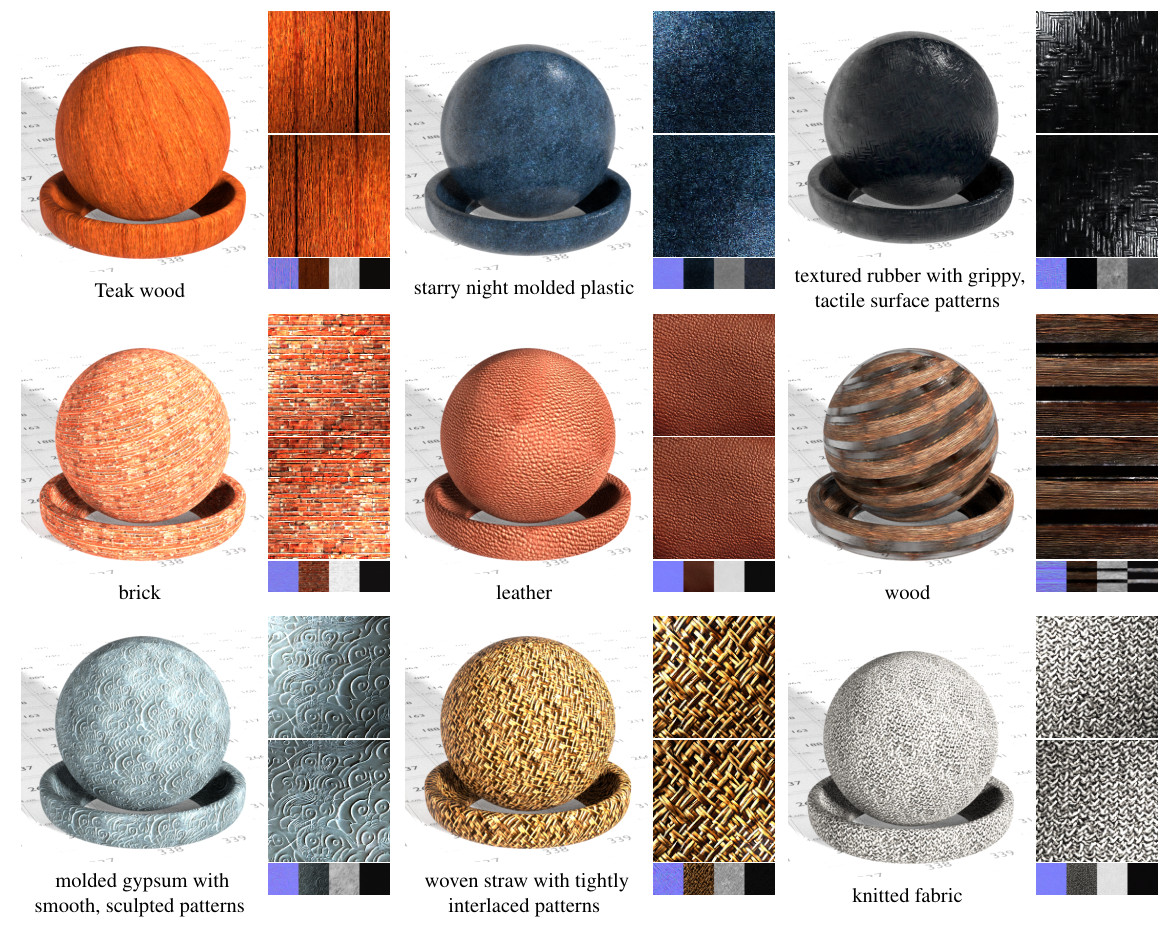
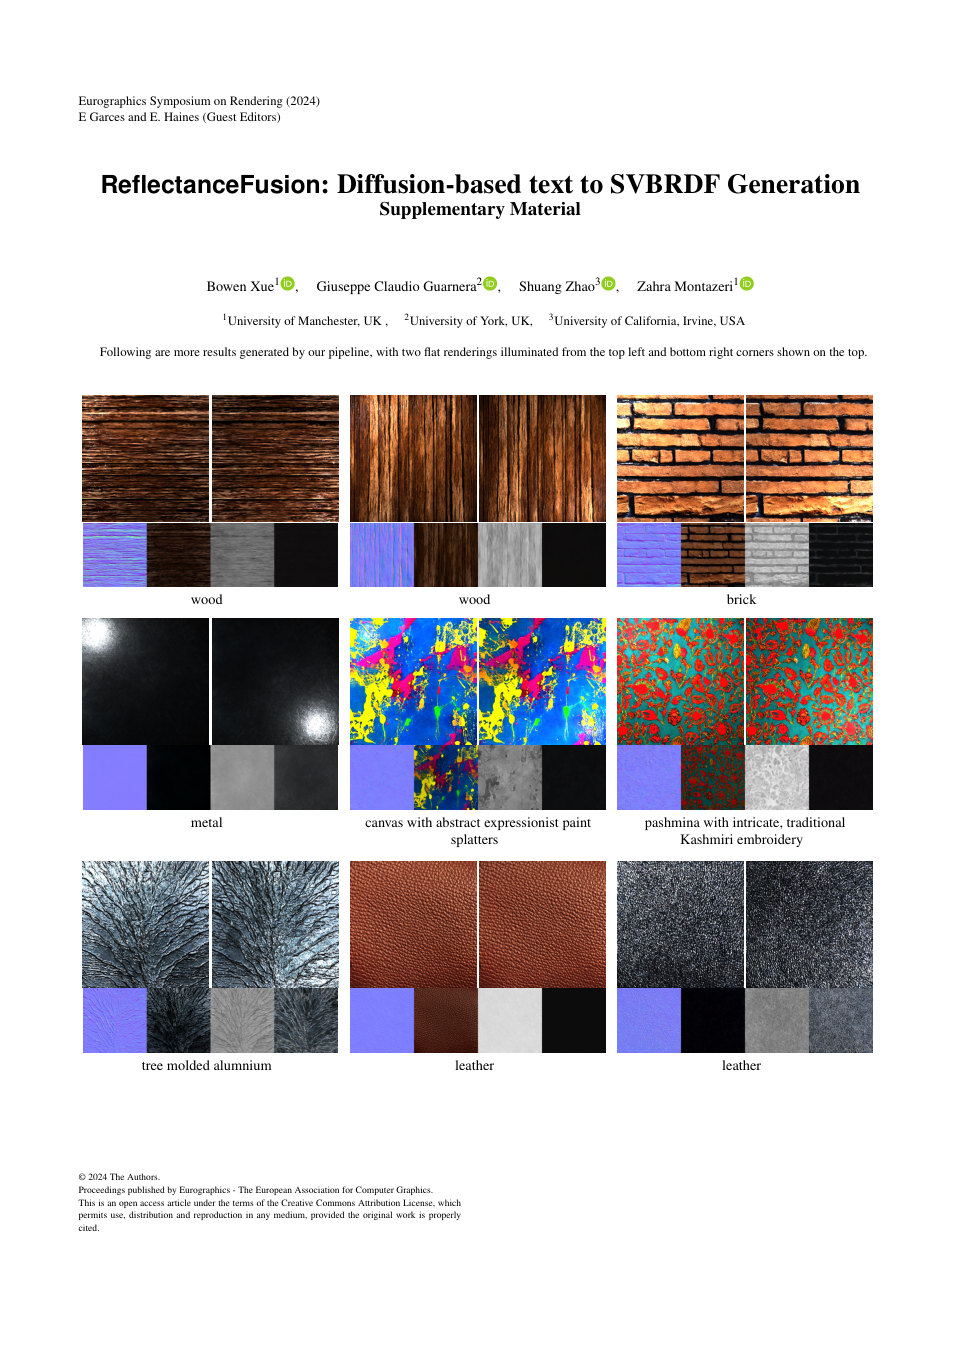
平稳示例包含木纹、砖、皮革、橡胶、编织和石膏。作者指出橡胶例子漫反射近黑而外观主要由镜面项贡献,说明网络不只是把RGB图片复制到albedo。但这只是一个示例,后面作者也承认某些样本会把高光烘进漫反射图。
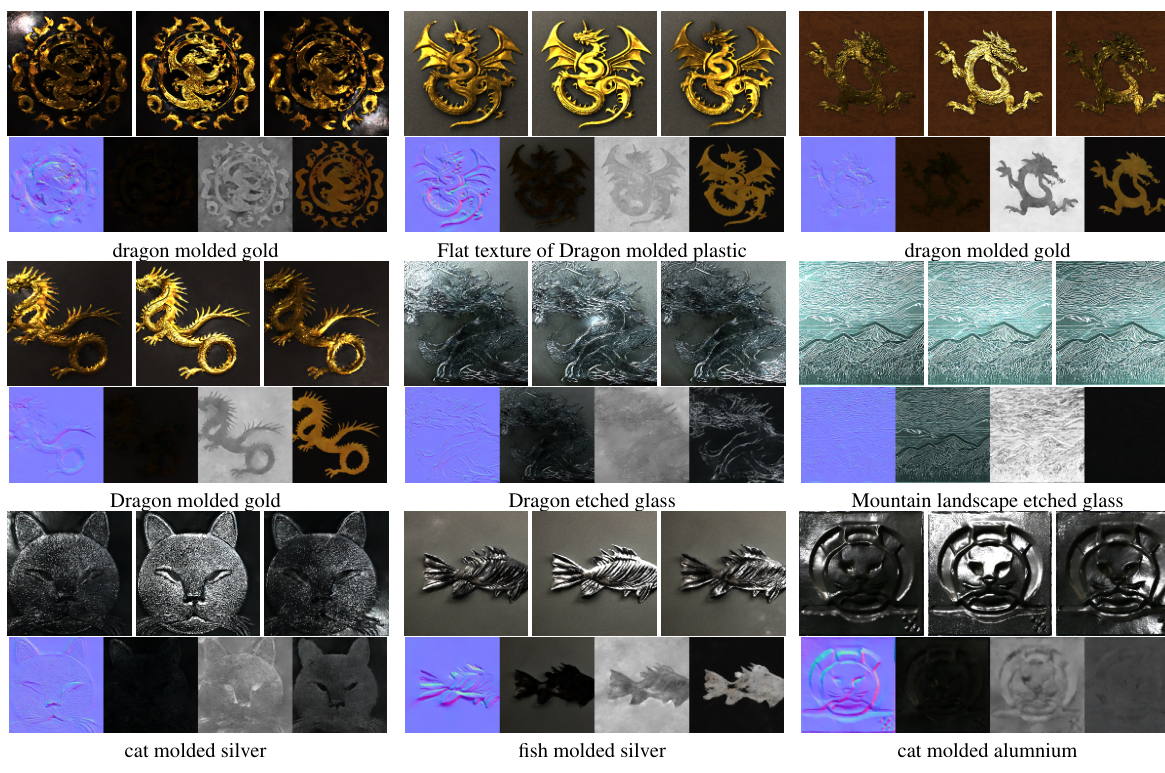
金属的镜面颜色可带色,和普通电介质不同。三束变化灯光下的平面效果展示可重打光能力。“玻璃”样例没有透射,只展示表面反射的电介质感,不能外推成生成透射系数、IOR、吸收或厚度。法线图上看似雕刻的龙,也不代表真实物体网格已经挖出轮廓。
10 · Text2Mat比较与速度
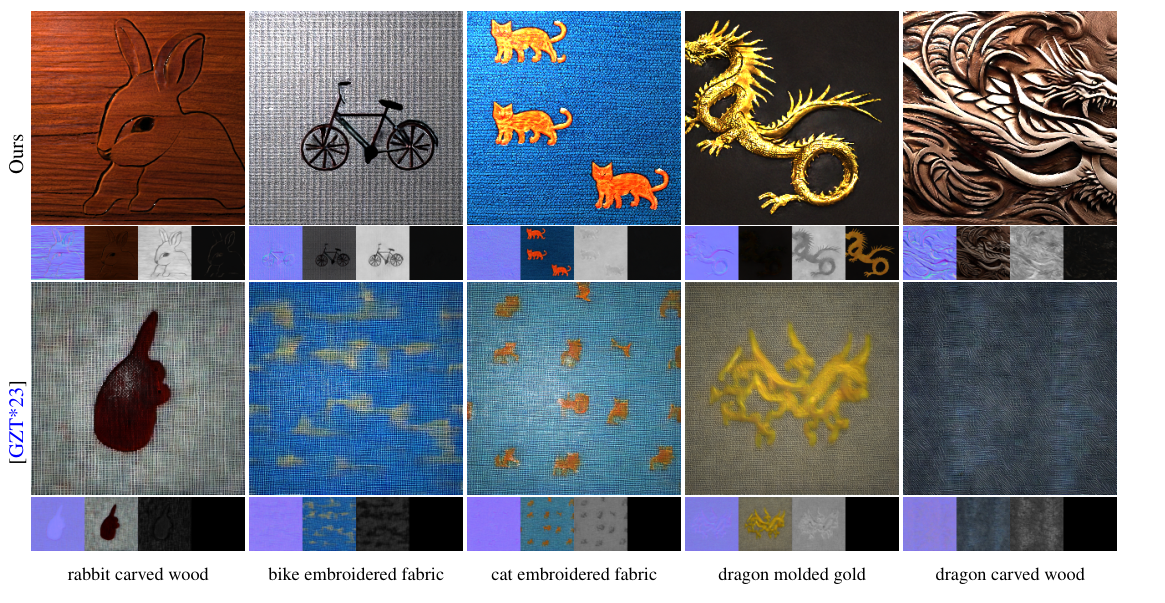
v1仅与Text2Mat做直接方法对比。当时其未开源,作者把同样文字交给对方作者生成,再展示结果;因此不是本研究在统一硬件、统一采样次数、统一挑选策略下重跑的全自动benchmark。复杂图案示例中ReflectanceFusion更能呈现文本,但没有盲评人数、统计显著性、失败率、FID/CLIPScore或跨光照误差表。
| 运行条件:A100,100次查询取平均 | 平均时间 | 输出 |
|---|---|---|
| Stable Diffusion2 | 3.21秒 | 单张静态RGB外观 |
| ReflectanceFusion | 5.16秒 | 四类SVBRDF参数图 |
按报告值计算增加1.95秒,约1.61倍、60.7%的相对耗时。作者称差异小,这是应用判断;不能把5.16秒写成只多几乎零成本。两者输出目标不同,时间比较说明实用性而非同任务速度优势,且未说明采样步数、warmup、方差和是否包括全部后处理。
“唯一现有text-to-material方法”是v1的历史性表述,不应当作2026年仍成立的全领域结论。也不要把同名MatFusion的单图材质获取,和本文ReflectanceFusion的文本生成混为一个模型。
11 · 外观编辑、物理编辑与平铺
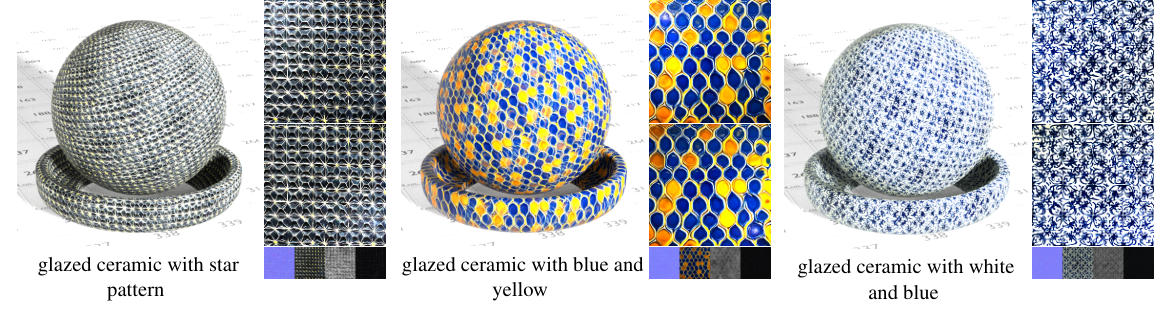
改变主要文本可改同一材质类别中的色彩和局部形状,例如陶瓷上的星纹、蓝黄或蓝白组合。这不是带像素保持约束的局部编辑:换提示可能连全局纹理一起变化,论文没有给编辑区域外误差或identity保持指标。
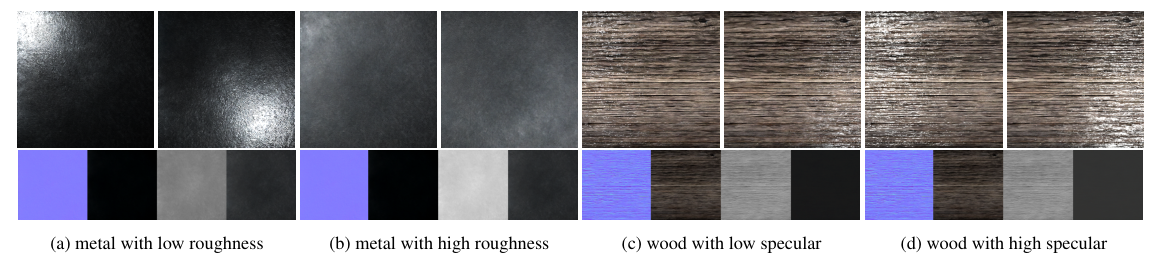
第二阶段可接受额外text2式高/低roughness、high/low specular条件,在保留第一阶段外观时调整物理倾向。也可直接后处理输出图,这两种交互应分开:前者是条件生成,后者是参数图数值编辑。论文没有给词语对应的确切目标粗糙度、单调性曲线或通道解耦量化,不能保证只改变一个属性、其他图完全不动。
连续平铺不是网络天生保证。作者将原图与quarter-shift版本用渐变mask融合来减缝,属于后处理。图案对象可能被融合重复、切断,法线图混合也可能需要重新单位化;正文未完整给出算法及接缝指标,本精读不捏造tileability分数或断言任意文本都无缝。
12 · 官方结果仓库与可复现边界
官方仓库快照58e6ba1…定位为结果发布。README描述约700个随机组合文本,每个生成4次;查看完整递归树,实际可见2323个PNG,另有README及小型test.py辅助文件,未见训练器、ReflectanceUNet实现、完整配置或模型权重。README的约数与当前文件数不完全对应,不将其当作精确2800个可复现实验。
展示条带的顺序为渲染预览、法线、albedo、roughness、specular;它不是把每一项都当作等通道数的原始训练张量。可以检查现成结果,不等于能够按文中设置重新训练或对新文本运行推理。GitHub页面显示Python语言也不能作为模型源码已发布的证据。
本次没有执行仓库脚本或运行模型,只审阅公开记录并构建阅读材料。正式版对连接模块补充了低层VGG和reshape/零填充,但仍没有代码级shape规范。原文称RMSE与Eq.1平方误差的差异保留;未公开细节以“未报告”标注,不用其他扩散论文默认值代替。
13 · 强项、局限与物理一致性
- 合理的模块分工:大图像模型保留组合语义,小材质模型学习物理通道分布,避免整个网络被小数据集拉回简单纹理。
- 可用资产形式:明确输出参数图而非静态渲染,允许后续灯光与场景改变,这是与纯text-to-image最重要的区别。
- 不等于物理保证:生成参数落在训练分布附近,不自动满足能量守恒、通道一致、法线可积性或无烘焙高光;论文没有显式相关损失。
- 证据主要定性:成功画廊和单基线样例不足以估计失败率、训练外泛化或重复运行稳定性。
- 分辨率与数据:256²材质图限制近看细节;增大数据/分辨率需要新证据,不是简单宣称能扩展。
- 错误语义:作者承认会生成不相关或无意义结果,需要人挑选;没有自动质量拒绝机制。
- 表示范围:玻璃无透射,复杂织物微几何/BTF行为没有完整表达;“可用在任意表面”不代表各向异性、曲率、尺度均可靠。
从研究设计看,最有价值的下一步不是再加一页成功样本,而是系统拆解连接模块、数据先验和物理控制的贡献,并披露失败分布与可复现配置。对制作资产而言,还需在目标引擎、多个光照和不同UV尺度下验证,单张漂亮渲染不够。
14 · PMG可检验延伸与复现清单
以下是本精读提出的研究设想,不是论文已完成的实验。
- 把第二阶段输出从稠密参数图扩展到可编辑程序材质图时,需同时约束拓扑有效性、节点参数与渲染效果;不能直接把10通道U-Net说成程序生成器。
- 建立颜色、图案、粗糙度、镜面强度的因子测试集,固定第一阶段噪声与外观表示,测各控制对其他属性的泄漏。
- 加入多光照可微渲染一致性和通道先验,检测烘焙阴影/高光;但需报告是否降低语义细节和样本多样性。
- 对平铺后处理比较接缝误差、局部图案损坏和法线有效性,独立报告原始输出与修复输出。
- 匹配总采样预算与挑选数量,进行人类盲评、文本一致性、物理属性控制误差及渲染质量比较;提供随机种子与失败例。
复现所需但目前不全的信息:精确数据划分与caption生成、VAE/VGG融合shape、U-Net通道/head配置、噪声schedule、训练步数/优化器/batch、物理条件数值映射、采样步数/CFG、材质通道归一化和渲染器约定。将这些标为未披露比照搬其他项目配置更可靠。
15 · 官方补充材料完整图集
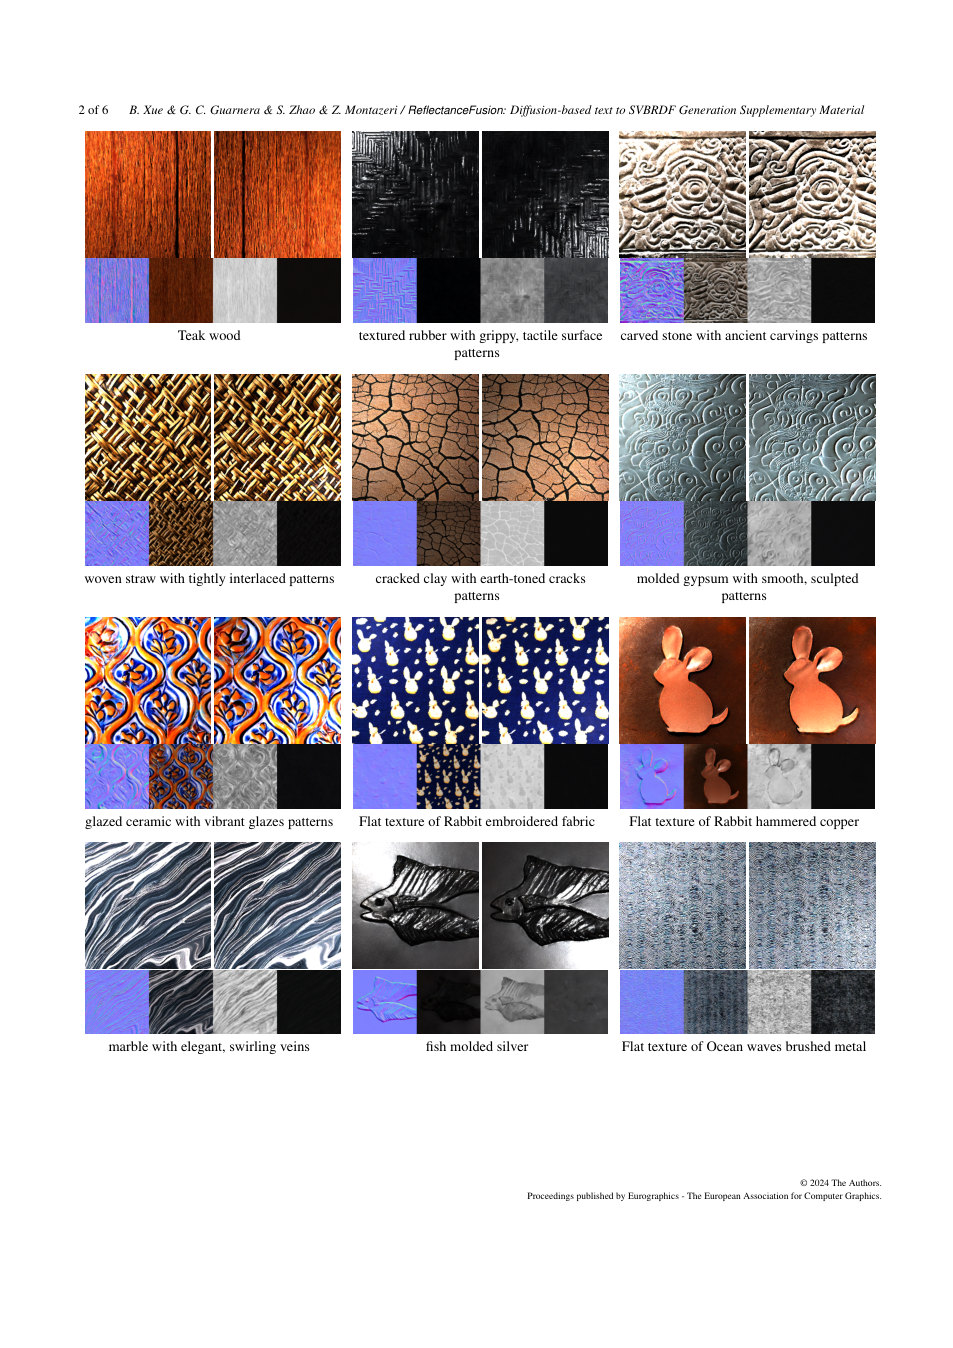
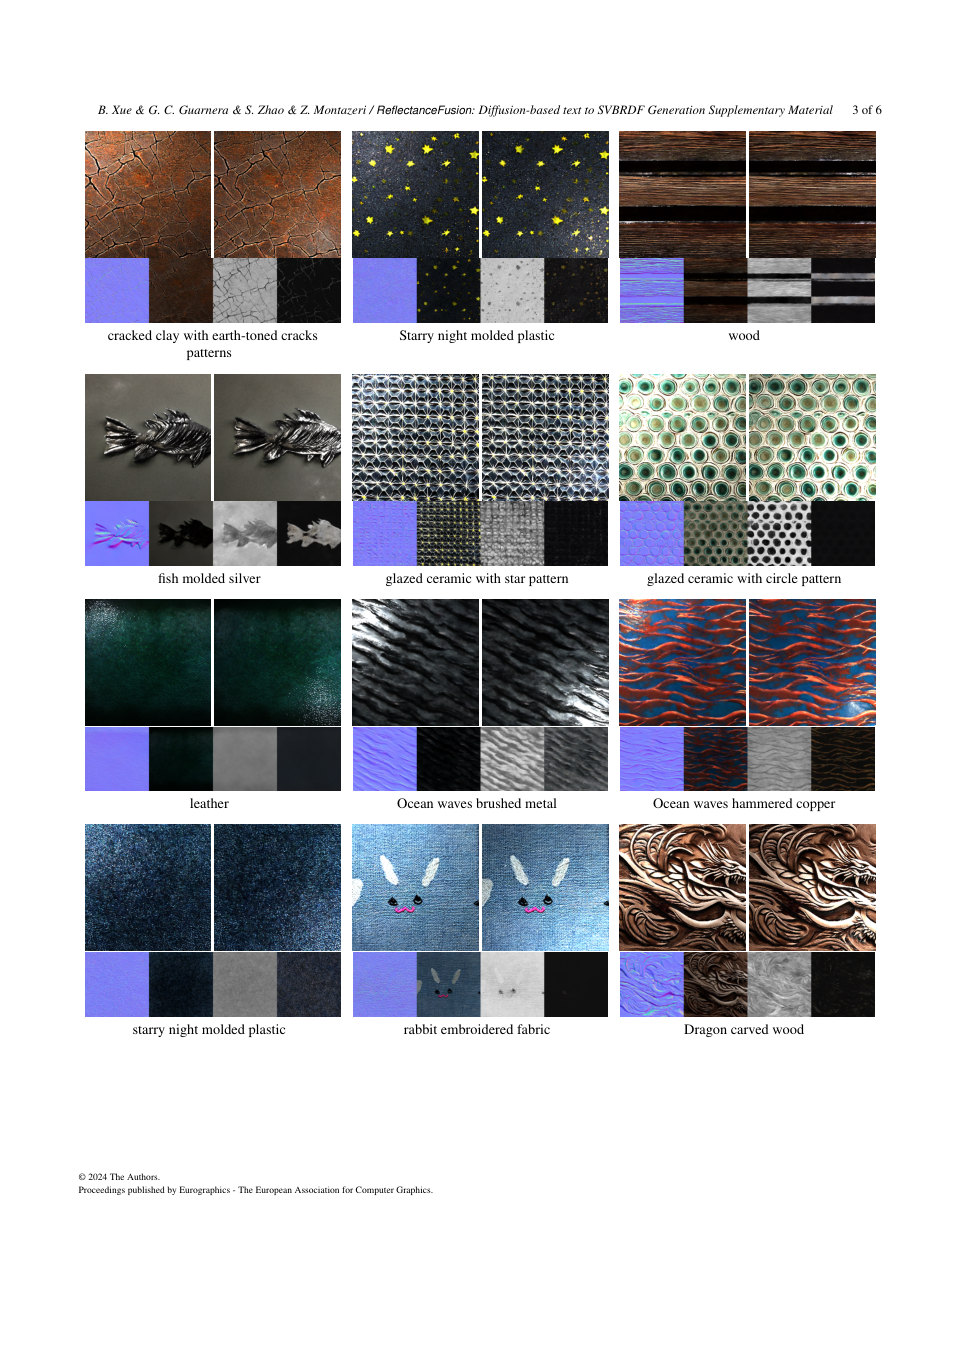
下面保留官方EGSR六页补充材料的全部页面,展示更多平稳和语义图案材质及不同光照。它是后续发表配套图集,不是用户v1中的额外定量附录;没有新的指标表或训练算法。图像仅用于私人阅读和来源核查,版权与署名见原页。
16 · 最终记忆点
- 第一阶段SD2.0负责外观/文本先验,第二阶段是材质图空间的扩散;整套流程仍使用预训练图像VAE。
- 四类图合计10通道:normal3、diffuse3、specular3、roughness1;不是透明玻璃或完整BTF。
- v目标 \(\alpha_t\epsilon-\sigma_t x\),Eq.1是平方L2期望,文字RMSE说法不一致。
- 约20万训练例、4A100、FP16、约10天、256²;缺失的训练超参不要自行补全。
- 5.16秒与SD2的3.21秒输出任务不同;没有定量质量表和用户实验,证据强度有限。
- 平铺靠后处理,物理属性文本控制未给精确定标,高光烘焙仍是失败类型。
- 官方仓库主要发布结果,不等于完整模型已开源;原笔记和PDF选区链接已完整保留。
覆盖固定v1正文全部9幅图、唯一编号Eq.1及所有报告数字;原论文无编号数值表,本文表格均为来源事实的整理。内容与静态检查完成,浏览器渲染/本地验收按用户要求延后;没有训练、部署或写回Obsidian。