01 · 身份、核心结果与版本边界
RegNeRF 的核心是“在没有照片的视点也约束 NeRF”:给稀疏相机输入拟合颜色之外,从虚拟视点渲染小块图像,约束深度平滑与自然图像外观,并在早期缩小沿射线的采样范围,避免把高密度堆在相机附近来记忆训练照片。
固定阅读:arXiv 2112.00724v1,2021-12-01,原 PDF 共 11 页,虽然本地文件名与下载地址未写版本。正文到第 9 页开头,参考文献到第 11 页。另完整阅读了作者 CVLABS 提供的独立 supplementary,共 14 页,不能说成固定 PDF 自带的 14 页附录。
官方项目页确认 CVPR 2022 oral。作者为 Michael Niemeyer、Jonathan T. Barron、Ben Mildenhall、Mehdi S. M. Sajjadi、Andreas Geiger、Noha Radwan。第一作者关联 MPI-IS、University of Tübingen 和 Google Research;星号表示 Google 实习说明,不是通讯作者标记。Noha Radwan 仍仅为原笔记中的未核实通讯作者候选。
| 结论 | 固定 v1 证据 | 必要限定 |
|---|---|---|
| 少至 3 张图可以明显改善新视角 | DTU masked PSNR 18.89 vs mip-NeRF 8.68;LLFF 19.08 vs 14.62 | 已知相机姿态;不是未知 pose 重建或任意遮挡内容的准确补全 |
| 几何约束和退火贡献最大 | DTU 3-view 去掉退火 10.17、去掉几何 14.34、完整 18.89 | 偏好平滑几何,未观察到的细节会模糊 |
| 不依赖多场景 posed-data 预训练的场景生成器 | 每场景从头优化 mip-NeRF | 完整方法仍用 JFT-300M 上预训练的 RealNVP 外观先验 |
| 公开代码可以训练简化版 | Google 官方仓库明示不含 flow 模型及 appearance loss | 不能把公开脚本默认结果称为完整 RegNeRF 的复现 |


本页完整保留固定主文 4 表、8 图和公式 1–13;补充材料 6 表、编号 1–16 的图及公式 S1–S5 单独标注。Supplement Figure 4/5 是同一组 9-view 比较的重复编号式图注,按源文一起呈现,不虚构一个额外实验。
02 · 稀疏输入为何退化:误几何与早期优化
少量相机下,重建输入图像只是弱约束。网络可以沿每台相机附近放置密度,使训练视图看似正确,却无法在新的观察位置组成一致三维结构。更多迭代或更强颜色拟合不必解决这个欠定问题,反而会强化记忆。
条件 NeRF 用大量多场景、带相机标注的数据训练一个可泛化生成器,提供先验但成本高且可能有域偏移。RegNeRF 选择每个场景独立优化,用较简单的几何先验与非结构化 2D 图像先验约束看不到的位置。它并未消除先验,只是改变先验来源与施加位置。

输入蓝色相机提供 RGB 真值;红色虚拟相机没有真实图像标签,只提供渲染 patch 上的深度/外观正则。推理时仍是普通 mip-NeRF 体渲染,不再调用 RealNVP 或计算训练损失。整个方法不是生成 mesh、material graph 或物理 BRDF 的系统。
| 对象 | 输入/输出与角色 |
|---|---|
| 场景网络 θ | 3D 位置、视角 → density 与 RGB;每场景优化 |
| 已有相机与图像 | 训练 RGB 监督;相机参数已知,不由本算法校准 |
| 目标姿态集合 | 限定要生成的新视角范围;用于定义虚拟相机采样 |
| 虚拟 patch | 8×8 RGB 和 depth,计算正则;没有逐像素 GT |
| RealNVP φ | 冻结的自然图像 patch 密度先验;不是逐场景重新学习的 NeRF |
03 · radiance field、mip-NeRF 与深度的含义
\[f_\theta:\mathbb R^{L_x}\times\mathbb R^{L_d} \longrightarrow[0,1]^3\times[0,\infty),\quad (\gamma(x),\gamma(d))\longmapsto(c,\sigma).\tag{1}\] \[\widehat c_\theta(r)=\int_{t_n}^{t_f}T(t)\sigma_\theta(r(t))c_\theta(r(t),d)\,\mathrm dt, \quad T(t)=\exp\!\left[-\int_{t_n}^{t}\sigma_\theta(r(s))\,\mathrm ds\right].\tag{2}\] \[\mathcal L_{\mathrm{MSE}}(\theta,\mathcal R_i) =\sum_{r\in\mathcal R_i}\|\widehat c_\theta(r)-c_{\mathrm{GT}}(r)\|_2^2.\tag{3}\]射线为 \(r(t)=o+td\),T 是从 near 到 t 的透射率,密度乘透射率决定该处对像素的贡献。训练颜色误差经可微体渲染传播到所有采样点,监督的是最终图像而不是直接的真实几何。
RegNeRF 建立在 mip-NeRF 上:一个像素视为锥体,以 conical frustum 的高斯近似做 integrated positional encoding,而不是无限小的点。多尺度采样共享同一个 MLP;两级各 128 samples,所以每条射线约 256 次场查询,不是原始 NeRF 两套独立 coarse/fine MLP。
\[\mathbb E_{x\sim\mathcal N(\mu,\Sigma)}[\sin(b^\top x)] =\exp(-b^\top\Sigma b/2)\sin(b^\top\mu).\]这是帮助理解 IPE 的通用高斯期望公式,并非 RegNeRF 新增编号公式。较大的像素 footprint 会抑制过高频率,从而缓解 aliasing;但单靠 mip-NeRF 不能解决少视图下几何欠约束。
\[\widehat d_\theta(r)=\int_{t_n}^{t_f}T(t)\sigma_\theta(r(t))\,t\,\mathrm dt.\tag{8}\]原 Eq.8 写未归一化的深度一阶矩。公开 mip.py 的 distance_mean_save 则以权重总和 acc 归一化,再做数值 clip。若射线 opacity 约 1,两者接近;透明或空区域时差别很大。不能将本文正则理解成拥有真实 depth label,更不能把渲染深度当直接测得的表面真值。
来源:固定 PDF §3.1、Eq.1–3、8;补充 §2.1;官方 models.py 与 mip.py。
04 · 未观察视点如何采样
\[P_i^{\mathrm{target}}=[R_i^{\mathrm{target}}\mid t_i^{\mathrm{target}}]\in SE(3).\tag{4}\] \[\mathcal S_t=\{t\in\mathbb R^3:t_{\min}\le t\le t_{\max}\}.\tag{5}\]先用所有给定目标相机位置的逐分量 min/max 构造采样盒。它不是任意全空间,也不是只在训练相机旁做小扰动。目标姿态可用于限定测试分布,因此这是“已知目标相机覆盖范围”的设定;虽然没有使用测试 RGB,仍不是对未知任意视点分布的无条件保证。
共同 up 方向为目标相机 up 的归一化平均;focus point 通过最小化到各 optical axes 的平方距离得到。若光轴方向为单位向量 d_i、原点 o_i,可写解释性的最小二乘:
\[\bar p_f=\arg\min_p\sum_i\|(I-d_id_i^\top)(p-o_i)\|_2^2.\]平行或近共线光轴可能使该求解不适定,代码直接矩阵求逆,需要检查相机配置。论文假设相机大致朝向共同场景中心,不适合直接迁移到任意城市街道、任意 360° 相机分布。
\[\mathcal S_{R\mid t} =\{R(\bar p_u,\bar p_f+\epsilon,t):\epsilon\sim\mathcal N(0,0.125)\}.\tag{6}\] \[\mathcal S_P=\{[R\mid t]:R\sim\mathcal S_{R\mid t},\,t\sim\mathcal S_t\}.\tag{7}\]R 是 look-at 构造。Eq.6 的 Gaussian 第二参数没有明确区分方差与标准差;当前 DTU 代码使用 randn×0.125,即标准差 0.125。本文保留原写法并说明代码,避免无依据把方差解释为 0.125。
当前代码基于 centered camera 坐标的 radii/poses_avg 构造位置分布,与主文“全局轴对齐 bounding box”的简写不是逐符号完全相同实现;LLFF 又用近远界的 disparity 插值得到 focus depth。需要保持每个数据集的坐标归一化、NDC 与视线方向约定。
05 · 深度平滑与自然图像 patch 先验
\[\mathcal L_{\mathrm{DS}}(\theta,\mathcal R_r) =\sum_{r\in\mathcal R_r}\sum_{i,j=1}^{S_{\mathrm{patch}}-1} \left(\widehat d_\theta(r_{ij})-\widehat d_\theta(r_{i+1,j})\right)^2 +\left(\widehat d_\theta(r_{ij})-\widehat d_\theta(r_{i,j+1})\right)^2.\tag{9}\]每个虚拟相机渲染 8×8 patch,以水平和垂直邻域差的平方鼓励 piecewise smooth depth。它并没有利用 RGB 梯度做 edge-aware 权重;物体真实边缘、薄结构或细碎深度也可能被抹平。作用于渲染深度的损失沿整条射线传播,比只惩罚一个 3D 采样点的 normal/density 提供更全局的信号,这是作者对其成功的解释。
\[\phi:[0,1]^{S_{\mathrm{patch}}\times S_{\mathrm{patch}}\times3} \longrightarrow\mathbb R^d,\quad S_{\mathrm{patch}}=8,\ d=192.\tag{10}\] \[\mathcal L_{\mathrm{NLL}}(\theta,\mathcal R_r) =\sum_{r\in\mathcal R_r}-\log p_Z(\phi(\widehat P_r)), \quad \widehat P_r=\{\widehat c_\theta(r_{ij})\}_{i,j=1}^{8}.\tag{11}\]RealNVP 在 JFT-300M 的自然图像 patch 上预训练,用高斯 latent 密度评价新视角颜色是否像自然图像。它是低级局部外观先验,不是 CLIP 语义一致性,也不使用额外深度标签。自然图像预训练数据与完整 flow 权重/训练设置的公开可用性是复现限制。
Eq.11 的密度变换不能漏读
\[\log p_P(P)=\log p_Z(\phi(P))+ \log\left|\det\frac{\partial\phi(P)}{\partial P}\right|.\]数学核查:对一般非体积保持的 RealNVP,真正的图像空间 likelihood 还包含 Jacobian log-determinant。固定 v1 Eq.11 仅显式写第一项,若 p_Z 确实按文中说明是高斯密度,则它不是完整 change-of-variables 公式。这里把标准完整公式列出来,不静默改原式;官方 release 没有 flow 实现,因此本次无法核实论文训练时是否在内部 likelihood API 中包含该项。不能武断认定实际训练一定遗漏。
\[\mathcal L(\theta)= \mathcal L_{\mathrm{MSE}}(\theta,\mathcal R_i) +\mathcal L_{\mathrm{DS}}(\theta,\mathcal R_r) +\mathcal L_{\mathrm{NLL}}(\theta,\mathcal R_r).\tag{12}\]主文省略权重;supplement 给出 λMSE=1、λDS=0.1、λNLL=10⁻⁶,且 λDS 前 512 步从 400 线性下降到 0.1。只有训练视点使用真实 RGB MSE;虚拟视点不假装有真值照片。
06 · 采样空间退火、公式印刷问题与优化流程
\[t_n(i)=t_m+(t_n-t_m)\eta(i),\qquad t_f(i)=t_m+(t_f-t_m)\eta(i).\tag{13a}\] \[\eta_{\mathrm{printed}}(i)=\max\bigl(\min(i/N_t,p_s),1\bigr).\tag{13b}\]固定 v1 原 Eq.13 的问题:当文中举例 \(p_s=0.5\) 时,min 的结果总不超过 0.5,外层 max 与 1 比较永远为 1。因此照印刷式执行根本没有退火。这不是本页推导出的新算法,而是与正文描述不一致的原式。
\[\eta_{\mathrm{clamp}}(i)=\min\bigl(\max(i/N_t,p_s),1\bigr).\]上式是符合“起始范围至少 p_s,随后扩展到 1”描述的一种修正,但当前代码不是这条修正曲线,而是:
\[\eta_{\mathrm{code}}(i)=p_s+(1-p_s)\min(i/N_t,1).\]代码先算 near_init/far_init,再对它们与最终界线性插值,所以从第 0 步就逐步扩大,没有 plateau。三个版本必须分开:原版印刷式、合理 clamp 修正、实际代码线性插值。两种合理退火在完成时一样,中间课程不同。
| 场景 | near/far 与中心 | 早期课程 |
|---|---|---|
| DTU 3/6-view | 配置 near=0.5、far=3.5,中心为中点 2.0 | 前 256 步由 p_s=0.5 扩到全范围,初始 [1.25,2.75] |
| LLFF 3/6-view | NDC near=0、far=1,中心取 far=1 | 前 512 步,p_s=0.0001,初始 near=0.9999、far=1 |
| 9-view | 补充说明退火主要用于 3/6 输入 | 不能将 3-view 配置未经核查复制为所有场景的唯一设置 |
退火同时应用输入射线与虚拟射线。它改变采样区域而不是删除真实几何,也不是 positional encoding frequency annealing。代码虽包含某些频率辅助函数,本文的贡献与主实验是沿射线 near/far 的空间课程,不能与 FreeNeRF 等后续频率正则混淆。
- 读取稀疏 RGB、内外参与目标相机,初始化 mip-NeRF。
- 采 4096 输入像素用于颜色重建,另采虚拟相机 patch 射线做正则;公开默认 random rays 也是 4096,即 64 个 8² patch。
- 按当前步退火 near/far,渲染两级 RGB/depth;完整论文还使用冻结 flow 计算 appearance 项。
- 组合重建、深度与外观损失;梯度先逐值 clip 到 ±0.1,再全局范数 clip 到 0.1,Adam 更新。
- 完成 500 pixel epochs。测试新相机使用最终范围,分块体渲染整图;没有优化 prompt、beam search 或材质程序执行。
07 · 完整训练、数据划分与公开实现差异
| 项目 | 论文 / supplement | 公开代码核查 |
|---|---|---|
| MLP | 8×256 ReLU;两级各128采样 | 共享一个 MLP;view branch 1×128,softplus density、sigmoid RGB、位置 IPE 最大频率级16、视角级4 |
| 优化 | Adam,LR 0.002→0.00002 exponential | warmup 512 步、delay multiplier .01;gradient value/norm 各 .1 |
| 预算 | 500 pixel epochs、batch4096 | DTU 3-view43945 steps;LLFF3 的 room config69768 steps,与分辨率/输入图数有关 |
| 主文步数 | DTU 3/6/9-view 约44K/88K/132K | pixel epoch不是把全部256K网络采样点当训练像素 |
| 深度损失 | 8×8、L2差;λ从400→.1,512步 | 默认 selector=distance_mean_save;DTU加 stop-gradient opacity weighting |
| 完整外观损失 | RealNVP、JFT-300M、λ10⁻⁶ | 明确未发布;配置 flow_loss_mult=0 |
| 硬件/墙钟 | JAX mip-NeRF实现 | 未给可统一复现所有表的逐场景硬件小时;不能将减少迭代率当实际速度比 |
数据划分
DTU 测试 scan IDs:8、21、30、31、34、38、40、41、45、55、63、82、103、110、114。输入 image IDs 从 0 开始,按顺序为 25、22、28、40、44、48、0、8、13,3/6-view 取前 3/6 个。其余用于评价,但剔除曝光不对的 3、4、5、6、7、16、17、18、19、20、21、36、37、38、39。分辨率 300×400。
LLFF 每第 8 张为 holdout,输入从其余视图等间隔选取,分辨率 378×504;前向场景用 NDC。完整模型只以输入 RGB 做重建,却使用目标相机范围设计虚拟视点,这是需要披露的 transductive pose 信息,不是测试颜色泄漏。
当前公开源代码的静态风险
- 缺少 appearance:README 明确说没有 flow 模型和外观 loss,完整模型请用发布 checkpoint。Scan114 GPU masked PSNR 21.37 对此前21.48 只是单场景说明,不可充当全 DTU 的替代结果。
- LLFF 几何权重路径:configs.py 默认 depth_tvnorm_mask_weight=0,llff3.gin 未覆盖;train.py 仍构造 acc×该值作为 weighting,math.compute_tv_norm 无条件乘该权重。沿这条默认配置路径,几何损失被乘零。注释称0表示禁用mask,但实现没有转为 None。这里是静态代码推论,没有实际运行训练。
- LLFF 虚拟相机循环:当前 datasets.py 的 LLFF _generate_random_poses 中 random_poses.append 位于 for 循环外;虽然循环生成 n_poses 个候选,最终只 append 最后一个。这与默认 n_random_poses=10000 的意图不同。需检查实际版本并用计数单元测试验证,不能把当前源码当论文历史运行证据。
- LPIPS 没实现:eval.py 中 eval_disable_lpips 两个分支均返回 NaN,启用配置不能自动恢复指标;因 Average 依赖 LPIPS,也会受影响。复现需要补齐匹配论文的 LPIPS 实现与预处理,不声称本次已经修复。
- depth 与 loss 归约:代码渲染深度除 acc,DTU mask detach;fine geometry 乘调度权重,coarse 项在当前表达式中单独以 coarse_loss_mult 相加。与主文一个未加权求和式不逐项相同,不能静默抹掉差异。
来源:官方 Google release及其中 README、train.py、internal/configs.py、datasets.py、math.py、mip.py、models.py、eval.py、dtu3.gin、llff3.gin。源码快照有哈希;未执行外部模型代码,未定位论文历史 commit。
08 · 背景评价偏差与指标协议


DTU 常见白桌子、黑背景,背景面积会支配全图误差。Figure 3 中 PixelNeRF full/object PSNR 为17.37/16.89;本文为8.79/20.08。仅看 full-image 会得出相反评价,因此主表使用对象 mask。此处 mask 用于评价,不是额外训练 depth 或 segmentation 监督。
PSNR 只在 mask 内计算;SSIM 与 LPIPS 先把预测与真值对象合成到白背景,再计算整图特征指标。它们不是简单对原全图 SSIM map 做相同 masked mean。Supplement 文中将该现象错指主文 Figure4,固定主文实际为 Figure3,本页按内容标注。
\[\mathrm{Average} =\left(10^{-\mathrm{PSNR}/10}\sqrt{1-\mathrm{SSIM}}\, \mathrm{LPIPS}\right)^{1/3}.\]Average 是三种误差的几何平均,越低越好;不是把 PSNR、SSIM、LPIPS 三个原始数值做算术平均。逐场景先算再平均与将表格均值代入不同,不能用后一种操作指责小幅数值不一致。
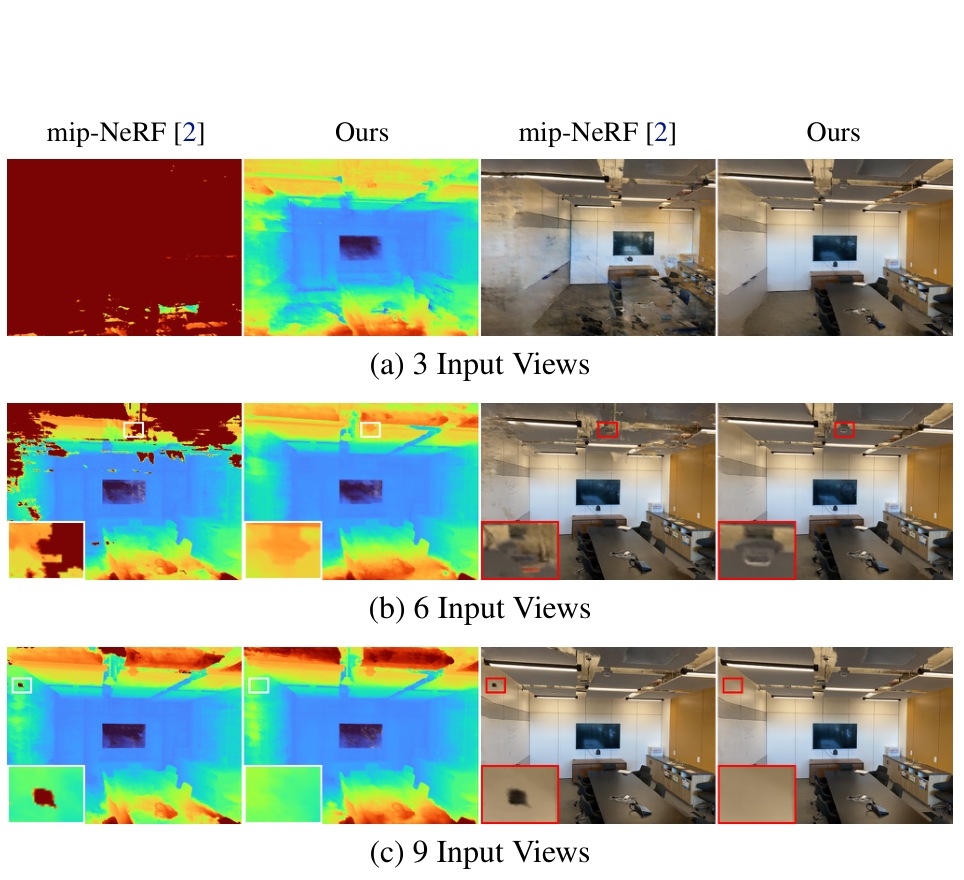

Figure4 展示深度质量和 RGB 质量关联;不是用真实深度指标证明唯一真实表面。Figure5 在更小测试子集上比较数据效率,声称稀疏区间至多节约55%输入图达到相近 PSNR,18-view时趋同。曲线样本与Table1不完全一样;不能将“最多55%”写成所有场景都省一半图。
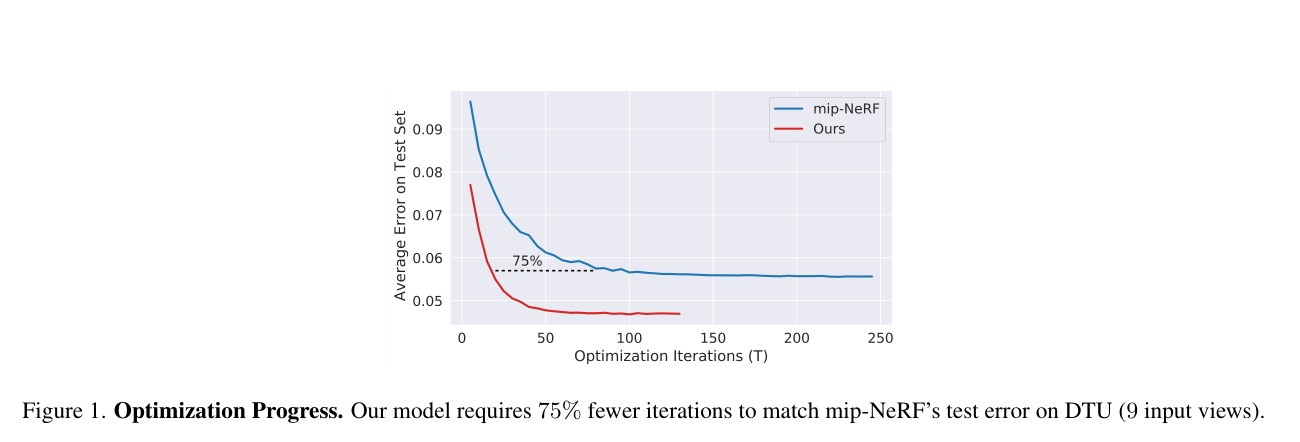
Supplement Figure1 为 DTU9-view,达到 mip-NeRF top5% 表现所需迭代减少约75%。这比较迭代数,不是等GPU时间;RegNeRF每步额外渲染虚拟patch,完整版本还调用flow,单步成本不同。
09 · 完整主表与多设置比较
固定 v1 原 Table 1
| Setting | PSNR \(\uparrow\) | SSIM \(\uparrow\) | LPIPS \(\downarrow\) | Average \(\downarrow\) | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 3-view | 6-view | 9-view | 3-view | 6-view | 9-view | 3-view | 6-view | 9-view | 3-view | 6-view | 9-view | ||
| SRF [8] | Trained on DTU | 15.32 | 17.54 | 18.35 | 0.671 | 0.730 | 0.752 | 0.304 | 0.250 | 0.232 | 0.171 | 0.132 | 0.120 |
| PixelNeRF [62] | 16.82 | 19.11 | 20.40 | 0.695 | 0.745 | 0.768 | 0.270 | 0.232 | 0.220 | 0.147 | 0.115 | 0.100 | |
| MVSNeRF [6] | 18.63 | 20.70 | 22.40 | 0.769 | 0.823 | 0.853 | 0.197 | 0.156 | 0.135 | 0.113 | 0.088 | 0.068 | |
| SRF ft [8] | Trained on DTU and Optimized per Scene | 15.68 | 18.87 | 20.75 | 0.698 | 0.757 | 0.785 | 0.281 | 0.225 | 0.205 | 0.162 | 0.114 | 0.093 |
| PixelNeRF ft [62] | 18.95 | 20.56 | 21.83 | 0.710 | 0.753 | 0.781 | 0.269 | 0.223 | 0.203 | 0.125 | 0.104 | 0.090 | |
| MVSNeRF ft [6] | 18.54 | 20.49 | 22.22 | 0.769 | 0.822 | 0.853 | 0.197 | 0.155 | 0.135 | 0.113 | 0.089 | 0.069 | |
| mip-NeRF [2] | Optimized per Scene | 8.68 | 16.54 | 23.58 | 0.571 | 0.741 | 0.879 | 0.353 | 0.198 | 0.092 | 0.323 | 0.148 | 0.056 |
| DietNeRF [19] | 11.85 | 20.63 | 23.83 | 0.633 | 0.778 | 0.823 | 0.314 | 0.201 | 0.173 | 0.243 | 0.101 | 0.068 | |
| Ours | 18.89 | 22.20 | 24.93 | 0.745 | 0.841 | 0.884 | 0.190 | 0.117 | 0.089 | 0.112 | 0.071 | 0.047 | |
固定 v1 原 Table 2
| Setting | PSNR \(\uparrow\) | SSIM \(\uparrow\) | LPIPS \(\downarrow\) | Average \(\downarrow\) | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 3-view | 6-view | 9-view | 3-view | 6-view | 9-view | 3-view | 6-view | 9-view | 3-view | 6-view | 9-view | ||
| SRF [8] | Trained on DTU | 12.34 | 13.10 | 13.00 | 0.250 | 0.293 | 0.297 | 0.591 | 0.594 | 0.605 | 0.313 | 0.293 | 0.296 |
| PixelNeRF [62] | 7.93 | 8.74 | 8.61 | 0.272 | 0.280 | 0.274 | 0.682 | 0.676 | 0.665 | 0.461 | 0.433 | 0.432 | |
| MVSNeRF [6] | 17.25 | 19.79 | 20.47 | 0.557 | 0.656 | 0.689 | 0.356 | 0.269 | 0.242 | 0.171 | 0.125 | 0.111 | |
| SRF ft [8] | Trained on DTU and Optimized per Scene | 17.07 | 16.75 | 17.39 | 0.436 | 0.438 | 0.465 | 0.529 | 0.521 | 0.503 | 0.203 | 0.207 | 0.193 |
| PixelNeRF ft [62] | 16.17 | 17.03 | 18.92 | 0.438 | 0.473 | 0.535 | 0.512 | 0.477 | 0.430 | 0.217 | 0.196 | 0.163 | |
| MVSNeRF ft [6] | 17.88 | 19.99 | 20.47 | 0.584 | 0.660 | 0.695 | 0.327 | 0.264 | 0.244 | 0.157 | 0.122 | 0.111 | |
| mip-NeRF [2] | Optimized per Scene | 14.62 | 20.87 | 24.26 | 0.351 | 0.692 | 0.805 | 0.495 | 0.255 | 0.172 | 0.246 | 0.114 | 0.073 |
| DietNeRF [19] | 14.94 | 21.75 | 24.28 | 0.370 | 0.717 | 0.801 | 0.496 | 0.248 | 0.183 | 0.240 | 0.105 | 0.073 | |
| Ours | 19.08 | 23.10 | 24.86 | 0.587 | 0.760 | 0.820 | 0.336 | 0.206 | 0.161 | 0.146 | 0.086 | 0.067 | |
两张主表分别对应 DTU masked 和 LLFF;每表全部9个方法行及3/6/9-view下4组指标均保留。Trained on DTU、再按场景fine-tuned、仅逐场景优化三类设置不能混为一种训练预算。
- DTU3-view:本文18.89并非最高PSNR,PixelNeRF-ft18.95略高;MVSNeRF SSIM .769 高于本文 .745。本文 LPIPS .190、Average .112 优于表中对照,但不是每项第一。
- DTU6/9:本文PSNR22.20/24.93,Average .071/.047,整体领先。相较mip-NeRF的16.54/23.58,增益为5.66/1.35dB,稀疏输入越少收益越大。
- LLFF3:本文PSNR19.08、SSIM .587、Average .146更优,但MVSNeRF-ft LPIPS .327 优于本文 .336。正文“best across scenarios”应理解整体,而非所有单指标无例外。
- LLFF6/9:本文23.10/24.86,mip-NeRF20.87/24.26;增益2.23/.60dB。三视图增益4.46dB更大,符合定位。
- 条件模型在DTU预训练后直接用于LLFF往往较差,支持domain-shift风险,但不能据此否定所有conditional NeRF或后续更大规模训练。


Figure6/7 对应 DTU/LLFF 的3/6/9-view视觉比较,全部面板保留。mip-NeRF、DietNeRF在极少视图时可产生错误几何和浮层;conditional模型可能边缘模糊。本文改善来自更合理约束,不意味着每个未知区域都恢复真实内容。
基线训练如何被加强
PixelNeRF 原始只用3输入训练、可变数量评价;作者为6/9重新训练,避免拿不匹配输入数量的弱基线比较。SRF也按3/6/9各训练一个;MVSNeRF使用官方预训练模型。条件模型再用测试场景RGB fine-tuning,但不同方法采用调过的合理步数/学习率,不是机械保持相同步数。
mip-NeRF与重新实现的DietNeRF均训练250K steps,LR5×10⁻⁴→5×10⁻⁵;RegNeRF更高LR、退火和梯度裁剪,500 pixel epochs。于是最终对比既包含正则,也包含更有效优化课程;Table3的消融比整体跨方法差异更能隔离组件作用。
10 · 补充材料全部表格与数值冲突
补充 Table S1 · PixelNeRF重新训练;DTU对象级评价
| Method | PSNR ↑ · 6-view | PSNR ↑ · 9-view | SSIM ↑ · 6-view | SSIM ↑ · 9-view | LPIPS ↓ · 6-view | LPIPS ↓ · 9-view | Average ↓ · 6-view | Average ↓ · 9-view |
|---|---|---|---|---|---|---|---|---|
| PixelNeRF original | 17.470 | 17.715 | 0.712 | 0.724 | 0.263 | 0.257 | 0.137 | 0.132 |
| PixelNeRF retrained | 19.110 | 20.400 | 0.745 | 0.768 | 0.232 | 0.220 | 0.115 | 0.100 |
补充材料原 Table 1,全部方法与指标重建;小数统一三位,仅补零。官方来源
PixelNeRF6/9重新训练后PSNR19.110/20.400,对原17.470/17.715,收益1.640/2.685dB。这是调整基线输入数量的重要证据。
补充 Table S2 · PixelNeRF在DTU上的fine-tuning
| Method | PSNR ↑ · 3-view | PSNR ↑ · 6-view | PSNR ↑ · 9-view | SSIM ↑ · 3-view | SSIM ↑ · 6-view | SSIM ↑ · 9-view | LPIPS ↓ · 3-view | LPIPS ↓ · 6-view | LPIPS ↓ · 9-view | Average ↓ · 3-view | Average ↓ · 6-view | Average ↓ · 9-view |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| PixelNeRF original | 16.820 | 19.110 | 20.400 | 0.695 | 0.745 | 0.768 | 0.270 | 0.232 | 0.220 | 0.147 | 0.115 | 0.100 |
| PixelNeRF ft long | 18.851 | 18.253 | 19.850 | 0.713 | 0.714 | 0.779 | 0.262 | 0.242 | 0.190 | 0.126 | 0.132 | 0.104 |
| PixelNeRF ft optimized | 18.945 | 18.699 | 21.831 | 0.710 | 0.720 | 0.781 | 0.269 | 0.237 | 0.203 | 0.125 | 0.125 | 0.090 |
补充材料原 Table 2,全部方法与指标重建;小数统一三位,仅补零。官方来源
补充 Table S3 · PixelNeRF在LLFF上的fine-tuning
| Method | PSNR ↑ · 3-view | PSNR ↑ · 6-view | PSNR ↑ · 9-view | SSIM ↑ · 3-view | SSIM ↑ · 6-view | SSIM ↑ · 9-view | LPIPS ↓ · 3-view | LPIPS ↓ · 6-view | LPIPS ↓ · 9-view | Average ↓ · 3-view | Average ↓ · 6-view | Average ↓ · 9-view |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| PixelNeRF original | 7.927 | 8.735 | 8.613 | 0.272 | 0.280 | 0.274 | 0.682 | 0.676 | 0.665 | 0.461 | 0.433 | 0.432 |
| PixelNeRF ft long | 14.828 | 14.752 | 18.174 | 0.380 | 0.418 | 0.520 | 0.546 | 0.527 | 0.425 | 0.253 | 0.253 | 0.176 |
| PixelNeRF ft optimized | 16.171 | 17.034 | 18.916 | 0.438 | 0.473 | 0.535 | 0.512 | 0.477 | 0.430 | 0.217 | 0.196 | 0.163 |
补充材料原 Table 3,全部方法与指标重建;小数统一三位,仅补零。官方来源
PixelNeRF与RegNeRF等步数长程优化会过拟合,最终选20K-step fine-tuning。版本/源内冲突:主v1 Table1 的DTU6-view PixelNeRF-ft为20.56/.753/.223/.104;官方supp Table2的optimized对应18.699/.720/.237/.125。这不是四舍五入差异。本页保留各自原值,不选一个静默覆盖;可能来自修订或报告不一致,现有证据不足以确定原因。
补充 Table S4 · MVSNeRF在LLFF上的fine-tuning课程
| Method | PSNR ↑ · 3-view | PSNR ↑ · 6-view | PSNR ↑ · 9-view | SSIM ↑ · 3-view | SSIM ↑ · 6-view | SSIM ↑ · 9-view | LPIPS ↓ · 3-view | LPIPS ↓ · 6-view | LPIPS ↓ · 9-view | Average ↓ · 3-view | Average ↓ · 6-view | Average ↓ · 9-view |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| MVSNeRF Official Curriculum | 16.049 | 17.329 | 17.055 | 0.456 | 0.544 | 0.554 | 0.452 | 0.374 | 0.376 | 0.208 | 0.175 | 0.177 |
| MVSNeRF Improved Curriculum 1 | 17.652 | 19.694 | 20.089 | 0.589 | 0.654 | 0.667 | 0.329 | 0.280 | 0.272 | 0.160 | 0.128 | 0.120 |
| MVSNeRF Improved Curriculum 2 | 17.875 | 19.986 | 20.466 | 0.584 | 0.660 | 0.695 | 0.327 | 0.264 | 0.244 | 0.157 | 0.122 | 0.111 |
补充材料原 Table 4,全部方法与指标重建;小数统一三位,仅补零。官方来源
MVSNeRF在LLFF降低fine-tune学习率到10⁻⁵与10⁻⁶都改善。Improved Curriculum2对应主表fine-tuned数值;没有将原official curriculum的低分冒充最好结果。
补充 Table S5 · DietNeRF在Blender上的重实现验证
| Method | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|
| DietNeRF | 23.147 | 0.866 | 0.109 |
| DietNeRF MSE ft | 23.591 | 0.874 | 0.097 |
| DietNeRF our implementation | 24.345 | 0.880 | 0.100 |
补充材料原 Table 5,全部方法与指标重建;小数统一三位,仅补零。官方来源
DietNeRF重实现用mip-NeRF底座,在Blender PSNR24.345、SSIM .880优于原23.147/.866;但LPIPS .100仍略差于原文带MSE fine-tune版本的 .097。因此“重实现更强”也需按指标说明。
补充 Table S6 · DTU全图评价;与主文对象masked表分开
| Method | PSNR ↑ · 3-view | PSNR ↑ · 6-view | PSNR ↑ · 9-view | SSIM ↑ · 3-view | SSIM ↑ · 6-view | SSIM ↑ · 9-view | LPIPS ↓ · 3-view | LPIPS ↓ · 6-view | LPIPS ↓ · 9-view | Average ↓ · 3-view | Average ↓ · 6-view | Average ↓ · 9-view |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SRF · DTU pretrained | 15.840 | 17.770 | 18.560 | 0.532 | 0.616 | 0.652 | 0.482 | 0.401 | 0.359 | 0.207 | 0.162 | 0.145 |
| PixelNeRF · DTU pretrained | 18.740 | 21.020 | 22.230 | 0.618 | 0.684 | 0.714 | 0.401 | 0.340 | 0.323 | 0.154 | 0.119 | 0.105 |
| MVSNeRF · DTU pretrained | 16.330 | 18.260 | 20.320 | 0.602 | 0.695 | 0.735 | 0.385 | 0.321 | 0.280 | 0.184 | 0.146 | 0.114 |
| SRF ft · pretrained + per-scene | 16.060 | 18.690 | 19.970 | 0.550 | 0.657 | 0.678 | 0.431 | 0.353 | 0.325 | 0.196 | 0.143 | 0.125 |
| PixelNeRF ft · pretrained + per-scene | 17.380 | 21.520 | 21.670 | 0.548 | 0.670 | 0.680 | 0.456 | 0.351 | 0.338 | 0.185 | 0.121 | 0.117 |
| MVSNeRF ft · pretrained + per-scene | 16.260 | 18.220 | 20.320 | 0.601 | 0.694 | 0.736 | 0.384 | 0.319 | 0.278 | 0.185 | 0.146 | 0.113 |
| mip-NeRF · per-scene | 7.640 | 14.330 | 20.710 | 0.227 | 0.568 | 0.799 | 0.655 | 0.394 | 0.209 | 0.485 | 0.231 | 0.098 |
| DietNeRF · per-scene | 10.010 | 18.700 | 22.160 | 0.354 | 0.668 | 0.740 | 0.574 | 0.336 | 0.277 | 0.383 | 0.149 | 0.098 |
| Ours · per-scene | 15.330 | 19.100 | 22.300 | 0.621 | 0.757 | 0.823 | 0.341 | 0.233 | 0.184 | 0.189 | 0.118 | 0.079 |
补充材料原 Table 6,全部方法与指标重建;小数统一三位,仅补零。官方来源
DTU full-image完整表显示目标背景偏差真实存在:3-view本文PSNR15.33,而PixelNeRF18.74;6-view本文19.10,而PixelNeRF-ft21.52;9-view本文22.30略高于PixelNeRF22.23。主文对象masked结果与本表不可交叉挑最好值拼成一个新表。
11 · 消融与五种替代几何正则
固定 v1 原 Table 3
| PSNR \(\uparrow\) | SSIM \(\uparrow\) | LPIPS \(\downarrow\) | Average \(\downarrow\) | |
|---|---|---|---|---|
| w/o Scene Space Ann. | 10.17 | 0.613 | 0.332 | 0.291 |
| w/o Geometry Reg. | 14.34 | 0.689 | 0.246 | 0.188 |
| w/o Appearance Reg. | 18.34 | 0.742 | 0.191 | 0.117 |
| Ours | 18.89 | 0.745 | 0.190 | 0.112 |
固定 v1 原 Table 4
| PSNR \(\uparrow\) | SSIM \(\uparrow\) | LPIPS \(\downarrow\) | Average \(\downarrow\) | |
|---|---|---|---|---|
| Opacity Reg. [30] | 11.07 | 0.617 | 0.309 | 0.268 |
| Ray Density Entropy Reg. | 13.93 | 0.680 | 0.254 | 0.198 |
| Normal Smooth. Reg. [40] | 14.22 | 0.683 | 0.251 | 0.193 |
| Density Surface Reg. | 14.71 | 0.687 | 0.247 | 0.184 |
| Sparsity Reg. [17] | 16.77 | 0.711 | 0.221 | 0.145 |
| Depth Smooth. Reg. (Ours) | 18.89 | 0.745 | 0.190 | 0.112 |
DTU3-view完整18.89dB;无退火10.17,差8.72dB;无几何14.34,差4.55dB;无appearance18.34,差.55dB。强证据是早期稳定性与几何约束占主导,appearance贡献较小但一致。不能将多项提升简单相加,组件之间会相互作用。
Supplement S1–S5:替代先验的精确定义
\[\mathcal L_{\mathrm{opacity}} =\sum_{r\in\mathcal R_r}\left[\log\widehat\alpha_\theta(r) +\log(1-\widehat\alpha_\theta(r))\right].\tag{S1}\]最小化该式偏向opacity端点0/1;它不是标准带负号的Bernoulli熵。原式在端点发散,具体epsilon数值保护未给出,不补造。
\[\mathcal L_{\mathrm{RDE}} =-\sum_{r\in\mathcal R_r}\sum_{i=1}^{128} \frac{w_\theta^i}{\delta_i}\log\frac{w_\theta^i}{\delta_i},\quad w_\theta^i=T_i(1-e^{-\sigma_\theta^i\delta_i}).\tag{S2}\]这是原文“ray density entropy”表达;w/δ不是一般归一化离散概率,不能随意替换成−Σwlogw而仍称同一baseline。
\[\mathcal L_{\mathrm{NS}} =\sum_{r\in\mathcal R_r}\|n(x_r)-n(x_r+\epsilon)\|_2^2.\tag{S3}\] \[\mathcal L_{\mathrm{surface}} =\sum_{r\in\mathcal R_r}\sum_{i=1}^{128} [\log v_\theta^i+\log(1-v_\theta^i)],\quad v_\theta^i=1-e^{-\sigma_\theta^i\delta_i}.\tag{S4}\] \[\mathcal L_{\mathrm{sparsity}} =\sum_{r\in\mathcal R_r}\sum_{i=1}^{128} \log\left(1+\frac{(\sigma_\theta^i)^2}{c}\right),\quad c=0.5.\tag{S5}\]原supp同时把surface和sparsity的符号写作LSR,这里用不同下标解释但不改原表。稀疏先验16.77优于前四种,却仍弱于depth smoothness18.89。本文推测整条射线上的监督更稳定;没有单独实验将梯度传播范围与所有loss scale/优化差别完全分离。
12 · 补充图全集、失败与适用范围
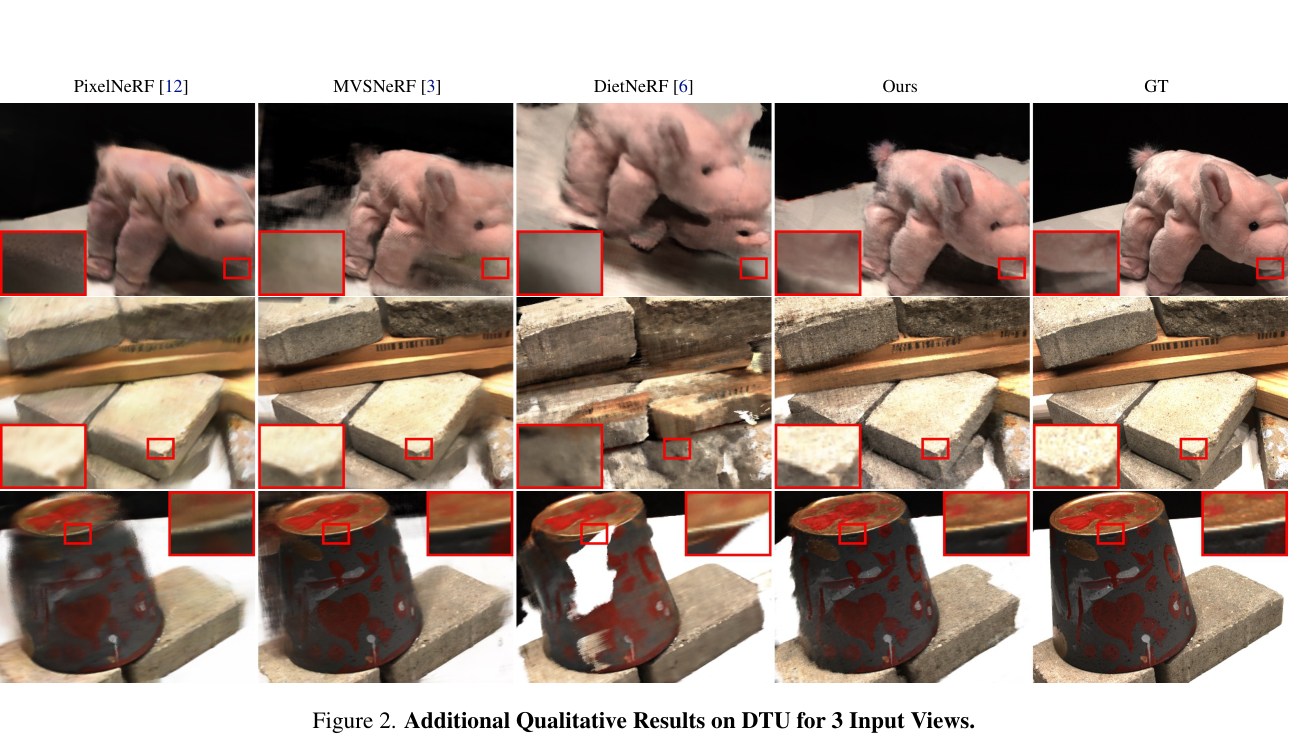
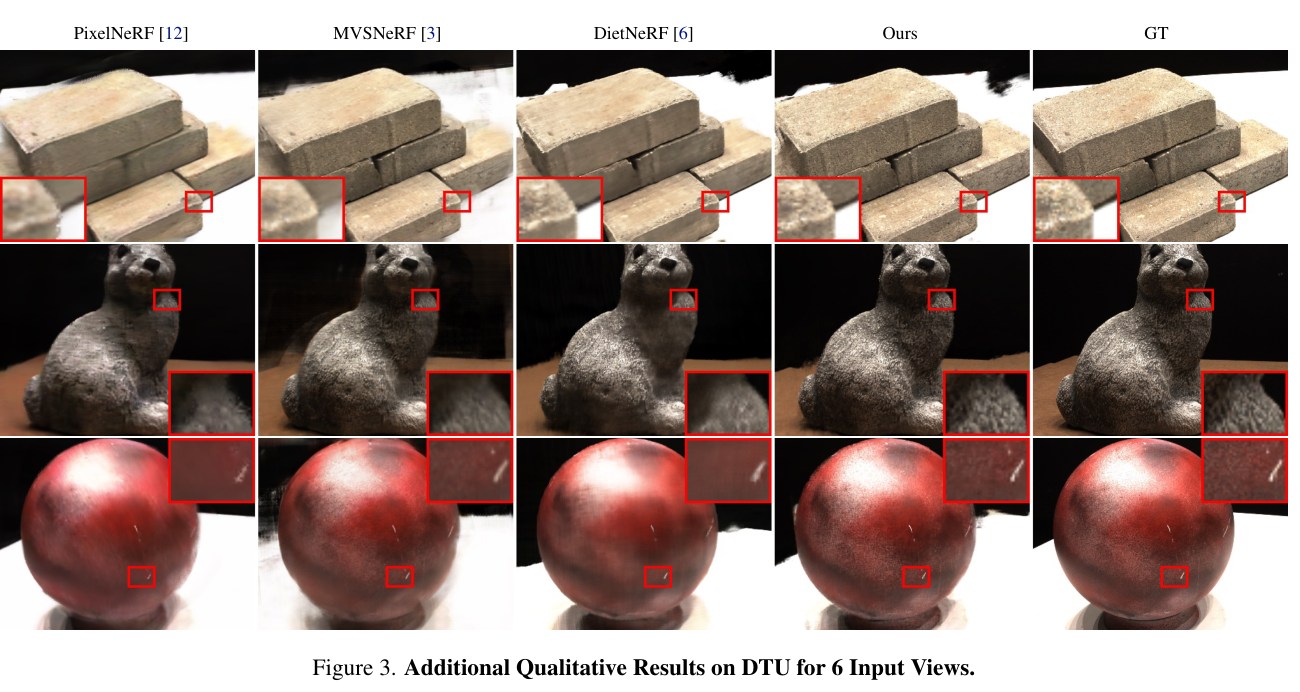
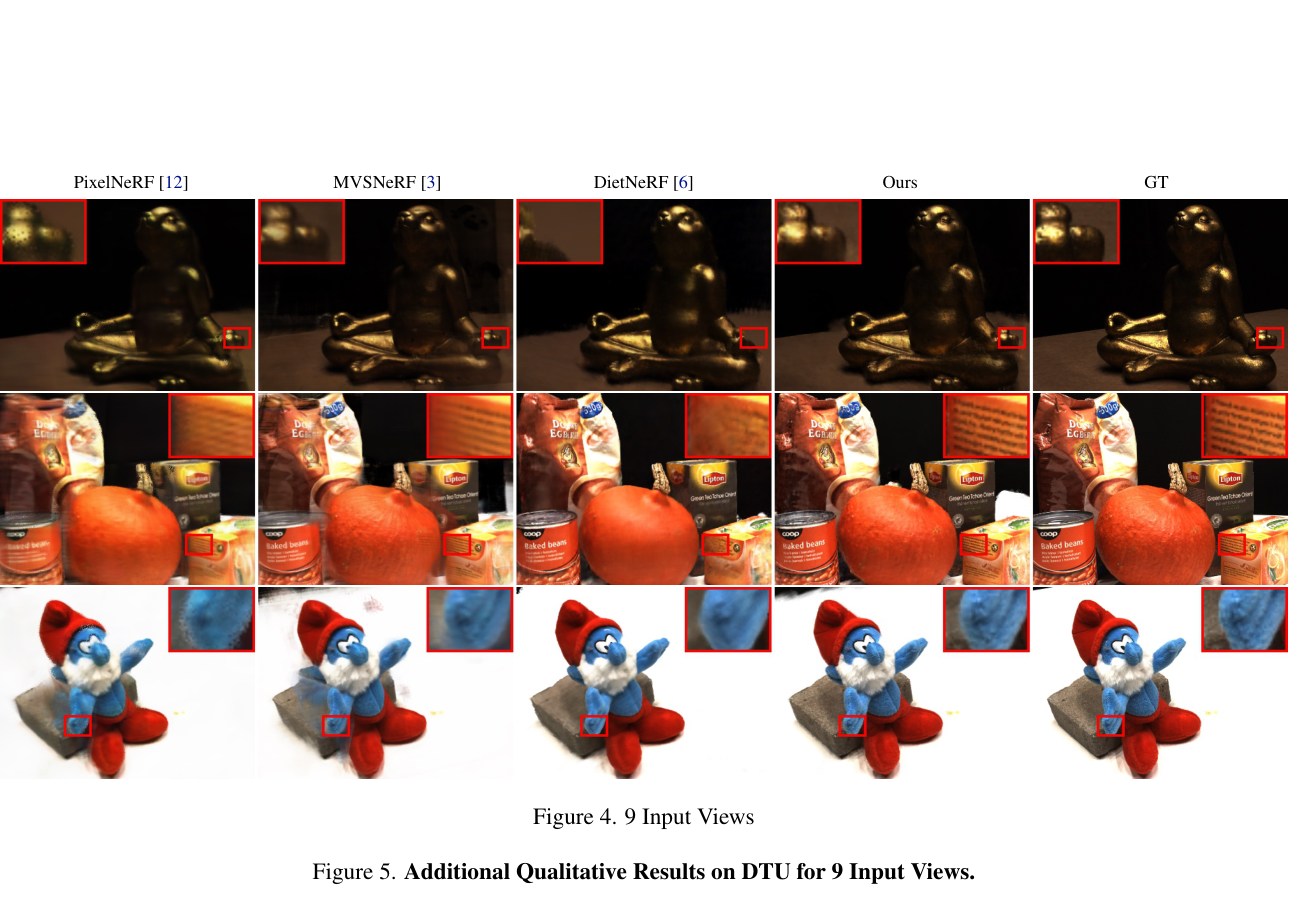
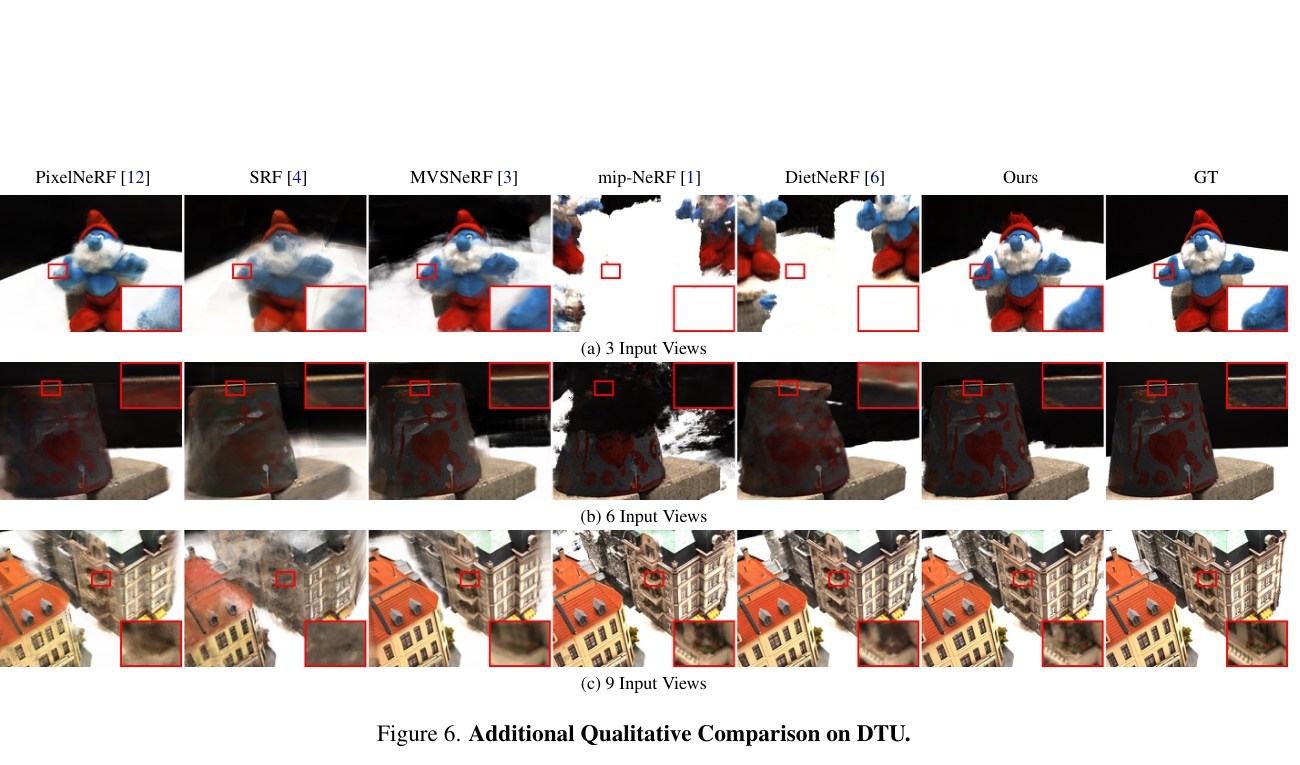
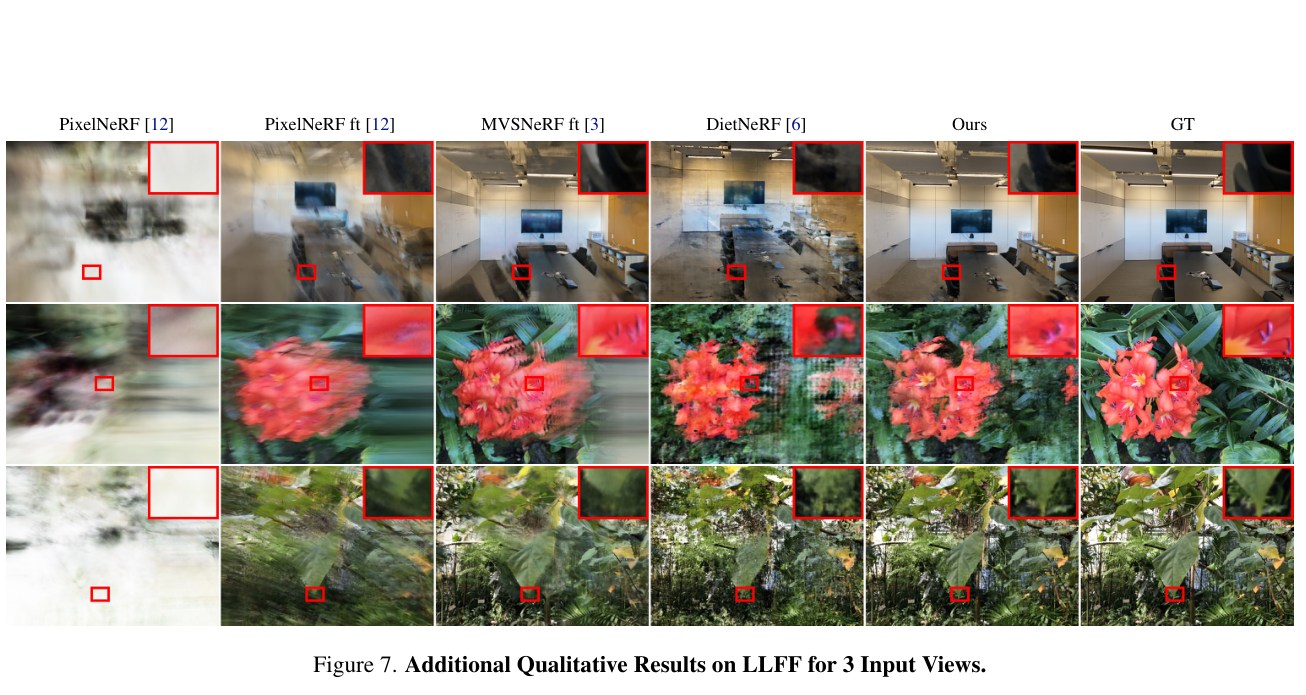
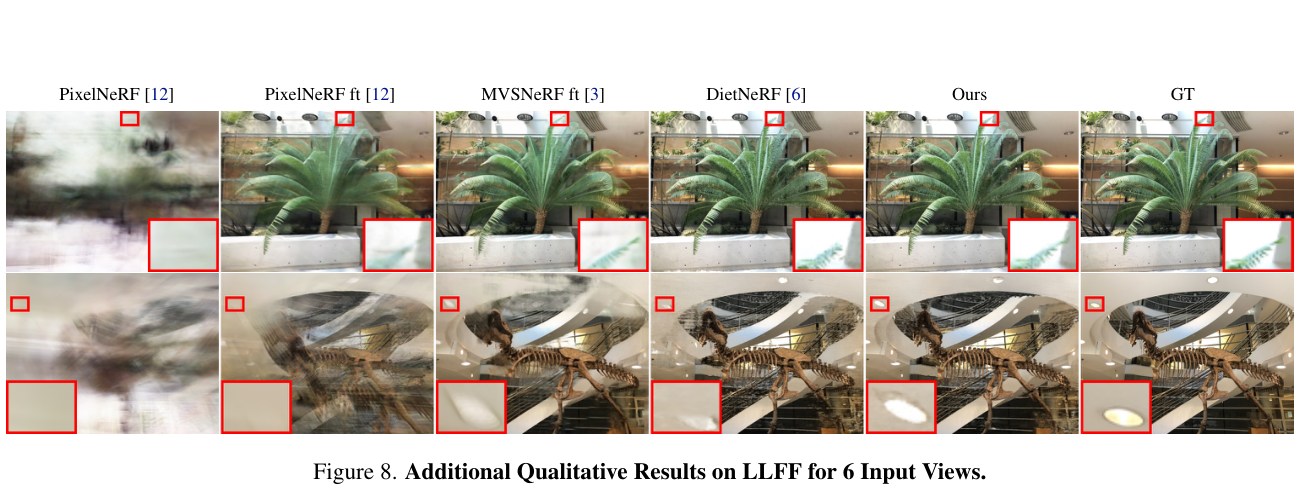
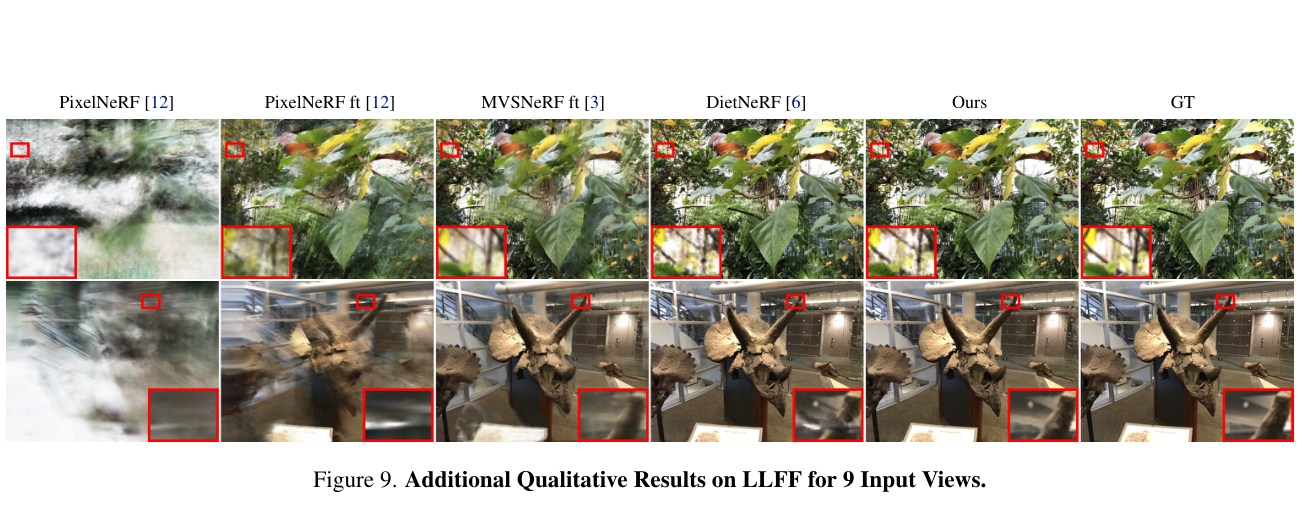
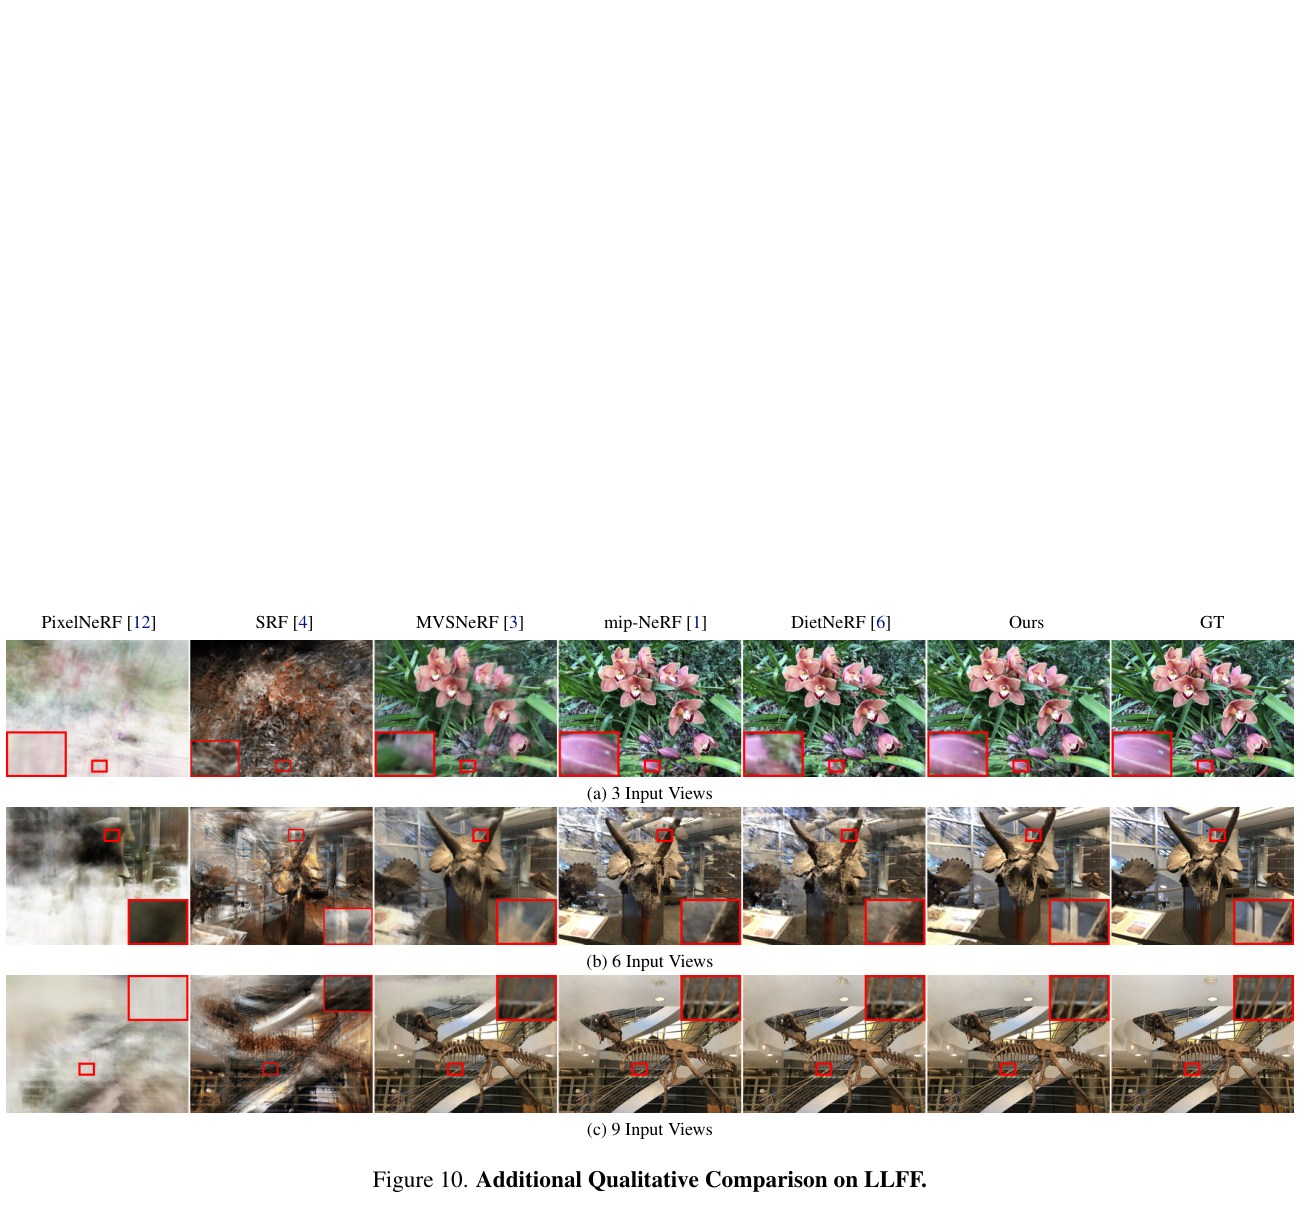
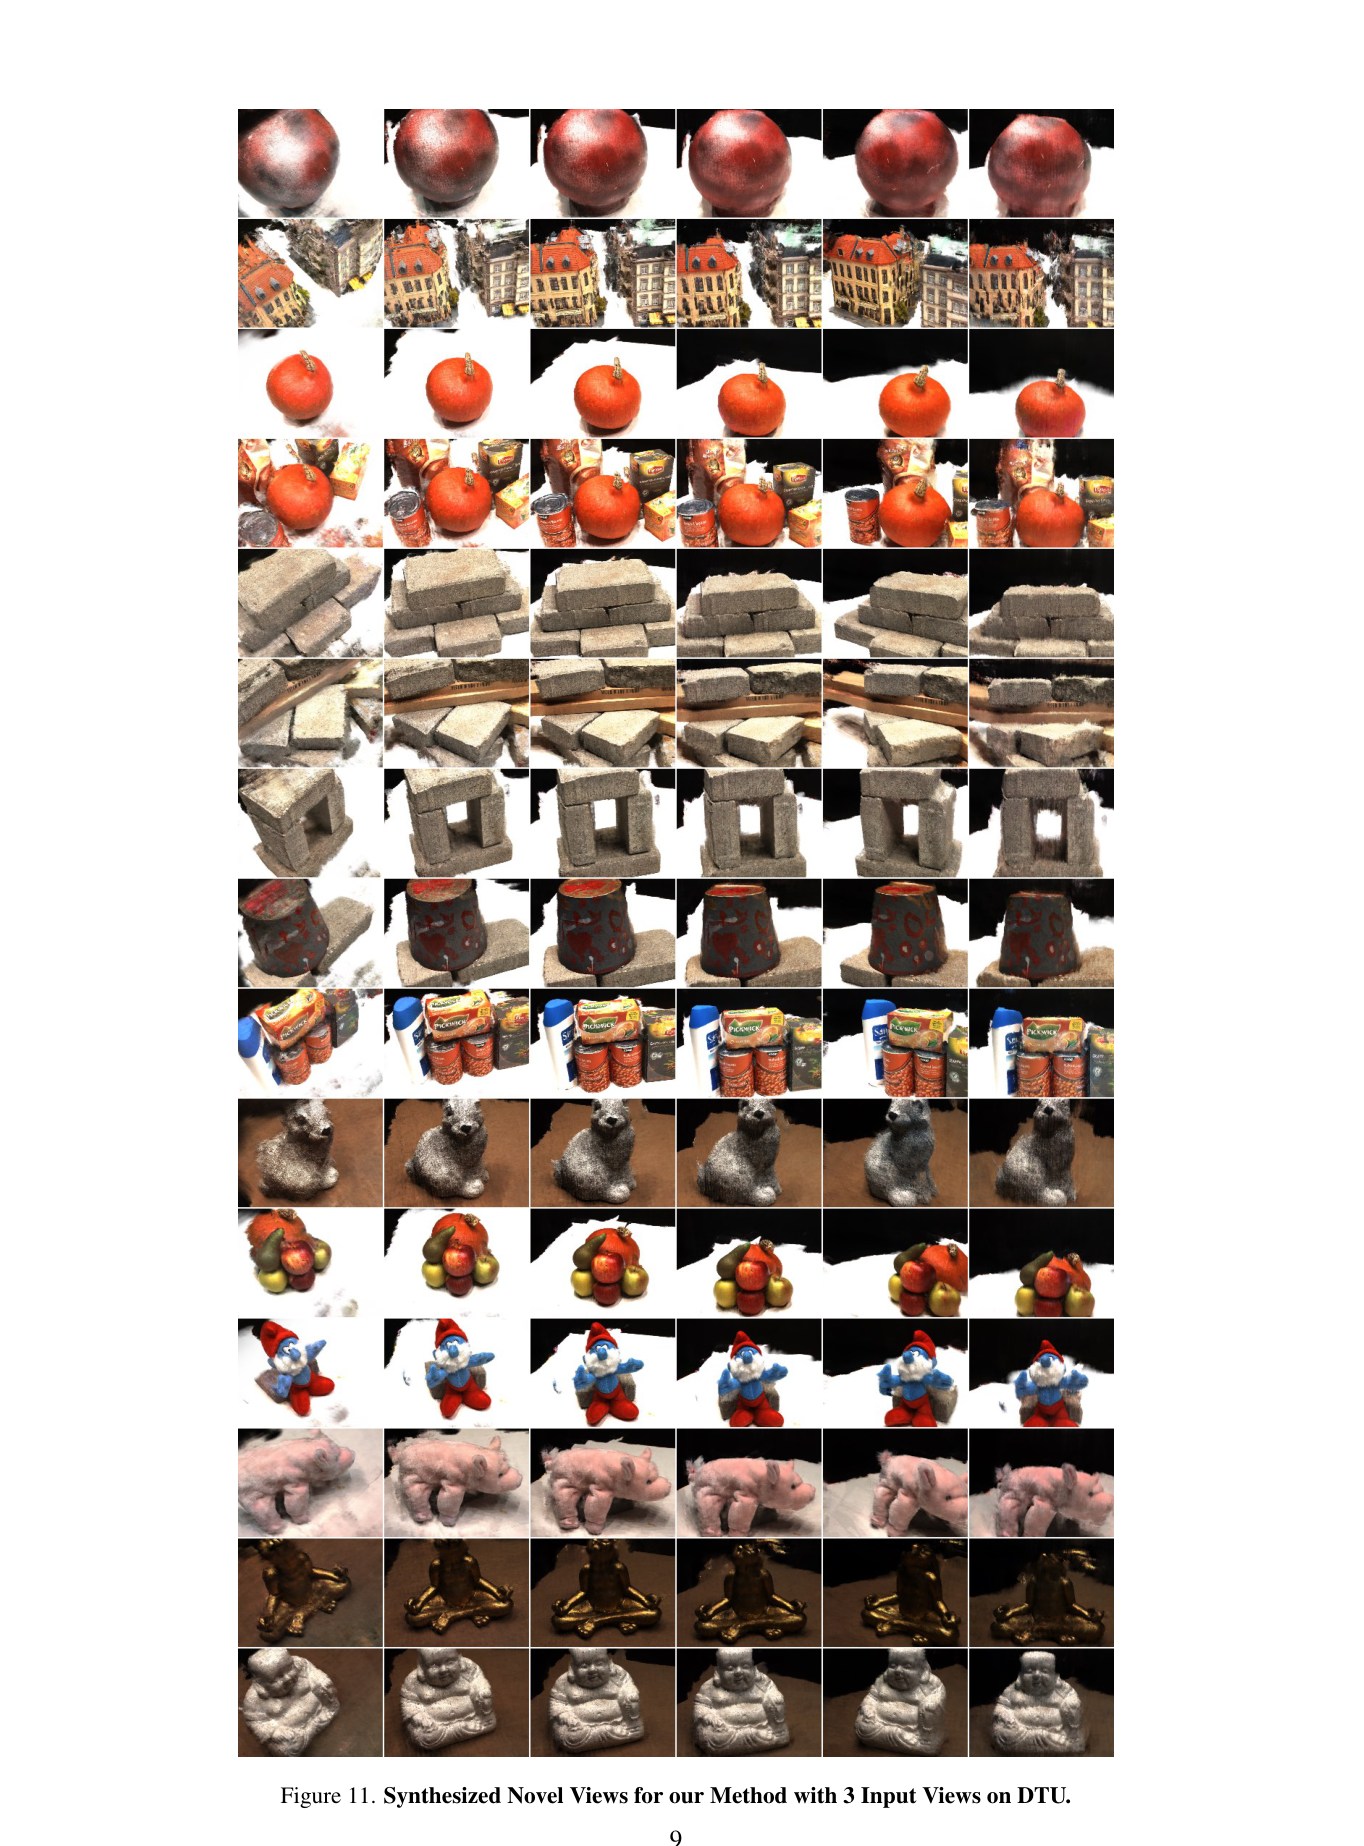
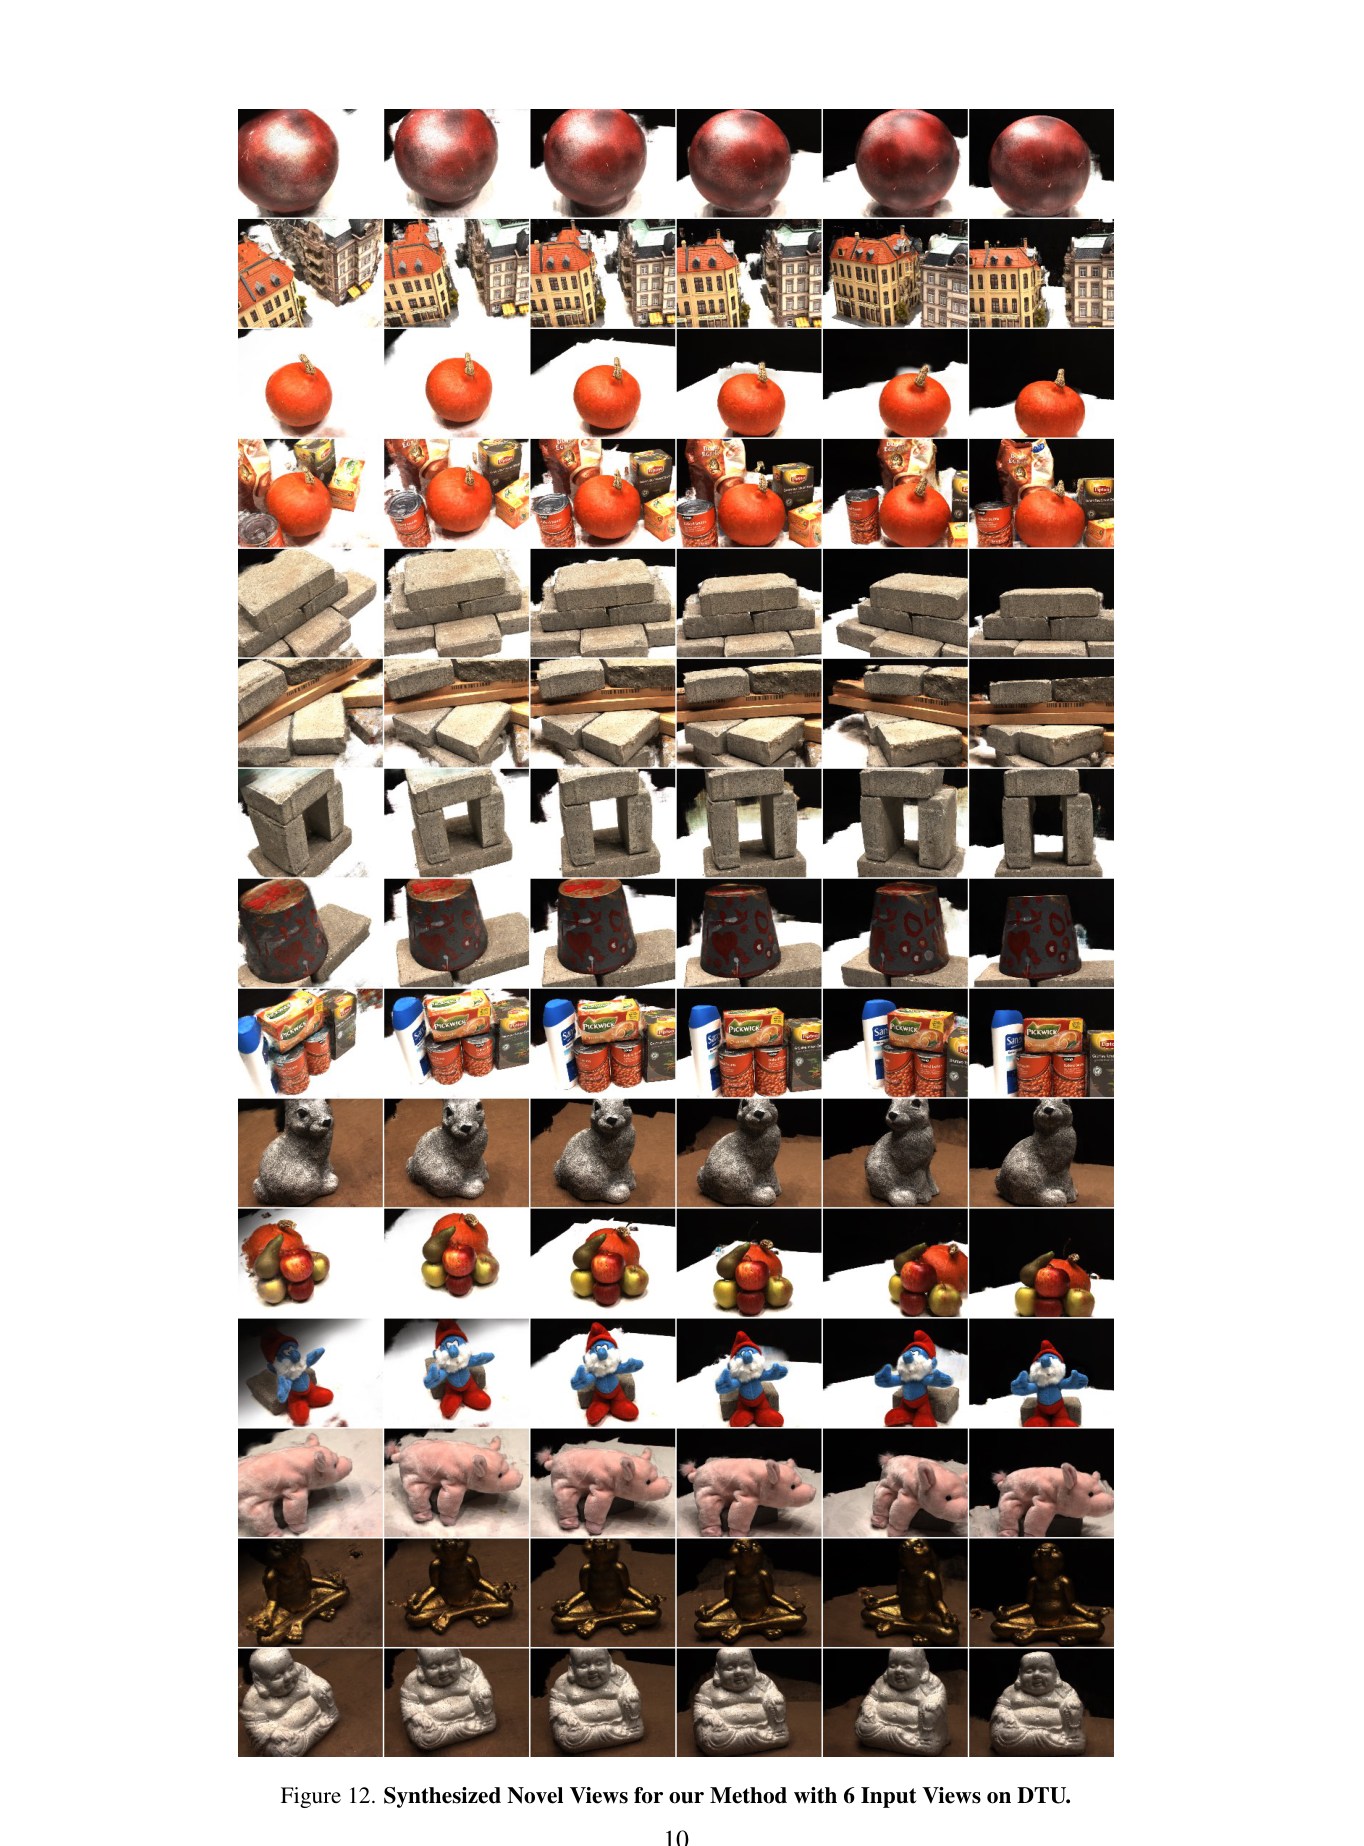
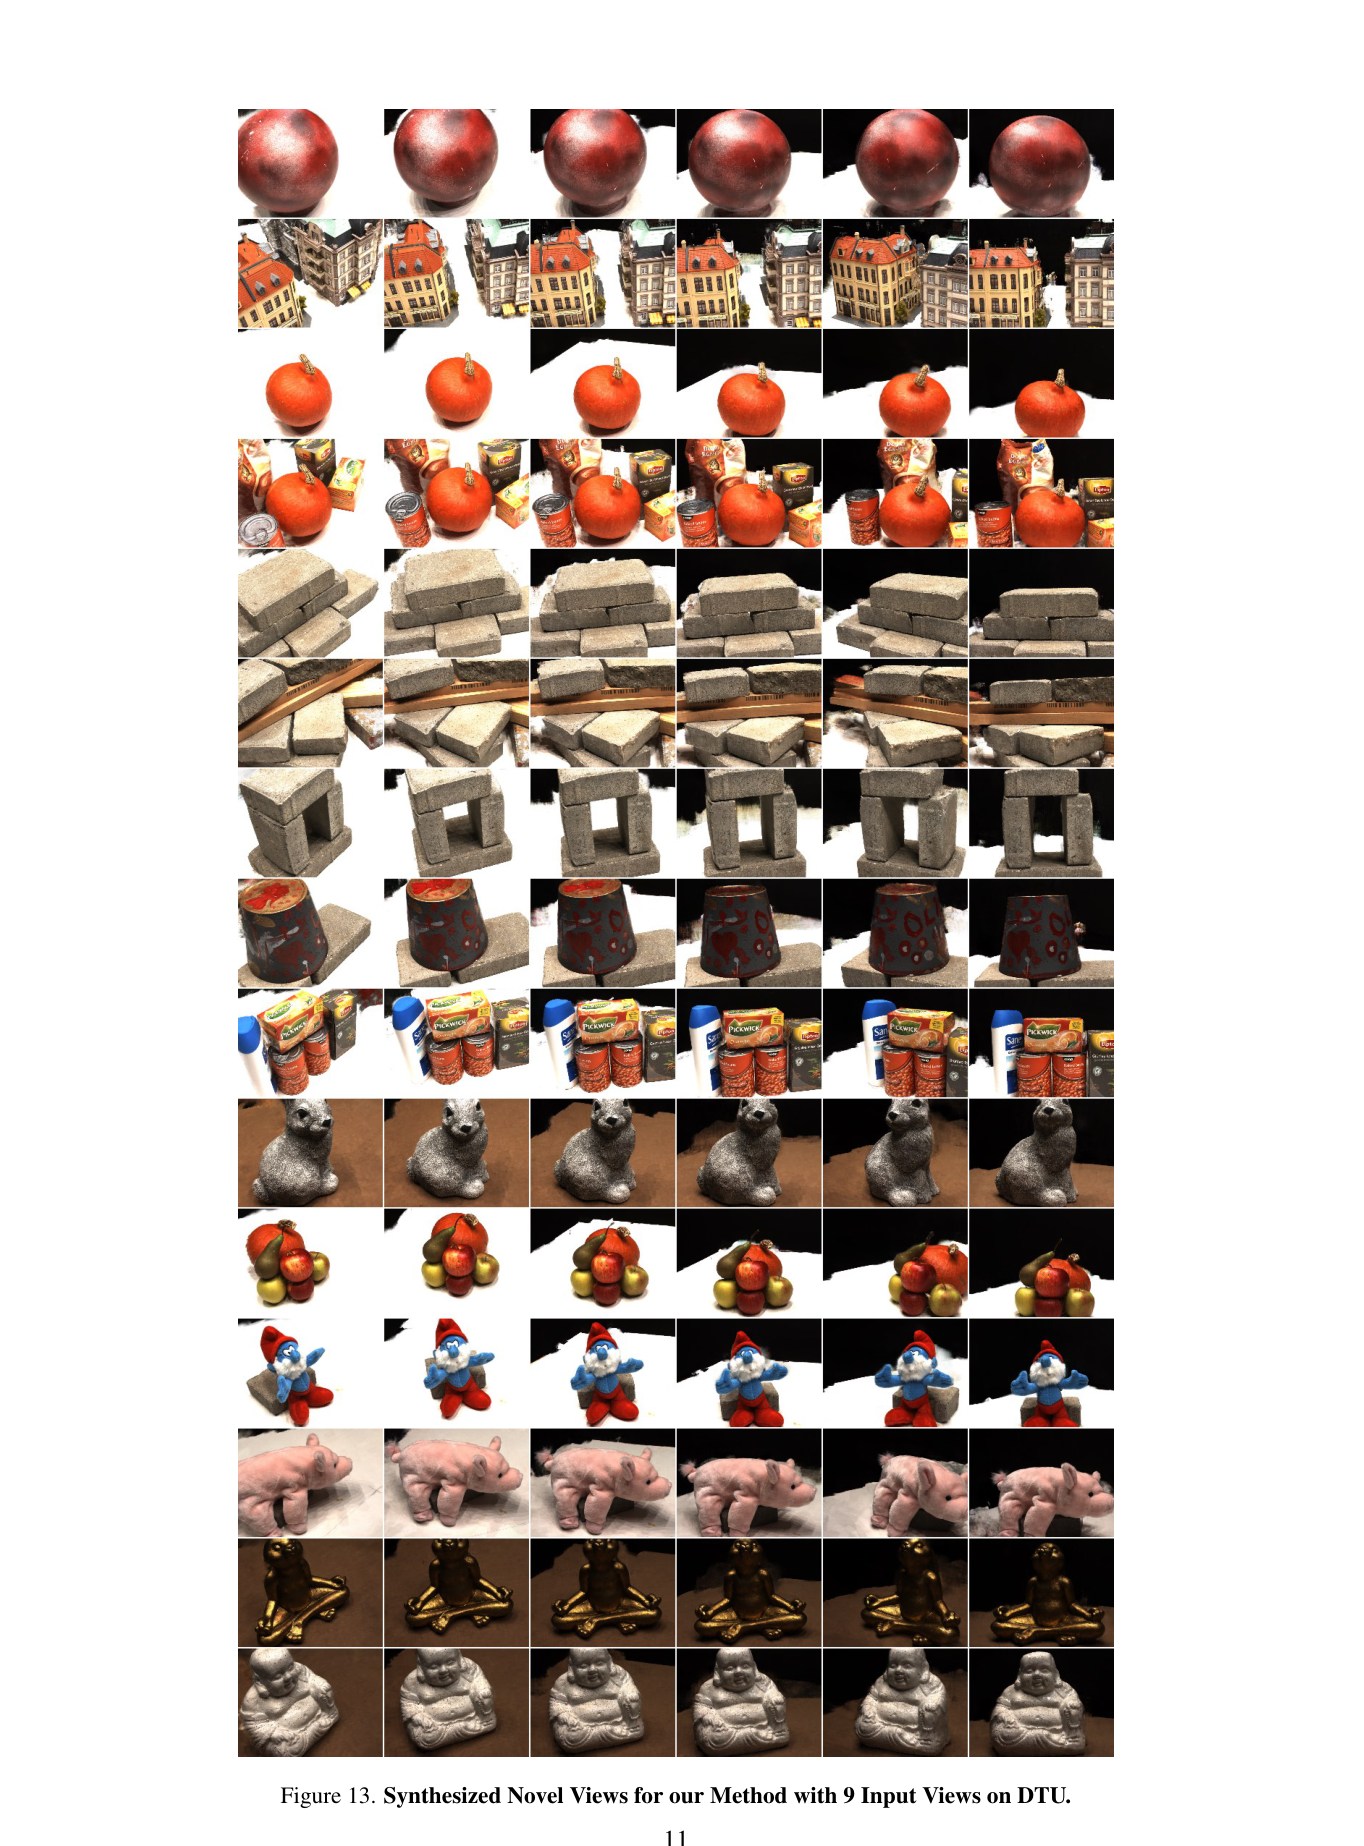
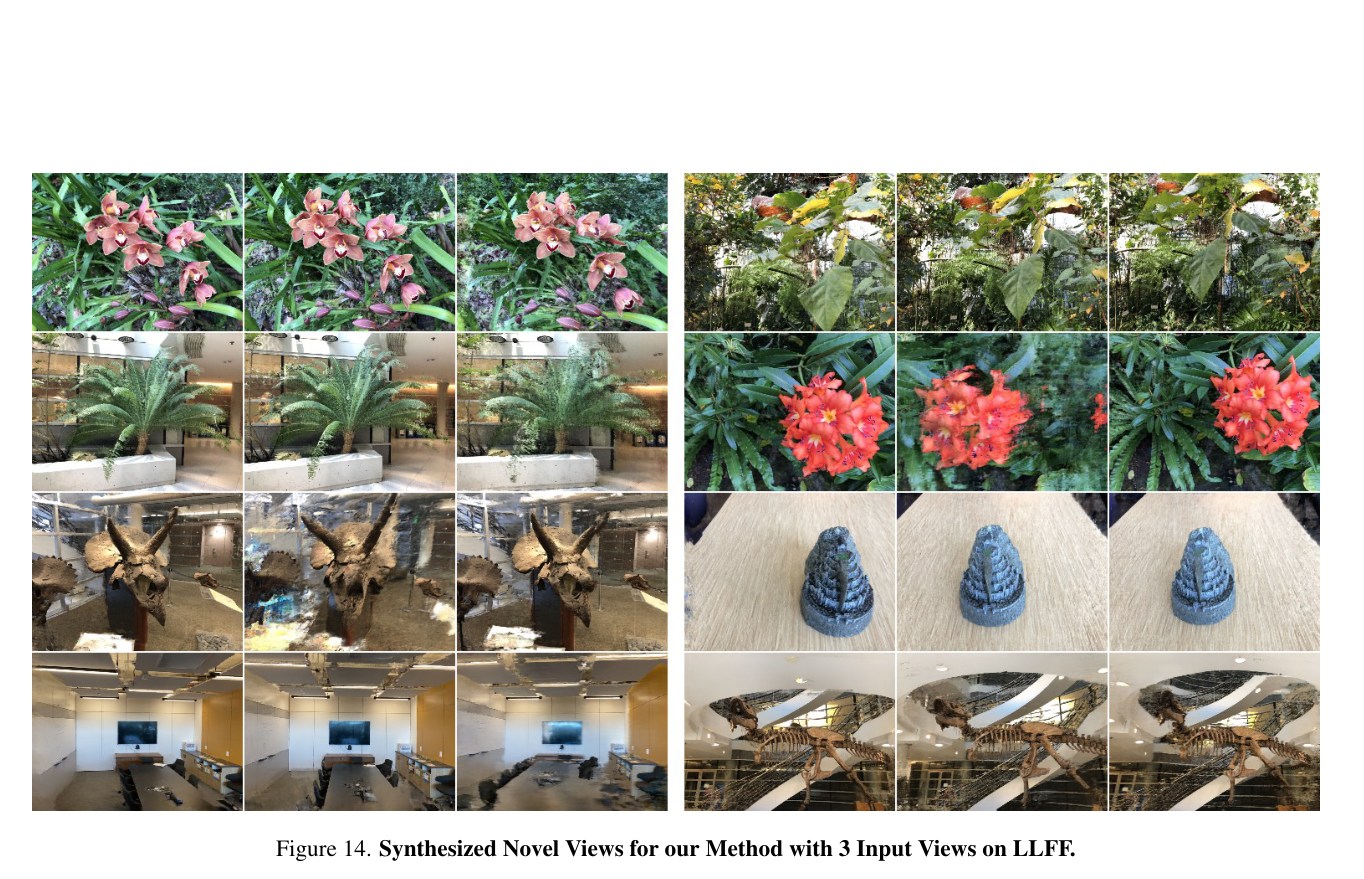
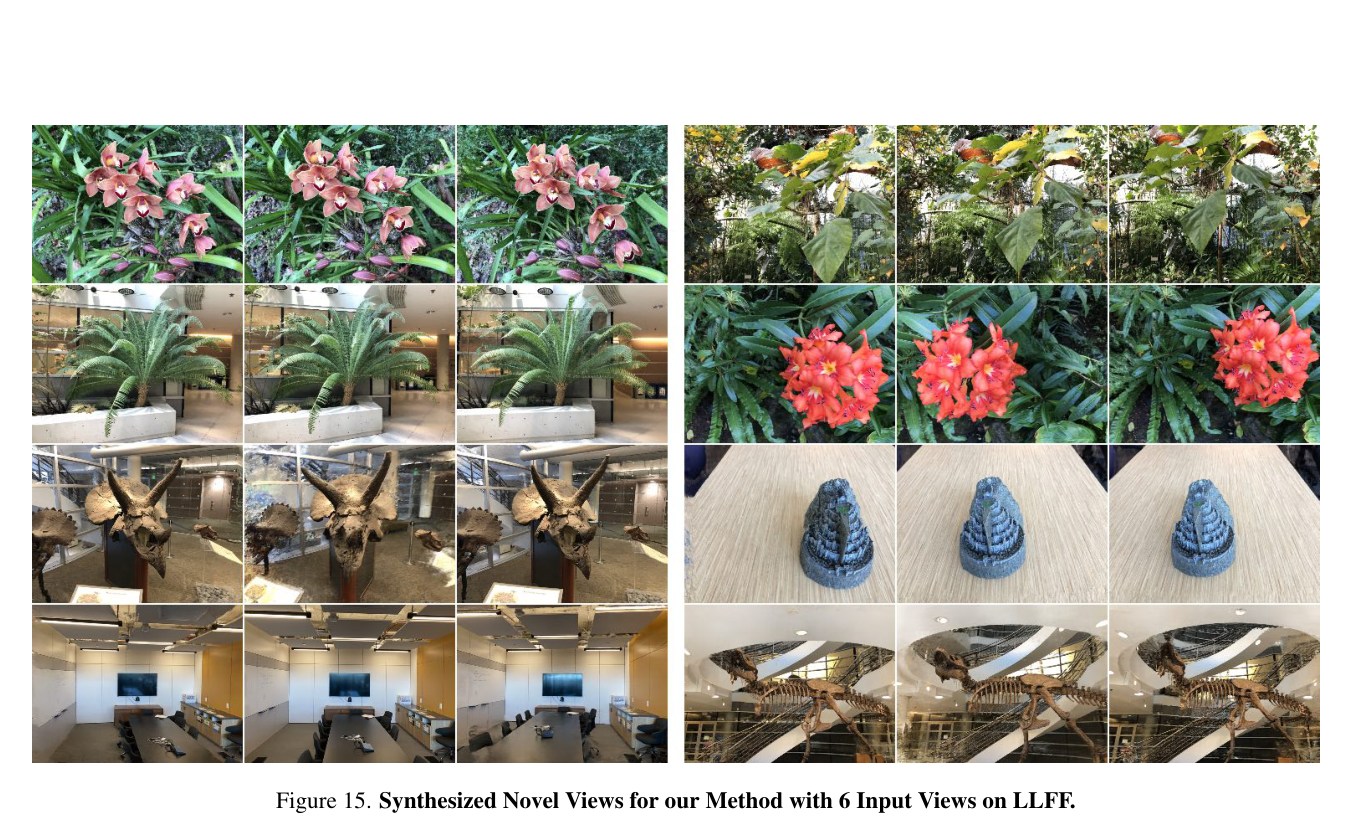
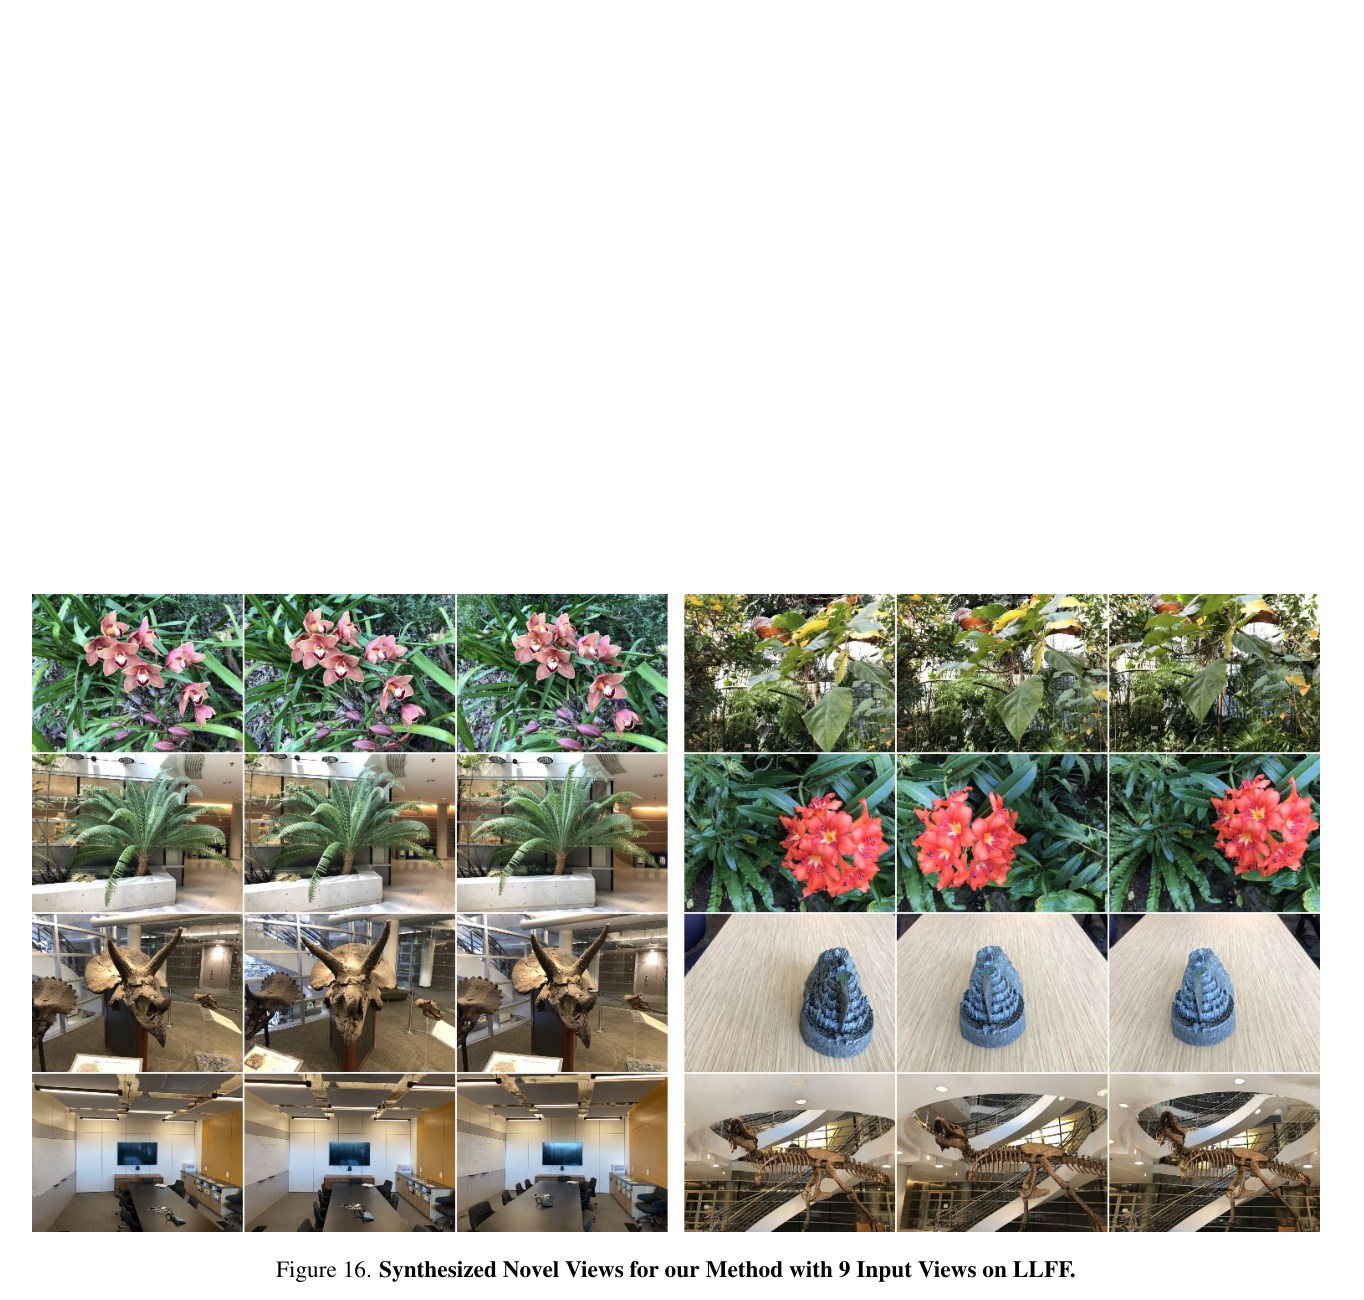
Supplement2/3/4–5为DTU3/6/9-view补充对比;6为多基线组合;7/8/9为LLFF3/6/9-view;10为LLFF组合;11–13为DTU所有场景多视角,14–16为LLFF3/6/9-view。PDF裁图保留所有面板和原编号,不仅摘取单例。它们展示已观察形状的跨视角稳定性,不提供真实几何误差、材质分解或未见物体语义准确性的独立证明。


Figure8承认未观测细几何会模糊,因为模型并不尝试幻觉式补全。平滑先验有利于去除浮层,却可能抹去细杆、尖锐边缘或纹理诱导的真实深度变化;生成式先验与不确定性预测只是作者未来方向,未在本方法验证。
13 · Reviewer:贡献、复现风险与改进路线
值得保留的研究价值
- 把监督从训练相机延伸到虚拟视点,在不增加真实图像采集的情况下收缩退化解空间。
- 显示稀疏NeRF失败不仅是表示能力问题,还与几何先验、采样课程和早期优化路径有关。
- 主文与supp给出masked/full-image、基线重训/调参、几何正则对照,揭示评价目标会改变排序。
- 深度正则简单、可微、可嵌入普通体渲染,推理不增加flow成本。
主要保留意见
- “no pre-training at all”若覆盖完整系统并不准确:appearance需要JFT-trained flow;应限于场景NeRF无需多场景3D预训练。
- 目标相机分布、中心朝向和前向/对象场景假设限制适用范围;pose噪声、动态物体、未知内参没有系统测试。
- 深度平滑是统计偏好,不保证真实几何。视角相关radiance与密度可互相补偿,仍有逆问题不可辨识性。
- Eq.13印刷问题、Eq.11密度项省略、主附表冲突以及公开代码缺模块,均需在复现记录中透明呈现。
- 最新公开源码有可静态定位的LLFF损失/相机循环问题和LPIPS空实现,必须区分历史论文实验与当前release可靠性。
- 没有多seed置信区间;迭代数减少不等于统一硬件的时间、能耗或成本同比下降。
优先补充实验
| 问题 | 控制实验 | 评价 |
|---|---|---|
| 目标相机信息是否关键 | 训练pose限定采样 vs 已知target范围 vs 随机扩大范围 | 内插/外推分开PSNR与几何误差 |
| 平滑是否损伤细节 | 固定、edge-aware、uncertainty-weighted depth prior | 细结构保持、边缘误差、浮层率,不只平均图像指标 |
| 退火曲线差别 | clamp修正 vs 当前线性插值,固定seed与budget | 前512步density分布、梯度峰值、失败率 |
| 外观先验可复现性 | 公开图像集预训练flow、无flow、完整原checkpoint | 质量、色偏、域偏移与训练成本 |
| 代码验证 | 断言虚拟pose数量、非零DS gradient、有限LPIPS | 先单元测试,再小场景端到端复现 |
Supplement还讨论隐私图像未经许可的新视角合成、误导性内容、算力不平等与能耗。部署时应获得输入许可、标注生成视图,不把合成的不可见区域当作事实观测。
14 · 面向程序材质与逆图形的研究延伸
Research Extension,以下均未由RegNeRF证明:最可迁移的是“对未监督的可渲染条件施加结构约束”,而不是直接把RGB NeRF当作材质估计器。radiance field 的颜色包含光照与视角效应,不能直接读取为albedo、roughness或BRDF。
A. 材质图的虚拟光照/视角正则
只有一张材质目标图时,程序可能把高光烘焙进base color,或用不物理纹理匹配像素。可在未观测光照与视角渲染同一候选材质图,约束能量、法线、周期接缝和多尺度外观合理性,类似虚拟视点约束。真实目标图loss与虚拟条件prior必须分开,后者不是新增真值。
\[\mathcal L(G)=d(R(G,\ell_{\mathrm{obs}},v_{\mathrm{obs}}),I^\ast) +\lambda\mathbb E_{\ell,v\sim q} \mathcal C(R(G,\ell,v),G).\]G是程序材质图,R是renderer,q覆盖预计使用的光照/视角范围,C是可验证先验。若使用自然图像flow评估材质render,需要检验其是否偏好物体语义而抹除微表面纹理;更合适的先验可能来自合法材质多光照patch。
B. 程序复杂度与参数范围课程
对应near/far退火,可以先限制高频噪声节点、位移幅度或图深度,稳定低频外观,再逐步释放。这个课程必须写成可测试的实际函数并检查起点/终点,避免类似Eq.13的clamp错误。先验过强会阻止真正复杂材质,应根据残差与不确定性自适应解除。
C. 把“深度平滑”替换为物理结构约束
材质法线不应被无差别平滑,否则磨砂、织物等真实高频结构会消失。可分别约束法线单位长度、height-normal一致性、roughness范围、tile边界和多光照反射一致性,而将频谱统计与局部纹理保留作为独立指标。对象几何边缘和材质微结构不能共用一个盲目的平滑强度。
D. 执行器与失败反馈
NeRF渲染器是可微的;Substance/外部shader编译未必可微。程序图需typed DAG检查、端口兼容、无循环、参数合法与可执行预览。若不能端到端反传,使用合法候选搜索、渲染重排或可微代理,并报告真实renderer调用数;不能声称一个loss公式自动解决离散拓扑优化。
| 最小可行验证 | 对照 | 成功标准 |
|---|---|---|
| 固定图拓扑的单图反演 | 仅观察图loss vs加虚拟光照prior | 换光照误差更低,同时观察图拟合和多样性不明显下降 |
| 可控频率课程 | 全范围训练 vs线性释放 vs自适应释放 | 失败率、收敛时间、细节频谱,避免仅看早期loss |
| 多尺度patch prior | 自然图像flow vs材质专用prior vs无prior | 色偏、周期性、真实高频保存与OOD材质表现 |
| 不确定性视点采样 | 均匀q vs高不确定条件 | 相同执行预算下泛化更好,置信度经过校准 |
15 · 来源、版本与完成状态
- 固定v1 PDF:11页,公式1–13、主表1–4、主图1–8,保持原指标。
- 同版本HTML:定位图像与重建主表,关键数字回查固定PDF。
- 官方作者补充材料:独立14页,全部表1–6、图1–16和补充公式1–5,来源版本与固定主文分开。
- 项目主页与官方代码:CVPR2022 oral、release缺少flow、当前实现设置与静态问题;未观看视频、运行训练或复测指标。
HTML、全量Markdown新增内容、原笔记字节前缀保留的合并候选及证据记录均为下载验收产物。原year2021描述预印本首发,出版venue/year2022仅列更新建议,不修改原始笔记。浏览器MathJax、远程图片加载与响应式布局验收按用户要求延后;没有发布、修改vault或People。