七类知识
Empirical、Artifact、Methodological、Theoretical、Dataset、Survey、Opinion。它们可以共同出现在一篇论文里,不构成从低到高的排名。
从知识产物、证据标准到研究定位:七类框架、CHI 历史表格与多标签统计的完整精读
Jacob O. Wobbrock · Julie A. Kientz · University of Washington
一篇 HCI 论文的贡献,不等于它做过哪些工作,而是完成这些工作之后,别人获得了什么此前没有的、可以理解和利用的知识。Wobbrock 与 Kientz 用七种知识形态组织这个问题,并为不同产物配上不同的评价依据。
Empirical、Artifact、Methodological、Theoretical、Dataset、Survey、Opinion。它们可以共同出现在一篇论文里,不构成从低到高的排名。
CHI 2016 将 Empirical 拆成「研究系统使用」与「研究人」两类,形成八个可选标签;七与八描述的是不同层次。
系统、输入技术和设计愿景同属 Artifact,但不必使用同一套评价。统计显著、做过用户研究或上传代码,都不是自动成立的贡献证明。
Paper Verified:正式标题为 Research Contributions in Human-Computer Interaction,作者按顺序为 Jacob O. Wobbrock、Julie A. Kientz,均署名 University of Washington。发表于 Interactions 23(3),2016 年 5–6 月,刊页 38–44,DOI 10.1145/2907069。用户原文件共 7 页,第一页是开篇插图,正文从刊页 39 开始;没有额外附录,也没有机器学习模型、训练实验或消融表。
版本核验:作者网站的 2016 正式文章 PDF与用户原 PDF 的七页提取文本逐页完全相同;文件字节不同,原文件及已有标注保持原样。旧笔记的 Wobbrock-2012.pdf是另一份单作者、6 页的未发表白皮书 Seven Research Contributions in HCI,当前可下载版注明最后更新于 2015-11-06。不能用这个链接替代双作者 2016 文章的书目信息。
Our Interpretation:本文最实用的作用是让作者把「贡献陈述」与「证据责任」连接起来,让评审先理解工作的知识产物,再判断验证是否充分。它不是投稿成功预测器,也没有证明七类穷尽所有未来 HCI 研究。
阅读基准:用户原 PDF 全部 7 页及参考文献;原图 1–2、原表 1–3 全部保留。以下标记分别表示 Paper Verified(原文事实)、Author Claim(作者主张)、Our Interpretation(分析判断)、Research Extension(尚未验证的研究建议)。
HCI 的参与者来自计算机科学、工程、设计、心理学、社会科学等传统。同样叫「好研究」,不同传统可能重视发现、可运行系统、理论解释、研究方法或设计表达。如果把一种传统的验证方式当成统一门槛,就容易把有价值的工作排除在外;如果只强调多元,又可能使评价缺乏清楚的依据。本文尝试在开放性与可判断性之间建立一张概念地图。
因此,本文的「方法」应理解为概念分析、历史材料整理与会议元数据描述,而非训练一个分类模型。文章没有报告系统检索协议、双人编码一致性实验、随机对照教学研究或分类法有效性的受控检验。CHI 投稿系统采用这套标签,是实际使用的证据,但不是分类互斥、完备或能改善评审质量的独立证明。
| 层次 | 例子 | 应追问什么 |
|---|---|---|
| 研究活动 | 访谈、写代码、训练网络、收集数据、做设计工作坊 | 这些活动最终产生了什么新知识? |
| 传播载体 | 论文、视频、演示、原型、数据文件 | 他人通过它理解或复用的内容是什么? |
| 研究贡献 | 新的行为发现、交互可能性、可靠方法、解释框架、代表性资源 | 相对于已有知识,它新增什么;凭什么相信;适用边界在哪? |
| 贡献价值 | 重要性、可信性、启发性、可迁移性、实际用途 | 这项新知识为什么值得研究共同体保留和进一步使用? |
Our Interpretation:一项用户研究可能只是为系统主张提供验证,也可能同时得到值得单独保留的人类行为发现。反过来,代码量再大,如果没有解释新能力、新机制或可迁移知识,也不能仅凭工程投入确认研究贡献。判断单位是主张和知识增量,而不是论文里出现过哪些材料。
下表按原文顺序保留全部七类,并把定义、评价依据与常见误判并列。最后一列是本页的操作性解读,不是原文给出的机械评分规则。
| 类型 | 知识产物 | 原文核心评价依据 | 容易混淆之处与判断边界 |
|---|---|---|---|
| Empirical 实证 | 经观察和数据收集得到的新发现 | 发现的重要性;产生发现的方法是否严谨、精确,是否受到混淆因素影响 | 不等于定量实验;访谈、民族志、日记、日志等同样可能形成实证贡献 |
| Artifact 交互制品 | 通过系统、架构、工具、技术、草图或愿景揭示的新可能性 | 依据制品类型:系统看能力与实现;输入技术看人类表现;设计表达看洞察、说服力、创新与权衡 | 可运行产品不是唯一形式;用户研究也不是统一的必要形式 |
| Methodological 方法学 | 关于如何研究或实践、如何发现/测量/分析/创造的新方法知识 | 效用、可复现性、可靠性、效度;通常需要反复验证 | 仅使用一个方法不等于提出方法贡献;需要把方法的改进及适用性本身作为主张 |
| Theoretical 理论 | 新的或改进的概念、定义、模型、原则、框架 | 新颖性、合理性与描述/预测/解释能力;科学理论应可检验、可证伪 | 一组概念不自动成为成熟的解释理论;覆盖所有现象却无法排除任何情况也可能失去区分力 |
| Dataset 数据集 | 对共同体有用的新语料或资料库,常附特性分析与基准 | 对测试和测量的用途、代表性及社区可用性 | 数据是实证研究的输入时,不自动同时构成独立数据集贡献 |
| Survey 综述 | 对一个研究主题已有工作的综合,揭示趋势与空白 | 组织已知内容与暴露研究机会的能力;完整性、深度、成熟度、组织性 | 文献多不等于综合强;调查问卷与文献综述在这里是不同概念 |
| Opinion 观点/论证 | 以证据和论证改变读者看法,促使反思、讨论、争论 | 论证强度、证据可信度、公平对待反方、议题广泛相关且易于理解 | 不是「无需证据的个人意见」,也不要求观点已经获得普遍赞同 |
原文并没有给这七类设定互斥的决策树。一项工作可以由 Artifact 主导,同时贡献新的 Empirical 发现;一套共享语料可以伴随新的抽样 Methodological 贡献。多种贡献需要分别提出和举证,不能把同一个结果重复命名七次来扩大贡献数量。
Our Interpretation:可以用一个问题快速定位:删掉所有实验过程、工具名称和实现细节之后,读者还带走什么?若答案是一个发现,偏实证;是一种实现新交互的办法,偏制品;是一种可迁移的研究做法,偏方法学;是一套解释或组织概念,偏理论。这个启发式仅用于整理主张,不能替代细读。
实证知识来自观察与数据收集。原文明确容纳定性或定量、实验室或田野,以及带有不同认识论立场的数据。列举的来源包括实验、用户测试、田野观察、访谈、问卷、焦点小组、日记、民族志、传感器和日志。这些方法的共同点不是数字多,而是结论与材料之间有可审查的关系。
严谨不等于只报告统计检验:一个定性研究同样需要交代参与者、情境、材料来源、分析过程与解释边界。这些具体实践是本页对「方法合理」的展开,原文并未规定统一操作清单。即使某个差异具有统计显著性,若问题无关紧要或效果缺乏实质意义,也不能凭显著性本身说明贡献重要。
Our Interpretation:系统可用性测试可能告诉我们「此系统在这些任务下可用」,但这不必然产生可迁移的人类行为发现。若要另列实证贡献,需要说明发现相对于已有研究的新意、其解释范围及方法是否足以支持该范围。
| 原文区分的制品 | 主要要证明的东西 | 原文评价方向 | 本页建议的证据组织 |
|---|---|---|---|
| 系统、架构、工具、工具包 | 哪些事情因此成为可能,以及怎样实现 | 整体评价能力、结构与实现方式 | 解释机制、代表性能力演示、与已有方案的实质差异、适用限制;若宣称效能提升,再增加与该主张匹配的证据 |
| 新输入/交互技术 | 人类操作表现的收益 | 精确、定量地隔离性能收益 | 合理基线与受控任务、学习/熟练度、时间和错误的权衡;不能只展示好看的演示 |
| 草图、模型、愿景等设计表达 | 设计展示的洞察、创新与未来可能性 | 表达是否有洞察和说服力;是否处理相互冲突的优先事项 | 呈现设计理由、情境、竞争目标和取舍;不要把未来愿景当作已部署系统的效果证据 |
原文说制品贡献常伴随实证研究,但并非必须如此,有时甚至不应如此。这里的重要限制是评价方式与主张相称:对设计愿景强行测量完成时间可能答非所问;对明确声称让用户更快的输入技术,却拒绝任何人类表现证据,也不成立。原文引用 Greenberg 与 Buxton 对可用性评价的讨论,并以 Olsen 的系统研究评价工作为依据;它没有授予所有系统论文免于验证的权利。
对于材质编辑工具,一段能生成图的程序、一个可交互原型,以及一项「艺术家能够以更低认知负担完成有意图的编辑」的研究主张,是三个不同层次。前两项可以支撑第三项的研究,但不能直接替代第三项所需的证据。这个例子是对框架的应用,不是本文做过的实验。
方法学贡献指导研究或实践如何开展:发现、测量、分析、设计、制造都在范围内。原文的例子既有方法应用、创新和改造,也有新度量与新量表。因此,新意不必表现为全新算法,但必须清楚说明旧方法为什么不够、改动了什么、怎样知道改动有效。
| 原文标准 | 本页的操作性解释 | 不足以单独证明它的材料 |
|---|---|---|
| Utility 效用 | 方法解决了研究或实践中的真实困难 | 只有流程图,没有展示在哪种困难上提供帮助 |
| Reproducibility 可复现性 | 他人能根据充分描述重做关键程序 | 仅公开一个入口脚本,关键采样或解释规则仍隐藏 |
| Reliability 可靠性 | 在应当一致的条件下产生稳定结果 | 只在单个案例、单次运行或同一研究者手中成功 |
| Validity 效度 | 方法支持所宣称的测量/推断目标 | 把便于计算的代理量直接当成目标构念 |
原文强调这些属性需要重复验证,未把「一次实验看起来有效」当成充分条件。在程序化材质研究里,若要贡献新的可编辑性度量,需要证明它测到了编辑能力,而不只是节点数量、图大小或渲染相似度。
理论贡献包括概念、定义、模型、原则与框架,既可定性,也可定量。作者用「如何做」与「做什么、为什么做、预期什么」区分方法学与理论,又用「观察到什么」与「解释为什么」区分发现与成熟理论的目标。两类工作会相互支持,不应理解为经验研究不允许解释,或理论研究不能含有实验。
过窄的理论只能解释原始情境,迁移价值有限;过宽的理论对几乎任何结果都能自圆其说,也可能没有真正的区分力。原文提出科学理论应能被检验和证伪,理论验证通常依靠实证工作。与此同时,它列出的理论类例子也包含设计空间和思考框架。因此,将一个有用框架归入 Theoretical,并不等于声称它已经成为成熟的预测性或因果理论。
Our Interpretation:本文自身的七类框架主要提供分类与评价语言,没有给出能预测单篇录用结果的定量理论。检验它,可以研究不同使用者是否理解一致、是否能识别原本遗漏的知识、能否改进贡献陈述;这些尚未由本文验证。
数据集应提供有用的新语料,通常伴随特性分析;基准测试可以帮助统一比较。原文强调「有用且有代表性的共同语料」,并指出数据集常伴随访问工具或新方法。Dataset 与 Methodological 可以同时成立,但两者的知识主张应分开:资源覆盖了什么,与资源怎样构造或评价,是不同问题。
Research Extension:材质图数据若要作为独立 Dataset 贡献,应明确材质族、图结构、节点类型、参数与编辑操作覆盖,记录数据生成或筛选过程,并说明许可、划分和已知偏差。合法执行率与材质族多样性不能替代人类编辑需求的代表性;这个检查表是本页建议,并非原文公开了某个材质数据集。
本文的 Survey Contributions 指文献综述与元分析:综合一个研究主题已有工作,揭示趋势、缺口及进一步研究机会。问卷调查作为数据收集方法,出现在 Empirical 的方法列表中;仅因英文都用 survey,不能把问卷论文归入文献综述类。
原文说综述通常适合已经达到一定成熟程度的主题,但其例子也包含「Emerging topic」。这里的成熟度应理解为已经有足够材料支持有意义的综合,而不是要求领域必须很老。好的综述需要完整性、深度、组织性,并帮助读者看见研究空间;堆砌上百条引用并不能取代比较维度与综合结论。
Our Interpretation:检验一篇综述,不仅看纳入多少论文,也要看遗漏是否系统性影响结论、分类是否有解释力、相邻方向能否比较、研究空白是否由材料支持。本文给出通用评价语言,但没有规定系统综述的数据库、检索式、纳入排除标准或元分析统计流程。
观点贡献通过论证促使读者改变理解或实践,目标包含反思、讨论与争论。它可以调动实证、理论、历史等多种材料,评价依据是论证能否成立:证据是否可信、是否公平处理相反观点、问题是否具有广泛相关性、表达是否易于理解。
原笔记写到议题「广为接受」容易产生误导。原文要求议题具有广泛兴趣、文章易于读懂,并不是要求论点已经成为多数人的共识。提出有力的异议,恰好可能是 Opinion 的价值。另一个误区是把「论点新颖」当成充分条件:新颖而没有论据、忽略显而易见的反例,仍是薄弱论证。
本文将 Oulasvirta 与 Hornbæk 的 HCI Research as Problem-Solving列为 Opinion 的 Definition 示例。这揭示了分类可以针对论证目的:一篇文章即使提出概念框架,也可以通过说服读者采用一种学科理解而体现 Opinion 贡献。标签边界不是固定的学科户籍。
每类贡献各有五个例子。下面保留全部原始子标签、论文标题与来源,便于看到同一知识类型内部的多样性。中文最后一列只解释为什么作者把它放在这里,不对这 35 篇论文的完整结果、实验质量或全部贡献作二次认证。本次完整精读对象仍是 2016 这篇文章。
| 类型 | 原文子标签 | 作者/出处 | 原例论文 | 它示范的知识产物(本页释义) |
|---|---|---|---|---|
| Empirical | Interview study | Burke, Kraut & Williams · CSCW 2010 | Social use of computer-mediated communication by adults on the autism spectrum | 访谈产生关于特定人群交流实践的知识 |
| Empirical | Diary study | Czerwinski, Horvitz & Wilhite · CHI 2004 | A diary study of task switching and interruptions | 日记记录帮助描述任务切换与中断 |
| Empirical | Quantitative lab experiment | Lee & Zhai · CHI 2009 | The performance of touch screen soft buttons | 受控实验测量触屏软按钮的人类操作表现 |
| Empirical | Crowdsourced study | Pandey et al. · CHI 2015 | How deceptive are deceptive visualizations?: An empirical analysis of common distortion techniques | 众包数据检验可视化失真产生的影响 |
| Empirical | Qualitative field study | Poltrock & Grudin · TOCHI 1994 | Organizational obstacles to interface design and development: Two participant-observer studies | 参与式观察揭示组织层面的界面开发障碍 |
| Artifact | Input device | Baudisch, Sinclair & Wilson · UIST 2006 | Soap: A pointing device that works in mid-air | 输入设备展示新的交互能力 |
| Artifact | System | Dixon & Fogarty · CHI 2010 | Prefab: Implementing advanced behaviors using pixel-based reverse engineering of interface structure | 系统架构与实现展示可实现的新行为 |
| Artifact | Hardware toolkit | Greenberg & Fitchett · UIST 2001 | Phidgets: Easy development of physical interfaces through physical widgets | 工具包使物理界面开发成为可复用能力 |
| Artifact | Input technique | Grossman & Balakrishnan · CHI 2005 | The Bubble Cursor: Enhancing target acquisition by dynamic resizing of the cursor’s activation area | 输入技术的主要主张需要人类表现证据 |
| Artifact | Envisionment | Ishii & Ullmer · CHI 1997 | Tangible bits: Towards seamless interfaces between people, bits and atoms | 设计愿景揭示新的交互可能性 |
| Methodological | Method application | Consolvo & Walker · IEEE Pervasive Computing 2003 | Using the experience sampling method to evaluate ubicomp applications | 已有方法用于新研究情境,需要证明适用性 |
| Methodological | Method innovation | Druin · CHI 1999 | Cooperative inquiry: Developing new technologies for children with children | 提出新的参与式设计研究做法 |
| Methodological | Method adaptation | Millen · DIS 2000 | Rapid ethnography: Time deepening strategies for HCI field research | 调整田野研究过程以满足研究限制 |
| Methodological | New measures | Soukoreff & MacKenzie · CHI 2003 | Metrics for text entry research: An evaluation of MSD and KSPC, and a new unified error metric | 测量定义与分析方式本身成为知识产物 |
| Methodological | New instrument | Suh et al. · CHI 2016 | Developing and validating the User Burden Scale: A tool for assessing user burden in computing systems | 量表开发及验证说明测量工具如何成立 |
| Theoretical | Thought framework | Bellotti et al. · CHI 2002 | Making sense of sensing systems: Five questions for designers and researchers | 组织设计思考的问题框架 |
| Theoretical | Design space | Card, Mackinlay & Robertson · CHI 1990 | The design space of input devices | 用维度组织输入设备的设计空间 |
| Theoretical | Conceptual model | Lee & Paine · CSCW 2015 | From The Matrix to a Model of Coordinated Action (MoCA): A conceptual framework of and for CSCW | 对协同行动提出概念组织方式 |
| Theoretical | Design criteria | Nathan et al. · DIS 2008 | Envisioning systemic effects on persons and society throughout interactive system design | 把系统性社会影响纳入设计判断 |
| Theoretical | Quantitative model | Wobbrock et al. · CHI 2008 | An error model for pointing based on Fitts’ law | 模型把输入任务条件与错误表现联系起来 |
| Dataset | Test corpus | MacKenzie & Soukoreff · CHI EA 2003 | Phrase sets for evaluating text entry techniques | 共享文本测试语料支撑可比较评价 |
| Dataset | Benchmark tasks | Myers et al. · unpublished 1997 | Using benchmarks to teach and evaluate user interface tools | 可重复执行的基准任务;原文标注未发表稿 |
| Dataset | Corpus creation | Paek & Hsu · CHI 2011 | Sampling representative phrase sets for text entry experiments: A procedure and public resource | 代表性抽样程序与公共资源共同构成价值 |
| Dataset | Repository | Plaisant, Fekete & Grinstein · TVCG 2008 | Promoting insight-based evaluation of visualizations: From contest to benchmark repository | 把竞赛资料转化为社区基准资源 |
| Dataset | Global dataset | Reinecke & Gajos · CHI 2014 | Quantifying visual preferences around the world | 跨地区偏好数据支持后续比较研究 |
| Survey | Techniques | Balakrishnan · IJHCS 2004 | “Beating” Fitts’ law: Virtual enhancements for pointing facilitation | 组织指向辅助技术的研究空间 |
| Survey | Emerging topic | Coelho & Duarte · Computers in Human Behavior 2016 | A literature survey on older adults’ use of social network services and social applications | 综合新兴主题中的用户群体与应用知识 |
| Survey | Tools | Johnson et al. · Foundations and Trends in HCI 2009 | Computational support for sketching in design: A review | 把草图设计的计算支持研究整理成整体 |
| Survey | Domain | MacKenzie & Soukoreff · HCI 2002 | Text entry for mobile computing: Models and methods, theory and practice | 综合一个领域的方法、理论与实践 |
| Survey | Technology | Shaer & Hornecker · Foundations and Trends in HCI 2009 | Tangible user interfaces: Past, present and future directions | 通过历史、当前状况与未来方向组织技术研究 |
| Opinion | Evaluation | Bernstein et al. · CHI EA 2011 | The trouble with social computing systems research | 针对研究评价提出有证据的论证 |
| Opinion | Prioritization | Dourish · CHI 2006 | Implications for design | 重新审视研究结论与设计之间的期待 |
| Opinion | Application | Greenberg & Buxton · CHI 2008 | Usability evaluation considered harmful (some of the time) | 质疑特定情境下过早或不匹配的可用性评价 |
| Opinion | Vision | Newell & Card · HCI 1985 | The prospects for psychological science in human-computer interaction | 论证学科发展的愿景 |
| Opinion | Definition | Oulasvirta & Hornbæk · CHI 2016 | HCI research as problem-solving | 通过论证给出 HCI 的元科学理解 |
这份例子清单是教学性地图,不是系统抽样的 HCI 全集,也不是每种类型的排名。单看论文题目往往无法完成分类:一篇包含工具的文章可能主要贡献一种研究方法,一篇提出模型的文章也可能以说服读者采用新观点为目标。应回到具体主张及支撑材料。
原文刊页 40–43:全部 Examples,7 类 × 5 篇。原文对部分 CHI 2016 文献标注 To appear;此处保留 2016 年与会议身份,不将写作时态误解为另一出版年份。
Paper Verified:1996–2001 年,CHI 要求作者标示论文类型,但还未称作贡献类型;1996 年的例子包括 experience papers 和 systems papers。作者指出,1998 年的征稿启事首次出现 contribution 一词;到 2000 年,已有较长的贡献描述。2002–2008 年要求提交 30 词的 contributions and benefits statement,供会议程序使用。
2009–2013 年投稿时从清单选择类型;2014–2015 年类型仍列于征稿启事,但不能在提交时选择。2016 年转成可选投稿关键词,由 Frank Bentley 与 Jofish Kaye 制定,并受早期白皮书影响。以下是论文对历史材料的整理,不是本页对当前投稿系统的规则说明。
完整保留九项及 2006、2007、2008 的原文差异。原表只有描述列;这里新增短标签与中文释义用于阅读,没有删除或合并条目。该时期同时要求 30 词贡献与收益陈述。
| 原条目 | 完整原始描述(保留年份差异) | 中文释义 |
|---|---|---|
| Case studies | Case studies of the development and use of interactive systems that provide new insights for HCI research [2007, 2008: or practice]. | 系统开发与使用案例;2007/2008 明确也可为实践提供新认识 |
| Interaction technologies | Interaction technologies—A new technique or device [2006: or other component of the user interface]. | 交互技术、设备;2006 包括其他界面组成部分 |
| Interactive systems | Interactive systems—Descriptions of the architecture, interface, and evaluation of a new interactive system. | 新系统的架构、界面与评价 |
| Methods and tools | Methods [2006: Methodologies] and tools—New methods, processes, techniques, and tools for use in interactive system design, development, and deployment. | 用于交互系统设计、开发、部署的研究/实践方法与工具 |
| Metrics | Metrics by which the performance of interactive technologies can be measured and compared more meaningfully. | 使交互技术性能的测量、比较更有意义的度量 |
| Reflective Analyses | Reflective Analyses—Thought-provoking, well-substantiated analyses of HCI issues. | 有根据、促使反思的 HCI 议题分析 |
| Reports of Fieldwork and Ethnography | Reports of Fieldwork and Ethnography—Findings, guidelines, and so on, from studies of real-world settings, or of technology use in such settings, with clear relevance to the design and deployment of interactive systems. | 真实场景或其中技术使用的发现、指南,并连接系统设计和部署 |
| Laboratory Studies Reports | Laboratory Studies Reports—Tests of theory, explorations of new phenomena using well-designed controlled studies of human-computer interactions. [2006: Results from Laboratory Studies—Findings, techniques, methods, and so on, from controlled studies of systems, techniques, and other phenomena relevant to HCI.] | 受控研究检验理论、探索现象;2006 描述还混合发现、技术、方法等结果 |
| Theories and Models | Theories and Models—Presentation and critical analysis of HCI theories, including but not limited to formal approaches. [2006: Theories and Models—Descriptions and evaluation of HCI theories, models, and other formal approaches.] | 呈现并批判分析理论;2006 版本偏向描述和评价理论、模型及形式方法 |
九行是跨年份的并集,不代表每一年都同时具有九种选项。Experience 仅标示于 2009/2010,Validation and refutation 仅标示于 2014/2015;Opinions 在 2011–2015 年名为 Argument。年份列是对原表方括号的展开。
| 原标签 | 适用年份 | 中文释义 |
|---|---|---|
| Understanding users | 2009–2015 | 理解用户;偏研究对象/目的 |
| Development or refinement of interface artifacts or techniques | 2009–2015 | 界面制品或技术的开发/改进;偏工作活动 |
| Systems, tools, architectures and infrastructure | 2009–2015 | 系统、工具、架构和基础设施;偏产物 |
| Methodology | 2009–2015 | 方法论 |
| Theory | 2009–2015 | 理论 |
| Innovation, creativity and vision | 2009–2015 | 创新、创造力与愿景;未清晰限定知识形态 |
| Experience | 仅 2009、2010 | 原表以方括号标示适用年份 |
| Validation and refutation | 仅 2014、2015 | 验证与反驳;研究活动及论证方向 |
| Opinions [2011–2015: Argument] | 2009、2010 为 Opinions;2011–2015 为 Argument | 观点/论证的名称变迁 |
原表的 Empirical 单元格跨越两行;重建时在两行都写明 Empirical 以避免读者误以为第二类没有对应项。八个投稿标签对应七类知识,差异正是 Empirical 的拆分。
| CHI 2016 投稿标签 | Wobbrock (2012) 对应类 | 中文释义 |
|---|---|---|
| Empirical study that tells us about how people use a system | Empirical | 系统使用实证研究 |
| Empirical study that tells us about people | Empirical | 关于人的实证研究 |
| Artifact or system | Artifact | 交互制品/系统 |
| Method | Methodological | 方法学 |
| Theory | Theoretical | 理论 |
| Dataset | Dataset | 数据集 |
| Meta-analysis / Literature survey | Survey | 元分析/文献综述 |
| Essay / argument | Opinion | 论说/论证 |
Author Claim:早期分类混合了知识类型、工作类型、实质关注点与方法路径,后来的简短标签更聚焦于产生的知识。Our Interpretation:「越来越简洁」并不自动证明分类更准确;本文没有给出跨年份一致性编码或决策质量实验。三张表最有力地支持的是命名方式与组织原则发生变化,而不是一套分类法已经取得可量化优越性。
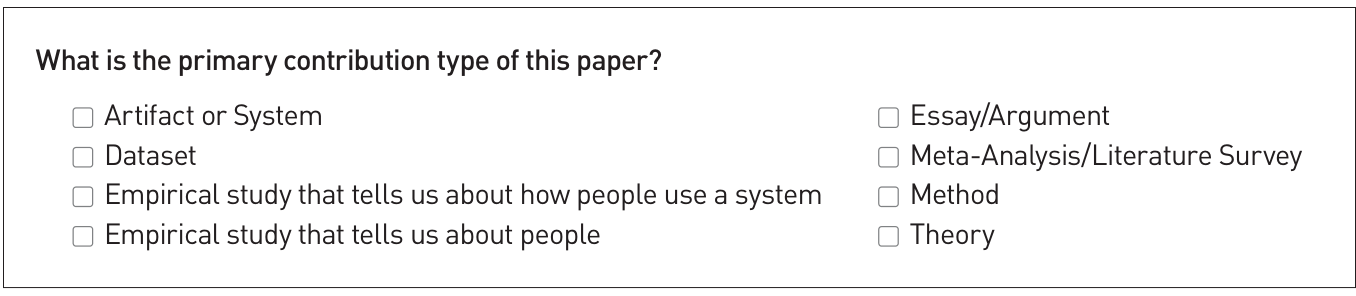
表单标题使用「primary contribution type」,但作者明确说明可不选、选一个或选多个。不能根据问题措辞把结果当成单标签分类。2,316 篇投稿中,130 篇未选择标签(5.6%),1,481 篇选择一个(63.9%),705 篇选择多个(30.4%);平均 1.29 个标签,标准差 0.66。百分比四舍五入后相加为 99.9%,不是漏了 0.1% 的论文。
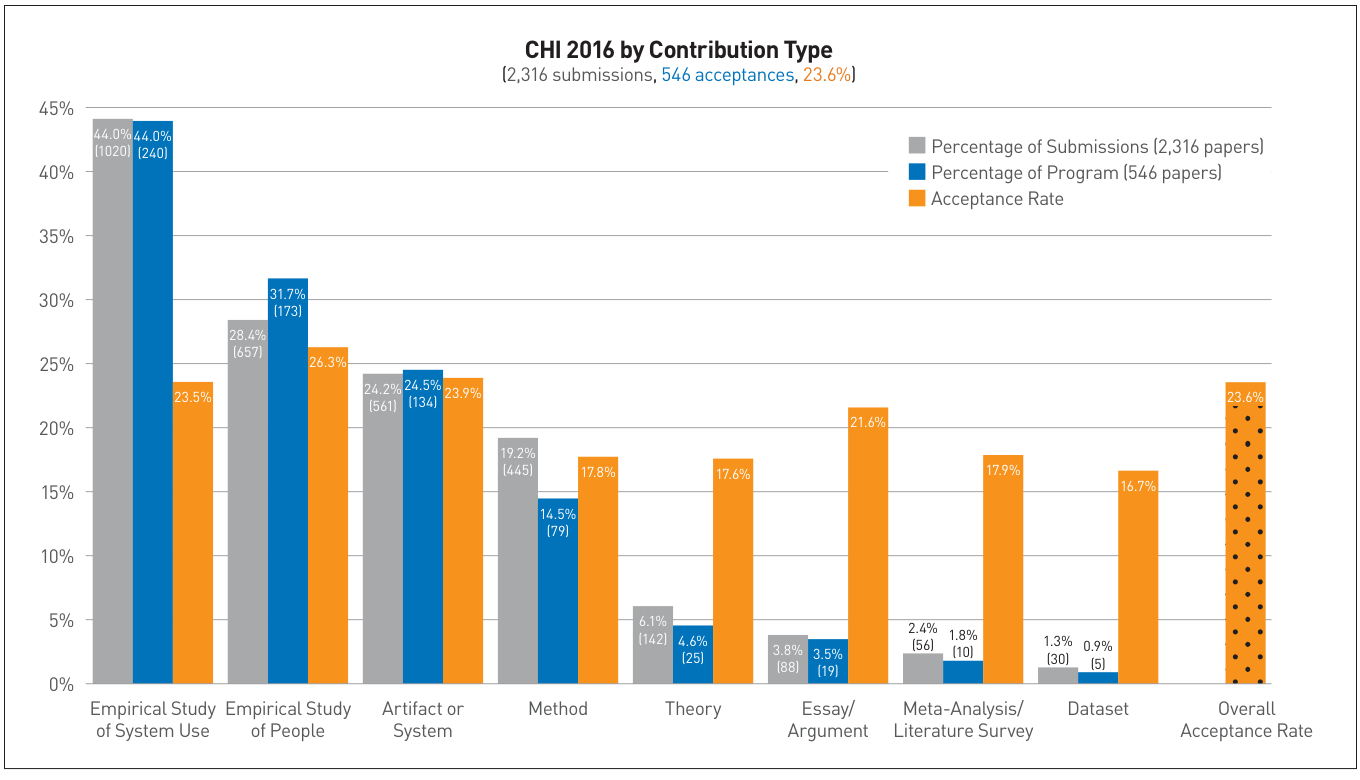
灰色是该标签在全部投稿中的占比;蓝色是该标签在全部录用论文中的占比;橙色是该标签自身投稿的录用率。图按投稿数递减排列,整体 2,316 篇投稿、546 篇录用,整体录用率为 23.6%。下面把原图全部八类、两个计数与三个比例重建为可读表格,没有只保留最高或最低值。
| 贡献类型 | 投稿数 | 占全部投稿 | 录用数 | 占全部录用 | 该类录用率 |
|---|---|---|---|---|---|
| Empirical Study of System Use | 1020 | 44.0% | 240 | 44.0% | 23.5% |
| Empirical Study of People | 657 | 28.4% | 173 | 31.7% | 26.3% |
| Artifact or System | 561 | 24.2% | 134 | 24.5% | 23.9% |
| Method | 445 | 19.2% | 79 | 14.5% | 17.8% |
| Theory | 142 | 6.1% | 25 | 4.6% | 17.6% |
| Essay / Argument | 88 | 3.8% | 19 | 3.5% | 21.6% |
| Meta-Analysis / Literature Survey | 56 | 2.4% | 10 | 1.8% | 17.9% |
| Dataset | 30 | 1.3% | 5 | 0.9% | 16.7% |
令 \(S=2316\) 为全部投稿数,\(A=546\) 为全部录用数,\(S_t\) 和 \(A_t\) 为带标签 \(t\) 的投稿数与录用数。三列百分比分别是:
例如 Method 的三个百分比依次来自 \(445/2316\)、\(79/546\)、\(79/445\),得到 19.2%、14.5%、17.8%。它们不能互换。整体录用率是 \(100\times546/2316\approx23.6\%\),并非八个类别录用率的算术平均。
Paper Verified:「系统使用实证」标签最多,占投稿与录用项目均约 44.0%;「关于人的实证」录用率最高,为 26.3%;Artifact 录用率 23.9%,与总体接近。Method、Theory、Essay/Argument、Survey、Dataset 的类内录用率都低于总体。后五类中 Essay/Argument 最高,为 21.6%;Dataset 最低,为 16.7%,同时投稿数只有 30、录用数只有 5。
Our Calculation:八类投稿计数相加为 2,999 次标签出现,录用计数相加为 685 次。相应占比之和约为 129.49% 与 125.46%,超过 100% 是多标签结构导致的正常结果。\(2999/2316\approx1.2949\) 与原文平均 1.29 相容。没有逐篇标签组合,无法从这些边际计数独立重算标准差 0.66,也不能求各标签交集或精确的「任一实证」总人数。
| 问题或说法 | 现有证据 | 可支持的结论 | 不能越过的边界 |
|---|---|---|---|
| 哪些知识标签在 CHI 2016 更常见? | 全届投稿的自选标签边际计数 | 这一届作者怎样标示其工作,以及录用项目的标签分布 | 不是研究者独立复核后的客观贡献分类,也不代表整个 HCI 领域 |
| 各类论文的录用率不同吗? | 带同一标签的投稿数与录用数 | 描述观察到的类内比例差异 | 没有控制质量、主题、作者群体、评审分配等因素,不能归因为标签导致录用 |
| 理论或数据集是否不被重视? | 该届较低投稿量和录用率 | 数量与当届接受机会较低的现象值得进一步研究 | 没有长期影响或引用数据,不能推出学术价值更低;作者也明确提醒不要混淆活动量与价值 |
| 分类法可靠、完备吗? | 概念定义、例子、投稿系统采用 | 提供了可使用的组织语言 | 未做独立编码者一致性、覆盖率、歧义或实际决策改进实验 |
| 多写几个贡献标签会提高录用机会吗? | 只有零/一/多标签的投稿总数 | 知道作者选择行为的总体分布 | 未给不同标签数量组的录用结果,更没有因果干预证据 |
原文没有报告分类间的假设检验、置信区间、回归模型或去混淆分析。本页不补造 p 值,也不把「最高」解释为统计显著优于所有其他类别。该统计是对 CHI 2016 当届记录的描述;推论到下一届、其他会议或未来 HCI 需要额外设计与材料。
本次可直接复核的是:七类定义与各类标准是否完整,35 个例子是否归位,三张历史表是否忠实,八类统计能否从计数复算,以及作者主张是否超出这些材料。原文没有给出逐篇投稿记录或对应分析脚本,因此不能复现标签交叉关系、未标注录用情况、标准差或混淆因素分析。
「基础模型、参数量、训练集划分、学习率、推理采样、模型消融」不适用于这篇文章。历史表是演化材料,不是算法基线;七类是知识框架,不是网络模块。若提出未来分类实验,应另写实验设计,并标为研究延伸。
数据与作者的价值提醒:原文刊页 44。统计边界、敏感性计算与再分析建议为本页判断。
补充一手核验:Oulasvirta 与 Hornbæk 的框架区分实证、概念、建设性研究问题,再以问题解决能力评价结果;其五个方面是重要性、有效性、效率、迁移和可信度。它明确包含理论与概念问题,并非只适用于产品或现实应用。因此,旧笔记中「三类贡献、偏实际应用、因而不够灵活」的概括需要修正。对照原文,正文 4956–4959 页
Our Interpretation:比较时应先区分两个问题:「留下了什么知识产物?」与「解决了什么知识缺口、解决得有多好?」七类框架适合前者。对于本文,可以先描述它提出的组织框架、历史综合与统计材料,再追问这些材料是否真的缓解研究定位和评价困难。这个顺序比给两个框架做普适的优劣排名更有操作性。
| 本文组成部分 | 本页建议的贡献定位 | 依据与边界 |
|---|---|---|
| 七类知识产物及评价语言 | 主要:Theoretical 中的概念组织/框架 | 整理可供思考的概念和区分;不是新数学理论,七类也已有早期白皮书来源 |
| 倡导按知识类型理解、评价 HCI | 重要的 Opinion 维度 | 文章希望影响研究者和评审的看法;这与框架贡献并存,不一定需要强行排出唯一主类 |
| CHI 2016 投稿与录用分布 | 次要:Empirical,描述性元研究证据 | 对学术共同体活动提供新描述;缺少因果、质量控制及长期影响分析 |
| 历史表与代表例文 | 次要:有界的综合与历史整理 | 有 Survey 性质,但不是报告了可复现检索流程的系统综述 |
| 评审与写作的实践用途 | 方法学启发,尚不能据此认定为已验证的新评价方法 | 文章没有反复验证一套操作流程的可靠性和效度 |
| 未报告的部分 | 不主张新的交互 Artifact 或独立 Dataset 贡献 | 表格本身不是新的交互系统;聚合计数公开不等于提供了可独立复用的投稿级数据集 |
以上是本页的分类判断,不是作者自选标签,也不是出版社的官方类型。若写一段英文贡献评价,可以表述为:The paper primarily offers a conceptual framework for distinguishing forms of HCI knowledge and their evaluation criteria. Its descriptive analysis of CHI 2016 and its historical synthesis provide secondary contributions. Its argument for contribution-sensitive evaluation also has an opinion-oriented dimension. 这里的 primary 表示本页为写作聚焦作出的选择,不排除另一位读者基于文章说服目的把 Opinion 作为主类。
两套框架都不应被简化成自动贴标签器。对自己的论文,先提出确切主张,再选能暴露证据缺口的分析方式;不要先选有利标签,再回填贡献故事。
本文七类与对照论文被列为 Opinion 示例的依据:原文刊页 43。对照资料只用于纠正旧笔记中的框架混淆;不替代对另一篇文章的单独精读。
Research Extension:以下六步是基于本文编制的工作方法,尚未通过用户研究验证。它用于检查贡献陈述是否清楚、证据是否对应,不是本文发布的标准化评分量表。
| 弱陈述 | 更可评价的陈述骨架 | 由此产生的证据责任 |
|---|---|---|
| 我们做了一个新的材质工具 | 通过机制 A,使用户在约束 B 下完成此前难以完成的操作 C | 展示 A 如何工作、C 是否可实现、与现有工具相比增加何种能力、B 的限制 |
| 用户喜欢我们的系统 | 在某类任务和参与者中,用户给出偏好 D,并报告原因 E | 交代招募、任务、偏好收集、相反意见与情境;不直接外推生产效率或长期采用 |
| 我们提出一个新指标 | 该指标测量构念 F,并在条件 G 下保持可重复且与独立证据一致 | 构念定义、可靠性与效度验证;不只报告与另一个相似代理量的相关 |
| 我们建立了新理论 | 概念关系 H 能组织已知现象,并提出有边界的预期 I | 处理反例、解释与预测范围、与现有概念的关系;没有完成这些时称为框架或假说更准确 |
| 我们总结了很多论文 | 沿维度 J 组织已有结果,由材料揭示冲突 K 或缺口 L | 说明范围与选择理由,展示跨工作的综合,而非逐篇摘要相加 |
对于强调交互可能性的系统,可以要求机制和能力边界清楚,但不应自动要求一种无关的人类速度实验。对于声称降低用户负担的系统,也不能因为归为 Artifact 就放弃对负担主张的验证。对理论框架,可以要求边界、反例与对已有知识的增益;对综述,则需要检查综合深度和覆盖合理性。
同样,不宜把研究工作划分为「做系统的」与「做用户研究的」两个阵营。一个工作组合可以让系统揭示可能性,让实证材料说明使用情境,再让概念分析解释何时这些能力有意义。贡献陈述应让这些层次形成关系,而不是只形成标签列表。
基础标准来自原文七类评价描述;六步流程与陈述工作表均为本页提出,未宣称验证有效。
本文把跨学科的评价冲突转译成具体知识产物,帮助读者理解为什么一个系统、一个方法和一个理论不能完全依靠同一套证据标准。每类配备多个例子,且 Artifact 内部继续区分系统、输入技术与设计愿景,比只罗列七个词更有教学价值。
三张历史表将分类变化放在投稿制度中理解;两张统计图则展示概念如何在真实学术流程里被使用。作者没有把较低的录用率等同于较低的研究价值,并明确提醒不要用分类限制未来想象。这些边界使文章更适合用作讨论起点,而不是领域准入规则。
这些批评是对框架使用边界的分析,不是声称文章本应成为机器学习基准。作为七页的学科反思文章,它提供的清晰概念语言有独立价值;若把它用于定量科研评价,才需要补充更强的编码与效度证据。
| 待验证问题 | 可执行研究设计(本页建议) | 需要观察的证据 | 避免的误判 |
|---|---|---|---|
| 不同研究者会一致理解类别吗? | 从不同 HCI 传统选取论文,先独立标注主张与可多选类别,再记录分歧和理由 | 逐类一致性、边界案例、对定义的不同理解、未覆盖知识形式 | 强迫单选得到的低一致性不能直接否定允许多标签的框架 |
| 框架能改善贡献陈述吗? | 比较使用框架前后的写作;由不了解条件的评阅者按预先说明的标准评价 | 主张清晰度、证据匹配、遗漏或夸大减少情况、学习成本 | 参与者觉得有用,不等于实际文本质量提高 |
| 录用差异来自哪里? | 在获授权与保护隐私的前提下,跨年份分析投稿级标签、主题、评审与结果 | 类别共现、样本与流程差异、不同模型假设下的稳健性 | 仍不能把观察关联直接称为歧视或因果效应 |
| 框架如何适应新研究形式? | 主动寻找不能清楚归类的作品,与其作者讨论实际知识目标 | 是否需要调整定义、加入横向维度或保留开放类别 | 硬把所有工作塞入七类会掩盖真正的新知识形式 |
这些研究应以明确问题、材料选择与评价依据开始;本文没有提供样本量或效应量,不能从它推导出一个保证充分的参与人数。具体规模应根据研究设计、资源与所需精度确定。
Reviewer Commentary 全部为本页判断;被审查事实的依据为2016 全文。
Research Extension:本文没有研究程序化材质、节点图或生成模型。下面把它的贡献语言用于 PMG 研究规划,目标是使「图像生成效果」「图结构可编辑性」与「人类创作能力」各自承担清楚的证据责任。
| 可能的知识类型 | 可以提出的 PMG 研究主张 | 对应证据与公开产物 | 常见短路 |
|---|---|---|---|
| Artifact | 一个交互机制让用户在保留结构约束时表达并执行材质修改意图 | 图表示、交互动作、执行流程、示例与失败边界;若主张人类效益,再补匹配评价 | 只证明能渲染一张相似图,就声称支持专业创作 |
| Empirical | 艺术家如何形成编辑意图、理解节点关系以及修复生成错误 | 真实任务材料、观察/访谈/操作记录、分析过程、反例与适用情境 | 小样本偏好投票被写成普遍创作规律 |
| Methodological | 可重复地评价材质图的可控性与编辑成本 | 构念、任务协议、度量与重复验证,跨工具或数据检验 | 把节点更少或执行更快直接定义为用户更容易控制 |
| Theoretical | 用概念关系解释意图表达、结构约束、反馈与修改策略之间的关系 | 概念边界、对已有现象的解释、可检验预期、反例 | 给系统组件画一张框图就称为解释理论 |
| Dataset | 代表性材质图、编辑目标和操作过程组成可复用研究资源 | 覆盖分析、来源与许可、划分、工具、失败及偏差记录 | 大规模合成图数量替代了研究任务代表性 |
| Survey | 把材质生成研究按表示、控制能力、执行与人类评价组织,揭示证据断层 | 明确范围、比较维度、综合推论与遗漏说明 | 按模型名称分组后逐篇摘要,没有新的整体认识 |
| Opinion | 论证 PMG 的评价应纳入持续编辑和创作自主性 | 证据、反方观点、适用边界与对现有视觉指标的公平讨论 | 简单宣布渲染指标毫无价值,忽略不同任务的合理需求 |
假设系统允许用户选中材质局部属性,表达目标变化,查看候选节点与影响范围,再通过渲染反馈逐步修正。其主贡献可先聚焦于 Artifact:新的交互能力及实现机制;如果观察揭示了新的编辑行为,再单独提出 Empirical 次要贡献。无需在一篇论文中追求七类齐全。
需要公开的机制包括:图中允许哪些节点和边、怎样表示可编辑参数、用户动作如何映射到修改、执行失败如何反馈、哪些内容自动决定、哪些内容仍由用户选择。若使用 Agent,还需区分系统建议、用户确认、执行结果和失败后的恢复;这些界面机制不能用隐藏的人工挑选来证明。
这里不指定训练网络、学习率或参与人数,因为研究问题尚未确定到需要这些参数的程度。生成质量差可能限制交互任务,界面机制弱也可能浪费生成能力;两者应在研究中分别记录,而非把所有效果都归给模型或都归给界面。
对 PMG 工作而言,本文的启发是明确自己要交付哪一种知识。视觉相似度可以支持重建质量主张;合法执行可以支持工程可靠性主张;可理解的编辑操作和人类任务证据才能支撑相应交互主张。把这些层次连接起来,会让贡献陈述更准确,也更容易发现真正值得研究的缺口。
以上全部为基于七类框架的研究设想,没有被本文实验验证;核心框架来源:原文刊页 40–42。
上述作用说明限于它们在本文中的引证位置,不表示本次完整阅读了这些书籍及各篇参考文献。35 个分类例文的完整标题与链接见第 7 节。
| 旧内容/空缺 | 本次确认或补充 | 处理方式 |
|---|---|---|
| DOI 为空 | 10.1145/2907069,原文末页明确印出 | 列入元数据建议,原始前缀保持不变 |
| ref 指向 Wobbrock-2012.pdf | 它是白皮书;2016 正文对应 interactions-16.pdf | 保留旧链接,新增清楚的版本关系 |
| Opinion 议题需要「广为接受」 | 应为议题广泛相关、表达易于理解;不要求观点已经成为共识 | 以本页明确修正,不删除原笔记 |
| 另一框架是三类贡献、偏实际应用 | 其核心是三类研究问题;理论与概念问题属于范围 | 补充一手对照,保留旧讨论与 prompts |
| 理论需要包含各种异常情况 | 应处理重要反例与适用边界;原文同时警惕「什么都能解释」失去区分力 | 限定表述,避免把不可证伪当成强理论 |
| Julie A. Kientz 为通讯候选 | 未找到明确通讯作者标记;两位作者均列出联系方式不等于指定通讯作者 | 继续保持末位作者候选与 unverified |
本页完整阅读与重建对象为用户提供的 2016 文章。原表 1–3 全部条目、原图 1–2 和图内八类统计均已保留;开篇的装饰性插图不作为研究结果图重复加入。数字已按原文核对,三个百分比列按计数复算;本页自己的公式仅解释这些分母,没有伪造原论文公式。
新增 Markdown 和合并候选均保留全部旧正文、提示词与 PDF++ 锚点;合并候选以原始 14,712 字节为逐字节前缀。元数据、人物链接和索引仅提出归档建议,尚未写入实际知识库。本次完成静态内容、数学源码、表格、图片文件解码、链接目标与大小检查;实际浏览器中的公式渲染、导航点击和不同屏宽布局,按约定留待下载后验收。