01 · 先抓住真正的贡献
ReVideo 让用户先改好视频第一帧,再指定局部运动轨迹,把外观与运动一同传播到后续帧,同时尽量保留区域外的原视频。真正困难的不是多接一个条件分支,而是模型会从密集背景中“偷看”原运动,忽略稀疏的轨迹指令。
论文已验证 作者先训练运动先验,再把两个不相关视频拼成训练样本,切断区域内外运动的统计关联,最后只调整时间自注意力的 K/V 投影以消除拼接边界。SAFM 根据位置与去噪噪声阶段融合内容和运动条件。三阶段训练与融合模块共同构成主要贡献;这里没有语言代理、图程序生成或可微物理渲染器。原文 §3
结果边界 16 段测试视频、20 位评价者中,ReVideo 的编辑目标偏好为 67.0%,但保留区 PSNR 和相邻帧 CLIP 一致性都低于 Pika。它更好地实现作者设计的局部编辑目标,并不代表所有指标、所有视频时长或所有场景都更优。正式版额外报告 768×768、A100 上 26 秒推理;这与训练分辨率、测试视频分辨率和公开脚本默认设置是不同条件。

02 · 论文身份与版本边界
完整作者顺序是 Chong Mou、Mingdeng Cao、Xintao Wang、Zhaoyang Zhang、Ying Shan、Jian Zhang。第一作者为 Chong Mou;PDF 星号与项目页信封标记均明确确认 Xintao Wang、Jian Zhang 为通讯作者。第一作者机构是北京大学电子与计算机工程学院,并列署名北京大学深圳研究生院与 Rabbitpre 的 AIGC 联合实验室;其余机构包括腾讯 ARC Lab 与东京大学。
| 版本/资产 | 核实结果 | 本页处理 |
|---|---|---|
| 用户原始 PDF | arXiv 2405.13865v1,2024-05-22,17 页;正文至第 10 页,参考文献至第 13 页,附录 A.1–A.7 在第 14–17 页 | 作为原笔记和 PDF++ 锚点的固定依据,不替换原文件 |
| 正式会议版 | NeurIPS 2024,Advances in Neural Information Processing Systems 37;DOI 10.52202/079017-0586;合订本 25 页 | 补充时间列、两张新增图、扩充附录及 checklist;不是另有 25 页 supplement |
| 正式版附录 | A.1–A.9,PDF 第 14–18 页;checklist 第 19–25 页 | 原 v1 图 10–13 在正式版改为图 12–15;本页并列标号 |
| arXiv 历史 | 检索时只有 v1 | 不能把会议版新增内容称为 arXiv v2 |
| 代码快照 | 174645250d9dfcdb6a8f48a0758d72e4fe59ba79,2024-09-26 | 只做静态源码审计,没有执行模型或载入 checkpoint |
| 官方补充 ZIP | 9,974,853 字节,HTML 与视频演示 | 完整读取 HTML、清点视频并检查容器元数据;不声称已观看视频或完成浏览器播放验收 |
原笔记的预印本 venue 和空 DOI 已过时;归档计划建议补充正式发表信息与项目链接。当前交付只在原文字节之后追加新内容,原 YAML、视频链接、两条 PDF++ 标注全部保留。正式 proceedings · arXiv 版本记录 · 作者项目页
03 · 为什么局部内容与运动很难同时控制
全局风格转换可以容忍背景被重新生成,局部编辑却要求“改动指定部分,同时保留其他部分”。用文本描述墨镜、汽车、狗,通常无法精确确定局部外观、尺度与位置。第一帧编辑把这个问题交给成熟的二维编辑工具,后续视频模型负责传播;轨迹则给出运动方向、位移和随时间变化的路径。
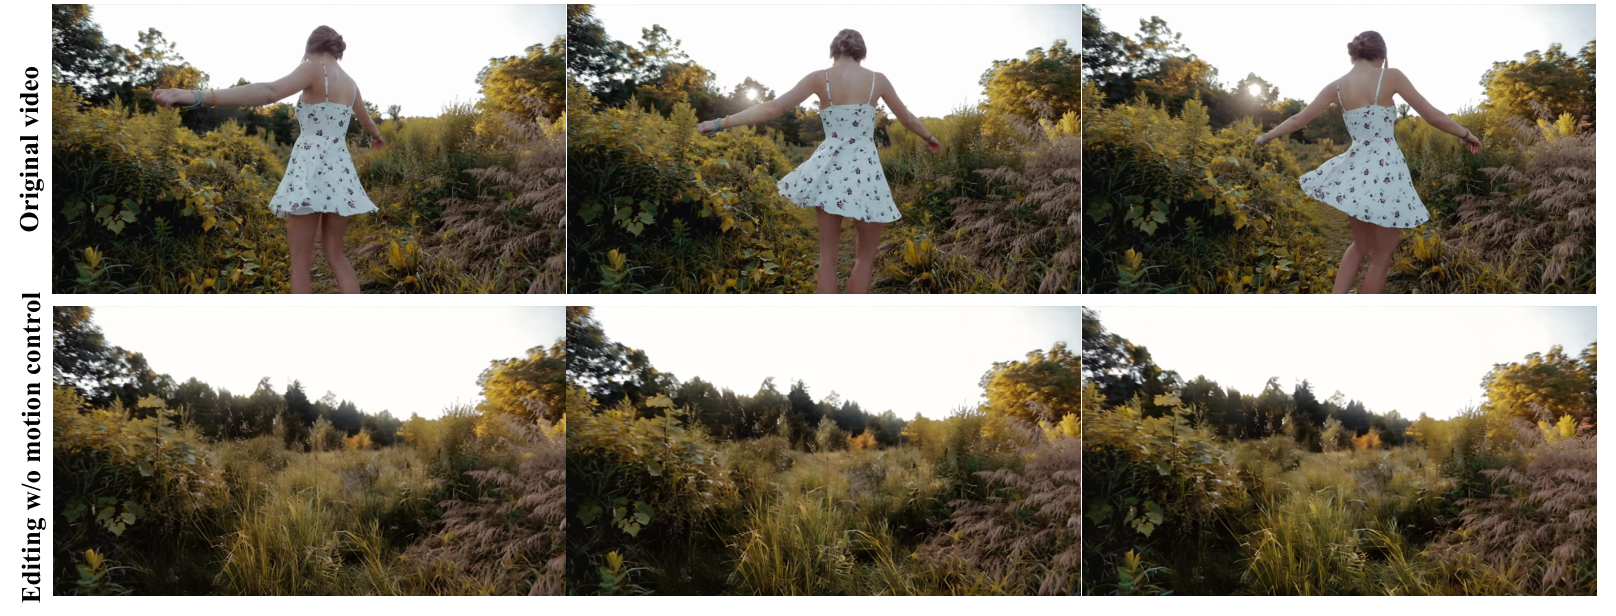
密集的未编辑视频包含纹理、光照,也包含相邻帧位移。因此,内容条件实际上还是一个强运动提示。对于稀疏轨迹与背景运动冲突的样本,网络可能选择更容易预测像素的背景捷径。运动控制弱并不必然是条件网络容量不足。

结构 A 把两个条件编码后合并,使用一套 ControlNet 式分支;结构 B 分别使用内容与运动控制分支。图 3 的 toy experiments 依次测试:A 直接训练、B 直接训练、B 先训练运动再联合训练、A 使用三阶段训练。前两者都忽略目标轨迹;第三者的运动先验在联合训练后被削弱;第四者改善这一问题。这些图支持“训练关联会影响控制”的解释,但不是严格的因果证明或多随机种子统计。

04 · 输入输出与掩码语义
| 符号 | 形状与意义 | 关键区分 |
|---|---|---|
| \(V\) | \(N\times3\times H\times W\),原始 RGB 视频 | 本页采用实现常用的 H、W 顺序;论文有 W、H 写法 |
| \(c_{\mathrm{ref}}\) | \(3\times H\times W\),已编辑的第一帧 | 提供精确目标外观;不是文本 prompt |
| \(M\) | 保留区为 1、编辑区为 0 的空间掩码,沿帧广播 | 与论文 \(c_{\mathrm{con}}=V\odot M\) 的保留语义一致 |
| \(R=1-M\) | 编辑区为 1 | 公开代码的 region 使用这个语义 |
| \(c_{\mathrm{con}}\) | 已遮挡编辑区域的原视频 | 代码以归一化 RGB 的 −1 填充洞,而不是乘掩码后填 0 |
| \(c_{\mathrm{mot}}\) | \(N\times2\times H\times W\),稀疏位移场经高斯扩散 | 两通道存帧间位移;代码顺序是垂直、水平 |
| \(z_t\) | \(N\times4\times H/8\times W/8\),带噪视频潜变量 | \(t\) 是扩散噪声阶段,不是视频帧编号 |
| \(\hat V\) | 解码后的完整视频 | 保留区一致性是学习目标,不是逐像素复制的硬保证 |
任务可以解释为从 \(p_{\theta}(V'\mid c_{\mathrm{ref}},c_{\mathrm{con}},c_{\mathrm{mot}},R)\) 采样。输出是 RGB 视频,不能直接转成材质节点图、分解后的光照、3D 运动或可编辑对象轨迹。第一帧怎么被改好不是本文算法的一部分;评价中使用的文本描述主要用于比较文本基线和 CLIP 打分,ReVideo 本身不需要生成式语言提示模板。
在代码坐标中,名字容易误导:s_h/e_h 对应横坐标 x,s_w/e_w 对应纵坐标 y;数组切片先 y 后 x。复现应根据实际切片和 README 的参数描述核对,不能仅凭变量后缀解释。
05 · SVD 潜空间扩散与训练目标
原式 1 把带噪潜视频、噪声阶段和参考图送入条件 3D UNet,预测干净潜变量:
参考图有两条路径:CLIP 图像编码器生成 token,经 cross-attention 注入语义;VAE 把参考帧编码为四通道潜变量,复制到每帧后,与四通道噪声潜变量在通道维拼接。所以 UNet 输入为 8 通道、输出为 4 通道,而不是把整段视频直接送进 CLIP。
原式 2 使用 EDM 预条件化,把网络残差与带噪输入混合:
这些系数调节不同噪声尺度下网络输入、输出及 skip connection 的数值范围;它们不是额外可自由预测的控制权重。原式 3 的 denoising score matching 目标为:
ReVideo 在三阶段中仍沿用去噪重建目标;其创新主要改变条件、训练样本分布和允许更新的参数,没有公开一个独立的轨迹监督损失、光流端点损失或 mask 外硬约束。
代码补充 配置实际使用 VScalingWithEDMcNoise,系数为:
负号来自该 v-prediction 预条件化实现;不能机械套用另一套 EDM 默认正号。Denoiser 将 \(c_{\mathrm{noise}}\) 传入网络和 SAFM,因此图 5 标注的 t=1000…0 是论文可视化语境,不应直接当作公开代码的原始整数时刻范围。Denoiser · scaling
06 · 从条件编码到多尺度控制
原式 4 概括控制分支:内容与运动编码为融合特征 \(f_c\),经零初始化卷积接入复制的 UNet 编码器,再把多尺度控制残差加回 SVD:
这是结构概括,不是逐张量逐层的唯一实现。源码先在输入卷积后加融合条件,再输出逐尺度 zero-conv 残差以及 middle-block 残差。基础 UNet 的下采样特征和中间特征接收这些残差;控制分支没有独立生成最终 RGB。
| 组件 | 公开配置 | 作用/边界 |
|---|---|---|
| SVD UNet | model_channels=320;channel_mult=[1,2,4,4];每层级 2 个 residual blocks;num_head_channels=64;transformer_depth=1 | 跨空间与跨帧建模,不是 Diffusion Transformer 大模型 |
| 注意力 | attention_resolutions=[4,2,1];context_dim=1024;linear transformer projection;xformers | 参考图 CLIP token 作为上下文 |
| 时间卷积/融合 | video_kernel_size=[3,1,1];learned_with_images;extra_ff_mix_layer=true | 时间模块与空间模块混合 |
| 运动编码器 | 2 通道输入;16→32→96→256;最终 320 通道 | 三个 stride-2 降采样,空间缩小 8 倍 |
| 内容编码器 | 3 通道输入;同样通道路径 | 代码名 mask_embedding 实际编码遮挡后的 RGB 视频 |
| SAFM | 编辑区掩码与广播时刻组成 2 通道;输出 320 通道 sigmoid 权重,再经 3×3 卷积 | 权重可依赖通道与位置,不仅是一个二维二值掩码 |
| VAE | 4 通道潜变量;scale_factor=0.18215;含 VideoDecoder | 公开推理逐帧 decode,降低显存但需核对时间解码上下文 |
| 其他条件 | fps、motion bucket、cond_aug 各 256 维,拼成 768 维附加条件 | motion bucket 不替代局部逐点轨迹 |
编码器在初始 3×3 卷积与最终 zero-conv 之间,每个尺度包含一次同通道 3×3 卷积及一次 stride-2 卷积;因此“3 个子块”不等于“总共只有 3 个卷积”。精确参数总量、各阶段可训练参数量与模型 checkpoint 到论文实验的逐项对应未公开核实,不能据 SVD 家族名称补造参数数。本文也没有正式的 base/large 变体对照。配置 · 模型结构
07 · 三阶段训练如何打断捷径
| 阶段 | 训练样本与目标 | 更新范围 | 步数 |
|---|---|---|---|
| 1 Motion prior | 正常视频,整段图像范围采样轨迹;先让稀疏运动条件可用 | 训练运动控制分支,保持基础 SVD 先验 | 40K |
| 2 Decoupling | 两个不同视频组成内外区域;参考帧与重建目标来自合成视频 | 从阶段 1 初始化,训练加入内容条件的控制分支 | 30K |
| 3 Deblocking | 恢复正常视频,以真实内外边界关系修复拼接伪影 | 控制分支及 SVD 的 temporal self-attention K/V,加 SAFM | 20K |
保留区域来自 \(V_1\),待编辑区域来自无关的 \(V_2\)。相同训练目标中,外部运动不再可靠地预测内部运动,迫使网络利用稀疏轨迹。这不是一个真实配对“编辑前/编辑后”数据集,也不是把两段完整视频做风格插值。

代价是边界分布不自然:对象可能被矩形硬切断,纹理、光照、运动都不连续。阶段 3 将正常视频分布重新带回,但若全部解冻,模型可能重新学习原来的捷径。只调时间自注意力 K/V 是在修复协调性与保留运动控制之间做经验折中。
解释而非证明 这种构造近似“干预训练相关性”,但不能保证任意内外条件在统计上独立,也没有证明得到可识别的因果因子。更严格的验证应比较多个随机种子、不同运动冲突强度和配对构造方案。
08 · SAFM 的空间门控与噪声阶段适配
原式 5 以 \(\Gamma\) 表示内容权重:
较大的 \(\Gamma\) 让背景内容主导;较小的 \(\Gamma\) 让运动控制主导。掩码告诉模块空间位置,噪声阶段告诉它当前去噪进程;模块在阶段 3 与 K/V 联合训练。论文观察到编辑区更偏运动,保留区更偏内容,且可视化随步骤变化。这种观察不表示网络被强制约束成对 t 线性的函数。

实现语义 源码以 w 代表运动权重:\(u=E_m(c_{\mathrm{mot}})\odot w+E_c(c_{\mathrm{con}})\odot(1-w)\),随后还有 conv_final。因而 \(w=1-\Gamma\) 才与论文内容权重对应。权重方向反转是记号差异,不是发现公式错了;额外卷积和多通道门控则是需要纳入复现的实现细节。
这里的“spatiotemporal”包含空间掩码与扩散阶段适配;视频帧间的动态关联同时由 UNet 的时间模块学习。不要把 SAFM 时刻输入误解为每个对象的真实世界速度或时间戳。
09 · 从跟踪点到可学习的运动条件
训练先用网格稀疏化初始点,再以 CoTracker 得到各点跨帧路径。为了避免被几乎不动的背景点支配,先筛出路径长度高于平均值的点,再按长度比例抽样 1–10 条轨迹。以下是对文字算法的显式数学化,原文没有给出这组编号公式:
轨迹落点写入其相对上一帧位移,第一帧为零;再用高斯核把稀疏点扩展为局部平滑场。写入的是运动向量而不是带颜色的轨迹示意线。若所有点静止导致筛选集合为空,训练端的回退策略、网格精确尺寸、遮挡过滤和重复采样约定没有公开训练管线可确认。

发布推理有两条路径:constant_motion 使用用户指定初始点调用 CoTracker2,保留原视频运动;single_region 和 multi_region 用起终点线性插值加周期偏移构造新路径。推理无需执行训练时的均值筛选和长度加权随机采样,这种差异是使用场景不同,不应误报成算法缺陷。
源码高斯核为 51×51、σ=10,核峰值为 1,未按核元素总和归一化。因此用普通 normalized Gaussian blur 替代,会改变轨迹信号幅度;该值是发布推理设置,论文未明确承诺训练使用同一核。
10 · 训练资源与尚未公开的设置
论文描述使用 WebVid 的 1000 万文本—视频对来源,但本文条件并不依赖文本输入。明确设置是 4 张 NVIDIA A100、每卡 batch 4、512×320 分辨率、Adam、总计 90K iterations、约 6 天。后两阶段随机选矩形区域,最小 64×64,并只在区域内采样轨迹。原文 §4.1
| 项目 | 可确认的信息 | 不能推出的信息 |
|---|---|---|
| 全局 batch | 4 GPU × 每卡 4,未额外积累时为 16 | 没有明示梯度积累设置 |
| 采样次数 | 按 batch 16 算,90K 步约 144 万 sample presentations | 不等于 144 万不同视频,也不是 WebVid 全量完整 epoch |
| 计算量 | 4 卡 × 6 天约 576 A100 GPU-hours | 不含数据下载、轨迹预处理、失败运行与全部消融;显存型号未注明 |
| 学习率 | 公开 inference YAML 有 base_learning_rate=3e−5 | 不能视为三阶段训练各自确认的学习率 |
| 数据划分 | 自行构建 16 视频测试集 | 训练可用子集、去重、过滤、验证集、训练测试泄漏检查未完整披露 |
| 优化细节 | Adam 与每阶段步数明确 | betas、weight decay、warmup、scheduler、混合精度、梯度裁剪、种子分布未确认 |
| 训练资产 | 模型与测试集入口公开 | 仓库没有完整三阶段 data loader、启动配置、阶段选择与冻结白名单 |
generic SGM 模块中存在通用训练方法,不代表已经发布可直接重跑 ReVideo 的训练脚本。正式版 checklist 对可复现细节给出 Yes,但实际复现仍需要这些缺失信息;本页将“作者自评”与“可核实资产”分开。
11 · 发布脚本的完整推理流程
- 按文件名排序读取输入帧,按约 1024² 像素面积缩放并对齐到 64 的倍数;截取前 14 帧。参考图被缩放到相同大小,RGB 归一化到 −1…1。
- 按同一比例缩放编辑矩形和轨迹坐标;保留运动时使用 CoTracker2,自定义运动时计算位移场。
- 高斯扩展轨迹;将待编辑区域的 RGB 置 −1,region 置 1;其余位置保留原视频。
- 编码参考帧:CLIP 语义与 VAE latent;再准备 fps、motion bucket、cond_aug 条件。
- 从四通道潜高斯噪声开始,执行 Euler EDM 采样;每一步经 SAFM、ControlNet 分支和基础 SVD 联合去噪。
- VAE 解码;截断到 0…1;保存有轨迹与无轨迹的帧及可视化视频。发布脚本未实现自动评分、重试、最佳候选排序或迭代编辑搜索。
| 设置 | 来源 | 真实含义 |
|---|---|---|
| 14 帧 | YAML 和示例 shell | 不是长视频一轮生成;ControlNet 内部 num_frames 也固定为 14 |
| 15 或 25 采样步 | 20 个示例中 17 个用 15 步;head6、head7、monkey 用 25 步 | 名字叫 DDIM,但 sampler 类实际是 EulerEDMSampler |
| 25/50 步 | 分别是 YAML 与 argparse 默认 | 示例显式步数会覆盖默认,不能混记为统一设置 |
| σ 最大 700,最小 0.002,ρ=7 | YAML 与 EDMDiscretization 默认 | 降噪 schedule;最终追加零噪声 |
| CFG 从 1 到 4 | LinearPredictionGuider | 沿视频帧序号线性变化,区别于 SAFM 沿扩散阶段变化 |
| seed=23,motion bucket=127 | 默认与示例 | 固定种子便于重复输入比较,不能代表论文统计稳定性 |
| cond_aug=0.02;decode chunk=1;FP16 | 单区/保留运动推理 | 多区脚本实际没有给 cond_frames 加这项噪声,尽管仍传递其数值条件 |
| 显存至少 20GB | README 的 768×1344 编辑说明 | 作者声明,没有在当前环境复测 |
CFG 可以写成 \(\hat z_k=\hat z_{u,k}+s_k(\hat z_{c,k}-\hat z_{u,k})\),其中 \(s_k=1+3k/(N-1)\)。源码的 conditional 与 unconditional 两路共享原视频、掩码、轨迹,只对参考图条件做置零处理;所以“unconditional”并非所有控制信号都关闭。
Euler 更新的解释式为 \(d_i=(z_i-\hat z_{0,i})/\sigma_i\),\(z_{i+1}=z_i+(\sigma_{i+1}-\sigma_i)d_i\)。默认 churn=0,没有额外随机扰动。该过程不做输入视频 DDIM inversion,也没有每步把保留区原像素强行粘回去。推理入口 · sampler
12 · 完整 Table 1 与实验实际证明了什么
下面保留 v1 Table 1 的全部 4 行与 5 项指标,并加入正式会议版新增的 Time 列。数字未取整改写;↑ 为越高越好,↓ 为越低越好。自动指标测试视频为 720×1280;时间列来自独立的 768×768、单 A100 测试,Pika 没有可比时间。
| Method | PSNR ↑ | Text Alignment ↑ | Consistency ↑ | Overall ↑ | Editing Target ↑ | Time ↓(正式版新增) |
|---|---|---|---|---|---|---|
| InsV2V | 29.77 | 0.2022 | 0.9808 | 10.2% | 5.1% | 132s |
| AnyV2V | 29.80 | 0.2143 | 0.9836 | 2.8% | 4.0% | 380s |
| Pika | 33.07 | 0.2184 | 0.9956 | 27.9% | 23.9% | — |
| ReVideo | 32.85 | 0.2304 | 0.9864 | 59.1% | 67.0% | 26s |
文字对齐是各帧与编辑描述的 CLIP cosine 均值;Consistency 是相邻帧 CLIP cosine 均值;PSNR 评价未编辑内容重建。人评让 20 位参与者对 16 个样本分别选出“整体质量最佳”和“编辑目标最符合”的方法。若每人对每样本每问题只投一票,则每个问题有 320 次选择,这是由协议推算,原文未公布逐票原始表。
- 对 Pika:Text Alignment 绝对高 0.0120,约相对提升 5.49%;整体偏好高 31.2 个百分点,编辑目标偏好高 43.1 个百分点。
- 代价:PSNR 低 0.22 dB,Consistency 低 0.0092。静态对象可能具有很高相邻帧相似度,所以一致性指标无法单独判断运动是否正确。
- 对 AnyV2V:PSNR 高 3.05 dB,编辑目标偏好高 63.0 个百分点;正式版时间 380/26≈14.62 倍。对 InsV2V 时间 132/26≈5.08 倍。
- 上述速度比仅对应作者的计时协议。帧数、预处理是否计入、服务端 Pika 成本、首帧编辑的人力时间未在同一表中完整控制。


Reviewer 视角 ReVideo 输入精确参考图与轨迹,Pika/InsV2V 主要接收文本;因此人评对实际工作流有价值,却不能将优势全部归因于融合网络本身。轨迹跟随没有报告 ADE/FDE、逐点误差或遮挡恢复率;16 个测试案例和缺少置信区间也不足以推出广泛的动作泛化结论。商业 Pika 的具体版本与采样日期未固定,结果不能外推到现时服务。
13 · 消融的证据链与缺口

| 消融 | 论文观察 | 能支持的结论 | 不能支持的结论 |
|---|---|---|---|
| 移除 SAFM,直接相加 | 波浪形复杂轨迹跟随变差 | 给定案例中自适应融合有帮助 | 没有数值误差,无法估计平均提升或最小必要容量 |
| SAFM 无时间条件 | 编辑边界出现不满意伪影 | 噪声阶段适配可能改善协调 | 未做不同时间编码、schedule 和随机种子的系统比较 |
| 阶段 3 更新全部控制模块 | 局部运动控制退化 | 过宽微调会损害阶段 2 先验 | 未证明所有全参数学习率或正则配置都失败 |
| 阶段 3 更新空间层 | 重新忽略运动条件 | 作者所测更新位置不理想 | 未验证 LoRA、梯度投影或其他子空间方案 |
| 只调控制分支时间 K/V | 复杂树干错位,头发与面部运动冲突产生伪影 | 同时调基础 SVD 的 K/V 有助于边界协调 | 只展示案例,没有基础模型更新量与性能曲线 |

此处没有隐藏的定量消融表。图 3、7、11 是原论文的关键消融证据,全部保留真实图;上表是分析性重组,不伪装成作者报告的数值结果。
14 · 附录中的扩展与失败条件
不规则与多区域编辑
虽然训练只采样矩形,附录展示手绘不规则 mask 仍可控制外观与运动;多区域案例也无需专门再训练。这说明模型可以在一些 mask 分布变化下工作,但没有对孔洞、复杂边界、密集多对象、遮挡交互数量做曲线测试。发布 CLI 提供单矩形和多矩形入口,没有现成任意 mask 图像参数;不能把论文能力直接等同于现成界面功能。


正式版新增的两类场景
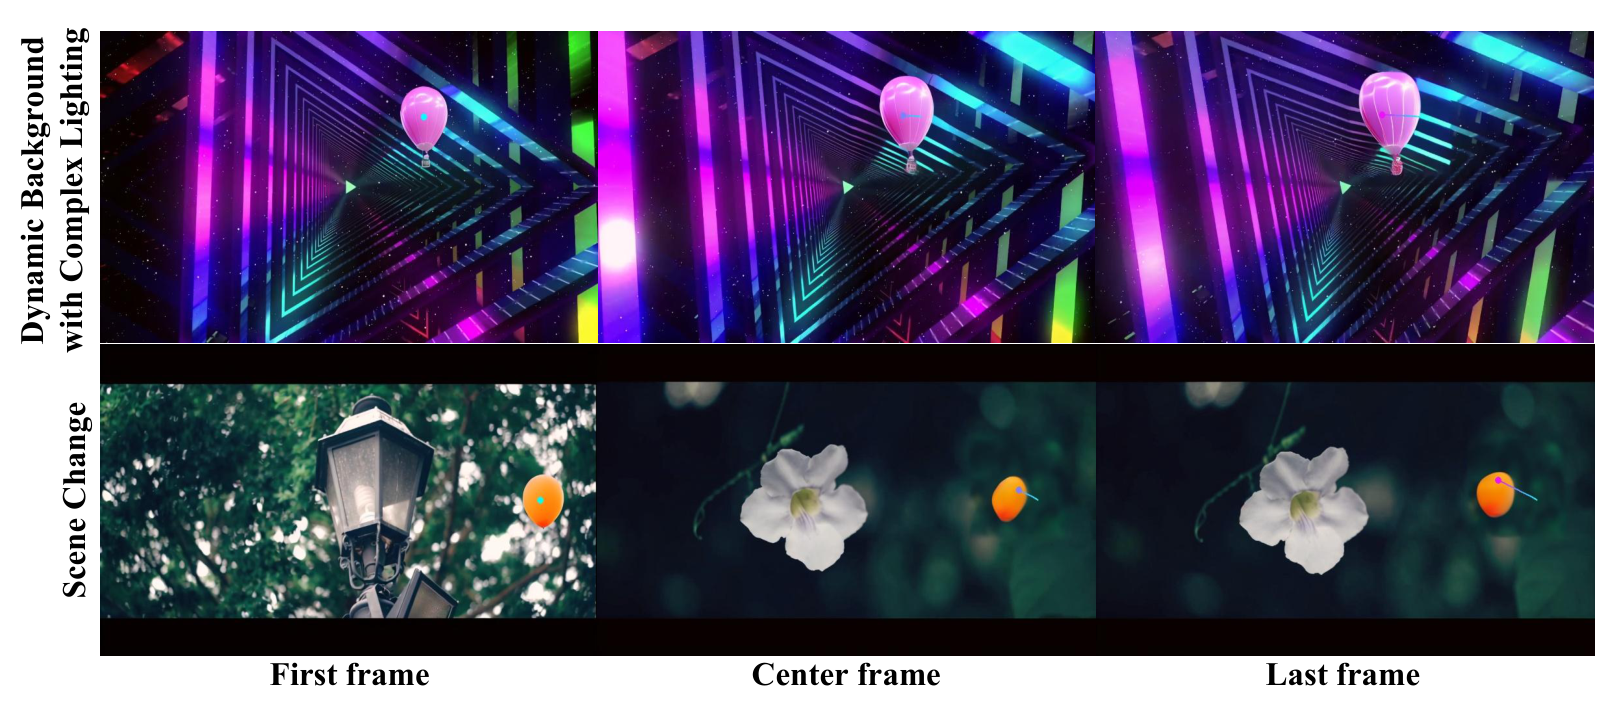
正式版 A.3 用空运动条件执行对象擦除,让背景线索推断待填区域运动;A.4 展示复杂光照/动态背景,并明确把场景切换造成的内容质量下降作为失败例。这也说明“依赖背景运动”本身不总是错误:需要改写运动时它是干扰,无显式运动指令的修补时它又是可用先验。
滑动窗口长视频
v1 A.6/正式版 A.8 将前一窗口最后编辑帧作为下一窗口参考图,展示 9 秒、90 帧视频,并承认误差积累。论文未给出精确窗口重叠、融合权重和停止修复规则;公开入口只截取前 num_frames 帧,没有完整滑窗实现。README 的 Open-Sora 合作预告与初步视频不能视为已发布、验证的长视频大模型版本。

Pika 五种随机种子检查
作者把文本一致性设置拉到最高,在“天空中添加飞机”的一个案例重试 5 个种子,仍失败。原图保留所有种子与界面。它减少了“只是某一次随机失败”的解释,但只有一个目标,不能据此断言 Pika 普遍不能添加物体,也不能推断现版本表现。

15 · 官方视频补充材料
正式补充 ZIP 包含 20 组原始/编辑对照,HTML 共引用 40 个视频位置,对应 39 个独立 MP4(sea2 原视频复用)。下方使用作者官方项目地址,保留全部对照;本次检查下载可达性、文件完整性与 ffprobe 容器元数据,未观看视频、未验收浏览器播放或视觉质量。原本的 ZIP 同时保留为离线证据。
视频只在点击时加载,避免一次加载所有动态资源。补充展示不是独立测试集的逐样本评分表;不能从这些精选案例反推出总体成功率。
16 · 论文与发布实现的关键差异
审计固定在 1746452 快照,同时比较首次代码释放后的历史。源码仅被阅读,没有导入会触发下载的推理模块,也没有执行外部项目代码。
| 检查项 | 证据与影响 |
|---|---|
| 训练未完整开放 | main 只有三个 inference 入口;无三阶段训练 recipe、数据混合 loader 或 temporal K/V 冻结白名单。通用 SGM 的训练类不能填补这部分。 |
| SAFM 权重方向 | 论文 Γ 是内容权重;代码 w 是运动权重,另有 conv_final。复现时先做补量对应,而不是直接把两个公式当作矛盾。 |
| mask 与 region | mask 键实际传入 RGB 遮挡视频;region 才是编辑区二值图。RGB 缺失区域为 −1,条件范围与论文简写乘法不同。 |
| 采样器名字 | ddim_steps 只是旧 CLI 命名;实际 Euler EDM。ddim_eta 和 n_samples 被解析,却未进入 sample 的有效采样逻辑。 |
| 固定 14 帧 | load_model 改写 sampler guider 的 num_frames,却没有同步改写 controlnet_config 的 num_frames;只改 CLI 帧数可能发生维度错误。滑窗需要额外实现。 |
| 轨迹边界与碰撞 | constant_motion 对轨迹落点做 clip;自定义路径直接用整数索引,没有同等边界检查。多点落在同一像素是赋值而非累计,可能覆盖运动;CoTracker visibility 输出未用于过滤。 |
| 可视化与控制路径错位 | 自定义位移 map 的区间数是 N−2;可视化另循环 N 帧,可能多走一次增量。应对照真正位移场核验端点,不应只看彩线。 |
| 多区域条件噪声 | 单区/保留运动给参考图加入 cond_aug 高斯噪声;多区将 cond_frames 直接设为参考图。这是脚本间实际差异,影响严格复现。 |
| 缩放与坐标 | 尽管有 resize 开关,代码固定执行面积缩放;输入帧按字典序排序,建议固定零填充文件名。不同大小帧的最后一帧比例可能被复用于全部坐标。 |
| 模型与路径 | model.ckpt 会在推理模块顶层自动下载;控制分支有独立 ckpt/model.ckpt 路径。自定义主 checkpoint 时需核对控制分支路径与 strict=False 缺失键日志。 |
| 测试集与权重 | 官方 Hugging Face 显示 model.ckpt、testset.zip;本次只读取元数据,没有下载或反序列化权重,未核实 testset.zip 与 16 个评测视频的逐项一致性。 |
| 许可证 | 仓库 LICENSE 和模型卡指向 SVD non-commercial community 条款。开源入口不等于不受限制的商业使用许可;本页只记录官方标注,不作法律结论。 |
以上风险是静态审计发现的复现注意项,未执行模型,因此不把潜在问题写成已复现的崩溃或已测得的质量下降。首次代码发布后的改动主要为 README、路径/参数说明,版本清单与逐文件哈希见随附 source-evidence。
17 · 严格 reviewer 的判断
值得肯定
问题定义实用:区域外保留、区域内外观与运动同时可控,比单纯全局风格迁移更接近编辑需求。toy experiments 排除了最简单的“多加一套分支即可”的解释,随后用训练数据构造处理条件竞争,方法动机与干预设计相连。正式版补充了速度、对象擦除、复杂场景与明确失败例;发布推理代码让架构和采样细节可以审计。
实验与论证仍不足
一是轨迹控制没有直接的定量度量。二是自动 CLIP consistency 奖励静态,PSNR 又不衡量物体运动自然度,三项自动指标不能覆盖任务核心。三是相同视频上 20 位参与者的选择并非 320 个独立视频样本,分析显著性需要考虑视频与参与者两层相关。四是消融多为单例,无法区分网络门控、阶段时长、优化设置之间的作用。五是训练集覆盖和滑窗细节缺失,使“代码公开”与“完整训练复现”存在距离。
正式版 checklist 的自评要与正文核对
作者明确对统计显著性回答 No。对理论假设与证明回答 Yes,却援引的是 toy experiment,不能把它当作数学定理证明。正文描述了 20 位志愿者的人评,而 checklist 的 human subjects/IRB 条目写 NA;这构成披露口径不一致,应请求说明研究设计、参与者指引与适用审查情况,不能据此推断已经违反某项制度。模型可修改人物视频,broader impacts 与 safeguards 的 NA 理由也偏弱,局部修改同样可能产生误导性内容。
可落地改进应优先补齐:轨迹 ADE/FDE 与遮挡分层、保留区 LPIPS 与边界接缝分数、同等输入信息的基线、训练冻结列表、数据/种子 manifest、多轮编辑和长视频漂移曲线、按视频 bootstrap 的区间。对于视频编辑,应保留原素材与编辑记录,避免把模型输出误当作真实事件证据。
18 · 对程序化材质与生成代理的研究启发
以下均为研究延伸,不是 ReVideo 已完成的实验
从视频运动解耦到材质属性解耦
材质编辑也可能出现密集外观压过稀疏参数指令的捷径。例如“只改粗糙度”与高光形状强相关,模型可能通过改光照或颜色实现图像相似。可以固定几何/灯光,对基色、粗糙度、法线、位移进行独立可执行干预,构造跨材质条件配对。与 ReVideo 拼接不同,材质组合必须通过 renderer 检验物理与图执行有效性,避免训练出不可能的 BRDF。
区域、节点与优化阶段三维门控
把 SAFM 扩展成依赖编辑区域、节点属性类型及优化阶段的门控,让高频法线、低频颜色和结构性位移获得不同权重。一个可研究的目标是:
这里 \(G,G'\) 是编辑前后程序图,\(\mathcal R\) 是固定条件 renderer,\(\mathcal C\) 是端口类型、可编译性与参数域约束。这个公式是建议的研究设计,不是论文的 DSM loss;仅比较最终图像还不足以排除通过错误物理属性作弊。
把有限解冻改为可执行的局部更新
阶段 3 只动时间 K/V 的思想可以迁移为“先学会编辑,再限制修复只动接口附近节点”。代理先提出局部子图替换,运行编译器与 renderer,观察边界、平铺和多光照指标,再选择修复节点。reasoning、action、observation 与 retry 应显式记录;不要把神经门控直接称为 agent reflection。
可检验的最小研究方案
- 先固定同一个材质图骨架与渲染器,比较混合训练、独立干预训练、三阶段训练;保持样本数和计算预算一致。
- 评估目标属性达成、未编辑属性泄漏、多视角/多光照一致性与接缝,不只报告 CLIP。
- 再开放局部拓扑修改,检查图合法率、外部 bitmap 依赖、节点预算和回退次数;否则无法确定收益来自控制解耦还是额外搜索成本。
- 对每次修复给定相同 renderer 调用预算,比较无门控、静态门控、阶段适配门控,并保留失败类型和种子。
最有价值的可迁移思想是主动破坏训练中的错误条件关联,并限制后续修复的更新范围;直接把视频 RGB 网络换名为程序化材质生成器,则没有解决拓扑、合法执行与物理一致性。
19 · 一手来源与阅读范围
- 用户固定 arXiv v1 PDF:17 页,完整正文、参考文献和 A.1–A.7,保留原文件 SHA-256 与标注锚点。
- arXiv 官方记录 与 实验 HTML:HTML 漏掉 teaser 且 figure 编号发生偏移,所以本页以 PDF 编号为准。
- NeurIPS 2024 proceedings、25 页正式 PDF 合订本、官方补充 ZIP:正文、A.1–A.9、checklist 均已读取;额外附录图与计时列单独标识。
- 作者项目页:作者角色、两张项目图及视频直链。
- 官方代码固定快照:配置、三个推理入口、控制网络、条件嵌入、EDM scaling、采样器和指导模块静态审计。
- 作者模型仓库:元数据 revision c6606345a8bb802f2f9e38e3148f4bf316c9017f;公开模型与测试集入口已定位,权重和测试包未载入。
本页所有原图和视频归作者及原素材权利人所有,研究评论与延伸单独标注。HTML 数学、资源下载/解码、表格与锚点完成静态检查;浏览器布局、MathJax 实际运行和视频播放验收按本次要求暂缓。未执行训练、推理、模型反序列化或用户库归档。