01 · 先抓住结论
RGB↔X 把室内图像的“拆解”和“合成”放进同一种条件扩散框架:RGB→X 估计材质、法线与光照;X→RGB 根据完整或缺失的属性图生成照片式图像。真正有用的设计,是允许数据和用户只提供一部分属性,而不是要求每张图都有完美的全套物理标签。
最值得借鉴的机制:分解端保留 Stable Diffusion 原本四通道的去噪 latent,用文字作为输出任务开关;合成端把各条件图接入输入通道,并用 channel dropout 学习条件缺失。两个模型共享建模思想,但使用分别微调的网络权重,不是一个自动双向可逆的网络,也没有论文所述的联合循环一致性训练。[P §§4–5]
| 问题 | 本文支持的答案 | 边界 |
|---|---|---|
| 能否更好地拆解室内图像? | Table 2 的四个有可比 baseline 的通道,PSNR 与 LPIPS 均领先所列方法 | 测试集规模、采样选优和完整评测脚本没有给足;真实照片主要是定性展示 |
| 能否从不完整 X 生成图像? | Figures 5–7 展示全通道、部分通道、文字控制与局部编辑 | 没有 X→RGB 的大规模数值表、用户研究或物理一致性误差统计 |
| 能否直接变成可复用 PBR / 程序材质资产? | 提供可解释的屏幕空间属性估计与编辑接口 | 没有 UV、完整几何、材质节点图或程序输出;跨视角和光照变化仍需独立检验 |

复现前最重要的提醒:官方 README 承认,论文使用的 roughness / metallicity 联合打包预测 checkpoint 已遗失;公开 demo 使用分别预测的 checkpoint。本文保留论文结果,同时单独审计公开实现,不能把 demo 的输出或设置追认成论文原始实验。[C README]
02 · 身份、版本与阅读范围
正式论文为 RGB↔X: Image decomposition and synthesis using material- and lighting-aware diffusion models,作者依次为 Zheng Zeng、Valentin Deschaintre、Iliyan Georgiev、Yannick Hold-Geoffroy、Yiwei Hu、Fujun Luan、Ling-Qi Yan、Miloš Hašan。出版于 ACM SIGGRAPH 2024 Conference Papers,Article 75,正式 bibliographic 页数 11,DOI 10.1145/3641519.3657445;arXiv 2405.00666v1 提交于 2024-05-01。[O][A]
本次阅读固定用户已有 PDF,SHA256 为 026c4102aa224fb89a8880987c6f604114a6b926adcfc6d1d5f67d688b18b36e,共 13 页:前 11 页包含正文、参考文献与附录 A–C,后两页是失败案例及多输出消融。它与下载的 arXiv v1 文件字节不同;逐页文本经 Unicode / 空白规范化并移除第一页 arXiv 印记后核对,不以新下载文件替换原 PDF。项目页 PDF 也是 13 页,经过 Ghostscript 重制,字节亦不同。
作者信息以论文第一页为准:Zheng Zeng 同时列 Adobe Research、University of California, Santa Barbara,前者列在前;Ling-Qi Yan 列 UCSB,其余作者列 Adobe Research。论文没有明确通讯作者标记,因此 Miloš Hašan 仍只能作为末位作者候选,不能因名单位置改成 verified。原笔记的全部文字、metadata、BibTeX 与 PDF++ anchors 原样保留,核实后的补充只追加。
阅读包含完整固定 PDF、全部 11 幅编号图、两张原表、官方项目页、官方仓库及三个模型的配置。另一个独立 supplementary ZIP / video archive 为 438 MB,下载出现 Google Drive 无法病毒扫描的确认页;本次没有接受该警告,也没有下载或审阅该独立包。这里的“附录完整”只指固定 PDF 中的附录,不包含未读压缩包。浏览器布局与 MathJax 实际渲染验收按约定留待本地下载后,本轮做静态检查。
03 · 为什么要把分解和合成放在一起
同一张照片里的暗色区域可能来自深色材质、阴影、遮挡、低照度,也可能混入镜面反射。逐像素回归在这种多解问题中容易把多个合理解释平均,得到带阴影的 albedo 或过度平滑的几何。扩散模型的价值在于利用强图像先验,采样一个结构完整、语义合理的解释;这仍然是先验约束下的猜测,不会消除信息论上的歧义。[P §§1–2]
另一端,传统渲染要求完整三维场景:可见和不可见几何、光源、材质、遮挡及反射路径。这里的 X 只是当前视角的属性图,即使五类属性都齐全,也不足以唯一地执行物理渲染。X→RGB 因而需要补全缺失的光传输和外观。它位于精确但输入繁重的物理渲染与自由但控制有限的文字生成之间:用户指定部分属性,其余由模型先验补齐。[P Appendix A]
相关工作究竟差在哪里
- Zhu et al. 2022b:基于室内数据的逆渲染方法,属于本文重要比较对象;与本文的生成式属性预测不同,论文将其不足部分归因于非生成模型与数据限制,但没有用同数据同预算实验完全隔离这两个因素。
- Kocsis et al. 2023:已经使用 intrinsic image diffusion;因此“用扩散预测材质”不是本文新发明。本文新增异构多源训练、更多通道和逆向合成,并比较多输出 latent 与逐任务切换。
- Careaga and Aksoy 2023:针对 intrinsic albedo / shading 的专门方法;它在真实旧木地板上更好地保留磨损,是本文自己承认的反例。
- PVT-normal:作者使用的内部法线模型,基于 Pyramid Vision Transformer,训练域更广。这里的室内测试胜出不能推广为所有图像上的法线 SOTA。
- Deep Shading / Deep Illumination:同样学习屏幕空间光照或着色,但任务、训练条件和泛化范围不同。本文也不宣称已完整解决单图重打光。
研究假设:保留预训练去噪任务的形状和输出空间,比把所有属性同时挤进扩张后的 latent 更容易迁移;让模型训练时看见条件缺失,能同时解决异构数据利用与测试时部分控制。这些假设的证据强弱不同,后面的消融与 reviewer 部分分别评价。
04 · X 的物理含义与不完整性
| 符号 | 尺寸 / 定义 | 实际意义及注意事项 |
|---|---|---|
| RGB image I | H × W × 3 | 分解输入,或合成目标;公开代码在网络前使用近似 linear RGB |
| Normal n | H × W × 3 | camera-space 法线,不是 tangent-space normal,不包含完整深度或遮挡后几何 |
| Albedo a | H × W × 3 | 电介质不透明表面的 diffuse albedo;金属表面的 specular albedo / base color |
| Roughness r | H × W | 通常为 GGX / Beckmann 微表面分布参数 alpha 的平方根;高值更哑光 |
| Metallicity m | H × W | 电介质与金属模型之间的线性混合权重,不是金属元素的真实比例 |
| Irradiance E | H × W × 3 | 表面接收的 cosine-weighted 半球入射光积分;本论文唯一显式光照属性 |
| VAE encoder / decoder | 记为 \(\mathcal E,\mathcal D\) | 和 irradiance E 区分;把三通道图编码为四通道 latent |
| Text encoder | \(\tau\) | RGB→X 是任务标签;X→RGB 是一般场景 / 风格 / 光照语言条件 |
为解释物理差异,可把 irradiance 写成下式。这是本文文字定义的数学展开,不是新增的训练 loss:
它把所有方向的入射光压缩成每像素三个数,所以方向分布不同的光照可以有相同 E,却在光滑金属上产生完全不同的高光。对理想 Lambertian 不透明表面,常见辐射度约定下有:
这是用于理解的物理近似,不代表作者公开数据都采用同一曝光、单位和归一化,也不能用它直接处理镜面、玻璃、金属或遮挡变化。本文 qualitative 的 irradiance 对比也说明可以只匹配到全局缩放。把预测 E 当绝对 HDR 光度测量是不成立的。[P §3.1, Fig.3(b)]
作者没有加入 depth,理由是 normal 已提供更多局部高频变化,并可用于估计 depth。解读:法线积分仍涉及相机模型、尺度、边界、不可积场和不可见面,不能由此推论完整几何已恢复。玻璃也不由这些参数完整表示:论文把玻璃的 r、m 置为零,靠上下文生成透过玻璃的东西,而不是估计折射率、厚度和真实透射。
因此 RGB→X 生成的是当前视角、当前曝光和先验下的属性解释。同一张图的五次预测也没有显式联合物理约束;它们可能各自合理却互相不完全一致。这是把它接入程序材质生成时最先要补的缺口。
05 · 异构数据如何组成训练集
| 数据集 | 图像数 | Albedo | Normal | Roughness | Metallicity | Irradiance |
|---|---|---|---|---|---|---|
| InteriorVerse | 50,097 | ✓ | ✓ | △不完全可靠 | △不完全可靠 | ✗ |
| Hypersim | 73,819 | △不完全可靠 | ✓ | ✗ | ✗ | ✓ |
| Evermotion | 17,000 | ✓ | ✓ | ✓ | ✓ | ✗ |
| ImageDecomp | 50,000 | ✓(估计) | ✓(估计) | △估计且不完全可靠 | △估计且不完全可靠 | ✓(估计) |
原表的绿色勾、红色叉、橙色勾不能全转成“有标签”:InteriorVerse 的 r / m、Hypersim 的 albedo,以及 ImageDecomp 的 r / m 被标为不完全可靠。上表用文字显式保留这种差别。ImageDecomp 所有 X 都是模型估计,不是真实 ground truth;其中绿色也只表示作者认为较可靠。[P Table 1, §3.2]
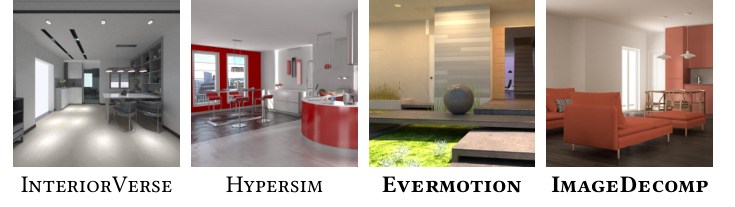
四种数据分别补什么
- InteriorVerse,50,097 图:提供 RGB、n、a、r、m,但原始渲染有噪声。对 X→RGB,作者先用 NVIDIA OptiX denoiser 清理 RGB,以免生成器模仿噪声;r / m 标签被认为可疑,正文明确决定不使用它们。缺少 irradiance。场景、材质多样性较低,例如绿色与植物高度相关,模型可能把绿色墙面生成叶片纹理。
- Hypersim,73,819 图:提供 RGB、n、a,特别重要的是 irradiance;缺 r / m。部分 albedo 混入 specular shading,作者仍认为总体可用。它扩展场景多样性,但单靠这些 synthetic 数据还不足以达到理想照片感。
- Evermotion,17,000 图 / 85 个室内场景:作者渲染艺术家制作的场景,在预先记录的相机路径上随机采样视点;其核心价值是较可靠的 r / m。这不是 17,000 个独立场景,视点间相关性和按场景切分的细节会影响泛化评估。
- ImageDecomp,50,000 图:高质量商业室内照片或渲染,只含 RGB。先用 RGB→X 预测整套 X,再把 RGB 与伪标签配对训练 X→RGB;不用于反过来训练 RGB→X。它提升合成端的真实感,同时把分解器偏差传给合成器。
Appendix B 指定:RGB→X 使用前三种数据;X→RGB 再加入 ImageDecomp。前者涉及的原始图像数简单相加为 140,916,四源合计为 190,916;这只是表内库存求和,不是作者公布的去重后训练集大小、独立场景数或 train split 大小。因为分解时一张图能产生多个可用通道样本,实际优化样本数又不同。数据源采样概率、通道采样比例、dropout 概率、过滤清单和 test split 大小都没有完整公开。
文字标签与训练顺序
为保持 X→RGB 的语言控制能力,作者使用 BLIP-2 为各源 RGB 预生成 image caption。BLIP-2 只用于数据准备,不在每个去噪步骤里调用。RGB→X 的条件文字则是固定任务名称;不能把其论文中沿用的“computed for I”措辞理解为每次分解都要生成描述照片的 caption。[P §3.2 end, §4]
可重建的训练顺序是:整理可靠标签与去噪 RGB → 微调 RGB→X → 为商业 RGB 生成伪 X → 组织四源数据与 caption → 微调 X→RGB → 在该合成器上做 inpainting 微调。论文没有提供 Evermotion 原始商业场景、ImageDecomp 全数据及完整训练管线的公开下载与脚本,因此“有推理仓库”不等同于“数据和训练端到端可复现”。
06 · RGB→X:文字开关与保持四通道输出

给定一张 RGB 图 I,先用冻结的 SD VAE encoder 得到条件 latent;每次挑一个目标属性 g,以其任务标签为 CLIP context。目标图编码后加噪,条件 RGB 不加同样的扩散噪声,两者在通道维拼接进入 U-Net。不是在 token 序列中拼图,也没有额外 ControlNet。[P §4, Fig.2]
这里 \(\bar\alpha_{t}\) 是到 timestep t 的累计信号比例,训练时 t 均匀采样;z 是 VAE latent,不是原始属性像素。原文 Eq.1 的 v target 为:
Eq.2 将目标 v 与模型预测对齐。此处用 concat 明写 PDF 中不容易看清的拼接,期望符号用于表达训练样本平均:
v 不是物理速度,也不是 normal vector;它是噪声与干净 latent 的旋转式参数化。把上面两个定义联立即得:
这解释了 sampler 如何使用 v prediction 恢复去噪方向。代码变量仍叫 noise_pred,但 scheduler 配置为 v_prediction,不能仅凭变量名把目标误写成 epsilon loss。论文说 v 比 epsilon 更好,却没有数值对照表。
为什么不一次生成五类 X
标准 SD 的一个四通道 latent 解码为一张三通道图。若把五类属性的 latent 一起扩展,去噪 U-Net 的输入与输出卷积都要适配,预训练模型原来的输出任务被改变;同时不同数据源缺不同标签,简单屏蔽缺失项的 loss 在作者实验中效果差。本文保持输出头四通道,按任务反复调用同一组权重,以更接近预训练的方式学习五个条件分布。
注意用户旧笔记的一处表述:“需要重新 train from scratch”只适用于新扩张的输入 / 输出层或新增权重,而不是整个预训练 U-Net 必须从零训练。RGB→X 自身也扩张输入以接纳条件 RGB,但保留了原来的输出 latent 空间。模型“shocked”是作者的解释性说法,消融没有测量优化景观或严格因果机制。
当前公开模型的形状可由配置核对:RGB→X U-Net 输入 8、输出 4;在 512 × 512 输入下,VAE 空间缩小为 64 × 64,即四通道 noisy latent 加四通道 RGB latent。各任务循环采样,完整五类 X 的默认公开 demo 需要五次各 50-step 去噪,共 250 次 U-Net 评估(不启用 CFG),并非一次 50-step 就联合输出全部属性。
07 · X→RGB:缺失条件、粗光照与合成自由度
合成端目标是 RGB 的 latent,输出维度天然保持 SD 的四通道。普通文字提示通过 CLIP cross-attention 进入 U-Net;属性图作为额外输入通道。所有属性可选,缺了某个属性,模型就从先验中补它,而不是让缺失项变成错误的全黑材质。[P §5]
上式忠实对应论文 Eq.3 的初始抽象写法。它的 t 下标不表示条件本身也在反向扩散;紧随其后的 low-resolution lighting 段落实际上将 irradiance 的 VAE 编码替换为直接低分辨率采样。代码也确认了这个特例,不能停在 Eq.3 就说所有 X 一律过 VAE。
这里用独立参数 \(\phi\) 区分第二个模型;论文在文字中继续用 theta,不代表两方向权重共享。训练调优 U-Net,新的条件输入卷积权重需要初始化;论文没有提供参数总量、所有层的精确冻结清单或初始化脚本,不能声称使用 LoRA。公开 pipeline 继承 LoRA loader 仅是库接口,并非训练采用 LoRA 的证据。
channel dropout 的逻辑
Eq.6–7 表示有标签时可随机保留或丢弃、无标签时置零。它不是 Bernoulli 概率的完整定义;论文没有给各通道的概率、是否独立抽样、全空概率和文本 dropout 细节。五种属性理论上有 32 种子集,包括空集,但 Figure 6 并没有逐一评测全部子集。“任何子集都能输入”是架构能力,不能直接等同于所有子集都有同等质量。
公开实现的真实条件 tensor 可写为:
各项仍按是否缺失整体置为 latent 零块。四张属性各四通道,irradiance 三通道,条件共 19 通道,加 noisy RGB 的四通道后 U-Net 输入为 23。条件顺序在当前代码固定为 albedo、normal、roughness、metallic、irradiance,和论文概念式的书写顺序不同;自定义调用应保留槽位顺序,只把缺失值设为 None,不能简单把该槽位从列表中删除。
为什么故意降低 irradiance 分辨率
完整分辨率 E 含有细法线和原有阴影痕迹。如果编辑沙发细小凹凸,却还用原始精细 irradiance 作为硬条件,会把旧光照细节锁死。作者将其直接降到 latent 尺寸,作为低频 lighting hint,让新 normal 细节和扩散先验重新决定高频阴影。公开代码用 bilinear、antialias=True,512 像素时光照条件约为 64 像素。它并不保证只保留物理上恰当的信息,也会丢掉用户希望精确保存的硬阴影。
给更多 X 一般收紧生成空间,但各条件可能冲突;给更少 X 增加自由度,也更依赖数据先验。Figure 5 的暗金属炉灶被生成成较亮铝材,正好说明模型可以服从 metallicity 而牺牲指定 albedo。这是软条件生成,不是严格约束求解器。
08 · 训练配置与可复现缺项
| 项目 | RGB→X | X→RGB / inpainting |
|---|---|---|
| 预训练基础 | Stable Diffusion 2.1 | Stable Diffusion 2.1;inpainting 在合成模型上继续微调 |
| 数据 | InteriorVerse、Hypersim、Evermotion | 前三种 + ImageDecomp;inpainting 数据/掩码分布未完整说明 |
| 优化器 | AdamW | AdamW |
| learning rate | 1e−5 | 1e−5;inpainting 是否完全沿用未单独列 |
| batch size | 256 | 256;global / per-device 分配未给 |
| 训练图像 | 随机裁剪 512 × 512 | 随机裁剪 512 × 512 |
| 水平翻转 | 不使用,避免破坏 camera-space normal | 不使用 |
| 训练耗时 | 约 100 小时 | 约 100 小时;inpainting 约 20 小时 |
| 硬件 | 8 张 A100 | 8 张 A100 |
| 扩散训练目标 | v prediction,latent L2 | v prediction,latent L2 |
| 缺失数据处理 | 只选择可用且可信的目标通道 | 缺失条件置零,已有条件也做 dropout |
| 未报告 | 总 step / epoch、Adam betas、weight decay、LR schedule、warmup、gradient accumulation、precision、EMA、seed、各源权重、各通道采样率 | 上述各项,另有 dropout 概率、caption dropout、inpainting 掩码采样细则与全部超参 |
若按 8 GPU 全程运行粗算,两大模型各约 800 A100 GPU-hours,inpainting 约 160,共约 1,760 GPU-hours。这是由论文壁钟和设备数推算,不是作者测量的费用,也未计数据渲染、BLIP-2 caption、RGB→X 伪标注、消融或失败试验。不能把 100 小时等同于 100 epochs;100 epochs 只出现在 Figure 9–10 的扩张 latent 消融描述里。
VAE encoder 明确冻结;预训练 decoder 用于解码各属性。正文没有说每个 batch 同时训练两个方向,也没有 cycle loss、renderer-in-the-loop、物理 BRDF loss 或 normal integrability loss。全文唯一主要训练监督是正确模态的 v target。公开仓库的树只含推理/demo/预处理和样例,未见训练脚本、数据加载器或 Table 2 评测实现。
水平翻转问题的正确理解
论文采取“不翻转”的简单选择。更一般地,若对图像作水平翻转,同时对 camera-space normal 的水平分量取反并正确重排像素,可以构造几何一致增强;这是可研究的改进,非作者实验结论。直接把法线颜色图当 RGB 随机翻转,会把几何方向变错。
09 · 推理步骤、CFG 与公开参数
论文所有结果用 DDIM 50 steps,遵循 Lin et al. 的建议避免曝光偏差,训练 512 × 512 但测试可到 1080p;超过 2K 时质量下降。RGB→X 不用 CFG,因为作者观察其损害质量;X→RGB 用类似 InstructPix2Pix 的双条件 CFG。Appendix C 却笼统说“CFG 在我们的情境中不起作用”,与 Appendix B 的 X→RGB 使用描述存在措辞冲突。合理的保守做法是逐方向记录:分解端关闭,合成端启用;不能把 C 的一句话扩展成全系统不用 CFG。[P Appendix B–C]
公开 demo 的分解流程
- 读取照片:LDR 按 2.2 次幂近似从 sRGB 转 linear;EXR 使用曝光调整后截断到有效范围。
- 将最长边设为 1000,再将两边向下取 8 的倍数。注意即使输入本来较小也会被上采样,而不是仅“大图降采样”;输出最后 resize 回原图大小。
- 建立一个 CUDA 随机数 generator,以 seed 初始化;依次对五个任务、各 sample 调用同一分解模型。generator 会前进,各属性并不重用同一份初始噪声。
- DDIM 迭代默认 50 步。模型用 clean RGB latent 条件预测 v,sampler 更新 noisy 属性 latent;最终 VAE decode。
- albedo 与 irradiance 做显示 gamma;roughness / metallic 只取解码结果第一通道再重复为三通道灰度。此包装输出是图像,不自动提供物理单位。
| 输出属性 | 论文 §4 | 公开 demo 固定 prompt |
|---|---|---|
| Albedo | albedo | Albedo (diffuse basecolor) |
| Normal | normal | Camera-space Normal |
| Roughness | roughness | Roughness |
| Metallicity | metallicity | Metallicness |
| Irradiance | irradiance | Irradiance (diffuse lighting) |
这些文本是任务选择器,没有 user/system/few-shot agent prompt。required_aovs 主要还控制后处理和条件槽位;分解调用若把文本和该列表写成不一致,代码没有自动判断语义匹配。正文五类通道叙述也与 README 所述论文 r/m 打包版本不完全一致,应以实际 checkpoint 和论文披露共同解释。
公开合成 CFG 的三个分支
实现将三组输入 batch 拼在一起:文字 + X、空文字 + X、空文字 + 零 X。以 \(\hat v_{p,X}\)、\(\hat v_{\varnothing,X}\)、\(\hat v_{\varnothing,\varnothing}\) 表示对应预测:
demo 默认 text guidance 7.5、image guidance 1.5,guidance rescale 0.7;直接调用 pipeline 的函数默认 guidance 却是 0.0 / 0.0。因此“用默认参数”要说明默认在 UI 还是 API 层。合成 CFG 的开启条件是两个 scale 都至少 1.0;只把其中一个调低会关闭整段 CFG,而非单独去掉一项。50 步对应三分支的约 150 个单样本等价 U-Net 预测,实际以 batch 合并,不是实测运行时间。
三种 demo 均显式把 scheduler 覆盖为 zero terminal SNR rescaling + trailing timesteps;模型文件里的配置原本写 rescale=False、spacing=leading。保持模型库 config 而漏掉 demo 的覆盖,会改变采样。eta=0 是 pipeline 默认,但初始噪声仍由 seed 决定。论文没有报告推理秒数、显存测量或吞吐量;仓库仅推荐 NVIDIA GPU、至少 12 GB 显存。[C three demos / pipelines][H configs]
10 · 局部编辑和对象插入的真实操作
原始 X→RGB 可以改整张图,但局部换材质需要保留未编辑区域。作者在该模型输入上增加 masked image 的 latent 与下采样 mask,再微调一个 inpainting 版本。公开配置为输入 28、输出 4:原有 23 通道加四通道 masked RGB latent 和一通道 mask。[P §5, §6.3]
- 先分解:从 RGB 得到 n、a、r、m、E;选一个合理样本并明确哪些属性需要编辑。
- 改属性:红色沙发例子改变 albedo 和 normal;木地板例子先改变 normal 产生木板几何,再加木色 albedo。
- 选生成区域:inpainting mask 应覆盖受影响区域,包含可能变化的阴影或颜色溢出。Cornell box 的蓝墙案例把 mask 扩大到会发生 color bleeding 的右侧盒子。
- 合成:把编辑后的属性和未遮挡 RGB 条件送入 inpainting 模型,生成局部内容与光照效果。
- 后期融合:对象插入使用比生成 mask 更紧的 final blend mask 与原图融合,不能省略这一步就声称整个背景严格不变。
对象插入还有一个外部步骤:先渲染新物体的 intrinsic buffers,再合入照片估计出的 X。本文没有从文字自动产出新对象几何,也没有把完整多次散射求解写进 inference。Figure 1 的雕塑、咖啡车能看起来融入环境,证明的是该例子的视觉可行性。
公开 mask 约定需格外小心
demo 先把输入 mask 反转,即上传 mask 的白色区域表示编辑,内部 mask 白色表示保留;masked photo = photo × 内部 mask。pipeline 又把各 X 乘以“1 − 内部 mask”,只保留编辑区域的属性条件。它随后生成 RGB 并返回 masked-photo / photo 的 VAE 重建诊断图,代码里没有执行论文展示的更紧 final blend。若误把两种 mask 方向混淆,会遮住相反区域;若把返回的 photo 重建当原始照片,也会无意引入 VAE 重建误差。[C inpainting]
上式解释公开脚本的计算约定,不是作者正式发布的 mask-generation 算法。若想保证编辑区外像素完全相同,最后显式使用保留 mask 合成,并检查阴影边界是否被切断。
11 · 全量结果表与指标应如何读
Table 2 是全文唯一的性能数值表,全部评估 RGB→X。Albedo、Normal、Irradiance 来自 Hypersim test;Roughness、Metallicity 来自 Evermotion test。数据源规模见 Table 1,但 Table 2 没给 test 图像数,也没有公开精确按场景 split 列表、随机 seed、置信区间与量化采样筛选规则。[P Table 2, §6.1]
| 方法 | PSNR ↑ | LPIPS ↓ |
|---|---|---|
| Our RGB→X | 17.4 | 0.18 |
| Zhu et al. 2022b | 11.7 | 0.54 |
| Careaga and Aksoy 2023 | 13.5 | 0.34 |
| Kocsis et al. 2023 | 12.1 | 0.41 |
| 方法 | PSNR ↑ | LPIPS ↓ |
|---|---|---|
| Our RGB→X | 19.8 | 0.18 |
| Zhu et al. 2022b | 16.5 | 0.45 |
| PVT-normal | 18.8 | 0.30 |
| 方法 | Roughness PSNR ↑ | Roughness LPIPS ↓ | Metallicity PSNR ↑ | Metallicity LPIPS ↓ | Irradiance PSNR ↑ | Irradiance LPIPS ↓ |
|---|---|---|---|---|---|---|
| Our RGB→X | 11.2 | 0.52 | 12.1 | 0.44 | 14.1 | 0.22 |
| Zhu et al. 2022b | 4.4 | 0.77 | 2.22 | 0.82 | N/A | N/A |
| Kocsis et al. 2023 | 10.3 | 0.57 | 8.63 | 0.75 | N/A | N/A |
原表两组并排布局在此拆为三个易读表,所有方法、所有指标和 N/A 都保留;28 个实际数值均可与固定 PDF 及 arXiv HTML 逐项交叉核对。Irradiance 的 baseline 空缺不是对方得分为零,作者没有证据声称其超越已有 irradiance 方法。
| 通道 | 对照 | PSNR 增加 | LPIPS 减少 | 相对减少 |
|---|---|---|---|---|
| Albedo | Careaga and Aksoy | 3.9 dB | 0.16 | 47.1% |
| Normal | PVT-normal | 1.0 dB | 0.12 | 40.0% |
| Roughness | Kocsis et al. | 0.9 dB | 0.05 | 8.8% |
| Metallicity | Kocsis et al. | 3.47 dB | 0.31 | 41.3% |
PSNR 是对数尺度,不能把增加 3.9 dB 写成“提升 28.9% 的质量”。若像素范围和计算方式相同,3.9 dB 对应 MSE 约下降 59.3%;这只是 PSNR 定义带来的数学关系,不是独立的物理材质恢复证据。
Normal 采用 PSNR / LPIPS,而不是常见角度误差、角度阈值成功率;Metallicity 的感知图像距离也不直接等价于 BRDF 分类正确率。论文未详细规定这些通道的颜色空间、尺度对齐、法线归一化、HDR 曝光及 LPIPS backbone。要重现具体小数点,必须补齐评测协议,不能直接调用任意现成指标。
公平性与采样选择
作者明说正文挑一个样本展示,不推荐把多样本均值作为预测,因为它会模糊细节。albedo、lighting、normal 通常可用;r / m 因训练数据少和固有歧义,样本方差更大,需要更多筛选。但没有给“挑选一个”的候选数量、人工评分标准或 Table 2 是否也选优。应将展示样本选择与数值评估协议未充分披露分开,不能武断断言数值表造假或 best-of-N。
另一个可见差异是 Zhu et al. 默认 320 × 240,本文可运行更高分辨率;PVT-normal 训练范围广,本文专精室内;本文额外使用 Evermotion 等数据。主表是系统级对比,不是控制数据、分辨率和计算预算后的架构因果比较。
12 · 分解图像逐项读
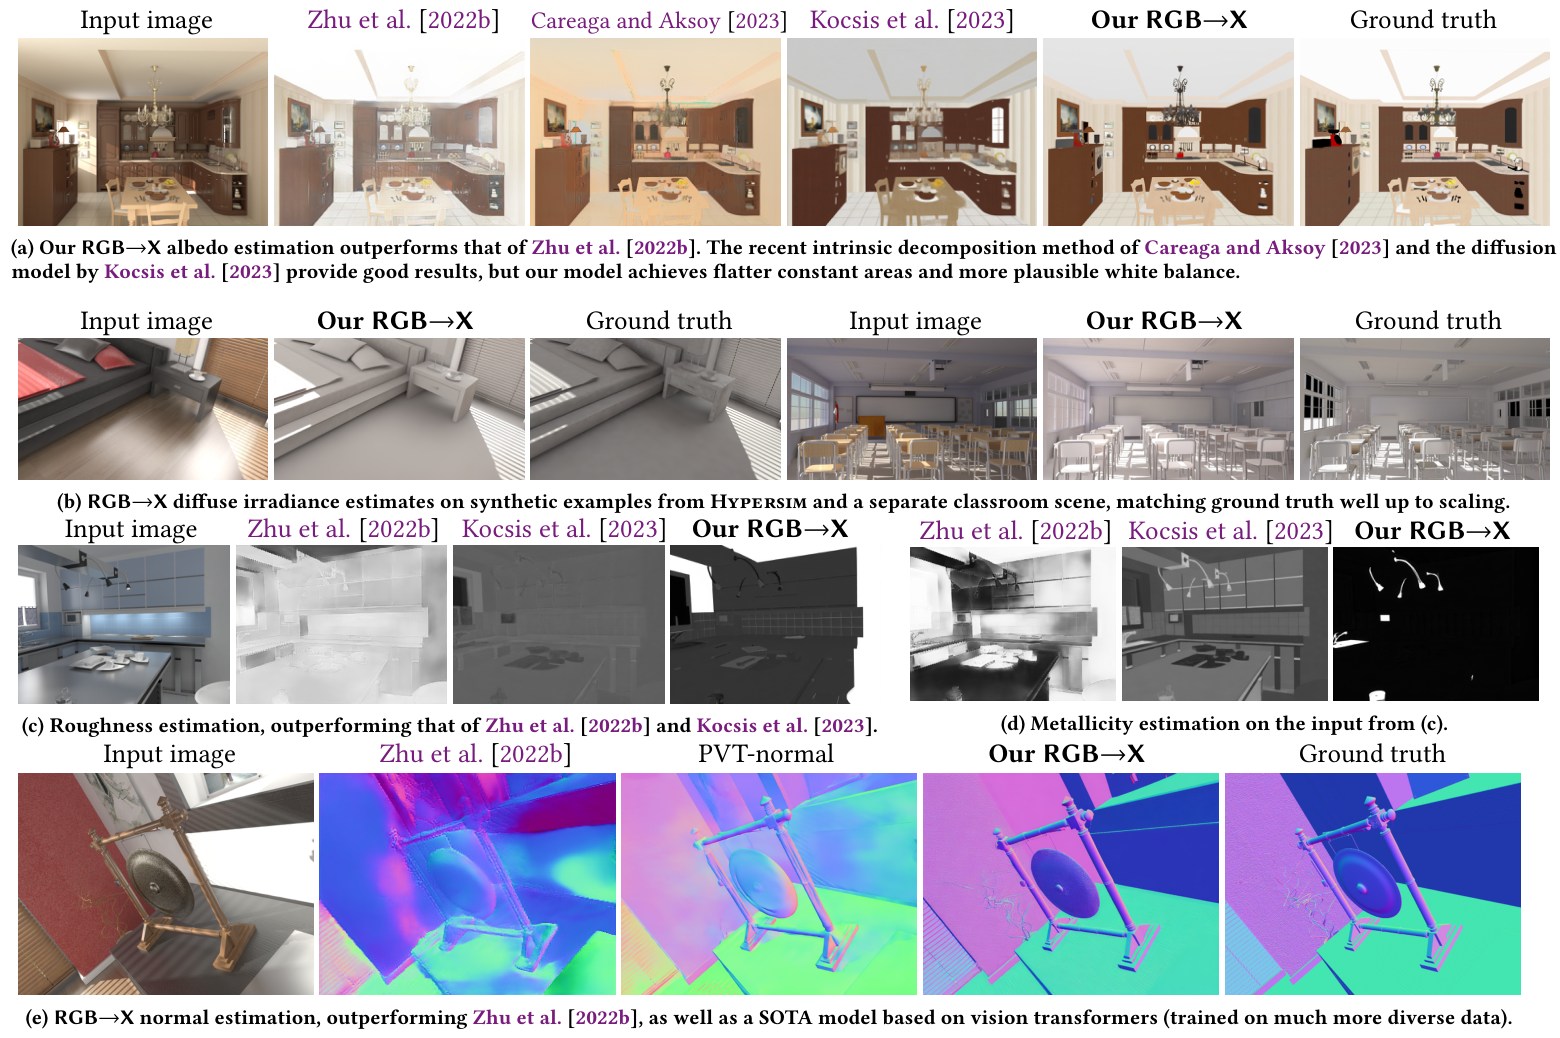
Figure 3(a):synthetic albedo 对照呈现去掉阴影、反射、高光与光照色偏的能力。Zhu 较多保留了外观污染;Careaga 与 Kocsis 较好,RGB→X 的平坦区域更干净。这里的“更平坦”需要与 ground truth 对照,不能一概把所有细纹去掉视为进步。
Figure 3(b):Hypersim 与 classroom 的 irradiance 展示复杂阴影和彩色光照,作者注明匹配允许缩放。(c)(d):roughness / metallicity 的样例更符合对象先验,但部分属性在当前光照下本来就难以辨识。(e):法线保留高频几何,同时在带纹理的平面区域保持较平。图注将除 classroom 外的素材归于 Hypersim,不能把有真值的 synthetic 示例说成全部真实照片。
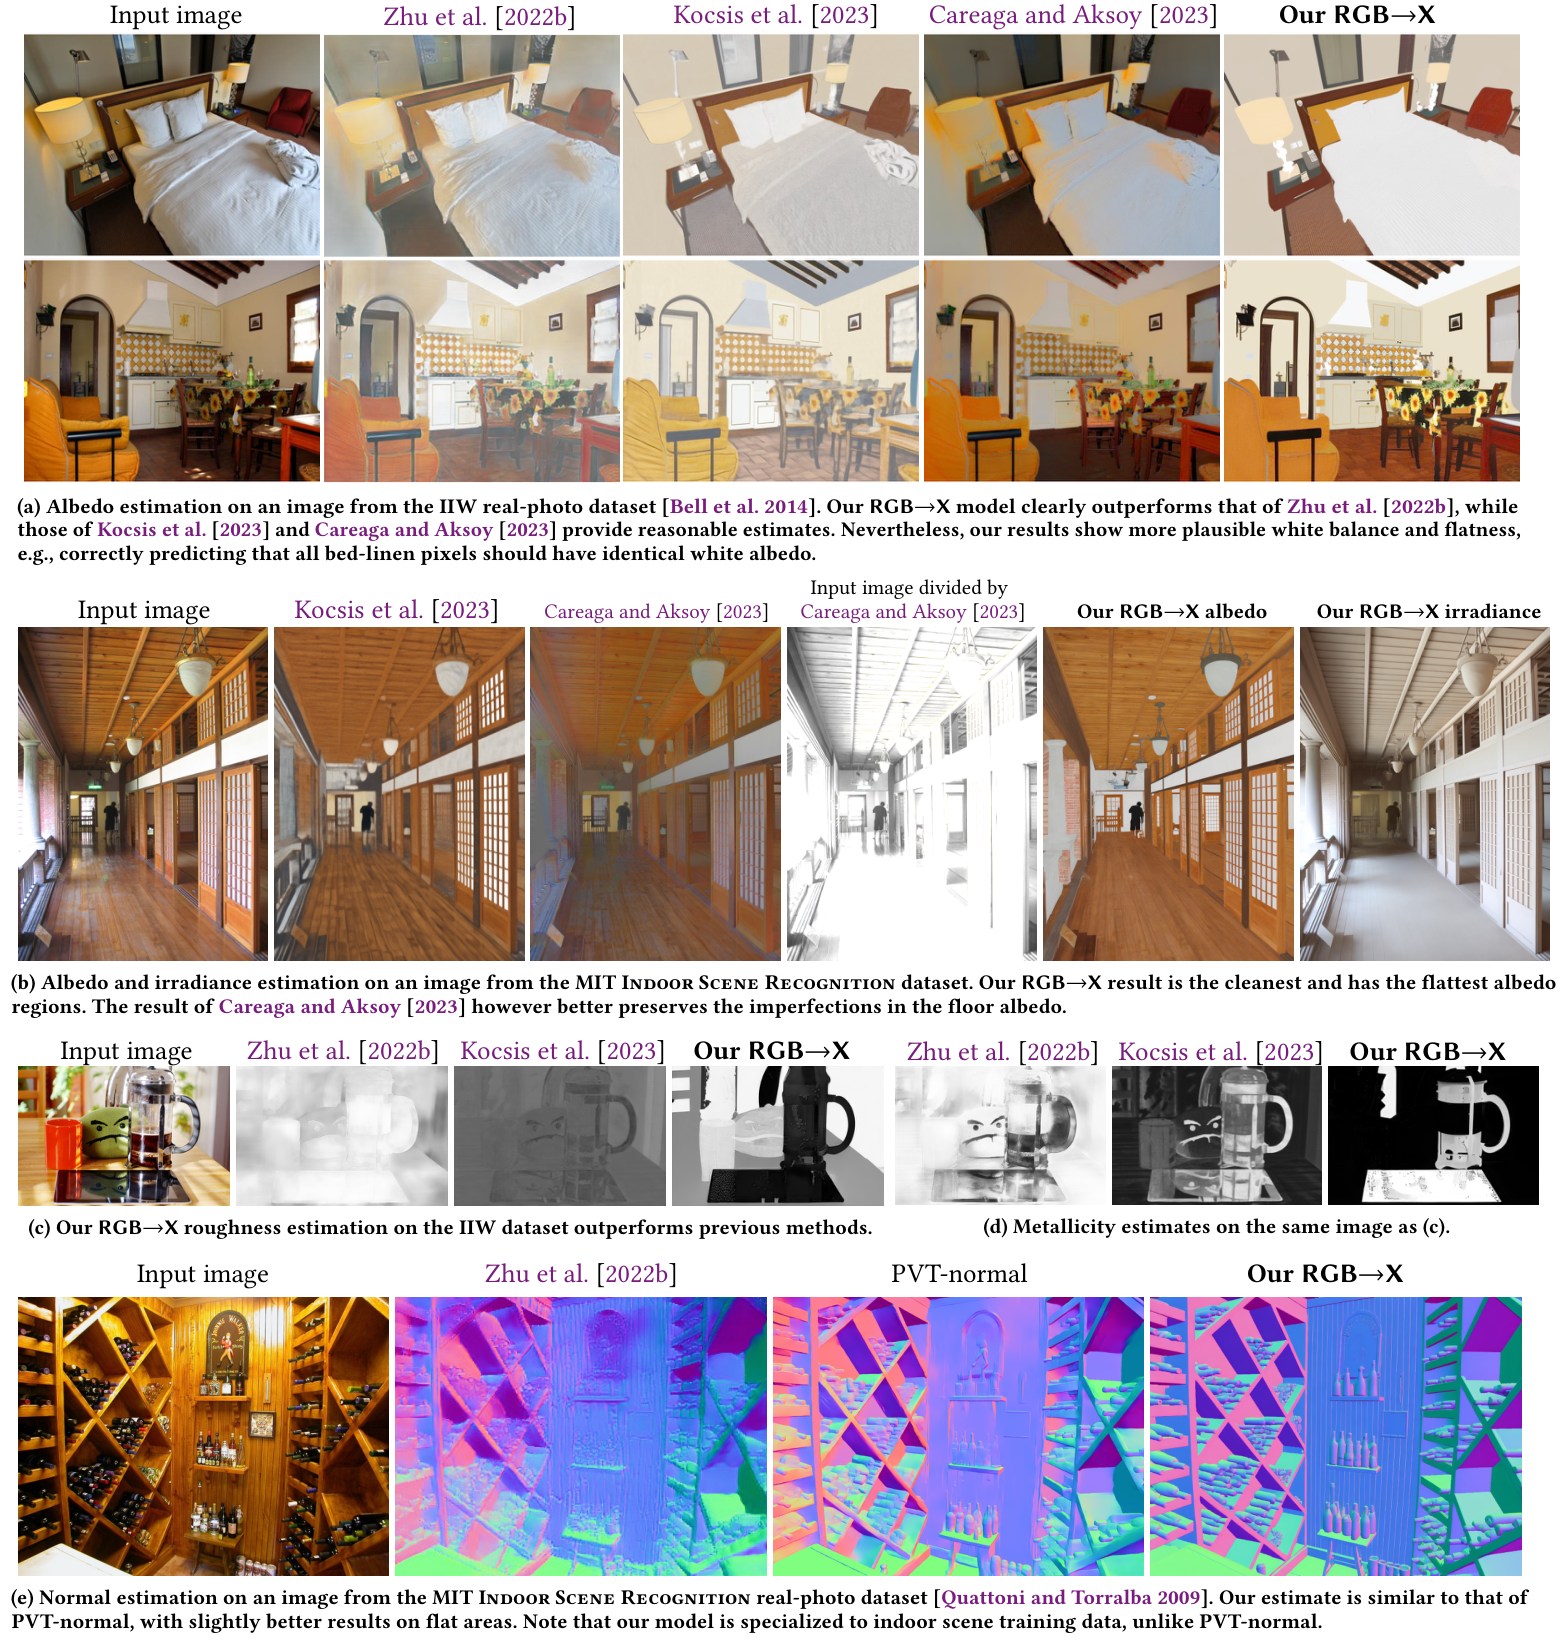
Figure 4(a):IIW 卧室图中,白色床品被估计成更一致的白色 albedo。(b):MIT 室内走廊的木地板有强反射和阴影;本文分解更干净,但也抹掉了地板磨损,Careaga 的结果更保留这些真实瑕疵。其“irradiance baseline”是原图除以其 albedo 得到的近似,混入镜面等非 diffuse 项,并非同类型专门 irradiance 模型。
Figure 4(c)(d):IIW 的 r / m 视觉上较合理,但没有真实物理标签证明每个像素正确。(e):MIT 酒窖法线与 PVT-normal 相近,平坦区域略好;作者明确不声称全域法线估计优越。对于木材、织物和金属外观的程序重建,应该把这些图作为候选解释而非唯一真值,保留不确定性。
13 · 合成与编辑图像逐项读
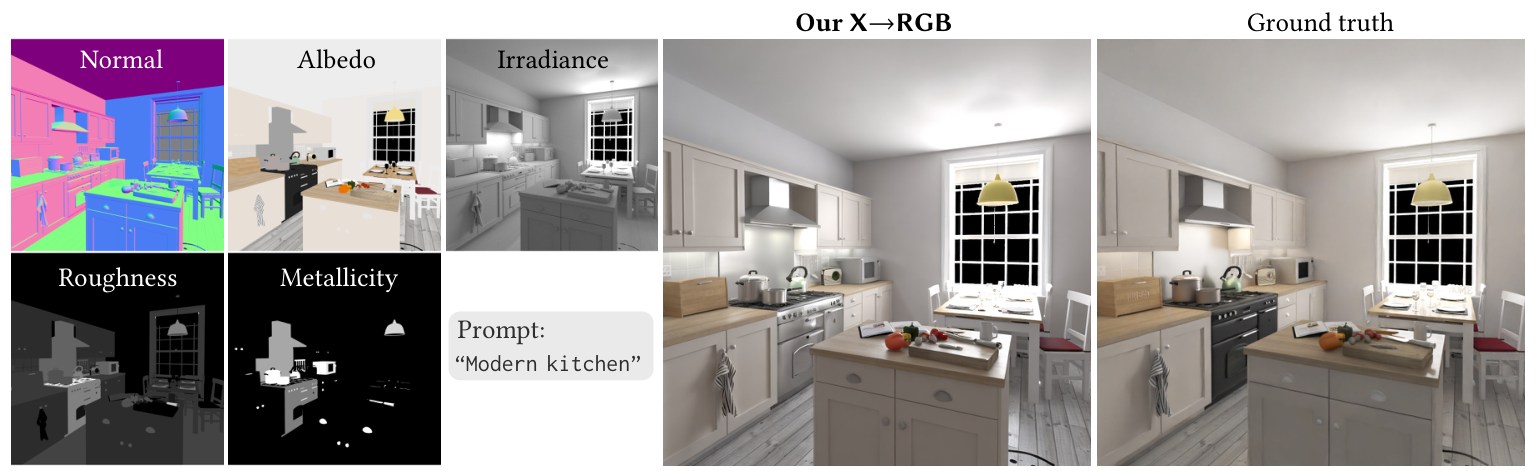
Figure 5:未纳入训练的厨房场景,以全部 intrinsic channels 和 “Modern kitchen” 为输入,对比 Monte Carlo path-traced reference。整体布局、材质感和照明相近,但炉灶没有服从暗金属 albedo,生成了更常见的亮铝材。作者把原因解释为训练集里暗金属稀少。该图没有给数值误差,更不能证明模型精确模拟所有反射或全局光传输。
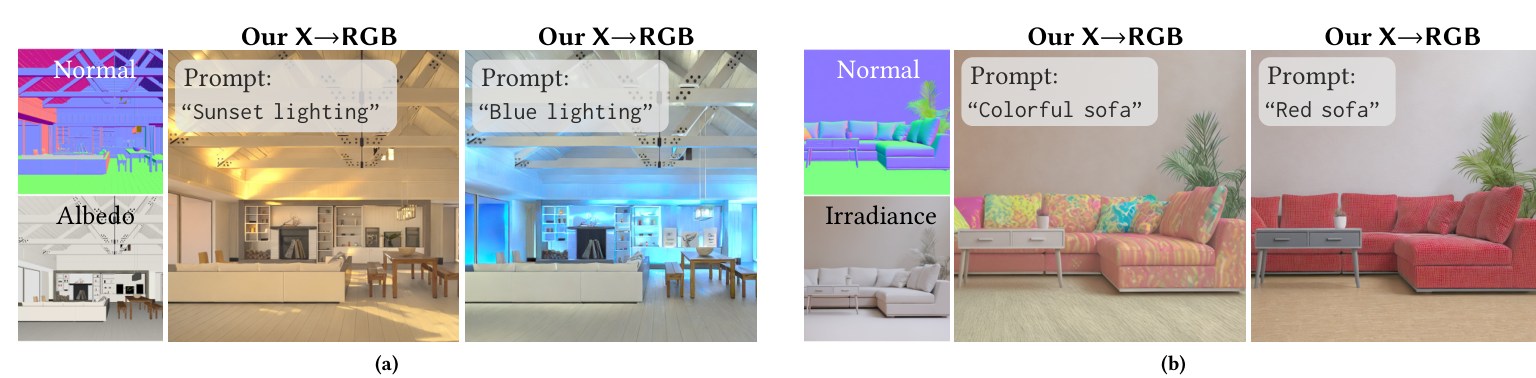
Figure 6(a):输入 normal + albedo,文字从 “Sunset lighting” 改为 “Blue lighting”,展示在不提供 irradiance 时可由文本决定光照。Figure 6(b):图内输入明确标为 normal + irradiance,文字为 “Colorful sofa” 与 “Red sofa”,展示不提供 albedo 时控制颜色。原图注把 (b) 也写成 normal + albedo,和实际标签及 source 文件名 sofa-normal-irra 冲突;这里以图内实际条件为准并保留这处文稿问题。
文字控制在对象较少时更可靠;复杂场景中指定某个对象的颜色仍困难。固定 a 后用文字改颜色与固定 E 后用文字改光照可能制造条件冲突,不能把文本优先级当作普遍规则。图中“to some extent”应保留为有限控制,不扩写为精确交互编辑系统。
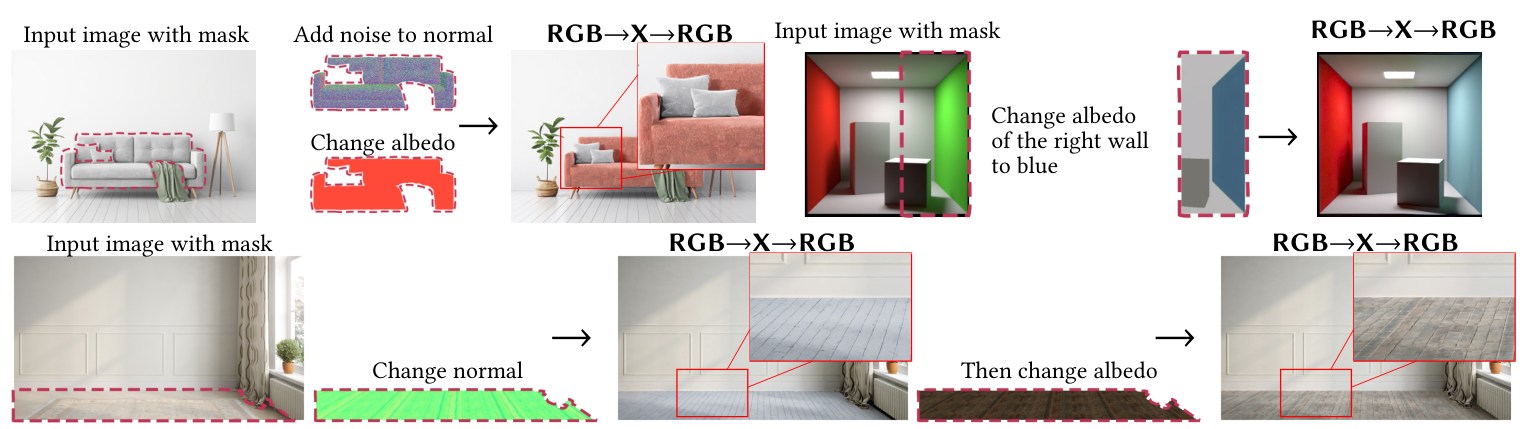
Figure 7:三组材质编辑分别验证 normal + albedo 改沙发、扩大 mask 后蓝墙的颜色溢出、先改木板法线再改木色。它们强调属性操作带来的视觉效果,未报告 mask 边界误差、背景不变率、编辑成功率或与通用 inpainting 的对照。图像里的毛茸茸感觉也不是显式纤维几何或可导出的毛发材质程序。
对本文最公平的评价是:它给出了一套实用的“从语义外观到属性缓冲再到外观”的编辑原型;把这一原型用于严谨的资产生成,还需要物理渲染和多视角检验闭环。
14 · 附录消融:支持什么,没有支持什么
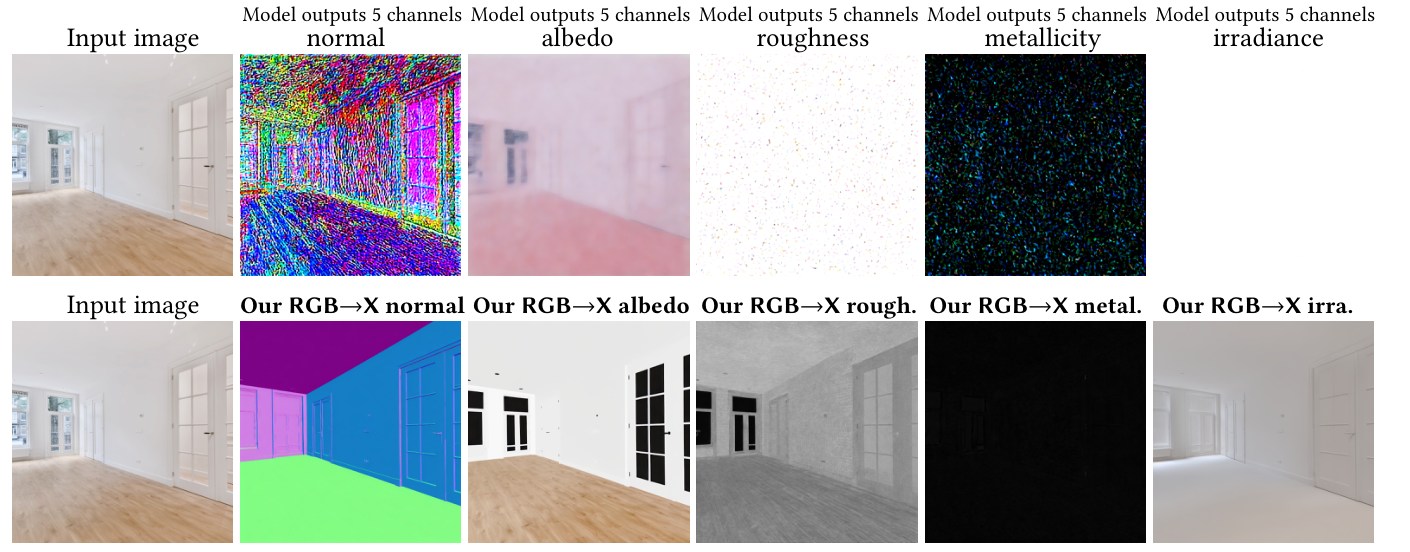
Figure 9:同时输出五类属性的大 latent 模型,在 100 epochs 后仍出现大量噪声和失真;下面给逐属性切换的结果。它支持“作者尝试的五输出训练方案不好训练”,不证明所有多任务 joint latent 架构天然不可行。
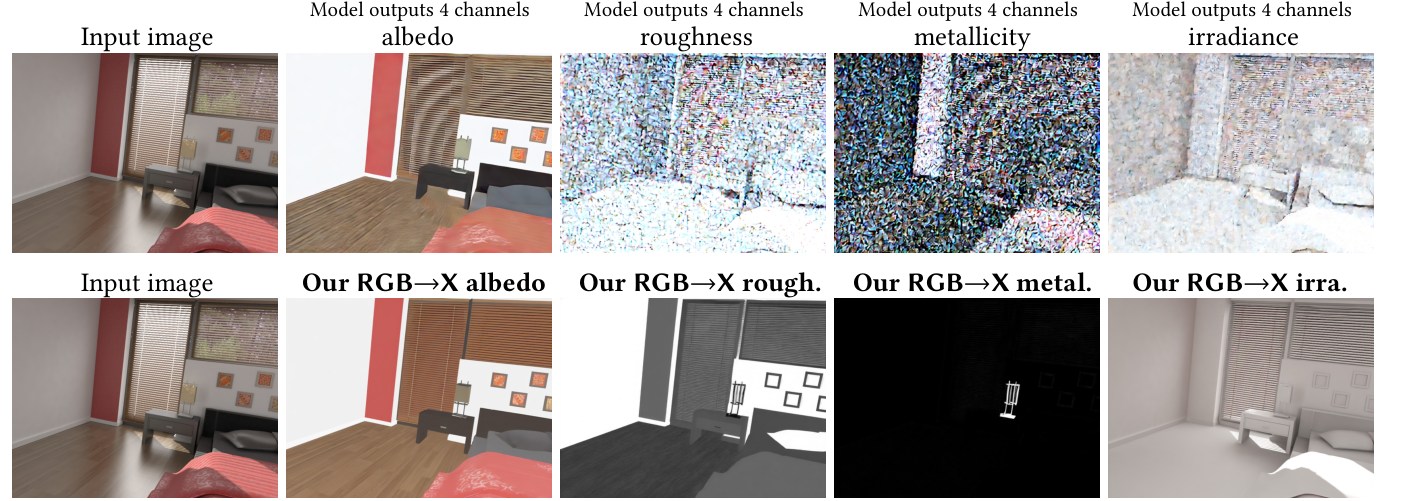
Figure 10:去掉 normal,改成同时输出 a、r、m、E 的四输出版本。100 epochs 后 albedo 开始合理,但其余属性仍差。由此可以看到任务数量和模态组合影响训练,不宜把失败简单归因于“增加一个通道一定损坏 SD”。
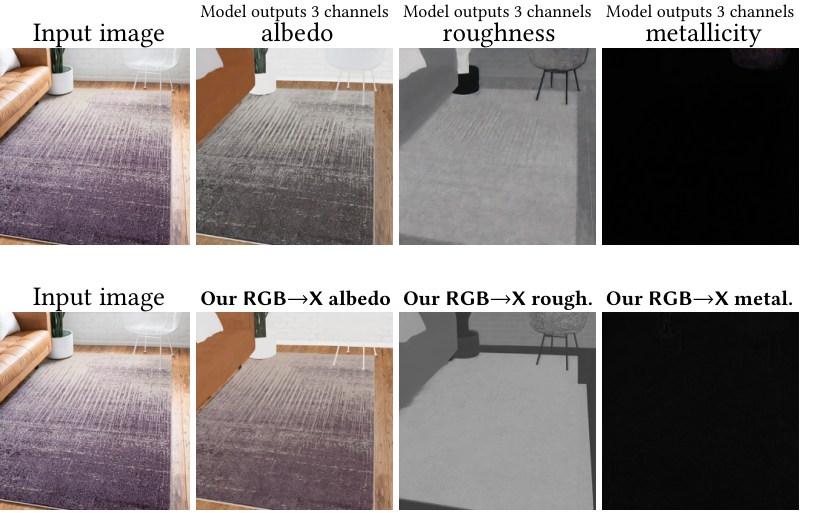
Figure 11:只联合输出 a、r、m 的三输出版本能产生干净 albedo 和尚可 r/m,但相较同 epoch 的逐属性模型,仍有 albedo 色偏与 roughness 形变。它比前两个版本更强,也说明“所有多通道模型都完全失败”的总结不准确。这里的三、四、五“channels”指属性组,不是 U-Net 的三个、四个、五个标量 latent channel。
| 设计问题 | 提供的证据 | 不足 / 待验证 |
|---|---|---|
| 联合输出 vs 任务切换 | Figures 9–11,5 / 4 / 3 属性版本,100 epochs 或相同 epoch 的视觉对照 | 没有数值表、相同 GPU-hours、训练曲线、多个 seed;新增参数与可用监督不同 |
| 一个任务切换模型 vs 多个独立模型 | 正文说表现相近,只需存一组权重 | 未给逐任务数值、总参数和推理耗时表 |
| v prediction vs epsilon | 正文定性陈述 v 更好 | 没有独立消融表 |
| channel dropout | 部分条件合成图,架构支持缺失 | 没有 no-dropout、dropout 概率扫描或 32 子集完整对比 |
| 低分辨率 irradiance | 动机和编辑示例 | 没有 VAE 编码 / 多尺度 / 不同降采样率的定量对照 |
| 新增 Evermotion / ImageDecomp | 数据解释和总体结果 | 没有逐源 leave-one-out,无法分离真实感提升来源 |
| CFG | 分解端关闭的经验陈述;合成端采用 | 两方向缺少完整 sweep;附录 C 叙述有歧义 |
Reviewer 解读:这是强系统设计与视觉演示论文,不是每个设计选择都被严格量化消融支撑的论文。最值得复现的对照,应在相同数据、分辨率、GPU-hours 和采样预算下比较 joint-output、task-switch 与独立模型,而不是照抄正文对“shock”的解释作为已证明机制。
15 · 附录失败案例与适用边界
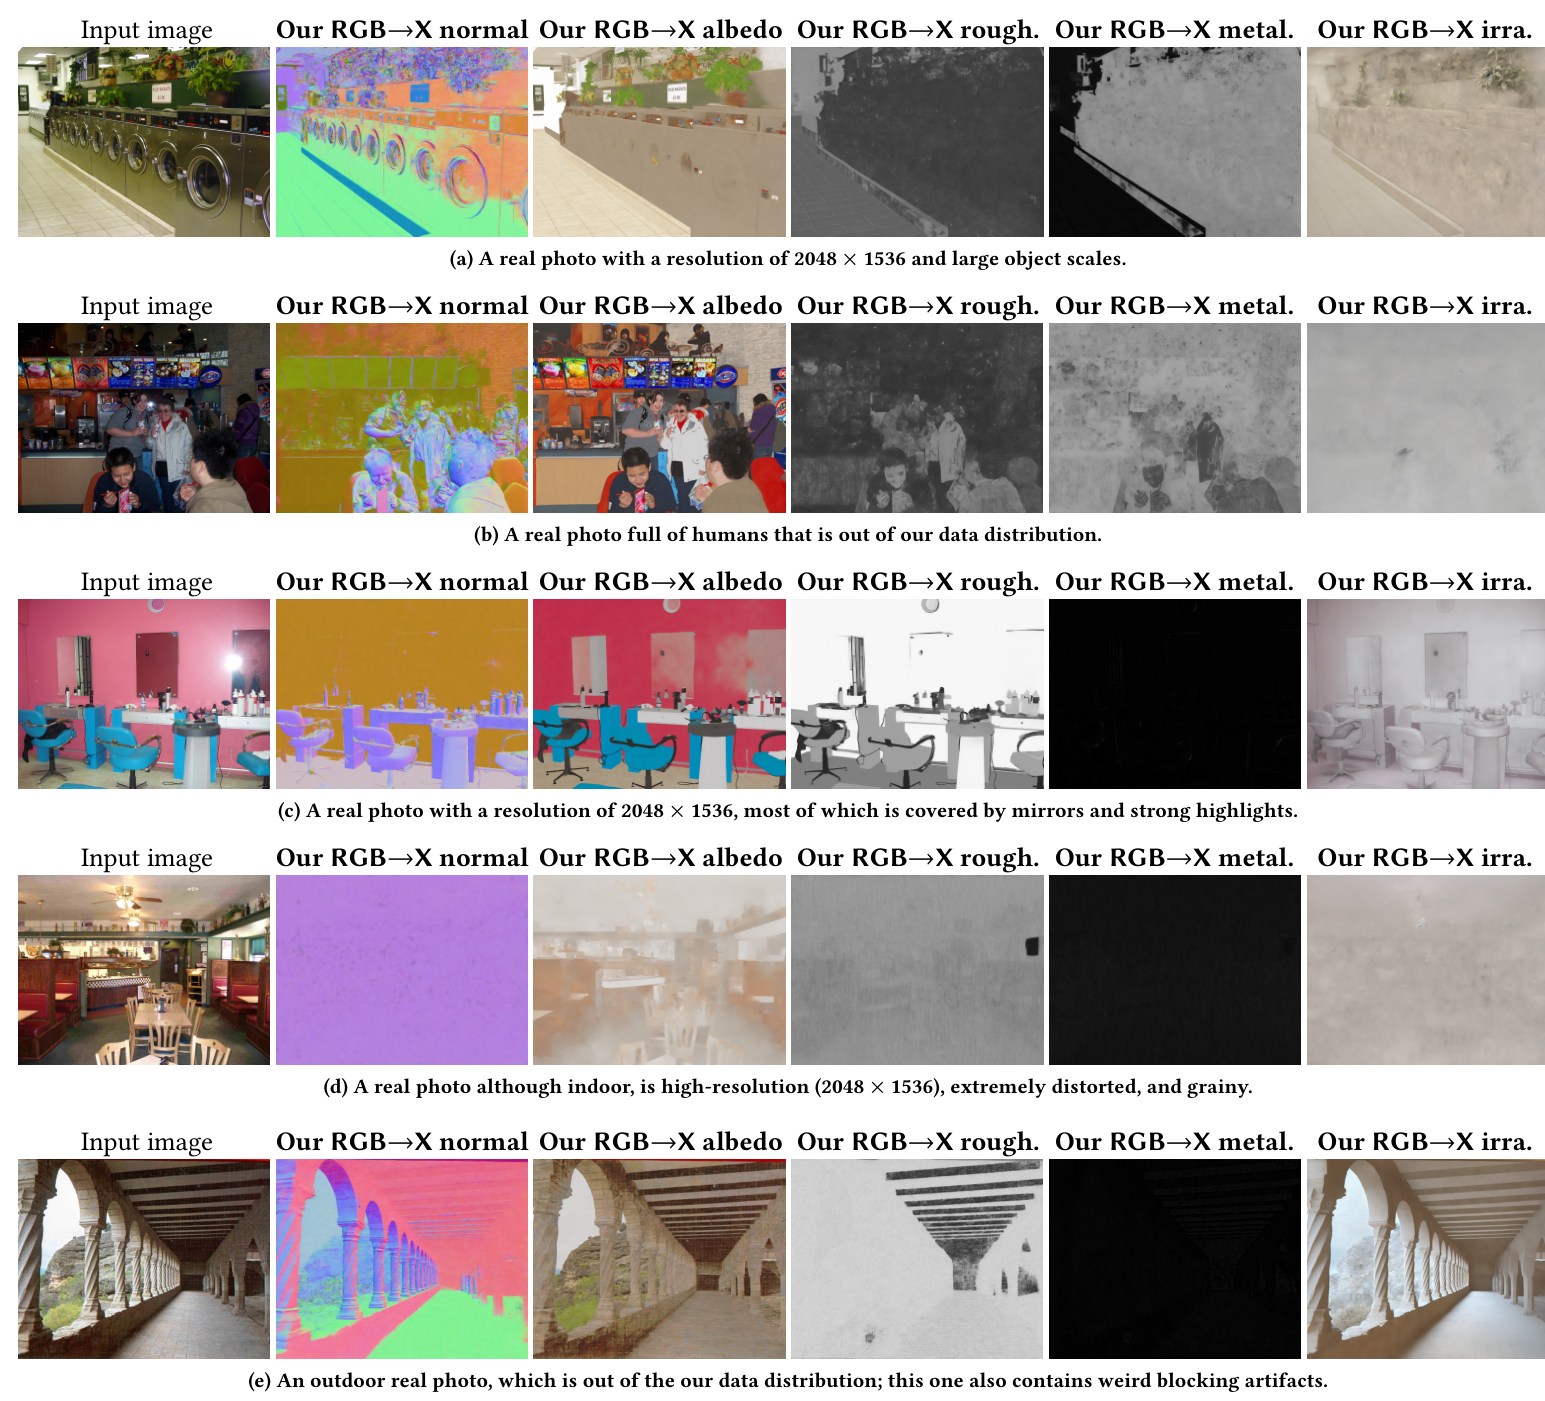
Figure 8 的总图注写“X→RGB failure”,但每行实际是输入 RGB 和预测 normal / albedo / roughness / metallicity / irradiance,显然展示的是 RGB→X 分解失败。这处方向误标在固定 PDF 和 arXiv HTML 中都存在,不能照抄成合成失败。
- (a) 2048 × 1536,大物体尺度:远离训练 crop 的尺度分布,法线和材质分解不稳定。
- (b) 人群:虽然照片可发生在室内,但大量人物明显超出室内静态场景材质数据的主分布。
- (c) 2048 × 1536,镜面和强高光:反射虚像与真实表面难分,X 缺乏精细反射光场,属性解释受限。
- (d) 2048 × 1536,严重畸变和颗粒:输入仍是室内也不保证适用,图像成像过程不同会造成错误。
- (e) 室外及 block artifacts:域外内容叠加压缩异常;多通道预测可能看起来完整但不可信。
Appendix C 还指出:Hypersim 的 albedo 标签污染、InteriorVerse 的 r/m 不可靠、噪声与 aliasing、室内数据语义偏置、采样源比例和 dropout 比例改变模型偏好。作者认为更大更多样的数据会缓解这些问题,但没有用该论文的实验量化这个推测。
“绿色多是植物”“木质窗帘罕见”“暗金属被改亮”的共同原因,是模型会用物体语义先验修正低概率属性组合。它有利于自动补全,却会压制反常材质设计。对创作工具,这不是只靠追求更逼真就能解决的问题:必须单独测量用户指定的反常条件是否被遵守。
16 · 公开代码与论文版本审计
本次只做静态 source audit,没有安装运行官方代码、下载模型权重、训练或调用 GPU inference。固定仓库 commit 为 977e0df27d369d3e68900399f59a42b0156d4440,2026-01-24。仓库最早公开 commit 是 2024-10-08,晚于论文;2024-11-09 加入 inpainting demo,后续主要改环境和 UI。没有能被该仓库历史证明为论文提交时训练快照的版本。
| 项目 | 实际审计发现 | 影响 |
|---|---|---|
| 原论文权重遗失 | README 说明论文将 roughness/metallicity 打包为一个 RGB 图,蓝通道为 0;公开模型改为分别预测 | 不能声称用当前分解 checkpoint 重现原论文 r/m 数值 |
| 训练与评测代码 | 公开树包含三个推理 pipeline、demo、通用 load_image、环境与样例;没有训练/数据/指标脚本 | Table 2、数据混合和 dropout 精确复现不足 |
| latent 形状 | HF configs 分别为 8→4、23→4、28→4;VAE latent=4、scale factor=0.18215 | 证明 low-resolution irradiance 是三通道,inpainting 多五输入通道 |
| text / U-Net | cross-attention dim=1024;text encoder hidden=1024、max positions=77、23 层 | 不要照 pipeline 旧注释推定成另一种 CLIP 配置 |
| 调度器覆盖 | HF 文件为 leading / zero-SNR=False;demo 改成 trailing / zero-SNR=True | 只读取模型 config 不足以复现 demo |
| 不同属性缩放 | X→RGB 对 a/n/r/m 使用四个训练数据推得的固定 latent multiplier | 不能全部替换成 SD 默认 0.18215 |
| 颜色与曝光 | LDR 输入用 power 2.2 线性化,输出用 power 1/2.2;EXR 依据对数平均亮度把中灰置为 0.18 后 clamp | 不是严格分段 sRGB,也不是保留绝对 HDR;跨软件一致性需校准 |
| 分解分辨率 | demo 无条件将最长边设为 1000,取 8 的倍数,再回原尺寸 | 不能把 UI 输出分辨率等同于实际推理分辨率 |
| normal 后处理 | 分解端只做解码/映射,没有显式单位长度归一化;合成 loader 会从 [0,1] 映至 [-1,1] 并 normalize | 输出 normal PNG 用于物理计算前应检查长度与坐标系 |
| inpainting 与 blend | 代码反转上传 mask,生成后返回三类诊断图;没有论文的 tighter final blend | 保存背景的后期环节需要自己实现与测试 |
| 多图 batch 接口 | missing-AOV 零块分配使用 batch_size,未乘 num_images_per_prompt;默认 demo 每次 1 张 | 改变该参数并有缺失条件时有 shape mismatch 风险,属于静态风险,未运行验证 |
| latent 输出模式 | inpainting 的 output_type=latent 路径仍解码诊断 photo,再交由 processor 返回 | 非默认输出接口需独立测试;不能依据 docstring 推断所有路径可用 |
| 属性 | 乘数 |
|---|---|
| albedo | 0.17301377137652138 |
| normal | 0.17483895473058078 |
| roughness | 0.1680724853626448 |
| metallic | 0.13135013390855135 |
这些数值由代码注释称为从训练数据计算的 scaling factors,但如何估计、用哪些 split 和统计量没有对应脚本。irradiance 不使用这四个乘数,它已经在预处理后直接降采样。RGB 条件、RGB 目标 latent 则依赖 VAE 自身 0.18215 的缩放。
模型和依赖快照
- rgb-to-x:HF revision
b38b3fd73a14ea62f3953fc54bc4ac67b067bae0,最后修改 2024-10-08。 - x-to-rgb:HF revision
abb89a792d32cae5331099664bd84e8f642d3aa0,最后修改 2024-10-08。 - x-to-rgb-inpainting:HF revision
a7c8ee099ed8cc7e8d64d51758148f9eef4aeb28,最后修改 2024-11-09。
只取模型配置和 model card,不取数 GB 的 safetensors;revision pin 表示配置审计快照,不表示权重行为已测试。HF 三个 README 基本为空,平台自动给的通用示例不能代替作者自定义 pipeline。模型配置中的旧训练目录名称也不是可访问数据路径,不能据此推定 epoch、数据配比或已发布训练代码。
环境文件为 UTF-16 编码,列 Python 3.9、PyTorch 2.3、CUDA 12.1、Diffusers 0.20.0、Gradio 3.48.0、ImageIO 2.34.1、NumPy 1.26.4、OpenCV 4.9.0.80、Transformers 4.40.2、huggingface-hub 0.25.0。配置保存时 Diffusers 版本是 0.20.2;这是环境版本不完全相同,不等于已发现运行失败。依赖较旧,升级前应做兼容检查,而不是无条件用最新库。
仓库 LICENSE 为 Adobe Research License,范围限定非商业研究;不能按 MIT / Apache 理解为自由商业集成。数据、基础模型与第三方资源还要分别检查适用条件。本次未执行安装、启动 Gradio 或接受任何额外协议。
17 · 可操作的复现路线与自检
先复现推理,再讨论重训
- 记录对象:固定本页所列代码 commit、三个 HF revisions 和依赖;明确目标是公开 demo 还是论文配置。对 r/m 原论文 checkpoint 的缺失做显式标注。
- 验证输入:确认照片颜色空间,法线属于 camera-space,r/m 无 gamma;统一图像尺寸,并保留五个条件槽位。把任意缺失条件设 None,而不是提交一张“看起来黑”的属性图。
- 测基本路径:先跑 repo 自带样例,在默认单图路径检查每个输出的形状、范围、NaN、normal 单位长度、相同 seed 可重复性。记录实际 GPU、显存、耗时与 resize 过程。
- 逐项干预:固定 seed 和其他条件,仅改变某一种 X;分别检查指定属性是否遵守、未指定属性是否合理、未编辑区域是否变化。用生成的 X 再分解只是内部一致性辅助,不能作为唯一正确性标准。
- 评估多样性:每图固定候选预算,报告全部样本分布、均值/方差/失败率;若要选优,单列选择规则和成本,不混进单样本数字。
- 要重训时:先解决商业数据许可、精确 split、r/m 标签筛除和 ImageDecomp 伪标注复现,再公开 dropout、data-source weights、mask generator 和评测代码;否则训练时间数字本身不可重现。
本次做过的独立算术检查
不调用官方神经网络,仅用本页重新写的小型算术验证:v 与 z0/epsilon 的互逆关系、23 / 28 输入通道数、五类条件的 32 子集、数据库存求和、Table 2 增量、CFG 两个 scale=1 时回到全条件分支、上传 mask 与内部 mask 的方向。这些只验证解释自洽,不替代训练或推理复现。
一个实用的 sanity check 是线性化:显示值 0.5 在 power-2.2 约定下变为约 0.2176,经过逆 gamma 回到 0.5;如果误将 roughness=0.5 也做同样变化,它会被送成更光滑的 0.2176。材质通道的语义不会因为文件后缀是 PNG 就自动变成 sRGB。
18 · Reviewer 视角
最强的贡献
接口设计有实用性。属性任务开关把异构目标标签问题变成可用任务采样;条件 dropout 把异构输入标签问题变成缺失条件学习。这两件事分别解决相反方向的数据瓶颈,而非仅拼接现成模型。
表达紧凑且可编辑。n/a/r/m/E 能对应艺术家的操作,较纯文字更可定位;低分辨率光照使几何微编辑有一定重着色自由。通过旧模型生成 ImageDecomp 伪标签,也展示了从“准确标签但不够真实”走向“更真实但标签有噪声”的务实折中。
失败案例公开得有价值。论文保留磨损被抹除、暗金属变亮、域外人群、高分辨率退化和多输出架构失效,帮助定位先验压过条件的情况。这比只展示好看的渲染更有研究启发。
最重要的弱点
- 可识别性不足:只用单图,r/m/E 的多解无法靠视觉真实感解决;分解没有物理约束,合成也能“修正”指定材质。
- 合成评估弱:没有专门 X→RGB 数值 benchmark、条件遵守度、光照误差或用户研究;因此“逼真”主要依赖选取的视觉样例。
- 训练数据和实现不完全公开:核心商业数据与训练脚本缺失;原论文 r/m checkpoint 又遗失,复现可比性进一步受损。
- 缺少预算对齐的消融:多输出头失败可能来自初始化、loss balance、优化步数、缺标签策略或数据,不能只归因于输出 latent 增大。
- 表示的 2D 局限:irradiance 丢方向,normal 缺 geometry,透明/复杂各向异性未建模;跨视角和极端材质组合没有保证。
- 度量不完全对应任务:normal 的 PSNR/LPIPS、metallicity 的图像距离,无法完整评价可重渲染性和真实材质参数。
最有价值的补实验
把每个主张对应到一个能证伪的实验:固定预算比较 joint-vs-switch;按 32 条件子集分别测 adherence / realism;在可控渲染数据上改变光照方向而保持 diffuse irradiance 近似不变,测试镜面预测;对“绿色墙”“暗金属”“木帘”等低频组合专门测条件覆盖率;按新场景而非新相机 split;在 512、1024、2048 分辨率报告失效率与耗时。
尤其应同时报告图像好看程度和输入约束遵守程度。二者可以反向变化,不能只用 CLIP 或用户偏好替代材质参数准确性,也不能用条件误差低就宣称照片真实。
19 · 对 Procedural Material Generation 的具体启发
以下均为研究延伸,不是 RGB↔X 已做的实验。本文不输出 Substance graph、SBS/SBSAR、shader program、节点序列或程序参数,也没有 DiffMat / renderer feedback / graph repair。能迁移的是数据组织、条件接口与生成先验,不能直接把像素属性预测称作程序材质生成。
方向一:将分解不确定性带入程序搜索
从参考图得到多组 X 候选,再让程序图 G 及参数 theta 生成材质 maps,由真正 renderer R 在多视角、多光照下验证。不要先把所有候选平均成模糊贴图;可以保留 K 个互不兼容但合理的解释,再根据渲染证据淘汰。r/m 候选方差可成为“还需要什么光照证据”的信号。
这里 G 是有效节点图,theta 为参数,L/C 为光照和相机,B 是程序生成后投影到观察视角的属性 buffer,Omega 约束复杂度、可执行性与 bitmap 依赖。权重 w 应反映不同属性及不同像素的可信度;不能用一个“干净但错误”的 albedo 强行决定整个程序。
最小实验:在有已知程序图和 renderer 的合成集上,对比直接图像拟合、单次 RGB→X 辅助、多候选 X 辅助;测试新光照下的图像误差、图执行成功率、参数恢复、图复杂度和运行成本。若训练与测试都靠 RGB↔X 自己打分,会形成自证循环,应保留独立物理真值。
方向二:把“任务开关”改成可执行输出槽位
程序生成器可以用明确 task token 选择 topology、参数、材质 map 或诊断,而不是扩张一个无结构大输出。但 tokenizer/grammar 必须约束节点类型、输入端口和边连接;每个阶段执行 graph compiler 检查。与本文不同,输出的是离散图和可执行程序,不能仅用图像 VAE 处理语法有效性。
可证伪假设:先共享一个 task-switch backbone,再按图结构/参数/预览分任务训练,可能比一次输出所有表示更稳定。对照需给 joint model 同等参数和计算预算,同时测 graph validity、render fidelity、可编辑性,而不仅看训练 loss。
方向三:缺失条件训练,但显式标识“未知”
PMG 资料常只有预览图、部分 PBR maps 或节点代码片段。可继承 channel dropout 思路,随机缺失材质/光照/几何条件,让生成器学会补全;但增加显式 availability mask 或 modality embedding,避免“未知条件”的零 latent 与“真实零数值”混淆。比较数据随机缺失与真实来源缺失的差别,防止模型通过数据源风格推断错误参数。
还要按实际使用频率设计子集分布:图像-only、albedo-only、normal+roughness、程序局部节点等。仅保证接口接受某个组合,没有该组合的验证集,就不能宣布统一控制成功。
方向四:用 renderer 判断“正常先验”是否覆盖了用户意图
为暗金属、彩色金属、反常木质家具等设计反先验测试;要求程序材质固定参数,再把同一个资产在未见照明下重渲染。若 RGB↔X 合成预览把暗金属改成亮铝,系统应将其识别为约束冲突,而不是把更熟悉的结果作为 reward 更高的候选。
这里的 target 必须来自可校验的设计要求或真实渲染监督,而不是生成模型的任意“漂亮图”。把 diffusion 作为可选 proposal / preview,把 renderer 和约束检查作为验收,能保留创作自由而降低先验偷改材质的风险。
方向五:把粗光照提示改成多尺度、可诊断的控制
低分辨率 E 有利于编辑新几何,却损失硬阴影。可同时提供 low-frequency irradiance 与有置信度的高频 shadow mask,由模型或 renderer 决定哪些应保持;在 coarse-to-fine 流程中分别优化光照结构和细材质。实验需要对比 fine E、downsampled E、多尺度 E,并用投射阴影边缘和高光位置误差评估,而不是只看 LPIPS。
最短的研究路线是先把 RGB↔X 当作室内材质候选和交互预览器,建立跨光照程序资产验证集,再决定是否把 diffusion 分数接入图搜索。优先解决“生成图能否真的重渲染”这一闭环,比继续追求单张展示图的干净程度更接近 PMG 的目标。
20 · 来源、旧笔记补充与未解决事项
- [P] 固定原 PDF 与对应公开 v1:arXiv 2405.00666v1 PDF。所有方法、数字和编号图以用户固定 PDF 为准;公开 v1 用于交叉核对。全文含 13 页,不能把附加两页说成另有 13 页 supplement。
- [A] 版本及 HTML:v1 元数据;完整 HTML。HTML 部分拼图转换不完整,因此除完整可用的 Figures 1–2 外,采用固定 PDF 源图。
- [O] 作者项目页:RGB↔X 官方项目页;项目页 PDF。用于身份、正式引用与补充资源入口;未把项目页新的泛化演示冒充论文定量结果。
- [C] 官方源代码:固定 commit 仓库;README 权重遗失说明;X→RGB pipeline;RGB→X pipeline。
- [C inpainting] 局部编辑:demo;pipeline。
- [H] 作者模型配置:RGB→X 固定 revision;X→RGB 固定 revision;inpainting 固定 revision。
- 使用范围:Adobe Research License,复用前检查非商业研究限制及第三方条款。
旧笔记保留,但在此补充
- 旧 note 的 SD 2.1 判断正确,但 RGB→X 的文字是任务开关,不是一般语义 prompt;X→RGB 才使用通常意义的文字条件。
- “input RGB 和 output X 都用原 SD encoder”适用于分解;合成时 irradiance 是明确例外,直接 downsample。
- 扩张 latent 引起重新训练主要涉及改变的输入/输出卷积和新增权重,不能表述为整个网络从零训练。
- 正式出版信息、arXiv v1 和 DOI 可补齐;第一作者首列机构是 Adobe Research。末位通讯作者候选仍未核实,不静默修改旧 metadata。
- 公开实现与正文 task switch、论文 r/m 打包 checkpoint 的版本差异必须和实验数字一起保留。
仍未解决:原论文遗失 checkpoint、完整训练数据与切分、dropout 和采样权重、Table 2 评测实现及选样规则、训练其他超参、独立 supplementary archive 的内容、实际推理行为与浏览器渲染。本文没有把这些缺失项补成猜测值,也没有声称已完成模型复现。