01 · DiT 的问题不是“如何发明扩散”
扩散生成长期默认用U-Net做去噪器。DiT问:如果把它换成结构接近ViT的Transformer,并有计划地增加模型宽深和latent token数,能否获得更好的质量与计算扩展性?论文的贡献是去噪骨干与条件注入设计的系统研究,不是新的前向扩散过程。
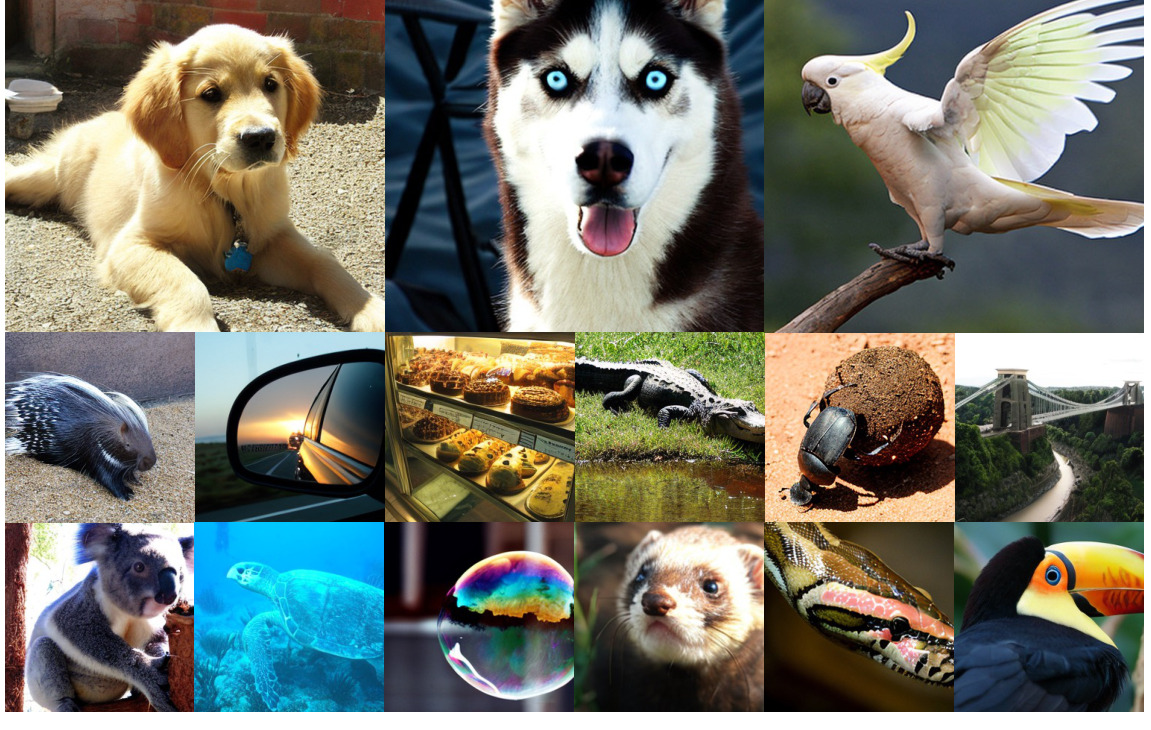
本文最重要的两个结论:adaLN-Zero比试验的其他条件注入方式好;在所研究范围内,前向Gflops比参数量更能反映质量,因为减小patch会增加token和计算,却几乎不增加参数。最高配置DiT-XL/2在256²、CFG1.5下FID2.27;512²为3.04,只能说优于表内此前扩散模型,不能说512²优于所有GAN。
基准是用户固定arXiv2212.09748v2,2023-03-02,25页,含Appendix A–D和20组未精选样本。后续官方项目页确认ICCV2023 Oral;官方PyTorch仓库与论文JAX训练分开核查。
02 · 身份与任务边界
两位作者William Peebles(UC Berkeley)和Saining Xie(NYU);Peebles的工作在Meta AI FAIR实习期间完成。原笔记venue为arXiv preprint,可追加ICCV2023 Oral信息;首页没有明确通讯作者标记,Saining Xie的unverified状态保持。arXiv编号源自2022年,用户版本与正式发表为2023年,这是不同时间字段,不冲突。
输入条件是1000类ImageNet标签与扩散时间,图像尺寸256或512。学习的是数据分布的生成,不是给定照片的重建、编辑或精确物理材质提取。论文将text-to-image扩展列为未来方向,因此不能把后来DiT家族、MMDiT、FLUX中的所有功能倒灌成这篇已经实现。
原笔记准确记录了patch/token关系及三类大方向,但其中adaLN原因、零初始化的位置和LayerNorm含义需要修正。本次保留原文字、两处PDF选区和块ID,在后文单独追加技术澄清。
03 · 扩散、latent与训练目标
为区分像素图与latent,本精读用 \(x\) 表示RGB,用 \(z_0=\mathcal E(x)\) 表示干净latent。前向过程为
\(\bar\alpha_t\)是累积保留信号比例。去噪器接收 \(z_t,t,c\),预测噪声以及反向过程对角协方差的参数:
噪声分支以MSE训练,协方差分支按照ADM/Improved DDPM的变分项训练。输出不是直接RGB,也不是只预测四个latent通道就结束。最终从高斯latent多步反向采样,最后VAE decoder将latent转回图像。
VAE下采样8倍:256×256×3→32×32×4,512×512×3→64×64×4。预训练VAE固定,DiT只学习latent分布。官方实现将采样自VAE后验的latent乘0.18215,解码前除同一常数;漏掉这个标度会改变噪声/信号的相对尺度。
扩散训练1000步线性variance schedule从1e−4到2e−2;评估通常用250步DDPM采样。训练时间步数与推理采样步数是不同概念。论文不是单步模型,也没有利用训练图像作为推理时检索输入。
04 · 张量路径:latent、patch、token、输出
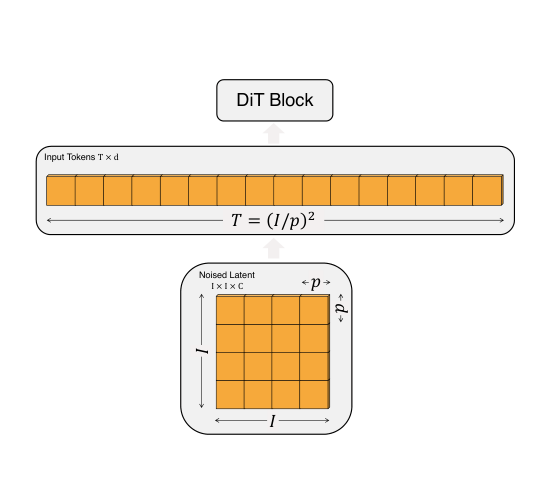
对latent边长 \(I\)、通道 \(C=4\)、patch边长 \(p\),每块含 \(p^2C\) 个数,经线性映射到hidden width \(d\)。token数是
| 图像/latent | p=8 | p=4 | p=2 |
|---|---|---|---|
| 256² / 32² | 16 tokens | 64 tokens | 256 tokens |
| 512² / 64² | 64 tokens | 256 tokens | 1024 tokens |
使用固定2D sine-cosine位置编码,不是RoPE,也没有把二维像素顺序任意打乱。经过N个DiT block后,每token经final norm和线性层输出 \(p^2\cdot2C\),unpatchify回 \(B\times2C\times I\times I\),前C通道对应noise、后C对应learned variance参数。
减半p使token数四倍,逐token线性/MLP成本约四倍,自注意力的二次项约十六倍,因此总成本至少显著上升,不能只以参数数目衡量。Patch embedding和输出投影参数会随p略变,但中间大部分Transformer权重不变。
05 · 四种条件注入的公平比较
| 设计 | 时间/类别怎样进入 | XL/2 Gflops | 400K无guidance FID |
|---|---|---|---|
| In-context | 两个condition token直接接在图像token后,末尾去掉 | 119.37 | 35.24 |
| Cross-attention | 时间/类别组成长度2的独立序列,image query跨注意 | 137.62 | 26.14 |
| adaLN | 时间embedding与类别embedding相加,回归norm的scale/shift | 118.56 | 25.21 |
| adaLN-Zero | 在adaLN外加两个残差门控,零初始化 | 118.64 | 19.47 |
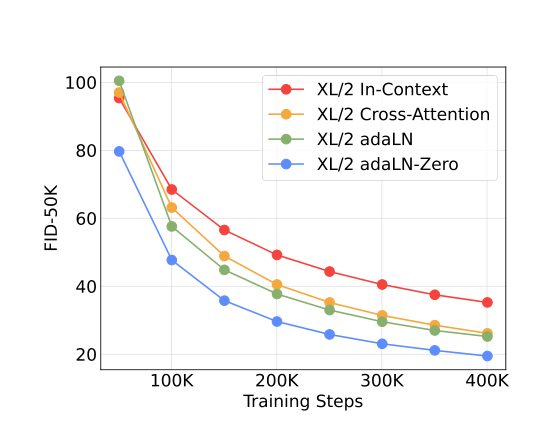
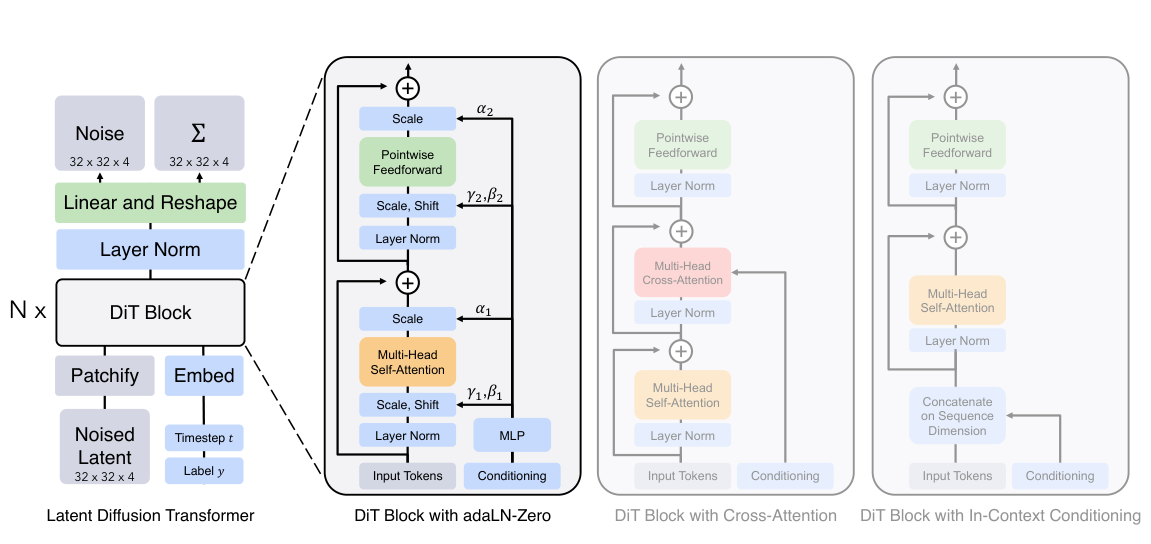
原文是四个变体;可归成三大注入思路,但adaLN与adaLN-Zero的初始化差异是重要对照。Cross-attention增加约15%计算;adaLN把同一条件映射作用于所有token,开销很小。类别/时间低维条件适合这种方式,结果不等于已经证明长文本条件也无需cross-attention。
表4显示这四个配置的参数量并不相等:in-context449M、cross-attention598M、adaLN600M、adaLN-Zero675M,因此“只改变初始化、其余参数严格匹配”的说法不适用于全部四路比较。adaLN-Zero相对adaLN还多了gate输出,原实验支持整个设计方案更有效,并未完全分离所有因素。
06 · adaLN-Zero到底把什么初始化为零
LayerNorm通常沿每个token的特征维 \(d\) 求均值/方差:
它不改变向量维度,也不是使每个数相等。adaLN从 \(c=e_t+e_y\) 回归条件相关scale和shift,官方代码采用
adaLN的MLP仍在学习;不是“不再学习scale/shift”,而是学习如何根据条件生成它们。也没有证据说引入adaLN就是因为普通LayerNorm的仿射参数必然导致过拟合。
adaLN-Zero的condition MLP输出六组d维向量:attention和MLP各自shift、scale、gate。官方实现把这个MLP最后的线性层权重/偏置设0,初始gate为0,于是两个残差分支不改变输入,整个block是identity。LayerNorm本身仍执行归一化,绝不是“把LayerNorm初始化成0所以LN成为identity”。
模型最终输出线性层也零初始化,初始输出为0。网络仍能学习,首先在门控/输出端获得梯度后逐渐打开分支。主Transformer采用tanh近似GELU,条件MLP采用SiLU;时间先经256维frequency embedding,再两层MLP到d。官方norm设置elementwise_affine=False,eps1e−6,由条件调制代替固定仿射。
07 · 模型规模、token规模与Gflops
原 Table 1
| Model | Layers \(N\) | Hidden size \(d\) | Heads | Gflops (\(I\)=32, \(p\)=4) |
|---|---|---|---|---|
| DiT-S | 12 | 384 | 6 | 1.4 |
| DiT-B | 12 | 768 | 12 | 5.6 |
| DiT-L | 24 | 1024 | 16 | 19.7 |
| DiT-XL | 28 | 1152 | 16 | 29.1 |
S/B/L/XL分别12/12/24/28层,hidden384/768/1024/1152,heads6/12/16/16;和p=8/4/2组合成12个模型。比如DiT-XL/2的XL是宽深配置,/2是latent patch边长,不是层数2或图像压缩2倍。
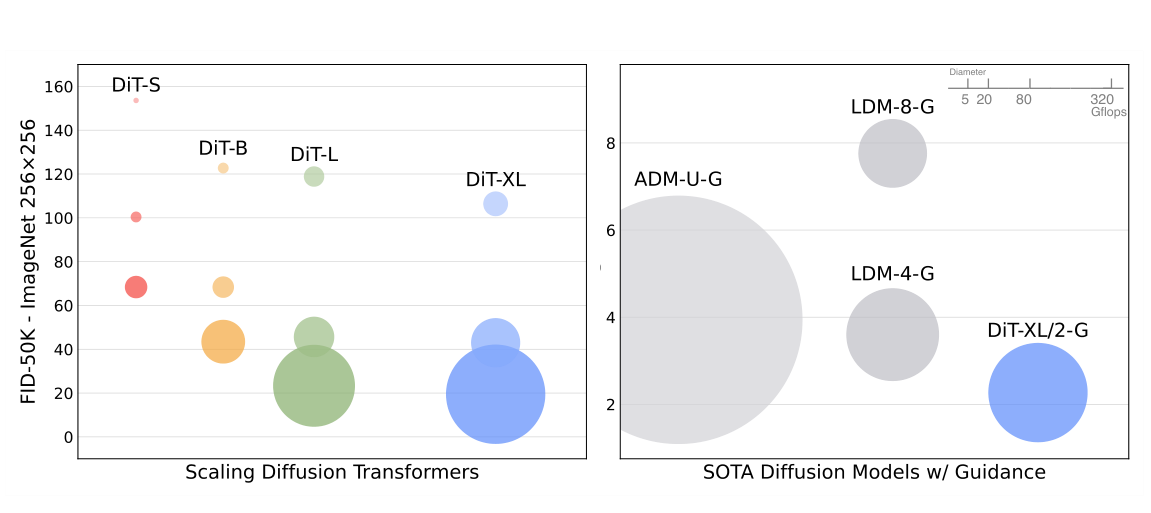
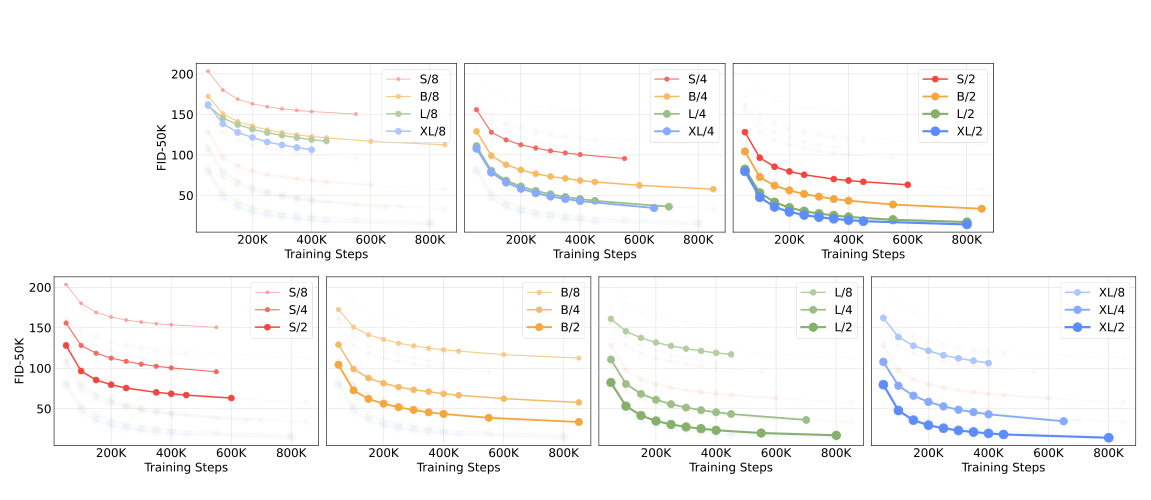
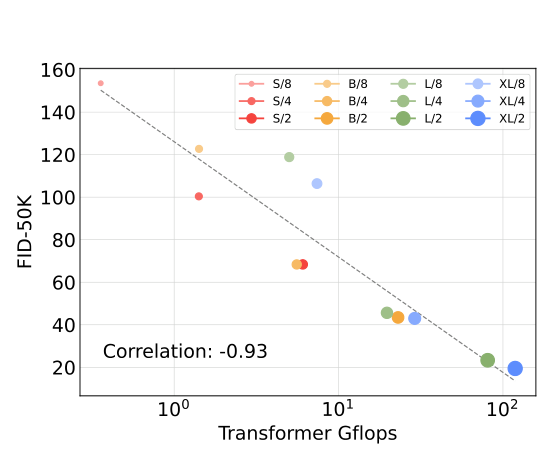
在400K相同步数、无CFG下,Gflops与FID报告相关系数−.93。S/2(6.06G,33M)的FID68.40几乎等于B/4(5.56G,130M)的68.38;XL/8有676M参数却FID106.41,远差于相同宽深、675M参数的XL/2(19.47)。说明参数量不是唯一控制变量。
原 Table 4
| Model | Image Resolution | Flops (G) | Params (M) | Training Steps (K) | Batch Size | Learning Rate | DiT Block | FID-50K (no guidance) |
|---|---|---|---|---|---|---|---|---|
| DiT-S/8 | \(256\times 256\) | 0.36 | 33 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 153.60 |
| DiT-S/4 | \(256\times 256\) | 1.41 | 33 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 100.41 |
| DiT-S/2 | \(256\times 256\) | 6.06 | 33 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 68.40 |
| DiT-B/8 | \(256\times 256\) | 1.42 | 131 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 122.74 |
| DiT-B/4 | \(256\times 256\) | 5.56 | 130 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 68.38 |
| DiT-B/2 | \(256\times 256\) | 23.01 | 130 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 43.47 |
| DiT-L/8 | \(256\times 256\) | 5.01 | 459 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 118.87 |
| DiT-L/4 | \(256\times 256\) | 19.70 | 458 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 45.64 |
| DiT-L/2 | \(256\times 256\) | 80.71 | 458 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 23.33 |
| DiT-XL/8 | \(256\times 256\) | 7.39 | 676 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 106.41 |
| DiT-XL/4 | \(256\times 256\) | 29.05 | 675 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 43.01 |
| DiT-XL/2 | \(256\times 256\) | 118.64 | 675 | 400 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 19.47 |
| DiT-XL/2 | \(256\times 256\) | 119.37 | 449 | 400 | 256 | \(1\times 10^{-4}\) | in-context | 35.24 |
| DiT-XL/2 | \(256\times 256\) | 137.62 | 598 | 400 | 256 | \(1\times 10^{-4}\) | cross-attention | 26.14 |
| DiT-XL/2 | \(256\times 256\) | 118.56 | 600 | 400 | 256 | \(1\times 10^{-4}\) | adaLN | 25.21 |
| DiT-XL/2 | \(256\times 256\) | 118.64 | 675 | 2352 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 10.67 |
| DiT-XL/2 | \(256\times 256\) | 118.64 | 675 | 7000 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 9.62 |
| DiT-XL/2 | \(512\times 512\) | 524.60 | 675 | 1301 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 13.78 |
| DiT-XL/2 | \(512\times 512\) | 524.60 | 675 | 3000 | 256 | \(1\times 10^{-4}\) | adaLN-Zero | 11.93 |
完整Table4含12模型、三种额外block比较、长训模型与512²配置;其FID使用ft-MSE decoder且无guidance。512²长训FID为11.93,而主Table3为12.03,因为主表采用ft-EMA,不能抹成抄写错误。表内FLOPs与参数均不含VAE,VAE另有84M参数。
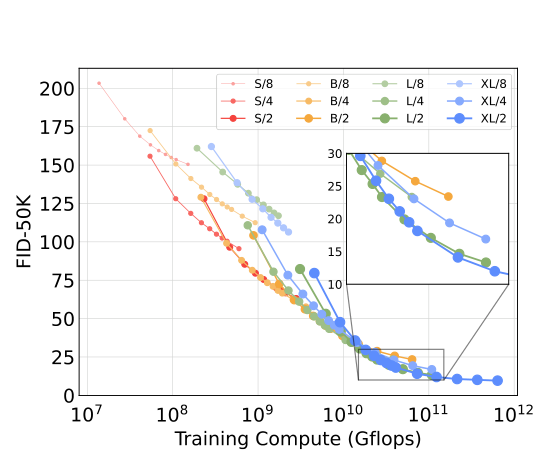
相同步数比较给大模型更多总算力,作者进一步用总训练预算 \(\mathrm{Gflops}\times\mathrm{batch}\times\mathrm{steps}\times3\) 作横轴,3近似前后向开销。大模型在预算够时更有效,例如XL/2在约10¹⁰Gflops后超过XL/4。该公式是粗计算量而非实测GPU小时,不能把相关曲线升级为任意硬件、数据规模下的普适缩放定律。
08 · 训练与评价设置
| 项目 | 固定v2设置 |
|---|---|
| 数据/条件 | ImageNet类别条件,256²和512² |
| 优化 | AdamW,恒定1e−4,weight decay0,batch256 |
| 增强/正则 | 随机水平翻转;未采用学习率warmup或额外regularization |
| EMA | decay.9999,报告使用EMA参数 |
| 训练步数 | 缩放比较400K;最佳256²训练7M,512²训练3M |
| 扩散 | 1000步线性variance,1e−4→.02;预测noise+learned covariance |
| 通常评价 | 50K样本FID,250DDPM步,ADM TensorFlow评估套件 |
| 采样预算实验 | FID-10K,16/32/64/128/256/1000步 |
| 硬件/框架 | JAX、TPUv3;XL/2在v3-256 pod、batch256约5.7步/秒 |
FID的预处理、decoder和样本数都影响可比性;FID-10K不能直接与FID-50K按同一量级比较。512²的precision/recall沿既有工作用1000张真实图,需保留该口径。IS、sFID、precision、recall分别补充类别判别、空间特征与质量/覆盖信息,不能只看一个最好FID。
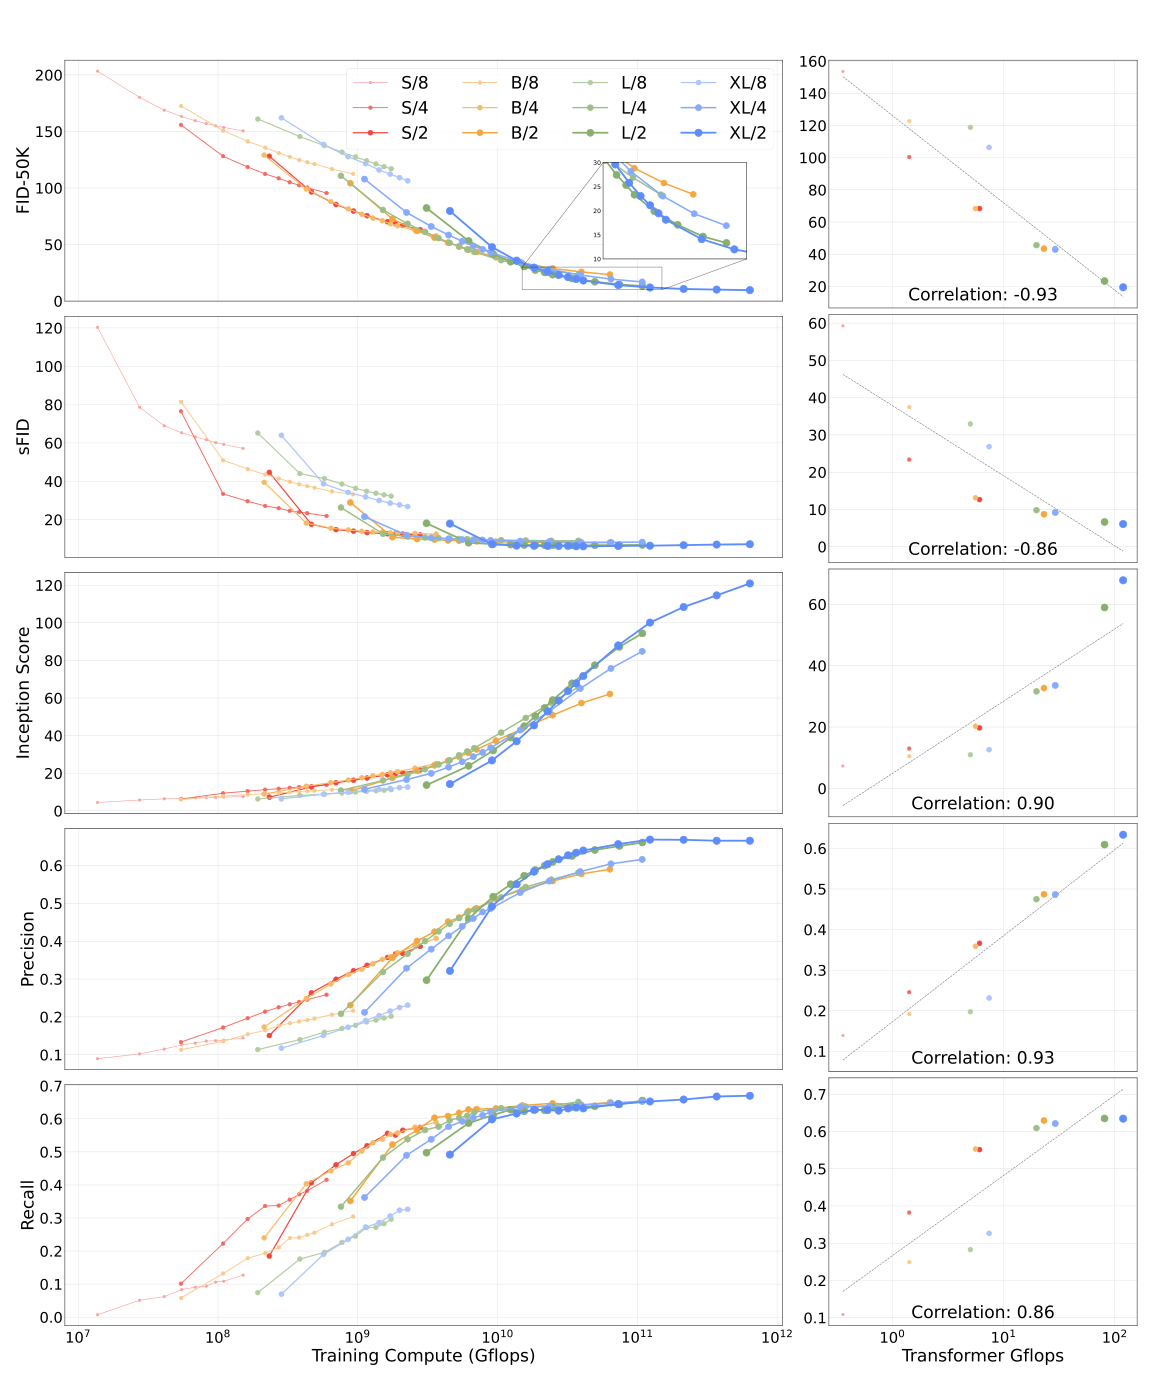
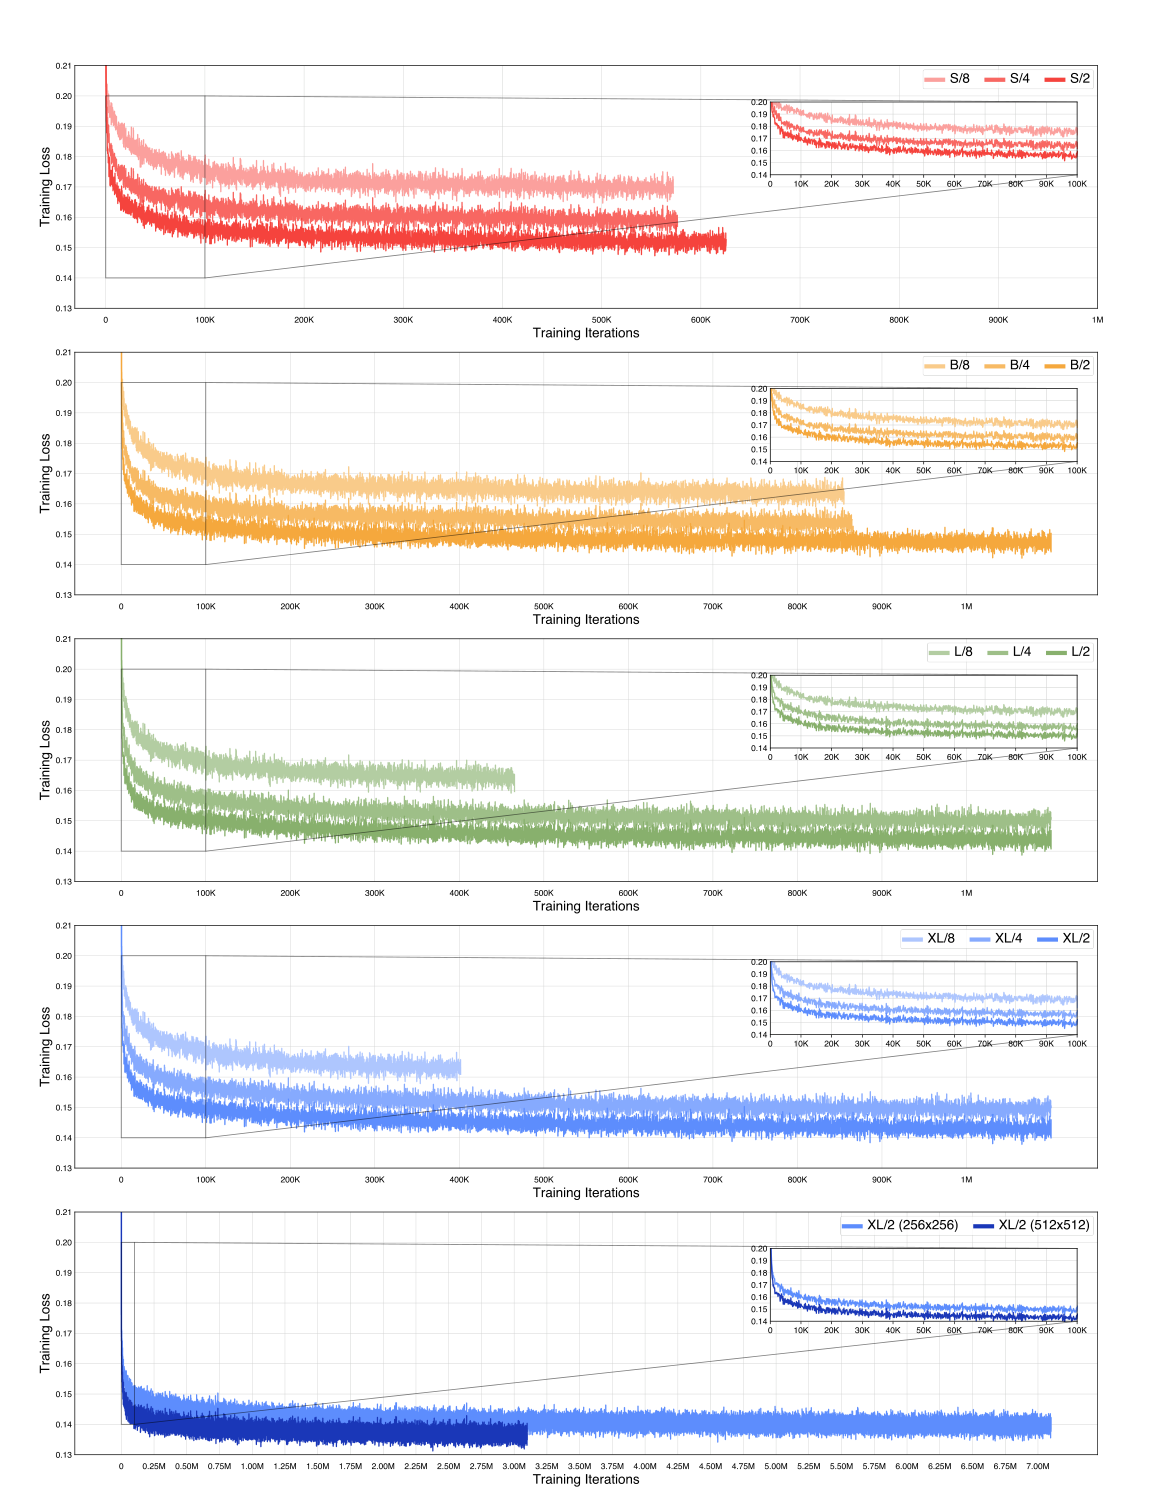
附录多指标与loss曲线大体支持更高计算模型收敛更好,但本文未报告多seed完整置信区间,且未在所有数据域验证。纯ImageNet类别条件实验不能直接替代长文本、视频或三维材质的扩展试验。
09 · CFG与三通道的特殊实现
训练时随机丢类别,使用可学习null embedding,从而推理时同时有无条件/条件预测。\(s=1\)是普通条件采样,不是无条件;更大s常提高条件忠实与锐利度,同时损失多样性。官方模型class dropout默认.1。
Appendix A明确:原实验只对latent前3个通道做CFG,而不是全部4个;这是latent通道,不等于RGB三个颜色通道。官方forward_with_cfg也保留这一行为。协方差和剩余通道不套同一外推公式。
作者观察三通道scale \(1+x\) 大致可由四通道scale \(1+\tfrac34x\) 近似;三通道1.5的FID2.27,四通道1.375为2.20。这不是数学恒等,也不能换实现仍沿用同样CFG而期待完全相同数值。
精选可视化用较强CFG:512²为6,256²为4;主最佳指标用1.5,附录未精选图用1.5/2/4。因此一页漂亮精选图不等于FID2.27的同一抽样分布,样本选择与guidance应一起报告。
10 · 完整基准与哪些结论不能夸大
原 Table 2
| Class-Conditional ImageNet 256\(\times\)256 | |||||
|---|---|---|---|---|---|
| Model | FID\(\downarrow\) | sFID\(\downarrow\) | IS\(\uparrow\) | Precision\(\uparrow\) | Recall\(\uparrow\) |
| BigGAN-deep [2] | 6.95 | 7.36 | 171.4 | 0.87 | 0.28 |
| StyleGAN-XLÂ [53] | 2.30 | 4.02 | 265.12 | 0.78 | 0.53 |
| ADMÂ [9] | 10.94 | 6.02 | 100.98 | 0.69 | 0.63 |
| ADM-U | 7.49 | 5.13 | 127.49 | 0.72 | 0.63 |
| ADM-G | 4.59 | 5.25 | 186.70 | 0.82 | 0.52 |
| ADM-G, ADM-U | 3.94 | 6.14 | 215.84 | 0.83 | 0.53 |
| CDMÂ [20] | 4.88 | - | 158.71 | - | - |
| LDM-8Â [48] | 15.51 | - | 79.03 | 0.65 | 0.63 |
| LDM-8-G | 7.76 | - | 209.52 | 0.84 | 0.35 |
| LDM-4 | 10.56 | - | 103.49 | 0.71 | 0.62 |
| LDM-4-G (cfg=1.25) | 3.95 | - | 178.22 | 0.81 | 0.55 |
| LDM-4-G (cfg=1.50) | 3.60 | - | 247.67 | 0.87 | 0.48 |
| DiT-XL/2 | 9.62 | 6.85 | 121.50 | 0.67 | 0.67 |
| DiT-XL/2-G (cfg=1.25) | 3.22 | 5.28 | 201.77 | 0.76 | 0.62 |
| DiT-XL/2-G (cfg=1.50) | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
256²:XL/2无CFG FID9.62;CFG1.25为3.22、1.5为2.27。相比LDM-4-G1.5的3.60更低;相比StyleGAN-XL的2.30仅略低。DiT sFID4.60仍高于StyleGAN-XL4.02,precision.83低于LDM-4-G.87,recall.57更高于LDM-4-G.48。不存在所有指标全面获胜的结论。
原 Table 3
| Class-Conditional ImageNet 512\(\times\)512 | |||||
|---|---|---|---|---|---|
| Model | FID\(\downarrow\) | sFID\(\downarrow\) | IS\(\uparrow\) | Precision\(\uparrow\) | Recall\(\uparrow\) |
| BigGAN-deep [2] | 8.43 | 8.13 | 177.90 | 0.88 | 0.29 |
| StyleGAN-XLÂ [53] | 2.41 | 4.06 | 267.75 | 0.77 | 0.52 |
| ADMÂ [9] | 23.24 | 10.19 | 58.06 | 0.73 | 0.60 |
| ADM-U | 9.96 | 5.62 | 121.78 | 0.75 | 0.64 |
| ADM-G | 7.72 | 6.57 | 172.71 | 0.87 | 0.42 |
| ADM-G, ADM-U | 3.85 | 5.86 | 221.72 | 0.84 | 0.53 |
| DiT-XL/2 | 12.03 | 7.12 | 105.25 | 0.75 | 0.64 |
| DiT-XL/2-G (cfg=1.25) | 4.64 | 5.77 | 174.77 | 0.81 | 0.57 |
| DiT-XL/2-G (cfg=1.50) | 3.04 | 5.02 | 240.82 | 0.84 | 0.54 |
512²:DiT-XL/2-G1.5 FID3.04优于表内ADM组合3.85,但StyleGAN-XL是2.41,所以这里是“此前扩散模型中最好”,不是“所有生成模型最好”。不同模型的外部训练数据、预训练VAE、总训练预算也未完全匹配,表格展示系统结果,不独立证明骨干架构的全部因果贡献。
原 Table 5
| Class-Conditional ImageNet 256\(\times\)256, DiT-XL/2-G (cfg=1.5) | |||||
|---|---|---|---|---|---|
| Decoder | FID\(\downarrow\) | sFID\(\downarrow\) | IS\(\uparrow\) | Precision\(\uparrow\) | Recall\(\uparrow\) |
| original | 2.46 | 5.18 | 271.56 | 0.82 | 0.57 |
| ft-MSE | 2.30 | 4.73 | 276.09 | 0.83 | 0.57 |
| ft-EMA | 2.27 | 4.60 | 278.24 | 0.83 | 0.57 |
同一DiT可换decoder而不重训,因为encoder相同。original/ft-MSE/ft-EMA在256²CFG1.5下FID2.46/2.30/2.27,差距不大但足以影响小数点级记录。因此报告decoder不是可省略的附加信息。
原 Table 6
| Diffusion U-Net Model Complexities | ||||
| Model | Image Resolution | Base Flops (G) | Upsampler Flops (G) | Total Flops (G) |
| ADM | \(128\times 128\) | 307 | - | 307 |
| ADM | \(256\times 256\) | 1120 | - | 1120 |
| ADM | \(512\times 512\) | 1983 | - | 1983 |
| ADM-U | \(256\times 256\) | 110 | 632 | 742 |
| ADM-U | \(512\times 512\) | 307 | 2506 | 2813 |
| LDM-4 | \(256\times 256\) | 104 | - | 104 |
| LDM-8 | \(256\times 256\) | 57 | - | 57 |
只算DDPM部分时,256²DiT118.6G略大于LDM-4约104G,却远低于ADM1120G或ADM-U742G;512²DiT524.6G对ADM-U2813G。不能从单前向Gflops直接推出端到端生成时延,还需采样步数、CFG双分支和VAE解码,以及硬件实现效率。
11 · 多采样几步能补偿小模型吗
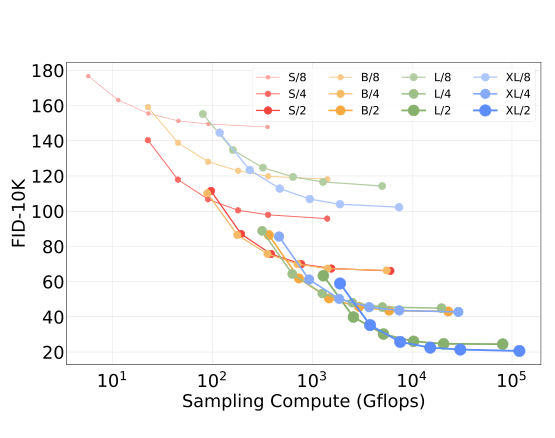
作者在400K训练后的12模型上扫16到1000步。例子:L/2用1000步约80.7Tflops/图,FID-10K25.9;XL/2用128步约15.2Tflops/图,FID-10K23.7。更大去噪器即便少走很多步,仍可优于小模型堆测试时计算。
结论限定在这些训练配置、采样器与步数范围。它不意味着采样器改进没有价值,也不覆盖后来的蒸馏、一致性模型、流匹配或多候选搜索。训练预算和推理预算是两条不同轴,需要在具体应用约束下权衡。
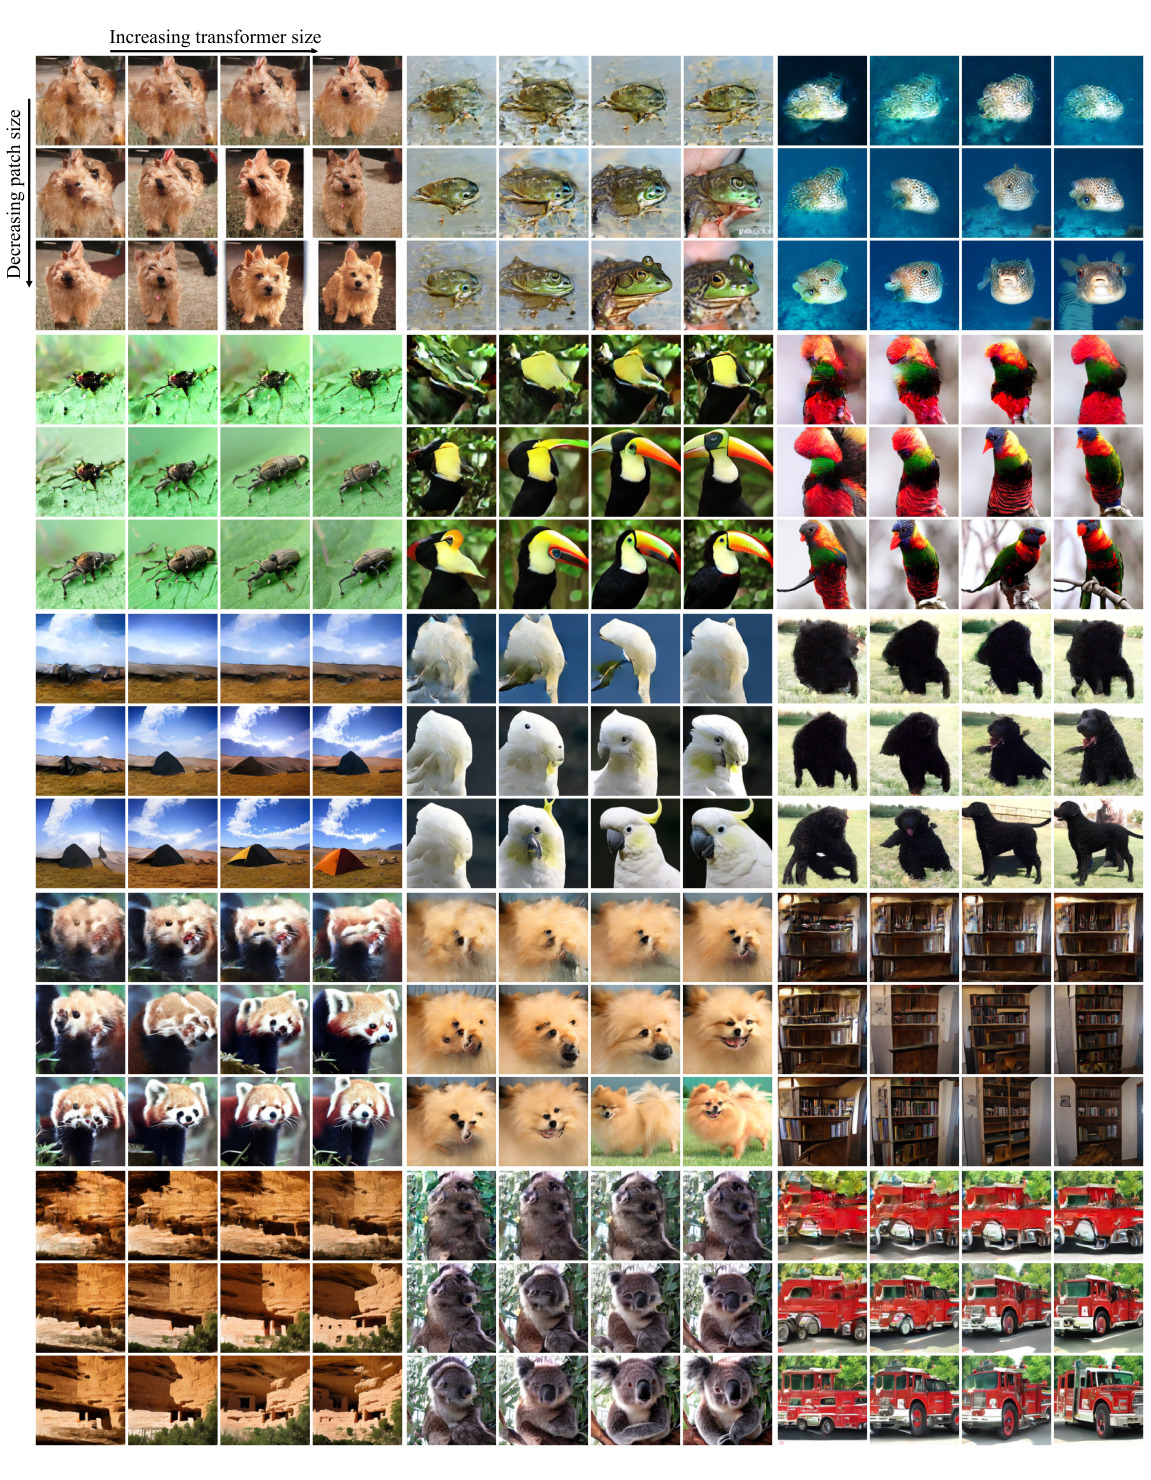
Figure7对12模型使用相同初始/采样噪声和类标签,更利于观察规模变化;但仍是定性展示,不是每个类别质量随Gflops严格单调的证明。
12 · 官方实现核查与原笔记修正
核查快照为ed81ce2…。原模型在JAX/TPU训练,官方PyTorch权重为移植,另提供DDP训练脚本。README报告相同移植权重FP32采样FID2.21,而论文JAX为2.27;这是实现/数值差异,不是本次重新训练达到的结果。仓库已归档,只读状态不妨碍静态核查。
| 原笔记/复现易错点 | 更精确表述 |
|---|---|
| “三种条件输入” | 三类大方向、四个实验block变体,adaLN与adaLN-Zero分别比较 |
| “LayerNorm维持同一个维度” | 沿特征归一化,不改变shape;每个特征仍可不同 |
| “adaLN不学习scale/shift” | MLP学习条件到scale/shift的映射,参数仍可训练 |
| “LN初始化0成为identity” | 残差gate初始0使整个block identity;LN本身非identity |
| “zero final convolution” | 核心block条件MLP末层与最终输出Linear置0,勿泛称所有卷积归零 |
| 位置编码与RoPE | 本论文固定2D sin-cos;RoPE/FLUX讨论为用户后续联系,不是本文实验 |
| 采样默认值 | sample.py默认VAE=mse,而主最佳表用ema;必须显式匹配 |
位置向量相减依赖绝对位置,并不自动意味着sin-cos无法表达相对关系;同频正余弦内积本来就包含相位差。RoPE将旋转引入Q/K内积是另一种机制,需要专门对照,不能从原筆记的一句话推出在所有cross-attention情形“已证明更好”。本次不验证未提供的FLUX代码版本,保留用户观察为原始记录。
代码确认norm无固定affine、MLP ratio4、fixed sin-cos requires_grad=False、噪声/方差8通道、.18215缩放、EMA.9999、AdamW权重衰减0。没有执行模型、训练、下载checkpoint或重新测FID,所有原结果均注明来源。
13 · 局限与PMG研究延伸
- 模型规模提高也增大显存、注意力成本和训练总预算,Gflops只是可解释代理,不是用户体验指标。
- VAE对细纹理和空间频率有瓶颈;Transformer更强不能恢复被encoder不可逆丢掉的信息。
- 类别条件低熵于长文本,adaLN胜出不能替代复杂文本对齐实验。
- 生成分布指标不保证物理通道有效、几何一致或程序图结构合法。
以下是待验证的PMG研究方向,不是原论文结果。
- 对程序化材质图或参数序列区分token语义:图节点/端口和图像patch的邻接结构不同,不能直接把2D PE贴到任意序列。
- 将全局材质类别/时间放adaLN,局部参考图或文本关系用更细条件机制,比较条件保真与算力,而非默认全部gate调制即可。
- 做同参数不同token数、同训练算力不同宽深的对照,报告可编辑性、节点有效率、渲染误差和生成多样性。
- 在高频材质上同时测VAE重建上限与扩散误差,确定瓶颈来自表示还是去噪器。
- 原有笔记可保留与后续模型的联系,但把原论文事实、代码版本发现和研究假设分层标注。
14 · 附录全部样本与阅读结论
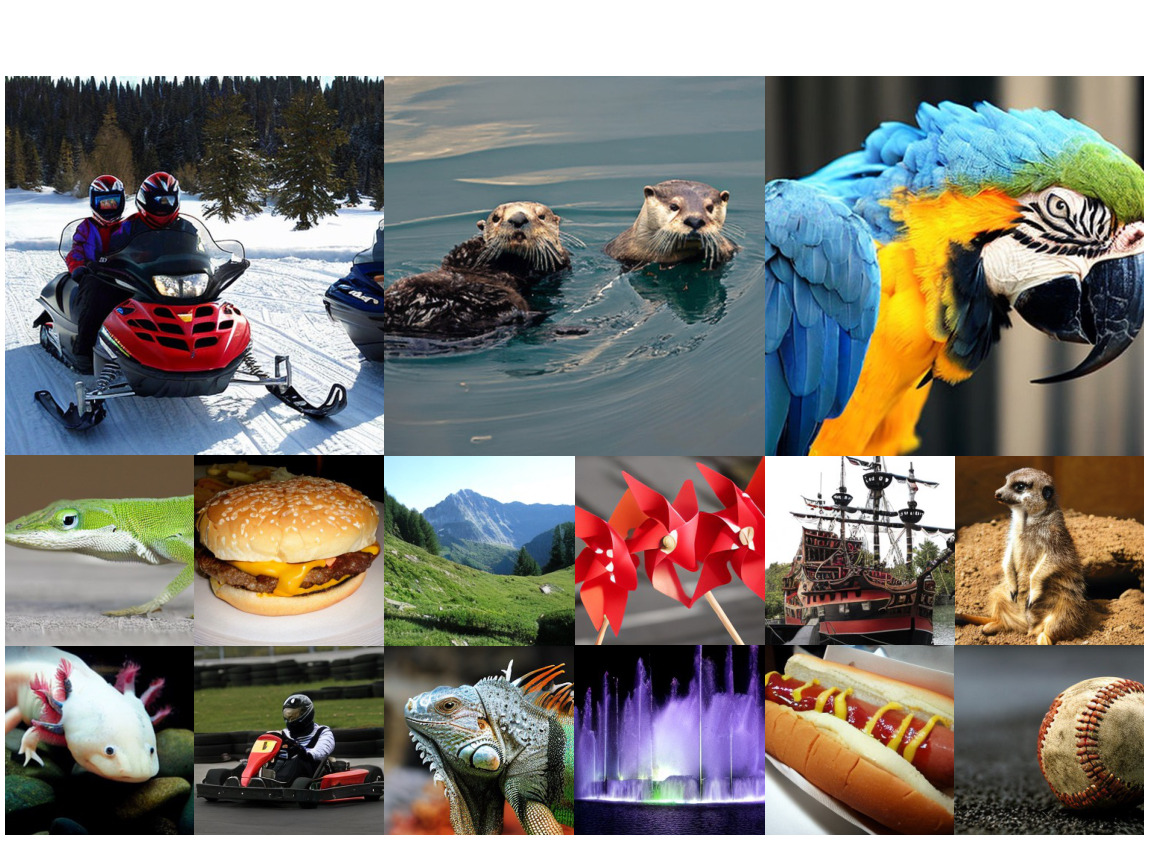
下面保留Figures14–33的全部未精选样本组,包括512²与256²、不同类别和CFG,原图注信息保留。需要网络加载远程图像;已做HTTP/图像静态检查,浏览器验收仍按用户安排延后。


- DiT改变去噪骨干,不改变扩散的基本目标;完整系统仍有卷积VAE。
- 减少patch增token和算力,不显著增参数;XL/2是模型配置加latent patch大小。
- adaLN-Zero通过条件残差gate置零使block identity,不能说LayerNorm本身变identity。
- 400K无CFG、7M有CFG、不同decoder、精选样本是不同设置,不能混报。
- 512²只优于表内扩散模型,不胜过StyleGAN-XL的FID;原三通道CFG是明确附录细节。
- 6张完整原表、33幅原图组、Appendix A–D覆盖;原笔记和选区锚点字节保留,未写回vault或发布。