2.20 FID / 9.89 IS
CIFAR-10 无条件生成,NCSN++ continuous deep,VE SDE,训练中最佳 FID checkpoint。
把噪声过程、分数学习与生成求解器分开理解
完整36页与附录A–I · 5张原表、17张原图 · 数学边界与双版本实现审计
Score SDE 的核心贡献是把“怎样加噪、学什么、怎样生成”拆成可以独立研究的三个部分:预先规定前向随机微分方程,用同一个时间条件网络估计各时刻的分布分数,再选择反向 SDE、预测校正采样器或概率流 ODE。它不仅提供一个更强的生成器,也说明 DDPM 与 Langevin 系列为什么可以共用 score,以及为什么同一网络能支持密度计算和条件生成。
CIFAR-10 无条件生成,NCSN++ continuous deep,VE SDE,训练中最佳 FID checkpoint。
均匀去量化 CIFAR-10,DDPM++ continuous deep,sub-VP,最后 checkpoint 的概率流 ODE 密度。
CelebA-HQ 定性生成,另一个高分辨率配置。上述三项成绩不能拼成“同一模型一次运行”。
| 对象 | 定义和作用 | 不能混同的内容 |
|---|---|---|
| 前向 SDE | 固定漂移和扩散系数,把数据扰动为接近简单先验的分布 | 不是训练得到的神经生成器 |
| Score 网络 | 输入带噪图像和时间,输出与图像同维的对数密度梯度 | 不是标量概率,也不是分类器置信度 |
| 反向 SDE | 在负时间步下使用完整 score 漂移,并持续加入随机增量 | 不是简单取消前向噪声 |
| 概率流 ODE | 使用一半 score 系数、无扩散项的确定性输运 | 理想情况下共享边缘分布,不共享随机轨迹 |
| 有限步采样程序 | 离散器、corrector、末端去噪和数值容差的组合 | 其实际输出不自动等于理想连续过程 |
主来源:arXiv v2,2021-02-10,ICLR 2021 Oral。原件 36 页:正文 1–9 页,致谢及参考文献 10–12 页,附录 A–I 为 13–36 页;本页覆盖全部 5 张编号表、17 张编号图及 5 个算法。旧笔记原字节保留,纠正清单见后文。

SMLD 先在一组噪声尺度上学 score,再逐尺度运行退火 Langevin;DDPM 则固定离散前向链,学习反向高斯转移。二者都在不同噪声水平上学习去噪信息,但网络、损失参数化与采样器绑在各自离散设计上,容易把模型能力和采样策略混为一谈。本文把有限个噪声分布扩展为连续密度族,从而可以研究“同一学到的 score 换一个 solver 会怎样”。
正向加噪不要求知道数据密度的显式表达式,只需要数据样本;反向生成也不需要知道归一化常数,只需要对图像求导的 log-density 梯度。难点由“直接学复杂密度”转为“在所有扰动尺度准确学向量场”。大噪声改善低密度区域的估计和跨模态移动,小噪声负责细节,时间条件网络共享不同尺度的统计结构。
理论基础的反向扩散定理来自 Anderson,去噪 score matching 来自既有研究,概率流推导受已有 Fokker–Planck 工作启发。论文的新贡献主要是把这些部分组成统一生成框架,提出 PC 采样组合、sub-VP、与神经 ODE 的实用联系,并通过系统架构探索把性能做强。不能把每个基础定理都归为本文首次提出,也不能用今天的扩散模型成绩改写 2021 年的历史比较。

令数据维数为 \(d\),连续时间 \(t\in[0,T]\)。图像实验通常取 \(T=1\)。\(\mathbf{x}(t)\) 是随机过程,\(\mathbf{x}_t\) 是某时刻的随机变量;一个给定起点仍对应许多 Brownian 随机轨迹。只固定时间并不会让图像分布变成高斯:高斯通常指固定干净样本后的条件扰动核,边缘分布是这些高斯对数据分布的混合。
| 符号 | 含义 |
|---|---|
| \(p_0,p_t,p_T\) | 数据、时刻 t 的扰动边缘、终端分布;计算时用简单高斯近似终端先验 |
| \(p_{0t}(\mathbf{x}_t\mid\mathbf{x}_0)\) | 从给定干净样本到 t 的条件核,仿射漂移实验中可解析 |
| \(\mathbf{f},g,\mathbf{G}\) | 向量漂移、标量扩散系数、一般矩阵扩散系数;不是 score 网络参数 |
| \(\mathbf{s}_{\theta},\boldsymbol{\epsilon}_{\theta}\) | score 参数化与噪声预测参数化,符号和尺度变换必须与核标准差匹配 |
| \(\lambda(t),\epsilon,r\) | 训练权重、截断终止时间、corrector 的信噪比超参数;三个量互不相同 |
| \(\alpha_i,\bar\alpha_i\) | 原论文用 α 表示累积乘积;本页解释 DDPM 时用 \(\bar\alpha_i=\prod_{j=1}^{i}(1-\beta_j)\) 避免与代码单步 alphas 混淆 |
标准正态噪声写作 \(\mathbf{z}\sim\mathcal N(\mathbf0,\mathbf I)\)。高斯记号第二个参数是协方差,不是标准差。令条件核为 \(\mathcal N(a(t)\mathbf{x}_0,b(t)^2\mathbf I)\),则条件 score 为 \(-(\mathbf{x}_t-a(t)\mathbf{x}_0)/b(t)^2=-\mathbf z/b(t)\)。这里的已知训练靶标与未知边缘 score 是两个对象,下一节解释为何前者能训练后者。
SMLD 的原式 1 以噪声方差加权每个尺度的 DSM;DDPM 原式 3 把常用噪声 MSE 改写成 score MSE,权重是条件方差。两者都属于以下统一形式:
以均方误差的条件期望最优性,可得最优网络是条件 score 在给定带噪样本下的后验平均;把梯度移入边缘化积分后,正好是边缘 score。此论证要求相关可微、可积条件,且“最优”是假设数据、容量与优化充分,绝不保证训练后的网络处处精确。
对上述高斯核取 \(\lambda(t)=b(t)^2\),训练可直接实现为 \(\mathbb E\|b(t)\mathbf{s}_{\theta}+\mathbf z\|^2\)。若令网络输出噪声预测,则 \(\mathbf{s}_{\theta}=-\boldsymbol{\epsilon}_{\theta}/b(t)\),损失变成噪声 MSE。负号不可省,VP 的 b 随时间变化;不是两个模型仅差一个固定终端系数。SMLD 的离散权重为 \(\sigma_i^2\),DDPM 为 \(1-\bar\alpha_i\)。
一次训练更新只需抽一批数据、一个 t 和一份高斯噪声,直接解析采样带噪图像;不必跑完整前向链或对求解器反向传播。连续训练学习的仍是同一个时间条件网络,并不意味着训练无时间采样误差。改变权重会改变有限容量下各噪声区间的拟合优先级,最佳似然和最佳视觉质量未必一致。
原文 §2.1–2.2、§3.3;原式 1、3、7;官方 losses.py 的 get_sde_loss_fn 与 get_score_fn。
第一式的时间向前;第二式从 T 走向 0,因此 \(\mathrm dt\lt0\),\(\bar{\mathbf w}\) 是反向时间方向定义的标准 Wiener 过程。不能把它当成向前 Brownian 增量再取负数。前向轨迹里的随机噪声也没有被逐项“找回”,反向过程恢复的是正确的概率演化。
把一步正的步长写为 \(h\gt0\),从 t 走到 t−h 的 Euler–Maruyama 更新是:
漂移乘 h,噪声乘根号 h,score 修正乘 \(g^2\)。若改用正向增长的新钟 \(\tau=T-t\),漂移应写成 \(-\mathbf f+g^2\mathbf s\),不要一边改钟一边沿用旧负号。网络、终端先验近似、有限步离散都引入误差;原论文引用的唯一强解条件也不是任意神经场都自动满足的许可证。
直觉上,正向扩散从高密度处向外摊开;反向时 score 指向高密度区域,补偿扩散造成的概率散开。但“梯度上升找 mode”仍不足以描述生成,因为反向 SDE 的噪声项与时间变化共同维持多模态分布,去掉噪声却保留完整 score 系数通常会走向错误分布。
定义 \(B(t)=\int_0^t\beta(s)\,\mathrm ds\)、\(a(t)=e^{-B(t)/2}\)。以下表同时写清扩散系数和条件方差,避免把 sub-VP 标准差误开平方:
| 过程 | 漂移 f | 扩散平方 g² | 条件均值 | 条件方差 b² |
|---|---|---|---|---|
| VE | 0 | \(\mathrm d\sigma(t)^2/\mathrm dt\) | \(\mathbf x_0\) | \(\sigma(t)^2-\sigma(0)^2\) |
| VP | \(-\beta(t)\mathbf x/2\) | \(\beta(t)\) | \(a(t)\mathbf x_0\) | \(1-e^{-B(t)}\) |
| sub-VP | \(-\beta(t)\mathbf x/2\) | \(\beta(t)(1-e^{-2B(t)})\) | \(a(t)\mathbf x_0\) | \((1-e^{-B(t)})^2\) |
VE 离散增量的方差是相邻噪声方差的差:\(\mathbf x_i=\mathbf x_{i-1}+\sqrt{\sigma_i^2-\sigma_{i-1}^2}\mathbf z\)。只有这样各步独立噪声方差才望远镜求和为总方差。VP 的 \(\mathbf x_i=\sqrt{1-\beta_i}\mathbf x_{i-1}+\sqrt{\beta_i}\mathbf z\),在 \(\beta_i\approx\beta(t)\Delta t\) 极限下,展开平方根得到漂移 \(-\beta(t)\mathbf x/2\)。离散 β 与连续 β 相差时间尺度,不能直接把最大 20 当离散单步概率。
因此 VP 只有在初始协方差为单位阵时才每时刻保持单位协方差;一般是有界并趋于单位阵。相同起点和 β 下,二者差为 \(e^{-B(t)}(1-e^{-B(t)})\mathbf I\succeq0\),故 sub-VP 方差不超过 VP。sub-VP 在中间时刻注入更少噪声,仍可在足够大的 B 下逼近标准正态,其较好似然是本文的经验结果,不是对所有数据集的普遍保证。
VE 的“exploding”说的是随噪声尺度增大方差可增大,并非在有限 T 必然数学发散。有限终点的分布仍含少量数据均值与结构;把它替换为零均值高斯只是受噪声强度控制的近似。以上推导对应原式 8–12、20–29。
CIFAR 配置中 VE 使用 \(\sigma_{\min}=0.01,\sigma_{\max}=50\),数据尺度为 [0,1];VP/sub-VP 图像通常转到 [−1,1],β 从 0.1 线性升至 20。噪声参数和输入尺度是一套约定,混用会让 score、损失与终端先验都错位。官方 NCSN++ 内部又把非 centered 输入变换为 [−1,1],这是网络内部预处理,不应悄悄改变外层 VE 核的定义。
原附录 C 专门讨论 VE 起点:离散约定 \(\sigma(0)=0\),而连续几何日程的右极限是 0.01,所以不能把日程在零点假装成光滑函数。一般式 29 中的方差差值与实践式 31 中直接使用 \(\sigma(t)^2\) 需要这项边界约定。实现避开零点,在 \([\epsilon,1]\) 上训练或求解。
| 用途 | VE ε | VP / sub-VP ε | 说明 |
|---|---|---|---|
| 训练 | 10⁻⁵ | 10⁻⁵ | 防止零方差导致除零或极大 score |
| 采样 | 10⁻⁵ | 10⁻³ | VP 末端方差匹配离散 DDPM 的第一噪声层 |
| 似然 | 10⁻⁵ | 10⁻⁵ | 论文观察更小截断常改善 likelihood,但不是无代价精确零点 |
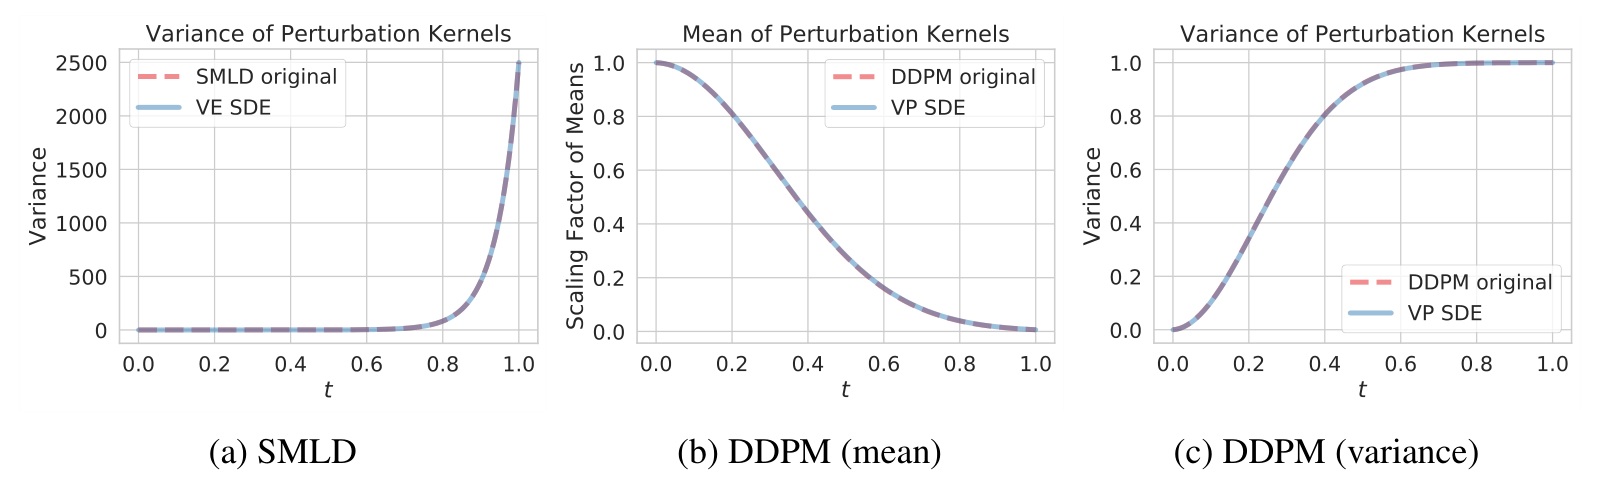
原式 30–34 是上节高斯核的具体实例:VP 标准差为 \(\sqrt{1-e^{-0.1t-9.95t^2}}\),sub-VP 则是 \(1-e^{-0.1t-9.95t^2}\)。Figure 5 比较 1000 步离散核和连续核的均值及方差,说明近似吻合,而不是任意有限步离散精确等价。
标量、与状态无关的扩散满足 Fokker–Planck 方程:
右侧是连续性方程,因此向量场 \(\mathbf v=\mathbf f-\frac12g^2\nabla\log p_t\) 的确定性流具有同一族边缘密度。把它反向积分即可从先验生成数据。这个一半来自扩散方程的二阶项,不能把反向 SDE 中的噪声删掉后保持系数 1。
相同的是每个时刻的分布,不是耦合、转移概率或单条路径。ODE 给定初值后没有额外随机性;SDE 会持续分叉。同一随机种子不能保证两种 sampler 产生同一张图。只有真实 score、匹配端点分布和精确积分的理想条件下,才能直接使用边缘等价结论。
学到的近似 score 通常不等于模型自己所有边缘的 score,此时把它分别代入 ODE 与 SDE,两个生成分布可能不相同。因此 ODE 可定义一个可计算密度的模型,但其 likelihood 不能自动称为“同一近似反向 SDE 的精确 likelihood”。这是读摘要最容易漏掉的范围限制。
原文 §4.3;附录 D.1 原式 35–38 的逐项散度重写。这里从标量情形展示逻辑,一般矩阵情形见下一节。
令 \(A(\mathbf x,t)=\mathbf G(\mathbf x,t)\mathbf G(\mathbf x,t)^{\mathsf T}\)。当扩散依赖状态时,多出的矩阵散度项不能省略;按原文逐行散度约定:
条件反向 SDE 再减去 \(A\nabla_{\mathbf x}\log p_t(y\mid\mathbf x)\),对应原式 18。原式 15 是一般前向 SDE;原式 35–37 展开双重求导,利用 \(\nabla p=p\nabla\log p\) 把扩散项写成流的散度。理论支持一般 G,但官方本次核查的 SDE 基类和反向封装主要实现标量、状态无关扩散,不能把代码包装器直接用于任意矩阵 G。
对于非仿射漂移,扰动核未必有解析式。可数值模拟前向过程得到样本,再使用不需要条件核 score 的 sliced score matching。此处原 v2 的式 19 在 PDF 文本和 arXiv HTML 数学源码中都写成了形如 \(\mathbf v^{\mathsf T}\mathbf s_{\theta}\mathbf v\) 的项,缺少 Jacobian,维数也不成立。下面明确写出数学上应使用的 score-matching 形式,不冒充原式逐字正确:
该式把 divergence 用随机方向的 Jacobian 二次型估计;在标准边界条件下与 Fisher divergence 只差不依赖参数的常数。额外前向模拟和导数计算并非免费,论文的主要图像实验仍用解析高斯核的 VE/VP/sub-VP DSM,不应声称已经实证了任意复杂 SDE。
沿概率流 ODE,连续变量的密度满足 \(\mathrm d\log q_t(\mathbf x_t)/\mathrm dt=-\nabla\cdot\mathbf v_{\theta}\)。从数据积分到 T 后,模型密度为:
这里用 q 和 π 显式区分学到的 ODE 模型与未知真实数据密度。积分式前是加号,因为我们从低噪声向先验方向编码;若程序把散度状态定义成负号,最后合并也必须相应改变。计算的是向量场 Jacobian 的 trace,不是 score 向量求和或图像梯度模长。
Hutchinson–Skilling 估计器通过自动微分的向量–Jacobian 乘积实现,不构造 d×d 矩阵。官方默认 Rademacher ±1 向量,也支持 Gaussian;每次 ODE 求解先抽一次探针并沿积分保持固定,重新运行再抽。无偏的是理想 trace 估计;有限探针、有限容差、自适应求解与 ε 截断仍有误差,不能把“exact likelihood”解释成浮点程序无误差或真实数据 likelihood 已知。
论文使用 SciPy RK45,atol=rtol=10⁻⁵,ε=10⁻⁵;Table 2 的 test bits/dim 平均五次运行。其“exact”主要区别于用变分下界代理 log-likelihood,基于可逆流的 change-of-variables;训练并非最大似然训练。
8-bit 像素先做均匀去量化:\(u=(k+\xi)/256,\ \xi\sim\mathcal U(0,1)\)。若密度建在 [0,1],bpd 为 \(8-\log q(u)/(d\log2)\);若再缩放为 [−1,1],缩放 Jacobian 使常数变为 7。这个量是均匀去量化协议下的连续密度评价;把一个 bin 的积分变成离散概率仍有 Jensen 下界关系。Table 2 的带星 DDPM 数字来自离散数据 ELBO,不能只看数值便把差值全归因于“去掉 ELBO 松弛”。
末端 Tweedie 去噪是采样后处理,可能改变分布或可逆性; likelihood.py 对纯 ODE 积分计算密度,不是对“ODE 加末端去噪”复合操作无条件给出同一密度。评估时要记录这一差别。
固定网格可用原式 43–44 的 probability-flow predictor;也可从先验初值反向运行自适应 RK45,容差控制局部积分误差。Figure 3 的 14、86、548 是三种精度下的 score 函数评估次数,说明同一 ODE 可以更灵活地分配计算;“减少超过 90% 且视觉无损”是展示样本的定性描述,不是整个数据集统一加速倍数或任何容差都保 FID 的定理。

给定固定前向 SDE、同一真实数据分布和精确 score,概率流向量场确定;在适当唯一解条件下,某输入的编码也确定。改变 SDE 或日程后一般得到另一种编码,因此“uniquely identifiable”不是跨任意生成器的万能语义坐标。有限训练结果只是近似;附录用每分辨率 4 与 8 个 block 的两种 NCSN++ 模型对 16 张 CIFAR 图像比较编码,不能把这个小实验写成所有图像的严格同一性证明。
Figure 7 画一张图前 100 维 latent;Figure 8 的打乱基线和维度相关性支持相似编码,图内某一维例子 r=0.96,并非所有维度均值。图中没有提供可重建的完整数字表,本页保留原图,不伪造点值或统计检验。
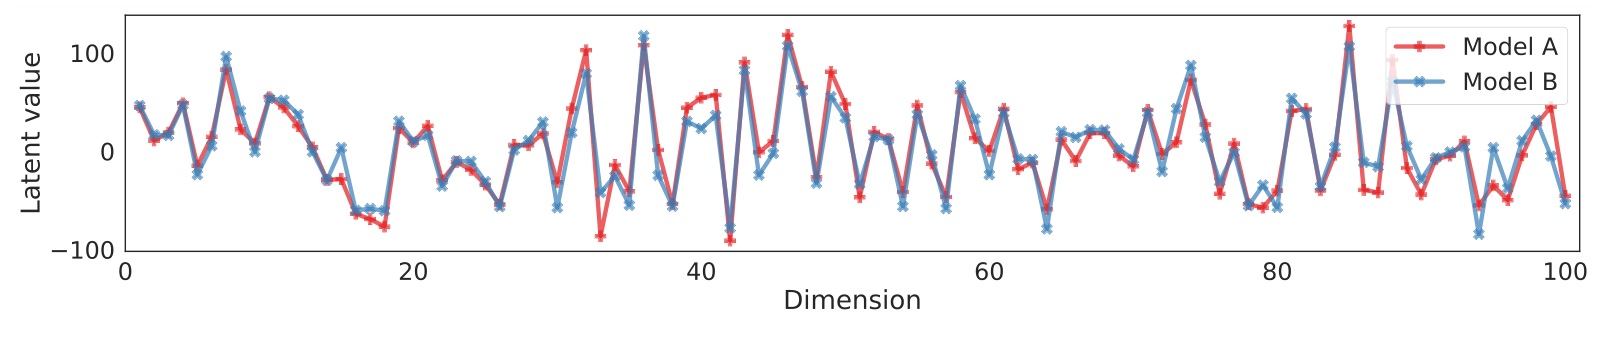
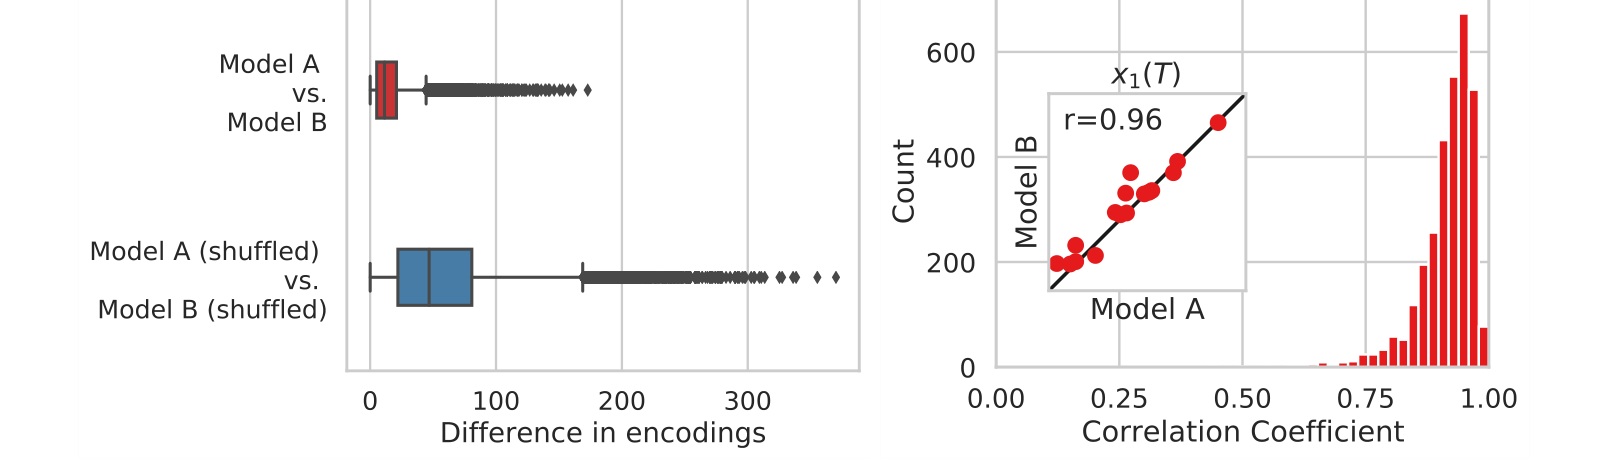
同一 ODE 可把真实图像编码为 latent,再逆积分重建或进行球面插值、改变 latent 范数来调温。温度变化会改变先验,因而输出分布也改变;插值平滑不代表每个 latent 方向已经语义解耦。Figure 6 来自 256×256 CelebA-HQ 的 DDPM 配置,而不是 CIFAR 的最佳 VE 模型。


设前向离散一步为 \(\mathbf x_{i+1}=\mathbf x_i+\mathbf f_i(\mathbf x_i)+G_i\mathbf z\),其中 \(\mathbf f_i,G_i\) 已经吸收步长。对从 i+1 返回 i 的步骤:
这是原式 41–46 的标量写法。reverse diffusion 与 DDPM ancestral 都逼近同一连续反向过程,但有限步公式不同。VP ancestral 为 \(\mathbf x_{i-1}=(\mathbf x_i+\beta_i\mathbf s_{\theta})/\sqrt{1-\beta_i}+\sqrt{\beta_i}\mathbf z\);VP reverse diffusion 的均值则为 \((2-\sqrt{1-\beta_i})\mathbf x_i+\beta_i\mathbf s_{\theta}\)。展开到 β 的一阶才对齐;把两者叫成完全同一个 finite-step 算法会丢失实验问题。
VE ancestral 的均值与 reverse diffusion 一样,噪声方差更小,是条件高斯后验推导出的选择;最后 \(\sigma_0=0\) 时噪声消失。附录 F 在参数化说明里把 score 写成估计正的 z/σ,但条件高斯 score 应是负的 z/σ;其均值式、原式 47、官方 losses.py 的负 target 相互一致,文字符号错误已在此显式指出。
连续 VP/sub-VP 实验改用 Euler–Maruyama predictor,原因是原 DDPM 离散器在靠近零时间处对连续方差的匹配较差,影响 FID。任何 solver 名称后都应跟上时间网格、步数、末端 ε、是否去噪和 score 参数化,才是一份可复现实验描述。
原 Algorithm 1 先 predictor 从当前时间向低噪声时间移动,再做 M 个 corrector 使样本向该时刻的边缘靠近。Algorithm 2/3 分别把 VE/VP 的 reverse-diffusion 更新代入;Algorithm 4/5 给出退火 Langevin corrector。Langevin 更新为:
VP Algorithm 5 为 \(\eta_{\mathrm{VP}}=2\alpha_i(r\|\mathbf z\|_2/\|\mathbf s_{\theta}\|_2)^2\),这里暂保留原文记号 αᵢ,并在实现审计中区分其与代码单步 alphas。r 控制一次更新中 score 漂移与随机噪声的相对尺度,不是训练 loss 权重;论文大批量下用 batch 平均范数,小批量建议以根号 d 代替噪声范数。有限步未 Metropolis 校正的 Langevin 只近似保持目标分布,corrector 也不能保证修正所有网络系统误差。
一般高斯核的 Tweedie 后验均值可写为 \(\widehat{\mathbf x}_0=(\mathbf x_t+b(t)^2\mathbf s_{\theta})/a(t)\),VE 的 a=1。官方 PC 返回最后 predictor 的无噪均值 x_mean,ODE sampler 可额外执行一次 reverse-diffusion 均值更新;精确实现并非直接逐字计算同一个任意核公式。论文指出人眼不明显的小噪声会显著恶化 FID,因此所有比较都要检查去噪开关。
重要代码差异:两套官方实现的每个网格时刻实际上先 corrector 再 predictor,不是 Algorithm 1 的先后顺序。它是在当前密度上校正后再向前推进的可用离散变体,不能声称有限步逐行完全复现了伪代码。对应源码位置与 α 记号问题在实现审计中列出。
Table 1/4 比较固定网络下的采样:两种SDE均使用Ho等DDPM架构,分别按原离散SMLD和DDPM目标训练1000个噪声层,并不是后面最佳NCSN++ deep的对照。CIFAR-10 FID 越低越好,± 为五次采样运行标准差,不是五次独立训练。P1000 约 1000 次 score 评估;P2000、C2000、PC1000 都约 2000 次,PC1000 是 1000 predictor 加 1000 corrector。C2000 列在原表跨三行合并,本页重复显示以避免误读成三个不同值。
| Predictor | VE P1000 | VE P2000 | VE C2000 | VE PC1000 | VP P1000 | VP P2000 | VP C2000 | VP PC1000 |
|---|---|---|---|---|---|---|---|---|
| ancestral sampling | 4.98 ± .06 | 4.88 ± .06 | 20.43 ± .07 | 3.62 ± .03 | 3.24 ± .02 | 3.24 ± .02 | 19.06 ± .06 | 3.21 ± .02 |
| reverse diffusion | 4.79 ± .07 | 4.74 ± .08 | 20.43 ± .07 | 3.60 ± .02 | 3.21 ± .02 | 3.19 ± .02 | 19.06 ± .06 | 3.18 ± .01 |
| probability flow | 15.41 ± .15 | 10.54 ± .08 | 20.43 ± .07 | 3.51 ± .04 | 3.59 ± .04 | 3.23 ± .03 | 19.06 ± .06 | 3.06 ± .03 |
VE 上单独 ODE predictor 较差,加入 corrector 后从 15.41 降至 3.51;VP 上 PC 的改善较小。相同计算预算应把 PC1000 与 P2000 比,而不是只报对 P1000 的提升。原 Table 1 使用线性时间 embedding 插值,Table 4 改为向下取整插值:
| Predictor | VE P1000 | VE P2000 | VE C2000 | VE PC1000 | VP P1000 | VP P2000 | VP C2000 | VP PC1000 |
|---|---|---|---|---|---|---|---|---|
| ancestral sampling | 4.98 ± .06 | 4.92 ± .02 | 20.43 ± .07 | 3.62 ± .03 | 3.24 ± .02 | 3.11 ± .03 | 19.06 ± .06 | 3.21 ± .02 |
| reverse diffusion | 4.79 ± .07 | 4.72 ± .07 | 20.43 ± .07 | 3.60 ± .02 | 3.21 ± .02 | 3.10 ± .03 | 19.06 ± .06 | 3.18 ± .01 |
| probability flow | 15.41 ± .15 | 12.87 ± .09 | 20.43 ± .07 | 3.51 ± .04 | 3.59 ± .04 | 3.25 ± .04 | 19.06 ± .06 | 3.06 ± .03 |
这里有一个值得保留的限定:Table 4 中 VP ancestral P2000=3.11 优于 PC1000=3.21;reverse diffusion P2000=3.10 也优于 PC1000=3.18。因此“corrector 总胜过加倍 predictor”太强,正文说通常更好或接近才符合完整表。离散训练只有 1000 噪声层,P2000 使用额外插值,不能把结果全部归因于积分阶数。
| Predictor | VE P1000 | VE P2000 | VE C2000 | VE PC1000 | VP P1000 | VP P2000 | VP C2000 | VP PC1000 |
|---|---|---|---|---|---|---|---|---|
| ancestral sampling | — | — | 0.22 | 0.17 | — | — | 0.27 | 0.01 |
| reverse diffusion | — | — | 0.22 | 0.16 | — | — | 0.27 | 0.01 |
| probability flow | — | — | 0.22 | 0.17 | — | — | 0.27 | 0.04 |
r 以 0.01 步长网格搜索得到,表中 predictor-only 的 r 不适用;corrector-only 在每噪声层 2 步,PC 默认每层 1 步。CIFAR 训练 batch128、采样 batch1024;LSUN bedroom/church 256² 训练 batch64、采样 batch8,r=0.075。Figure 9 展示预算在 P 与 C 间分配的定性效果,没有对应的完整数值 FID 表,不填造曲线点。


网络是多尺度卷积 U-Net 型 score 网络,不是 Transformer,也没有单独的 VAE latent 压缩。输入为 H×W×3 带噪 RGB 与一个时间或噪声条件,输出同尺寸三通道向量。下采样路径保存特征,瓶颈做残差和 attention,上采样拼接 skip 特征恢复空间分辨率。噪声 embedding 经两层全连接注入各 residual block;“conditional=True”在这里表示噪声条件,不是训练时使用类别标签。
| 组件 | NCSN++ / VE | DDPM++ / VP 与 sub-VP |
|---|---|---|
| 基础通道与分辨率 | CIFAR nf=128,倍率 (1,2,2,2),对应 32、16、8、4 像素;16 像素 attention,瓶颈也有 attention | |
| 归一化与激活 | GroupNorm、Swish;dropout=0.1;卷积大小 3;输出末层 init_scale=0 | |
| 残差块 | BigGAN 型;skip 相加后按根号 2 缩放;基础每分辨率 4 个,deep 为 8 个 | |
| 上/下采样抗混叠 | FIR,核 [1,3,3,1] | 不使用 FIR |
| 渐进输入 / 输出 | residual / none | none / none |
| 连续时间 embedding | 对 log σ 的随机 Fourier 特征,scale16 | 官方配置保留 positional embedding;时间标签缩放为 t×999 |
| 输出解释 | 模型内部除以 σ,输出 score | 网络输出经 wrapper 取负并除以条件标准差成为 score |
| EMA | 0.999 | 0.9999 |
“4 个 block 每分辨率”是配置计数,不是整个网络只有 16 层。源码下行每级 num_res_blocks,上行每级 num_res_blocks+1,另有瓶颈、重采样 residual block、attention 与输入输出卷积。deep 翻倍的是这项 block 配置,不应在没有测量时声称总参数精确翻倍。论文没有提供统一参数量表,本次没有实例化模型统计参数或 FLOPs。
附录 H 的架构探索包含 FIR、skip rescale、BigGAN block、2→4 blocks、输入与输出 progressive 组合。VE 在 CIFAR 和 CelebA64 上比较,VP 仅 CIFAR;VP 共 144 个配置,NCSN++ 的结构排第 4,而最佳 DDPM++ 去掉 FIR 与 progressive。Equalized learning rate 早期有害而未继续探索,不能列成最终训练技巧。
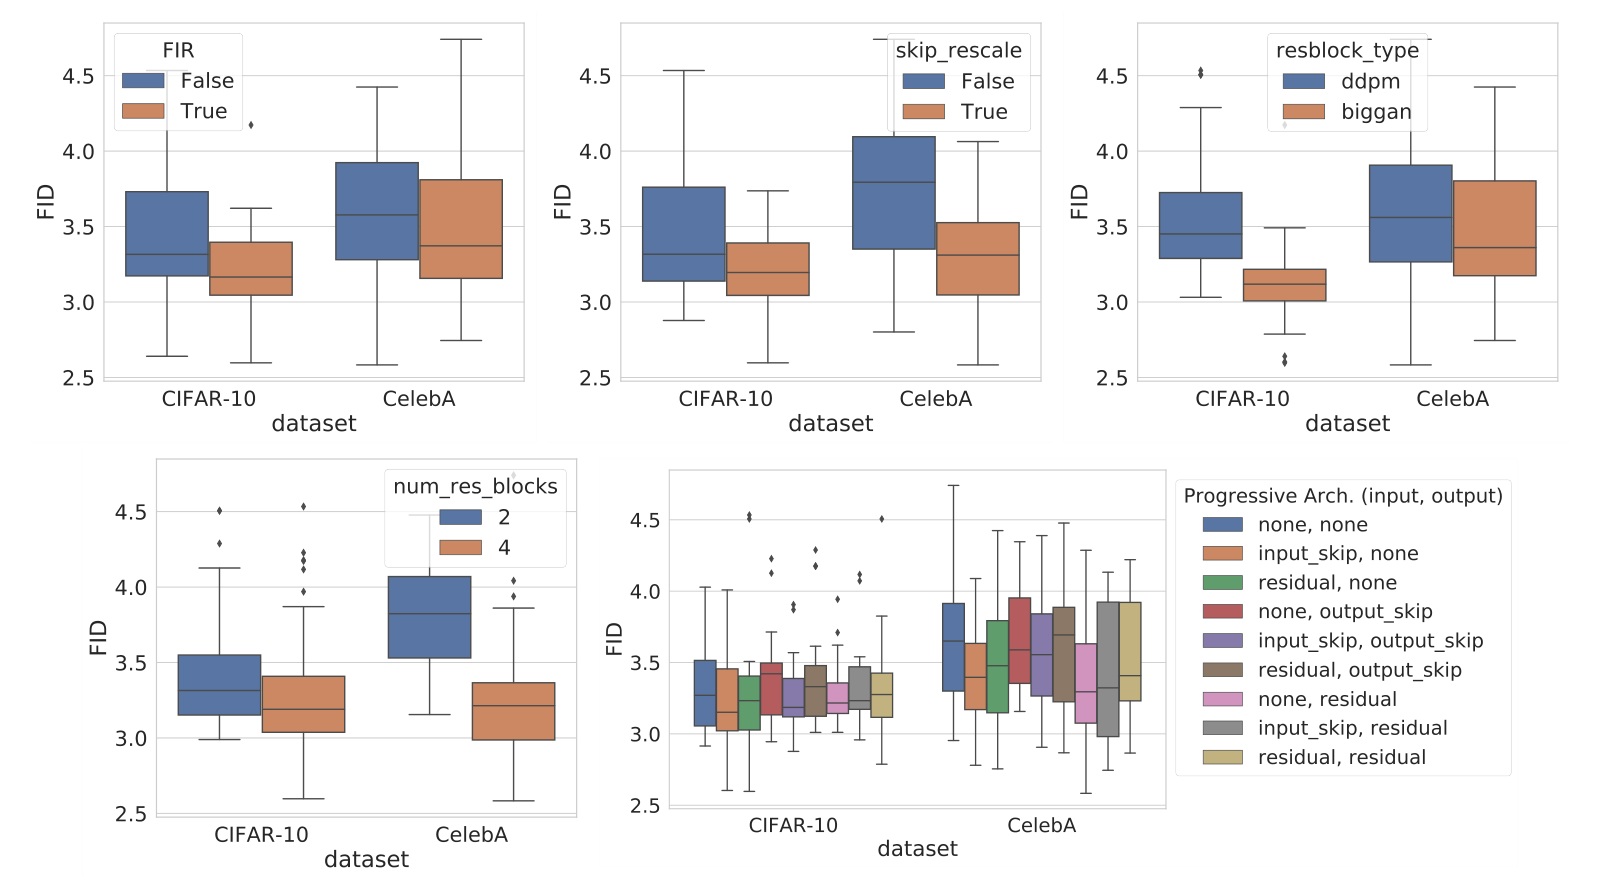
Figure 10 是其他组件也可以变化时的箱线图,不是所有因素都严格固定的一次单变量对照。论文没有逐配置数字表,本页完整保留五面板、不给箱线位置编造小数。结果支持“组件组合有帮助”,对每一项的独立因果增益应谨慎。
CIFAR-10 是 60,000 张 32² 彩色图,官方划分 50,000 train / 10,000 test;无条件生成不使用类别监督,只有额外分类器实验用标签。CelebA64 用于 VE 架构搜索,LSUN bedroom 与 church outdoor 的 256² 图用于 PC、补全与上色,CelebA-HQ 用于 256² ODE 展示和 1024² 生成。这些不同目的的数据实验不可合并成单一训练集。CIFAR 原始数据说明
官方 loader 的 CIFAR 使用 train/test split 与训练随机水平翻转;CelebA 中央裁 140 再缩放,LSUN 按分辨率配置缩放裁切。用于 bpd 的 loader 专门打开均匀去量化,默认训练配置 uniform_dequantization=False,不要为了“遵从似然协议”无意改写所有训练图像。高分辨率 CelebA-HQ 的精确文件清单、全部预处理 provenance 与原内部 checkpoint 本次未获得。
| 设置 | 论文与已固定源码 | 范围限定 |
|---|---|---|
| 优化器 | Adam,lr2×10⁻⁴,β₁0.9,PyTorch 明确 β₂0.999,eps10⁻⁸,weight decay0 | 来自默认 CIFAR 配置与 losses.py,不能默认所有历史外部基线相同 |
| 稳定化 | 5000-step 线性 warmup,梯度范数裁剪 1,EMA | VE 与 VP 的 EMA 不同 |
| 基础架构搜索 | 默认 1.3M iterations,每 50k 保存 | VE 用 0.5M 后各 checkpoint FID 平均;VP 用 0.25M–0.5M 平均 |
| 连续与 deep | 论文 NCSN++ cont. 描述降为 0.95M;deep 配置 n_iters=950001 | 当前非 deep NCSN++ cont. 配置仍继承 1300001,复现须明确覆盖 |
| batch | CIFAR128;LSUN64;CelebA-HQ1024为8 | 采样 batch 另有1024和8,不与训练混同 |
| FID | 50,000 生成样本,tensorflow_gan | 统计文件、Inception 版本与归一化也是协议的一部分 |
| 最终选模 | Table3 训练中最低 FID;Table2 最后 checkpoint | 同时报告 best 与 last,不能当成同一权重的性能权衡 |
连续损失默认 likelihood_weighting=False,意味着按论文的核方差加权。库里还实现了另一篇工作对应的 g² likelihood weighting,不能看到选项便归入本文所有结果。VE 默认 reduce_mean=False 使用半个维度求和,VP/sub-VP 配置 reduce_mean=True;把 sum 改为 mean 会改变数值尺度,需要连同优化设置记录。
JAX 原版依赖固定在 Flax0.3.1、JAX0.2.8、jaxlib0.1.59、TensorFlow2.4.0;PyTorch requirements 写 torch≥1.7.0 并仍依赖 TF 的数据与评估。README 的 4×V100 框架训练性能比较不是所有论文实验的实际硬件清单。本次只做静态阅读,不安装旧环境、不下载权重、不声称重现实测。
下表所有方法行和两项指标保留。“—”是原文未报告,不能填零。除带星两行外,NLL 是均匀去量化 CIFAR 的 bits/dim。带星行是 Ho 等工作的离散 ELBO 上界,FID 也来自其原采样协议;本文模型行的 FID 则来自 black-box ODE 和最后 checkpoint。
| Model | NLL Test ↓ bits/dim | FID ↓ |
|---|---|---|
| RealNVP (Dinh et al., 2016) | 3.49 | — |
| iResNet (Behrmann et al., 2019) | 3.45 | — |
| Glow (Kingma & Dhariwal, 2018) | 3.35 | — |
| MintNet (Song et al., 2019b) | 3.32 | — |
| Residual Flow (Chen et al., 2019) | 3.28 | 46.37 |
| FFJORD (Grathwohl et al., 2018) | 3.40 | — |
| Flow++ (Ho et al., 2019) | 3.29 | — |
| DDPM (L), Ho et al. | ≤ 3.70* | 13.51 |
| DDPM (Lsimple), Ho et al. | ≤ 3.75* | 3.17 |
| DDPM, 本文ODE评价 | 3.28 | 3.37 |
| DDPM cont. (VP) | 3.21 | 3.69 |
| DDPM cont. (sub-VP) | 3.05 | 3.56 |
| DDPM++ cont. (VP) | 3.16 | 3.93 |
| DDPM++ cont. (sub-VP) | 3.02 | 3.16 |
| DDPM++ cont. (deep, VP) | 3.13 | 3.08 |
| DDPM++ cont. (deep, sub-VP) | 2.99 | 2.92 |
最干净的内部比较是相同架构、同类训练与评估协议下换 SDE:基础 DDPM cont. 的 VP3.21→sub-VP3.05;DDPM++ cont. 的3.16→3.02;deep 的3.13→2.99。架构和 SDE 共同改善最终结果。原 H.2 段在讨论 DDPM++ 时提到3.21/3.05,但 Table2 明确把这一对标为基础 DDPM cont.;本页以完整表的行身份区分,DDPM++ 对应3.16/3.02。
Table2 中 VP DDPM++ cont. 虽 NLL3.16 好于基础 DDPM3.28,ODE FID3.93 却差于3.37。这直接说明 likelihood 与视觉质量不是同一个优化目标。2.99 的“最佳”限于论文当时、此去量化协议和列出的模型,不是今天的排行榜结论。
| 监督组 | Model | FID ↓ | IS ↑ |
|---|---|---|---|
| Conditional | BigGAN (Brock et al., 2018) | 14.73 | 9.22 |
| Conditional | StyleGAN2-ADA (Karras et al., 2020a) | 2.42 | 10.14 |
| Unconditional | StyleGAN2-ADA (Karras et al., 2020a) | 2.92 | 9.83 |
| Unconditional | NCSN (Song & Ermon, 2019) | 25.32 | 8.87 ± .12 |
| Unconditional | NCSNv2 (Song & Ermon, 2020) | 10.87 | 8.40 ± .07 |
| Unconditional | DDPM (Ho et al., 2020) | 3.17 | 9.46 ± .11 |
| Unconditional | DDPM++ | 2.78 | 9.64 |
| Unconditional | DDPM++ cont. (VP) | 2.55 | 9.58 |
| Unconditional | DDPM++ cont. (sub-VP) | 2.61 | 9.56 |
| Unconditional | DDPM++ cont. (deep, VP) | 2.41 | 9.68 |
| Unconditional | DDPM++ cont. (deep, sub-VP) | 2.41 | 9.57 |
| Unconditional | NCSN++ | 2.45 | 9.73 |
| Unconditional | NCSN++ cont. (VE) | 2.38 | 9.83 |
| Unconditional | NCSN++ cont. (deep, VE) | 2.20 | 9.89 |
Table3 同时保留 conditional 与 unconditional 两组,以防把需要标签的比较混成无条件。NCSN++ deep 的2.20 FID优于表中 conditional StyleGAN2-ADA2.42,但其 IS9.89小于10.14,因此不能写成所有指标全面优于条件 GAN。相比 NCSN++2.45,continuous2.38,再到deep2.20;这里同时涉及训练目标、embedding、训练时长和容量变化,不能把全部提升归为单独的“连续时间”。
DDPM++ deep VP 和 sub-VP 都有2.41 FID,但 IS 分别9.68与9.57。最佳视觉结果来自 VE,最佳似然来自sub-VP,支持为具体任务选 SDE,而不是宣布某一个始终优越。Table3多数新结果没有给±,不补造置信区间;Table1的五次采样标准差也不能移植给Table3。

1024² CelebA-HQ 使用修改版 NCSN++:continuous训练约2.4M步,batch8,EMA0.9999,Fourier scale16,input_skip 与 output_skip;PC采用2000时间步,每个predictor一次Langevin,r=0.15。与 CIFAR 基础 residual/none 架构不同。论文展示高保真人脸,同时承认面部对称性等可见缺陷,没有给这一分辨率的完整 FID、感知实验或GPU延迟表。

这些肖像是论文生成样本图,不用于身份推断。README 说明受发布政策影响,原 CelebA/CelebA-HQ 权重未公开,之后发布的是作者另行训练的 FFHQ1024、FFHQ256、CelebA-HQ256等。后续公开权重可帮助实践,但不是原 Figure12 checkpoint 的逐位复现证明。
Bayes 分解给出一个关键恒等式:
把右侧替换进反向 SDE 得到原式14/48。在条件分布趋近无条件终端先验时,可以从相同简单先验初始化;否则严格应从条件终端分布出发。分类器必须认识对应 t 的带噪样本,不能拿干净图片分类器梯度不加说明地套用全部时间段。
附录 I.1 在 CIFAR 上训练 Wide-ResNet-28-10,使用 VE 扰动,并以 log σ 的随机 Fourier 特征作为噪声条件;不同噪声层采样交叉熵训练。score model 使用 4-block NCSN++ 无条件模型,PC2000采样。原 Figure13 同时包含十类样本与分类准确率随噪声增大的曲线。分类梯度不需要重新训练 score 网络,但确实需要另一个有标签训练的 classifier;“所有条件生成完全无额外训练”不成立。


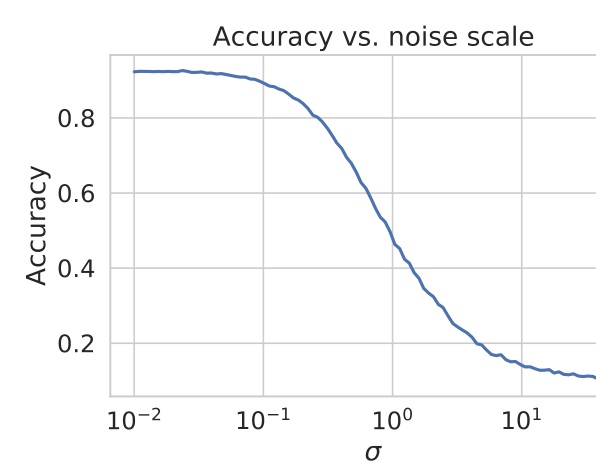
本文公式系数为1,没有把后来流行的 classifier-free guidance、空条件训练或大于1的 guidance scale 当成本文已验证结果。若人为放大梯度,一般改变目标分布,也可能牺牲多样性;这应作为后续实验设计,而非原文定理。
补全观察某些像素 Ω,未知区域为其补集。VE/VP 的漂移逐坐标作用、扩散对角,允许给已知像素加入与时间匹配的噪声,把它和当前未知区域组合,再用无条件 score 更新未知部分。附录 I.2 的关键步骤是近似忽略“原始已知像素 y”在给定其带噪版本之后的额外影响,并以一次采样代替对所有带噪观测的积分。它是实用后验近似,不是任意 mask 都严格无偏的后验采样器。
实现每个 corrector/predictor 更新后,用条件核的带噪已知区域重新投影,mask=1表示已知、0表示待补。一直把已知区域固定成干净像素会与高噪声网络输入分布失配。最终希望满足观测约束,同时生成多种合理填补;Figure14/15 展示 bedroom/church 的扩展样本,没有定量 PSNR/后验校准表。


上色先做正交通道变换,第一通道承载等权 RGB 灰度方向,其余两通道作为未知部分补全,然后逆变换。原 I.3 的矩阵是精确正交基的三位小数展示;实现保留更多精度并计算逆矩阵。用行向量颜色的约定,可写:
正交变换保持各向同性 Wiener 噪声;第一通道是和为根号3归一化的灰度分量,不应直接当作带感知权重的任意 luminance 公式。变换方向若写成列向量就必须转置 M;代码 einsum 明确采用行向量输入乘 M。Figure16/17 保留不同颜色解,说明颜色本来不唯一。


一般逆问题令观测模型为 \(p(y\mid\mathbf x)\),需要当前噪声层的观测梯度,不只是干净空间的梯度。原 I.4 要求能采样可处理的 \(p(y_t\mid y)\),并近似 \(p_t(\mathbf x_t\mid y_t,y)\approx p_t(\mathbf x_t\mid y_t)\),再抽一个 \(\widehat y_t\) 代替积分:
精确恒等式的条件 score 可以用于多种solver;然而这里的近似不保证一般非线性、噪声观测或严重病态问题仍精确。尤其 score of mixture 不是各分量 score 的简单无权平均。作者提供三个图像任务展示,未实测所有逆问题,也没有把未知 forward likelihood 自动学出来。
已固定并只读检查原 JAX 仓库 0acb9e0ea3b8cccd935068cd9c657318fbc6ce4c 与官方 PyTorch 版 cb1f359f4aadf0ff9a5e122fe8fffc9451fd6e44。38个源码/配置/说明文件分别保存哈希。以下是这两个快照的静态事实,不把当前主分支、历史实验与其他库实现混为一个版本。
| 核查点 | 源码行为 | 复现影响 |
|---|---|---|
| SDE / ODE 开关 | sde_lib.reverse 将 score 系数设1或0.5;ODE diffusion置0 | 不能仅关闭随机采样而保留SDE漂移 |
| sub-VP 的 std | marginal_prob 返回 1−exp(−B),不是其平方根 | 它是标准差;再开方会把模型变成另一噪声核 |
| 负噪声映射 | VP/sub-VP get_score_fn 使用 −network/std;连续标签 t×999 | 硬编码999是时间embedding约定,num_scales改动需审查 |
| PC顺序 | 采样循环先corrector后predictor;论文Algorithm1相反 | 需指定实际离散变体,不宣称逐行相同 |
| VP corrector α | sde.alphas=1−discrete_betas,为单步量;另有alphas_cumprod | 论文前文α定义是累积量,Algorithm5未澄清换记号;不要擅自按一套替换另一套 |
| sub-VP corrector路径 | LangevinCorrector接受subVPSDE类型,却读取其未定义的alphas属性 | 静态可见的潜在属性错误;提供的sub-VP配置corrector=none避开此路径,本次未运行确认 |
| NFE返回 | PC固定返回N×(n_steps+1),即使NoneCorrector不调用score | 这个计数可能高估实际forward次数;测速度应真实计数 |
| 末端去噪 | PC返回x_mean;ODE可加一次reverse-diffusion均值更新 | 额外去噪forward不包含在solve_ivp的nfev内 |
| ODE似然 | RK45、固定Hutchinson探针、先验logp加积分;默认Rademacher | 不是精确trace全维展开,也不是DDPM ELBO |
| 数值保护 | 范数比未显式给grad_norm加小常数;读取ODE最终状态,未见对solution.success的显式检查 | 极端零范数或solver失败需要外层验证,不能默认为已处理 |
| 通用性 | PyTorch广播多处固定[:,None,None,None] | 适合四维图像张量,不能无改动推广任意图/序列维数 |
| 后续功能 | likelihood_weighting开关及Diffusers集成超出原实验主配置 | 应注明使用后来的选项,不能覆盖v2历史事实 |
另外,JAX与PyTorch的bpd尺度补偿写法不同:JAX根据inverse_scaler导数加log₂项,PyTorch用7−inverse_scaler(−1)匹配受支持的identity/centered两种缩放。对这两种情形分别得到8或7,但后一写法不是任意非线性归一化的通用Jacobian公式。
源码中的配置名虽有DDPM++,实际类仍注册为 ncsnpp,由配置切换结构。README 明确 PyTorch 不含其JAX版预训练分类器条件生成功能;不能只切换框架就假定所有demo均可用。上述两个仓库为Apache-2.0,数据集、图片与权重的使用条件另需分别核查。
建议最小数学单元测试(本页的独立验证脚本已执行,不调用学习模型):检验sub-VP方差不超过VP、协方差演化的差值恒等式、VE相邻方差可望远镜相加、M的正交性、标准正态在VP下的概率流速度为0,以及一维线性ODE的change-of-variables符号。它们能抓公式实现错误,不能证明神经模型训练、GPU环境或FID复现成功。
这次交付提供源码审计与数学/文档静态检查,没有运行训练和图像生成,也没有下载checkpoint或原始训练数据。用户要求的浏览器验收延后,因此MathJax实际渲染、外部图像的浏览器加载、导航点击和1440/760/390布局仍列为未运行。
原笔记完整保留在合并候选的起始字节段,不覆盖其推导或链接。以下以证据说明应如何重读:
| 原笔记易错处 | 应采用的解释 |
|---|---|
| 固定t就有高斯分布,均值写成根号α | 条件于x₀才有已知高斯核;均值还需乘x₀,协方差是1−累计α,边缘通常是高斯混合 |
| 固定x₀就确定一条轨迹 | 还需固定Brownian噪声实现;SDE仍有无穷多随机轨迹 |
| VE转移噪声是相邻方差相加的根号 | 必须是差:σᵢ²−σᵢ₋₁²,见原式8/20 |
| Bayes/Taylor推导中梯度写成∇p,均值括号和协方差混杂 | 目标是∇log p;原反向定理与本页负dt约定给出一致式,不沿用错误配方 |
| 反向离散式省略时间步与根号时间步 | 一般Euler更新需要漂移乘h、噪声乘√h;单位步公式只在已吸收离散日程时才可用 |
| VE和VP只差一个根号(1−累计αT) | 二者漂移、数据收缩、完整噪声日程和先验不同;score与噪声参数化的换算也含负号和随时间变化的标准差 |
| 只分VE与VP | 本文还提出sub-VP,且2.99bits/dim主要结果依赖它 |
| 未区分概率流ODE和反向SDE | score系数为1/2与1,随机性不同;近似网络时分布等价需重新限定 |
作者信息也需谨慎:Yang Song名字上的星号脚注表示部分工作在Google Brain实习期间完成,并非通讯作者标记。没有找到明确通讯标识,依既定规则保留末位Ben Poole为未核实候选。旧笔记BibTeX的2020是arXiv首发年份;正式引用可另附ICLR2021,不必删除用户原文。
最有价值的证据。统一框架不是纯比喻:DDPM/SMLD的极限、反向漂移、概率流和密度积分都有推导;同一模型换sampler的Table1/4提供可分离采样贡献的实验;架构与连续训练又通过Table2/3展示与SDE选择的相互作用。附录给出足够实现细节,使“模型”和“数值求解器”真正成为可替换部件。
归因上的限制。最佳结果叠加架构、容量、损失、embedding、训练长度、EMA、采样器、r搜索与checkpoint选择,不能把2.20全部归给SDE数学表达。比较中NFE相同不代表壁钟和显存相同,深模型单次score成本也不同;Table4出现P2000胜PC的例外应被保留。所有视觉最佳权重选自训练中最低FID,可能存在选模乐观性。
理论上的限制。逆时定理要求真实边缘score与适当正则性;边缘等价不是路径等价;“可辨识”需固定前向过程;一般inverse-problem公式含近似条件独立和单样本积分。把这些前提省掉,会把一个强而精确的理论框架过度扩张为“任何神经场、任何观测都成立”。
实践上的限制。采样仍慢于GAN,这是作者结论明确承认的;高分辨率展示并未给完整基准;FP数值、ε、r、末端去噪与预处理明显影响结果;官方当前代码也有历史依赖、符号约定与可选分支风险。原始CelebA高分辨率checkpoint不可公开增加了逐项复现难度。
若补实验。用相同架构、同一checkpoint评估SDE与ODE的FID/NLL/成本,逐项控制训练策略;对ε与r做完整敏感性图;报告含末端去噪的真实NFE与显存;重复独立训练seed;逆问题增加观测一致性、后验覆盖与病态案例;给出原图分布、先验近似、score误差和离散误差的分离测试。以上均为本页评审建议,不冒充作者已做。
本文直接生成的是像素图像,未输出Substance节点、图拓扑、着色器程序或物理BRDF参数。因而它不能凭图像质量保证材质图可执行、可编辑、tileable或重光照一致。对用户的程序化材质方向,其价值首先是连续参数/纹理先验与条件推断的数学工具。
一个可研究的方向是在固定材质图的连续参数空间定义SDE,再用渲染观测约束生成。需先处理参数边界、尺度差异和多个参数组合的不可辨识性,学习该参数分布的score;渲染loss对干净参数的梯度不等于所有噪声时刻的真实条件likelihood梯度。把它插入反向过程是一种待验证近似,应测试在多光照图像、不同视角及观测噪声下的后验覆盖。
若扩散对象是SVBRDF贴图,需设计跨通道物理范围、法线约束与平铺边界;普通图像FID不足以评价反射率的物理真实性。对于离散节点类型和连接,本文的欧氏连续SDE不直接保证图合法,可以考虑“离散结构先验+连续参数score”分解,但图语法、渲染器和约束采样是新增研究,不是本论文已经提供的部件。
概率流编码可用于材质插值或候选检索,但固定图的latent平滑性不保证跨拓扑语义一致。更可检验的实验是:固定训练集与渲染协议,比较VE/VP/sub-VP在连续材质参数上的覆盖与似然,再比较P/C/ODE的观测误差、可编辑性、执行成功率和真实成本。这样继承本文“解耦噪声过程与sampler”的长处,而不借用不相关的图像纪录作材质效果证明。
本页的原表重建以固定PDF为准;正文中的推导、评审与研究延伸都单独标明性质。17张编号图全部保留:有可靠官方图片地址的优先使用外链,并保存下载副本用于Markdown;其余曲线/组合面板从原PDF裁切内嵌。链接已做HTTP与图像解码检查,不能替代浏览器实际显示验收。Figure13另保留分类准确率曲线,避免只留下样本图。
HTML与新增Markdown仅作为下载候选;merged-note-candidate 保留原笔记的精确字节前缀。原PDF、现有YAML、用户推导与全部旧链接不被修改;People、索引与vault归档仅有计划,未执行。8个通用公式验收样例放在单独fixture中,不混入论文论证。