输入
一句文本、冻结的 Stable Diffusion v1.5、随机初始化的密度与四通道 latent 体素、随机相机。
用二维扩散方向更新三维场景|PAAS、概率勘误与逐行实现审计
Haochen Wang · Xiaodan Du · Jiahao Li · Raymond A. Yeh · Greg Shakhnarovich
SJC 把冻结的二维扩散模型当作图像空间的方向场,再通过可微渲染器把这个方向传回三维体素。它最值得学习的不是“又一种 text-to-3D”,而是如何在没有三维训练集的情况下,明确区分图像 score、渲染 Jacobian、噪声扰动、优化权重与几何先验。
一句文本、冻结的 Stable Diffusion v1.5、随机初始化的密度与四通道 latent 体素、随机相机。
经过逐物体优化的 latent radiance field。新视角先渲染 latent,再用 SD 解码器产生 RGB;不是直接输出可编辑 mesh、材质图或原生 RGB 辐射场。
给渲染结果加噪,计算去噪方向,停止对去噪网络求导,借渲染器的 VJP 更新场景;稀疏性课程抑制浮动密度。
Paper Verified:固定 v1 展示了多个文本生成对象、与第三方 Stable-DreamFusion 的定性比较、二维噪声调度实验,以及 emptiness 和中心深度的图像消融。没有原始定量 Table、FID/CLIP 分数表、用户研究、成功率或跨种子置信区间。下文自制对照表仅整理原文设置和证据,绝不伪装成论文实验表。
关键版本修正:官方项目页明确撤回 arXiv 中“平均图像密度后再绕经 Jensen”的建模路线,改为直接定义平均 log-density 的三维能量。本文保留固定 PDF 的推导供溯源,同时解释修正与尚未成立的采样保证。
主依据:固定 arXiv v1 PDF,第 1–8 页方法与实验、第 9–11 页致谢和参考文献、第 12–16 页附录 A1–A3;官方项目页及勘误。
| 字段 | 核实结果 | 处理原则 |
|---|---|---|
| 标题 | Score Jacobian Chaining: Lifting Pretrained 2D Diffusion Models for 3D Generation | 简称 SJC |
| 作者 | Haochen Wang、Xiaodan Du、Jiahao Li、Raymond A. Yeh、Greg Shakhnarovich | 前三人为共同第一作者,星号含义是 equal contribution |
| 机构 | 前三位及 Greg 为 TTI-Chicago;Raymond 为 Purdue University | 原 note 的 institute: Purdue University 不对应第一作者,追加建议,不覆盖原文 |
| 年份/版本 | arXiv:2212.00774v1,2022-12-01;官方项目页标 CVPR 2023 | 预印本年份与会议年份并列。arXiv 当前历史仅列 v1 |
| 通讯作者 | 未发现明确标记 | Greg 仅保留为未核实候选;不可把末位或共同一作星号当通讯证据 |
| 实现 | pals-ttic/sjc,审计树 commit f63c40dea228dda61beda49f5432065052658740 | 读取源码与配置,不执行第三方训练代码,不下载大模型权重 |
| 保存策略 | 原 note、BibTeX、五条 PDF++ 注释全部按字节保留 | 生成独立新增精读和原文前缀的合并候选;未写入真实 vault |
固定 PDF 共 16 页,已经包含附录,不把它计作“16 页正文另加附录”。arXiv HTML 缺少部分图像及后半附录素材,因此数学与附录以固定 PDF 为准。官方网页新增的勘误、SDEdit 解释和 README 后续可视化更新,都明确标为后续官方说明。CVF 页面本轮访问返回 403,会议身份由作者官方项目页交叉核实,不声称逐字核验 camera-ready。
arXiv 身份/版本 · 作者机构与会议 · 官方仓库
三维生成的困难不只是数据量:mesh、点云、隐式场、体素之间不存在统一且无损的训练格式,而二维互联网图像已能支撑强生成先验。SJC 选择把共同可观测量设为“渲染图像”,用同一个三维场景解释多个随机视角。它不学习一个从随机码到场景的共享 3D generator,每个 prompt 都重新优化一组场景参数。
这与三类前作的关系很清楚:3D GAN 从数据学习一个可快速采样的场景分布;CLIP 引导方法通过文本图像相似度优化场景;SJC 使用已训练好的图像生成模型给出更细粒度的图像更新方向。代价是测试时慢优化、模式偏置以及二维外观先验未必对应真实几何。
| 符号 | 含义与形状 | 是否优化 |
|---|---|---|
| \(\theta\) | 密度网格、外观/latent 网格、背景网格、密度尺度 | 逐场景优化 |
| \(\pi\) | 相机位置、朝向、内参;由策略采样 | 不做相机姿态估计 |
| \(x_{\pi}=R(\theta,\pi)\) | 一般为渲染图像;SD 实验中为 \(4\times64\times64\) latent | 随场景变化 |
| \(D_{\phi}(z;\sigma,c)\) | 给定噪声尺度和文本条件的去噪器,\(\phi\) 为预训练权重 | 冻结;无 U-Net Jacobian |
| \(n,\sigma\) | 标准高斯噪声与 noise-to-signal ratio | 随机采样,非可训练变量 |
| \(J_{\pi}\) | \(\partial x_{\pi}/\partial\theta\),渲染器 Jacobian | 通过自动微分隐式计算 VJP |
| \(\tau,w_i,\alpha_i\) | 空间密度、射线终止权重、分段不透明度 | 与扩散噪声 \(\sigma\) 不同 |
“无需 3D 数据”指 SJC 优化阶段不需要三维样本或配对多视图数据,不意味着无预训练、无数据先验或无算力成本。LAION、FFHQ、LSUN 是预训练二维模型的数据来源;本文没有重新训练这些扩散模型,也没有新的三维 train/validation/test 划分。
扩散模型先在多个噪声水平学习恢复干净样本:
\[\min_{\phi}\ \mathbb E_{y\sim p_{\mathrm{data}},\,n\sim\mathcal N(0,I)} \left\|D_{\phi}(y+\sigma n;\sigma)-y\right\|_2^2.\tag{1}\]这里固定一个噪声水平书写目标;实际训练跨噪声水平取样。其最优平方损失预测器是条件均值。对于以噪声残差为输出的网络,先转换到同一“未缩放加噪坐标”:
\[D(z;\sigma)=z-\sigma\widehat\epsilon(z;\sigma),\qquad s_{\sigma}(z)=\nabla_z\log p_{\sigma}(z)\approx\frac{D(z;\sigma)-z}{\sigma^2}.\tag{2–3}\]不要把这条式子直接套到 DDPM 的缩放输入上;SD 适配器会先用 \(\sqrt{1+\sigma^2}\) 做输入归一化,后面单独展开。score 是对输入的 log-density 梯度,并不是对网络参数的训练梯度。
\[p_{\sigma}(x)=\mathbb E_{y\sim p_{\mathrm{data}}}\mathcal N(x;y,\sigma^2I),\qquad D(x;\sigma)=\frac{\sum_i\mathcal N(x;y_i,\sigma^2I)y_i} {\sum_i\mathcal N(x;y_i,\sigma^2I)}.\tag{4–5}\]经验分布下,去噪结果是高斯核加权的邻近样本均值。较大的 \(\sigma\) 聚合更广的结构,较小的 \(\sigma\) 强调局部细节。这个 mean-shift 直觉解释了方向,不代表真实神经网络会在任意离群输入上准确实现该条件均值;OOD 正发生在这里。
训练时去噪器看到的是“自然图像加对应强度的噪声”;优化初期的渲染可能既没有正确噪声统计,也完全不在自然图像支持区域。固定 PDF 的 Fig. 2 用 FFHQ 去噪器和 \(\sigma=6.5\) 展示:直接输入橙色团块出现尖锐伪影,加噪后再去噪才更像人脸。加噪不是保证修复一切 OOD,而是减少特定的噪声条件失配。


固定 PDF §3、§4.1,第 3–4 页;PAAS 原文。
原文用行向量写成 score 乘 Jacobian;这里用列向量写为转置 Jacobian 乘 score,二者是同一个 VJP。大网格的完整 Jacobian 不需要也不应该显式构造。
数学审读:在可积与可交换微分假设下,Jensen 不等式本身成立;问题是下界指数未必归一化,其梯度不等于原先平均密度分布的 score,更没有保证能从真实三维分布采样。多个三维参数可能渲染相同图像,未观测空间自由度还会让 \(Z\) 的存在性成为假设。它不是一个可逆变换的密度变换公式,因此不能补上普通 flow 的 determinant 就解决问题。
后续官方说明:作者把上述平均密度再 Jensen 的路线明确标为不正确且不必要,建议直接从平均 log-density 出发。为避免网页中比例符号的歧义,可严谨写成能量定义:
\[E_{\sigma}(\theta)=-\mathbb E_{\pi}\log p_{\sigma}(R(\theta,\pi)),\qquad q_{\sigma}(\theta)=Z_q^{-1}\exp[-E_{\sigma}(\theta)],\tag{修正解释}\] \[\nabla_{\theta}\log q_{\sigma}(\theta) =\mathbb E_{\pi}[J_{\pi}^{\mathsf T}s_{\sigma}(x_{\pi})],\]第二式仍要求归一化常数存在;即使只把第一式当可优化能量,VJP 依然有效。它像多视图的几何平均/乘积约束,倾向让每个采样视角都合理;平均密度目标可能允许一个很好的视角掩盖很差的视角。作者修正了建模解释,没有改变核心更新形式。
为什么不反传 U-Net:网络输出已经估计了对图像的一阶导数。要把这一阶导数传到场景,只需要渲染 Jacobian。再对网络输出微分会引入 score 的导数或 Hessian 类信息,优化的是另一个对象。这里的 stop-gradient 是算法语义,不只是节省显存的近似。
官方 Chain Rule on Score Function 段及勘误;固定 PDF 第 3 页用于版本溯源。
直接法 Eq. 12 是 \(s_{\sigma}(x)=(D(x;\sigma)-x)/\sigma^2\),但离群渲染上不可靠。PAAS 定义为:
\[\operatorname{PAAS}(x,\sqrt{2}\sigma) \equiv\mathbb E_n[s_{\sigma}(x+\sigma n)] =\mathbb E_n\left[\frac{D(x+\sigma n;\sigma)-(x+\sigma n)}{\sigma^2}\right] =\mathbb E_n\left[\frac{D(x+\sigma n;\sigma)-x}{\sigma^2}\right].\tag{13–16}\]最后一步利用 \(\mathbb E[n]=0\)。两种估计器的期望相同,单次样本却相差 \(n/\sigma\)。原文把去掉该显式噪声项称为方差减少技巧,但相关项的协方差决定实际方差,不能只从“均值为零”证明所有场景方差必定下降。官方仓库允许两种方式,部分 prompt 反而保留噪声项表现更好。
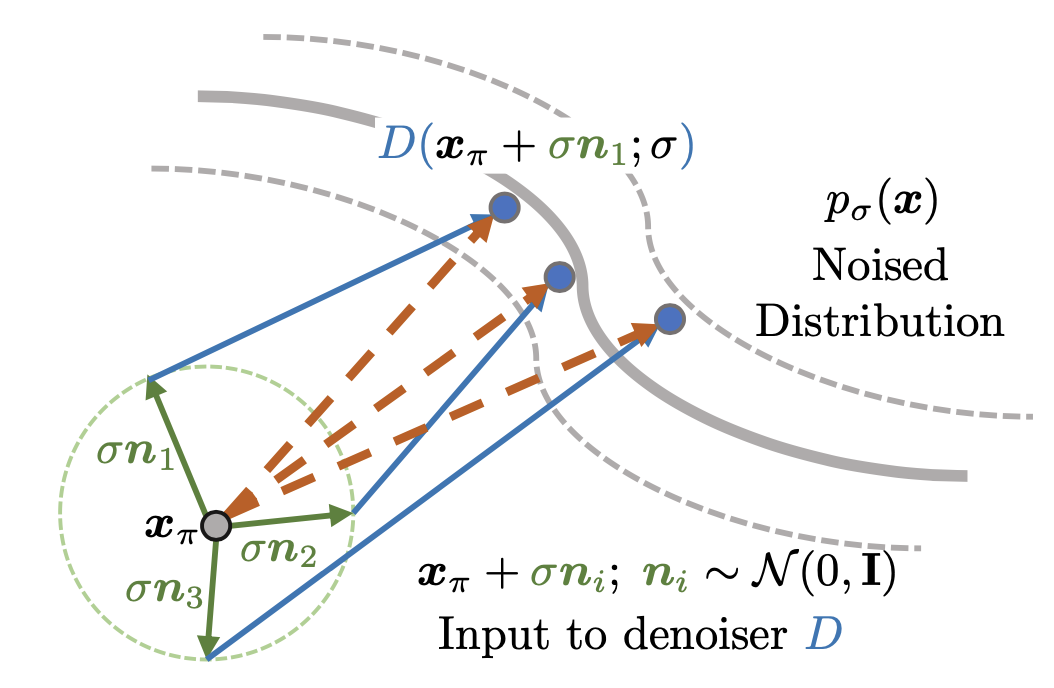
这才是 Lemma 1 与 Claim 1 的严格内容:PAAS 估计下界 \(F_{\sigma}\) 的梯度。Eq. 17 写成更宽噪声 score 的近似,但下界函数接近与否、梯度方向接近与否,都没有由 Jensen 自动保证。
Our Interpretation,一个可验证反例:令数据只有一个点 \(\mu\)。则 \(p_{\sigma}(x)=\mathcal N(x;\mu,\sigma^2I)\),PAAS 等于 \(-(x-\mu)/\sigma^2\),而 \(s_{\sqrt{2}\sigma}(x)=-(x-\mu)/(2\sigma^2)\),已经相差 2 倍。方向在这个简单例子相同,但不是精确 score;多峰情形连方向接近也不能仅凭不等式得出。
精确宽噪声 score 实际有密度权重:
\[\nabla_x\log p_{\sqrt{2}\sigma}(x)= \frac{\mathbb E_n[p_{\sigma}(x+\sigma n)s_{\sigma}(x+\sigma n)]} {\mathbb E_n[p_{\sigma}(x+\sigma n)]}.\tag{审读推导}\]PAAS 用均匀噪声平均,缺少上式的密度重加权。它的价值是可计算、能缓解输入失配;它不是无偏估计真实宽噪声 score 的普遍定理。
加入相应噪声权重后,对该代理损失做梯度下降相当于沿 PAAS 方向上升。代码直接调用 y.backward(-grad),无需真的构造这个损失。不得把未停止梯度的重建损失当作同一算法。官方后续网页还提出可把一次去噪目标换为多步 SDEdit 结果,并指出 SparseFusion 的相关方案;这不是固定 v1 做过的 SJC 消融。
固定 PDF §4.1,第 4 页;官方仓库 run_sjc.py。
密度为单通道 \(100^3\) 网格,SD 外观为四通道 \(100^3\) 网格,三线性插值取样。与普通 NeRF 的位置编码加 MLP 不同,这是直接优化稠密网格;不建模 view-dependent appearance。背景是按射线方向查询的可优化 \(4\times4\) 小纹理。在 SD 分支它也有四个 latent 通道。
\[\alpha_i=1-\exp(-\tau_i d),\quad T_i=\prod_{j\lt i}(1-\alpha_j),\quad w_i=T_i\alpha_i,\quad x_{\pi}(r)=\sum_iw_i a_i+ \left(1-\sum_iw_i\right)a_{\mathrm{bg}}.\tag{25 + 实现背景项}\]\(d\) 是射线步长,\(a_i\) 为 RGB 或四通道 latent。四通道特征没有 sigmoid 范围限制,颜色从最终二维 VAE decoder 得到。Decoder 存在空间感受野:即使 latent 来自共享三维场,不同视角解码后的 RGB 也不自动满足严格的物理多视图一致性。
代码密度激活为 \(\tau=\operatorname{softplus}(v_{\mathrm{density}}\exp(d_{\mathrm{scale}})-1)\)。初始密度网格为零、外观与背景随机正态、密度尺度为零。空间边界为 \([-1,1]^3\),每轴长度 2,体素边长 0.02;step ratio 0.5 给出步长 0.01。颜色查询跳过 \(w_i\le10^{-4}\) 的样本,权重本身仍参与几何正则。默认 SJC 路径没有启用渐进网格升分辨率或额外 MLP。
可训练标量数量按默认张量形状计算为 \(100^3+4\cdot100^3+4\cdot4\cdot4+1=5{,}000{,}065\),这是本次基于代码的推算,不是论文报告的模型参数表,也不包含冻结 SD。保存的是场景 checkpoint,固定实验未提供 mesh 提取质量或可复用 PBR 材质。
小权重附近斜率大,较大权重边际惩罚小。在形成物体所需 opacity 的约束下,这种凹惩罚偏向少量较强终止位置,抑制广泛云状密度。但如果只有此项,所有权重为零也是最优,所以必须与外观方向平衡。由于 \(w_i\) 依赖相机与前方遮挡,它不是对全部体素密度的直接 L1,也不保证封闭表面或唯一几何。
\[\lambda(k)=\begin{cases}10^4,&k\lt0.5K,\\2\times10^5,&k\ge0.5K.\end{cases}\]前半程允许形成结构,后半程清理浮动密度。太早强稀疏会抑制物体形成;过弱则残留云雾。论文没有给出对所有 prompt 通用的最优系数,README 确实列出例外。
作者意图是减少物体偏移、在画面中心形成主体。公开代码以 64×64 深度图中央 50×50 为 \(B\),对差值加 \(10^{-12}\) 再取 log。然而 render.py 输出的是距离期望加背景距离 10:\(D=\sum_iw_it_i+(1-\sum_iw_i)\cdot10\),数值越大通常越远。若中心物体更近而边缘为空,中心减边缘往往是负数,微小 epsilon 不能修复对数定义域;即使差值为正,最小化此式也偏向增大中心相对距离。
Implementation Audit:这是依据当前源码的符号与数值风险,不声称已运行复现 NaN。默认 depth_weight=0 跳过此项;正权重 prompt 在复现前必须打印中心/边缘统计,并确认论文中深度或逆深度的约定。不要未经说明把公式反号、clamp 或换成 inverse depth 后仍称原始实现。
SJC 的“training”主要指每个新物体的测试时优化;扩散模型训练只是背景知识。冻结 U-Net、文本编码器、VAE,不对其做 finetune。每一步只有一个相机、一份高斯噪声、一张 64×64 latent;使用带 momentum 的 Adamax 隐式平滑随机梯度。作者试过每步显式平均多份噪声,未观察到收益或退化,但没有给出样本数扫描表。
冻结基础模型配置:官方 v1-inference.yaml 中 U-Net 输入/输出均为 4 通道,基础宽度 320,channel multipliers 为 [1,2,4,4],每级 2 个 residual blocks,8 attention heads,spatial transformer depth 1,文本 context dimension 768;文本编码器为 FrozenCLIPEmbedder。AutoencoderKL 的 latent channels/embed dimension 都是 4,基础宽度 128,multipliers [1,2,4,4],每级 2 residual blocks,dropout=0,latent scale_factor=0.18215。配置中的 autoencoder resolution=256 是架构配置字段,不能据此否定适配器实际 512 输入/输出路径。yaml 的 base_learning_rate 与 10k warmup 是基础 LDM 配置遗留,不是 SJC 场景 Adamax 的学习率和训练日程。
\[z_{\mathrm{VP}}=\frac{y+\sigma n}{\sqrt{1+\sigma^2}}, \quad \bar\alpha_t=\frac1{1+\sigma^2},\quad \widehat\epsilon_{\mathrm{cfg}} =\widehat\epsilon_{\varnothing} s_{\mathrm{cfg}}(\widehat\epsilon_c-\widehat\epsilon_{\varnothing}),\] \[D(y+\sigma n;\sigma,c)=y+\sigma n-\sigma\widehat\epsilon_{\mathrm{cfg}}.\]代码把条件和无条件样本拼为批次计算,场景 batch size 仍是 1。默认 guidance scale 100,二维 Fig. 4 另用 3 与 10,不可混写。高 CFG 强化条件模式,可能降低多样性并造成饱和、多面问题;“自然语言把分布变窄使优化容易”是作者的解释,非数学收敛定理。
原式以 \(\sigma^2\) 为分母,代码以 \(\sigma\) 为分母,所以相当于额外乘 \(\sigma\) 的噪声权重。默认方向可化为 \(n-\widehat\epsilon_{\mathrm{cfg}}\),var_red=False 则为 \(-\widehat\epsilon_{\mathrm{cfg}}\)。这是固定噪声水平下相同方向的缩放,但随机混合不同噪声水平并使用自适应优化器时,会改变相对贡献,不能笼统说被学习率完全吸收。
源码建立 1,000 个 SD 离散尺度:\(\beta_t\) 为 0.00085 与 0.012 的平方根线性插值再平方,\(\bar\alpha_t=\prod_{j\le t}(1-\beta_j)\),\(\sigma_t=\sqrt{(1-\bar\alpha_t)/\bar\alpha_t}\)。随后从倒序 us[30:-10] 选取 960 个条目均匀抽样,对应原始时间索引 10–969。它不是连续 \(\sigma\) 区间上的均匀分布。正文的 Random σ 应据此精确实现。
| 项目 | 固定论文 | 当前官方实现/复现提示 |
|---|---|---|
| 网格与背景 | 100³,边界 [-1,1]³,4×4 背景 | V_SD 四通道,无 sigmoid;背景独立小学习率 |
| 相机半径/FOV | 1.5;训练 40°–70°;测试 60° | 相同 FOV 范围,训练每步随机 |
| 相机分布 | 均匀半球 | 实现将内部变量 v∈[0,100°] 映射到球极角,y/R∈[-1/9,1],会略低于地平线 |
| overhead 前缀 | 文字称 elevation above 30° | 代码对映射前 v<30° 判断,实际对应 y/R>2/3,即真实 elevation 约大于 41.81°;不是同一个阈值 |
| 侧向前缀 | front/backside/side | 方位角加 45° 后分四象限,依次 front、side、backside、side |
| 优化 | Adamax,lr 0.05,10k,部分更长 | 显式只传 lr;其余采用安装版本默认。原文未详列 beta/epsilon、梯度裁剪、weight decay |
| 正则课程 | 10⁴→2×10⁵ | 默认半程乘 20;beta=10 |
| 内存/时间 | A6000,约 9 GB、25 分钟,含可视化 | README 后续给 A5000、约 10 GB/25 分钟;不同设备陈述,不合成一个实测值 |
| 分辨率 | 正文说 latent 4×64×64 解码到 3×256×256 | v1.5 适配器 H=W=512,VAE 下采样因子 8,原生解码 512;展示 pane 再缩到 256,需区分模型输出与展示 |
| 随机种子 | 未提供种子扫描 | 入口 seed_everything(0),README 标注尚未配置化 |
| 高分辨率展示 | 附录用 subpixel rays,正文未用 | 后续脚本 factor=4,256² 射线;latent 缩到 128² 后解码,默认200相机略去前60 |
正文的随机相机覆盖、视角文本前缀和中心结构假设共同构成强先验。“多视图”并非从一组输入照片监督得到,而是随机生成视点,让每个视点单独接受二维 prior。强制所有视图各自像 prompt,仍可能出现 Janus 多面以及把阴影、地面和水面编码成几何。
固定 PDF A3,第 14–15 页;pose.py · adapt_sd.py · 高分辨率脚本。
把 renderer 设为恒等映射,直接优化 RGB 或 latent 图像。FFHQ 和 LSUN Bedroom 使用 256×256 的无条件 DDPM;SD v1.5 使用文本条件。这是重要的失败对照:如果连二维简单参数化都难以用该方向采样,不能把三维失败全部归因于渲染器。


| 原 Fig. 4 行 | 退火噪声 | 随机噪声 | 能支持的判断 |
|---|---|---|---|
| FFHQ | 人脸姿态与细节较丰富 | 趋向平均脸,明显 mode-seeking | 随机噪声优化不等价于标准扩散采样 |
| LSUN Bedroom | 相对改善,仍不理想 | 模糊、缺少结构 | 复杂无条件分布仍是公开难题 |
| SD,guidance 3 | 与无条件趋势相近 | 模糊输出 | 文本条件本身不足以保证可优化 |
| SD,guidance 10 | 作者尝试不同调度,仍较差 | 清晰图像 | 较强 CFG 有利于这里的模式搜索,但无定量泛化保证 |
两行 SD 使用 “a squirrel holding a saxophone”。作者主动承认 Fig. 4 所有图像仍比标准扩散推理差。无条件 FFHQ/Bedroom 的 3D 退火调度很难调,正文把它留作未来问题;不可把三个模型都写成完成了同样质量的 3D 生成。README 还说二维 Fig. 4 复现脚本尚待补充,单一 sigma 在脸域可能有效,卧室域更难,因此不能把泛用二维采样脚本当成完整复现实验。


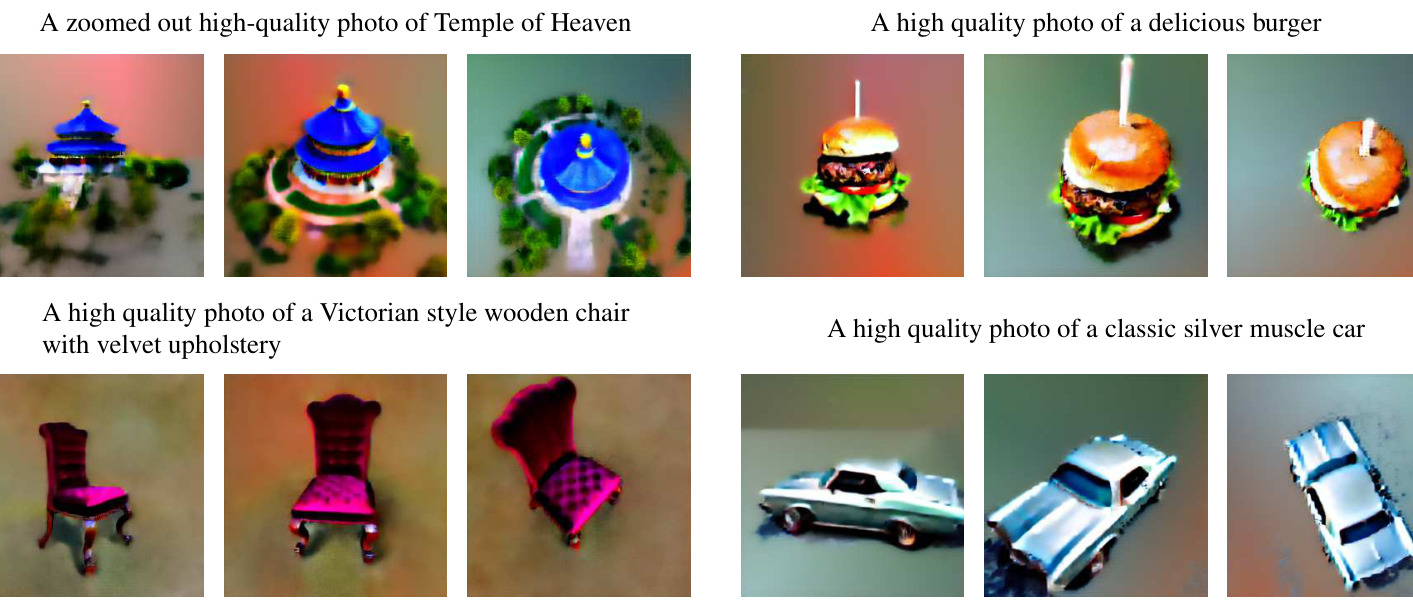
六组分别为黄色鸭子、盆栽、城堡、玩具摩托车、悉尼歌剧院、行走的马。每组显示两个 RGB 视图及深度。图像说明共享体素能够形成一些有结构的可环绕对象;深度是模型自己的预测,没有 ground-truth 几何可用于判定准确度。


六个 prompt 覆盖汉堡、鸭子、盆栽、玩具坦克、巧克力冰淇淋、长颈鹿;上下行为 SJC 与 StableDF,每对象 RGB/深度并列。原 caption 指双方 10k iterations、这组比较没有逐 prompt 调超参。它控制了 SD 基础模型,但不是与 Imagen 版原始 DreamFusion 的直接复现比较,10k 步也未必等计算量。
两者的 representation、latent/RGB 路径、正则与渲染实现同时不同,因此不能从 Fig. 6 单独归因“PAAS 比 SDS 优越”。作者自己强调质量跨 trial 波动,目的在证明系统有竞争力。原文没有统一 prompt benchmark、重复次数、盲测、几何测量或完整失败比例。
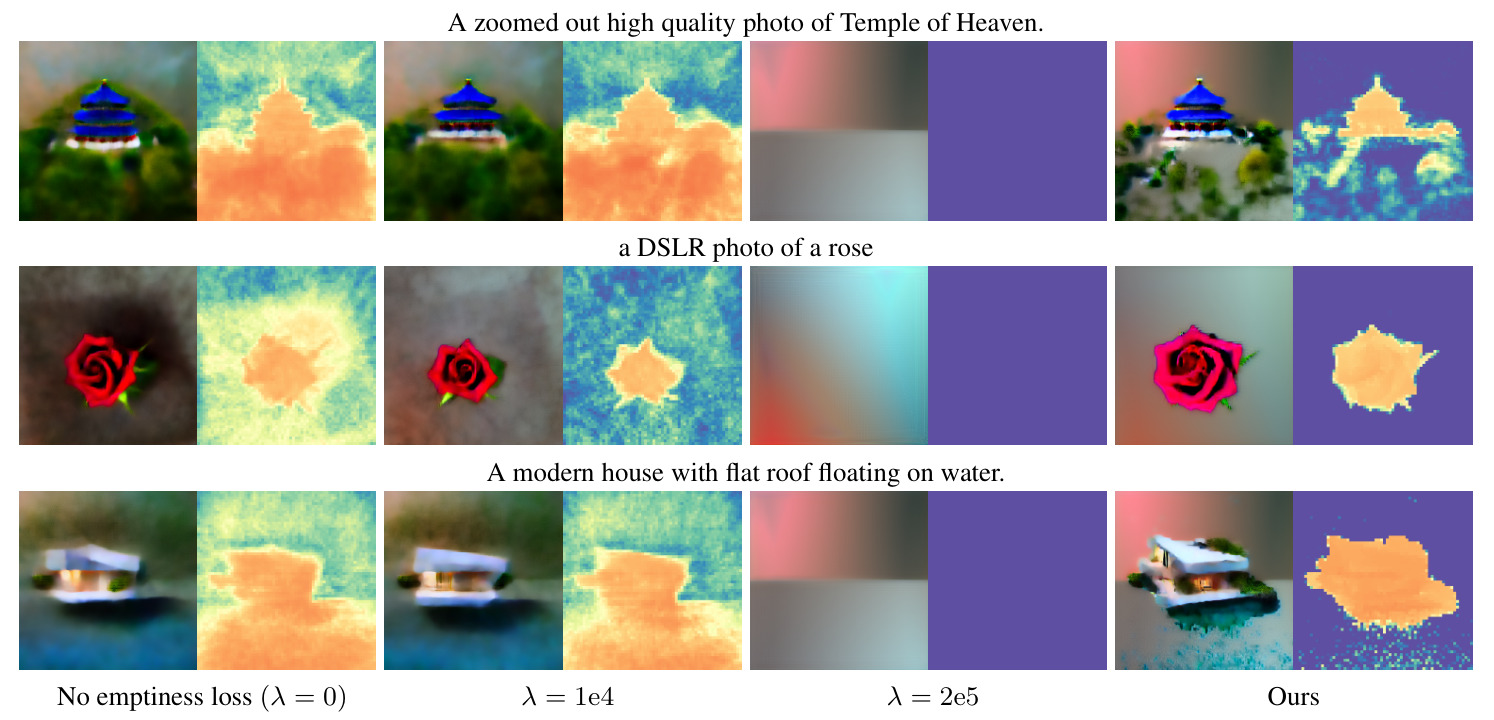
天坛、玫瑰、浮水现代房屋各有四种条件:无正则、固定 10⁴、固定 2×10⁵、两阶段课程。无或低正则残留云状深度,过强从一开始就抑制结构,课程在展示样本上更干净。此结果支持“形成后再清理”的工程逻辑,不证明课程全局最优或泛化到任意物体。
图源处理说明:arXiv HTML 的 Fig. 7 多个高权重深度格重复指向天坛文件,存在来源映射疑点;本页使用固定 PDF 的完整原图裁切,保留原始四列与三行,不从重复链接重新拼出另一张图。
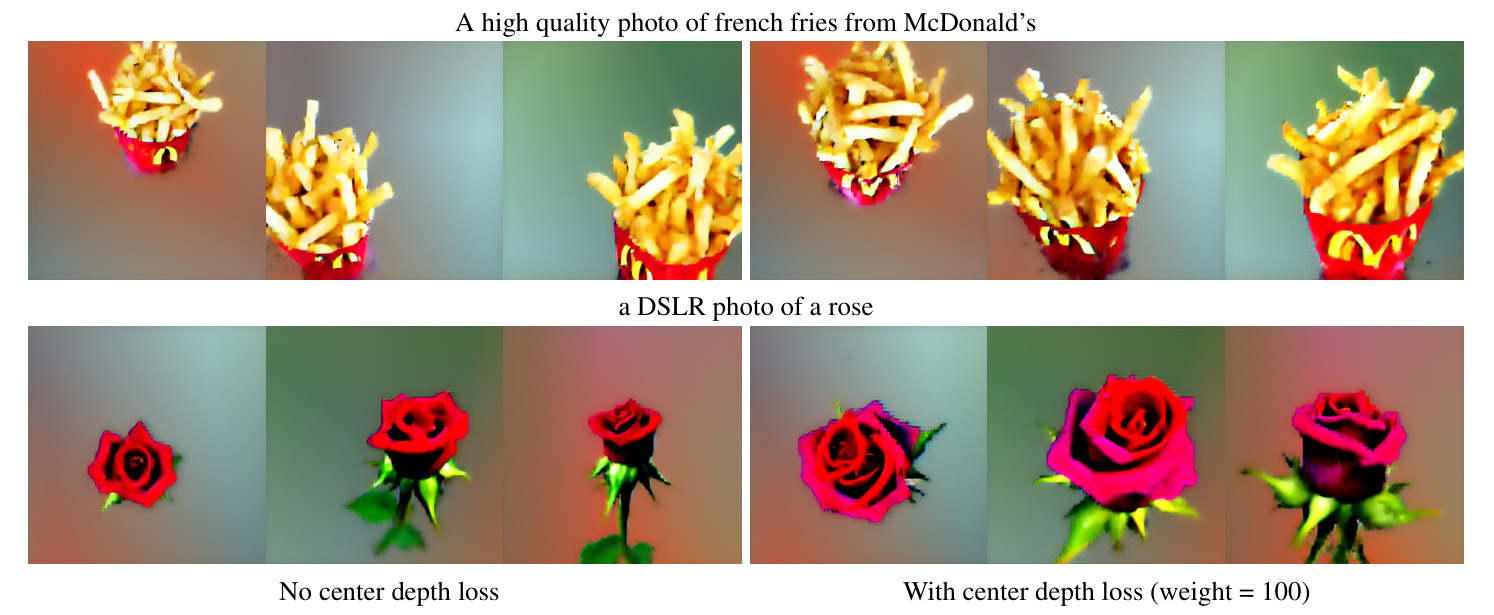
薯条与玫瑰,对比无中心深度与权重 100。固定视角下主体更居中、更大;作者视频叙述还说减少随视点变化的漂移。它是可视化而非真实对象位姿误差。README 的最终样例薯条权重 10、玫瑰 50,与此消融的 100 属不同实验,不应替换。
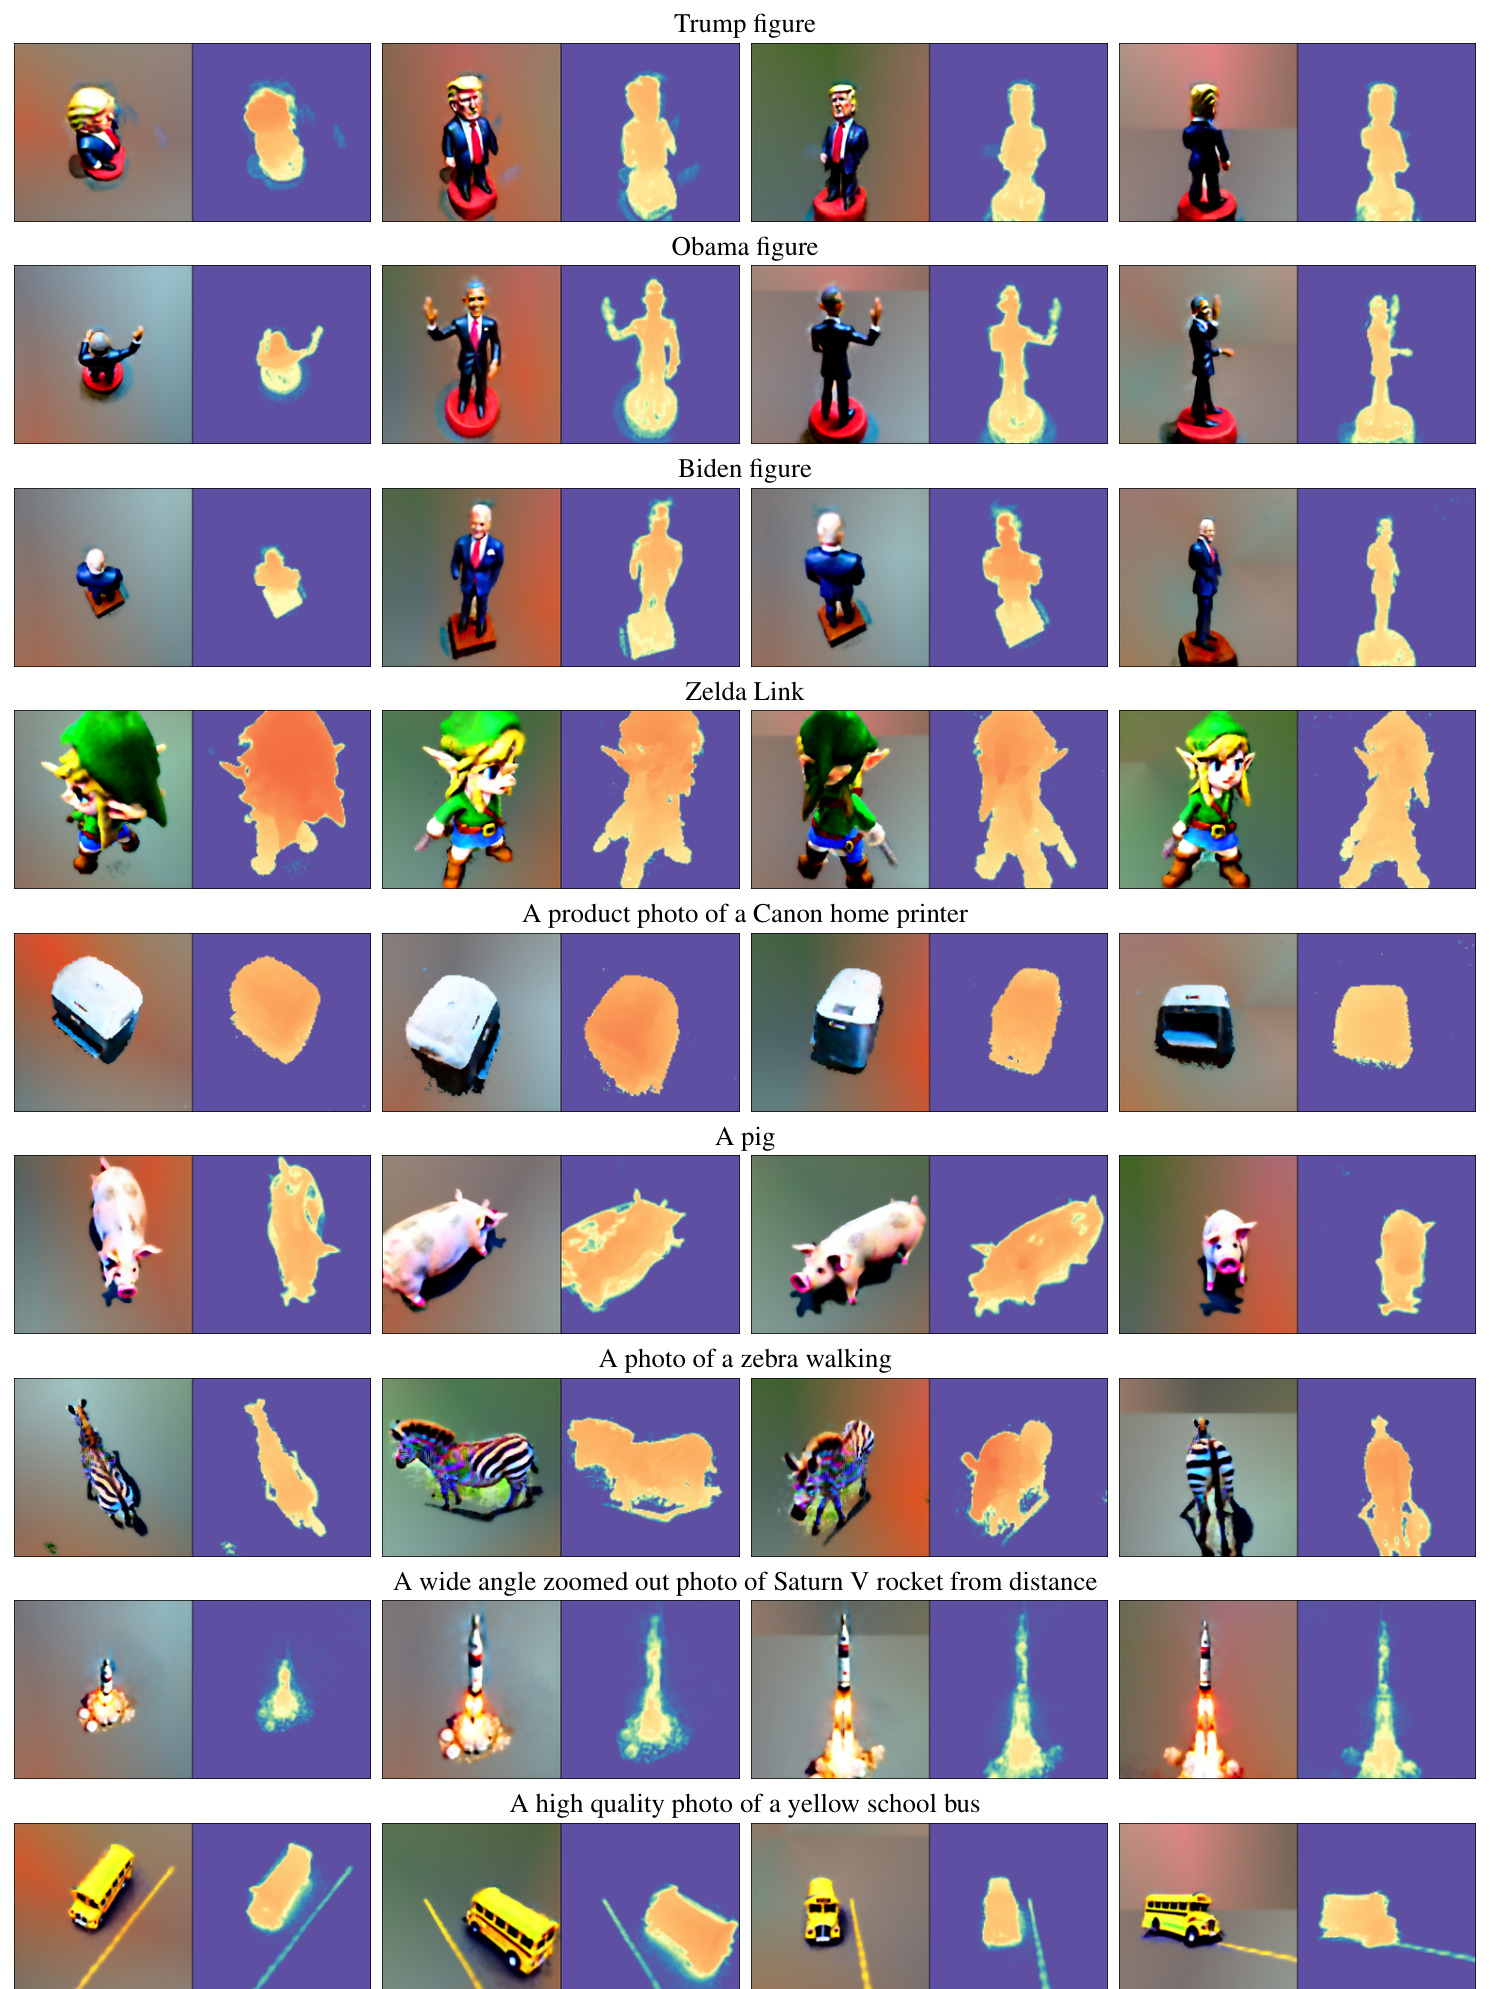
原图九行完整保留:Trump figure、Obama figure、Biden figure、Zelda Link、Canon home printer、pig、zebra、Saturn V rocket、yellow school bus。论文还指出场景会把阴影、水面、草地、车道幻化进密度;这些效果可能让图像更合理,也暴露外观与几何纠缠。公开视频提供环绕观察,但本轮不播放视频、不执行浏览器验收,不能声称检查了时间连续性或所有角度的质量。
固定 PDF 第 5–8、14、16 页;视频入口见官方项目页。
这部分是扩散背景,不是 SJC 已具备正确三维采样的证明。它把不同参数化统一到缩放 \(s(t)\) 和噪声信号比 \(\sigma(t)\):
\[x_t=s(t)x_0+s(t)\sigma(t)z,\qquad z\sim\mathcal N(0,I).\tag{28}\]在各维单位方差、噪声独立的假设下,DDPM 为保持方差设:
\[\operatorname{Var}[x_t]=s(t)^2I+s(t)^2\sigma(t)^2I=I, \quad \sigma(t)=\sqrt{\frac{1-s(t)^2}{s(t)^2}}, \quad s(t)=\sqrt{\bar\alpha_t}.\tag{29–32}\]一般 forward SDE 及对应 Fokker–Planck 方程为:
\[dx=f(t)x\,dt+g(t)dW_t,\qquad f(t)=\frac{\dot s(t)}{s(t)},\quad g(t)=s(t)\sqrt{2\dot\sigma(t)\sigma(t)}.\tag{33}\] \[\partial_t p_t(x)=-\nabla\cdot \left[f(t)x\,p_t(x)-\frac{g(t)^2}{2}\nabla p_t(x)\right].\tag{34}\]通过 \(\nabla p=p\nabla\log p\) 把扩散概率流写成等价连续性方程:
\[\partial_t p_t=-\nabla\cdot\left[ \left(f(t)x-\tfrac12g(t)^2\nabla\log p_t(x)\right)p_t(x)\right],\] \[dx=\left[f(t)x-\tfrac12g(t)^2\nabla_x\log p_t(x)\right]dt.\tag{35–39}\]“等价”指在适当正则条件和同一初始密度下,SDE 与 probability-flow ODE 有相同时间边缘分布,不指随机轨迹逐条相同。固定 PDF Eq. 36–39 是上面的除以密度与 log-derivative 展开,没有额外训练算法。
\[dx=\left[\frac{\dot s}{s}x-s(t)^2\dot\sigma(t)\sigma(t) \nabla_x\log p_t(x)\right]dt =\left[\frac{\dot s}{s}x-s(t)\frac{\dot\sigma}{\sigma} \left(D(x/s;\sigma)-x/s\right)\right]dt.\tag{40–41}\]当 \(s=1,\sigma(t)=t\),有:
\[dx=-\sigma_t\frac{D(x;\sigma_t)-x}{\sigma_t^2}\,dt =-\sigma_t\,s_{\sigma_t}(x)\,dt.\tag{42–43}\]反向积分时 dt 为负,所以总体沿 score 前进。Euler 离散更新为:
\[x_{t-1}=x_t+(\sigma_t-\sigma_{t-1})\sigma_t s_{\sigma_t}(x_t) =(1-\omega_t)x_t+\omega_t D(x_t;\sigma_t),\quad \omega_t=\frac{\sigma_t-\sigma_{t-1}}{\sigma_t}.\]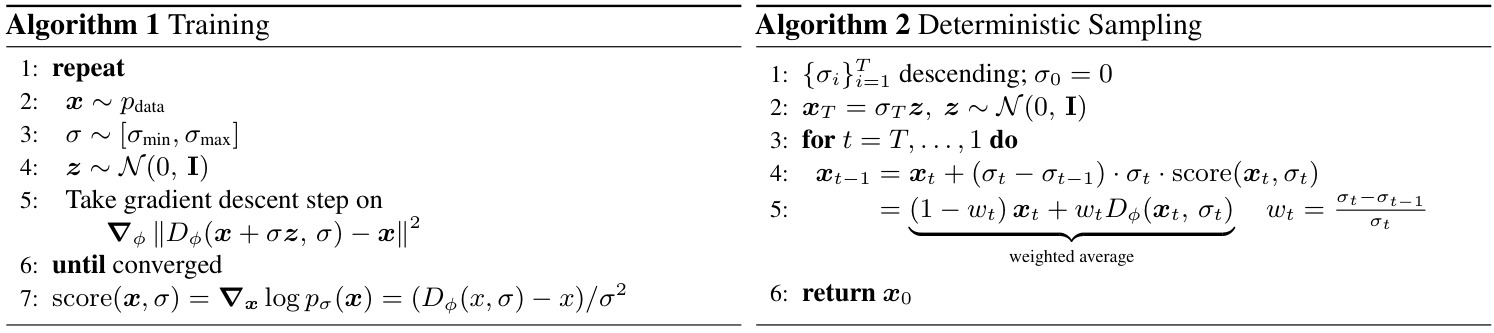
原 Fig. A1 的 Algorithm 1:采样干净样本、噪声尺度、高斯噪声,训练去噪 MSE,获得 score。Algorithm 2:从最大噪声的高斯起点出发,按下降噪声表迭代上述加权平均,最后返回干净样本。caption 的约 80 次网络评估是引用 Karras 一类二维采样经验,不是 SJC 生成一个 3D 场景的成本。
不能跨越的逻辑:二维 ODE 的正确定义不等于随机噪声 Adamax 场景优化。SJC 更新变量是 \(\theta\),噪声加在渲染图像上;它没有构造一致的三维 forward SDE,也未证明 PAAS/Jacobian 场满足对应目标分布的边缘演化。
下面完整整理 README 的 24 个逐 prompt 复现命令。它们是后续官方复现设置,不能混入 Fig. 6“统一 10k 不逐 prompt 调参”的比较。共同默认 CFG=100、emptiness_step=0.5、multiplier=20;未显式写出的选项按当前 SJC 配置解析。var_red=T 使用 Eq. 16 形式,F 使用 Eq. 15 形式,但均带代码的分母 sigma。
| 对象 | 完整文本 | 步数 | 学习率 | 初始稀疏权重 | 中心权重 | var_red |
|---|---|---|---|---|---|---|
| Trump | Trump figure | 30000 | 0.05 | 10000 | 0 | True |
| Obama | Obama figure | 30000 | 0.05 | 10000 | 0 | False |
| Biden | Biden figure | 10000 | 0.05 | 10000 | 0 | True |
| Temple of Heaven | A zoomed out high quality photo of Temple of Heaven | 10000 | 0.05 | 10000 | 0 | True |
| Burger | A high quality photo of a delicious burger | 10000 | 0.05 | 10000 | 0 | True |
| Icecream | A high quality photo of a chocolate icecream cone | 10000 | 0.05 | 10000 | 10 | True |
| Ficus | A ficus planted in a pot | 10000 | 0.05 | 10000 | 100 | True |
| Castle | A zoomed out photo a small castle | 10000 | 0.05 | 10000 | 50 | True |
| Sydney Opera House | A zoomed out high quality photo of Sydney Opera House | 10000 | 0.05 | 10000 | 0 | True |
| Rose | a DSLR photo of a rose | 10000 | 0.05 | 10000 | 50 | True |
| School Bus | A high quality photo of a yellow school bus | 30000 | 0.05 | 10000 | 0 | False |
| Rocket | A wide angle zoomed out photo of Saturn V rocket from distance | 30000 | 0.05 | 10000 | 0 | False |
| French Fries | A high quality photo of french fries from McDonald's | 10000 | 0.05 | 10000 | 10 | True |
| Motorcycle | A high quality photo of a toy motorcycle | 10000 | 0.05 | 10000 | 0 | True |
| Car | A high quality photo of a classic silver muscle car | 10000 | 0.05 | 10000 | 0 | True |
| Tank | A product photo of a toy tank | 20000 | 0.05 | 10000 | 0 | True |
| Chair | A high quality photo of a Victorian style wooden chair with velvet upholstery | 50000 | 0.01 | 7000 | 0 | True |
| Duck | a DSLR photo of a yellow duck | 10000 | 0.05 | 10000 | 10 | True |
| Horse | A photo of a horse walking | 10000 | 0.05 | 10000 | 0 | True |
| Giraffe | A wide angle zoomed out photo of a giraffe | 10000 | 0.05 | 10000 | 50 | True |
| Zebra | A photo of a zebra walking | 10000 | 0.02 | 30000 | 0 | False |
| Printer | A product photo of a Canon home printer | 10000 | 0.05 | 10000 | 0 | False |
| Zelda Link | Zelda Link | 10000 | 0.05 | 10000 | 0 | False |
| Pig | A pig | 10000 | 0.05 | 10000 | 0 | True |
上述种类同时展示了隐藏的人工选择成本:有的需要 30k 或 50k 步、不同学习率、中心约束或更高稀疏权重。论文“通常 25 分钟”不能推广到 50k 步例子,也不能当作数据集级吞吐测试。
| 审计点 | 已确认 | 复现时应做 |
|---|---|---|
| 梯度图边界 | denoise 与方向计算在 no_grad 内,渲染结果仍可求导 | 用小规模有限差分核验 VJP 符号;不要打开 U-Net 梯度 |
| score 权重 | σ²→σ,random index 而非 uniform σ | 把噪声取样分布和权重分开记录,消融时不要同时改两个 |
| 中心深度 | 距离图、中心减边缘、log 无有效非负截断 | 先检查定义域;若修正需单独实验命名,不覆盖基线 |
| 固定分辨率假设 | 中心窗口与分母写死 64²−50² | 改变 rend_hw 时同步修改掩码逻辑并标明偏离原实现 |
| seed 与 trial | 入口固定 0;same_noise 创建后不用于主循环 | 不要声称每步共用噪声;新增多 seed 测试需明确是扩展 |
| 相机定义 | 采样变换与论文 elevation 描述不完全一致 | 记录实际相机分布、前缀边界;测试侧后与顶部缺陷 |
| 架构边界 | 无 view-dependent appearance;latent decoder 在渲染后 | 分别测几何一致性与 RGB 一致性;不将清晰 RGB 等同正确 mesh |
| 精度/优化默认 | SD 支持 autocast;场景张量浮点优化 | 锁定 PyTorch/CUDA 与依赖版本;原文未报告完整数值设置 |
| 展示选择 | 高分辨率脚本跳过前 60 个顶部视角 | 评估不沿用展示筛选;完整覆盖视球 |
| 权重与许可证 | README 要求外部 SD/FFHQ/LSUN checkpoint,捆绑约 12 GB;声明 OpenRAIL | 本轮未下载或运行;使用前核验各组件许可与来源 |
本次完整阅读主入口、SD 适配器、pose、voxel、renderer、README、高分辨率脚本及配置;未执行生成、未安装依赖、未测实际显存/耗时、未审计仓库所有 vendored U-Net 源码。代码差异是静态证据,不能包装成重现实验结果。
官方 README 的逐对象命令;所有主张对应下载源码与 source-evidence 记录。
第一,计算接口清楚。图像先验与场景表示通过 VJP 解耦,解释了为什么可以冻结扩散网络而优化复杂可微系统。第二,正面分析 OOD。橙色团块示例和二维失败实验比只展示漂亮 3D 更能说明问题。第三,公开工程细节。latent 体素、稀疏课程、背景容量控制和逐 prompt 配置让系统机制可检查,而不是只留下黑盒结果。
概率解释有两层边界:官方已修正三维能量的起点,PAAS 的下界梯度仍不能自动等同宽噪声 score。即使可优化,也不能由此声称准确采样真实三维分布。作者高 CFG、随机噪声和正则的组合更接近模式搜索,跨 seed 多样性与无条件失败都需要量化。
视觉实验不足以区分 PAAS、representation、prior、regularizer 各自贡献。要更强地证明算法价值,应固定 renderer、预训练模型、相机、计算预算和 prompt 集,只切换 score estimator 与噪声权重。几何评价应包含多视图重投影、法线/表面质量和遮挡稳定性,不能只看模型自己的深度可视化。
latent 的可渲染性不代表材质物理性。阴影、水面与地面进入密度,可能让固定照明下的图像更好但破坏重光照、碰撞、网格导出与编辑。中心化和视角文本先验也限制非中心物体、多物体组合、室内场景等应用。
可复现性风险包括原论文与当前代码的 sigma 权重、相机阈值、解码分辨率、中心深度符号、种子硬编码、逐 prompt 调参和后续展示脚本变化。本页将这些作为待检验的具体问题,而不是笼统否定作者结果。
令材质图拓扑为 \(G\)、连续参数为 \(\eta\)、几何/照明/相机条件为 \(c\),渲染器输出 \(I=R(G,\eta;c)\)。在固定有效拓扑下,可使用:
\[\Delta\eta\propto\mathbb E_{c,\sigma,n} \left[J_{\eta}R(G,\eta;c)^{\mathsf T} \operatorname{PAAS}(I,\sqrt2\sigma)\right] -\lambda\nabla_{\eta}L_{\mathrm{physical}}.\]这是研究设想,SJC 没有生成 Substance graph 或验证材质参数优化。关键实验应固定图拓扑,比对 CLIP、SDS/PAAS、像素重建、感知损失,并报告新光照/新形状下的材质识别与参数误差,而非只测训练视图。
对同一材质在多光源、HDR 环境、几何曲率下联合引导,同时共享 albedo、roughness、metallic、normal。设置物理范围与能量守恒项,避免把阴影烘焙入 albedo、把高光写进纹理。验证方式:训练环境与测试环境分开,测重光照一致性、通道泄漏和编辑响应。不能沿用“每个视角独立像 prompt”而没有跨条件约束。
节点类型、连边和拓扑不可直接用本论文的普通 Jacobian。可由 typed DAG grammar 保证合法性,在外层搜索节点增删与结构,内层对连续参数用 PAAS VJP 优化,再用可执行性、复杂度、真实渲染反馈筛选。拓扑搜索、backtracking 和 graph repair 是新增机制,不是 SJC 原有 agent pipeline。
借鉴“先形成后清理”,先允许充分节点/频率容量,再逐步增加复杂度与冗余惩罚。不要直接照搬 log(1+βw) 到所有图节点,因为 ray weight 与节点作用不同。应比较固定惩罚、两阶段、按梯度稳定性自适应课程,测图规模、可编辑性、外观误差与运行时间的 Pareto 曲线。
对“代码除 sigma”和“论文除 sigma²”做受控噪声权重扫描,记录梯度范数、跨视角方向冲突、有效更新大小;用共同随机数或多噪声采样研究方差,不预设去噪项一定方差更低。以高斯单峰、多峰合成分布作可计算真值单元测试,再上真实材质,防止把概率近似直接升级为采样理论。
风险与责任:二维训练数据偏差可能传给三维外观,真实人物或商标示例不意味着授权制作误导资产。用于工程时,应保留生成来源和许可信息,区分研究展示与可交付实体模型;计算资源、人工调参时间、失败重试也应计入成本。
内容覆盖:全部正文与附录已读;原文无定量表,所有原图与算法完整覆盖。本页设置表、公式推导、代码差异表和 PMG 研究计划均明确标注来源与推断性质。原笔记完整前缀保存,待本地审阅后再决定归档。
验收边界:已做 HTML 体积、内部锚点、数学源码与原始注释保护等静态检查;互联网图源做 HTTP 检查。浏览器 MathJax、图片实际布局和 1440/760/390px 响应式验收按用户要求延后,不能把静态检查写成浏览器通过。当前未发布、未集成真实知识库。