流程视角
离线纸笔、数字交互、模型检索与沉浸式绘制各有优势。作者主张消除它们之间的信息断点,而非让一种输入方式取代所有工具。
Sketch-based interaction and modeling: where do we stand?
离线解释、交互建模、检索、NPR 与 VR/AR:一份保留全部原图表及证据边界的中文精读
Alexandra Bonnici 等 · 2019 年文献范围 · 原文与独立核查分开标注
真正的目标不是把一张线稿变成一个三维模型,而是让草图、模型、检索、协作与设计决策在整个产品设计过程中连续流动。
离线纸笔、数字交互、模型检索与沉浸式绘制各有优势。作者主张消除它们之间的信息断点,而非让一种输入方式取代所有工具。
初始模型生成快,不等于完成设计快。修形、纠错、补尺寸、切换工具和学习手势都进入用户成本。
这是综述与立场文章。3 张表汇总异质研究,没有本文统一训练、统一数据集上的 SOTA 排名或组件消融。
标题:Sketch-based interaction and modeling: where do we stand?。发表于 AI EDAM,2019 年,第 33 卷第 4 期,正式页码 370–388;Cambridge 在线发布日期为 2019 年 11 月 29 日,DOI 为 10.1017/S0890060419000349。固定 PDF 为 19 页的在线排版版本,内部页码 1–19,因此下文页码均按这份 PDF,而非期刊连续页码。
作者按原文顺序:Alexandra Bonnici、Alican Akman、Gabriel Calleja、Kenneth P. Camilleri、Patrick Fehling、Alfredo Ferreira、Florian Hermuth、Johann Habakuk Israel、Tom Landwehr、Juncheng Liu、Natasha M. J. Padfield、T. Metin Sezgin、Paul L. Rosin。第一作者及明确标注的通讯作者均为 Alexandra Bonnici,论文机构为 University of Malta。其余机构包括 Koç University、HTW Berlin、Instituto Superior Técnico、Peking University 和 Cardiff University。
范围与时间:论文基于 2018 年 3 月 Malta 的三天工作坊,汇集草图识别、检索、VR/AR 与 NPR 研究者,并吸收制造工程师与建筑设计师的讨论。2018 年 11 月投稿、2019 年 8 月修订、10 月接受;引文包含 2019 年研究,但没有声明精确检索截止日期、数据库检索式或系统纳入排除流程。因此,它是面向产品设计的叙述性综述与研究议程,不能代表 2026 年所有方法的最新状态。
全文已覆盖:正文与结论第 1–15 页,参考文献第 15–18 页,作者简介第 18–19 页;固定文件没有附录。下文完整重建原 Table 1–3 的 26 个研究条目及全部列,保留 Figure 1–6。对于原文内部矛盾,先忠实呈现原表,再提供独立的一手来源核查。
来源:固定 PDF 第 1–2 页;Cambridge 论文页;Malta 机构仓储。原笔记历史内容不作覆盖。
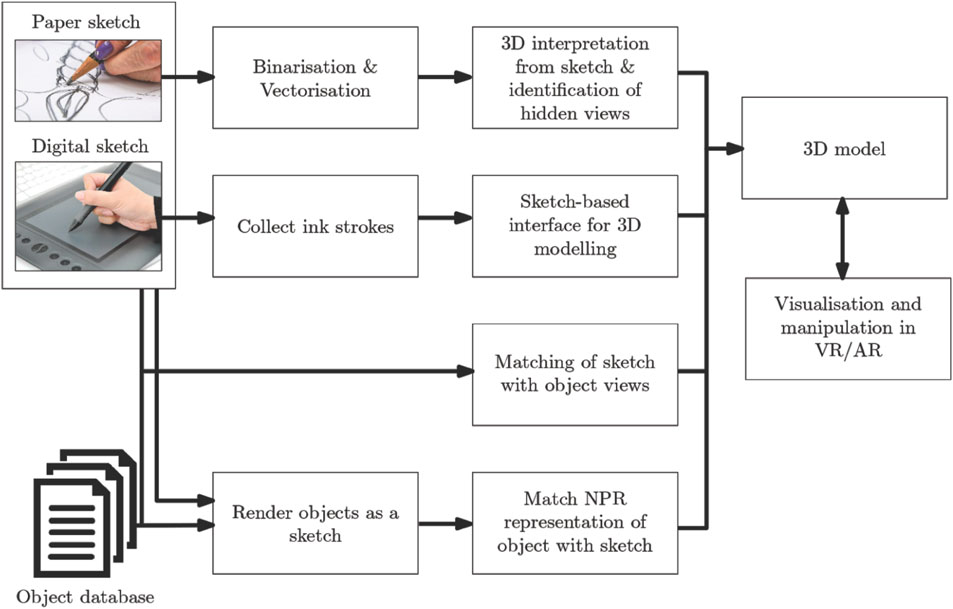
Figure 1 是全文的组织骨架:同样是“画”,系统可能需要恢复笔画拓扑、推断几何、找到数据库对象、解释修改手势,或者让人在真实三维空间中直接造形。把这些任务都写成 sketch-to-3D,会掩盖输入信息和评价目标的差异。
| 原文分支 | 输入与可用信息 | 输出或行动 | 关键困难 |
|---|---|---|---|
| Interpretation of offline sketches | 扫描/拍照后的二维图像,没有可靠时间顺序 | 二值墨迹、矢量笔画、拓扑,再到三维形状 | 背景污染、重描、交汇歧义、单视图深度与隐藏结构 |
| Interactive sketches | 数字笔画、用户追加手势/视图、当前模型 | 持续创建、膨胀、变形或修正三维对象 | 交互语言学习、自由度与歧义、初始速度与后续编辑成本 |
| Sketch-based shape retrieval | 草图查询与预存三维模型库 | 排序候选、部件组合或场景组装 | 库覆盖、视点不一致、画风差距、结果可探索性 |
| NPR / line detection | 图像或三维几何 | 适于匹配或理解的线描表示 | 图像强度边缘不等于人类感知的形状线 |
| Multimodal interaction | 草图、语音、凝视、手势;触觉作为反馈 | 推断意图、定位讨论区域、帮助操作 | 时间对齐、无意动作、误判恢复、隐私与干扰 |
| AR/VR sketching | 被追踪的三维手/笔/控制器运动 | 三维笔画、曲面、体或原语 | 空间精度、感知与运动控制、支撑结构、长期学习 |
这些分支是按交互场景组织的,不是互斥算法类别。神经网络可用于简化草图、恢复深度或匹配检索;NPR 既能构建检索表示,也能生成学习数据;多视图交互又能连接离线解释与在线编辑。
设计阶段决定精度要求。构思初期容许不完整和模糊的草图,以便快速外化与重新解释想法;详细设计需要尺寸、约束、可编辑结构与工程验证。VR/AR 适合比例感、空间探索和协同审阅,传统 CAD 可能更适合精确设计。论文追求保留这些阶段之间的语义关系,而非只转换文件后丢掉设计意图。
来源:固定 PDF 第 2、12–15 页,Figure 1。
基本流程是 图像二值化 → 矢量化 → 几何解释。三个阶段分别回答“哪些像素是墨迹”“哪些笔画连接在一起”“这些连接对应什么三维结构”。前一阶段的局部错误会改变后续的全局解释。
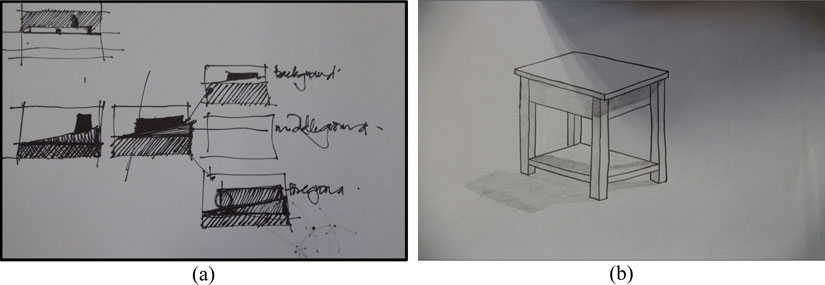
二值化:白纸扫描件上,全局 Otsu 或局部阈值类方法可能足够。方格纸、横线纸、背面透印、旧笔迹与不均匀照明会破坏前景背景分离;Figure 2 分别展示透印与亮度变化。不能只把困难归因于扫描噪声:纸张纹理本身可能产生稳定却无关的线。
骨架法:细化删除笔画宽度、保留中轴,再拟合直线和圆弧。轮廓不光滑会产生毛刺,所以往往需要简化、合并与美化。若早期删除真实短支路,后面再精确拟合也无法恢复原拓扑。
轮廓配对与游程法:匹配相对边界、或利用水平/垂直 run-length 表示估计中轴。通常仍需遍历图像像素。稀疏采样法则假定线条可近似为分段线性结构,用沿笔画推进的采样窗口降低计算量,但越过交汇点时必须决定沿哪条分支延伸。
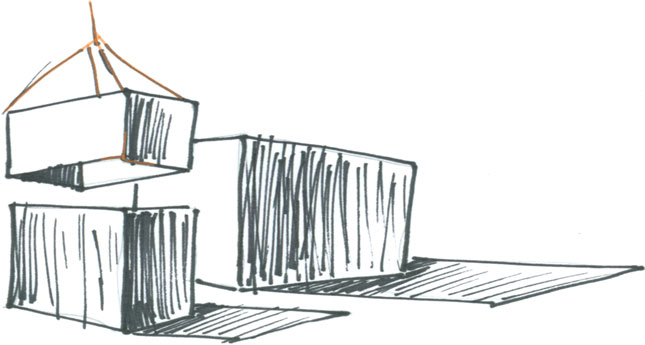
连接点优先:直接以拟合直线的交点作为 junction,对规整机器制图较合适,对潦草手绘不可靠。Figure 3 展示笔画未必真正相交于预期的顶点;“端点没碰到”可能是手绘误差,也可能真是断开,需要利用周围上下文。
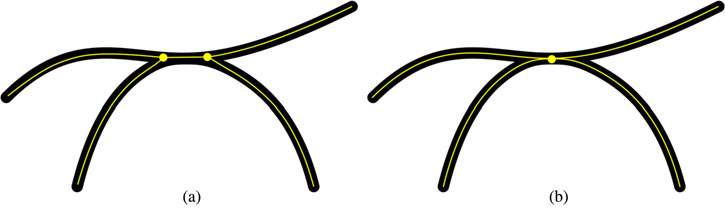
Figure 4 的切触例子说明:几何拟合距离相近,不代表拓扑相同。两条平滑曲线应在一个切点相遇,错误处理会产生两个交点。Chen 的极坐标强度分析、Noris 的拓扑模型、Pham 的高曲率骨架区、Favreau 的超图与 Bessmeltsev 的方向场,均尝试直接处理这种分支解释。Bonnici 等 2018 年的工作还用 Gabor-like/COSFIRE 过滤器先定位局部 junction,再精化其位置和结构。
神经预处理的角色:Simo-Serra 等 2016 年的全卷积网络以空间编码、主干线提取、解码恢复分辨率三个阶段,把重复描线的粗草图简化为单线图。训练配对采用反向构造:给艺术家干净线稿,让其重描成粗糙版本,再加入色调、模糊和噪声增强。Li 等 2017 年处理漫画结构线的更深网络,应对纹理/网点背景。这些方法输出仍是图像;“清理成单线”不自动保证已经得到 CAD 级矢量拓扑。
来源:固定 PDF 第 2–4、6 页,Figures 2–4;此处 CNN 结构只按综述给出的层次描述,未补造层数、损失权重或训练超参数。
以下保留原表全部 10 行、算法说明及性能列。中文翻译按原表语义展开;年份和数字不改写。这是一份各自实验条件下的报告汇总,不能直接按 VRI 或误差数值给全部方法排名。
| 算法 Algorithm | 简述 Brief description | 性能 Performance measure |
|---|---|---|
| Ramel et al. (1998) | 在图像边缘轮廓上拟合直线、四边形与 Bézier 曲线;适合技术和工程图。 | 作者自建图像库上的视觉检查。 |
| Dori and Wenyin (1999) | 沿二值图像的线条推进矩形片段,提取直线和圆弧片段;适合技术和工程图。 | 作者自有图像上平均 VRI 为 0.88。 |
| Song et al. (2002) | 直线使用一个矩形片段、圆弧使用三个矩形片段推进,并渐进简化绘图;适合技术和工程图。 | 平均 VRI 0.95,平均 ECI 0.16。 |
| Hilaire and Tombre (2006) | 把骨架模糊分割成直线和圆弧,再简化骨架并统一各部分;适合技术和工程图。 | GREC 2003 竞赛示例图像上平均 ECI 0.68,平均 VRI 0.74。 |
| Keysers and Breuel (2006) | 直接对二值图像作 run-length encoding,并拟合直线/圆弧原语;通过 branch-and-bound 递归划分参数空间;适合技术和工程图。 | GREC 2003 图像上的 VRI 为 0.76。 |
| Noris et al. (2013) | 分析绘图拓扑以消除 junction 歧义;处理自由手绘。 | 作者自有绘图上,平均 CE 为线宽的 4.15%,SPE 小于线宽。 |
| Chen et al. (2015) | 追踪图像轮廓检测 junction;以强度极坐标映射确定位置,再用轮廓路径弯曲程度确定拓扑;处理自由手绘。 | 作者自建图像库上的视觉检查。 |
| Pham et al. (2014) | 从图像骨架的高曲率区域检测 junction 区,再利用周边骨架拓扑优化位置;处理粗糙草图。 | GREC 2011 绘图的旋转、缩放、噪声变体上,repeatability 为 75.25%。 |
| Favreau et al. (2016) | 过分割图像骨架并表示为超图;按简单性和保真度合并片段,以曲线连接约束定位 junction;处理粗糙草图。 | 线宽 24 像素时,真值与提取矢量平均位移为 0.6 像素。 |
| Bessmeltsev and Solomon (2019) | 以 frame-field processing 消解 junction 歧义,用图结构保留绘图拓扑;处理自由手绘。 | 使用 Favreau et al. (2016) 与 Noris et al. (2013) 的图像作视觉比较。 |
原表来源:固定 PDF 第 5 页 Table 1。原脚注指向 GREC 2003,此历史链接仅作出处,不保证服务仍可用。
Pham 的重复性和 Favreau 的像素位移是表中另外的评价方式,并不等价于上述指标。0.6/24 = 2.5% 可作为线宽归一化的算术直觉,但这不是作者报告的 CE,更不能拿来宣称优于 Noris 的 4.15%,因为误差对象、样本与汇总方式不同。
真正未解决的需求:不仅要处理整洁工程图,还要容忍早期设计中的重复描线、涂划、不完整结构、阴影与自由曲线,并可靠保留高阶连接关系。
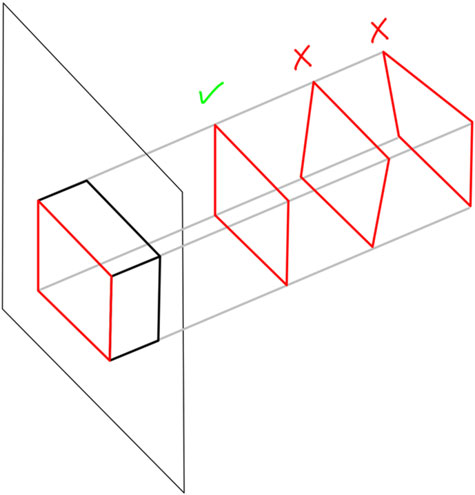
矢量化不是三维理解。即使二维线条和 junction 完全恢复,同一投影仍可对应多种深度配置。Figure 5 展示多个符合二维外观的三维膨胀结果,说明问题不仅来自图像噪声,还来自投影本身丢失信息。
Clowes、Huffman、Waltz 与 Cooper 等边标记方法,把边分类为凸、凹或遮挡边,针对三/四条边相交的 junction 建立允许配置目录,再传播局部一致性约束。它们能够限制几何解释,却需要维护和搜索复杂目录;仅知道边类型仍不能唯一确定三维形状。
优化型方法加入正交、平行等形状规则,倾向于符合人类理解的解释。另一条路线利用消失点、投影中心与相机校准恢复几何。两者的代价都是先验依赖:真实设计若刻意不正交,或草图含透视夸张,就可能被“合理化”成错误形状。
Ros 与 Thomas 可在已有线框条件下求解平面方程,但普通设计者常常只画可见部分。Cao、Varley 和 Kyratzi 等方法从可见顶点构造隐藏连接候选,再断开边、插入顶点或添加支路,利用隐藏面与可见面的相似性、共线和平行约束、尽量少顶点等规则选择拓扑。树形组织可保留多个假设,仍没有消除组合搜索本身的困难。
Lun 等 2017 年从一张或多张线稿预测各视点的深度图与法线图,由此形成点云并生成多边形网格。综述明确说单视点提供的信息不足以稳定准确重建;让用户追加视点能缓解歧义,也把离线重建接入交互系统。这里的学习先验不等于测得真实背面,而是依据训练经验选择合理候选。
论文特别提出一个微妙的平衡:过于严格的 junction 几何拒绝自然手绘,过于宽松的学习又会接受错误连接。更好的系统要看全局上下文,尝试利用艺术家表达形体的阴影与线重,而非只依赖局部线段拟合。
来源:固定 PDF 第 4–6 页、Figure 5。下文数学抽象仅用于解释,本文没有提出新的重建能量函数。
轮廓膨胀:Teddy 先从闭合轮廓的三角网格提取 chordal axis,再抬高内部形状并镜像,快速获得圆润体。用户再以拉伸、切割、平滑等操作修形。它给第一版的速度很快,但天然偏向 blob-like 形状,尖锐特征与复杂结构需要额外操作。
交互语言与显式约束:SKETCH 用特定手势创建和变形原语;DigitalClay 美化等轴测草图,再进行边标记;True2Form 让用户以不同颜色注明正交、平行、对称与曲线共面等关系。系统通过让用户提前表达意图来减少歧义,也因此增加学习与输入负担。
可追加视图的学习:Delanoy 等的 initial CNN 从单图预测体素占据,updater CNN 再融合新视点,可迭代接受多图而无需用户给出逐笔对应关系。综述描述其合成训练集由立方体、圆柱等布尔加减生成,可表现平面正交面、孔洞和凸起;共有 20,000 个对象,其中 50 个测试、其余训练。这个 50 是综述叙述中的对象测试数,不应被误用为本文自己的数据划分,也不能推断按作者/风格的泛化已测。
Li 等 2018 年预测深度/法线,采用 flow field regression 与置信图处理局部歧义。用户可补画表面曲线、指定稀疏深度点,或借用正面草图绘制背面;rolling guided normal filtering 用于平滑曲面上的尖锐特征。训练草图由三维形状经 NPR 生成。
关键判断:“无需笔画对应”降低用户负担,不代表系统不需要视点/投影上下文;也不代表生成模型已保留参数化 CAD 特征树。每一种方法都在把劳动从初始绘制、显式标注和后续修正之间重新分配。
来源:固定 PDF 第 6–7 页;Delanoy 的作者项目页核实单视图网络、迭代更新网络和代码资源。未把被综述方法当作本文的新贡献。
| 算法 Algorithm | 简述 Brief description | 评价 Evaluation |
|---|---|---|
| Teddy (Igarashi et al., 1999) | 初始笔画生成闭合多边形网格;通过拉伸、切割、平滑改变底层多边形结构以适配新笔画;主要支持圆润自由形体。 | 面向计算机图形研究者和学生的非正式评价;参与者报告在 10 分钟教程与引导练习后能熟练使用。 |
| DigitalClay (Schweikardt and Gross, 2000) | 用户绘制等轴测视图;拉直线、连接相邻笔画形成角点;可拖动角点或覆盖描绘边;先执行 Huffman–Clowes 标记,再生成三维表示。 | n/a,原表没有给出评价。 |
| Masry and Lipson (2007) | 从线框草图重建,假设底层正交轴系;渲染时不显示隐藏线;用户旋转和修改结果;支持直线或曲线轮廓的平面物体。 | 作者对生成对象作视觉比较;初始草图最多 50 个笔画,以交互速度处理。 |
| Sketch (Zeleznik et al., 2006) | 用手势创建圆锥、圆柱、球、棱柱;另用手势执行拉伸、旋转、缩放;可通过画阴影表达空间位移。 | n/a,原表没有给出评价。 |
| Fibremesh (Nealen et al., 2007) | 先由轮廓膨胀模型,再修改;笔画直接作用于三维表面,并累积为三维曲线集合;主要为圆润自由形体,也可通过曲线变形和曲面优化形成尖锐特征。 | 对初次使用的非专家及一名专业二维动画师作非正式评价;报告易用,二维绘画技能可迁移到三维建模。 |
| NaturaSketch (Olsen et al., 2008,原表标注) | 在已有图像上描绘以控制比例;围绕笔画建立平面网格,再用垂直位移函数膨胀;可添加凸起、孔洞、拉伸与浮雕变形。 | 8 人非正式研究:5 名图形研究者、1 名二维铅笔画者、2 名无绘画/建模经验者;观察到在图像上描绘时画得更好。 |
| True2Form (Xu et al., 2014) | 导入草图;用不同颜色标注正交、平行、对称、曲线共面等属性,作为重建约束;支持自由形体。 | 作者把生成模型与相似交互系统的模型作视觉比较。 |
| Delanoy et al. (2018) | CNN 产生初始三维重建,再由新增视点更新;面向有平坦正交面的人工物体,原语加减也支持孔洞与凸起。 | 2 名专家和 6 名绘画/三维建模经验有限的参与者,选择两个目标形状之一进行建模;上手快,但用户认为细节不足。 |
| Li et al. (2018) | CNN 通过 flow field regression 预测深度/法线;用户补线精化或添加细节;面向平滑自由曲面,以 rolling guided normal filtering 支持尖锐特征。 | 5 名缺乏草图与三维建模知识的初学者,完成 3 项目标形状重建任务。 |
来源:固定 PDF 第 7 页 Table 2,全 9 行。原表写作 Fibremesh,正文与文献使用 Fibermesh,指同一工作。NaturaSketch 年份矛盾见后文来源审计。
证据强度并不均匀:有的只是作者截图,有的为小样本非正式体验,有的只写 n/a。10 分钟熟练是 Teddy 的特定非正式反馈,不是所有技能达到专家水平;“最多 50 笔画”是某系统示例的规模,而非跨方法计算预算。综述没有提供统一任务、学习时长、完成标准与统计显著性,所以不能由这张表证明神经方法在真实设计效率上全面领先。
作者归纳的折中是:膨胀型方法初始输入少但修正多,规则/语言型方法初始投入多但结果更受约束,学习型多视图可能处于中间地带却缺少细节。这个概括是跨研究解释,而不是本文控制变量实验的因果结论。
检索方法假定数据库已经存在所需形状。其标准流程为 视点选择与渲染 → 特征提取及形状表示 → 度量学习与匹配 → 展示和选择。用户可绘制侧、正、顶视图,寻找形状一致的对象;复杂物体可按部件检索组合,场景则可逐对象检索。
Light field descriptor 用多个投影视图代表三维对象;Eitz 等把库中模型渲染成 sketch-like 图像,使查询和库对象在二维域比较。这样可绕开直接匹配二维线稿与三维网格的表示差异,却引入“预先选出的视点是否涵盖用户画法”的问题。
| 综述中的代表路线 | 对齐方式 | 主要限制 |
|---|---|---|
| 多视点描述子 / 陈等 2003 | 渲染三维视图,提取可比较的二维特征 | 视点覆盖和采样成本;手绘失真 |
| Wang et al. 2015 | CNN 学习草图与三维投影图像之间的跨域相似性 | 仍依赖模型渲染表示与训练分布 |
| Zhu et al. 2016 | 学习二维草图特征与三维形状特征的直接跨域映射 | 两个域的统计差异与语义类别对齐 |
| Dai et al. 2018 DCML | 两域分别用深网络,再以联合损失增强域内判别性和跨域相关性 | 综述没有提供可重建的完整损失和基准数字 |
| Xie et al.,正文记 2016、文献列 2017 | 学习三维投影的 barycentric representation | 原文年份不一致;不要据此拆成两项工作 |
库再大,也未必有与新设计完全相同的对象;甚至类别相同也可能只检索到比例、结构或视点近似的结果。应区分找回指定实例、找到同类别、找到可编辑部件、获得设计灵感这几种成功定义。综述说 DCML 优于 Wang 等,但没有统一结果表,本页不伪造提升百分比。
缩略图和可旋转对象是传统方式。作者提出在三维空间中组织结果,让不同轴表达不同检索标准,使用 VR/AR 展示更多候选;难点是用户移动后组织关系是否仍然清楚,以及如何避免把无意动作解释为选择或操作。显示更多内容不天然等于更容易找到合适对象,排序后的用户决策成本必须单独评价。
来源:固定 PDF 第 8–10 页。原文提及的商业服务和链接属于 2019 年背景,未作为当前产品可用性推荐。
从 RGB 图像抽线:线检测依赖亮度分布,可用 Hessian 特征值/特征向量、不同阶高斯导数、Gabor 小波或学习分类器。影像中的纹理、光照与背景杂物会产生强边缘,因此边缘响应强并不意味着这是形状上值得画出的线。
Kang 等 2007 年的 coherent line drawing 先估计局部边流,在垂直方向计算 DoG,并使卷积核沿边流弯曲,以形成更连贯线条。Lu 等 2012 年的铅笔化先用 8 个方向的线核为像素分配方向,形成 8 张响应图,再用对应长线核连接缺口、略微延长笔画。综述将结构线部分视为对检索更直接有用的表示,而明暗色调更多服务于风格。
学习型线检测包括用于道路/血管分割的 U-Net 类网络,以及用人工调整的传统线描算法输出构造训练数据的 PencilArt。这说明“合成标签便于训练”有代价:教师渲染器未画出的语义线,很可能也不在监督里。后处理可填小断裂、去除孤立误报,hysteresis 双阈值只保留与高响应线相连的中等响应像素,但不会凭空补足语义知识。
| 线型 | 几何含义 | 视点性质 |
|---|---|---|
| Ridges / valleys | 主方向上主曲率的极值轨迹 | 基于对象内禀曲率,通常视点无关 |
| Occluding contours | 表面法线与视向垂直的轮廓位置 | 视点相关 |
| Suggestive contours | 当前视点下接近出现真实轮廓的位置;综述以法线和视向点积的正局部最小解释 | 视点相关,帮助表达平滑曲面 |
| Apparent ridges | 把曲率与投影缩短结合,寻找最大视点相关曲率轨迹 | 视点相关 |
Cole 等 2008 年的数据含 208 幅线描、12 个三维模型、每个模型 2 个视点和 2 种光照、29 位艺术家。208 是实际绘图数,不是把所有因素相乘后得到的完整笛卡尔积。以 precision/recall 比较 Canny 强度边缘、ridges/valleys、suggestive contours 和 apparent ridges 后,没有一个方法对所有对象始终最好。机械物体更适合 ridges/edges,布料与骨骼更适合遮挡轮廓和 suggestive contours;组合方法能表达部分褶皱。
后续知觉研究表明某些形状从线描中也能获得接近明暗图的理解,但这不等于所有草图都信息充分。综述还提到 DeepShapeSketch 以 GAN 与 LSTM 产生二维坐标序列,以及 RenderNet 学习体素到图像的渲染,后者将对象缩放到 64×64×64 体素以限制内存。这些是 2019 年视野内的路线,不是对当前三维学习技术成熟度的判断。
来源:固定 PDF 第 8–9 页。原文没有给出这些方法的统一训练表或完整公式,本页不把它们拼成一个虚构系统。
语音:人在协作绘制时,会用语言解释尺寸、功能、修改关系与指代,补充笔迹中没有的含义。研究既要考察人愿意如何说和画,也要解决二者的时序对应;不能假定每句话都与当前最后一笔一一配对。
凝视:凝视轨迹能帮助提前识别操作活动,也能定位共同关注的部件。Çığ 与 Sezgin 2015 年收集 10 名参与者(6 男、4 女)完成 5 类任务的数据,以 SVM 预测任务,综述报告 88% 成功率。这是一个有限任务空间的活动预测结果,不是任意草图意图理解准确率,也不是本文的新实验。
错误会改变用户行为:当系统误判时,用户可能刻意移动眼睛或改变说话方式来纠正系统,而这种非自然行为又会破坏训练时的统计关系。可靠交互因此需要撤销、确认、不确定性表达与低成本恢复,而不能只追求离线分类分数。
触觉:不同于语音和凝视主要向系统提供输入,触觉向用户反馈虚拟接触、约束与双手对象关系。Haptic Links 用可变刚度连接支持双手操作,其研究含 12 名参与者,年龄 25–49 岁,其中 1 名女性,报告相对普通 VR 控制器更真实的部分交互体验。PHANToM 在指尖施力、pen-shaped gripper 操作自由曲面,则是较早的力反馈例子。真实感评价不能直接转换成草图几何精度或完成时间收益。
协作的特殊问题:指点属于 deictic gesture,可以表明“这个零件”或“这里的边”,但拨头发等自然动作与设计无关。把所有轨迹都送入解释器会增噪;持续记录还可能让参与者感到被监视,从而降低自然表达。论文将跨文化通用手势与个体化识别都列为研究问题,并没有宣称已找到通用解法。
来源:固定 PDF 第 10、13–14 页。以上参与者与结果均为综述转述,样本构成和任务边界应随结论一起保留。
沉浸式绘图直接记录被追踪的控制器、笔或手在三维空间中的运动,用户移动头部和身体即可从新方向观察笔画与平面。CAVE、桌面 VR、HMD、移动设备 AR 的显示、追踪、触觉和多人可见性不同,不能简单视为“同一种三维交互”。
论文描述从投影型系统向较低成本、空间占用更小、移动性更强的 HMD 转移。投影环境能让用户看到彼此,但通常只有一个观察者具有正确的立体视角;不透明 HMD 则会遮挡物理环境。AR 保留真实世界,可把虚拟参考线或模型叠加在真实对象上;移动 AR 还需由传感器和摄像头估计设备姿态。这里是论文发表时的技术背景,并未核实列举商业产品的当前状态。
Arora 等先访谈/观察 5 名设计专家,发现他们倾向于在受控与自由模式间切换;另以 12 名无专业绘画经验的参与者测试,物理表面相对自由绘制改善精度 22%,虚拟表面改善 17%。网格和 scaffolding curves 分别改善 17% 和 57%,但受约束的作品更不美观,特别是使用支架曲线时。不能把 57% 精度增益当作总体体验增益,更不能把所有这些百分比混成同一设备的叠加收益。
Multiplanes 选择另一条路线:将三维笔画投射至二维平面,并实时矫正或美化。初步用户研究中,8 名本科生有 2 人具沉浸绘图经验,平均评价 4.5/7,6 人对功能感到兴奋;这些是接受度证据,尚不足以证明长期生产率或几何误差优于其他系统。
Wacker 等比较 AR 中相同尺寸的物理和虚拟对象,16 名参与者在物体表面描线,物理对象相对无触觉支撑的虚拟对象准确 48%。结论绑定于追描任务,不应扩展成“AR 比 VR 精确 48%”。触觉可能减少对密集视觉支架的需求,这是作者提出的研究机会,而非已验证的等价替代。
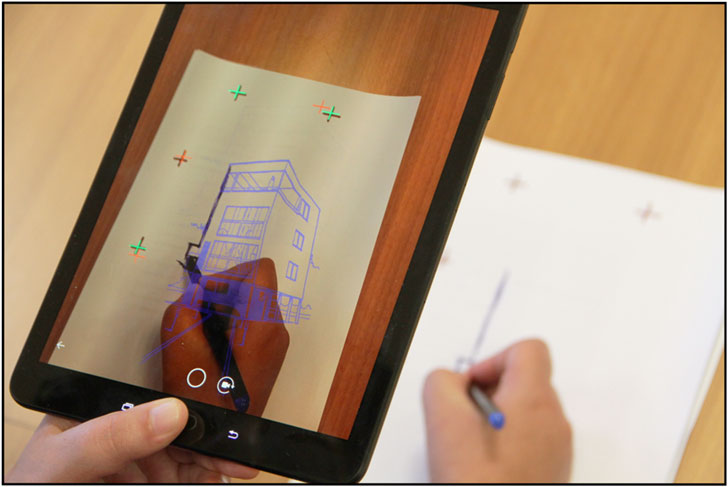
Figure 6 中 SketchAR 使用摄像头检测纸面、在手机显示中叠加模板,再由用户用实体笔追描。输出依然可以是纸上草图,体现跨介质辅助,而非自动从任意草图生成三维模型。CreateAR 的地理位置共享绘画与 HoloLens 的手势画线则代表其他 AR 交互方式。
来源:固定 PDF 第 10–13 页,Figure 6。中长期学习、创作自由与工程有效性仍需分别评价。
下表保留原表的全部 7 项研究与 5 列。“原表如此”不等于经核查正确;Wiese 一行明确保留待纠正字段,随后给出原研究证据。
| 项目/作者 Project/authors | 环境 Environment | 目标与指标 Aim and metrics | 参与者 Participants | 主要发现 Key findings |
|---|---|---|---|---|
| Cave painting Keefe et al. (2001) | VR CAVE | 用非正式观察评价沉浸式建模的可行性。 | 两个艺术班、画家与不同背景的艺术学生。 | 展示以沉浸式建模创作艺术作品的可行性。 |
| Drawing on air Keefe et al. (2007) | Desktop VR | 通过位置误差与绘制时间评价触觉支撑。 | 12 名有经验的设计师和艺术家。 | 相对自由三维绘图,带触觉支撑的绘图位置和旋转误差约减半。 |
| Immersive sketching Israel et al. (2009) | VR CAVE | 比较二维与三维绘图行为:草图尺寸、细节、使用时间与用户速度。 | 24 名家具设计师和室内建筑师。 | 三维草图接近两倍大;移动快 33%;细节为两倍;三维条件的使用时间高 50%。 |
| Learnability Wiese et al. (2010) | VR HMD(原表标注,原研究为 CAVE) | 测量线准确性、均匀性、形状偏差、工作负荷/时间、线匹配与修正动作。 | 原表列“25 students, 12 designers, 4 architects, 1 visual artist, and 4 art teachers”;存在总数与专业分项歧义,见核查。 | 原表表述线准确性、对象均匀性、形状偏差在 30 分钟后“increased”;方向应按各指标定义解释。 |
| Sketching on surfaces Arora et al. (2017) | VR HMD | 比较虚拟/物理表面支撑与无支撑自由模式,以深度偏差和曲率平滑度衡量精度。 | 12 名没有沉浸式草图经验的参与者(原表措辞)。 | 物理绘图表面改善精度 22%,虚拟表面改善 17%。 |
| Multiplanes Barrera Machuca et al. (2017) | VR HMD | 评价实时笔画美化的接受度:交互容易度、感知速度/精度和总体意见。 | 8 名本科生,其中 2 人有沉浸式绘图经验。 | 平均中等评分 4.5/7;6 名参与者对功能感到兴奋。 |
| Physical guides Wacker et al. (2018) | AR HMD | 比较在同尺寸虚拟和物理对象上的描绘,以 x、y、z 方向的三维偏差评价。 | 16 人:11 人无 AR 或沉浸绘图经验,4 人有 AR 但无沉浸绘图经验,1 人有沉浸绘图但无 AR 经验。 | 追描物理对象比追描无触觉支撑的虚拟对象准确 48%。 |
来源:固定 PDF 第 11 页 Table 3。保留原表研究条目、列与报告数字;更正单独列出。
Eurographics 原论文明确使用五面背投 CAVE,总计 25 名学生。12、4、1、4 是专业分项,不能再加到 25 上,且这些分项自身仅合计 21,来源未解释余下 4 人。测试为累计练习 0、10、30 分钟;线准确性评分实际越低越好,shape deviation 也越低越好,uniformity 越高越好。质量改善不应被写成所有指标数值上升。原研究没有发现绘制时间或主观工作负荷的显著改善。
独立核查:Wiese et al. 2010,原论文 §2.1–3.2、§4–5,DOI 10.2312/SBM/SBM10/135-142。综述正文另以约 10%、8%、9% 概括质量方面的改善,未把它们当成统一分母的可合并效应量。
Table 3 最容易误读的另一项是“使用时间增加 50%”:它可反映更投入或更丰富的创作,也可意味更慢。若没有同质量任务完成准则,不能把它自动解释为效率提升。同样,“更自然”是用户体验信号,与完成精确工程模型的成本并非同一指标。
从粗略构思到精细设计需要不同输入、精度和软件。作者认为现有工具在各自局部问题上进步,却缺乏跨介质互操作;早期 Bonnici 等 2015 年的纸笔到 VR 三维模型工作展示过连接的可能。后续重点是交换格式与可持续编辑的信息结构,使草图、尺寸、模型和决策连续,而不是每进入新工具就重新画一遍。
群体头脑风暴中的草图还包含短暂手势、口头推理与不断重解释的概念。手势可视为“第二层草图”,但需要过滤与设计无关的动作、处理跨文化差异、考虑个体表达,并研究全面记录是否会改变团队自然行为。更高采集量不等于更高理解质量。
文件共享不能完全传递当下注意焦点。两三人面对面交流可用指点配合语言建立共同背景,远程大群体更难。实时凝视共享、热图与路径可以补充关注区域,但眼动低信噪比和不断移动容易分散注意。D’Angelo 与 Gergle 的双人任务结果不能直接推及多人,因此需要研究语音与凝视联合消歧,以及对共享区域的简洁显示。
PLM 通常保存产品在生命周期各阶段的信息;作者希望把草图、绘图和三维模型纳入,允许人追踪某个特征何时、为何被决定,并把后续使用反馈关联到设计。它要求能够导航的设计故事板和语义索引,而不是仅保存一堆按日期命名的文件。消费者、设计师、工程师、供应商等角色的需求也不同。
GREC 适合规整工程图,却不足以覆盖自由曲面、粗描和多种风格。让艺术家在干净线稿上加粗重描可以获得对齐监督,但限制自然绘制;让人自由画后再追踪干净线稿,更接近自然笔迹,却仍可能受临摹对象限制。作者建议让人绘制实体三维对象,并同时采集扫描或三维模型,使同一组数据服务矢量化、重建和检索。真正自然的人机协作数据难采,因为所需的完整智能系统本身尚未存在。
来源:固定 PDF 第 12–15 页。以上五项是作者提出的研究议程,论文没有实现完整互操作平台或发表统一新数据集。
本节是阅读者建立的解释性抽象,不是原文公式。这篇综述没有编号的统一损失、概率模型或新算法。以下公式用于区分任务和复现边界,不能引用为 Bonnici 等提出的模型。
\(I\) 是灰度草图,\(B\) 为墨迹掩码,\(V\) 是 junction/端点,\(E\) 是连接关系,\(\Gamma\) 为各边的几何曲线,\(M\) 为三维形状。位置误差作用于 \(\Gamma\),漏连/错连则改变 \(E\);视觉接近并不能保证拓扑正确。这里的草图图结构不自动等价于参数化 CAD 图或 shader graph。
\(S\) 是草图,\(\mathcal{L}\) 表示在相机 \(c\) 下渲染线稿,\(d\) 衡量线条差异,\(\varepsilon\) 容许手绘误差,\(\Omega\) 是平行/正交/简单性或学习先验。候选集合可含多个不同背面和深度;最小化先验仅是在欠定问题中选择一个解释。原论文并未给出这里的具体 \(d\) 或 \(\Omega\)。
\(\mathcal{D}\) 是模型库,\(\mathcal{V}\) 是候选视点,两个 \(f\) 把不同域映射到可比较特征。它说明视点覆盖、跨域特征与库覆盖为什么彼此独立。公式只抽象多视图检索的一种典型方式,不能把所有深度检索方法都当作显式穷举视点。
各项分别为学习、绘制、等待、纠错、跨工具迁移与验证时间。论文的工业采用论证可用此式理解:只减少第一版的等待或绘制时间,可能被修形和迁移成本抵消。若用户需多次使用,应将一次性学习成本单独报告,而非每次都重复计入;也应在相同结果质量与任务约束下比较。
第一项表达 CE/SPE 使用线宽作为尺度的直觉,不能代替其原实现的对应与聚合细节。后两项解释线检测的精确率和召回率;必须先定义容差、像素/曲线匹配与真值标注方式,数字才有意义。这些通用数学解释不补足综述未公开的评价代码。
对综述做“复现”首先应复核文献身份、分类归属和实验转述,而不是寻找一个不存在的本文 checkpoint。作者没有提出新的 backbone、统一训练集、优化器、推理采样器或消融配置。
| 复现项目 | 本文给出的内容 | 不能据此补出的内容 |
|---|---|---|
| 综述检索流程 | 工作坊来源、作者经验与相关文献组织 | 完整检索式、筛选流图、纳入排除标准、偏倚评价、预注册方案 |
| 数据集 | GREC、各作者自有草图、合成三维对象与 NPR、用户研究样本 | 本文统一 train/validation/test split |
| 训练 | 若干被综述模型的网络角色、数据来源和少量规模 | 统一 optimizer、学习率、batch、epoch、GPU、训练时间和损失权重 |
| 推理 | 二值化/矢量化/重建、多视图更新、检索和交互流程 | 本文统一解码策略、温度、beam、停止条件或运行时 |
| 消融 | 不同研究的支撑面、触觉、显示和交互条件比较 | 本文新方法逐组件消融、跨方法公平因果实验 |
| 统计 | 部分参与者数、百分比与非正式用户反馈 | 跨研究可汇总的效应量、置信区间或显著性排名 |
| 软件 | 列举既有系统;部分被引用工作提供代码 | 把别人的工具当作本综述官方实现或完整复现包 |
本轮在固定全文、Cambridge 页面与作者机构记录中没有找到归属于这篇综述的新模型仓库、数据集发布或独立补充材料;这应表述为“在已检查的一手来源未找到”,而非证明全网不存在。网页没有发布本文模型的虚构运行命令。
作为可复现路线的具体例子,Delanoy 的作者页公开 20K 程序化对象及轮廓/视点资源,区分 C++ 程序形状生成、体素化/数据库生成、定制 Caffe、网络与权重下载。其 Caffe 链接确实指向 jdelanoy/caffe。这说明获取项目时需同时核对预处理与框架分支,不能只安装普通框架就假定输入和坐标变换完全相同。
只读抽查将该分支固定到 0c9f2e500c6f971b2de45d08021c26d55cabc91b,阅读 README、hdf5_data_3dsketch_layer.cpp 与 voxels_data_layer.cpp。前者读取 sketch3D_update,并包含以 8 个基础视点、13 个更新视点组织数据的索引假设;后者从打包图像解出体素标签。固定提交源码证实预处理数据布局属于复现契约。仅看到这些类不能证明所有网络配置均启用它们,也不能据此替代原方法完整训练配置;这些不是本综述的实现缺陷。
本轮未下载大规模数据和模型权重,未执行训练或推理,也未复现任何被引用算法的精度;项目页与源代码的静态核查不能替代运行验证。前面给出的 20,000/50 划分仍按综述转述,其完整训练细节应回到 Delanoy 原论文和实际配置,不作为本综述的实验设置。
来源:固定 PDF 全文;Delanoy 作者项目页与官方下载入口;本综述的出版社条目。
| 项目 | 固定综述的写法 | 本页处理 |
|---|---|---|
| Wiese 的显示环境 | Table 3 写 VR HMD;前文又将其列入投影型早期工作 | 保留原表;原研究明确为五面背投 CAVE,更正单独给出 |
| Wiese 参与者 | 25 students 与专业人数并列,易误读成相加 | 原研究总数 25;专业分项不完整,不推造缺失类别 |
| Wiese 指标方向 | Table 3 把 accuracy、uniformity、shape deviation 都表述为 increased | 解释性改善不等于数值都增大;原研究前两类量中 accuracy 评分与 deviation 实为越低越好 |
| NaturaSketch 年份 | Table 2 标 Olsen et al. 2008;正文与文献列 2011 | 保留原表标注;采用正文/参考文献的 2011 识别该具体论文,2008 条目为另一篇 taxonomy 工作 |
| Barycentric retrieval 年份 | 正文写 Xie et al. 2016;参考文献列 CVPR 2017 | 指明内部矛盾,不建立两个重复条目或伪造版本关系 |
| Arora 参与者经验 | Table 3 说无 immersive sketching 经验;正文说无专业 drawing 经验 | 两种原文措辞分别标注,不假定完全等价;未据此推断技能分层结果 |
| 19 页与期刊页码 | 固定 PDF 内页 1–19;正式期刊页码 370–388 | 同时保留,所有图表定位按固定 PDF 页码 |
Paper reported:原图、原表、文献分支与作者提出的未来方向可直接追溯到固定文件。Source cross-check:Wiese 的设备、参与者与指标方向由独立原研究核实。Author interpretation:学习型方法位于交互成本中间地带、互操作会促进采用、凝视与语音结合可能帮助协作。Our interpretation:总成本分解和本页的通用数学形式。Research extension:后文程序化材质研究建议,均未由这篇综述实验验证。
这种分级很重要:论文是相关工作的二手归纳,而其引用的原论文才是每个实验结果的第一手证据。完整保留表格并不能自动消除转述错误。阅读者引用具体数字时,应优先追到原研究及其任务定义。
来源:固定 PDF 第 6–8、11–12、16–17 页;Wiese 原论文;NaturaSketch 作者机构 PDF提供进一步核查入口,本轮不声称已逐页审计该方法。
以下是本页提出的研究方案,不是作者已经做过的实验。这篇综述最适合用来检查评价是否覆盖完整交互,而不是只在相似输入上测最终像素误差。
应预先定义主要终点、平衡任务顺序、报告样本与排除标准、给出效应量和置信区间。若比较同时改变设备、显示分辨率、追踪延迟与输入维度,不能把效果全部归因于“3D 更自然”。对于失败案例要展示原输入、系统解释与用户实际想要的关系,而不是只展示最成功的结果。
跨领域组织价值高。把矢量化、三维重建、检索、NPR、凝视/语音、触觉、VR/AR 连接到同一设计流程,比单一算法排行榜更能解释工具为何难以进入实际生产。NPR 被放到数据/检索桥梁的位置,具有明确技术作用。
用户劳动没有被隐藏。它指出“第一版很快”和“完成所需模型很快”不同,并把规则学习、后续变形、媒体切换与已有工具投资纳入判断。对需要可控编辑而非单张漂亮图的系统,这个评价视角尤其有用。
研究议程具体。粗糙 junction、共享注意、互换格式、设计历史、同源草图/三维数据等问题可落到数据结构和实验设计,不只是泛泛要求更高准确率。
不是可复现的系统综述。缺少检索协议、纳入标准和覆盖完整性评估;工作坊参与者擅长的领域可能影响选题权重。不同领域的证据深度不平衡,不能从篇幅或被列入表格推断客观重要性。
比较表缺少统一条件。Table 1 混合标准数据、私有数据和视觉检查;Table 2 多为非正式小样本;Table 3 混合设备、任务、经验与指标。它们适合导航文献,不足以支持数值排名或整体技术优劣。未报告某项性能不能视为该方法失败。
转述准确性需谨慎。本轮核查发现显示环境、人数组织与指标方向的问题,也有年份和引用不一致。它们不推翻整体研究议程,却说明不能把汇总表直接当成干净 benchmark 数据。
互操作尚停留在需求。作者呼吁交换格式,但没有定义保留笔画时间、视点、约束、模型编辑历史与不确定性的具体 schema,也未实现完整系统验证收益。所谓“全流程支持”仍是目标。
历史语境不可省。今天阅读它的价值主要在任务分解、人因与评价原则;不能把 2019 年“没有中长期研究”或“3D 深度学习采用少”的观察,直接当成当前仍然成立的断言。
若按综述标准修订,应增加检索/筛选记录、统一的输入输出与数据可用性矩阵、来源级结果核查、任务和评价证据分级,以及一条跨工具端到端案例。若按系统论文推进,则需要一个可执行的跨媒介信息模型与对照用户研究,证明其减少总劳动并保留设计意图。
Research extension:原论文未研究 Substance Designer、shader graph、材质参数反演或 LLM 生成程序。以下是把其交互原则迁移到 PMG 的研究设想,需要重新实现和验证。
材质草图中的线可能代表砖缝、裂纹、纤维方向、边缘磨损或仅是构思标记。应先区分语义角色,再把几何位置、周期、方向场、区域关系转换为约束。不要把每条黑线强制解释成最终渲染中的黑色边。对于歧义,保留多个候选并让用户用少量笔划或语言消歧,比过早锁定一个完整图更可控。
可以从草图检索可编辑材质子图,显示结构与参数可调范围,再生成缺失连接或修改拓扑。评价不只看 top-k 检索命中,更看用户是否可在候选基础上完成目标材质,以及对比从零生成减少多少工作。库里没有对应子图时要承认覆盖不足,不能把近似检索伪装成正确程序。
建议建立持久对象 ID,将草图区域、文本意图、graph node/edge、参数、渲染预览和用户修改事件关联。二维草图进入三维预览、再回到图编辑器时,应该还能定位“这块区域来自哪个子图、为什么选择该参数”。这对应论文的 media breaks 与 PLM 索引思想,但具体 schema 和程序语义由后续系统负责。
这是研究设想的目标函数:\(G\) 为材质程序图,合法集合 \(\mathcal{G}_{\mathrm{valid}}\) 要求节点、端口类型与依赖有效;\(R\) 为给定光照 \(\ell\) 和相机 \(c\) 的渲染,\(I^{\ast}\) 为目标图,\(S\) 为草图,\(U\) 为用户语义约束。\(D\) 衡量外观差异,\(C\) 衡量意图违反,\(E\) 衡量后续编辑负担。各权重、编辑度量和可执行性验证仍需设计,这不是现成算法。
让用户说“只改砖缝宽度,保留砖排列与磨损”时,系统应约束编辑范围并提供可撤销的候选。跨光照和视角验证材料属性,避免通过错误纹理或烘焙光照只拟合单张图。置信较低的解释先展示预览,避免凝视或随手比划直接触发不可逆图编辑。
可比较纯文本、纯草图、草图加少量结构约束、检索加编辑、自由自动生成等条件;同时记录渲染误差、图合法率、参数可编辑性、意图保持、完成时间、撤销次数和跨工具信息丢失。固定模板材质与未见材质家族分开测试,专家与初学者分开报告。若加入凝视/语音采集,应明确同意、保存范围与关闭方式,避免记录压力改变设计行为。
最有潜力的落点不是“再添一种输入模态”,而是降低从模糊构思到可执行、可修改、可追踪材质程序的总成本,并提供可证明的保真交接。
建议阅读顺序:先看 Figure 1 和三张原表掌握地图;再读离线 junction 与隐藏结构、交互成本、NPR;最后读五项未来方向与 reviewer。若要开发实际系统,应按具体分支回到原论文代码与评价协议,不能从这篇综述直接复现某个模型。
| 要解决的问题 | 固定论文参考文献中的起点 | 阅读位置 |
|---|---|---|
| 工程图矢量化与编辑成本 | Ramel 1998;Dori and Wenyin 1999;Song 2002;Hilaire and Tombre 2006;Keysers and Breuel 2006 | Table 1 与参考文献第 15–17 页 |
| 自由手绘 junction 和拓扑 | Noris 2013;Pham 2014;Chen 2015;Favreau 2016;Bessmeltsev and Solomon 2019 | 第 3–6 页 |
| 粗糙草图清理 | Simo-Serra 2016;Li 2017;Bonnici 2018 | 第 4、14 页 |
| 单视图与隐藏结构 | Ros and Thomas 2002;Lipson and Shpitalni 2007;Cao 2008;Kyratzi and Sapidis 2009;Liu 2011;Lun 2017 | 第 4–6 页 |
| 交互式曲面与约束 | Teddy 1999;DigitalClay 2000;Fibermesh 2007;NaturaSketch 2011;True2Form 2014;Delanoy 2018;Li 2018 | 第 6–7 页与 Table 2 |
| 草图与三维检索 | Chen 2003;Shilane 2004;Eitz 2012;Wang 2015;Zhu 2016;Xie 2017;Dai 2018 | 第 8 页 |
| 线描渲染与知觉 | DeCarlo 2003;Judd 2007;Kang 2007;Cole 2008/2009;Lu 2012;RenderNet 2018 | 第 8–9 页 |
| 沉浸绘图与支撑 | Keefe 2001/2007;Israel 2009;Wiese 2010;Arora 2017;Barrera Machuca 2017;Wacker 2018 | 第 10–12 页与 Table 3 |
| 协作 凝视与信息历史 | Çığ and Sezgin 2015;D’Angelo and Gergle 2018;Schlösser 2018;Sudarsan 2005;Kiritsis 2011 | 第 10、13–14 页 |
覆盖声明:固定 PDF 的全部正文、三张表、六张图、参考文献与作者信息均已阅读。作者资源和原研究用于定位核查,不声称逐篇复现全部参考文献。未找到这篇综述的独立附录,不把其他论文补充材料并入本综述。
文件验收:单文件 HTML 内嵌六张原图和 MathJax 3;原始图片分辨率依照固定 PDF 保留,不通过放大伪称更清晰。已做源代码、数学分隔符、表格结构、图片解码、链接目标和原笔记前缀静态检查;真实浏览器中的公式渲染、屏幕布局与加载验收按用户要求延后。
归档边界:本轮只生成云端 HTML、Markdown 增量、原文前缀不变的合并候选和归档计划。保留既有 PDF 与分类;第一作者兼通讯作者 Alexandra Bonnici 的现有 People 链接应复用。正式 vault 合并、人物/索引更新与网站发布均未执行。