输入
人物图、目标衣服图、去衣服人物图、agnostic mask、DensePose。不是单靠两张原始 RGB 就免预处理。
Latent 空间的服装对应学习|Zero Cross-Attention、ATV 与公开实现审计
Jeongho Kim · Gyojung Gu · Minho Park · Sunghyun Park · Jaegul Choo
StableVITON 把衣服到人体的对应关系学习放进预训练扩散模型的 latent 空间:人物位置提供 Query,衣服空间特征提供 Key/Value,由新增 zero cross-attention blocks 完成软匹配。它借用了 ControlNet 的可训练编码分支和零初始化思想,但核心注入操作不是把未对齐衣服特征逐像素直接相加。
人物图、目标衣服图、去衣服人物图、agnostic mask、DensePose。不是单靠两张原始 RGB 就免预处理。
保持人物身份、姿态与背景的虚拟试穿图。输出是二维合成,不是布料物理仿真、尺码测量或三维服装重建。
预训练 PBE/SD 主干提供生成能力,衣服空间编码分支和九个 cross-attention 插入块提供细节,增强与 ATV 约束帮助对应学习。
对原笔记的追加澄清:Q 与 K/V 来自不同特征流,因此该层属于 cross-attention,不因衣服与人物都属于图像就变成 self-attention。新增块内部确实先有 self-attention,再有 cross-attention;不能把“训练新增块中的 self-attention”写成“只训练原主 U-Net decoder 的 self-attention”。原文说不更新原始 blocks,代码默认也没有把原 decoder 加入 optimizer。
结论需分版本:固定 v1 无 RePaint 时不在所有指标上最优;RePaint 变体大幅改善未改动区域的重建。当前公开 inference.py 的 --repaint 是最终 RGB 蒙版合成,与正文描述的每步采样替换并不相同。ATV 的实现、数据增强开关也有可定位的差异,后文完整列出。
主依据:固定 arXiv v1,17 页、官方项目页、官方代码。
| 字段 | 核实事实 | 原记录处理 |
|---|---|---|
| 论文 | StableVITON: Learning Semantic Correspondence with Latent Diffusion Model for Virtual Try-On | 固定使用 2312.01725v1 |
| 版本 | 2023-12-04 预印本,17 页;官方仓库标 CVPR 2024 | 不把原 2023 arXiv 记录悄悄改成另一版本 |
| 作者与机构 | Jeongho Kim、Gyojung Gu、Minho Park、Sunghyun Park、Jaegul Choo;KAIST | 原作者拼写以 PDF 为准;README BibTeX 的 Guojung 与 PDF Gyojung 不一致 |
| 第一作者 | Jeongho Kim | 未发现共同一作标记 |
| 通讯作者 | Sunghyun Park,固定 PDF 第 9 页致谢明确说明,项目页也确认 | 原 note 的 Jaegul Choo/unverified 为旧候选,追加建议改为 Sunghyun Park/verified |
| 页数 | 正文与参考文献第 1–10 页;附录 A–E 及 Fig. 11–16 第 11–17 页 | 17 页为合订总页数,不是正文另加 17 页补充材料 |
| 公开实现 | 读取 2026-09-30 的 master 源文件,逐文件保存 SHA-256 | GitHub API 返回 rate limit,未核实 commit,不虚构固定 revision |
原 note 中关于 ReferenceNet、ControlNet 的疑问、两张 PDF 裁切对照、BibTeX、作者链接、原有标签与全部 PDF++ anchors 均原样保留。本页是追加精读,不把原有思考当成可删除错误。CVF 页面本轮返回 403,CVPR 2024 身份由官方仓库核实,未声称逐字比对 camera-ready。
传统 try-on 往往先估计衣服到人物的 flow/warp,再让生成器融合。错误 warp 会把图案拉错、在身体与衣服交界造成重叠;小型 GAN 生成器还难以泛化到复杂背景。另一路只把衣服压成 CLIP 语义向量,容易保留“是什么衣服”却丢失字母、纹理和局部设计。
作者的假设是:让预训练扩散模型的身体先验直接参与对应学习,不在 RGB 空间提前固化一个错误 warp。新增衣服分支提供多尺度空间 token,cross-attention 每个目标位置可以从衣服任意位置取信息。这里的“warping”是特征加权聚合,不是输出一个具有显式拓扑、可逆性或物理含义的几何变换。
| 符号/张量 | 含义 | 512×384 设置下 |
|---|---|---|
| \(x\) | 人物 RGB;训练时穿着与商品图对应的衣服 | 3×512×384 |
| \(x_c\) | 目标商品衣服图;推理可换成另一件 | 3×512×384 |
| \(x_a\) | clothing-agnostic 人物图,去除待替换衣服信息 | RGB,经 VAE 编码成 4×64×48 |
| \(m_a\) | agnostic 区域的 mask;须确认黑白语义 | 缩放成 1×64×48,不经 VAE |
| \(x_p\) | DensePose 条件图 | 经 VAE 编码成 4×64×48 |
| \(z_t\) | 人物 latent 加噪结果 | 4×64×48 |
| \(\tau_{\phi}(x_c)\) | CLIP image embedding,提供全局衣服语义 | 代码 pooled 1024 维,再投影到 768 |
| \(c_i\) | 衣服空间编码分支中间特征 | 16×12、32×24、64×48 各三组用于注入 |
| \(A,F,M\) | 跨注意力、其坐标重心场、训练衣服区域 mask | ATV 是训练正则,推理不需要 ground-truth 衣服 mask |
“端到端、不用独立 warping network”不等于无需 segmentation、agnostic 处理或 DensePose。训练数据的商品与穿着照片配对监督仍然不可缺少;本文没有通过纯文本或无配对图像学会所有穿搭关系。

Fig. 2 把衣服区域的注意力叠到生成图,说明目标人体位置可以和源衣服语义区域关联;这是网络内部响应可视化,不是有 ground truth 对应标注的精度评价。
附录 A 明确采用 SD v1.4 的 autoencoder 与去噪 U-Net 架构,主 U-Net 初始化自 Paint-by-Example。PBE 已提供图像 exemplar 条件,因此不是简单在任意 SD checkpoint 上多加四个通道就等价。官方发布专用 13 通道初始化 checkpoint 及单独在 VITON-HD 微调的 VAE。
\[\zeta_t=\operatorname{concat} [z_t,\mathcal E(x_a),\operatorname{Resize}(m_a),\mathcal E(x_p)] \in\mathbb R^{13\times H/8\times W/8}.\]通道数是 4+4+1+4=13。原 note 的“ConvIn 使用 Zero Init”需要细化:相对 PBE 的 9 通道增加 DensePose 的 4 通道,README 说 add zero conv;发布代码要求下载已经改造过的 checkpoint,并未公开一个从原 PBE 权重完整扩展的脚本供本轮逐值确认。不能推断把全部原有输入卷积清零。

主 U-Net encoder/decoder 各 12 blocks、各 3 次下/上采样。512×384 图像对应 64×48 latent,再得到 32×24、16×12、8×6。每尺度三份特征,跳过最小 8×6 的注入,剩余九个 zero cross-attention blocks。CLIP 全局 context 与空间 K/V 是两组不同条件,不能混为一张 attention map。
这里省略 LayerNorm、残差和 FFN 以突出数据来源;原 Fig. 3(b) 给出 self-attention→cross-attention→FFN→零初始化输出层。\(Z_i\) 初始为零,所以条件支路初期不扰动预训练主流。零输出层先学到非零权重后,梯度再有效进入前面的新增网络;这不同于全部 Q/K/V 同时清零。
当前实现使用 CustomSpatialTransformer 自身的零输出投影,加上外部 warp_zero_convs 的 1×1 zero conv,再残差加回人物特征。1×1 卷积是逐位置通道线性映射;关键不是其名字,而是外部相加之前已完成了跨空间匹配。即使代码模块名带 ControlNet,也不能因此认定没有 cross-attention。
| 模块 | 论文角色 | 当前默认代码的更新路径 |
|---|---|---|
| 原主 U-Net encoder/middle | 预训练先验,冻结 | forward 显式 no_grad;输入卷积虽被 optimizer 收录,也不会从这条路径得到梯度 |
| 原主 U-Net decoder | 原始 blocks 不更新 | 默认 sd_locked=True,不进 optimizer;需保留到新增模块的反传路径,不能把整个 decoder 包成 no_grad |
| 空间编码分支 | 可训练的预训练 encoder copy | control_model.parameters() 加入 optimizer |
| 九个新增块 | 自注意力+衣服跨注意力+FFN+零层 | warp_flow_blks 与 warp_zero_convs 均加入 optimizer |
| VAE | 先单独微调 decoder,再固定 | 加载 VAE checkpoint,整体冻结用于 try-on 训练 |
| CLIP vision backbone | 预训练衣服语义 | 冻结;mapper/final_ln 可 requires_grad,但默认 cond_stage_trainable=False 时不加入 optimizer |
| 全局投影与空条件 | PBE 条件接口 | proj_out 与 learnable_vector 加入 optimizer |
代码级边界:requires_grad、optimizer 参数列表、no_grad 三者必须联合检查。仅看网络框图的颜色,或只看“参数在 optimizer 中”,都可能误判实际训练范围。原 note 的总结作为原始思考保留,这里给出更精确的后续核查。
固定 PDF §4.1–4.2、附录 A;架构代码 · optimizer 与条件输入。
Eq. 2 是通用文本条件 LDM 背景;StableVITON 实际将文本条件替换成衣服图像语义,并增加空间衣服输入和人物条件:
\[\mathcal L_{\mathrm{LDM}}= \mathbb E_{\zeta,x_c,\mathcal E(x_c),\epsilon,t} \left\|\epsilon-\epsilon_{\theta} \left(\zeta_t,t,\tau_{\phi}(x_c),\mathcal E(x_c)\right)\right\|_2^2.\tag{3}\]训练目标仍是噪声预测,不是直接监督 attention correspondence,也不要求真实人体与商品图之间的 dense flow ground truth。配对训练中的人物照片充当目标;agnostic 与 DensePose 从人物生成。推理换装是 unpaired 条件,没有该换装结果的像素 ground truth。
商品图与人物图在训练集中布局相似,网络可能混合多个不对应的衣服区域,仅凭“附近大致是什么颜色”就降低去噪损失。独立平移/缩放打破位置共现,迫使人物 query 寻找真正相关的衣服区域。共同颜色增强则保持目标与衣服颜色一致,避免把颜色扰动误当目标变化。

多头取平均后,将注意力重塑为 \(A\in\mathbb R^{H_q\times W_q\times h_k\times w_k}\),源衣服坐标为 \(G\in[-1,1]^{h_k\times w_k\times2}\)。固定原文写:
\[F_{ijn}=\frac1{h_kw_k} \sum_{k=1}^{h_k}\sum_{l=1}^{w_k} \left(A_{ijkl}G_{kln}\right).\tag{4 原式}\]归一化疑点:若 A 是标准 key-softmax,每个 query 上权重已经和为 1,通常的重心应为求和而不再除以 key 数。原式额外除数会让坐标幅度收缩。当前代码确实用求和、不除 \(h_kw_k\),并使用 0…h−1 / 0…w−1 的像素坐标而非 [-1,1]。两者相差的不只是写法,TV 的量纲与有效正则强度都会改变。
M 为训练时真实衣服区域 mask。直觉是相邻目标人体位置应映射到连续的衣服位置,减少不规则对应;作者观察到更清晰的 attention 与图案。Author Claim:文章把它描述为中心更均匀分布、注意力更尖锐。Our Interpretation:TV 直接鼓励局部平滑,并没有显式保证均匀覆盖、单峰或低熵。
反例很简单:所有 query 都关注同一个 key,重心处处相同,TV 为零,但语义对应完全塌缩;一个单峰 attention 与左右对称双峰也可拥有相同重心,因而重心 TV 无法区分。它需要与去噪目标、增强、预训练先验共同工作。不能从 Eq. 5 单独推导“保证 sharp attention”。
代码只对两端都在有效区域的邻边求差,而原式 \(\nabla(FM)\) 会在 mask 边界把内外差纳入,因此并不逐字等同。公开 get_tvloss 分母没有 epsilon,空区域或没有有效邻边时存在除零风险。mask 来自 gt_cloth_warped_mask 的反相再反相路径,必须跟踪实际布尔语义,不可只从变量名推断。
ATV 只有 xformers 分支实现非零损失;触发条件为 cross-attention、key tokens 介于 700 和 3000、use_loss=True。512×384 设置中 32×24=768 满足,16×12=192 与 64×48=3072 不满足;warp 构造还用 idx%3==1 选择每组三块中的一块。故默认并非九个 attention 图都加 ATV。1024×768 的触发尺度会随 token 数变化,不能机械沿用“固定 32 分辨率”的说法。
普通 softmax fallback 返回 attn_loss=0,并且自定义调用额外 keyword 的兼容性需要检查;官方指定 xformers 环境不是可随意去掉而仍保证同一训练目标的优化开关。
固定 PDF 第 3–5 页 Eq. 1–6;attention.py 的 get_tvloss 与 MemoryEfficientCrossAttention。
正文分别在 VITON-HD 和 DressCode upper-body 上训练模型,使用相同数据域或跨数据域测试。VITON-HD 官方说明共有 11,647 训练对、2,032 测试对,原始 1024×768,主要为正面女性与上装商品图;它不代表所有体型、性别呈现、视角和衣物类别。DressCode 本文只用上装子集,不能把数据集全部多类别样本数量当成 StableVITON 训练量;固定论文未逐项报告该子集精确 train/test 数量,本次不补猜。
SHHQ-1.0 使用前 2,032 张图,按 VITON-HD 流程构造 agnostic、mask 和 DensePose;是跨域测试,不用于训练该模型。Web-crawled 图像只有可视化,未报告系统采集规模和量化协议。公开 dataset.py 主类为 VITONHDDataset,默认 paired 训练会将衣服文件名设成人物同名,unpaired 评估才读取 pairs 文件第二列。
README 列 cloth_mask 目录,而 dataset.py 实际读取 cloth-mask,运行前须按代码核对。训练 ATV 还需 gt_cloth_warped_mask;测试不用真实该 mask,创建零占位。所谓“无独立 warp”不能误读成训练/前处理没有人体分割信息。
| 阶段 | 训练对象 | 优化设置 | 用途 |
|---|---|---|---|
| 基础 try-on | 可训练空间分支与新增模块 | AdamW,固定 lr=10⁻⁴,batch 32,360k iterations | 学习配对重建与语义对应 |
| ATV finetune | 在基础权重上继续训练 | 同 lr/batch,36k iterations,λ=0.001 | 正则对应重心场,改善局部细节 |
| VAE decoder 微调 | 分别在 VITON-HD/DressCode 上 | AdamW,lr=5×10⁻⁵,batch 32,10k iterations | 缓解脸部等细节的 autoencoder 重建误差;与主训练分开 |
| 高分辨率继续训练 | 由已有模型渐进到 1024×768 | 额外 85k iterations,其余训练设置同基础说明 | 更清晰脸部和衣物细节,仅展示定性结果 |
| 报告成本 | 四张 NVIDIA A100 | 约 100 小时 | 作者报告;未给详细分阶段显存/耗时拆分 |
完整扩散时间步为 1,000,配置 linear_start=0.00085、linear_end=0.012,latent scale=0.18215。U-Net 基础宽度 320、channel multipliers [1,2,4,4]、每级两 ResBlocks、8 attention heads、spatial transformer depth=1、context=768。VAE 基础宽度 128、四个 latent 通道、multipliers [1,2,4,4]。固定论文未给整体/可训练参数数目,不伪造统计。
当前发布代码风险:README 命令传 shiftscale3,但 dataset.py 仅在列表含 shiftscale 时创建位移/缩放变换,shiftscale2/3 没有实现分支。照抄命令时仍有 resize/hflip 与颜色增强,但所描述的独立位移缩放可能未启用。即使改为 shiftscale,人物裁变后 gt_cloth_warped_mask 被从旧 transformed 字典取回,而不是 transformed_image,存在标签几何不同步风险;mask 还作为 image target 插值,可能形成软边界。这些是静态审计,未执行训练证明影响大小。
train.py 默认 max_epochs=1000 而非 max_steps=360k/36k,README ATV 命令也未明确限制阶段步数。复现实验应按 global_step 设置停止条件并保存实际样本曝光量,不能把命令跑到默认 epoch 终点后声称精确复现。默认精度 16、DDP、accum_iter=1,总 batch 32 分给 GPU。论文未说明 beta、weight decay、完整随机种子协议,代码采用 AdamW 默认未覆盖项。
当前 inference.py 从人物真实 latent 的 q_sample(t=999) 初始化,而不是直接标准高斯;虽然残余信号很小,它并非严格纯噪声。它构造 unconditional_conditioning,却没有传 guidance scale,采样器默认 scale=1,因此默认不做额外 CFG 放大。训练 logging/validation 中有 scale=5 路径,不能据此把发布推理写成 CFG=5。训练以 0.2 概率用 learnable global vector 替代 CLIP 条件,但空间衣服条件仍然在,所谓 unconditional 不是完全无衣服条件。
固定 PDF 附录 A、D,第 11 页;VITON-HD 官方数据说明 · 数据增强 · 推理入口。
SSIM↑、LPIPS↓ 用 paired reconstruction;FID↓、KID↓ 用 unpaired 集合分布。两类问题不同:前者衡量与原图一致,后者衡量生成集合与真实集合的特征分布差异,并不直接证明目标商品身份完全保留。原表 KID 的展示倍率未在表头明确,本页原值保留,不自行换算。缺失项用 “-”,不当成零。
| Train / Test | VITON-HD / VITON-HD | D.C. Upper / D.C. Upper | |||||||
|---|---|---|---|---|---|---|---|---|---|
| Method | SSIM | LPIPS | FID | KID | SSIM | LPIPS | FID | KID | |
| VITON-HD [3] | 0.862 | 0.117 | 12.117 | 3.23 | - | - | - | - | |
| HR-VITON [15] | 0.878 | 0.1045 | 11.265 | 2.73 | 0.936 | 0.0652 | 13.820 | 2.71 | |
| LADI-VTON [20] | 0.864 | 0.0964 | 9.480 | 1.99 | 0.915 | 0.0634 | 14.262 | 3.33 | |
| Paint-by-Example [33] | 0.802 | 0.1428 | 11.939 | 3.85 | 0.897 | 0.0775 | 15.332 | 4.64 | |
| DCI-VTON [8] | 0.880 | 0.0804 | 8.754 | 1.10 | 0.937 | 0.0421 | 11.920 | 1.89 | |
| GP-VTON [32] | 0.884 | 0.0814 | 9.072 | 0.88 | 0.769 | 0.2679 | 20.110 | 8.17 | |
| Ours | 0.852 | 0.0842 | 8.698 | 0.88 | 0.911 | 0.0500 | 11.266 | 0.72 | |
| Ours (RePaint [18]) | 0.888 | 0.0732 | 8.233 | 0.49 | 0.937 | 0.0388 | 9.940 | 0.12 | |
原 Table 1 来源;粗体/下划线按源表保留。
VITON-HD 上无 RePaint 的 FID 8.698,相比 DCI-VTON 8.754 只下降 0.056,约 0.64%;KID 0.88 与 GP-VTON 相同。其 SSIM=0.852 低于 GP-VTON 0.884,LPIPS=0.0842 也差于 DCI-VTON 0.0804。不能复述为“不加 RePaint 也全面超过”。DressCode 无 RePaint 的 SSIM 0.911、LPIPS 0.0500,也分别不及 DCI-VTON 0.937/0.0421。
加入 RePaint 后 VITON-HD 达 0.888/0.0732/8.233/0.49;DressCode 达 0.937/0.0388/9.940/0.12,其中 SSIM 0.937 与 DCI-VTON 相同。改善来自对非换装区域的保留与生成共同作用,不能全部归因于服装对应更精确。
| Train / Test | VITON-HD / D.C. Upper | D.C. Upper / VITON-HD | VITON-HD / SHHQ-1.0 | ||||||||||
| Method | SSIM | LPIPS | FID | KID | SSIM | LPIPS | FID | KID | FID | KID | |||
| VITON-HD [3] | 0.853 | 0.1874 | 44.257 | 28.82 | - | - | - | - | 71.149 | 52.01 | |||
| HR-VITON [15] | 0.909 | 0.1077 | 19.970 | 7.35 | 0.811 | 0.2278 | 45.923 | 36.69 | 52.732 | 31.22 | |||
| LADI-VTON [20] | 0.901 | 0.1009 | 16.336 | 5.36 | 0.801 | 0.2429 | 31.790 | 23.02 | 24.904 | 6.07 | |||
| Paint-by-Example [33] | 0.889 | 0.0867 | 16.398 | 4.78 | 0.784 | 0.1814 | 15.625 | 7.52 | 26.274 | 9.830 | |||
| DCI-VTON [8] | 0.903 | 0.1217 | 23.076 | 12.03 | 0.825 | 0.1870 | 16.670 | 6.40 | 24.850 | 6.68 | |||
| DCI-VTON (Aug.) [8] | 0.898 | 0.1240 | 18.809 | 8.02 | - | - | - | - | 24.368 | 6.11 | |||
| GP-VTON [32] | 0.724 | 0.3846 | 65.711 | 66.01 | 0.804 | 0.2621 | 52.351 | 48.68 | - | - | |||
| Ours | 0.911 | 0.0603 | 12.581 | 1.70 | 0.817 | 0.1308 | 10.104 | 1.72 | 23.531 | 5.68 | |||
| Ours (RePaint [18]) | 0.938 | 0.0470 | 10.480 | 0.41 | 0.855 | 0.1173 | 9.714 | 1.35 | 21.077 | 5.10 | |||
原 Table 2 来源;粗体/下划线按源表保留。
VITON-HD→DressCode,无 RePaint 的 FID 12.581,比最好的基线 LADI-VTON 16.336 低 3.755,约 23.0%;RePaint 10.480 则约低 35.8%。DressCode→VITON-HD 的 LPIPS 从最佳基线 PBE 0.1814 降至 0.1308,约 27.9%,但无 RePaint SSIM 0.817 仍低于 DCI-VTON 0.825。SHHQ 无 RePaint FID 23.531,相对 DCI-VTON(Aug.) 24.368 约低 3.44%,优势存在但不是数量级差距。
跨域主要支持利用预训练生成先验处理不同背景与人物分布,而不是证明对任意姿态、遮挡、服装类别都泛化。GP-VTON 在 SHHQ 缺结果,原表也没有置信区间、重复运行方差或显著性检验。
| Train / Test on VITON-HD | SSIM | LPIPS | FID | KID |
|---|---|---|---|---|
| ControlNet + Aug. | 0.832 | 0.1157 | 9.81 | 1.81 |
| ControlNet-W + Aug. | 0.822 | 0.1124 | 9.66 | 1.57 |
| Zero Cross-Attention Block + Aug. | 0.850 | 0.0851 | 8.74 | 0.91 |
原 Table 3 来源;粗体/下划线按源表保留。
ControlNet 与 ControlNet-W 均加同样增强。预 warp 的 ControlNet-W 对 FID/KID 略有改善,但 SSIM 从 0.832 降到 0.822,不是所有指标上升;新增 cross-attention 达 0.850/0.0851/8.74/0.91,支持软对应优于直接相加的设计。对照仍包含模型结构和特征路径差异,不是只对某一单层替换的完全同构因果实验。
| Aug. | Attention TV Loss | SSIM | LPIPS | FID | FID |
|---|---|---|---|---|---|
| ✗ | ✗ | 0.847 | 0.0969 | 9.35 | 1.33 |
| ✓ | ✗ | 0.850 | 0.0851 | 8.744 | 0.91 |
| ✓ | ✓ | 0.852 | 0.042 | 8.698 | 0.88 |
原 Table 4 来源;粗体/下划线按源表保留。
固定源异常一:最后两列表头都印为 FID;根据其他表和数值量级,末列很可能意指 KID,但本页保留原表头并在此解释。固定源异常二:最后一行 LPIPS=0.042,而 Table 1 同一 Ours 行为 0.0842。未找到作者对该差异的明确勘误,不能悄悄改数,也不能据 0.042 宣称 ATV 将 LPIPS 减半。
能稳妥计算的是增强使 FID 9.35→8.744,ATV 再到 8.698(仅再降 0.046,约 0.53%);图案细节改善需要结合 Fig. 10。无“只加 ATV、不加增强”一行,也没有置信区间,因此两因素完整独立效应与交互强度尚未测清。
所有原数来自固定 PDF 第 6–8 页,与同版原表 HTML逐行核对。

与六种 baseline 比较衣服文字、边界、手臂和遮挡。作者特别说明 LOVE 图案的 L 被手臂/衣服遮挡时,应自然省略而非强行完整复制;这提醒我们“更多文字可见”不总是更准确。本文没有 OCR 指标量化字符保留,图像是定性证据。


Fig. 6 为 DressCode,Fig. 7 为 SHHQ,后者额外列 DCI-VTON(Aug.)。GAN 基线较难保持背景与身体,扩散基线通常较自然却可能丢失服装细节。给 DCI-VTON 加增强仍无法全面修复独立 warp 的错位,不等于证明所有 flow 方法必然失败。
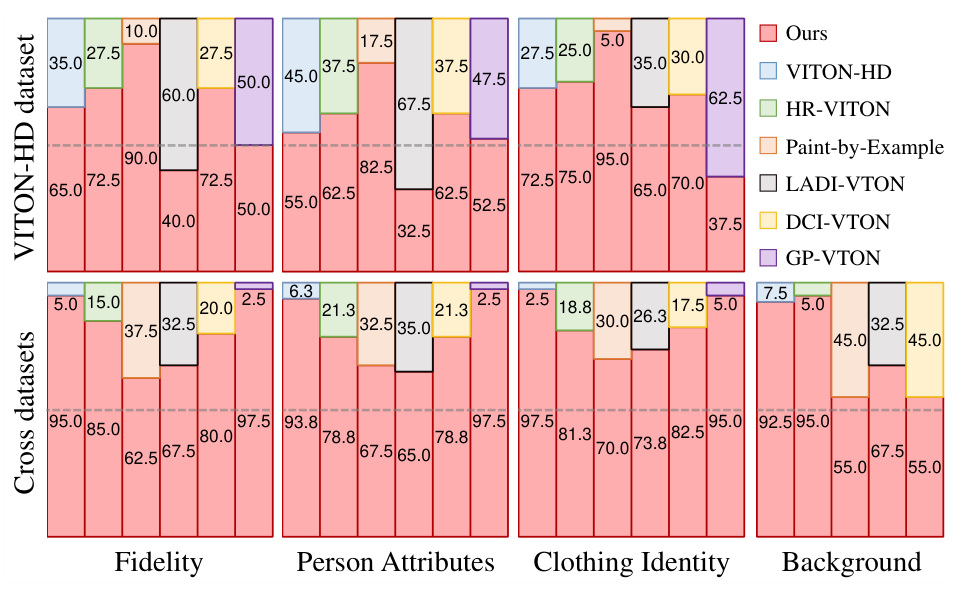
每次展示一个 baseline 输出与 StableVITON 输出,让参与者按 fidelity、person attributes、clothing identity 二选一;跨域再问 background quality。原文未充分披露题目总数、分配方式、随机左右顺序、参与者背景、置信区间。本页保留完整图,并按横坐标顺序整理“偏好 Ours”的百分比,另一方为原图所示互补值,存在四舍五入到一位小数的情况。
| Ours 获选率(%) | VITON-HD | HR-VITON | Paint-by-Example | LADI-VTON | DCI-VTON | GP-VTON |
|---|---|---|---|---|---|---|
| 同域 Fidelity | 65 | 72.5 | 90 | 40 | 72.5 | 50 |
| 同域 Person attributes | 55 | 62.5 | 82.5 | 32.5 | 62.5 | 52.5 |
| 同域 Clothing identity | 72.5 | 75 | 95 | 65 | 70 | 37.5 |
| 跨域 Fidelity | 95 | 85 | 62.5 | 67.5 | 80 | 97.5 |
| 跨域 Person attributes | 93.8 | 78.8 | 67.5 | 65 | 78.8 | 97.5 |
| 跨域 Clothing identity | 97.5 | 81.3 | 70 | 73.8 | 82.5 | 95 |
| 跨域 Background | 92.5 | 95 | 55 | 67.5 | 55 | - |
LADI-VTON 在同域 fidelity 获 60%、person attributes 获 67.5%,明显高于 Ours;GP-VTON 在同域 clothing identity 获 62.5%,Ours 只有 37.5%。所以“用户研究所有项都更好”不成立。跨域 Ours 多数项目领先,但背景相对 PBE/DCI 的 55% 只是较小偏好;原图没有 GP-VTON 的跨域 background 柱,不补造。参与者喜好也不能替代身份隐私、体型公平性或尺码真实度评价。


Fig. 9 区分衣服原图与预 warp 两种 ControlNet 输入,说明直接位置相加对细微错位仍敏感。Fig. 10 逐步加入增强和 ATV,展示 PUMA 字母与线条变化;应与 Table 3/4 一起读,不能把图中更清晰直接转化成未测量的数量收益。


Fig. 11 为 DressCode 训练→VITON-HD。Fig. 12 明确展示遮挡人物的物体和手镯等配饰未保留:agnostic mask 把这些信息抹掉后,模型只拿到衣服条件,无法凭空恢复原物。作者把这一点留作未来工作,不是通过现有 RePaint 已完全解决。


按顺序为 VITON-HD、DressCode、SHHQ-1.0、网络图像,全部由 VITON-HD 高分辨率模型生成。高分辨率由继续训练 85k 获得,不能归因于仅在推理时放大分辨率;这些网格没有对应 1024 指标表或等计算量基线。图像细节更清楚仍可能改变眼睛、细小饰物或商品局部文字。
| 关键点 | 论文/概念 | 公开 master 静态证据 | 影响 |
|---|---|---|---|
| 空间编码 | 以衣服 latent 为输入的 trainable encoder | 13 通道人物 noisy condition 先卷积,再加入衣服 cond_first_block;还有 timestep 与 CLIP context | 不能简化成离线纯衣服 ReferenceNet 缓存 |
| 原始主干 | 原 blocks 冻结 | encoder/middle no_grad;decoder 默认不进 optimizer | 新增块内 SA 与原 decoder SA 必须区分 |
| 输入卷积 | 扩展到 13 通道,零初始化新增部分 | 从专用 PBE_pose checkpoint 加载;原 encoder no_grad 令该卷积实际没有反传 | 不能仅凭 optimizer 列表判断其被训练 |
| ATV 坐标 | [-1,1] 坐标、额外除 key 数 | 像素坐标求加权和,不额外除数 | λ 的数值不可跨实现直接复用 |
| ATV 区域 | 对 FM 的梯度 | 有效区域内部邻边加权差与归一化 | 边界行为不同;空 mask 可除零 |
| ATV 层选择 | 正文未逐层给触发规则 | 700<key tokens<3000 且 idx%3==1 | 默认不是所有尺度同时加同一个 loss |
| 增强开关 | 独立 shift/scale | README shiftscale3 与 dataset 分支 shiftscale 不匹配 | 照抄命令可能缺最关键空间增强 |
| mask 同步 | GT 衣服区域应与人物变换一致 | 裁变后错误取旧 transformed 字典字段 | 启用空间变换时需检查监督错位 |
| RePaint | 逐步对已知区域重新加噪替换 | inference.py 没传 sampler mask/x0,--repaint 只在最终 RGB 粘回已知区域 | 不能用该开关直接声称重现论文 RePaint 路径 |
| 起始噪声 | 常规 diffusion 推理描述 | 对人物 latent 用 q_sample(t=999) | 仍含极小原图残留,需公平比较同一初始化 |
| CFG | 附录未详列系数 | 推理默认1;validation/logging5;训练全局条件drop20% | 这些不是同一个设置 |
| 训练步数 | 360k+36k | 默认 max_epochs=1000,无对应 max_steps 限制 | 需手动按论文设置阶段终止 |
| 运行环境 | 4×A100 | README Python3.10、torch2.0.0/cu117、PL1.5、xformers0.0.19 等 | 版本兼容与依赖许可须独立验证,未执行安装 |
论文的思路可写为每步把已知区域的前向加噪 latent 拼回当前采样状态:
\[z_t\leftarrow m_{\mathrm{known}}\odot q_t(\mathcal E(x_a)) +(1-m_{\mathrm{known}})\odot z_t^{\mathrm{generated}}.\]公开默认路径实际在全部去噪后做:
\[I_{\mathrm{out}}=m_{\mathrm{known}}\odot I_{\mathrm{person}} +(1-m_{\mathrm{known}})\odot I_{\mathrm{generated}}.\]两者都可帮助保护未编辑区域,但边界融合、生成过程约束和重建指标影响不同。plms_hacked.py 内确有可选逐步 mask 分支,却需要 mask、x0、first_n_repaint 等参数,入口未传,默认不触发。不能看到函数存在就认定实际调用路径已经使用。
本轮是只读代码审计,没有下载权重、训练、试穿真实人物、上传个人照片或执行第三方脚本。API 限流不影响已获取关键文件;缺少可验证 commit 的限制已记录,不把当前 master 称为作者原始实验的逐字快照。
方法把“生成”和“对齐”放到同一 latent 推理过程,避免独立 RGB warp 的早期错误锁死;空间特征路径补充 CLIP pooled token 的细节瓶颈。论文同时报告跨数据域结果、ControlNet 对照、组件消融和失败案例,覆盖范围比只展示同域试穿更有解释力。零初始化保留预训练行为,是将新结构接到大模型的稳健工程原则。
ATV 的数学直觉过强:平滑重心不能保证 sharp attention,也不能保证双射、面积保持或拓扑一致。需要直接测注意力熵、多峰程度、对应误差与纹理频率保持,而非只凭热图。Table 4 排版与数值矛盾、发布训练命令与实现开关不一致,都限制精确复现。
背景保留影响 SSIM/LPIPS/FID,RePaint 变体的收益不能全部计作对齐能力。跨域无 RePaint 的效果确实较强,但少数关键指标只小幅改善,且没有统计显著性。用户研究有明确输给 LADI/GP 的项目,选择性只引用“多数领先”会遗漏真实 trade-off。
系统依赖预处理质量,遮挡物被 mask 擦掉后可能不可恢复;高分辨率有额外训练预算。数据主要来自特定拍摄与服装类别,未检验复杂穿层、极端姿态、尺码真实感、身体多样性。生成“像穿上”与预测“真的合身”是不同任务。
把人物目标位置换成待编辑表面的 UV/渲染特征,把衣服 K/V 换成 exemplar 材质 patch,可研究在固定形状上保持纹理身份。必须额外处理 UV 接缝、各向异性、尺度与周期性;二维图像对应不是物理材质参数。对照应包括全局 CLIP 条件、直接特征相加、显式 flow 和 cross-attention,并用新形状/光照评测。
ATV 的塌缩反例提示可以加入 attention entropy、局部协方差、循环一致性和覆盖约束,但这些目标会相互冲突:低熵有利清晰复制,高覆盖可能不适用于遮挡,cycle consistency 也不能强迫不可见区域双射。先在有真实对应的合成纹理上分别验证,再联合训练。
\[\mathcal L_{\mathrm{ext}}= \mathcal L_{\mathrm{denoise}}+ \lambda_{\mathrm{smooth}}\mathcal L_{\mathrm{centerTV}}+ \lambda_{\mathrm{cycle}}\mathcal L_{\mathrm{cycle}}+ \lambda_{\mathrm{phys}}\mathcal L_{\mathrm{physical}}.\]此式为研究计划,不是论文实验。对所有项需有独立消融,不能把加入更多约束自动当作提高质量。
可训练编码分支可提取 exemplar 的局部结构,再指导程序材质图的节点选择与参数优化。但 StableVITON 本身不生成 DAG、节点 token、Substance 程序或可执行 graph。真正 PMG 系统仍需 typed ports、无环性、节点合法性、编译执行与 renderer feedback;连续 attention 无法替代离散拓扑有效性。
借鉴 RePaint 的问题,材质编辑应分别测受保护通道/区域是否保持、目标纹理是否正确,以及新光照下是否出现烘焙阴影。避免通过最终 RGB 粘贴得到好指标,却失去可重光照的 albedo/roughness/normal。对“只修改粗糙度”等任务,建立严格通道不变性约束和渲染验证。
零初始化适配器的第一步梯度、no_grad 的位置、optimizer 收录与实际更新不同步,都是可自动化检查的对象。针对新 PMG 模型,可为每个模块建立输入来源、可训练状态、梯度与输出扰动的测试,防止“框图说训练、代码实际冻结”的误差。
隐私与使用边界:试穿应使用有权处理的人像和商品图,避免未经同意改动真实人物衣着或制造误导内容。官方代码为 CC BY-NC-SA 4.0,数据与基础模型另有许可;研究结果不能直接推出商业授权。展示时标识合成,且不将其作为身体测量或购买尺码保证。
原 note 完整前缀保留;建议元数据将通讯作者核实为 Sunghyun Park,会议信息追加 CVPR2024,保留原预印本版本。作者/People 与共享索引只有待整合计划,本次未修改真实 vault。
已完成内容与静态检查,HTML 严格小于 20 MB;MathJax 3 公式、内部锚点、原表数值、原笔记前缀与 PDF++ 链接均检查。远程图源做 HTTP 检查。真实浏览器 MathJax、图片加载布局和 1440/760/390px 响应式验收按用户要求延后,本页不宣称浏览器通过。