01 · 只定制图像,怎样仍生成会动的视频
把DreamBooth或StyleDrop定制好的图像权重直接塞进视频模型,常导致身份丢失、风格不准或视频伪影。Still-Moving把问题视为定制空间特征与预训练时间层之间的分布失配,用小型Spatial Adapter对齐它们;训练只需定制静态图,但还要设法避免把视频模型教成不动。
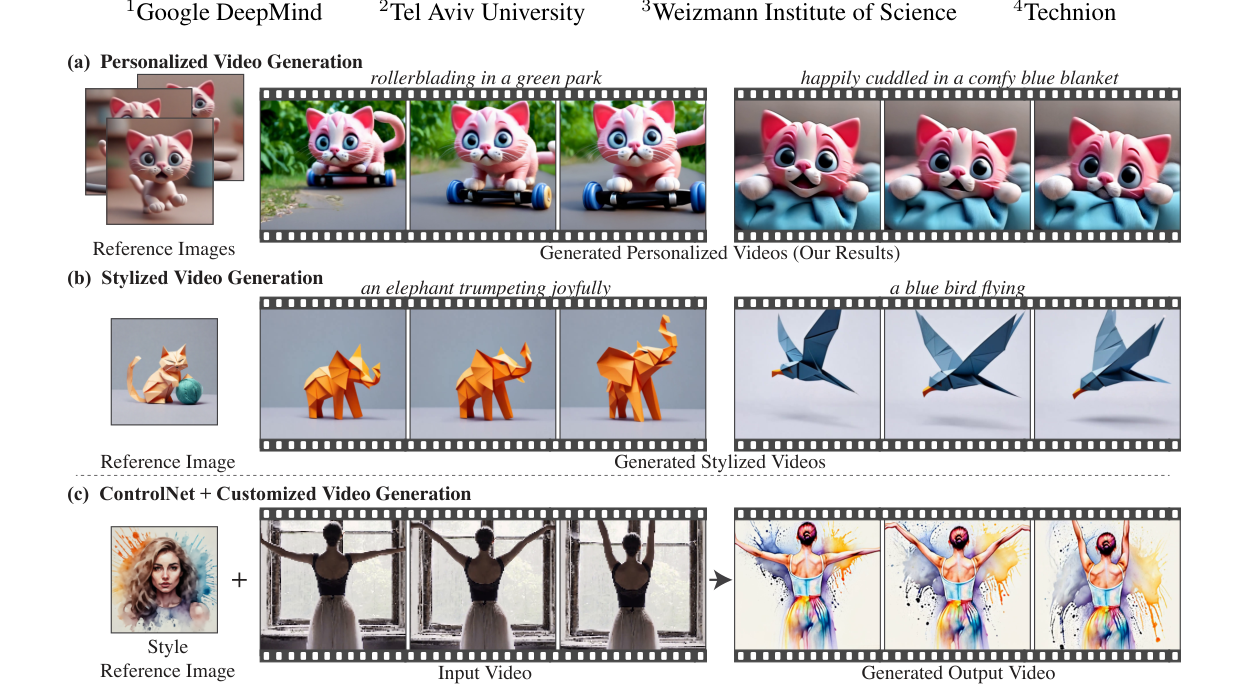
标题是“无需定制对象/风格的视频”,不是“全程不用任何视频”。Motion Adapter预训练和prior preservation都使用普通视频;只是不要求目标角色或风格已有动态数据。它也不保证恢复真实对象会怎样运动,只是借用视频模型的生成先验。
固定来源:用户v1,2024-07-11,14页含附录A–C · 官方项目 · 官方补充视频页面。静态图可以辅助理解方法,但本次没有播放视频做视觉验收。
02 · 作者、正式发表与适用模型
十位作者按原文顺序为Hila Chefer、Shiran Zada、Roni Paiss、Ariel Ephrat、Omer Tov、Michael Rubinstein、Lior Wolf、Tali Dekel、Tomer Michaeli、Inbar Mosseri。机构包括Google DeepMind、Tel Aviv University、Weizmann、Technion,第一作者在Google实习时完成工作。脚注的星号表示core technical contribution,并非通讯作者标记;原笔记Inbar Mosseri的通讯作者unverified保持。
作者机构出版记录确认ACM TOG43(6)、Article244、2024,DOI10.1145/3687945。原笔记仍是arXiv信息,本次仅追加建议。以下实验数值来自固定v1,不静默替换为正式版。
框架要求视频模型由某个T2I骨干“inflation”而来,并能注入同源定制T2I权重。实际展示Lumiere/Imagen和AnimateDiff/StableDiffusion。它不是对任意不可分解视频模型都已验证的通用黑盒接口;需要内部权重、特征位置和可训练adapter接入。
03 · 为什么直接替换和静态训练都不够

预训练视频模型 \(V\) 由图像模型 \(M\) 与时间模块构成。定制得到 \(M'\) 后,其输出激活分布可能变化,原时间层是在 \(M\) 的分布上学到的,因此“形状对得上”不等于“语义统计兼容”。直接weight injection会放大失配,权重插值则以牺牲定制保真换取靠近原模型。
最直接的纠正方案是用目标视频训练,但这正是缺少的数据。把定制图片复制F次当视频虽然有身份/风格监督,却会把“所有帧相同”这个伪运动分布教给模型。Motion Adapter让冻结模式成为可拆卸的分支,Spatial Adapter只需在这个临时模式下学对齐。
它不同于简单屏蔽temporal layers做图像微调:后者根本没有让定制图像损失经过完整视频前向,因而无法有效适配空间–时间接口。Still-Moving保留视频计算路径,只调整小规模参数;冻结权重不代表切断通过它们的梯度。

04 · Temporal attention 的张量解释
原输入为 \(X\in\mathbb R^{F\times H\times W\times C}\),其中F帧数,H/W是当前特征分辨率,C是中间特征通道数,不是总等于RGB3。重排后为 \((HW)\times F\times C\),每个空间位置是一条跨帧“针”。
对应原Eq.1/2,这里以 \(V_a\) 区分value张量与整视频模型V。时间注意力在每个位置的帧维交互,不是将全部 \(FHW\) 个token做同一种全局注意力。这是所用inflated架构的机制,不代表所有现代视频Transformer都如此。
Motion Adapter放在temporal Q/K/V投影上,因为这些权重直接参与帧间信息交换。Spatial Adapter则作用在定制空间层之后,对接预训练时间层;两者位置、训练目标和测试时保留策略均不同。
05 · Stage I:训练可移除的冻结开关
原Eq.3中down矩阵 \(C\times r\)、up矩阵 \(r\times d_k\),一个随机初始化、另一个零初始化,初始增量为零。冻结原视频模型,仅训练这些LoRA增量;每个普通训练视频随机抽一帧,复制F次,加扩散噪声后做去噪训练,\(\alpha=1\)。
训练结束,\(\alpha=1\)让模型倾向生成静止视频,\(\alpha=0\)让该增量失效,恢复底座时间模块行为。该Motion Adapter在未定制视频模型上训练一次,可供不同定制主题重复使用,并非每来一个新角色都重新从零学习冻结器。

负alpha(例如−1)在作者示例中增加运动,是经验性外推,非严格线性运动强度控制,也没有保证任意负值都安全稳定。普通最终生成关闭Motion Adapter;保留负scale是额外可选控制,不是默认算法必需步骤。
开启/关闭alpha是控制Motion Adapter贡献,不等于决定哪些权重可训练。参数是否冻结由训练设置决定;不要把原笔记“alpha控制训练什么”当作精确实现描述。
06 · Stage II:适配定制激活,保留泛化
原Eq.4是identity加低秩线性残差。将它加在每个注入的定制T2I层之后,down随机、up零初始化。初始adapter不改变激活,但已注入的M'仍然是定制权重,不能说整个网络因此回到原始未定制V。
| 训练数据流 | Motion scale | 目的 |
|---|---|---|
| M'生成的定制静态图,复制成frozen video | α=1 | 学习目标身份/风格的空间–时间接口,不逼底座学静止 |
| 40个普通真实视频 | α=0 | prior preservation,维持一般视频能力和运动 |
只优化Spatial Adapter,原视频/定制空间权重和已训练Motion Adapter保持冻结,但梯度穿过完整模型到达adapter。数据流在同一适配阶段结合,不是先拿图片训练一次、再对“用户要编辑的视频”训练一次。普通视频是保持先验,不需要与目标角色匹配,也不是ControlNet输入。
可概括训练为两类去噪loss的混合 \(\mathcal L_s=\mathcal L_{\mathrm{custom},\alpha=1}+\lambda\mathcal L_{\mathrm{prior},\alpha=0}\),这是解释性符号;原文未在已给设置中列出明确lambda,不能擅填1。推理通常 \(\alpha=0\),仍保留M'和Spatial Adapter,因此恢复的是可用运动先验,不保证完整输出与原V逐样本相同。
07 · 两个底座的完整实现设置
| 设置 | Lumiere / Imagen | AnimateDiff / StableDiffusion |
|---|---|---|
| 硬件 | 8张TPU-v5 | 单A10040GB |
| 学习率 | 1e−4 | 2e−5 |
| batch | 8 | 1 |
| Motion训练步 | 2000 | 4000 |
| Motion普通视频 | 1600,Lumiere训练集 | 2000,WebVid evaluation数据 |
| Spatial训练步 | 最多500 | 最多600 |
| Spatial先验视频 | 40个随机训练集视频 | 40个WebVid视频 |
| Motion rank | 4 | 4 |
| Spatial rank | 4 | 64 |
| noise offset | .01 | .1 |
noise offset跨帧复制,帮助非常亮/暗参考。Motion训练应足够短,避免改变原视频模型的帧分布太多;不是训得越久越好。两底座Spatial rank不同,说明“轻量”不是统一固定参数量;正文未列每套adapter确切总参数数、训练墙钟时间和完整采样超参,不编造。
Motion阶段从视频抽静帧,Spatial阶段用生成静图与真实动态视频;这再次说明无需目标定制视频,而不是无需任何动态训练先验。Lumiere数据与底座可获得性限制公开完整复现,AnimateDiff路径也需要精确版本和训练实现。
08 · ControlNet 是额外的结构条件分支

把预训练ControlNet分支加入Lumiere的时间层,再在视频上训练其空间ControlNet层,逐帧提取结构条件,得到能插入Lumiere的视频ControlNet。此步骤本身使用视频,并非Spatial Adapter训练中的40个prior样本就自动完成。
在需要结构可适应的生成中,只在前半段去噪使用ControlNet,并乘.5减弱约束。介绍段泛称depth或canny,实际论文结果说明采用depth或HED edges,同一种主体/风格保持一致的condition类型,不应把所有边图都叫Canny。
此时才有“驾驶视频/输入视频”控制结构。普通个性化和风格化生成没有必须提供源视频的要求。作者示例中输出可加入风格相关滴落/飞溅运动,说明结构控制不是逐帧像素完全复制;因此也不能保证输入动作或几何被精确保持。
09 · 定性结果与对照各自回答什么


| 基线 | 操作 | 典型不足 |
|---|---|---|
| Injection | 直接换T2I定制权重 | 空间/时间特征失配 |
| Interpolation | 原始与定制T2I权重插值 | 减轻失配同时削弱目标身份/风格 |
| Interleaving | 定制图训练时禁用时间层,普通视频时启用时间层 | 目标定制loss未经过完整时间路径 |
| Still-Moving | 冻结开关下训练低秩Spatial Adapter | 依赖底座及定制图像模型质量 |
作者展示水彩飞溅、金色滴落、真实或动画角色的动作,主张空间先验和视频运动先验协同。这里不能根据静态帧自行确认运动真实与流畅;本页原图保留作者证据,动态检查应在官方视频和后续本地验收中完成。

AnimateDiff定性示例表明直接注入对细致定制也会失效,而不是所有AnimateDiff自带权重替换都完美。主表和大部分定量评价集中在给定评价流程,不将两个底座的全部性能混成统一数字。
10 · 完整定量表与显著性边界
原 Table 1
| Personalization | Stylization | |||
|---|---|---|---|---|
| Method | CLIP-I | CLIP-T | CLIP-I | CLIP-T |
| Injection | 0.680 \(\pm\) 0.018 | 0.236 \(\pm\) 0.007 | 0.670 \(\pm\) 0.013 | 0.211 \(\pm\) 0.007 |
| Interpolation | 0.724 \(\pm\) 0.009 | 0.320 \(\pm\) 0.006 | 0.664 \(\pm\) 0.008 | 0.259 \(\pm\) 0.005 |
| Interleaving | 0.717 \(\pm\) 0.011 | 0.324 \(\pm\) 0.006 | 0.642 \(\pm\) 0.011 | 0.275 \(\pm\) 0.008 |
| Ours | 0.772 \(\pm\) 0.007 | 0.325 \(\pm\) 0.004 | 0.673 \(\pm\) 0.01 | 0.297 \(\pm\) 0.005 |
CLIP-I测生成帧与参考的相似度,CLIP-T测帧与文字的相似度,均越高越好。表中±是作者称为standard error of mean的SEM(正文缩写写SME),不是标准差。个性化CLIP-I从最强基线.724到.772,风格CLIP-T从.275到.297,有清楚的均值增益。
但个性化CLIP-T为.325±.004对interleaving .324±.006,风格CLIP-I为.673±.010对injection .670±.013,差值很小。作者称所有指标均统计显著,仅凭这张SEM表无法独立验证,需要配对原始数据、样本层级和检验方法。误差条重叠本身也不是否定配对显著性的充分证据,因此本精读不擅自宣布结论错误,只限制可证实范围。
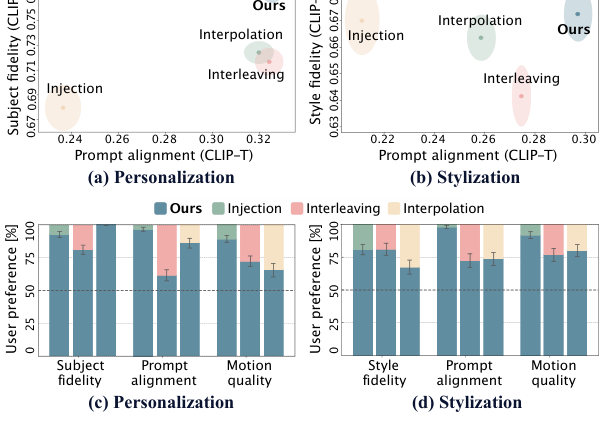
评价数据为5个个性化对象加5种风格,共10项,每项10条不同prompt,用相同seed比较,故每方法100段视频,不是10个对象外加10种风格。真实角色、玩具/风格化角色、矢量风格和细节丰富风格都有覆盖,但规模仍小,不能代表任意对象。
重复一张高质量图也能得到很高CLIP-I/T,所以这两项无法证明模型会动,亦不能作为时间一致性或运动自然性的度量。本文用用户研究补充,而非声称CLIP已经解决运动评估。
11 · 用户研究与三个消融
31位参与者,每人20次成对视频比较,每次回答三题:参考忠实、文字匹配、运动质量。总计 \(31\times20\times3=1860\) 票,属于620次比较的三个评价维度,并非1860名独立参与者。比较对保持同一prompt/seed,随机展示本方法和一个baseline。Figure7(c)(d)显示各项偏好,但正文未给完整逐格数值,本次保留原图、不从像素高度伪造精确百分比。
论文未在固定稿提供完整参与者属性、配对投票数据、排除策略、多重比较处理和时间指标基准。偏好支持这些例子更受欢迎,不等于准确恢复物理运动。重复参与者/多个相似视频之间的依赖在重分析时应考虑。

- 去Motion Adapter、仍用静态重复帧训练:视频几乎冻结,说明需要隔离静止训练的影响。
- 去Spatial Adapter、改训练全网络:运动减少、背景多样性下降,作者归因为高参数自由度更易过拟合。这同时改变了可训练参数范围,不是纯“有没有一层”的严格匹配消融。
- 去prior preservation:泛化和运动下降,例如prompt要求戴帽却未实现,表明普通视频保持项有作用。
消融主要定性,没有逐项CLIP/运动数值表和方差,因此不把三个因素的贡献写成确定百分比。
12 · 附录评价数据与完整20类prompt

个性化prompt由LLM建议,风格prompt取自Lumiere以利比较;稀有token[V*]与类别[c]组成主体描述,风格以[s]占位。本表将原20条任务内容完整列出为中文含义,模板标记保留,便于核对覆盖而不声称生成过新实验。
| 序号 | 个性化:A [V*] [c] … | 风格化:… in [s] style |
|---|---|---|
| 1 | 驾驶赛车 | 熊欢快地旋转 |
| 2 | 探索花园 | 蝴蝶在花间飞舞 |
| 3 | 举行茶会 | 狗行走 |
| 4 | 在天空飞翔 | 有雄壮鬃毛的狮子 |
| 5 | 在巴黎 | 海豚跃出水面 |
| 6 | 从毯子堡垒中探头 | 企鹅跳舞 |
| 7 | 骑彩色自行车穿过晴朗公园 | 考拉吃桉树叶 |
| 8 | 在秋叶堆中愉快行走 | 有雄壮鬃毛的狮子咆哮 |
| 9 | 戴漂亮帽子,显得可爱 | 猫头鹰栖在树枝上 |
| 10 | 戴墨镜,显得很酷 | 一家鸭子在池塘游泳 |

Figure9是单固定seed、无手工挑选的风格样例,和其它精选展示应区分。该未精选集合仍不等于多个seed、所有prompt的随机抽样评估。
13 · 局限、原笔记更正与复现状态

如果M'没有学好目标身份,或者把背景一起记住,视频适配也会继承这些问题。Spatial Adapter不是能纠正任何图像定制错误的万能解;底座运动、文本理解、时长/分辨率同样限制结果。
| 原笔记易混点 | 新增澄清 |
|---|---|
| C是color channel | 时间注意力输入是中间feature,C不固定为3 |
| alpha决定训练哪些层 | alpha缩放Motion LoRA贡献,requires-grad/优化器决定可训练参数 |
| Spatial两个步骤分别用图片和待编辑视频 | 同一阶段两数据流:定制重复帧与普通prior视频,后者不是用户输入编辑视频 |
| 不需要视频 | 不需customized video,但需通用Motion/先验视频和已预训练T2V |
| 去Motion Adapter恢复原模型 | 只撤销冻结运动增量,定制T2I与Spatial Adapter仍在 |
官方项目和补充页面主要展示方法与视频,本次未找到可核实的完整官方训练代码/权重发布,不对第三方同名实现进行模型一致性背书。Lumiere内部底座与训练视频也不是给出公开实现就自动可得。这里只完成论文/一手来源审阅,没有训练、推理或视频运动质量实测。
身份定制可能用于合成误导内容,作者也讨论检测偏差和恶意使用;实际产品需要取得参考资产授权和合成标识。这里讨论的是论文技术,不把动画示例解释为真实人物行为。
14 · 对PMG和条件模块组合的启发
以下是研究设想,不是原论文实验。
- 把强图像材质先验接到多视角/动画系统时,先研究模块接口的特征分布失配,别假定同层shape相同就能直接换权重。
- 可拆卸“训练模式”adapter可隔离不完整监督的副作用,例如静态外观与动态行为;需要独立验证退出该模式后目标能力是否恢复。
- 将全网fine-tune与低秩adapter在相同预算下比较,测身份/材质保持、运动或光照变化能力与背景多样性。
- 图像相似度无法评估时序或物理行为,需添加任务对应的跨帧/跨光照指标和盲评。
- 评估要同时保留定制失败、先验继承错误与采样随机性,不只展示好看的角色动作。
15 · 最终记忆点与交付边界
- Motion Adapter先学“冻结”,Spatial Adapter再学“对齐”;最终通常移除前者、保留后者。
- 定制静图经过冻结视频模式产生监督,普通40段视频用于prior preservation。
- 框架依赖可注入同源T2I权重的inflated T2V;非所有视频模型的通用黑盒。
- Table1全部16个均值及16个SEM完整保留;显著性不能仅凭SEM表确认。
- 31人、620次比较、1860票必须分清;CLIP不测运动。
- 覆盖4条原公式、13幅图、附录A–C和20类评价prompt;原用户笔记、外链图片、PDF++及块锚点均保留。
- 内容/静态检查完成,浏览器与视频播放验收按用户安排延后;未发布、未写回Obsidian。