01 · 让纹理沿语义方向变化,而不是换一张图
把“小石子”变“大石子”,希望改变尺度却仍像原来的那种石头。TexSliders用两个文字端点定义一个CLIP图像嵌入方向,再筛除容易改变身份的坐标,让同一纹理沿正负方向连续编辑。滑杆来自嵌入空间,不是每个编辑重新训练LoRA。

输出是RGB颜色纹理,不是完整PBR通道,也不是程序材质图。文字“rough/smooth”在这里控制视觉外观,并未保证对应数值粗糙度或物理BRDF参数。真实照片也先经CLIP条件近似重建,再对重建外观编辑,不保证原像素严格保留。
基准为用户固定arXiv2405.00672v1,2024-05-01,11页;官方项目确认SIGGRAPH2024 Conference Papers,Article7,DOI10.1145/3641519.3657444。
02 · 作者、模型来源与“零样本”含义
九位作者依次Julia Guerrero-Viu、Miloš Hašan、Arthur Roullier、Midhun Harikumar、Yiwei Hu、Paul Guerrero、Diego Gutierrez、Belen Masia、Valentin Deschaintre,来自Zaragoza-I3A与Adobe/Adobe Research。项目页确认第一作者有Adobe实习经历;原笔记Valentin Deschaintre通讯作者尚未有明确标记验证,本次保留unverified。
底座是已有的图像条件latent diffusion decoder及纹理diffusion prior:decoder在7700万张不含人和文字的图像上训练,prior在其中1000万张被归类为纹理的子集上训练。本文编辑步骤不需目标编辑标注或额外fine-tune,但整个系统显然使用了大规模预训练。因此“zero-shot editing”不等于不训练任何模型。
官方页面给论文、补充PDF与完整测试结果,但未见完整底座权重、训练/编辑源码的可核实发布;作者感谢内部backbone团队。原笔记“没有code和dataset”应细化:没有验证到可运行模型代码/原预训练数据,但80个测试样本的结果画廊是公开的,不是所有测试资料都不可获取。
03 · 为什么纹理不适合照搬物体attention编辑

自然图像中的“熊猫”“披萨”通常各有区域,对应文本token的cross-attention能提供结构分区。纹理的石块、木纹或噪声在全图重复,往往没有清晰token→对象区域对应。若用这些图保持布局,就可能保错结构,或无法改变全局尺度。本文由SD1.4图例提出这个动机,不应扩展为所有纹理、所有attention方法永远无效的定理。

详细文字仍可能对应很多视觉身份;单张图片的CLIP图像嵌入更能限定特定外观。作者因此选择在image embedding中改方向,并用texture prior限制其来自纹理域。Figure3的文字与图像条件分别使用不同预训练生成模型,这不是严格只换条件、其余网络相同的控制实验;它提供设计直觉而非独立的因果证明。
纹理“身份”没有形式化统一定义。作者将它理解为除被编辑属性之外的其它外观特征。改石块尺度时,像素布局必然改变,不能把identity简单定义为每个像素位置或轮廓完全不变。
04 · 文字不是直接相减,而是先采样图像嵌入

令source/target文字为 \(s_o,s_t\),CLIP text encoder得到条件,prior \(P\)分别生成CLIP-L/14图像嵌入 \(o^{(i)},t^{(k)}\in\mathbb R^{768}\)。两端各采 \(n_e=150\) 个,合计300个prior输出。本文编辑的768维是全局图像embedding,不是VAE的空间latent或U-Net权重。
这对应原Eq.1。用多个样本平均,意图抵消每张纹理独有的身份差异,留下共同编辑属性。它是生成分布的统计差,不是对768维text embedding直接做向量减法;CLIP文字和图像相关,不代表可无条件把文本差加到任意图像向量。
用一个样本 \(n_e=1\) 会把单独采到的颜色、纹路和结构混入方向。即使用150平均仍可能残留干扰,因此下一步继续筛选维度。没有对decoder进行梯度优化,创建新滑杆的时间来自prior采样和统计处理。
05 · 逐坐标筛选:簇间变化大,簇内波动小
对归一化后的向量,用方向幅度与两簇内部标准差比较。原Eq.2可写为:
通常 \(\tau=.8\)。两个条件必须同时满足,不是二者取一;比较使用带tilde的归一化量,保留时使用原 \(d'_j\)。不能把它改成“选最大k维”或PCA投影,原方法是坐标mask,不学习新的旋转基。
如果某维同簇样本之间变化很大,它可能承载身份噪声;若两簇均值分开且各自集中,则更像目标属性。但这只是可解释启发式:簇内方差也可能是属性自然变化,簇间差也可能是数据偏见。没有因果保证所有保留坐标都只控制目标属性。
方向是坐标基相关的,同一空间做任意正交旋转后逐坐标mask可不同。阈值增大一般保留更少坐标,但质量未必单调;过严可消掉编辑,过松会漂移身份。归一化口径和std估计应跟随作者补充说明,不能自行替成任意逐维z-score再声称复现。
06 · 从方向到滑杆:连续不等于物理定标
原Eq.3用输入纹理embedding \(e_0\) 加方向。正alpha沿target方向,负值向相反方向;常展示−1、−.5、0、.5、1、1.5。alpha=0对应原embedding的重建条件,并非保证输出像素等于原图。alpha=1也不保证恰好到某张target图:输入e0不一定是source簇中心,且方向已剪枝。
不论正向还是负向,走得太远都可能离开可生成纹理的嵌入分布。虽然latent向量线性移动,生成网络高度非线性,因此“连续滑杆”不意味着外观变化等速、单调、可逆或无突变。
多个方向可叠加 \(e=e_0+\sum_k\alpha_kd_k\)。向量加法的次序可交换,但这不证明属性感知上彼此独立;剪枝只是减少耦合,不是严格解耦。新滑杆在单A10G的未优化实现约2分钟,之后可复用;不能把创建成本与每次输出的交互延迟混为一谈。
07 · 测试数据与对照设置
测试包含7类材料:brick、fabric、leather、metal、paper、stone、wood;围绕9类常用属性设计1–4个prompt,再筛选语义合理的material–attribute组合。每组用两个不同prior随机seed生成source纹理,共66张生成图;另每材料2张Adobe Stock真实照片,共14张,合计80图。
80是评估样本量,不是decoder训练集,也不是150×2的方向估计样本。完整80行结果见官方测试画廊,可以查看负向和正向外推,并非仅正文成功案例。
| 方法 | 报告设置 |
|---|---|
| 共同条件 | 50扩散步、CFG7.5,基线prompt加“a texture of…” |
| P2P | 搭配null-text inversion;cross_replace_steps=.8,self_replace_steps=.3 |
| Pix2pix-zero | xa_guidance=.5 |
| SDEdit | 噪声强度.5与.75两种 |
| TexSliders展示 | n_e150、τ.8,比较图α1.5 |
相同步数和CFG减少部分推理配置差异,但baseline是StableDiffusion,而本文是另一个image-conditioned decoder+texture prior,训练数据/条件能力不相同。结果比较评价系统效果,不能把全部收益严格归因于坐标mask。
08 · 编辑效果与核心消融

展示覆盖老化、新旧、锈蚀、苔藓、金属感、粗糙/光滑等全局属性;改变整图而保持材质身份,是它与局部物体替换的区别。尤其尺度变化本来就不能保持每个石块的原像素边界,视觉身份必须在属性之外定义。
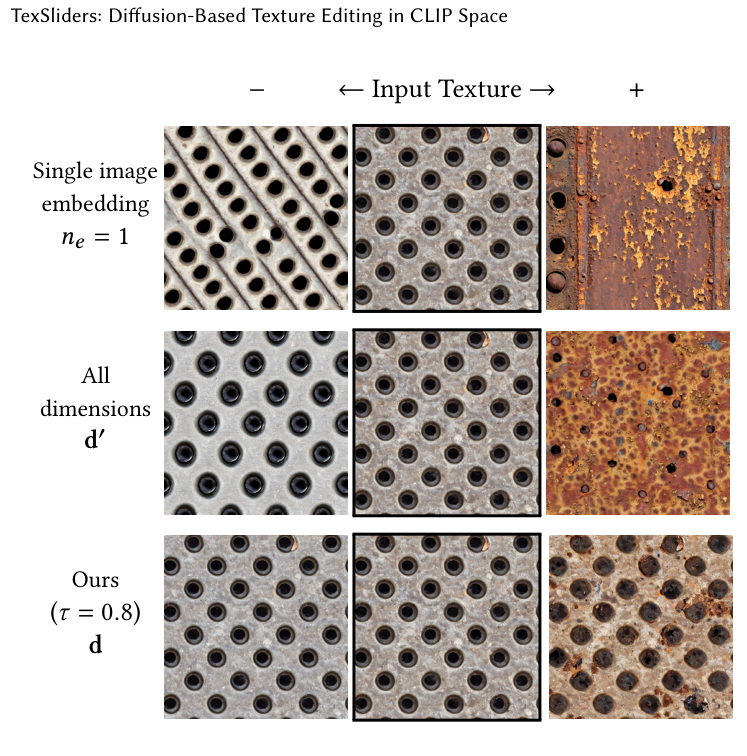
单一prior样本方向会混入偶然身份;多样本均值但不筛维度仍漂移;150样本加阈值mask最好。它支持两步设计有用,但主文只有该例的定性消融,不能据此给每个组件编造固定百分比贡献。

SDEdit低噪声保留更多源图但编辑弱,高噪声编辑更强却身份更易变化;P2P/Pix2pix-zero在这些纹理案例中出现结构漂移或出域伪影。论文结论针对其数据和底座,不能断言这些方法对任何纹理都不适用。
09 · 完整量化表与指标局限
原 Table 1
| Method | \(\uparrow\) CLIP-Direction | \(\uparrow\) CLIP-Im2Im |
|---|---|---|
| P2P | 0.0880 | 0.9033 |
| Pix2pix-zero | 0.0811 | 0.8667 |
| SDEdit 0.5 | 0.0706 | 0.8753 |
| SDEdit 0.75 | 0.0690 | 0.8707 |
| Ours | 0.1063 | 0.9303 |
两项指标都用CLIP:Direction是图像变化向量与文字变化向量的余弦,Im2Im是输入与编辑图的余弦。形式化理解为
本方法Direction .1063、Im2Im .9303均高于表中对照;相对最强P2P .0880/.9033,绝对增加.0183/.0270。原表是80样本均值,没有误差条、置信区间或人类评价,原文“significantly”不能直接翻译为已做统计显著性检验。
生成控制与评价都依赖CLIP,存在表征偏好的共享;CLIP高分不一定等于人类认为纹理身份不变。Im2Im极端情况下奖励不编辑,Direction又需要可靠、非零变化向量,两者应联合看。未报告分材料/真实与生成子集的完整统计分布,不能从总体平均推断全部类别受益。
10 · 真实照片、跨材质和图片定义方向

真实照片通过CLIP图像encoder得到e0,decoder基于该条件重建相似纹理;编辑在该重建上进行。本文不做DDIM/null-text inversion,原照片细节可能在alpha=0时已经变化。主文把更准确inversion列为未来改进,因此不能把该方法说成无损编辑任意照片。

作者把砖的新旧方向迁移到木材,可获得合理效果但付出少量身份损失;多方向组合展示石块尺度和苔藓的二维网格对角线。迁移不是保证:不同材料中同一个词的外观含义可能不同。
方向也能由图片而非文字定义:用20张纹理及其裁剪/缩放建立“放大/缩小”两簇,直接从CLIP图像嵌入做相同统计。这绕过text prior,但仍依赖样本覆盖与表征是否捕捉该属性,不会变成有真值物理参数的监督学习。
11 · 失败原因与复现边界

- CLIP对概念不对称,例如vertical比horizontal更好,导致竖纹难转横纹。
- 身份仍可能漂移,例如鹅卵石布局在编辑中改变;mask未去掉全部干扰。
- 大幅外推会离开嵌入采样分布,产生不合理纹理;负向滑杆不是精确逆操作。
- 纹理身份没有统一标注定义,本文未提供深入人类感知验证或完整创作者UI研究。
- 只处理颜色纹理,PBR参数图扩展是未来方向,不应把视觉“metallic”直接当metalness数值。
- 预训练decoder/prior未验证公开,单靠论文三个公式不能在现有任意SD模型上直接复现。
平铺来自底层纹理生成器的构造能力,不是方向mask的数学保证。本文不修改生成器权重,输出遵循底座tileability流程;若换一个不保证平铺的decoder,仅照抄e0+alpha d不会自动无缝。
12 · 补充材料核查
官方项目提供独立补充PDF和完整80图测试结果网页。独立PDF约321MB,本次未能完整取得,因此未核验其中额外的实现参数、维度筛选消融和组合矩阵,不能将它们写成已经完整审阅。固定11页正文及原表全部覆盖。
官方完整测试画廊按材料与编辑prompt列出两组随机输入及alpha −1、−.5、0、.5、1、1.5结果,可用于后续人工验收。公开结果图片不是模型代码或原始训练集,用户原笔记对此的概括应保持区分。
由于公开模型实现未验证可用,本次没有运行生成、重算CLIP指标或断言完整复现。方向归一化、采样scheduler、图片定义方向的完整预处理若需要严格复现,应进一步取得补充材料/代码说明。
13 · PMG研究启发
以下是待验证研究设想,不是原论文结果。
- 将图像嵌入滑杆与程序材质参数关联,需要验证同一方向是否真的只改变目标节点或物理属性;不能把视觉方向直接命名为精确BRDF参数。
- 建立人类纹理身份数据,比较CLIP方向分数、局部纹理统计与专家偏好,避免同一表征既控制又裁判。
- 研究对坐标旋转更稳健的子空间方法,并在相同采样预算下对比当前逐坐标启发式。
- 为alpha做感知定标与安全范围提示,检测出域和方向失效,提供可回退的候选而非无限外推。
- 严格分离底座训练差异与编辑器贡献,控制image-conditioned/texture prior/剪枝三个因素做消融。
14 · 最终记忆点
- 两端文字→texture prior各150图像embedding→两簇均值差→τ.8逐维筛选→e0+alpha d。
- 768维CLIP图像空间不是VAE空间,也不是模型权重空间。
- 保持的是目标属性以外的感知身份,不是逐像素布局;真实图先近似重建。
- 方法不为每滑杆fine-tune,但底座使用7700万/1000万预训练数据。
- 80评估图、两CLIP指标均值、无主文人类实验;不能只凭“significantly”推断统计检验。
- 输出是RGB纹理,不直接生成物理PBR图;公开测试结果与未验证公开的模型代码要区分。