0.982 Accuracy
平衡二分类评估,F1=0.983、AUC=0.997。训练标签与通用感知偏好不是同一件事。
怎样让纹理的平铺性可计算、可比较,也可被梯度优化
11页原文 + 23页独立补充 · 完整图表 · 数学与2024/当前代码差异
TexTile 把“这张纹理重复铺开后是否露出接缝、颜色跳变或显眼重复块”变成可微分的单图分数。它用人工整理的正负纹理训练 ConvNeXt 加线性注意力分类器,既能评价纹理,也能在合成时提供梯度。最重要的使用边界是:高 TexTile 不等于高画质、物理正确材质或经过人类感知实验验证的美观程度。
平衡二分类评估,F1=0.983、AUC=0.997。训练标签与通用感知偏好不是同一件事。
14纹理合成基准上,Heitz等方法加入TexTile后,其TexTile均值提高0.350。
SinFusion加入推理时优化后提高0.410,但部分其他质量指标同时变差。
阅读主线:先理解可平铺性和图像质量的区别,再看分类数据与增强为何比“边缘差值”更复杂,最后检查梯度怎样用于合成、代码如何真正返回分数,以及哪些结论仍缺少独立验证。本页读完原文11页与官方补充材料23页,保留主文11图、补充35图和全部3张原表。
Carlos Rodriguez-Pardo、Dan Casas、Elena Garces、Jorge Lopez-Moreno · 固定 arXiv v1,2024-03-19 · 正式发表CVPR2024,4439–4449页,DOI记录。历史原PDF与当前项目PDF差异另列,不覆盖原件。
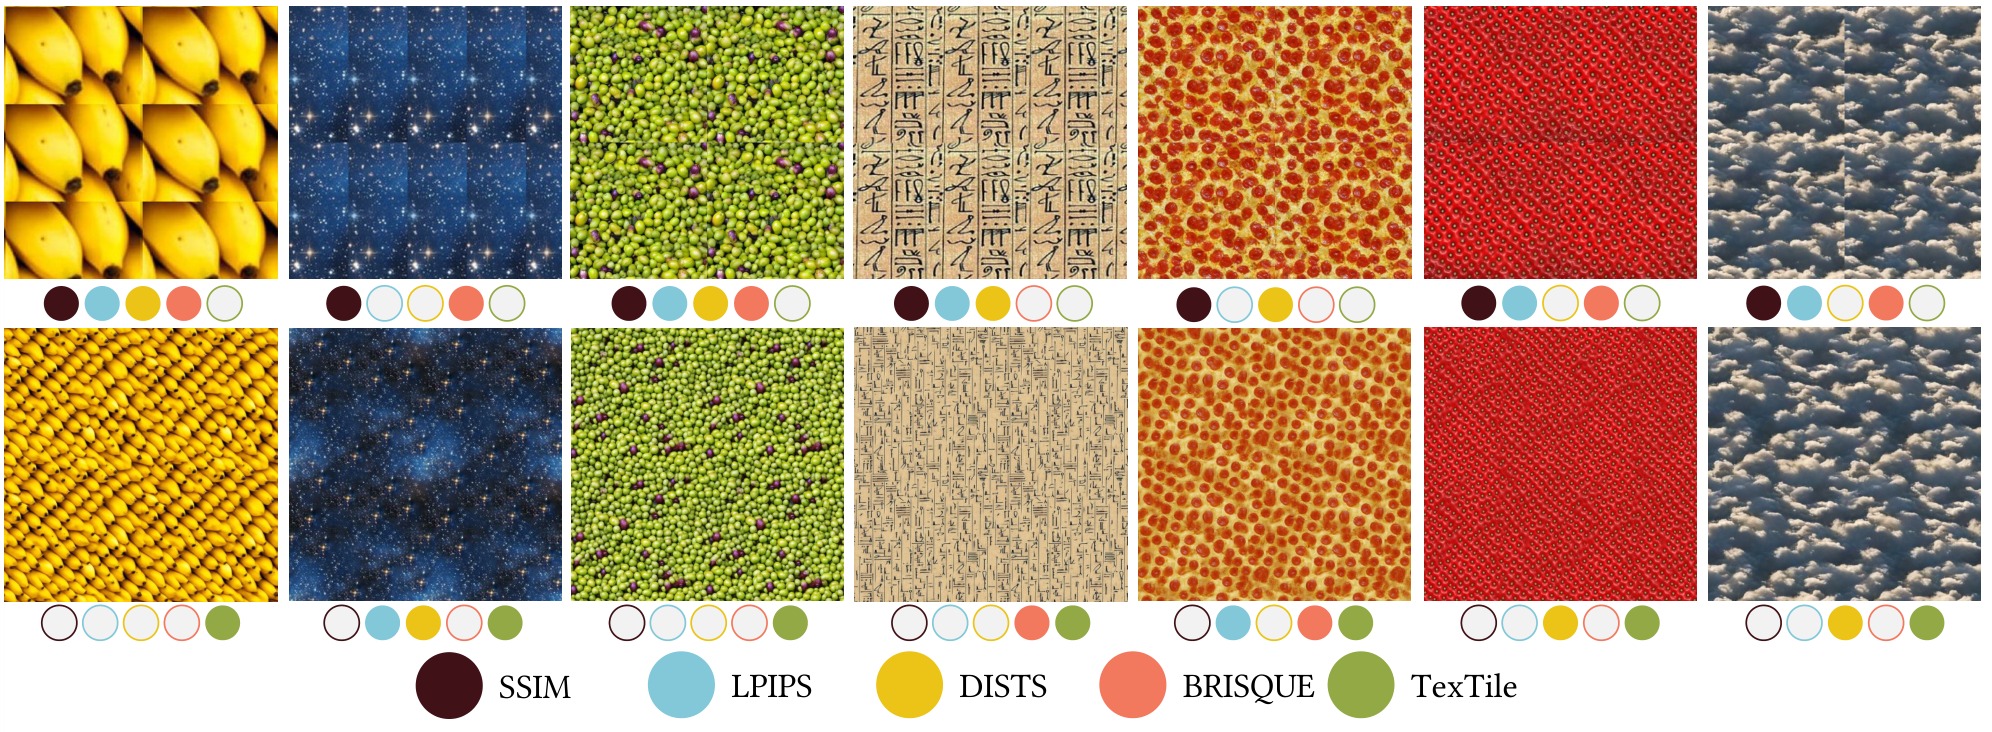
把一张纹理沿水平和竖直方向周期重复,最直接的问题是相邻边缘不连续。但即使边缘经过混合,图内独特的大块物体、阴影渐变、不均匀亮度或明显重复节奏仍可能暴露每个tile。TexTile希望识别这种更宽的“重复后产生伪影”属性,因此它不是一个只检查第一列和最后一列像素差的边界算子。
参考型IQA如SSIM、LPIPS、DISTS比较输出与参考图像是否相似;无参考IQA如BRISQUE、CLIP-IQA评价另一类总体质量;FID等比较两个集合的特征分布。这些任务都不直接回答平铺后的观感。高SSIM可能来自一张几乎照搬输入、但边缘仍不连贯的图,低像素对应相似度也可能只是纹理发生平移,并非质量差。
数学上完全周期延拓与感知上“看不出复制块”也不等价。一个镜像纹理能让接缝连续,却可能产生强烈对称性;均匀纯色容易平铺却失去原纹理;有组织的砖墙本来就重复,不应因存在周期便全部判坏。论文的分类标签是在这些复杂因素上形成的经验监督,并没有给出唯一、普适的物理定义。
这也解释了为何作者在结尾承认人类对重复性的感知尚未有充分理解,而且人类感知验证不在本工作范围。不能把“使用人工整理的数据”转述成“经过用户研究证实与人类偏好高度一致”。
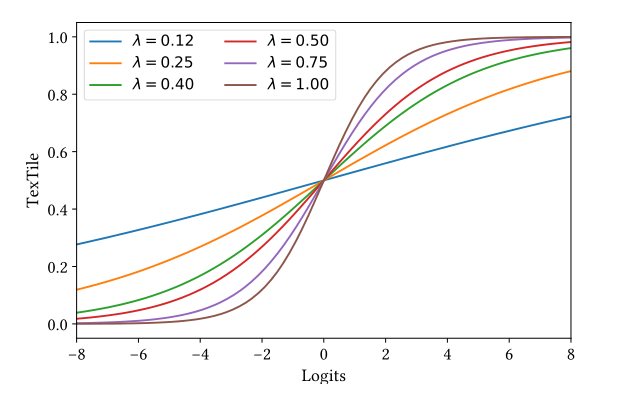
输入是一张RGB纹理,不需要第二张参考图、文本提示、节点图或渲染器。官方wrapper先将输入平铺成2×2,再将整个拼接结果缩放到512×512,最后做ImageNet通道标准化送入模型。输出为每张图一个标量logit z,再作温度缩放的logistic映射:
因此512²不是每块纹理的大小:方形输入的每个重复单元在最终网络图像中约占256²。训练默认整个输入384²;改变tile次数而保持最终分辨率,会同时改变局部纹理尺度。网络在形式上可以处理不同尺寸和比例,但默认wrapper会缩成方形,实际分数有尺度和预处理依赖。
λ=0.25使极端logit的分数不像普通sigmoid那样紧贴0或1。它是严格单调变换,正λ下不会改变同一批logit的排序、AUC或0.5分类阈值所对应的z=0;却会改变数值间距、梯度与跨图均值。它不是通过人类评分校准的“真实平铺概率”。
例如同一logit z=4,经默认映射得约0.731,而λ=1约0.982,这是显示和梯度尺度的变化,不是模型突然更有把握。当前代码允许λ=0,此时所有分数恒为0.5且梯度为零,不能用于排名或优化。为避免与注意力残差尺度混淆,本页把后者记作γ。

卷积擅长局部接缝,深层注意力用于连接远处重复结构。论文从TorchVision的ConvNeXt-Base、ImageNet1K V1预训练权重出发,在深层加两个残差线性注意力模块。不是从头训练一个扩散模型,也不是把整个骨干替换为ViT。
| 部分 | 已核实设置 | 作用 |
|---|---|---|
| 卷积骨干 | ConvNeXt Base,四stage通道128/256/512/1024,block数3/3/27/3 | 由局部边缘累积到多尺度纹理表示 |
| 注意力一 | 输入512通道,16heads,每head128维 | 在较深特征上建立空间全局信息联系 |
| 注意力二 | 输入1024通道,16heads,每head256维 | 更低分辨率上整合整体模式 |
| 分类头 | 保留自适应平均池化,改为Flatten和Linear(1024,1) | 产生一个未经sigmoid的logit |
| 注意力残差 | \(x\leftarrow x+\gamma f_{\mathrm{att}}(x)\) | 初始小扰动保留预训练特征,γ可学习 |
补充材料称把模块加入骨干第5、第7层;源码更明确地在原features[4]之后、[5]之前,以及[6]之后、[7]之前插入,分别对应512和1024通道。经过插层后模块下标改变,因此补充滤波器图中的第7和第11可视化层不能直接等同于原features下标。
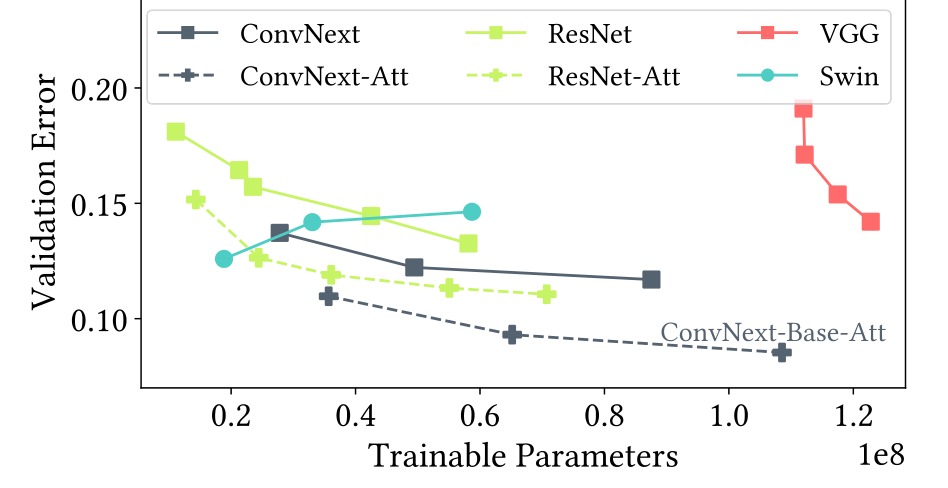
ConvNeXt本身使用7×7 depthwise卷积、通道MLP、GELU和残差结构;它与attention都可对输入求导。Base并不意味着本文另有一个“大型TexTile主模型”:Figure4确实比较多个家族和大小,最终统一选择Base-Att,未发布各点的完整参数量与指标表,不从散点图伪造精确数值。骨干官方定义
已固定的实现通过1×1卷积产生Q、K、V,按head展开为d×N,其中N=H×W。Q沿通道维softmax,K沿空间位置softmax;先计算d×d上下文,再与Q组合,不显式建立N×N的空间attention矩阵。用矩阵记号概括源码:
中间上下文聚合使空间复杂度避免N²项,但仍有依赖head维度的计算,不能称为“没有全局交互”或“任意尺寸零成本”。归一化方向决定算法,不等于标准softmax(QKᵀ)V;论文引用Linformer,但此公开实现没有可学习的序列投影E/F矩阵,应按实际factorized attention描述,不能只按引用名称脑补实现。
明确的论文—代码差异:主文说注意力残差可学习尺度初始化为10⁻⁶;2024发布的PyPI0.0.10和本次固定GitHub版本都写gamma=0.01。训练后的checkpoint会加载学到的gamma,因此这不证明最终模型的gamma为0.01;它说明公开构造器的默认初始化与论文文字不一致。缺少完整训练脚本和日志,无法恢复原实验究竟使用哪一个初值。
模型构造时weights=None是为了随后加载整个TexTile state_dict,不代表原训练没有ImageNet预训练。反过来,若只调用空的CreateModel而不加载TexTile权重,也不能期待得到论文分数。代码还替换了原classifier,包括原分类头的归一化部分;必须使用匹配的checkpoint和strict加载。
| 类别 | 来源 | 图像数 |
|---|---|---|
| 可平铺 | 作者收集的高分辨率材质照片,艺术家处理 | 4276 |
| 可平铺 | Plan2Scene引用的数据 | 285 |
| 可平铺 | Julio Sillet,包含albedo与normal,CC-BY | 186 |
| 可平铺 | ManyTextures royalty-free纹理 | 290 |
| 不可平铺 | Deschaintre等SVBRDF数据中的高质量合成图 | 3922 |
| 不可平铺 | DTD中选取的纹理照片 | 1187 |
| 不可平铺 | Facade照片 | 506 |
| 不可平铺 | Zhou与Kalantari2021,不同照明 | 7265 |
| 不可平铺 | Zhou与Kalantari2022 | 760 |
| 不可平铺 | Texture Stationarization数据 | 93 |
| 不可平铺 | KTH-TIPS、Kylberg、Lazebnik、KTH-TIPS2的合并来源 | 8675 |
| 不可平铺 | 非平稳纹理 | 86 |
按正文列项相加,可平铺5037、不可平铺22494,总计27531,负正比约4.47。这些是对文中报告数的算术汇总,不是本次清点实际发布文件,也不意味着所有来源均可重新分发。原文“约5倍”是近似描述。
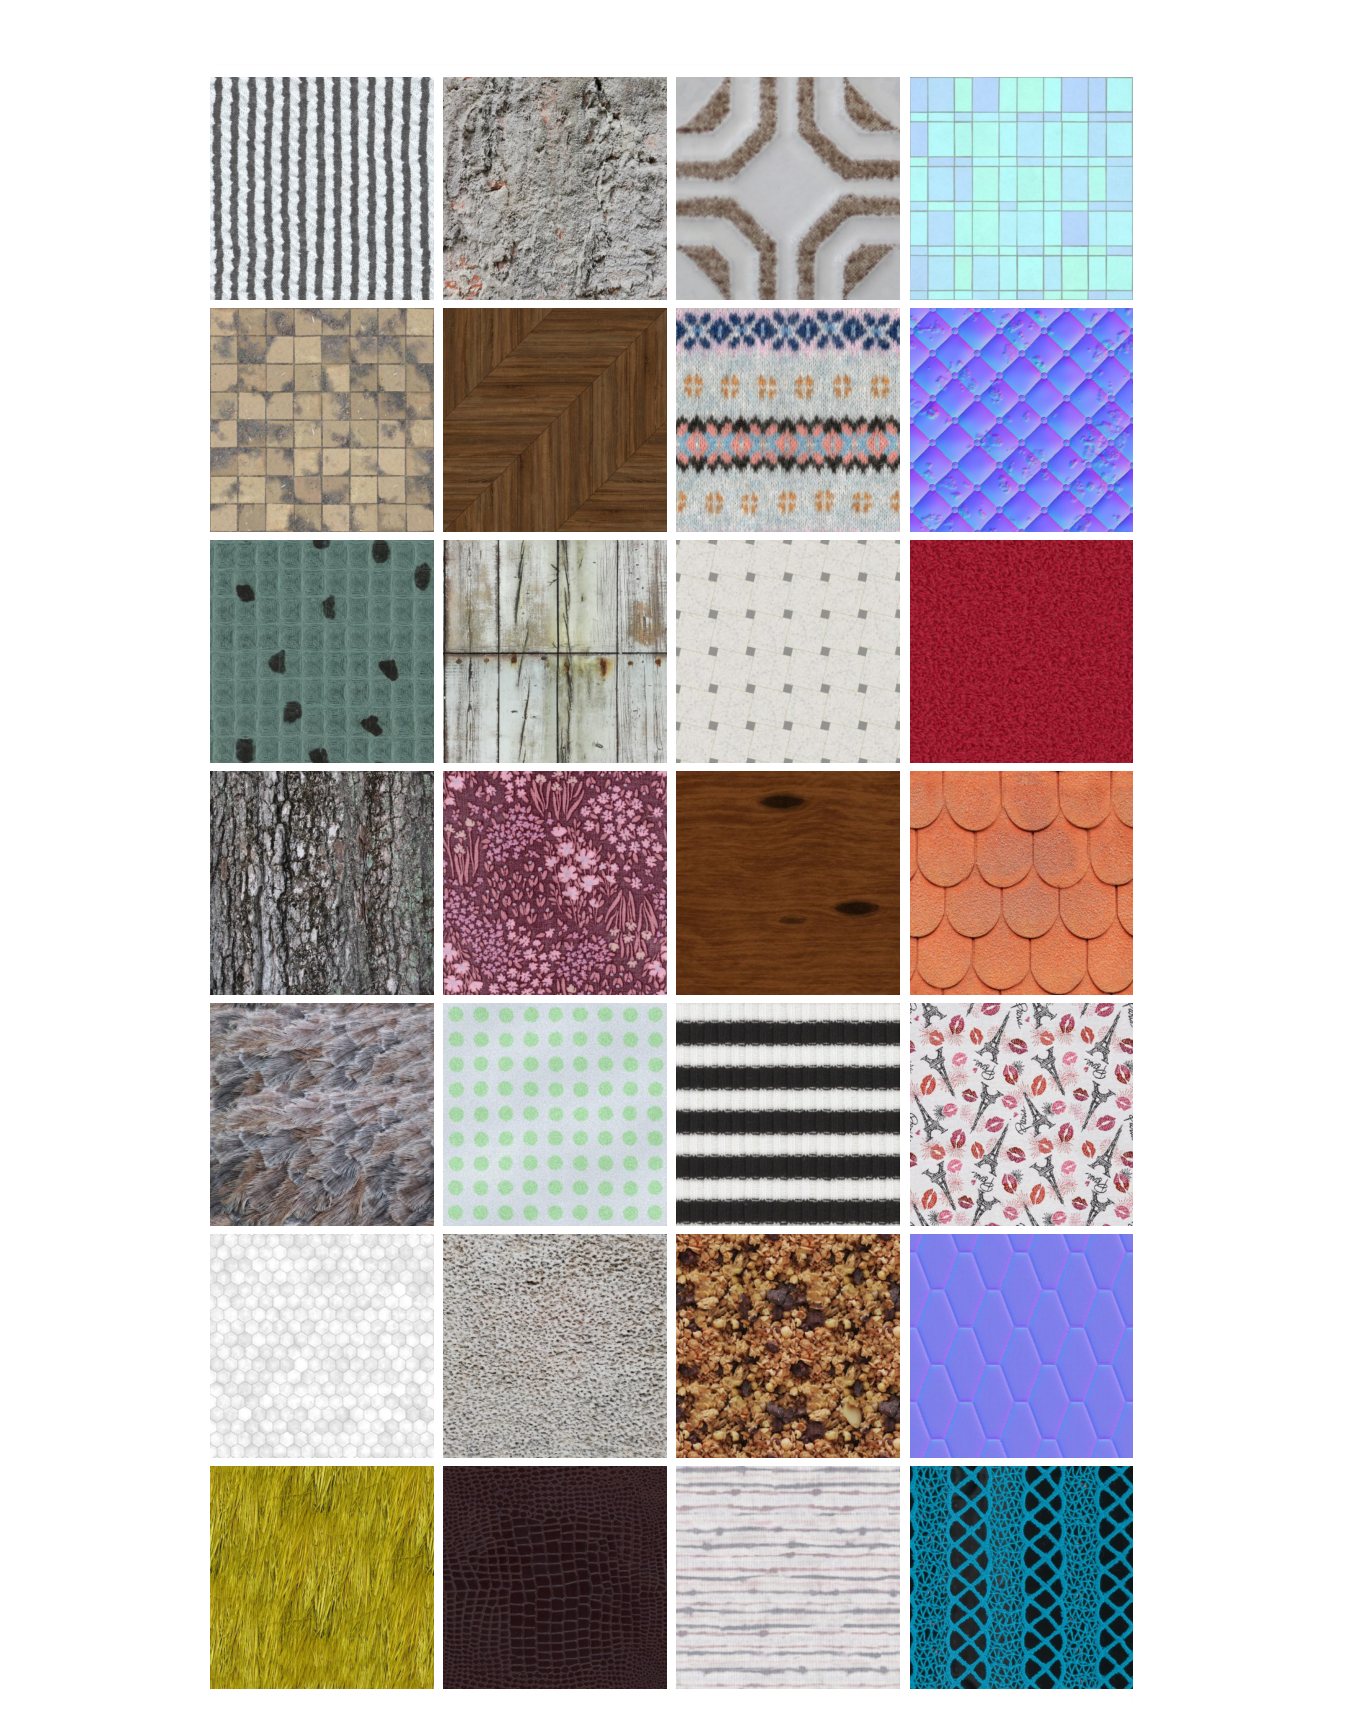
§3.4说留出504正例+504负例作validation,剩余training;若按此扣除,训练为4533正例+21990负例。§3.5又写Bayesian调参validation1000张,评估段落把平衡集合称作test。不能据此自行发明“另有一个完全独立1000张test”,也不能擅自把1008改成1000;独立划分及是否按材质、来源、照明组去重的完整清单没有得到核实。
正例与负例来自不同来源,模型可能学到数据源、类别或拍摄条件而非平铺性。跨域增强和标签转换是作者对这一风险的核心处理,但没有按来源留一测试来完全排除泄漏或域偏差。补充S4/S5展示测试集样本,不能代替完整数据许可证和划分manifest。
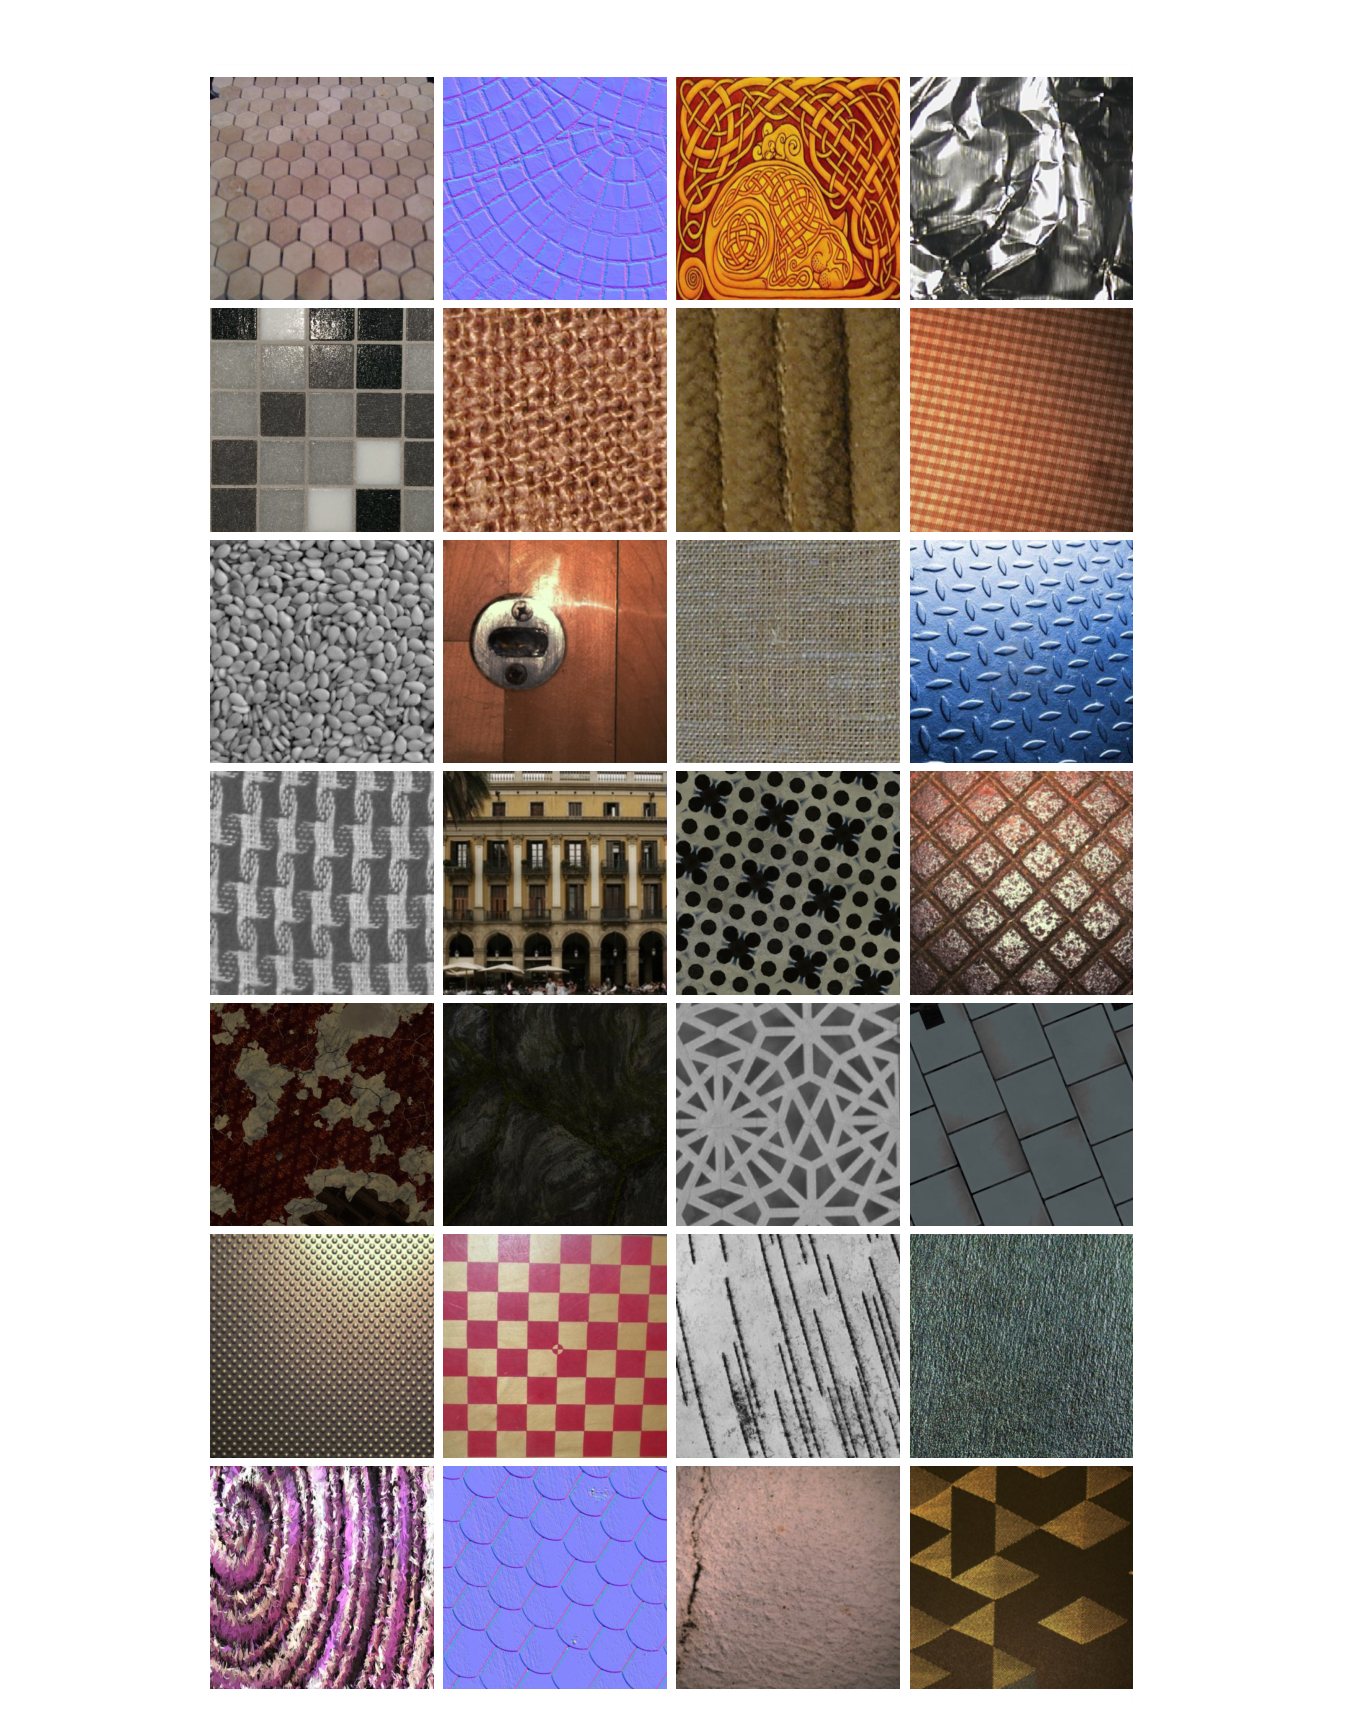
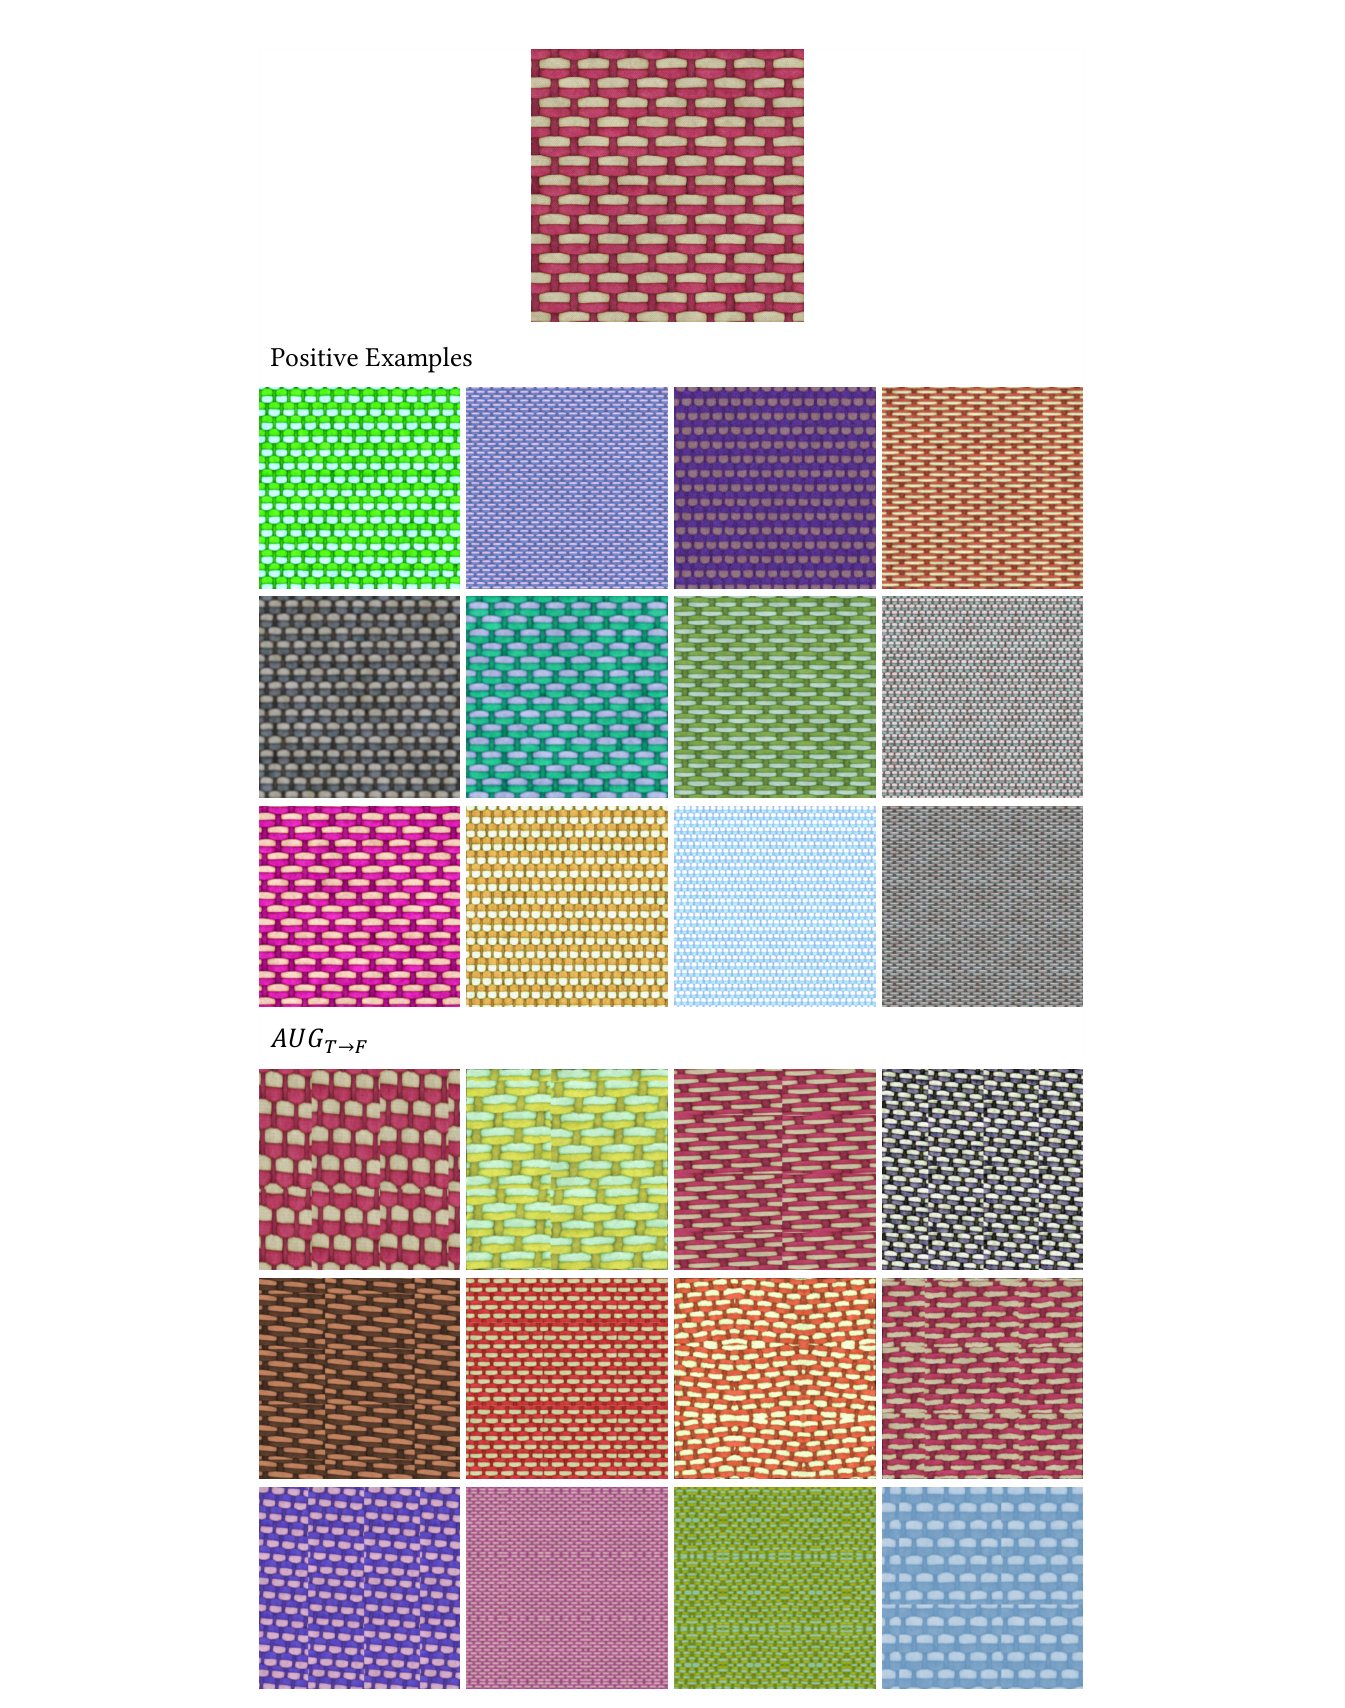
作者区分保持平铺性的操作与破坏平铺性的操作。颜色、翻转、尺度等前者用于正例;旋转、剪切、裁切、薄板样条或弹性扭曲等会改变边界对应,属于后者。负例可以接受两类增强。最后的随机1–5次tiling、缩放和裁切让网络见到不同重复尺度;“保持”是训练策略假设,并非任何具体噪声、裁切或重采样都严格保持边界一致的数学保证。
| 策略 | 补充材料参数 | 概率 |
|---|---|---|
| HSV颜色 | hue完整范围;contrast factor0.4、brightness0.25、saturation0.25 | 1 |
| 非等比缩放 | 横纵分别从(0.6,1.4)取倍率 | 1 |
| 横翻 / 竖翻 | 分别随机 | 各0.5 |
| Gaussian / Box blur | kernel分别7、3 | 各0.15 |
| Gaussian noise | σ=0.05 | 0.15 |
| Equalization | 随机均衡化 | 0.1 |
| Gamma | gamma与gain分别从(0.9,1.1)取值 | 0.2 |
| Elastic | 只对负例,kernel15、σ32 | 0.15 |
| Affine | 只对负例,旋转与shear范围(−20,20) | 0.25 |
| UnFold | 水平与竖直镜像展开 | 0.1 |
| AUG T→F | 对正例施加破坏平铺性的变换,改为负标签 | 0.25 |
| AUG F→F′ | 对负例施加除随机tiling外的增强,作为不含重复伪影的正标签例 | 0.25 |
T→F让正源图也出现负标签,F→F′让负源图也出现正标签,削弱“来源=标签”的捷径。后一策略尤其需要正确理解:它不是证明原本不平铺的图经过任意变换就变成无缝纹理,而是把没有被重复呈现、因而没有显露重复伪影的图标正,训练网络关注展示中的重复问题。最终推理仍需把目标图真的铺成2×2。
镜像UnFold可制造边界连续的样本,但可能引入对称图案,正好提醒我们“无缝”与“没有可见周期伪影”不是严格一致的标签。本文提供消融支持这些策略有用,并没有发布完整增强脚本供逐随机操作复现;Kornia各参数的确切采样语义还依赖版本。

分类学习使用二元交叉熵,网络输出原始logit z。下面是解释该任务的标准logit形式,原文报告BCE误差但没有给出独立训练损失编号:
训练100epochs,NAdam加Lookahead,初始lr0.002,每33epochs减半;batch24,目标正负均衡;混合精度与自动梯度缩放,PyTorch+Kornia,作者报告单RTX3060约6小时。输入384²,评价512²。Bayesian optimization用于超参数选择;未公开足以逐项恢复的训练日志、随机seed、Lookahead细节、NAdam全部参数与scheduler边界,本次不补写猜测默认值。
补充式2试图由标签转换概率计算抽正源图概率。设 \(a=p(\mathrm{AUG}_{T\to F})\)、\(b=p(\mathrm{AUG}_{F\to F'})\),原件印为:
给定a=b=0.25,分母为零,不能按此复现。若a、b分别是条件于原正/负源图的标签翻转概率,按全概率计算增强后正例比例为 \(q(1-a)+(1-q)b\)。要求恰为1/2,得到:
这是本页在明确条件假设下给出的纠正推导,不是宣称已知作者真正运行的采样器。若增强事件相互依赖、顺序不同或概率定义另有条件,仍需原训练实现才能确认。即使q给出期望平衡,随机抽样也不保证每个batch精确12正12负;要逐batch平衡需要显式分层或配额。
| Configuration | Error ↓ | Accuracy ↑ | F1 ↑ | AUC ↑ |
|---|---|---|---|---|
| W/out Pretraining | 0.459 | 0.808 | 0.804 | 0.886 |
| W/out NAdam | 0.096 | 0.965 | 0.966 | 0.992 |
| W/out Look-Ahead | 0.082 | 0.971 | 0.971 | 0.992 |
| W/out Negative Samples | 0.319 | 0.905 | 0.909 | 0.943 |
| W/out Color Aug. | 0.119 | 0.956 | 0.957 | 0.992 |
| W/out Rescales | 0.105 | 0.960 | 0.968 | 0.990 |
| W/out Flips | 0.087 | 0.972 | 0.972 | 0.993 |
| W/out Distortions | 0.094 | 0.966 | 0.966 | 0.987 |
| W/out AUG T→F | 0.121 | 0.960 | 0.961 | 0.990 |
| W/out AUG F→F′ | 0.087 | 0.969 | 0.966 | 0.991 |
| W/out UnFold | 0.082 | 0.970 | 0.971 | 0.992 |
| Final Model | 0.064 | 0.982 | 0.983 | 0.997 |
最显著的因素是预训练:去掉后Error0.459、Accuracy0.808;去掉真实负例、只从正例合成负例,Accuracy降至0.905,说明真实负例的多样性不能由简单破坏边界替代。颜色增强去掉后Error0.119,T→F去掉后0.121;它们对抗数据源和内容捷径具有重要作用。UnFold与Lookahead各自去掉后Error均0.082,属于相对小的增益。
这些是从最终配置逐项删除的消融;表没有独立训练seed均值、标准差或显著性检验。不能把每个0.001级差值解释为确定优势,也不能把Accuracy0.982换成“人类有98.2%同意其平铺评分”。连续T分数的感知间距也没有因二分类准确而获得验证。
Figure4还比较ResNet、VGG、ConvNeXt、SwinV2和加attention的卷积版本。作者观察更大通常更好,Swin例外;ConvNeXt更强,加attention进一步改善,最终Base-Att最低验证BCE。这个架构实验的各点只以图报告,本页保留原图而不捏造每种网络的参数和小数成绩。
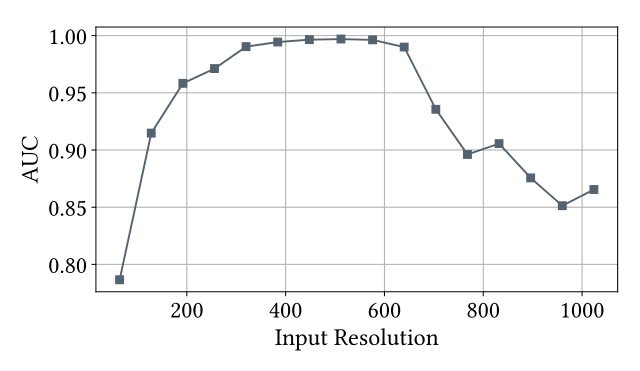
补充评估把平铺后图像分辨率从64到1024变化,以ROC-AUC观察泛化。作者说超过192像素后通常较强,384–640范围最佳;太小可能抹掉边界问题,太大则超出训练尺度。曲线没有给逐点表格,本页不从截图估计精确AUC。
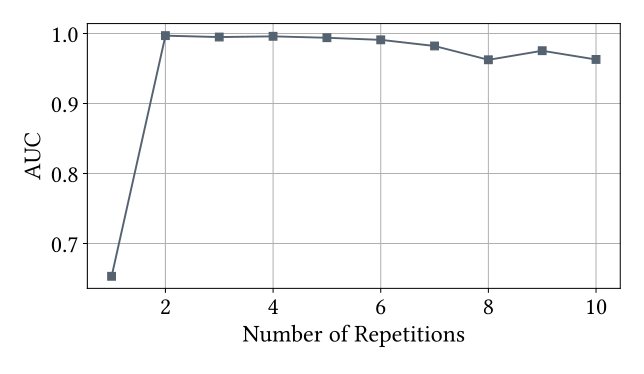
第二项实验保持512²,重复次数从1到10变化,2–6次表现最佳,大于6后开始退化。1次仍好于随机可能说明模型使用照明和对齐线索,但也可能反映数据集偏差,不能仅凭这一点证明已经学到某个具体因果概念。固定512²时重复越多,每个tile细节越小,尺度和次数的效应存在耦合。
默认2×2是计算与可见接缝之间的实用选择。比较不同系统时必须固定tile数、最终分辨率、缩放方法和归一化;否则分数差可能来自输入处理而非平铺改善。补充正文把第二曲线也引用成Figure2,实际编号为S3,本页分开保留。
主文Figure5给出10个由低到高的分数:0.013、0.059、0.089、0.217、0.531、0.572、0.652、0.819、0.821、0.969。前两张明显边缘不连续;随后几张只有一轴连续;后五张虽然边缘无缝,模型仍关注不均匀阴影、异常物体或重复结构。此排序是选定示例的观察,不是大规模人类排序实验。

作者使用axiom-based Grad-CAM方法;主文写作“Axion-Based”是名称拼写问题,参考文献为Axiom-based Grad-CAM。热区说明在给定解释算法下哪些位置影响输出,不等于因果机制已被验证。还需要遮挡、替换和受控干预才能排除模型只是利用相关线索。补充S21/S22分别展示不可平铺与可平铺样本的显著图。
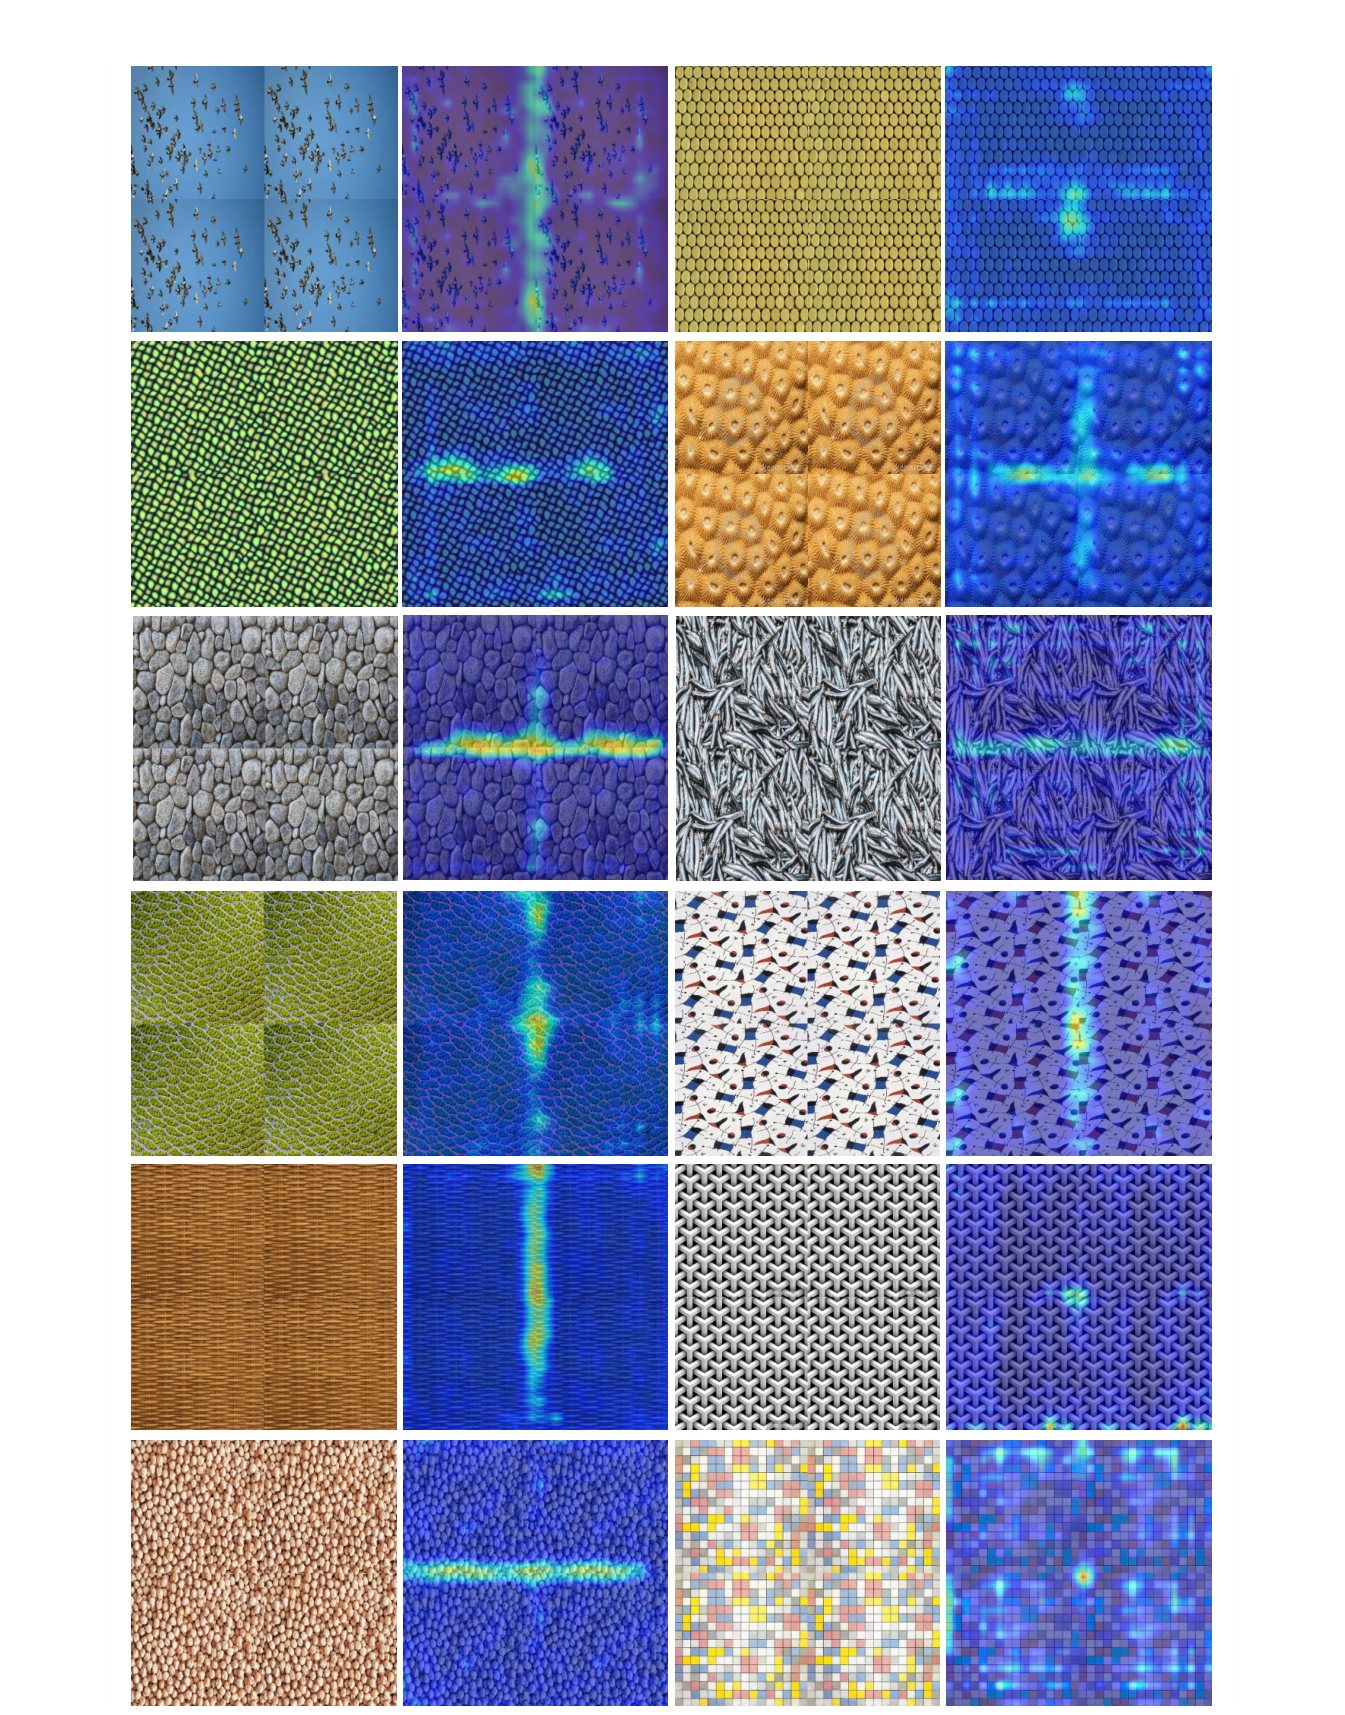
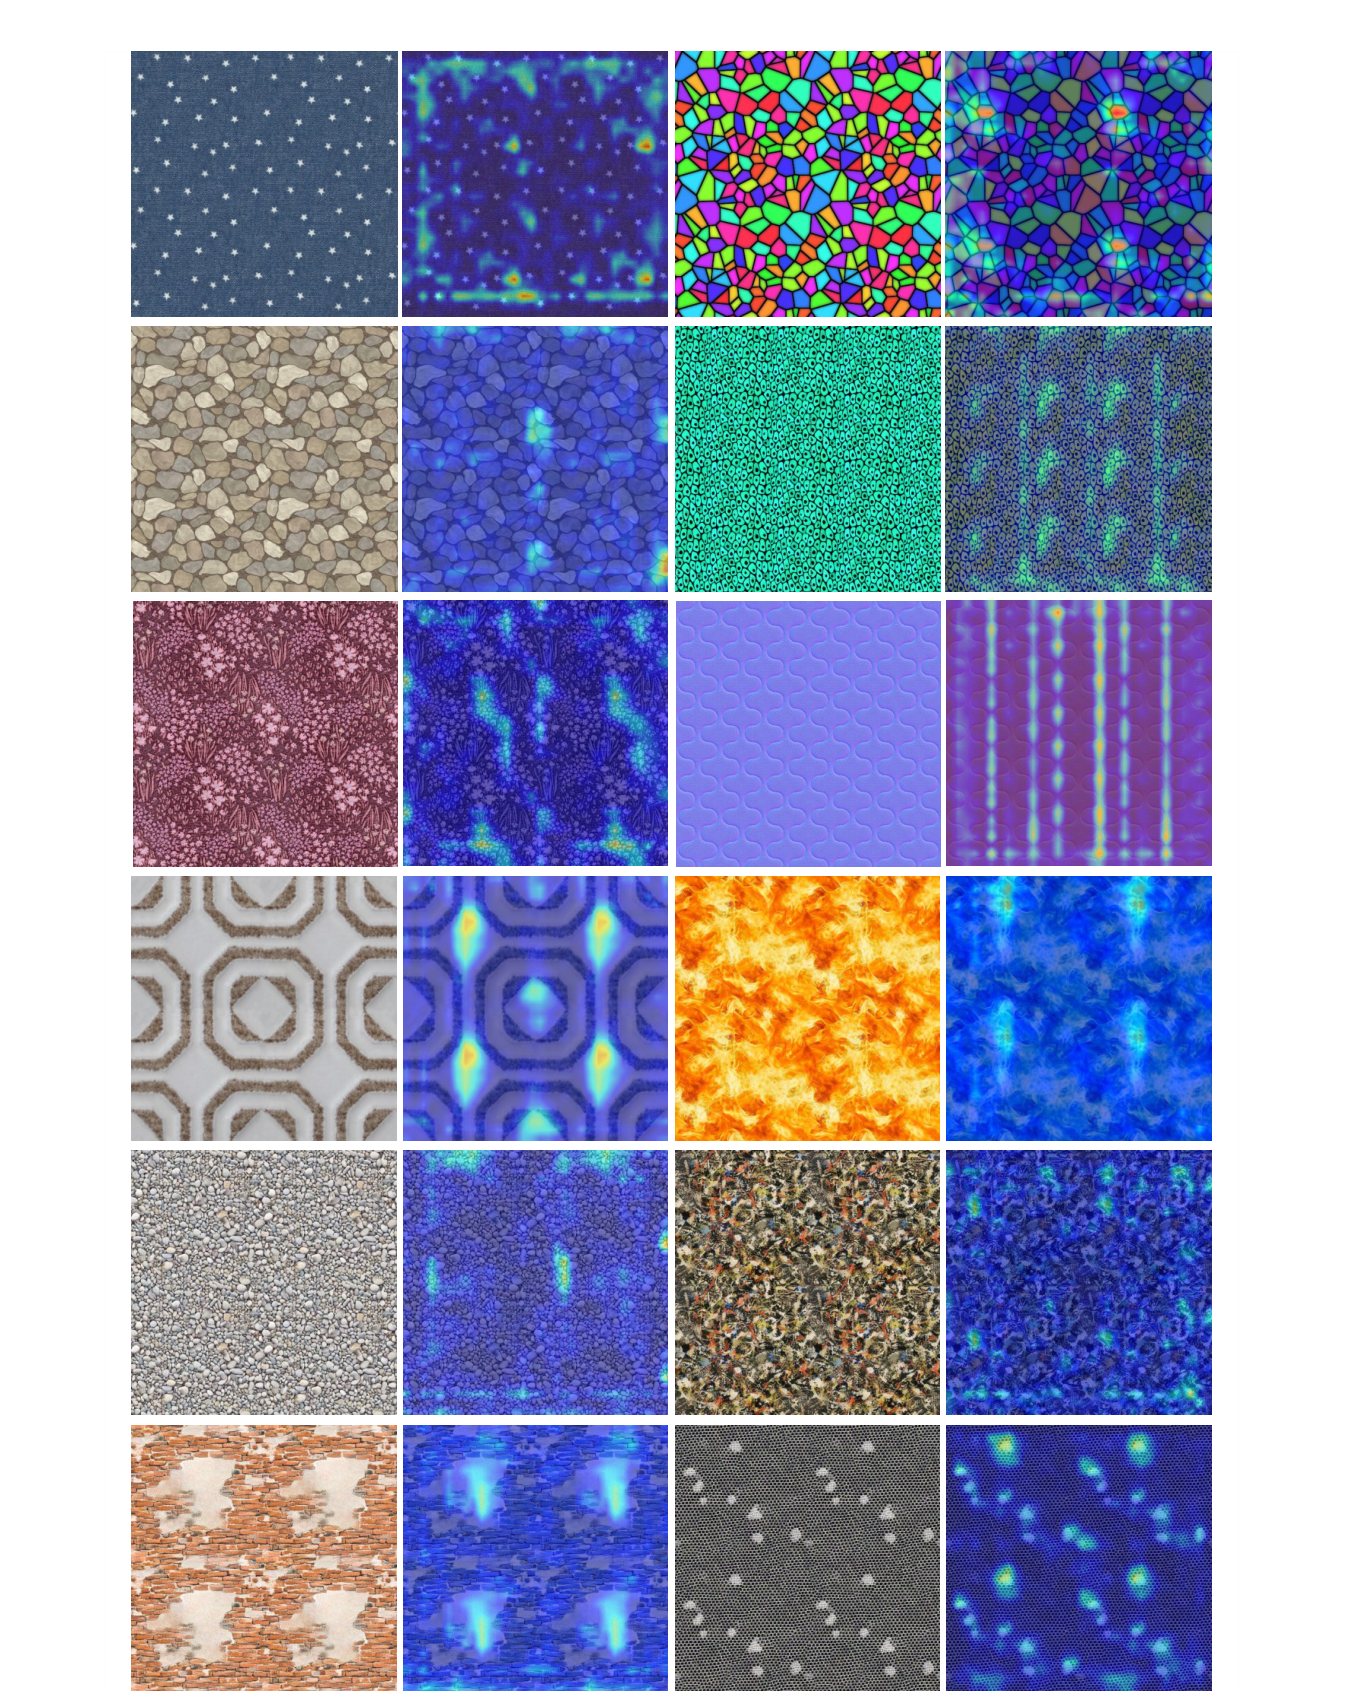
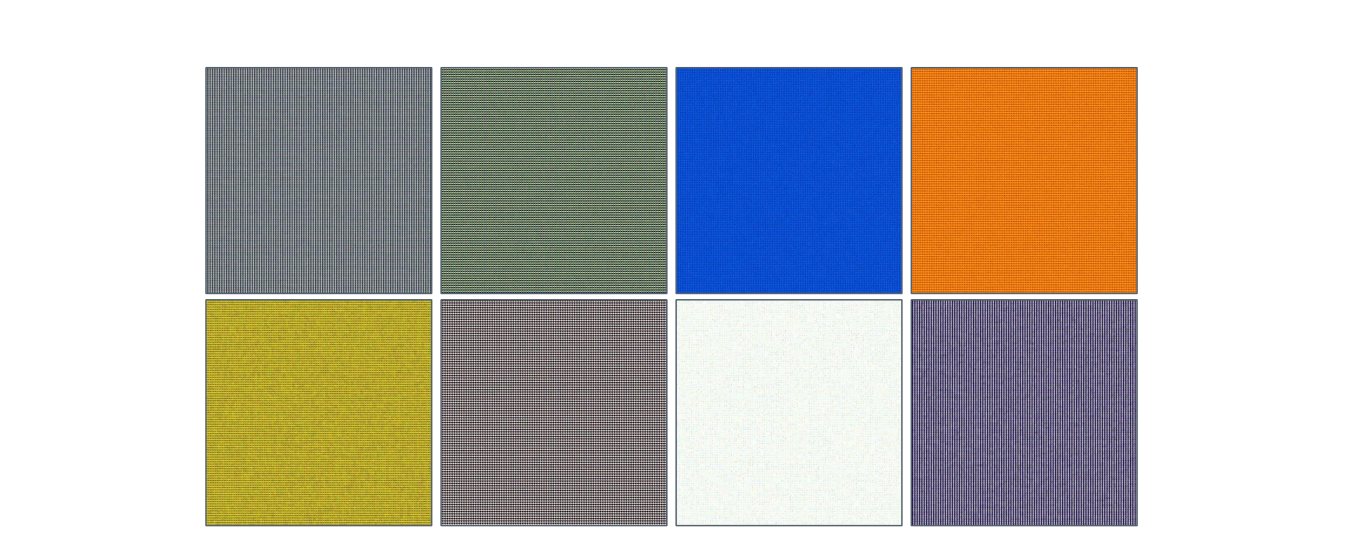
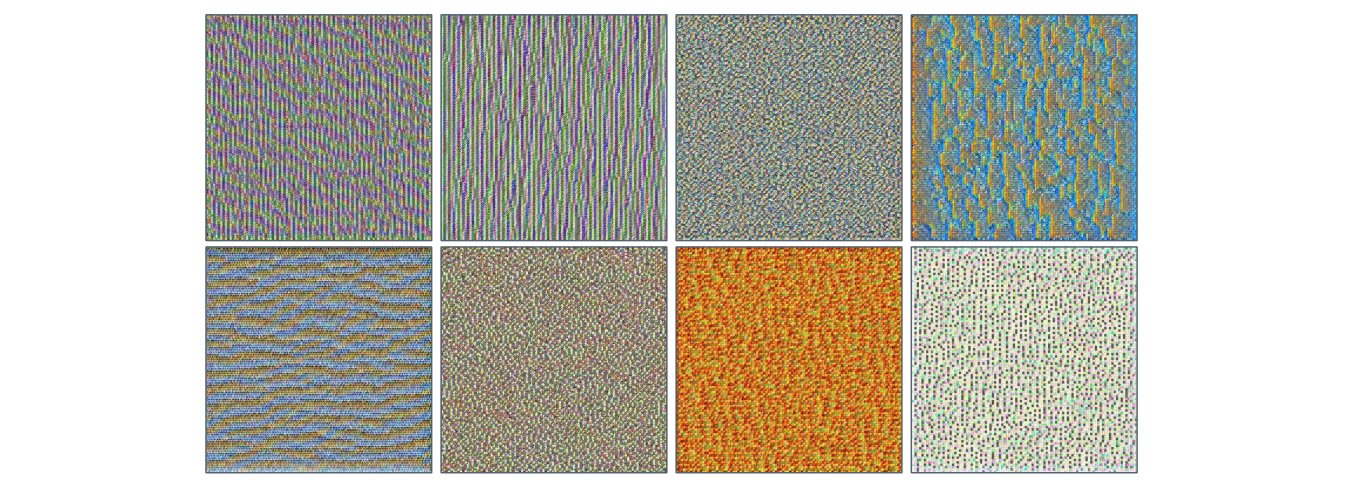
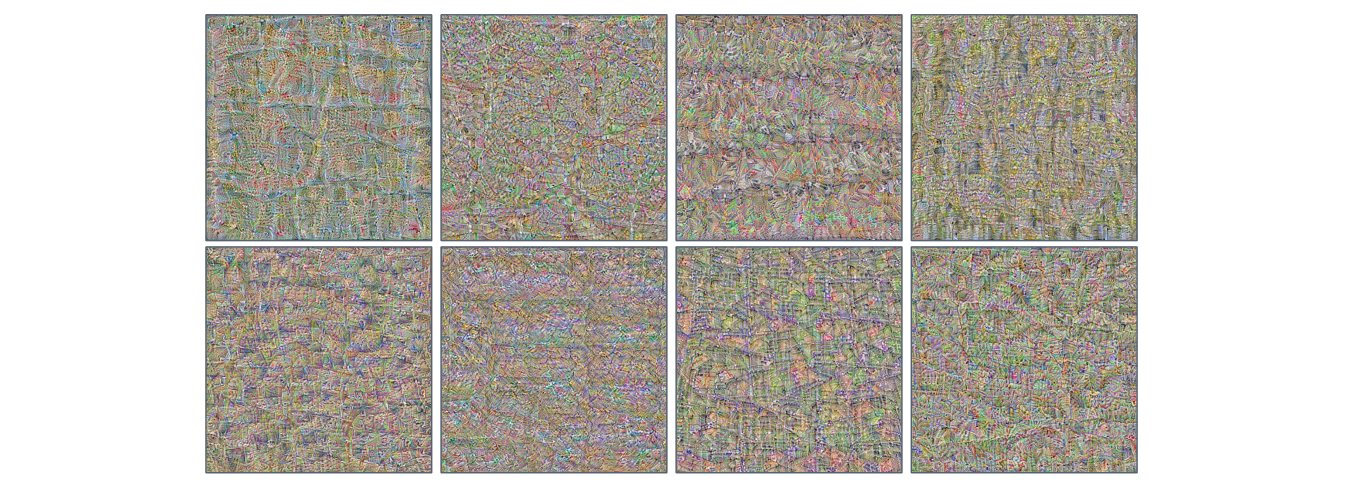
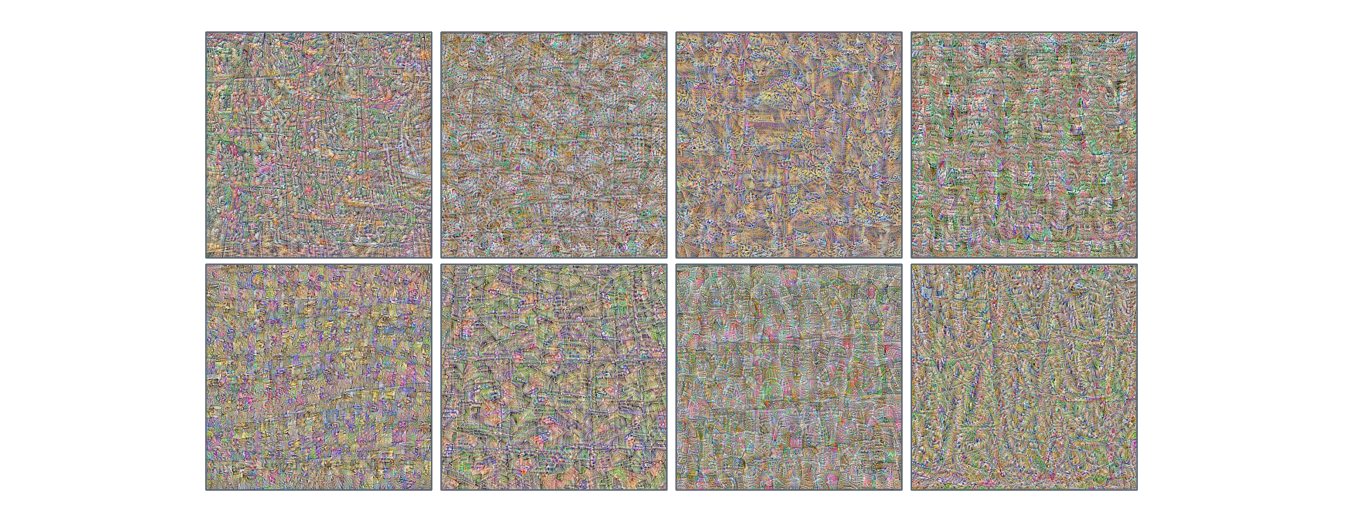
补充S23–S34是通过输入优化得到的滤波器可视化,作者另加梯度裁剪、weight decay来改善可视化效果。图注从局部颜色和边缘、局部纹理,到深层更大范围网格或抽象结构描述特征;这些图不是训练数据重构,也不代表每个滤波器只有图注所说的一种语义。完整保留如下:
| Distance | Error ↓ | Accuracy ↑ | F1 ↑ | AUC ↑ |
|---|---|---|---|---|
| FID [27] | 0.568 | 0.703 | 0.699 | 0.764 |
| GS [31] | 0.694 | 0.507 | 0.533 | 0.510 |
| MSID [61] | 0.797 | 0.582 | 0.544 | 0.503 |
| TexTile | 0.064 | 0.982 | 0.983 | 0.997 |
作者不是把FID直接当作单张图的TexTile分数,而是先对可平铺与不可平铺训练集合取特征,再把测试集的随机子集分别与两个训练分布比较,按照更近者分类。FID结果Accuracy0.703;GS0.507接近随机,MSID0.582;直接监督平铺性后的TexTile为0.982。
这说明现成分布距离不擅长这个下游判别协议,但不意味着FID本来的生成分布质量任务失效,也不能忽略TexTile使用了任务标签而几个距离没有专门训练。子集大小、如何把距离转成BCE可用概率、完整特征设置未给足,本页不把表中Error当成未经转换的原始FID值。
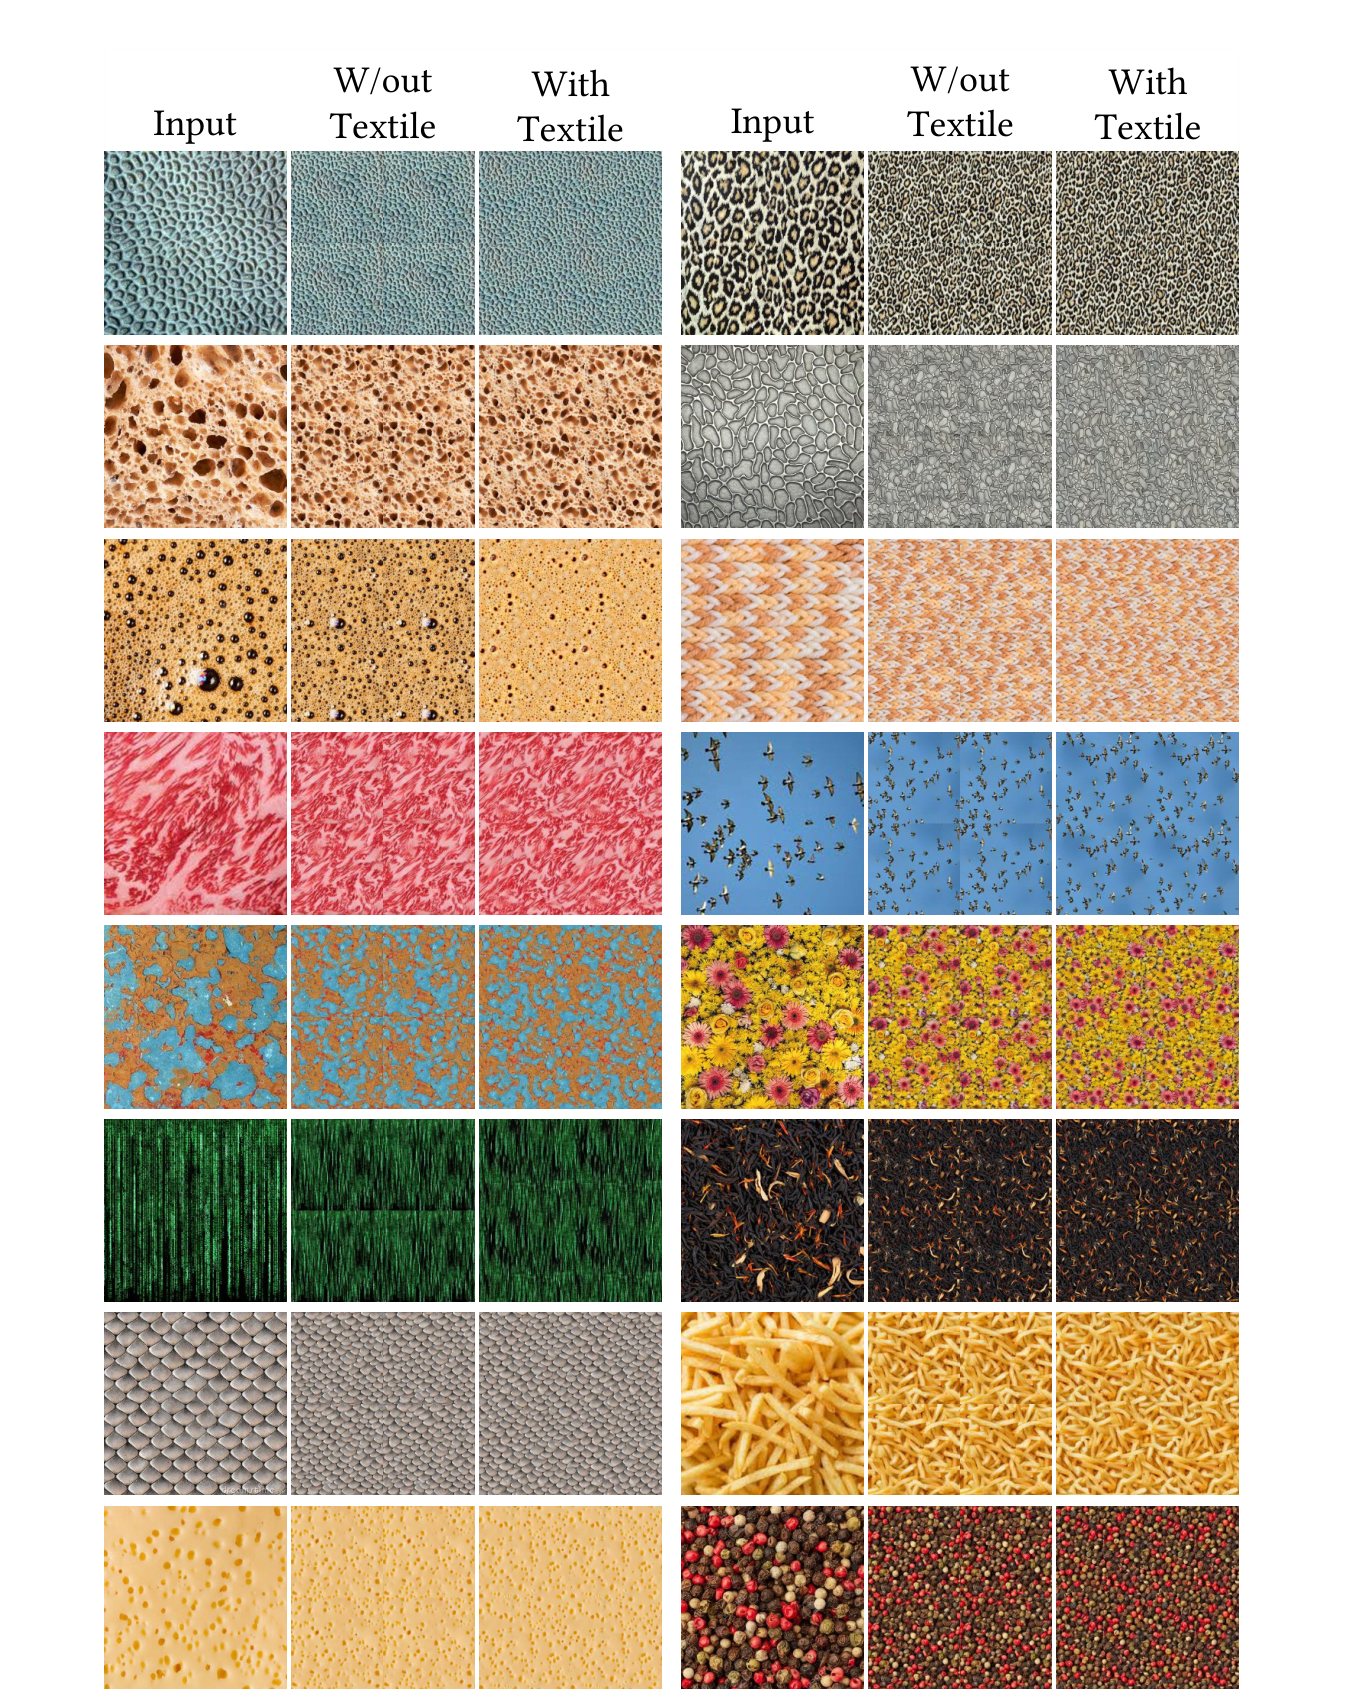
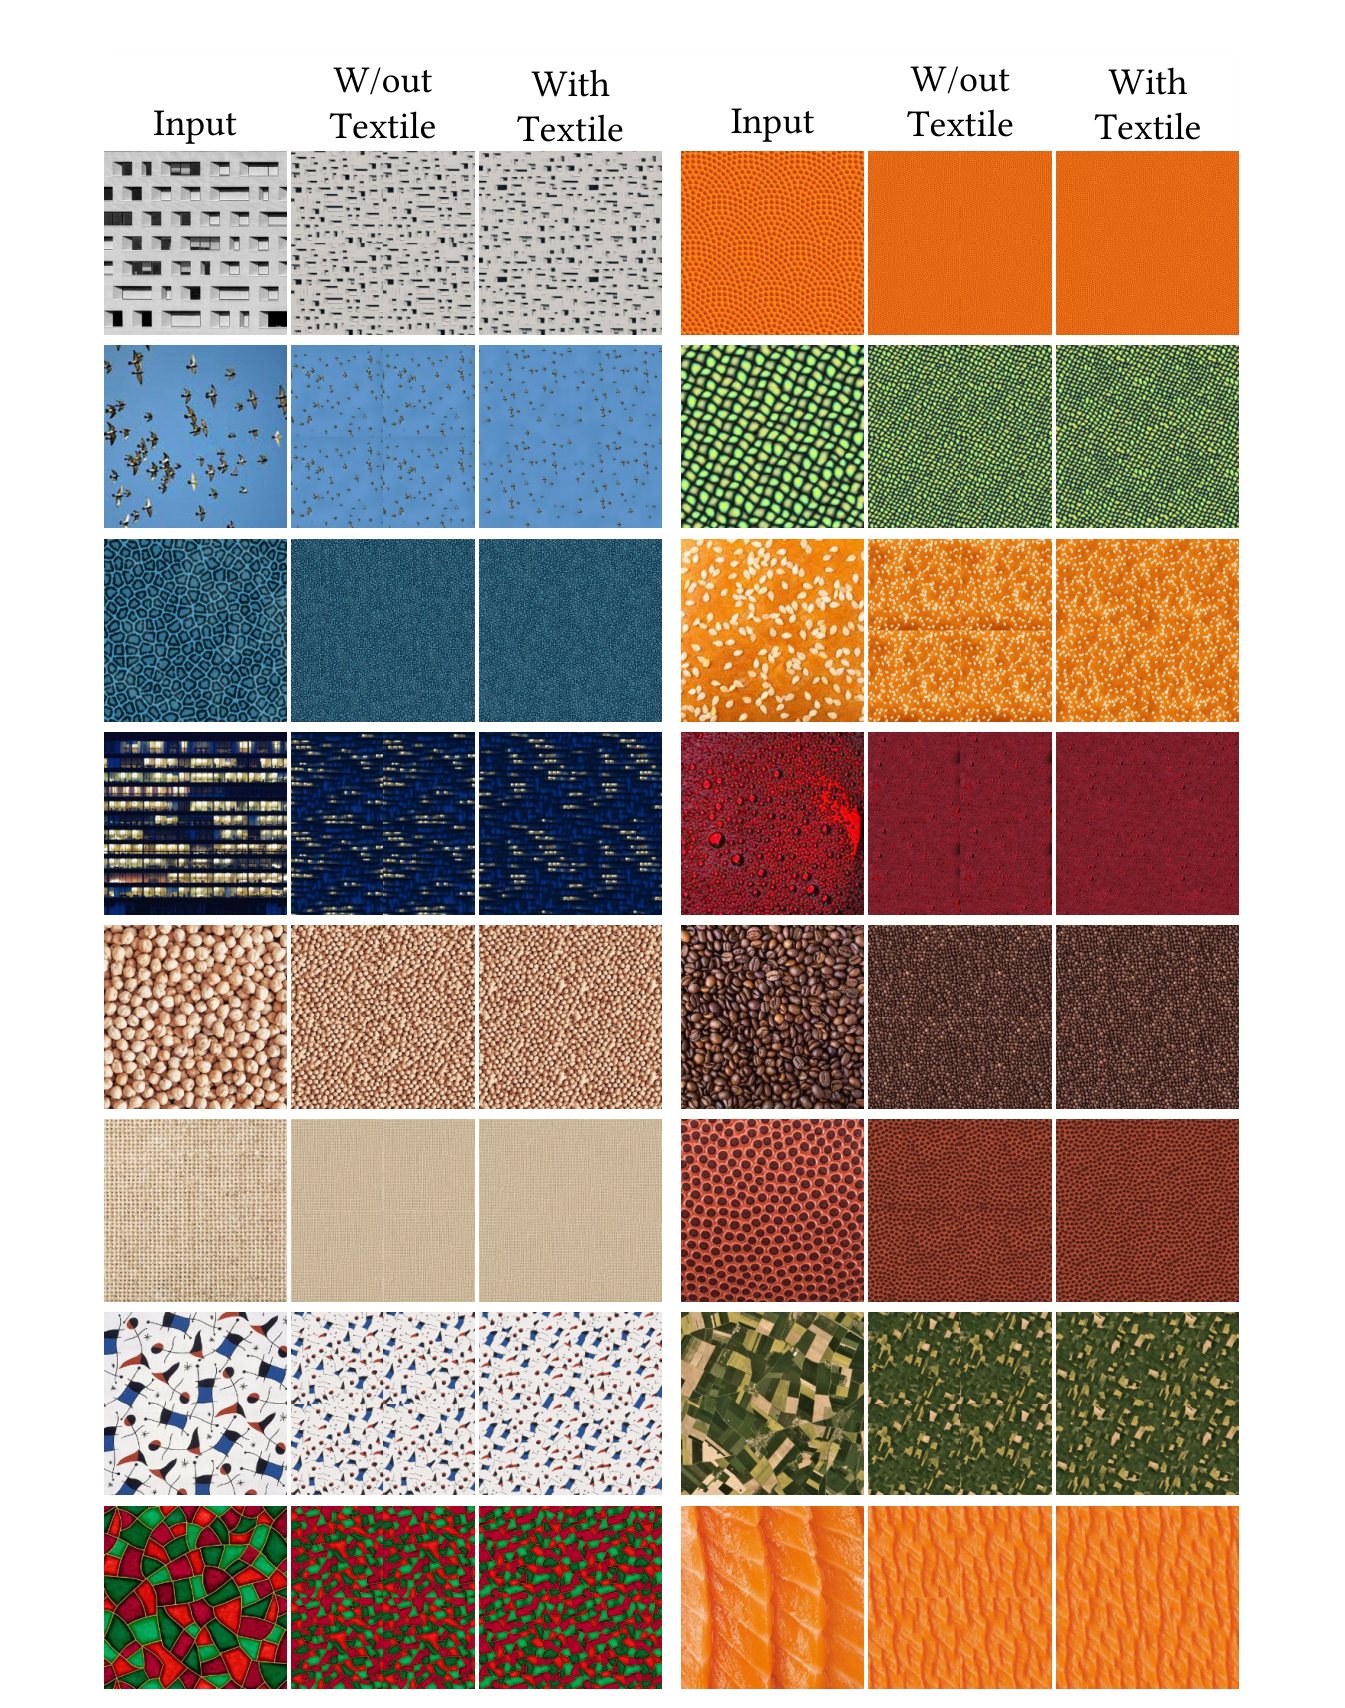
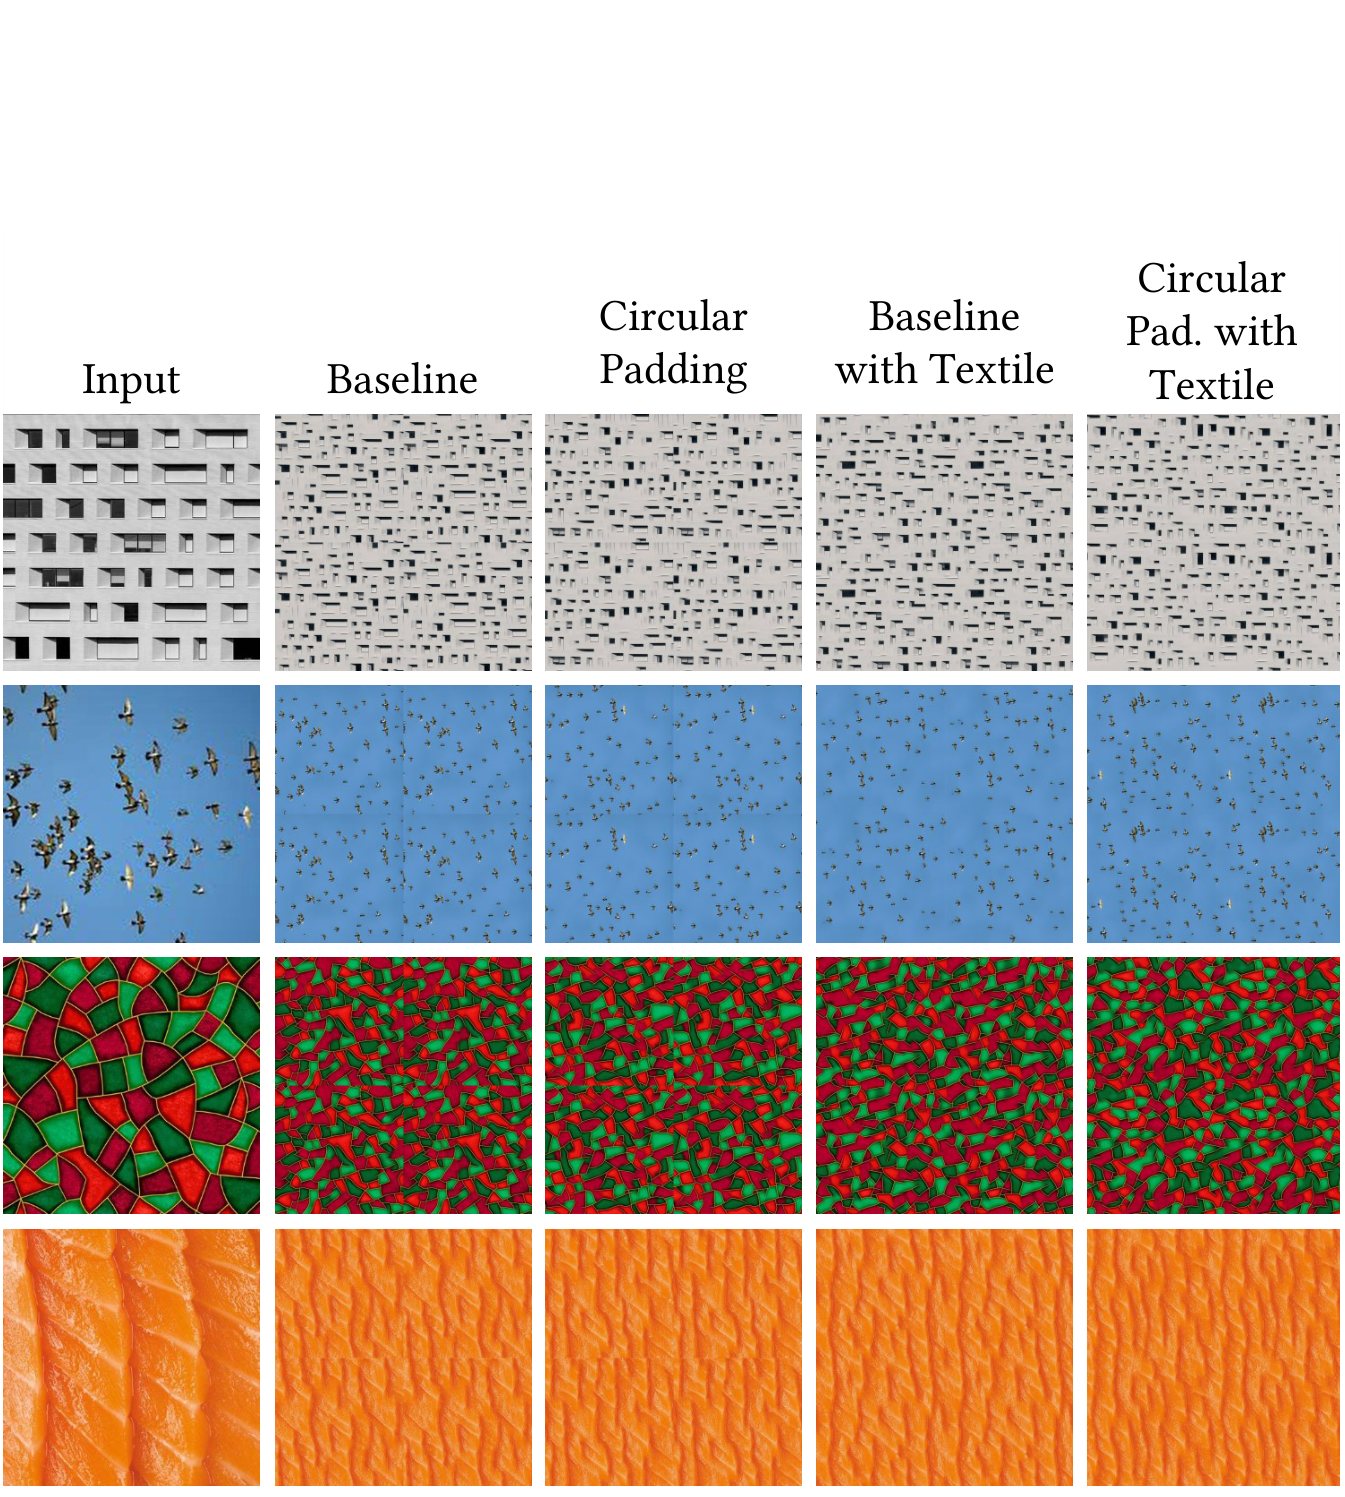
实验使用SeamlessGAN工作中的14张纹理,比较传统混合、图割、重复图案提取、PSGAN、自组织纹理、SeamlessGAN,以及Heitz神经纹理合成和SinFusion的原版/加TexTile版本。8列指标的方向分别保留,不能把所有数值统一解释为越大越好。
| Method | SSIM ↑ | Si-FID ↓ | LPIPS ↓ | DISTS ↓ | PieAPP ↓ | BRISQUE ↓ | CLIP-IQA ↑ | TexTile ↑ |
|---|---|---|---|---|---|---|---|---|
| Deloit et al. [11] | 0.138 | 1.707 | 0.595 | 0.372 | 2.289 | 49.43 | 0.407 | 0.639 |
| Li et al. [36] | 0.149 | 0.981 | 0.559 | 0.341 | 1.672 | 45.84 | 0.437 | 0.707 |
| Rodriguez-Pardo et al. [54] | 0.171 | 0.969 | 0.594 | 0.361 | 1.890 | 43.14 | 0.661 | 0.403 |
| Bergmann et al. [5] | 0.148 | 0.981 | 0.579 | 0.359 | 1.789 | 44.13 | 0.638 | 0.675 |
| Niklasson et al. [48] | 0.146 | 0.819 | 0.623 | 0.446 | 2.292 | 53.99 | 0.435 | 0.731 |
| Rodriguez-Pardo et al. [53] | 0.166 | 0.694 | 0.540 | 0.336 | 1.542 | 51.10 | 0.452 | 0.729 |
| Heitz et al. [25] w/out TexTile | 0.140 | 1.741 | 0.575 | 0.329 | 1.687 | 49.05 | 0.376 | 0.431 |
| Heitz et al. [25] with TexTile | 0.152 | 1.764 | 0.555 | 0.327 | 1.653 | 48.49 | 0.392 | 0.781 |
| Nikankin et al. [47] w/out TexTile | 0.172 | 1.314 | 0.591 | 0.386 | 1.963 | 55.96 | 0.408 | 0.388 |
| Nikankin et al. [47] with TexTile | 0.189 | 1.415 | 0.569 | 0.387 | 1.926 | 56.99 | 0.396 | 0.798 |
加入TexTile后,Heitz方法的TexTile从0.431到0.781,SSIM/LPIPS/DISTS/PieAPP/BRISQUE/CLIP-IQA也略改善,但Si-FID从1.741到1.764变差。SinFusion的TexTile从0.388到0.798,SSIM与LPIPS/PieAPP改善,但Si-FID1.314→1.415、DISTS0.386→0.387、BRISQUE55.96→56.99、CLIP-IQA0.408→0.396均朝不利方向变化。
因此作者“保持或改善总体质量”的总结应理解为总体定性判断和多指标权衡,不能表述成所有感知指标都改善。更重要的是,优化TexTile后再用TexTile评分存在目标重用,较高数值本身不构成独立有效性验证,需要未参与优化的评价、边界误差或人类判断作为补充。
14张是小规模合成基准,与分类数据集规模完全不同。Table3没有给跨训练seed方差、每类纹理分组统计或用户研究,不据此宣布适用所有材质。主文Figure8展示4个例子;补充S7/S8给完整14图比较面板,包含所有10种方法结果。


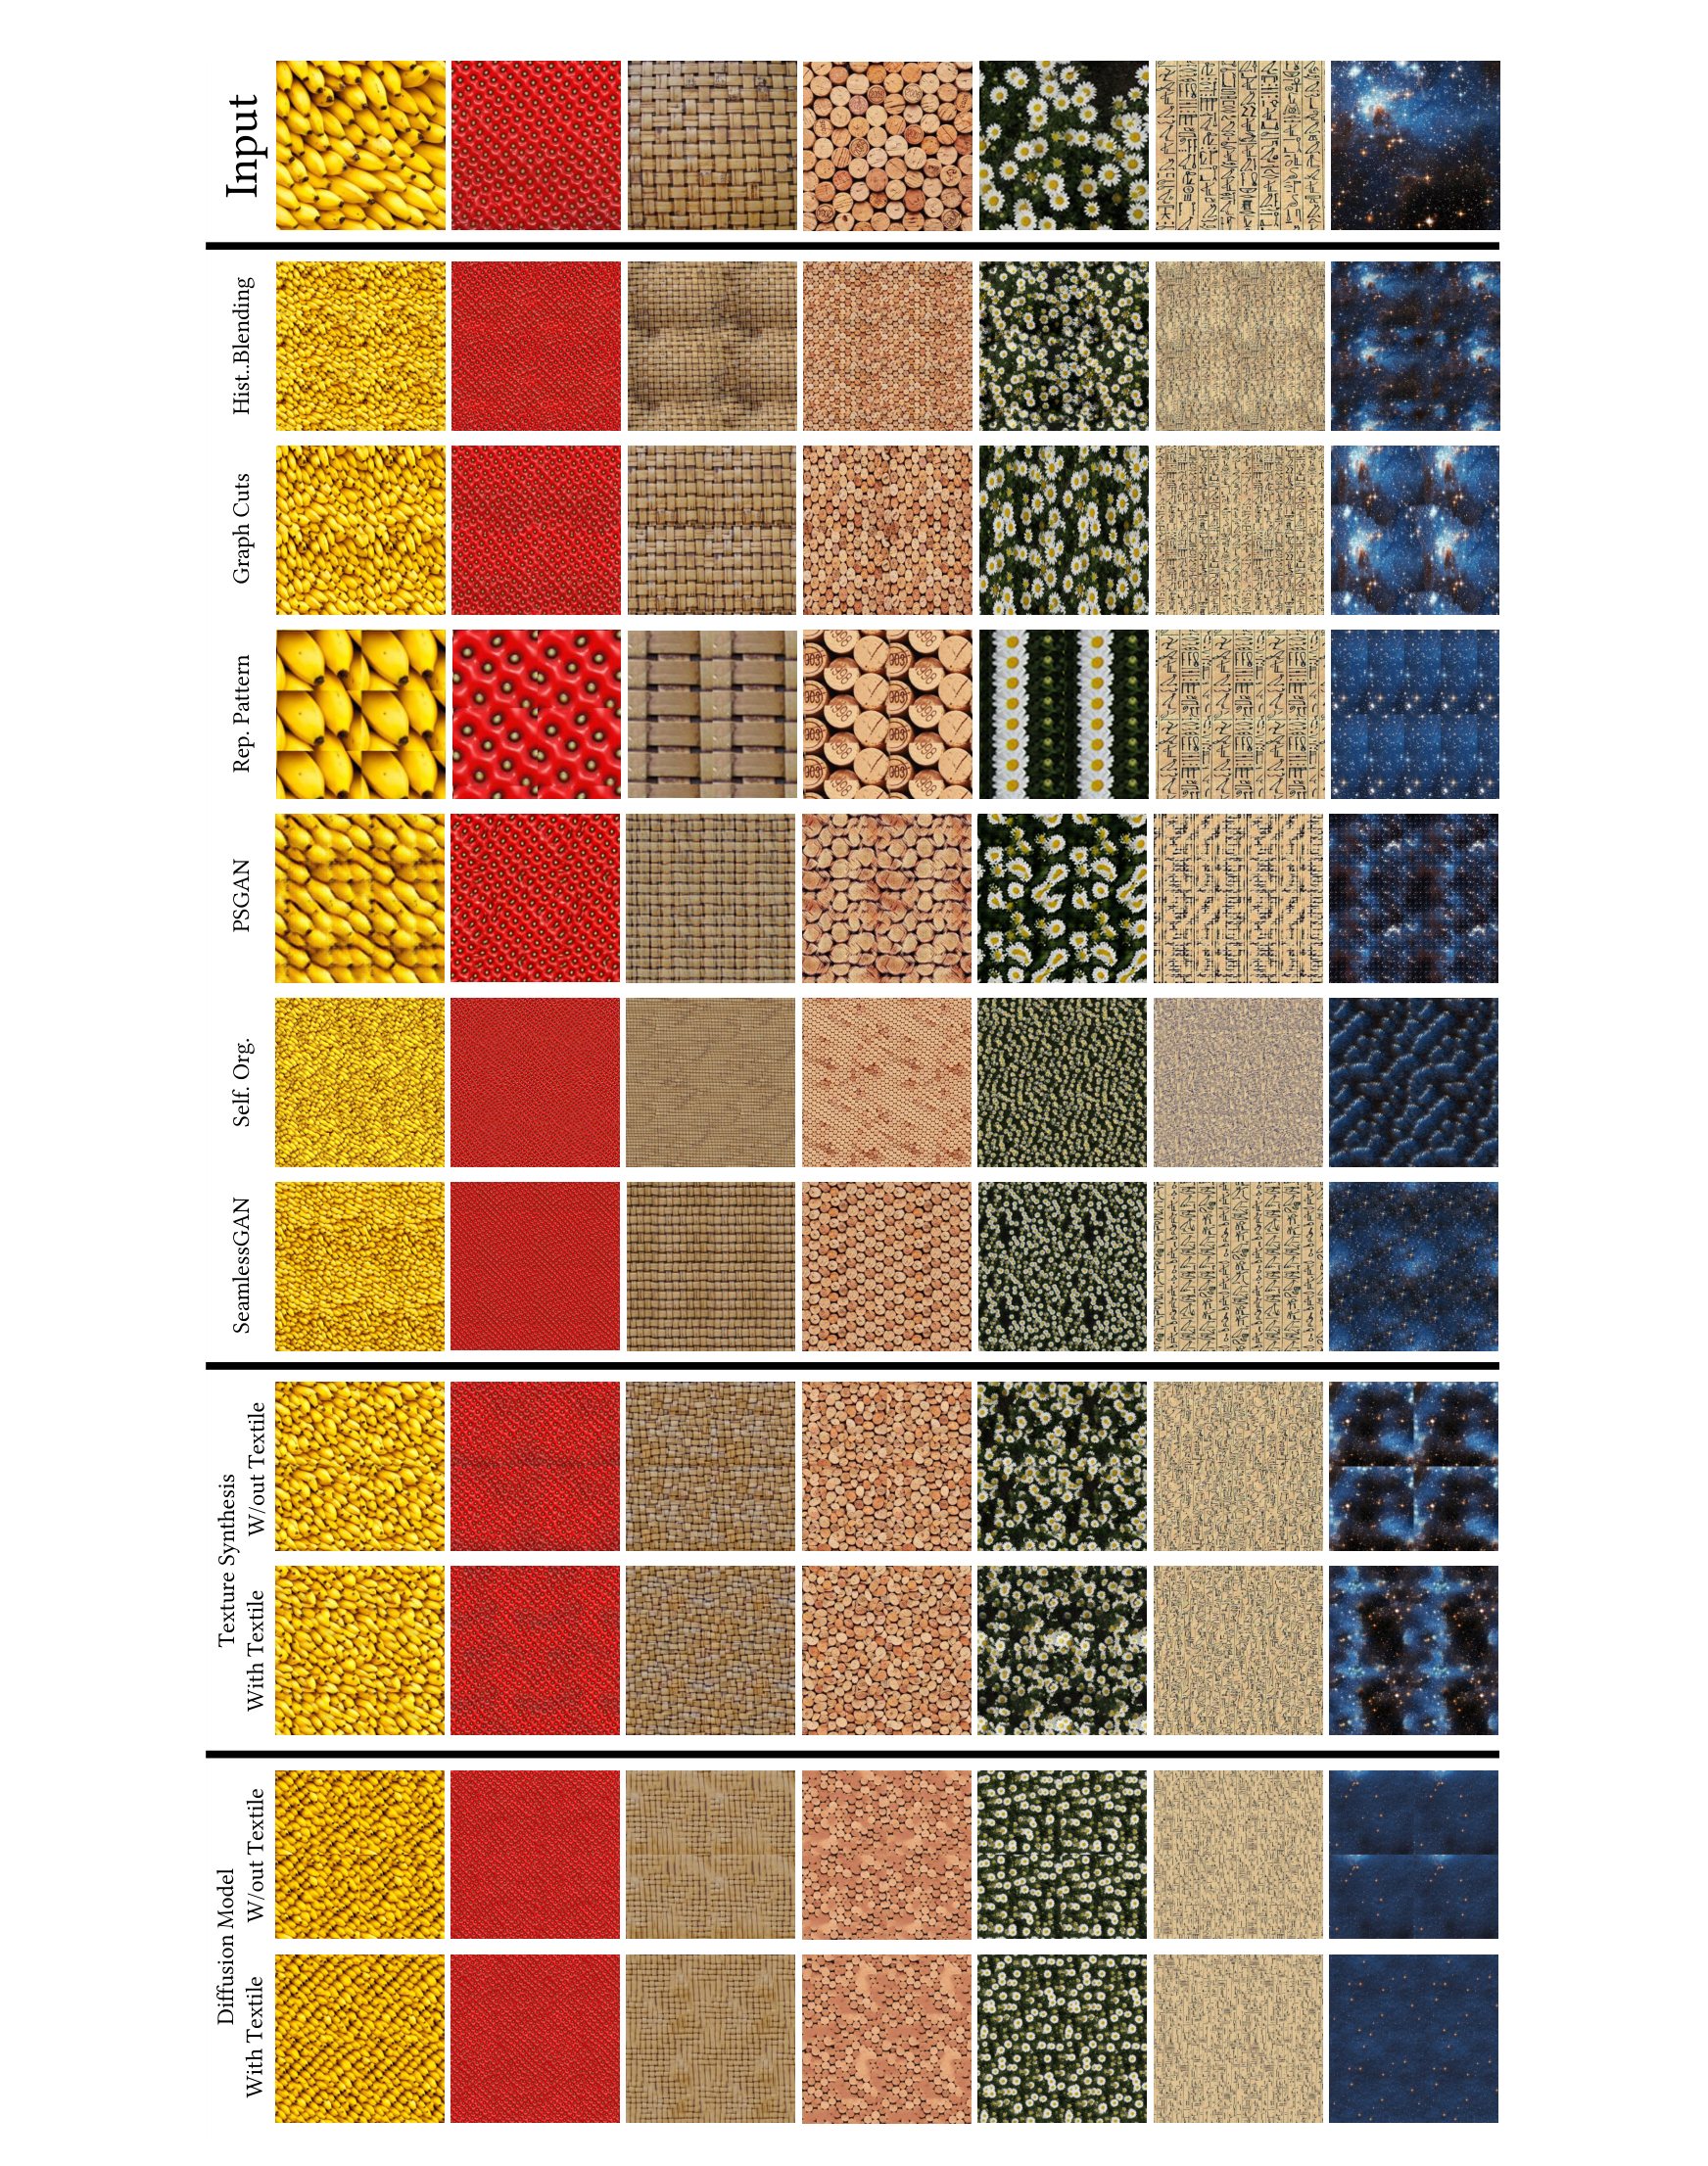
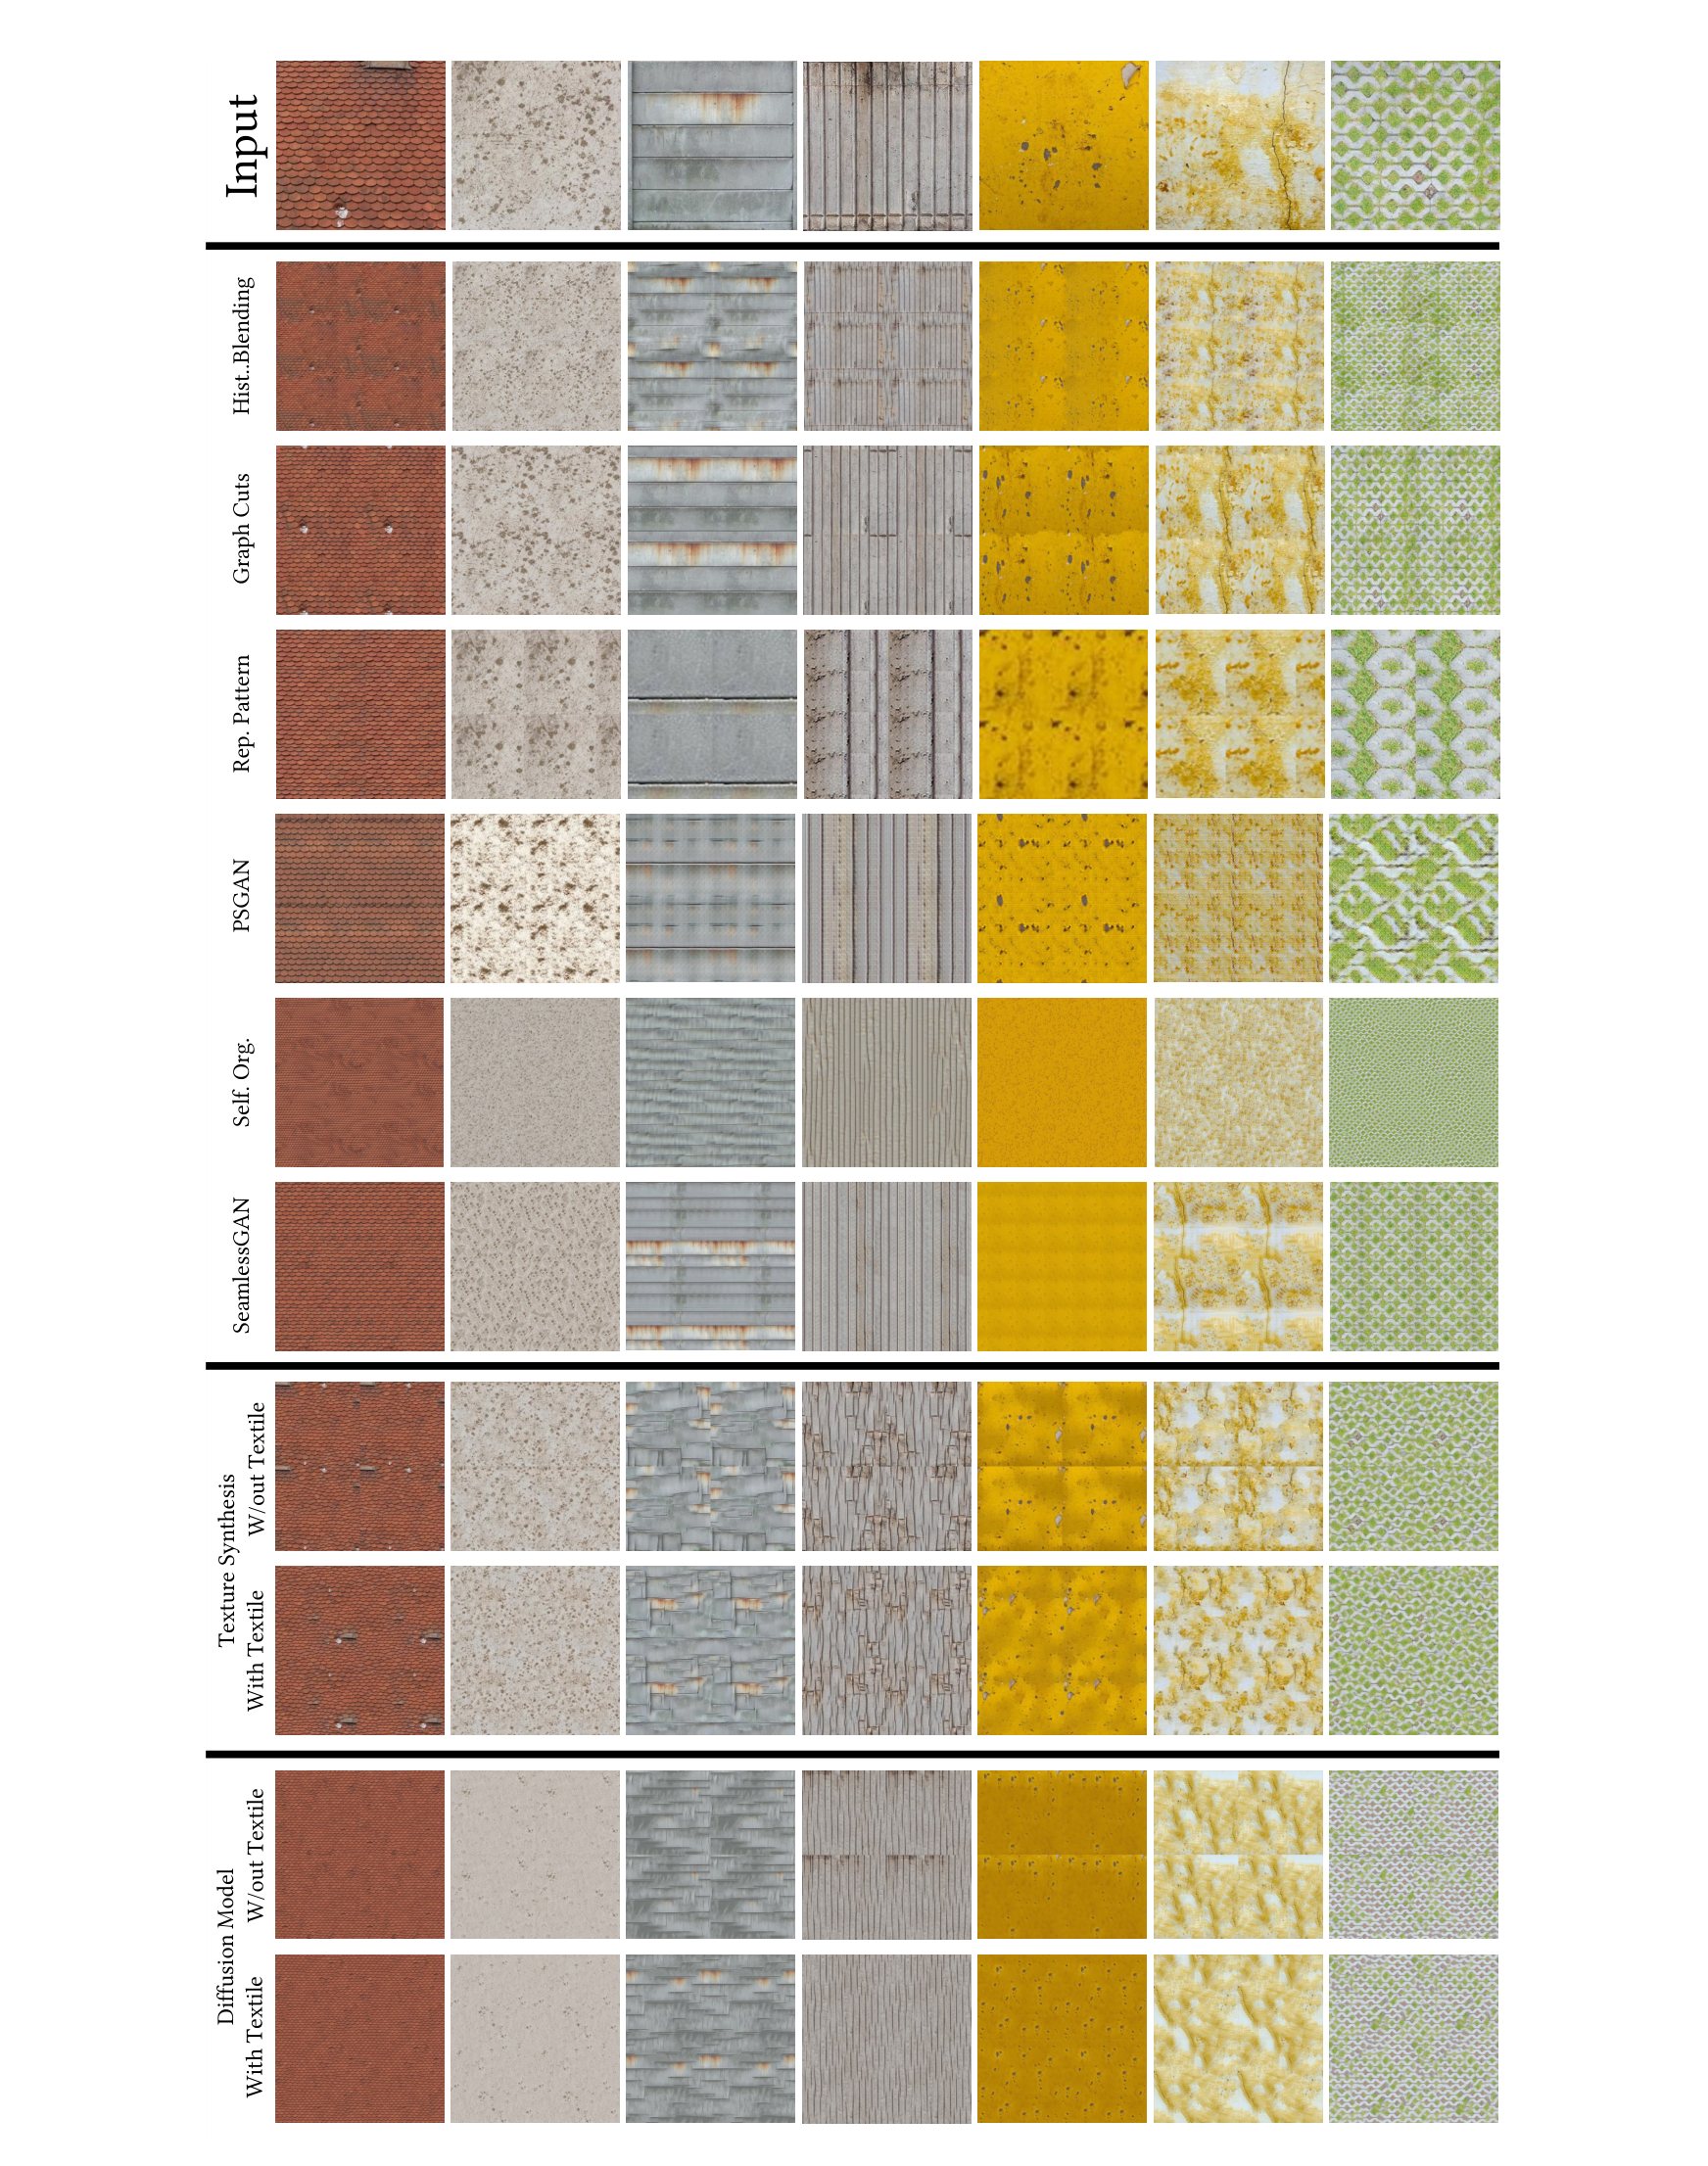
还有一个文献对应问题:图中的Graph Cuts标签关联主文[36]/补充[7],但两处参考条目的题名是Li等的复杂室内逆渲染论文。这里保留原Table3的Li et al.行与原图标签,并将引用不匹配列为待核查,没有替作者换成另一篇猜测的Graphcut文献。原表把Deliot姓印成Deloit,本页表中同样保留其原行标识。
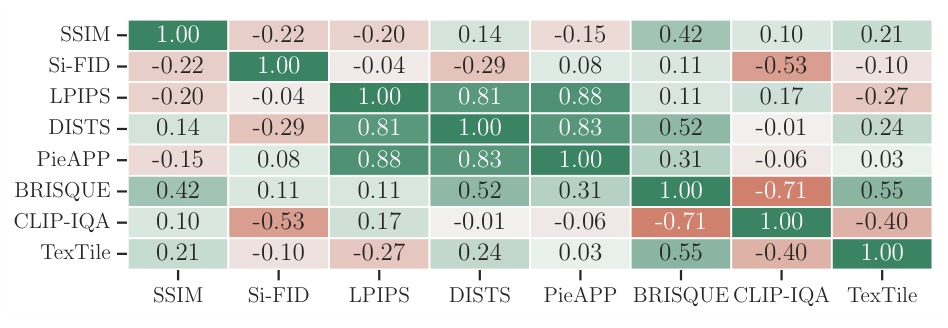
| Metric | SSIM | Si-FID | LPIPS | DISTS | PieAPP | BRISQUE | CLIP-IQA | TexTile |
|---|---|---|---|---|---|---|---|---|
| SSIM | 1.00 | -0.22 | -0.20 | 0.14 | -0.15 | 0.42 | 0.10 | 0.21 |
| Si-FID | -0.22 | 1.00 | -0.04 | -0.29 | 0.08 | 0.11 | -0.53 | -0.10 |
| LPIPS | -0.20 | -0.04 | 1.00 | 0.81 | 0.88 | 0.11 | 0.17 | -0.27 |
| DISTS | 0.14 | -0.29 | 0.81 | 1.00 | 0.83 | 0.52 | -0.01 | 0.24 |
| PieAPP | -0.15 | 0.08 | 0.88 | 0.83 | 1.00 | 0.31 | -0.06 | 0.03 |
| BRISQUE | 0.42 | 0.11 | 0.11 | 0.52 | 0.31 | 1.00 | -0.71 | 0.55 |
| CLIP-IQA | 0.10 | -0.53 | 0.17 | -0.01 | -0.06 | -0.71 | 1.00 | -0.40 |
| TexTile | 0.21 | -0.10 | -0.27 | 0.24 | 0.03 | 0.55 | -0.40 | 1.00 |
LPIPS、DISTS和PieAPP互相关系强,0.81/0.88/0.83符合它们共同关注参考相似性的任务。TexTile与LPIPS−0.27、DISTS0.24、PieAPP0.03、SSIM0.21、Si-FID−0.10,没有一致关系。不能把几种不同任务的度量不相关,直接等同于某个度量“错误”。
尤其要看指标方向:TexTile与BRISQUE的Pearson r=+0.55,但BRISQUE越低越好;与CLIP-IQA为−0.40,而CLIP-IQA越高越好。所以这两个相关符号在原分数方向上并不意味着“平铺性越好,总体画质也越好”。本页完整保留64格值和符号,没有先把指标翻转后混报。
相关系数依赖所选14纹理与生成方法集合、具体预处理和是否存在聚合。论文未在此提供独立人类评分或相关性显著性检验,矩阵说明各指标捕获不同属性,不证明TexTile对人类评价的相关系数更高。
论文把Heitz等的神经纹理合成目标扩展为:
这里的style方法来自sliced Wasserstein神经纹理合成,不应自动替换成Gatys Gram损失。作者说相同数量级的权重下不太敏感,但没有完整数值敏感性表。更关键的是,主文和这份补充材料没有给出L_TexTile的明确代数定义,也没有发布此优化循环的训练代码;公开API返回的是越高越好的分数或原始logit,不是默认越低越好的loss。
实践若采用梯度下降,必须改变符号。下面只是几种自洽的使用选择,不是原文已披露的精确实现:
−T易在饱和处梯度很小;−z没有sigmoid压缩,但更可能把logit推向极端。API的return_logits=True说明作者提供原始logit供优化,不能据此唯一反推出论文用的是哪一个表达式。直接把默认TexTile正值加到要最小化的loss里,会鼓励更低平铺评分,方向完全相反。
自动微分可穿过tile、resize、标准化与网络返回到原输入;同一个像素被复制到四个位置,反向梯度会从副本累加。将model.eval()设为推理态不会关闭梯度;若要冻结评价器,应冻结其参数但保留图像或生成参数的梯度,不能把整个调用包进no_grad后再要求优化。
对于outpainting,固定内部纹理,只优化边缘区域,通过style项保持输入外观,通过tile项减少拼接伪影。可用固定mask写作 \(I=(1-M)\odot I_{\mathrm{fixed}}+M\odot U\),只对U更新;这是理解流程的参数化表达,不是文中未公开代码的逐字还原。边缘区域宽度、初始化、迭代次数、优化器和学习率没有在提供的补充材料里充分列明。

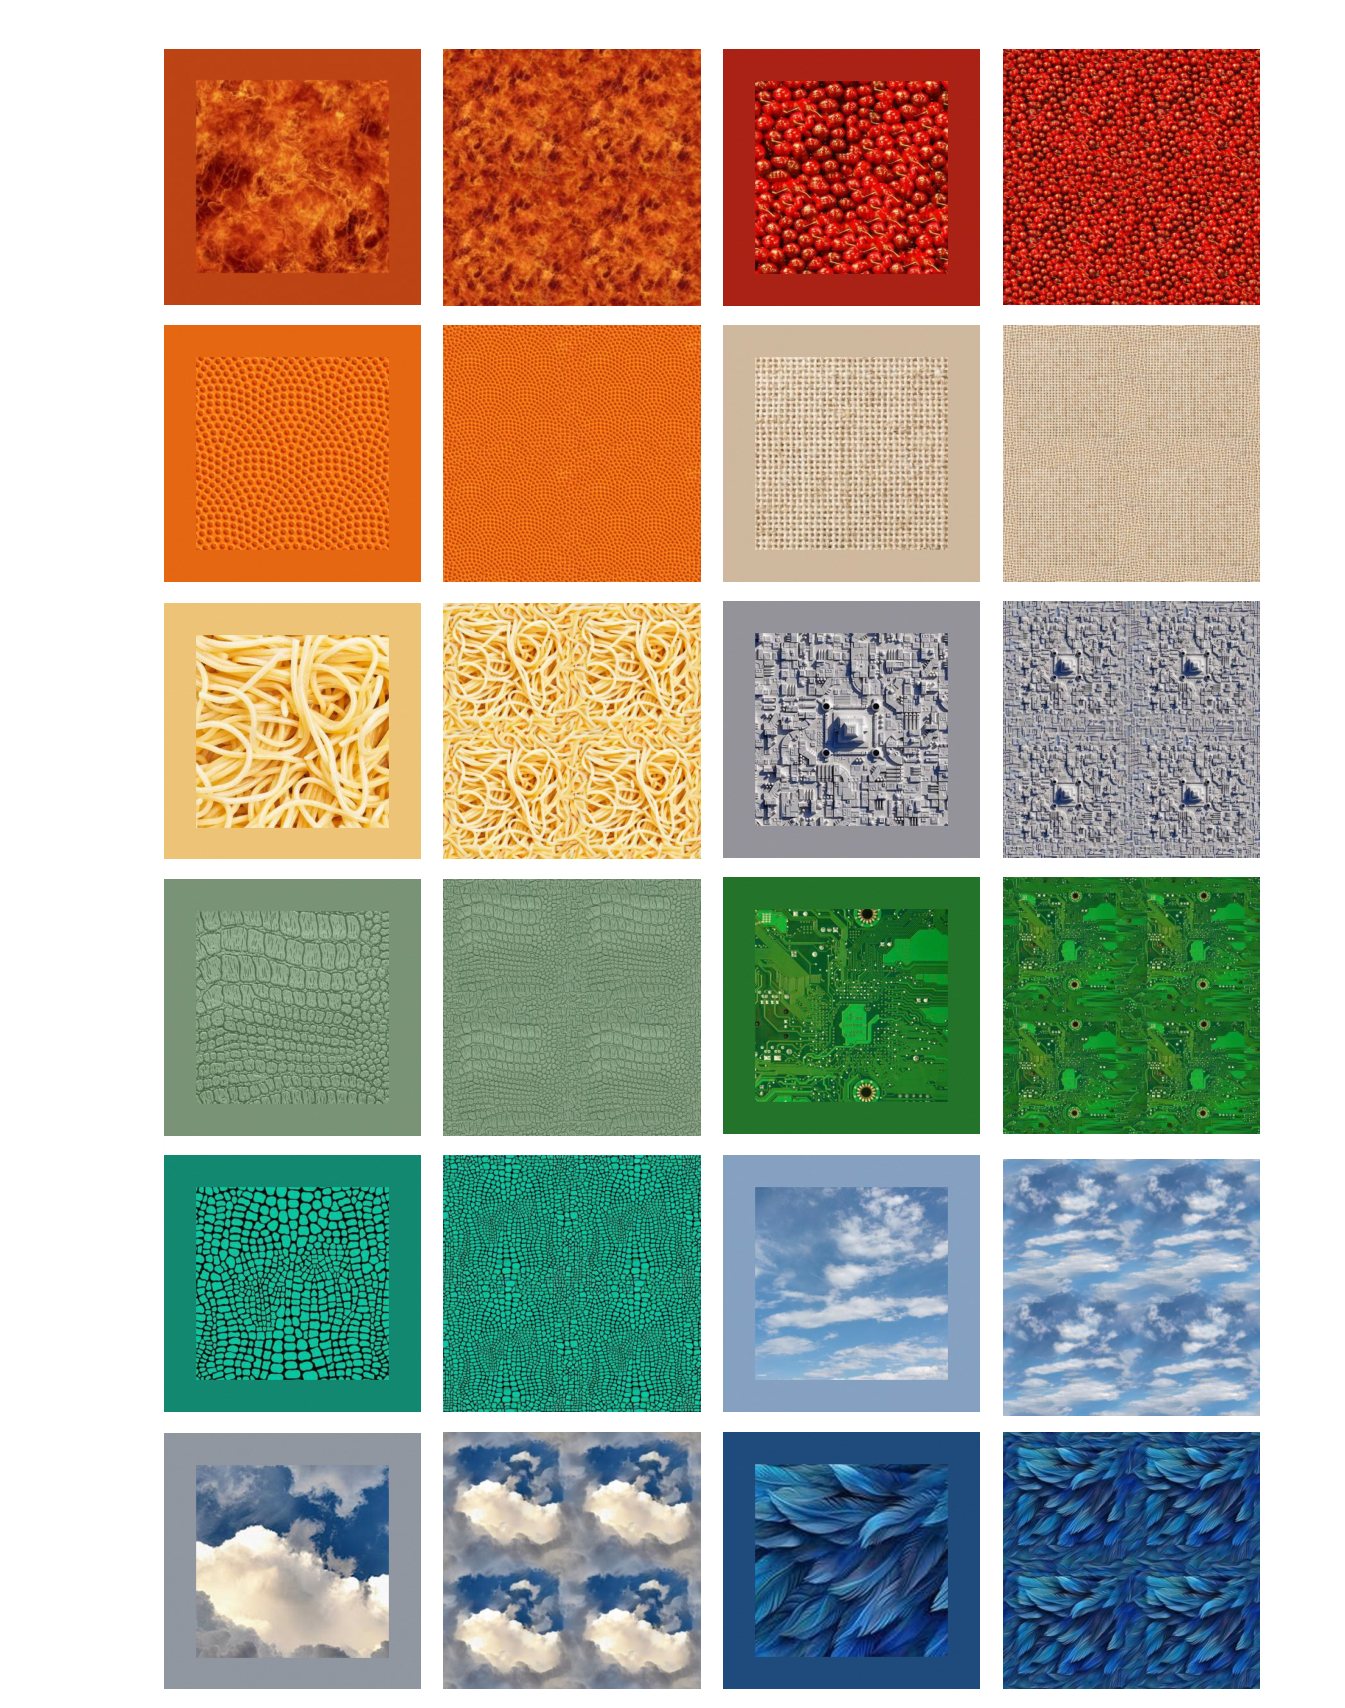
SinFusion是单图/单视频训练的扩散模型。作者不改它的训练过程,在每次扩散采样步骤后,对当前带噪图像做一次提高TexTile的优化,再继续采样。这里的“不重新训练”指已经训练好的合成模型与评价器可在推理时组合,不表示整个系统不需要模型训练。
上式是流程示意,Φ可以是所选的score或logit;原文未交代精确η日程、取梯度的噪声时刻、裁剪范围与多尺度处理。不能把它等同于已经推导过的严格条件扩散后验,也不是对所有文本到图像模型做过验证。带噪输入与分类训练分布可能不同,梯度引导还可能出现分数投机。
补充S35给出了负结果:把SinFusion卷积改成circular padding,没有单靠这项修改得到满意可平铺纹理,加入TexTile推理优化后才改善。它说明某个生成模型里的局部padding改动不自动解决全局重复伪影,不证明所有周期卷积模型都不能平铺,也不是否定专门设计的周期生成架构。
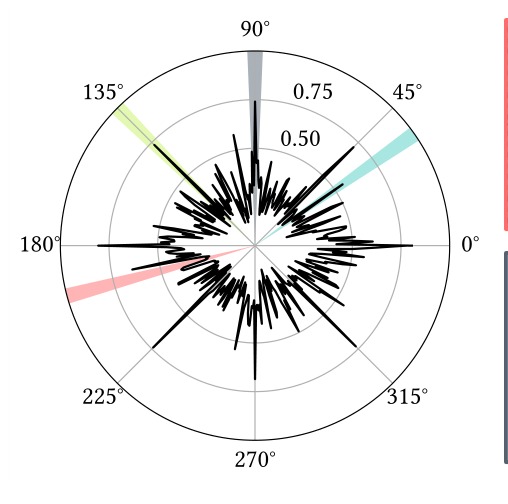
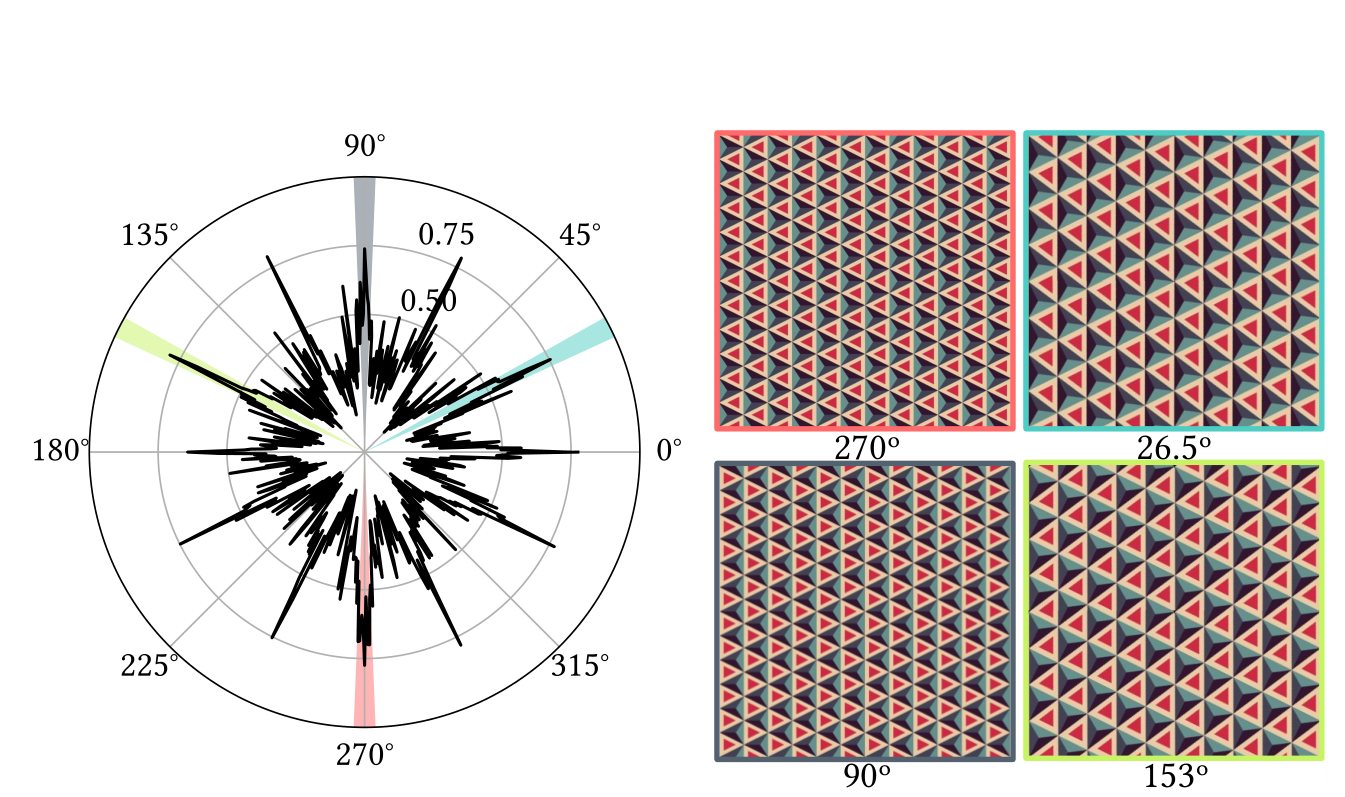
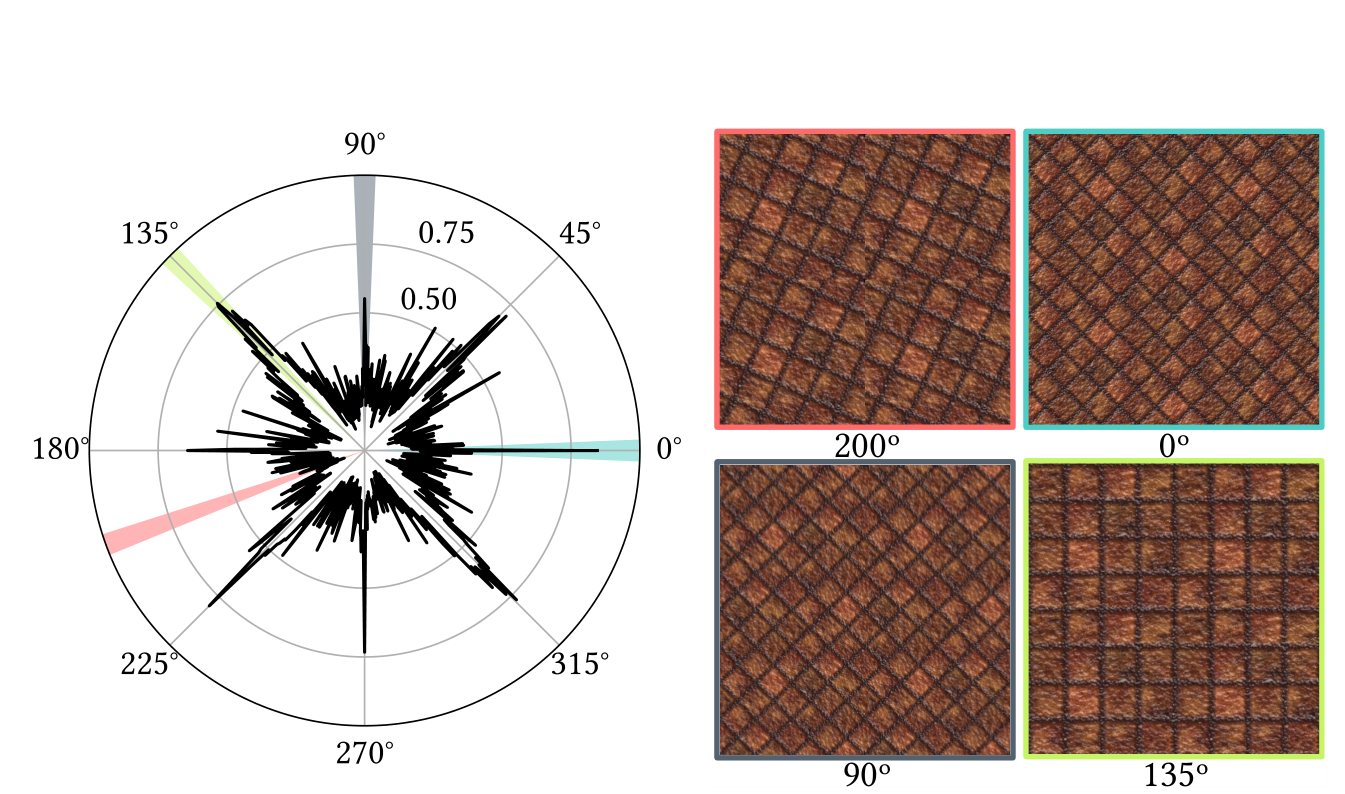
对不同旋转角度的图像评价tileability,可以寻找让线条在边界接起来的方向。主文Figure9的±35°也有局部峰,因为线条接续但颜色不匹配;更高峰同时满足方向与颜色连续。图示的0.5附近分数不能被解释为角度正确率。
旋转需要规定插值、边界填充、画布和裁切,否则黑色三角区等预处理伪影可能支配分数。文中展示搜索曲线与局部峰,未给与Radon或其他方向估计方法的大规模角误差基准,也没有全局最优搜索保证。下面六个补充例子说明多峰、对称和局部解的存在,不能据图推断唯一真实朝向。

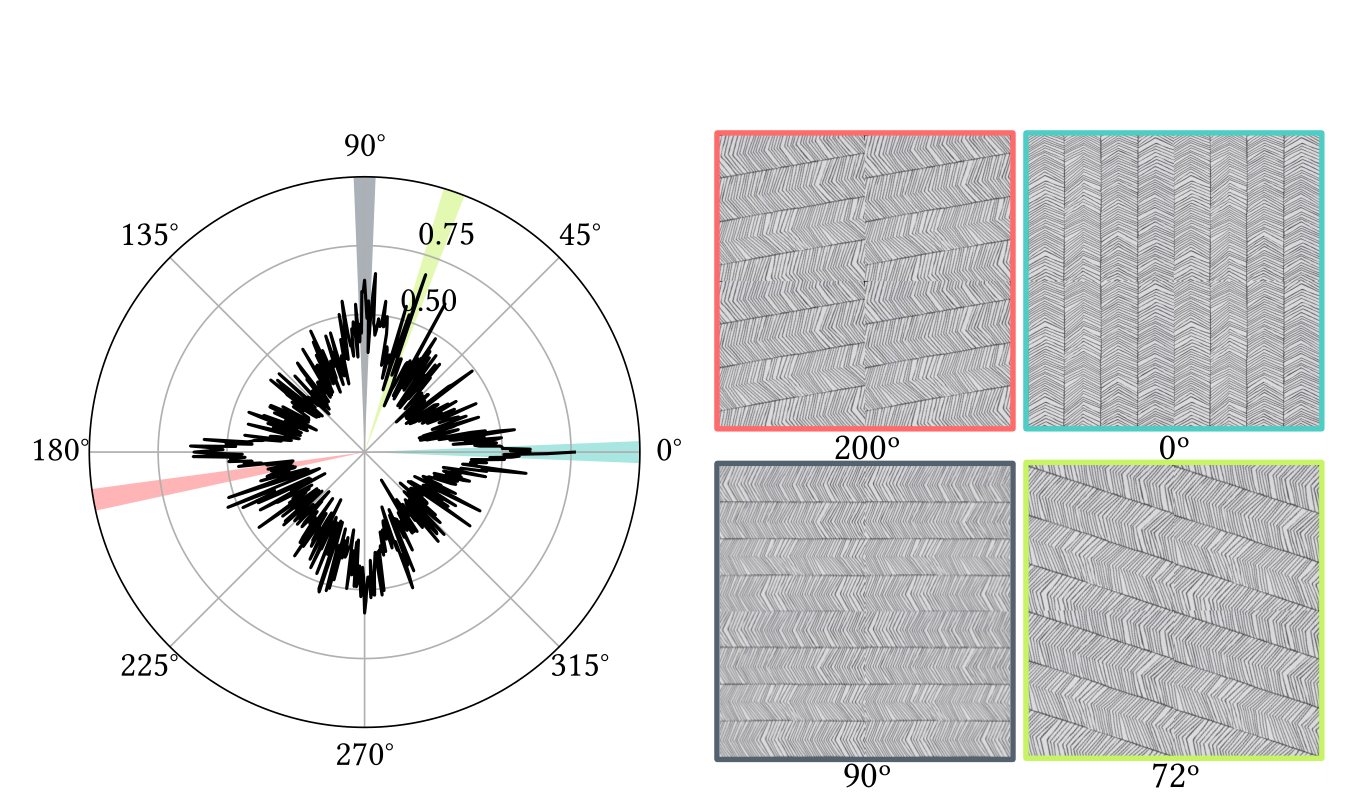
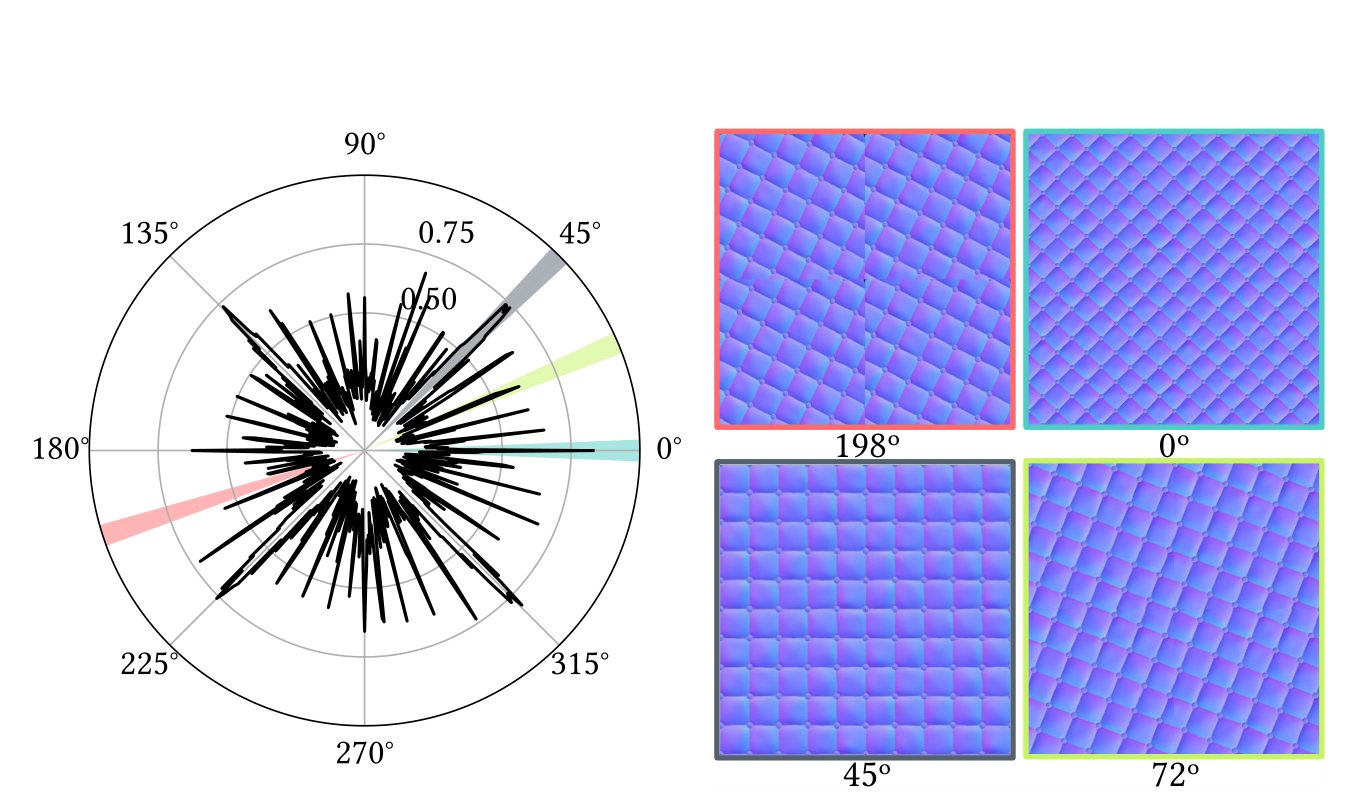
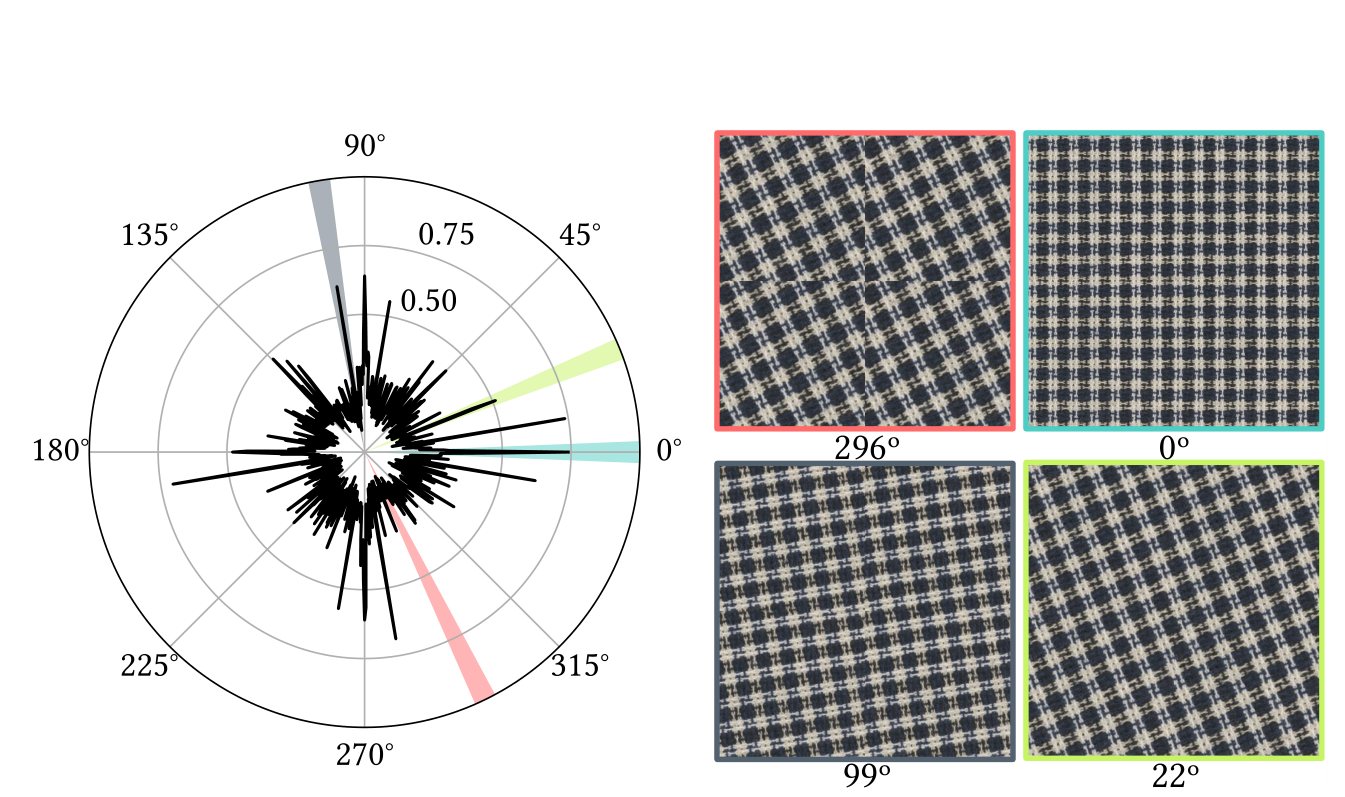
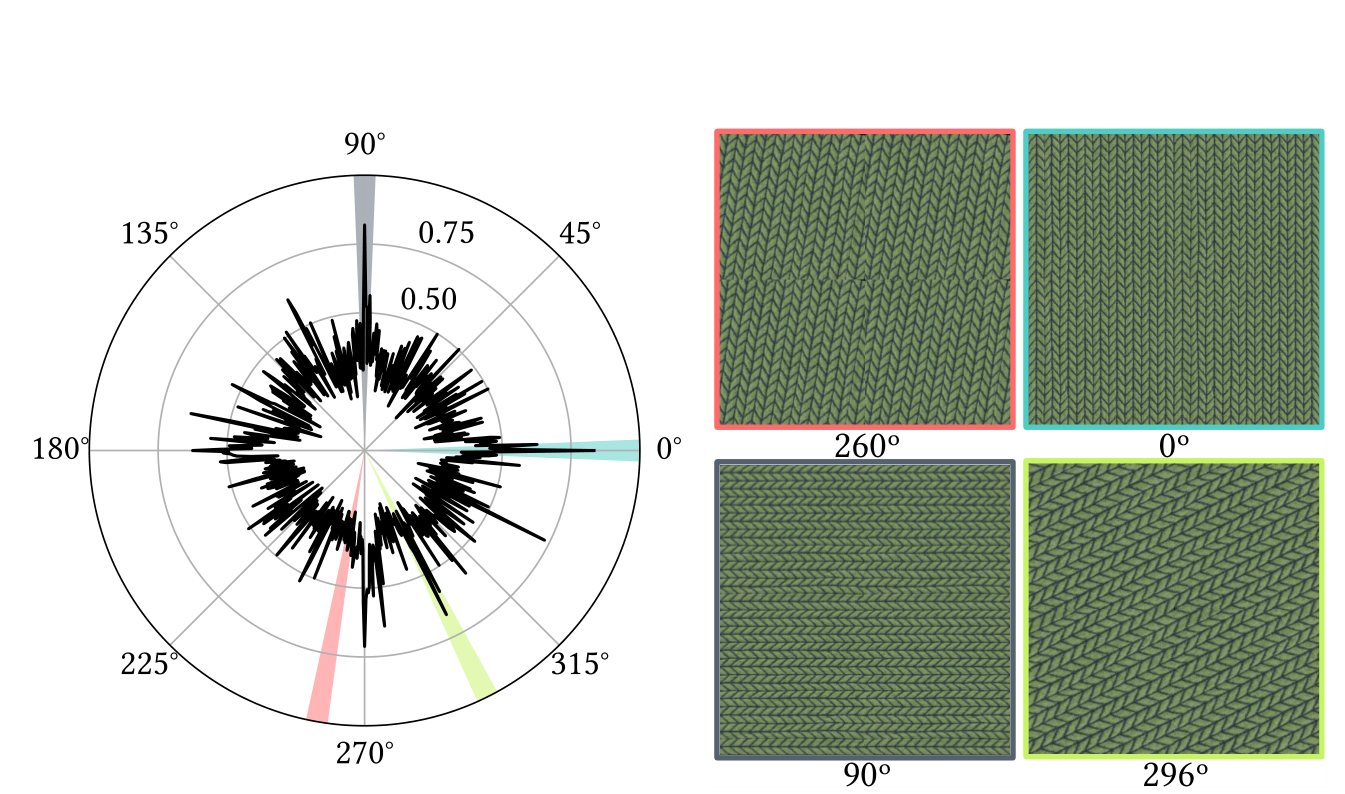
前提是输入已经轴对齐。作者固定裁切中心,搜索高宽并评分;原Figure10的最高峰对应最小重复单元,另有三个较低峰位于其不同整数尺度。旧笔记保存的PDF锚点正对应这个应用,本次保留完整,并补充其约束。
必须注意:上述目标本身没有“尺寸越小越好”的正则项,不保证所有输入都找到最小基本周期。若某个更大倍数的crop评分更高,就会选大块;非平稳纹理、遮挡、错位、透视或偏离中心的重复单元也可能失败。高度/宽度搜索是离散候选时,模型可微不等于argmax搜索就变成端到端可微。
作者称它直接在原图crop尺寸上操作,因此可能比低分辨率CNN激活上的周期检测更精细。公开wrapper仍将crop平铺后缩到512²,细节可能损失;这里的“原图分辨率”指候选裁切坐标可在原图定义,不意味着所有原始像素都以原分辨率输入网络。论文没有给精确周期误差统计,本页保留可能性而非宣称已经定量胜出。


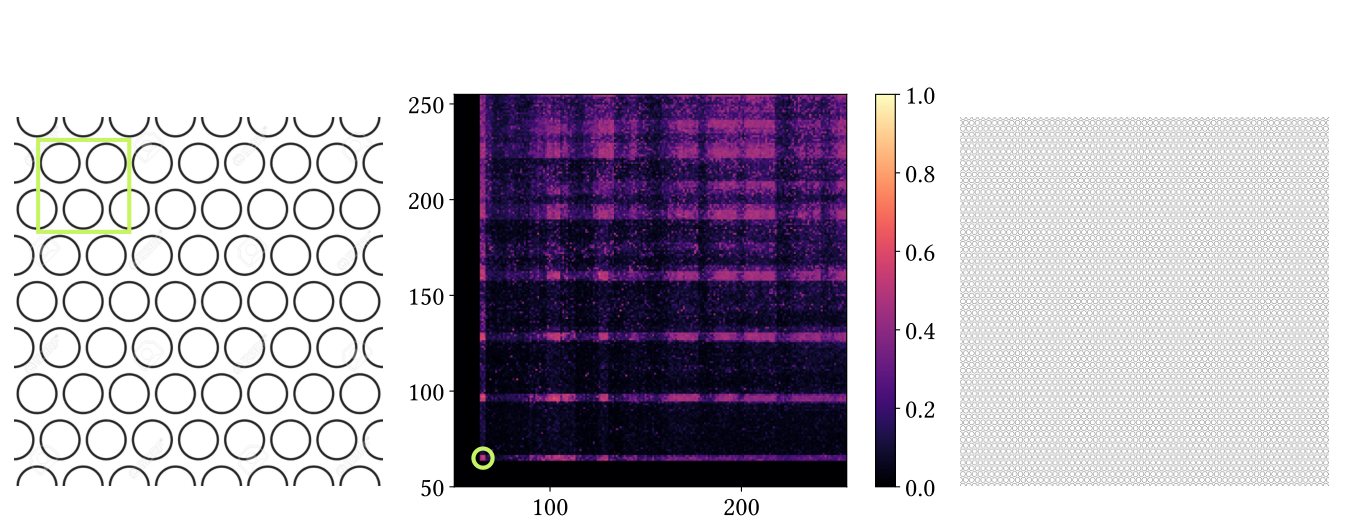
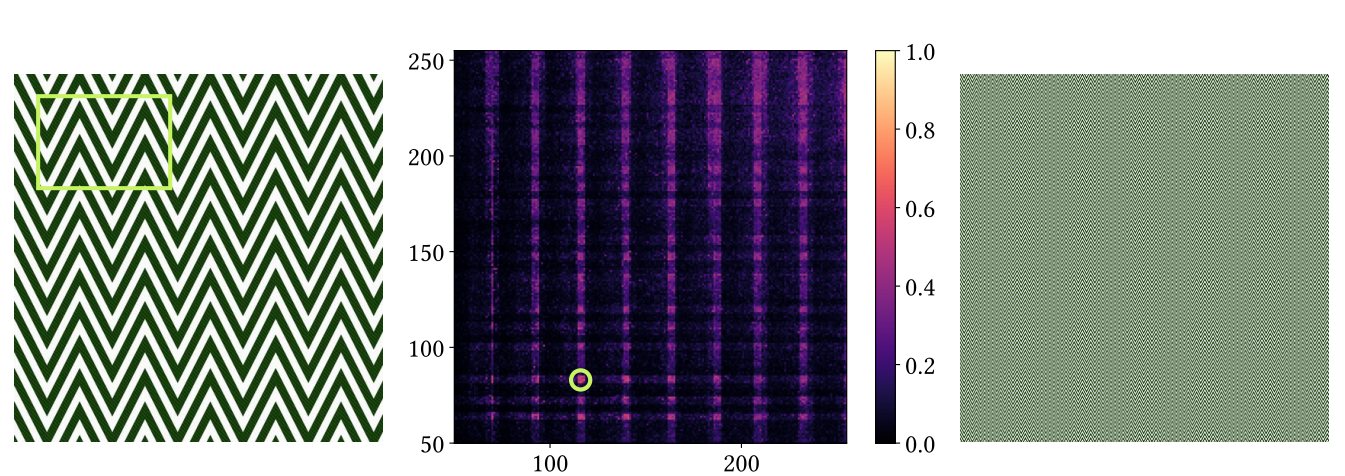
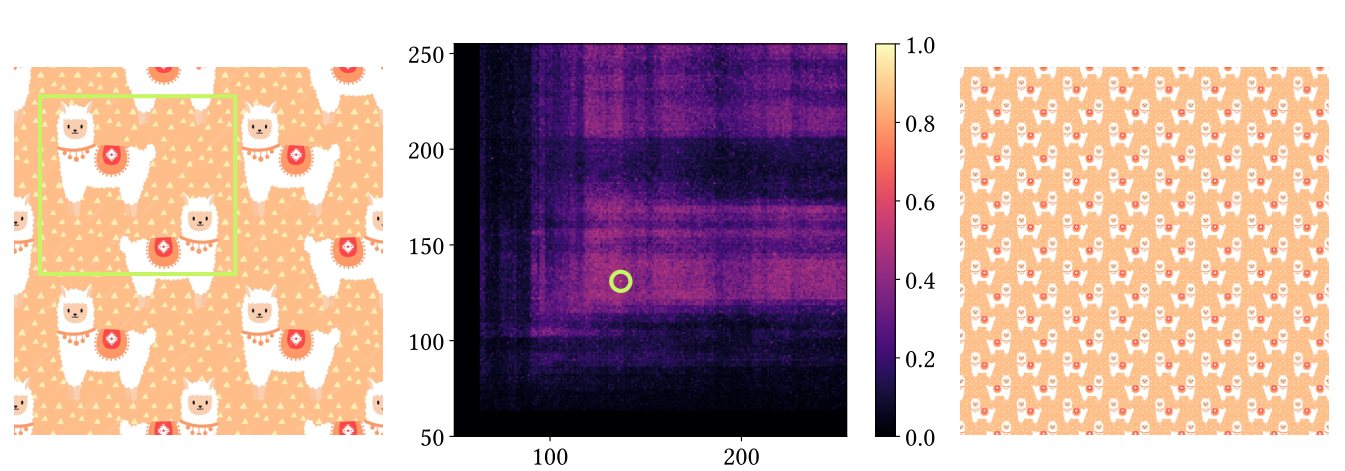
主文Figure11左侧真实标签0,预测T=0.569,细微接缝被漏检;右侧真实标签1,T=0.482,成为假阴性。它们靠近阈值,展示标签边界和感知判断的模糊性。高AUC也不意味着不存在这些具体误判,更不意味着任何纹理类型都泛化。

当生成骨干无法匹配输入的纹理外观时,TexTile可以帮助边界连贯,却不能凭空恢复缺失内容。只追求其分数可能牺牲细节、平滑成简单图案或利用模型偏差;论文没有系统对抗鲁棒性测试。对比质量必须同时记录reference质量、无参考质量、原纹理保真和tile评分。
模型依赖ImageNet预训练和人工整理的材质来源;罕见纹理、强语义图案、不同数据动态范围、非常大/小尺度、SVBRDF不同通道可能不在有效覆盖中。normal map作为RGB图进入数据,不意味着网络已理解法线向量的坐标系和渲染物理。
最后,TexTile是一个有用的经验度量,不能替代周期边界的硬约束。如果后续系统要求数学上可重复、无UV裂缝或材质参数物理合法,应同时做直接边界检查、法线一致性和实际渲染检验。
主审计固定于GitHub commit 1e04e9a94c2d8c3840c0e71ca8150745959d3486,其setup版本为0.0.11。本次另只读下载2024-04-21的PyPI0.0.10,核对wheel哈希并读取源码,没有安装、导入执行或下载模型权重。新版本与论文年代的旧发行包分开记录。
| 问题 | 实际行为 | 使用影响 |
|---|---|---|
| 输入 | 断言4维NCHW、3通道;默认tile→resize→normalize | 已平铺/标准化输入需设置相应开关,避免重复处理 |
| 图像读取 | OpenCV读图、取前三通道、BGR→RGB、直接除255 | 默认面向8-bit三通道;灰度、16-bit、高动态范围、透明合成需单独处理 |
| 设备 | 两版都assert CUDA可用,并把模型/输入移到CUDA | 默认不是CPU通用包;不能按“PyTorch兼容”承诺任意设备运行 |
| 模型输出 | 默认sigmoid(0.25z),return_logits=True返回z | 优化时应最大化输出或最小化正确负损失 |
| 梯度 | 没有no_grad/decorated inference;model.eval()不冻结参数 | 输入梯度可用,单纯评估需要自己管理梯度与内存 |
| 注意力gamma | 新旧源码均初始化0.01 | 与论文10⁻⁶不同;最终checkpoint值未检查 |
| 权重加载 | 新版本从Hugging Face取safetensors,或weights_only加载本地pth;旧版本从作者站点取pth | 缓存路径和加载方案变更,不把默认下载当成固定可重复权重哈希 |
| 分类头 | ConvNeXt构造weights=None,替换head后strict载入TexTile参数 | 不能误用未加载的空模型,也不说明历史无预训练 |
| 训练公开程度 | 公开树主要是模型、数据读取、预处理和推理;未包含完整训练增强与论文合成优化循环 | 推理API可用性与端到端论文可复现程度需分开 |
源码attention使用因式分解Q/K softmax,而不是按论文Linformer引用想象的序列投影。代码docstring还把return_logits误写成return_numpy,实际签名和返回值仍是Torch tensor。lambda_value是一个普通tensor属性而不是register_buffer;自定义多GPU或设备迁移时要检查它与模型的处理,不能从默认单CUDA演示推断多设备经过验证。
requirements中的torch下限较低,但torchvision≥0.17.1和现代权重加载参数有自己的版本需求;应锁定兼容环境,不把宽松声明视为所有组合通过测试。本次确认MIT代码许可,不据此扩张原论文图像、收集材质或训练数据的再分发权。当前PyPI元数据与固定源码均已留存供复核。
本次静态检查覆盖完整表格、所有图像解码、数学源码、旧笔记字节前缀与文件大小;另用独立代数/数值测试验证logistic单调性、梯度、label-balance纠正式和Table3差值。它们不等同于加载TexTile模型、重跑训练或复现实验成绩。浏览器检查按用户要求延后。
贡献扎实的部分。它识别了通用IQA忽略的纹理重复属性,把局部边缘与全局模式结合,并给出可用于优化的无参考网络。Table1有完整训练/增强消融,补充材料公开负结果、失败样本、分辨率/重复次数敏感性,比仅展示漂亮纹理更有信息。开源推理接口使其他系统可以较容易地采用同一评价。
最重要的未闭合环。没有人类感知研究来验证分数的连续意义;正负类别与来源相关,validation/test表述不够清楚;训练数据和完整增强循环不可直接重建;合成优化再用同一指标评价有循环验证风险。文章说“客观量化”应理解为可重复计算一个函数,不是已证实无偏地代表人的感知。
需要更强的实验。建议按材质来源留出、按同一材质不同照明分组去重;做受控接缝幅度、亮度渐变、重复频率与异常物体实验;给出分数与独立人类成对选择/置信度的关系;测试对抗或过度优化的高分失败;在更大纹理集、多个生成器和独立评价上复核。所有建议都是本页提出,未被冒充为论文已有结果。
注意力提升和增强提升不能仅靠saliency证明机制。若要区分全局attention是否真的必要,可加入边界距离、频谱/自相关、同参数CNN、局部窗口attention等任务匹配基线;分布级FID分类协议不是这些直接tileability基线的替代。
TexTile很适合作为程序化材质系统的一个可检查约束,但不是节点图生成器。对于可微渲染或可微图执行器,可以把某张贴图或渲染结果的tile损失梯度传给连续参数;离散节点、连接和不可微节点仍需要搜索或其他估计方法。一个高分RGB结果不说明图合法、节点可编辑或参数已经物理正确。
实际可设计“保真项+平铺项+物理约束”联合目标。先用硬性的周期参数化保证相邻边界匹配,再用TexTile惩罚内部明显重复块;用多光照、多视角的渲染保真避免靠降低对比、模糊或平坦化抬分。这个组合比把TexTile单独最大化更符合材质需求,但属于待验证方案。
对SVBRDF各通道,应分别审查:albedo的颜色连续、roughness的数值范围、normal的向量单位长度与接缝方向、height的值与导数连续。直接把法线图当RGB翻转/旋转,并不自动执行法线坐标变换;论文出现normal图数据,也没有验证这些物理约束。若模型只在美观RGB上校准,就不应把它的阈值直接搬到全部材质通道。
重复单元提取可以成为图像到程序的前处理:先候选轴对齐,再搜索crop,保留多个周期峰及不确定性,后续做节点结构拟合。选择最小周期需额外尺寸惩罚或整数倍关系分析;TexTile的argmax本身没有这一保证。最终评价应同时包含可执行率、渲染一致性、编辑稳定性和用户偏好。
作者站当前paper.pdf与原v1哈希不同。逐页文本比较发现去掉arXiv侧边标记,并把“将提供代码和权重”变为“接收后将提供”;其余提取文本一致。当前项目页与公开代码说明后来已发布,不能依据旧PDF的将来时声称现在没有代码。本次主要事实仍以受保护的原v1和独立补充材料为准。
第一作者机构为Universidad Rey Juan Carlos;Elena Garces、Jorge Lopez-Moreno另列SEDDI。未发现明确通讯标记,末位Jorge保留为未核实候选。原笔记把venue写arXiv,建议以后归档时改为CVPR2024并补DOI;输入模态应审查为image,原text标签和diffusion主题不能仅因应用到了扩散模型就当作本方法的输入或核心模型类别。
这些仅是archive-plan中的提案。原笔记全文、YAML、BibTeX及Figure10的PDF++锚点全部逐字保留,新精读只追加到合并候选。HTML仅在本地生成;公开图像链接已做HTTP和解码检查,实际浏览器图片、MathJax、导航和响应式验收仍标注延后。