SATT
Self-Attention-based Texture Transfer。人物在左、衣服在右,先拼成更宽的图像,再编码与去噪;不增加专门的衣服 CLIP/ViT/第二 U-Net。
共享画布的SATT与两阶段DMP|纹理、编辑区域与公开实现
Xu Yang · Changxing Ding · Zhibin Hong · Junhao Huang · Jin Tao · Xiangmin Xu
TPD 用一张横向拼接画布,让同一个扩散 U-Net 同时看见人物和参考衣服。原有 self-attention 在两半画布之间传递纹理;同一模型还联合预测衣服覆盖区域,以两轮去噪决定“哪里该改”与“改成什么”。两项贡献分别是 SATT 和 DMP。
Self-Attention-based Texture Transfer。人物在左、衣服在右,先拼成更宽的图像,再编码与去噪;不增加专门的衣服 CLIP/ViT/第二 U-Net。
先用粗 mask 预测目标衣服覆盖范围,再与原衣服范围合并,第二轮只修改必要区域,尽量保护手臂、纹身和背景。
二维试穿图与区域预测,不是三维布料、真实尺码或服装物理仿真。生成质量依赖 parsing、姿态条件与数据域。
回应原 note:简称是 SATT,而非 SAAT;实现不是先分别运行 source/reference attention 再只拼 K/V。空间拼接在像素输入构建时已完成。没有额外 garment encoder 不等于去掉 VAE,本文仍依赖冻结 VAE,补充材料还把极小文字重建失败归因于其压缩损失。
另一个关键点:“新旧衣服区域的并集”与 Figure 3 的 mask 逐元素乘法并不矛盾:代码的 mask 中 1 表示保留,0 表示重绘。两张保留 mask 相乘,恰好得到衣服前景并集的补集。若把 mask 都当作衣服前景,原 note 的乘法解释就会变成错误交集。
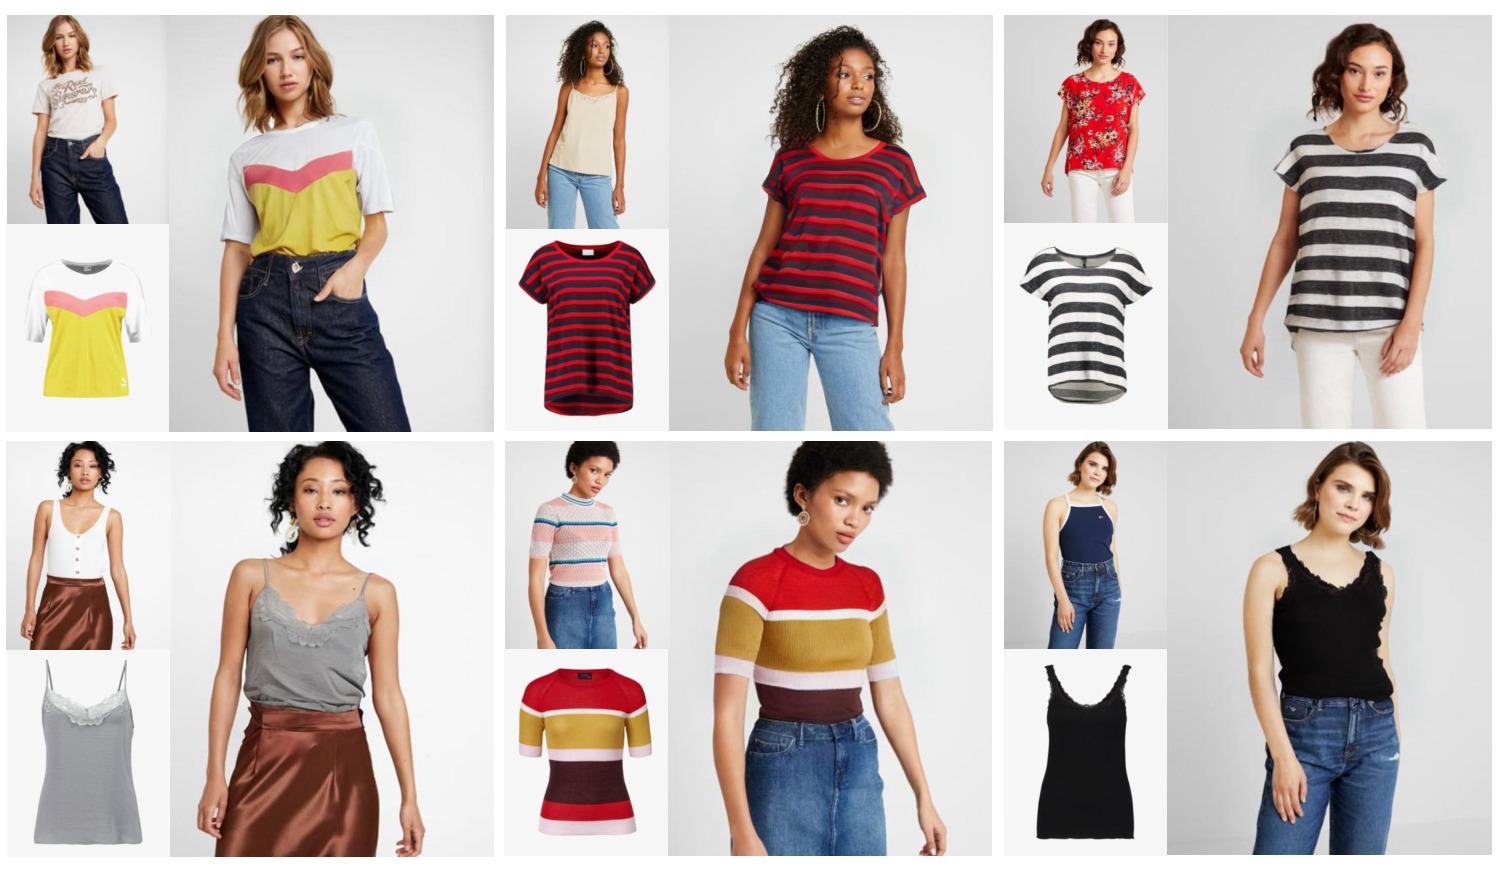
固定来源:arXiv v1 正文 10 页;另读 CVPR 官方补充材料 5 页;官方实现。
| 字段 | 核查结果 |
|---|---|
| 标题 | Texture-Preserving Diffusion Models for High-Fidelity Virtual Try-On |
| 作者 | Xu Yang、Changxing Ding、Zhibin Hong、Junhao Huang、Jin Tao、Xiangmin Xu |
| 机构 | Xu Yang、Changxing Ding、Jin Tao、Xiangmin Xu:South China University of Technology;Zhibin Hong、Junhao Huang:S Research |
| 通讯作者 | Changxing Ding;固定 PDF 首页星号明确为 Corresponding author |
| 版本 | arXiv:2404.01089v1,2024-04-01;CVPR2024,论文页码 7017–7026 |
| 全文范围 | 固定正文 10 页,含 8 页内容与 2 页参考文献;独立官方 supplement 5 页,不混计为原 PDF 内附录 |
| 仓库迁移 | 正文 Gal4way/TPD 现重定向到 MPI-Lab/TPD |
| 代码审计 | 只读当前 main 的配置、数据集、模型损失、DDIM、训练/推理/评估脚本;保存 URL、文件 hash 与原创审计,不在交付中复制官方源码或权重 |
原 note 中的全部中英混合记录、未完成问题、原始标签、外部图片链接、PDF++ 裁切/高亮和块标识均完整保留。补充信息只追加,不修改原始前缀。原记录 modality/text 可列为待审:通用 SD 介绍出现 text embedding,但 TPD 实际没有自然语言 prompt,cross-attention 使用固定可学习向量;本文的任务输入模态是图像与派生条件图。
当前公开代码是后续发布实现,不能仅凭当前参数断言所有原论文实验完全按该脚本运行。CVF 论文 HTML 本轮返回 403,但官方 supplement PDF 成功获取并核实标题。补充材料是会议源,和固定 arXiv 正文并列引用,不伪装成同一个文件。
试穿需要同时满足服装身份和人物身份:字母、logo、条纹与局部图案应随身体合理变形,而非衣服部分的皮肤、纹身、手指和背景应尽可能保持。一个方法即使把目标衣服生成得漂亮,只要粗 mask 抹掉了手臂纹身,也没有完成高保真试穿。
传统两阶段方法先估计 TPS、flow 或关键点 warp,再融合。前端形变错误会传给生成器。基于扩散的 warping-free 方法常使用 CLIP 或额外视觉编码器,把衣服特征作为 cross-attention context;全局语义特征可能丢失高频细节,强空间编码分支又增加容量和计算。TPD 把衣服直接作为同一画布的可见上下文,利用既有 U-Net 多尺度卷积和 self-attention。

| 符号 | 语义 | 注意事项 |
|---|---|---|
| \(S,C,C^{\ast},I^{\ast}\) | 原人物、与原人物配对的衣服、推理目标衣服、理想换装人物 | 训练拥有 \((S,C)\),通常没有换另一件衣服的真实 \(I^{\ast}\) |
| \(c_m\) | 输入保留 mask | 代码约定 1保留、0重绘;人体背景为 \(c_m\odot S\) |
| \(M_S\) | 论文中描述原衣服区域;实现存储其保留区域补集 | 说明前景/补集后才能解释乘法 |
| \(b_S\) | 粗矩形编辑范围 | 代码结合衣服和手臂 parsing 生成,非任意人工矩形 |
| \(c_p,c_d\) | OpenPose pose map、DensePose 图 | 仍需外部预处理,不是 parser-free |
| \(z_t,m_t\) | 四通道图像 latent 与一通道 mask 的加噪状态 | mask 不经 VAE,直接缩放到 latent 分辨率 |
| \(e\) | U-Net cross-attention context | TPD 是共享可学习向量,不承载不同商品文本 |
Paper Verified:正文验证 garment-to-person 的 VITON、VITON-HD,以及 DeepFashion 的 person-to-person 定性结果。Author Claim:“精确 mask”与“更有效率”是相对所比较方案的经验结论,没有证明预测区域是最小可编辑集合,也没有保证任意自然场景都成功。
它是条件去噪目标,不是显式“纹理铺贴损失”。训练时目标人物 S 已经穿着商品 C;遮掉衣服后,要预测正确噪声、恢复目标纹理,模型可以利用未遮的人体、姿态和右侧商品图。若所有衣服条件都忽略,细节变化会提高重建误差;配对样本与随机噪声提供学习信号。但 MSE 不保证逐字复制,也不能突破 VAE 丢掉的高频信息。
每张原图为 3×512×384,拼接后为 3×512×768。VAE 在整张拼接画布上编码,得到 4×64×96 latent;左右分别对应人物和衣服。输入 noisy state 覆盖两半,训练也要求同时重建人物与衣服。右侧 clean garment 还在 background condition 中可见,并非只依靠一份噪声衣服重建猜测。
pose 与 densepose 条件同样左右拼接:左侧对应人物 pose/DensePose,右侧放商品图;mask 右侧填 1,表示参考区域已知。这个安排让所有条件在同一宽画布坐标上有一致左右语义,并没有提前把商品像素对齐到人体像素。几何对应由 self-attention 学出来。
Q/K/V 来自同一 combined feature map。按人物与衣服 token 分块:
\[Q=\begin{bmatrix}Q_S\\Q_C\end{bmatrix},\quad K=\begin{bmatrix}K_S\\K_C\end{bmatrix},\quad A=\begin{bmatrix}A_{SS}&A_{SC}\\A_{CS}&A_{CC}\end{bmatrix}, \quad O_S=A_{SS}V_S+A_{SC}V_C.\]\(A_{SC}\) 是人物 query 读取衣服 value 的通路,但模型执行的整体仍是 self-attention,不是单独安装一层 garment cross-attention。多尺度卷积提取局部纹理,不同分辨率 attention 汇聚远距离对应。与原 note 中“分别 attention 后拼 K/V”不同,源码数据集已在 torch.cat(dim=2) 构造左右像素画布。
若沿 channel 拼接,人物和衣服同一位置被挤进同一个 token 的通道,空间上的独立源索引消失,需要额外变换才能重定位;这解释了为什么空间拼接更自然。它不是数学上证明 channel 方法绝对无法转移纹理,而是该论文消融中性能较差。
移除专门衣服编码器节省参数,但画布宽度翻倍会让同尺度 token 数从 p 增至 2p,标准全局 attention 的 QK 相关矩阵由 p² 增到 4p²;卷积/VAE 的面积也增大。实际实现、分辨率和高效 attention 可改变内存与速度,但不能只看参数减少就断言端到端 FLOPs 同比例下降。DMP 还有第二轮完整采样成本,补充效率表只标 SATT,后文单独审读。
固定正文 §3.3,Eq.1–2;官方画布构建。

令 \(G_{\mathrm{old}}\) 是原衣服前景,\(G_{\mathrm{new}}\) 是预测目标衣服前景,1 表示衣服。要去掉原衣服并留出新衣服空间,编辑区域为:
\[G_{\mathrm{edit}}=G_{\mathrm{old}}\lor G_{\mathrm{new}} =1-(1-G_{\mathrm{old}})(1-G_{\mathrm{new}}).\]代码使用保留 mask \(K_{\mathrm{old}}=1-G_{\mathrm{old}}\)、\(K_{\mathrm{new}}=1-G_{\mathrm{new}}\),于是:
\[K_{\mathrm{stage2}}=K_{\mathrm{old}}\odot K_{\mathrm{new}} =1-G_{\mathrm{edit}}.\tag{DMP 语义展开}\]例如原长袖变成短袖,原长袖位置仍必须编辑以生成手臂,不能只遮新短袖;原短袖变长袖,则新增袖子覆盖处也需要编辑。因此取并集有合理性。不过保留皮肤纹理只发生在并集之外;旧衣服本来遮住的皮肤没有观测,模型只能生成。
训练配对 \((S,C)\) 中,新衣服就是 S 原本所穿衣服,真实 mask 可从 parsing 获得。把 image latent 与缩放后的保留 mask 拼成五通道目标:
\[u_0=\operatorname{Concat}_{\mathrm{ch}} [\mathcal E(\operatorname{Concat}_{W}(S,C)),\operatorname{Resize}(K_{\mathrm{GT}})], \quad u_t=\sqrt{\bar\alpha_t}u_0+\sqrt{1-\bar\alpha_t}\epsilon.\]辅助条件提供 masked combined image、mask、pose 与 densepose;U-Net 输出五通道噪声。前四通道去噪后由 VAE 解码,最后一通道直接还原/缩放为 mask。正文只给通用 Eq.1,以上是依据公开实现拆出的联合目标,不是论文额外编号公式。
两轮使用同一组权重,不是两个分别训练的网络。Stage1 的粗 RGB 主要用于展示,Stage2 真正继承的是预测区域和同一原人物/衣服条件。mask 预测仍会出错,二阶段没有建立物理碰撞、服装尺度或真实身体轮廓约束。
| 来源 | 给出的策略 | 如何解释 |
|---|---|---|
| 正文 | 在原衣服区域与其 bounding box 之间随机“插值” | 描述一族粗细不同的 mask,不应直接假定是像素线性混合 |
| 补充§1 | 衣服外轮廓采样20–50个点,各点向外移动30–70像素 | 生成多种精细 mask 形状,适应两阶段输入差异 |
| 当前代码 | 最大轮廓 approxPolyDP,epsilon比例0.001–0.005;坐标随机偏移范围±80/90/100;闭运算kernel80/100/130/150 | 不是补充的逐点固定向外30–70实现,随机偏移可以向内 |
| 代码混合比例 | 训练60%随机轮廓 mask、40%粗框;测试始终粗框 | 支持Stage1/2的输入域,但数字是当前代码设置 |
| 代码安全边界 | 保留 mask 相乘确保遮盖原衣服,再限制在粗框内;3×3腐蚀扩张编辑区 | 形态学处理影响真实编辑区域,不能把最终精度全归于扩散预测 |
解析标签方面,VITON-HD 实现用 upperclothes=5 与 coat=7 构造衣服,粗框额外纳入 arms=14/15;默认没有把 dress=6 当上装,这对应发布的上装训练路径,不是所有衣类通用解析规则。找不到衣服轮廓时有全零保留 mask 的兜底,可能扩大重绘范围。
| U-Net 输入组成 | 通道数 | 512×768 combined canvas 的 latent 形状 |
|---|---|---|
| noisy image latent | 4 | 4×64×96 |
| noisy mask state | 1 | 1×64×96 |
| encoded masked combined RGB | 4 | 4×64×96 |
| resized keep mask condition | 1 | 1×64×96 |
| encoded combined pose condition | 4 | 4×64×96 |
| encoded combined DensePose condition | 4 | 4×64×96 |
| 合计 | 18 | 输出五通道:图像与mask的噪声 |
这两种 concat 必须同时区分:人物/衣服沿空间宽度拼;noisy state 和辅助条件沿 channel 拼。论文否定的是“用通道拼接替代空间衣服上下文”的消融,不是禁止所有 channel concatenation。
官方初始化脚本从 PBE 9 通道权重开始,在原前4个通道之后插入一个全零 noisy-mask 通道,再在末尾加入8个全零 pose/DensePose 通道;输出卷积追加一个全零通道和 bias,保留旧4通道输出。移除 cond_stage_model 的 CLIP 权重。它没有把整个 U-Net 输入或输出清零。
公开 configure_optimizers 明确将整个 U-Net 参数解冻,使用 AdamW;不是只训练 self-attention 或一个小 adapter。VAE 在 first-stage 初始化后冻结。共享 learnable vector 形状为1×1×768,作为 cross-attention context;不从文本或衣服 CLIP 提取可变 token。类中遗留1024→768投影参数被 optimizer 收录,但当前常量条件路径没有使用它,不应把它写成仍在运行的 CLIP garment encoder。
U-Net基础宽度320、channel multipliers [1,2,4,4]、每级2 residual blocks、8 attention heads、transformer depth1、context768;VAE四latent通道、基础宽度128、multipliers [1,2,4,4]、dropout0,scale_factor0.18215。时间步1000,噪声schedule起止0.00085/0.012。没有在正文公布精确 SD release编号,本页只断言官方代码的 PBE 初始化与该 LDM 架构。
| 项目 | 论文/补充报告 | 当前官方配置与范围 |
|---|---|---|
| 学习率/优化器 | Adam,10⁻⁵ | 代码AdamW,base_lr10⁻⁵;命令scale_lr=False,不按GPU/batch乘大学习率 |
| 日程 | 正文未给完整epoch/step | 240 epochs,warmup10000 steps,从倍率10⁻⁶升至1后长周期保持 |
| batch/GPU | 训练设备和batch正文未披露 | batch_size10,训练命令GPU0,1,2,3;标准DDP下约40全局样本/步,仍应核实运行配置与累积 |
| 分辨率 | 比较时每人物/衣服512×384 | 数据集硬编码resize384×512,combined为512×768;yaml image_size224不是最终训练画布 |
| 采样器 | 正文未给默认步数 | 官方命令默认DDIM,每阶段100步,eta0;--plms可切换 |
| 噪声/种子 | 未报告多种子协议 | 命令seed321;默认不fixed_code,两阶段各自取样 |
| CFG | 无自然语言prompt | scale默认1,c与uc都为同一learnable vector;同样辅助条件下不能靠提高该scale获得新的文本引导 |
| 推理batch | 未给逐样本显存 | 发布命令batch15;CLI默认5,不能混写 |
| mask膨胀 | 正文未详列后处理 | paired命令显式0,unpaired命令保留默认10次3×3腐蚀keep mask,即扩张编辑区 |
| 最终输出 | 左半试穿图 | 保存second_stage/result中的RGB融合图,膨胀/模糊kernel均30,再裁左半384列 |
训练时两半画布均贡献重建信号,右半参考重建可帮助保留纹理,但它也占用学习容量。mask预测采用联合连续高斯去噪,不是独立的二分类 segmentation head;最终二值化阈值和形态学会影响其可用性。原文未给 mask IoU、边界F-score 或 mask loss权重扫描,不能把“精确”当成已测量的分割性能。
源码只给前五通道加噪,其余十三个条件通道保持干净;损失对五通道与两空间维取平均,没有单独的 BCE、Dice 或额外 mask 权重。忽略可选 VLB 项时,可写为:
\[\mathcal L_{\mathrm{joint}}=\frac{1}{5hw}\sum_{c=1}^{5}\sum_{i,j} \left(\epsilon_{cij}-\widehat\epsilon_{cij}\right)^2.\]图像四通道与mask一通道在同一平均中按标量等权,并非图像任务和mask任务各占一半。不同数值尺度仍可改变优化难度。默认DDIM eta=0在每阶段对五通道状态使用:
\[\widehat u_0=\frac{u_t-\sqrt{1-\bar\alpha_t}\widehat\epsilon_{\theta}}{\sqrt{\bar\alpha_t}}, \qquad u_{t'}=\sqrt{\bar\alpha_{t'}}\widehat u_0+ \sqrt{1-\bar\alpha_{t'}}\widehat\epsilon_{\theta},\quad t'\lt t.\]每阶段100个选定时间点,两阶段通常约200次主U-Net预测,另有VAE与后处理;这不是单步试穿。learnable context只有一个token时,cross-attention的单key softmax恒为1,不能执行衣服空间检索;衣服细节的信息通路确实来自拼接画布及其self-attention。
VITON 原文报告14,221训练对、2,032测试对,原分辨率256×192;VITON-HD原始1024×768。本文把比较图像调整为512×384,不把两套数据或两个分辨率的分数直接合并。固定正文没有给VITON-HD具体样本数,官方VITON-HD来源为11,647训练/2,032测试;发布TPD实际取决于其pair-list,不从文件名推断已经逐项核验过训练数据。
DeepFashion用于person-to-person,正文未报告细分样本数、训练/测试构成或量化表。补充§2说明先从参考人物parse出衣服;右半不再只是商品照的姿态假设,还将参考人物pose图放在源人物pose图右侧,为大姿态变化提供信息。当前公开VITON-HD loader只演示商品图路径,不能据此宣称完整复现了DeepFashion设置。
| 评估 | 条件 | 指标及其边界 |
|---|---|---|
| Paired | 人物原本就穿参考衣服,目标为原图重建 | SSIM↑、LPIPS↓;受未编辑区域、颜色与融合影响,不能完全等同商品细节正确率 |
| Unpaired | 更换另一件衣服,没有相应人物真实换装图 | FID↓评估集合分布,不检验每张图是否忠于指定衣服 |
| Person-to-person | 从另一人物提取衣服并转移 | DeepFashion图示;没有定量几何、身份或人体部位保留分数 |
| 效率 | 补充中在A100测试SATT及两类对照 | 参数量与samples/s;不等同双阶段TPD用户可见端到端FPS |
公开evaluation调用PerceptualSimilarity、SSIM脚本与pytorch-fid,对比second_stage/result融合输出和resize后的GT。脚本注释记录LPIPS=0.07231199、SSIM=0.89628089、FID=8.53282485,与主表0.07/0.90/8.54近似但不是精确同一数值;8.5328通常四舍五入为8.53,因此不能把该注释当作主表每个数字的直接可复现日志。
原论文没有用户研究、多个seed的标准差、mask质量量化、逐类失败率或真实尺码试穿验证。SSIM/LPIPS只保留两位小数时,细微差距也不宜被解释为精确显著优势。
| Database | Method | SSIM\(\uparrow\) | FID\(\downarrow\) | LPIPS\(\downarrow\) |
|---|---|---|---|---|
| VITON | CP-VTON [12] | 0.78 | 24.43 | - |
| VITON | ClothFlow [2] | 0.84 | 14.43 | - |
| VITON | ACGPN [3] | 0.84 | 15.67 | 0.11 |
| VITON | SDAFN [9] | 0.85 | 10.55 | 0.09 |
| VITON | PF-AFN [24] | 0.87 | 10.09 | 0.08 |
| VITON | Paint-by-Example [21] | 0.83 | 12.56 | 0.12 |
| VITON | Ours | 0.89 | 9.58 | 0.07 |
| VITON-HD | CP-VTON [12] | 0.79 | 30.25 | 0.14 |
| VITON-HD | PF-AFN [24] | 0.85 | 11.30 | 0.08 |
| VITON-HD | VITON-HD [13] | 0.84 | 11.65 | 0.11 |
| VITON-HD | HR-VITON [8] | 0.87 | 10.91 | 0.10 |
| VITON-HD | LaDI-VTON [57] | 0.87 | 9.41 | 0.09 |
| VITON-HD | DCI-VTON [46] | 0.88 | 8.78 | 0.08 |
| VITON-HD | Paint-by-Example [21] | 0.84 | 12.15 | 0.13 |
| VITON-HD | Ours | 0.90 | 8.54 | 0.07 |
同版原表来源;完整方法行、指标列、缺失值保留。
VITON上最佳列出的FID基线PF-AFN为10.09,TPD9.58,下降0.51约5.05%;SSIM0.87→0.89,LPIPS0.08→0.07。VITON-HD最佳FID基线DCI-VTON8.78,TPD8.54,下降0.24约2.73%;SSIM0.88→0.90。作者表内TPD三项均最佳,但没有统计检验,且LPIPS等分数精度较低。
“优于SOTA”只限列出的基线和该实验协议。原表不含StableVITON,不应把另一篇论文的指标直接拼接排名。TryOnDiffusion由于非开源、私有大数据、person-to-person设定而未参加正文质量比较;补充中另做自实现模型的效率比较,不矛盾。
| Method | SSIM\(\uparrow\) | FID\(\downarrow\) | LPIPS\(\downarrow\) |
|---|---|---|---|
| w/o SATT | 0.85 | 11.34 | 0.12 |
| Channel-dim Transfer | 0.85 | 10.95 | 0.11 |
| w/o DMP | 0.88 | 9.08 | 0.08 |
| w/o Mask Augmentation | 0.80 | 27.24 | 0.19 |
| Ours | 0.90 | 8.54 | 0.07 |
同版原表来源;完整方法行、指标列、缺失值保留。
去掉SATT改CLIP cross-attention,FID11.34对比8.54,恶化2.80;channel-dim transfer为10.95,表明在该体系中保留独立空间token更有效。去掉DMP为9.08,差0.54约6.32%相对于最终模型;mask augmentation缺失时27.24,较8.54显著恶化,说明两阶段mask域差异是重要训练问题。
这些不是完整因子设计:没有全组合、没有对mask预测后处理与RGB融合单独消融,也未匹配所有方法的token/FLOPs。SATT对比同时改变编码器、条件接口和画布结构,不能只归因于“self-attention天然强于cross-attention”。
| Method | Parameters (Million) | Throughput (samples/s) |
|---|---|---|
| TryOnDiffusion(作者基于SD重新实现) | 2176 | 1.78 |
| LaDI-VTON | 1920 | 1.92 |
| SATT | 945 | 2.85 |
SATT945M参数比LaDI-VTON1920M少50.78%,比自实现TryOnDiffusion2176M少56.57%;吞吐2.85相对1.92约1.48倍,相对1.78约1.60倍。该表没有完整说明batch、采样步数、预处理和两阶段DMP是否计入;行名明确是SATT。因此可以说报告的模块级/模型比较更紧凑,不能据此给TPD承诺2.85张完整双阶段试穿/秒。
TryOnDiffusion一行是作者基于SD重新实现的代理,不是原闭源系统。参数边界是否含全部预处理模型也未明确。评估效率应包含OpenPose、human parsing、DensePose、VAE、多轮去噪、后处理和数据传输,而不仅主U-Net。
固定正文第6页;官方补充第1页。


Fig.4在VITON-HD对照VITON-HD、HR-VITON、LaDI-VTON、PBE与TPD;Fig.5在VITON对照ACGPN、PF-AFN、SDAFN。主要观察文字、logo、细条纹与手臂边界。好看的例子说明可行性,不能估计总体成功率,缺少逐字符OCR或特定花纹对应误差。

DeepFashion上与PBE比较。参考衣服来自另一个人物,需parse分离衣服,姿态差异更大。该图没有与所有正文基线公平量化比较,也没有证明可恢复参考衣服背面或被遮纹理。

完整方法、无SATT、channel transfer、无DMP、无mask augmentation。视觉变化与Table2配套:模糊图案、改坏身体、mask边界伪影。正文中引用“第二列”描述mask augmentation效果与图中栏目位置不完全对应,本页按图上实际标签读,不据该文字重排图。

DeepFashion例子对比传统mask及结果、预测mask及结果,强调纹身/胳膊/手指保留。它说明“减少无关编辑”有价值,但仍没有mask IoU,也未单独排除最终RGB融合带来的保留效果。预测mask不意味着所有衣服相关的阴影或遮挡变化都已正确建模。
Supplement Fig.1展示自然复杂背景泛化不足;Fig.2展示微小字母与图案无法完美重现。作者明确认为VAE latent有损压缩限制SATT细节,不应把“texture-preserving”解释成逐像素无损复制。正文认为没有明显负面社会影响,这是作者立场;真实人像编辑仍有同意、误导与隐私风险。
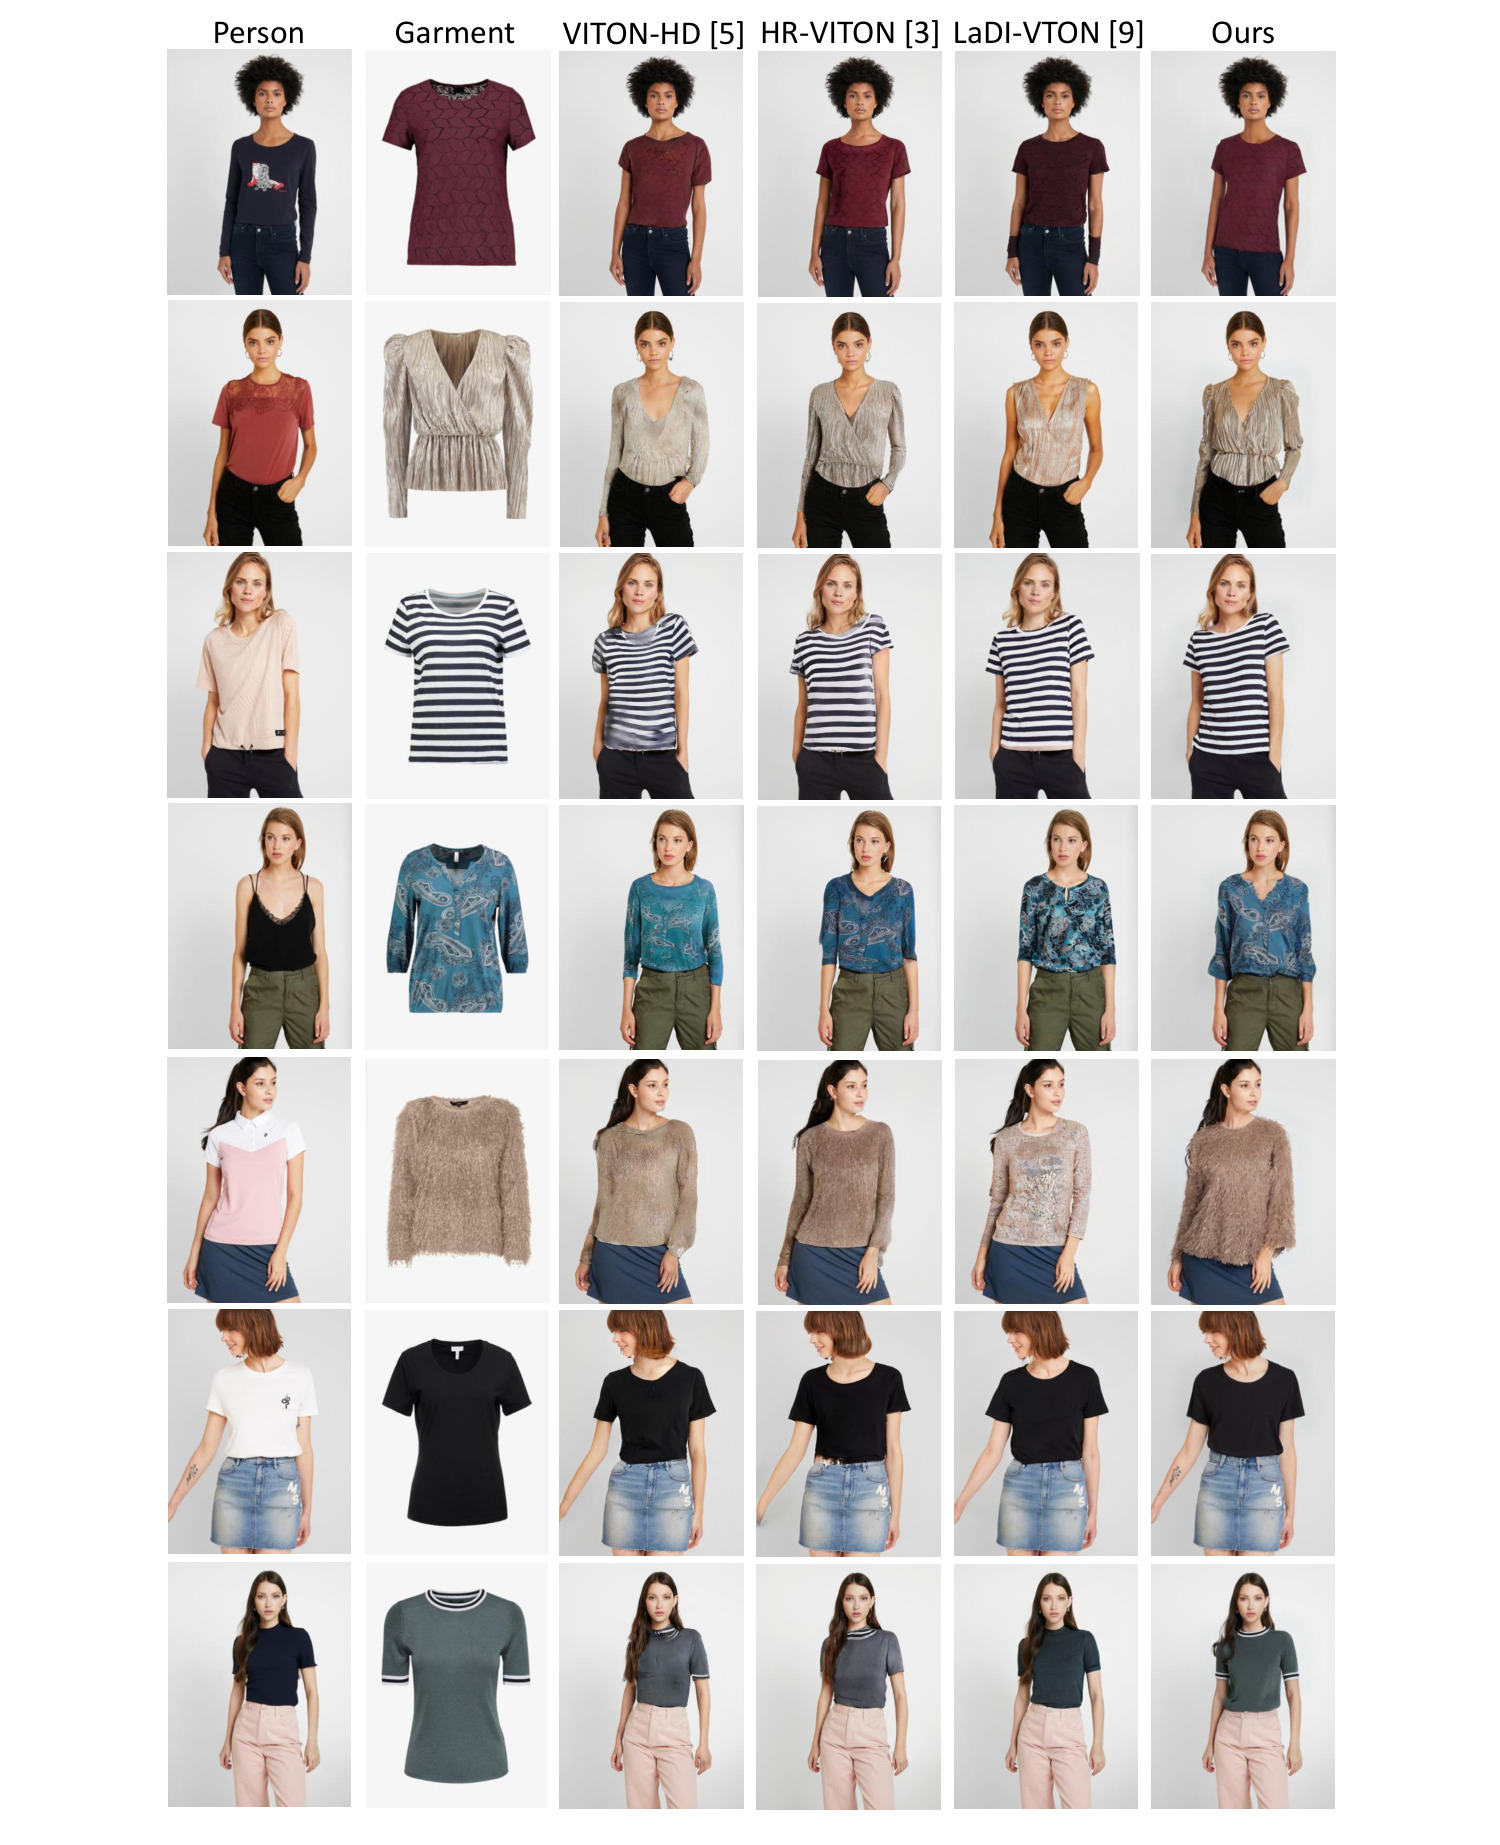
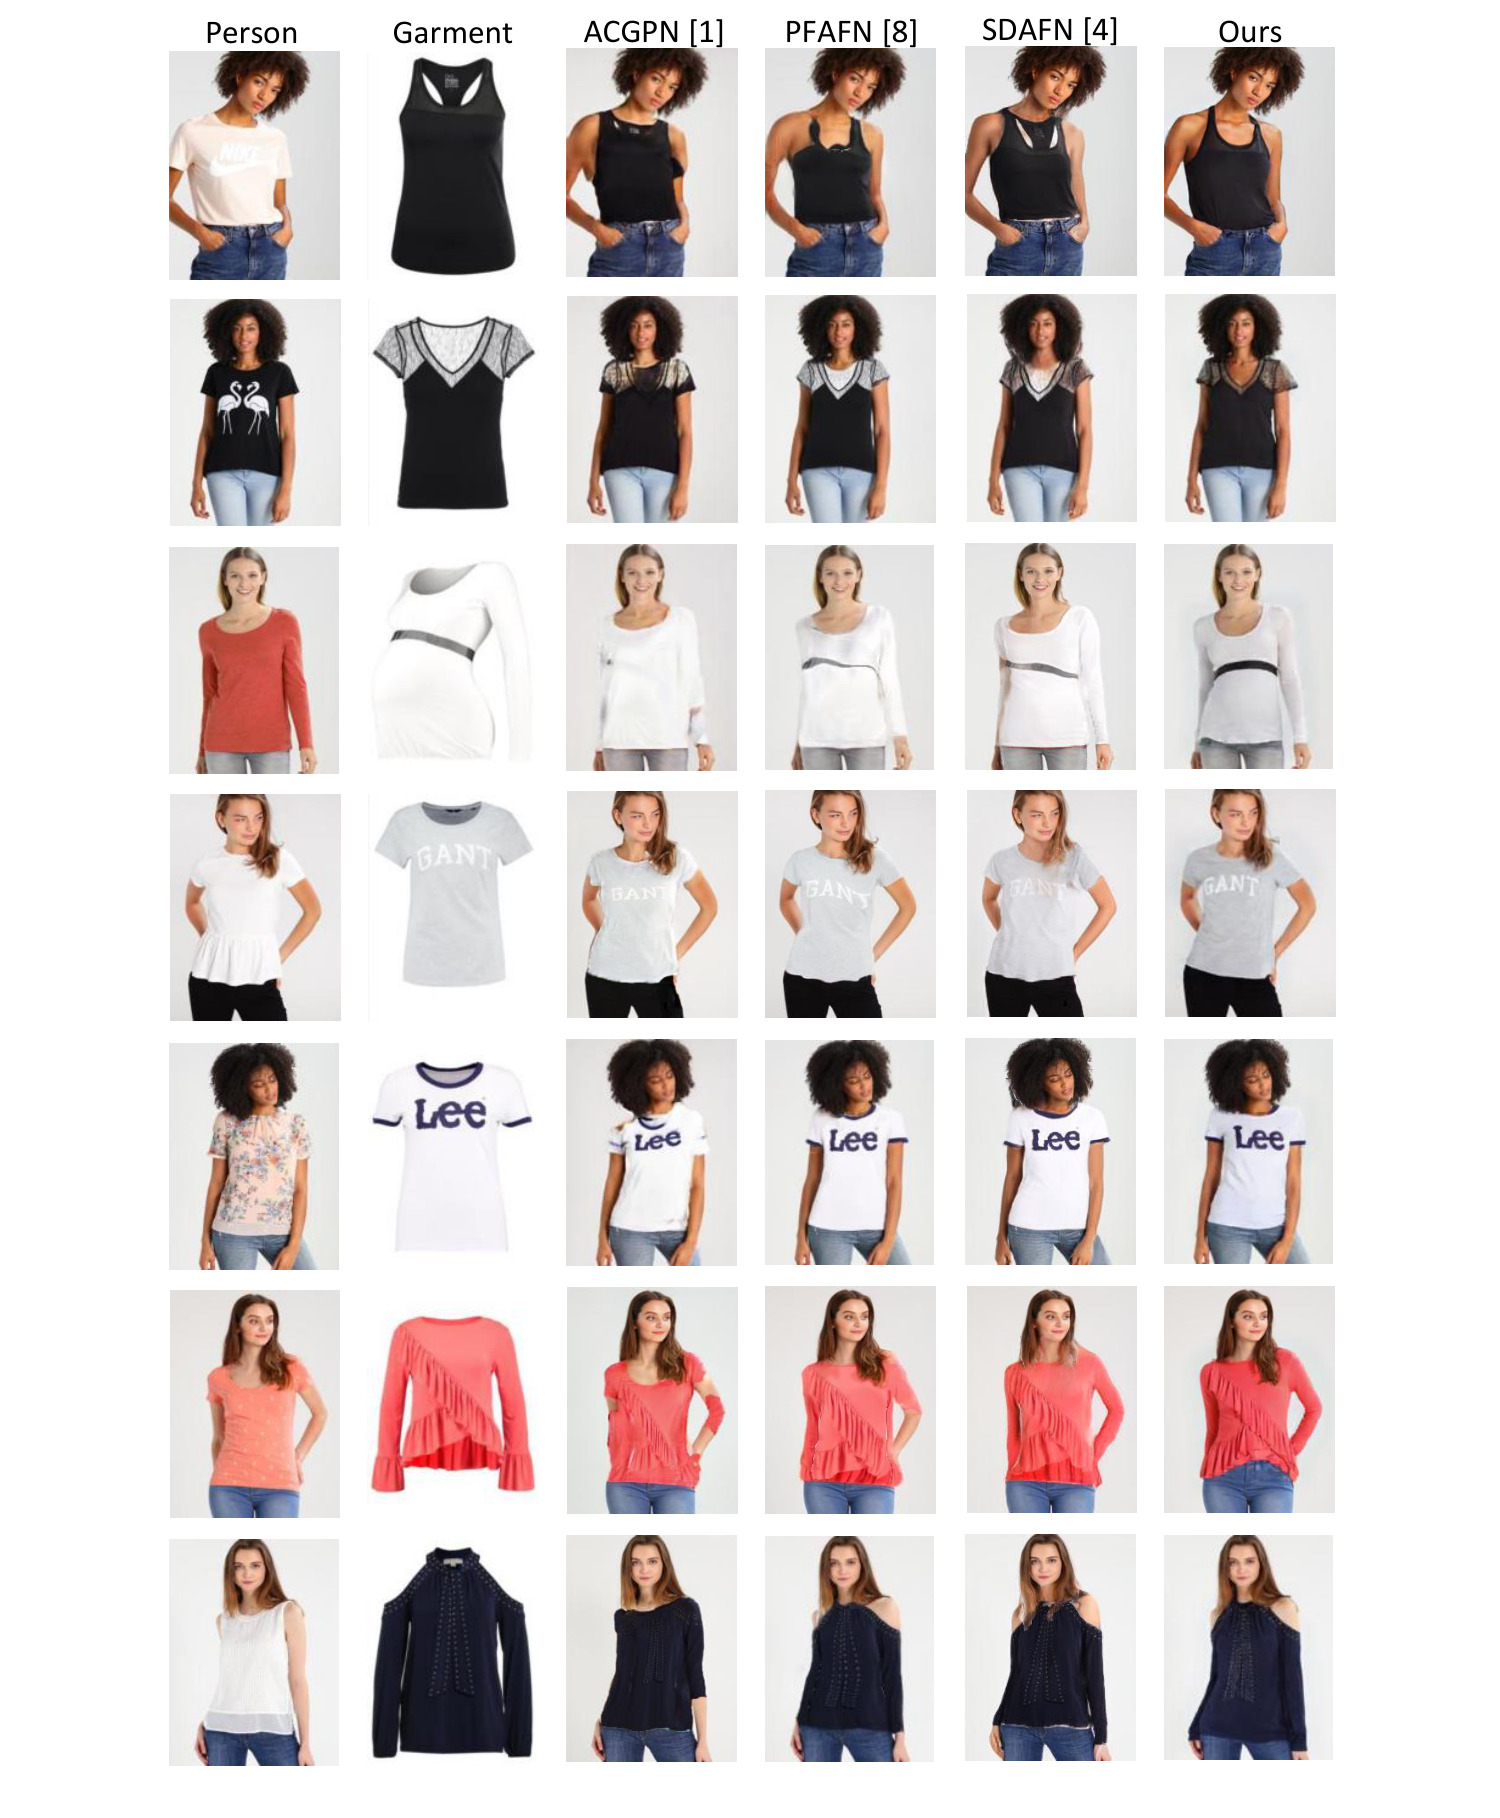
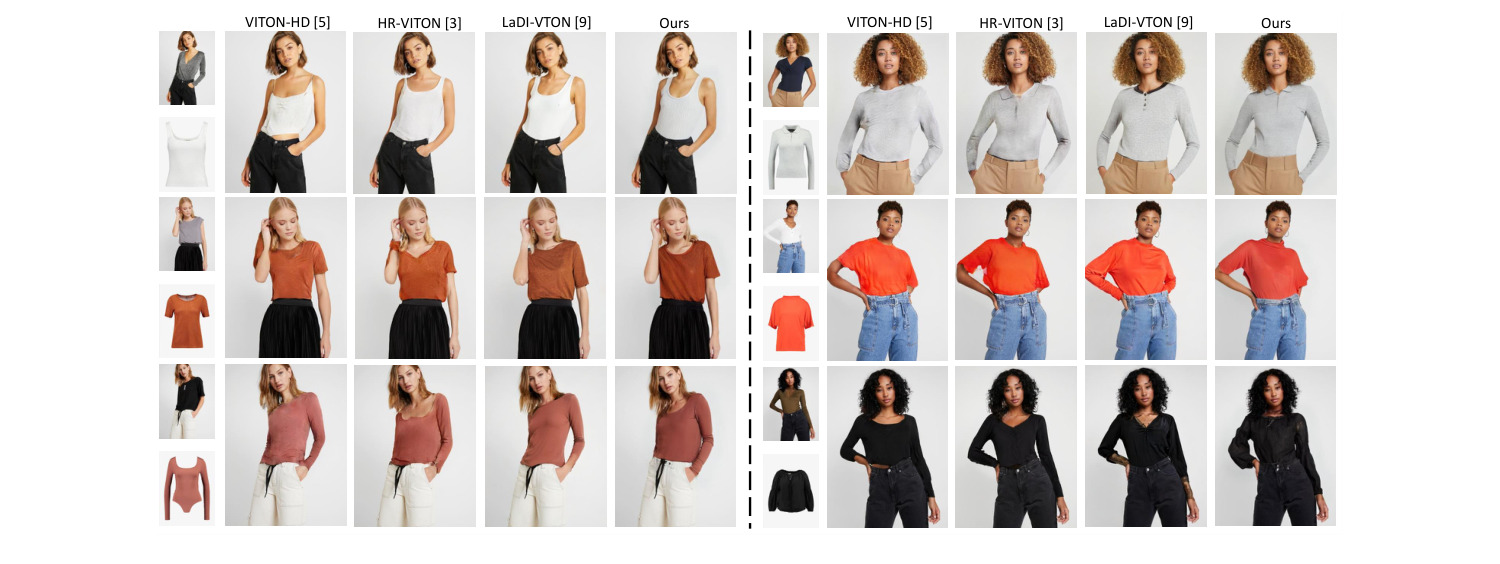
依次为VITON-HD更多商品试穿、VITON更多结果、VITON-HD挑战姿态。各图完整保留原方法列和样本行。补充图内引用编号与其参考文献存在个别错位,方法名称与数据集内容优先依据caption和正文对应,不由编号猜测不同模型。
| 容易混淆的说法 | 核查后应如何表述 |
|---|---|
| TPD不用encoder | 不增加专门衣服编码器;VAE依然存在并冻结,pose/parsing预处理也存在 |
| 只拼K/V | 人物与衣服先横向拼接,Q/K/V都来自combined feature map;人物到衣服通路是self-attention矩阵的一个子块 |
| spatial concat做好对齐 | 仅给定左右画布布局,没有商品到人体显式几何配准;对应由网络学习 |
| mask乘法得到并集 | 必须使用1为保留的补集约定;衣服前景乘法本身是交集 |
| 第二阶段继续修第一阶段latent | 复用预测mask后重新以原人物和目标衣服为条件采样;默认不是沿粗结果继续 |
| 第二阶段完全只改预测像素 | 预测区域与旧衣服并集,还有腐蚀keep mask、30像素级融合处理,真实改动边界更宽 |
| 论文Adam等于发布代码Adam | 正文Adam,实际configure_optimizers为AdamW,有10k warmup配置 |
| 945M证明更快 | 参数紧凑不直接证明FLOPs;双宽画布和两轮采样都增加代价,需看同预算实验 |
| 同一模型无需额外监督 | 联合mask目标来自human parsing;mask监督虽无需人工标注,也有外部模型依赖 |
| 无文本所以删所有cross-attention | CLIP移除,原cross-attention仍接一个共享可学习向量;它不携带衣服细节条件 |
| 全部实验可由发布loader复现 | 本轮公开路径主要VITON-HD;DeepFashion person-to-person细节有补充说明但未完整运行验证 |
| 比所有近作都好 | 只支持原表基线范围;不能跨论文数据/预处理/后处理协议直接排名 |
本次没有运行下载的官方代码或大模型,不把静态发现当复现结果。代码证据以URL、获取内容hash、行号范围和原创分析保存,交付白名单不含官方源码、权重或环境包。像训练时间、峰值显存、完整独立validation协议、mask预测精度等缺项如实标明。
SATT展示了一种简单条件组织方式:改变输入空间布局,让预训练模型已有的相关性建模能力承担跨图信息转移,而不是默认增加第二个encoder。DMP则把编辑边界作为生成系统的一部分,指出高保真不只来自更强生成器,还来自少改动不该改的部分。这两点都能迁移到更一般的参考图编辑。
正文只给两条公式,联合mask训练、输出尺度、采样与后处理细节主要需读代码。mask预测没有直接质量指标,最终图像指标同时混入RGB融合的贡献。mask augmentation消融很强,但代码与补充的具体算法不同,应做统一版本复现后再解释关键因果。
效率表比较的是SATT与两个结构不同的基线,其中TryOnDiffusion还是自实现。没有相同样本质量、相同去噪步数、完整两阶段预算下的延迟/显存曲线。合理的后续实验应报告每阶段时间、预处理成本、并行batch和画布attention开销,而不是只用一个samples/s数字。
高保真仍受VAE压缩、训练集背景单一和human parsing误差限制。DMP可能漏掉必要的光照/遮挡变化,也可能过度扩张掩码。无量化的多样体型、复杂穿搭、透明材质、反光衣服、宽松衣物及后背姿态测试,因此离电商可信试穿还有任务差距。
将待编辑渲染与参考材质图作为左右画布,借self-attention迁移纹理频率和局部结构,是可测试的条件组织方案。必须区分像素外观匹配与可重光照材质:目标可以扩为albedo、roughness、metallic、normal多通道,而不是只生成某一光照下的RGB。对照包括CLIP全局条件、额外空间encoder与共享画布,分别测参数/FLOPs/速度和纹理身份。
把DMP推广为材质编辑区域预测,例如替换一个图案而保留接缝、污渍与已有损伤。但编辑范围不一定只是旧/新前景并集;反射和阴影可能越过局部区域。可引入跨光照一致性与物理影响范围,验证局部编辑是否导致不应变化的材质通道漂移。
\[\mathcal L_{\mathrm{extension}} =\mathcal L_{\mathrm{denoise}} +\lambda_{\mathrm{keep}}\|(1-M_{\mathrm{edit}})\odot(\widehat P-P)\|_1 +\lambda_{\mathrm{render}}\mathcal L_{\mathrm{multilight}}.\]上式P表示材质参数通道,明确是研究设想,不是TPD已经证明的目标。要防止mask收缩为零逃避编辑,也要防止扩大到全图抹掉保留约束,需有mask覆盖与编辑成功的联合验收。
TPD并不输出可执行材质graph。若接到PMG,外层可用合法typed DAG生成器决定节点和连边,内层用渲染图像上的SATT条件优化连续参数;DMP只负责预期影响区域或节点责任归属。节点类型、无环性、端口兼容、执行错误与graph repair必须单独解决,不能用一张attention图替代程序语义。
补充失败案例提示可在latent生成后增设受约束的高频细节支路,或使用更高保真VAE。需要严控复制区域与形变,否则简单贴回参考高频会违背几何。评估采用字符准确率、局部频谱、接缝一致性与多视图/多光照重投影,不能只看FID。
对Stage1预测多份mask,测不确定度;不确定边界可选择保守重绘或人工提示。比较单阶段、两阶段、共享中间latent、固定/自适应步数,在同延迟预算下权衡质量。mask连通域规则改进应明确版本,检验遮挡造成多片衣服区域时是否误删有效组件。
使用风险:应取得人物影像与商品图使用许可,避免未经同意改动人物衣着或将合成作为真实穿着证据。当前仓库声明非商业使用,商业需明确授权;基础模型与数据集许可也需分别核实。试穿图不构成合身、尺码、布料触感或真实肤色表现保证。
产物包含原创中文HTML、完整Markdown新增部分、原笔记前缀合并候选和证据/归档计划。原 note 和PDF++ anchors全部保护;只建议补充项目链接、精确方法名与mask解释,不写入共享vault。复制的官方模型源码与权重不在交付白名单。
内容与静态QA完成后记录真实字节数,HTML必须严格小于20,000,000字节;远程图源进行HTTP检查。浏览器MathJax、实际图片布局、响应式与导航交互按用户要求延期,本次不声称已完成浏览器验收。