01 · 核心结论
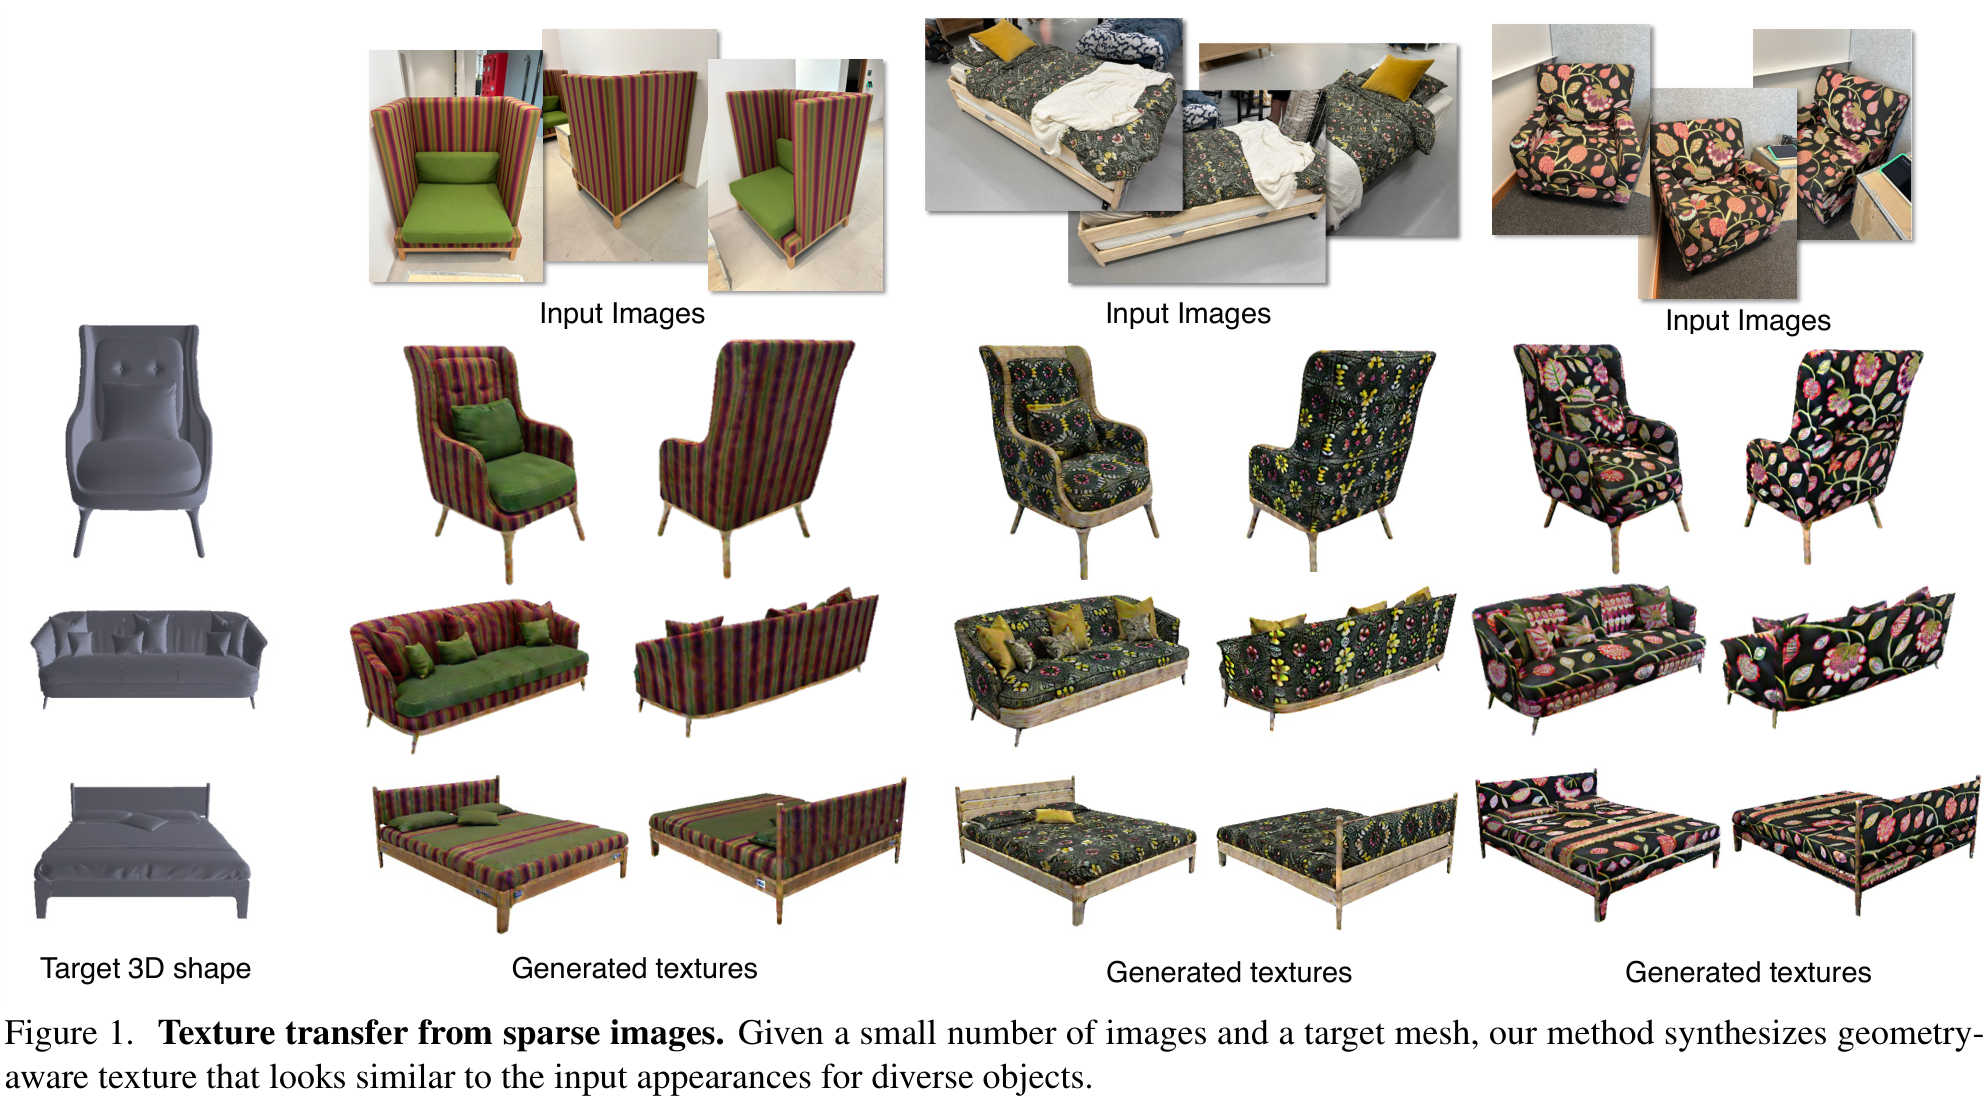
把 3–5 张随手拍的外观迁移到另一件物体:先把纹理记进个性化扩散模型,再用目标几何的法线约束一个可重光照的 BRDF 场。
输入与输出
稀疏物体照片与固定目标 mesh → 空间变化的 albedo、roughness、metallic;可烘焙到 UV 图。原物体与目标不要求几何一致,也可跨类别。
真正的技术选择
DreamBooth 提供参考外观;normal-ControlNet 约束几何;两个噪声预测的差驱动材质。相较 vanilla VSD,移除通用分支的 LoRA,只训练相机编码器。
证据边界
人类偏好和 CLIP 优于两条完整基线,但 CLIP 在去掉几何控制后反而更高。可重光照不等于从照片恢复真实物理材质,扫描表面瑕疵和高光烘入仍会失败。
Paper Verified CVPR 2024,pp.4304–4314,DOI 10.1109/CVPR52733.2024.00412。此页以用户指定的 arXiv v1 为保留基准,并完整核对 会议终稿 与 补充材料。所有原表重建;所有 v1 原图及终稿新增/重排图保留。
02 · 身份、版本与阅读范围
完整作者顺序为 Yu-Ying Yeh、Jia-Bin Huang、Changil Kim、Lei Xiao、Thu Nguyen-Phuoc、Numair Khan、Cheng Zhang、Manmohan Chandraker、Carl S Marshall、Zhao Dong、Zhengqin Li。第一作者在论文中挂 UC San Diego 与 Meta,按规范第一机构记 University of California, San Diego。Jia-Bin Huang 挂 University of Maryland, College Park 与 Meta;终稿将 Meta 写为 Meta Reality Lab。
原笔记漏掉末位 Zhengqin Li。 本次不改动旧 frontmatter 或用户正文,仅在追加内容与归档建议中纠正。PDF、项目页、出版记录未见明确通讯作者标记;按既定规则,末位 Zhengqin Li* 只能是 unverified 候选,不能把原笔记的 Zhao Dong 或项目联系人自动认定为通讯作者。CVF 完整作者列表 · 官方项目页
| 版本 | 范围 | 重要差异 |
|---|---|---|
| arXiv 2401.09416v1,2024-01-17 | 13 页;正文/结果 p.1–10,参考文献 p.11–13 | 10 图、3 表;本地原 PDF 的哈希已与移交记录匹配。arXiv 当前仅列 v1。 |
| CVPR 2024 终稿 | 11 页;正文/结果 4304–4311,参考文献 4312–4314 | 正文 9 图、2 表;新增 1/5/11 输入视图比较;跨类别展示扩至包、衣服;公式显式区分视角文本。 |
| CVPR supplementary | 独立 2 页,并非额外 13 页 | Fig.10–14、Table 3;新增镜面高光视角变化、扫描物体的几何瑕疵结果;重光照、多样性与扩展消融移至此处。 |
图号不可混用:v1 Fig.7 对应终稿 Fig.6 基线比较;v1 Fig.10 的两组消融在终稿 Fig.7 与补充 Fig.14 分开;v1 Fig.8 多样性变为补充 Fig.10;v1 Fig.6 重光照变为补充 Fig.11。终稿 Fig.8 是输入图像数量,与 v1 Fig.8 内容不同。本页所有图名都携带版本前缀。
03 · 为什么照片指导比文字更适合
作者要解决的是外观迁移到不同几何,不是给原对象做几何重建。密集多视图拼接需要已对齐的几何和充足覆盖;类别专用生成器受训练形状分布约束;把图像先转成一句文本,会丢掉图案密度、叶片形状、颜色搭配和局部结构。Fig.2 用 BLIP 生成文字后交给 TEXTure,展示这一描述瓶颈。

关键假设可以拆成三条:① 个性化扩散权重能保存少量照片中难以口述的纹理;② 在多视角渲染过程中注入目标法线,可让纹理服从部件布局;③ 用个人化与通用预测的残差,比大 CFG 的 SDS 更能保留清晰外观。这里的“语义推理”是作者对生成效果的表述,系统没有显式语义部件标注、推理链、语言代理或可验证规则引擎。
Our Interpretation 这是一种将参考外观先验与目标几何约束分开的测试时优化。目标椅子应有自己的靠背、扶手和坐垫布局,不能只把源图像贴到正面;但“枕头应放在哪”“眼睛应位于何处”仍来自扩散模型的视觉先验,不是显式对应关系。跨种类成功说明有适应空间,不构成所有类别上的保证。v1 §1–2
04 · 形式化与材质表示
输入照片集 \(\mathcal I=\{I_k\}_{k=1}^{K}\),常规设置 \(K\in\{3,4,5\}\),以及固定三角网格 \(\mathcal M\)。照片不需要与目标 mesh 对齐,也未要求提供源照片相机标定。优化时另采样目标相机外参 \(c\),用目标法线图 \(k(c)\) 作为空间条件。避免将照片下标 \(k\) 与论文的法线符号 \(k\) 混淆。
论文的“三种参数”指 RGB albedo、标量 roughness 与标量 metallic 三类,实际输出为 5 个数值通道。多尺度 hash encoding 将表面 3D 位置编码,small MLP 输出材质。几何顶点、拓扑、法线图均不作为待学习输出;作者有意不优化 normal map,以免借法线伪造与 mesh 不一致的细节。材质法线固定不意味着 ControlNet 不使用法线,两者角色不同。v1 §3.2
前式用固定 HDR 环境 \(E\) 渲染图像 \(x\),后式解释 UV 烘焙:每个 texel 的 UV 坐标 \(u\) 对应 mesh 表面位置,再查询已经优化的场。这里用大写 \(M\) 表示 metallic 图时不要与花体 mesh 混淆。论文没有给出最终贴图分辨率、UV 展开方法、padding、抗锯齿或接缝修补参数,因此不能承诺 4K、8K 或某种 atlas 格式。
这不是 SBS/SBSAR、shader graph 或程序生成:没有节点类型、连边、拓扑搜索、离散程序序列;也没有训练一个直接预测整张材质图的条件生成网络。其可编辑性主要来自标准 PBR 参数图,重复使用到新目标仍需针对新几何优化。

05 · 阶段一:把纹理记进 DreamBooth
对每个参考物体,将前景从原背景中分离,背景设成白色。短边 resize 到 512,再随机裁 \(512\times512\) patch。训练 prompt 原文为 A photo of [V] object,其中 [V] 是唯一标识符占位;论文没有公开具体 rare token 的拼写、tokenization 或不同物体的完整 prompt 配置。这个图像集合是实例级适配数据,不是预训练大规模语料。
Our Interpretation 上式是解释“标准 diffusion denoising supervision”的等价教学写法,不是论文新增编号公式;\(\mathcal E\) 表示 latent diffusion 的图像编码步骤。论文没有展开 VAE 尺寸、scale factor 或预测参数化。不要把它写成作者明确采用的某个 Stable Diffusion checkpoint。
不使用 class-specific prior preservation loss。 作者希望让个性化外观推广到不同类别,而非把“object”保留成单一来源类。联合微调 text encoder、在个性化阶段使用预训练 ControlNet 的变体未带来改善;这些结论未给独立定量表。正文称 DreamBooth 比 textual inversion 收敛更快、复杂纹理更好,但没有公布训练时长曲线与量化对照,应标为经验观察。
源背景移除用 U2-Net 自动遮罩或 remove.bg 半自动处理。本文报告的是作者的数据准备,不代表本次上传用户图片到这些服务。输入遮罩错误会被当成纹理记忆;白底一致性减少源照片背景与目标渲染分布差异。v1 §3.2
06 · 从 SDS 到 VSD:残差究竟是什么
设时间步 \(t\)、标准高斯噪声 \(\epsilon\sim\mathcal N(0,I)\)、加噪图像 \(x_t=\alpha_t x+\sigma_t\epsilon\)。论文用 \(x\) 简记渲染图像及其扩散输入,不展开 latent 编码链。\(w(t)\) 是时间加权,具体函数及时间采样区间未公布。所有噪声预测都在同一加噪样本上比较。
SDS 将模型的噪声预测与实际加进去的噪声比较,再沿渲染器链传播到材质;大 guidance 往往带来饱和、平滑外观。终稿显式写 \(y^c\) 为视角相关文本。v1 数学式写 \(y\),实现段已说明采用 view-dependent prompt,因此这是一处符号澄清,不应宣称终稿才加入此设计。
Eq.(1) 是原 VSD 的“当前渲染分布”去噪学习,通常用 LoRA 与相机编码器;Eq.(2) 用通用/目标先验与当前分布的预测差替代 SDS 的“预测减白噪声”。这能理解为推动渲染分布接近先验,但把 3D 参数直接与图像分布做 KL并非严格的跨空间定义;应先经视角渲染与扩散加噪得到可比较图像分布。论文对此作概括,本页不把概述当作完整变分推导。
关键陷阱是把 Eq.(1) 的所有训练参数原封不动套到 TextureDreamer。作者最终删掉 LoRA,冻结通用扩散模型本体,只留下相机编码器学习。因此实际 PGSD 分支的表达能力弱于 vanilla VSD,不能直接把原 VSD 的理论解释、参数量和完整拟合能力等同迁移过来。v1 §3.1 · 终稿 Eq.(1–2)
07 · PGSD:个人化外观减去几何条件下的通用解释
\(\psi\) 是参考照片适配完成的个性化 denoiser;\(\phi\) 是原始预训练通用 denoiser,而非另一份 DreamBooth 权重;\(\rho\) 是可学习相机编码器。两条分支都加入以目标normal map为条件的预训练 ControlNet。终稿中只有个人化分支写 \(y^c\),通用分支写 \(y\) 并另收连续相机 embedding;不应把视角文本条件与相机编码器合并成同一个模块。
法线控制与材质优化是分工关系:固定 mesh 决定 normal map;ControlNet 帮助二维噪声预测尊重目标布局;微分渲染把二维残差整合到共享三维材质场。共享场带来跨视角参数一致性,但依旧可能出现 Janus 图案,不是数学保证的跨视图语义唯一性。
Our Interpretation 此式把论文 Eq.(1) 与“删除 LoRA、只更新相机编码器”的文字对应起来;\(\operatorname{sg}\) 强调拟合当前分支时不应顺便更新材质的常规分离方式。官方训练实现未公开,stop-gradient 位置、交替频率、一次材质步对应多少相机步并不能据此确认。 这不是声称从作者代码中恢复出的训练循环。
原笔记所说的“两个 diffusion 结果做差后同时返传相机与材质”需要细化:PGSD 的差值用于材质梯度,相机编码器基于噪声拟合目标更新;不能默认它们共享同一个残差 loss。删除 LoRA 导致更稳定/纹理更忠实,是本文经验设计;关于 rare identifier 让 LoRA 分布偏离的原因仅为作者假说。v1 PGSD 定义与设计选择
08 · 模块、冻结状态与未公开的规模
| 模块 | 确定结构或来源 | 实例适配阶段 | 材质优化阶段 |
|---|---|---|---|
| 个人化 diffusion \(\epsilon_\psi\) | 预训练 latent diffusion,经 DreamBooth 适配 | 适配 denoising network;联合 text encoder 变体未改善 | 作为固定外观先验;无继续更新报告 |
| 通用 diffusion \(\epsilon_\phi\) | 原始预训练权重;最终移除 LoRA | 不承担照片个性化 | 固定 denoiser,仅其 camera embedding 分支训练 |
| ControlNet | v1.1,normal 条件,两分支均使用 | 个性化阶段的替代变体未改善 | 预训练控制;论文未报告重新训练其权重 |
| 相机编码器 \(\rho\) | 两层 linear,相机外参 → 1,280 维,与 U-Net 时间/文本 embedding 融合 | 不用于保存输入外观 | 更新;隐藏层宽、激活、输入外参展平规范未给 |
| BRDF field \(f_\theta\) | 多尺度 hash grid + small MLP,3D → 5 通道 | 不训练目标材质 | 更新 hash encoding 与 MLP;层宽、层数、hash 配置未给 |
| Nvdiffrast 与 shading | 微分栅格化,microfacet BRDF,固定 HDR 照明 | 无 | 提供图像对材质导数;不更新 mesh 或 normal map |
论文只命名 latent diffusion 与 ControlNet v1.1,没有提供精确 backbone/checkpoint、U-Net 总参数、文本编码器/VAE 型号或总可训练参数量。不应因为相机 embedding 是 1,280 维,就反推出公开未确认的 SD1.5、SD2.1 或 SDXL。没有基础模型与“大模型”两档实验,唯一配置的缺失项应显式保留为未公开,而非编造 Large 结果。终稿 implementation details
09 · 训练配方与复现缺口
| 项目 | 论文可核实设置 | 不能补成事实的内容 |
|---|---|---|
| 照片数 / 预处理 | 3–5 张;白底前景;短边 512;随机 512² crop | mask 阈值、色彩空间、插值、增强概率 |
| DreamBooth 目标 | 标准去噪;不使用 class prior preservation | optimizer、learning rate、batch、steps、scheduler、seed |
| hash encoding 学习率 | 0.01 | hash levels、每层 resolution/feature、表长、权重衰减 |
| MLP 学习率 | 0.001 | 层数、宽度、激活、参数初始化与输出约束 |
| 相机编码器学习率 | 0.0001 | 两层中间宽度、训练频率、输入矩阵坐标规范 |
| PGSD CFG scale | 1.0;没有额外 CFG 放大 | 不得误写“无文本条件”或 CFG scale 0 |
| 框架 / 渲染 | PyTorch、Threestudio、Nvdiffrast;固定 HDR;白色背景 | 依赖版本、具体 HDR、渲染分辨率、相机采样范围、光照强度 |
| 训练与算力 | 未给出可核实完整配方 | GPU 数/型号、训练时间、显存、AMP、warmup、梯度累积、停止步数 |
| 扩散采样 | 按时间步加噪并比较预测 | noise scheduler、时间范围、权重 \(w(t)\)、每步视图数、timestep annealing |
| 导出 | 根据 UV 对场查询并生成 albedo/metallic/roughness 图 | 分辨率、UV 生成、纹理边界处理、文件格式、导出脚本 |
两页补充材料只增加实验,不包含训练 recipe。复现者可以选择 Adam、常见 Threestudio 配置或标准 DreamBooth 训练轮数,但必须标注为自行设定,不能把上游默认值写成该论文的正式实现。此处没有下载权重、运行模型或估算硬件时间。
10 · 实际执行顺序与 CFG 解释
- 准备一个源外观的 3–5 张照片与前景 mask,统一白底;为该源外观适配个人化 denoiser。
- 选取固定目标 mesh、UV 映射、固定 HDR 环境;初始化 hash-grid BRDF 场与相机编码器。源与目标的表面点没有显式一一对应。
- 采样目标相机,渲染 RGB 与 normal map;构造视角相关文本和连续相机 embedding;对 diffusion 输入加噪。
- 两条带 normal-ControlNet 的分支对同一样本预测噪声,用 PGSD 残差更新 BRDF 场;按去噪目标更新相机编码器。具体交替节奏未公开。
- 重复至预设优化预算/收敛;论文没有公布停止规则、候选数量、自动选优或失败重试流程。
- 查询场并烘焙贴图,在新光照下渲染。更换随机种子能产生不同花纹布局;图像数量/覆盖不足时可能无法恢复背面语义。
这不是一次普通扩散采样完成的 inference;大量工作发生在针对源外观的适配、针对目标 mesh 的材质优化。没有 temperature、top-k/top-p、beam search、工具代理、反思或程序执行语法约束,不能用这些术语伪装这里的流程。
常用实现约定下 scale=1 就是保留条件预测,无额外引导;原始 CFG 另一写法 \((1+\omega)\epsilon_{\mathrm{cond}}-\omega\epsilon_{\mathrm{uncond}}\) 对应 \(\omega=0\)。两者一致。论文将不需要 CFG 与小样本个性化、追求忠实迁移联系起来;这只是此系统的实验解释。CFG 普遍是调节条件服从性/采样分布的机制,并非通用“增加多样性”开关,不能据此断言所有少样本材质方法都应关 CFG。
Reviewer 同一 HDR 优化使 albedo、roughness、metallic 之间存在补偿空间。白底与固定照明帮助拟合稳定,却没有消除反照率和照明歧义。含高光输入可能被记到 albedo 里;可在新光照渲染只是参数化具备此能力,真实 BRDF 恢复还需物理 ground truth 或多光照验证。
11 · 数据、基线与公平性
作者自建四类外观:sofa、bed、mug/bowl、plush toy。每类 8 个对象,每对象 3–5 张照片,共 32 组参考;按区间算是 96–160 张源图,精确图像数未公布。每类选 3 个不同于参考对象的目标 mesh,共 12 个主要目标,来源含 3D-FUTURE、CGTrader、Sketchfab。同类全组合若全部执行为 \(4\times8\times3=96\) 对,这是由设置推得的数量,论文未给逐对清单或完整跨类总数。
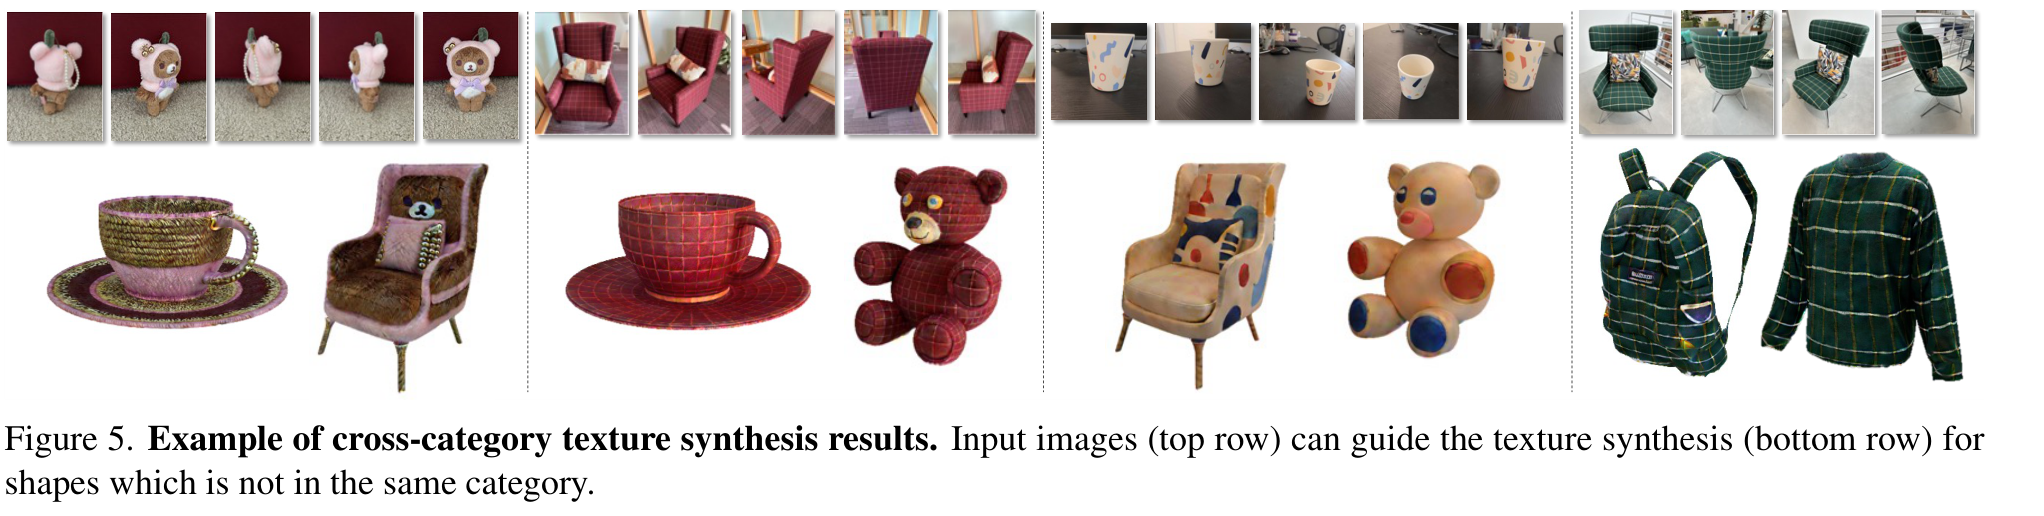
另做 bed↔chair 跨类评估,并展示 mug/plush/chair 等更大差异;终稿扩展到包、衣服和扫描物体。这不是 32 类也不是 32 个 mesh。模型是实例级优化,没有传统单一监督学习 train/val/test 划分;论文没有公开统一划分表、完整对象 ID、权重与全部输入原图集合。
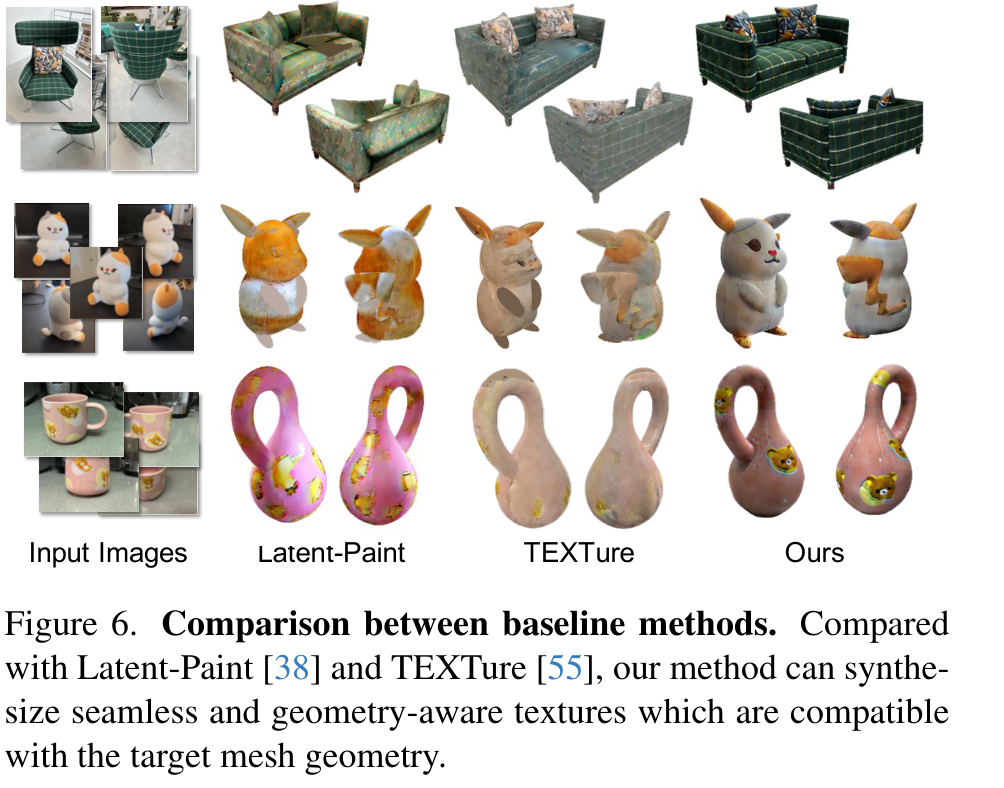
| 方法 | 输入外观适配 | 目标贴图过程 | 比较时需注意 |
|---|---|---|---|
| Latent-Paint | textual inversion;正文写成 Texture Inversion,但引用 [16] 是 Textual Inversion | SDS 驱动的纹理优化 | 相比 DreamBooth,适配容量与方法同时变化 |
| TEXTure | 结合 textual inversion 与 DreamBooth 的个性化 | 逐视角迭代 painting | 背景按基线惯例随机颜色;与 ours 白底不同 |
| TextureDreamer | DreamBooth、去掉 class prior preservation | geometry-conditioned score residual → 共享 BRDF 场 | 同时改变分数目标、几何条件与表示,主表不能归因到单个模块 |
作者声明紧跟基线原实现;但未报告等算力预算、墙钟时间、调参次数、不同随机种子的方差或相同输入预处理的完全消融。因此可说在所报告协议下整体效果优越,不能推断同等计算预算下每个组件单独领先。v1 §4.1–4.3


12 · 全部主结果:人类偏好与 CLIP
原 Table 1:每项指标的完整两列
| 评价项 | Ours preferred over Latent-Paint | Ours preferred over TEXTure |
|---|---|---|
| Image Fidelity | 71.82% | 69.43% |
| Texture Photorealism | 77.03% | 85.52% |
| Shape-Texture Consistency | 78.49% | 85.16% |
数值是 “ours preferred over baseline” 的选择率,不是绝对质量分、识别正确率或质量提升百分比。对 Latent-Paint 的偏好为 71.82%、77.03%、78.49%;对 TEXTure 为 69.43%、85.52%、85.16%。例如 85.52% 相对随机二选一 50% 高 35.52 个百分点,不表示 photorealism 指标提高了 85.52%。
Amazon Mechanical Turk 上设置三个独立任务:外观接近输入、材质像真实物体、纹理适合目标几何。每位用户每个任务 24 题,每题 ours 对一条 baseline,展示相同 4 个采样视图,每题由 20 位用户评估。仅“接近输入”任务展示输入照片,另两项隐藏参考以关注自身质量。论文未明确总独立参与者数、题目总池、每基线分配、报酬、去重/质控、置信区间或显著性检验;不能把 20 写成整个实验的总参与人数,也不能由 24×20 直接推定总独立评分数。终稿 user study protocol
原 Table 2:完整方法行
| 方法 | CLIP similarity ↑ |
|---|---|
| Latent-Paint | 0.7969 |
| TEXTure | 0.7988 |
| Ours | 0.8296 |
Ours 比 Latent-Paint 高 0.0327(相对其分数约 4.10%),比 TEXTure 高 0.0308(约 3.86%)。相对百分比只是在相同 CLIP 度量上的算术比较,不能作为感知质量增益。所有参考图与渲染图使用白背景,渲染取 left-front/right-front/left-back/right-back 四视角;每组先平均所有参考–渲染配对,再平均各组。
Our Interpretation 此式按论文文字协议展开平均过程;具体 CLIP backbone、resize/crop 预处理与特征归一化实现未公开。每组使用全部图像交叉比较,没有逐像素对应;CLIP 容易奖励“像原照片”的语义/图案,却不检验纹理是否尊重目标几何。因此无需也不适合凭空添加 PSNR/SSIM 结果。v1 CLIP protocol

13 · 完整消融:最高 CLIP 并不是完整模型
| 配置(保留全部原始方法行) | CLIP similarity ↑ |
|---|---|
| w/o ControlNet | 0.8394 |
| w/ ControlNet (Depth) | 0.8320 |
| SDS, w/o CFG | 0.8101 |
| SDS, CFG 100 | 0.7983 |
| w/o LoRA removed(保留 LoRA) | 0.8110 |
| Personalized model as φ | 0.8218 |
| CFG weight as 7.5 | 0.8218 |
| w/o camera encoder ρ updated | 0.8267 |
| Ours | 0.8296 |
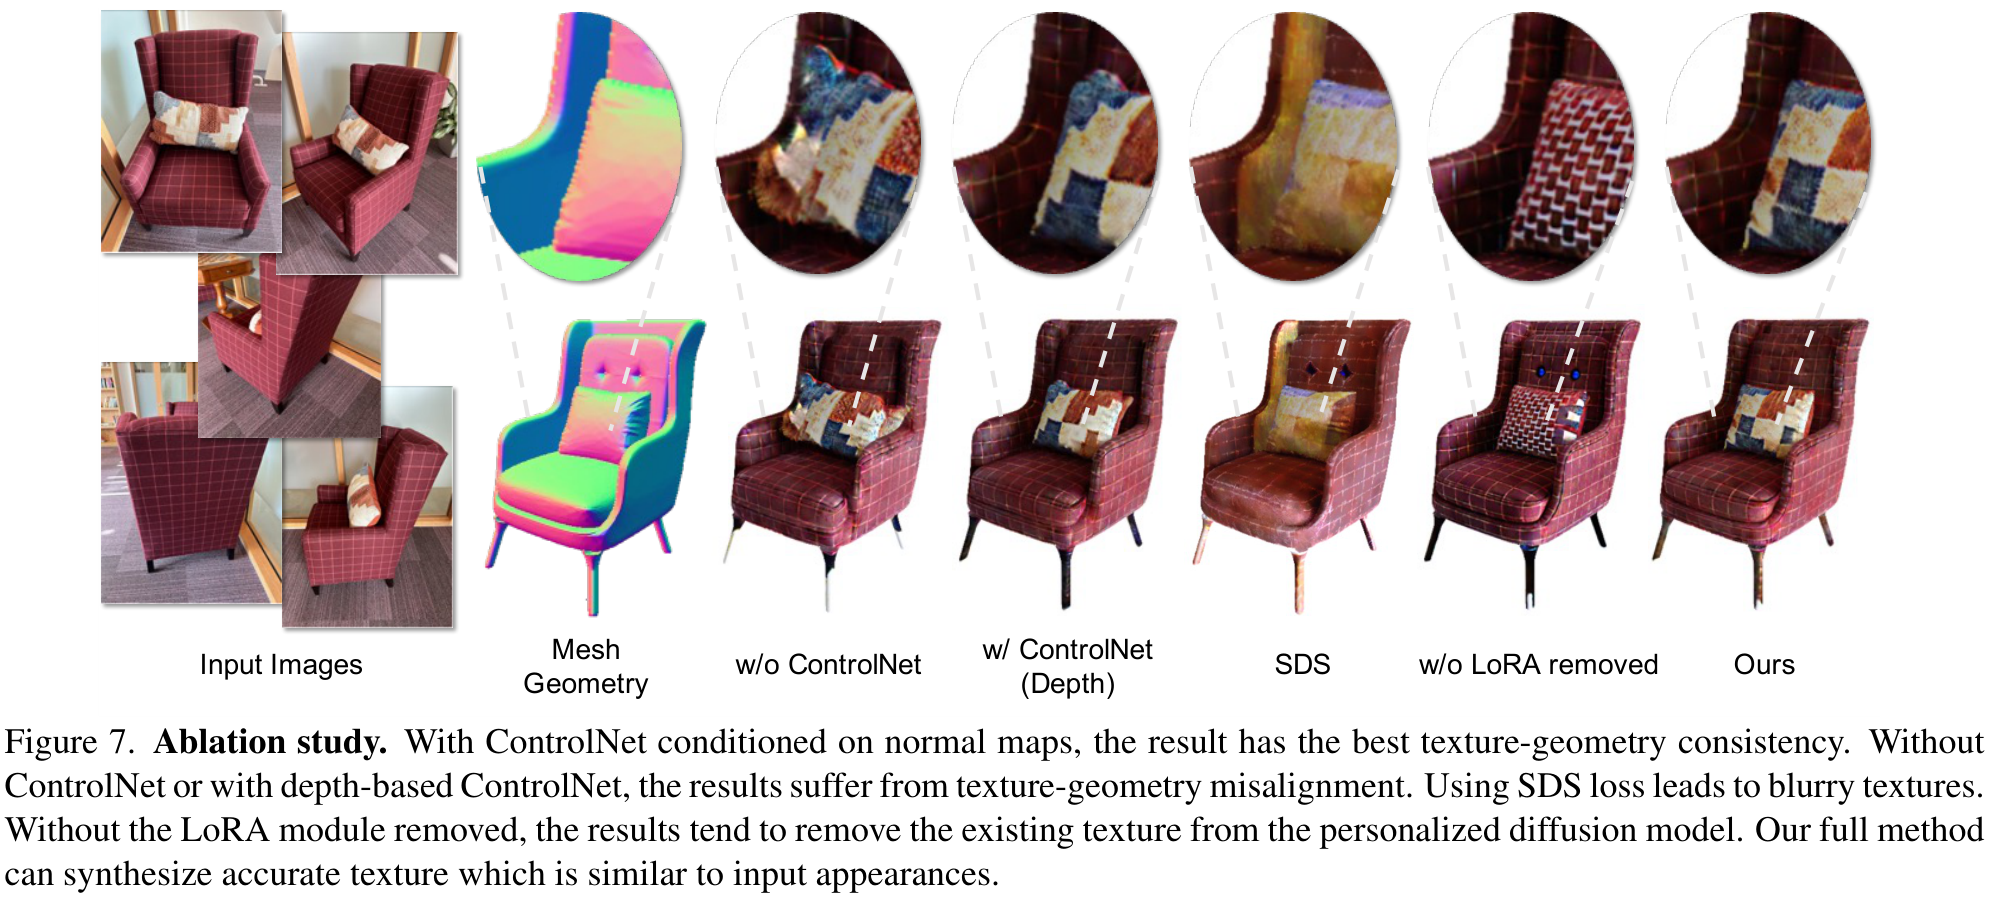
保留论文的奇特标签 “w/o LoRA removed”,其含义是没有执行删除 LoRA,也就是仍保留并训练 LoRA,不可误译成 “没有 LoRA”。完整模型为 0.8296;无 ControlNet 为 0.8394,高 0.0098;Depth-ControlNet 为 0.8320,高 0.0024。作者用图示说明它们倾向于忽略目标几何,把源纹理直接画上去,因此高 CLIP 与更好几何适配不一致。
其余消融相对完整模型的差值分别为:SDS 无 CFG 低 0.0195;SDS CFG100 低 0.0313;保留 LoRA 低 0.0186;以个人化模型替换通用分支低 0.0078;CFG7.5 低 0.0078;冻结相机编码器低 0.0029。最后一项差距较小且没有方差,不应声称统计显著。两项恰好同为 0.8218 是原表数值,不是抄写重复。
| 设计检验 | 可观察结果 | 结论边界 |
|---|---|---|
| normal 控制 vs depth / 无控制 | 图示部件对齐更好,但 CLIP 更低 | 支持几何条件的作用;未报告独立几何指标或对应消融人类偏好 |
| PGSD vs SDS | 纹理更清晰,CLIP 更高 | 不同 guidance、条件适配和表示细节需控制后才能纯归因 |
| 删除 LoRA | 减少无关花纹,更接近输入 | 不证明 LoRA 普遍不适合材质生成;rare identifier 机制仍是假说 |
| 原始通用模型 vs 个人化模型 | 个人化对照出现随机图案 | 说明该任务中残差参考分布的选择重要,不等于个性化分支本身无效 |
| CFG1 vs 7.5 | 7.5 更易出现无关图案 | 局部超参比较;没有完整 sweep,不推出 CFG 的普适最优值 |

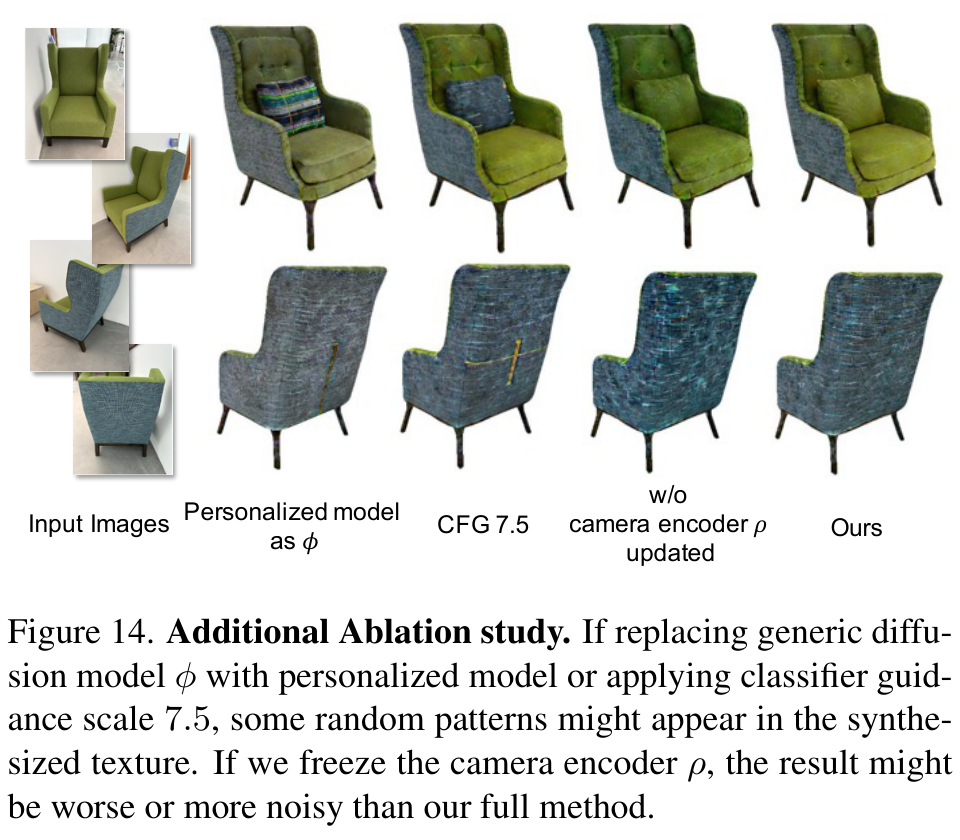
v1 Table 3 与 终稿补充 Table 3 所有 9 行数字一致,最终版本没有新增消融定量结果。
14 · 终稿与补充实验,逐项读完
输入照片数量
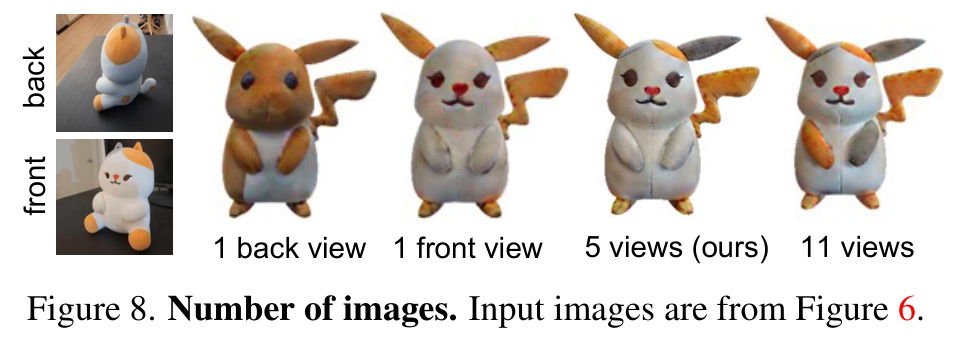
终稿 Fig.8 比较单独 back view、单独 front view、5 views、11 views。正文称单张信息不足,11 张未显示纹理质量优势。它是一组定性比较,没有每个数量的汇总表,也没有把“数量”与“视角覆盖/曝光/样本冗余”完全解耦。因此“3–5 张足够”是所示对象上的实践设置,不是全对象的采样复杂度定理。
不同种子的布局变化

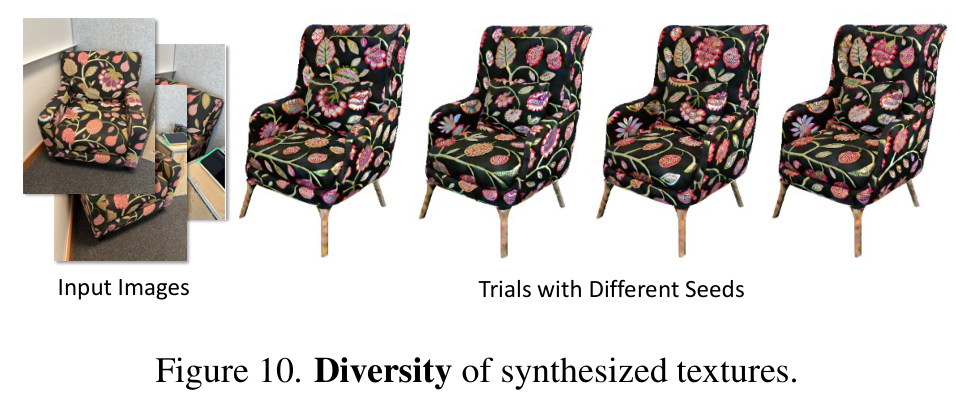
v1 Fig.8 与补充 Fig.10 展示相同参考下不同种子。输出有变化而保持外观,可说明多解性;未提供 diversity 指标、种子清单或失败概率。按种子变化生成的是纹理布局,不是生成新几何。
重光照与镜面高光

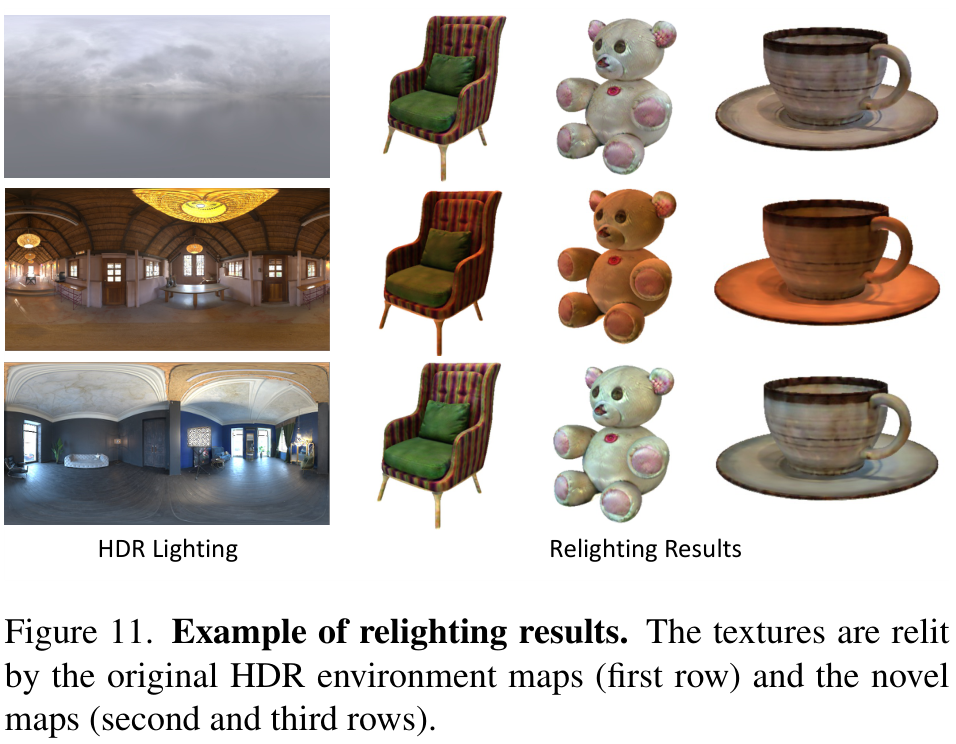
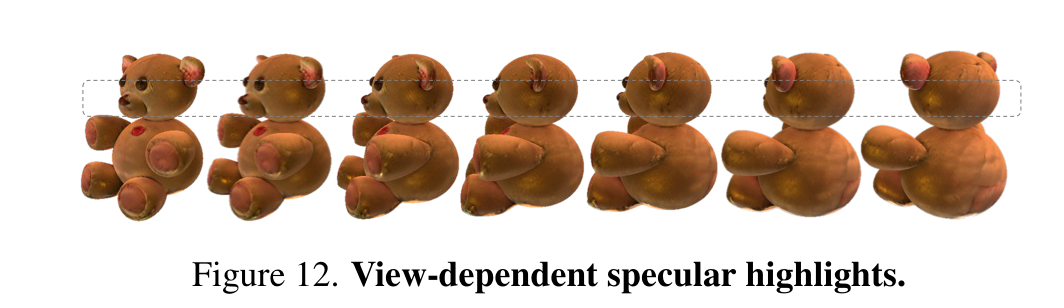
补充 §6.2 承认结果偏 diffuse、会烘入 lighting/specularity,但低 roughness、高 metallic 示例在新 HDR 下仍表现出视角相关高光。Fig.12 是对“完全没有视角效果”的反证示例,不是材质参数精确恢复的验证。缺少已知 BRDF、同一对象跨光照误差或 roughness/metallic 标定。重光照图片与该镜面示例都保留,不能只选好看的 albedo 效果。
真实扫描表面
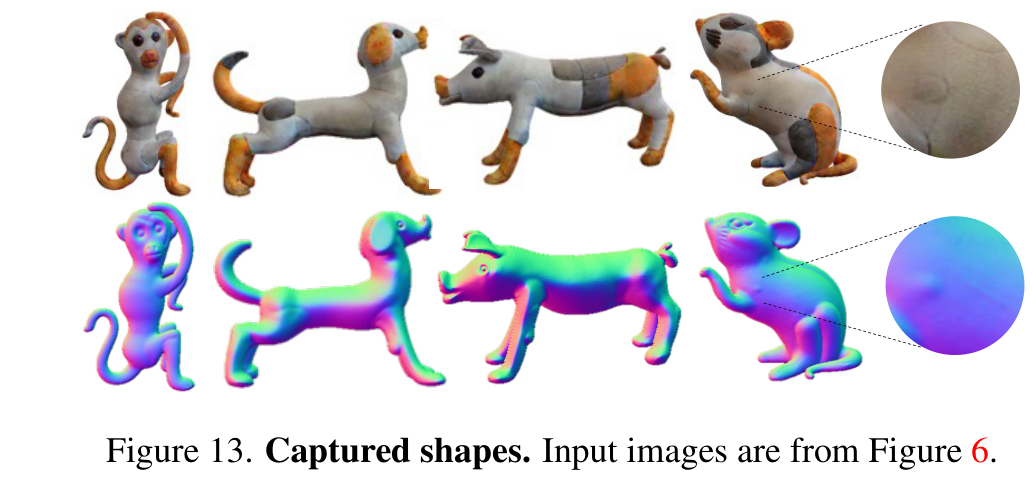
补充 §6.3 使用商业 3D 扫描器捕获 solid art objects;原图圈出的表面瑕疵会造成异常纹理/缺陷。normal guidance 对几何敏感是一体两面:它能对齐结构,也可能忠实响应扫描噪声。论文引用扫描工作 [34],但没有公开本实验逐网格质量、扫描仪型号、去噪与简化参数。完整 2 页补充文档
15 · 失败模式与可重光照的真实含义

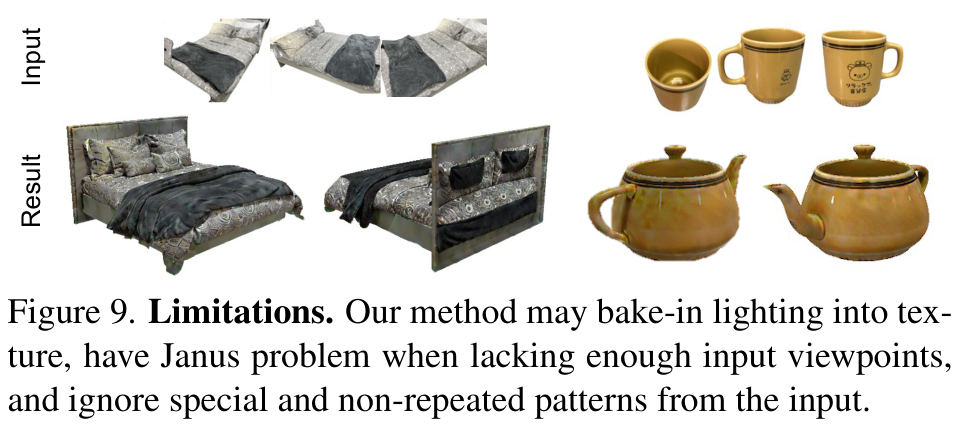
- 特殊、非重复图案可能消失。 全局外观先验擅长重组统计纹理,标志性单次符号、logo 或罕见局部细节未必被准确保留。整体 CLIP 高分不能保证图案身份。
- 高光或照明进入贴图。 源图中强 specular highlight 可能被 baked into texture;换光之后会出现不该固定的亮斑。最终 roughness/metallic 图存在并不消除逆问题歧义。
- 视角覆盖不足仍有 Janus。 不同视角条件与 normal-ControlNet 没有提供源对象背面的新证据,多张前面照不能等价替代有代表性的背面。
- 目标几何的错误可传给纹理。 扫描噪声在 normal 条件中显现,可能诱导不需要的图案;对异常拓扑、极薄面、遮挡内腔没有系统成功率。
- 计算与可复現成本未知。 没有官方方法实现、总时间、显存或精确 budget;不能承诺商业批量吞吐,更不能把逐对象优化当作实时一键工具。
“arbitrary categories” 应读为不限于单一训练类别的目标形式,而不是已覆盖所有材质类别。四个主要对象类别集中于日常物体,透明、半透明、各向异性、纤维、层状涂层等不由本文 5 通道简化 BRDF 完整表达。论文也没有生成 normal/bump/displacement,因此凹凸细节依赖现有 mesh 或被压进颜色。
16 · 官方实现审计与资源边界
截至 2026-09-30,核查官方项目页、项目 GitHub 账号的公开仓库清单及完整项目树。官方公开仓库 texturedreamer/texturedreamer.github.io 的可核实提交为 e32c2a514c76a2fe1c8066a261e3be35473e23ce(2024-05-16)。共有 113 个文件对象,主要是网页、CSS/JS、3 张项目图与 94 个 MP4;没有 TextureDreamer 的训练 Python、配置、导出脚本或模型权重。
仓库 README 明确将其定位为 project page。About code(2024-03-13)和 code release?(2024-06-05)仍 open,API 返回均无评论。这里能得出的谨慎结论是所核查官方入口没有发布方法实现,而不是声称整个互联网不存在任何私人代码或后续复现。
名称相近的 TexDreamer: Towards Zero-Shot High-Fidelity 3D Human Texture Generation 是另一篇 ECCV 2024 论文,不能拿其代码、Stable Diffusion 版本、LoRA rank 或训练设置补到此文。Threestudio、DreamBooth、ControlNet、TEXTure 的上游源码也不等于 TextureDreamer 的官方具体训练配方。
| 表述 | 核对结果 | 本页处理 |
|---|---|---|
| 本文使用 VSD | 受 VSD 启发,但最终删掉 LoRA,仅保留 camera fitting | 分开解释 vanilla VSD Eq.(1–2) 与 PGSD |
| “Texture Inversion” | 引用的 [16] 实为 textual inversion | 保留原文称呼并解释,避免虚构另一算法 |
| 本方法 CFG=1 | 等价原 CFG 公式的 \(\omega=0\) | 条件仍保留,未设成 unconditional |
| “三种 BRDF 参数” | RGB+1+1 共 5 通道 | 明确张量维度与三类材质图 |
| v1 与终稿 | 图号/布局变化、附加实验与视角文本符号澄清;三表数字不变 | 分别标注来源,不合成不存在的新版定量表 |
| 作者与通讯人 | 11 位作者;未找到明确通讯标记 | 补充末位 Zhengqin Li,候选保持 unverified |
本次仅读取与静态核查资源,没有执行作者程序、安装依赖或下载权重。交付清单排除作者网页源代码与任何训练代码/权重副本;只包含精读、图片、表格、文献 PDF、可复查事实与 QA。论文设定和未公开实现之间的差异是信息缺口,没有源码时不虚构“实现 bug”。
17 · Reviewer:贡献强在哪里,证据缺在哪里
值得保留的贡献
- 将图像级 personalization 与几何感知材质优化组合,绕开纯文字无法准确描述复杂纹理的问题,适用于不对齐的目标形状。
- 输出共享 3D BRDF 场和标准参数图,使多视角一致性与下游重光照进入同一流程,具备明确图形学接口。
- 将普通 VSD 的 LoRA 适配缩减为 camera embedding 学习是可操作的设计发现;消融涵盖分数目标、ControlNet 类型、初始化、guidance 和相机。
- 给出失败图、CLIP 与几何质量冲突,并在终稿追加照片数量和扫描对象,避免只展示同类理想数据。
主要证据不足
- 最想证明的 geometry-texture compatibility 没有独立自动指标;完整方法对基线的人类结果不能替代对 normal/depth/none 消融的人类或几何评估。
- CLIP 与目标强相关但非充分度量。去掉 ControlNet 更高分意味着优化/评价存在偏好错位,不能在选模型时只保留一个全局相似度。
- 假说“rare token 导致 LoRA 偏离”缺乏 rank、learning rate、token 和训练步数的受控 sweep;也可能含过拟合或优化预算因素。
- 研究范围为少量对象的实例优化,没给标准数据发布、总参与者、统计不确定性、算力与完备实现,严格复现成本较高。
- BRDF 的可重光照性主要靠定性示例,缺失材质参数真值、跨照明保真度、镜面恢复和物理可辨识性检验。
Our Interpretation 最合理的总体评价是“有针对性的系统组合与经验性目标改造,展示了图像指导材质迁移的实际可行性”。它不是已经解决材质逆渲染,也不提供直接可运行的公开参考实现。若复现,应先验证残差目标和 normal-conditioning 的交互,再扩展表示;否则很难判断收益来自新方法还是未控制的上游默认设置。
18 · 面向 Procedural Material Generation 的研究延伸
Research Extension 以下是从本文出发的新实验设计,均非作者已实现或验证的结果。
方向一:从连续 BRDF 场蒸馏到可执行材质图
用 PGSD 场提供目标多光照、多视角图像与参数图,把输出从位图升级为图结构 \(G\) 与参数 \(\eta\)。渲染器继续在环,但可微优化只处理连续参数;离散节点/边通过受约束搜索或结构生成器处理。必须同时比较图可编辑性、执行成功率、节点数与材质忠实度,防止一个巨大 bitmap 节点“作弊”。
这是提案目标,不是本文损失。执行合法性可限定节点输入类型、无环/受控循环、输出通道完整、seed 可复现与纹理坐标规范;graph search 每个候选的 GPU 预算需一致。compare:纯直接参数图、固定拓扑参数优化、可变拓扑搜索三组,分别报告失败率与最终效果。
方向二:解决 CLIP 与几何对齐的冲突
设等外观但错误位置的花纹为 hard negatives;以目标部件 mask、曲率/法线分组及视角对应检查局部语义。评估同时保留 global CLIP、局部花纹相似度、跨视图一致性与 blind human preference。把 no-ControlNet 的高 CLIP 样例当作“度量失效测试”,而不是从报告里删除。
方向三:低自由度辅助分支的偏差–方差研究
固定个人化分支,对照 frozen camera、camera-only、不同 LoRA rank、camera+LoRA、低学习率 LoRA;扫 token 类型、源图数量和优化步数。看外观漂移、各向异性高频与 geometry alignment,而非只比较一次 best sample。需要相同 denoiser checkpoint、渲染视角和随机噪声,以及多个对象/种子上的置信区间,才能检验作者关于 rare identifier 的机制解释。
方向四:光照解耦与自适应采集
多 HDR 优化或照明归一化参考可能减少 albedo 的 baked lighting,但也可能使小样本指导变弱。设置已知合成 BRDF 的受控实验,把 albedo、roughness、metallic 的误差与重光照误差分开;加入真实已标定对象验证迁移。若输入覆盖不足,优先请求背面/侧面新照片,而非无差别把数量从 5 增到 11。
方向五:受约束的外层工具代理
代理可以选择可疑区域、调用材质图执行器、渲染局部视图、比较度量、只修改相关节点,再验证是否破坏其他视角。日志必须记录候选图、执行错误、工具返回、预算和选择标准;“自我反思”不能替代执行证据。建立相同渲染调用数下的随机搜索、贝叶斯优化、梯度优化和代理策略对照。此扩展与本文无代理的连续场优化有明确边界。
19 · 原始资源、视频目录与复现清单
官方网页含 sofa、plush、mug、bed、cross-category、relighting、ablation 与 diversity 八组展示。本页把其完整仓库中的 94 个公开 MP4 按文件名列为链接,并放置少量代表性播放入口。静态检查验证 HTTP 响应;未观看视频、未做视觉评分,也未验证浏览器播放或 MathJax 的运行时行为。不得把媒体链接验证当成实验复现。
展开完整 94 个官方 MP4 链接
- bowl_ikea0_cup_with_plate_latentpaint.mp4
- bowl_ikea0_cup_with_plate_ours.mp4
- bowl_ikea0_cup_with_plate_texture.mp4
- bowl_ikea0_imgs_input.mp4
- bowl_ikea0_teapot_latentpaint.mp4
- bowl_ikea0_teapot_ours.mp4
- bowl_ikea0_teapot_texture.mp4
- ikea_bed13_bed_0_latentpaint.mp4
- ikea_bed13_bed_0_ours.mp4
- ikea_bed13_bed_0_texture.mp4
- ikea_bed13_bed_3_latentpaint.mp4
- ikea_bed13_bed_3_ours.mp4
- ikea_bed13_bed_3_texture.mp4
- ikea_bed13_imgs_input.mp4
- ikea_bed14_bed_0_latentpaint.mp4
- ikea_bed14_bed_0_ours.mp4
- ikea_bed14_bed_0_texture.mp4
- ikea_bed14_bed_3_latentpaint.mp4
- ikea_bed14_bed_3_ours.mp4
- ikea_bed14_bed_3_texture.mp4
- ikea_bed14_imgs_input.mp4
- mmmm_chair1_Pikachu_ours.mp4
- mmmm_chair1_bear_ours.mp4
- mmmm_chair1_bed_0_ours.mp4
- mmmm_chair1_bed_1_ours.mp4
- mmmm_chair1_cup_with_plate_ours.mp4
- mmmm_chair1_imgs_input.mp4
- mmmm_chair1_sofa_0_latentpaint.mp4
- mmmm_chair1_sofa_0_ours.mp4
- mmmm_chair1_sofa_0_texture.mp4
- mmmm_chair1_sofa_2_latentpaint.mp4
- mmmm_chair1_sofa_2_ours.mp4
- mmmm_chair1_sofa_2_texture.mp4
- mmmm_chair1_teapot_ours.mp4
- mmmm_chair7_imgs_input.mp4
- mmmm_chair7_sofa_0_cfg.mp4
- mmmm_chair7_sofa_0_depth_control.mp4
- mmmm_chair7_sofa_0_no_camemb.mp4
- mmmm_chair7_sofa_0_no_control.mp4
- mmmm_chair7_sofa_0_no_lora_rm.mp4
- mmmm_chair7_sofa_0_ours.mp4
- mmmm_chair7_sofa_0_phi.mp4
- mmmm_chair7_sofa_0_sds.mp4
- mmmm_chair7_sofa_0_sds0.mp4
- mmmm_chair9_Pikachu_ours.mp4
- mmmm_chair9_bed_0_ours.mp4
- mmmm_chair9_bed_1_ours.mp4
- mmmm_chair9_cup_with_plate_ours.mp4
- mmmm_chair9_imgs_input.mp4
- mmmm_chair9_sofa_0_latentpaint.mp4
- mmmm_chair9_sofa_0_ours.mp4
- mmmm_chair9_sofa_0_texture.mp4
- mmmm_chair9_sofa_2_latentpaint.mp4
- mmmm_chair9_sofa_2_ours.mp4
- mmmm_chair9_sofa_2_texture.mp4
- mug_bear0_cup_with_plate_latentpaint.mp4
- mug_bear0_cup_with_plate_ours.mp4
- mug_bear0_cup_with_plate_texture.mp4
- mug_bear0_imgs_input.mp4
- mug_bear0_teapot_latentpaint.mp4
- mug_bear0_teapot_ours.mp4
- mug_bear0_teapot_texture.mp4
- mug_zzz4_Pikachu_ours.mp4
- mug_zzz4_bed_0_ours.mp4
- mug_zzz4_bed_1_ours.mp4
- mug_zzz4_cup_with_plate_ours.mp4
- mug_zzz4_imgs_input.mp4
- mug_zzz4_sofa_0_ours.mp4
- mug_zzz4_sofa_2_ours.mp4
- plush_bear0_Pikachu_ours.mp4
- plush_bear0_bed_0_ours.mp4
- plush_bear0_bed_1_ours.mp4
- plush_bear0_cup_with_plate_ours.mp4
- plush_bear0_imgs_input.mp4
- plush_bear0_sofa_0_ours.mp4
- plush_bear0_sofa_2_ours.mp4
- plush_bear1_bear_light1.mp4
- plush_bear1_bear_light2.mp4
- plush_bear1_bear_ours.mp4
- plush_bear1_imgs_input.mp4
- plush_cat0_Pikachu_latentpaint.mp4
- plush_cat0_Pikachu_ours.mp4
- plush_cat0_Pikachu_texture.mp4
- plush_cat0_imgs_input.mp4
- plush_cat0_orangutan_latentpaint.mp4
- plush_cat0_orangutan_ours.mp4
- plush_cat0_orangutan_texture.mp4
- plush_tokage_Pikachu_latentpaint.mp4
- plush_tokage_Pikachu_ours.mp4
- plush_tokage_Pikachu_texture.mp4
- plush_tokage_imgs_input.mp4
- plush_tokage_orangutan_latentpaint.mp4
- plush_tokage_orangutan_ours.mp4
- plush_tokage_orangutan_texture.mp4
有据可查的最小复现流程
- 先固定照片/遮罩、目标 mesh、HDR、prompt、模型版本与随机种子,记录未在论文给出的自主选择。
- 确认 baseline 与 ours 使用同样目标 mesh、评价相机和 CLIP 预处理;不要把随机背景差异漏记。
- 分别记录 DreamBooth 与 per-mesh 优化的步骤/时间/显存,并发布配置;导出所有材质图与多光照渲染。
- 优先完整重复 9 行消融,再加几何指标;所有结果保留失败,不以最高 CLIP 代替几何合理性。
- 报告无 normal-map 优化的限制;对强镜面、高光源图、logo、背面缺失和扫描噪声单列鲁棒性测试。
一手资料
- 用户指定 arXiv v1 PDF · arXiv 版本记录 · 官方 HTML 与原图
- CVF 正式论文记录 · CVPR 终稿 PDF · CVPR 2 页补充材料
- 作者项目主页 · 官方链接演示视频(未观看)
- 固定提交的官方项目站仓库 · 完整公开树
- IEEE 提交的 Crossref 元数据 · 出版 DOI
阅读覆盖:13 页 v1、11 页终稿、2 页补充文档;所有 3 张原始数据表与版本图像覆盖。研究内容、作者解释、审稿评论和研究提案分别标识。图片版权属于原作者。保留原始 Markdown 与 PDF++ 标注;归档仅形成候选计划,浏览器 QA 按用户要求推迟。