01 / 身份与版本
这是一篇介绍可组合研究框架的六页短论文,不是一项提出全新 score distillation 目标的算法论文,也不是大规模统一评测。主文第 1–4 页,参考文献第 5–6 页;没有独立附录、编号数学公式或定量性能表。共有 6 幅图和 2 张方法组件设计表,下文全部覆盖。
论文作者顺序:Ying-Tian Liu、Yuan-Chen Guo、Vikram Voleti、Ruizhi Shao、Chia-Hao Chen、Guan Luo、Zixin Zou、Chen Wang、Christian Laforte、Yan-Pei Cao、Song-Hai Zhang。机构为 Tsinghua University、Stability AI、Tencent AI Lab、ARC Lab, Tencent PCG。† 表示部分工作在腾讯实习期间完成,不是共同一作或通讯作者标记。第一作者为 Ying-Tian Liu;没有明确通讯作者标记,Song-Hai Zhang 仅作为末位作者候选。原文 p.1
固定 PDF SHA-256:b5f853bf3d927838049c7e3e2a2fbec2c12d5938185b7bb579c7bb5bc87862b5。清华官方 PDF 与原文件逐字节一致。代码审计固定为 28d9d80d9d00f308244adfcf3be8b17ca0cb6465(2024-12-16);历史上下文为 8a51c37317b6f7cd74bb3cb24c975b56d0a96703(2023-08-28),后者不是作者确认的实验 release。
阅读标记:Paper Verified 指原文列出或图中实际呈现;Author Claim 指作者评价;Our Interpretation 指数学和工程解释;Research Extension 指尚未被本文验证的设想。以下所有补充公式都属于解释,原论文没有编号公式。
02 / 研究缺口与贡献
DreamFusion 证明了二维扩散先验可以在测试时指导三维场景优化。后续方法分别改善几何、纹理、多样性、速度和图像条件,但实现分散在不同代码库。替换 guidance 时常同时改变相机、初始化、表示与正则,难以判断收益来自哪里。threestudio 填补的是方法组合与实验比较的基础设施缺口。原文 p.1
四项原则各有对象:Modular 是同阶段换组件;Extensible 是添加新组件;Flexible 是串联不同 pipeline;Configurable 是用一个配置文件控制模块和超参数。它降低集成成本,却不自动保证任意两个组件兼容、优化稳定或实验公平。
核心假设是不同方法共享“采样观察条件 → 可微渲染 → 二维先验给出梯度 → 更新场景”的骨架。把变化点显式化,可以保留一个方法的形状优势,同时借用另一个方法的纹理策略。代表案例是 TextMesh geometry 接 ProlificDreamer geometry / texture。
贡献主要是接口抽象、开放实现、跨方法组合与实践经验。本文没有提出新三维训练集、graph grammar、tokenizer 或语言模型推理策略;也没有证明一组组件组合普适最优。
03 / 输入、输出与数学对象
Our Interpretation:下面的统一记法帮助理解接口,不是作者新增理论。
| 对象 | 含义 |
|---|---|
| \(y\) | 文本 prompt,或源图像与相对相机条件 |
| \(c=(K,T),\ell\) | 相机内外参及可选光照;决定优化观察分布 |
| \(\theta=(\theta_g,\theta_m,\theta_b)\) | 待优化的几何、材质与背景参数;阶段之间可能冻结或转换 |
| \(G,M,B,R\) | 几何、材质、背景与可微渲染器 |
| \(\phi,\psi\) | 预训练扩散参数与 VSD 中可训练适配器参数 |
| \(t,\epsilon\) | 扩散时间步与高斯噪声;不同于三维优化迭代步数 |
单次前向生成的是一张渲染图像,而不是完整三维资产。反复更新的对象是共享场景参数,条件文本或图像提供监督。输出可以是连续场,或经表面提取与纹理烘焙导出的 mesh。“优化完成”和“可直接用于 DCC 的高质量 PBR 资产”不是同一验收标准。
这是概念性目标。SDS 常直接指定梯度,而非给出可跨对象比较的显式 likelihood loss。相机分布控制哪些表面受到约束;正则控制漂浮密度、法线和平滑性。图像任务通常还要对已知视角 RGB / mask 作重建监督。
框架没有统一“总参数量”:每对象场景参数与外部预训练先验必须分别计算。Zero-1-to-3 在 Objaverse 上的模型训练不是 threestudio 对一张输入图像执行的优化。前者学习通用先验,后者是 test-time optimization。
04 / 七个模块的数据流
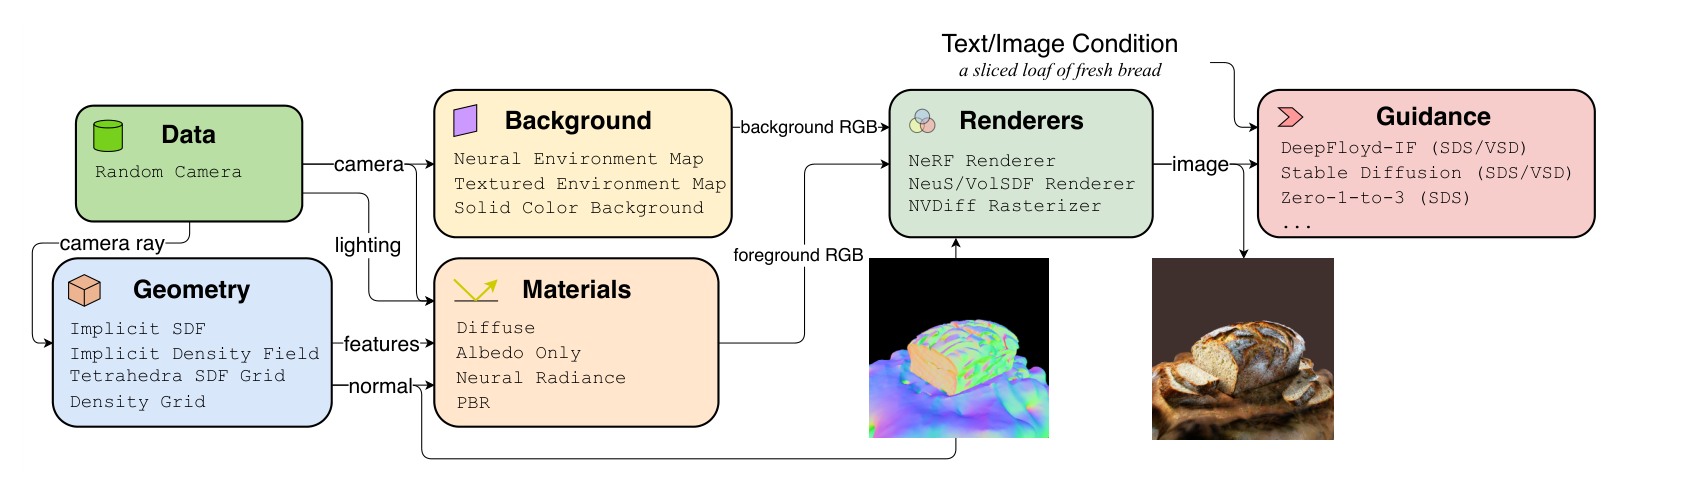
| 模块 | 输入 → 输出 | 关键选择与耦合 |
|---|---|---|
| Data Synthesizer | 范围 / 策略 → 相机、射线、光照 | elevation、azimuth、distance、FOV 共同控制所见面和尺度 |
| Geometry | 空间坐标 → 密度 / SDF、特征、法线 | implicit density、implicit SDF、density grid、SDF grid、mesh |
| Renderer | 场景和相机 → RGB / opacity / depth / normal | NeRF 配密度;NeuS / VolSDF 配 SDF;表面配 rasterizer |
| Material | 特征、法线、观察 / 光照 → 前景颜色 | Albedo Only、Diffuse、Neural Radiance、PBR |
| Background | 方向 → 背景颜色 | 小网络、显式纹理环境图、常量颜色 |
| Diffusion Guidance | 渲染与条件 → 更新信号 | SDS / SJC / VSD;SD / IF / Zero-1-to-3 等先验 |
| Prompt Processor | 文本和相机 → 条件嵌入 | 匹配 backbone;视角后缀、PerpNeg、Prompt Debiasing |
七个模块不是可任意排列的黑盒。Renderer 要支持 geometry 的数据结构;material 要拿到所需法线与特征;prompt encoder 要与 diffusion backbone 一致。system 层还负责损失与阶段控制:即使组件表相同,不同正则和 schedule 也会产生不同算法行为。原文 p.2
背景环境图按射线方向返回颜色,不必等价于照亮物体的环境光;神经 radiance 能拟合外观,不必满足物理能量约束。接口分离不等于已经实现几何、光照、材质的可辨识分解。框架支持 PBR 也不意味着全部管线输出可重光照材质。
05 / 表示转换与分阶段优化
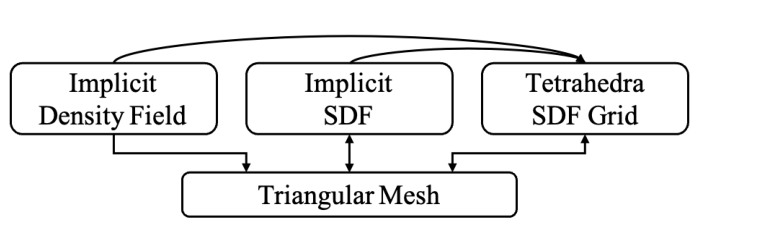
密度场在空间采样点预测非负密度,再沿射线积分。早期可以连续形成形状,但高分辨率需要大量采样,密度也未必对应干净表面。SDF 用零等值面定义几何;四面体 SDF grid 在格点保存标量并提取三角网格,以支持较高分辨率 rasterization。
数学补充:零等值面用于表面提取,法线用于着色、normal 渲染与正则。\(\varepsilon\) 防止数值除零;实际实现可以选择解析或有限差分法线。该式不是本文提出的新定义。
粗到细的动机是早期探索形状,后期把预算集中在表面与纹理。转换并非免费:阈值、包围盒、分辨率、离群组件处理和外观初始化都影响输出;坏粗形状可能被局部优化继续保留。
TextMesh–ProlificDreamer:原文串的是 TextMesh geometry → ProlificDreamer geometry → ProlificDreamer texture,并不再跑 ProlificDreamer coarse。前者借 SDF / NeuS 获得紧凑形状,中间细化网格,末阶段用 VSD 丰富纹理。特定组合的逐例完整运行日志与对应 paper commit 未给出。
06 / SDS、VSD 与梯度路径
Our Interpretation:原论文只命名 SDS / SJC / VSD。这里解释其共同接口和固定版本实现,不声称是本文的原创公式。
latent diffusion 先经 VAE encoder \(\mathcal{E}\) 编码,再按 scheduler 加噪;像素空间先验则可直接处理图像。\(\alpha_t,\sigma_t\) 取决于 scheduler,时间步百分比不能直接当作噪声标准差。
Classifier-free guidance 以尺度 \(s\) 加强条件方向。不同先验与算法采用的量级不同;增大不一定提高质量,也可能造成过饱和和偏置。
\(y_c\) 是相机相关条件,\(w(t)\) 是时间权重。扩散先验给出去噪残差,经过 encoder 与可微 renderer 回传场景。SDS 常不反传 U-Net Jacobian,因而不同于端到端训练扩散网络。共享三维参数产生跨视角耦合,但二维先验仍可能偏好各个视角都是正面,导致 Janus。
实现可将指定的 latent 梯度 \(g\) 包装成代理 loss,使对 \(z\) 的导数为 \(g/B\)。它的数值不是几何准确率或真实扩散似然;batch 归一化、梯度 clipping 与数值清理均影响有效更新。
VSD 的简化对照式用当前生成分布的预测项替换 SDS 中的采样噪声;常通过相机条件 LoRA 学习该项,所以有场景更新与 adapter 更新两条过程。这里省略粒子分布理论,不把单实例实现冒充完整推导。SJC 是另一套 score 与渲染参数关联的估计策略,并非替换一个 loss 名称即可保持其他细节不变。
Prompt Processor 按相机附加 front / side / back / overhead view;PerpNeg 和 Prompt Debiasing 用于抑制错误视角语义。本文只陈述集成,不提供完整 prompt 清单、逐项消融或 Janus 成功率。没有 LLM system prompt、top-p、beam search 等设置;这里应关注扩散步采样、相机采样和 CFG。
07 / Table 1:文本到三维的完整设计表
| Method | Stage | Geometry | Renderer | Material | Diffusion Guide |
|---|---|---|---|---|---|
| DreamFusion* | — | Implicit Density Field | NeRF Renderer | Diffuse | DeepFloyd-IF (SDS) |
| LatentNeRF | — | Implicit Density Field | NeRF Renderer | Albedo Only | Stable Diffusion (SDS) |
| SJC | — | Density Grid | NeRF Renderer | Albedo Only | Stable Diffusion (SJC) |
| Magic3D* | Coarse | Implicit Density Field | NeRF Renderer | Diffuse | DeepFloyd-IF (SDS) |
| Magic3D* | Refine | Tetrahedra SDF Grid | NVDiff Rasterizer | Diffuse | Stable Diffusion (SDS) |
| Fantasia3D | Geometry | Implicit SDF | NVDiff Rasterizer | — | Stable Diffusion (SDS) |
| Fantasia3D | Texture | Tetrahedra SDF Grid | NVDiff Rasterizer | PBR | Stable Diffusion (SDS) |
| ProlificDreamer* | Coarse | Implicit Density Field | NeRF Renderer | Albedo Only | Stable Diffusion (VSD) |
| ProlificDreamer* | Geometry | Tetrahedra SDF Grid | NVDiff Rasterizer | — | Stable Diffusion (SDS) |
| ProlificDreamer* | Texture | Tetrahedra SDF Grid | NVDiff Rasterizer | Albedo Only | Stable Diffusion (VSD) |
| TextMesh* | Geometry | Implicit SDF | NeuS Renderer | Diffuse | DeepFloyd-IF (SDS) |
全部 11 个方法 / 阶段行已重建。* 按 2023 原表保留,表示当时未发布代码、由作者复现;不说明这些项目今天的发布状态。“—”按原表保留。原文 p.4
DreamFusion 行采用 DeepFloyd-IF,不等同原 DreamFusion 闭源先验的完全复刻。Fantasia3D geometry 的 “Implicit SDF + NVDiff Rasterizer” 按原文保留;rasterizer 需要表面,不能理解为直接把连续 SDF 当成三角形。ProlificDreamer coarse / texture 用 VSD,geometry 用 SDS;PBR 仅在 Fantasia3D texture 行出现。
原文明说表格不覆盖正则和噪声退火等详细策略。因此六列不能当作完整可复现配置,也不能解释所有视觉差异。
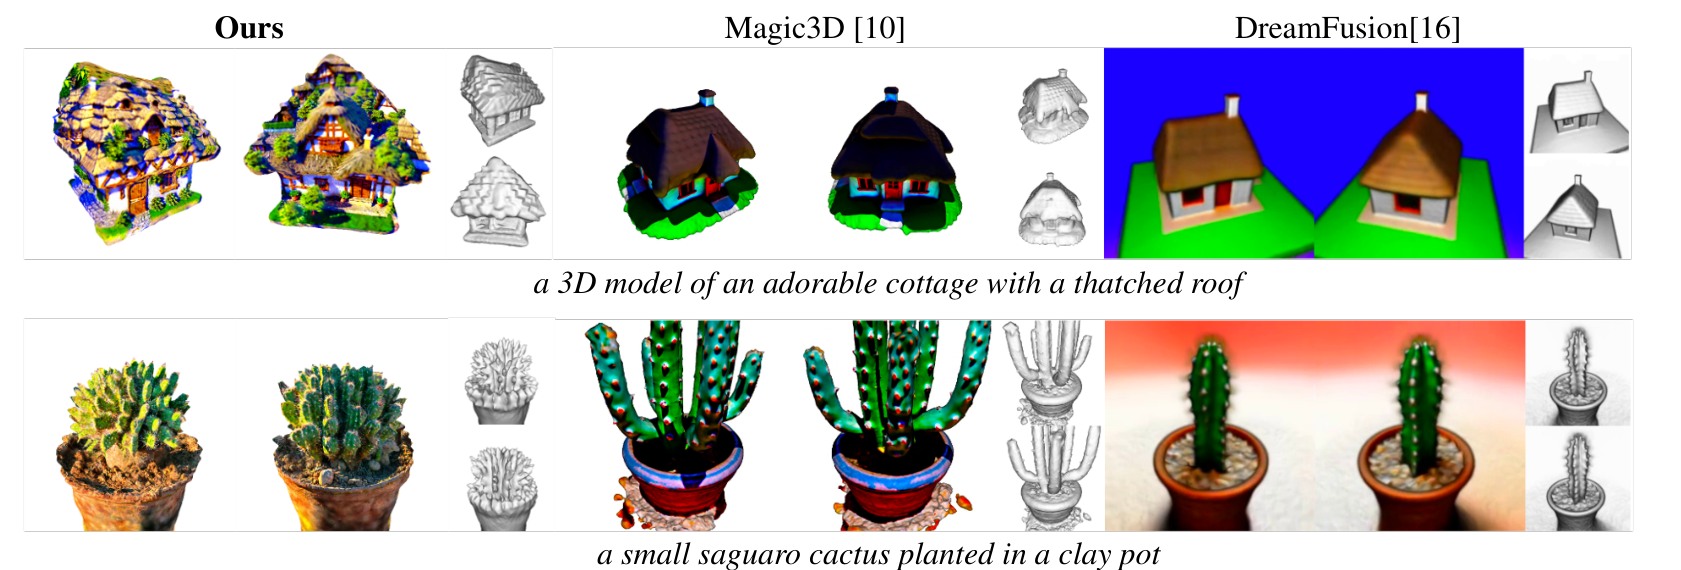
Paper Verified:实际展示两个 prompt 的比较。Author Claim:组合产生 promising results。Review:这不是大规模 benchmark;少量选择性示例不能证明普遍优于其他方法。预训练先验、分辨率和预算是潜在混杂因素。
08 / Table 2:图像条件生成与原表纠错
| Method | Stage | Geometry | Renderer | Material | Diffusion Guide |
|---|---|---|---|---|---|
| RealFusion | — | NeRF Renderer [原表如此] | Implicit Density Field [原表如此] | Albedo Only | Stable Diffusion (SDS) |
| Zero-1-to-3 | — | NeRF Renderer [原表如此] | Implicit Density Field [原表如此] | Albedo Only | Zero-1-to-3 (SDS) |
Zero-1-to-3 输入源图像与源 / 目标相对位姿,其先验来自在 Objaverse 图像上微调 Stable Diffusion。threestudio 利用该新视图先验指导三维 SDS / SJC 优化,而不是独立生成若干图像后简单拼接。RealFusion 采用文本扩散先验路线,两者的条件结构不同。原文 p.3
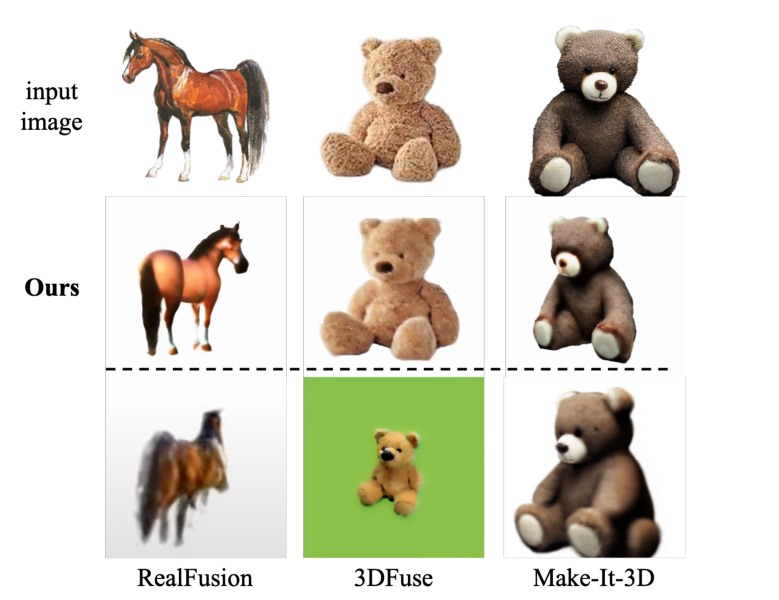
Implementation / 数学概括:参考图监督保持已见面,随机视角 guidance 填充未知面。\(A_\theta\) 为 opacity,\(M_{\mathrm{ref}}\) 为前景 mask。代码可选深度和法线监督,但不能默认每个配置开启。
“5 分钟、单张 A100 40GB”是特定 Zero123 SDS 配置的作者报告,没有样本数、多次均值、方差或完整计时边界;不能当作所有对象和硬件的速度保证。原文说视觉质量优于 SJC,但没有提供量化指标表。
09 / 参数观察,而非完整消融
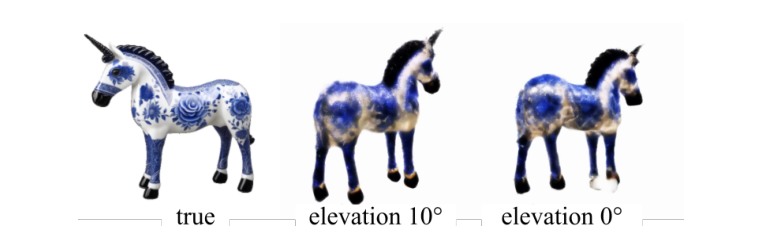
源相机误设会系统性改变所有目标相对视角条件,导致三维参数必须折中不一致的图像约束,可能引起顶面、轮廓和透视变形。合理改进是估计或搜索源视角,而非硬编码示例参数。这是机制解释,不是本论文的额外实验。
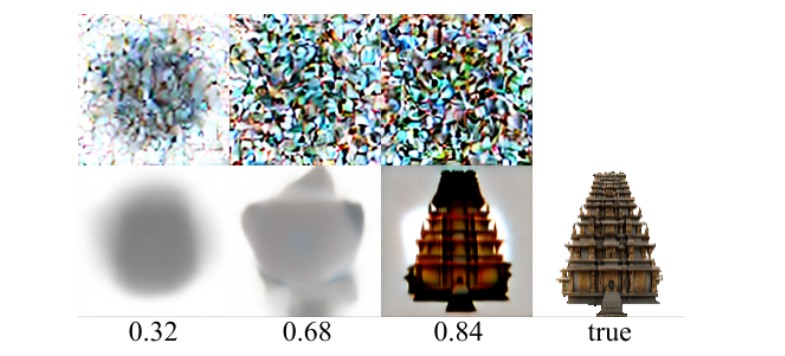
正文建议初期提高噪声,最小 noise level 从 0.7 退火至 0.2,最大保持 0.98。合理解释是高噪声弱化坏初始化细节,后期低噪声稳定细化,但时间步比例不等于噪声标准差。原文 p.4
缺少相同 seed 的多对象比较、固定噪声 baseline、不同退火长度与初始化的因子实验。因此 Figure 5 / 6 应叫定性参数观察。仓库快照的噪声 schedule 还与正文不同,复现不能混用后再声称完全遵循论文。
10 / 论文与代码:固定快照审计
只读审计包括 git 对象、哈希与 AST 解析,没有安装仓库依赖、加载权重或运行模型。审计快照 28d9d80d9d00f308244adfcf3be8b17ca0cb6465 的文件列表保存在 code-audit.json;它是较晚代码,不代表 2023 论文实验设置。
- launch.py 和 registry 把配置类型映射为系统与组件
- Stable Diffusion guidance 在 no-grad 中预测噪声,通过代理 loss 回传 latent / renderer
- VSD guidance 包含 LoRA 更新,不能笼统称 diffusion 全冻结
- Zero123 system 区分参考图与随机视图 substep,按权重启用损失
- C() 调度函数 将四元素列表解释为 start_step、start_value、end_value、end_step,默认线性插值
- mesh exporter 属于单独可检查的导出步骤,需检查表面与纹理质量
| Zero123 设置 | 2023 论文 | 历史快照 O | 审计快照 H |
|---|---|---|---|
| 源 elevation | 示例比较 10° / 0° | 默认 0° | 默认 5° |
| 总 steps | 未给 | 400 | 600 |
| 最小噪声比例 | 0.7 → 0.2 | 0.4 → 0.2,200 steps 完成 | 同历史 |
| 最大噪声比例 | 固定 0.98 | 0.85 → 0.5,200 steps 完成 | 同历史 |
| 速度 | 5 min / A100 40GB | 无受控计时记录 | 无受控计时记录 |
O = 8a51c37317b6f7cd74bb3cb24c975b56d0a96703,H = 28d9d80d9d00f308244adfcf3be8b17ca0cb6465。这些是版本漂移证据,不足以判断论文错误,也不能确定哪个提交生成了 Figure 4。历史版本只是靠近 PDF 创建时间的祖先,不是作者明确提供的 paper release。默认角度与示例最佳角度不同也并不矛盾。
11 / 配置级复现清单
Implementation H:以下来自固定快照配置,不能伪装成论文原文超参数。原文没有统一 train / val / test split、对象数量、模型参数量、optimizer、学习率或完整种子集合。Zero123 的 Objaverse 先验训练也不是此框架的新训练集贡献。
| Zero123 项目 | 固定快照设置 |
|---|---|
| 输入和模型 | 示例 hamburger_rgba.png;zero123-xl.ckpt;sd-objaverse-finetune-c_concat-256.yaml |
| 几何网络 | implicit-volume;radius 2.0;HashGrid 16 层、每层 2 features、log2 hashmap 19、base resolution 16;MLP 64 neurons / 2 hidden layers |
| 密度初始化 | softplus,blob_magic3d,scale 10.0、std 0.5 |
| 相机 | elevation −10°–80°;azimuth −180°–180°;distance 3.8,FOV 20° |
| 随机视图 | 分辨率 64 → 128 → 256;batch 12 → 4 → 2;milestones 200 / 300 |
| 参考视图 | 分辨率 128 → 256 → 512;milestones 200 / 300 |
| 渲染与材质 | NeRF volume;512 samples/ray;diffuse-with-point-light;ambient_only_steps 100000 |
| guidance | CFG 3.0;min [0,0.4,0.2,200];max [0,0.85,0.5,200] |
| 损失 | SDS 0.1;RGB 500;mask 50;normal smooth / 3D normal smooth 各 8;orient 1;sparsity / opaque 各 0.1 |
| 关闭监督 | depth、relative depth、normal 权重均为 0 |
| 优化器 | Adam,lr 0.01,betas 0.9 / 0.99,eps 1e−8 |
| 运行 | 600 steps,16-mixed;每 100 steps 保存;seed 0 |
| 评估 | 30 validation views、120 test views;是相机数,不是测试对象数 |
来源:zero123.yaml。ambient-only 阈值远大于总步数,不能只看到 material 类型便声称进行了复杂点光源物理材质拟合。
| 配置 / 阶段 | 图像与先验 | 优化器 / 学习率 | steps / precision |
|---|---|---|---|
| TextMesh geometry | 64² batch 1;SDF / NeuS;IF-I-XL-v1.0;CFG 20 | Adam;encoding .01,其余主要参数组 .001;eikonal 1000 | 10000 / 16-mixed |
| ProlificDreamer coarse | 64² → 512² 于 5000;SD 2.1 base + SD 2.1 LoRA;VSD CFG 7.5 | AdamW;encoding .01;density/feature/background .001;guidance .0001 | 25000 / 32 |
| ProlificDreamer geometry | 512² batch 1;tetrahedra grid 128;SD2.1-base SDS CFG100 | Adam .005;normal consistency / Laplacian 各10000 | 15000 / 32 |
| ProlificDreamer texture | 512² batch 1;fix_geometry true;VSD CFG7.5 | AdamW;encoding .01;feature/background .001;guidance .0001 | 30000 / 32 |
配置来源:TextMesh、coarse、geometry、texture。IF 的 XL、Zero123 XL 和 SD base 是各自模型族名称,不是统一的 base / large 对照实验。几何和纹理阶段的 geometry_convert_from 需要实际前阶段产物,不能保留占位值直接运行。
- 固定 commit、依赖、GPU、驱动、权重来源 / 哈希,保存全部配置覆盖项
- 保存 prompt、negative prompt 和视角后缀;图像任务保存 crop、mask、相机角度与尺度
- 先验证已知视角与坐标 convention,排除左右 / 上下 / 前后翻转
- 保存阶段转换前后的表面、阈值、包围盒、分辨率和拓扑统计
- 统一对象集合、多个种子与算力预算,包含失败样例
- 分开计时模型加载、预处理、优化、导出;检查多视角、重光照和网格可用性
未执行上述训练。配置是可复现起点,不是已经重现 Figure 3 / 4 的证明。没有提供停止条件之外的 reranking、beam search 或 agent retry,不应自行补写。
12 / 结论与证据强度
| 论点 | 证据 | 支持范围 | 不支持的延伸 |
|---|---|---|---|
| 模块可组合 | Fig.1、Table1–2 | 多条管线的统一表达 | 任意组合天然兼容 |
| 跨方法组合 | Fig.3 两个 prompts | 视觉可行性 | 普遍最优或显著提升 |
| 单图三维生成 | Fig.4 对比 | 展示条件生成结果 | 隐藏面真实准确 |
| 源 elevation 重要 | Fig.5 10° / 0° | 一个案例的敏感性 | 通用最优角度 |
| 早期噪声策略 | Fig.6 一步 denoising | 先验对初始化的作用 | 完整训练因果消融 |
| 快速优化 | A100 40GB 5 min 陈述 | 特定配置作者报告 | 所有硬件的时延保证 |
| 编辑与4D拓展 | 第5节 | 接口接入方向 | 已完成全面4D评测 |
没有 FID、CLIP score、Chamfer、PSNR 或用户研究偏好率的定量主表,没有显著性、标准差或完整失败率。Table 1 / 2 的 “state-of-the-art” 是方法背景描述,不是排名。正文 comprehensive comparisons 指设计选择对照,不能扩写成全面性能测评。
统一代码框架让控制变量更容易,但不自动统一先验、分辨率、时间、相机和初始化。评价时应区分软件可用性、组件组合潜力、单个算法质量。图像的视觉细节也不能代替可导出 mesh 的拓扑和可重光照检查。
13 / 编辑、4D 与程序化材质
第 5 节提到 InstructPix2Pix 支持 InstructNeRF2NeRF 类编辑,ControlNet 支持 Control4D-Static 类编辑。D-NeRF、HexPlane、K-Planes、Tensor4D 等时间相关几何配视频扩散模型可以扩展 text-to-4D。重点是模块可扩展;本文没有另给完整4D实验、时序损失和速度表。原文 p.4
对程序化材质的意义:Material 是可替换着色接口,但本文不生成 Substance 图、SBSAR、shader program 或离散节点拓扑。PBR 参数与可编辑程序历史并不相同;albedo-only 输出也不能称为已经获得 roughness、metallic、normal 分解。
Research Extension:程序图执行器接入渲染闭环
固定几何,用可微程序图生成 PBR maps,经过多光照 renderer 接受图像条件或 diffusion guidance。连续节点参数可求梯度,离散拓扑需要搜索、枚举或其他可验证策略。还要检查图合法性、节点支持范围、周期性、贴图分辨率与执行失败率,框架本身不提供这些保证。
可检验实验应比较直接纹理参数、固定拓扑程序图、拓扑搜索三条路线,统一预算和输入;同时测量图像质量、跨光照一致性、节点数与编辑稳定性。只在固定光照下提升图像匹配,可能只是把阴影烘进 albedo,不代表材质恢复进步。
14 / Reviewer 评论
Strengths
- 明确共同优化骨架与变化点,减少集成成本
- 既支持同阶段替换,也支持跨表示、跨方法串联
- 同时涵盖文本与图像条件,分清背景、材质、几何和 guidance
- 给出容易忽略的相机与噪声实践提醒
Weaknesses
- 创新主要在系统整合,理论新颖性有限
- 定量评测和控制变量不足,样例选择偏差不明
- 关键 schedule / regularization 未在短论文中完整报告
- 版本漂移使可运行代码不等于论文重现
- 几何真实性、隐藏面和物理材质缺少系统指标
优先改进是发布不可变 paper release、权重校验和全部输入 / seeds;统一对象与预算 benchmark;报告失败率及预处理、导出成本;为模块接口增加坐标系、形状、物理语义和阶段转换的契约检查。
更有因果意义的消融:固定全部组件只换 SDS / VSD;固定种子与场景只换 elevation;固定计算预算只换退火;测量表示转换前后的几何变化。只有隔离因素,才能从“方便组合”走向“知道为什么改善”。
结论:threestudio 把 diffusion-guided 3D 变成可组合、可检查的实验对象。最值得学的是模块契约和复现边界,而不是把一组默认参数当成已经被证明普适最优的答案。
15 / 来源与覆盖说明
- 清华官方 PDF:固定 SHA,与原文件一致;6 页、Figure1–6、Table1–2 全覆盖;无独立附录和编号公式
- 官方仓库;固定审计快照 H;历史上下文 O
- AI3DCC 2023 官方 accepted-papers 页面,本文列于 Non-Archival Workshop Publications;保留原页面作为身份证据
- 官方 poster 是补充说明,不能代替 PDF 或冒充附录定量实验
六幅原图从已核对的 PDF 提取。未发现完整图各自可靠的官方图片 URL,因此单文件内嵌优化 JPEG。两张原表重建为可选择文本;Table2 的列错误明确标注。补充公式使用 MathJax3,联网加载,不宣称完全离线数学渲染。
此版完成内容与静态检查。真实浏览器 MathJax、图片加载、导航、1440 / 760 / 390 px 布局按批次要求留待下载后验收。未部署、未写 Obsidian、未修改原笔记。