输入与输出
输入为概念图像和描述;每张图可含多个概念。输出为可复用的 token 调制偏移,以及在新提示词下组合这些概念的生成图像。
在DiT的逐文本token调制空间学习可组合概念,而不是修改全局条件或共享模型权重
Daniel Garibi* · Shahar Yadin* · Roni Paiss · Omer Tov · Shiran Zada · Ariel Ephrat · Tomer Michaeli · Inbar Mosseri · Tali Dekel | *共同第一作者
TokenVerse 把个性化从“为对象改一套模型”转成“为描述中的每个 token 学一条调制方向”:一张图里的对象、配饰、姿态、材质和光照可以分别绑定到词,再与其他图片独立学到的概念组合。关键不是增加文本 embedding,而是进入 DiT 的逐 token 调制空间 \(\mathcal{M}^{+}\)。
输入为概念图像和描述;每张图可含多个概念。输出为可复用的 token 调制偏移,以及在新提示词下组合这些概念的生成图像。
将同图的概念分解与跨图的独立学习后组合放在同一框架里;不要求用户提供对象分割或框。不是新的基础生成模型,也不是通用的一次前向参考图编码器。
三个定量任务的 CP 与 CP·PF 均最高,但 PF 并非最高;“九概念”只是定性展示,不能推导任意概念数量的稳定成功率。
本文精读锁定 arXiv:2501.12224v1,2025-01-21,合订 PDF 共 21 页,正文与参考文献为 1–12 页,附录 A–F 从 13 页起。不是“21 页正文加 21 页补充材料”。下载 PDF 的 SHA-256 与交接清单一致:9359fd5bb51e230192d89d48dfbc20074bc5dadf925052e440a5d721e0c7353e。
完整作者顺序为 Daniel Garibi、Shahar Yadin、Roni Paiss、Omer Tov、Shiran Zada、Ariel Ephrat、Tomer Michaeli、Inbar Mosseri、Tali Dekel。前两位明确为共同第一作者,研究在 Google DeepMind 实习期间完成;机构包括 Google DeepMind、Tel Aviv University、Technion 和 Weizmann Institute。未发现明确通讯作者标记,因此 Tali Dekel 仅作末位作者候选。
官方项目页标注 SIGGRAPH 2025 Best Paper Award,检查时仍显示 Code (coming soon)。会议信息与固定 v1 内容分开记录;本文不声称已审查或运行官方训练代码。
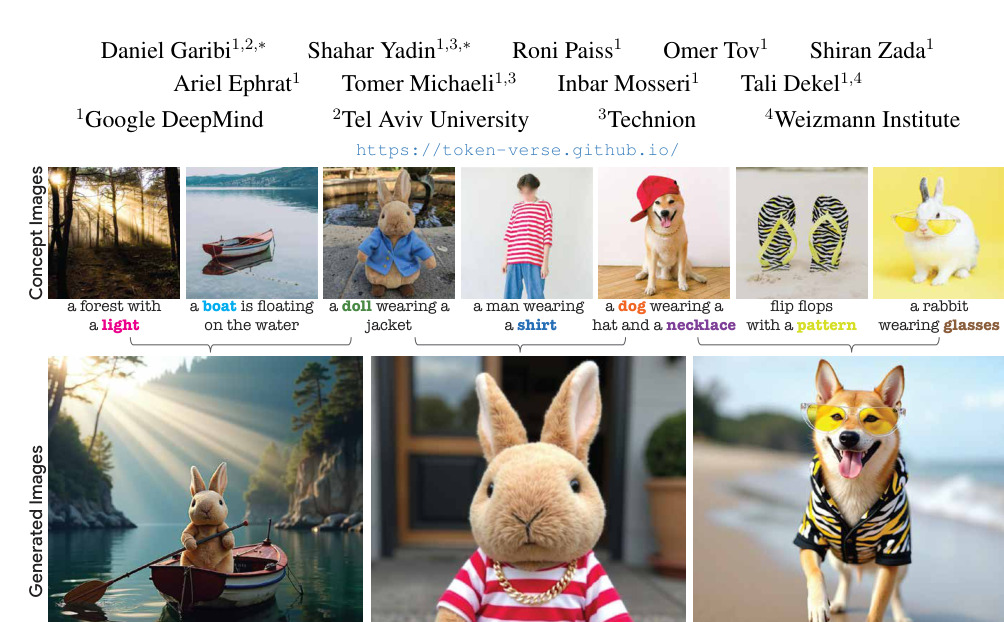
读图:上排是带多个概念的来源图,下排彩色词代表调用了哪个已学习概念。亮点不是生成一只新狗,而是狗的身份、别处学到的衬衫、纹理和眼镜能被重新绑定。注意图中并不等价于可编辑的分层场景或材质图输出。
设概念库为图像—描述对 \(\{(I_k,p_k)\}_{k=1}^{K}\)。每个描述中的词指定“希望学什么”:例如 a person dancing at dawn 可把 person、dancing、dawn 分别作为身份、姿势、照明的入口。新提示词既包含库内概念,又包含普通背景或动作;目标是在新布局中保留所选概念,并避免把原图的其他属性一并复制。这里的“无监督解耦”指没有对象掩码等空间监督,并不是没有图文配对或语言指导。§5
DreamBooth 类方法通过模型权重记忆新对象,但分别训练的权重或 LoRA 并不天然能无冲突合并。Textual Inversion 类方法固定基础模型,却受输入文本嵌入空间表达力限制。Break-a-Scene 依赖对象掩码,也不直接支持每张图独立训练后随意组合;ConceptExpress 可在一图中发现多个 token,却不保证找到用户想提取的姿态等概念。OMG 一类构图方法可组合个性化对象,但原本不解决复杂单图的多概念分解。
| Concept | Concept | masks | |
|---|---|---|---|
| Method | Decomposition | Composition | free |
| DB LoRA | \(\times\) | \(\times\) | \(\surd\) |
| Break-A-Scene | \(\surd\) | \(\times\) | \(\times\) |
| ConceptExpress | \(\surd\) | \(\times\) | \(\surd\) |
| OMG | \(\times\) | \(\surd\) | \(\surd\) |
| TokenVerse (Ours) | \(\surd\) | \(\surd\) | \(\surd\) |
Table 1 的三列分别是分解、组合、无需用户概念掩码。其 Composition 指分别学习后组合,所以 DreamBooth joint 或 BAS joint 的“共同训练后生成多个对象”不能据此算作同样的 plug-and-play 能力。OMG 的 mask-free 列也不意味着内部完全不使用空间分割,附录解释它使用自身生成图上的分割布局。
StyleGAN 的 modulation space 提供了“调制方向有语义”的启发;P+ / 文本反演扩展文本条件表示,但本文切换的是 DiT 内部的条件入口。LoRA 融合关注参数组合,TokenVerse 将共享基础模型保留不动,把可交换部分放在 token 侧。这个选择降低跨图权重冲突的来源,却不会数学上保证 attention 不相互干扰。
DiT 每个 block 包含 attention、前馈层和 modulation。图像 token 与文本 token 联合处理;另一条条件路径把扩散时间和 pooled 文本 embedding 映射为调制向量,再转换成逐通道 scale/shift。不要把“逐通道”和“逐 token”混淆:原模型按通道缩放,但同一个调制向量广播给所有 token。
\(p\) 是整个 prompt,\(\operatorname{CLIP}(p)\) 为 pooled 表示,\(t\) 为噪声时间,\(y\) 为 modulation 向量。这个公式是作者的概括表示,不应当替代 Flux 完整实现里的所有条件分支。模型进一步把 \(y\) 映射到各 block 的 scale 与 shift。用教学记号表达一个通道调制操作为 \(\widetilde h_i=s(y)\odot h_i+b(y)\);这只是机制说明,不是论文额外编号公式或完整 Flux block 代码。
\(e_{\mathrm{neutral}}\) 对应原始描述,\(e_{\mathrm{attribute}}\) 只增加一个属性,例如把 dog 改成 Poodle dog。方向加到原条件得到 \(y+w\Delta_{\mathrm{attribute}}\),其中 \(w\) 是方向强度。注意这一步是在探测调制空间的语义性,不能误认为最终每张参考图的个性化方向都由两条手写提示词相减得到。

全局 \(\mathcal M\) 的方向能把狗变成贵宾犬,却也可能改变旁边的猫;将同一方向只用于 dog token,其他文本及图像 token 继续使用原 \(y\),则干扰更局部。pose token 的例子说明其作用不局限于物体边界。这里“局部”是语义影响较集中,不代表一张硬掩码保证像素只在某个封闭区域变化。
可用以下说明式把注入位置写清楚:若需要个性化的 token 集合为 \(S\),则 \(y_i=y+\Delta_i\) 当 \(i\in S\),否则 \(y_i=y\)。文本 token 被不同条件调制后,通过 joint attention 影响对应图像 token。这借助基础模型原有的词—图关联,不是向图片像素直接粘贴一个对象,也不要求预先知道对象的精确分割区域。
\(\mathcal M^{+}\) 增加的是每个文本 token 可独立选取的 modulation,自由度与定位能力来自该结构改动;本文没有证明这些方向正交、独立或在任何 prompt 下不变。Fig. 14 的 key 冲突恰好说明不能把解耦理解为理论保证。§3–4,原公式 1–2

Concept-Mod 是小 MLP,为描述中的各 token 预测一条方向。训练以概念图及其描述为例,采用与基础生成模型相同的 diffusion objective;基础 DiT 权重固定,只学习新增方向预测模块。每张来源图可独立学习,因此无需为了每个新组合重新把所有来源图联合微调一遍。人类身份的例外是同一人的多图共同提供信息,而不是所有人物概念被强制联合训练。
这里有三种经常混淆的参数:基础 Flux 权重、用于生成调制的基础条件 MLP、为该概念图新训练的 Concept-Mod。前两者属于保留的 prior,第三者才是个性化优化对象。原公式把 Concept-Mod 的输入写作 \(p\),没有完整展开 tokenizer、子词对齐、MLP 层宽和缓存格式;不能凭“小 MLP”补造实现细节。
| 设置 | 阶段 1:粗语义 | 阶段 2:细节 |
|---|---|---|
| 步数 | 800 | 600,合计 1400 |
| 方向结构 | 每 token 一条,共享于 block | 额外 MLP 预测逐 block 偏移,并与 Concept-Mod 输出相加 |
| 92% 迭代采样 | \(800\le t\le1000\) | \(0\le t\le800\) |
| 剩余 8% 迭代 | \(0\le t\le800\) | \(800\le t\le1000\) |
| 设计意图 | 偏重高噪声时刻,建立粗语义 | 偏重低噪声时刻,完善细节 |
基础模型是 Flux-dev:58 个 DiT blocks,modulation 向量维度 3072。逐 block 方向可用说明记号 \(\Delta_{i,b}=\Delta_i+\delta_{i,b}\) 表达“相加后成为 per-token per-block”,但论文没有用这条式子规定第二 MLP 的精确输入、参数共享粒度,也没有报告它的参数总量,因此不能直接把自由偏移矩阵的元素数当成实际网络参数量。§6.1
一个偏移可以记住与它共现的其他东西。单图内的 token 已有语义定位倾向,但不同图各自优化以后,某个“狗”方向仍可能带出图里的帽子、背景,或干扰另一个“玩偶”。需要让训练见到本概念之外的图,并明确惩罚不该变的内容。

隔离损失在 50% 训练迭代启用。作者用基础 Flux 预生成固定 25 对普通图像和 caption;每次随机抽一个,与概念图左右拼接,并把两个 caption 拼成描述左右两部分的句子。学习方向只施加在原输入 prompt 的 token 上;比较“有个性化方向的模型”和“未个性化基础模型”的输出,但只对辅助图对应部分求 L2。教师目标是基础模型输出,不是直接把辅助 RGB 原图当作这项损失的预测目标。§5 与 Fig. 4
为帮助理解,可将其抽象成下式(本解读形式化,不是原文编号公式):
\[\mathcal L_{\mathrm{iso}}=\left\|R_{\mathrm{aux}}\odot\left[f_{\theta,\Delta}(z_t^{\mathrm{concat}},t,p_{\mathrm{concat}})-f_{\theta}(z_t^{\mathrm{concat}},t,p_{\mathrm{concat}})\right]\right\|_2^2.\]\(\theta\) 表示冻结基础模型,\(R_{\mathrm{aux}}\) 选择拼接后的辅助半幅,\(f_{\theta,\Delta}\) 是加入方向后的预测,\(f_\theta\) 是基础预测。该式省略原文未披露的归一化及权重,不可据此声称已获得可运行的完整损失。它使用已知拼接区域,却不需要用户标注概念的语义掩码;“完全不使用任何空间区域选择”是错误说法。
这项约束接近“局部保留基础先验”:要求新方向在无关半幅不影响模型行为。它不直接要求两个个性化概念互相正交,也不能完全覆盖任意复杂组合里的互扰。
文本增强保持对象、动作关键词,但变换语序,可借助 LLM 生成,使方向不只记住某个句法位置;图像增强包括随机翻转和镜像。人类身份用多张输入图,每图配 4 个 prompt 增强;其他案例单图配 8 个增强 prompt。文中没有给出人类每个身份固定图数、增强的精确采样概率或全部随机种子。附录 A

Fig. 12 是文本和图像增强一起移除的定性对照,不能分别量化两者各自带来的增益。作者报告更好的概念分离,但没有提供独立数值消融表或统计区间。
“Plug-and-play”发生在已训练概念的组合阶段,不表示新参考图无需优化。论文也未报告新 prompt 数量、概念数量与生成延迟的系统关系;不要将 1400 个训练步误写为采样步。
| 项目 | 有证据的内容 | 未充分披露的部分 |
|---|---|---|
| 基础网络 | Flux-dev,58 blocks,3072 维 | 精确 checkpoint revision 与所有推理条件 |
| 优化 | 两阶段 800+600,92% 时间分布,50% 隔离迭代 | 优化器、学习率、batch、权重系数、MLP 层宽与初始化 |
| 数据 | 单图/人类多图;25 张固定辅助图 | 完整训练图、prompt 增强列表、随机种子与 tokenizer 映射 |
| 推理 | 逐 token、逐 block 调制组合 | 采样器、采样步、guidance、分辨率、缓存策略 |
| 成本 | 需要逐来源的个性化优化 | 训练时长、显存、硬件、模块体积、推理额外开销 |
这是“能理解并设计复现”的论文,不是仅凭正文便能无歧义逐行复现的工程说明。没有运行代码、模型或生成流程;项目页的说明把 inference 简写成 added to text embeddings,但原论文 Fig. 3 和 §4–5 明确是 modulation vector offset,解读以固定 PDF 的数学和架构为准。

Fig. 5 每行四张来源图独立学习,右侧三幅新组合同时涉及对象身份、服饰、材质或环境。它说明来源概念并不必有相同空间布局,能够在新场景下重用;也提醒读者这些图是展示样例,不能以展示数量代替失败率。

Fig. 6 展示九个个性化对象/元素同处一图。作者说没有技术上的固定概念数量限制,但 attention 容量、词冲突与拥挤布局仍可能导致失败;没有对 2、4、8、16 概念进行统计扩展性实验。

Fig. 7 使用熊身份、人物姿态与多个光照来源进行组合;姿态不必绑定在原人物身份上。对研究材质的人尤其重要:这里的 material 是从图像提取的视觉概念,并没有估计 BRDF、分解反照率/光照或输出可渲染程序材质。光照概念表现力不等于物理光照一致性。

Fig. 13 逐列加入 pose、hair、shirt 或 lighting 等条件,普通背景仍由 prompt 控制。这是概念库的渐进式使用,不是对同一最终图执行严格可逆的属性编辑。

Fig. 8 比较两来源各取一概念的简单 full task。作者指出 OMG 可能把羊玩偶误提取成花瓶,方法间差异不仅在图像美观,也在是否取对了概念。图中 joint 方法为每个组合重新联合训练,不能把它们与独立训练方法的总工作量当成相同。
单概念来源使用 DreamBench++ 的 20 张子集及对应目标 prompt;多概念来源为作者自建 30 张图,每图 2–4 个概念,目标 prompt 由 LLM 生成。DreamBench++ 以多模态 LLM 评定 CP 与 PF,范围 0–1。每个生成概念分别计算 CP:评估时把参考图中其他概念遮掉,再对两个 CP 平均;所以“训练无需语义掩码”并不表示评估也从未使用 masking。§6.3.2
| Composition | Decomposition | Full task | |||||||
|---|---|---|---|---|---|---|---|---|---|
| Metric | CP \(\uparrow\) | PF \(\uparrow\) | CP \(\cdot\) PF \(\uparrow\) | CP \(\uparrow\) | PF \(\uparrow\) | CP \(\cdot\) PF \(\uparrow\) | CP \(\uparrow\) | PF \(\uparrow\) | CP \(\cdot\) PF\(\uparrow\) |
| Dreambooth | 0.280242 | 0.844422 | 0.236642 | 0.668524 | 0.660167 | 0.441337 | 0.207116 | 0.827521 | 0.171393 |
| DreamBooth\({}_{\text{joint}}\) | 0.371304 | 0.619288 | 0.229944 | 0.668524 | 0.660167 | 0.441337 | 0.306262 | 0.591337 | 0.181104 |
| OMG | 0.238606 | 0.743968 | 0.177515 | 0.267477 | 0.791793 | 0.211787 | 0.207787 | 0.843395 | 0.175246 |
| Break-A-Scene\({}_{\text{joint}}\) | 0.392912 | 0.372664 | 0.154380 | 0.598387 | 0.641935 | 0.384126 | 0.499054 | 0.641236 | 0.320011 |
| ConceptExpress | 0.214718 | 0.548723 | 0.117821 | 0.246387 | 0.695087 | 0.171260 | 0.187853 | 0.733286 | 0.137750 |
| Ours | 0.470108 | 0.688061 | 0.323463 | 0.669940 | 0.747698 | 0.500431 | 0.553125 | 0.821875 | 0.454600 |
该表完整保留 6 个方法、3 个任务、每任务 3 个指标,共 54 个指标数值。↑ 均为越高越好。CP·PF 是原作者报告的综合分数;不要把因小数精度或先逐样本相乘再平均产生的差异武断地认作算术错误,正文没有充分交代所有聚合细节。
Full task 的 DB CP 仅 0.207116,而 PF 仍有 0.827521,说明“句子看起来对”不等于“个人概念保留对”。作者解释 OMG 先生成再做布局分割,若目标对象与初始形状不匹配,就可能得到高 PF、低 CP;这是一种机制解释,论文未给每类失败单独的干预实验。
ConceptExpress 不微调基础权重,因此可直接组合学到的 token,但需人工把发现的 token 对应到目标概念;它只检测到测试集中 75% 的概念,剩余使用未个性化生成,这会影响总分。OMG 用多个 rare token 关联各概念以适配分解。DB 将多个分别训练的 LoRA 叠加;DB joint 和 BAS joint 对所有相关图共同微调,每个组合重新优化。它们有联合学习的信息优势,却丧失独立概念库的灵活性。附录 C.1–C.2
论文没有充分展示所有基线的统一基础模型、分辨率、总训练预算、超参数搜索和全部 checkpoint 信息;因此可认定“报告协议下的结果更优”,不能把表格当作只改变一个方法模块的完全受控架构实验。附录关于 OMG 的文字指向 Fig. 13,但相关基线对照实际是 Fig. 8;保留事实含义,不沿袭错误图号。

| Metric | CP \(\uparrow\) | PF \(\uparrow\) |
|---|---|---|
| Dreambooth | 2.2505 | 4.465 |
| DreamBooth\({}_{\text{joint}}\) | 2.7582 | 3.462 |
| OMG | 2.205 | 3.611 |
| Break-A-Scene\({}_{\text{joint}}\) | 3.203 | 3.151 |
| ConceptExpress | 2.211 | 2.686 |
| Ours | 4.078 | 4.292 |
1–5 分用户研究中,本法 CP 4.078,为表内最高,次优 BAS joint 3.203,差 0.875;PF 4.292,低于 DB 的 4.465。将其写成“人类偏好所有指标第一”会歪曲结果。两概念身份分别提问后平均,另问一次 prompt alignment,避免“一个非常好、一个很差”被联合问题掩盖。
未解决的报告一致性:§6.3.3 写 37 位参与者、每方法评价 5 个结果、总 3000 votes;按 6 方法、每图 3 问直乘得到 3330,而不是 3000。附录 D 又写每位 rater 看 15 个组合 × 6 方法 = 90 张图,若每人全答 3 问则为 9990。可能存在子采样、实际完成量或 vote 定义差异,但文中没有解释。本文照录原统计结果,同时标记人数/题量/票数口径待确认,不能自行替作者修正。

Fig. 20 给出了提示词匹配和概念保真题目界面;它能确认提问形式,但不能解释上述分配差异。未提供误差条、置信区间与参与者分层,因此平均分领先的统计稳定性仍需额外证据。

| 列 | 变化 | 观察与解释 | 证据边界 |
|---|---|---|---|
| (a) | 将偏移加到输入文本 token | 类似文本嵌入优化,难以忠实还原概念 | 不是宣布所有文本反演变体都无效 |
| (b) | 转到逐 token M+ | 保真改善,表明调制入口更有表达力 | 只有选定样例,未报告数字 |
| (c) | 增加逐 block 偏移 | 细节改善,但跨图组合仍可能互扰 | 不等于更大自由度自动带来解耦 |
| (d) | 增加隔离损失 | 减轻不同来源概念的干扰 | 仍存在 Fig. 11 / 14 的失败 |
消融是逐步添加组件的定性链,不是完整因子设计;模块交互、增加参数量和噪声阶段的贡献没有被独立量化。值得复现的最小扩展是固定基础网络和预算,比较 embedding、全局 modulation、逐 token、逐 block、隔离 loss 的 CP/PF 及方差,并单独扫描辅助图数量、50% 比例与噪声偏置。


作者在失败组合里观察到,独立学习的个性化方向使两个对象的 key 在所有 transformer block、所有时间步具有较高内积,引起 attention 混合;这种情况多发生在各自来源图的唯一/主要对象上,并不限于“狗 + 玩偶”这一类型。联合学习这些冲突概念可缓解,但也牺牲完全独立学习的优势。原文没有给出 key 相似度分布、阈值、失败频率或因果干预检验,因此这是有机制线索的观察,不是已证明的唯一原因。附录 F

两个不同来源都叫 doll 时,prompt 无法可靠区分想调用的实例。训练时分别命名为 rabbit 与 sheep 能缓解;这不是学习后任意改标签就已被验证。词的原有语义既帮助定位,也约束可用的身份命名空间。真正大规模概念库需要实例标识、子词处理和消歧策略。
短肢玩偶被要求执行人类四肢姿态时,可能长出不想要的人类身体部分。生成先验会试图满足姿态与身份的冲突约束,不能简单理解为方向强度不够。需要对形态适配、动作可行性和冲突提示设计单独机制。
附录 B 与 Figures 16–18 扩展展示对象、衣物、项链、场景、纹理和姿态组合。它们与主文统一使用独立概念来源后组合的思路,完整保留是为了检查跨域效果,而非只看少数精美主图。

Fig. 16 包含狗跳伞、玩偶换灯泡、马赛克材质与人物/配饰的复合场景。查看同一配饰是否在新姿态下保留形态,能够比只观察最终画面的审美更有效地评判个性化。

Fig. 17 包括驾驶、游乐设施、伞与项链等组合;从来源 caption 到输出 prompt 的对应关系,可区分是借用了泛化词义还是参考实例细节。

Fig. 18 增加灯光、雾、塑料外观和多个道具的配置;没有相应的物理一致性指标,光照与材质应作为视觉概念控制理解。

附录 E 的故事工作流先准备角色、场景和姿势概念库,由 LLM 写故事,再将故事转成逐幅 prompt,交给 TokenVerse 生成配图。图像中的身份一致性有助于叙事,但没有视频时序训练、帧间损失或对情节正确性的自动评估,因此不能叫作视频生成方法或完整故事规划系统。

Fig. 21 完整给出隔离损失用到的 25 张 Flux 基础图及 prompt。它们不是每个新概念现场生成的 25 张专属训练数据,而是所有示例重复使用的固定普通概念集合。辅助集覆盖人、动物、活动与场景,作用是暴露无关内容并约束扰动;其覆盖是否影响迁移仍没有消融。
以下是解读者提出的研究延伸,不属于原论文验证结论。
本文将原文三个编号公式全部讲解,辅助说明式明确标出,不以自行形式化的损失冒充作者已披露实现。所有原表保留全部方法行与数值;Figure 1–21 按主题插入且标明原编号。
归档时应补充 Shahar Yadin 为共同第一作者,加入官方 project_page,venue 更新应与固定版本说明共存。人物链接建议为 Daniel Garibi、Shahar Yadin 和通讯候选 Tali Dekel*;这里仅给候选关系,未修改实际人物记录或共享索引。旧笔记中的全部正文、图片引用与 PDF++ anchors 必须逐字保留,新增精读只追加末尾。
仍待核实:官方代码与超参数、用户研究统计口径、显著性/方差、通讯作者身份、所有基线公平配置。此交付仅包含内容与静态检查;没有运行训练/推理、没有浏览器验收、没有部署,也没有将候选笔记写回用户仓库。